一、實際硬體、作業系統與部署邊界
1. 工作站硬體配置
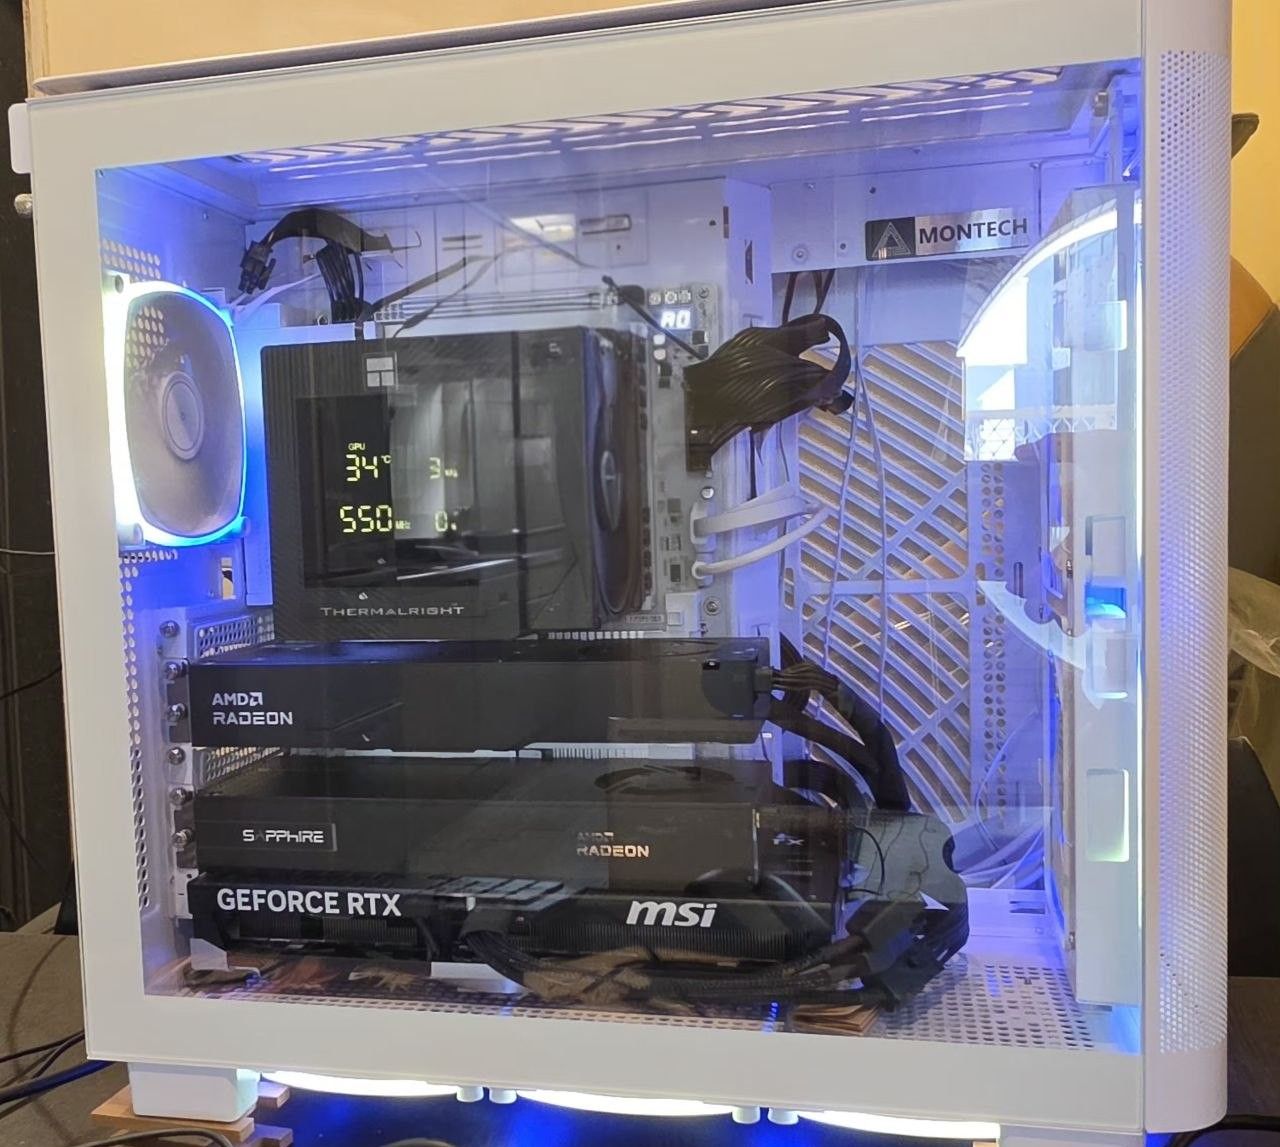
| 項目 |
本機配置 |
備註 |
| CPU |
Intel Core Ultra 7 270K Plus |
8 P-Core+16 E-Core,合計 24 核心/24 執行緒 |
| 主機板 |
GIGABYTE Z890 AERO G |
兩個 CPU 直連顯卡插槽規格為 PCIe 5.0;雙卡安裝時採 x8/x8 分配 |
| 系統記憶體 |
224 GB DDR5(96 GB+128 GB 混插) |
既有紀錄的實際速度約 4400 MT/s,不是以 5600 MT/s 或標稱 XMP 頻率計算 |
| GPU 0(服務代號) |
AMD Radeon AI PRO R9700 32GB |
Strata/HIP/ROCm(gfx1201),主推論服務 Port 8080 |
| GPU 1(服務代號) |
AMD Radeon AI PRO R9700 32GB |
llama.cpp/Vulkan,輔助服務 Port 8081;啟動參數使用 Vulkan2 |
| 第三張顯卡 |
NVIDIA RTX 5070 Ti 16GB |
用於其他獨立工作負載;未計入本文兩張 R9700 的跑分 |
| CPU 內顯 |
Intel Graphics |
用於 Windows 桌面顯示的配置方向 |
| 儲存裝置 |
SSD 4 TB+1 TB |
模型及編譯資料可依實際磁碟配置分配 |
| 電源供應器 |
1200 W |
是整機額定電源配置,不代表已經完成長時間滿載電力驗證 |
| 主要作業系統 |
Windows 11 64 位元 |
|
PCIe 必須分開記錄兩件事:
- 主機板設計能力:Z890 AERO G 的
PCIEX16 與 PCIEX8 共用通道;兩張卡同時裝入時,規格為 PCIe 5.0 x8/x8。
2. 建置與調校過程的主要挑戰
- 跨卡執行同一模型的通訊成本:早期嘗試過跨雙 R9700 切層或拆分模型運算。某些配置的單路解碼表現不如預期,因此後來改採「一卡一個服務」;但原稿沒有提供完整的 Tensor Parallel 與 Layer Split 對照資料,不能據此認定所有雙卡模型並行都比單卡慢,也不能直接將差異全歸因於 All-Reduce。
- MoE 的 VRAM 容量與主記憶體存取成本:Qwen3.8-Flash-Next 這類大型 MoE 量化檔案,依量化版本可能明顯超過單張 32GB VRAM。Strata 使用 GPU 專家快取與 CPU/RAM 路徑搭配;瓶頸可能涉及 RAM 頻寬、PCIe 傳輸、專家命中率、CPU 計算及排程,須以時序資料判斷。不能把模型總參數量、GGUF 檔案大小與 VRAM 專家常駐量混為一談。
二、現行架構:兩張 R9700 各自承擔不同任務
不再預設由兩張 R9700 合力執行同一個模型,而是分別啟動推論服務,由 Hermes 或其他 Agent 呼叫端按工作性質選擇端點。
                  Hermes/Agent 呼叫端
               (按任務選擇模型與端點)
                           │
                ┌──────────┴──────────┐
                ▼                     ▼
     GPU 0/127.0.0.1:8080   GPU 1/127.0.0.1:8081
     AMD R9700 32GB          AMD R9700 32GB
     Strata v0.1.40.3        llama.cpp b11388
     Windows HIP/ROCm       Windows Vulkan
                │                     │
     Qwen3.8-Flash-Next      Qwen3.8-27B-Uncensored
     Dyluhn UD-IQ4_XS MoE    IQ4_XS 主模型
     GPU 專家快取+CPU/RAM   +DFlash2 Q4_K_M 草稿
                │                     │
     複雜推理/長任務        程式碼/摘要/任務委派
     Tool Calling            視覺輸入(需驗證 mmproj)
| 面向 |
GPU 0:主推論服務 |
GPU 1:輔助推論服務 |
| 主要用途 |
多步驟推理、工具呼叫、長文本任務 |
快速程式碼回覆、摘要、Agent 分工、可選視覺處理 |
| 運算引擎 |
Strata v0.1.40.3 |
llama.cpp b11388(Vulkan) |
| 模型 |
Dyluhn-Qwen3.8-Flash-Next-Uncensored-UD-IQ4_XS |
Qwen3.8-27B-Uncensored-IQ4_XS+Qwen3.8-27B-DFlash2-Q4_K_M |
| 記憶體策略 |
GPU 專家快取與主記憶體互補 |
主模型+草稿模型;目標與草稿 KV Cache 採 Q8 |
| 服務位址 |
127.0.0.1:8080(依實際啟動器設定) |
127.0.0.1:8081 |
| 已有的測試依據 |
MoE decode/MTP/約 38.8K tokens 請求記錄 |
DFlash 接受率、decode、prefill 測試記錄 |
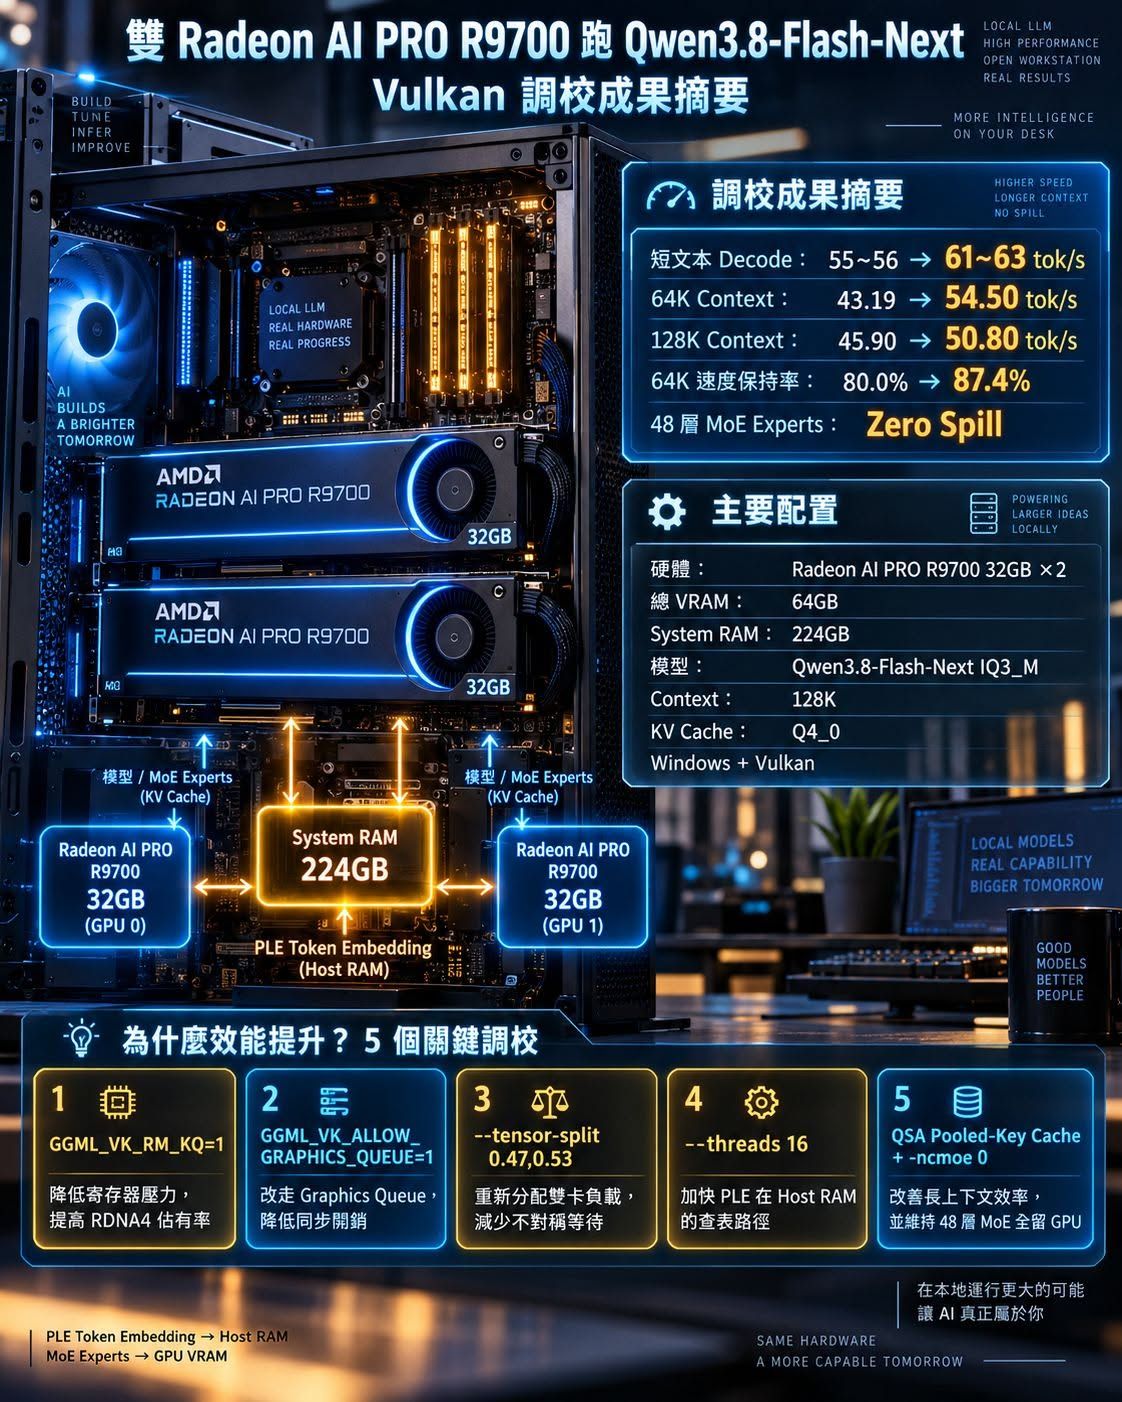
GPU 0 的快取配置為 21.66 GiB,監測數值顯示 9,611 個 Expert 快取條目或相關計數、命中率約 91%~95%。在未看到 Strata log 欄位定義之前,這裡不把「9,611」直接解釋成 9,611 個相異且同時完整駐留的專家模型。
**架構上的限制:**兩張 32GB R9700 並不是天然共享的單一 64GB VRAM。這套方案是兩個各自使用其 VRAM、RAM 和執行引擎的工作節點。Hermes 是否真的自動路由,仍需檢查 routing 規則或實際請求記錄;端點存在本身不代表智慧路由已驗證。
三、GPU 0:MoE 模型版本更換的生產力任務比較。
| 評測任務 (Task) |
指標項目 |
Model A (IQ3_S 獨立獨佔) |
Model B (Dyluhn UD-IQ4_XS 獨立獨佔) |
實測差異與特性分析 |
| ① Three.js 露營區 3D 單檔 HTML<br>(生成 1024 tokens, temp=0.7) |
• 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) |
2.52s<br>62.2 tok/s<br>59.1% (354/599)<br>19.04s |
1.89s (更快  )<br>58.7 tok/s<br>58.2% (463/795)<br>19.36s |
Dyluhn 首字回應更快;兩者解碼皆穩定在 ~60 tok/s 水準。 |
| ② Python LRUCache 完整結構<br>(生成 1024 tokens, temp=0.0) |
• 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) |
1.36s<br>80.0 tok/s<br>75.6% (605/800)<br>14.19s |
1.74s<br>70.9 tok/s<br>86.0% (顯著提升  )<br>16.21s |
IQ3_S 因專家槽位多 (1.18萬) 純文字速度快;但 Dyluhn 投機接受率高出 10.4%,代碼邏輯預測更精準。 |
| ③ 道路工程結構化 JSON 萃取<br>(生成 512 tokens, temp=0.0) |
• 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) |
1.85s<br>82.8 tok/s<br>88.3% (361/409)<br>8.04s |
2.34s<br>67.9 tok/s<br>90.5% (最高 )<br>9.89s |
兩者均 100% 正確萃取 JSON 結構;Dyluhn 投機接受率突破 90% 大關。 |
| ④ 中文公文函稿撰寫<br>(生成 1024 tokens, temp=0.7) |
• 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) |
1.60s<br>73.0 tok/s<br>65.7% (497/757)<br>15.66s |
1.94s<br>60.9 tok/s<br>62.8% (505/804)<br>18.80s |
兩者皆流暢產出千字長文公文,正體用語扎實。 |
| ⑤ Hermes Agent Tool-Call 巡檢<br>(max 256 tokens, temp=0.0) |
• 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 消耗 Token<br>• 工具調用判定 |
1.88s<br>71.3 tok/s<br>256 tok (用罄截斷)<br> FAIL (思考溢出未成調用) |
2.47s<br>51.6 tok/s<br>105 tok (精準收斂)<br> PASS (成功輸出 XML) |
【致命分水嶺】<br>IQ3_S 思考標籤漫遊,256 tokens 耗盡仍無 <tool_call>;Dyluhn 4.5秒精準輸出標準 XML 標籤! |
| 全任務平均解碼速度 |
- |
~73.9 tok/s |
~62.0 tok/s |
- |
四、GPU 1:llama.cpp Vulkan+DFlash2 調校結果
GPU 1 使用 Qwen3.8-27B-Uncensored IQ4_XS 主模型+DFlash2 Q4_K_M 草稿模型,原始紀錄的執行檔為 llama-server b11388。以下數據保留原稿,並把各指標分開看待。
1. 配置比較
| 組別 |
測試變更 |
Short Code (tok/s) |
Decode 512 tok (tok/s) |
DFlash 接受率 |
Prefill 4K (tok/s) |
Prefill 25.8K (tok/s) |
原稿 Hash/觀察 |
| G1-0 |
b11388;draft n-max 6;Q8 目標 KV;停用 graph optimize |
190.6 |
74.94 |
49.9% |
832.0 |
780.0 |
33f09658;基準 |
| G1-1a |
改用 b10780 |
71.2 |
30.95 |
59.5% |
666.2 |
602.5 |
a9da36ea;退步 |
| G1-1b |
改用 b10751 |
80.3 |
31.88 |
59.5% |
677.1 |
603.8 |
a9da36ea;退步 |
| G1-2 |
b11388;草稿 K/V KV 改用 Q8 |
188.6 |
75.60 |
50.4% |
821.4 |
774.8 |
33f09658;草稿 KV 節省 |
| G1-3a |
draft n-max 改為 4 |
188.1 |
72.54 |
50.0% |
821.7 |
775.9 |
33f09658 |
| G1-3b |
draft n-max 設為 6 |
188.6 |
75.60 |
50.4% |
821.4 |
774.8 |
33f09658;均衡配置 |
| G1-3c |
draft n-max 改為 8 |
187.5 |
72.88 |
45.0% |
819.8 |
775.3 |
38c9a247 |
| G1-4 |
移除 GGML_VK_DISABLE_GRAPH_OPTIMIZE |
196.2 |
76.69 |
52.1% |
702.9 |
770.0 |
a5f37019;原稿三次輸出一致 |
| G1-5 |
目標模型 V KV 改為 Q4 |
188.9 |
71.07 |
40.4% |
787.3 |
700.7 |
b6e3f98d |
2. 技術判讀與取捨
(1)新舊 llama.cpp 版本的表現
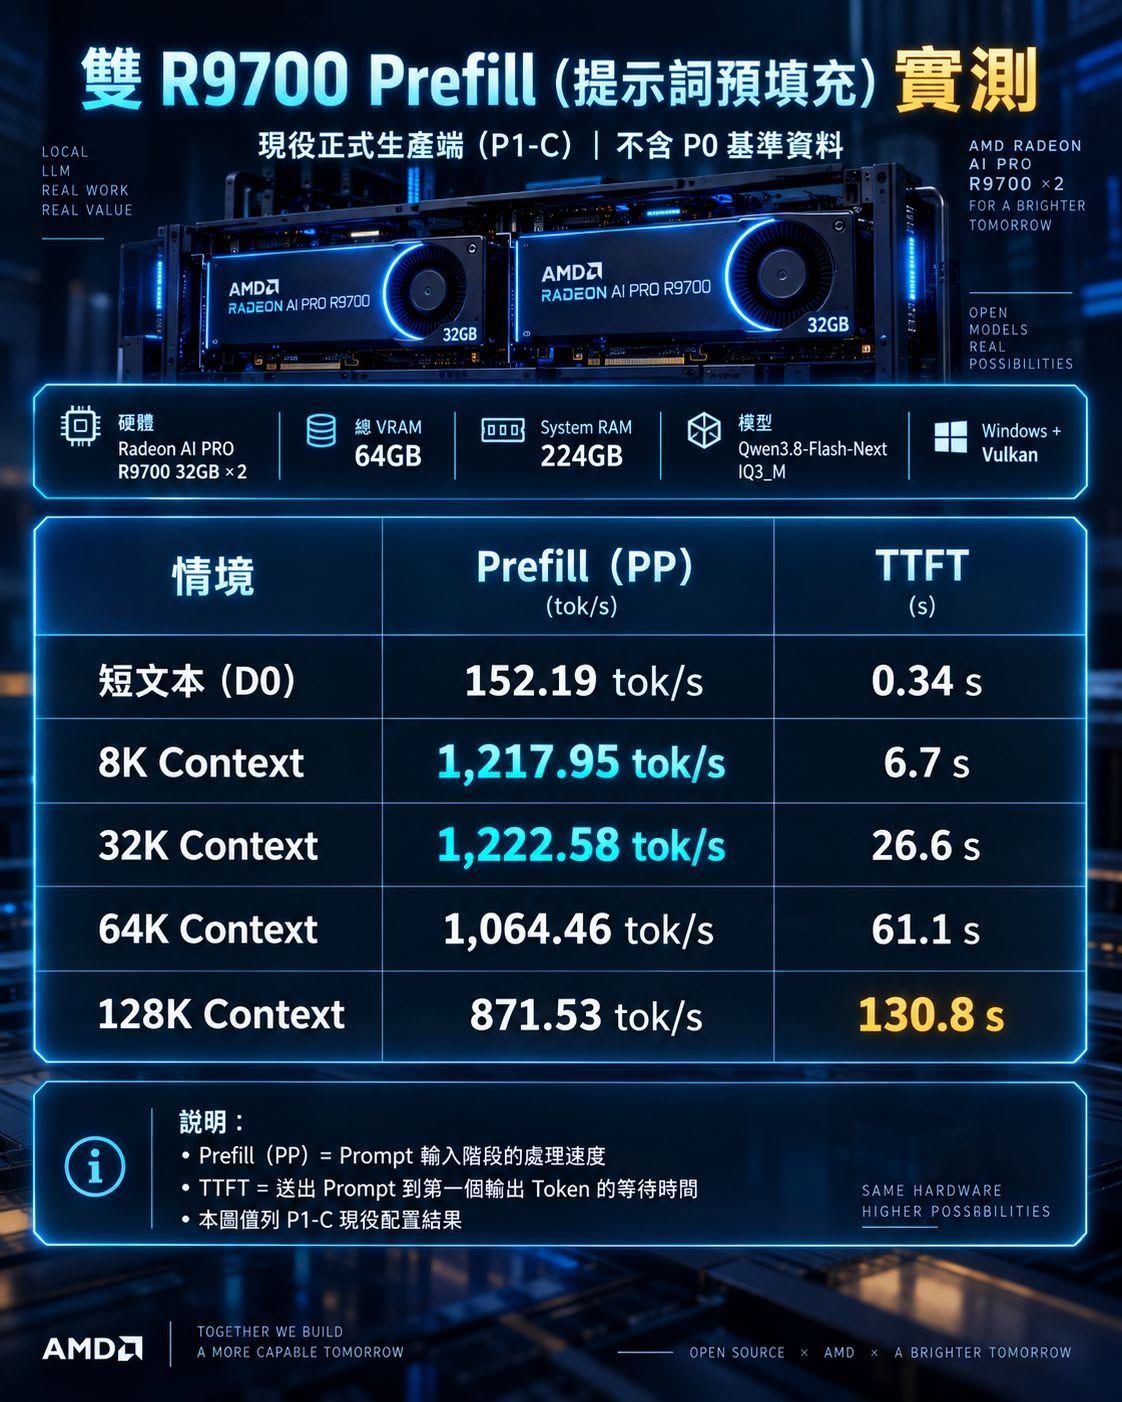
R9700/Vulkan 工作負載中,b11388 的 Decode 512 為 74.94 tok/s,b10780 為 30.95 tok/s,b10751 為 31.88 tok/s。因此這台機器的這組配置不適合直接套用降版建議。
(2)草稿 KV 量化有益,但不是整體 VRAM 減半
加入 -ctkd q8_0 -ctvd q8_0,是把草稿模型的 K/V KV Cache 由預設 F16 路徑改為 Q8;依資料型別的每元素儲存開銷,草稿 KV 容量可接近減半(仍有量化區塊開銷),不是整張顯卡顯存用量或整個模型占用減半。原稿 G1-0 → G1-2 的 Decode 512 是 74.94 → 75.60 tok/s,屬小幅改善。
(3)n-max = 6 在這組測試較均衡
草稿窗口 4、6、8 的 Decode 512 分別為 72.54、75.60、72.88 tok/s;故暫保留 --spec-draft-n-max 6。Hash 改變只表示輸出不同,不等於答案必然錯誤;若要比較答案品質,還須固定 seed、取樣設定與評分方法。
(4)開啟 Vulkan graph optimization 的確改善 decode,但犧牲部分 prefill
G1-4 的 Decode 512 76.69 tok/s 是原稿最高,Short Code 也達 196.2 tok/s;然而 G1-4 的 4K Prefill 為 702.9 tok/s,低於 G1-2 的 821.4 tok/s(約 -14.4%),25.8K Prefill 則為 770.0,略低於 G1-2 的 774.8。
因此,不應寫成「移除禁用 graph optimize 後所有指標全面提升」。若以長輸出解碼為主,G1-4 可以優先;若頻繁送入 4K 新提示詞,G1-2/G1-3b 可能更適合。
(5)目標模型 V KV 改成 Q4 的測試未帶來速度優勢
G1-5 的 Decode 512 為 71.07 tok/s、DFlash 接受率 40.4%,低於 G1-4。這能支持「目前測試不採用此設定」,但不能單憑速度下降就認定唯一原因一定是反量化計算。
五、GPU 0:Strata MoE、MTP 與排程參數比較
GPU 0 的 Strata v0.1.40.3 以較大的 GPU 專家快取服務 MoE 模型,原稿觀察到約 91%~95% 的專家快取命中率。對於 CPU/RAM 與 PCIe 同時參與的路徑,以下數字有參考價值,但仍需搭配完整 profiling 判斷瓶頸。
1. 原始測試結果
| 組別 |
參數配置 |
Greedy Decode (tok/s) |
Greedy MTP 接受率 |
Sampled Decode (tok/s) |
Sampled MTP 接受率 |
判讀 |
| G0-0 |
預設;--pool-workers 7;預設 tasks |
60.3 |
85.0% |
50.4 |
73.53% |
基準 |
| G0-1a |
STRATA_SPEC_COUPLED=1 |
66.6 |
85.0% |
54.0 |
60.49% |
Greedy、Sampled 均較基準快 |
| G0-1b |
Coupled+Gumbel |
66.3 |
85.0% |
55.3 |
62.08% |
Sampled 進一步提升 |
| G0-2 |
啟用 decode timing 診斷 |
62.3 |
85.0% |
48.3 |
67.56% |
診斷模式;不作正式效能排名 |
| G0-3a |
--pool-tasks 64+Coupled+Gumbel |
65.7 |
85.0% |
56.1 |
69.57% |
Greedy/Sampled 綜合取捨較均衡 |
| G0-3b |
--pool-tasks 96+雙加速 |
60.5 |
87.0% |
55.0 |
61.94% |
Greedy 較弱 |
| G0-3c |
--pool-tasks 128+雙加速 |
59.7 |
76.6% |
60.5 |
64.69% |
Sampled 單項最高,但 Greedy 較弱 |
2. 調校結論
- Greedy 單項最高:G0-1a 的 66.6 tok/s。
- Sampled 單項最高:G0-3c 的 60.5 tok/s。
- 兩種工作負載均衡:G0-3a 的 Greedy 65.7 tok/s 與 Sampled 56.1 tok/s;相對基準 Sampled 50.4 tok/s,約增加 11.3%。若主力是日常混合 Agent 工作,暫選
--pool-tasks 64 有依據。
--pool-workers 7 代表 Strata 設定的工作執行緒/worker 數量,不代表 CPU 只有 7 顆 P-Core。本機 CPU 實際具有 8 P-Core+16 E-Core;--pool-affinity p-cores 的綁定效果須用執行緒親和性/實際 CPU 使用情形確認。
3. 時序診斷與 PCIe 瓶頸
原稿記錄 STRATA_DECODE_TIMING=1 下 361 個解碼窗口的部分統計:
GPU Wait Time:15.86 msCPU Pool Time:4.65 ms- 原稿的
pcie_frac 設定/讀值:0.55;另提到 26.1 GB/s,但未附頻寬計數器與測量定義。
現階段建議:把 pcie_frac=0.55 當成原始基準,不急著調高;同時在固定負載下比較 PCIe 實際傳輸量、專家 cache hit/miss、CPU per-core 使用率、GPU idle/wait、單次 token latency。若要調 pcie_frac,用相同 prompt 逐項比對,避免依單一計時器做過度推論。
六、記載的推論啟動配置
這是配置記錄,不是已於本次連入主機驗證可直接執行的腳本。
1. GPU 1:Qwen3.8-27B IQ4_XS+DFlash2(Port 8081)
"C:\llama.cpp-b11388-vulkan\llama-server.exe" ^
--device Vulkan2 ^
-m "D:\LLM\Qwen3.8-27B-Uncensored\Qwen3.8-27B-Uncensored-IQ4_XS.gguf" ^
--mmproj "D:\LLM\Qwen3.8-27B-Uncensored\Qwen3.8-27B-Uncensored-vision-f16.gguf" ^
--spec-draft-model "D:\LLM\Qwen3.8-27B-Uncensored\Qwen3.8-27B-DFlash2-Q4_K_M.gguf" ^
--spec-draft-device Vulkan2 ^
--spec-draft-ngl 999 ^
--spec-draft-n-max 6 ^
--spec-draft-p-min 0 ^
--spec-type draft-dflash ^
-c 131072 ^
-np 1 ^
-ngl 999 ^
-fa on ^
-ctk q8_0 ^
-ctv q8_0 ^
-ctkd q8_0 ^
-ctvd q8_0 ^
-b 2048 ^
-ub 1024 ^
--alias Qwen3.8-27B-Uncensored,Qwen3.8-27B ^
--host 127.0.0.1 ^
--port 8081 ^
--jinja
endlocal
### 2. GPU 0:Strata MoE(Port 8080)

```json
{
  "engine": "strata",
  "model_path": "D:\\LLM\\Dyluhn-Qwen3.8-Flash-Next-Uncensored-UD-IQ4_XS",
  "args": [
    "--kv", "int8",
    "--kv-resident", "32768",
    "--expert-cache", "auto",
    "--pool-workers", "7",
    "--pool-affinity", "p-cores",
    "--pool-tasks", "64"
  ],
  "env": {
    "STRATA_PREFILL_MMQ": "1",
    "STRATA_HIP_WMMA": "1",
    "STRATA_SELECT_WMMA": "1",
    "STRATA_HIPBLASLT_TUNING": "D:\\LLM\\Strata-Orca-Q4\\Strata\\tools\\hip\\gfx1201-hipblaslt-100500.txt",
    "STRATA_SH_STREAM": "0",
    "STRATA_SPEC_COUPLED": "1",
    "STRATA_SPEC_GUMBEL": "1"
  }
}
官方技術規格與參數參考
實測
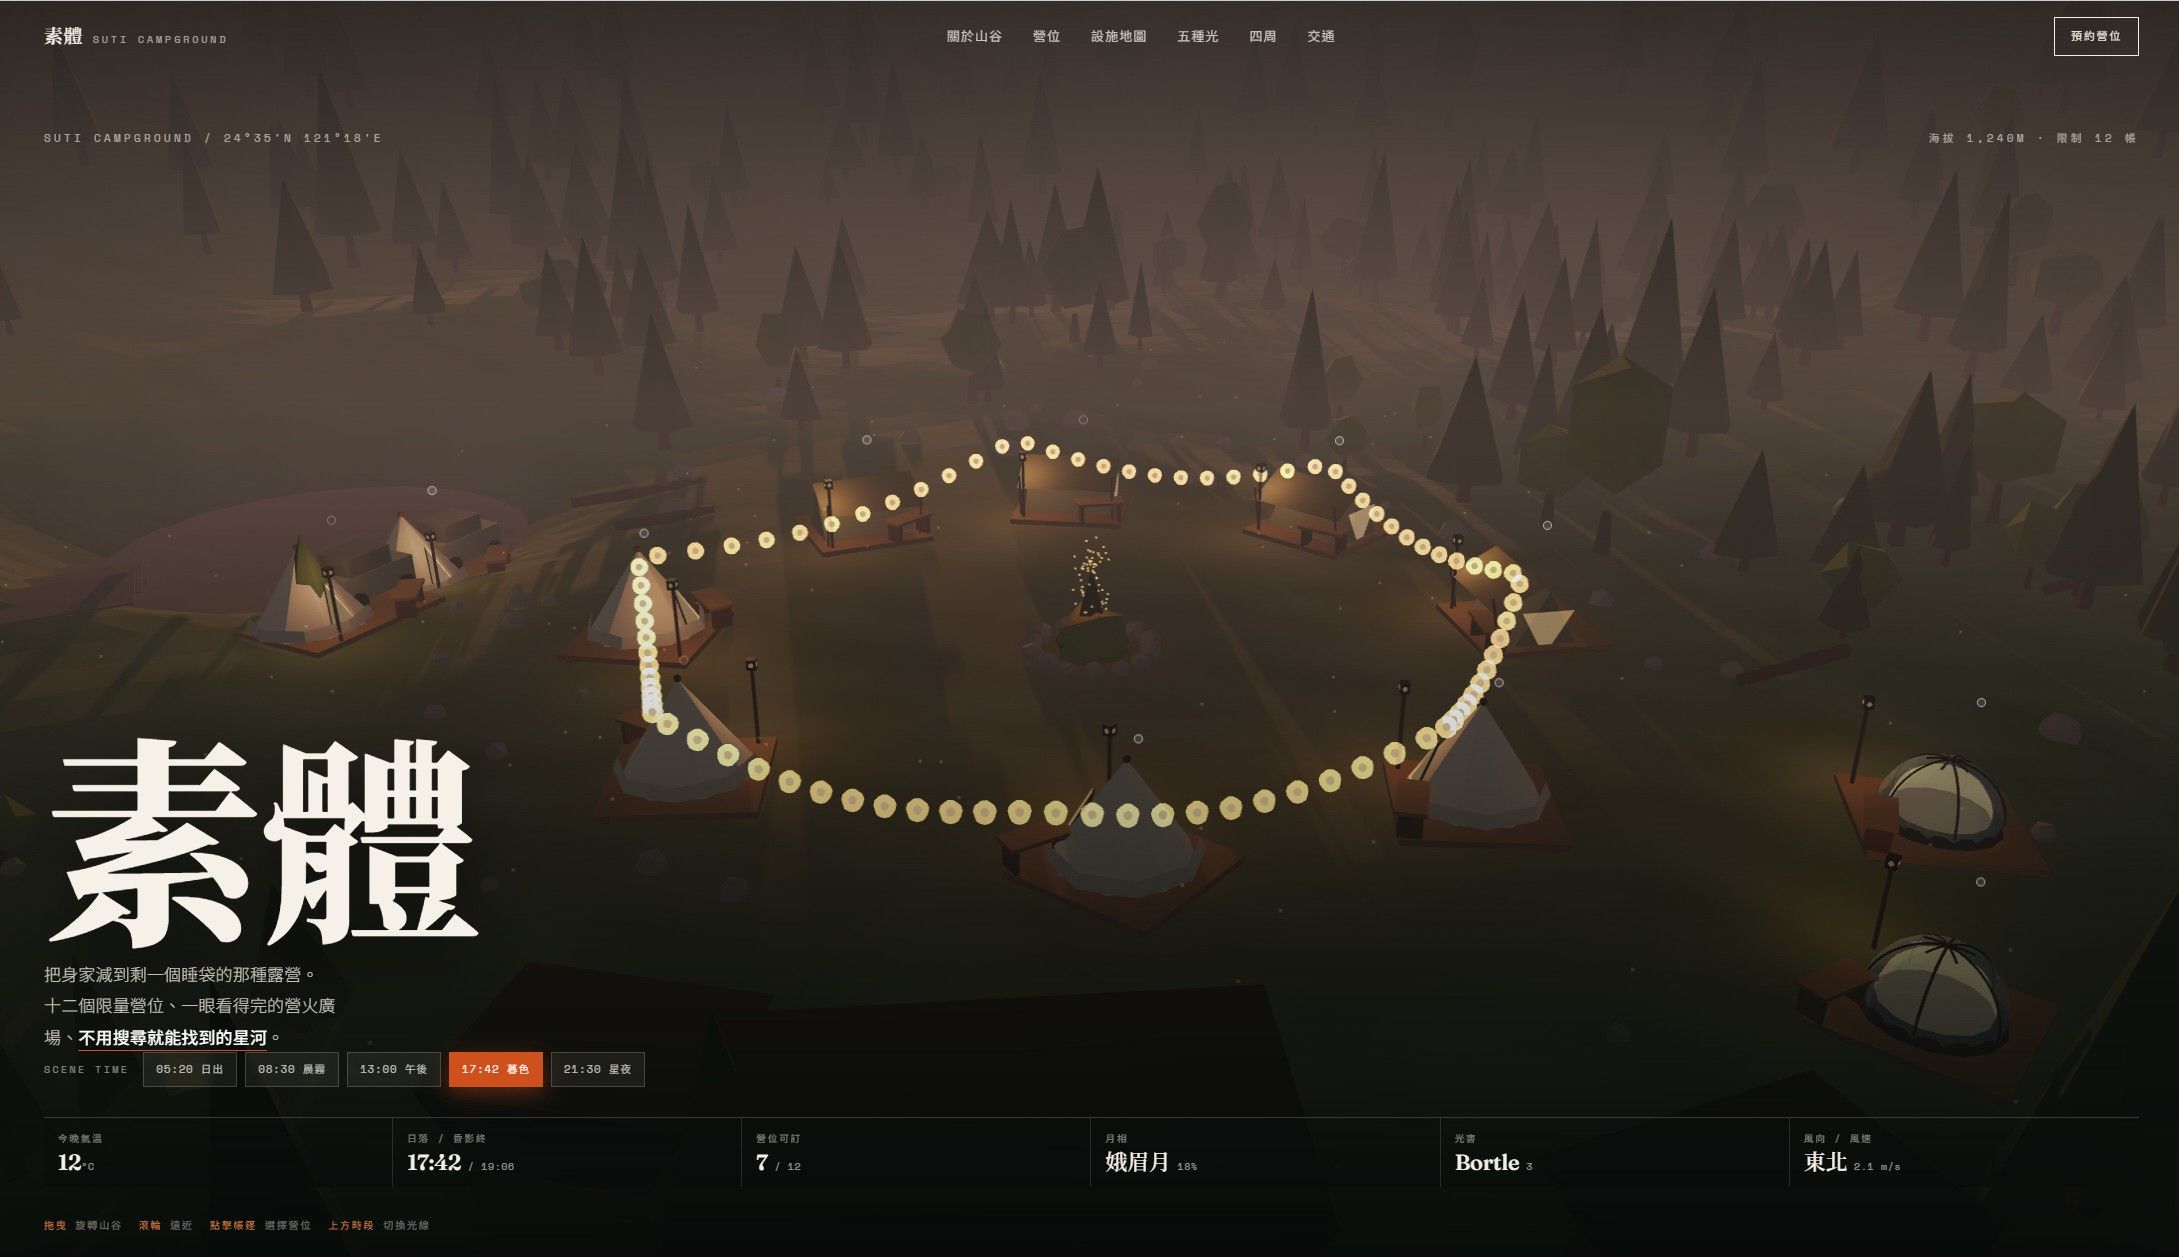
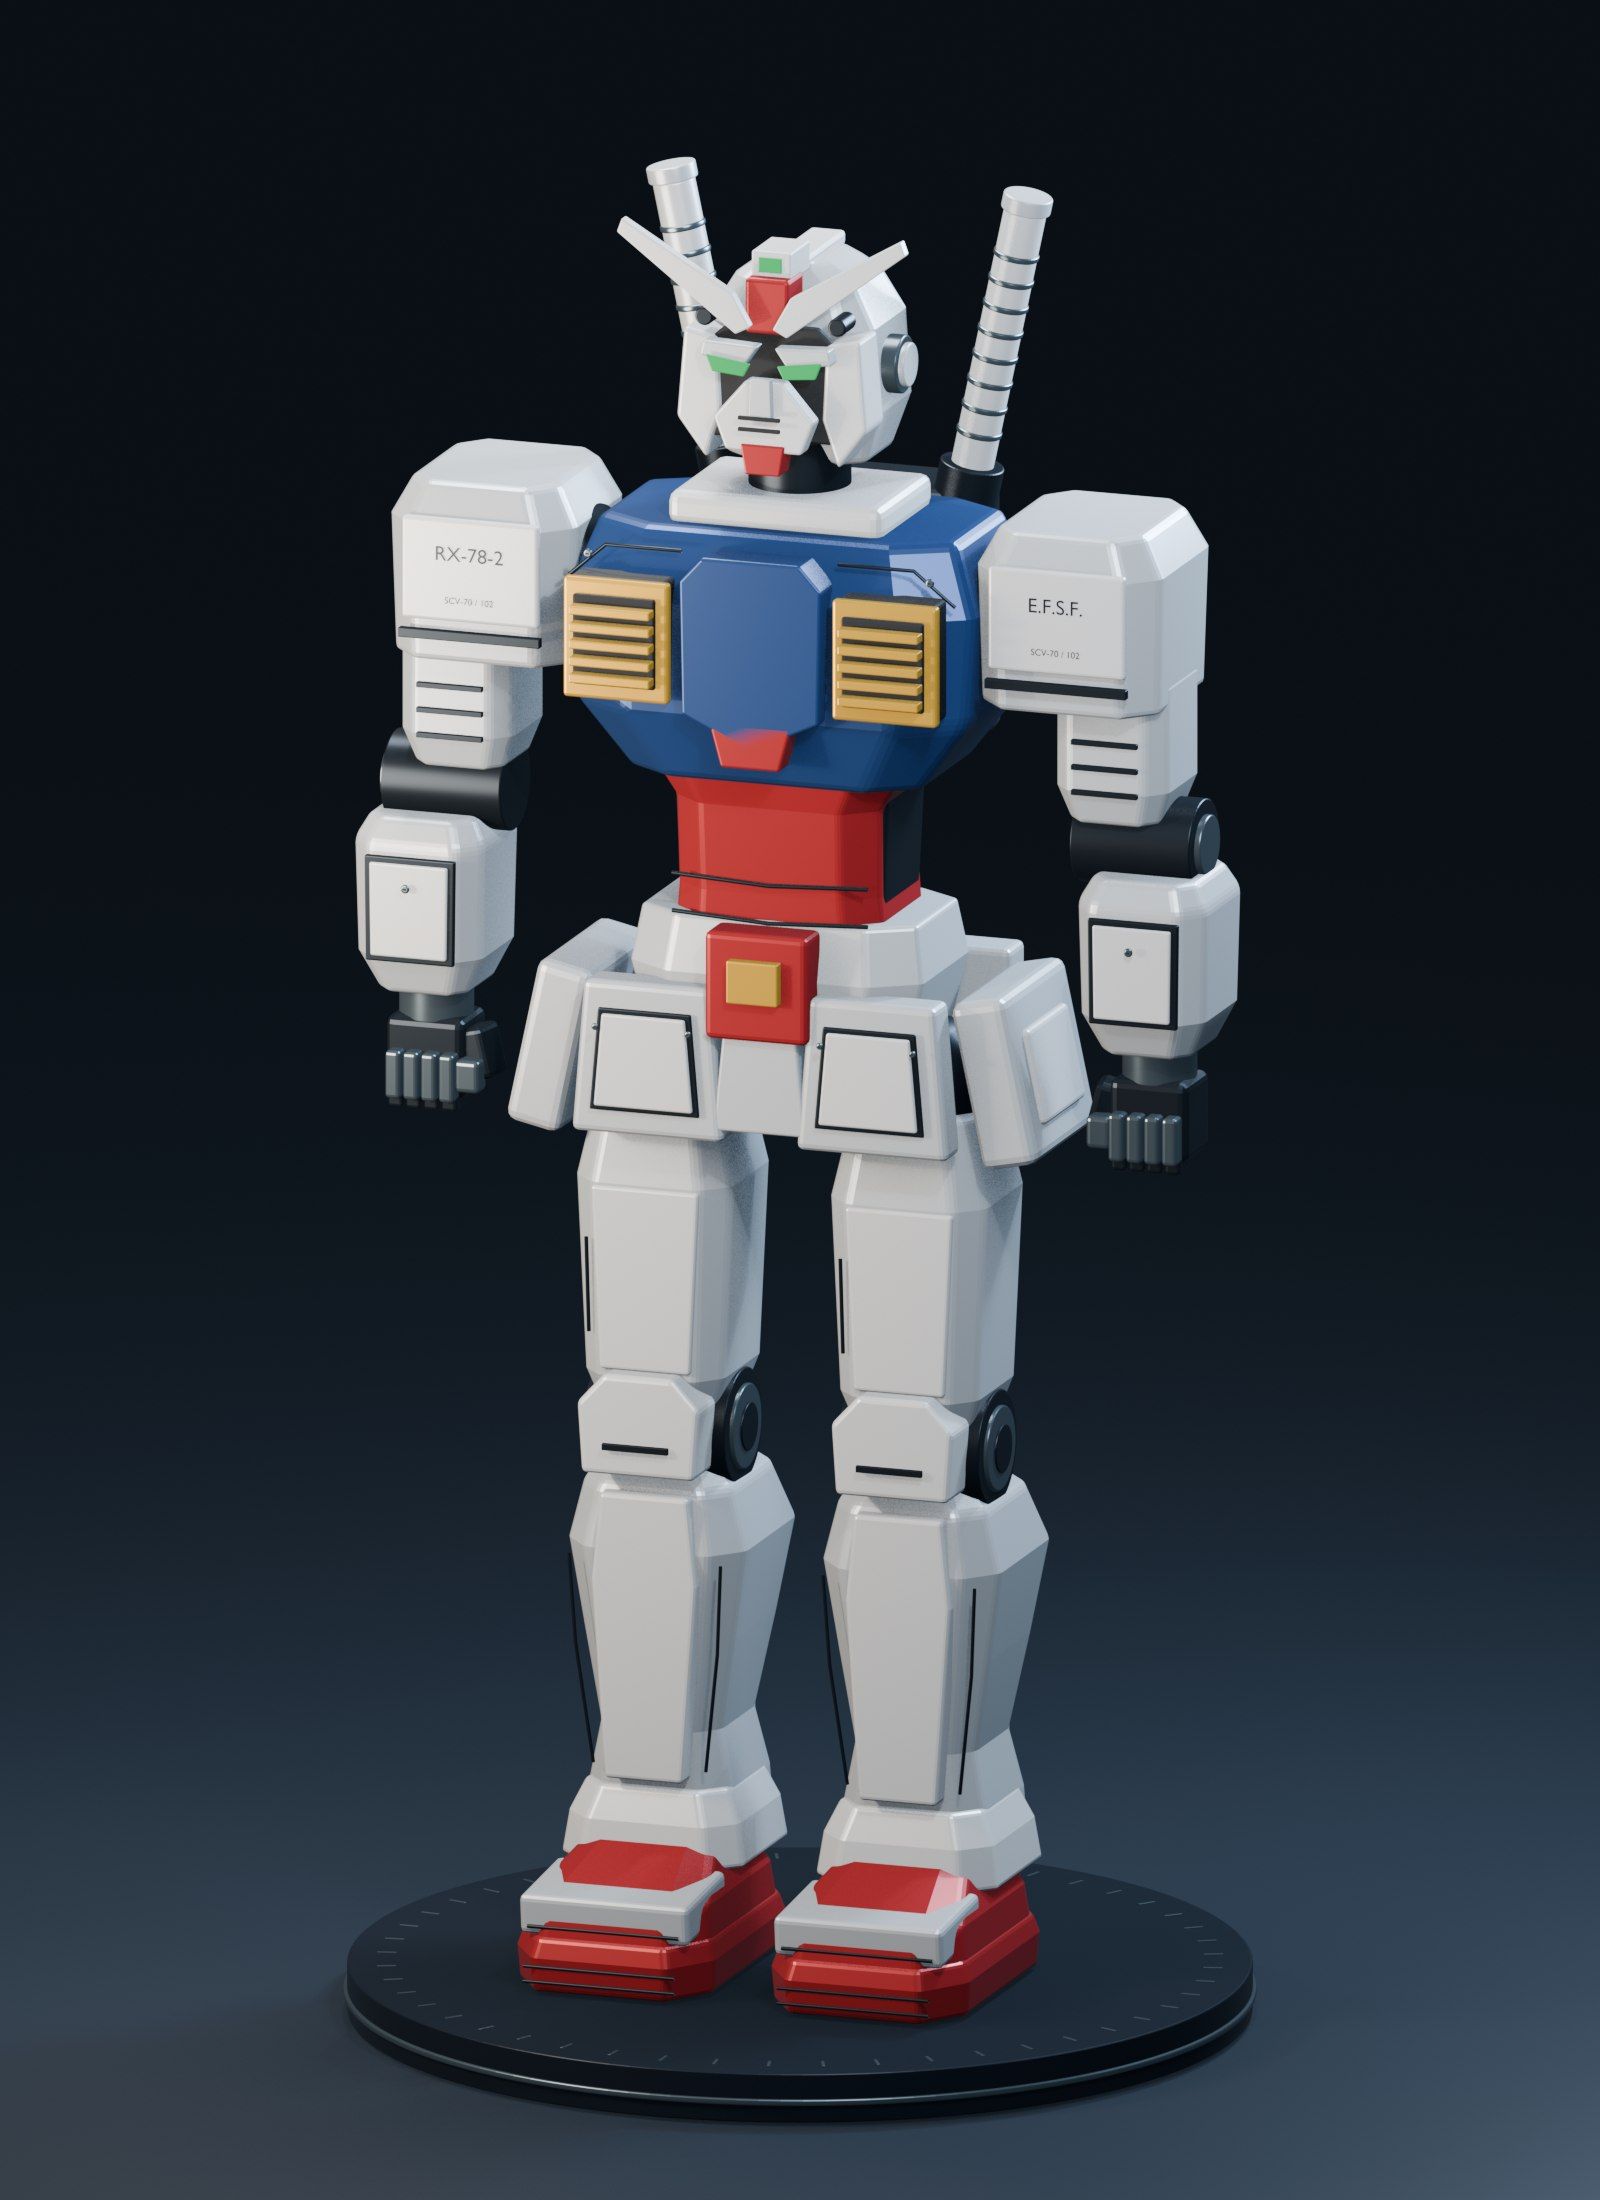
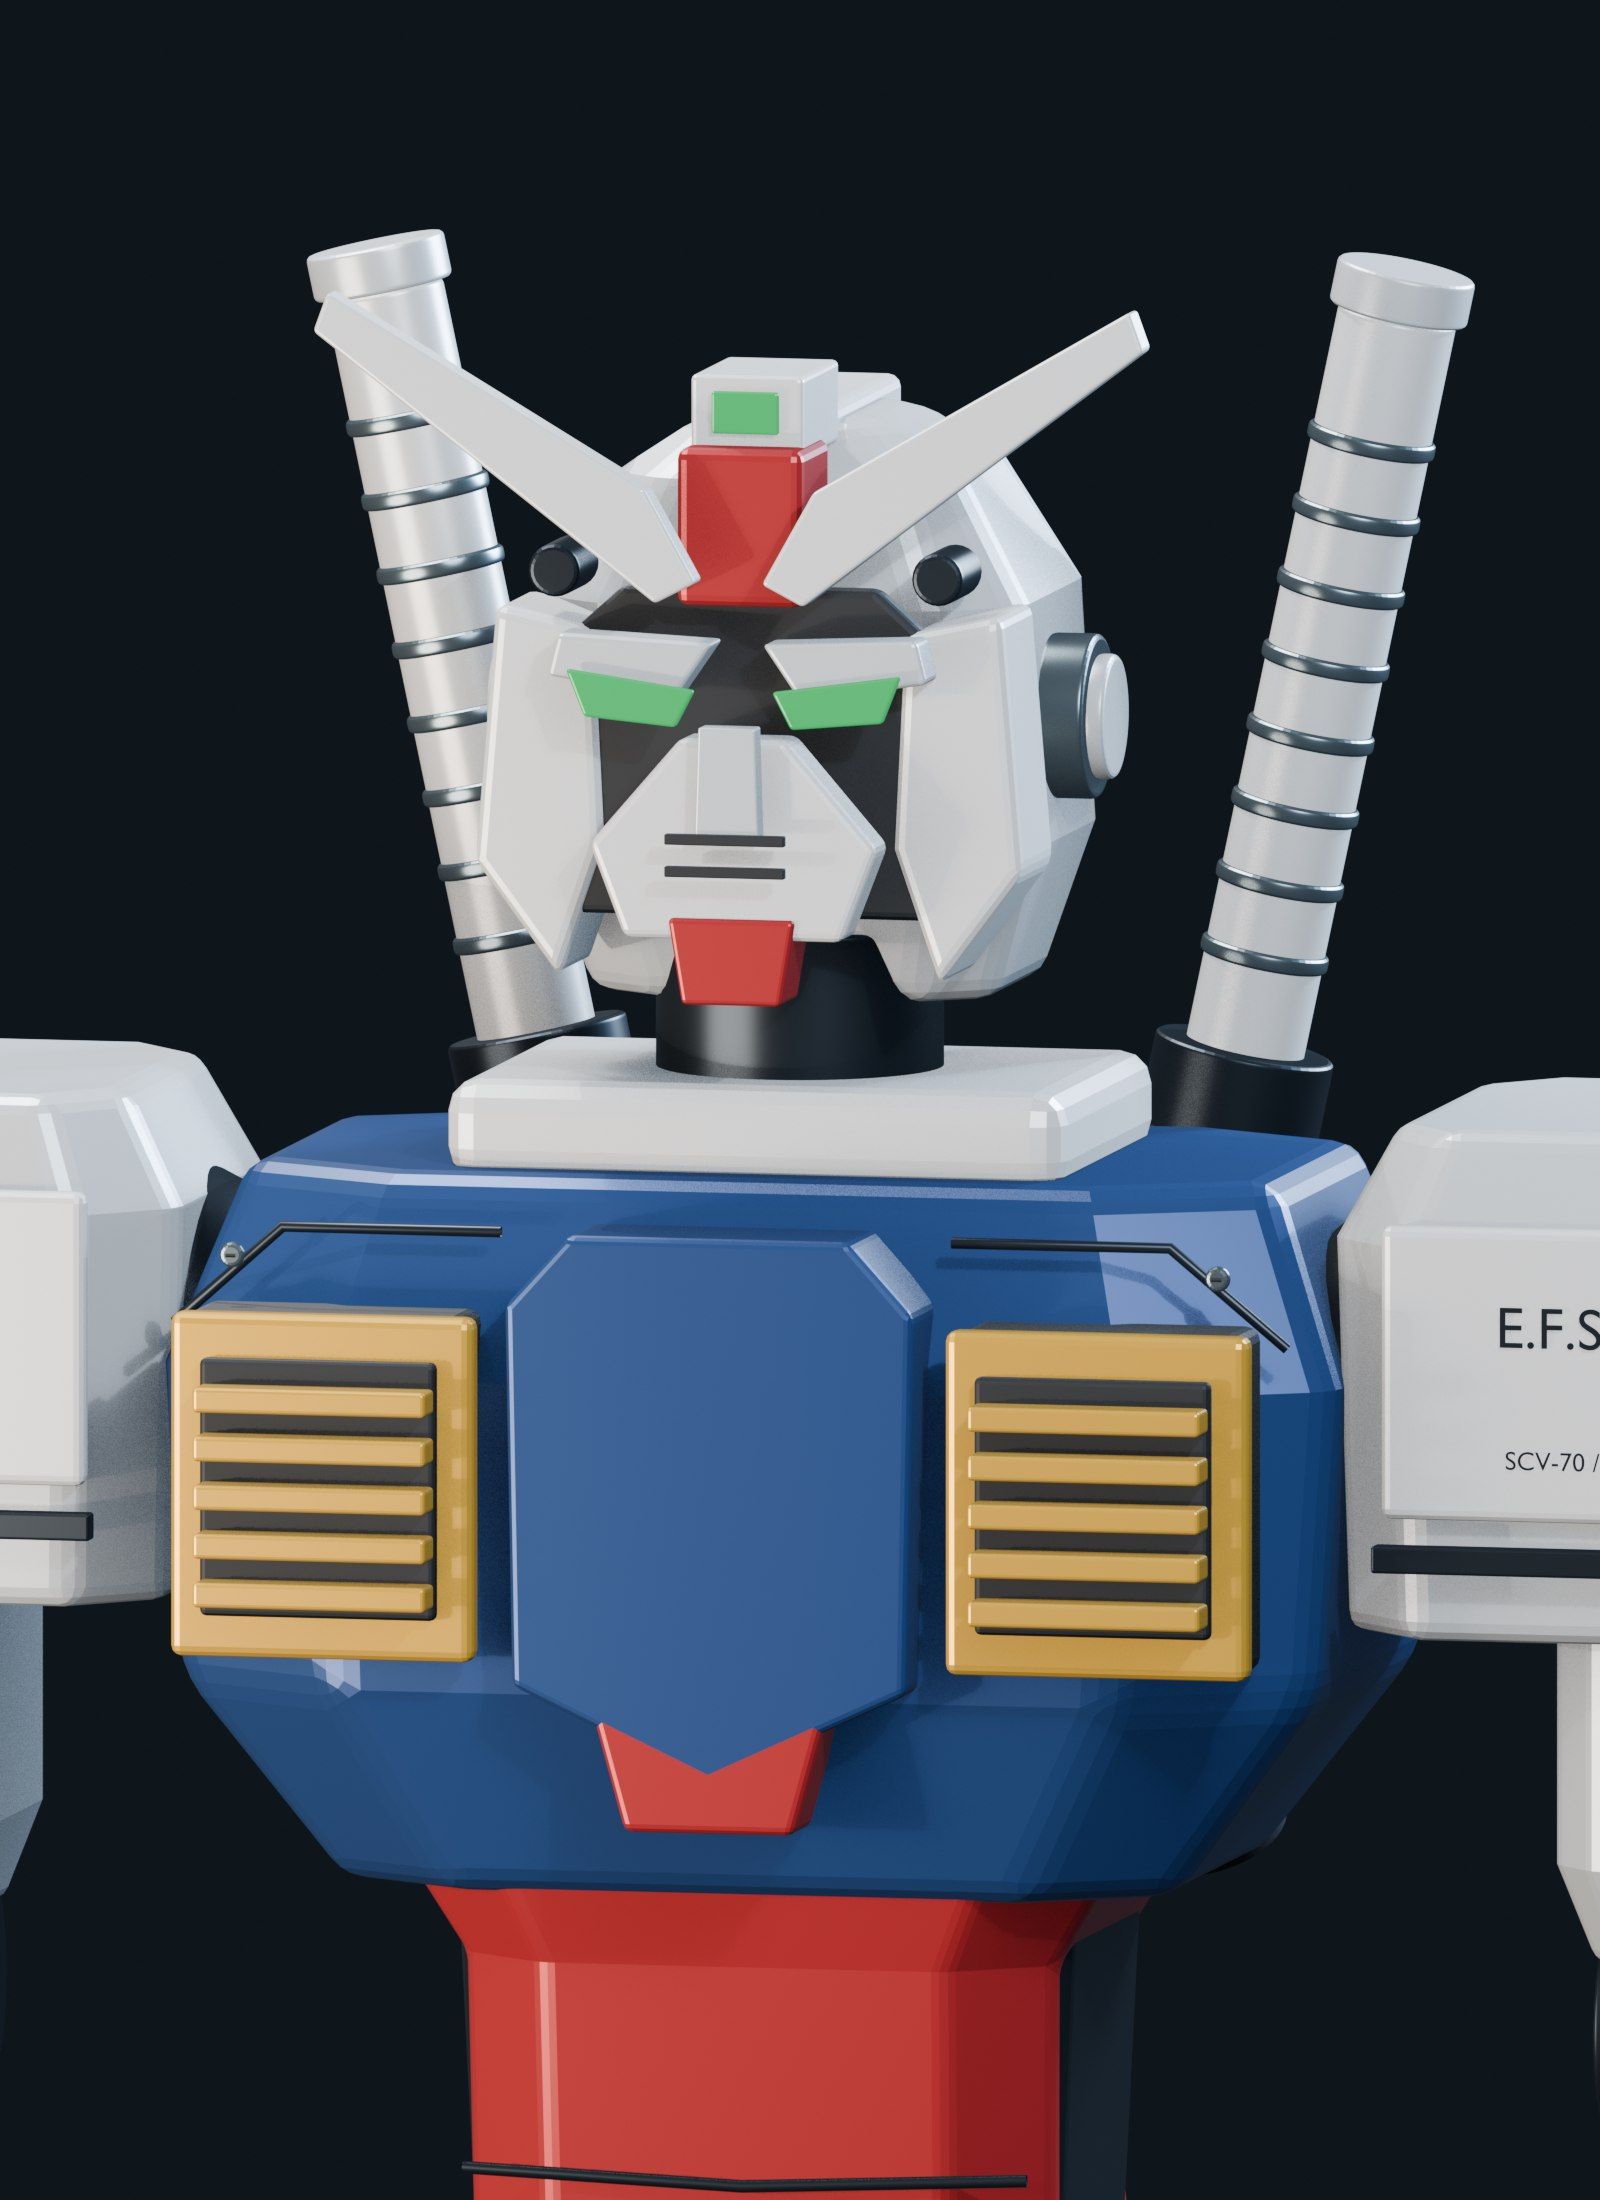
使用同一提示詞"使用three.js 生成 素體露營區 html"生成結果如下,Qwen3.8-Flash-Next-Uncensored-Q4量化確實比較強。
Qwen3.8-27B-DFlash2-Q4_K_M
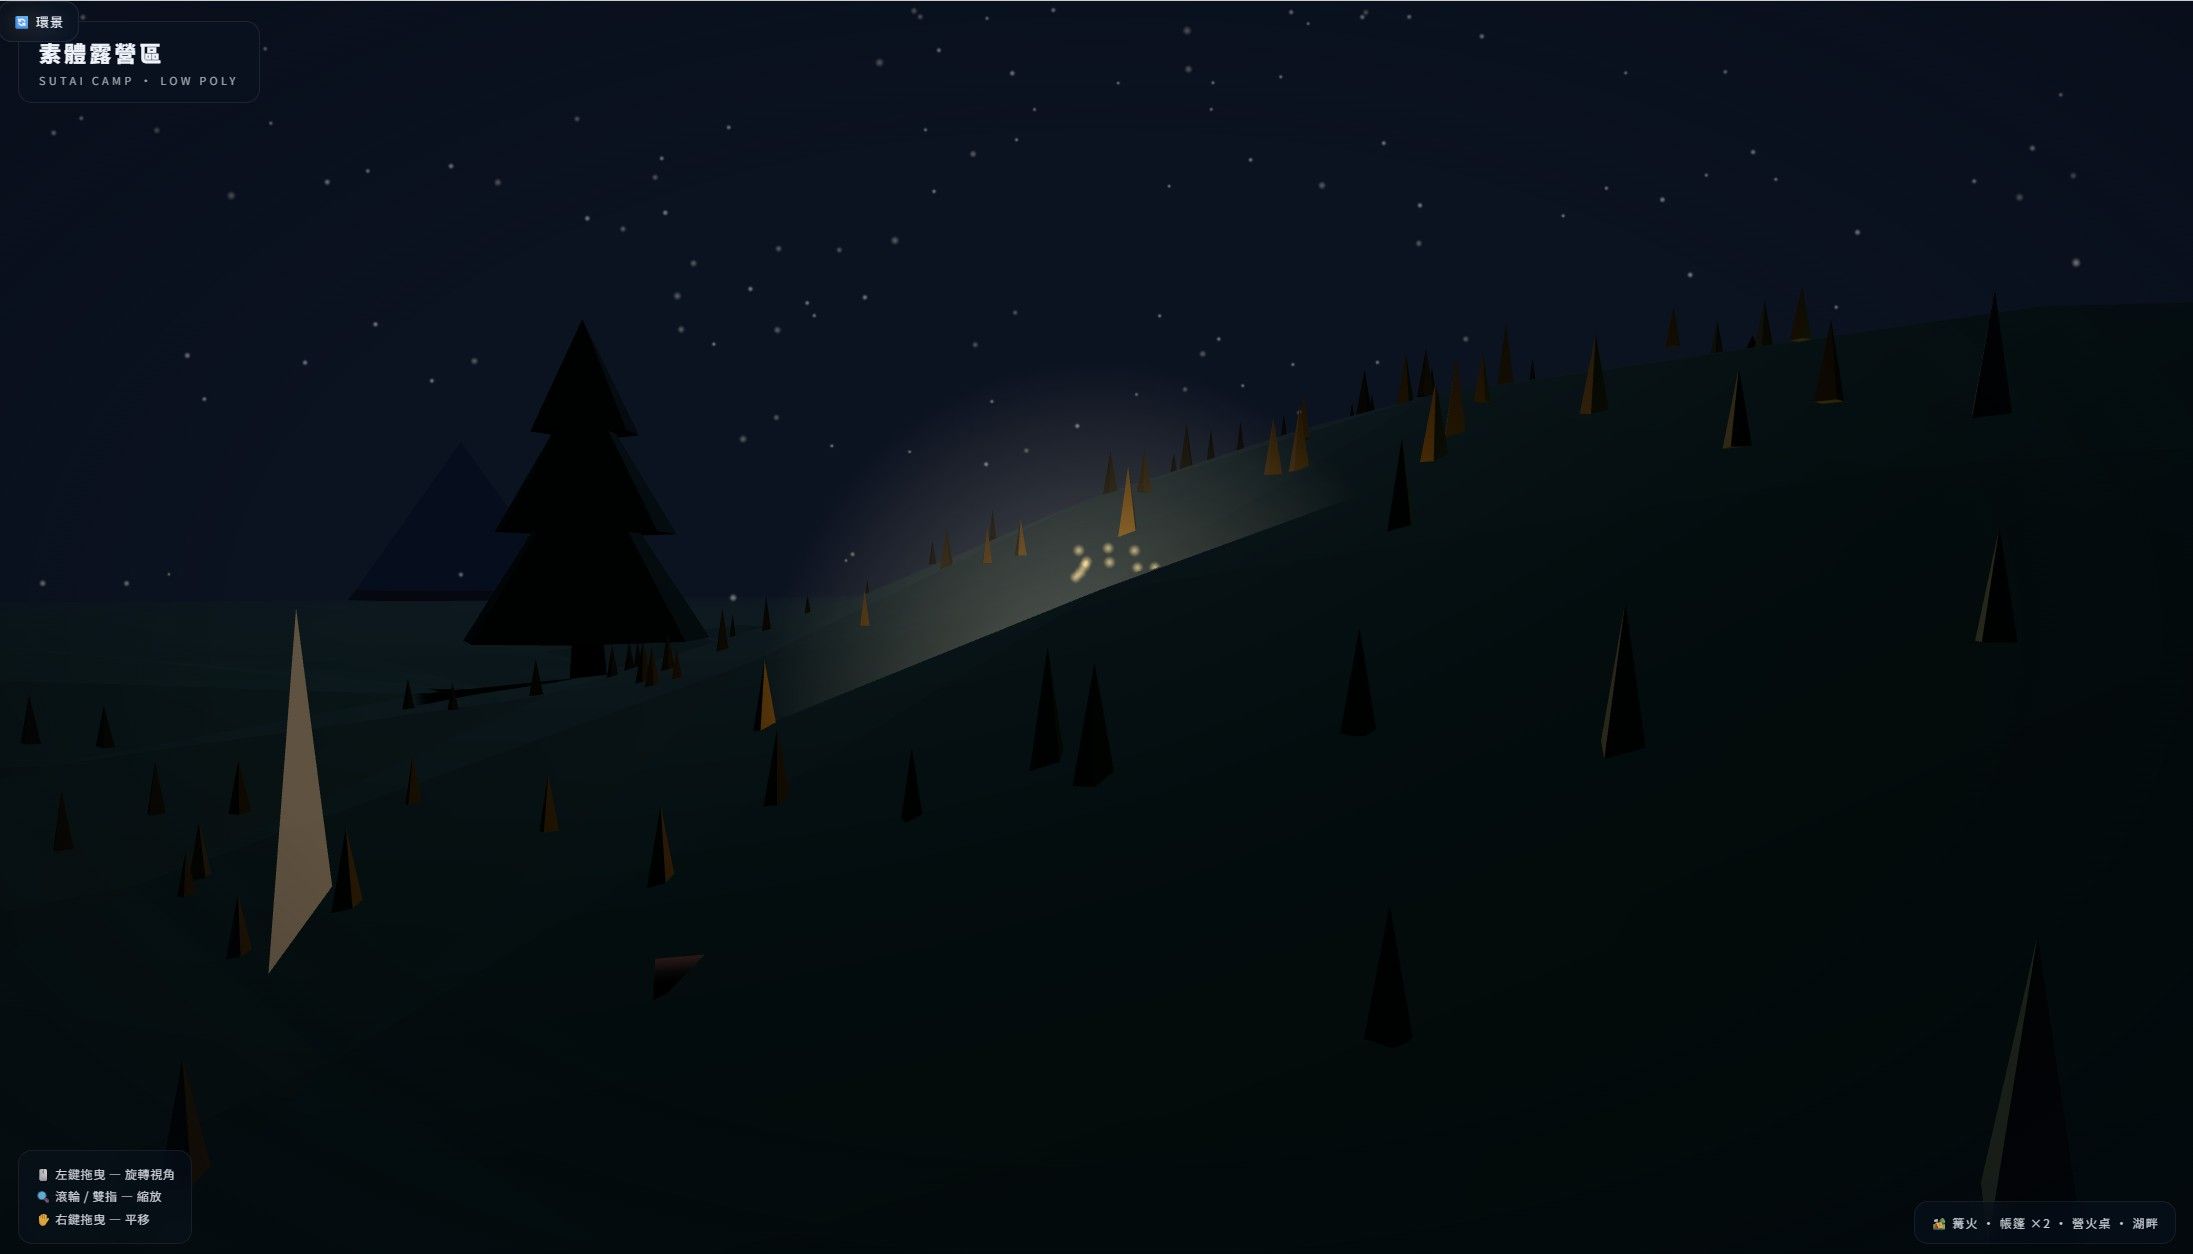
Qwen3.8-Flash-Next-Uncensored-Q4_K_S