ram 多建議用 Q5 kl,雖然速度只有30-50,但精度好不用煩惱一直返工的問題QQ
-
R9700确实还是挺强的,Strata QFN IQ3S ,基本90多,最高130 -
實測Strata改造雙卡_R9700_本地大模型架構演進與調優實錄 -
實測Strata改造雙卡_R9700_本地大模型架構演進與調優實錄 -
實測Strata改造雙卡_R9700_本地大模型架構演進與調優實錄 -
實測Strata改造雙卡_R9700_本地大模型架構演進與調優實錄一、實際硬體、作業系統與部署邊界
1. 工作站硬體配置
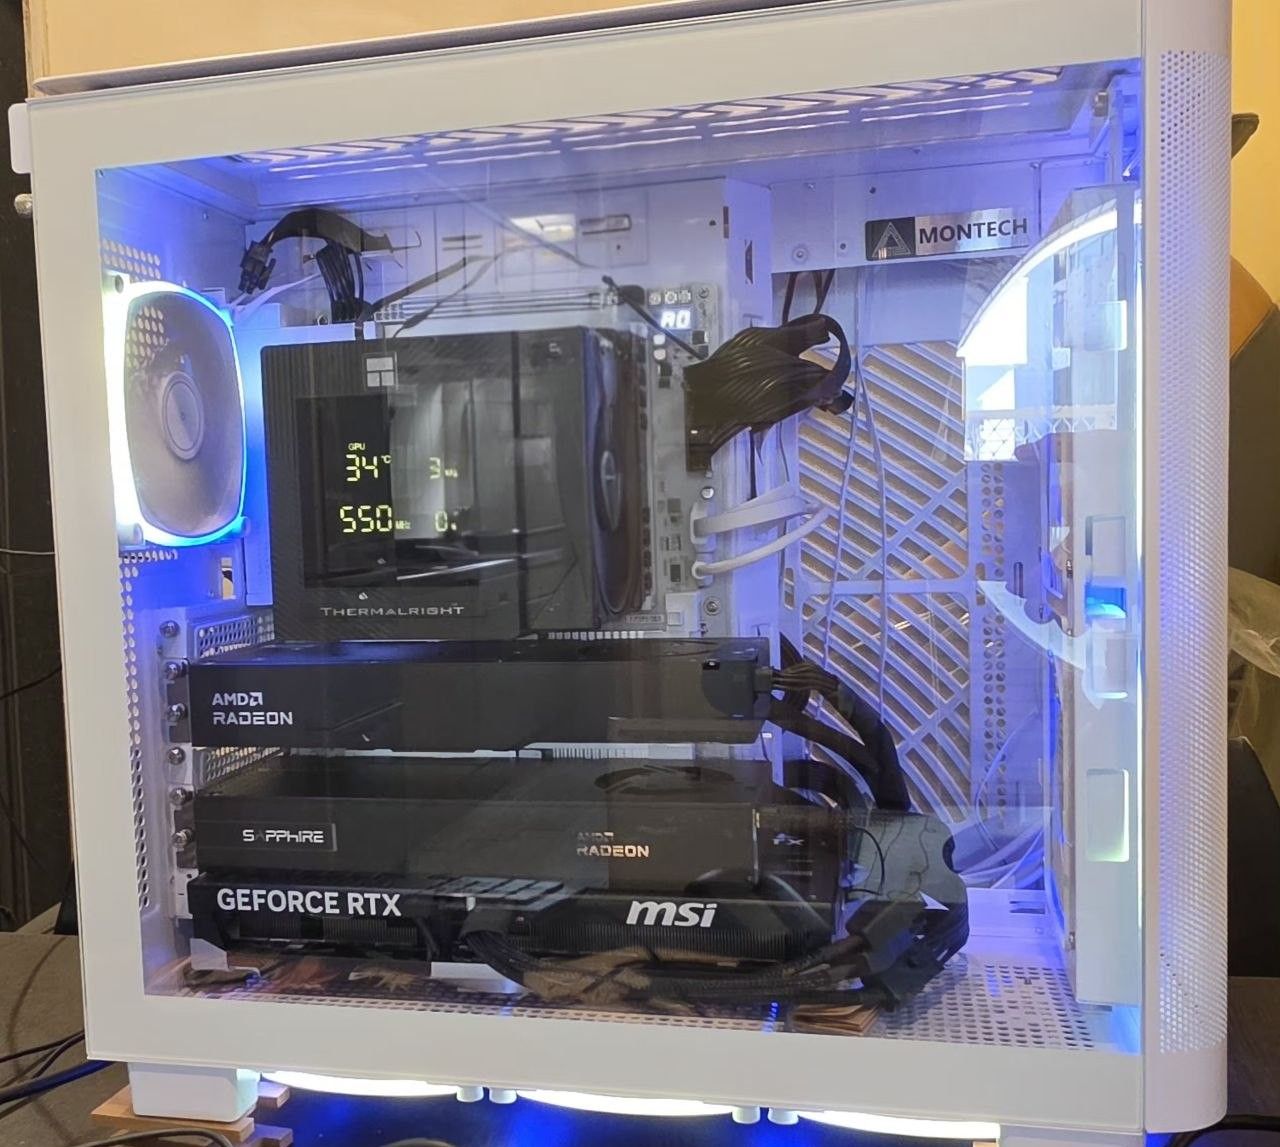
項目 本機配置 備註 CPU Intel Core Ultra 7 270K Plus 8 P-Core+16 E-Core,合計 24 核心/24 執行緒 主機板 GIGABYTE Z890 AERO G 兩個 CPU 直連顯卡插槽規格為 PCIe 5.0;雙卡安裝時採 x8/x8 分配 系統記憶體 224 GB DDR5(96 GB+128 GB 混插) 既有紀錄的實際速度約 4400 MT/s,不是以 5600 MT/s 或標稱 XMP 頻率計算 GPU 0(服務代號) AMD Radeon AI PRO R9700 32GB Strata/HIP/ROCm(gfx1201),主推論服務 Port 8080 GPU 1(服務代號) AMD Radeon AI PRO R9700 32GB llama.cpp/Vulkan,輔助服務 Port 8081;啟動參數使用 Vulkan2第三張顯卡 NVIDIA RTX 5070 Ti 16GB 用於其他獨立工作負載;未計入本文兩張 R9700 的跑分 CPU 內顯 Intel Graphics 用於 Windows 桌面顯示的配置方向 儲存裝置 SSD 4 TB+1 TB 模型及編譯資料可依實際磁碟配置分配 電源供應器 1200 W 是整機額定電源配置,不代表已經完成長時間滿載電力驗證 主要作業系統 Windows 11 64 位元 PCIe 必須分開記錄兩件事:
- 主機板設計能力:Z890 AERO G 的
PCIEX16與PCIEX8共用通道;兩張卡同時裝入時,規格為 PCIe 5.0 x8/x8。
2. 建置與調校過程的主要挑戰
- 跨卡執行同一模型的通訊成本:早期嘗試過跨雙 R9700 切層或拆分模型運算。某些配置的單路解碼表現不如預期,因此後來改採「一卡一個服務」;但原稿沒有提供完整的 Tensor Parallel 與 Layer Split 對照資料,不能據此認定所有雙卡模型並行都比單卡慢,也不能直接將差異全歸因於 All-Reduce。
- MoE 的 VRAM 容量與主記憶體存取成本:Qwen3.8-Flash-Next 這類大型 MoE 量化檔案,依量化版本可能明顯超過單張 32GB VRAM。Strata 使用 GPU 專家快取與 CPU/RAM 路徑搭配;瓶頸可能涉及 RAM 頻寬、PCIe 傳輸、專家命中率、CPU 計算及排程,須以時序資料判斷。不能把模型總參數量、GGUF 檔案大小與 VRAM 專家常駐量混為一談。
二、現行架構:兩張 R9700 各自承擔不同任務
不再預設由兩張 R9700 合力執行同一個模型,而是分別啟動推論服務,由 Hermes 或其他 Agent 呼叫端按工作性質選擇端點。
                  Hermes/Agent 呼叫端
               (按任務選擇模型與端點)
                           │
                ┌──────────┴──────────┐
                ▼                     ▼
     GPU 0/127.0.0.1:8080   GPU 1/127.0.0.1:8081
     AMD R9700 32GB          AMD R9700 32GB
     Strata v0.1.40.3        llama.cpp b11388
     Windows HIP/ROCm       Windows Vulkan
                │                     │
     Qwen3.8-Flash-Next      Qwen3.8-27B-Uncensored
     Dyluhn UD-IQ4_XS MoE    IQ4_XS 主模型
     GPU 專家快取+CPU/RAM   +DFlash2 Q4_K_M 草稿
                │                     │
     複雜推理/長任務        程式碼/摘要/任務委派
     Tool Calling            視覺輸入(需驗證 mmproj)
面向 GPU 0:主推論服務 GPU 1:輔助推論服務 主要用途 多步驟推理、工具呼叫、長文本任務 快速程式碼回覆、摘要、Agent 分工、可選視覺處理 運算引擎 Strata v0.1.40.3 llama.cpp b11388(Vulkan) 模型 Dyluhn-Qwen3.8-Flash-Next-Uncensored-UD-IQ4_XSQwen3.8-27B-Uncensored-IQ4_XS+Qwen3.8-27B-DFlash2-Q4_K_M記憶體策略 GPU 專家快取與主記憶體互補 主模型+草稿模型;目標與草稿 KV Cache 採 Q8 服務位址 127.0.0.1:8080(依實際啟動器設定)127.0.0.1:8081已有的測試依據 MoE decode/MTP/約 38.8K tokens 請求記錄 DFlash 接受率、decode、prefill 測試記錄 GPU 0 的快取配置為 21.66 GiB,監測數值顯示 9,611 個 Expert 快取條目或相關計數、命中率約 91%~95%。在未看到 Strata log 欄位定義之前,這裡不把「9,611」直接解釋成 9,611 個相異且同時完整駐留的專家模型。
**架構上的限制:**兩張 32GB R9700 並不是天然共享的單一 64GB VRAM。這套方案是兩個各自使用其 VRAM、RAM 和執行引擎的工作節點。Hermes 是否真的自動路由,仍需檢查 routing 規則或實際請求記錄;端點存在本身不代表智慧路由已驗證。
三、GPU 0:MoE 模型版本更換的生產力任務比較。
評測任務 (Task) 指標項目 Model A (IQ3_S 獨立獨佔) Model B (Dyluhn UD-IQ4_XS 獨立獨佔) 實測差異與特性分析 ① Three.js 露營區 3D 單檔 HTML<br>(生成 1024 tokens, temp=0.7) • 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) 2.52s<br>62.2 tok/s<br>59.1% (354/599)<br>19.04s 1.89s (更快  )<br>58.7 tok/s<br>58.2% (463/795)<br>19.36s
Dyluhn 首字回應更快;兩者解碼皆穩定在 ~60 tok/s 水準。 ② Python LRUCache 完整結構<br>(生成 1024 tokens, temp=0.0) • 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) 1.36s<br>80.0 tok/s<br>75.6% (605/800)<br>14.19s 1.74s<br>70.9 tok/s<br>86.0% (顯著提升  )<br>16.21s
IQ3_S 因專家槽位多 (1.18萬) 純文字速度快;但 Dyluhn 投機接受率高出 10.4%,代碼邏輯預測更精準。 ③ 道路工程結構化 JSON 萃取<br>(生成 512 tokens, temp=0.0) • 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) 1.85s<br>82.8 tok/s<br>88.3% (361/409)<br>8.04s 2.34s<br>67.9 tok/s<br>90.5% (最高 )<br>9.89s兩者均 100% 正確萃取 JSON 結構;Dyluhn 投機接受率突破 90% 大關。 ④ 中文公文函稿撰寫<br>(生成 1024 tokens, temp=0.7) • 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 投機接受率 (MTP)<br>• 壁鐘耗時 (Wall Time) 1.60s<br>73.0 tok/s<br>65.7% (497/757)<br>15.66s 1.94s<br>60.9 tok/s<br>62.8% (505/804)<br>18.80s 兩者皆流暢產出千字長文公文,正體用語扎實。 ⑤ Hermes Agent Tool-Call 巡檢<br>(max 256 tokens, temp=0.0) • 首字延遲 (TTFT)<br>• 解碼速度 (Decode)<br>• 消耗 Token<br>• 工具調用判定 1.88s<br>71.3 tok/s<br>256 tok (用罄截斷)<br>  FAIL (思考溢出未成調用)
2.47s<br>51.6 tok/s<br>105 tok (精準收斂)<br>  PASS (成功輸出 XML)
【致命分水嶺】<br>IQ3_S 思考標籤漫遊,256 tokens 耗盡仍無 <tool_call>;Dyluhn 4.5秒精準輸出標準 XML 標籤!全任務平均解碼速度 - ~73.9 tok/s ~62.0 tok/s -
四、GPU 1:llama.cpp Vulkan+DFlash2 調校結果
GPU 1 使用 Qwen3.8-27B-Uncensored IQ4_XS 主模型+DFlash2 Q4_K_M 草稿模型,原始紀錄的執行檔為
llama-server b11388。以下數據保留原稿,並把各指標分開看待。1. 配置比較
組別 測試變更 Short Code (tok/s) Decode 512 tok (tok/s) DFlash 接受率 Prefill 4K (tok/s) Prefill 25.8K (tok/s) 原稿 Hash/觀察 G1-0 b11388;draft n-max 6;Q8 目標 KV;停用 graph optimize 190.6 74.94 49.9% 832.0 780.0 33f09658;基準G1-1a 改用 b10780 71.2 30.95 59.5% 666.2 602.5 a9da36ea;退步G1-1b 改用 b10751 80.3 31.88 59.5% 677.1 603.8 a9da36ea;退步G1-2 b11388;草稿 K/V KV 改用 Q8 188.6 75.60 50.4% 821.4 774.8 33f09658;草稿 KV 節省G1-3a draft n-max 改為 4 188.1 72.54 50.0% 821.7 775.9 33f09658G1-3b draft n-max 設為 6 188.6 75.60 50.4% 821.4 774.8 33f09658;均衡配置G1-3c draft n-max 改為 8 187.5 72.88 45.0% 819.8 775.3 38c9a247G1-4 移除 GGML_VK_DISABLE_GRAPH_OPTIMIZE196.2 76.69 52.1% 702.9 770.0 a5f37019;原稿三次輸出一致G1-5 目標模型 V KV 改為 Q4 188.9 71.07 40.4% 787.3 700.7 b6e3f98d2. 技術判讀與取捨
(1)新舊 llama.cpp 版本的表現
R9700/Vulkan 工作負載中,b11388 的
Decode 512為 74.94 tok/s,b10780 為 30.95 tok/s,b10751 為 31.88 tok/s。因此這台機器的這組配置不適合直接套用降版建議。(2)草稿 KV 量化有益,但不是整體 VRAM 減半
加入
-ctkd q8_0 -ctvd q8_0,是把草稿模型的 K/V KV Cache 由預設 F16 路徑改為 Q8;依資料型別的每元素儲存開銷,草稿 KV 容量可接近減半(仍有量化區塊開銷),不是整張顯卡顯存用量或整個模型占用減半。原稿 G1-0 → G1-2 的Decode 512是 74.94 → 75.60 tok/s,屬小幅改善。(3)n-max = 6 在這組測試較均衡
草稿窗口 4、6、8 的
Decode 512分別為 72.54、75.60、72.88 tok/s;故暫保留--spec-draft-n-max 6。Hash 改變只表示輸出不同,不等於答案必然錯誤;若要比較答案品質,還須固定 seed、取樣設定與評分方法。(4)開啟 Vulkan graph optimization 的確改善 decode,但犧牲部分 prefill
G1-4 的
Decode 51276.69 tok/s 是原稿最高,Short Code 也達 196.2 tok/s;然而 G1-4 的 4K Prefill 為 702.9 tok/s,低於 G1-2 的 821.4 tok/s(約 -14.4%),25.8K Prefill 則為 770.0,略低於 G1-2 的 774.8。因此,不應寫成「移除禁用 graph optimize 後所有指標全面提升」。若以長輸出解碼為主,G1-4 可以優先;若頻繁送入 4K 新提示詞,G1-2/G1-3b 可能更適合。
(5)目標模型 V KV 改成 Q4 的測試未帶來速度優勢
G1-5 的
Decode 512為 71.07 tok/s、DFlash 接受率 40.4%,低於 G1-4。這能支持「目前測試不採用此設定」,但不能單憑速度下降就認定唯一原因一定是反量化計算。
五、GPU 0:Strata MoE、MTP 與排程參數比較
GPU 0 的 Strata v0.1.40.3 以較大的 GPU 專家快取服務 MoE 模型,原稿觀察到約 91%~95% 的專家快取命中率。對於 CPU/RAM 與 PCIe 同時參與的路徑,以下數字有參考價值,但仍需搭配完整 profiling 判斷瓶頸。
1. 原始測試結果
組別 參數配置 Greedy Decode (tok/s) Greedy MTP 接受率 Sampled Decode (tok/s) Sampled MTP 接受率 判讀 G0-0 預設; --pool-workers 7;預設 tasks60.3 85.0% 50.4 73.53% 基準 G0-1a STRATA_SPEC_COUPLED=166.6 85.0% 54.0 60.49% Greedy、Sampled 均較基準快 G0-1b Coupled+Gumbel 66.3 85.0% 55.3 62.08% Sampled 進一步提升 G0-2 啟用 decode timing 診斷 62.3 85.0% 48.3 67.56% 診斷模式;不作正式效能排名 G0-3a --pool-tasks 64+Coupled+Gumbel65.7 85.0% 56.1 69.57% Greedy/Sampled 綜合取捨較均衡 G0-3b --pool-tasks 96+雙加速60.5 87.0% 55.0 61.94% Greedy 較弱 G0-3c --pool-tasks 128+雙加速59.7 76.6% 60.5 64.69% Sampled 單項最高,但 Greedy 較弱 2. 調校結論
- Greedy 單項最高:G0-1a 的 66.6 tok/s。
- Sampled 單項最高:G0-3c 的 60.5 tok/s。
- 兩種工作負載均衡:G0-3a 的 Greedy 65.7 tok/s 與 Sampled 56.1 tok/s;相對基準 Sampled 50.4 tok/s,約增加 11.3%。若主力是日常混合 Agent 工作,暫選
--pool-tasks 64有依據。 --pool-workers 7代表 Strata 設定的工作執行緒/worker 數量,不代表 CPU 只有 7 顆 P-Core。本機 CPU 實際具有 8 P-Core+16 E-Core;--pool-affinity p-cores的綁定效果須用執行緒親和性/實際 CPU 使用情形確認。
3. 時序診斷與 PCIe 瓶頸
原稿記錄
STRATA_DECODE_TIMING=1下 361 個解碼窗口的部分統計:GPU Wait Time:15.86 msCPU Pool Time:4.65 ms- 原稿的
pcie_frac設定/讀值:0.55;另提到 26.1 GB/s,但未附頻寬計數器與測量定義。
現階段建議:把
pcie_frac=0.55當成原始基準,不急著調高;同時在固定負載下比較 PCIe 實際傳輸量、專家 cache hit/miss、CPU per-core 使用率、GPU idle/wait、單次 token latency。若要調pcie_frac,用相同 prompt 逐項比對,避免依單一計時器做過度推論。六、記載的推論啟動配置
這是配置記錄,不是已於本次連入主機驗證可直接執行的腳本。
1. GPU 1:Qwen3.8-27B IQ4_XS+DFlash2(Port 8081)
"C:\llama.cpp-b11388-vulkan\llama-server.exe" ^
--device Vulkan2 ^
-m "D:\LLM\Qwen3.8-27B-Uncensored\Qwen3.8-27B-Uncensored-IQ4_XS.gguf" ^
--mmproj "D:\LLM\Qwen3.8-27B-Uncensored\Qwen3.8-27B-Uncensored-vision-f16.gguf" ^
--spec-draft-model "D:\LLM\Qwen3.8-27B-Uncensored\Qwen3.8-27B-DFlash2-Q4_K_M.gguf" ^
--spec-draft-device Vulkan2 ^
--spec-draft-ngl 999 ^
--spec-draft-n-max 6 ^
--spec-draft-p-min 0 ^
--spec-type draft-dflash ^
-c 131072 ^
-np 1 ^
-ngl 999 ^
-fa on ^
-ctk q8_0 ^
-ctv q8_0 ^
-ctkd q8_0 ^
-ctvd q8_0 ^
-b 2048 ^
-ub 1024 ^
--alias Qwen3.8-27B-Uncensored,Qwen3.8-27B ^
--host 127.0.0.1 ^
--port 8081 ^
--jinjaendlocal
### 2. GPU 0:Strata MoE(Port 8080)

```json
{
  "engine": "strata",
  "model_path": "D:\\LLM\\Dyluhn-Qwen3.8-Flash-Next-Uncensored-UD-IQ4_XS",
  "args": [
    "--kv", "int8",
    "--kv-resident", "32768",
    "--expert-cache", "auto",
    "--pool-workers", "7",
    "--pool-affinity", "p-cores",
    "--pool-tasks", "64"
  ],
  "env": {
    "STRATA_PREFILL_MMQ": "1",
    "STRATA_HIP_WMMA": "1",
    "STRATA_SELECT_WMMA": "1",
    "STRATA_HIPBLASLT_TUNING": "D:\\LLM\\Strata-Orca-Q4\\Strata\\tools\\hip\\gfx1201-hipblaslt-100500.txt",
    "STRATA_SH_STREAM": "0",
    "STRATA_SPEC_COUPLED": "1",
    "STRATA_SPEC_GUMBEL": "1"
  }
}
官方技術規格與參數參考
- Intel:Core Ultra 7 270K Plus 官方規格(8 P-Core+16 E-Core)
https://www.intel.com/content/www/us/en/products/sku/245692/intel-core-ultra-7-processor-270k-plus-36m-cache-up-to-5-50-ghz/specifications.html - GIGABYTE:Z890 AERO G 規格(PCIEX16 與 PCIEX8 共用通道,雙卡 x8/x8)
https://www.gigabyte.com/eu/Motherboard/Z890-AERO-G/sp - AMD:Radeon AI PRO R9700 規格(RDNA 4、32GB GDDR6、PCIe 5.0 x16)
https://www.amd.com/en/products/graphics/workstations/radeon-ai-pro/ai-9000-series/amd-radeon-ai-pro-r9700.html - llama.cpp:
llama-server參數與 speculative decoding 官方文件
https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md - Windows WHEA 17 範例(PCIe Root Port/Corrected Hardware Error)
https://learn.microsoft.com/en-gb/answers/questions/5783344/how-to-fix-whea-logger-event-17
實測
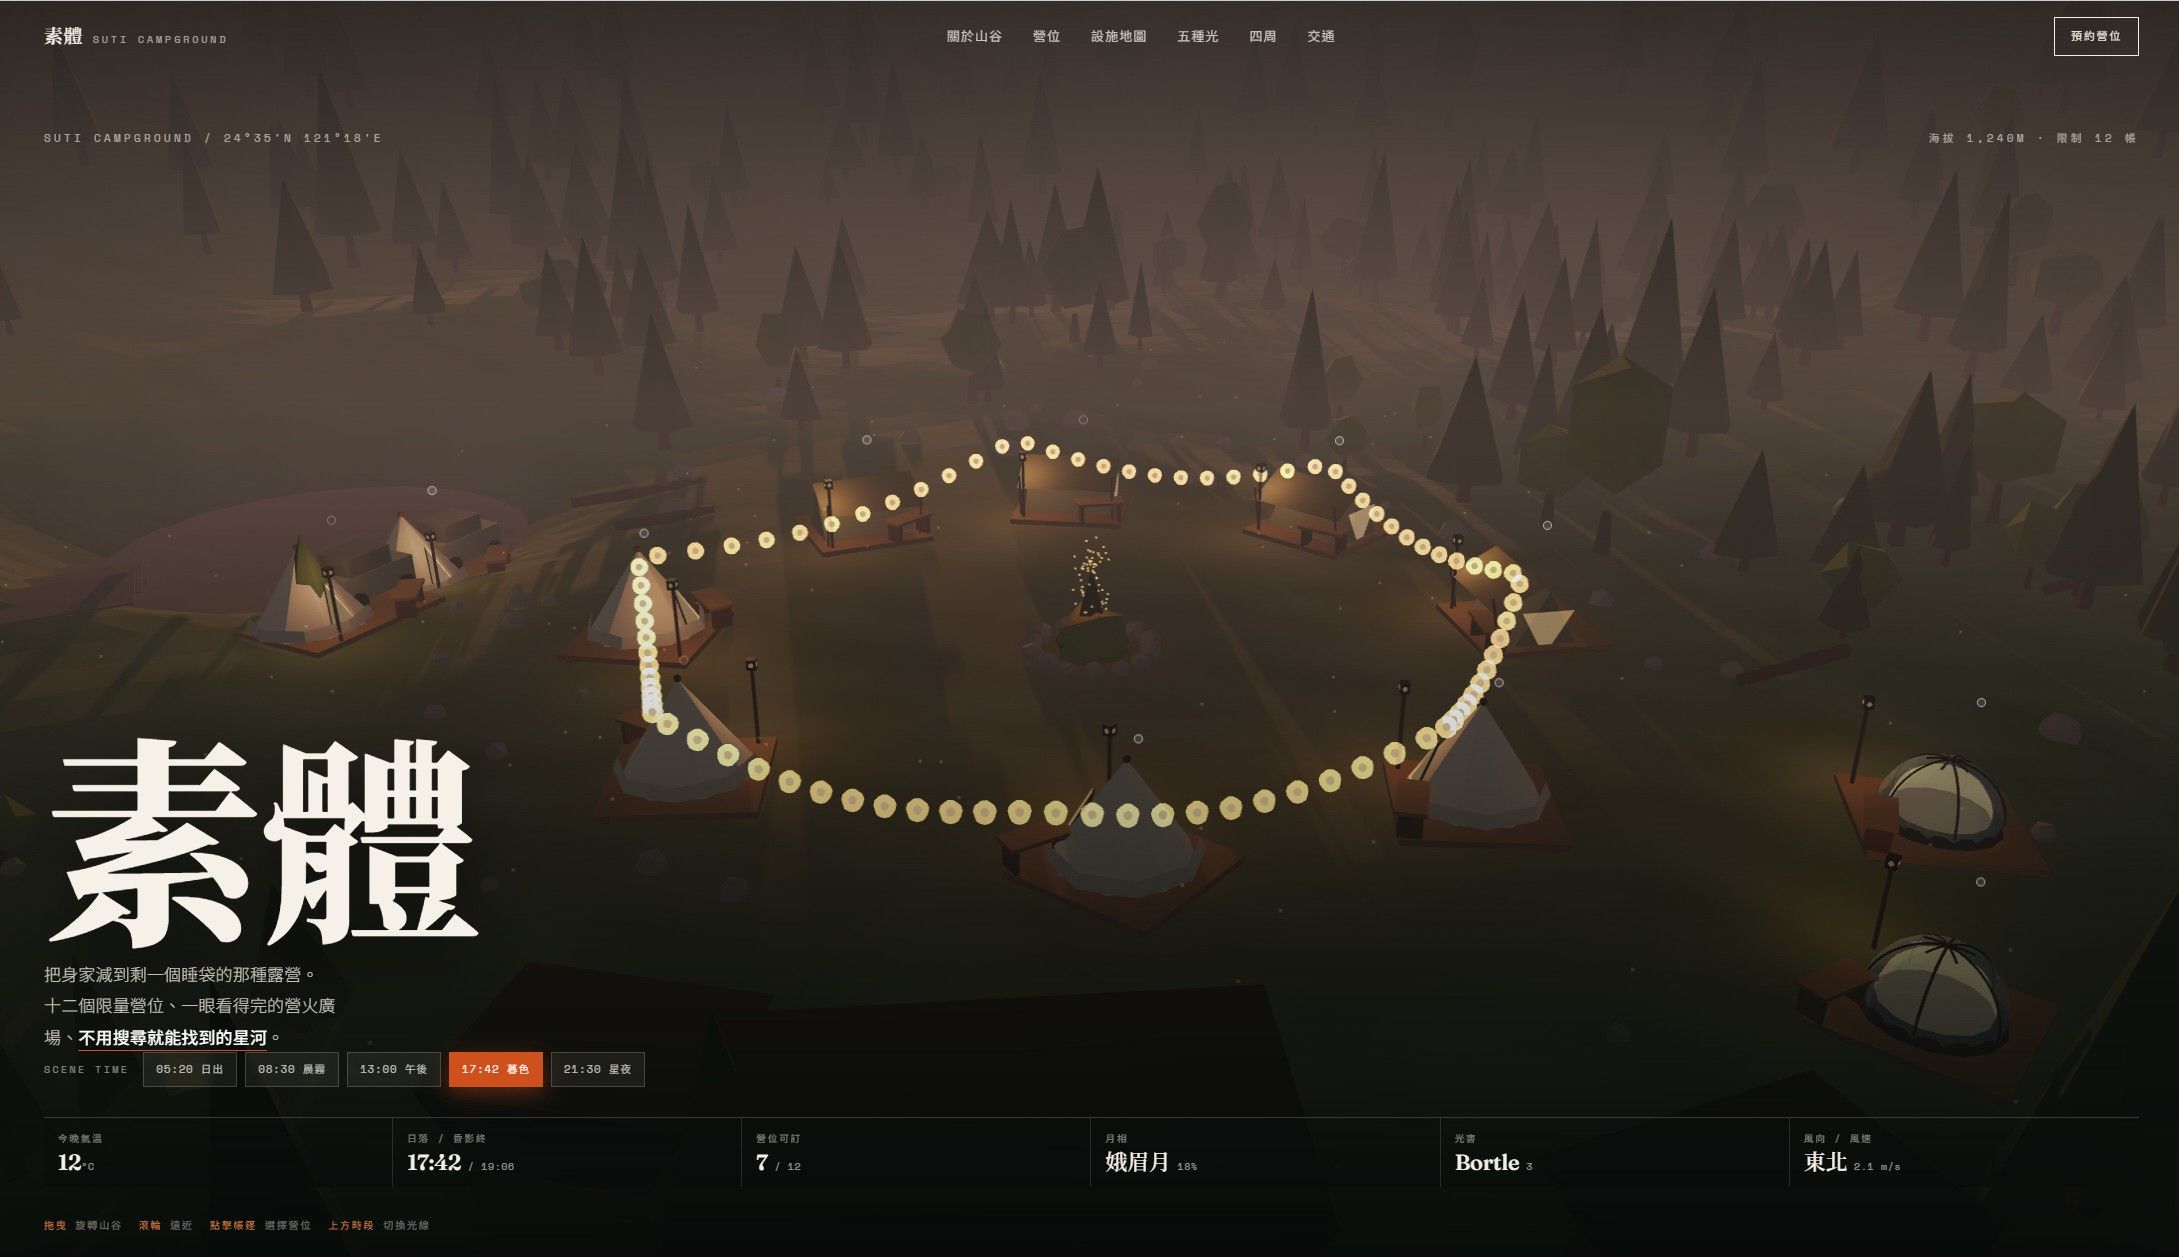
使用同一提示詞"使用three.js 生成 素體露營區 html"生成結果如下,Qwen3.8-Flash-Next-Uncensored-Q4量化確實比較強。
Qwen3.8-27B-DFlash2-Q4_K_M
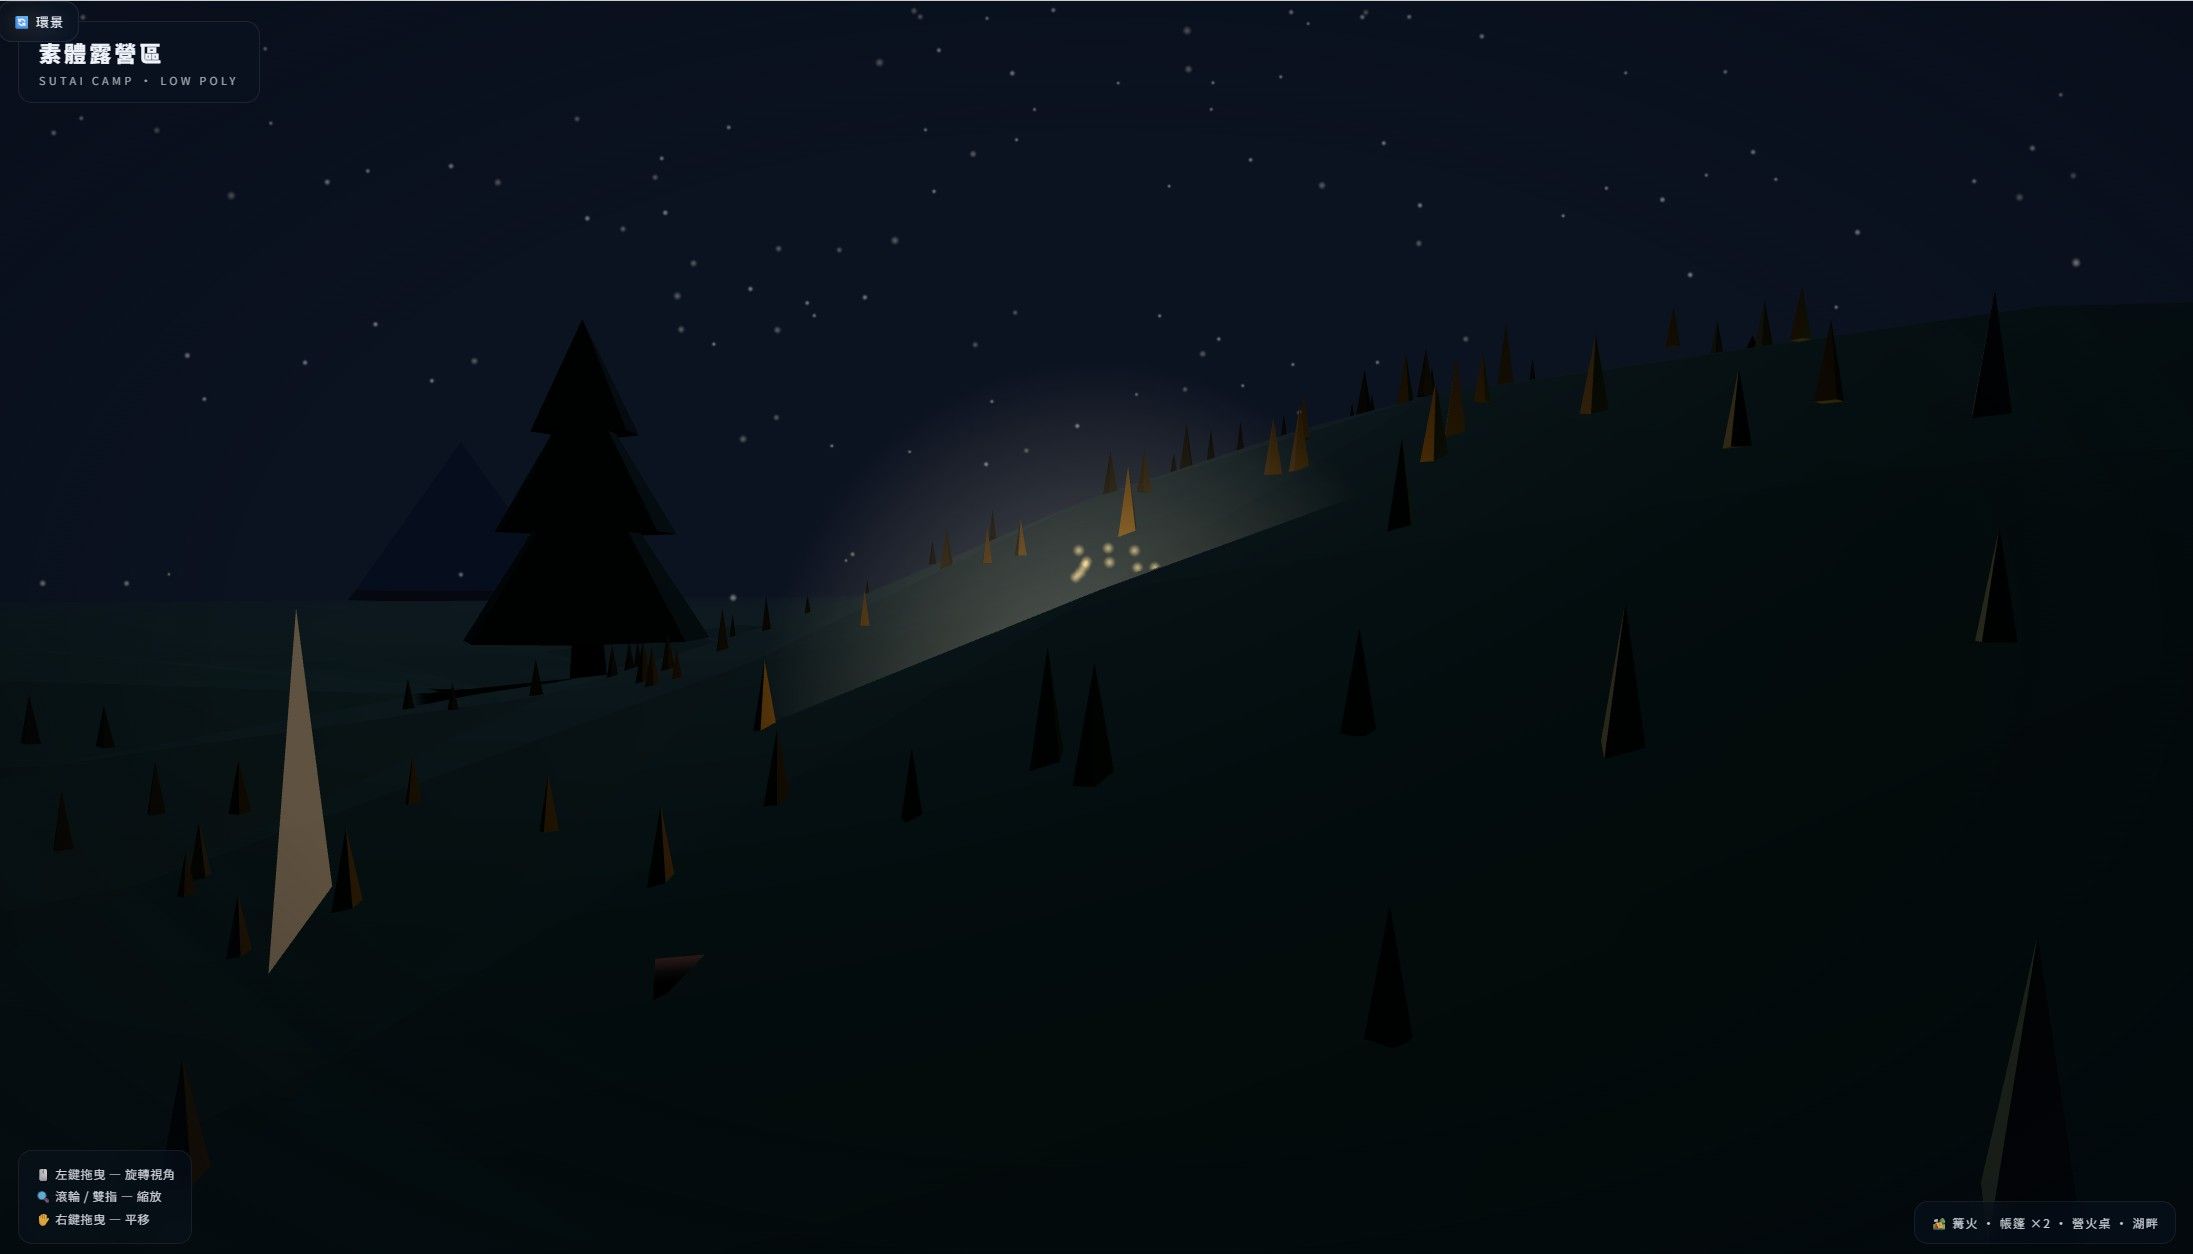
Qwen3.8-Flash-Next-Uncensored-Q4_K_S
- 主機板設計能力:Z890 AERO G 的
-
不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了! -
4卡r9700应该选择 WRX90E-SAGE 还是 MU72-SU0 主板?影片來源
- 影片連結:http://www.youtube.com/watch?v=UyEbXIQZvnY
- 頻道名稱:Alex Grankin
- 影片標題:M5 Ultra Is Out — Let's See How Good It Is for Local AI
硬體規格數據 [01:05]
- CPU 核心數量:36 核心
- GPU 核心數量:80 核心
- 記憶體頻寬:1.2 TB/s(1,200 GB/s),對比 M3 Ultra 增長 50%,達 M5 Max 之 2 倍 [01:05]
- 統一記憶體規格:96 GB 至 512 GB(512 GB 版本上市時程為 10 月)[01:16]
- 評測機型配置:256 GB 統一記憶體、4 TB 儲存空間,售價標示 12,000 至 13,000 美元 [02:07]
本地語言模型生成速度(Writing Speed)[02:45]
說明:生成速度取決於記憶體頻寬,衡量指標為每秒 Token 數量(tokens/s)。
測試模型:Qwen 3.8 27B(4-bit)[03:50]
硬體晶片 輸出速度(tokens/s) 備註說明 RTX 5090 60 獨立顯示卡數據 [05:11] M5 Ultra 46 至 54(平均值 48) 速度超越 M3 Ultra 達 50% 至 100% [04:16] M5 Max 30 效能等同 M3 Ultra [04:46] M3 Ultra 30 前代晶片數據 [04:46] M4 Max 23 筆電晶片數據 [04:46] M6 Mac Mini 10 入門機型數據 [04:46] 六邊形生成任務測試(16,500 Token 總輸出量)[06:25]:
- RTX 5090:耗時 5.0 分鐘
- M5 Ultra:耗時 5.7 分鐘
- M5 Max / M3 Ultra:耗時 9.0 分鐘
- M6 Mac Mini:耗時 28.0 分鐘
提示詞讀取處理速度(Reading Speed)[07:19]
說明:讀取處理速度取決於 GPU 運算核心效能與神經網路加速單元,與記憶體頻寬關聯度低。
對比 M3 Ultra 讀取效能增長 [08:03]:
- 各項模型讀取速度提升幅度介於 2 倍至 4 倍。
32,000 Token 上下文讀取耗時 [08:36]:
- M5 Ultra:耗時 19 秒
- M5 Max:耗時 39 秒
- M3 Ultra:耗時 77 秒
首字生成延遲時間(Time to First Token, TTFT)[10:18]:
- 8,000 Token 上下文:耗時 10 秒 [10:26]
- 32,000 Token 上下文:耗時 42 秒 [10:26]
- 256,000 Token 上下文:M5 Ultra 耗時 100 秒,M3 Ultra 耗時 250 秒 [11:06]
上下文視窗(Context Window)對輸出速度之影響 [12:19]
說明:擴展上下文長度增加記憶體佔用量,導致寫入速度下降。
M5 Ultra 執行 Qwen 3.8 27B 速度變化(MLX 架構)[12:29]:
- 8,000 上下文:48 tokens/s
- 64,000 上下文:39 tokens/s
- 128,000 上下文:32 tokens/s
- 256,000 上下文:24 tokens/s
- 上下文由 8,000 擴展至 256,000,速度衰退幅度達 50% [12:58]
GGUF 格式在 128,000 上下文環境表現 [13:52]:
- M5 Ultra:30 tokens/s
- M4 Max:8 至 9 tokens/s
- DGX Spark:8 至 9 tokens/s
特定模型實測表現 [14:30]
- Qwen 3.8 Flash Next:架構優化帶來高速運算,輸出速度達 91 至 100 tokens/s [14:36]
- GLM 5.3 Flash:256 GB 記憶體機型支援上限為 128,000 上下文(速度 32 tokens/s);256,000 上下文導致記憶體耗盡(OOM)限制 [14:44]
硬體選購建議與定位分析 [16:21]
- M5 Ultra 與 RTX 5090 比較 [16:53]:RTX 5090 具備速度優勢(60 tokens/s 對比 48 tokens/s)。組裝多張 RTX 5090 達成 256 GB 記憶體規格需要承擔高額設備花費、電力負擔、散熱負擔與運轉噪音;M5 Ultra 具備高容量統一記憶體與靜音運作優勢。
- M5 Ultra(96 GB)與 M5 Max(128 GB)比較 [17:36]:M5 Ultra 具備頻寬與提示詞處理速度優勢。模型記憶體需求低於 96 GB 之情境,M5 Ultra 效能表現超越 M5 Max。
- M6 Mac Mini 定位評估 [20:05]:記憶體容量上限為 32 GB,生成速度為 10 tokens/s,缺乏本地大型模型執行效益,排除於 AI 採購清單。
- 本地部署與雲端 API 成本對比 [18:37]:M5 Ultra 頂規購買金額等同多年 Claude 或 OpenAI 雲端服務訂閱費用;本地設備核心價值在於資料隱私掌控。
-
4卡r9700应该选择 WRX90E-SAGE 还是 MU72-SU0 主板? -
我普通人的算力需求 病态@applejuice 3090不差啊~R9700換上去應該沒啥感覺~
-
NVIDIA 4卡異構 挑戰 Exllamav3 + Qwen3.8-Flash-Next 130k 上下文+MTP -
双 R9700 + 32G RAM 跑 83.8GB 的 Qwen3.8-Flash-Next:ROCm RDNA4 融合算子 + 共享 MTP 投机解码,144K 深度 decode 破 72 tok/s,双卡零 GTT 溢出一、 64K 全冷啟動預填(Cold Prefill,從零載入 6.5 萬字)
當第一次一口氣塞入完整 65,025 個 Tokens(純冷啟動,KV Cache 命中率 0%)時:
64K Prefill 預填吞吐率(PP):1,104.7 tok/s
首字延遲(TTFT,Time To First Token):58.862 秒(約 58.8 秒完成全量 6.5 萬字的注意力與專家前向運算並吐出第 1 個 Token)
預填完畢後的生成速度(TG):54.50 tok/s二、 多輪對話熱前綴(Warm Cache Prefill,如 Hermes Agent 實機)
在 Hermes 智慧體或連續對話中,由於開啟了前綴快取機制(LCP Prompt Cache,命中率高達 99.4% 以上):歷史 62K~64K 上下文:100% 命中顯存 KV Cache,完全免重新計算(0 秒開銷)。
新輸入的 Query / 工具回傳(約 400 餘字):
增量預填耗時:僅約 1.14 秒(實測 423 tokens / 1,145 ms,換算增量吞吐為 369.13 tok/s)。
體感首字延遲:直接從 58 秒驟降到 1.1 秒 左右! -
双 R9700 + 32G RAM 跑 83.8GB 的 Qwen3.8-Flash-Next:ROCm RDNA4 融合算子 + 共享 MTP 投机解码,144K 深度 decode 破 72 tok/s,双卡零 GTT 溢出@hong-chen 我覺得還是有差,寫個2048遊戲就很明顯了
2048qwen38 27BQ4.html
2048qwen3.8flashQ3.html -
双 R9700 + 32G RAM 跑 83.8GB 的 Qwen3.8-Flash-Next:ROCm RDNA4 融合算子 + 共享 MTP 投机解码,144K 深度 decode 破 72 tok/s,双卡零 GTT 溢出 -
两张R9700 32GB和一张4090 48G魔改卡,哪个更适合本地普通消费者。 -
新手贴:配置32G内存+5060TI 16G跑Huihui-Qwen3.8-27B-abliterated-GSQ-RCO-IQ3_S-mtp,在40上下tokens/s。 -
神秘union-alpha與blender鋼彈擦出火花@imbiplaza-ASUS 有這種事情!!!我以為都是接入blender mcp刻出來的@@
-
神秘union-alpha與blender鋼彈擦出火花神秘union-alpha與blender鋼彈擦出火花
2026-09-17 · Hermes Agent × Union Alpha × Blender MCP 工作紀錄
一、接上神秘模型:stealth/union-alpha
老板在 OpenRouter 發現一個未公開出品方的 stealth 模型
stealth/union-alpha,要把它接進 Hermes 當主腦。接線過程
項目 內容 模型 ID stealth/union-alpha(Stealth 出品,Union Alpha)Context 262,144 tokens(256K) 費用 實測 $0(免費) API key 沿用既有 ${OPENROUTER_API_KEY}環境變數,明文 key 不落 config設定位置 ~/.hermes/profiles/main/config.yaml→custom_providers新增stealth條目踩過的坑
- 配置寫入被工具層拒絕:
custom_providers長在 profile 層的config.yaml(不是根層 config),改檔先備份config.yaml.bak_union,再用 Python 精準插入 YAML 區塊。 - Gateway 快取舊配置:改完必須
taskkill /F殺 gateway 進程重啟,新配置才會進記憶體。 - 驗證方式:實呼一次 OpenRouter chat/completions 確認模型在線 + cost=0,再確認 gateway 重啟後模型進入可選清單(
hermes model可切換)。 - 小插曲:實測時模型回「訊息讀不懂請重送」——是 Windows curl 層中文編碼被搞壞,不是模型問題。
二、主角登場:一張三視圖進場
老板丟來一張 574×348 的黑白線稿三視圖(RX-78-2 鋼彈:正面/背面/側面 + 單腿細節圖,附日文組裝標註「反対側も同様」),要求:
「請使用此圖透過 MCP 生成模型,需要符合商用標準,完成後可以傳給我」
先講清楚一件事:技術品質與 IP 授權是兩件事。模型做得再漂亮,RX-78-2 的造型版权归利不因此轉移;要販售忠實還原模型需另行確認授權。老板裁定:只要高品質成果展示。
三、Blender MCP 連線血淚
第一層:9876 連線被拒
Blender MCP 架構 = Blender 5.2 加裝
blender_mcp外掛,在127.0.0.1:9876開一個純 TCP JSON server。第一輪連線直接ConnectionRefusedError。根因:
blender-mcp.exe(MCP 橋接程式)在跑,但 Blender 主程式根本沒開——橋接程式活著,被橋的端點是空的。第二層:Windows 路徑迷宮
- 用 git-bash 直接啟動 Blender,路徑被 MSYS 路徑轉換吞掉,
C:\Users\...被改寫成C:\Users\Administrator\c:\Users\...(多長出一層c)。 - PowerShell 命令碼在 bash 裡跑,
$變數又逸出炸了好幾輪。
正解:寫一個
blender_mcp_start.py開機腳本(addon_utils.enable+ 自動srv.start()),用 PowerShellStart-Process以原生 Windows 路徑啟動,啟動後輪詢 9876 直到ping回 pong。第三層:中文編碼
execute_codepayload 用 PowerShell 內送字串時中文又炸碼。正解:一律先寫成 UTF-8 的 .py 檔,用 Python heredoc +json.dumps送進 socket,不碰 PowerShell 跳脫。
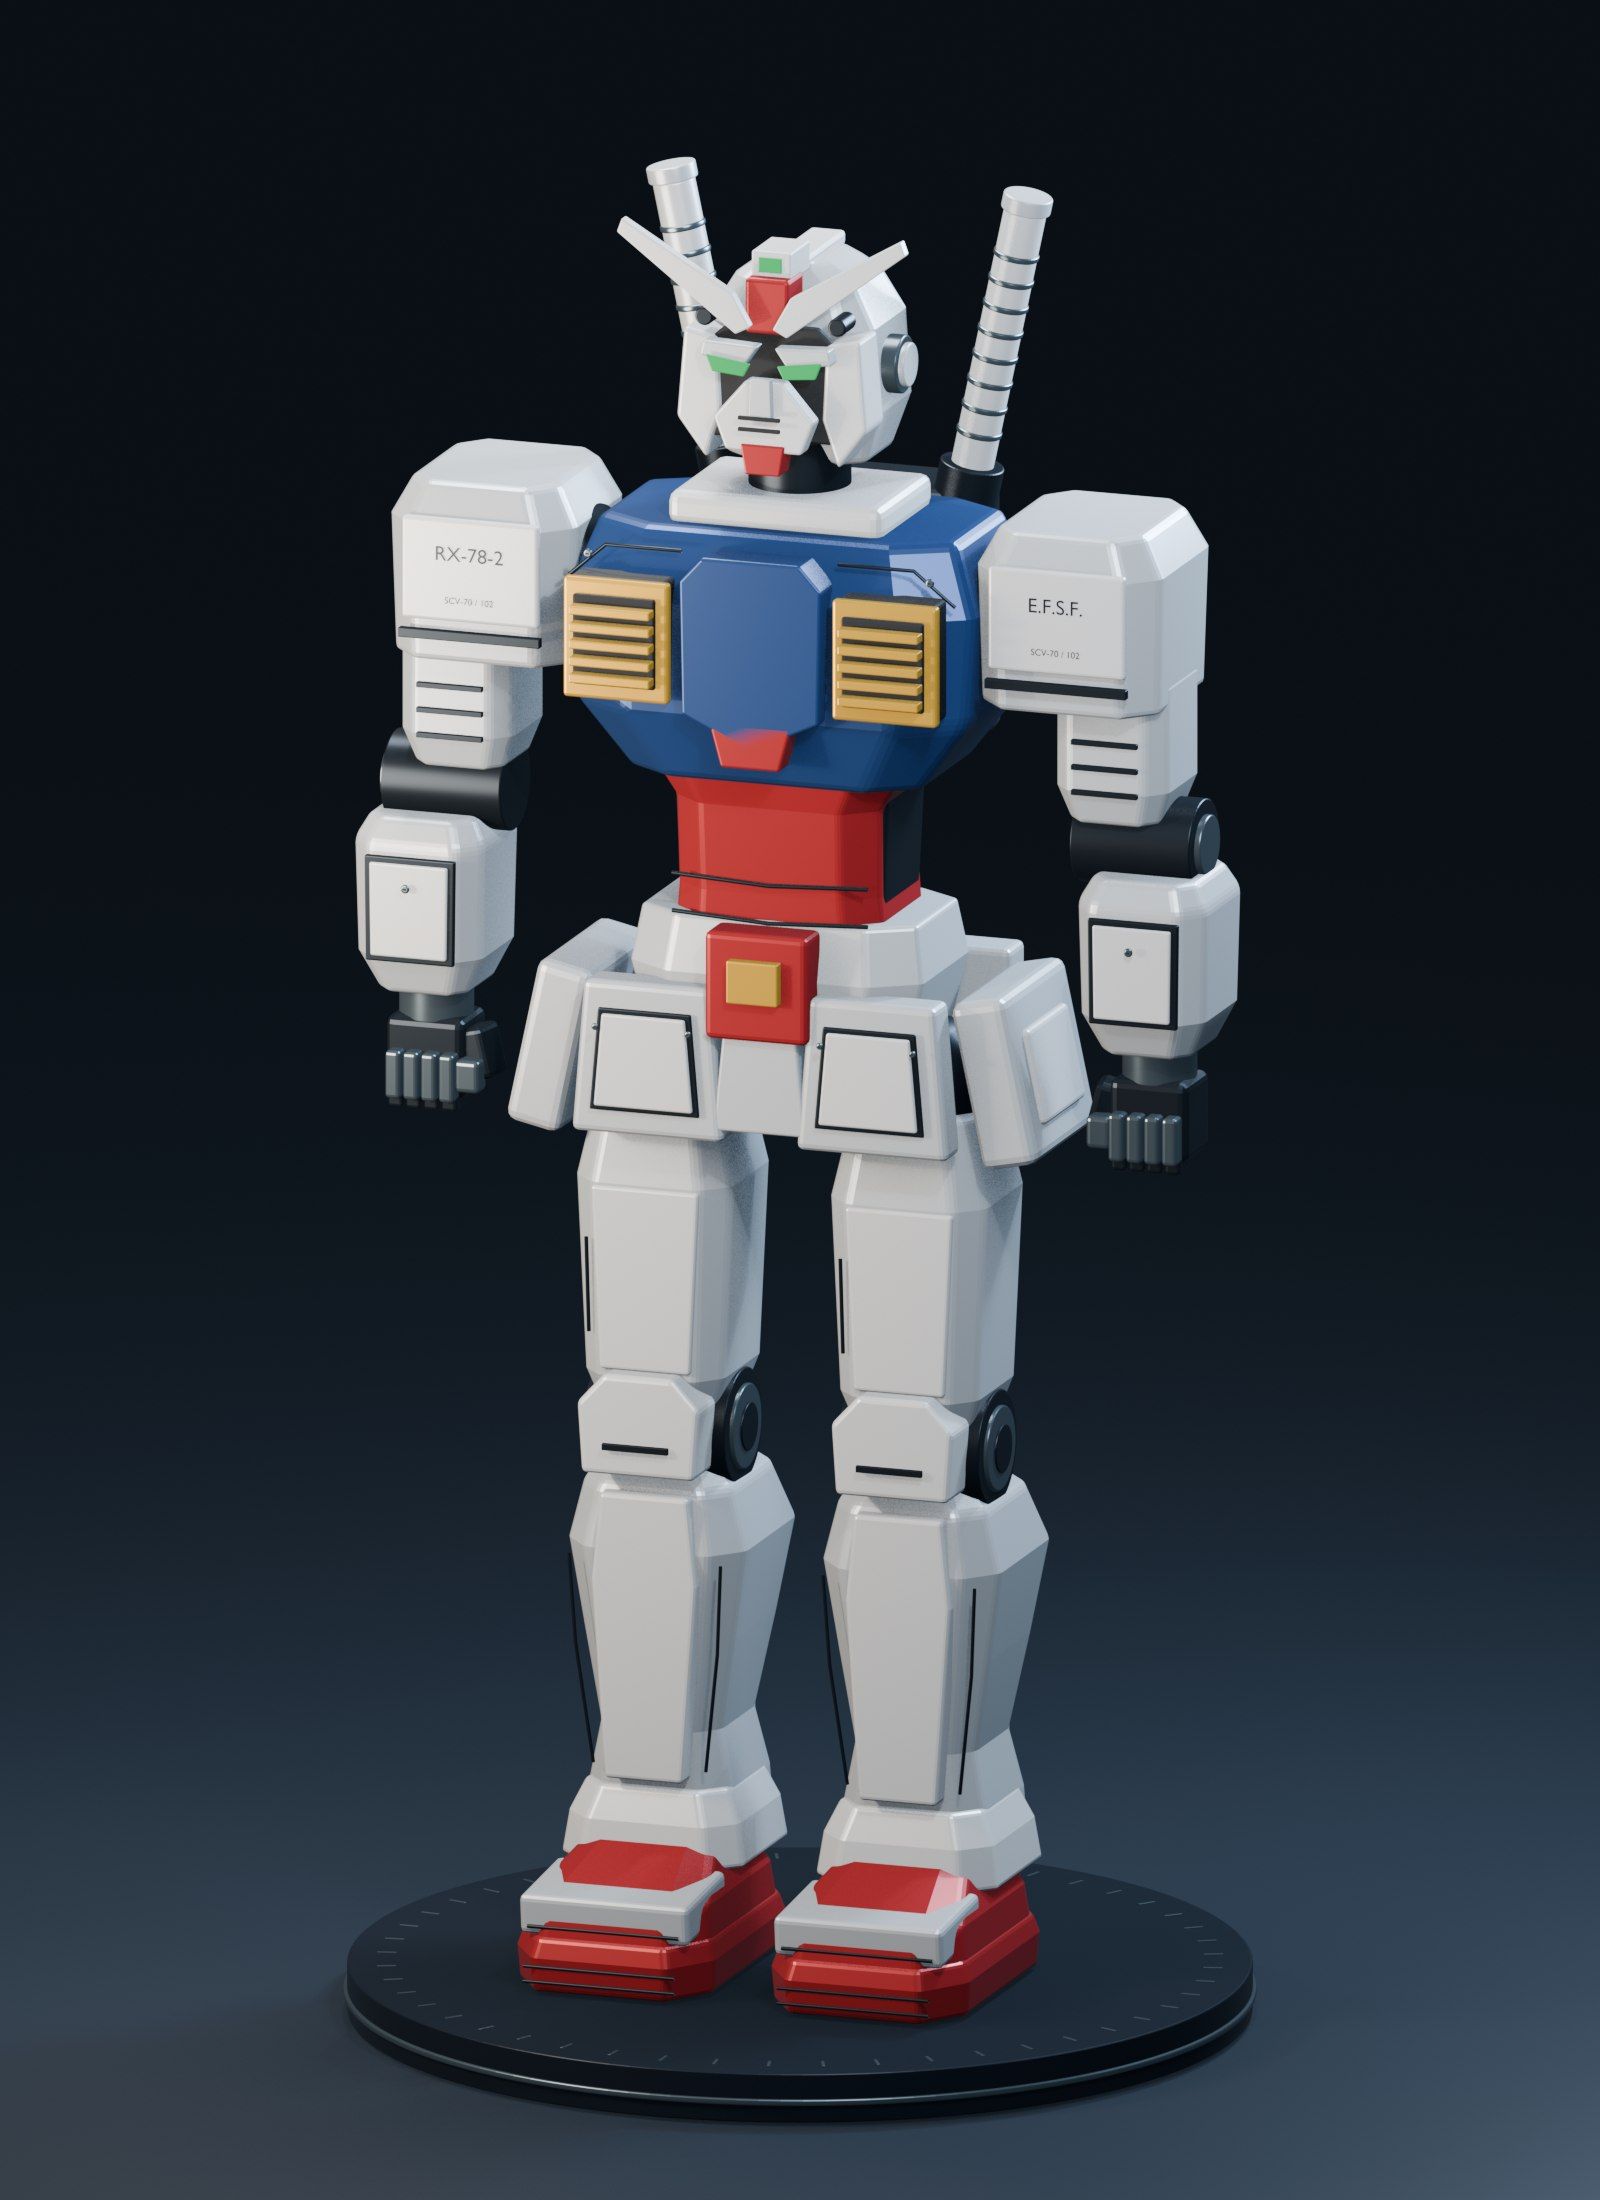
四、建模:從零蓋一台 246 物件的鋼彈
沒有外部模型檔、沒有掃描——全部用程式碼從三視圖重建。透過 MCP
execute_code送進 Blender 的 Python 建模腳本,核心手法:手法 用途 loft()八角形截面放樣胸甲/裙甲/小腿的立體曲面(不是硬方塊) plate()輪廓擠出前裙甲、膝蓋甲、胸脊等片狀裝甲 cyl()軸向圓柱膝/踝/肘關節軸、排氣口、光束軍刀 line()貝茲細管裝甲接缝、分割線 label()文字曲線肩甲 RX-78-2/E.F.S.F.字樣BEVEL + weighted normal 每個零件都倒角,消灭塑料感棱線 第一版渲染 → 视觉驗收 → 修改
第一轮全身照:246 個物件組裝完成、雙腳入鏡——但有三個問題:
- 白甲過曝偏亮 → 燈光降 38% + 曝光 -0.25(AgX 色調映射)
- 綠眼顏色被 emission 洗白 → 改 emission strength 0.7 + 深綠 base color(發光強度 ≥12 會把顏色吹掉)
- 鏡位讓一側 V-fin 被擋 → V-fin 整體前移 0.09、改正面 3/4 鏡
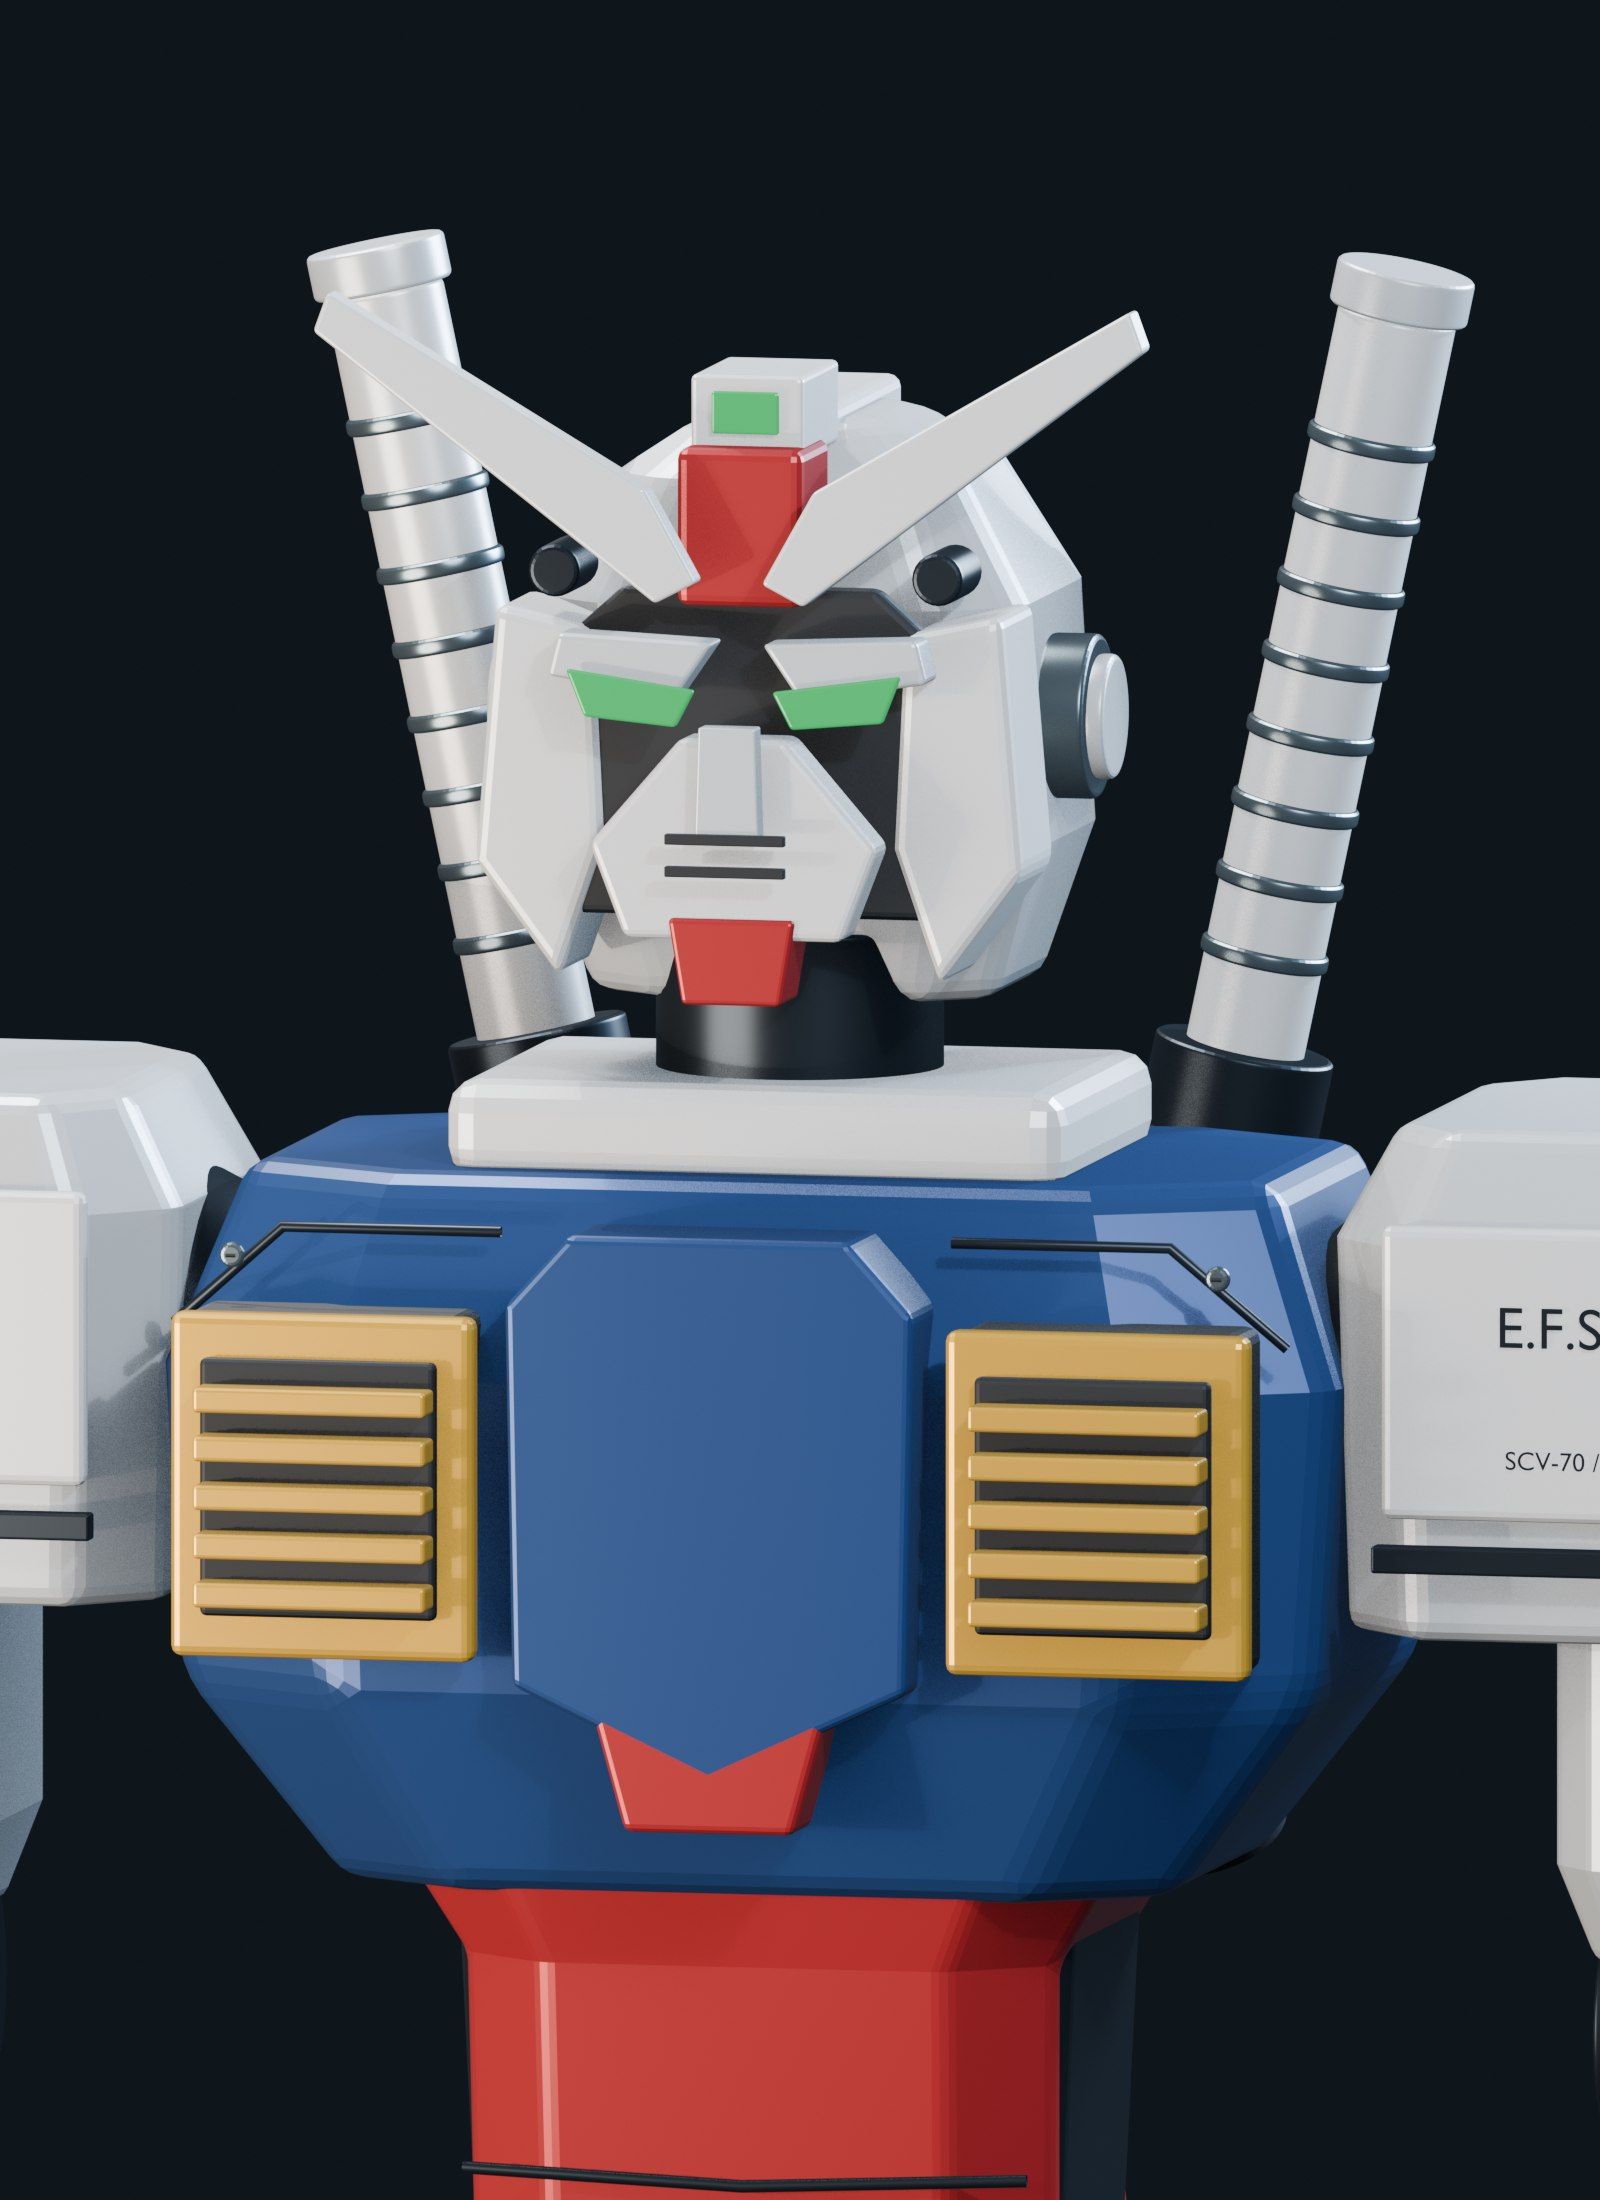
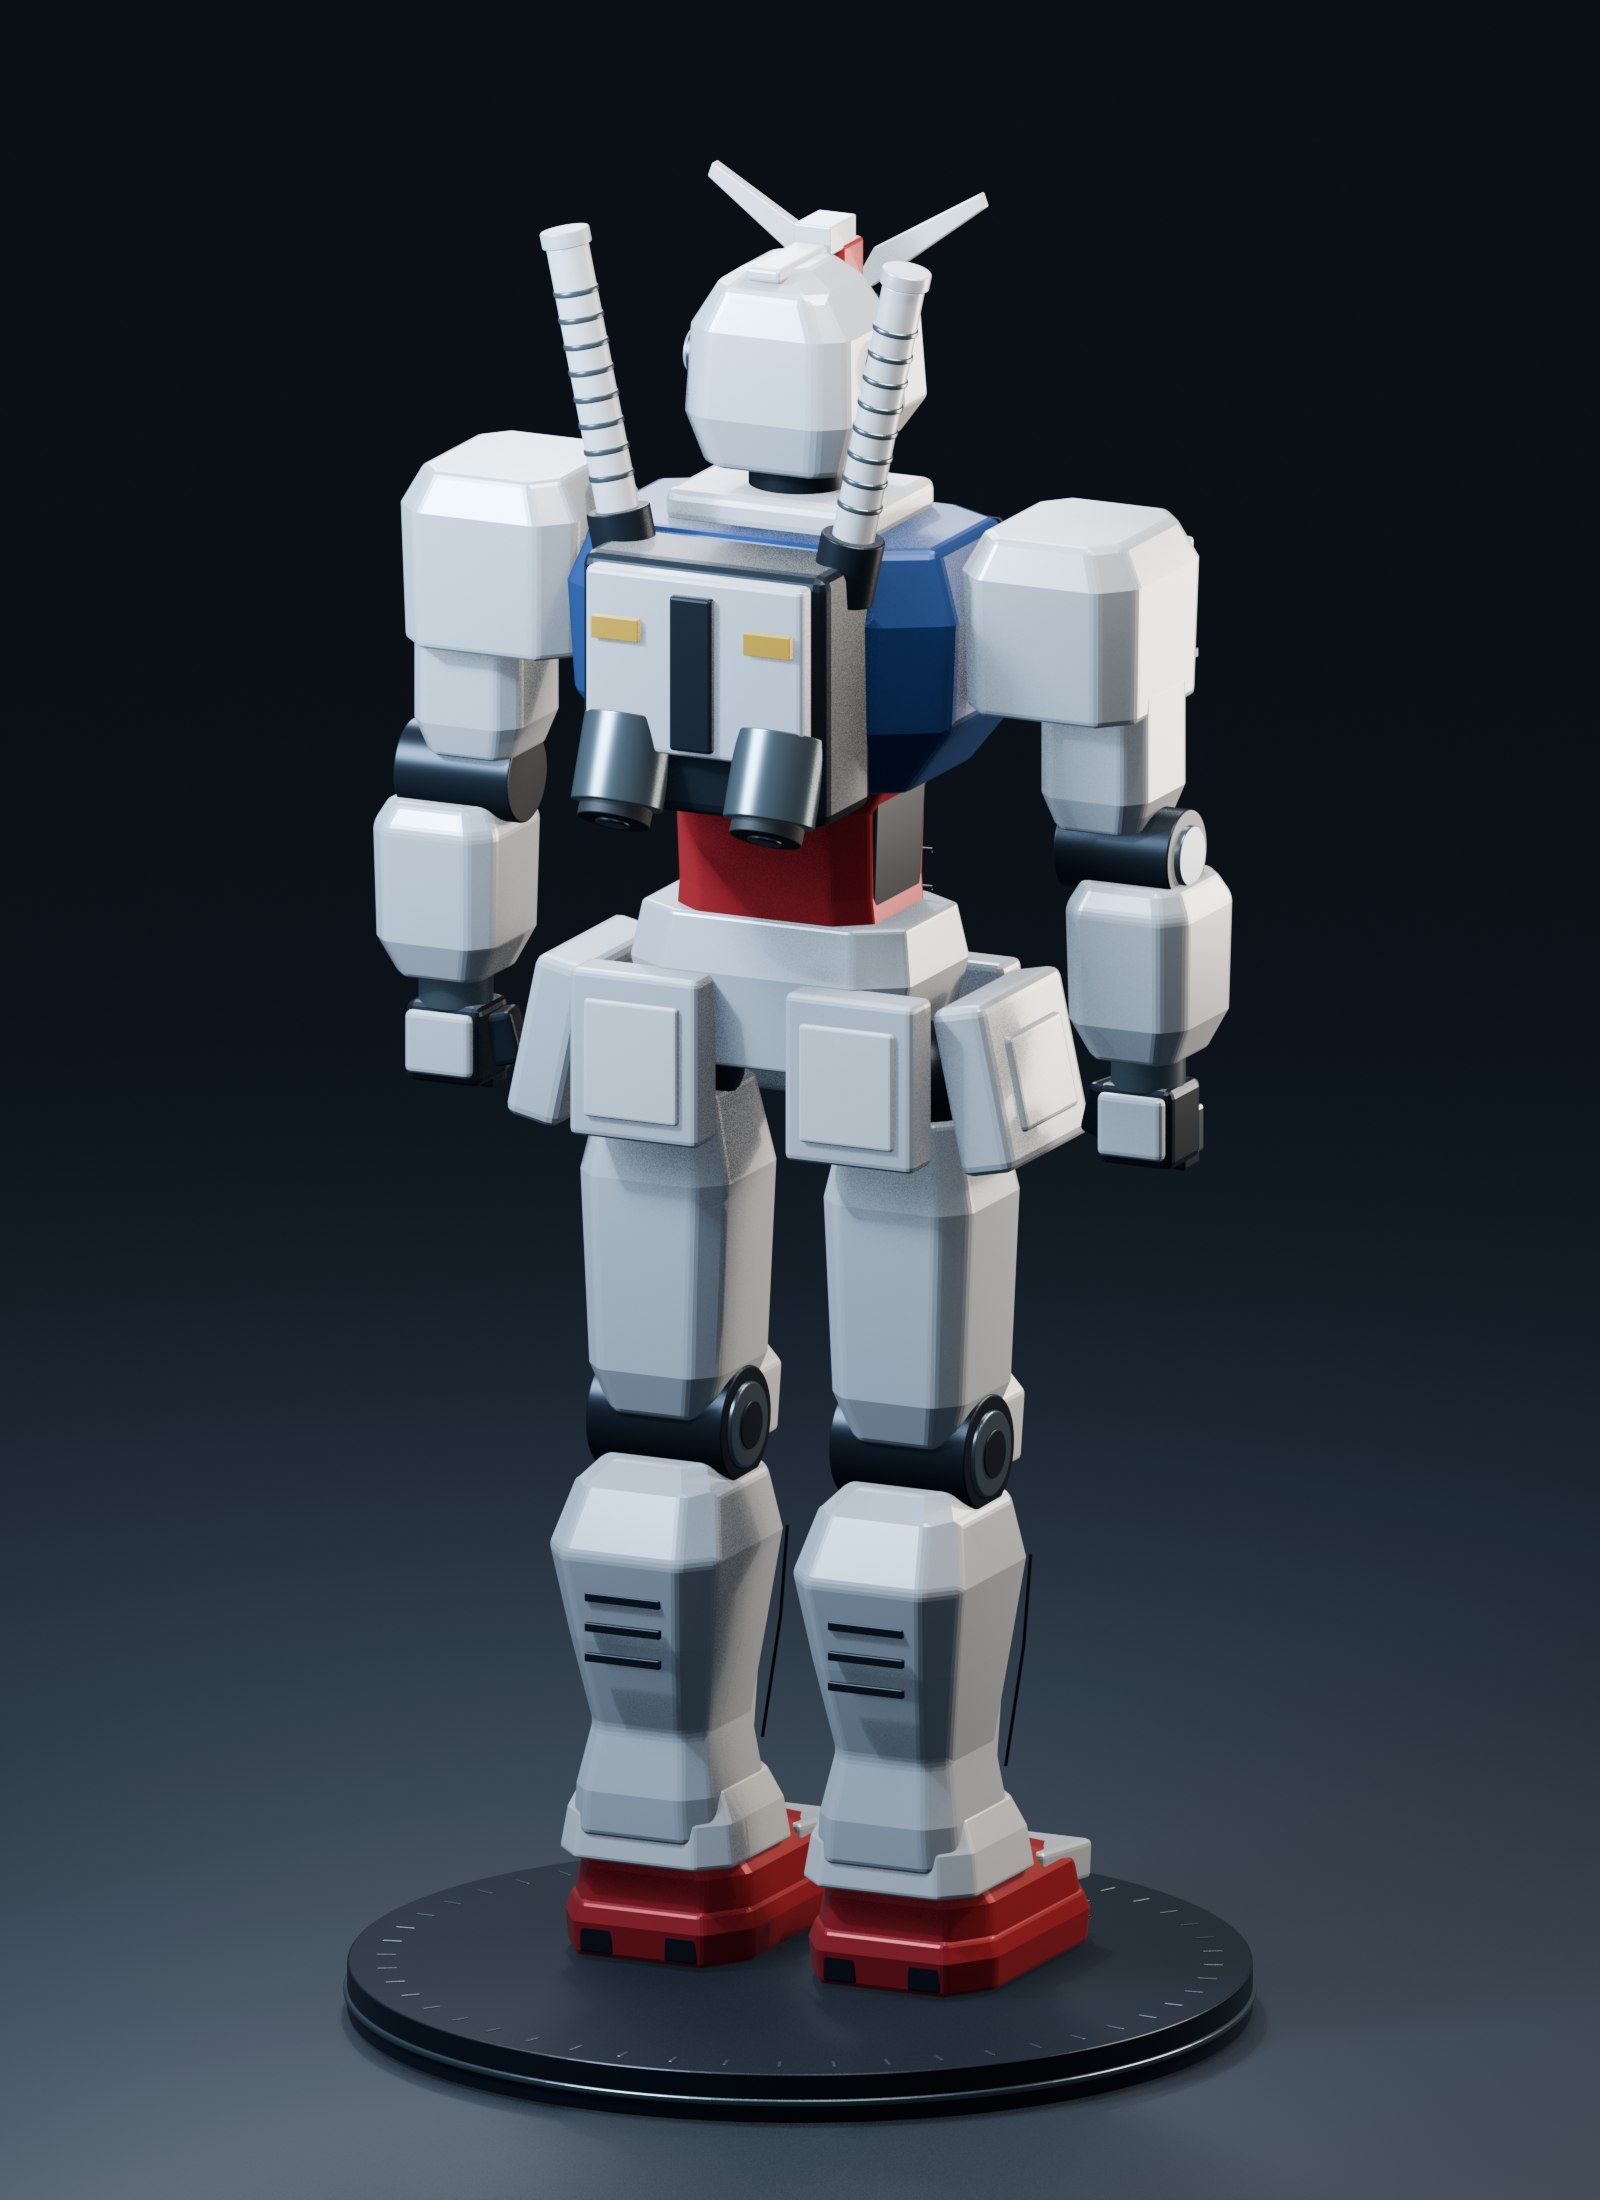
第二轮:正面_hero、背面、头胸近照三張同出,全部通過視覺驗收。
五、成果
檔案 說明 大小 01_hero.png全身主視覺 1600×2200(AgX) 3.9 MB 03_head_chest.png頭/胸近景驗收圖 3.5 MB 02_rear.png背面:背包推進器+光束軍刀 3.9 MB RX78_Showcase.glb匯出檔,217 mesh / 86,600 三角面 4.6 MB RX78_Showcase.blend可編輯原始檔(246 物件、分層收攏) 344 KB 存放:
D:\Hermes_Data\3D_Showcase\RX78_20260917\最终驗收清單(全過)
- 完整组裝態,無散件
- 双腳踏實接地(站在刻有 48 格刻度線的展示台)
- 双側 V-fin 可見、绿眼清晰不过曝
- 肩章 RX-78-2 / E.F.S.F. 分侧正确
- 胸口黃色散熱格 ×5 柵片、膝/踝關節軸可見
- 白甲保留藍/紅/黃色相
- 材质为 Principled PBR 参数化(無外部貼圖相依),GLB 即開即用
六、这次合作学到了什么
- union-alpha 首戰表現:256K context 全程記住從語音克隆到 Blender 的數小時工作歷史;踩坑(PowerShell
$逸出、路徑吞字、encoding)時能自己翻舊教訓換方法,不會同一個坑摔三次。 - 验证文化:每一轮都「先建 → 渲染 → 视觉检查 → 修改 → 重验」,没有把「环境就绪」当成交付成果。
- 交付標準:模型檔本身直接傳 Telegram(.blend + .glb),不是只报路径;授权问题写进
validation.json随档交付。
結論:
比之前的gemini 3.8flash(high)及qwen 3.8 flash Q3效果好,雖然還是沒辦法跟GPT6 Astra ultra比,但也是很不錯了。
Generated by Hermes Agent (Nous Research) · Model: stealth/union-alpha · 2026-09-17
- 配置寫入被工具層拒絕:
-
台灣技嘉 AI Pro R9700 32GB 自取, 手速要快 -
双R9700 + 华南X99 + 128g ddr3内存部署 qwen3.8-flash-next@Quanta-Magic 四卡不會後悔的,能上就上~sglang跑tp4會起飛
-
雙 Radeon AI PRO R9700 跑 Qwen3.8-Flash-Next 調校成果