R9700价值解放跑Qwen3.8-27B MXFP4(本地Deepseek V4 flash质量和速度)采用paiton/vLLM框架折腾实录,真实部署Minimax-H3
-
一、库与结论
Eliovp-BV/paiton-vllm-plugin(vLLM 0.29 / ROCm 10 / 65K r3);
Qwen3.8-27B-NVFP4+DFlash2;
R9700 32G、250W。
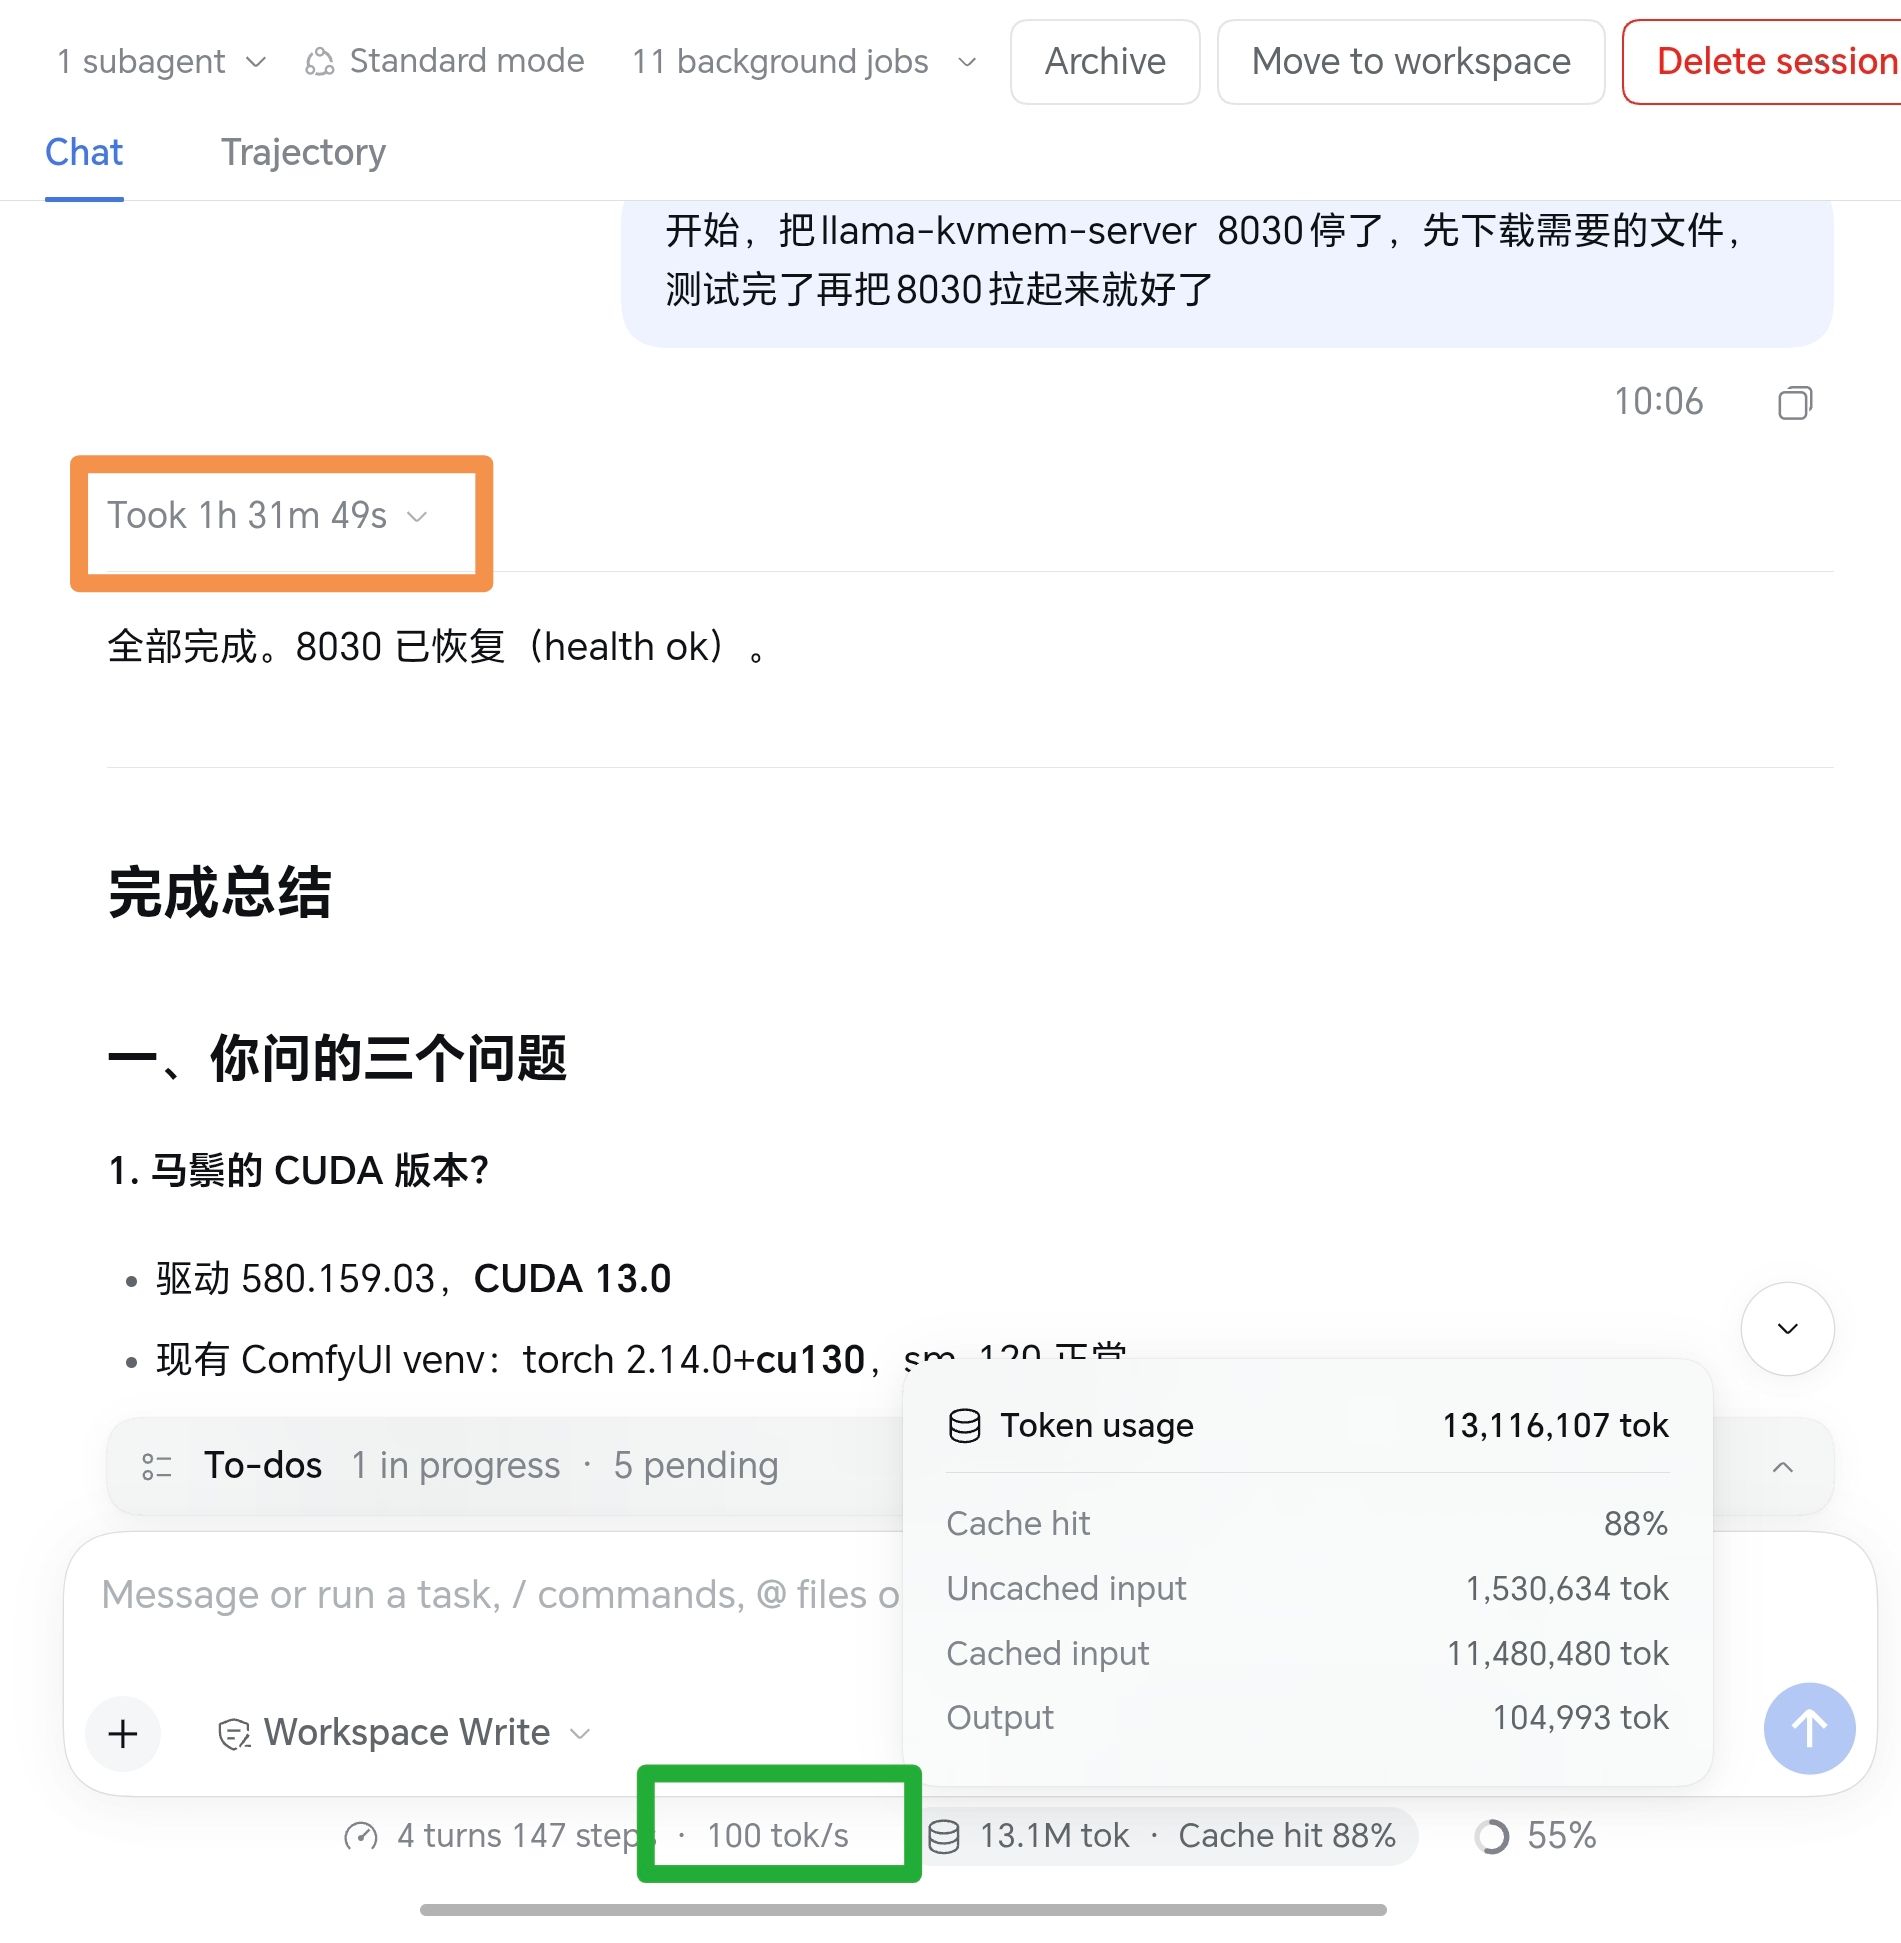
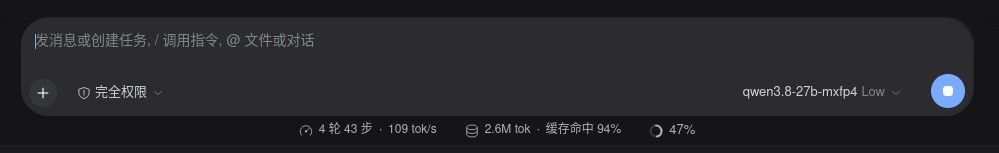
结论:prefill ~3.3k、decode 大概100-110,比裸跑快一个量级。
实测(200K/chunk4096):0.8K→2.4k、12K→3.36k、48K→3.0k。二、最终启动参数
docker run -d --name paiton-qwen38 --network host --ipc host \
  --device /dev/kfd --device /dev/dri --group-add video \
  -e ROCR_VISIBLE_DEVICES -e HIP_VISIBLE_DEVICES -e CUDA_VISIBLE_DEVICES \
  -e PAITON_NGRAM_CODRAFT=1 -e PYTORCH_ALLOC_CONF=max_split_size_mb:64 -e RADIANCE_GDN_LAZY=0 \
  -v /data/models/qwen38-nvfp4:/models/target:ro \
  -v /data/models/qwen38-dflash2:/models/draft:ro \
  -v /data/paiton-cache-65k:/cache \
  --restart unless-stopped \
  ghcr.io/eliovp/paiton-vllm-plugin:qwen38-rocm10-vllm029-65k-20260924-r3@sha256:c2511888b76abf463c7f5c51f0c70bf66c593f3c2fca8d910765d85318d399ce \
  serve /models/target --tokenizer /models/target \
  --served-model-name Qwen3.8 Qwen3.8-27B-MXFP4-DFlash2 \
  --host 0.0.0.0 --port 8080 --tensor-parallel-size 1 --dtype bfloat16 \
  --max-model-len 204800 --max-num-seqs 1 --max-num-batched-tokens 4096 \
  --kv-cache-dtype fp8 --kv-cache-memory-bytes 7677640704 --gpu-memory-utilization 0.98 \
  --enable-prefix-caching --enable-chunked-prefill \
  --attention-backend R4D \
  --compilation-config '{"cudagraph_capture_sizes":[1,2,4,8],"pass_config":{"fuse_norm_quant":true,"fuse_act_quant":true}}' \
  --speculative-config '{"method":"dflash","model":"/models/draft","num_speculative_tokens":7,"draft_tensor_parallel_size":1,"attention_backend":"TRITON_ATTN","max_model_len":204800,"disable_padded_drafter_batch":true,"draft_sample_method":"greedy"}' \
  --mamba-cache-mode align --mamba-cache-dtype bfloat16 --mamba-ssm-cache-dtype float16 \
  --no-async-scheduling \
  --enable-auto-tool-choice --tool-call-parser qwen3_coder --reasoning-parser qwen3 \
  --override-generation-config '{"temperature":0.7,"top_p":0.95,"top_k":20}' --seed 42 \
  --default-chat-template-kwargs '{"enable_thinking":true}' --enable-prompt-tokens-details
三、异同与升级点
线上是 compose 托管(paiton-qwen38-27b-10img)。逐字比对:镜像、卷、性能开关全同,只两处不同——图片配额 1→10、mm 像素区间收窄,纯文本无关。 compose 看着 165 个 env,其实 163 条是镜像自带照抄;真正覆盖默认的只有那 3 条,故最小集 ≡ 线上。 升级点:chunk 1024→4096 让长 prompt prefill +12~15%(48K:2602→2992),短 prompt 持平;代价是放弃 200K 档并发——C2 仅线性 45%,步/秒腰斩、GPU 六成时间空转,瓶颈在主机侧。官方 65K 档 C1→C8 是 122.8→422.9,想并发请回 65K。四、折腾经过
照论坛抄,pp 只有 1300,一度怀疑卡买错。翻日志才知 vLLM 只报 10 秒窗口均值,不能当 pp;自写受控脚本(nonce 破缓存 + TTFT 口径)测出:空闲 2.9k、一忙 1.3k——是排队,不是算力。 官方并发数据全是 65K 档,200K 档本就标定 1 路。不服气开 C2,两组 A/B 全证伪;采样定位到主机侧开销。 教训:日志聚合值≠性能,别人的数先看档位,自己的印象也得同内容 A/B 才算数。相对上一版的改动(最小改动):参数块 env 从 3 条起保留、其余 162 条没列出来都是镜像自带的env
说明:
面向读者的一句提醒:200K 档别开并发,想要并发请回 65K 档(官方 8 路,C1→C8 聚合 122.8→422.9)。
-
-
-
-
-
-
-
-
-
楼主你好,跟着帖子参数复现了一轮,prefill 全中,decode 差得远,想请教几点
我这边:同款 r3 镜像、NVFP4 权重(容器内 quant_method: compressed-tensors)、TP=1、ctx 204800、chunk 4096、seqs 1、thinking ON、260W。启动参数逐项对过,真差异只有 port。
prefill 0.8K / 12K / 48K
• 帖子: 2.4k / 3.36k / 3.0k
• 我实测: 2994 / 3353 / 3029decode 加权
• 帖子: 154
• 我实测: 120.09(median 131.09)prefill 三个深度全中。decode 差 -22%。
-
154 怎么量的? 你 prefill 那边提过「vLLM 只报 10 秒窗口均值,不能当 pp」,所以自己写了脚本。decode 是不是也用了自写脚本?corpus、max_tokens、有原始 JSON 吗?
-
thinking ON 还是 OFF 量的? 你给的参数是 enable_thinking:true,但我这边 thinking ON 时有 57.5%(92/160)的 run 在答案开始前就撞 max_tokens 被截断,量到的是 thinking 段速度。同配置关掉 thinking 反而有 141.34。你量 154 时怎么处理的?
-
154 是 200K 档实测,还是引用官方 65K 档? 官方 9/20 candidate 在 thinking:false 下是 154.42,和你只差 0.3%。
-
250W 怎么设的? 命令里没看到功耗设置,宿主侧还是容器内?
-
draft_sample_method:你写 greedy,但我这边日志显示实际是 probabilistic(镜像内置 env 覆盖了 flag)。你量 154 时是哪个?
有原始结果文件的话我可以直接拿来对照,先谢过。
-
-
-
-
-
-
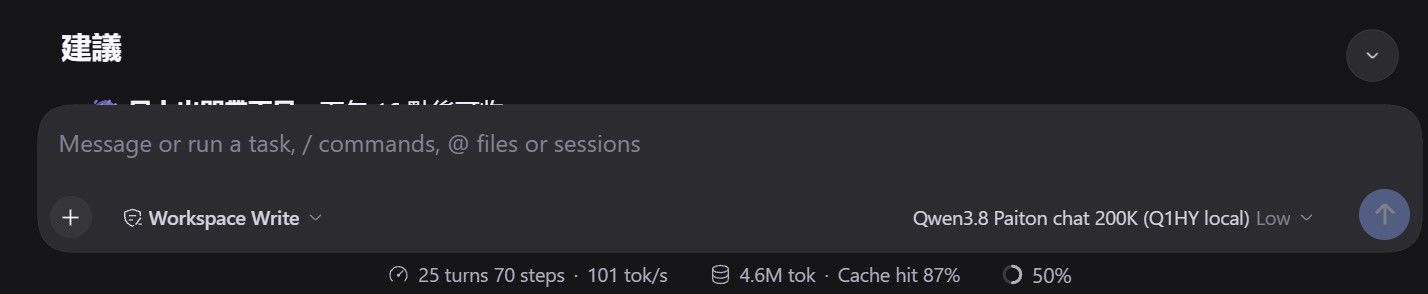
@fcme 了解,dsh 使用上来也是 100 tg/s 来的样子
-
-
-
-
,
 F fcme 引用了 此主题