跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. R9700价值解放跑Qwen3.8-27B MXFP4(本地Deepseek V4 flash质量和速度)采用paiton/vLLM框架折腾实录,真实部署Minimax-H3

R9700价值解放跑Qwen3.8-27B MXFP4(本地Deepseek V4 flash质量和速度)采用paiton/vLLM框架折腾实录,真实部署Minimax-H3

已定时 已固定 已锁定 已移动 LLM讨论区
r9700qwen-27bvllm
19 帖子 5 发布者 1.1k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • paul houP
    paul houP
    paul hou
    德高望重 劳动模范
    编写于 最后由 编辑
    #2

    204800應該是比較好的設定,以上似乎用處不大,我也這樣調整好了。

    fcmeF 1 条回复 最后回复
    0
    • suboyangS
      suboyangS
      suboyang
      劳动模范
      编写于 最后由 suboyang 编辑
      #3

      单卡 干净 实用

      对了,你这个裸机装驱动了嘛?还是只是拉的docker

      fcmeF 1 条回复 最后回复
      0
      • suboyangS
        suboyangS
        suboyang
        劳动模范
        编写于 最后由 编辑
        #4

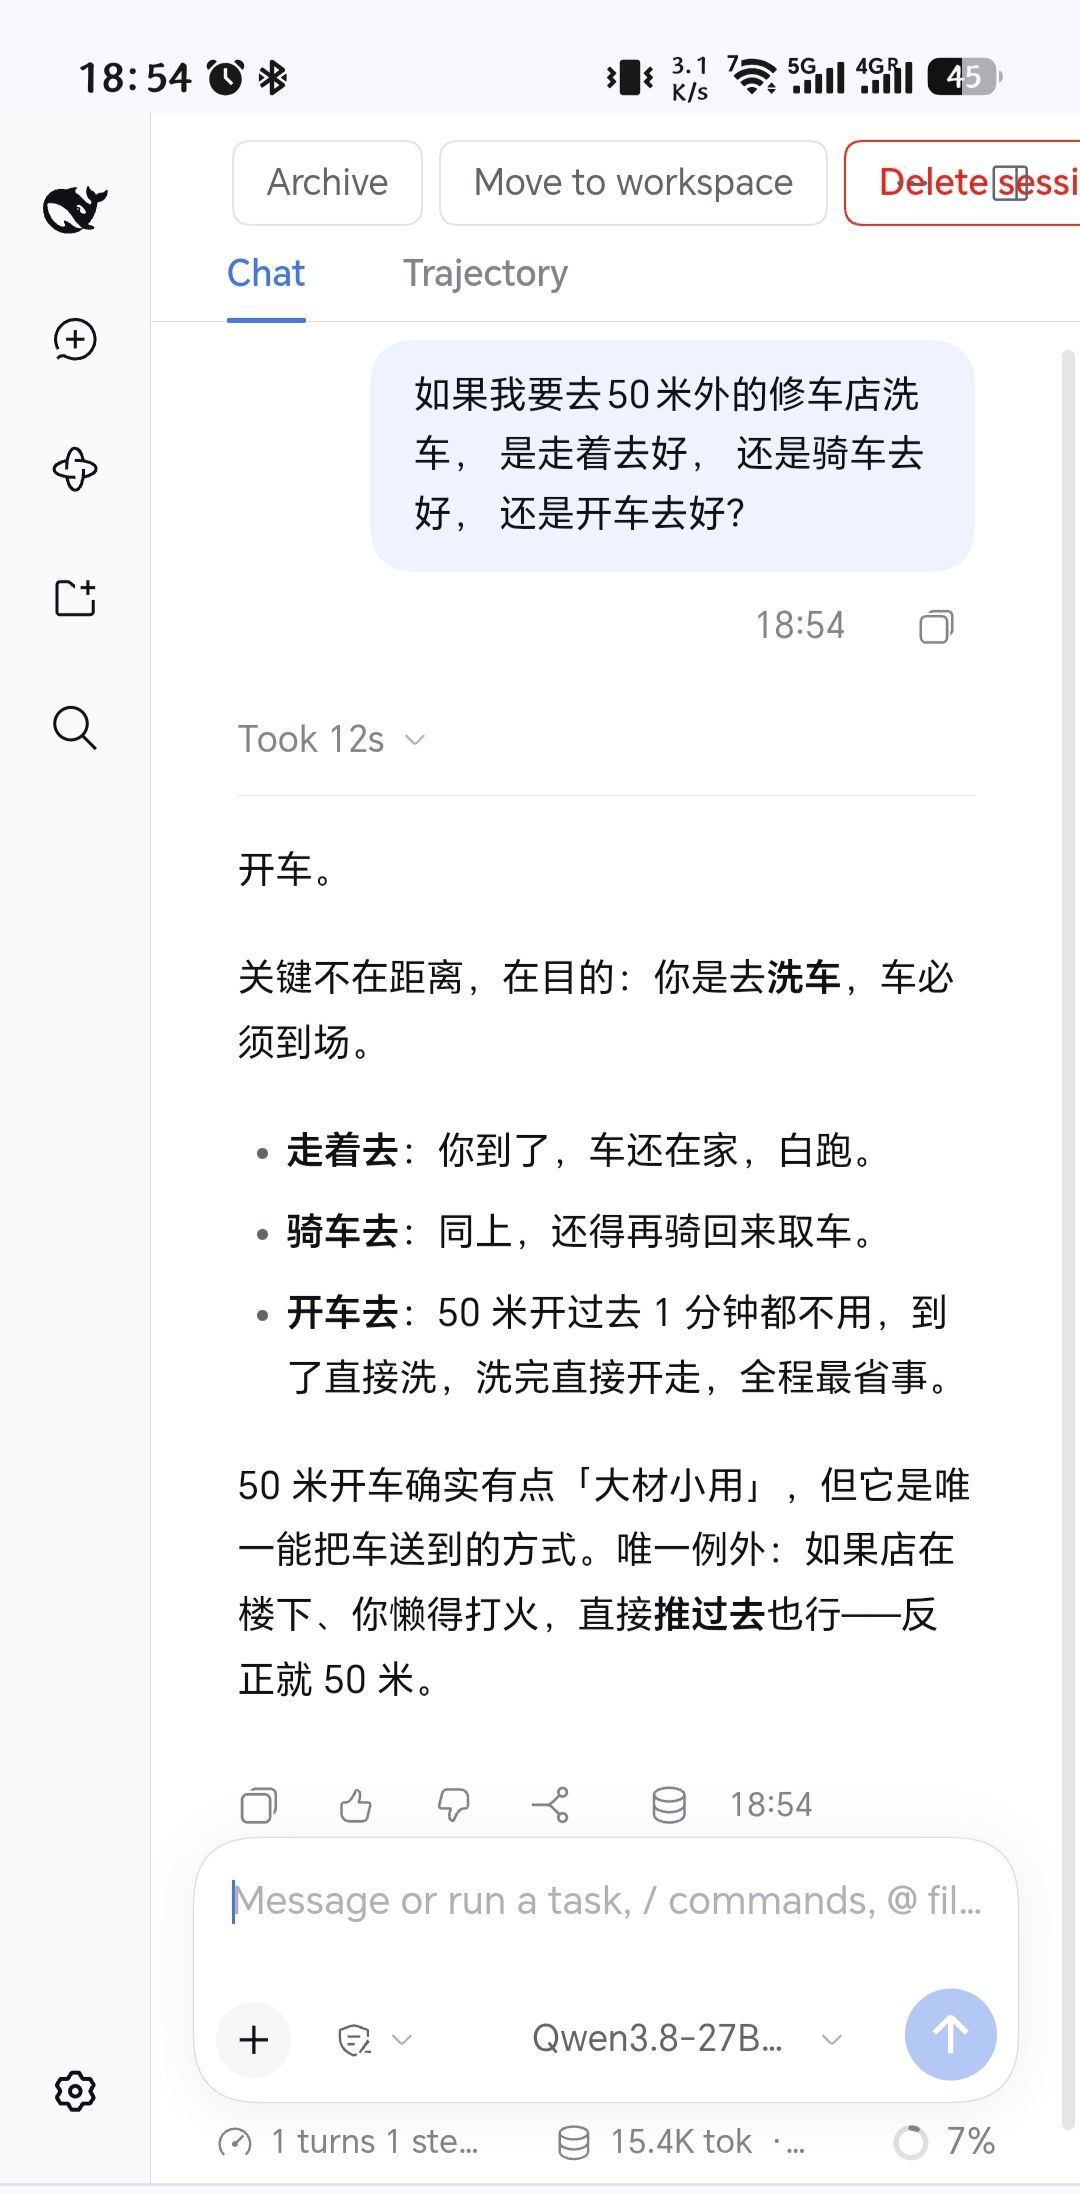
        让AI回答一个问题:“如果我要去50米外的修车店洗车, 是走着去好, 还是骑车去好, 还是开车去好?“

        你的27B 怎么回答?

        fcmeF 1 条回复 最后回复
        0
        • suboyangS suboyang

          让AI回答一个问题:“如果我要去50米外的修车店洗车, 是走着去好, 还是骑车去好, 还是开车去好?“

          你的27B 怎么回答?

          fcmeF
          fcmeF
          fcme
          超凡大师
          编写于 最后由 编辑
          #5

          @suboyang
          这是刚刚的截图,成功!Screenshot_20260927_185458_com_android_chrome_ChromeTabbedActivity_edit_412627554210771.jpg

          1 条回复 最后回复
          0
          • suboyangS suboyang

            单卡 干净 实用

            对了,你这个裸机装驱动了嘛?还是只是拉的docker

            fcmeF
            fcmeF
            fcme
            超凡大师
            编写于 最后由 编辑
            #6

            @suboyang
            docker啊,这个帖子就位了给我的启动参数备份一下,哈哈

            1 条回复 最后回复
            0
            • paul houP paul hou

              204800應該是比較好的設定,以上似乎用處不大,我也這樣調整好了。

              fcmeF
              fcmeF
              fcme
              超凡大师
              编写于 最后由 编辑
              #7

              @paul-hou
              对,目前来说这个单卡跑27B开多并发不值得,没啥意义,得不偿失

              1 条回复 最后回复
              0
              • tmp tmpT
                tmp tmpT
                tmp tmp
                编写于 最后由 编辑
                #8

                你这个配置支持视觉多模态吗?

                fcmeF 1 条回复 最后回复
                0
                • tmp tmpT tmp tmp

                  你这个配置支持视觉多模态吗?

                  fcmeF
                  fcmeF
                  fcme
                  超凡大师
                  编写于 最后由 编辑
                  #9

                  @tmp-tmp
                  支持的,这个配置里面的图片tokens设置的有点大而且只能有一张图的输入,可以让AI调整到你喜欢的数值。我最终是10张,每张最小512tokens最大16k tokens。目前用下来很好。AI时代,可以自己调的地方很多

                  1 条回复 最后回复
                  1
                  • alan.lgv60A
                    alan.lgv60A
                    alan.lgv60
                    编写于 最后由 alan.lgv60 编辑
                    #10

                    楼主你好,跟着帖子参数复现了一轮,prefill 全中,decode 差得远,想请教几点

                    我这边:同款 r3 镜像、NVFP4 权重(容器内 quant_method: compressed-tensors)、TP=1、ctx 204800、chunk 4096、seqs 1、thinking ON、260W。启动参数逐项对过,真差异只有 port。

                    prefill 0.8K / 12K / 48K
                    • 帖子: 2.4k / 3.36k / 3.0k
                    • 我实测: 2994 / 3353 / 3029

                    decode 加权
                    • 帖子: 154
                    • 我实测: 120.09(median 131.09)

                    prefill 三个深度全中。decode 差 -22%。

                    1. 154 怎么量的? 你 prefill 那边提过「vLLM 只报 10 秒窗口均值,不能当 pp」,所以自己写了脚本。decode 是不是也用了自写脚本?corpus、max_tokens、有原始 JSON 吗?

                    2. thinking ON 还是 OFF 量的? 你给的参数是 enable_thinking:true,但我这边 thinking ON 时有 57.5%(92/160)的 run 在答案开始前就撞 max_tokens 被截断,量到的是 thinking 段速度。同配置关掉 thinking 反而有 141.34。你量 154 时怎么处理的?

                    3. 154 是 200K 档实测,还是引用官方 65K 档? 官方 9/20 candidate 在 thinking:false 下是 154.42,和你只差 0.3%。

                    4. 250W 怎么设的? 命令里没看到功耗设置,宿主侧还是容器内?

                    5. draft_sample_method:你写 greedy,但我这边日志显示实际是 probabilistic(镜像内置 env 覆盖了 flag)。你量 154 时是哪个?

                    有原始结果文件的话我可以直接拿来对照,先谢过。

                    fcmeF 1 条回复 最后回复
                    0
                    • alan.lgv60A alan.lgv60

                      楼主你好,跟着帖子参数复现了一轮,prefill 全中,decode 差得远,想请教几点

                      我这边:同款 r3 镜像、NVFP4 权重(容器内 quant_method: compressed-tensors)、TP=1、ctx 204800、chunk 4096、seqs 1、thinking ON、260W。启动参数逐项对过,真差异只有 port。

                      prefill 0.8K / 12K / 48K
                      • 帖子: 2.4k / 3.36k / 3.0k
                      • 我实测: 2994 / 3353 / 3029

                      decode 加权
                      • 帖子: 154
                      • 我实测: 120.09(median 131.09)

                      prefill 三个深度全中。decode 差 -22%。

                      1. 154 怎么量的? 你 prefill 那边提过「vLLM 只报 10 秒窗口均值,不能当 pp」,所以自己写了脚本。decode 是不是也用了自写脚本?corpus、max_tokens、有原始 JSON 吗?

                      2. thinking ON 还是 OFF 量的? 你给的参数是 enable_thinking:true,但我这边 thinking ON 时有 57.5%(92/160)的 run 在答案开始前就撞 max_tokens 被截断,量到的是 thinking 段速度。同配置关掉 thinking 反而有 141.34。你量 154 时怎么处理的?

                      3. 154 是 200K 档实测,还是引用官方 65K 档? 官方 9/20 candidate 在 thinking:false 下是 154.42,和你只差 0.3%。

                      4. 250W 怎么设的? 命令里没看到功耗设置,宿主侧还是容器内?

                      5. draft_sample_method:你写 greedy,但我这边日志显示实际是 probabilistic(镜像内置 env 覆盖了 flag)。你量 154 时是哪个?

                      有原始结果文件的话我可以直接拿来对照,先谢过。

                      fcmeF
                      fcmeF
                      fcme
                      超凡大师
                      编写于 最后由 编辑
                      #11

                      @alan.lgv60
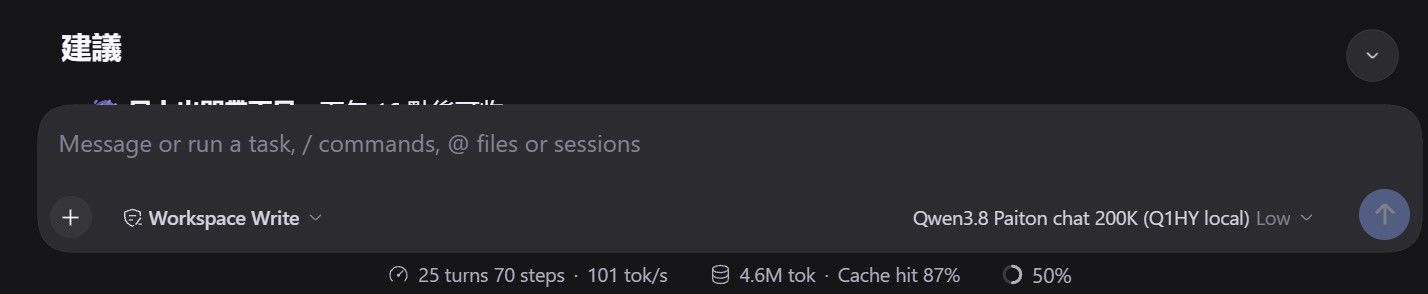
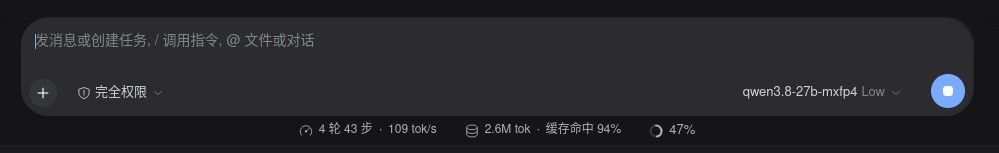
                      哦,这个只是个抛砖引玉的帖子。我的启动参数只能作为一个基准。具体的tg速度和你进行的任务有关系,我的话平均下来实际上应该是在100~110的样子,有做特定的任务才能到150次。思考模式开了。250W是我在外部做了一个脚本,然后限制了显卡的功率,在模型里面没法搞。

                      1 条回复 最后回复
                      0
                      • fcmeF
                        fcmeF
                        fcme
                        超凡大师
                        编写于 最后由 编辑
                        #12

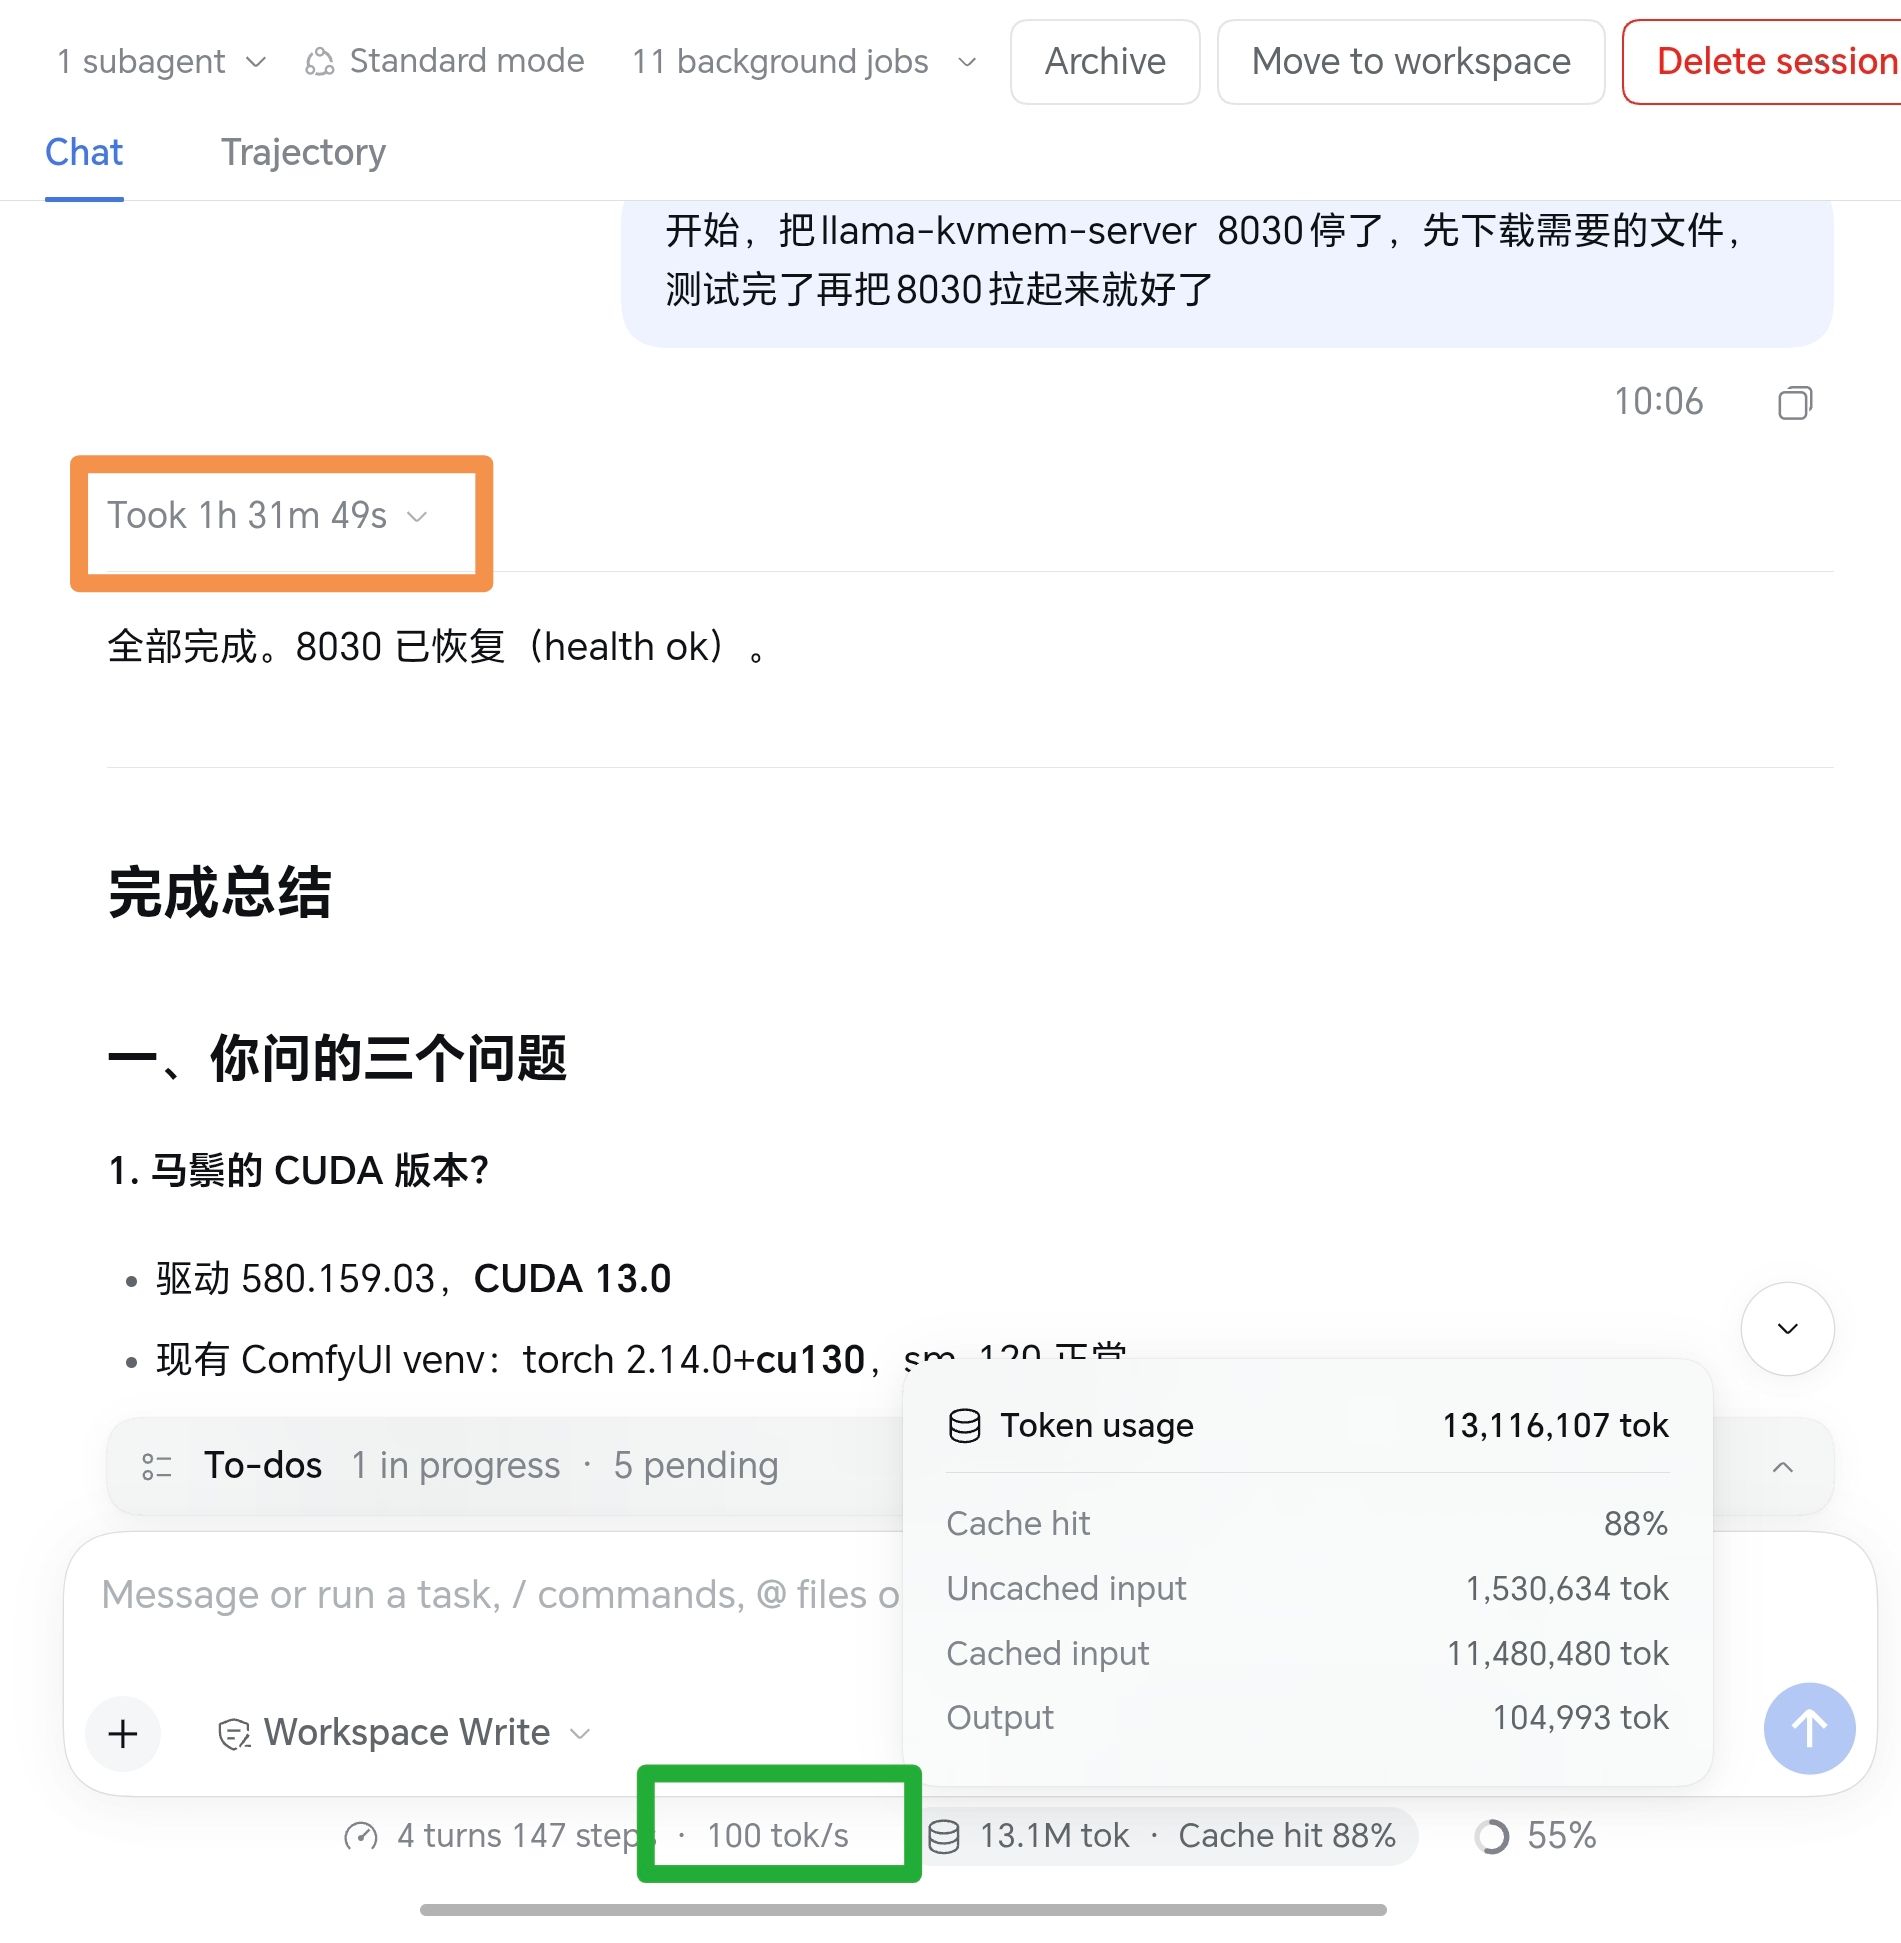
                        先上个图,证明千问3.8 27b在本地的能力和价值。
                        自己吭哧吭哧跑了一个半小时,不断链直接在本地部署好了给5070ti用的minimax h3的docker,一次过,我愿称之为本地的deepseek flash V4!
                        Screenshot_20260930_123920_com_android_chrome_ChromeTabbedActivity.jpg

                        1 条回复 最后回复
                        0
                        • paul houP
                          paul houP
                          paul hou
                          德高望重 劳动模范
                          编写于 最后由 编辑
                          #13

                          200K的版本也更新了,效能差不多。
                          用起來的速度和體驗確實滿像DEEPSEEK V4 FLASH 預覽版。27B能做到這個地步很厲害了。

                          image.jpeg

                          fcmeF tmp tmpT 2 条回复 最后回复
                          0
                          • paul houP paul hou

                            200K的版本也更新了,效能差不多。
                            用起來的速度和體驗確實滿像DEEPSEEK V4 FLASH 預覽版。27B能做到這個地步很厲害了。

                            image.jpeg

                            fcmeF
                            fcmeF
                            fcme
                            超凡大师
                            编写于 最后由 编辑
                            #14

                            @paul-hou
                            确实,所以我也不太想折腾了,就用这个版本定死了,再升级也就是不痛不痒的小修小补了,等俩月再看吧。

                            alan.lgv60A 1 条回复 最后回复
                            0
                            • fcmeF fcme

                              @paul-hou
                              确实,所以我也不太想折腾了,就用这个版本定死了,再升级也就是不痛不痒的小修小补了,等俩月再看吧。

                              alan.lgv60A
                              alan.lgv60A
                              alan.lgv60
                              编写于 最后由 编辑
                              #15

                              @fcme 了解,dsh 使用上来也是 100 tg/s 来的样子

                              image.jpeg

                              fcmeF 1 条回复 最后回复
                              0
                              • alan.lgv60A alan.lgv60

                                @fcme 了解,dsh 使用上来也是 100 tg/s 来的样子

                                image.jpeg

                                fcmeF
                                fcmeF
                                fcme
                                超凡大师
                                编写于 最后由 编辑
                                #16

                                @alan.lgv60
                                对,平均也就100左右。再提升到125或者150的话体感也不太明显了。因为你看任务详情就发现生成的还是少数,主要是pp那块的消耗,而这个问题已经被大神解决了。
                                但是后续各种优化还是回来的,比较现在有了想法用AI实现的难度降低了太多了。

                                1 条回复 最后回复
                                1
                                • paul houP paul hou

                                  200K的版本也更新了,效能差不多。
                                  用起來的速度和體驗確實滿像DEEPSEEK V4 FLASH 預覽版。27B能做到這個地步很厲害了。

                                  image.jpeg

                                  tmp tmpT
                                  tmp tmpT
                                  tmp tmp
                                  编写于 最后由 编辑
                                  #17

                                  @paul-hou 说:

                                  200K的版本也更新了,效能差不多。
                                  用起來的速度和體驗確實滿像DEEPSEEK V4 FLASH 預覽版。27B能做到這個地步很厲害了。

                                  image.jpeg

                                  请问200k的版本,在哪里呀?我昨天自己弄的200k上下文,pp速度跟帖子里差不多,tg只有45到70的样子,应该是哪里没做到位。

                                  paul houP 1 条回复 最后回复
                                  0
                                  • tmp tmpT tmp tmp

                                    @paul-hou 说:

                                    200K的版本也更新了,效能差不多。
                                    用起來的速度和體驗確實滿像DEEPSEEK V4 FLASH 預覽版。27B能做到這個地步很厲害了。

                                    image.jpeg

                                    请问200k的版本,在哪里呀?我昨天自己弄的200k上下文,pp速度跟帖子里差不多,tg只有45到70的样子,应该是哪里没做到位。

                                    paul houP
                                    paul houP
                                    paul hou
                                    德高望重 劳动模范
                                    编写于 最后由 编辑
                                    #18

                                    @tmp-tmp

                                    他有分65K和200K的版本,讓AI去抓回來用就行了。

                                    1 条回复 最后回复
                                    0
                                    • tmp tmpT
                                      tmp tmpT
                                      tmp tmp
                                      编写于 最后由 编辑
                                      #19

                                      哦,这样的啊,我的AI抓的是65K,然后自己改成200K了。

                                      1 条回复 最后回复
                                      0
                                      • ,fcmeF fcme 引用了 此主题

                                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                      有了你的建议,这篇帖子会更精彩哦 💗

                                      注册 登录
                                      回复
                                      • 在新帖中回复
                                      登录后回复
                                      • 从旧到新
                                      • 从新到旧
                                      • 最多赞同


                                      • 登录

                                      • 登录或注册以进行搜索。
                                      • 第一个帖子
                                        最后一个帖子
                                      0
                                      • 版块
                                      • 最新
                                      • 标签
                                      • 热门
                                      • 用户
                                      • 群组