R9700价值解放跑Qwen3.8-27B MXFP4(本地Deepseek V4 flash质量和速度)采用paiton/vLLM框架折腾实录,真实部署Minimax-H3
-
-
楼主你好,跟着帖子参数复现了一轮,prefill 全中,decode 差得远,想请教几点
我这边:同款 r3 镜像、NVFP4 权重(容器内 quant_method: compressed-tensors)、TP=1、ctx 204800、chunk 4096、seqs 1、thinking ON、260W。启动参数逐项对过,真差异只有 port。
prefill 0.8K / 12K / 48K
• 帖子: 2.4k / 3.36k / 3.0k
• 我实测: 2994 / 3353 / 3029decode 加权
• 帖子: 154
• 我实测: 120.09(median 131.09)prefill 三个深度全中。decode 差 -22%。
-
154 怎么量的? 你 prefill 那边提过「vLLM 只报 10 秒窗口均值,不能当 pp」,所以自己写了脚本。decode 是不是也用了自写脚本?corpus、max_tokens、有原始 JSON 吗?
-
thinking ON 还是 OFF 量的? 你给的参数是 enable_thinking:true,但我这边 thinking ON 时有 57.5%(92/160)的 run 在答案开始前就撞 max_tokens 被截断,量到的是 thinking 段速度。同配置关掉 thinking 反而有 141.34。你量 154 时怎么处理的?
-
154 是 200K 档实测,还是引用官方 65K 档? 官方 9/20 candidate 在 thinking:false 下是 154.42,和你只差 0.3%。
-
250W 怎么设的? 命令里没看到功耗设置,宿主侧还是容器内?
-
draft_sample_method:你写 greedy,但我这边日志显示实际是 probabilistic(镜像内置 env 覆盖了 flag)。你量 154 时是哪个?
有原始结果文件的话我可以直接拿来对照,先谢过。
-
-
-
-
-
-
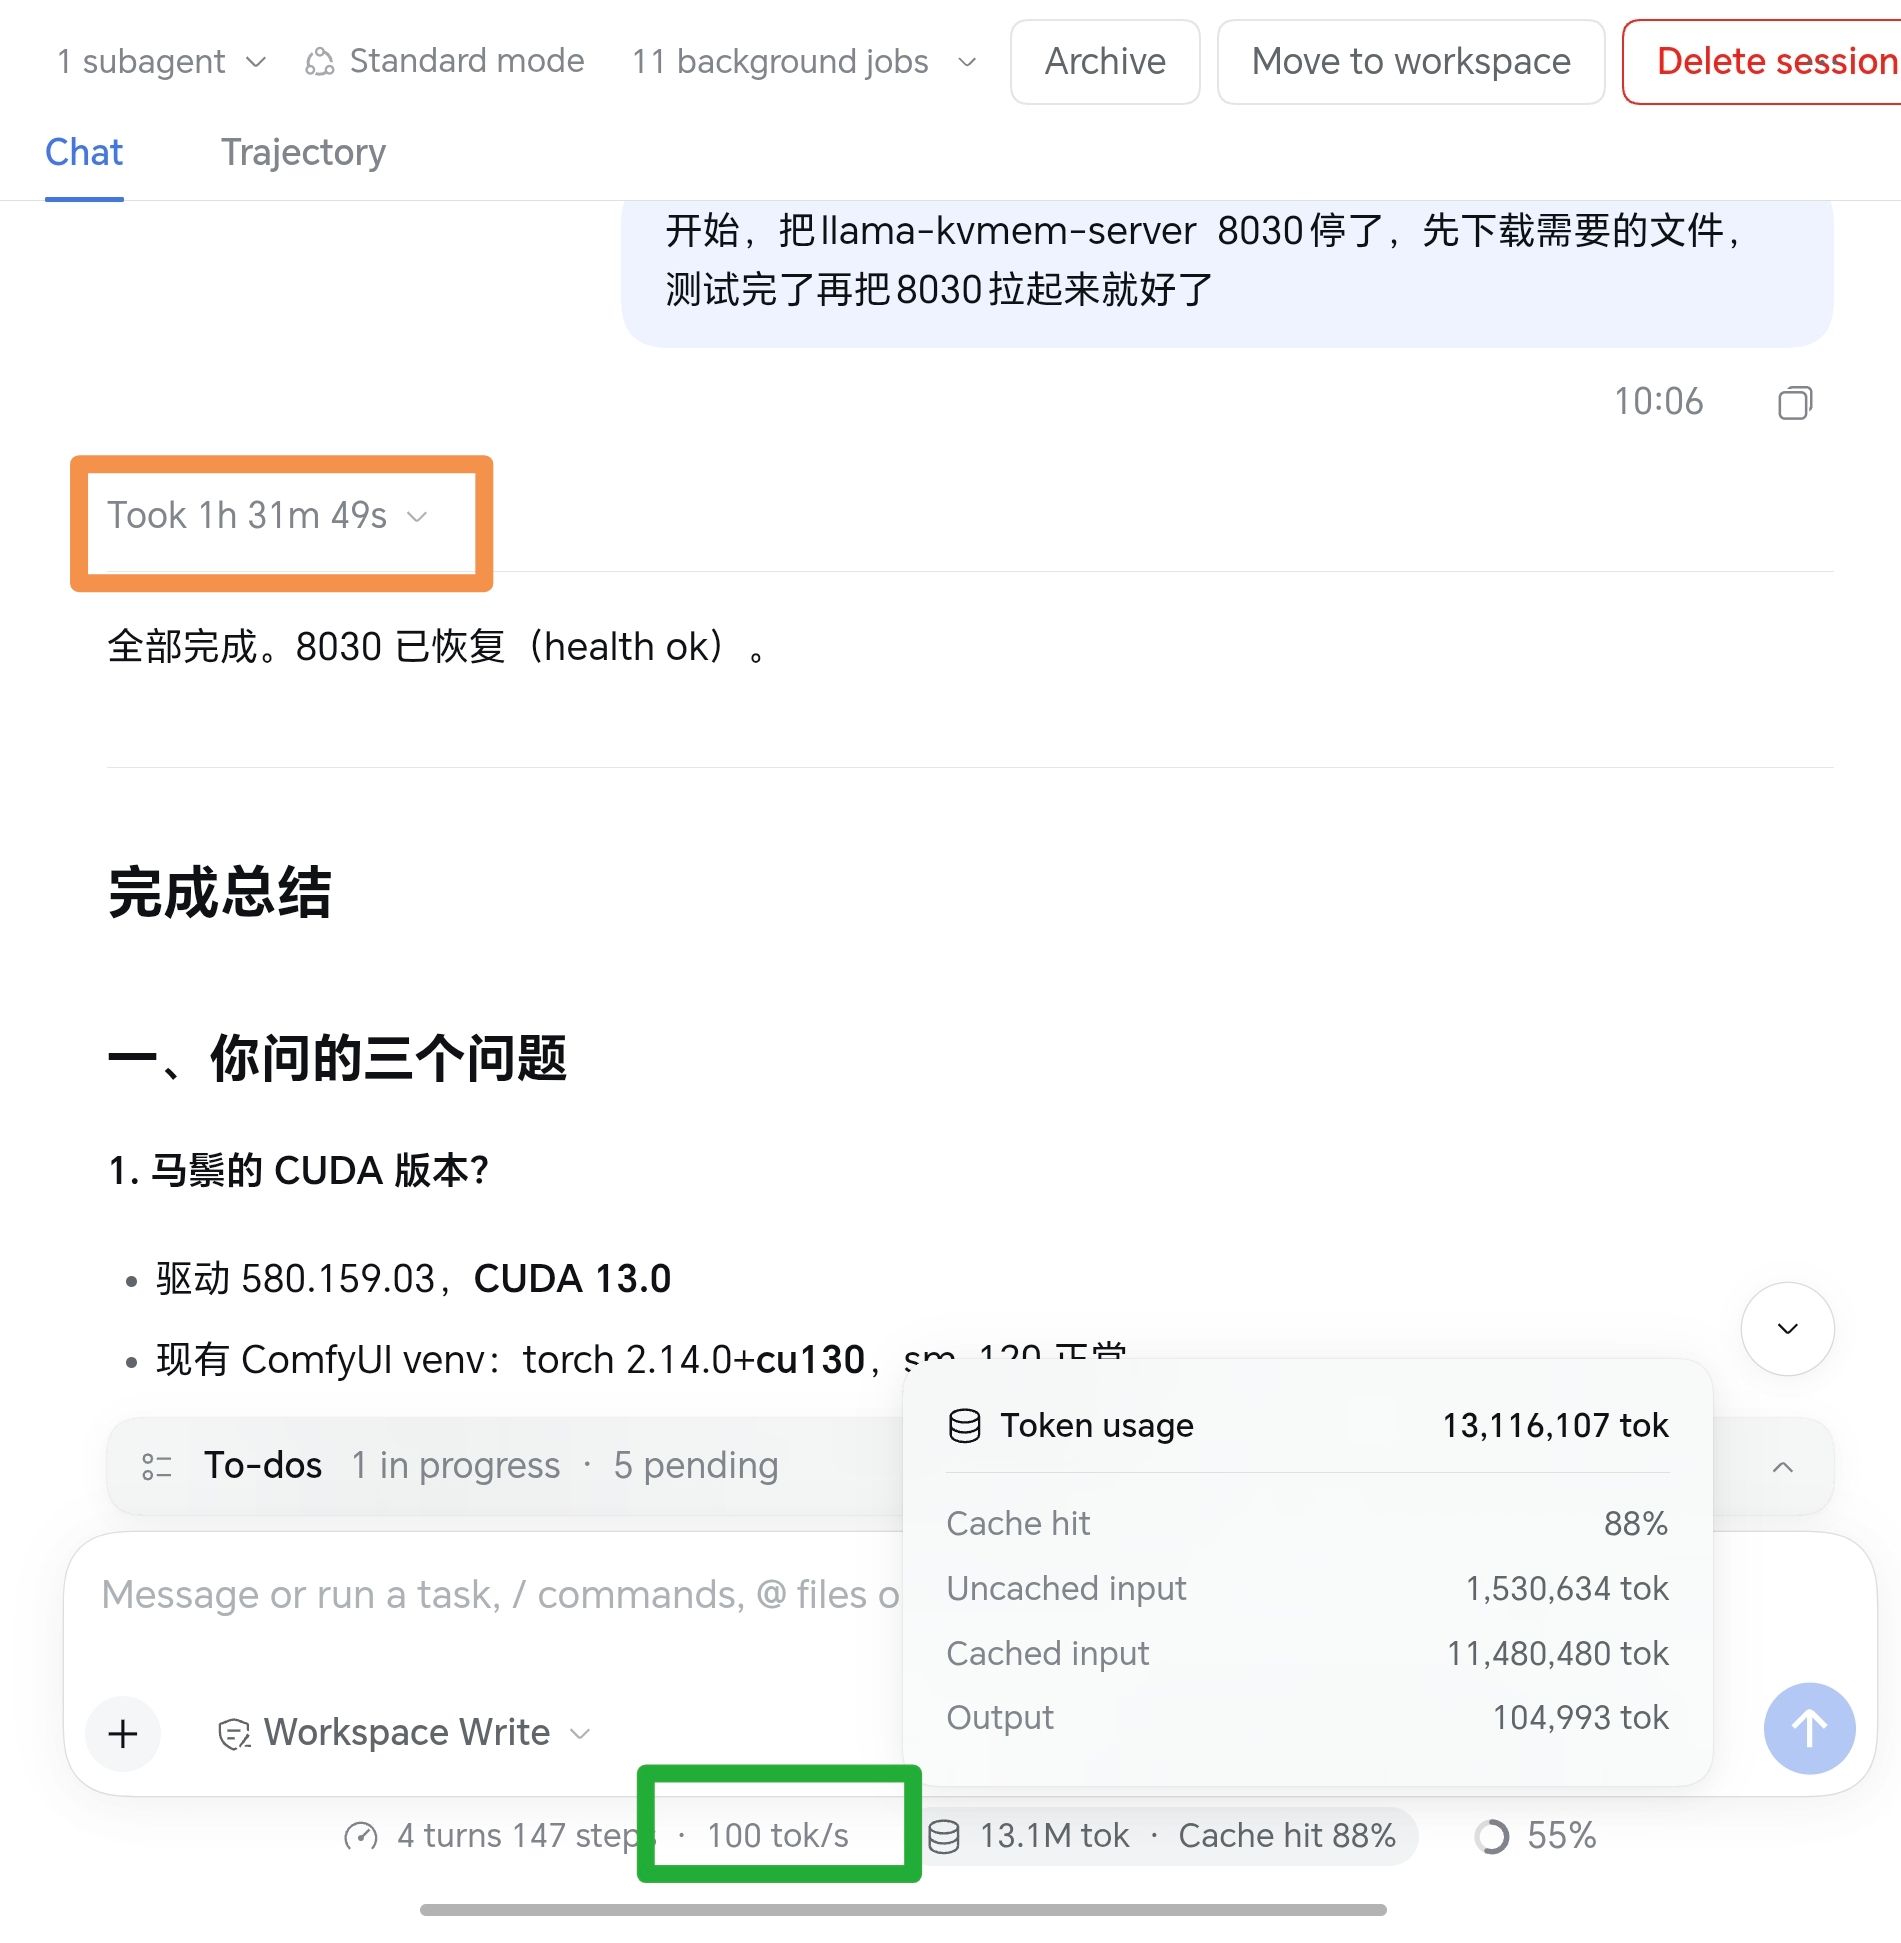
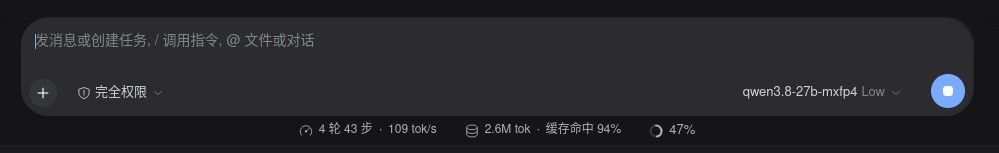
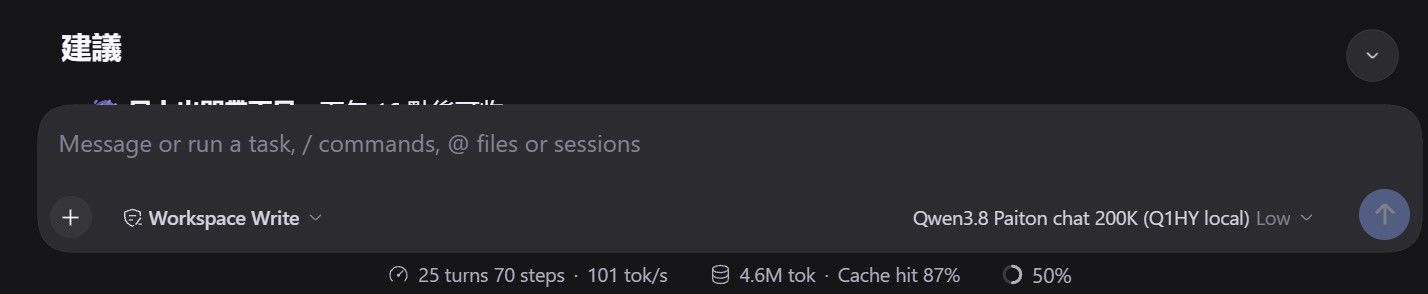
@fcme 了解,dsh 使用上来也是 100 tg/s 来的样子
-
-
-
-
,
 F fcme 引用了 此主题