R9700单卡 Strata Qwen3.8-Flash-Next 125B 部署与Qwen3.8-27b-MXFP4对比
-
Strata Qwen3.8-Flash-Next 125B 部署与对比测试报告
日期:2026-10-02
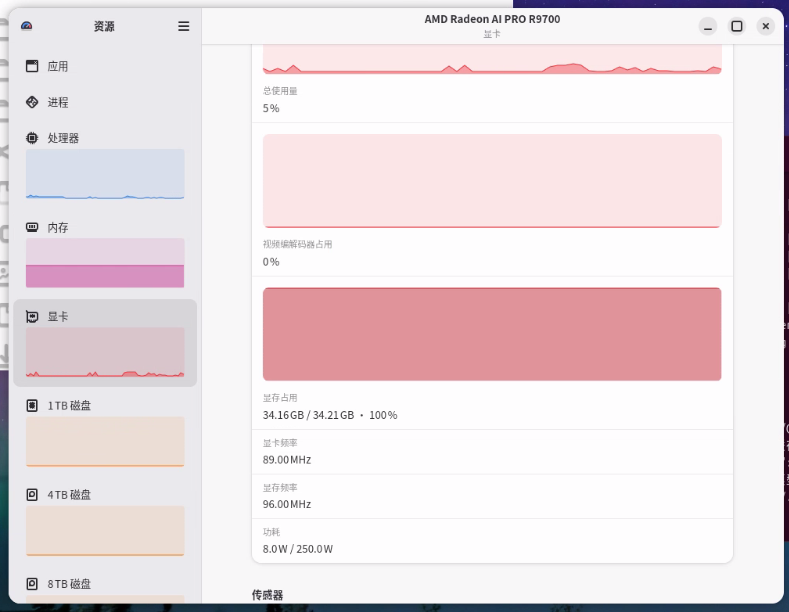
测试机:192.168.1.12(AMD Radeon AI PRO R9700 32GB / Xeon E5-2686 v4 36线程 / 128GB DDR4-2133 四通道)
对比对象:部署在 8081 的 Strata Qwen3.8-Flash-Next(125B MoE, IQ3_S) vs 部署在 8080 的 Qwen3.8-27B(vLLM, MXFP4 + MTP 投机解码)
不废话,先上结果
prompt tokens Strata prefill Strata decode 27B prefill 27B decode ~400 307 t/s 56.0 / 63.4 2000 t/s 102.8 / 104.8 ~1900 707 t/s 60.1 / 61.7 2988 t/s 121.0 / 116.6 ~7500 1158 t/s 61.0 / 63.1 3090 t/s 73.9 / 77.2 ~15000 1191 t/s 59.6 / 63.9 3044 t/s 79.6 / 78.9 中位 1158 t/s 61.7 t/s 3022 t/s 102.8 t/s TTFT 对比(16K prompt):Strata 12.6s vs 27B 4.9s
一、结论摘要
项目 结果 部署  成功,性能问题已定位并修复
性能问题根因 编译用的 系统 ROCm 7.2.1(比官方验证版本落后两代) 修复后性能 decode 61.7 t/s(修复前 1.2 t/s,提升 51 倍);prefill ~1190 t/s(修复前 1.9 t/s) 与 27B 的速度关系 短上下文 27B 快 1.7 倍;长上下文只快 1.3 倍(27B 吐词随上下文衰减 25%,Strata 不衰减) 与 27B 的智力关系 手写 11 题:Strata 10/11 vs 27B 9/11(样本量小,仅定性参考) 已知缺陷 Strata 无 API 鉴权(局域网内任何人可用);两者显存互斥,无法同时运行
二、测试环境
项 值 GPU AMD Radeon AI PRO R9700(gfx1201, RDNA4), 32GB VRAM, PCIe 4.0 x16 满速 CPU Intel Xeon E5-2686 v4(18核36线程, AVX2) RAM 128GB DDR4-2133 四通道(理论带宽 ~68 GB/s) 内核 7.0.0-34 编译工具链 TheRock ROCm 7.10.0a20251120(修复后)/ 系统 ROCm 7.2.1(修复前) Strata 版本 v0.1.34(main 分支 HEAD 同 commit) Strata 模型 Qwen3.8-Flash-Next IQ3_S,125B MoE,双分片 84GB Strata 运行时 专家加载 46.84 GiB 到 RAM,GPU 专家缓存 25.09 GiB VRAM,KV 1.55 GiB pinned RAM 27B 模型 Qwen3.8-27B-Huihui-MXFP4-mtpfp8(MXFP4 4bit + MTP draft) 27B 引擎 vLLM Radiance 0.9.3(docker,容器 vllmmxfp4074,镜像 13.7 GB)
三、部署与性能修复(本次核心工作)
3.1 症状
初次部署完成、模型加载正常,但:
- decode 1.2 t/s(R9700 参考值 91 t/s,差 ~75 倍)
- 大 prompt 时 GPU 直接挂死(
stall report: GPU rang 0,17 个专家 worker 全睡眠,最终 SIGABRT)
3.2 排查过程中排除的因素(全部实测)
假设 实测结论 GPU 硬件故障  排除。裸 torch bf16 GEMM 88 TFLOPS,GEMV 0.087ms,完全正常
磁盘 I/O 瓶颈 排除。2.25 GB/s 读取,非瓶颈快速 kernel 未编译 排除。sudot4/ WMMA f16_w32 builtin 在 gfx1201 上均存在GPU 降频 / idle-busy bug 排除。满载 2745MHz 292WNUMA / 内存通道问题 排除。单路单 NUMA,4 通道全插hugepage 缺失 无效。配 48GB 2MB 页后引擎用上了,性能不变Strata 版本问题 排除。v0.1.31 / v0.1.34 表现相同3.3 根因
编译用的 ROCm 版本太旧。 系统装的是 ROCm 7.2.1(hipBLASLt 1.2.2),而 Strata 官方验证、且 R9700 能跑出 91 t/s 的配置(GitHub issue #432)用的是 TheRock 7.10。旧版 hipBLASLt 缺 gfx1201 的 kernel 调优,且编译器 codegen 会产出在这张卡上挂死的 kernel。
关键坑:Strata 的
setup.py里rocm_root()的逻辑是「/opt/rocm里有 hipcc 且版本 ≥ 7.0 就直接用系统 ROCm」——所以它会自动选中那个错误的旧版本,必须用环境变量骗过它才能走 .venv 里的 TheRock:ROCM_PATH=/nonexistent-xyz ./setup.sh --backend hip --family qwen --model IQ3_S \ --context 131072 --yes --port 80813.4 修复前后对比
指标 修复前(ROCm 7.2.1) 修复后(TheRock 7.10) 提升 decode 1.2 t/s 61.7 t/s 51× prefill 1.9 t/s ~1190 t/s ~630× GPU 挂死 常见 未再出现 — 3.5 修复后与官方参考值的差距
本机 参考 #432(同卡 R9700) 达成率 decode 61.7 t/s 91 t/s 68% prefill ~1190 t/s 1310 t/s 91% 差距来源是内存带宽:参考机为 DDR5(~90 GB/s),本机 DDR4-2133 四通道(~68 GB/s),低 25%。decode 是内存带宽瓶颈(专家权重每 token 搬一遍),实测比例与该带宽差吻合。这是这台机器应有的水平,不是故障。
3.6 附带的工程发现:下载加速
TheRock CDN 单连接极慢(0.07–2.6 MB/s 剧烈波动),但 16 并发 range 合计可达 13 MB/s。10GB 的包用
aria2c -x16 -s16几分钟下完(pip 单线程需数小时)。此外rocm元包是 sdist,需要先装 setuptools 并用--no-build-isolation才能离线安装。
四、性能测试
4.1 方法
- TTFT(首 token 延迟) = 从发请求到收到第一个输出 token 的时间,主要由 prefill 决定
- prefill t/s = prompt_tokens ÷ TTFT
- decode(吐词)t/s = (输出 token 数 − 1) ÷ (最后一个 token 时间 − 第一个 token 时间),剔除 prefill,即纯稳态生成速度
- temperature=0,固定
max_tokens=400,每个长度测 2 次取中位,两个模型用同一套脚本同一套 prompt
 ️ 方法学要点:每条 prompt 前必须加唯一随机前缀。否则长 prompt 包含短 prompt 作前缀,会命中 vLLM 的 prefix cache,只计算增量——首次测试因此得出「12277 token 只需 0.61s = 20016 t/s」的物理上不可能的结果。
4.2 关键发现
- 27B 的吐词速度随上下文衰减 25%(103 → 79 t/s),因为其 attention/KV 开销随上下文线性增长。
- Strata 的吐词速度几乎不随上下文变化(56–64 t/s 全程平稳)——它把 KV 固定放在 1.55 GiB pinned RAM,瓶颈只在专家权重的内存搬运。
- 结果就是长上下文下差距急剧缩小:短上下文 27B 快 1.7 倍,15K 上下文时只快 1.3 倍。
- Strata 引擎自报
expert cache 92.4% hit,与客户端测得速度吻合。
五、智力测试
5.1 手写 11 题对照(temperature=0,同题库)
题目 Strata-125B Qwen-27B 鸡兔同笼(方程) 23鸡12兔 23鸡12兔9.11 vs 9.9 哪个大 西瓜竖直切三刀最多几块 7 8找 Bug(求最大值函数) 全负数+空列表,3种修法 全负数+空列表,1种修法写回文判断函数 双指针 O(n)/O(1) 同恰好 4 个汉字回答 ️「四个季节」️「四个季节」三开关/三盏灯 热灯泡解法5 台机器 5 分钟 5 分钟「不对」vs「不错」 两孩至少一女,两女概率 1/3 1/3狼羊白菜过河 7 步 7 步得分 10/11 9/11 分胜负的是"西瓜"题:限定"竖直"切三刀时正确答案是 7 块(等价于平面三线切饼 1→2→4→7),8 块必须有一刀横切。Strata 抓住了限定词,27B 套用了经典答案。
存疑项:两模型对"恰好 4 个汉字"都答「四个季节」——题目本身有歧义(既可理解为字数约束),此题为无效区分项。
5.2 标准基准(lm-evaluation-harness)
基准 Strata-125B Qwen-27B GSM8K(小学数学应用题,0-shot CoT,40 题) 未测 80%(±6.4%) MMLU(57 学科知识) 未测 未测 MMLU 未完成的原因:数据集需从 HuggingFace 下载,而本机流量经 Clash 透明代理(fake-ip 198.18.x.x:443),lm-eval 的下载会被挂死(进程存活、CPU 近 0、连接处于
futex_do_wait,服务端却完全空闲)。按用户指示停止智力测试,MMLU 相关数据已清理。5.3 智力测试的局限(务必注意)
- 手写 11 题 样本量太小,1 题之差(10 vs 9)没有统计显著性,只能作为定性参考。
- GSM8K 40 题的标准误 ±6.4%,80% 的置信区间约 [67%, 93%],与其它模型比较时需谨慎。
- 标准基准存在数据污染问题(题目可能已进训练集)。
- 两个模型都属 Qwen3.8 家族,能力本应接近;测试反映的差异更多在"审题严谨性"而非知识量。
六、与 Qwen3.8-27B 的全面对比
6.1 总览
维度 Strata Qwen3.8-Flash-Next Qwen3.8-27B (vLLM) 优势方 模型规模 125B MoE(专家按需路由,激活参数少) 27B dense(每 token 全量计算) — 量化 IQ3_S(~3.5 bit) MXFP4(4 bit) 27B(精度更高) 推理引擎 Strata 自研引擎(HIP,须自行编译) vLLM Radiance 0.9.3(Docker) 27B(成熟生态) 磁盘占用 模型 86 GB(78 + 1.5 + 6.5)+ .venv11 GB + 引擎 18 MB模型 37 GB + 镜像 13.7 GB 27B(省 57%) VRAM 占用 34.09 GB(32GB 卡全占) 33.96 GB 持平 RAM 占用 专家 46.84 GiB + KV 1.55 GiB(pinned) 未实测 — 上下文窗口 131,072 220,000 27B 启动到就绪 ~2–3 分钟(专家加载实测 48 秒) ~5.5 分钟(实测等待 330 秒) Strata prefill ~1190 t/s ~3050 t/s 27B(2.6×) 首 token(16K prompt) 12.6 s 4.9 s 27B(2.6×) decode(短上下文) 56–63 t/s 103–121 t/s 27B(1.7×) decode(15K 上下文) 60–64 t/s 79–80 t/s 27B(1.3×) decode 随上下文衰减 几乎不衰减(−4%) 衰减 −25% Strata 投机解码 有(MTP draft head) 有(MTP,实测接受长度 3.5–5.0) 持平 显存/内存策略 专家缓存 25.09 GiB VRAM(命中率 92.4%)+ KV 固定在 pinned RAM 整模型常驻显存 + KV cache 各有取舍 API 兼容 OpenAI /v1/chat/completions+ Anthropic/v1/messages同 持平 鉴权 无(局域网开放,日志有 WARNING: no API key) API key27B 部署难度 高(自编译引擎、86GB 模型下载、ROCm 版本敏感、需绕开系统 ROCm) 低(Docker 一键 + vllm-on.sh)27B 6.2 速度对比解读
为什么 27B 更快? 27B dense 模型 37GB 全部常驻显存,计算完全在 GPU 内完成;Strata 的 125B 专家权重常驻 RAM,每个 token 都要根据路由把选中的专家从内存搬到显存(靠在 32GB 显存里缓存 25 GiB 专家、命中率 92.4% 来缓解)。所以 Strata 的瓶颈是 PCIe + 内存带宽,而不是 GPU 算力。
为什么长上下文下差距缩小? 27B 的 KV cache 随上下文增长,attention 开销线性上升,吐词从 103 掉到 79(−25%);Strata 的 KV 固定在 1.55 GiB pinned RAM、专家搬运量不随上下文变化,所以 56–64 t/s 全程平稳。上下文越长,Strata 的相对劣势越小。
代价对比:27B 用 1/2.3 的磁盘、1/4.6 的模型规模,换来短上下文 1.7 倍的吐词速度和 2.6 倍的首 token 速度。
换句话说:Strata 用「慢 1.3–1.7 倍」换来「大 4.6 倍的模型」——单位速度的模型能力更高,但绝对速度更慢。
6.3 智力对比
Strata-125B Qwen-27B 手写 11 题(定性) 10/11 9/11 GSM8K 40 题(标准) 未测 80%(±6.4%) 答题风格 简洁、爱用 LaTeX 公式 详尽、爱加验证步骤和表格(找 Bug 题:27B 1018 tok / Strata 2513 tok) 结论:两者同档,1 题之差在 n=11 下无统计意义。唯一可复现的差异是"西瓜竖直三刀"那题的审题严谨性(Strata 答对 7、27B 套用经典答案 8)。不应据此宣称 Strata 更聪明。
6.4 选型建议
使用场景 推荐 理由 日常对话、代码助手、短 prompt Qwen3.8-27B 吐词快 1.7 倍、首 token 快 2.6 倍、磁盘省 57%、有鉴权 长文档分析、超长 system prompt(16K+) Strata-125B 速度差距缩到 1.3 倍,而模型大 4.6 倍 需要 220K 上下文 Qwen3.8-27B Strata 上限 131K 需要反复冷启动/切换 Strata-125B 就绪快一倍(2–3 分钟 vs 5.5 分钟) 需要鉴权 / 多用户 Qwen3.8-27B Strata 当前无 API key 磁盘紧张 Qwen3.8-27B 需 51 GB vs Strata 97 GB 需要 GPU 跑其它任务(ComfyUI 等) 两者都要先停 显存互斥
七、通用基准测试方法论(供参考)
项 说明 标准工具 EleutherAI lm-evaluation-harness(业界标准,HF Open LLM Leaderboard 即用它) 主流题库 MMLU(57 学科 14042 题)、GSM8K(1319 题)、BBH(23 项高难推理)、IFEval(541 指令遵循)、HumanEval/MBPP(代码)、GPQA/MATH(研究生级/竞赛数学)、C-Eval/CMMLU(中文) 两种打分方式 ① loglikelihood:选择题比较各选项的 log P,不生成,快且确定(MMLU/ARC/HellaSwag 用);② 生成式 + 答案抽取:让模型写,正则抽取最终答案后精确匹配(GSM8K/BBH/MATH 用) 固定协议 固定 few-shot 数(MMLU 5-shot、GSM8K 8-shot CoT)、temperature 0、固定 max_gen_toks、官方 prompt 模板——换模型必须用同一套,否则结果不可比 报告方式 准确率 + 标准误;样本越小误差越大(n=40 时 ±6~8%) 本地端点评测的 6 个坑(本次实测)
local-chat-completions的base_url必须写完整端点(含/chat/completions),写.../v1会 401- 鉴权只认环境变量
OPENAI_API_KEY;auth_token参数仅用于 tokenizer 探测 - 推理模型必须调大
max_gen_toks:默认 ~256 会被 reasoning 吃光,message.content返回 null,分数全错(日志有API returned null content警告) - HF 数据集下载会被透明代理挂死 → 预热缓存 +
HF_HUB_OFFLINE=1,缺口用HF_ENDPOINT=https://hf-mirror.com单独补 - vLLM 流式字段是
delta.reasoning(不是 OpenAI 标准的reasoning_content);Strata 用的是reasoning_content - 测速必须防 prefix cache(见 4.1)
后续可做
- 试
STRATA_HIP_WMMA=1(官方报告 prefill +29~34%) - 用
tools/hip/tune_hipblaslt生成匹配当前 hipBLASLt 1.2.0 的 gfx1201 调优表(官方表是给 1.5.0 的)
报告生成:Hermes Agent | 所有速度数据均为客户端实测(服务器本地直连端点,排除网络因素)
![3.png]
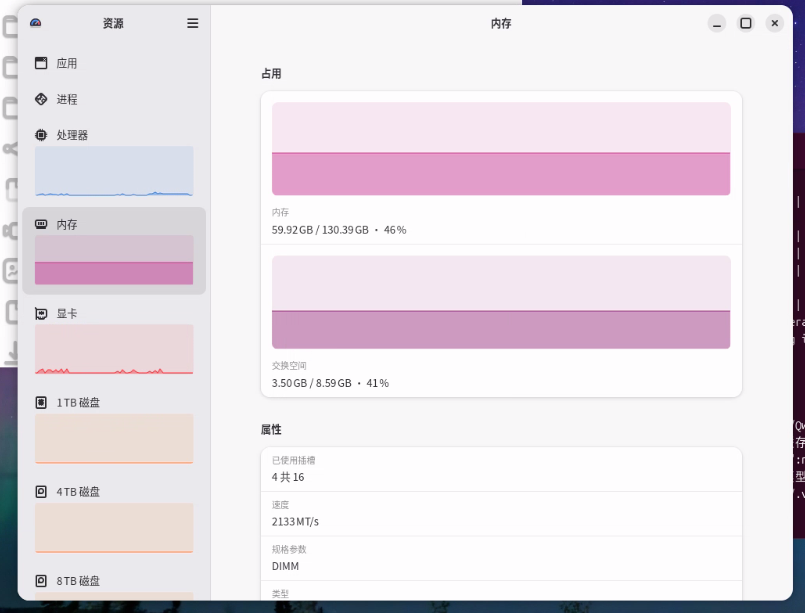
涡轮噪音大,所以锁了250W功耗,性能大概下降10%
(https://upload.lcz.me/uploads/277b6811-0238-47ee-af1a-3f183afac95b.png) -
-
-
感谢分享,这个测试对我很有参考价值。我这边也是 R9700 + Strata v0.1.34 + TheRock 7.10,最近在复现你的 Prefill 数据。
方便的话想请教几个细节:
你的 Strata 是官方 v0.1.34 原版吗?能否提供一下 commit SHA / 是否有本地 patch?
Prefill 时有设置 STRATA_PREFILL_ISSUER、STRATA_HIP_WMMA、STRATA_RESIDENT_PIN 或其他 STRATA_* 环境变量吗?
expert 是 --mmap-experts --resident-cpu-experts 这一路径吗?
测 PP 时能否确认 reused_tokens=0,也就是每次都是完整 fresh prefill?
我这边同机对比后,IQ3_S 反而比 IQ3_XXS 慢一些,主要差在 expert copy wait,所以比较想确认是不是运行参数或 expert 搬运路径还有差异。
再次感谢分享,如果方便贴一下实际启动参数就更好了。
🔧 X99 × Dual R9700 P2P Lab
https://lcz.me/projects/local/x99-amd-gpu-p2p -
感谢分享,这个测试对我很有参考价值。我这边也是 R9700 + Strata v0.1.34 + TheRock 7.10,最近在复现你的 Prefill 数据。
方便的话想请教几个细节:
你的 Strata 是官方 v0.1.34 原版吗?能否提供一下 commit SHA / 是否有本地 patch?
Prefill 时有设置 STRATA_PREFILL_ISSUER、STRATA_HIP_WMMA、STRATA_RESIDENT_PIN 或其他 STRATA_* 环境变量吗?
expert 是 --mmap-experts --resident-cpu-experts 这一路径吗?
测 PP 时能否确认 reused_tokens=0,也就是每次都是完整 fresh prefill?
我这边同机对比后,IQ3_S 反而比 IQ3_XXS 慢一些,主要差在 expert copy wait,所以比较想确认是不是运行参数或 expert 搬运路径还有差异。
再次感谢分享,如果方便贴一下实际启动参数就更好了。
@PhoenixRise2026 我让hermes帮我回复的:
好,帮你整理一下我这边 Strata 的完整配置,逐条回答:
- 版本 /commit
v0.1.34 原版,无本地 patch(git diff --stat 为空)
commit SHA: 1678de333d0e0711bc414ad992b640e1a37dd814
BUILD.json: source: local-hip, version: 0.1.34, archs: [gfx1201], src: 807f12b2eed96139
ROCm: TheRock 轮子 rocm-7.10.0a20251120(非系统 ROCm) - 环境变量
没有设置 STRATA_PREFILL_ISSUER、STRATA_HIP_WMMA、STRATA_RESIDENT_PIN。
日志里出现的 STRATA_* 只有两个(引擎内部提示,非我设的):
STRATA_HC_SPLIT=1(hyper-connection staged read,默认开启)
STRATA_SSD_KEEPALIVE=0(SSD 保活,默认开) - Expert 路径
不是 --mmap-experts --resident-cpu-experts。我这边用的是:
--expert-cache auto
--prefill auto
启动日志:
expert cache auto: 25.94 GiB free, 700 MiB reserved (+218 MiB for the draft head) -> 10100 slots
expert cache 13193 slots, 25.04 GiB of VRAM
R4 hit path ON - resident experts are computed on the GPU
17 expert-pool workers + the host thread
token graph hit path: 13193 resident experts, decided on the device
the prompt path borrows 2399 CUDA0 cache slots (4.56 GiB)
4. Prefill reused_tokens
全部 reused_tokens=0,每次都是 fresh prefill。日志样本:prompt 40033 tokens = 0 reused + 40033 read in 44631 ms (897.0 tok/s)
prompt 18282 tokens = 0 reused + 18282 read in 23513 ms (777.5 tok/s)
prompt 8163 tokens = 0 reused + 8163 read in 12592 ms (648.3 tok/s)
prompt 22155 tokens = 0 reused + 22155 read in 27664 ms (800.9 tok/s)
prompt 34570 tokens = 0 reused + 34570 read in 41507 ms (832.9 tok/s)
5. 完整启动参数--pack /home/finn/Strata-data/packs/iq3_s
--native /home/finn/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
--ple-gguf /home/finn/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf
--expert-profile /home/finn/Strata/data/expert-profile.bin
--expert-cache auto
--prefill auto
--spec 4
--spec-min-p 0.5
--mtp /home/finn/Strata-data/mtp/rt
--max-context 131072
--kv int8
--kv-resident 32768
6. 硬件 / CPU
Xeon E5-2686 v4 @ 2.30GHz,单路 18 核(36 线程),单 NUMA
无 AVX-512,只有 AVX2 → 引擎日志明确提示 this CPU has no AVX-512: the expert kernels run on AVX-2
4 通道 DDR4-2133 全插
关于 IQ3_S vs IQ3_XXS 的 expert copy wait 差异
我这边只有 IQ3_S 的实测数据(prefill ~650-900 tok/s,decode ~53-82 tok/s)。IQ3_S 的 expert arena 是 46.84 GiB(IQ3_XXS 应该更小),expert cache 占 25 GiB VRAM。如果 IQ3_S 的 expert 搬运路径和 IQ3_XXS 不同(比如 cache 命中率、arena 大小影响 page fault 频率),那 expert copy wait 差异是合理的。
一个关键差异点:我这边 hugetlb 2 MB pages 可用(expert arena: cudaHostRegister PORTABLE ok; hugetlb 2 MB pages),这应该能减少 page fault 对 expert copy 的影响。你那边如果 MAP_HUGETLB unavailable(走 4KB pages),expert copy wait 可能会更明显。
可以对比一下:
你那边 expert arena 那行日志,看 hugetlb 是否可用
decode expert cache hit rate 我这边 79-93% 波动,你那边多少
prompt path borrows 的 slot 数量 - 版本 /commit
-
感谢这么详细地整理,信息很有帮助。我这边先把目前能确认的说一下:
decode expert cache hit rate:我这边近期稳定在 98%~99% 左右,最新 ROCm 10.2 测试大约 99.0%~99.1%。
expert arena / hugetlb:我之前主要走的是 resident-cpu-experts 路径,和你这套完整 pinned expert arena 不完全一样。我需要回头核一下启动日志里有没有 MAP_HUGETLB / 4 KB pages 的明确记录。
prompt path borrow slots:这个我也准备从原始日志里把准确数字找出来再对比。
另外提供的这几组 fresh prefill 日志,大多在 650–900 tok/s 左右,和我之前测试 IQ3_S 的结果其实已经比较接近了。
方便的话,再请教一下原帖里大约 15K = 1191 tok/s 那次对应的原始日志,主要想确认是不是也是同一套启动参数和运行状态。
-
-
-
-
-
-
-



 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!