跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. 买了2张5060Ti,谁能跑最便宜的Qwen 27B?

买了2张5060Ti,谁能跑最便宜的Qwen 27B?

已定时 已固定 已锁定 已移动 热议 AI硬件
qwen-27brtx5060
54 帖子 19 发布者 4.6k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    超凡大师
    发表于 最后由 编辑
    #42

    MTP TG 50 t/s , 這MTP 為這個Dual RTX 5060 Ti 16 GB 組合增高了不少實用價值, 假如我都還沒買顯卡 試試6張 RTX 5060 Ti 16GB 組成 96GB VRAM 組 (用Workstation 主機板 6 x PCIe 4.0 x 16 lanes , 通訊速度 32 GB/s) 做Tensor Parallelism 張量並行 不知道TG 表現如何 ?

    1 条回复 最后回复
    0
    • kos orK
      kos orK
      kos or
      超凡大师
      发表于 最后由 kos or 编辑
      #43

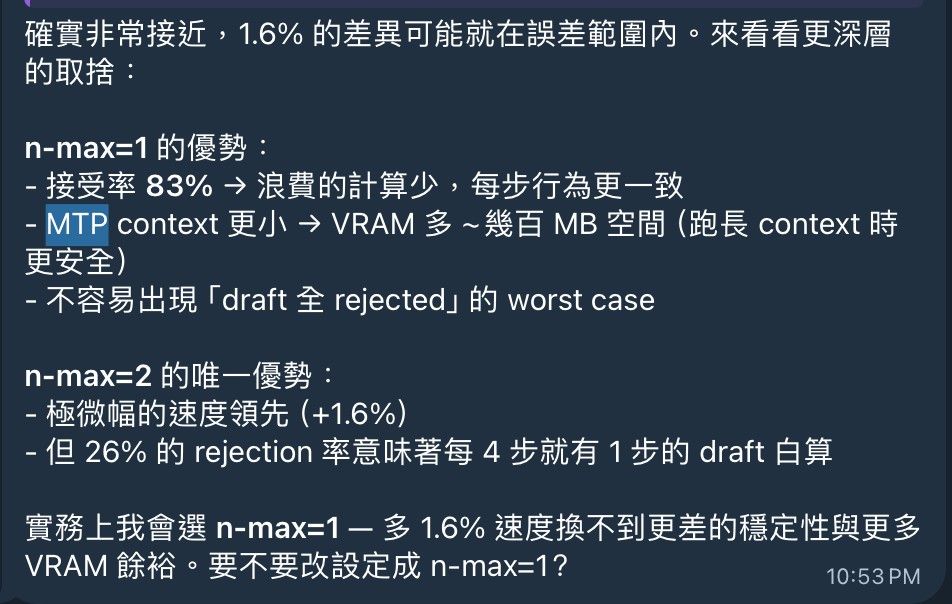
      MTP 版本需要設一個參數 Draft tokens (num_speculative_tokens or spec-draft-n-max): AI 幫我測試過 最後1 或 2 是最快的參數, 你也是設定1 或 2 嗎?2 速度只比1 快了3 tokens /s 但是它有一個"準確度" 降了很多(浪費算力) 我跟AI都認同Qwen3.6-27B-MTP-GGUF 最後選擇1 是最佳MTP參數
      4e3f6ade-72fb-4f1b-9501-9638d9e78d57-image.jpeg

      AresROCA 1 条回复 最后回复
      0
      • C comeN

        双5060TI 16G跑英伟达专门为50显卡优化的Qwen3.6-27B-NVFP4-MTP的表现比双3080-20G还好,NVFP4的优化号称无损Q4,速度40-70T,论坛里面有人发的。

        kos orK
        kos orK
        kos or
        超凡大师
        发表于 最后由 kos or 编辑
        #44

        @comeN 不知道還有這個版本 我請AI幫我測試一下 Qwen3.6-27B-NVFP4-MTP (目前狀態:一早起來Deepseek V4 Flash 給我下載一個 90GB的TesnorRT-LLM, 現在又說這太大了 要刪除 幫我安裝一個20GB版本的TensorRT來跑測試 哈哈 暈了)

        1 条回复 最后回复
        0
        • C
          C
          comeN
          发表于 最后由 编辑
          #45

          NVFP4号称不是无损,但损失小到感知不到,几乎等同于FP16,这可比Q4强不少。

          1 条回复 最后回复
          0
          • kos orK kos or

            MTP 版本需要設一個參數 Draft tokens (num_speculative_tokens or spec-draft-n-max): AI 幫我測試過 最後1 或 2 是最快的參數, 你也是設定1 或 2 嗎?2 速度只比1 快了3 tokens /s 但是它有一個"準確度" 降了很多(浪費算力) 我跟AI都認同Qwen3.6-27B-MTP-GGUF 最後選擇1 是最佳MTP參數

            4e3f6ade-72fb-4f1b-9501-9638d9e78d57-image.jpeg

            AresROCA
            AresROCA
            AresROC
            德高望重
            发表于 最后由 AresROC 编辑
            #46

            @kos-or 上面试的都是MTP=3。目前在研究FP4 & 升级CUDA 13.2,13.3。

            1 条回复 最后回复
            0
            • kos orK
              kos orK
              kos or
              超凡大师
              发表于 最后由 编辑
              #47

              我用的是llama.cpp + Ubuntu + 2 x RTX5070 Ti in PP 來跑同樣一個模型, 最佳MTP draft-n 設定居然會不同 有趣了

              1 条回复 最后回复
              0
              • johnnybegoodJ johnnybegood 于 引用了 此主题
              • AresROCA
                AresROCA
                AresROC
                德高望重
                编写于 最后由 AresROC 编辑
                #48

                电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.

                Model
                qwen3.8-flash-next-iq3_s
                Engine
                v0.1.33
                Context
                32,768 tokens
                KV cache
                8-bit, all in VRAM
                Experts in VRAM
                10,268 (19.4 GB)
                Speculation
                MTP drafts up to 3 tokens, prompt lookup on
                Images
                off

                terryT 1 条回复 最后回复
                2
                • AresROCA AresROC

                  电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.

                  Model
                  qwen3.8-flash-next-iq3_s
                  Engine
                  v0.1.33
                  Context
                  32,768 tokens
                  KV cache
                  8-bit, all in VRAM
                  Experts in VRAM
                  10,268 (19.4 GB)
                  Speculation
                  MTP drafts up to 3 tokens, prompt lookup on
                  Images
                  off

                  terryT
                  terryT
                  terry
                  超级版主
                  编写于 最后由 terry 编辑
                  #49

                  @AresROC 可以尝试下Strata,就等你补5060TI的作业了。单卡,双卡都来下。

                  油管:https://www.youtube.com/@抡锤者

                  1 条回复 最后回复
                  0
                  • kos orK
                    kos orK
                    kos or
                    超凡大师
                    编写于 最后由 编辑
                    #50

                    5060 Ti 16G C/P值很高 蠻需要這方面的數據

                    1 条回复 最后回复
                    1
                    • AresROCA
                      AresROCA
                      AresROC
                      德高望重
                      编写于 最后由 编辑
                      #51

                      https://lcz.me/post/22482

                      1 条回复 最后回复
                      0
                      • imbiplaza ASUSI
                        imbiplaza ASUSI
                        imbiplaza ASUS
                        谪仙人
                        编写于 最后由 编辑
                        #52

                        恭喜终于苦尽甘来。。。。。

                        AresROCA 1 条回复 最后回复
                        0
                        • imbiplaza ASUSI imbiplaza ASUS

                          恭喜终于苦尽甘来。。。。。

                          AresROCA
                          AresROCA
                          AresROC
                          德高望重
                          编写于 最后由 编辑
                          #53

                          @imbiplaza-ASUS

                          真的。但其实双卡Qwen3.6\3.8 27B 也是跑得很爽,而且可以同时多发。

                          1 条回复 最后回复
                          0
                          • terryT terry

                            @Vivid-Vector 牛逼啊兄弟,居然这么会玩,发个帖子说下你的2080Ti,我说2080Ti是垃圾之后,很多人不爽喷我,我想是不是我太武断了,你有信息分享下。跑大模型,ComfyUI实际体验,最好带图,让我坐一起视频,嘿嘿 🤤

                            rock shiR
                            rock shiR
                            rock shi
                            德高望重 劳动模范
                            编写于 最后由 编辑
                            #54

                            @terry 双2080 22g,共44g,ddr4 32g,qwen3.8 next Flash iq3_s,128k上下文,大约53t/s
                            整机价格6500左右,现在应该贵1000块了

                            主机:GPU0-3080 20g(H3),GPU1-3080 20g(Zimage)
                            副机:2x2080ti 22g,strata qwen3.8 next Flash iq3_s

                            1 条回复 最后回复
                            1

                            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                            有了你的建议,这篇帖子会更精彩哦 💗

                            注册 登录
                            回复
                            • 在新帖中回复
                            登录后回复
                            • 从旧到新
                            • 从新到旧
                            • 最多赞同


                            • 登录

                            • 登录或注册以进行搜索。
                            • 第一个帖子
                              最后一个帖子
                            0
                            • 版块
                            • 最新
                            • 标签
                            • 热门
                            • 用户
                            • 群组