跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. 买了2张5060Ti,谁能跑最便宜的Qwen 27B?

买了2张5060Ti,谁能跑最便宜的Qwen 27B?

已定时 已固定 已锁定 已移动 热议 AI硬件
qwen-27brtx5060
54 帖子 19 发布者 4.6k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • jianyuan zhangJ
    jianyuan zhangJ
    jianyuan zhang
    发表于 最后由 编辑
    #33

    @terry OK ,谢谢,马上处理掉

    1 条回复 最后回复
    0
    • Vivid VectorV Vivid Vector

      @Tide 限制显卡功率,同时给显存超频,测试一下稳定性。
      我用着2080Ti 22GB改水冷的,用Nvidia Inspector工具,把功率限制在200W~230W,核心超频+40Mhz(也可以不超核心),显存超频+1200Mhz,跑下来温度最高只有不到50°C,热点不超过65°C,室温27°C左右。
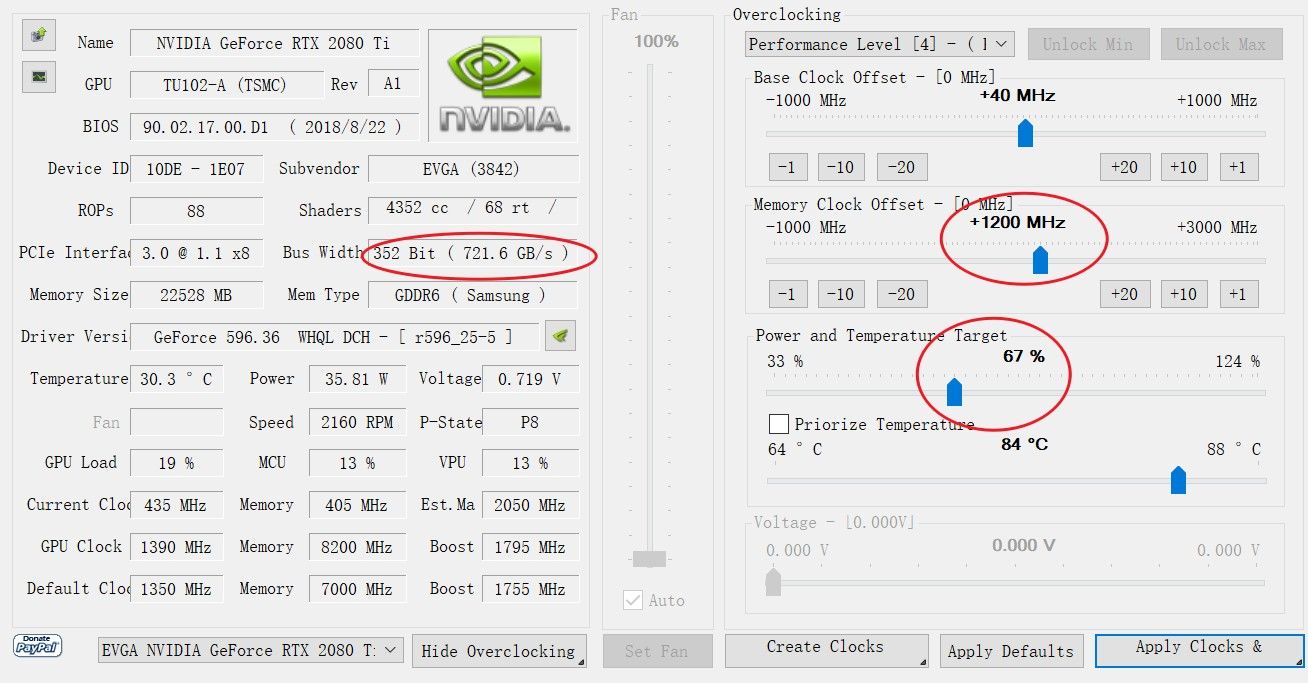
      c5e7bceb-5567-4c81-a8fe-141ef62f31cb-image.jpeg
      显存超频后带宽721.6GB/s,相比默认的616GB/s,提升超过17%,完美抵消限制功率导致的核心频率下降带来的性能损失,直接节约100W,33%的功率

      Qwen 27B Q4_K_M,上下文开32K跑下来,decode 25 tok/s

      用Llama.cpp benchmark跑分如图:
      全默认,显卡功率300W:

      651469fd-d0f4-49b3-9a39-0b9db73f5c9d-image.jpeg

      核心超频+40Mhz,显存超频+1200Mhz:
      2d1fcffb-c888-402a-a6bf-5634b04712d4-image.jpeg

      核心超频+40Mhz,显存超频+1200Mhz,显卡功率锁67%限制在200W:

      daa6d53a-0eef-4ffb-85ab-14ad9a2030a4-image.jpeg

      大语言模型主的矩阵运算要跑在GPU的Tensor Cores上,对GPU其他部分如大量的SM单元里的CUDA核心占用不高,GPU此时对功率的实际消耗并不需要太高。

      并且大语言模型prefill阶段对核心频率有一定依赖,但降频对prefill性能影响不太大。
      decode吐字阶段,对显存带宽的依赖程度大于核心算力,经常是显存带宽不足,喂不饱核心,核心有很多时间都在空转等数据。

      综上,你的3080可以尝试限制功率,并小超显存,给显卡背板加装散热铝片+风扇。
      然后实测看看数据。

      kos orK
      kos orK
      kos or
      超凡大师
      发表于 最后由 编辑
      #34

      @Vivid-Vector 你這調整的真是漂亮 謝謝分享

      1 条回复 最后回复
      0
      • 林小麟林 林小麟

        小白如果要即插即用,兩張5060TI 16G 插X99,用windows LMstudio,直接載QWEN3.6 27B Q4KM,KV Q8量化,可以拉到120k context,速度大概18token/s。以上是個人親測,屬於可用的程度。

        kos orK
        kos orK
        kos or
        超凡大师
        发表于 最后由 编辑
        #35

        @林小麟 说:

        兩張5060TI 16G 插X99,用windows LMstudio

        你這個組合真的是小白實用套件組 顯卡又有五年保固 : 兩張5060TI 16G + X99 + Windows LMstudio

        1 条回复 最后回复
        0
        • AresROCA
          AresROCA
          AresROC
          德高望重
          发表于 最后由 AresROC 编辑
          #36

          卡终于到货。等到天荒地老..。
          马上把双卡插进去,测试.

          历尽星霜岁月长, 天荒地老守3090。
          苍天有眼怜痴客, 5060Ti双剑合璧试锋芒!

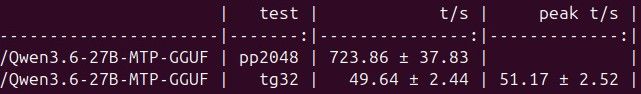
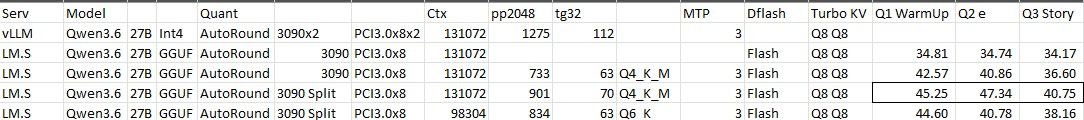
          觉得很可以用。用电少。不发热 ~ MTP TG 50 t/s

          891270d9-0751-4d66-8907-ec3165262110-image.jpeg

          通常可以跑到30 tk/s. 用 Q6_K Ctx 96k 比 Q4_K_M Ctx128k 还快.

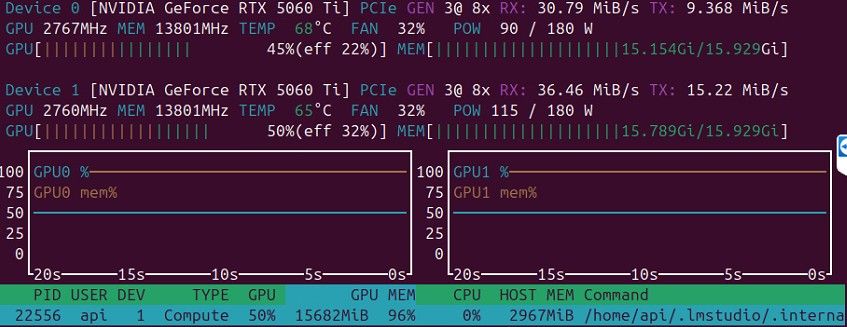
          LM Studio Split:
          3090:
          12e4e030-4fde-4f67-96cd-950aa8aa1cae-image.jpeg

          5060Ti:
          b4e37712-92d6-4e40-bb0d-da80a16c08c7-image.jpeg

          Q6_K 96k 显存几乎用满了d4dc9443-6724-40c9-8f79-31c1dc8c3777-image.jpeg

          terryT 1 条回复 最后回复
          2
          • AresROCA AresROC

            卡终于到货。等到天荒地老..。
            马上把双卡插进去,测试.

            历尽星霜岁月长, 天荒地老守3090。
            苍天有眼怜痴客, 5060Ti双剑合璧试锋芒!

            觉得很可以用。用电少。不发热 ~ MTP TG 50 t/s

            891270d9-0751-4d66-8907-ec3165262110-image.jpeg

            通常可以跑到30 tk/s. 用 Q6_K Ctx 96k 比 Q4_K_M Ctx128k 还快.

            LM Studio Split:
            3090:
            12e4e030-4fde-4f67-96cd-950aa8aa1cae-image.jpeg

            5060Ti:
            b4e37712-92d6-4e40-bb0d-da80a16c08c7-image.jpeg

            Q6_K 96k 显存几乎用满了d4dc9443-6724-40c9-8f79-31c1dc8c3777-image.jpeg

            terryT
            terryT
            terry
            超级版主
            发表于 最后由 编辑
            #37

            @AresROC 老铁单独发个帖子吧,流程讲清楚,写成Markdown格式,截图和数据放好,我给你来个置顶。

            油管:https://www.youtube.com/@抡锤者

            AresROCA 1 条回复 最后回复
            0
            • terryT terry

              @AresROC 老铁单独发个帖子吧,流程讲清楚,写成Markdown格式,截图和数据放好,我给你来个置顶。

              AresROCA
              AresROCA
              AresROC
              德高望重
              发表于 最后由 AresROC 编辑
              #38

              @terry 目前vllm Qwen3.6-27B 还是搞不定,假如成功的话再发 😬

              16+16=32GB 跑不了没有天理,
              最近LmStudio出了 TP, 假如可以跑我也想试试

              terryT 1 条回复 最后回复
              0
              • AresROCA AresROC

                @terry 目前vllm Qwen3.6-27B 还是搞不定,假如成功的话再发 😬

                16+16=32GB 跑不了没有天理,
                最近LmStudio出了 TP, 假如可以跑我也想试试

                terryT
                terryT
                terry
                超级版主
                发表于 最后由 编辑
                #39

                @AresROC 加油,等你交作业。

                油管:https://www.youtube.com/@抡锤者

                1 条回复 最后回复
                0
                • CHAO WANGC
                  CHAO WANGC
                  CHAO WANG
                  发表于 最后由 编辑
                  #40

                  我也想组双5060TI 16G,不知道什么效果

                  1 条回复 最后回复
                  0
                  • C
                    C
                    comeN
                    发表于 最后由 编辑
                    #41

                    双5060TI 16G跑英伟达专门为50显卡优化的Qwen3.6-27B-NVFP4-MTP的表现比双3080-20G还好,NVFP4的优化号称无损Q4,速度40-70T,论坛里面有人发的。

                    kos orK 1 条回复 最后回复
                    1
                    • kos orK
                      kos orK
                      kos or
                      超凡大师
                      发表于 最后由 编辑
                      #42

                      MTP TG 50 t/s , 這MTP 為這個Dual RTX 5060 Ti 16 GB 組合增高了不少實用價值, 假如我都還沒買顯卡 試試6張 RTX 5060 Ti 16GB 組成 96GB VRAM 組 (用Workstation 主機板 6 x PCIe 4.0 x 16 lanes , 通訊速度 32 GB/s) 做Tensor Parallelism 張量並行 不知道TG 表現如何 ?

                      1 条回复 最后回复
                      0
                      • kos orK
                        kos orK
                        kos or
                        超凡大师
                        发表于 最后由 kos or 编辑
                        #43

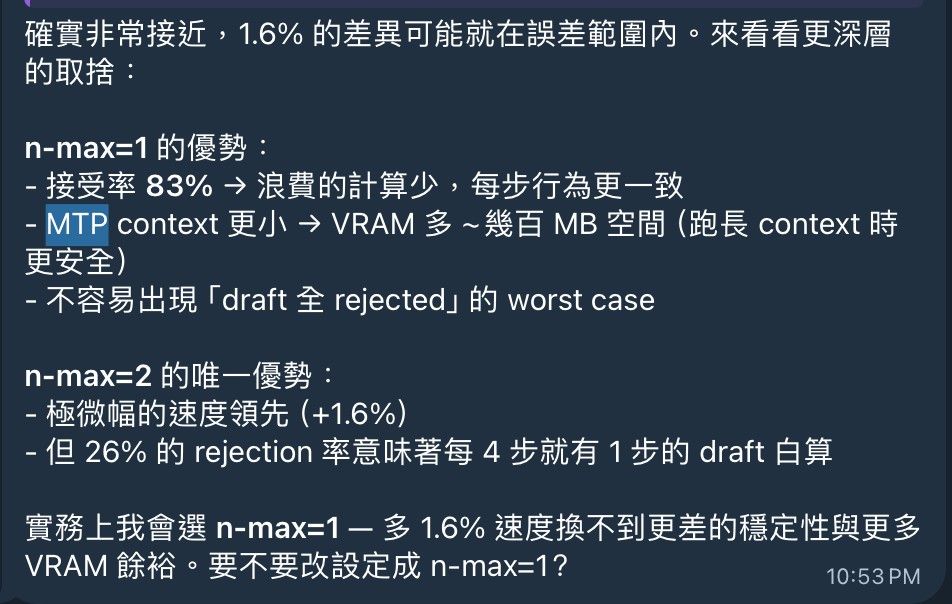
                        MTP 版本需要設一個參數 Draft tokens (num_speculative_tokens or spec-draft-n-max): AI 幫我測試過 最後1 或 2 是最快的參數, 你也是設定1 或 2 嗎?2 速度只比1 快了3 tokens /s 但是它有一個"準確度" 降了很多(浪費算力) 我跟AI都認同Qwen3.6-27B-MTP-GGUF 最後選擇1 是最佳MTP參數
                        4e3f6ade-72fb-4f1b-9501-9638d9e78d57-image.jpeg

                        AresROCA 1 条回复 最后回复
                        0
                        • C comeN

                          双5060TI 16G跑英伟达专门为50显卡优化的Qwen3.6-27B-NVFP4-MTP的表现比双3080-20G还好,NVFP4的优化号称无损Q4,速度40-70T,论坛里面有人发的。

                          kos orK
                          kos orK
                          kos or
                          超凡大师
                          发表于 最后由 kos or 编辑
                          #44

                          @comeN 不知道還有這個版本 我請AI幫我測試一下 Qwen3.6-27B-NVFP4-MTP (目前狀態:一早起來Deepseek V4 Flash 給我下載一個 90GB的TesnorRT-LLM, 現在又說這太大了 要刪除 幫我安裝一個20GB版本的TensorRT來跑測試 哈哈 暈了)

                          1 条回复 最后回复
                          0
                          • C
                            C
                            comeN
                            发表于 最后由 编辑
                            #45

                            NVFP4号称不是无损,但损失小到感知不到,几乎等同于FP16,这可比Q4强不少。

                            1 条回复 最后回复
                            0
                            • kos orK kos or

                              MTP 版本需要設一個參數 Draft tokens (num_speculative_tokens or spec-draft-n-max): AI 幫我測試過 最後1 或 2 是最快的參數, 你也是設定1 或 2 嗎?2 速度只比1 快了3 tokens /s 但是它有一個"準確度" 降了很多(浪費算力) 我跟AI都認同Qwen3.6-27B-MTP-GGUF 最後選擇1 是最佳MTP參數

                              4e3f6ade-72fb-4f1b-9501-9638d9e78d57-image.jpeg

                              AresROCA
                              AresROCA
                              AresROC
                              德高望重
                              发表于 最后由 AresROC 编辑
                              #46

                              @kos-or 上面试的都是MTP=3。目前在研究FP4 & 升级CUDA 13.2,13.3。

                              1 条回复 最后回复
                              0
                              • kos orK
                                kos orK
                                kos or
                                超凡大师
                                发表于 最后由 编辑
                                #47

                                我用的是llama.cpp + Ubuntu + 2 x RTX5070 Ti in PP 來跑同樣一個模型, 最佳MTP draft-n 設定居然會不同 有趣了

                                1 条回复 最后回复
                                0
                                • johnnybegoodJ johnnybegood 于 引用了 此主题
                                • AresROCA
                                  AresROCA
                                  AresROC
                                  德高望重
                                  编写于 最后由 AresROC 编辑
                                  #48

                                  电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.

                                  Model
                                  qwen3.8-flash-next-iq3_s
                                  Engine
                                  v0.1.33
                                  Context
                                  32,768 tokens
                                  KV cache
                                  8-bit, all in VRAM
                                  Experts in VRAM
                                  10,268 (19.4 GB)
                                  Speculation
                                  MTP drafts up to 3 tokens, prompt lookup on
                                  Images
                                  off

                                  terryT 1 条回复 最后回复
                                  2
                                  • AresROCA AresROC

                                    电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.

                                    Model
                                    qwen3.8-flash-next-iq3_s
                                    Engine
                                    v0.1.33
                                    Context
                                    32,768 tokens
                                    KV cache
                                    8-bit, all in VRAM
                                    Experts in VRAM
                                    10,268 (19.4 GB)
                                    Speculation
                                    MTP drafts up to 3 tokens, prompt lookup on
                                    Images
                                    off

                                    terryT
                                    terryT
                                    terry
                                    超级版主
                                    编写于 最后由 terry 编辑
                                    #49

                                    @AresROC 可以尝试下Strata,就等你补5060TI的作业了。单卡,双卡都来下。

                                    油管:https://www.youtube.com/@抡锤者

                                    1 条回复 最后回复
                                    0
                                    • kos orK
                                      kos orK
                                      kos or
                                      超凡大师
                                      编写于 最后由 编辑
                                      #50

                                      5060 Ti 16G C/P值很高 蠻需要這方面的數據

                                      1 条回复 最后回复
                                      1
                                      • AresROCA
                                        AresROCA
                                        AresROC
                                        德高望重
                                        编写于 最后由 编辑
                                        #51

                                        https://lcz.me/post/22482

                                        1 条回复 最后回复
                                        0
                                        • imbiplaza ASUSI
                                          imbiplaza ASUSI
                                          imbiplaza ASUS
                                          谪仙人
                                          编写于 最后由 编辑
                                          #52

                                          恭喜终于苦尽甘来。。。。。

                                          AresROCA 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组