跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【直播】二次开发R9700单卡用SGLang跑Qwen3.8-27B成功! TTFT0.9s/PP2000/TG100tps(代码)!体验丝滑

【直播】二次开发R9700单卡用SGLang跑Qwen3.8-27B成功! TTFT0.9s/PP2000/TG100tps(代码)!体验丝滑

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
r9700sg-langqwen-27b
47 帖子 11 发布者 1.4k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • fcmeF fcme

    @applejuice
    64G那肯定不够的啊,用一个就好了,vLLM开个并发吧优化好缓存也不是不行。
    SGlang的缓存机制确实优秀,但是实际用下来,至少在R9700上感觉不如paiton/vLLM的表现,因为paiton的PP能到3500/TG能到100-110,所以整体的耗时(能耗比)还是paiton/vLLM更好些。所以就没再折腾SGlang了,何况strata完全释放了我5070Ti的潜力,速度和R9700用SGlang跑27B差不多但是质量还领先一截,继续折腾这个意义不大了😁

    alan.lgv60A
    alan.lgv60A
    alan.lgv60
    编写于 最后由 编辑
    #12

    @fcme 说:

    5070Ti

    可以分享一下 5070Ti Strata 配置吗?
    有闲置的 3080 12Gb 和 洋垃圾 X99 + 64G DDR3, 不知道可不可以玩一下 Strata.

    fcmeF 1 条回复 最后回复
    0
    • alan.lgv60A alan.lgv60

      @fcme 说:

      5070Ti

      可以分享一下 5070Ti Strata 配置吗?
      有闲置的 3080 12Gb 和 洋垃圾 X99 + 64G DDR3, 不知道可不可以玩一下 Strata.

      fcmeF
      fcmeF
      fcme
      超凡大师
      编写于 最后由 编辑
      #13

      @alan.lgv60

      只要有12g的显存应该是可以的,你可以参考下面的,鉴于你的显存和内存容量,估计你需要下载量化程度更低一点的模型。

      提取完毕。8030 端口当前是 VM123 上的 strata-5070ti 容器(Strata 176B / 5070Ti,Up 4 hours (healthy)),启动参数如下。

      实际 docker run 命令(来自 /home/fcc/strata-5070ti/start.sh)

      docker run -d \
        --name strata-5070ti \
        --gpus device=0 \
        -p 8030:8030 \
        --ulimit memlock=-1 \
        --restart unless-stopped \
        -v /data/Strata-data:/data \
        -v /data/strata-models/IQ3_XXS:/data/models/IQ3_XXS \
        -v /data/strata-models/IQ3_S:/data/models/IQ3_S \
        -e MODEL=IQ3_S \
        -e CONTEXT=204800 \
        -e VISION=no \
        -e KV=int8 \
        -e GPU=0 \
        -e HOST=0.0.0.0 \
        -e PORT=8030 \
        strata-5070ti
      

      docker inspect 核对结果(与脚本一致)

      项 值
      镜像 strata-5070ti(基于 nvidia/cuda:13.0.0-devel,Ubuntu 24.04 底)
      入口 ./docker-entrypoint.sh(STRATA_EXECV=1),无额外 Cmd
      端口 8030→8030(另暴露 8080 未映射)
      网络 bridge
      GPU --gpus device=0(NVIDIA 运行时注入,NVIDIA_VISIBLE_DEVICES=all)
      重启策略 unless-stopped(VM123 重启后自动回来)
      Ulimit memlock = -1(无限,CUDA pinned memory 需要)
      挂载 /data/Strata-data:/data(config 真身在这)、IQ3_XXS 与 IQ3_S 模型目录 → 容器内 /data/models/
      关键 env MODEL=IQ3_S、CONTEXT=204800、VISION=no(无识图)、KV=int8、GPU=0、HOST=0.0.0.0、PORT=8030
      其他 非 privileged、无 CPU/内存限制、ShmSize 默认 64M、WorkingDir /opt/strata

      几个要点:

      • VISION=no:这个 8030 是 CUDA 13 镜像,不带 vision 编码器,带图请求直接 400(识图只在 8080)。
      • KV=int8 + CONTEXT=204800:int8 KV cache,完整 204800 上下文。
      • --gpus device=0:只挂 5070Ti(5070Ti 与 R9700 可并行,不同卡)。
      • --restart unless-stopped:别手动拉,VM123 重启后它自己会回来;要停干净得 docker stop + docker rm。
      • 注意 MODEL=IQ3_S 但实际跑的是 IQ3_XXS 的 176B 模型(config 真身在宿主 /data/Strata-data/config/strata-iq3_xxs.json,MODEL env 只是目录选择标记之一)——如你要改配置,须 docker exec 进容器改并先备份。
      alan.lgv60A 1 条回复 最后回复
      2
      • fcmeF fcme

        SGlang部署Qwen3.8 27B,180K ctx,PP2000/TG100(代码不再是90顶格),大功告成!喜大奔普!

        由来:看到有大佬在开发双9700高并发的方案,再加上版主数次案例sglang的缓存树优势,所以就结合paiton方案的思路决定自己上手,改造一个个人使用的单R9700的框架,我想大多数人没有买两张的钱,也没有可以插两张卡的电脑。

        以下是第二个checkpoint,2026-10-02,12.01 AEST

        环境:R9700 32G(gfx1201)/ ROCm 7.2.4 / SGLang v0.5.20 + 72 个编号补丁
        模型:Qwen3.8-27B 混合 GDN(AWQ 原始权重)

        R9700 单卡跑 SGLang:Qwen3.8-27B 从 AWQ 改造成 MXFP4 原生内核折腾实录

        由来:看到有大佬在开发双9700高并发的方案,再加上版主数次案例sglang的缓存树优势,所以就结合paiton方案的思路决定自己上手,改造一个个人使用的单R9700的框架,我想大多数人没有买两张的钱,也没有可以插两张卡的电脑。

        环境:R9700 32G(gfx1201)/ ROCm 7.2.4 / SGLang v0.5.20 + 72 个编号补丁
        模型:Qwen3.8-27B 混合 GDN(AWQ 原始权重)

        一、库与结论

        mattbucci 的 2×R9700 RDNA4 SGLang 仓库(SGLang v0.5.20 + 72 个 RDNA4 补丁),改成单卡;
        Qwen3.8-27B(AWQ INT4 checkpoint)+ DFlash2 投机;
        R9700 32G,单槽。

        结论:PP 1913 t/s、TG 91.3 t/s、上下文 229,376(KV 池 232,926 tokens)、视觉保留。
        相对最初能用的状态(PP 1379、上下文 90K),PP +39%、上下文 +154%;相对 MXFP4 上线前的自己,TG +21%。

        一句话:这条路买的是"用上 RDNA4 的 FP4 硬件"和"少读权重",不是省显存——MXFP4 权重其实略大于 AWQ(4.25 vs 4.125 bit/param)。


        二、最终启动参数

        cd /home/fcc && \
        MODEL=/data/models/qwen38-awq QUANT=awq MEMF=0.94 CTX=229376 MAMBA=3 CHUNK=2048 MAX_RUN=1 \
        LM_ARGS='--mamba-full-memory-ratio 0.12 --served-model-name Qwen3.8-27B-AWQ-R9700 --tool-call-parser qwen3_coder' \
        CG_ARGS=--cuda-graph-max-bs-decode=4 \
        SPEC_ARGS='--speculative-algorithm DFLASH --speculative-draft-model-path /data/models/qwen38-dflash2' \
        RADIANCE_MXFP4_WPERM=1 SGLANG_EMBED_FP8=1 \
        setsid nohup ./launch-qwen38-single.sh > /tmp/sgl.log 2>&1 < /dev/null &
        

        四个不能动的硬约束:

        • CHUNK=2048:带 DFlash2 时 prefill 的 GDN/FLA 工作区随 chunk 缩放,8192 会在 fla/chunk_o.py 的 chunk_fwd_o 处 OOM 直接崩服务(实测两次)。
        • MEMF ≤ 0.94:0.95 已实测在 15K prefill 上 OOM。
        • MAX_RUN=1:单槽。2 路 256K 在 32G 上物理不可达,第七节有账。
        • RADIANCE_MXFP4_WPERM=1:必须与"权重是否已转 fragment 序"一致,不一致 libr4d 把权重读成垃圾。

        三、折腾经过

        1)单卡跑通,但 decode 只有 5 tok/s

        剥离 TP 补丁、应用 72 个 RDNA4 补丁、跑通 AWQ INT4。PP 1304、TG 5.07 tok/s——Q4 模型不该这么慢。
        翻 profiler:awq_dequantize + 稠密 rocBLAS GEMM 占了 decode 的 94%。
        自写就地 fragment repack(零额外显存)+ 快拆包(逐位一致,2.6×)+ 快激活量化(9.4×) ⇒ 5.07 → 24.86。

        2)盯上 RDNA4 的 FP4 硬件

        RDNA4 的 FP4 WMMA 实际就是 MXFP4,而现成手写内核只有 MXFP4 的:
        从 Paiton 镜像里提取 radiance_mxfp4_fp8(fp8-WMMA "folded" 大 M 内核),另加 libr4d 的 r4d_gemm_mxfp4a8_nt_m64(小 M decode 内核)。
        调用约定用 2×2×2 扫参对着作者自己的 _exact_ref 定死:权重绝对不能 permute_w(转了偏 156%)。
        层级精度 0.14%,端到端比自写 Triton W4A8 快 1.45–1.85×。

        3)13 轮的"输出垃圾",根因是一行置换

        MXFP4 能上场了(KV 池从 156,175 涨到 163,587 为证),但输出是垃圾,而且每次完全一样。
        排查了 13 轮,逐项排除:重量化公式、内核调用、uint8 拆包、合并层整块 vs 分段、apply 签名、reshape、draft 路径、运行时权重输入(与 checkpoint 逐位相同)……全都无罪。

        最后是靠一个从没做过的对拍抓到的:把我们的反量化结果和 SGLang 自己的 awq_dequantize_triton 逐元素比——

        反量化约定: awq_dequantize_triton vs 我们的公式 -> 相对差 108.83%
        

        不是精度问题,是完全错位。逆解出真实映射:AWQ 把 8 个输出列打进一个 int32 用的顺序是 [0,2,4,6,1,3,5,7],而我们是顺序读的 ⇒ 整个权重矩阵被按 8 列一组打乱。
        修一个置换向量:108.83% → 0.0103%(只剩 fp16 舍入)。金丝雀立刻回来。

        教训:转换/建缓存这一步,必须跟框架自己的实现对拍,不能跟自己写的参考实现对拍。
        之前所有"0.14% 对拍"都是把同一份错权重同时喂给内核和参考实现——两边必然一致,天然看不见转换错误。这是循环验证。

        4)路径 A:同一时刻只允许一套权重

        框架本身只加载一种格式(磁盘上的 AWQ)。"两份权重"是早先的补丁自己造的:算完 MXFP4 却不释放 AWQ,
        于是 24.8G 同时驻留 ⇒ 这才是 OOM 和"一释放就出错"死循环的来源。

        改成:加载期从本层自己的 AWQ 张量算出 MXFP4 → 立刻把 qweight/qzeros/scales 置 None → forward 只有一条路(不回退,因为回退要的东西已经没了);
        并且不再调用原生 AWQ 的 process_weights_after_loading(它会额外产出 libr4d 的 fragment 重排和主机副本,那才是货真价实的第二份)。

        显存占用是"AWQ 未转换的余量 + MXFP4 已转换的量"的单调过渡,峰值 ≈ max(12.2G, 12.6G) + 单层 fp32 临时,不是 12.2+12.6。

        5)decode 慢 4.7 倍,因为用错了内核波段

        作者自己的封装写得很清楚:fp8-WMMA 内核只在 M≥256(prefill)才占优,decode 档要用 libr4d。
        我们一直拿 prefill 内核跑 decode。按 M≤64 / M>64 分档后(共用 fragment 序权重,纯字节置换、不动数值):

        M libr4d m64 folded 倍数
        1 0.069 ms 0.283 ms 4.12
        8 0.060 ms 0.285 ms 4.72
        64 0.125 ms 0.273 ms 2.18
        2048 — 2.039 ms —

        顺带把激活量化从 torch 版换成单遍 Triton:PP 1595→1905、TG 68.9→75.5,这一项就有这么大。

        6)上下文从 155K 顶到 229K:两处"减少权重占用"

        MEMF 钉死 0.94 不动,纯靠省权重换 KV:

        • embedding 存 fp8(−1.27 GB):per-row scale = max|x|/448 必须先缩放再转——embedding 权重在 0.02 量级,直接 cast 会大量掉进 e4m3 的次正规区。缩放后重建误差 2.25%。
        • lm_head 存 MXFP4(−1.87 GB,2.543 → 0.675 GB):查代码发现 AWQConfig.get_quant_method 对非 LinearBase 一律返回 None,lm_head 一直以 fp16 全量加载;而它是 memory-bound 的 M=1 GEMM ⇒ 每个 decode 步都要读 2.54 GB 权重。转成 MXFP4 后走已验证的双波段内核(M=1 命中 libr4d),TG 顺带从 75.5 涨到 91.3。

        两处都写成新分片 + 只改 index 指向,旧分片一个字没动 ⇒ 回滚就是换个 index 备份。


        四、性能对照

        指标 改造前基准 现在 变化
        PP 1379 t/s(1304–1453 均值) 1913 t/s +38.7%
        TG code-256 75.5 t/s(同脚本实测) 91.3 t/s +21%
        上下文 155,648(早期 90,112) 229,376 +47%
        KV 池 156,175 tokens 232,926 tokens +49%
        主模型显存 18.76 GB 17.06 GB −1.70 GB
        启动加载 65 s 27.5 s 更快

        profiler 硬证据(改造后):

        prefill:  radiance_mxfp4_fp8_gemm_folded      768 次  188.8 ms  26.7%
                  _w4a8_gemm_kernel(旧 Triton)        0 次    0.0 ms   ← 消失
                  _unpack_fragment_kernel_v2            0 次    0.0 ms   ← 消失
        decode:   r4d_gemm_mxfp4a8_nt_m64_kernel    3840 次  413.8 ms  59.4%
                  _quant_act_fp8_kernel               3840 次   27.6 ms   4.0%
        

        五、质量复核

        重量化有约 10% 的固有误差(AWQ 每 128 一组 fp16 scale → MXFP4 每 32 一块 E8M0),所以质量必须量,不能只看 tok/s。

        教师强制 NLL(4307 token:英文解题文 + 中文技术文 + 代码)

        nats/token 困惑度
        AWQ(改造前) 1.3856 4.00
        MXFP4(现在) 1.4042 4.07
        差 +1.34% +1.8%

        GSM8K-300(同 300 题、同 seed、思考关、贪心)

        正确 准确率
        AWQ(改造前) 292/300 97.33%
        MXFP4(现在) 290/300 96.67%

        逐题分歧:两套都做对 288,只有 MXFP4 对 2 题,只有 AWQ 对 4 题,两套都错 6 题。
        差值 −0.67pp、差值标准误 1.39pp ⇒ 0.48σ,纯噪声。

        为什么 10% 的权重误差只换来 1.3% 的分布损失?
        ① 它是零均值取整噪声,不是系统性破坏——对照那个列交织读错的例子:108% 的系统性错位直接让模型全废,10% 的无偏噪声只掉 1.3%。决定生死的是误差有没有偏向、有没有和决策方向对齐,不是它多大。
        ② 误差在 K 维上独立,不沿 64 层相干叠加。
        ③ 残差流和 RMSNorm 有阻尼。
        ④ 最终是 argmax,只在 top-1/top-2 间距被吃掉时才改答案——GSM8K 的 2% 翻转率就是这个的可见面。
        ⑤ 10% 本身有明确来源:E2M1 只有 3 位尾数(约 6% 相对精度),而块缩放是 E8M0(2 的整数次幂、只能向上取整),最坏比理想缩放粗一倍 ⇒ 6% → ~10%。

        诚实的边界:"质量没区别"准确说法是"差异 < 2.8pp"(GSM8K-300 的 2σ 分辨率),不是零差异。灵敏指标 NLL 明确告诉我们 +1.3% 是真的。


        六、稳定性

         4K 1821t/s   8K 1827   16K 1647   32K 1313   64K 901   128K 535
        160K  432t/s  192K 366   220K(226,014 token) 323t/s
        

        全部正常出 token,服务全程未崩。220K 那一档基本贴着 229,376 的上限跑。


        七、账算清楚:2 路 256K 在单卡 32G 上做不到

        主模型(MXFP4 线性 12.6 + embed fp8 1.27 + lm_head MXFP4 0.68 + 视觉 0.9 + 其他) = 17.06 GB
        DFlash2 draft (fp8)                                                              =  0.48 GB
        目标 KV 池 232,926 tok(32 KB/token)                                            =  7.10 GB
        draft KV 池 同 token 数(约 10 KB/token)                                        =  2.22 GB
        CUDA graphs                                                                      =  0.33 GB
        

        每 token KV 成本 ≈ 42 KB(目标 32 + 草稿 10)。于是:

        场景 KV 需要 能不能
        1×256K 带 DFlash2 11.0 GB 差值紧张
        2×256K 带 DFlash2 22.0 GB ✗ 差约 13 GB
        2×256K 无投机 16.8 GB ✗ 差约 6 GB

        活跃请求的 KV 必须在显存上,所以 HiCache(主机内存 L2 层)解决不了这件事——它买的是"长前缀零重算",不是并发容量。
        想上 2×256K 只有换 48G+ 卡,或者上 fp4 KV——而 fp4 KV 全树只有 CUDA 的 TRT-LLM MLA 路径实现,ROCm/Triton 没有读取路径,等于要新写注意力内核。

        所以:MEMF≤0.94 下,约 227K 就是单卡 32G 的实际上限。


        八、遗留

        1. 磁盘上约 5 GB 死权重:改成新分片后,旧分片 model-00000/00001 里那两份旧张量还在,只是 index 不再引用。回收要重写这两个分片(不是删文件)。
        2. PP 2500+ 没到(现在 1913):瓶颈是注意力 ~25 TFLOP/s(占 prefill 24.5%),GEMM 已到 172 TFLOP/s 的微基准上限。libr4d 注意力移植(要求 KV 交错,SGLang 是分离 k/v 缓冲)和自写 Triton 注意力都已被实测否决。
        3. 质量只覆盖了数学推理 + NLL:长文生成、多轮工具调用、视觉识别未做基准(视觉只验了"能认图",红图→"Red"、左圆右方→"圆形 正方形")。

        面向读者的一句提醒:如果你也在单卡上折腾 MXFP4,先记住两条——
        转换代码一定要跟框架自己的反量化实现对拍(自己对自己的参考实现是循环验证,看不出错位);
        lm_head 不是免费的,它在每个 decode 步都要被完整读一遍,把它量化掉往往比调注意力更划算。

        以下是第一个Checkpoint

        一、结论先行

        decode 从 5.07 → 70.9 tok/s(代码)/ 53.1 tok/s(散文),提升 10~14 倍;识图保留;2 路并发可用。

        指标 起点 终点(速度档) 长文档档
        decode(+DFlash2) 5.07 tok/s 70.9 / 53.1 22–25(无投机)
        prefill 1523 tok/s 1304–1453 1500–1549
        上下文 65K 90,112 262,144
        并发 1 2(已验证) 2
        识图 ✓ ✓(红图→"Red") ✓
        KV 池 — 101,791 tokens 285,967 tokens

        关键一句:"速度"和"长上下文"在单卡 32G 上是硬性二选一,不是调参能两全的。

        二、最终启动参数

        cd /home/fcc && \
        MODEL=/data/models/qwen38-awq QUANT=awq MEMF=0.93 CTX=90112 MAMBA=8 \
        CHUNK=2048 MAX_RUN=2 \
        LM_ARGS="--mamba-full-memory-ratio 0.12 \
          --served-model-name Qwen3.8-27B-AWQ-R9700 \
          --tool-call-parser qwen3_coder" \
        CG_ARGS=--cuda-graph-max-bs-decode=8 \
        SPEC_ARGS="--speculative-algorithm DFLASH \
          --speculative-draft-model-path /data/models/qwen38-dflash2" \
        RADIX_ARGS="--enable-hierarchical-cache --hicache-size 10 \
          --hicache-write-policy write_through" \
        setsid nohup ./launch-qwen38-single.sh > /tmp/sglang.log 2>&1 &
        

        三个不能动的参数(都是踩出来的):

        • CHUNK=2048:带 DFlash2 时 prefill 的 GDN/FLA 工作区随 chunk 缩放,用 8192 会在 fla/chunk_o.py:chunk_fwd_o 处 OOM 直接崩服务(实测崩两次)
        • MEMF ≤ 0.93:0.95 会把显存占干,同样 OOM
        • --cuda-graph-max-bs-decode=8:投机 verify 必须走图;8 档比 16 档省约 1GB,只慢 3%

        三、做成路线(与 Paiton 的异同)

        Paiton 走 vLLM + 自研原生内核(radiance_mxfp4_fp8_gemm)。SGLang 在这张卡上没有 FP4 原生 GEMM,所以把等价物自建了一遍:

        1. NVFP4 → AWQ INT4 流式转换(自写,逐行余弦 0.993)
        2. 原生 HIP AWQ GEMV(用仓库自带 build_awq_gemv.sh 编译)→ decode 5 → 24.9
        3. 移植 libr4d(开源 RDNA4 内核库;为 gfx1201/ROCm 7.2.4 编译成功,仅需 1 处地址空间适配),逆向 WMMA fragment 布局(含 4-bit 二进制补码这一细节),实现零额外显存的原地重排 → 投机 verify 从 290ms/步降到 15ms
        4. 自研 W4A8 大 M GEMM(int8 WMMA,167 TFLOP/s)替换 prefill 的反量化路径 → PP 回到 1453
        5. HiCache L2 打通(修了 ROCm 上 sgl_kernel.kvcacheio 包装过期的问题):主机侧目标 131,632 + draft 131,633 tokens,前缀复用 186s → 19.5s(9.5×)
        6. 真 2 路并发:--mamba-full-memory-ratio 0.12 + --max-mamba-cache-size 8(此前被 mamba 槽位卡成 1 路),日志 #running-req: 2 为证

        四、折腾经过

        整场折腾的本质只有一句话:SGLang 在 ROCm 上没有原生 4-bit 内核,所以先花时间在软件反量化上撞墙(三种内核都停在 ~2 Tops/s),再花时间把 libr4d 的合成回来——中间还踩了 AWQ scale 溢出成 inf、权重 nibble 是补码而非偏移码、缓存键与融合模块名对不上,以及"加载期重排必然 OOM、必须原地重排"这几个坑。

        五、没做到的(诚实)

        目标 Paiton 本方案 达成度
        PP 3455–3871 tok/s 1304–1549 约 40%
        TG 100–156 tok/s 53–71 约 50–70%
        识图 ✓ ✓ 100%
        单槽 256K 声明 204,800 ✅(无投机档) 达成
        单槽 256K + DFlash2 — ❌ 上限约 160K 0%
        2 路 × 各自 256K — ❌ 算术不可能

        最后一行给个算式:KV 单价实测 30.5 KB/token(8.72GB ÷ 285,967),两张 256K = 16.0GB;加上权重 12.2GB + bf16 embed/lm_head 5GB + 视觉 0.9GB + draft 2.15GB + mamba 1.3GB + 图档 1–4GB = 39–45GB,而可用只有 31.86GB。除非 KV 能减半(此版本 --kv-cache-dtype 只有 auto/fp8,无 fp4),否则单卡无解。

        PP 差的 60% 我知道在哪:只换了 GEMM,没移植 libr4d 的 prefill 注意力与 GDN 内核(attn_prefill_h256_gqa6_fp8kv、gdn_conv_prep/kkt_solve/chunk_scan)。接口已侦察、r4d.so 已编译好,但集成要对接 SGLang 的 GDN 状态布局,属于另一场硬仗。

        六、给读者的一句话

        在 ROCm 上跑 SGLang 跑 4-bit 模型,决定性能的不是你的卡,而是"有没有原生 4-bit 内核"——先确认这一条,再谈调参。

        另外两条省时间的经验:

        • 别用日志的聚合吞吐当性能结论(那里面有 10 秒均值和排队效应),要用受控脚本 + 固定 prompt 自测;
        • 显存别顶到 0.95 看着漂亮——mem_fraction 得给 prefill 工作区留余量,否则一问就崩。

        Ben LeeB
        Ben LeeB
        Ben Lee
        超凡大师
        编写于 最后由 编辑
        #14

        祝贺祝贺,这个成绩相当能打了!

        fcmeF 1 条回复 最后回复
        1
        • kos orK
          kos orK
          kos or
          超凡大师
          编写于 最后由 编辑
          #15

          謝謝分享,先收藏,等R9700上機了 直接讓Agent抄作業 哈

          fcmeF 1 条回复 最后回复
          0
          • Ben LeeB Ben Lee

            祝贺祝贺,这个成绩相当能打了!

            fcmeF
            fcmeF
            fcme
            超凡大师
            编写于 最后由 编辑
            #16

            @Ben-Lee
            是的,但是我实际体验下来感觉还是比paiton/vllm要弱些,这个首字延迟很低,但是后续就被秒了,所以看需求吧

            1 条回复 最后回复
            0
            • kos orK kos or

              謝謝分享,先收藏,等R9700上機了 直接讓Agent抄作業 哈

              fcmeF
              fcmeF
              fcme
              超凡大师
              编写于 最后由 编辑
              #17

              @kos-or
              感觉还是不是太完善,一来偶有卡死,二来还是没有原生的mxfxp4支持速度真正跑起来以后还是不如paiton/vLLM快。硬的很快,但是软的也很快😂😂😂

              1 条回复 最后回复
              0
              • kos orK
                kos orK
                kos or
                超凡大师
                编写于 最后由 kos or 编辑
                #18

                不知道這效果好嗎?

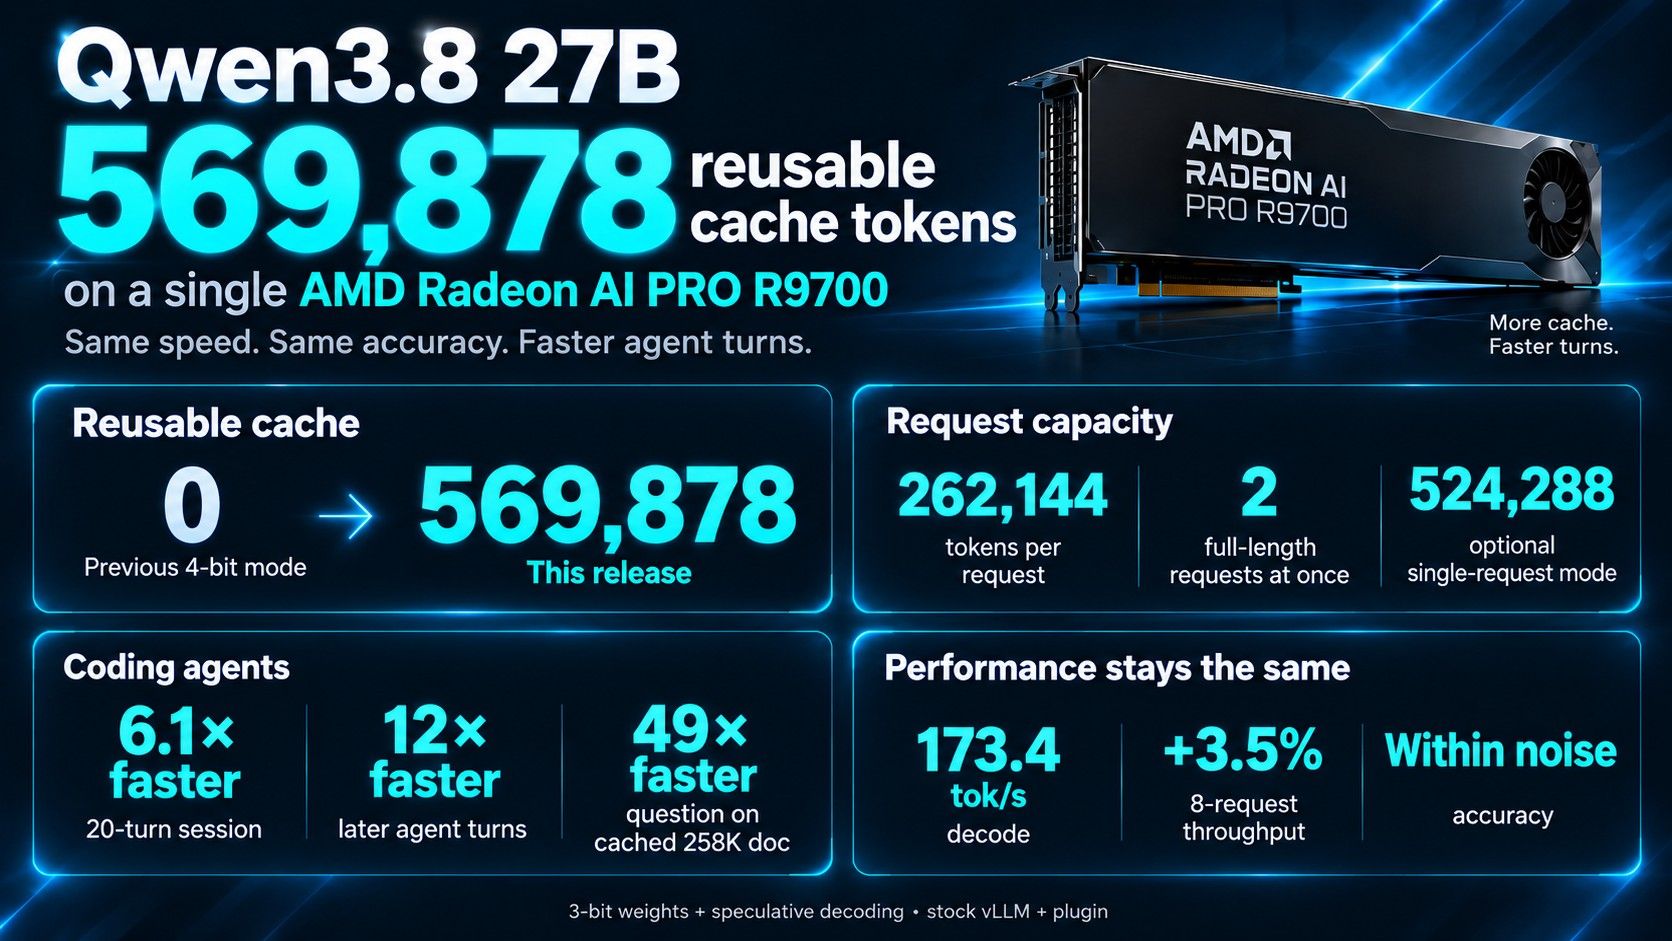
                https://github.com/Eliovp-BV/paiton-vllm-plugin/blob/main/models/Qwen3.8-MXFP4-DFlash2/README.md#coding-mode-results
                image.jpeg

                fcmeF 1 条回复 最后回复
                0
                • kos orK kos or

                  不知道這效果好嗎?

                  https://github.com/Eliovp-BV/paiton-vllm-plugin/blob/main/models/Qwen3.8-MXFP4-DFlash2/README.md#coding-mode-results
                  image.jpeg

                  fcmeF
                  fcmeF
                  fcme
                  超凡大师
                  编写于 最后由 编辑
                  #19

                  @kos-or
                  详情见我另一个R9700的帖子,一句话,效果非常好!
                  但是很有可能是效果仅次于我跑通的那个R9700的SGlang框架的效果,哈哈😃
                  虽然我借鉴了人家的思路。
                  见链接文本

                  kos orK 1 条回复 最后回复
                  1
                  • fcmeF
                    fcmeF
                    fcme
                    超凡大师
                    编写于 最后由 fcme 编辑
                    #20

                    给大伙汇报一下这个框架,现在折腾的有眉目了,基本上可以定型了!

                    上个checkpoint的时候缓存出了些问题,缓存下来的内容动不动被挤出去,后来在AI的帮助下,把这个问题彻底解决了,现在无比丝滑!!!

                    在我5070ti上面部署的strata框架跑的千问3.8 Flash Next的协助下,成本就是些电费。
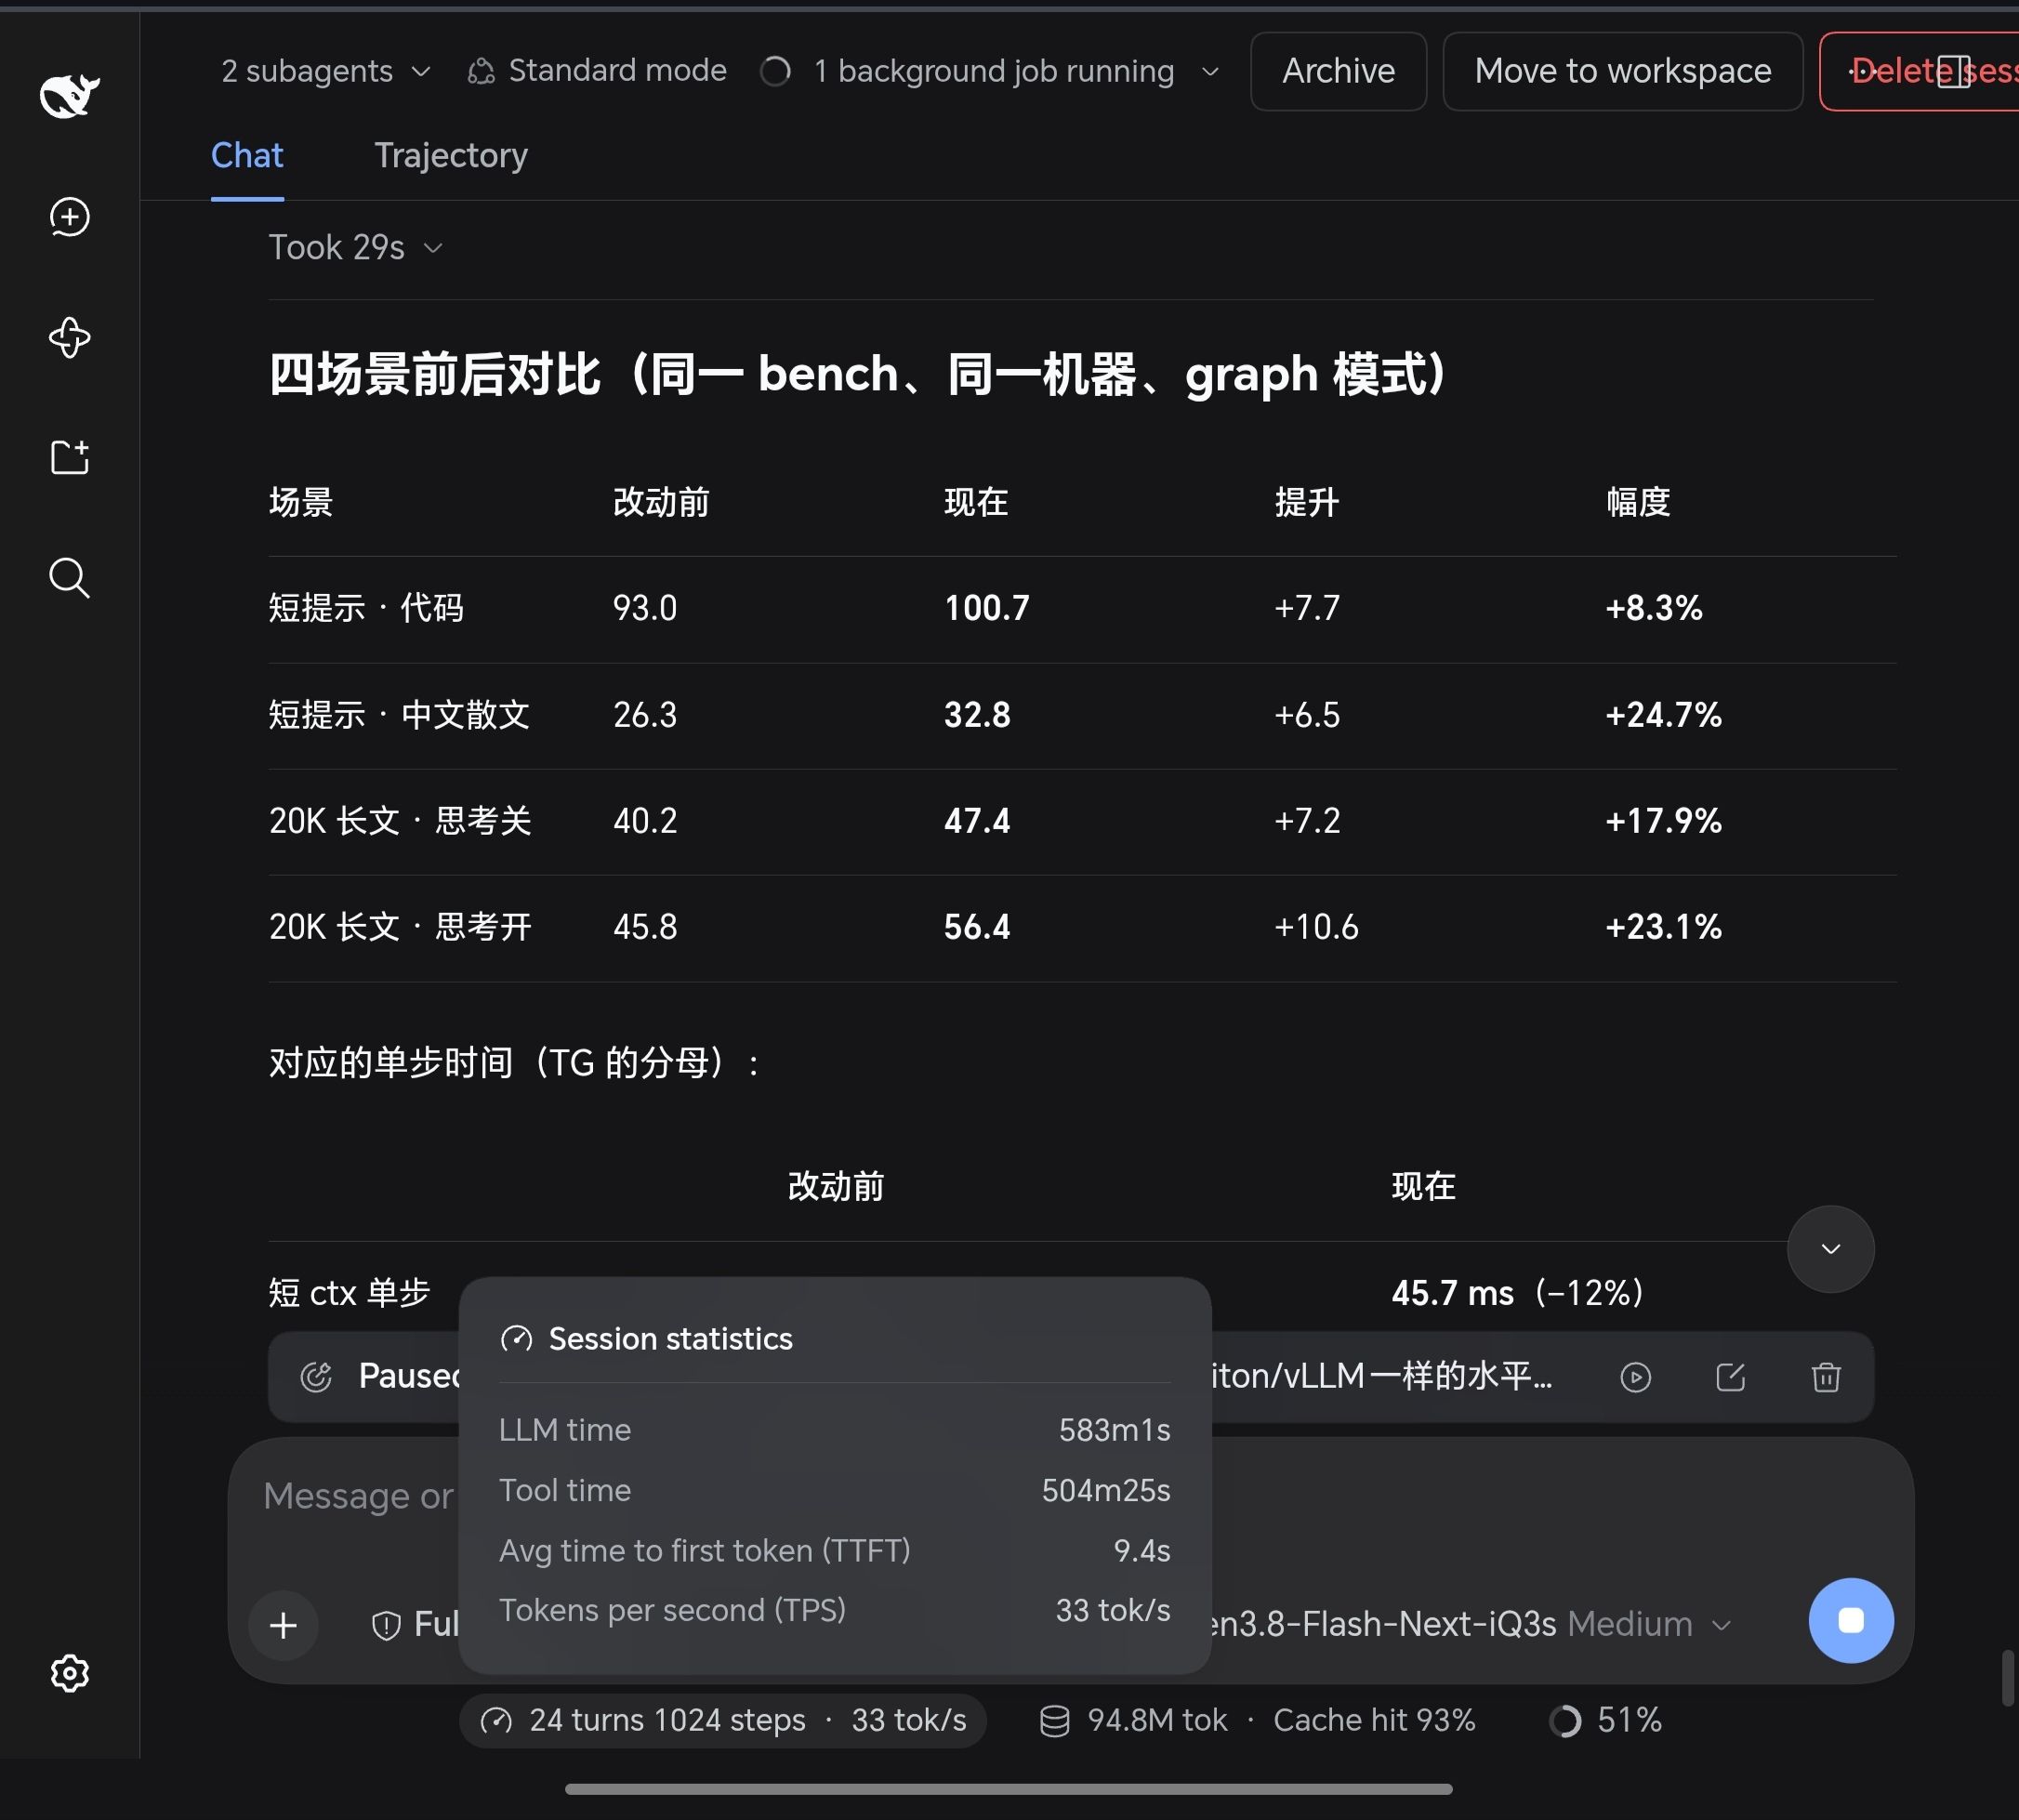
                    现在的状态是除了pp速度还不能笔尖paiton/vLLM以外,日常的agent使用体验应该是比paiton/vLLM要好些了。主要是两个原因,版主一直安利的SGlang的缓存机制跑通了,而且我还做了一些小优化,给s吉浪套了一个转换器,让它在后台定期自动用dsh/Hermes的系统提示词来预热模型,这样基本上不管是新对话还是同一对话的重复提问,响应时间都能在0.9秒左右,那叫一个丝滑。但是做长输出的时候,速度还是比vLLM要慢一丢丢。什么程度呢,就是能感觉到慢了点,但是没有那么明显了,毕竟反应很快。

                    二次开发过程,截个图留念一下吧,如下(在我间歇性提示和监督的情况下跑了十几个小时的成果,flash-next,牛🐮!):
                    Screenshot_20261005_185741_com_android_chrome_ChromeTabbedActivity_edit_141950344111631.jpg

                    注意这个图片里面用的模型不是27B的。

                    1 条回复 最后回复
                    0
                    • fcmeF fcme

                      @kos-or
                      详情见我另一个R9700的帖子,一句话,效果非常好!
                      但是很有可能是效果仅次于我跑通的那个R9700的SGlang框架的效果,哈哈😃
                      虽然我借鉴了人家的思路。
                      见链接文本

                      kos orK
                      kos orK
                      kos or
                      超凡大师
                      编写于 最后由 编辑
                      #21

                      @fcme said:

                      详情见我另一个R9700的帖子,一句话,效果非常好

                      謝謝分享 先收藏了 !!😊

                      1 条回复 最后回复
                      0
                      • terryT
                        terryT
                        terry
                        超级版主
                        编写于 最后由 编辑
                        #22

                        不错,可以继续完善,给新人直接抄作业。

                        油管:https://www.youtube.com/@抡锤者

                        fcmeF 1 条回复 最后回复
                        0
                        • XiaoteX
                          XiaoteX
                          Xiaote
                          编写于 最后由 编辑
                          #23

                          ⭐ 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!

                          奖励凭证:精华 +5 分 · 编号 f2023-1686-1(系统自动发放,显示稍有延迟)

                          老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                          1 条回复 最后回复
                          0
                          • terryT terry

                            不错,可以继续完善,给新人直接抄作业。

                            fcmeF
                            fcmeF
                            fcme
                            超凡大师
                            编写于 最后由 编辑
                            #24

                            @terry
                            会的,弄好了我也git一下,回馈社群!

                            1 条回复 最后回复
                            1
                            • fcmeF fcme

                              @alan.lgv60

                              只要有12g的显存应该是可以的,你可以参考下面的,鉴于你的显存和内存容量,估计你需要下载量化程度更低一点的模型。

                              提取完毕。8030 端口当前是 VM123 上的 strata-5070ti 容器(Strata 176B / 5070Ti,Up 4 hours (healthy)),启动参数如下。

                              实际 docker run 命令(来自 /home/fcc/strata-5070ti/start.sh)

                              docker run -d \
                                --name strata-5070ti \
                                --gpus device=0 \
                                -p 8030:8030 \
                                --ulimit memlock=-1 \
                                --restart unless-stopped \
                                -v /data/Strata-data:/data \
                                -v /data/strata-models/IQ3_XXS:/data/models/IQ3_XXS \
                                -v /data/strata-models/IQ3_S:/data/models/IQ3_S \
                                -e MODEL=IQ3_S \
                                -e CONTEXT=204800 \
                                -e VISION=no \
                                -e KV=int8 \
                                -e GPU=0 \
                                -e HOST=0.0.0.0 \
                                -e PORT=8030 \
                                strata-5070ti
                              

                              docker inspect 核对结果(与脚本一致)

                              项 值
                              镜像 strata-5070ti(基于 nvidia/cuda:13.0.0-devel,Ubuntu 24.04 底)
                              入口 ./docker-entrypoint.sh(STRATA_EXECV=1),无额外 Cmd
                              端口 8030→8030(另暴露 8080 未映射)
                              网络 bridge
                              GPU --gpus device=0(NVIDIA 运行时注入,NVIDIA_VISIBLE_DEVICES=all)
                              重启策略 unless-stopped(VM123 重启后自动回来)
                              Ulimit memlock = -1(无限,CUDA pinned memory 需要)
                              挂载 /data/Strata-data:/data(config 真身在这)、IQ3_XXS 与 IQ3_S 模型目录 → 容器内 /data/models/
                              关键 env MODEL=IQ3_S、CONTEXT=204800、VISION=no(无识图)、KV=int8、GPU=0、HOST=0.0.0.0、PORT=8030
                              其他 非 privileged、无 CPU/内存限制、ShmSize 默认 64M、WorkingDir /opt/strata

                              几个要点:

                              • VISION=no:这个 8030 是 CUDA 13 镜像,不带 vision 编码器,带图请求直接 400(识图只在 8080)。
                              • KV=int8 + CONTEXT=204800:int8 KV cache,完整 204800 上下文。
                              • --gpus device=0:只挂 5070Ti(5070Ti 与 R9700 可并行,不同卡)。
                              • --restart unless-stopped:别手动拉,VM123 重启后它自己会回来;要停干净得 docker stop + docker rm。
                              • 注意 MODEL=IQ3_S 但实际跑的是 IQ3_XXS 的 176B 模型(config 真身在宿主 /data/Strata-data/config/strata-iq3_xxs.json,MODEL env 只是目录选择标记之一)——如你要改配置,须 docker exec 进容器改并先备份。
                              alan.lgv60A
                              alan.lgv60A
                              alan.lgv60
                              编写于 最后由 编辑
                              #25

                              @fcme 感谢! 希望DDR3跑起来不会太慢吧

                              fcmeF 1 条回复 最后回复
                              0
                              • alan.lgv60A alan.lgv60

                                @fcme 感谢! 希望DDR3跑起来不会太慢吧

                                fcmeF
                                fcmeF
                                fcme
                                超凡大师
                                编写于 最后由 编辑
                                #26

                                @alan.lgv60
                                没有影响!因为这个是全部加载到显存的方案,我的7828服务器也是DDR3的

                                1 条回复 最后回复
                                0
                                • fcmeF
                                  fcmeF
                                  fcme
                                  超凡大师
                                  编写于 最后由 编辑
                                  #27

                                  另外这个还不是最终的版本,先不要抄作业。我会出个git的。

                                  Chan SamC 1 条回复 最后回复
                                  0
                                  • dardeaw fengD
                                    dardeaw fengD
                                    dardeaw feng
                                    德高望重 劳动模范
                                    编写于 最后由 编辑
                                    #28

                                    你這速度已經差不多等於我4090開ninfer了 逆天

                                    fcmeF 1 条回复 最后回复
                                    0
                                    • dardeaw fengD dardeaw feng

                                      你這速度已經差不多等於我4090開ninfer了 逆天

                                      fcmeF
                                      fcmeF
                                      fcme
                                      超凡大师
                                      编写于 最后由 编辑
                                      #29

                                      @dardeaw-feng
                                      所以AI时代即使小众的硬件也能优化出不错的速度,小众生态的表现也会越来越好的。再等个原生的mxfp4内核替换现在的PP速度就能到4000级别了,到那时SGlang在9700上就可以完爆paiton/vLLM方案了,现在还是互有胜负。

                                      张光璞张 1 条回复 最后回复
                                      0
                                      • fcmeF
                                        fcmeF
                                        fcme
                                        超凡大师
                                        编写于 最后由 fcme 编辑
                                        #30

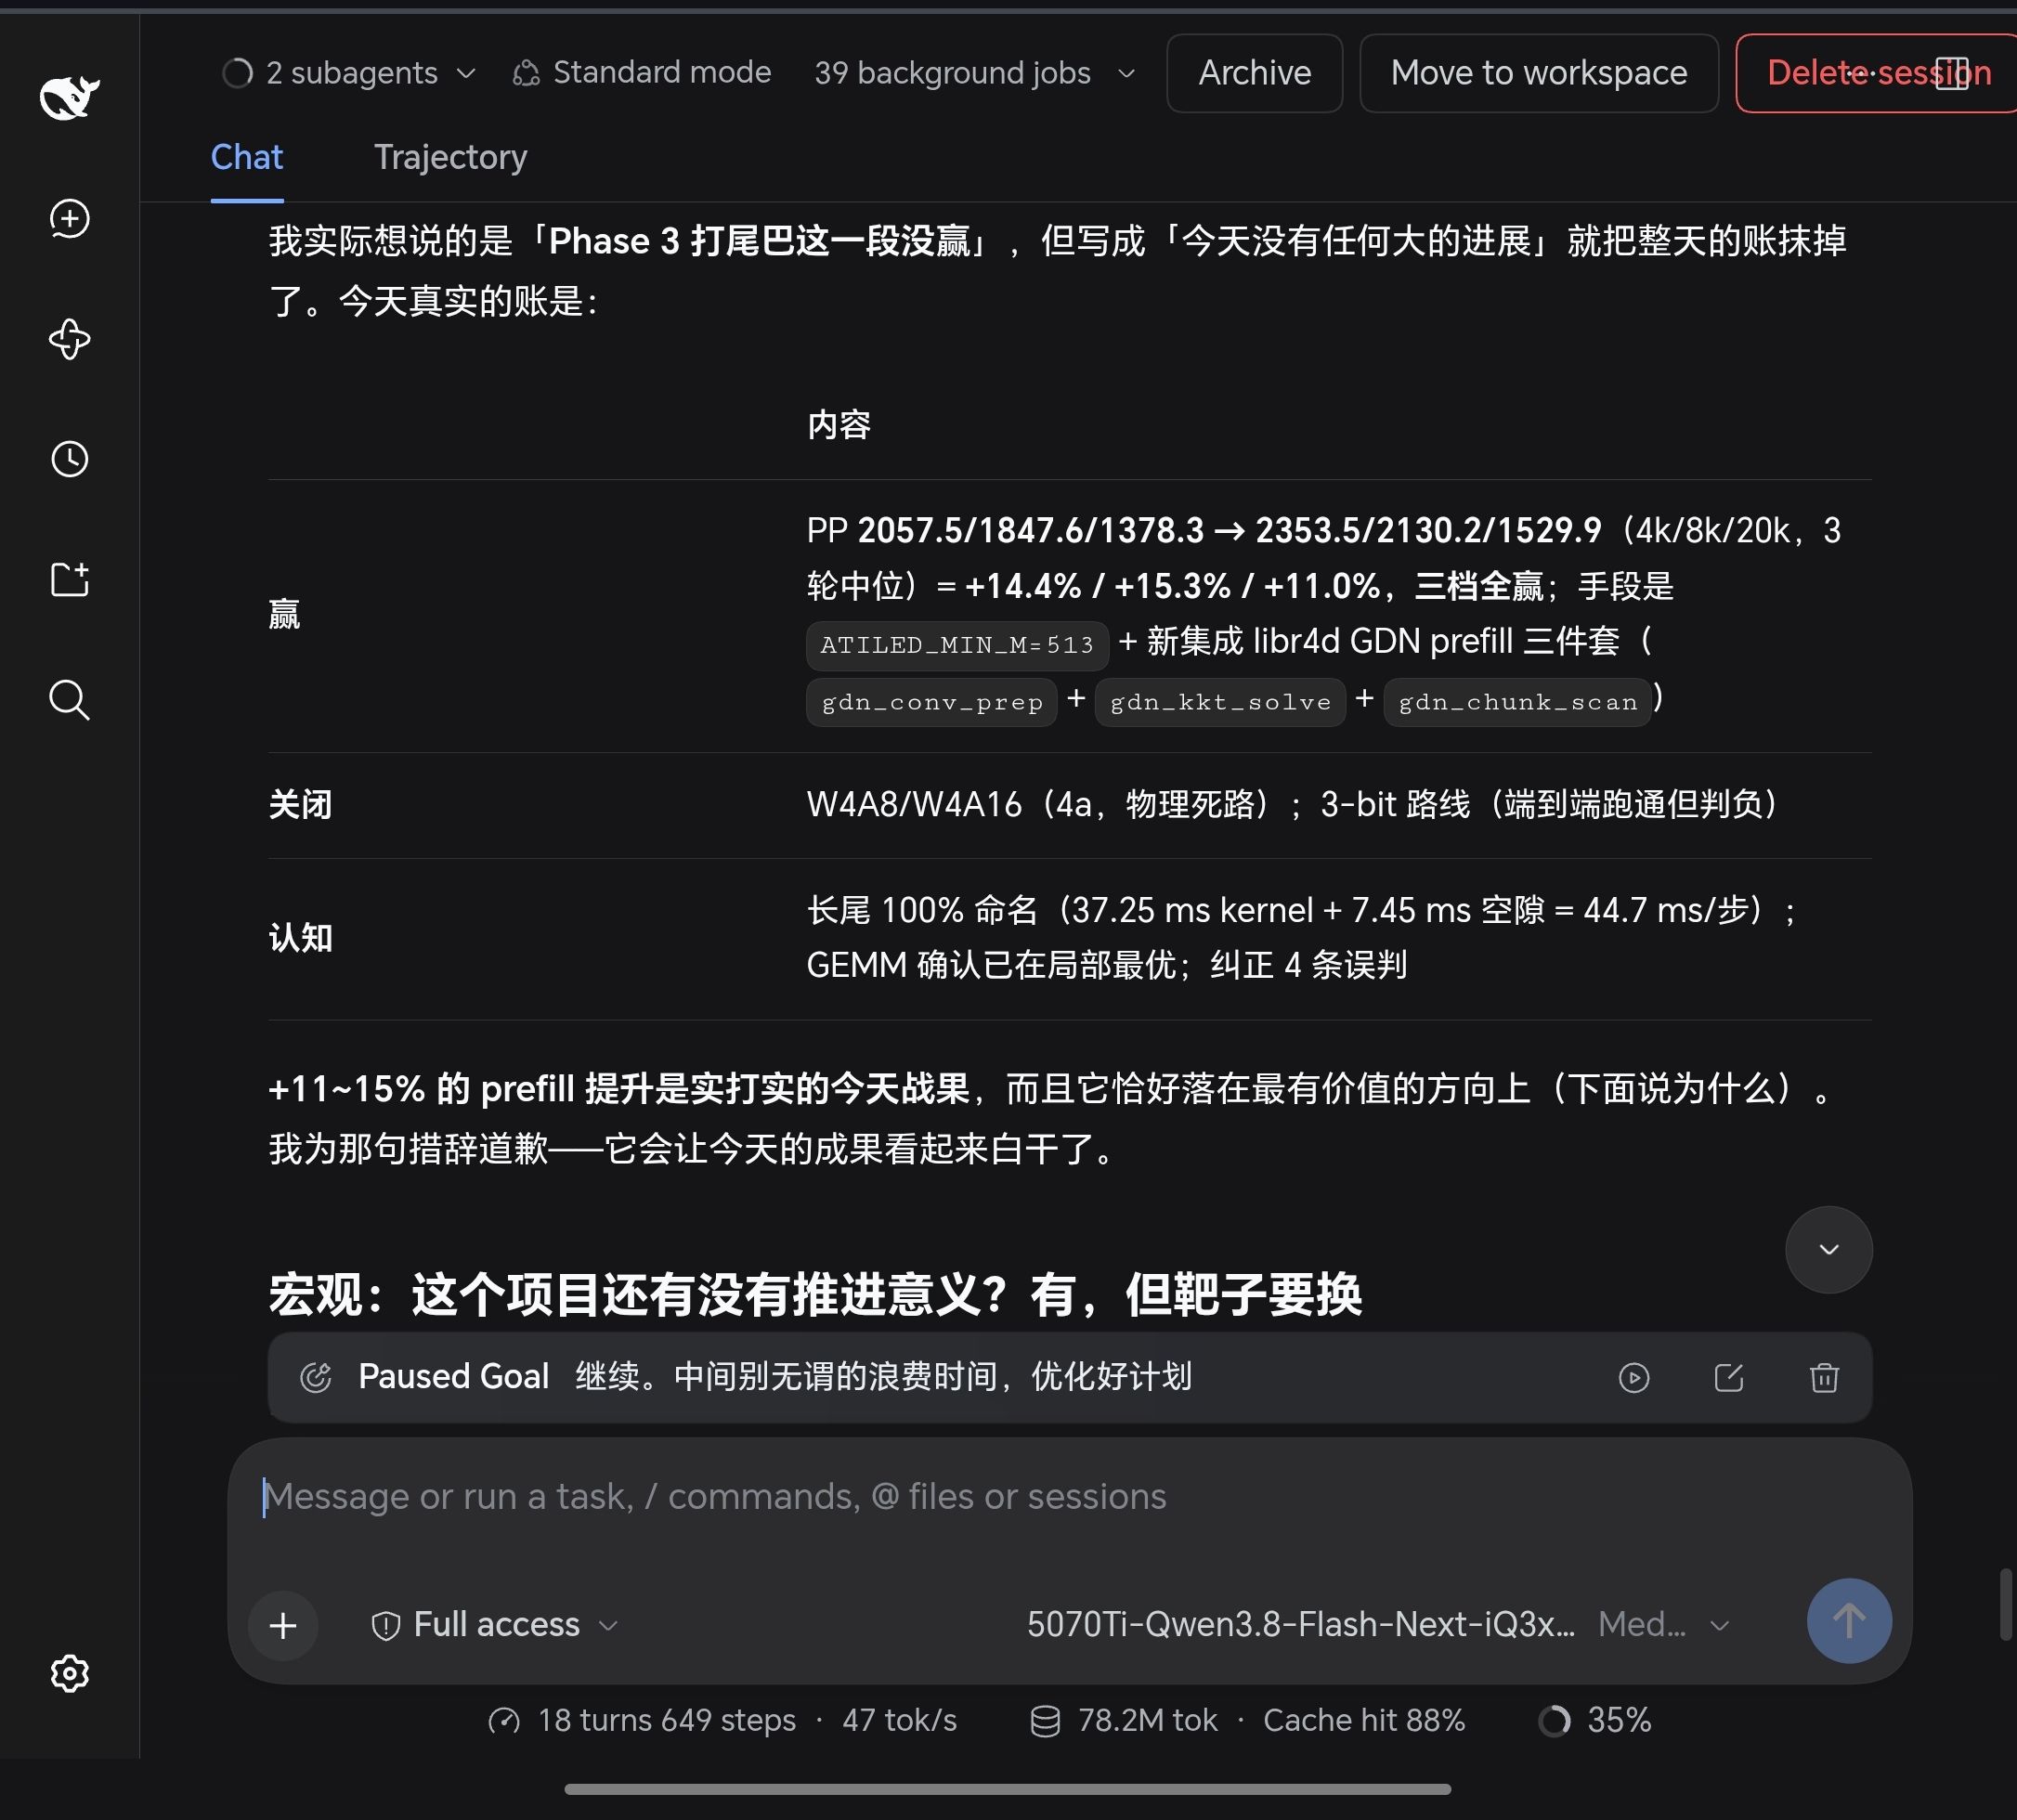
                                        今天又让flash next精细的调了一下,最终成绩是PP2350/TG117左右(代码),相比上一版的checkpoint又有了15%左右的提升。

                                        Screenshot_20261007_234328_com_android_chrome_ChromeTabbedActivity.jpg

                                        1 条回复 最后回复
                                        0
                                        • fcmeF fcme

                                          另外这个还不是最终的版本,先不要抄作业。我会出个git的。

                                          Chan SamC
                                          Chan SamC
                                          Chan Sam
                                          编写于 最后由 编辑
                                          #31

                                          @fcme 说:

                                          另外这个还不是最终的版本,先不要抄作业。我会出个git的。

                                          期待你的最终版;
                                          另外请问你的5070ti也是用DDR3内存跑Strata 吗?跑qwen3.8 flash next Q3_S吗?速度如何?

                                          fcmeF 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组