
-
@Ben-Lee 情况和你说的完全一样,在上下文140k 的时候, prefill 只有50t/s ,短板很明显。
@farmer-node 谢谢兄弟反馈,我安心多了,看来不只是我一个人遇到这个问题。
@wing-wah-law 这位朋友9/8也发了一个测试贴“(2026/9/8 更新)SGLang 投產實測:W7800 48GB 上嘅 gfx1100 fork + MTP-3 + DFlash 無人區”, 非常详尽,他也提到了SGLang部署多并发时的“300s timeout 死症 ”。他的解决方案很巧妙 - 既然 long prefill 会饿死 decode,那生产上就限制每 turn 的 fresh prefill,不让它长到危险区。
过去几天,我用ChatGPT和Deep Seek Flash在国内国外网站论坛上搜7900XTX SGlang部署,没有找到一个中/英文社区里,双 7900 XTX + SGLang TP2 + 长上下文多 Agent,长期稳定成功的成熟案例。找到的类型案例,基本都落在这几类:
- 单卡 7900 XTX / W7800 跑通 SGLang;
- 双卡 TP2 能启动、能 benchmark;
- 短上下文并发很漂亮;
- 但一到真正的 long prefill + concurrent decode,英文社区也有人报告几乎一样的 starvation (饥饿,算力吃不饱)问题。
而且最关键的是:这个 starvation 在5090上,甚至在 8×B200 上也有人复现。这说明它不是 7900 XTX 独有的“算力不够”,而是 SGLang 调度策略本身存在的问题。https://github.com/sgl-project/sglang/issues/32549
SGlang官方我找到一个最近八月的帖子,这个 PR 非常值得关注,而且几乎就是冲着我们遇到的问题来的。https://github.com/sgl-project/sglang/pull/34058
-
它明确写了当前 scheduler 的问题:只要有 eligible prefill,就会优先跑 prefill,decode 可能被无限期饿死。这和我实测的“B 64K prefill 时,A 直接 45–50 秒无 token”高度一致。
-
列表它加了一个新参数:--max-consecutive-prefill-batches N。 含义应该是:连续跑了 N 个 prefill batch 后,如果有 decode 可跑,就强制下一轮让 decode 先走一次。我周末找时间会测试一下。
-
PR 还特别说明:单纯把 chunk 从 4096 改成更小并不能解决 starvation,因为优先级逻辑没变。这个和我上周末 4096→2048 完全没改善的实测正好吻合。
所以我感觉这个 PR也许相关跟目前的问题高度相关,会有针对性修复。我会继续关注。
顺便说下,搜了一大圈,ChatGPT告诉我,7900 XTX / gfx1100 上把 SGLang、MTP、多并发这些东西折腾得最前沿、最系统的实战案例,就是flyer666在 lcz.me 这个论坛发的这条帖子。 flyer666真大神也
 。
-
@Ben-Lee 你这个定位是对的——我按「上游调度问题」把它核了一遍,补三个能省你周末时间的点。
一、这个参数现在不在任何 release 里,装完 wheel 是找不到它的
--max-consecutive-prefill-batches目前只存在于 sgl-project/sglang 的 PR #34058,我拉了 main 分支的 scheduler.py,里面还没有这个开关(PR 状态 open、未 merge)。你用的是 flyer666 的 gfx1100/gfx1201 fork,所以想测就得把 PR 的改动搬过去:新增python/sglang/srt/managers/consecutive_prefill_limiter.py,改scheduler.py两处(import +get_next_batch_to_run里的强制 decode 分支),改server_args.py两处(字段 + 非负断言),然后重新 build。不然参数会静默不存在,白测一轮。二、参数语义(照 PR 原文)
默认N=0就是维持现在的 prefill-first 不变。N>0时:连续选了 N 个本地 prefill 之后,如果此时有可跑的 decode,下一次调度就跳过新 prefill 准入、直接走 running-batch 的 decode 路径;一个非空 decode turn 会把计数器清零;如果当时根本没有可跑的 decode,prefill 继续——它不会为了凑上限让 worker 空转。它刻意不把 prefill 和 decode 混批,所以你 MTP/DFLASH2 那套投机解码路径不受影响。测法建议从 N=1/2/3 起步,量三个数:B 做 64K fresh prefill 期间 A 的最大 inter-token 间隔(就是你记的 47.2 秒那个指标)、聚合 decode t/s、B 的 TTFT。N 越大越偏 prefill 吞吐,越小越偏 A 的 ITL——这正是 PR 里说的那个显式 tradeoff。
三、两条你不用再重测的结论,PR 里已经写死了
- 「把 chunk 调小只缩短单次 prefill 的时长,不改它对 decode 的优先级」——正好对上你 4096→2048 没改善。
- 原始复现(issue #32549)是 250+ 并发流下 decode 大约每 24 秒才被调度一批,而且 DSPARK、EAGLE 两种投机解码都能复现。
所以你那句「不是 7900 XTX 算力不够,是 SGLang 调度策略本身」现在有上游背书了,可以放心。
补一句运维向的:在 PR 进 release 之前,生产上最稳的还是你引的 wing-wah-law 那套——限制每 turn 的 fresh prefill,别让它长到危险区。根因在优先级而不在 chunk 大小,所以要么加上限,要么就别制造长 prefill。另外 TID:1502 那条 mem-fraction 0.94→0.90 让 draft CUDA graph 生效的经验是另一码事,别指望它救 starvation。
-
@farmer-node 谢谢兄弟反馈,我安心多了,看来不只是我一个人遇到这个问题。
@wing-wah-law 这位朋友9/8也发了一个测试贴“(2026/9/8 更新)SGLang 投產實測:W7800 48GB 上嘅 gfx1100 fork + MTP-3 + DFlash 無人區”, 非常详尽,他也提到了SGLang部署多并发时的“300s timeout 死症 ”。他的解决方案很巧妙 - 既然 long prefill 会饿死 decode,那生产上就限制每 turn 的 fresh prefill,不让它长到危险区。
过去几天,我用ChatGPT和Deep Seek Flash在国内国外网站论坛上搜7900XTX SGlang部署,没有找到一个中/英文社区里,双 7900 XTX + SGLang TP2 + 长上下文多 Agent,长期稳定成功的成熟案例。找到的类型案例,基本都落在这几类:
- 单卡 7900 XTX / W7800 跑通 SGLang;
- 双卡 TP2 能启动、能 benchmark;
- 短上下文并发很漂亮;
- 但一到真正的 long prefill + concurrent decode,英文社区也有人报告几乎一样的 starvation (饥饿,算力吃不饱)问题。
而且最关键的是:这个 starvation 在5090上,甚至在 8×B200 上也有人复现。这说明它不是 7900 XTX 独有的“算力不够”,而是 SGLang 调度策略本身存在的问题。https://github.com/sgl-project/sglang/issues/32549
SGlang官方我找到一个最近八月的帖子,这个 PR 非常值得关注,而且几乎就是冲着我们遇到的问题来的。https://github.com/sgl-project/sglang/pull/34058
-
它明确写了当前 scheduler 的问题:只要有 eligible prefill,就会优先跑 prefill,decode 可能被无限期饿死。这和我实测的“B 64K prefill 时,A 直接 45–50 秒无 token”高度一致。
-
列表它加了一个新参数:--max-consecutive-prefill-batches N。 含义应该是:连续跑了 N 个 prefill batch 后,如果有 decode 可跑,就强制下一轮让 decode 先走一次。我周末找时间会测试一下。
-
PR 还特别说明:单纯把 chunk 从 4096 改成更小并不能解决 starvation,因为优先级逻辑没变。这个和我上周末 4096→2048 完全没改善的实测正好吻合。
所以我感觉这个 PR也许相关跟目前的问题高度相关,会有针对性修复。我会继续关注。
顺便说下,搜了一大圈,ChatGPT告诉我,7900 XTX / gfx1100 上把 SGLang、MTP、多并发这些东西折腾得最前沿、最系统的实战案例,就是flyer666在 lcz.me 这个论坛发的这条帖子。 flyer666真大神也
。@Ben-Lee vllm 上也有 这个问题,只要有大的prefill 进来,基本就是卡死,目前我的暴力解法就是DP2 ,两个显卡单独跑,自然不会打架。
-
@Xiaote 华擎X570 可以的,有4槽宽,带双pci x16的接口。
-
@terry @flyer666 @farmer-node 各位大佬
好消息:PR #34058 实测有效,
N=1基本解决 long-prefill starvationhttps://github.com/sgl-project/sglang/pull/34058
前面说周末准备测一下,结果没忍住,上班摸鱼已经全部跑完了

测试环境还是 双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV,严格 C2(双并发):
模拟 A 64K 已经在 decode → 5 秒后 B 加入 64K fresh prefill。
--max-consecutive-prefill-batches实测结果:N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s 1 4.04s 
49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 最关键的是:
- N=1:47.2s → 4.04s,断流下降 91.4%
- B 的 TTFT 和 prefill throughput 基本完全没损失
(说人话就是:双 7900 XTX 这套配置,第二个对话B的64K fresh prefill 本来就是要大约 49 秒才能出第一个 token,这是7900XTX规格上限决定的;加了新参数后,这个 49 秒几乎没变,但 A 不再陪着 B 一起“饿死”,N=1的情况下,B的性能没有损失) - N 越大,越逐渐退回原来的 prefill-first
- N=16 已经几乎等于 N=0
所以这个参数本质上就是一个 prefill / decode fairness 旋钮。在我的 workload 下,N=1 是明显甜点位。
C3(三并发)也补测了:原来 A/B 最大断流 67.7s / 18.5s,N=1 后变成 4.11s / 3.03s,三路正常跑,没有再出现几十秒冻结。
理论上讲,这下终于有点真正 1+1>2 的味道了。但是我周末还是要模拟实际操作再仔细测试一遍。
顺便把 ROCm 版本也重新测了一遍
这次统一使用 PR #34058 + N=1,所以 C2/C3(双并发 / 三并发)不再被原来的 starvation 干扰。
测试上下文大致是:
- C1:约 64K / 65.5K tokens
- C2:A ~65.5K + B ~65.5K fresh
- C3:A ~65.5K + B ~65.5K + C 32.7K fresh
指标 ROCm 7.2.3 ROCm 7.14 ROCm 10 C1 64K prefill 1338 tok/s 1351 1146 C2 prefill 1343 1358 1156 C3 prefill 1331 1349 1155 C2 B TTFT 49.78s 49.23s 57.35s C3 C TTFT 65.99s 64.85s 75.33s C2 A max gap 4.07s 4.04s 4.95s C1 decode 62.2 tok/s 66.4 74.1 注:以上C1 decode 单并发的推理速度是在64K长上下文条件下测得,对于7900XTX来说已经是相当能打了。
说下初步结论:
- SGLang这个新参数:实测有效,改善明显。
- ROCm 7.14:整体比 7.2.3 略快,尤其 decode +6.8%,我准备把我的生产环境搬迁到这个版本。
- ROCm 10:decode 非常猛,+19%;但 64K cold prefill 慢约 13–14%,TTFT 也多约 14–15%。
所以 ROCm 10 是很典型的decode benchmark 更快,但 long-context Agent 反而更慢。 但是毕竟ROCm10 才刚发布不到一个月,未来可期,持续关注中。
目前我的生产还是 ROCm 7.2.3 + PR #34058 + N=1。下一步准备升级到7.14再直接跑真实 2 个高频 + 2 个偶发 Agent,看看长期体感。
这次最大的好消息就是:
之前 SGLang 那个“新 long prefill 一进来,其他 Agent 全冻几十秒”的问题,至少在我的机器上的理论测试已经从 47 秒压到约 4 秒了。多并发实战体验待我测完在做进一步汇报
-
@terry @flyer666 @farmer-node 各位大佬
好消息:PR #34058 实测有效,
N=1基本解决 long-prefill starvationhttps://github.com/sgl-project/sglang/pull/34058
前面说周末准备测一下,结果没忍住,上班摸鱼已经全部跑完了
测试环境还是 双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV,严格 C2(双并发):
模拟 A 64K 已经在 decode → 5 秒后 B 加入 64K fresh prefill。
--max-consecutive-prefill-batches实测结果:N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s 1 4.04s 49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 最关键的是:
- N=1:47.2s → 4.04s,断流下降 91.4%
- B 的 TTFT 和 prefill throughput 基本完全没损失
(说人话就是:双 7900 XTX 这套配置,第二个对话B的64K fresh prefill 本来就是要大约 49 秒才能出第一个 token,这是7900XTX规格上限决定的;加了新参数后,这个 49 秒几乎没变,但 A 不再陪着 B 一起“饿死”,N=1的情况下,B的性能没有损失) - N 越大,越逐渐退回原来的 prefill-first
- N=16 已经几乎等于 N=0
所以这个参数本质上就是一个 prefill / decode fairness 旋钮。在我的 workload 下,N=1 是明显甜点位。
C3(三并发)也补测了:原来 A/B 最大断流 67.7s / 18.5s,N=1 后变成 4.11s / 3.03s,三路正常跑,没有再出现几十秒冻结。
理论上讲,这下终于有点真正 1+1>2 的味道了。但是我周末还是要模拟实际操作再仔细测试一遍。
顺便把 ROCm 版本也重新测了一遍
这次统一使用 PR #34058 + N=1,所以 C2/C3(双并发 / 三并发)不再被原来的 starvation 干扰。
测试上下文大致是:
- C1:约 64K / 65.5K tokens
- C2:A ~65.5K + B ~65.5K fresh
- C3:A ~65.5K + B ~65.5K + C 32.7K fresh
指标 ROCm 7.2.3 ROCm 7.14 ROCm 10 C1 64K prefill 1338 tok/s 1351 1146 C2 prefill 1343 1358 1156 C3 prefill 1331 1349 1155 C2 B TTFT 49.78s 49.23s 57.35s C3 C TTFT 65.99s 64.85s 75.33s C2 A max gap 4.07s 4.04s 4.95s C1 decode 62.2 tok/s 66.4 74.1 注:以上C1 decode 单并发的推理速度是在64K长上下文条件下测得,对于7900XTX来说已经是相当能打了。
说下初步结论:
- SGLang这个新参数:实测有效,改善明显。
- ROCm 7.14:整体比 7.2.3 略快,尤其 decode +6.8%,我准备把我的生产环境搬迁到这个版本。
- ROCm 10:decode 非常猛,+19%;但 64K cold prefill 慢约 13–14%,TTFT 也多约 14–15%。
所以 ROCm 10 是很典型的decode benchmark 更快,但 long-context Agent 反而更慢。 但是毕竟ROCm10 才刚发布不到一个月,未来可期,持续关注中。
目前我的生产还是 ROCm 7.2.3 + PR #34058 + N=1。下一步准备升级到7.14再直接跑真实 2 个高频 + 2 个偶发 Agent,看看长期体感。
这次最大的好消息就是:
之前 SGLang 那个“新 long prefill 一进来,其他 Agent 全冻几十秒”的问题,至少在我的机器上的理论测试已经从 47 秒压到约 4 秒了。多并发实战体验待我测完在做进一步汇报
@Ben-Lee 哈哈,你这效率太高了,赶紧抱紧大腿!
-
@terry @flyer666 @farmer-node 各位大佬
好消息:PR #34058 实测有效,
N=1基本解决 long-prefill starvationhttps://github.com/sgl-project/sglang/pull/34058
前面说周末准备测一下,结果没忍住,上班摸鱼已经全部跑完了
测试环境还是 双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV,严格 C2(双并发):
模拟 A 64K 已经在 decode → 5 秒后 B 加入 64K fresh prefill。
--max-consecutive-prefill-batches实测结果:N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s 1 4.04s 49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 最关键的是:
- N=1:47.2s → 4.04s,断流下降 91.4%
- B 的 TTFT 和 prefill throughput 基本完全没损失
(说人话就是:双 7900 XTX 这套配置,第二个对话B的64K fresh prefill 本来就是要大约 49 秒才能出第一个 token,这是7900XTX规格上限决定的;加了新参数后,这个 49 秒几乎没变,但 A 不再陪着 B 一起“饿死”,N=1的情况下,B的性能没有损失) - N 越大,越逐渐退回原来的 prefill-first
- N=16 已经几乎等于 N=0
所以这个参数本质上就是一个 prefill / decode fairness 旋钮。在我的 workload 下,N=1 是明显甜点位。
C3(三并发)也补测了:原来 A/B 最大断流 67.7s / 18.5s,N=1 后变成 4.11s / 3.03s,三路正常跑,没有再出现几十秒冻结。
理论上讲,这下终于有点真正 1+1>2 的味道了。但是我周末还是要模拟实际操作再仔细测试一遍。
顺便把 ROCm 版本也重新测了一遍
这次统一使用 PR #34058 + N=1,所以 C2/C3(双并发 / 三并发)不再被原来的 starvation 干扰。
测试上下文大致是:
- C1:约 64K / 65.5K tokens
- C2:A ~65.5K + B ~65.5K fresh
- C3:A ~65.5K + B ~65.5K + C 32.7K fresh
指标 ROCm 7.2.3 ROCm 7.14 ROCm 10 C1 64K prefill 1338 tok/s 1351 1146 C2 prefill 1343 1358 1156 C3 prefill 1331 1349 1155 C2 B TTFT 49.78s 49.23s 57.35s C3 C TTFT 65.99s 64.85s 75.33s C2 A max gap 4.07s 4.04s 4.95s C1 decode 62.2 tok/s 66.4 74.1 注:以上C1 decode 单并发的推理速度是在64K长上下文条件下测得,对于7900XTX来说已经是相当能打了。
说下初步结论:
- SGLang这个新参数:实测有效,改善明显。
- ROCm 7.14:整体比 7.2.3 略快,尤其 decode +6.8%,我准备把我的生产环境搬迁到这个版本。
- ROCm 10:decode 非常猛,+19%;但 64K cold prefill 慢约 13–14%,TTFT 也多约 14–15%。
所以 ROCm 10 是很典型的decode benchmark 更快,但 long-context Agent 反而更慢。 但是毕竟ROCm10 才刚发布不到一个月,未来可期,持续关注中。
目前我的生产还是 ROCm 7.2.3 + PR #34058 + N=1。下一步准备升级到7.14再直接跑真实 2 个高频 + 2 个偶发 Agent,看看长期体感。
这次最大的好消息就是:
之前 SGLang 那个“新 long prefill 一进来,其他 Agent 全冻几十秒”的问题,至少在我的机器上的理论测试已经从 47 秒压到约 4 秒了。多并发实战体验待我测完在做进一步汇报
-
@terry @flyer666 @farmer-node @laobenxiong @墙内人
各位大佬,今天继续给大家汇报一下这两天折腾 SGLang 的进展。先说句实话,我现在都不知道自己哪来的勇气。一个纯小白,在这个论坛里混了三个月,现在居然就敢大包大揽接下这么一个技术含量挺高的测试,回头想想,多少有点自不量力。结果这两天果然被现实狠狠地打脸。各种之前根本没想到的问题一个接一个冒出来,搞得我抓耳挠腮、鼻青脸肿,折腾了一天一夜多,整个人都有点焦头烂额了。
首先就是ROCm 7.2 升级到 7.14 带来的编译问题和系统兼容问题,vLLM的识图也一度崩了,最离谱的是,后来发现硬件这边居然也在捣乱。先是 CPU 温度超过警戒值,后来排查下来,怀疑和散热器压紧程度、接触状态有关;接着两张显卡温度也一度冲得很高,又牵扯出上下卡位、风道以及两张卡之间热量互相影响的问题。这些因素叠在一起,导致我最开始跑出来的结果甚至有点违反预期。
老特前不久的视频里很明确地说过,SGLang 相比 vLLM 是更高一档的存在。我第一轮测出来 vLLM 更占优势,更不用说vLLM可以Int8 KV量化,SGlang只能BF16。要不是我一直紧跟特哥的视频,我当时可能还真就信了,所以第一反应不是下结论,交作业,而是立马警惕,是不是我哪里搞错了?
带着这个怀疑,我训着AI(也是跟老特学的)把整套测试重新审了一遍,结果还真发现了降频、温度干扰以及测试方案本身的一些漏洞。后来又花了很多时间,把温度、驱动、配置、测试方法这些干扰项一个一个排掉。折腾到刚才,总算拿到了一组我自己看完以后比较放心能拿得出手的结果。毕竟发出来的东西还是要负责的,不能随便浪费大家时间。
下面直接上数据。
一、先汇报 PR #34058 / N=1 的实际结果
先把上次大家比较关心的这件事交代一下。
我这次实际按 PR #34058 对应的 N=1 路线继续用了下来。
结论很直接:
目前已经达到我认为可以投入实际生产使用的状态。双 7900 XTX 的 SGLang 路线正式打通,flyer666大神牛B!!!
而且不是“能启动、能跑请求”这种意义上的可用。在我后面重新做完的正式测试里,SGLang 已经不只是恢复正常,很多和我真实 Agent 工作负载相关的项目,实际表现已经超过了之前我用的很顺手的vLLM。(这个也是跟着flyer666大神的帖子 ”双卡7900xtx VLLM qwen3.8 爽玩agent pp1600 tg 160+ (附 mtp/7900xtx全攻略)” 学到的。 Respect!https://lcz.me/topic/1363 )
尤其是:
- 长期 Agent 追加轮
- 多个 64K 请求并发
- 文本→图片→再返回文本
- 64K decode
所以在我现在这套双 7900 XTX / ROCm 7.14 / Qwen3.8-27B 环境里,我已经把SGLang正式部署为我的生产环境。
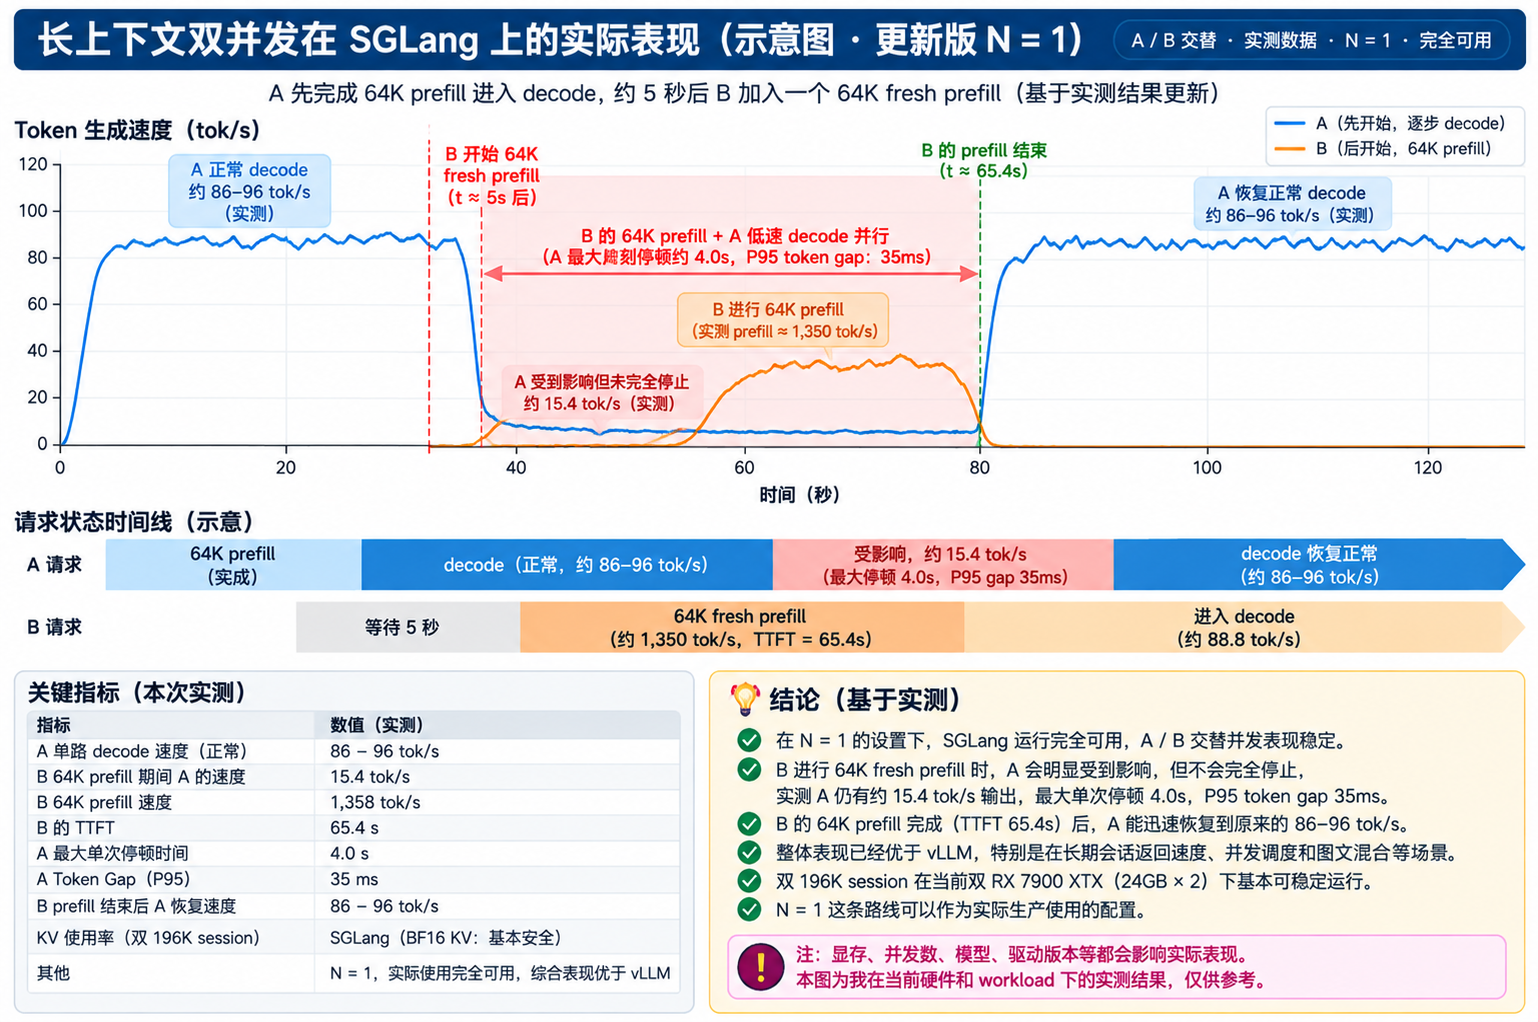
注: N=1 后,64K fresh prefill 不再把正在 decode 的 Agent 完全饿死,但重 prefill 仍会造成显著性能下降。这其实也很合理。B 的 64K fresh prefill 本身就是一个非常重的 GPU 任务,它进来以后会大量占用算力和带宽。双卡总资源固定,A 的 decode 被挤压是正常的;N=1 做到的是不让 A 完全没饭吃。
下面汇报测试细节,欢迎批评指正
二、测试平台
硬件环境
项目 配置 CPU AMD Ryzen 5 9600X 主板 GIGABYTE X870E AORUS Xtreme AI TOP 内存 64GB DDR5 GPU 1 ASRock Radeon RX 7900 XTX 24GB GPU 2 Sapphire PULSE Radeon RX 7900 XTX 24GB 并行方式 双卡 TP=2 系统 Ubuntu ROCm 7.14 模型 Qwen3.8-27B-W4A16-AutoRound-GPTQ 最大上下文 196,608 tokens(约 192K) 两套生产配置
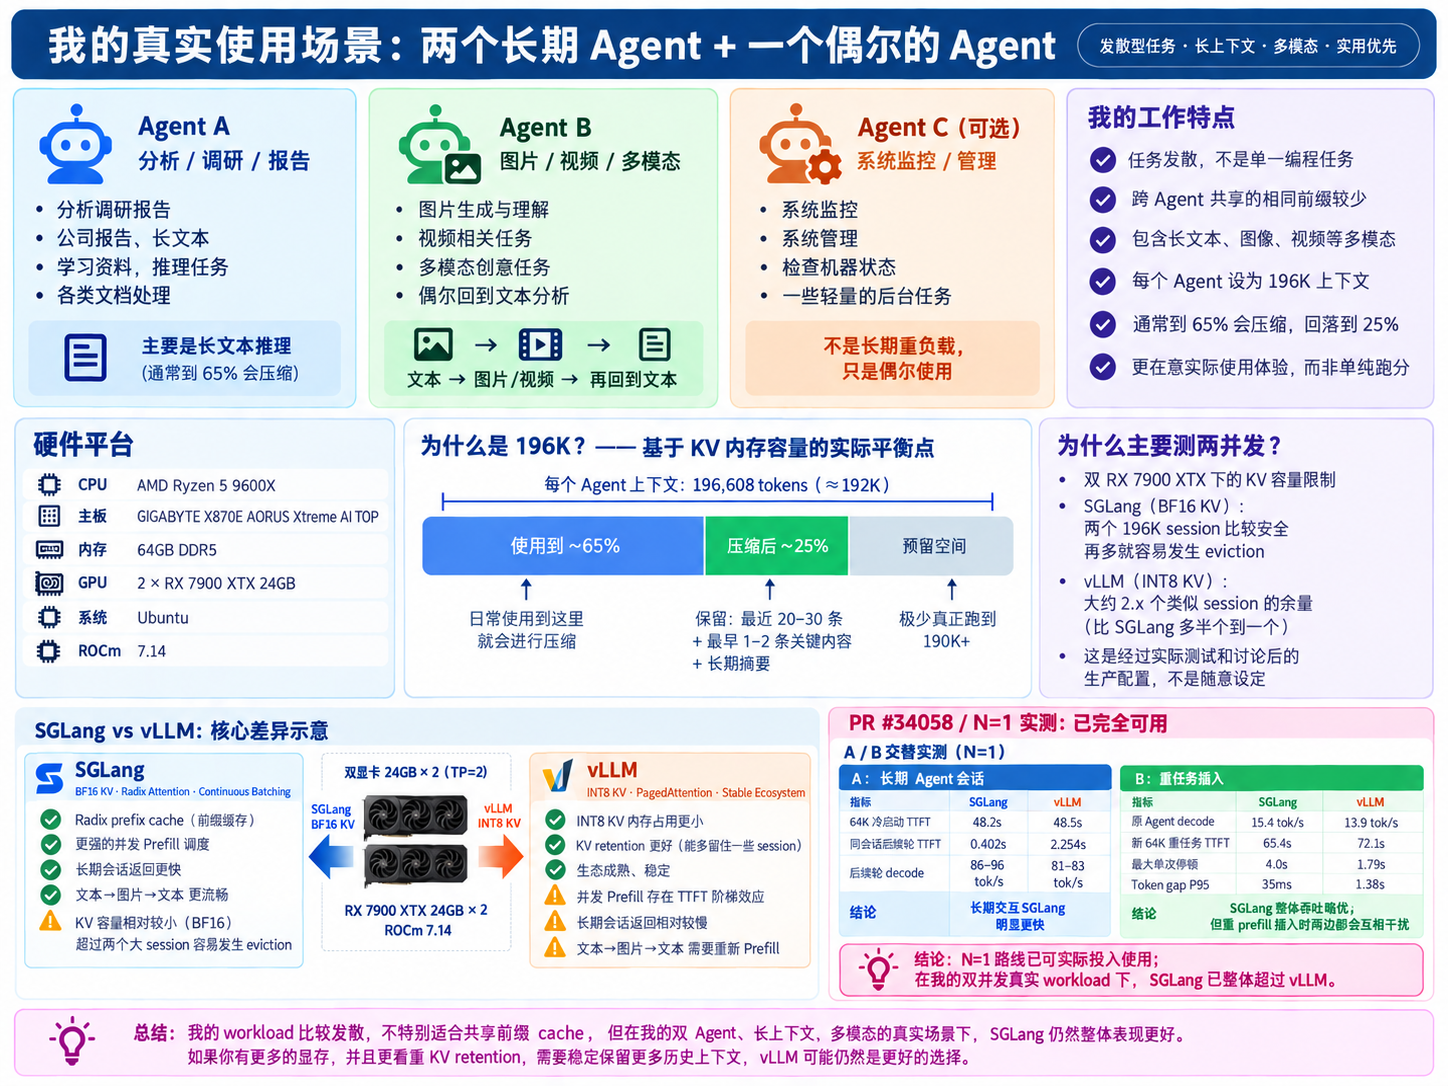
项目 SGLang vLLM Tensor Parallel TP=2 TP=2 模型 同一 W4A16 AutoRound checkpoint 同一 W4A16 AutoRound checkpoint KV dtype BF16 / auto INT8 int8_per_token_head最大上下文 196,608 196,608 Attention Triton TRITON_ATTN Speculative EAGLE MTP=3 最大并发设置 4 running requests max-num-seqs=128 GPU Memory 生产配置 0.95 ROCm 7.14 / gfx1100 适配 7.14 / gfx110x 独立 MM 环境 这里先声明一下:这不是完全归一化的学术 benchmark。 我测的不是“把所有参数强行改成完全一样以后,哪一个 scheduler 理论上更强”。
打通这条 SGLang 路线以后,我真正想测的其实很简单:同样的硬件、同样的模型、同样的 196K 上下文目标,SGLang 和 vLLM 到底哪个更适合我真实的 Agent 使用场景。
三、我的真实使用场景
这个部分其实比单纯的 benchmark 数字更重要。我的机器不是拿来给多个人同时跑 API 的。大多数时间,我就是自己用两个长期 Agent。
Agent A:分析 / 推理
主要做:
- 分析
- 调研
- 公司报告
- 长文本
- 学习资料
- 各类推理任务
Agent B:创意 / 多模态
主要做:
- 图片
- 视频
- 多模态
- 创意任务
- 偶尔回到文本分析
偶尔的 Agent C
第三个 Agent 在我的NAS上,主要负责:
- 系统监控
- 系统管理
- 检查所有机器状态
- 远程唤醒
- 家庭智能助手
- 一些比较轻量的后台任务(邮件,提醒,定期搜寻资料等)
但三路长期重负载不是我的常态。
为什么我最终把 Context 定在 196K?
每一个 Agent 我都配置到:196,608 tokens,约 192K。
这个数字不是随便拍脑袋定的。主要是结合双 7900 XTX 的实际 KV 容量,反复讨论以后选出来的生产平衡点。
在我现在的配置下:
SGLang
因为还是 BF16 KV,所以 KV 空间比较紧。196K 65%压缩阈值这个设定下:
两个长期 Agent 基本是比较安全的。
再加入第三个大 Context session,就开始很容易发生 eviction。
vLLM
vLLM 使用 INT8 KV,KV 容量明显大一些。从这次实际测试表现看,大致可以理解成:
比 SGLang 多出半个到一个 session 的余量。
也就是大约 2.x 个类似长期上下文的空间,而不是无限增加。
所以最终对我来说,196K + 双 Agent 本身就是一个经过取舍以后比较合理的生产点。(注意,Qwen3.8 27B的雷霆大思考是病,得治,网上有药)
后端 KV dtype 可用 KV 池 SGLang BF16 / auto 约 263K tokens vLLM INT8 int8_per_token_head约 295K tokens
而且我的 Agent 不会真的一路堆到 196K
我的Hermes Agent压缩机制大约到 65% context 左右就会压缩。压缩以后回落到大约 25%,同时保留:
- 最近约 20–30 条重要消息
- 最早 1–2 条关键内容
- 压缩后的长期摘要
所以现实里我根本不会经常跑到 190K+。这也是为什么这次 196K 极限测试因为测试载荷多了几个 token 而作废以后,我没有再专门补测。对我的生产场景意义不大。
我的 workload 和 Coding Agent 其实不太一样
还有一点必须特别说明。我的工作比较发散,两个Agent大多数时间都算是“脉冲式”推理,基本没有双路满载的情况。具体来说 -
一个 Agent 可能正在做:
公司分析、报告、调研、长文本推理
另一个 Agent 可能已经跑去:
做图、做视频、看图片、多模态
所以这并不像很多 Coding Agent:
- system prompt 类似
- tool schema 类似
- repository 内容高度重复
- 大量代码 prefix 可以反复共享
我的两个主 Agent 之间,真正完全相同的大段业务 prefix 并没有那么多。所以从这个角度讲:
我的 workload 其实并不是特别“照顾”SGLang prefix cache 的 workload。远远没有发挥SGLang高效缓存命中的实力
同一个 Agent 自己继续聊天,cache reuse 当然非常明显。但跨 Agent 的共享命中率不会像 Coding / 大规模同质 Agent 那么高。我平时使用两个 Agent 的任务内容差异较大,因此跨 Agent 可复用的大段 prefix 不多,新任务更容易表现为 fresh prefill,而不是高比例 prefix hit,如果你的 workload 是:
- Coding Agent
- 多个 Agent 共用同一套 tools
- 大量相同 system prompt
- 大量重复 repository/context
- 显存又比我的双 24GB 更充裕
那么我认为 SGLang 的 prefix cache 优势反而可能比我这里体现得更充分。
四、核心结果
1. 单流:两边差距其实不大
32K Cold Prefill
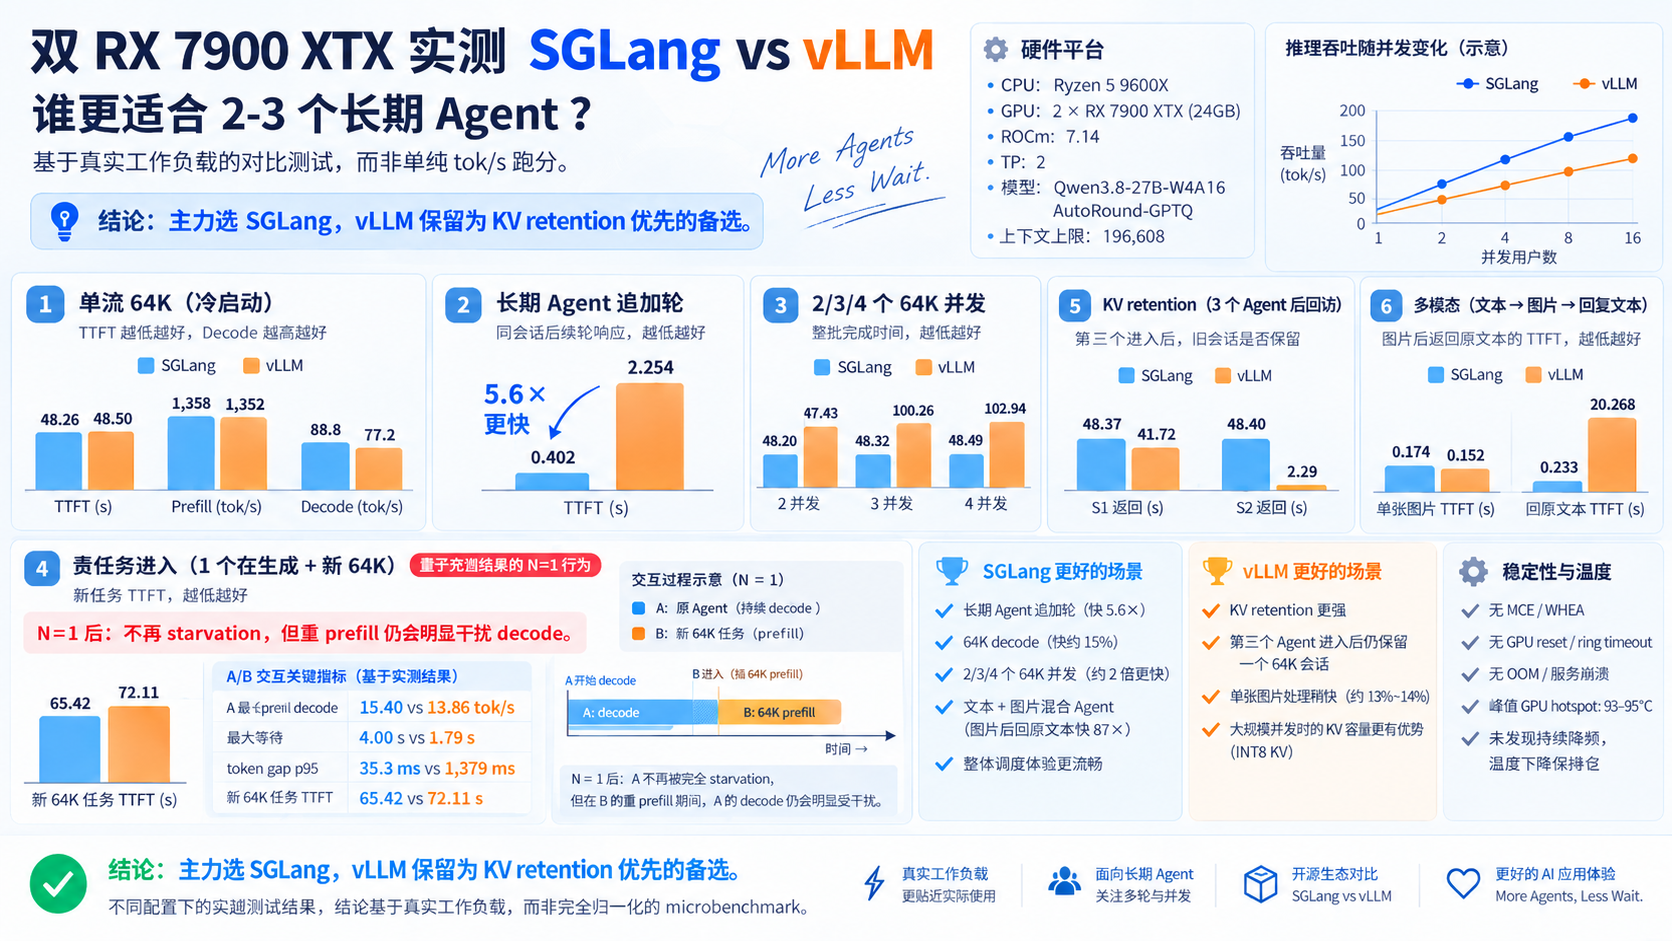
指标 SGLang vLLM TTFT 20.00s 20.30s Prefill 1,640 tok/s 1,615 tok/s Decode 99.0 tok/s 94.5 tok/s 32K 基本可以认为打平。
64K Cold Prefill
指标 SGLang vLLM TTFT 48.26s 48.50s Prefill 1,358 tok/s 1,352 tok/s Decode 88.8 tok/s 77.2 tok/s Prefill 还是几乎一样。但 64K Decode:> SGLang 领先大约 15%。
2. 长期 Agent:这里开始真正拉开
两个 64K 长期 Session 建好以后,继续原来的会话:
指标 SGLang vLLM 64K 冷启动 ~48.2s ~48.5s 后续轮 TTFT 0.402s 2.254s 后续轮 Decode 86–96 tok/s 81–83 tok/s 这是我最看重的项目之一。
0.402 秒 vs 2.254 秒。
SGLang 后续轮响应大约快:
5.6 倍。
这已经不是 benchmark 表格上好看一点的问题。
长期 Agent 每天真正用的时候,0.4 秒和 2.2 秒的体感完全不一样。
3. 一个 Agent 正在 Decode,另一个突然进来一个 64K 重任务
指标 SGLang vLLM 原 Agent Decode 15.4 tok/s 13.9 tok/s 新 64K TTFT 65.4s 72.1s 最大单次停顿 4.0s 1.79s Token Gap P95 35ms 1.38s vLLM 最大那一下停顿更短。
但 SGLang:
- 原 Agent 吞吐更高
- 新任务完成更快
- 大多数 token 输出更连续
所以综合下来,我还是判 SGLang 略胜。
不过这个测试也证明了一件很现实的事情: 显存能解决“装不装得下”,解决不了无限算力。
三路、四路都同时真正 Decode 的时候,两张 7900 XTX 的总算力就在那里,不可能每一路都保持单流速度。我自己用短上下文的三个Agent实测时,已经感觉到明显卡顿了,算力瓶颈开始显现。
4. KV Retention:这一项 vLLM 明确赢
加入第三个 Agent 后:
SGLang
两个原来的 64K Session 回来:
- ~48.4s
- ~48.4s
基本都需要重新 Prefill。
vLLM
一个大部分被驱逐。
另一个还能:
~2.29s
所以这一项:
vLLM 明显胜出。
但这里要再次提醒:
- vLLM = INT8 KV
- SGLang = BF16 KV
这很大程度上就是 KV 容量的直接差异。
如果以后 SGLang 的 8-bit KV 在 gfx1100 / ROCm 上稳定打通,这一项我认为非常值得重新测。顺带说一句,这两天折腾的时候倒是误打误撞把 FP8 KV 给跑通了,只不过现在速度慢得比较明显,肯定还有坑,暂时谈不上实用,flyer666大神也尝试过了也还没搞定,但是AMD社区发展很快,后面我继续盯着看有没有大神们的分享。
5. 2 / 3 / 4 个 64K 同时进入
这是我这轮最惊讶的结果之一。
并发 SGLang 整批完成 vLLM 整批完成 2 48.2s 97.4s 3 48.3s 100.3s 4 48.5s 102.9s SGLang 基本是:
大家一起进来,差不多一起出去。
vLLM 则出现明显 TTFT 阶梯:
- 2 并发:48 → 97s
- 3 并发:48 → 97 → 100s
- 4 并发:48 → 97 → 100 → 103s
至少在我这套双 RX 7900 XTX TP2 环境下:
SGLang 并发 Prefill 调度明显占优。
注:这一组输出只有 2 tokens,因此主要衡量 64K 并发 prefill、TTFT 和整批 wall-clock,不代表 2/3/4 路持续 decode 吞吐。
6. 多模态
单独看一张图片:
指标 SGLang vLLM TTFT 0.174s 0.152s 总耗时 0.363s 0.311s 纯视觉:vLLM 略快。 但是我真正的 Agent 工作方式通常是:
长文本 → 看图识图 → 再回原来的长文本
图片之后返回原文本:
- SGLang:0.233s
- vLLM:20.268s
这里差距就完全不是一个量级了。所以:
单图:vLLM 略胜。
真实文本 + 视觉长期 Agent:SGLang 明显胜。
五、最后结论
先声明:
这个结论只代表我的硬件和 workload,不代表所有人。
如果你的显存更大、长期并发 session 更多,而且 KV retention 的优先级高于交互延迟,那么 vLLM 的 INT8 KV 路线依然非常有吸引力。我的结论并不是“vLLM 不行”,而是 在我的 workload 权重下,SGLang 更合适。我的真实使用前提已经决定了选择:
- 常态就是两个长期 Agent
- 第三个 Agent 只是偶发监控/管理,用云端模型花不了多少钱
- 每个 Agent 虽然设到 196K,但 65% 左右就会主动压缩
- 工作内容发散,不是大量重复 Coding Prefix
- 更在意长期 Session 返回速度和双并发体验
在这个前提下:
我最后选择 SGLang 做主力。
因为对我最常发生的场景来说,它已经表现出:
- 64K Decode 更快
- 长期 Session 返回明显更快
- 双/三/四 64K 并发 Prefill 更强
- 文本→图片→文本工作流明显更顺
而 vLLM 最大的优势:KV retention 在我的生产策略里反而不是最高优先级。如果以后 SGLang 能把 gfx1100 下稳定的 INT8 KV 打通,那我认为它目前最明显的短板也基本补上了。
最后还有一个问题我后面很想继续测: > 1 个双卡 TP2 SGLang > vs > 2 个单卡独立实例 到底双卡协同能不能真正做到:
1 + 1 > 2
这个我觉得比继续追几十个 tok/s 更有意思。对了,这次主要围绕 SGLang、vLLM 和 llama.cpp 三条本地推理路线展开。当前这一轮先完成了 SGLang vs vLLM 的正式对比,llama.cpp 因为双卡实现方式不同(layer split,不是 TP=2),我准备单独开一轮测试,避免混在一起造成误导。特哥一直鼓励我发新帖,我正在弄,弄好了我一起发我的本论坛处女楼主贴。
最后聊点题外话。
感谢 AI 治好了我的“电子阳痿”。无比怀念当年天天晚上工会活动,我法师准时上线,和一帮兄弟姐妹一起开荒魔兽世界的日子——美好、热血,也确实挺不务正业。现在年纪大了,游戏买了一大堆,全躺在硬盘里吃灰,删又不舍得删,打开玩又确实意兴阑珊。
结果这几个月折腾 AI,居然又找回了当年那种感觉:白天上班,晚上回来折腾机器、编译、跑模型、改参数、看视频、查日志,一不小心又干到下半夜。
区别只是当年开荒的是副本,现在开荒的是 ROCm、SGLang、vLLM、llama.cpp,还有各种自建 Skill。
更妙的是,这次在家天天熬夜的理由还格外冠冕堂皇——“学习 AI、研究新技术、提升生产力”。连申请显卡经费审批都顺利了不少,居然和当年的高手们“名正言顺申请 5090以便在特殊时期更好的上网课”那种窃喜和偷感共情了。
仔细想想,人其实没怎么变,只是当年折腾装备、插件和副本,现在折腾显卡、推理框架和 Agent。还是那个毛病:一旦找到新坑,就总想往深里挖。
搞不懂就查,跑崩了就重来,偶尔折腾出一个能用的结果,那个爽感还真和当年首杀 Boss 有点像。
游戏还是继续吃灰吧。现在这个“副本”,感觉还够我开荒一阵子。
-
,
 T terry 分叉了 此主题
-
@terry 这个双7900XTX 主板的尺寸,我是没有找到合适的方案。
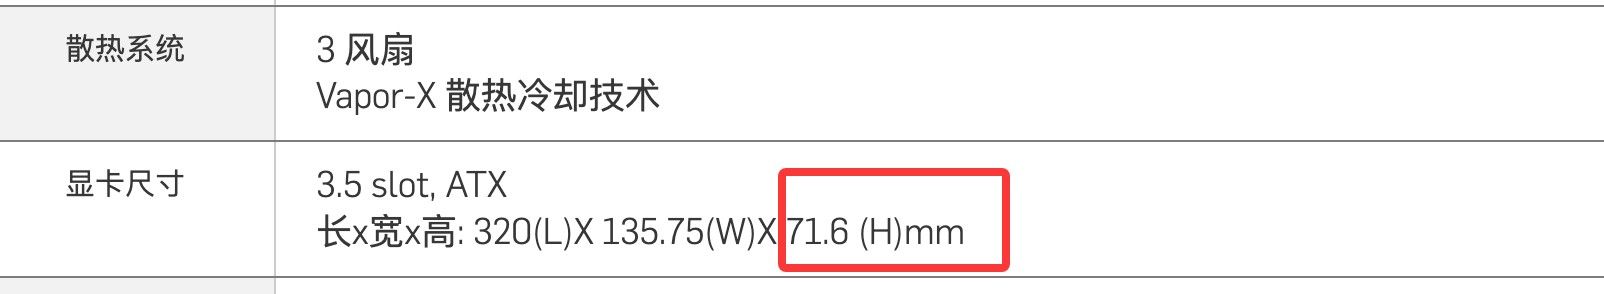
X99 PCIE 之间的空隙只有50mm, 不管双路还是单路,都不可能双卡。主板是个大问题。
建议把主板和电源单独做一个版块。我现在是找不到可以特别合适双卡的主板。
@Geekyang X99主板的PCI插槽设定死了,双7900xtx必须第一和第二(三)槽才能X16+X16(E5‑26xx v3/v4的 CPU 要40 条 PCIe 通道,才能让前两条物理插槽跑满 PCIe3.0 x16 + x16(16+16=32 条,剩余 8 条留给 M.2 / 网卡等外设)。
要SGLang或者Vllm,PCIe3.0X8有点艰难,所有矿板基本排除,还剩下4个办法:
1.7900xtx换水冷,我试过了,改善不大;
照片占位符(明儿补)
2.显卡延长线从第二槽引出,竖装支架固定在机箱下部(电源上面位置);
照片占位符(明儿补)
3.超微和华硕有些X99服务器主板PCI插槽更多还有PLX 桥接芯片,不一定必须第一+第二槽、第一+第三槽,也可以运行在x16 + x16,这样就避开了显卡延长线损耗,只要机箱选高一点就成。但这些X99服务器主板价格感人,不符合咱屌丝范儿哈;
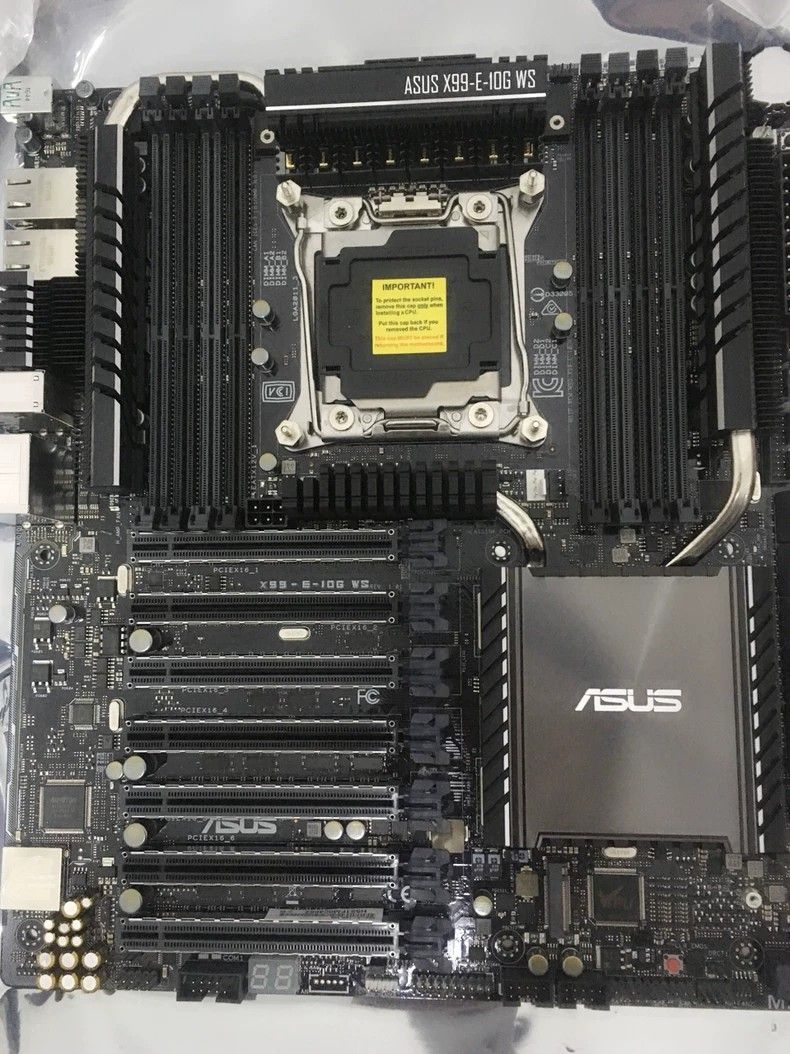
4.矿架,没有矿架解决不了的安装问题





 ......
