
我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。
-
我之前也以为 X99 基本没法搞 P2P,甚至已经在看 TRX40 / WRX80 和 PCIe Switch 板子了。
不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。
这件事不是改一个开关就行,我这边大概做了下面几层。
1. 先确认硬件拓扑没问题
两张 R9700 都是 CPU 直出的 PCIe 3.0 x16,但挂在不同的 Broadwell Root Port 下。
基础设置:
- Above 4G Decoding 开
- ReBAR 开
- CSM 关
- 两张卡确认都是 8GT/s x16
- 检查 BAR / IOMMU / PCIe topology
另外把整条 PCIe Path 的 MPS 都查了一遍。
X99/Broadwell Root Port 最大只支持 256B MPS,所以最终就保持256B,没有去强行改512/1024。
2. 先解决 AMDGPU / HSA 层面的跨 Root Port P2P
Broadwell-EP 这里有个比较麻烦的问题:
跨 Root Port P2PDMA + 44-bit DMA address / 大 BAR 映射 默认并不顺畅。
我这边最后使用了定制的:
6.8.12-r9700-p2p-dma44内核,把 X99/Broadwell 这层 P2P DMA 映射问题处理掉。
之后先不碰 SGLang,直接做底层测试。
HIP IPC 也单独验证过,使用:
HSA_ENABLE_IPC_MODE_LEGACY=0两张卡之间的 IPC 可以正常建立。
然后用 TransferBench / hipMemcpyPeerAsync 验证真正的 GPU→GPU 数据通路。
实测:
- GFX Push / Posted Write:约 10.29 GB/s
- SDMA / hipMemcpyPeerAsync:约 10.26~10.29 GB/s
- 双向同时传输 aggregate:约 19.7 GB/s
也就是说 PCIe 3.0 x16 的跨 Root Port P2P 实际已经跑到了比较正常的水平。
这里很重要的一点是:
先证明 GPU P2P 本身能工作,再折腾 RCCL。
3. RCCL 是第二个坑
底层 P2P 通了以后,Stock RCCL 还是不会自动使用它。
原因是两张卡跨 CPU Root Port,RCCL 把拓扑识别为:
PATH_PHBStock RCCL 会退回:
via SHM/direct/direct也就是说底层明明能 P2P,但 RCCL 还是绕系统内存。
当时实测:
- Stock RCCL SendRecv 1G:约 6.9 GB/s
- AllReduce BusBW:约 4.5 GB/s
所以还需要处理 RCCL。
4. 给 RCCL 做了一个很小的 patch
我现在用的是 patched RCCL 2.27.7。
修改其实很小,在:
src/graph/paths.cc里只有大约 6行顺序调整。
核心问题是 RCCL 对 Intel 平台设置默认 P2P level 的顺序,会把用户指定的 PHB override 覆盖掉。
修改后,让:
NCCL_P2P_LEVEL=PHB成为最终生效值。
这里要注意:
只设置环境变量没用。
我实际验证过:
- Stock RCCL +
NCCL_P2P_LEVEL=PHB→ 还是 SHM - Patched RCCL,不设置 PHB → 还是 SHM
- Patched RCCL +
NCCL_P2P_LEVEL=PHB→ Direct P2P
两者必须同时有。
我没有使用:
HSA_FORCE_FINE_GRAIN_PCIE=1
5. RCCL Direct P2P 打通后的结果
还是同一套 rccl-tests:
- SendRecv 1G:约 9.75 GB/s
- AllReduce BusBW:约 9.51 GB/s
- AllGather BusBW:约 9.16 GB/s
- ReduceScatter BusBW:约 8.92 GB/s
SendRecv 已经达到 TransferBench P2P Push 的约95%。
这时候基本可以确认:
RCCL 已经不是 SHM,而是真正走 GPU Direct P2P。
6. 最后再接 SGLang TP2
SGLang 启动后继续检查日志,不只是看“服务能跑”。
现在能够看到类似:
isAllDirectP2p 1以及:
via P2P/IPC确认 TP2 通信真正走 Direct P2P。
目前跑 Qwen3.8-27B AWQ,已经从1K一直测到251.5K context:
- 251.5K Prefill:约 712 tok/s
- 251.5K Native Decode:约 10.08 tok/s
- 251.5K input + 512 output:0 OOM
连续高负载测试也没有看到 PCIe AER、GPU reset 或 P2P掉线。
所以我现在对 X99 的看法和最开始完全不一样。
X99/Broadwell 不是硬件上完全不能 P2P,而是默认的软件路径很难直接用。
我这边实际上处理了两层:
第一层:
X99/Broadwell + AMDGPU/HSA 的跨 Root Port P2P DMA。第二层:
让 RCCL 接受PATH_PHB下的 Direct P2P,而不是自动退回 SHM。两层都打通以后,PCIe 3.0 x16 本身反而没有想象中那么差。
所以如果你的X99也是两张卡 CPU直连 x16+x16,我建议先把现有平台的 P2P 路径查清楚,不一定需要马上买 PCIe Switch。
Switch可以改善拓扑,但如果真正的问题是 AMDGPU / RCCL 软件策略,单纯加Switch未必就能解决。
后面我准备把 X99 双 R9700 从内核、TransferBench、RCCL到SGLang TP2的完整过程整理一下,应该比单独贴一个“跑通了”的结果更有参考价值。
🔧 X99 × Dual R9700 P2P Lab
https://lcz.me/projects/local/x99-amd-gpu-p2p -
此主題已被删除!
-
-
[[topic:post-is-deleted]]
大佬,从头到尾看完了,X99 跨 Root Port Direct P2P 跑通真的开眼界——之前一直以为硬件封死了,原来只是 kernel 白名单 + RCCL 策略两层软件问题。
我现在正计划 X99 + 双 R9700(已有 64GB DDR3),想抄你这条路线,有几个具体问题:
- 定制 kernel(
6.8.12-r9700-p2p-dma44)和 patched RCCL 2.27.7 可以公开 repo 吗? 还是只是本地改? - X99-TF GAMING V6.0 的 ReBAR 是官方 BIOS 原生选项,还是刷了 mod BIOS?
- 白名单 patch 是 Broadwell 专用,还是 Haswell(E5 v3)也适用?
- 模型 fit 不进单卡(比如 70B 级)时 TP2 实际加速多少? 27B 那个 1.01x 我理解是 fit 进单卡所以没意义,但真正需要双卡的模型有没有测过?
- 供电有没有遇到瞬态尖峰跳闸? 用了多少 W 电源、有没有做
pp_od_clk_voltage限频降压? - 你这套 P2P 配置对 vLLM 有没有意义,还是只有 SGLang 才行?
很期待你的完整 write-up,到时候一定跟着做一遍交作业!
我T7910 1300w 电源,双R9700 双卡限制在210w 才能保证同步工作不重启跳闸。
- 定制 kernel(
-
-
-
我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?
这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?
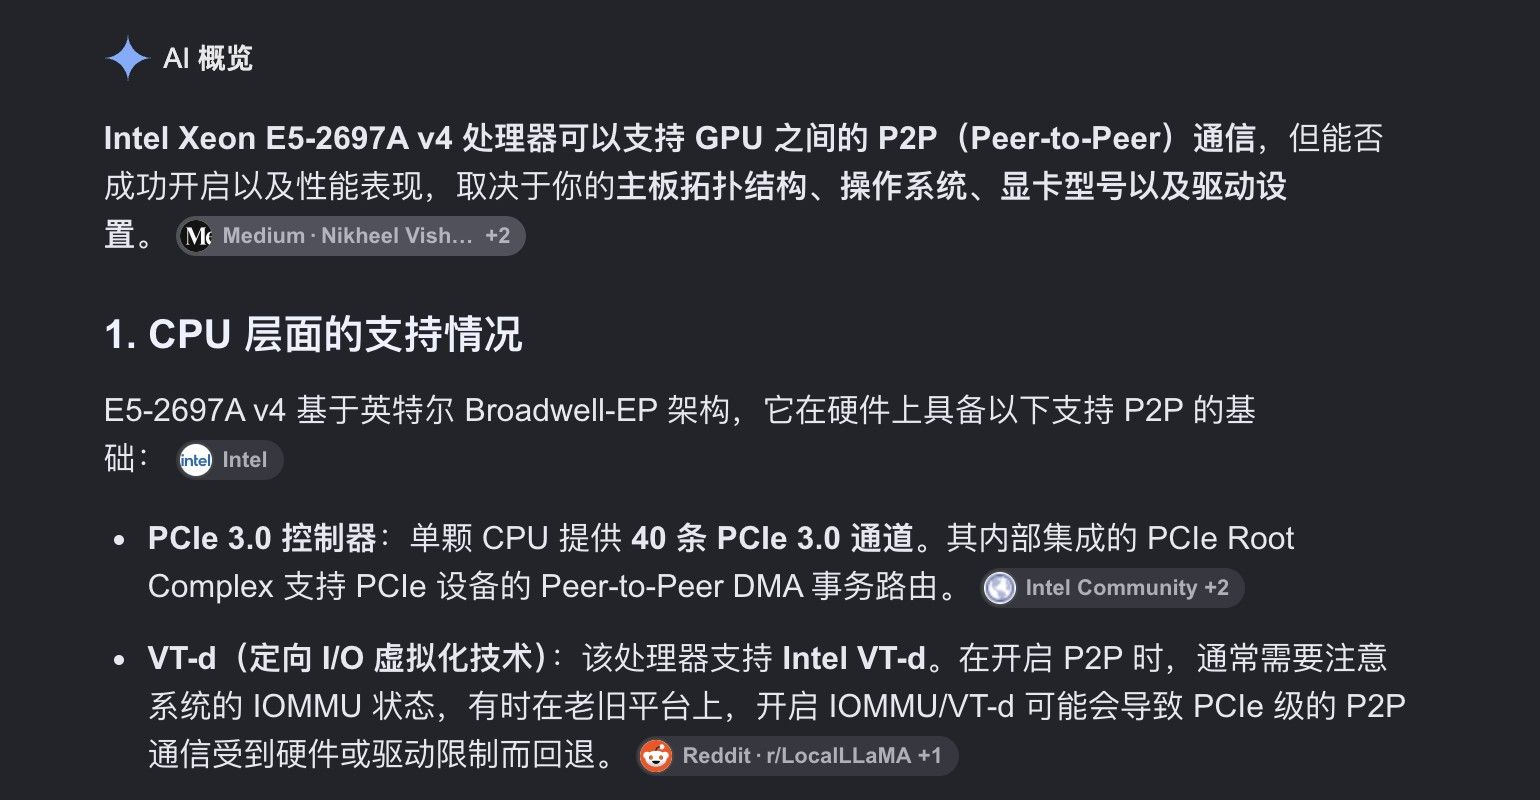
我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?
这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?
谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。🔧 X99 × Dual R9700 P2P Lab
https://lcz.me/projects/local/x99-amd-gpu-p2p -
-
我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?
这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?
谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
不知道是模型的问题,还是调优的问题。这些你都试过吗?tcclaviger/Qwen3.8-27B-DFlash2-FP8
https://github.com/magiccodingman/vllm-radiance
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。
-
-
我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?
这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?
谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。 -
还有一个知识 就是所有的志强CPU AMD的撕裂者 ZEN 系列都是跨 Root Port P2P DMA,这个是企业级CPU默认支持的。
Root Port P2P 可以看成交换机的两个端口。root complex就是那个交换机。任意两个GPU通信 都需要Root Port P2P DMA。 PCIE switch 是4个GPU以上的解决方案。
-
@suboyang 如果像我们这种普通主板, 两个 pcie ,一个挂在cpu上, 一个挂在南桥芯片上, 应该就没戏了是吧
前几天找铭瑄要了一下可以PCIE 拆分的产品,也可以
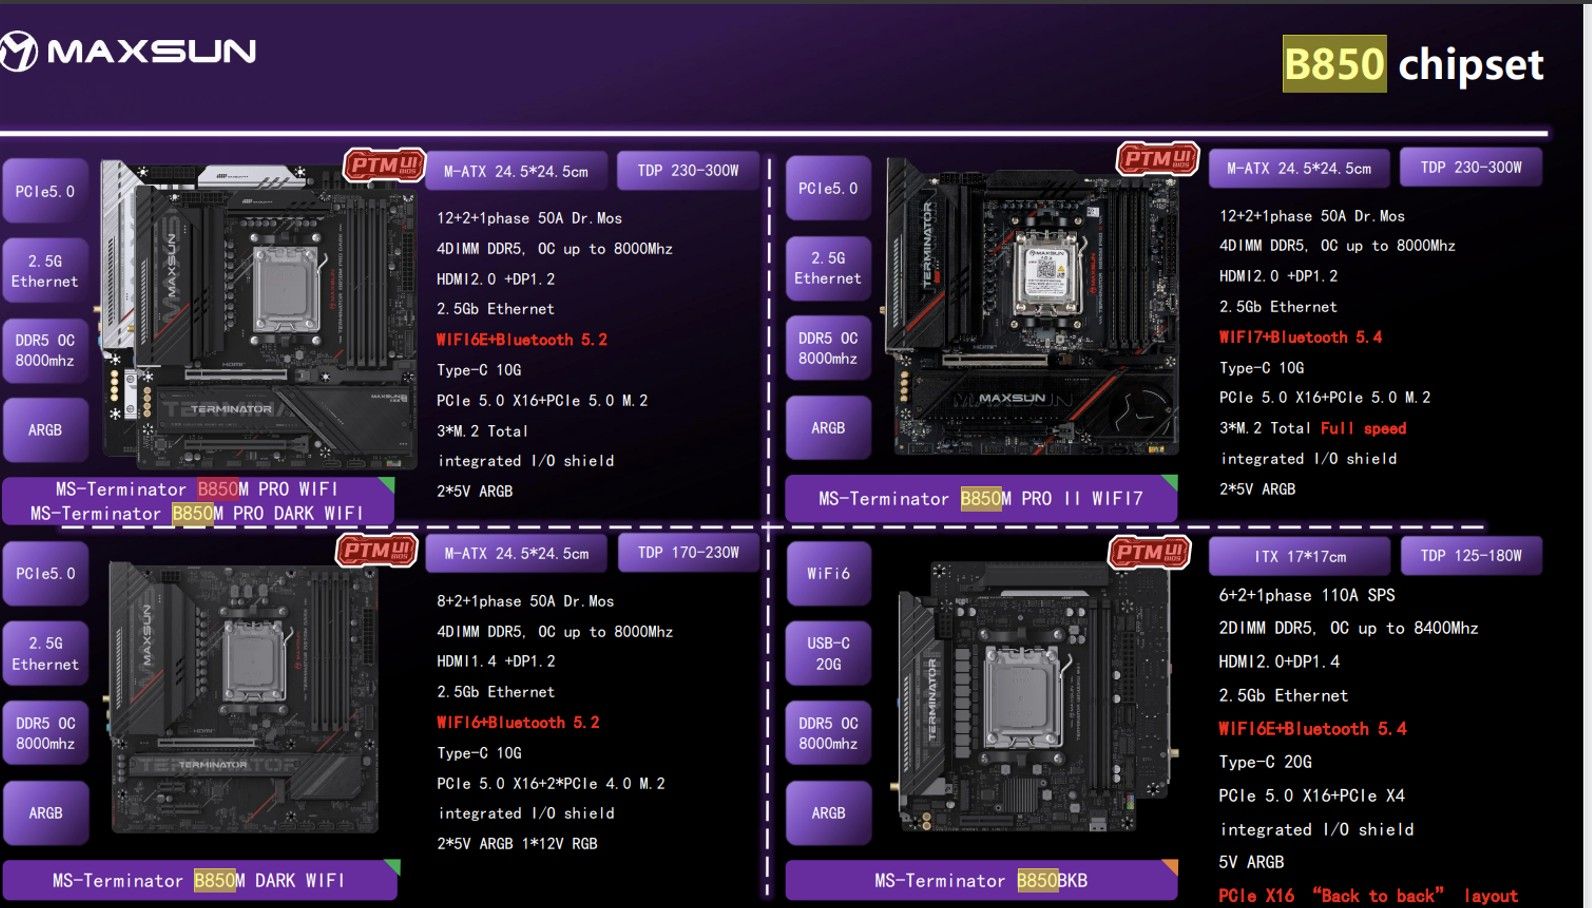
不用P2P,可以share-memory. 这个双卡7900xtx 也是share-memory
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
-
@suboyang 如果像我们这种普通主板, 两个 pcie ,一个挂在cpu上, 一个挂在南桥芯片上, 应该就没戏了是吧
我是用舊主機板 ASUS H97-Pro 來跑 llama.cpp 的雙卡 RX 9060 XT 配置。
因為 H97-Pro 的 PCIe 插槽規格限制:- 第一槽:PCIe 3.0 x16(直連 CPU)
- 第二槽:PCIe 3.0 x4(走 PCH 南橋晶片)
在 Ubuntu 環境下實測過 ROCm(ROCm 10 / 7.14)與 Vulkan:
- Prefill (PP) 速度:ROCm 表現遠優於 Vulkan。
- 心得:在搭配 Agent 時,Prefill (PP) 的處理速度甚至比 Text Generation (TG) 還要關鍵!
- 上下文與 VRAM 實測狀況目前雙卡配置下,穩定運作的極限是 176K Context Length(KV Cache 設為 Q8)。如果開到 192K,VRAM 就會壓在臨界點附近偶爾會crash。
- 因為是個人使用,大部分時間 np=1 ;但如果要分派 Sub-agent 執行任務,會需要設定 np=2。不過這也差不多是這套配置的極限了,上下文再縮短實用性就不高。
SGLang 與 TP/PP 傳輸測試:
前兩天請 DeepSeek 協助安裝 SGLang,過程中同樣對 RCCL 與 P2P 進行了各項功能測試。最後也是打了類似的 Patch——否則 SGLang 的程式邏輯會判斷無法通訊,連CPU DMA都不走直接放棄。
但即使打了 Patch,走 CPU AllReduce 的效能跟 llama.cpp 的 Tensor Parallel (TP) mode 差不多,速度都遠慢於 Pipeline Parallel (PP) mode,基本上沒有實用價值。加上 SGLang 本身吃 VRAM 比 llama.cpp 更兇,能開的上下文反而更短。總結:
- 建議走南橋的 PCIe 介面,最佳解依然是 PP (Pipeline Parallel) 分層模式。實測下來,PP 模式的 Prefill 速度甚至略微超越單張 R9700;不過 TG 速度就單卡水準,大概只有 R9700 的一半。
- 硬體升級思考:如果主機板本身支援 雙 PCIe x8/x8,且手邊已經有一張 9060 XT,再補一張二手跑 Tensor Parallel,整體性能應該有機會逼近 R9700。但算一算升級預算,如果手頭預算許可,直接買一張二手 RX 7900 XTX 可能是更乾淨俐落的選擇——畢竟 384-bit 帶來約 960 GB/s 的記憶體頻寬,在純單卡運算上優勢還是太明顯了,且雙卡在記憶體分配上會有尾巴浪費的零散區塊(我一張有接顯示輸出會佔用VRAM)。
-
-
-
没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
不知道是模型的问题,还是调优的问题。这些你都试过吗?tcclaviger/Qwen3.8-27B-DFlash2-FP8
https://github.com/magiccodingman/vllm-radiance
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。
没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
不知道是模型的问题,还是调优的问题。这些你都试过吗?tcclaviger/Qwen3.8-27B-DFlash2-FP8
https://github.com/magiccodingman/vllm-radiance
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。
目前只是证明了在X99上把双 R9700 Direct P2P 真正跑通,后面有时间会测一下DFlash2、vllm-radiance。
🔧 X99 × Dual R9700 P2P Lab
https://lcz.me/projects/local/x99-amd-gpu-p2p -
没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
不知道是模型的问题,还是调优的问题。这些你都试过吗?tcclaviger/Qwen3.8-27B-DFlash2-FP8
https://github.com/magiccodingman/vllm-radiance
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。
目前只是证明了在X99上把双 R9700 Direct P2P 真正跑通,后面有时间会测一下DFlash2、vllm-radiance。






