跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签 硬件 AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. 我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。

我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。

已定时 已固定 已锁定 已移动 AI硬件
x99r9700多卡部署
18 帖子 8 发布者 176 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题由 X99 不能P2P让我很难受 。 买Pcie switch(260925DELL T7910 已判:死缓,原因:拿不到大Bar ) 分支而来 terry
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • PhoenixRise2026P
    PhoenixRise2026P
    PhoenixRise2026
    德高望重
    编写于 最后由 编辑
    #5

    完整作业:https://lcz.me/topic/1925

    1 条回复 最后回复
    1
    • suboyangS
      suboyangS
      suboyang
      编写于 最后由 suboyang 编辑
      #6

      我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?

      这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?
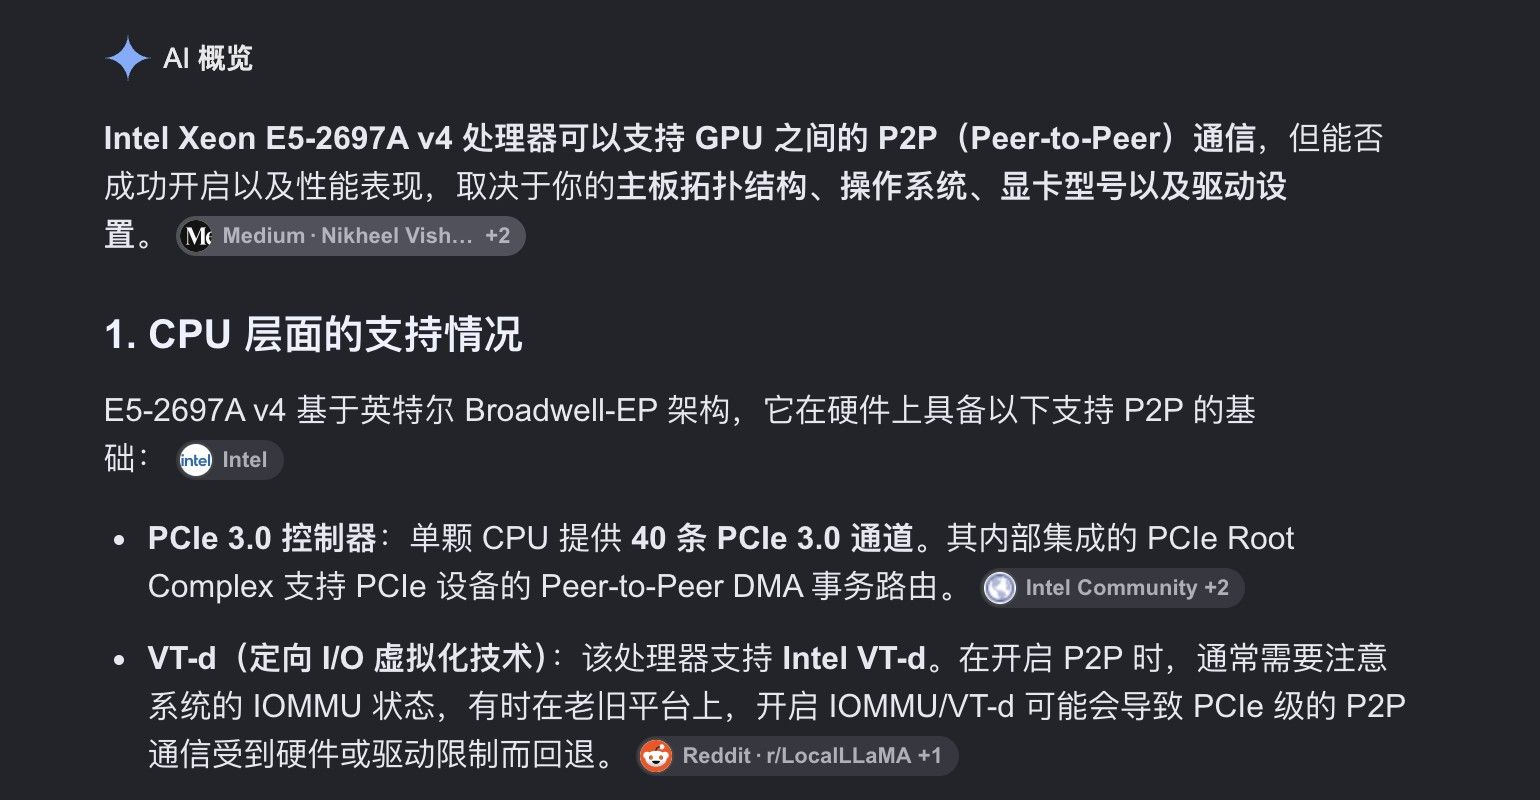
      image.jpeg

      PhoenixRise2026P 1 条回复 最后回复
      0
      • suboyangS suboyang

        我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?

        这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?

        image.jpeg

        PhoenixRise2026P
        PhoenixRise2026P
        PhoenixRise2026
        德高望重
        编写于 最后由 编辑
        #7

        @suboyang 说:

        我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?

        这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?

        image.jpeg

        谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
        我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
        所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。

        suboyangS 2 条回复 最后回复
        1
        • suboyangS
          suboyangS
          suboyang
          编写于 最后由 编辑
          #8

          44-bit DMA address 可以在 Above 4G Decoding里改吗?

          PhoenixRise2026P 1 条回复 最后回复
          0
          • PhoenixRise2026P PhoenixRise2026

            @suboyang 说:

            我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?

            这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?

            image.jpeg

            谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
            我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
            所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。

            suboyangS
            suboyangS
            suboyang
            编写于 最后由 suboyang 编辑
            #9

            @PhoenixRise2026

            没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
            不知道是模型的问题,还是调优的问题。这些你都试过吗?

            tcclaviger/Qwen3.8-27B-DFlash2-FP8

            https://github.com/magiccodingman/vllm-radiance

            https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese

            按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。

            PhoenixRise2026P 1 条回复 最后回复
            0
            • 拐
              拐
              拐子001
              编写于 最后由 编辑
              #10

              又一成形的案例,看样子,可以抄作业了。

              1 条回复 最后回复
              0
              • PhoenixRise2026P PhoenixRise2026

                @suboyang 说:

                我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?

                这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?

                image.jpeg

                谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
                我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
                所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。

                suboyangS
                suboyangS
                suboyang
                编写于 最后由 编辑
                #11

                @PhoenixRise2026

                还有一个知识 就是所有的志强CPU AMD的撕裂者 ZEN 系列都是跨 Root Port P2P DMA,这个是企业级CPU默认支持的。

                Root Port P2P 可以看成交换机的两个端口。root complex就是那个交换机。任意两个GPU通信 都需要Root Port P2P DMA。 PCIE switch 是4个GPU以上的解决方案。

                johnnybegoodJ 1 条回复 最后回复
                0
                • suboyangS suboyang

                  @PhoenixRise2026

                  还有一个知识 就是所有的志强CPU AMD的撕裂者 ZEN 系列都是跨 Root Port P2P DMA,这个是企业级CPU默认支持的。

                  Root Port P2P 可以看成交换机的两个端口。root complex就是那个交换机。任意两个GPU通信 都需要Root Port P2P DMA。 PCIE switch 是4个GPU以上的解决方案。

                  johnnybegoodJ
                  johnnybegoodJ
                  johnnybegood
                  超凡大师
                  编写于 最后由 编辑
                  #12

                  @suboyang 如果像我们这种普通主板, 两个 pcie ,一个挂在cpu上, 一个挂在南桥芯片上, 应该就没戏了是吧

                  suboyangS Scott LeeS 2 条回复 最后回复
                  0
                  • johnnybegoodJ johnnybegood

                    @suboyang 如果像我们这种普通主板, 两个 pcie ,一个挂在cpu上, 一个挂在南桥芯片上, 应该就没戏了是吧

                    suboyangS
                    suboyangS
                    suboyang
                    编写于 最后由 suboyang 编辑
                    #13

                    @johnnybegood

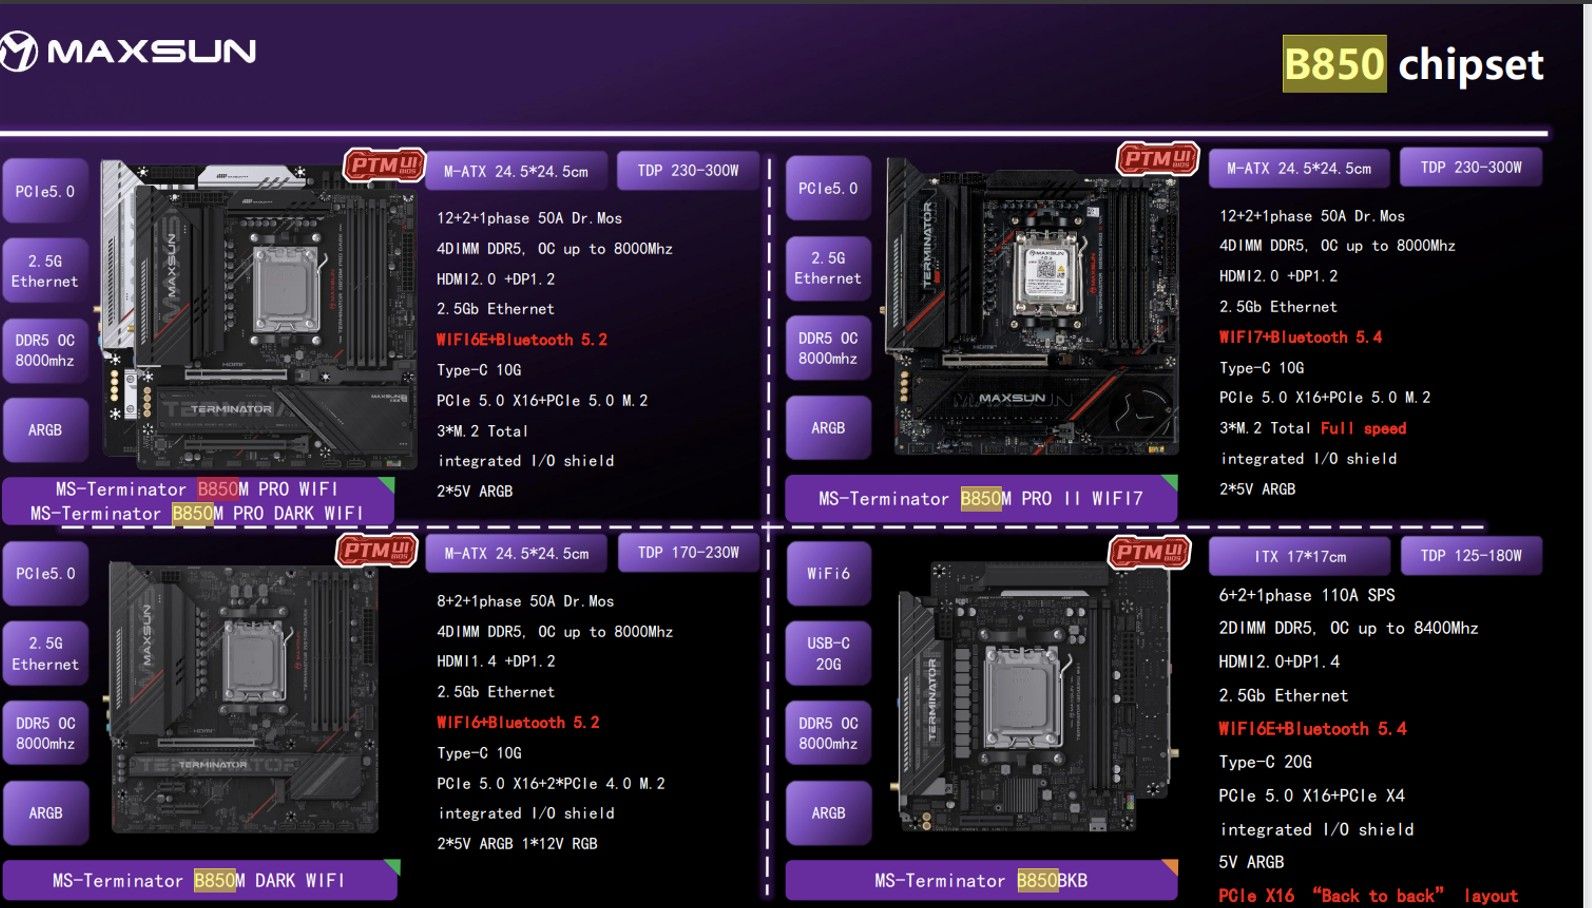
                    前几天找铭瑄要了一下可以PCIE 拆分的产品,也可以
                    image.jpeg

                    不用P2P,可以share-memory. 这个双卡7900xtx 也是share-memory

                    https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese

                    南桥芯片的速度慢,其实也能TP,就是效率太低。

                    1 条回复 最后回复
                    0
                    • johnnybegoodJ johnnybegood

                      @suboyang 如果像我们这种普通主板, 两个 pcie ,一个挂在cpu上, 一个挂在南桥芯片上, 应该就没戏了是吧

                      Scott LeeS
                      Scott LeeS
                      Scott Lee
                      编写于 最后由 Scott Lee 编辑
                      #14

                      我是用舊主機板 ASUS H97-Pro 來跑 llama.cpp 的雙卡 RX 9060 XT 配置。
                      因為 H97-Pro 的 PCIe 插槽規格限制:

                      • 第一槽:PCIe 3.0 x16(直連 CPU)
                      • 第二槽:PCIe 3.0 x4(走 PCH 南橋晶片)

                      在 Ubuntu 環境下實測過 ROCm(ROCm 10 / 7.14)與 Vulkan:

                      • Prefill (PP) 速度:ROCm 表現遠優於 Vulkan。
                      • 心得:在搭配 Agent 時,Prefill (PP) 的處理速度甚至比 Text Generation (TG) 還要關鍵!
                      • 上下文與 VRAM 實測狀況目前雙卡配置下,穩定運作的極限是 176K Context Length(KV Cache 設為 Q8)。如果開到 192K,VRAM 就會壓在臨界點附近偶爾會crash。
                      • 因為是個人使用,大部分時間 np=1 ;但如果要分派 Sub-agent 執行任務,會需要設定 np=2。不過這也差不多是這套配置的極限了,上下文再縮短實用性就不高。

                      SGLang 與 TP/PP 傳輸測試:
                      前兩天請 DeepSeek 協助安裝 SGLang,過程中同樣對 RCCL 與 P2P 進行了各項功能測試。最後也是打了類似的 Patch——否則 SGLang 的程式邏輯會判斷無法通訊,連CPU DMA都不走直接放棄。
                      但即使打了 Patch,走 CPU AllReduce 的效能跟 llama.cpp 的 Tensor Parallel (TP) mode 差不多,速度都遠慢於 Pipeline Parallel (PP) mode,基本上沒有實用價值。加上 SGLang 本身吃 VRAM 比 llama.cpp 更兇,能開的上下文反而更短。

                      總結:

                      • 建議走南橋的 PCIe 介面,最佳解依然是 PP (Pipeline Parallel) 分層模式。實測下來,PP 模式的 Prefill 速度甚至略微超越單張 R9700;不過 TG 速度就單卡水準,大概只有 R9700 的一半。
                      • 硬體升級思考:如果主機板本身支援 雙 PCIe x8/x8,且手邊已經有一張 9060 XT,再補一張二手跑 Tensor Parallel,整體性能應該有機會逼近 R9700。但算一算升級預算,如果手頭預算許可,直接買一張二手 RX 7900 XTX 可能是更乾淨俐落的選擇——畢竟 384-bit 帶來約 960 GB/s 的記憶體頻寬,在純單卡運算上優勢還是太明顯了,且雙卡在記憶體分配上會有尾巴浪費的零散區塊(我一張有接顯示輸出會佔用VRAM)。
                      1 条回复 最后回复
                      0
                      • terryT
                        terryT
                        terry
                        超级版主
                        编写于 最后由 编辑
                        #15

                        相当牛逼的帖子,这个就是把洋垃圾的上限再推进

                        油管:https://www.youtube.com/@抡锤者

                        1 条回复 最后回复
                        0
                        • suboyangS suboyang

                          44-bit DMA address 可以在 Above 4G Decoding里改吗?

                          PhoenixRise2026P
                          PhoenixRise2026P
                          PhoenixRise2026
                          德高望重
                          编写于 最后由 编辑
                          #16

                          @suboyang 说:

                          44-bit DMA address 可以在 Above 4G Decoding里改吗?

                          Above 4G 不能改 44-bit DMA。我的问题恰恰是 ReBAR 后 BAR 被放得太高,超过 44-bit DMA 可达范围,所以需要在内核侧处理。

                          1 条回复 最后回复
                          0
                          • suboyangS suboyang

                            @PhoenixRise2026

                            没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
                            不知道是模型的问题,还是调优的问题。这些你都试过吗?

                            tcclaviger/Qwen3.8-27B-DFlash2-FP8

                            https://github.com/magiccodingman/vllm-radiance

                            https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese

                            按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。

                            PhoenixRise2026P
                            PhoenixRise2026P
                            PhoenixRise2026
                            德高望重
                            编写于 最后由 编辑
                            #17

                            @suboyang 说:

                            @PhoenixRise2026

                            没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
                            不知道是模型的问题,还是调优的问题。这些你都试过吗?

                            tcclaviger/Qwen3.8-27B-DFlash2-FP8

                            https://github.com/magiccodingman/vllm-radiance

                            https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese

                            按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。

                            目前只是证明了在X99上把双 R9700 Direct P2P 真正跑通,后面有时间会测一下DFlash2、vllm-radiance。

                            suboyangS 1 条回复 最后回复
                            0
                            • PhoenixRise2026P PhoenixRise2026

                              @suboyang 说:

                              @PhoenixRise2026

                              没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
                              不知道是模型的问题,还是调优的问题。这些你都试过吗?

                              tcclaviger/Qwen3.8-27B-DFlash2-FP8

                              https://github.com/magiccodingman/vllm-radiance

                              https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese

                              按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。

                              目前只是证明了在X99上把双 R9700 Direct P2P 真正跑通,后面有时间会测一下DFlash2、vllm-radiance。

                              suboyangS
                              suboyangS
                              suboyang
                              编写于 最后由 编辑
                              #18

                              @PhoenixRise2026

                              谢谢等你后续,稳定后,我也整一套,主要是双卡R9700跑tcclaviger/Qwen3.8-27B-DFlash2-FP8 就是怕性能太低。

                              1 条回复 最后回复
                              0

                              你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                              厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                              有了你的建议,这篇帖子会更精彩哦 💗

                              注册 登录
                              回复
                              • 在新帖中回复
                              登录后回复
                              • 从旧到新
                              • 从新到旧
                              • 最多赞同


                              • 登录

                              • 登录或注册以进行搜索。
                              • 第一个帖子
                                最后一个帖子
                              0
                              • 版块
                              • 最新
                              • 标签
                              • 热门
                              • 用户
                              • 群组