
-
-
现在最大的问题是,Qwen3.8-27B-MXFP4 这类模型,我还没有看到双卡 R9700 可以稳定100t/s 以上的,尤其是250K上下文的测试,如果在250K 还能保持80~100t/s,本地模型部署才有意义,要不然干活太慢了,这个时间等不起。
-
-
-
-
没有mtp 没有 dflash 3090 双卡才80多 r9700 宽带都没有3090 强
不可能有150 吧 -
-
-
@fcme 就怕双卡TP 拉稀啊。
https://github.com/mattbucci/2x-R9700-RDNA4-GFX1201-sglang-inference
这个sglang 双卡才20t/s多,就算加上dflash2,也就40t/s。 如果是这样,双卡TP就没有折腾的必要。
我认为双卡TP 本地模型,需要保持在150t/s,才有折腾的必要,否则就没有生成力啊。玩玩image 还行。
-
-
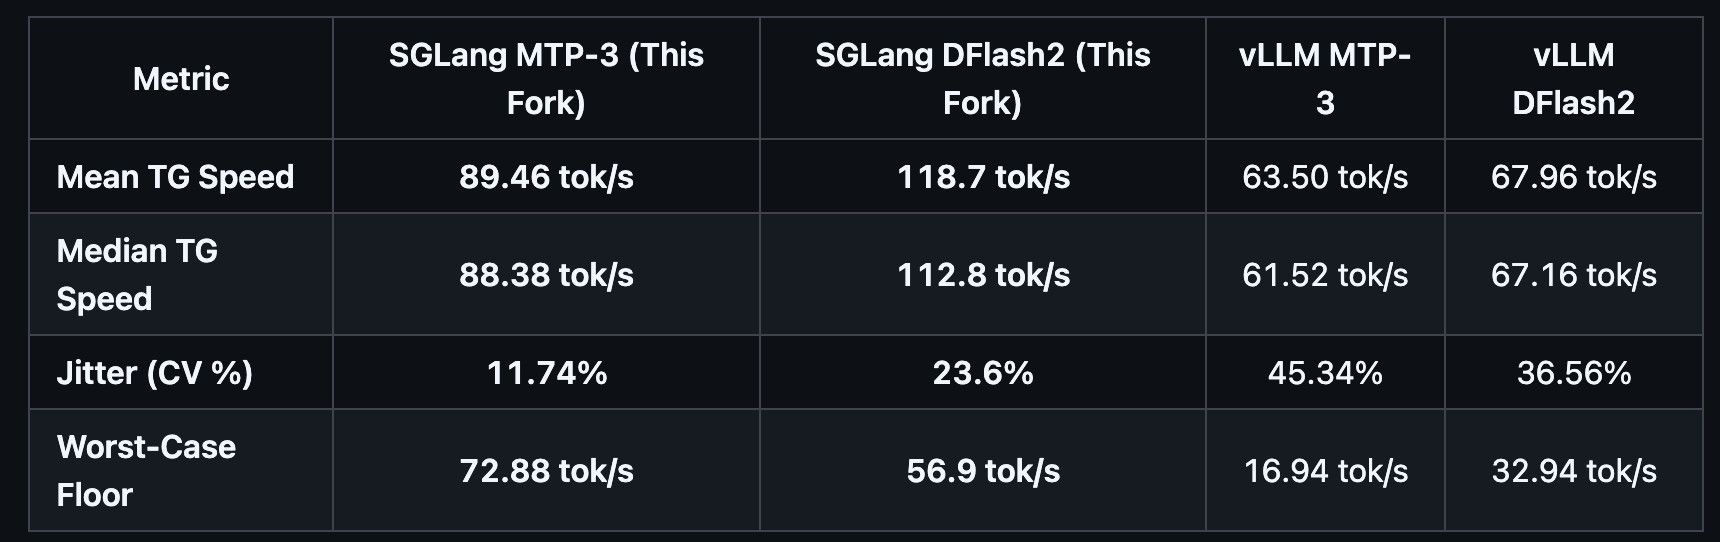
按说这个sglang方案是没有问题的
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese双卡7900xtx 跑出了这样的水平,R9700 应该更高才对。
-
-
但是带宽影响比较大的是视频生成,和语音生成。大模型TP未必这么敏感,这个还得有人测。主要成本实在太高,要不然我自己早上手了。
-
按说这个sglang方案是没有问题的
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese双卡7900xtx 跑出了这样的水平,R9700 应该更高才对。
-
@suboyang 视频对vram 大小 带宽都有要求
只是vram更重要因为大小决定了可以生成更长的视频
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
这个方案实际上论坛里是没有人测试过R9700双卡的,需要换一下模型,和KV参数。需要有人完全测过这个方案才行,就算R9700带宽只有640G,也不至于双卡TP 50多token,这还玩个毛线。R9700 就只能单卡方案了,那么AMD本地模型还差的很远。
-
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
这个方案实际上论坛里是没有人测试过R9700双卡的,需要换一下模型,和KV参数。需要有人完全测过这个方案才行,就算R9700带宽只有640G,也不至于双卡TP 50多token,这还玩个毛线。R9700 就只能单卡方案了,那么AMD本地模型还差的很远。
-
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
这个方案实际上论坛里是没有人测试过R9700双卡的,需要换一下模型,和KV参数。需要有人完全测过这个方案才行,就算R9700带宽只有640G,也不至于双卡TP 50多token,这还玩个毛线。R9700 就只能单卡方案了,那么AMD本地模型还差的很远。
-
-
@suboyang
这一点你说错了,我好好求证过,sglang只支持到RDNA3,R9700是RDNA4,一字之差就是不支持,NND。所以就得等民间大神的移花接木技术了。
现在有了更牛逼的在线模型估计也快了吧 -


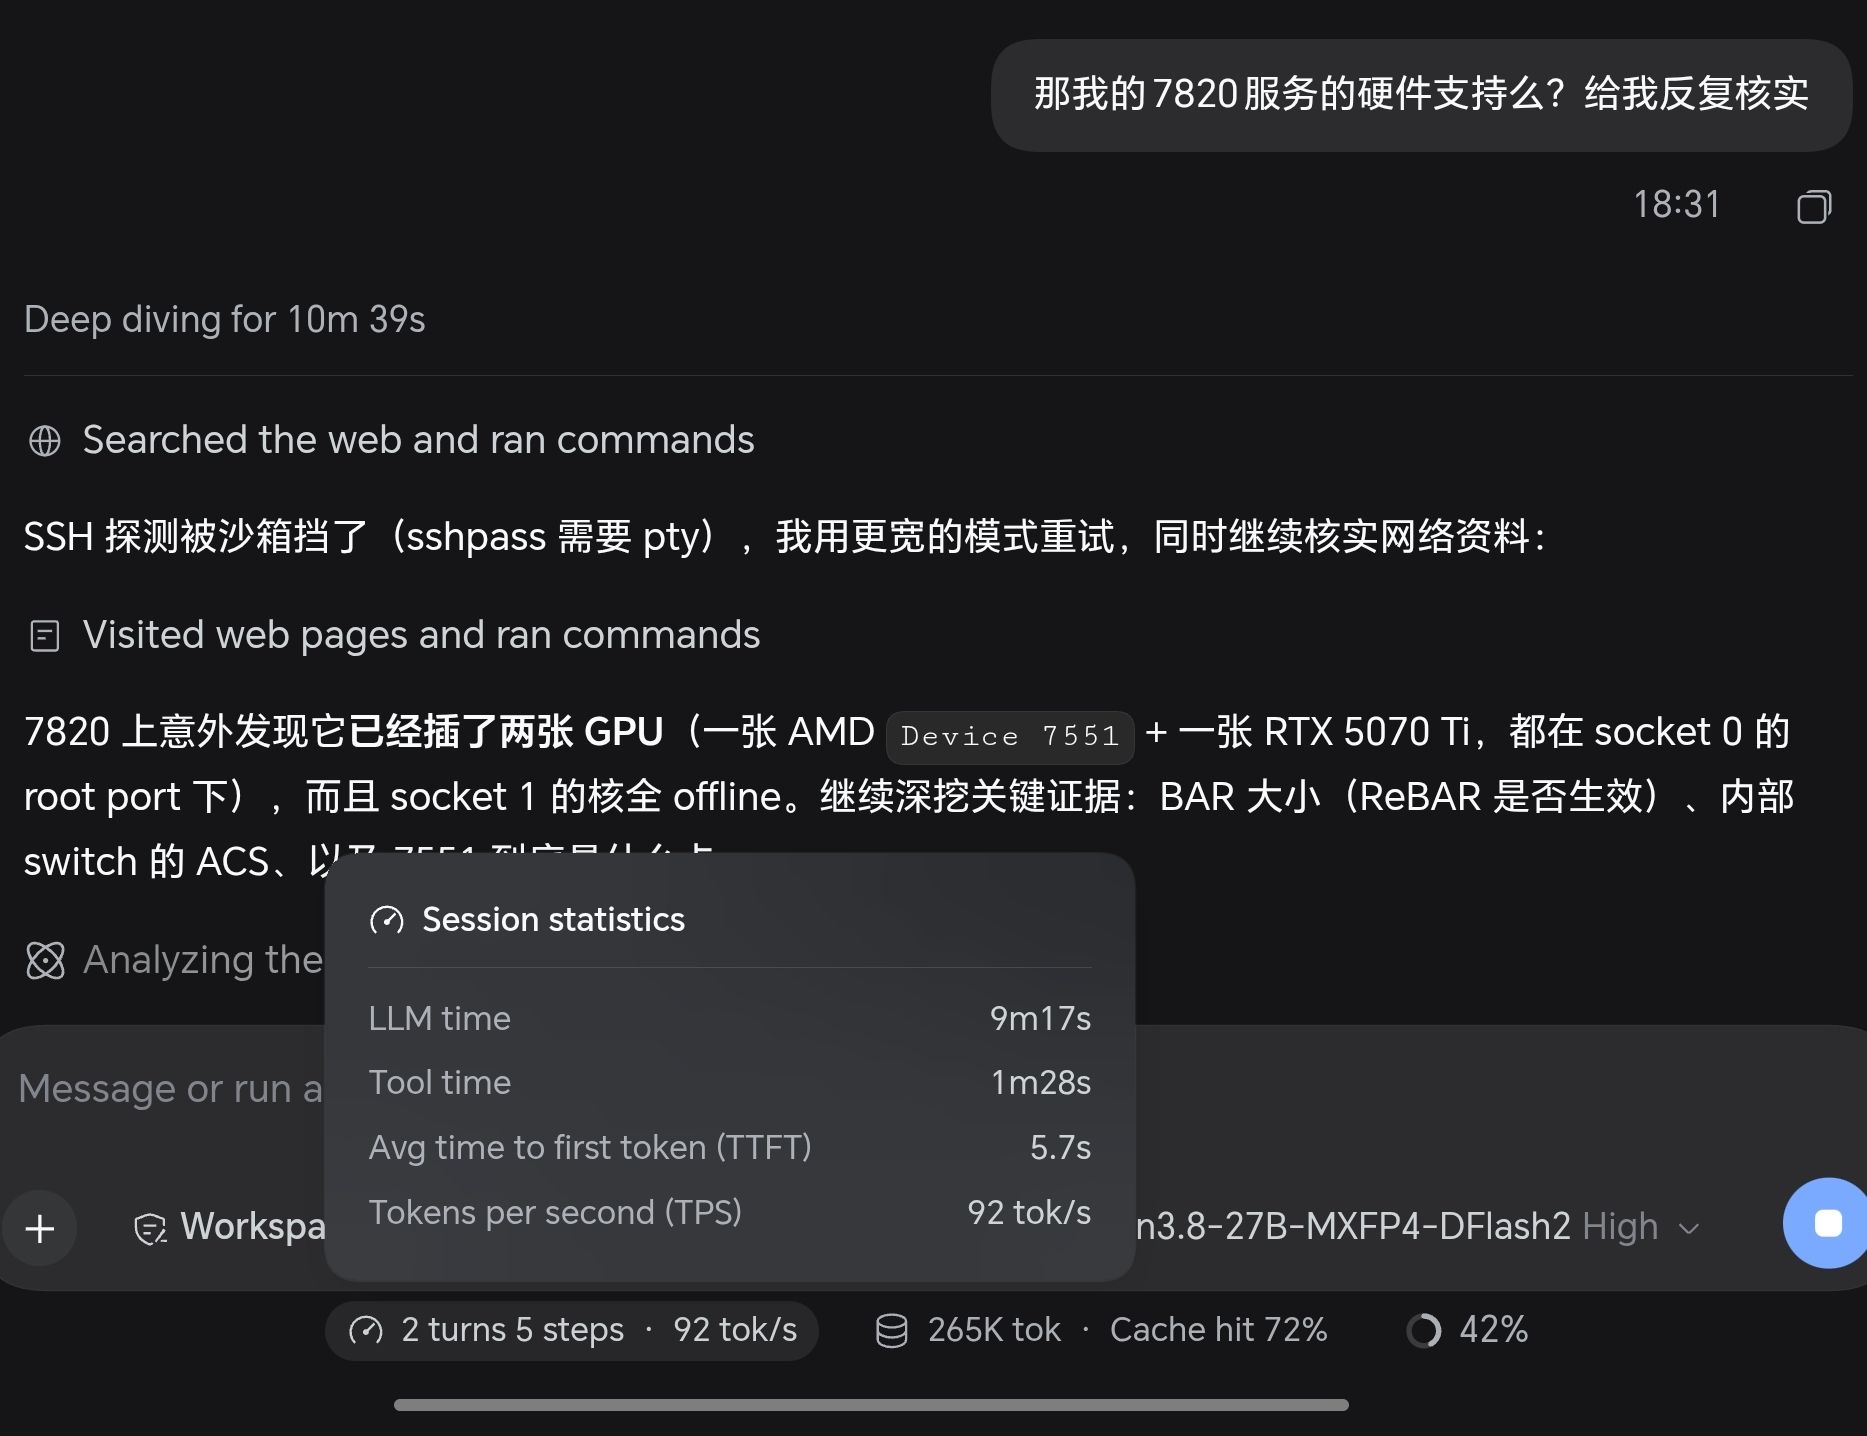

 等我闲了看看

