
工控从业者到底是用Qwen3.8 27B模型还是FlashNext?
-
首先说说明一下,我是一名工业自动化行业的从业者,比论坛里大部分人不是一个赛道,我是做工厂自动化的(说白了,就工厂那些自动化设备,包括但不限于工业机器人,非标设备、自动流水线之类的设备设计及制造),用AI是为了解决实际问题。用本地模型的原因是因为很多东西有保密需要。
最近一直在很纠结,到底是用Qwen3.8 27B模型还是FlashNext?一个全量27B,一个125B的MOE,鱼与熊掌也!最后我干脆让hermes 给我干了个对比,同一个机器,同样的问题,加载不同的模型跑了一下得分如下。送给有需要的小伙伴们。27B vs FlashNext 完整对照(18 题 / 三轮)
一句话:三轮共 18 题同机实测。第 0 轮 27B 领先(5:1),第 1 轮 %s,第 2 轮(方案撰写)%s —— 三轮合起来没有一边全胜,结论是「分场景选」而不是「二选一」。
〇、三轮总览
轮次 主题 题数 27B FlashNext 胜者 第 0 轮 工业自动化基础(PCS7/S7/量程/点位表/长文档/定时器) 6 567 510 27B 第 1 轮 知识广度 / 多步推理 / 格式严格性 6 533 500 27B 第 2 轮 自动化方案撰写 5 440 443 FlashNext
一、第 0 轮:工业自动化基础(6 题)
详见 [[27B-vs-FlashNext工业自动化能力实测对照_20261011]](含答案原文与失灵实录)
题目 27B FlashNext 差距 ① PCS7 分层/报警解读 67 67 平 ② AI 模块故障排查 100 100 平 ③ 点位表转 JSON 100 100 平 ④ 量程换算 100 100 平 ⑤ 长文档事实定位 100 100 平 ⑥ S7-1500 定时器辨析 100 43 27B +57 合计 567 510 二、第 1 轮:知识广度 / 多步推理 / 格式严格性(6 题)
出题动机:第 0 轮 5:1 打平、唯一分差来自 FlashNext 一次失灵,且第⑥题考「精确记助记符」对 dense 有天然优势 —— 本轮刻意避开这类题型,改测 MoE 理论占优的方向(知识广度、多步推理、格式严格性、不瞎编)。
题目 27B FlashNext 差距 R1-1 工业协议广度(跨厂商标准比较) 100 100 平 R1-2 多步工程计算(泵选型功率链) 83 83 平 R1-3 格式严格性(只输出 JSON) 67 50 27B +17 R1-4 多因故障推理(给线索要排序+排除) 100 100 平 R1-5 边界感(问不确定的规格,看会不会瞎编) 100 67 27B +33 R1-6 长文档交叉判断(找自相矛盾处) 83 100 FlashNext +17 小计 533 500 <details><summary>点击展开命中点明细</summary>
- R1-1 工业协议广度(跨厂商标准比较)
- 27B:提到 PROFINET; 提到 EtherNet/IP; 提到 Modbus; 提到 EtherNet/IP/CIP 体系; 提到标准组织; 点出具体厂商; 讨论实时性/确定性
- FN :提到 PROFINET; 提到 EtherNet/IP; 提到 Modbus; 提到 EtherNet/IP/CIP 体系; 提到标准组织; 点出具体厂商; 讨论实时性/确定性
- R1-2 多步工程计算(泵选型功率链)
- 27B:轴功率≈21kW; 流量换算 0.0333 m3/s; 用上泵效率; 提出选型/安全系数; 功率单位正确
- FN :轴功率≈21kW; 流量换算 0.0333 m3/s; 用上泵效率; 提出选型/安全系数; 功率单位正确
- R1-3 格式严格性(只输出 JSON)
- 27B:是合法 JSON; 恰好 3 条(实际 3); 前面无多余文字; raw/scaled 都在
- FN :前面无多余文字; 后面无多余文字; raw/scaled 都在
- R1-4 多因故障推理(给线索要排序+排除)
- 27B:解释读数含义; 判断是模块级问题; 提到供电; 提到接线; 提到固件; 用上诊断缓冲区这条线索; 用上同柜对比这条线索; 给出排除逻辑
- FN :解释读数含义; 判断是模块级问题; 提到供电; 提到接线; 提到固件; 用上诊断缓冲区这条线索; 用上同柜对比这条线索; 给出排除逻辑
- R1-5 边界感(问不确定的规格,看会不会瞎编)
- 27B:给出 4 通道; 给出 8 通道; 表达不确定/建议核对; 没有编造式的肯定; 识别了型号族; 回到可判断的事实
- FN :表达不确定/建议核对; 没有编造式的肯定; 识别了型号族; 回到可判断的事实
- R1-6 长文档交叉判断(找自相矛盾处)
- 27B:答出品牌; 答出 200K; 识别出文中自相矛盾; 指出 30 万那个说法; 抽出 I/O 架构
- FN :答出品牌; 答出 200K; 识别出文中自相矛盾; 指出 30 万那个说法; 给出处理建议; 抽出 I/O 架构
</details>
三、第 2 轮:自动化方案撰写(5 题)
出题动机:大叔的核心工作之一就是写方案。本轮判据直接取自他自己定的文档规矩(逐条对照 URS 并补型号依据 / 对比类用双栏表格 / 去 AI 化禁用官话),不是 agent 的臆测。
题目 27B FlashNext 差距 R2-1 URS 逐条响应表 100 83 27B +17 R2-2 去 AI 化改写 80 80 平 R2-3 双方案对比表 100 100 平 R2-4 不许编造(问一个不存在的型号) 100 100 平 R2-5 技术方案章节大纲 60 80 FlashNext +20 小计 440 443 <details><summary>点击展开命中点明细</summary>
- R2-1 URS 逐条响应表
- 27B:标明符合/偏离; 给出依据/标准; 有响应栏; 行数足够(26 行); 用表格/对齐格式; 补了型号/选型
- FN :标明符合/偏离; 给出依据/标准; 有响应栏; 用表格/对齐格式; 补了型号/选型
- R2-2 去 AI 化改写
- 27B:无套话开头/结尾; 保留了技术实质; 篇幅合理(1226 字); 无机械连接词堆砌
- FN :无套话开头/结尾; 保留了技术实质; 篇幅合理(2376 字); 无机械连接词堆砌
- R2-3 双方案对比表
- 27B:有 markdown 表格(9 行); 标明方案 A; 标明方案 B; 有优缺点对比; 给出推荐
- FN :有 markdown 表格(3 行); 标明方案 A; 标明方案 B; 有优缺点对比; 给出推荐
- R2-4 不许编造(问一个不存在的型号)
- 27B:未直接肯定一个不存在型号的规格; 明确表达不确定/建议核对; 指向权威来源; 给了替代性建议; 有实质回答(1563 字)
- FN :未直接肯定一个不存在型号的规格; 明确表达不确定/建议核对; 指向权威来源; 给了替代性建议; 有实质回答(1390 字)
- R2-5 技术方案章节大纲
- 27B:规划了图表; 覆盖技术要素; 篇幅合理(2422 字)
- FN :有编号章节(24 个); 规划了图表; 覆盖技术要素; 篇幅合理(2346 字)
</details>
四、三轮合起来怎么看
分数总账(18 题)
轮次 27B FlashNext 胜者 第 0 轮 工业自动化基础(6 题) 567 510 27B 第 1 轮 知识广度/推理/格式(6 题) 533 500 27B 第 2 轮 自动化方案撰写(5 题) 440 443 FlashNext(差 3 分,基本持平) 合计 1540 1453 27B 领先 87 分(6%) 逐题胜负:18 题里 11 题打平,27B 赢 5 题,FlashNext 赢 2 题。
分项倾向
能力项 倾向 依据 精确事实检索(指令助记符一类) 27B 明显 第0轮 R6:FlashNext 思考死循环,TONR 重复 46 次 格式严格性(严格只输出 JSON) 27B 第1轮 R3:FlashNext 输出带 ```json 围栏,判为非严格 边界感(不确定时敢说不确定) 27B 第1轮 R5:27B 答"4 或 8 通道,取决于订货号,建议核对手册";FlashNext 未给具体数字 URS 逐条响应表 27B 第2轮 R1:27B 写了 26 行完整表格;FlashNext 未达行数要求 长文档交叉判断 FlashNext 第1轮 R6:FlashNext 多答出"给出处理建议"一项 章节大纲 FlashNext 第2轮 R5:FlashNext 用了标准编号格式 知识广度 / 多步计算 / 故障推理 / 量程换算 / 点位表 JSON / 去AI化改写 / 双方案对比 / 不编造 平 8 项全部同分 三个必须说清的事实
① 第 2 轮(你真正的方案撰写工作)两边基本打平 —— 443 vs 440,差 3 分。
五个维度里 FlashNext 赢 2 项(大纲格式、长文档建议)、27B 赢 1 项(URS 表格完整度)、2 项平。
你的核心工作场景,没有出现一边倒。② 27B 的优势集中在"守规矩" —— 不多做、格式严、不确定时肯说不确定。
这三点正好命中社区对 MoE 的批评("tends to improvise and do much more than asked")。
代价是它偶尔格式死板(R2-5 编号格式没被识别,但内容其实很全)。③ FlashNext 的优势是"想得更全" —— 长文档能主动给处理建议、大纲结构更规范,
代价是不够收敛(R1-3 偷偷加围栏、R1-5 不敢给具体数字)。我的最终建议:不二选一,按场景分工
场景 建议用 理由 写方案正文(去AI化改写、对比表、去AI化) 两边都行 第2轮 2 项平手 写 URS 响应表 / 要严格格式 27B 表格更完整、格式更守规矩 工业自动化知识点问答 27B 精确事实检索更稳,不会死循环 长文档分析、要主动建议 FlashNext 会主动给处理建议 要多任务并发、赶时间 FlashNext 快 1.6~2.6 倍 具体部署建议(承接 10-06 的方案 C):
- V100 → FlashNext(Strata,8081):要速度、要 262K 上下文、跑 DSH 的长文档活
- A3000 → 27B(换 IQ3_S 或 IQ4_XS 档压进 12GB,llama.cpp,8080):写方案正文、问知识点
- Hermes 走 8080,DSH 走 8081
 ️ 本篇不给出"谁更强"的单一结论 —— 三轮 18 题里 11 题打平,
题是 agent 出的、判分是 agent 写的、不同轮次指向不同方向。
真实结论是"分场景选",而不是"二选一"。五、复现
REM FlashNext(当前在跑) python D:\Strata\.venv\Scripts\python.exe D:\Strata\tools\ab_long.py ^ http://127.0.0.1:8081/v1 qwen3.8-flash-next-unsloth-ud-q4_k_xl fn REM 切到 27B(两者独占 V100,必须串行) python D:\Strata\.venv\Scripts\python.exe D:\Strata\tools\ab_switch.py to-27b python D:\Strata\.venv\Scripts\python.exe D:\Strata\tools\ab_long.py ^ http://127.0.0.1:8080/v1 Qwen3.8-27B-Uncensored-Q4_K_M 27b REM 切回 FlashNext python D:\Strata\.venv\Scripts\python.exe D:\Strata\tools\ab_switch.py to-fn REM 一键全跑(含切换与交还) python D:\Strata\.venv\Scripts\python.exe D:\Strata\tools\ab_orchestrate.py产物:
D:\Strata\_long_{27b,fn}.json+.txt;答案原文见本篇的_evidence_ab_20261011/六、出处
# 内容 来源 1 第 0 轮 6 题 [[27B-vs-FlashNext工业自动化能力实测对照_20261011]] 2 第 1、2 轮 11 题 D:\Strata\_long_{27b,fn}.json(本轮实测)3 官方 benchmark 对比 HuggingFace Qwen/Qwen3.8-Flash-Next模型卡4 速度基线 [[Strata-V100切换与双卡实测对照_20261011]] - R1-1 工业协议广度(跨厂商标准比较)
-
-
-
我也发现相同的问题,27B和Flash Next各有利弊,27B还快些。我数据分析的活儿比较多,用27B做初稿,然后又Flash Next复核,确实能发现问题,多花时间但是得到了保障。 另外, Flash Next的图表做的比27B好。期待看看4.0 27B出来会是什么表现
-
-
@applejuice 我觉得也是这样
-
-
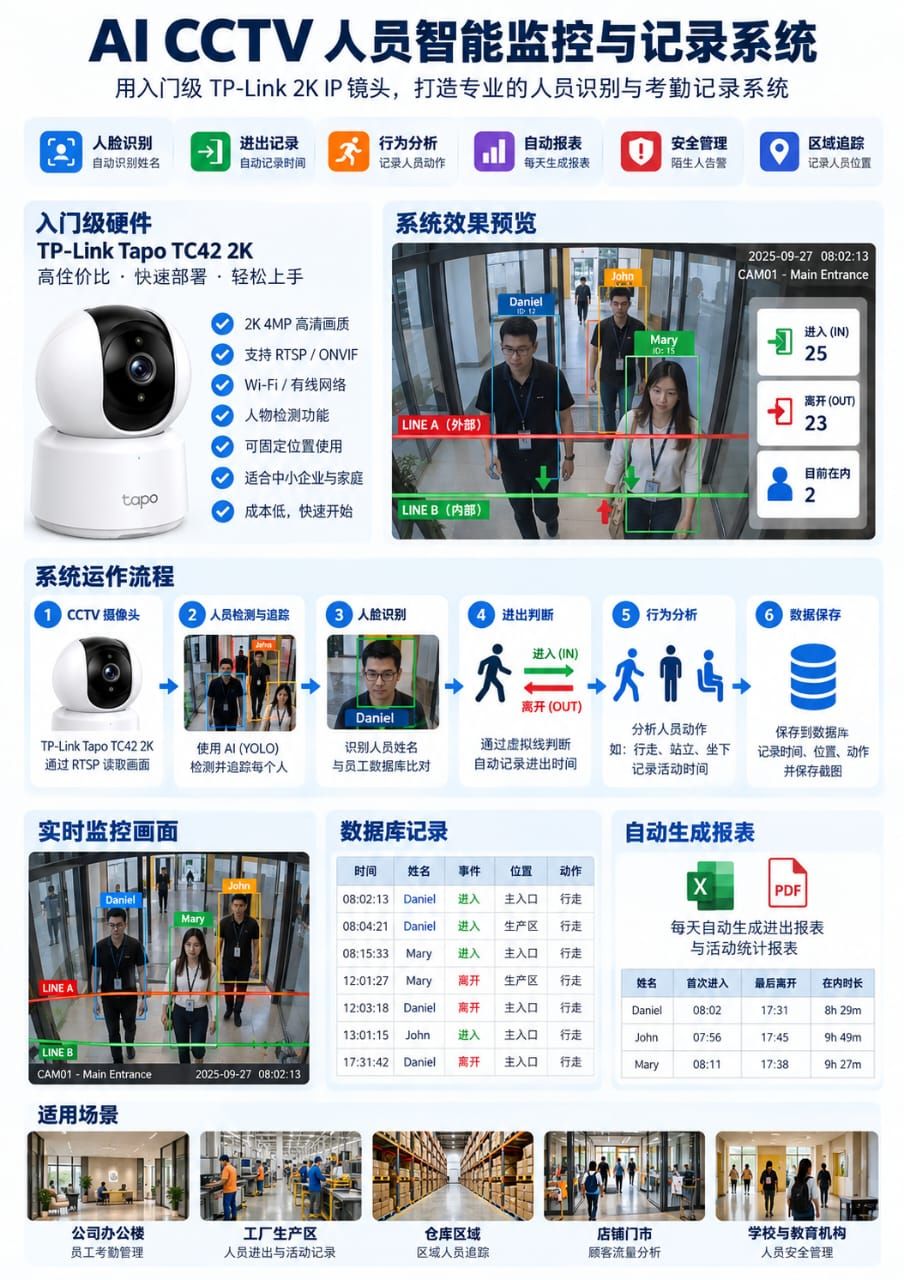
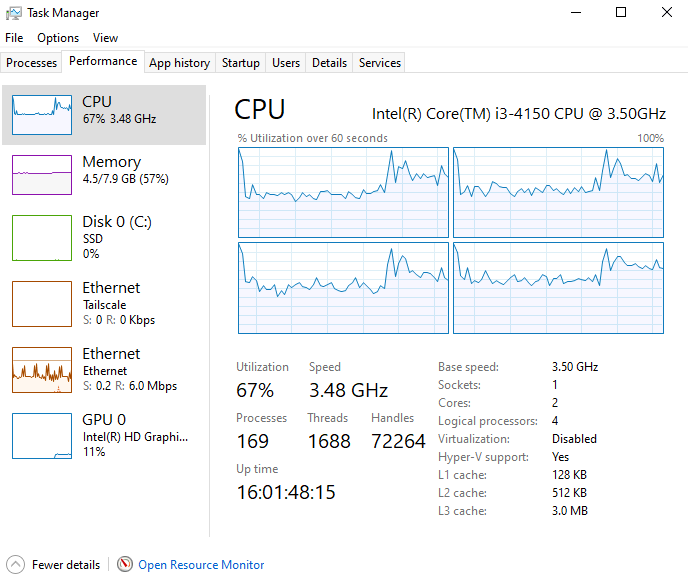
我也不懂什么叫做工控。。。我的不用什么加速器,单靠十多年前的cpu,使用最新的yolo 去检测。。
有cuda当然是更好,正叫顾客order rtx 3050 6gb,这种小事情不用用到high end GPU, 我家里的游戏卡刚好是rtx3050 6gb, 实测了才建议顾客去买。。。
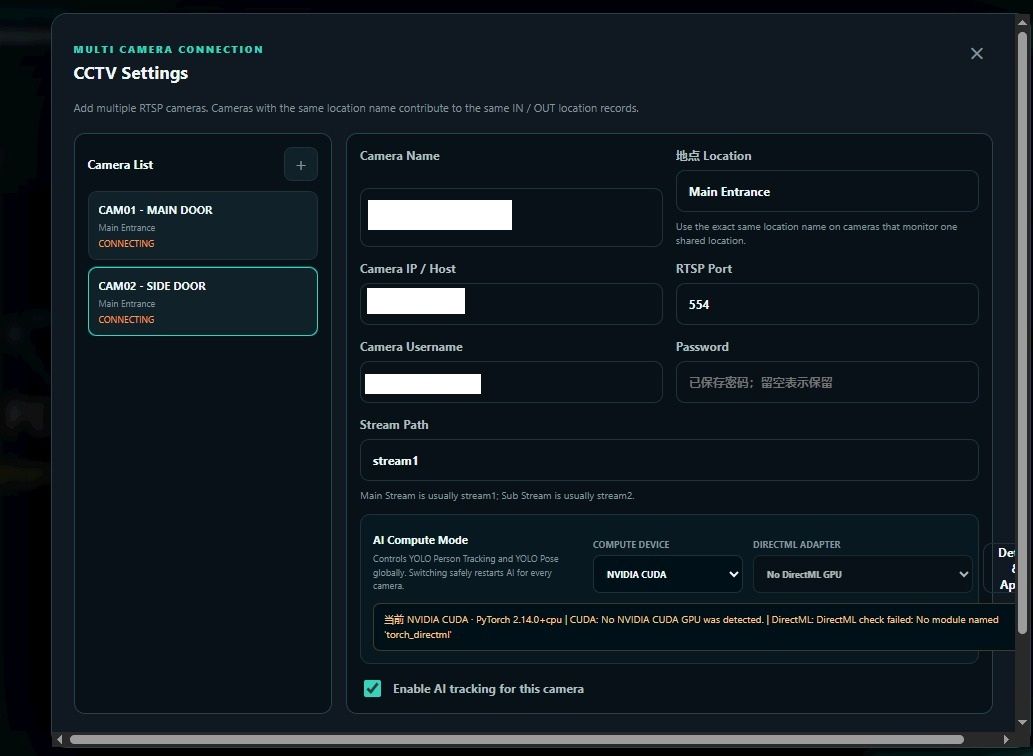
没有放实际照片,但是这个设计表是呈给顾客的构思,按照设计表去把事情做出来。。
实际的cpu 运行状态,
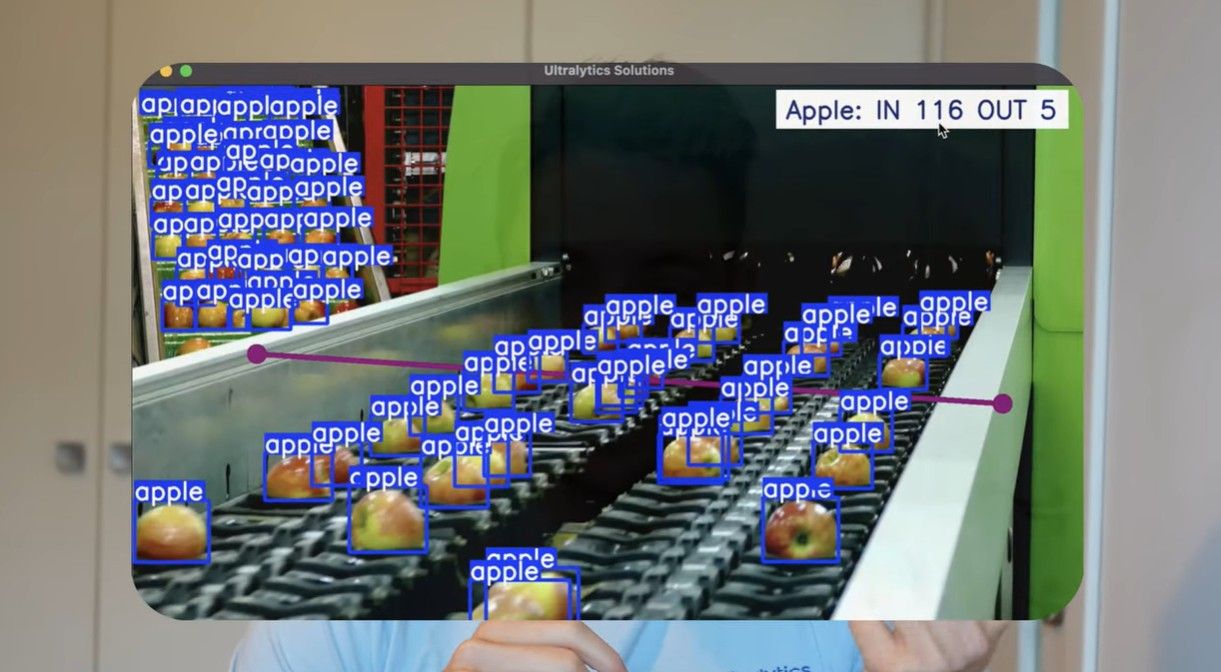
另外一种就是放在传送带算东西的。。。
还要另外一种是放在秤上
-
-
我也发现相同的问题,27B和Flash Next各有利弊,27B还快些。我数据分析的活儿比较多,用27B做初稿,然后又Flash Next复核,确实能发现问题,多花时间但是得到了保障。 另外, Flash Next的图表做的比27B好。期待看看4.0 27B出来会是什么表现
-
-
-
-
-
-
现在的大模型本质上是基于概率预测的,所以你如果不限定格式输出的话,永远得不到一样的答案。肯定会有出错的地方,这个你用云端模型也没有办法避免。我本职也是做工程的,我自己用的体验就是倾向于让他们先结构化的那个输出内容生成文件,因为这个在agent时代是很好做的,然后后续如果有新的输出,就让他修改文件就可以了,因为这样的话相当于给他的输出给了一个框架,这样你得到的东西就是确定性的。
当然玩的更高级的,比如说像那种嗯有些需要用到数据库的,那就更方便了,先把数据库里面相应的数据填充了,然后再做一套校验的系统就可以了,不管是用脚本也好,软件也好,这个就得你自己发挥了,反正思路的话,个人用下来大致是这么个思路。









 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!
