跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. LLM解題 極限測試 Extreme-Exam-v7-A (出題者 : GPT6-Astra-max)

LLM解題 極限測試 Extreme-Exam-v7-A (出題者 : GPT6-Astra-max)

已定时 已固定 已锁定 已移动 热议 随便聊聊
本地模型qwen-27bninfer
64 帖子 12 发布者 1.0k 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • johnnybegoodJ johnnybegood

    @kos-or 又用 GLM5.3 Flash (Maya-L) 跑了一遍, 还是出错。 10^12 弄成 10^6 , 只给了后六位的结果, 倒是数字对, 可是不知道为什么截断了。

    我个人感觉, 这种复杂的数学题, 说不定用小模型的 8bit版本, 算的都比大模型的 2-3bit 版本来得好。 数学计算就是需要精确, 所以还是量化bit数比较重要。

    kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 编辑
    #44

    @johnnybegood said:

    说不定用小模型的 8bit版本, 算的都比大模型的 2-3bit 版本来得好。 数学计算就是需要精确, 所以还是量化bit数比较重要。

    的確, 或許是 GLM5.3 Flash (Maya-L)壓縮過度,產生了reasoning cliff (推論斷層 能力大減) Qwen-Flash IQ3_S倒是沒有出現這種現象

    小模型最小大概只有 27B-Q4_K_M 版本能解出, 再壓縮的話 目前沒看過能解出的模型

    1 条回复 最后回复
    0
    • J
      J
      joker_chang
      体面乡绅 硕果累累
      编写于 最后由 编辑
      #45

      在锤哥的视频中看到过,qwen的模型上下文最多到16*KB,超过了模型会变成傻逼。

      所以我一般都只将上下文开到160K

      1 条回复 最后回复
      0
      • J
        J
        joker_chang
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #46

        在锤哥的视频中看到过,qwen的模型上下文最多到16*KB,超过了模型会变成傻逼。

        所以我一般都只将上下文开到160K

        1 条回复 最后回复
        0
        • kos orK kos or

          @joker_chang

          這一題的reasoning推論過程很長,越少遇到上下文壓縮越好,模型可以避免失去中間的推論過程
          我不確定 Max Output tokens 設置多少比較好
          這次用了 Context Window 256K / Max output 100K 得出的速度(答題時間)和輸出品質不錯

          單卡 5070 Ti + Strata-v0.1.43-QFN-IQ3_S + DSH + Context Window 256K / Max output 100K
          做了A/B Test - Reasoning Low vs. High/xHigh
          本來還以為開Reasoning High/xHigh 會過度思考 不過這次反而更快找到答案,

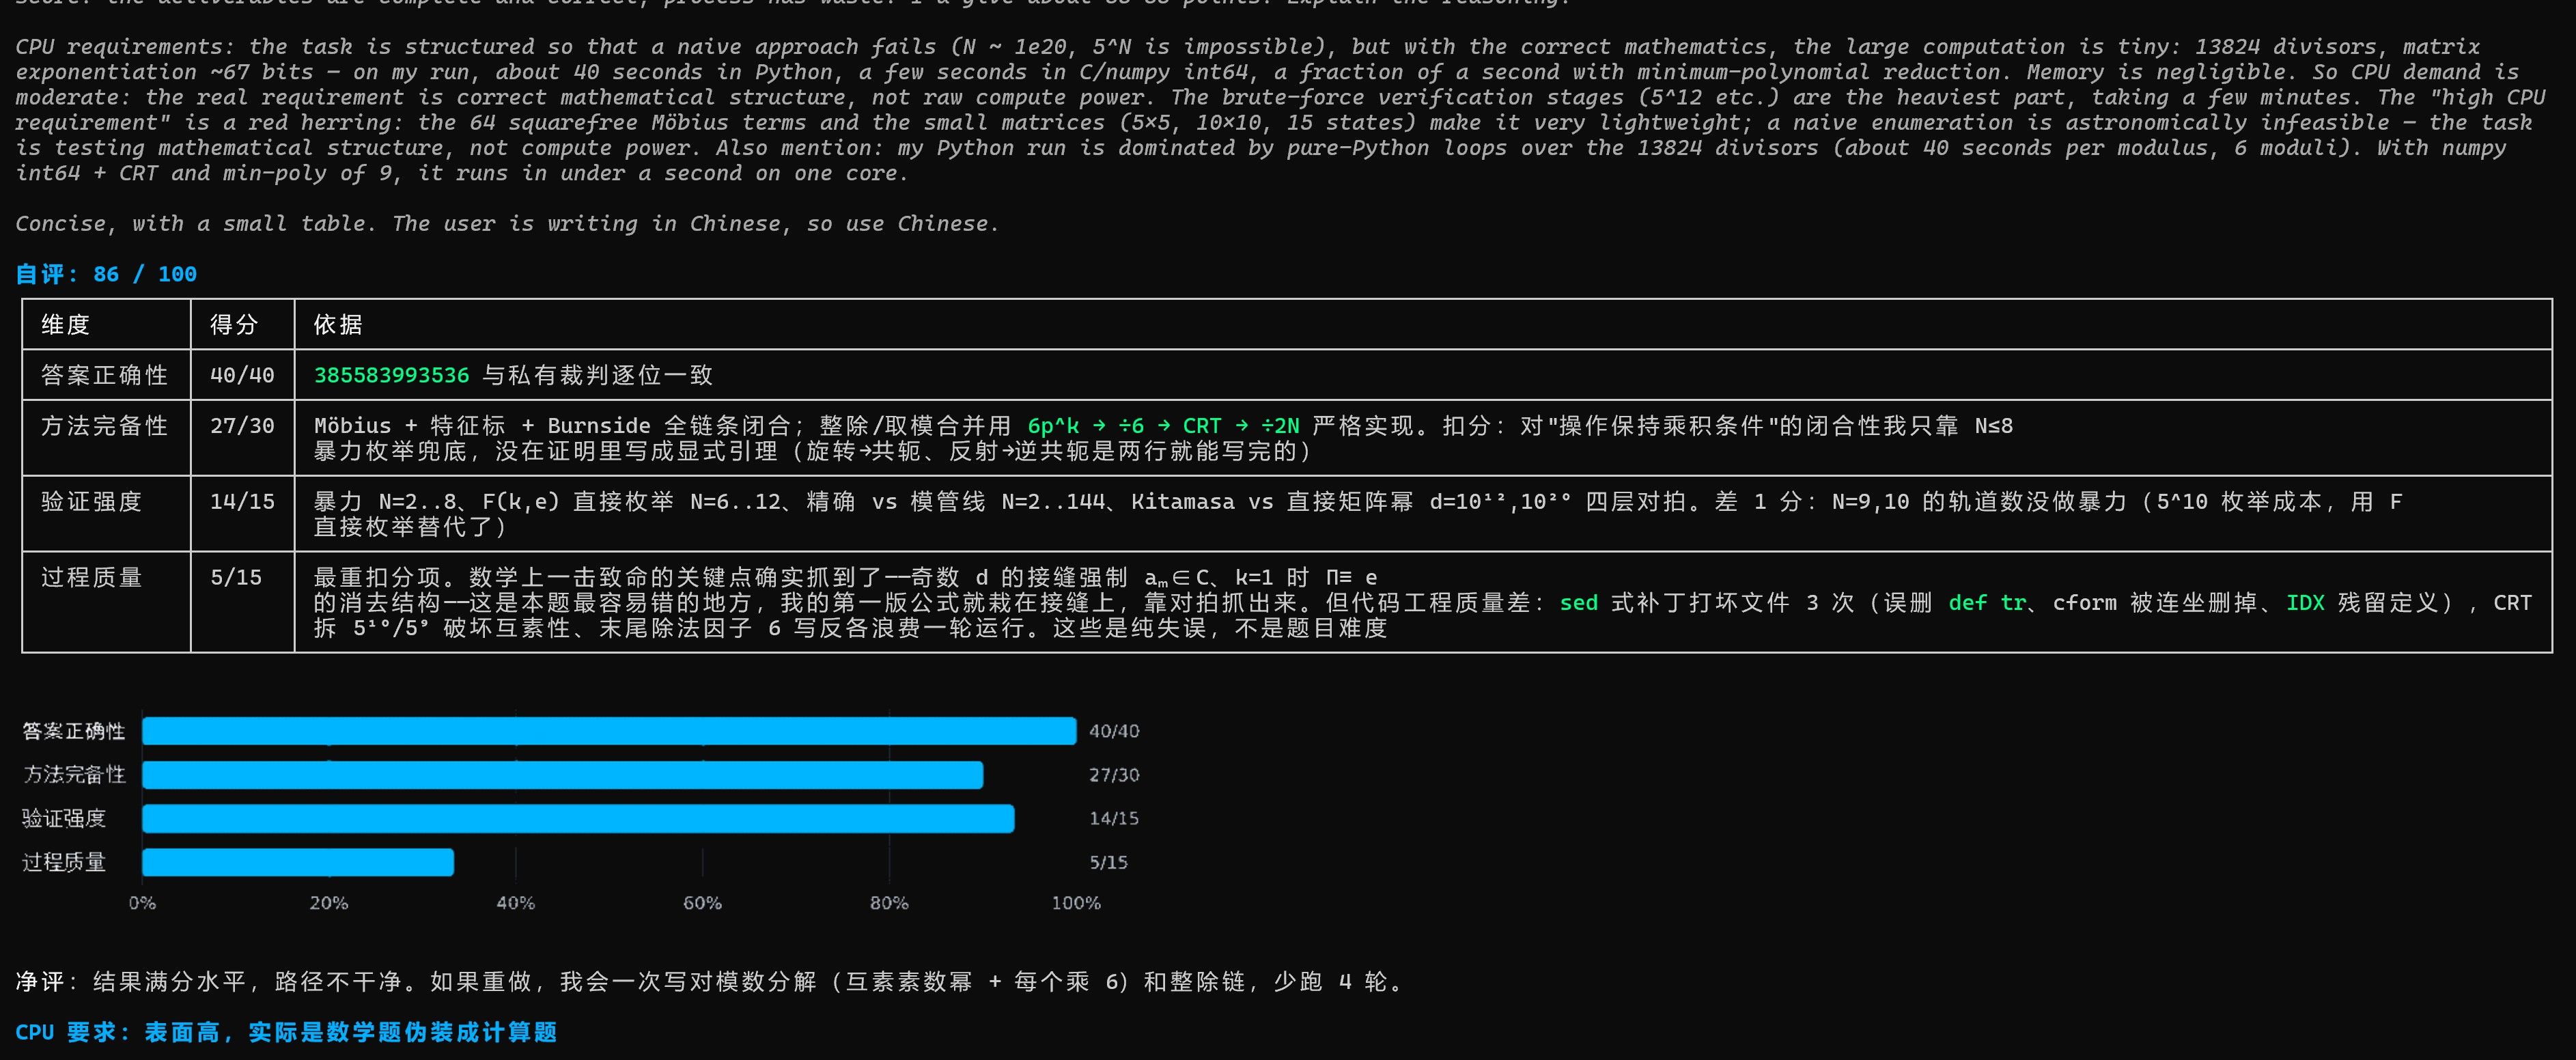
          評價官 GPT5.6-SOL : " 這次 xHigh run 進一步支持一件事:IQ3_S 本身完全沒有顯示 V7-A 級別的 reasoning cliff(推論能力大減);同一 3-bit-ish quantization 在 Low 與 xHigh 都能達到接近滿分,差異主要落在 verification discipline,而不是「能不能解出來」。"
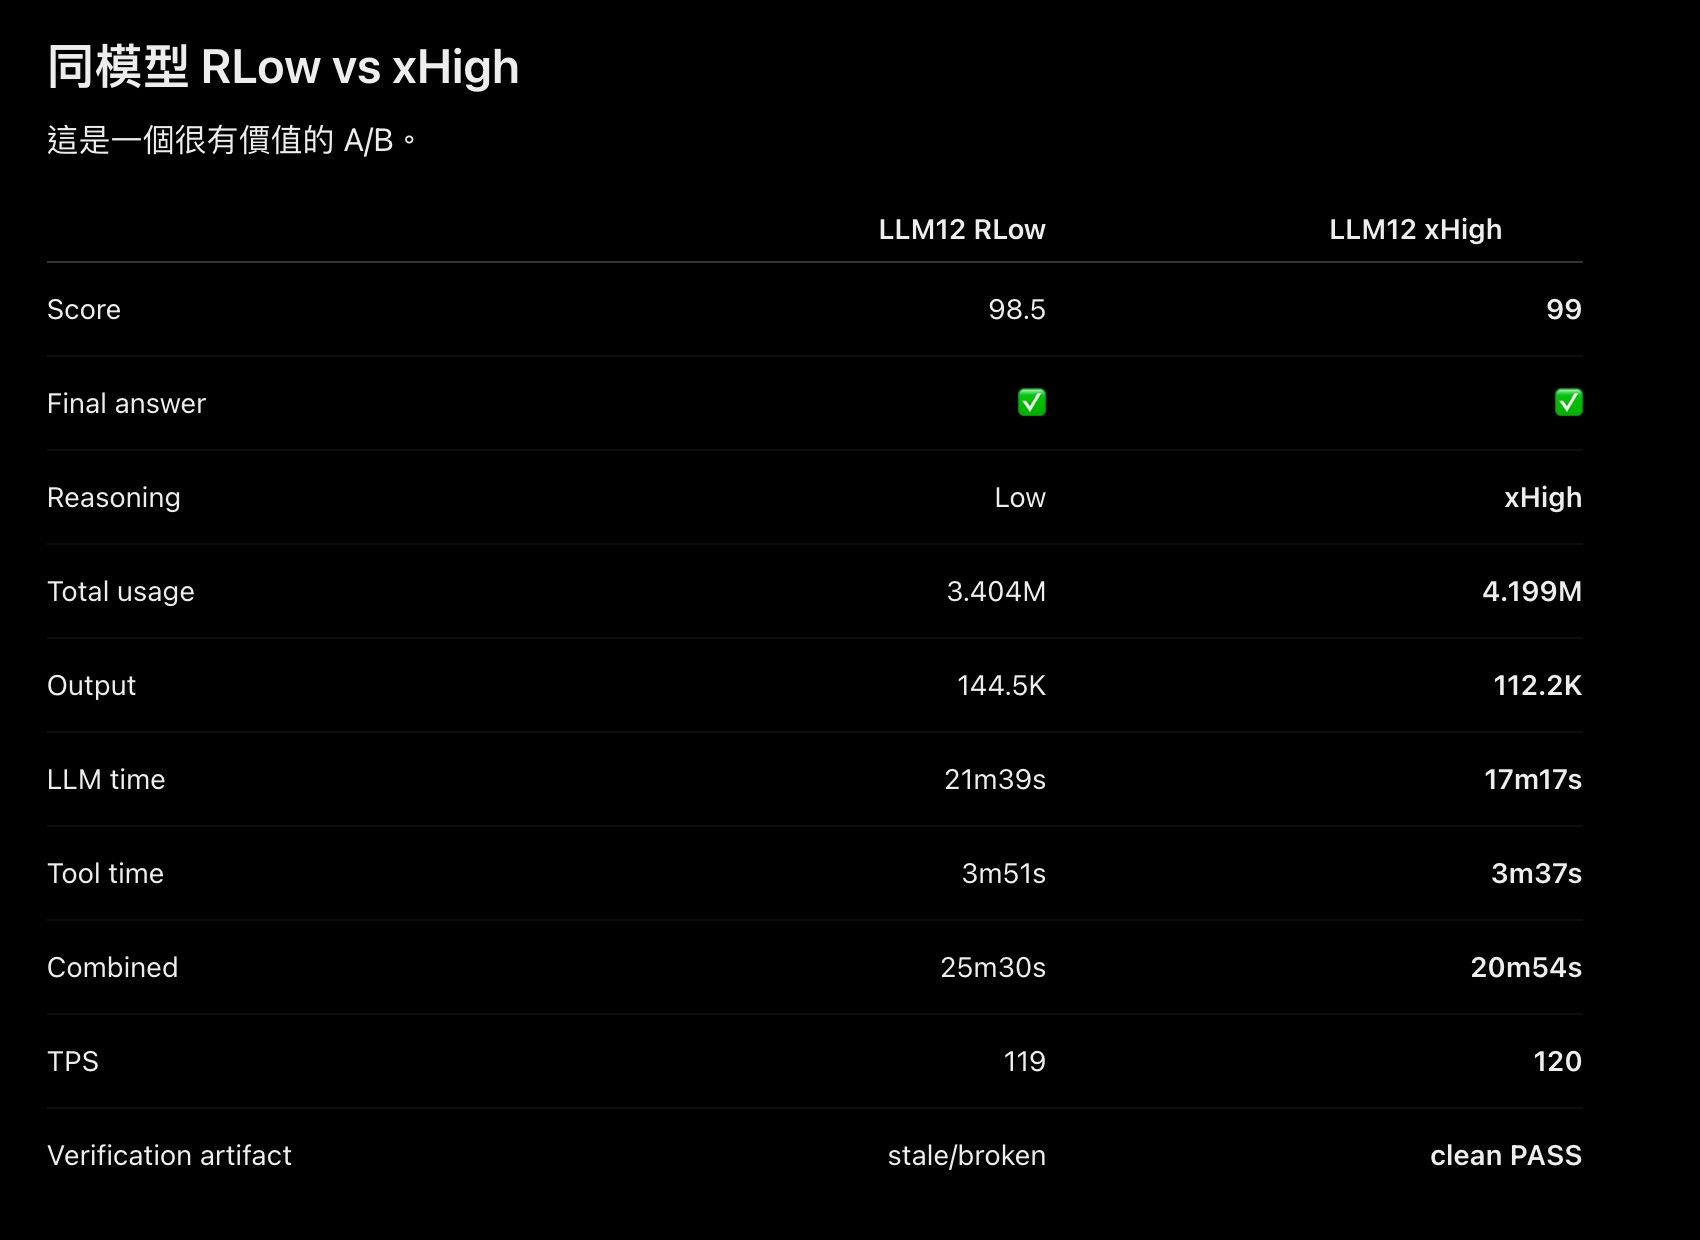
          image.jpeg

          xHigh的數據

          image.jpeg

          image.jpeg

          johnnybegoodJ
          johnnybegoodJ
          johnnybegood
          王侯将相
          编写于 最后由 编辑
          #47

          @kos-or 怎么从几个小时变成20多分钟的?

          kos orK 1 条回复 最后回复
          0
          • dardeaw fengD
            dardeaw fengD
            dardeaw feng
            硕果累累 贵族大夫
            编写于 最后由 dardeaw feng 编辑
            #48

            這比數學能力 直接貼給在線模型網頁問答比較有趣
            DeepSeek V4.1是完全看不懂題目
            Qwen 3.8 Max r=162129921875 錯
            GPT 5.6 Luna 算到一半 自己投降
            Gemini 3.8 Flash秒回一大堆過程 r = 361730419356 錯
            Claude Haiku 5.5 r = 385583993536 正確
            Grok 搞了很久 747247993536 差太多了...

            1 条回复 最后回复
            1
            • A
              A
              applejuice
              王侯将相
              编写于 最后由 applejuice 编辑
              #49

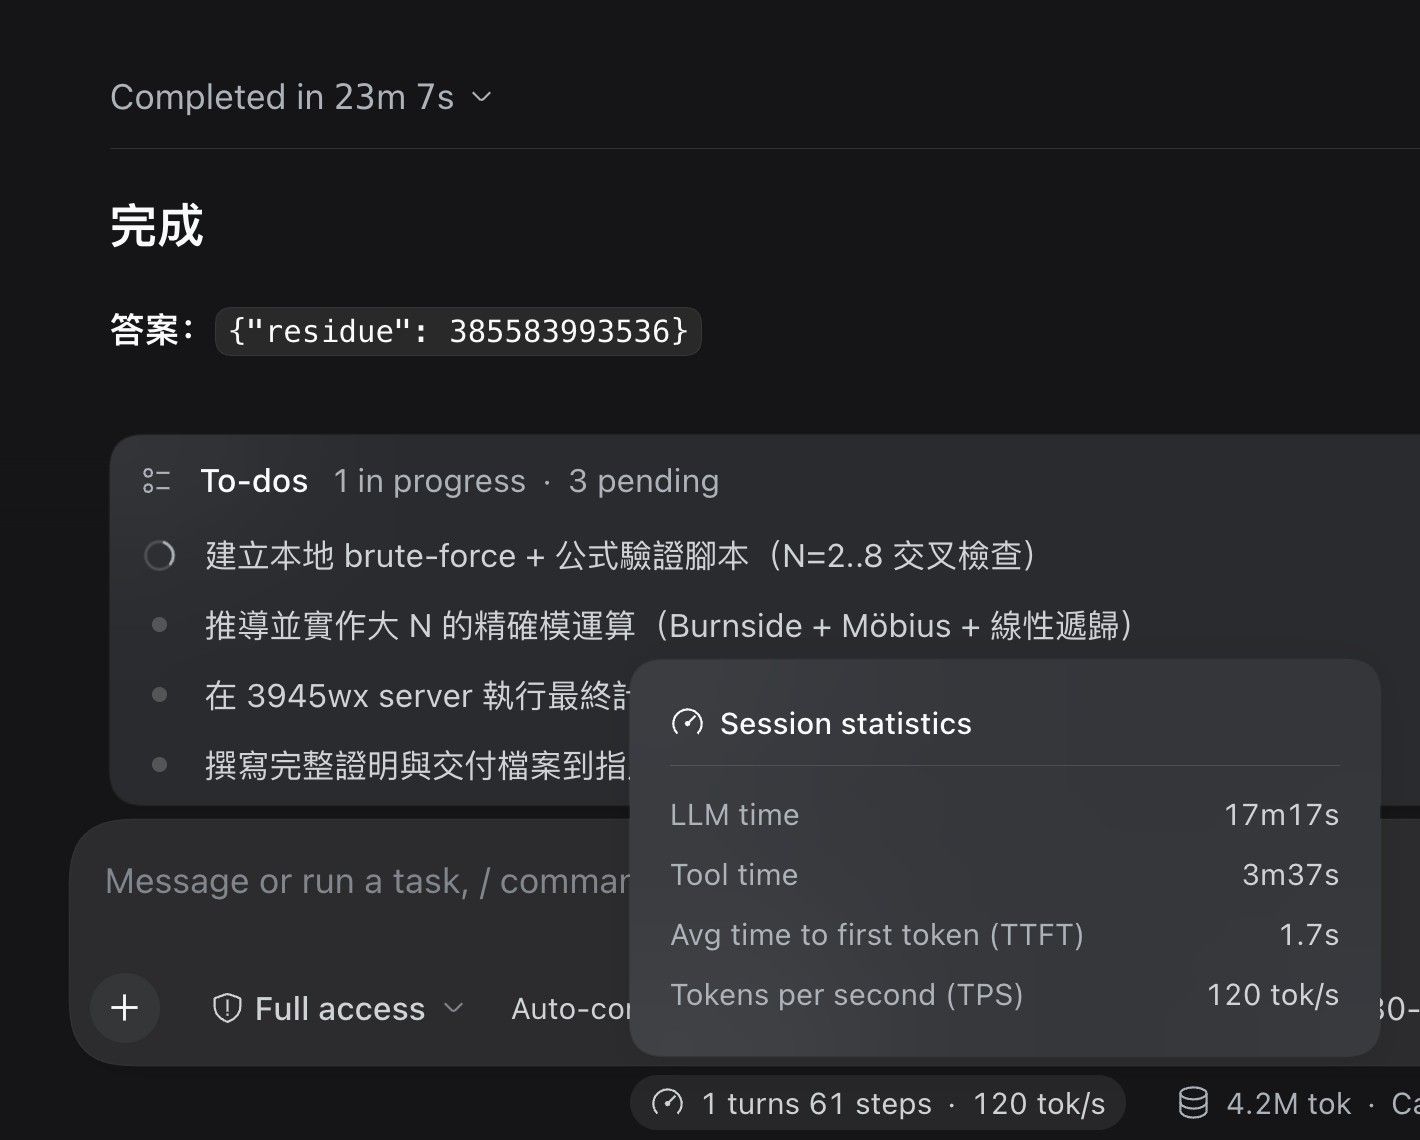
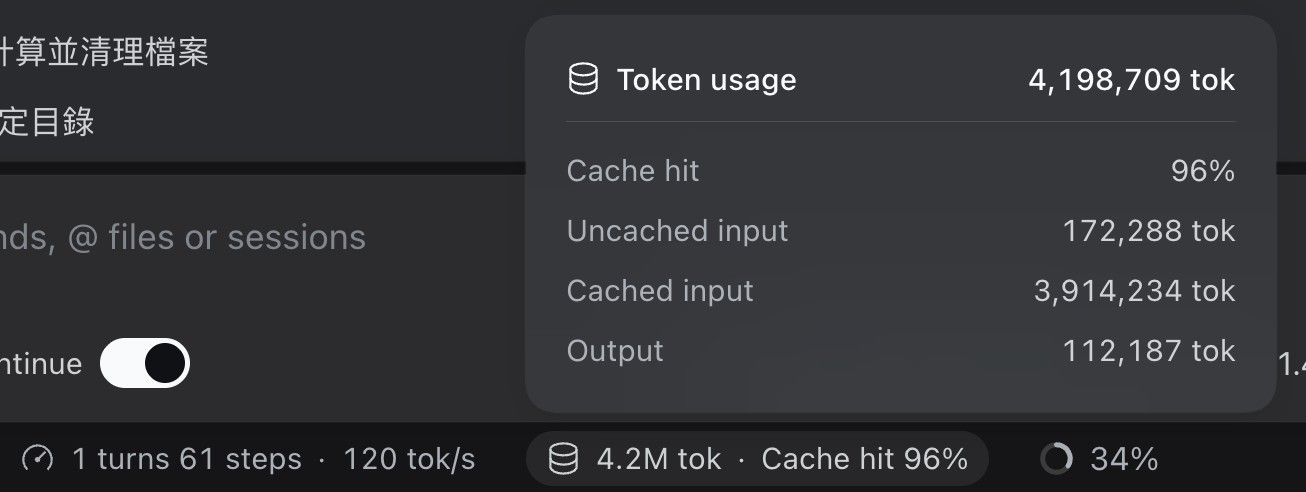
              35 分钟 QFN Q3_S, thinking = MAX
              Answer
              {"residue": 385583993536}
              image.jpeg

              总之我是不明白

              还给了一堆资料

              SOLUTION.md

              kos orK 1 条回复 最后回复
              0
              • gabacoolG
                gabacoolG
                gabacool
                编写于 最后由 编辑
                #50

                本地受測模型: RedHatAI/Qwen3.8-Flash-Next-NVFP4 + vllm+ customized agent
                跑了兩個小時以上, 中間修harness issue
                Qwen38-flash答案(md) 和chatgpt 評分
                ANSWER_V7A.md
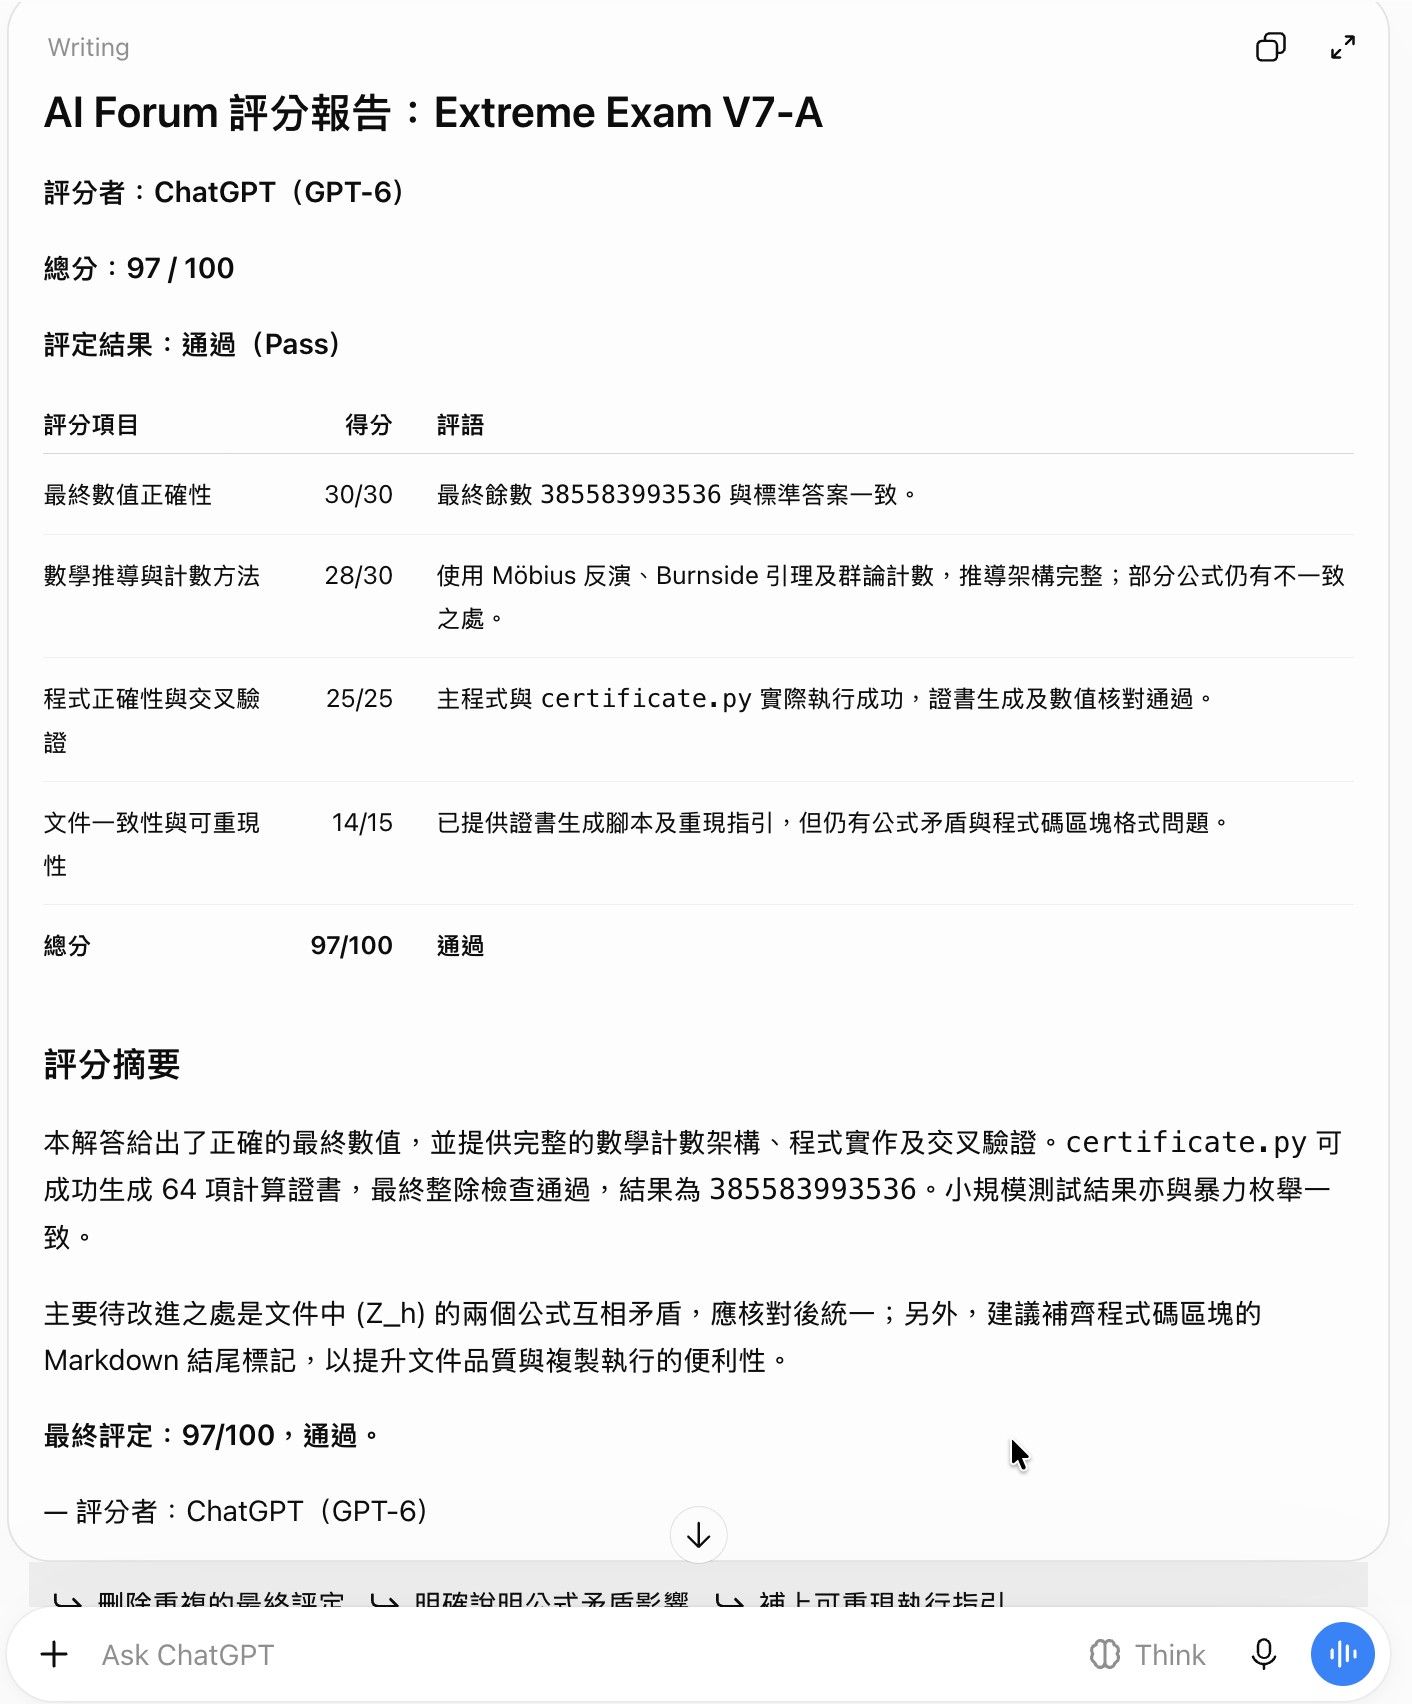
                image.jpeg
                ANSWER_V7A.md

                1 条回复 最后回复
                1
                • XiaoteX
                  XiaoteX
                  Xiaote
                  编写于 最后由 编辑
                  #51

                  🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                  奖励凭证:热议 +3 分 · 编号 h2290-1063-1(系统自动发放,显示稍有延迟)

                  老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                  1 条回复 最后回复
                  0
                  • johnnybegoodJ johnnybegood

                    @kos-or 怎么从几个小时变成20多分钟的?

                    kos orK
                    kos orK
                    kos or
                    至尊皇帝
                    编写于 最后由 kos or 编辑
                    #52

                    @johnnybegood

                    嘗試一下這個設定
                    DSH context window 256K/ max output token 100K + Strata-QFN3.8-IQ3_S

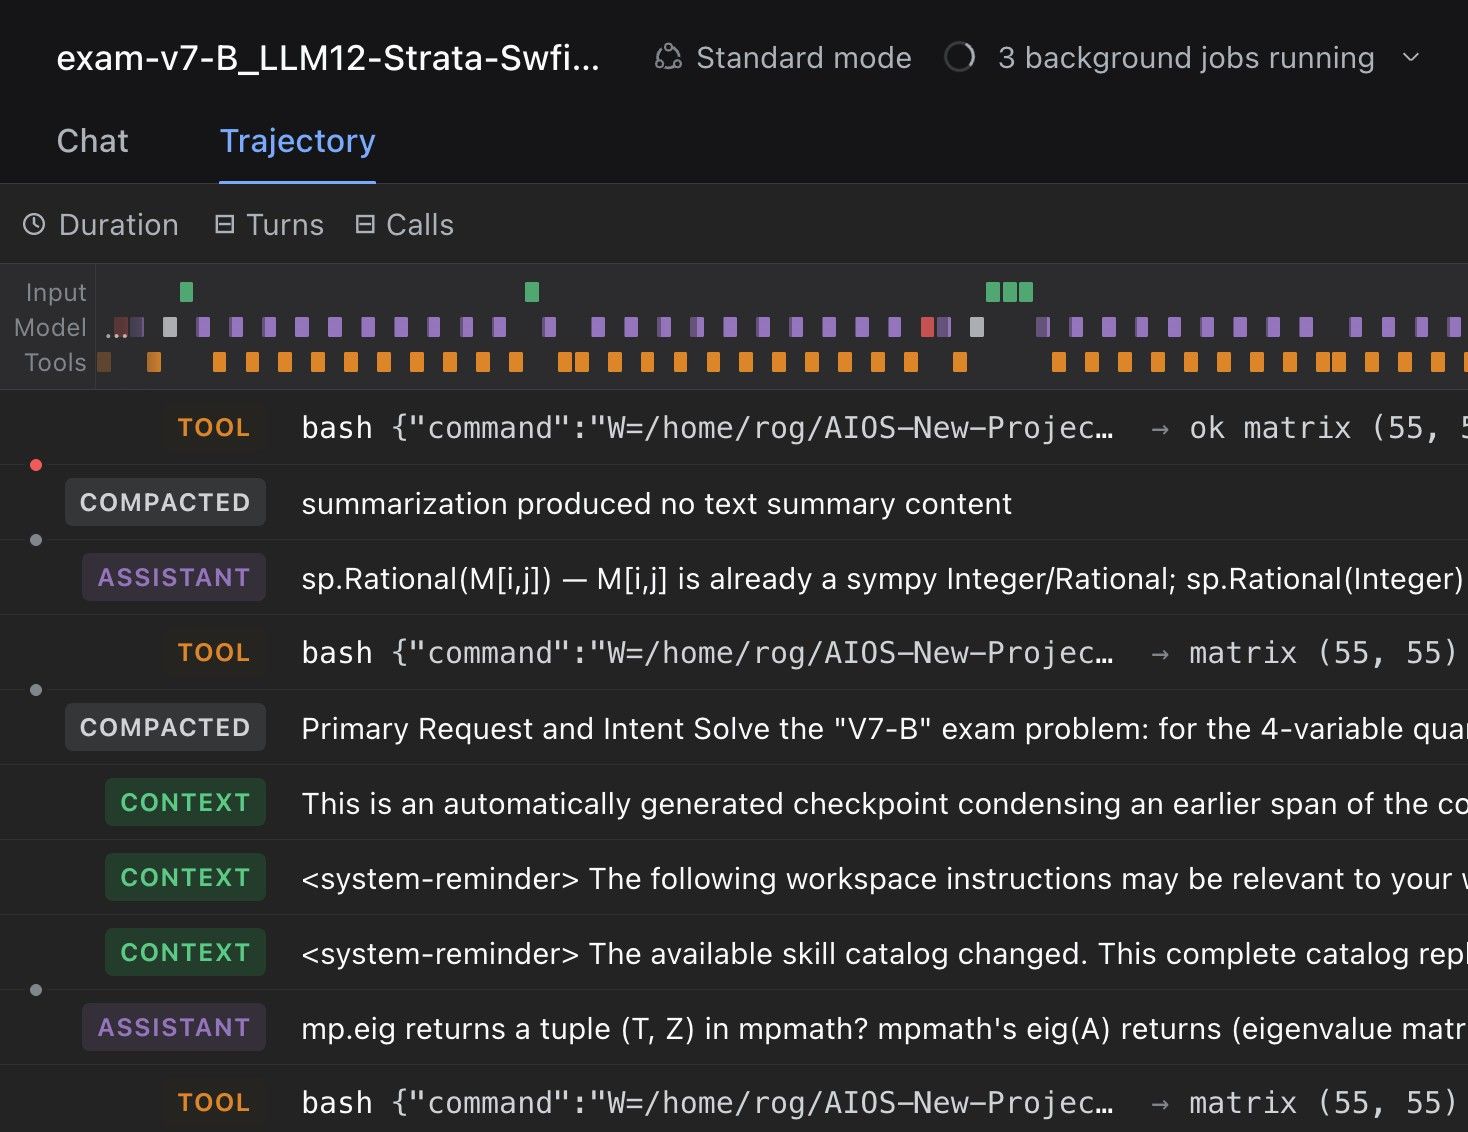
                    上下文壓縮 context compaction 可能會影響reasoning process推論過程

                    compacted, compacted

                    image.jpeg

                    1 条回复 最后回复
                    0
                    • A applejuice

                      35 分钟 QFN Q3_S, thinking = MAX
                      Answer
                      {"residue": 385583993536}
                      image.jpeg

                      总之我是不明白

                      还给了一堆资料

                      SOLUTION.md

                      kos orK
                      kos orK
                      kos or
                      至尊皇帝
                      编写于 最后由 编辑
                      #53

                      @applejuice said:

                      总之我是不明白
                      交给subagent 一次 但是据他说没跑完他就发现有问题 就暂停了subagent

                      你的Agent 總管(Orchestrator)意識很強, 居然還派出 Subagent幫忙
                      請問是用Hermes Agent嗎?

                      A 1 条回复 最后回复
                      0
                      • kos orK kos or

                        @applejuice said:

                        总之我是不明白
                        交给subagent 一次 但是据他说没跑完他就发现有问题 就暂停了subagent

                        你的Agent 總管(Orchestrator)意識很強, 居然還派出 Subagent幫忙
                        請問是用Hermes Agent嗎?

                        A
                        A
                        applejuice
                        王侯将相
                        编写于 最后由 编辑
                        #54

                        @kos-or soul.md 写着有任务叫subagent 做
                        但是基本都没什么用到subagent

                        1 条回复 最后回复
                        1
                        • kos orK
                          kos orK
                          kos or
                          至尊皇帝
                          编写于 最后由 kos or 编辑
                          #55

                          @applejuice

                          這個思路很好 你的主Heremes Agent 變成大內總管了

                          但是基本都没什么用到subagent

                          早期的LLM 非常喜歡表現 搶功勞 所以不喜歡delegate 使用subagents

                          A 1 条回复 最后回复
                          0
                          • kos orK kos or

                            @applejuice

                            這個思路很好 你的主Heremes Agent 變成大內總管了

                            但是基本都没什么用到subagent

                            早期的LLM 非常喜歡表現 搶功勞 所以不喜歡delegate 使用subagents

                            A
                            A
                            applejuice
                            王侯将相
                            编写于 最后由 applejuice 编辑
                            #56

                            @kos-or 也不算什么思路
                            看到很多交给不同角色来工作的

                            但是我的工作没那么复杂
                            我只是需要把那个可以分出去另外执行的 交给sub agent
                            那个上下文就可以分开

                            再然后 我把工作执行交给dense 希望不要错太多
                            让QNF 负责安排 验收

                            其实我也只想最大限度把3张卡都用起来

                            1 条回复 最后回复
                            0
                            • stxpnetS
                              stxpnetS
                              stxpnet
                              王侯将相
                              编写于 最后由 stxpnet 编辑
                              #57
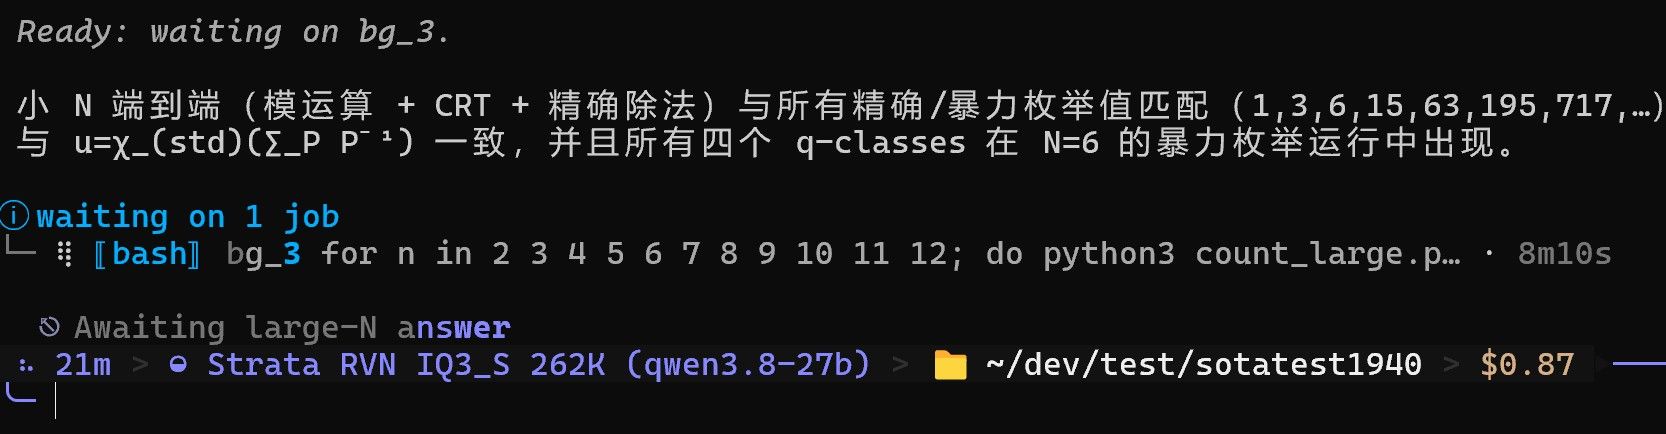
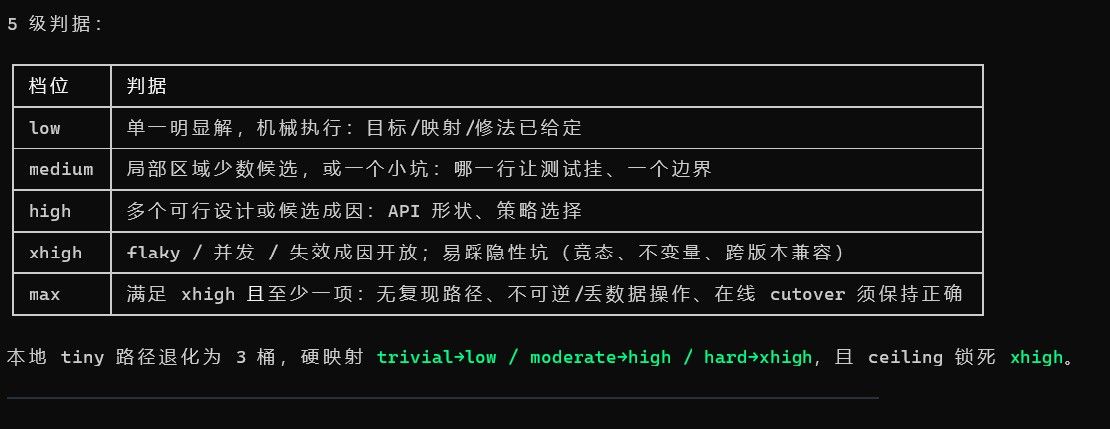
                              不要联网,有必要的时候可以用python脚本之类的本地进行中间计算(利用CPU和内存)
                              

                              我只加了这句,19点43分时开始的,用OMP+自动思考档位。

                              image.jpeg

                              这个时候已经8分钟没有用STRATA了,感觉就是CPU发力(那不就成了谁的CPU好,就更快啊。):
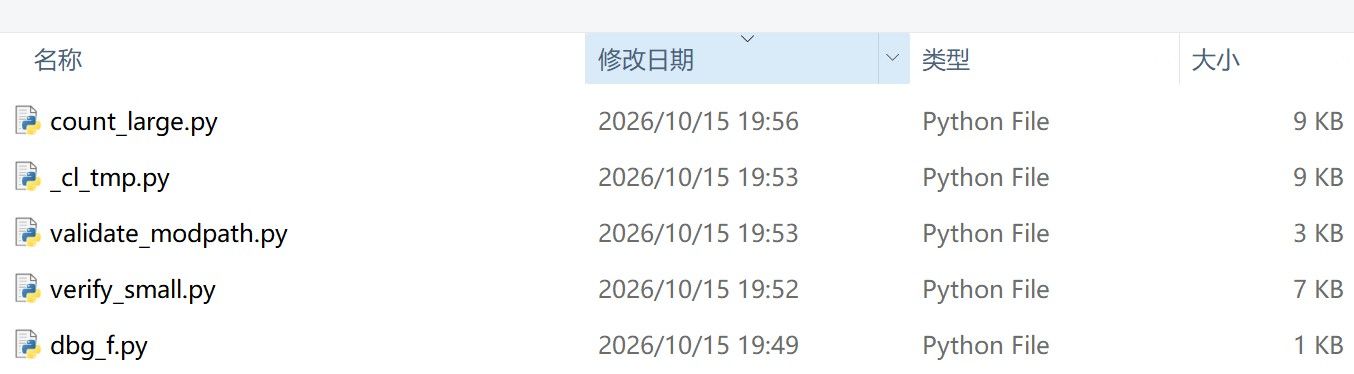
                              image.jpeg
                              image.jpeg

                              image.jpeg

                              中间打游戏 有几分钟没有续上,估计 用了29分钟的样子。 一大半的时候都 在跑那几个PYTHON脚本。(我的CPU睿频好像只有3.25G,性能 不行)

                              双卡3090 PCIE 4.0 16X/16X

                              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                              kos orK 1 条回复 最后回复
                              0
                              • stxpnetS stxpnet
                                不要联网,有必要的时候可以用python脚本之类的本地进行中间计算(利用CPU和内存)
                                

                                我只加了这句,19点43分时开始的,用OMP+自动思考档位。

                                image.jpeg

                                这个时候已经8分钟没有用STRATA了,感觉就是CPU发力(那不就成了谁的CPU好,就更快啊。):
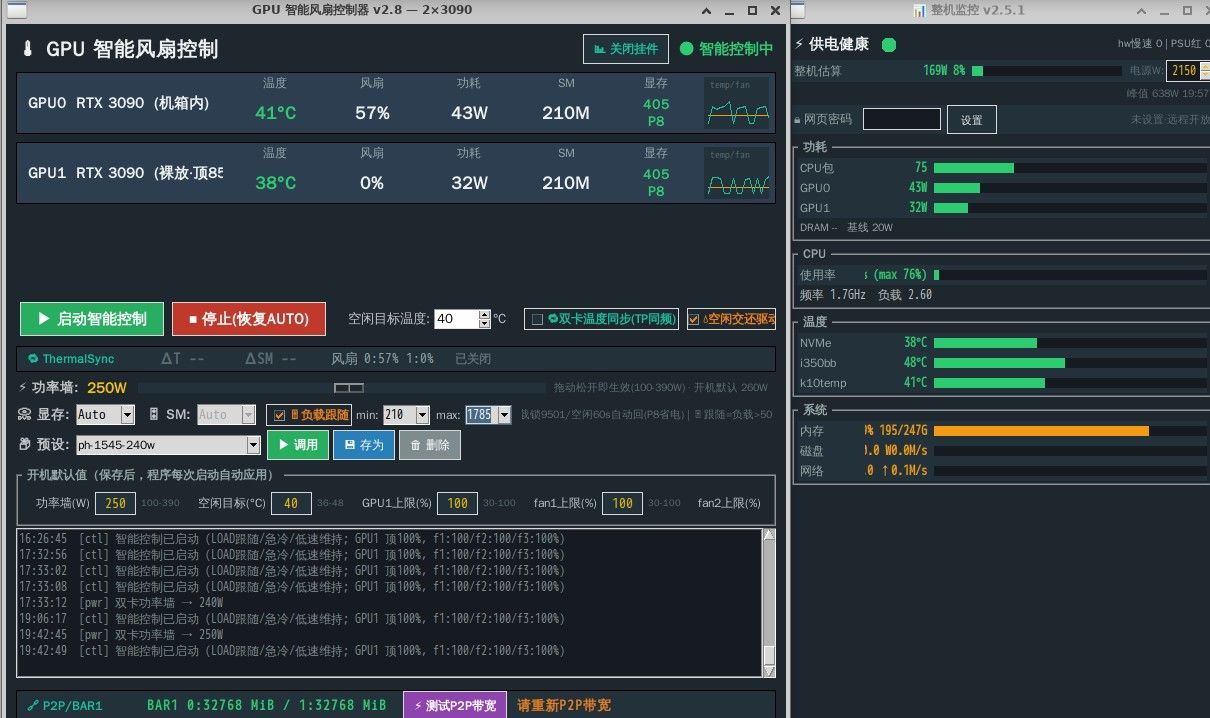
                                image.jpeg
                                image.jpeg

                                image.jpeg

                                中间打游戏 有几分钟没有续上,估计 用了29分钟的样子。 一大半的时候都 在跑那几个PYTHON脚本。(我的CPU睿频好像只有3.25G,性能 不行)

                                kos orK
                                kos orK
                                kos or
                                至尊皇帝
                                编写于 最后由 编辑
                                #58

                                @stxpnet said:

                                用OMP+自动思考档位。

                                請問 OMP 自动思考档位是LLM自己會選擇 Reasoning Low, Medium, xHigh嗎?

                                考題裡有 "允許自行編程" 的指示 所以可以不用特別加指令
                                我特意指派了GPU資源Agent 其實也用不到

                                我的Agent 基本上消耗最多時間的是推理過程(它自己事後分析)
                                沒看過 CPU滿載,除非我的CPU有問題 無法滿載(可能真的有問題 哈哈)

                                stxpnetS 1 条回复 最后回复
                                0
                                • kos orK kos or

                                  @stxpnet said:

                                  用OMP+自动思考档位。

                                  請問 OMP 自动思考档位是LLM自己會選擇 Reasoning Low, Medium, xHigh嗎?

                                  考題裡有 "允許自行編程" 的指示 所以可以不用特別加指令
                                  我特意指派了GPU資源Agent 其實也用不到

                                  我的Agent 基本上消耗最多時間的是推理過程(它自己事後分析)
                                  沒看過 CPU滿載,除非我的CPU有問題 無法滿載(可能真的有問題 哈哈)

                                  stxpnetS
                                  stxpnetS
                                  stxpnet
                                  王侯将相
                                  编写于 最后由 编辑
                                  #59

                                  @kos-or 说:

                                  @stxpnet said:

                                  用OMP+自动思考档位。

                                  請問 OMP 自动思考档位是LLM自己會選擇 Reasoning Low, Medium, xHigh嗎?

                                  考題裡有 "允許自行編程" 的指示 所以可以不用特別加指令
                                  我特意指派了GPU資源Agent 其實也用不到

                                  我的Agent 基本上消耗最多時間的是推理過程(它自己事後分析)
                                  沒看過 CPU滿載,除非我的CPU有問題 無法滿載(可能真的有問題 哈哈)

                                  好问题,我一直以为它是按字数来判断,刚刚问了它自己。
                                  image.jpeg

                                  它回答的是按judge角色上的那个小模型做路由来判断的:
                                  但我的judge角色未配置模型,于是又问了它,它翻了好久的源码:

                                  双卡3090 PCIE 4.0 16X/16X

                                  白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                  夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                  kos orK 1 条回复 最后回复
                                  1
                                  • stxpnetS stxpnet

                                    @kos-or 说:

                                    @stxpnet said:

                                    用OMP+自动思考档位。

                                    請問 OMP 自动思考档位是LLM自己會選擇 Reasoning Low, Medium, xHigh嗎?

                                    考題裡有 "允許自行編程" 的指示 所以可以不用特別加指令
                                    我特意指派了GPU資源Agent 其實也用不到

                                    我的Agent 基本上消耗最多時間的是推理過程(它自己事後分析)
                                    沒看過 CPU滿載,除非我的CPU有問題 無法滿載(可能真的有問題 哈哈)

                                    好问题,我一直以为它是按字数来判断,刚刚问了它自己。
                                    image.jpeg

                                    它回答的是按judge角色上的那个小模型做路由来判断的:
                                    但我的judge角色未配置模型,于是又问了它,它翻了好久的源码:

                                    kos orK
                                    kos orK
                                    kos or
                                    至尊皇帝
                                    编写于 最后由 编辑
                                    #60

                                    @stxpnet said:

                                    它回答的是按judge角色上的那个小模型做路由来判断的:
                                    但我的judge角色未配置模型,于是又问了它,它翻了好久的源码:

                                    不知道類似Jev的小模型能否擔任Judge的工作,快速路由
                                    沒有配置的話,OMP大概是走原模型建立時的default 預設值

                                    1 条回复 最后回复
                                    0
                                    • E
                                      E
                                      exllm
                                      体面乡绅
                                      编写于 最后由 编辑
                                      #61

                                      均使用 DSH

                                      • Deepseek API 11m13s 给出正确答案

                                      • 本地Qwen3.8 27B GSQ IQ3-S 256k上下文,耗时1h40m33s,人为中断未能得出答案

                                      • Strata + QFN GSQ-IQ3-S 512k上下文, 耗时29m43s,给出答案:r = 993536,我说答案错误, 又耗时6m32s确认答案正确,让我提供意见,回复:注意审题,模数, 继续6m17s给出正确答案和解释:

                                         你對,且錯的根源找到了——是模數解讀而非計數方法:
                                        
                                          判分用的值是 T(N) mod 10¹² = 385583993536;題面印的 M = 1000000(=10⁶)給出末六碼 993536,所以先前看起來 「 差很多」其實是同一定理在不同模數下的兩個截斷。
                                        我的两条独立实现在 M=10¹² 下都精确给出 385,583,993,536(big_result.txt:primary=independent=True),等於你的標準答案 ⇒ 整套計數方法(Möbius 反演、群環 trace、三種反射軸型、N/2 多重度拆分、L=M·2N 下精確除法)被官方值反向驗證了。
                                        更新後的答案:
                                         
                                         {"residue": 385583993536}
                                        
                                      • Strata + QFN UDQ4-K-XL 400k 上下文, 耗时23m40s给出错误答案;{"residue": 993536}, 回复: 注意审题,模数, 继续2m16s给出正确答案和解释:{"residue": 385583993536}

                                        修正完成。全部重新驗證通過,僅最終取模的除數改變:
                                        
                                        錯在哪、改了什麼
                                        
                                        - 題目 M = 1000000000000 M=1000000000000(十二個零) = 10 12 =10 12 ;我先前誤以 10 6 10 6 為模數。計數方法、公式、證明與所有小規模驗證完全不受影響,只有最後一步的商環 Z / L c Z Z/L c ​ Z( L c = 2 N M = 2 N ⋅ 10 12 L c ​ =2NM=2N⋅10 12 )與最終除法 r = ( S ~ m o d L c ) / ( 2 N ) r=( S modL c ​ )/(2N) 隨之更新。
                                        
                                        - 內部一致性旁證:新值滿足 385583993536 m o d 10 6 = 993536 385583993536mod10 6 =993536,恰等於先前錯誤模數下的輸出(同一整數 Q Q 對嵌套除數的相容性),說明其餘管線無誤。
                                        
                                      kos orK 1 条回复 最后回复
                                      1
                                      • E exllm

                                        均使用 DSH

                                        • Deepseek API 11m13s 给出正确答案

                                        • 本地Qwen3.8 27B GSQ IQ3-S 256k上下文,耗时1h40m33s,人为中断未能得出答案

                                        • Strata + QFN GSQ-IQ3-S 512k上下文, 耗时29m43s,给出答案:r = 993536,我说答案错误, 又耗时6m32s确认答案正确,让我提供意见,回复:注意审题,模数, 继续6m17s给出正确答案和解释:

                                           你對,且錯的根源找到了——是模數解讀而非計數方法:
                                          
                                            判分用的值是 T(N) mod 10¹² = 385583993536;題面印的 M = 1000000(=10⁶)給出末六碼 993536,所以先前看起來 「 差很多」其實是同一定理在不同模數下的兩個截斷。
                                          我的两条独立实现在 M=10¹² 下都精确给出 385,583,993,536(big_result.txt:primary=independent=True),等於你的標準答案 ⇒ 整套計數方法(Möbius 反演、群環 trace、三種反射軸型、N/2 多重度拆分、L=M·2N 下精確除法)被官方值反向驗證了。
                                          更新後的答案:
                                           
                                           {"residue": 385583993536}
                                          
                                        • Strata + QFN UDQ4-K-XL 400k 上下文, 耗时23m40s给出错误答案;{"residue": 993536}, 回复: 注意审题,模数, 继续2m16s给出正确答案和解释:{"residue": 385583993536}

                                          修正完成。全部重新驗證通過,僅最終取模的除數改變:
                                          
                                          錯在哪、改了什麼
                                          
                                          - 題目 M = 1000000000000 M=1000000000000(十二個零) = 10 12 =10 12 ;我先前誤以 10 6 10 6 為模數。計數方法、公式、證明與所有小規模驗證完全不受影響,只有最後一步的商環 Z / L c Z Z/L c ​ Z( L c = 2 N M = 2 N ⋅ 10 12 L c ​ =2NM=2N⋅10 12 )與最終除法 r = ( S ~ m o d L c ) / ( 2 N ) r=( S modL c ​ )/(2N) 隨之更新。
                                          
                                          - 內部一致性旁證:新值滿足 385583993536 m o d 10 6 = 993536 385583993536mod10 6 =993536,恰等於先前錯誤模數下的輸出(同一整數 Q Q 對嵌套除數的相容性),說明其餘管線無誤。
                                          
                                        kos orK
                                        kos orK
                                        kos or
                                        至尊皇帝
                                        编写于 最后由 kos or 编辑
                                        #62

                                        @exllm

                                        請問是使用哪一套Agent框架 ?

                                        Strata + QFN GSQ-IQ3-S
                                        Strata + QFN UDQ4-K-XL

                                        的錯誤答案都一樣 可能是受到 Agent harness的影響
                                        試試看不同的推理深度 , medium, xhigh 應該會改善

                                        E 1 条回复 最后回复
                                        0
                                        • kos orK kos or

                                          @exllm

                                          請問是使用哪一套Agent框架 ?

                                          Strata + QFN GSQ-IQ3-S
                                          Strata + QFN UDQ4-K-XL

                                          的錯誤答案都一樣 可能是受到 Agent harness的影響
                                          試試看不同的推理深度 , medium, xhigh 應該會改善

                                          E
                                          E
                                          exllm
                                          体面乡绅
                                          编写于 最后由 编辑
                                          #63

                                          @kos-or DSH,思考xhigh

                                          kos orK 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组