双 RTX PRO 6000 + 48GB RAM:DeepSeek V4.1 Flash 1017 在 Strata 上跑通,接上 OpenCode 约 63 tok/s
-
之前在1017 上 Strata 还差哪些 Gap和准备开始实测的回复里挖了个坑,这次回来交作业:同一台双 96GB 显存、48GB 系统内存的机器,DeepSeek V4.1 Flash 1017 已经跑上 Strata,也接到 OpenCode 里实际用了。

不是之前 Qwen 那个 210 tok/s 的配置换了个模型名。这次用的是 1017 的 EXL3 2.7 bpw 量化。原帖截图使用普通 decode;完成下面这轮对照后,当前部署改选 按层拆分 + DSpark,仍然不开跳专家。
2026-10-20 更新:最后选了 Layer + DSpark
这轮把 DSpark 的验证和状态提交改了一遍,也实际做了 TP2。结论先说:这台机器上,当前实现还是按层拆分 + DSpark 更快,TP 暂时不作为默认方案。
同一个代码问题(要求用 Python 写线程安全的 LRU cache),63-token 输入,固定比较前 96 个 greedy 输出 token。输入逐 token 处理,prefill 不计入 decode 时间;预热一轮,再测三轮取中位数。四种模式的输出 token 完全相同:
执行方式 推测解码 Decode Layer split,18/22 层 关 68.1 tok/s Layer split,18/22 层 DSpark 80.8 tok/s TP2 关 42.0 tok/s TP2 DSpark 43.0 tok/s 这组短代码题里,Layer + DSpark 比 Layer 普通 decode 快约 18.7%。DSpark 的预热和测量轮都用了 33 个验证窗口,平均每窗口接收 2.909 个输入 token;不是说每个窗口都接收了这么多个额外草稿,这个统计包含必然提交的首 token。
测量使用 CUDA 13.4 / GCC 15;测试进程限制为 16 GiB 主机内存、禁用 cgroup swap,CPU 配额设为 200%。MTP 专家 GPU 缓存上限为每个参与 drafting 的 rank 1024 MiB,按可用显存有界增长。
这轮主要改了两点:
- DSpark 不再接受几个 token 就重跑几次主干。 多个候选输入按层批量验证,直接提交接受前缀对应的 KV、压缩状态和下一步 drafting 输入,拒绝的尾巴回滚。缓存只针对可选的 MTP 专家,不挤掉主干常驻专家,也没有重新量化模型。
- TP2 不是把 Layer split 换个名字。 两张卡实际持有量化矩阵和专家的输出通道分片,attention head 也做了拆分;合并分组通信、使用有界双缓冲 mailbox 后,比最初的 TP 实现快了不少。但它仍然明显落后于按层拆分,不能因为叫 TP 就当成加速。完整内核 profile 尚未拿到,不把猜测写成已确认的耗时归因。
代码和部署配置都已提交、推送:
80.8 tok/s 是这组短输入、固定输出的 native-engine 对照结果,不是下面 OpenCode 截图那条 51K 输入请求的新版测速,也不是所有 coding 请求都能达到的速度。 原截图和约 63 tok/s 的标题保留,不混成同一组数据。
具体配置:
- CPU:AMD Ryzen 7 9700X
- RAM:48GB DDR5-6400 CL32,双通道
- GPU:2 × RTX PRO 6000 Blackwell,各 96GB,每卡限功耗 300W
- 主板:铭瑄 MS-iCraft B850 AIGA,两张 GPU 都是 PCIe 5.0 x8
- SSD:2TB 系统盘 + 2 × 4TB PCIe 5.0 NVMe,模型和 Engram 放在数据盘
- OS:Ubuntu 26.04 LTS
还是之前跑 Qwen 的那台机器,没有为了这次实验升级系统内存。装机、拓扑和机器照片可以看旧帖。
项目细节:
感谢 Niko 的 Strata、Jackwwg83 的 DeepSeek 后端,以及 sudoingx 的量化。不是我从零写了整个推理引擎:现在的仓库直接基于 Niko 的上游,选择性移入已有 DeepSeek/EXL3 实现,再补这台机器需要的双卡驻留、低 RAM 加载、prefill 和服务适配。
部署仓库固定引擎版本和量化版本,具体构建、安装和启动方法都放在 README 里。现成量化会生成运行用的 pack,这是打包/重排,不是本地再量化一遍;也仍然需要额外磁盘空间,不是零转换缓存。
实际使用截图:
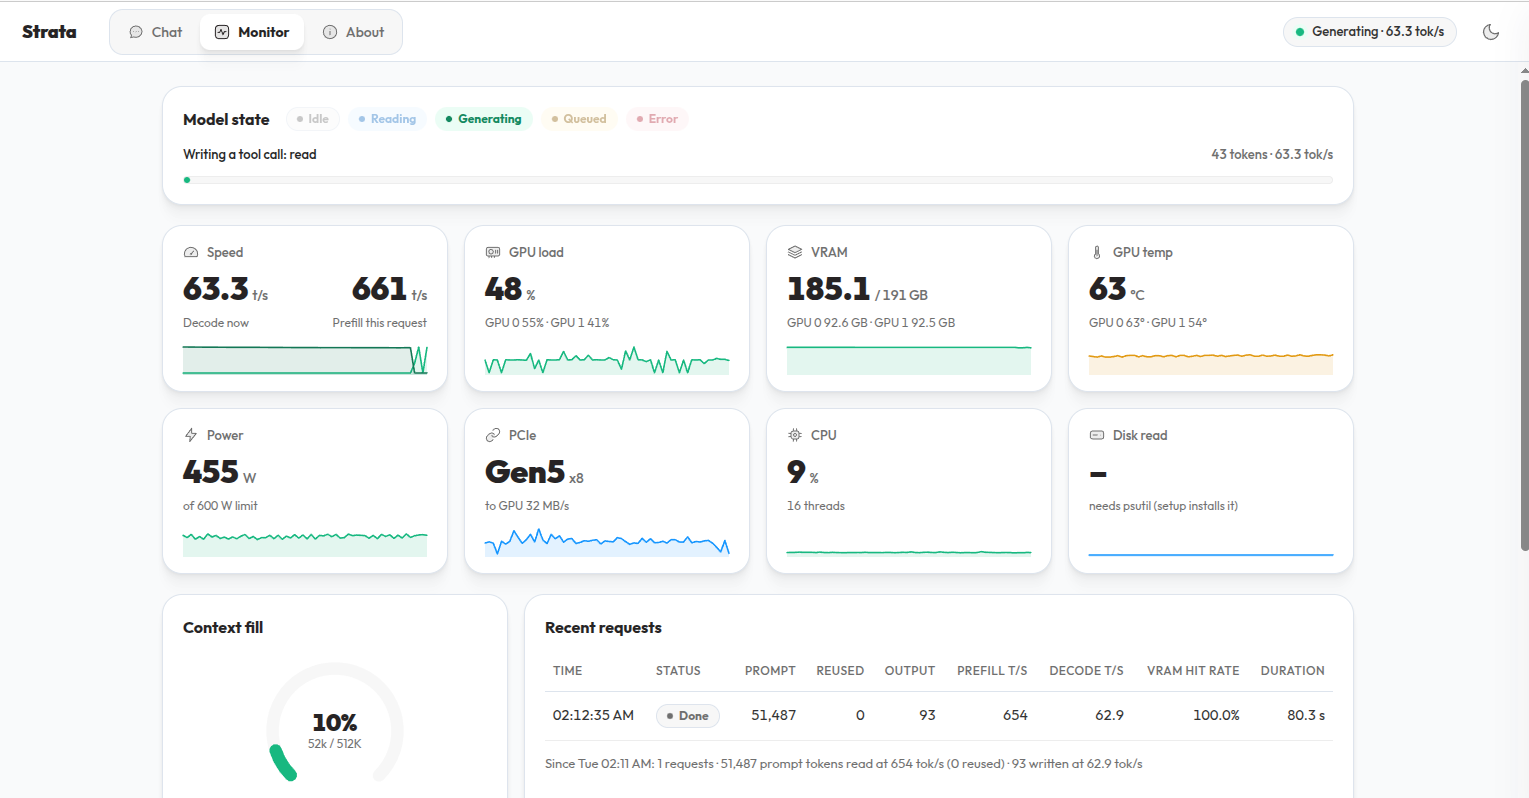
图里正在生成一个
read工具调用。下面那条已经完成的请求,统计是:项目 数值 输入 51,487 tokens 输出 93 tokens Prefill 654 tok/s Decode 62.9 tok/s 请求总耗时 80.3 秒 专家显存命中率 100% 截图当时双卡合计显存占用 185.1GB,两张卡分别约 92.6GB / 92.5GB。GPU 合计功耗读数约 455W,这是显卡传感器读数,不是整机插座功耗。
所以现在可以更新成:1017 不只是能输出几个字,已经能接进 OpenCode 发起实际工具调用请求,截图这条请求的 decode 约 63 tok/s。
不过这不是统一条件的 benchmark:这条输入约 51K,只输出了 93 tokens,不能代表所有任务和上下文长度。也不要拿它和旧帖 Qwen 的 210 tok/s 直接横比,模型、量化和请求都不同。
这次主要填了哪些坑?
核心还是旧帖说的那件事:显存够,不代表加载过程就能在 48GB RAM 里完成。
默认部署走的仍是按层拆分,不是 TP,也不是把两张卡当成一张统一的 192GB 显卡:
- 第 0–17 层放第一张卡,第 18–39 层放第二张卡,跨卡 KV/index 等状态也要一起处理。
- 主干专家权重常驻双卡显存,不依赖一边生成一边从 SSD 换进主干专家,也没有为了命中率改掉路由选择。
- Engram 留在 NVMe,按需查表;加载和传输使用有限的主机缓冲,不先在 RAM 里放一整份专家权重。
- 专家 RAM 预算设为零,只表示不保留专家权重的常驻 RAM 副本,不表示整个进程不占 RAM。数据仍然经过主机内存,不是 SSD 直传显存。
Prefill 也做了有界分块,避免长输入时临时空间失控。当前仍是单会话,生成路径改选 Layer + DSpark;上面的 OpenCode 截图仍然是普通 decode 的历史请求,不是靠这轮 DSpark 改动跑出来的。
关于 524K:分清配置上限和真正测过的输入
目前配置容量是 524,288 tokens,单个会话。但这里有两轮版本,数据不能混着写:
- 之前的 resident 版本
ccd8cf2,实际跑过 32K、128K、262K,最后输入 524,256 tokens,在 524,288 容量内取回了开头指定的口令。最后一档 prefill 531.73 秒,约 985.95 tok/s,完整测试 552.90 秒,没有 swap/OOM,也没有主干专家流式换入。 - 现在基于 Niko 上游整理后的版本,15 个组件测试通过;实模型测试覆盖逐 logit 对照、接受前缀直接提交、错误草稿回滚、会话隔离和取消恢复,TP 还测试了两种 GPU 顺序。513-token 用例的 prefill 和逐 token logits 均与之前发布的二进制逐字节一致。已安装的 Layer + DSpark 也在 524,288 配置容量下通过了短请求、重放、STOP 恢复和正常退出测试。但之前全长 524K 复跑我中途停掉了,之后没有重跑,不能写成新版又完整通过了一轮 524K 实际输入。
前面的长输入测试是重复填充内容加开头口令检索,不是全面的长上下文质量测试;OpenCode 截图也不是 524K 输入。这里先把能确认的结果交代清楚。
下一步:从能跑,走到能稳定干活
之前在讨论里说过,能启动、能输出,不等于已经证明适合当 coding agent 或 subagent。现在至少把部署和实际请求这一步走通了,后面更值得花时间的是 Eval:中文、代码、工具调用成功率、长上下文效果,以及真实任务的延迟和成本。
EXL3 2.7 bpw 的质量损失还没有靠这些测试量化出来,和可信参考实现的全面对照也没做完,暂时不下“无损”“追平原版”之类的结论。Docker 的 GPU 路径和新版实模型 HTTP 端到端验证还没做完,目前部署仍走 native,服务按需手动启动。
总之,之前的 Gap 帖不是白挖坑了。这台“大显存、小 RAM”的机器,现在又多了一个能接进 OpenCode 折腾的模型。欢迎有类似配置的朋友交流,尤其想看看大家怎么做真实 coding/tool-use 的评测。

-
,
L lunarmoon26 引用了 此主题
-
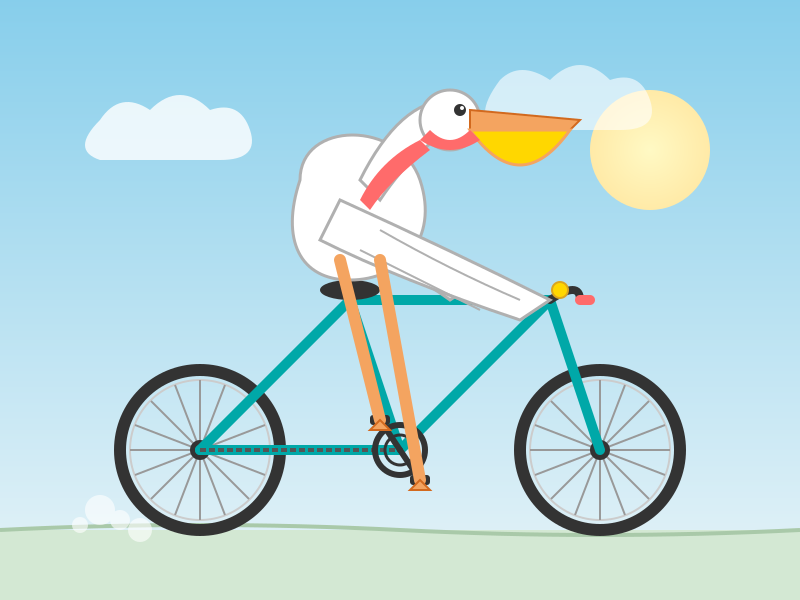
按规矩:鹈鹕骑车(Generate an SVG of a pelican riding a bicycle)
-
-
很有意義的測試 感謝分享