-
之前在 1017 上 Strata 还差哪些 Gap里挖的坑,继续交作业:双 RTX PRO 6000 + 48GB RAM,DeepSeek V4.1 Flash 1017 已经跑通,也接进 OpenCode 实际用了。
配置与 Decode
Ryzen 7 9700X、48GB DDR5,双 RTX PRO 6000 Blackwell,各 96GB、限功耗 300W,均为 PCIe 5.0 x8。仍用 sudoingx 1017 EXL3 2.7 bpw,不重新量化、不跳专家;主干专家常驻显存,Engram 留在 NVMe 按需查表。
目前选 Layer split 18/22 + DSpark,单会话容量 524,288 tokens。同一个短代码题,Layer 普通 decode 68.1 tok/s,加 DSpark 后 80.8 tok/s(+18.7%);TP2 只有 42.0 / 43.0 tok/s,暂不作为默认。
这组 decode 对照使用 63-token 输入、固定 96 个 greedy 输出,prefill 不计时,预热一次、测三次取中位数,四种模式输出相同。
2026-10-24 更新:Prefill 提速,补完新版实际 524K 输入
新增 GPU 专家分组和 packed EXL3 GEMM,减少 CPU 路由往返与完整矩阵重建。同设置的新旧路径对照:
实际输入 / 用例 原 Prefill Grouped Prefill 加速 16,384 / 源码 511.0 tok/s 1,325.2 tok/s 2.59× 65,536 / 检索 1,003.8 tok/s 1,904.5 tok/s 1.90× 524,256 / 检索 833.8 tok/s 1,384.9 tok/s 1.66× 16K 是预热后测三次的中位数;长输入每条路径各测一次。实际 chunk/batch 均为 512/256,无前缀复用;只计 native prefill,不含模型加载、分词和 HTTP。这些不是 decode 速度,不同用例也不直接横比。
满长一档从 628.75 秒降到 378.56 秒。两条路径都实际喂入 524,256 tokens、取回
BRONZE-73921,通过 snapshot 恢复后继续生成,最终位置 524,262 / 524,288;没有 swap/OOM 或主干专家流式换入。数值回归通过,但新旧 logits 不逐字节一致。长输入是重复背景加口令检索,不是全面 coding/长上下文质量评测。batch 512 的重放试验未通过,不采用,仍保留 batch 256。
代码已推送:引擎 3cda8ac · 部署 4497ef7。Grouped 仍是显式开启的实验路径,原路径保持默认;本机安装和停止状态没有被这次发布改变。
新版 OpenCode 实际使用截图
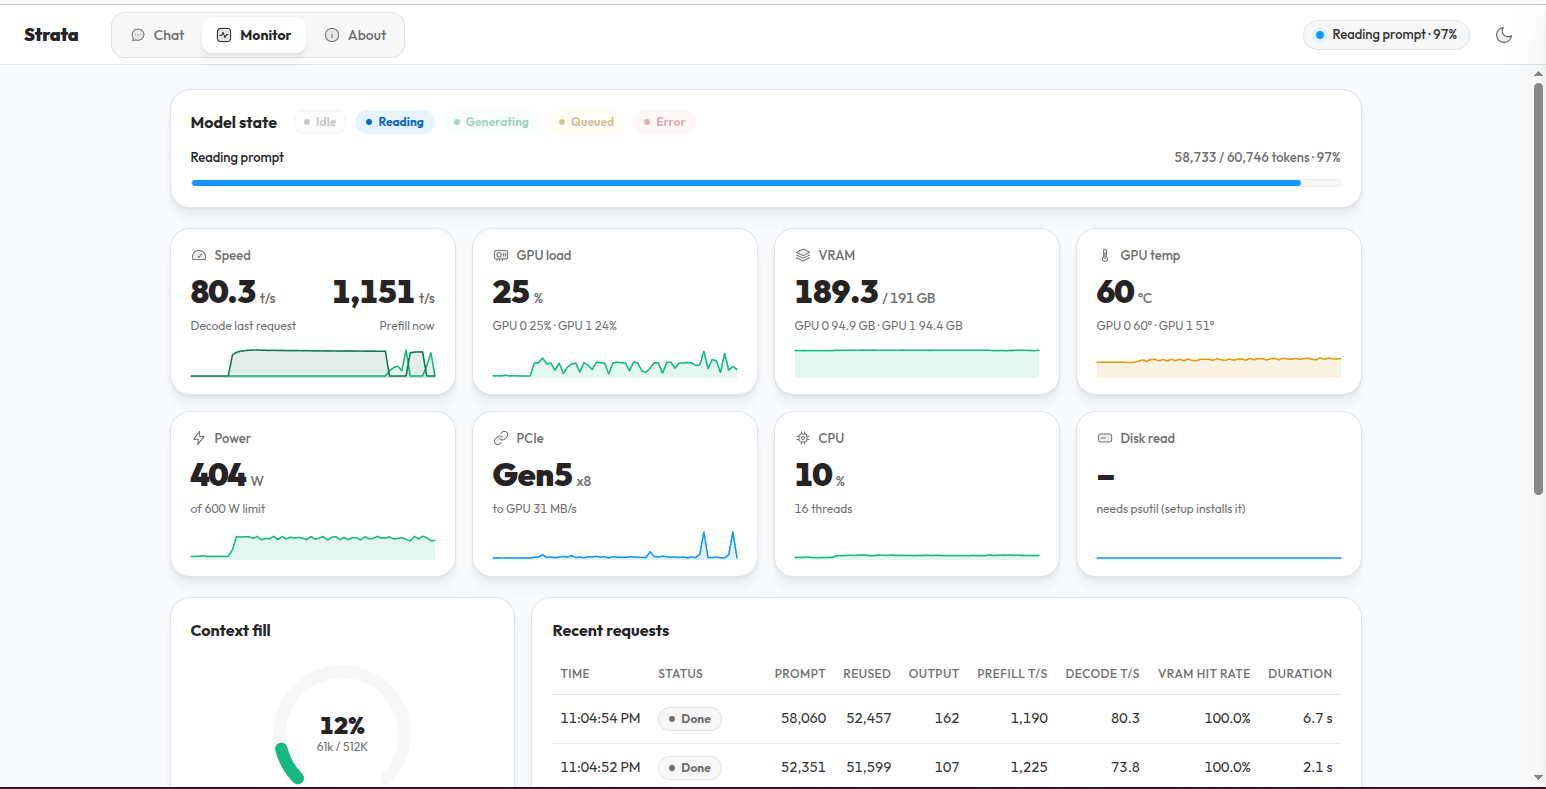
新版 OpenCode 实际请求:58,060 输入(复用 52,457)/ 162 输出,prefill 1,190 tok/s、decode 80.3 tok/s,总计 6.7 秒。截图上方是另一条仍在 prefill 的请求;这组含前缀复用,不与上面的零复用 native 测试直接比较。
接下来:Project Maya 对照测试
准备把我这个 Strata-DS 分支和 Project Maya 做一轮对照 benchmark,尽量对齐硬件、模型/量化、上下文与缓存条件,比较 prefill/decode、资源占用和工具调用表现,也看看有哪些优化值得借鉴。还没出对比结果,敬请期待!
感谢 Niko、Jackwwg83、sudoingx、Diffbot 等作者。下一步继续做代码、工具调用和真实任务 Eval;独立参考质量对照、新版实模型 HTTP 和 Docker GPU 验证尚未完成。欢迎交流。

-
,
L lunarmoon26 引用了 此主题
-
-
-
很有意義的測試 感謝分享


-
按规矩:鹈鹕骑车(Generate an SVG of a pelican riding a bicycle)
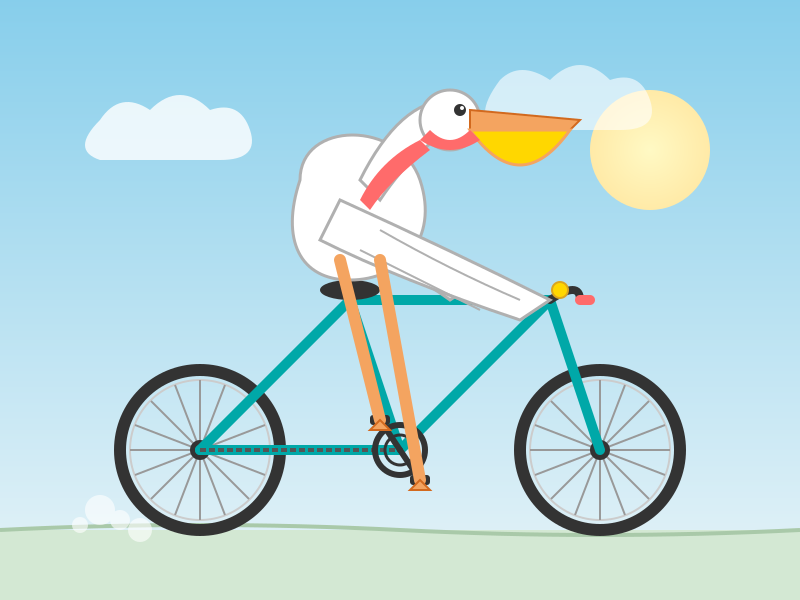
@lunarmoon26 说实话有点难看啊, 这是 deepseek V4.1 ?
看我的本地 qfn : tihu2.html
-
@lunarmoon26 说实话有点难看啊, 这是 deepseek V4.1 ?
看我的本地 qfn : tihu2.html
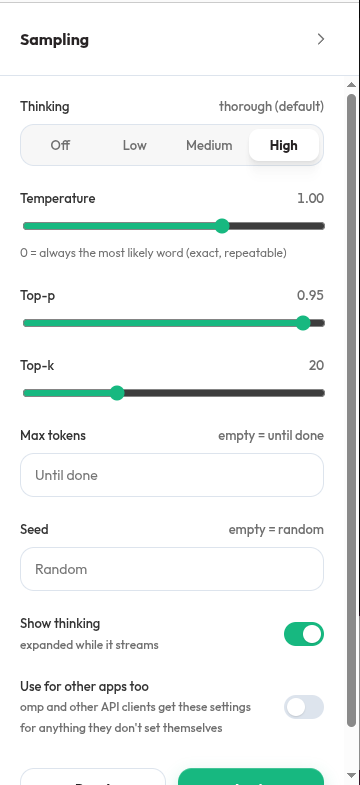
@johnnybegood 你用的prompt,思考等级,harness具体是什么?
我是直接用的Strata自带的UI选项全默认,prompt就是:Generate an SVG of a pelican riding a bicycle
-
,
 T terry 将此主题从 AI硬件 移至此处
-
-
按规矩:鹈鹕骑车(Generate an SVG of a pelican riding a bicycle)
-
-
看完後還是覺得去儲值比較省錢
無意冒犯啦,但有實驗精神給兄弟們羨慕真好
@dardeaw-feng 没错 如果纯粹使用 还是直接调用api充值比较便宜。但是有个问题是api一般会throttle request 高频调用就会被卡脖子
本地的一个好处是可以不需要等timeout
-
@johnnybegood 你用的prompt,思考等级,harness具体是什么?
我是直接用的Strata自带的UI选项全默认,prompt就是:Generate an SVG of a pelican riding a bicycle
@lunarmoon26 我也没有调参数, 都是默认, 提示词就是 , 给我生成一个鹈鹕骑自行车的 SVG动画 , 没有其他任何要求, 说实话我自己也很惊讶, 模型是 qfn iq4-xs 。 确实没有单独特地去调优。我感觉可能就是抽卡比较幸运吧。抽到了幸运卡。 用的是 deepseek harness xhigh 。 这是我的原贴:https://lcz.me/topic/2168 , 第一次我写错了, 把 鹈鹕 写成了 醍醐, 可能因为他思考过一回了吧, 第二次的时候只是把 醍醐 改成了 鹈鹕, 就成 tihu2.html 这个样子了。这两次为什么差别如此之大, 我也无法解释。