
-
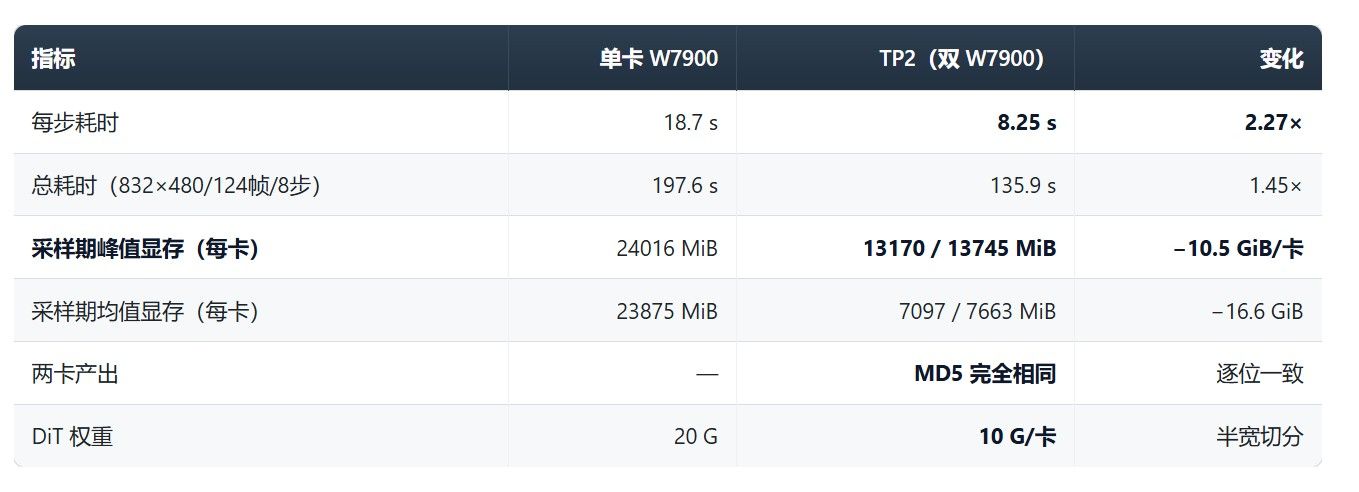
综上双卡应该就是最佳的了,优化完后大概是1张 48G 显存的水平。性能能到5090那个层级。四卡显存利用率会大幅下降,优化完后大概是PRO 5000 72G的水平,但代价是功耗是1200W,性能大概是单卡的3倍。
-
-
-
@Bunsei 那以后推荐卡的顺序都变了,有24G的卡能测试下吗?我这几天没时间,想大家测试了,我忙完,11月中直接抄作业。你搞完这个帖子要奖励你50积分,先奖励20积分。因为太重要了。感谢你的贡献!
-
@terry 我只有两张R9700 7900XTX我么的。而且得注意RDNA4跟RDNA3之间差的蛮大的,不能指望算力上有多大的提升。 显存方面按照我的测试双卡大概是 70%左右的利用率、最高80%,但这个是全程脱离了comfyui的环境的,而且配套的节点还没vibe出来,所以我不能保证。
-
-
mark留名,双r9700只搞了Qwen3.8fn,速度还是很满意的。
这下可以跟着大佬们学习跑图和视频了。
-
mark留名,双r9700只搞了Qwen3.8fn,速度还是很满意的。
这下可以跟着大佬们学习跑图和视频了。 -
-
,
 T terry 引用了 此主题
-
,T terry 引用了 此主题
-
@shawn-shen 跑的是radiance 吗?
测试下512K 长上下文呗
@applejuice 是的,radiance推qwen3.8-next-flash-uncensored-fp8-iq4r-moe这个破甲模型。
部署来自己开发用的,所以上下文设的512k,日常速度大概170t/s,调试说是大约支持2并发。
ngram卸载到nvme之后,内存要求蛮低的,我记得空了二三十g的样子,我内存是96g,感觉64g说不定也能用了。 -
@applejuice 是的,radiance推qwen3.8-next-flash-uncensored-fp8-iq4r-moe这个破甲模型。
部署来自己开发用的,所以上下文设的512k,日常速度大概170t/s,调试说是大约支持2并发。
ngram卸载到nvme之后,内存要求蛮低的,我记得空了二三十g的样子,我内存是96g,感觉64g说不定也能用了。 -
-
-
,系统 取消固定了此主题
-
-
@Bunsei 那以后推荐卡的顺序都变了,有24G的卡能测试下吗?我这几天没时间,想大家测试了,我忙完,11月中直接抄作业。你搞完这个帖子要奖励你50积分,先奖励20积分。因为太重要了。感谢你的贡献!
-
-
-
-
-
@fcys 能跑通那就牛逼了,这两个卡就是同一张卡,只是显存区别。你48G不需要TP吧,那就是说原理上是通的,我看你这效果也不错啊。双卡XTX主要是为了高分辨率和时长突破,处理一些特殊情况,平时分开跑,24G能跑还不错的分辨率。
如果每步耗时快这么多,其他部分是可以优化的,最终可以做到很不错的效果。这个和显卡架构无关,可能要改软件。
@terry 需要配合内存调度,才能补上单卡 24G 的短板。
在本次测试里,通过多次实验发现,锁定主机内存能在不拖慢速度的前提下提高分辨率和时长。
把部分 DiT 权重放在锁定的主机内存里,算当前层的同时异步搬运下一层。视频序列很长,1MP、226 帧大约有 6.7 万个 token,每层的计算时间远长于搬运时间,所以搬运基本被计算掩盖。
这次在 R9700 上实测,每步搬十几 GB,步时只增加 1–4%。权重腾出来的显存可以留给激活,而分辨率和时长受限的正是激活,所以能跑的规模就上去了。我把每卡主机池从 12G 加到 20G 后,双卡跑通了 1920×1088、158 帧,1MP 的帧数上限也从 260 提到 328,没有换显卡。
GPU 只保留正在计算的 2–3 层,再加上激活分块。XTX 的算力比 R9700 低,每层算得更久,所以内存的搬运反而更容易被隐藏,这套方法理论上更适合 XTX。
至于每步速度,还要靠 gfx11 的注意力内核来优化,这部分和架构有关。


 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!
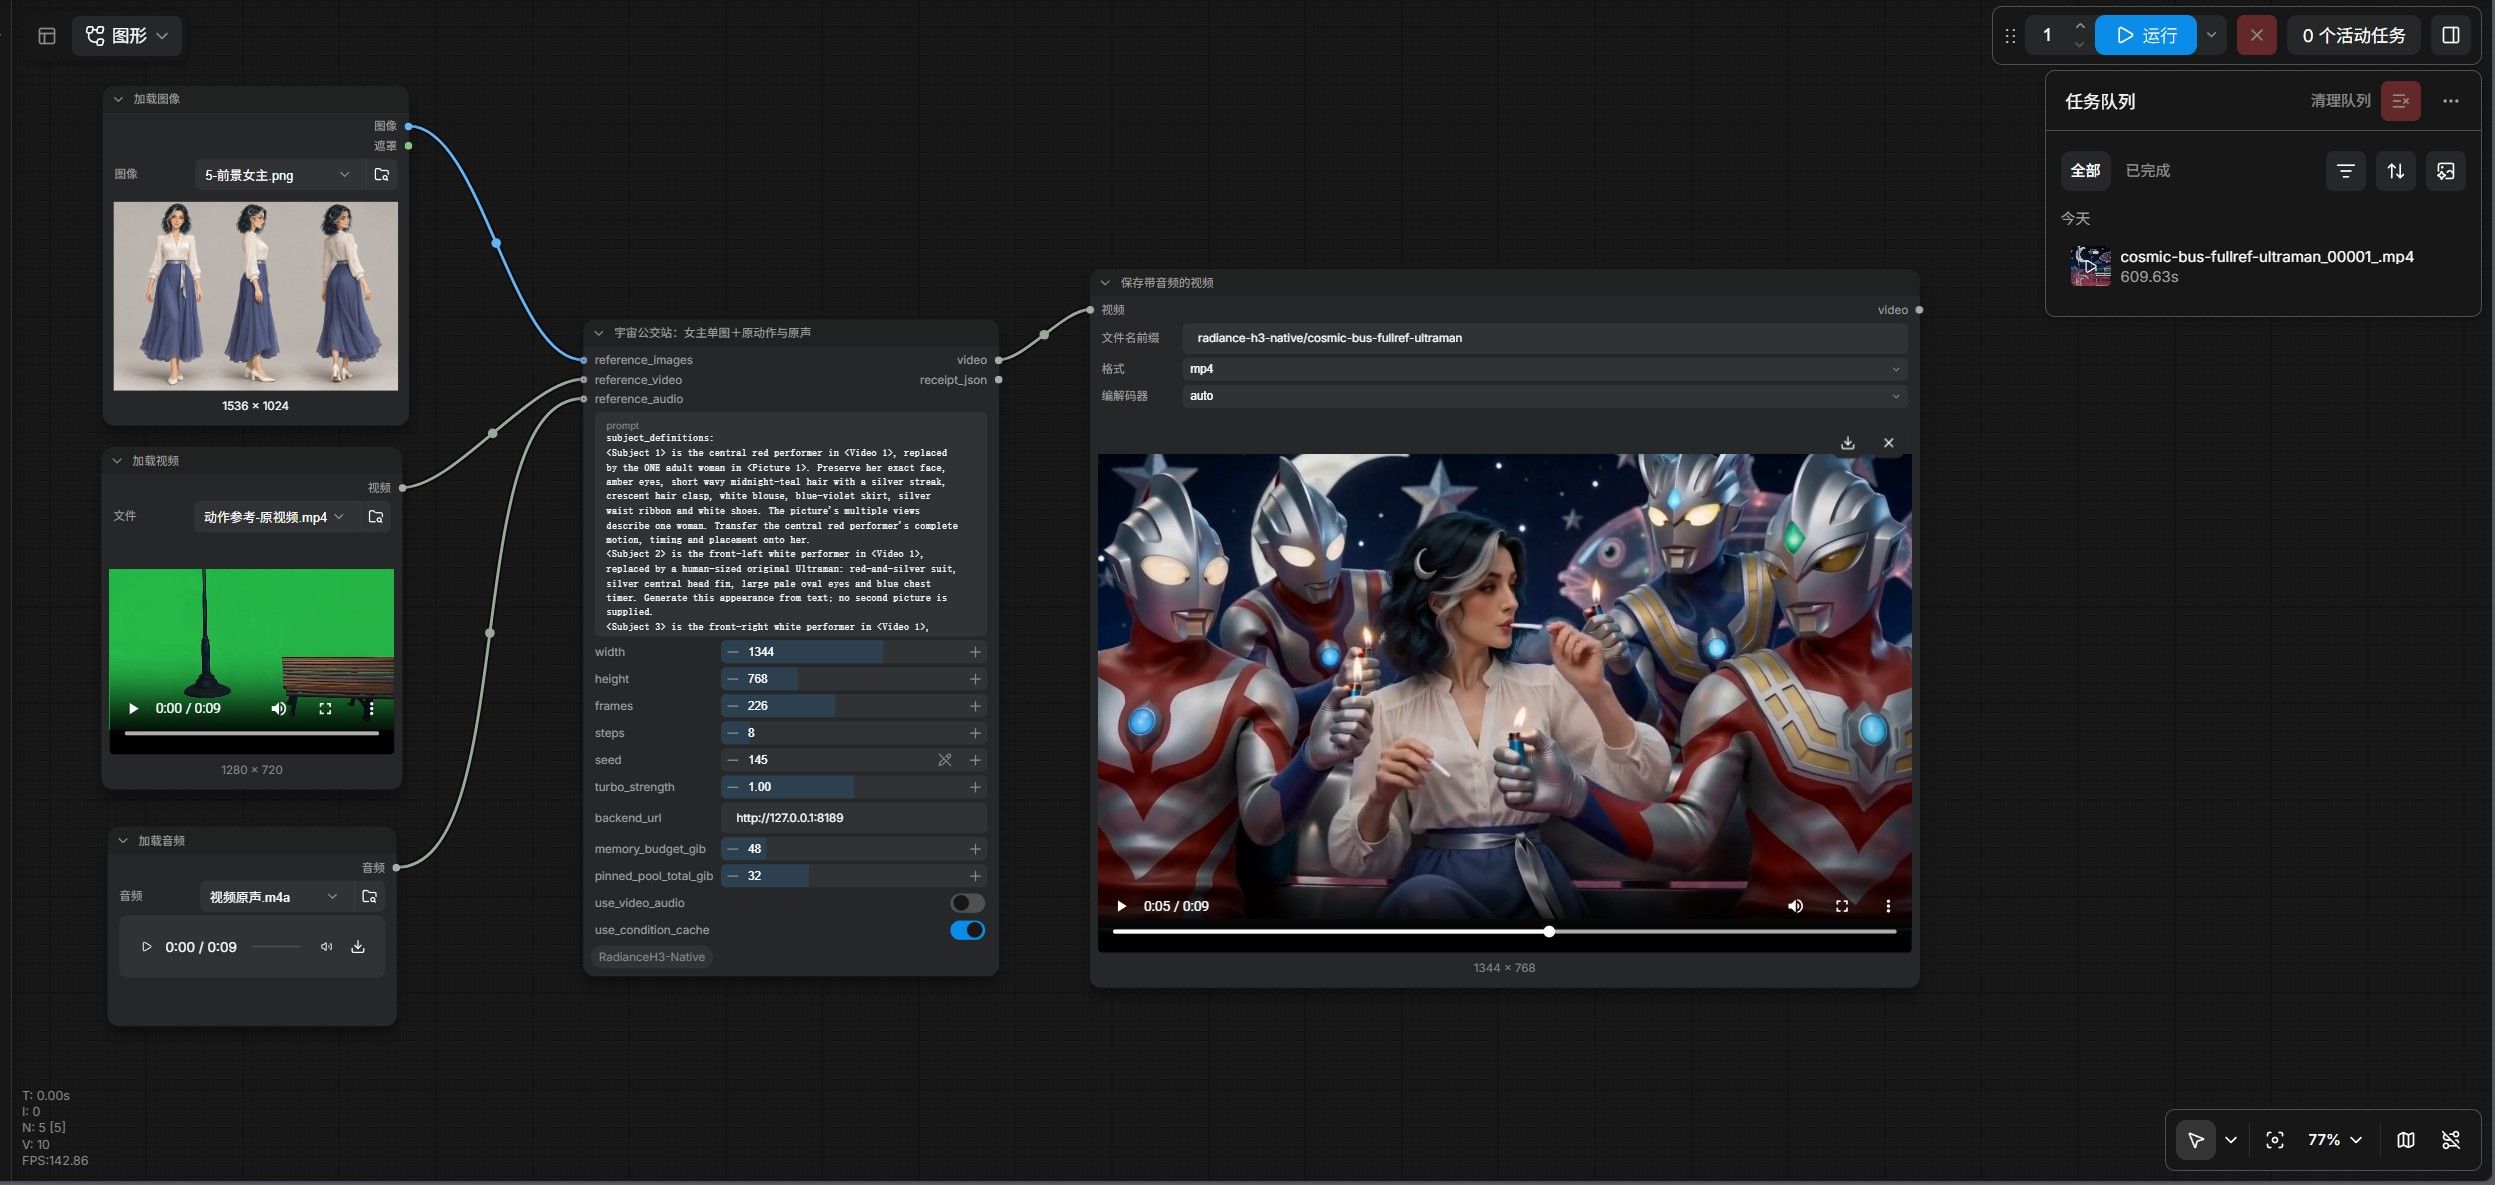

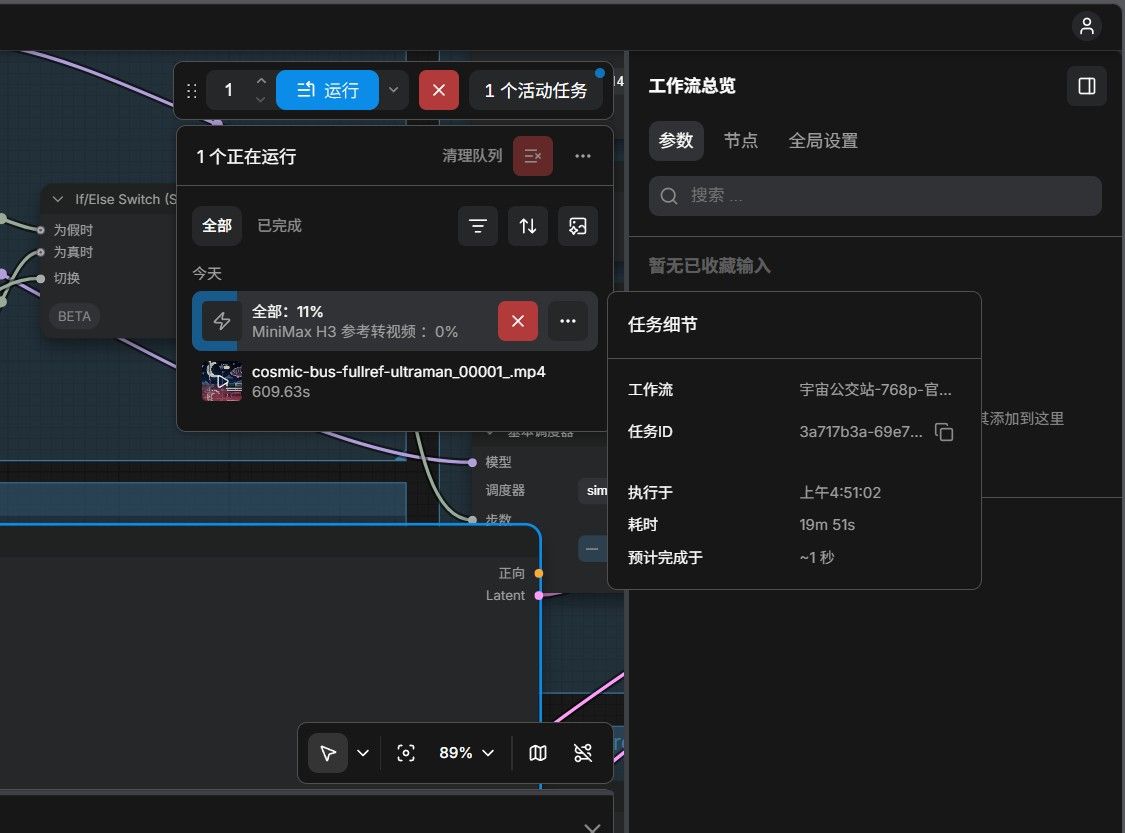

 , 咱们是用什么跑的?