我在 DGX 上跑了一下 Qwen3.8 27B 的TensorFold,相比 SGLang 确实能快点,显存占用也降低了,
Prose:SGLang 24.9 vs TensorFold 31.1,快 25%
Thinking:SGLang 22.5 vs TensorFold 31.2,快 39%。
速度随生成长度衰减
生成长度 速度
64 tok 54.0 tok/s**
128 tok 44.8 tok/s
256 tok 35.2 tok/s
512 tok 27.9 tok/s
1024 tok 27.2 tok/s
→ 官方标称的 58.3 tok/s 是短生成口径(和启动冒烟 41 tok/0.68s≈60 吻合)。上下文越长,DFlash2 草稿接受率越低,回落至 ~27-31。


 不然怎么叫“艺高人胆大”,唉……终究是输给了“德艺双馨”的马老师啊,心里拔凉拔凉的,算了,不说了,我去看邮件了,万一回复了呢……
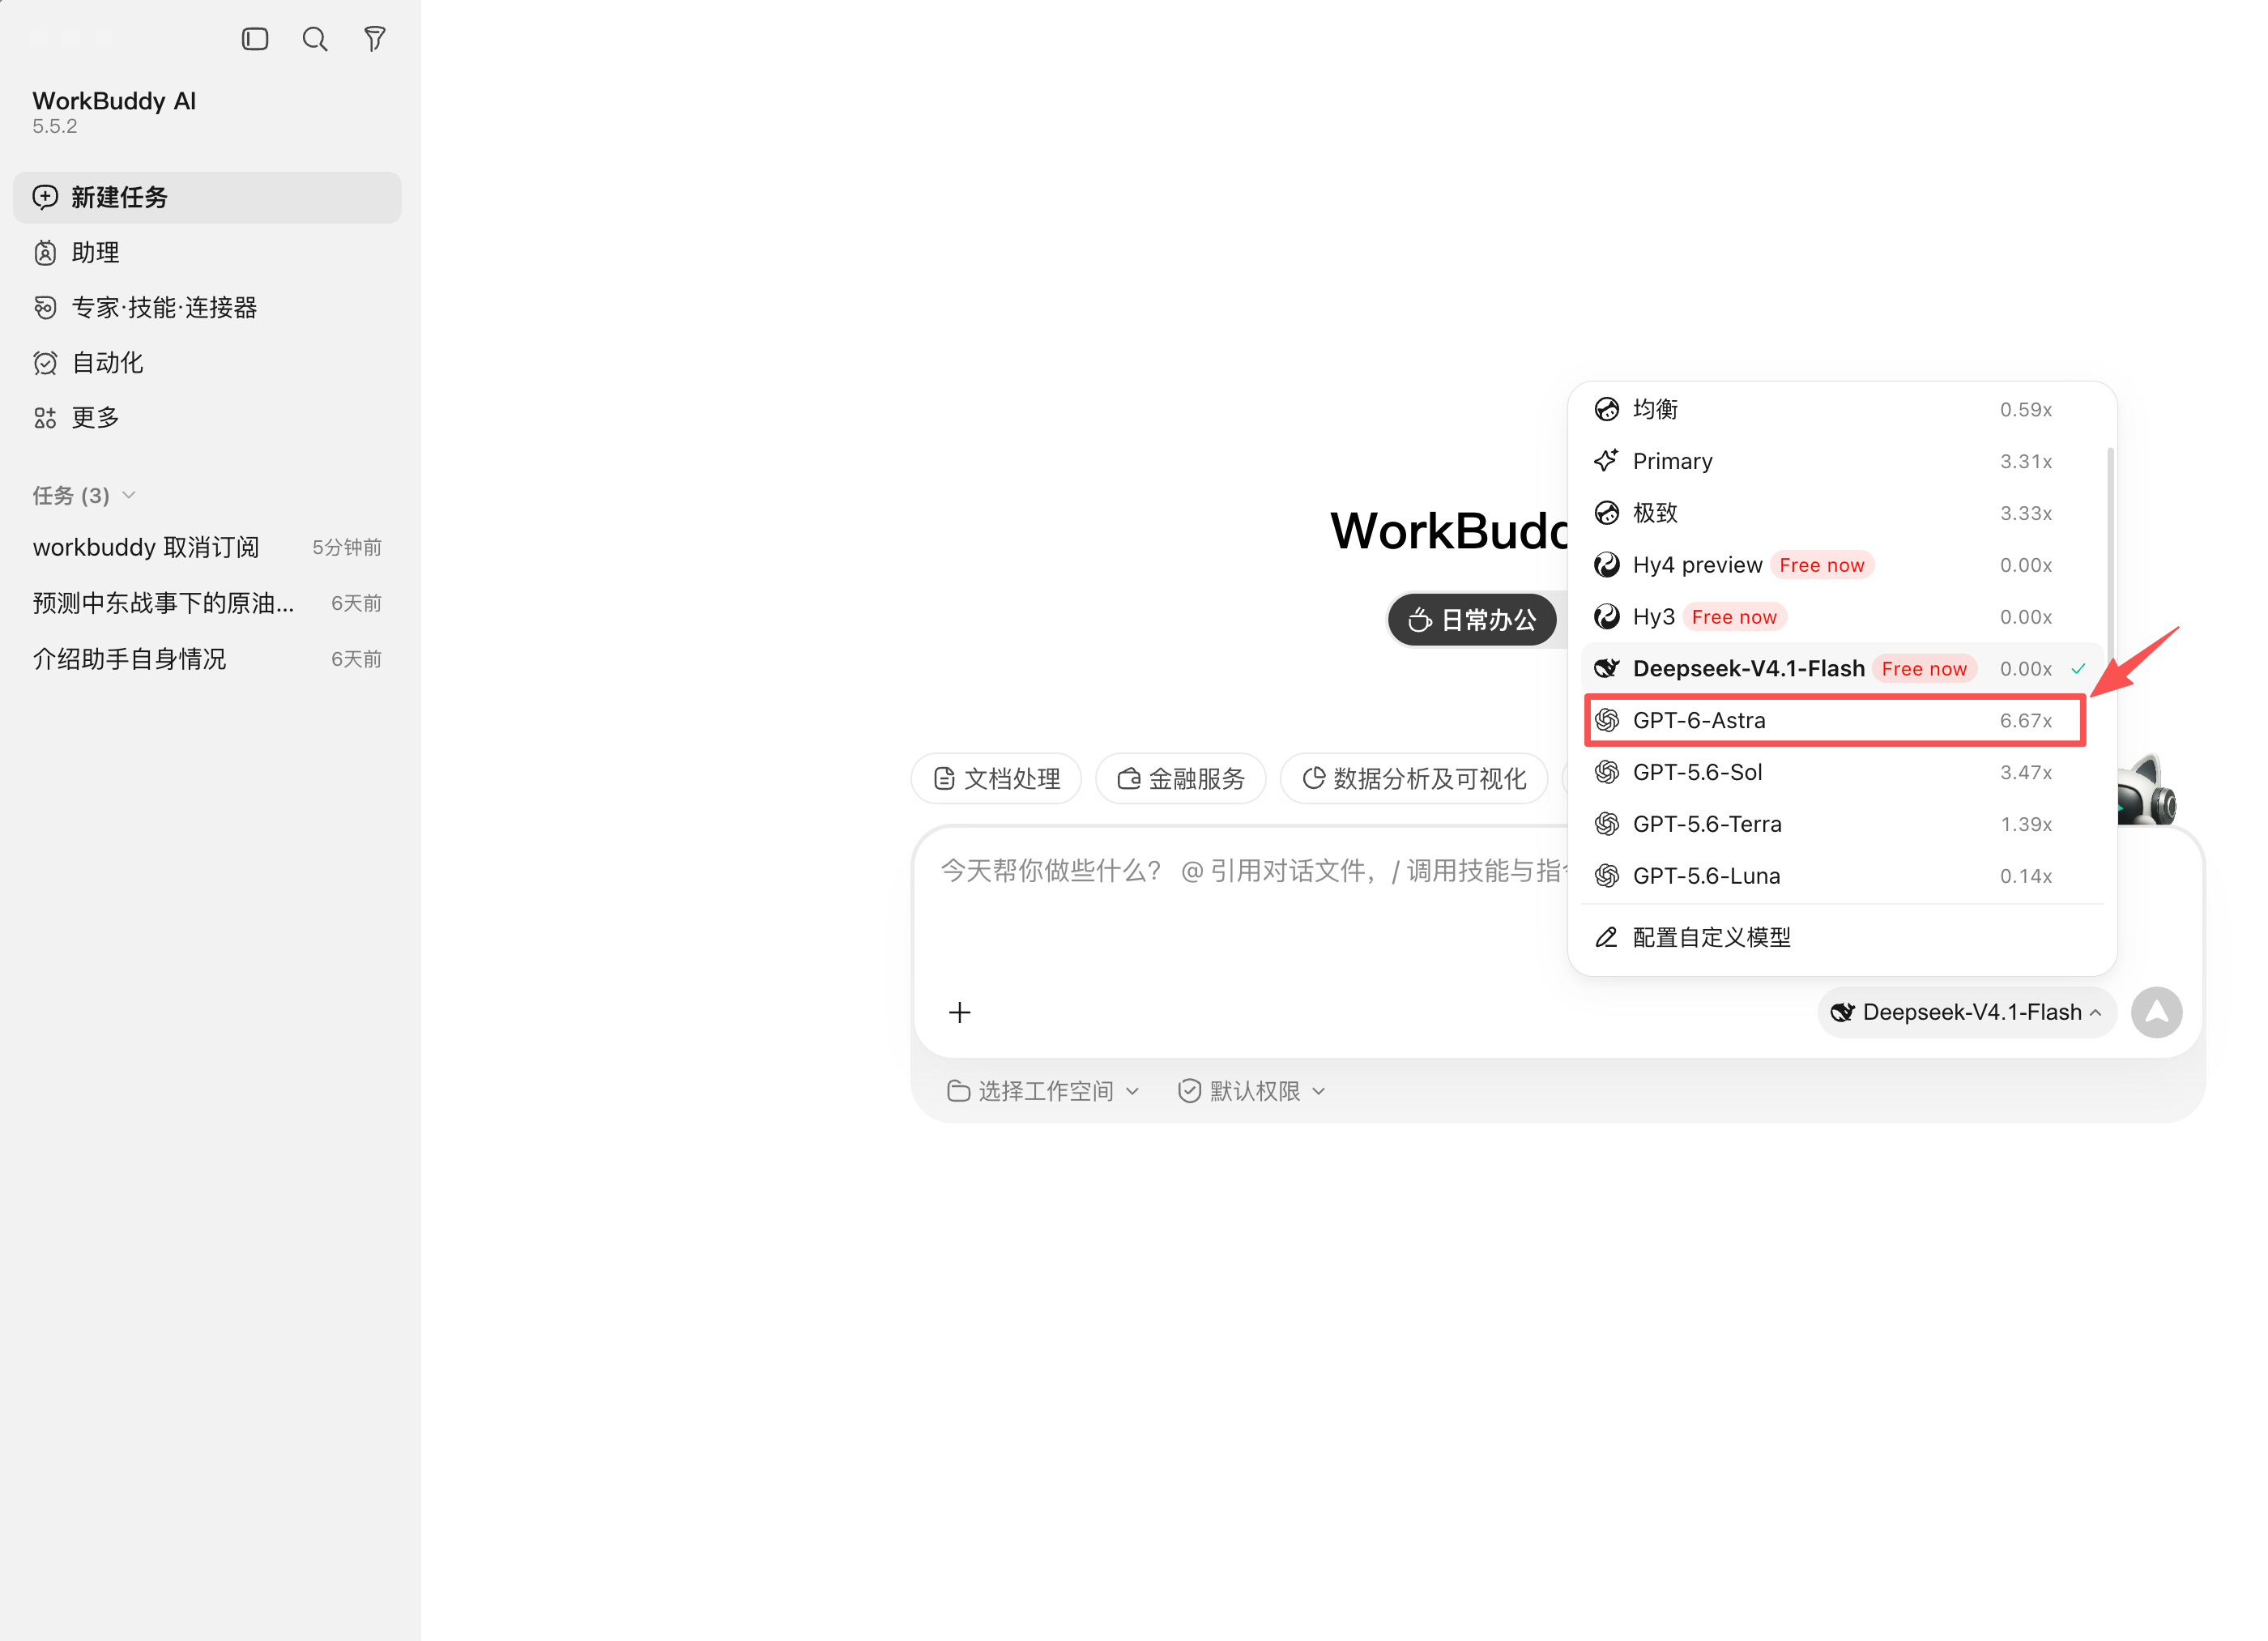
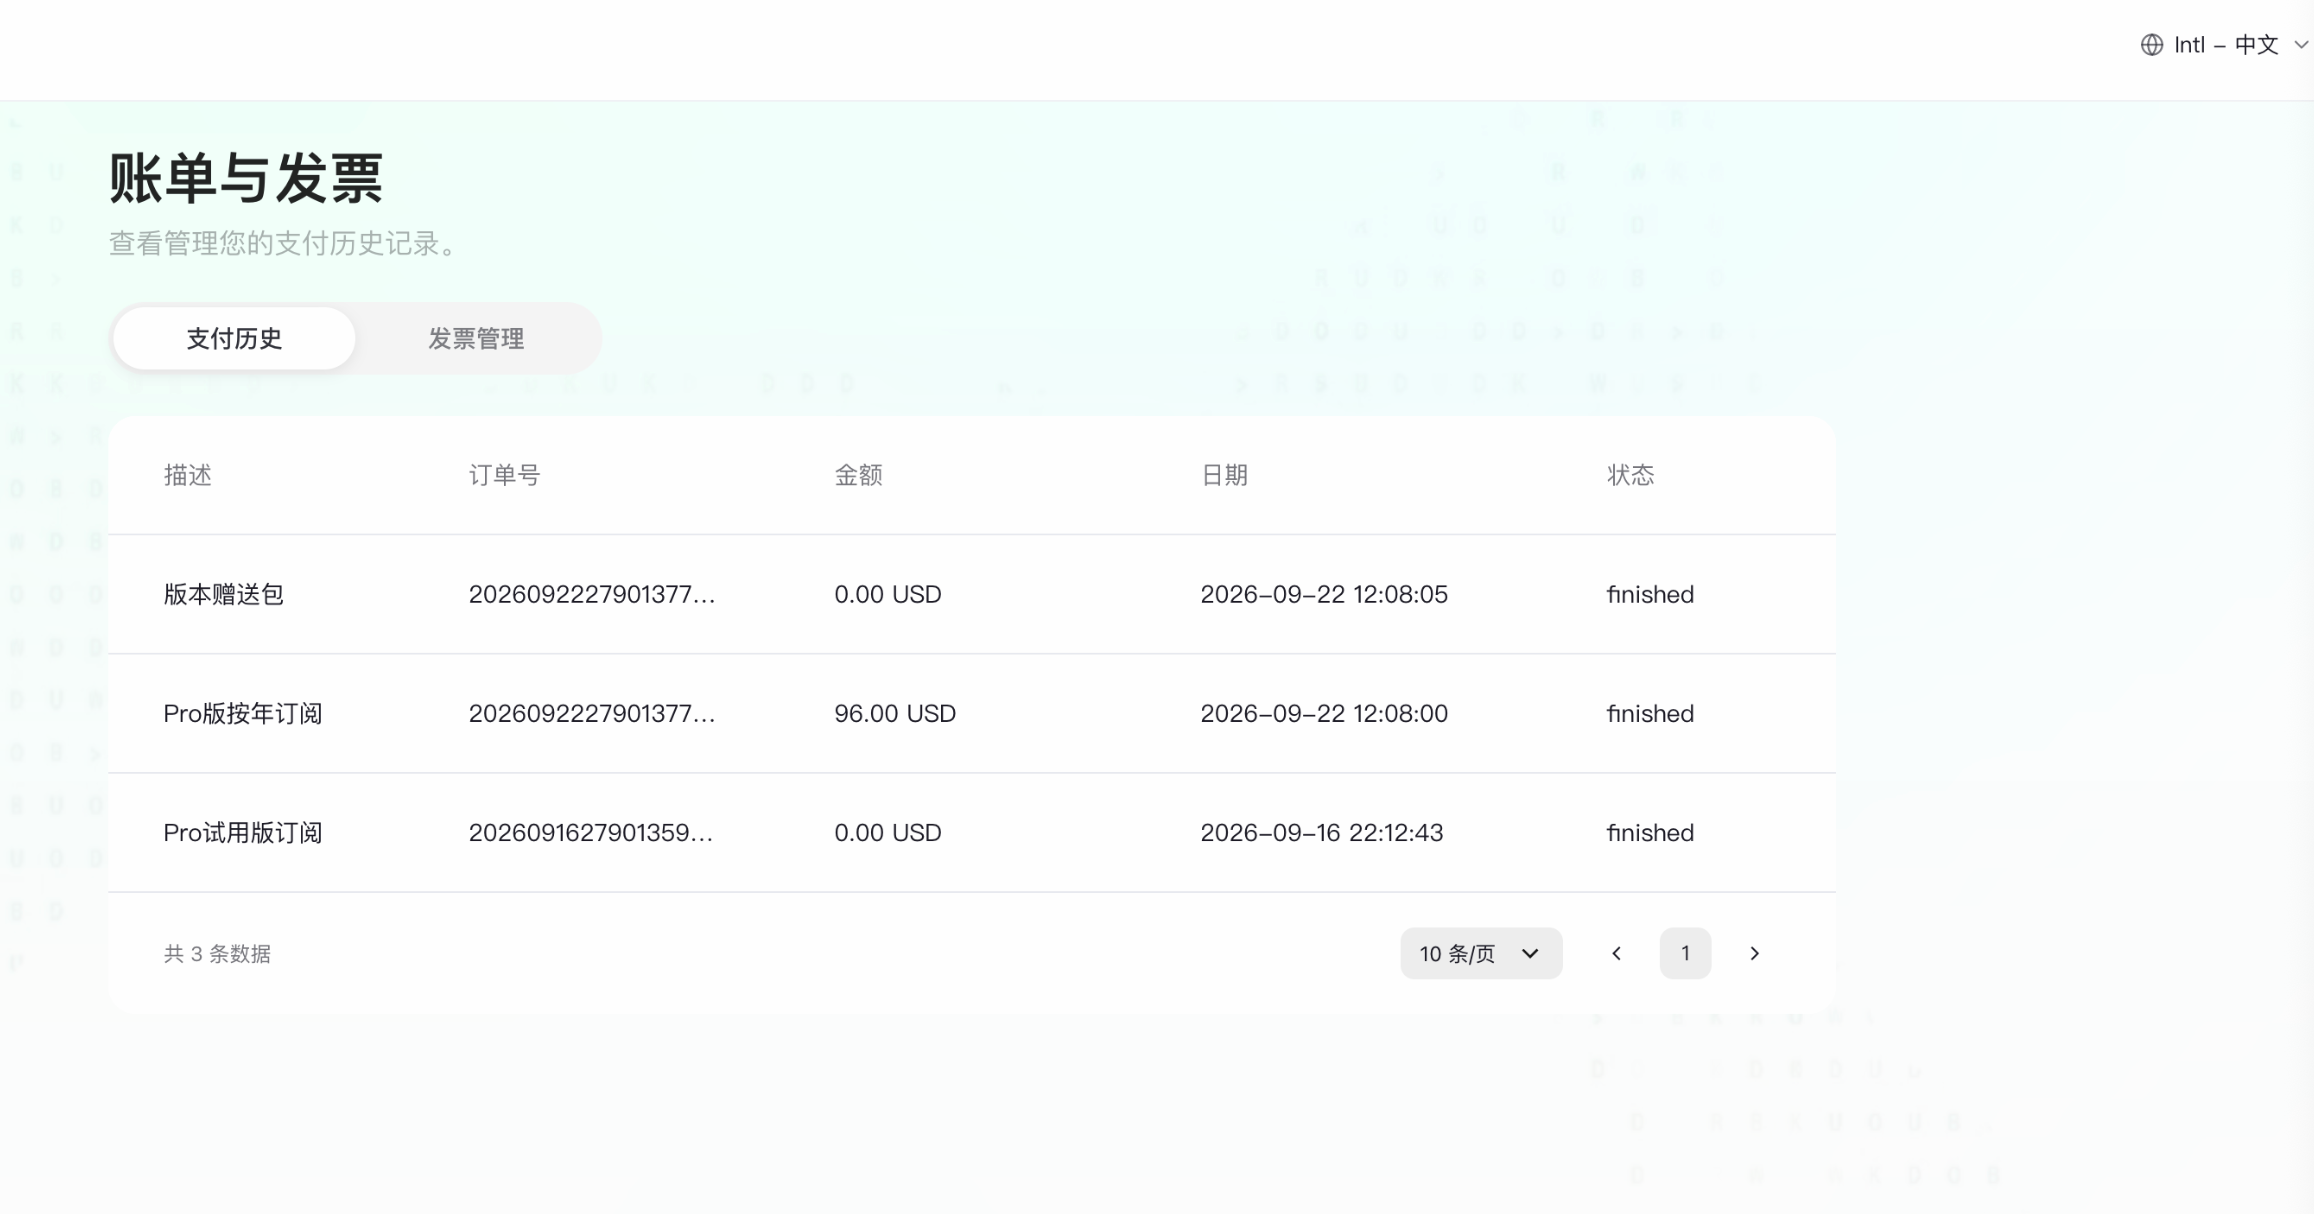
 说好的 7 天免费,竟然如此猴急,看来来者不善啊。

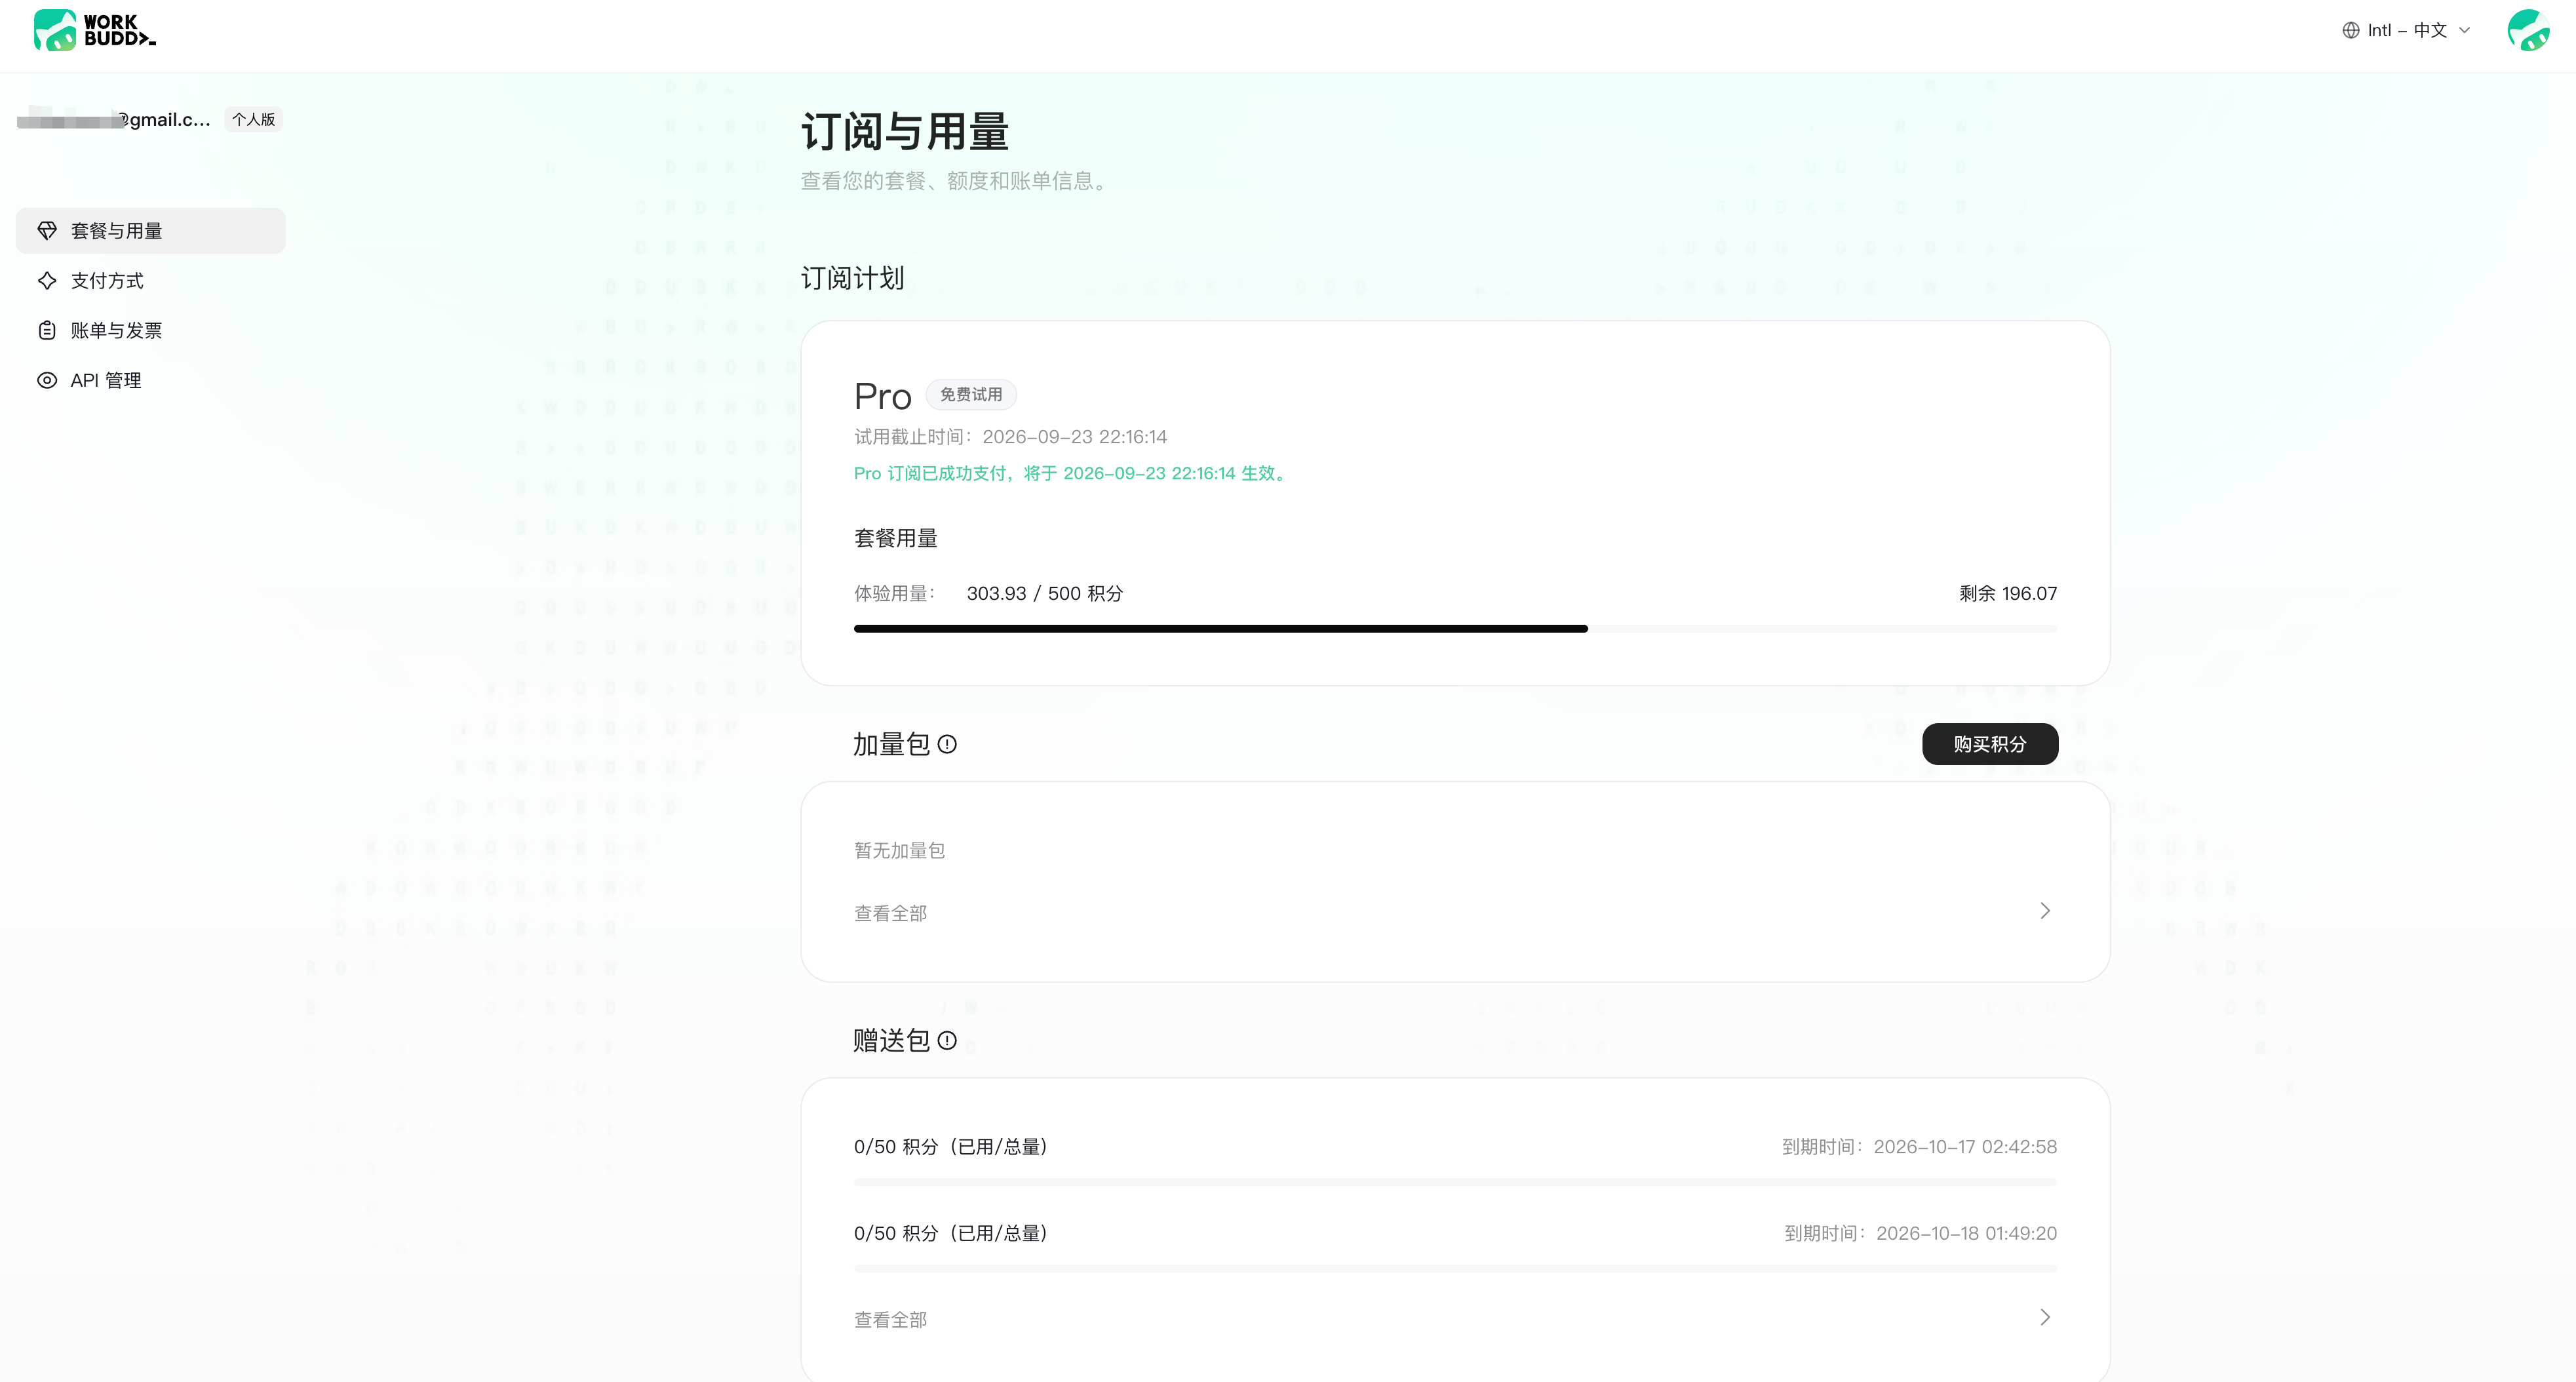
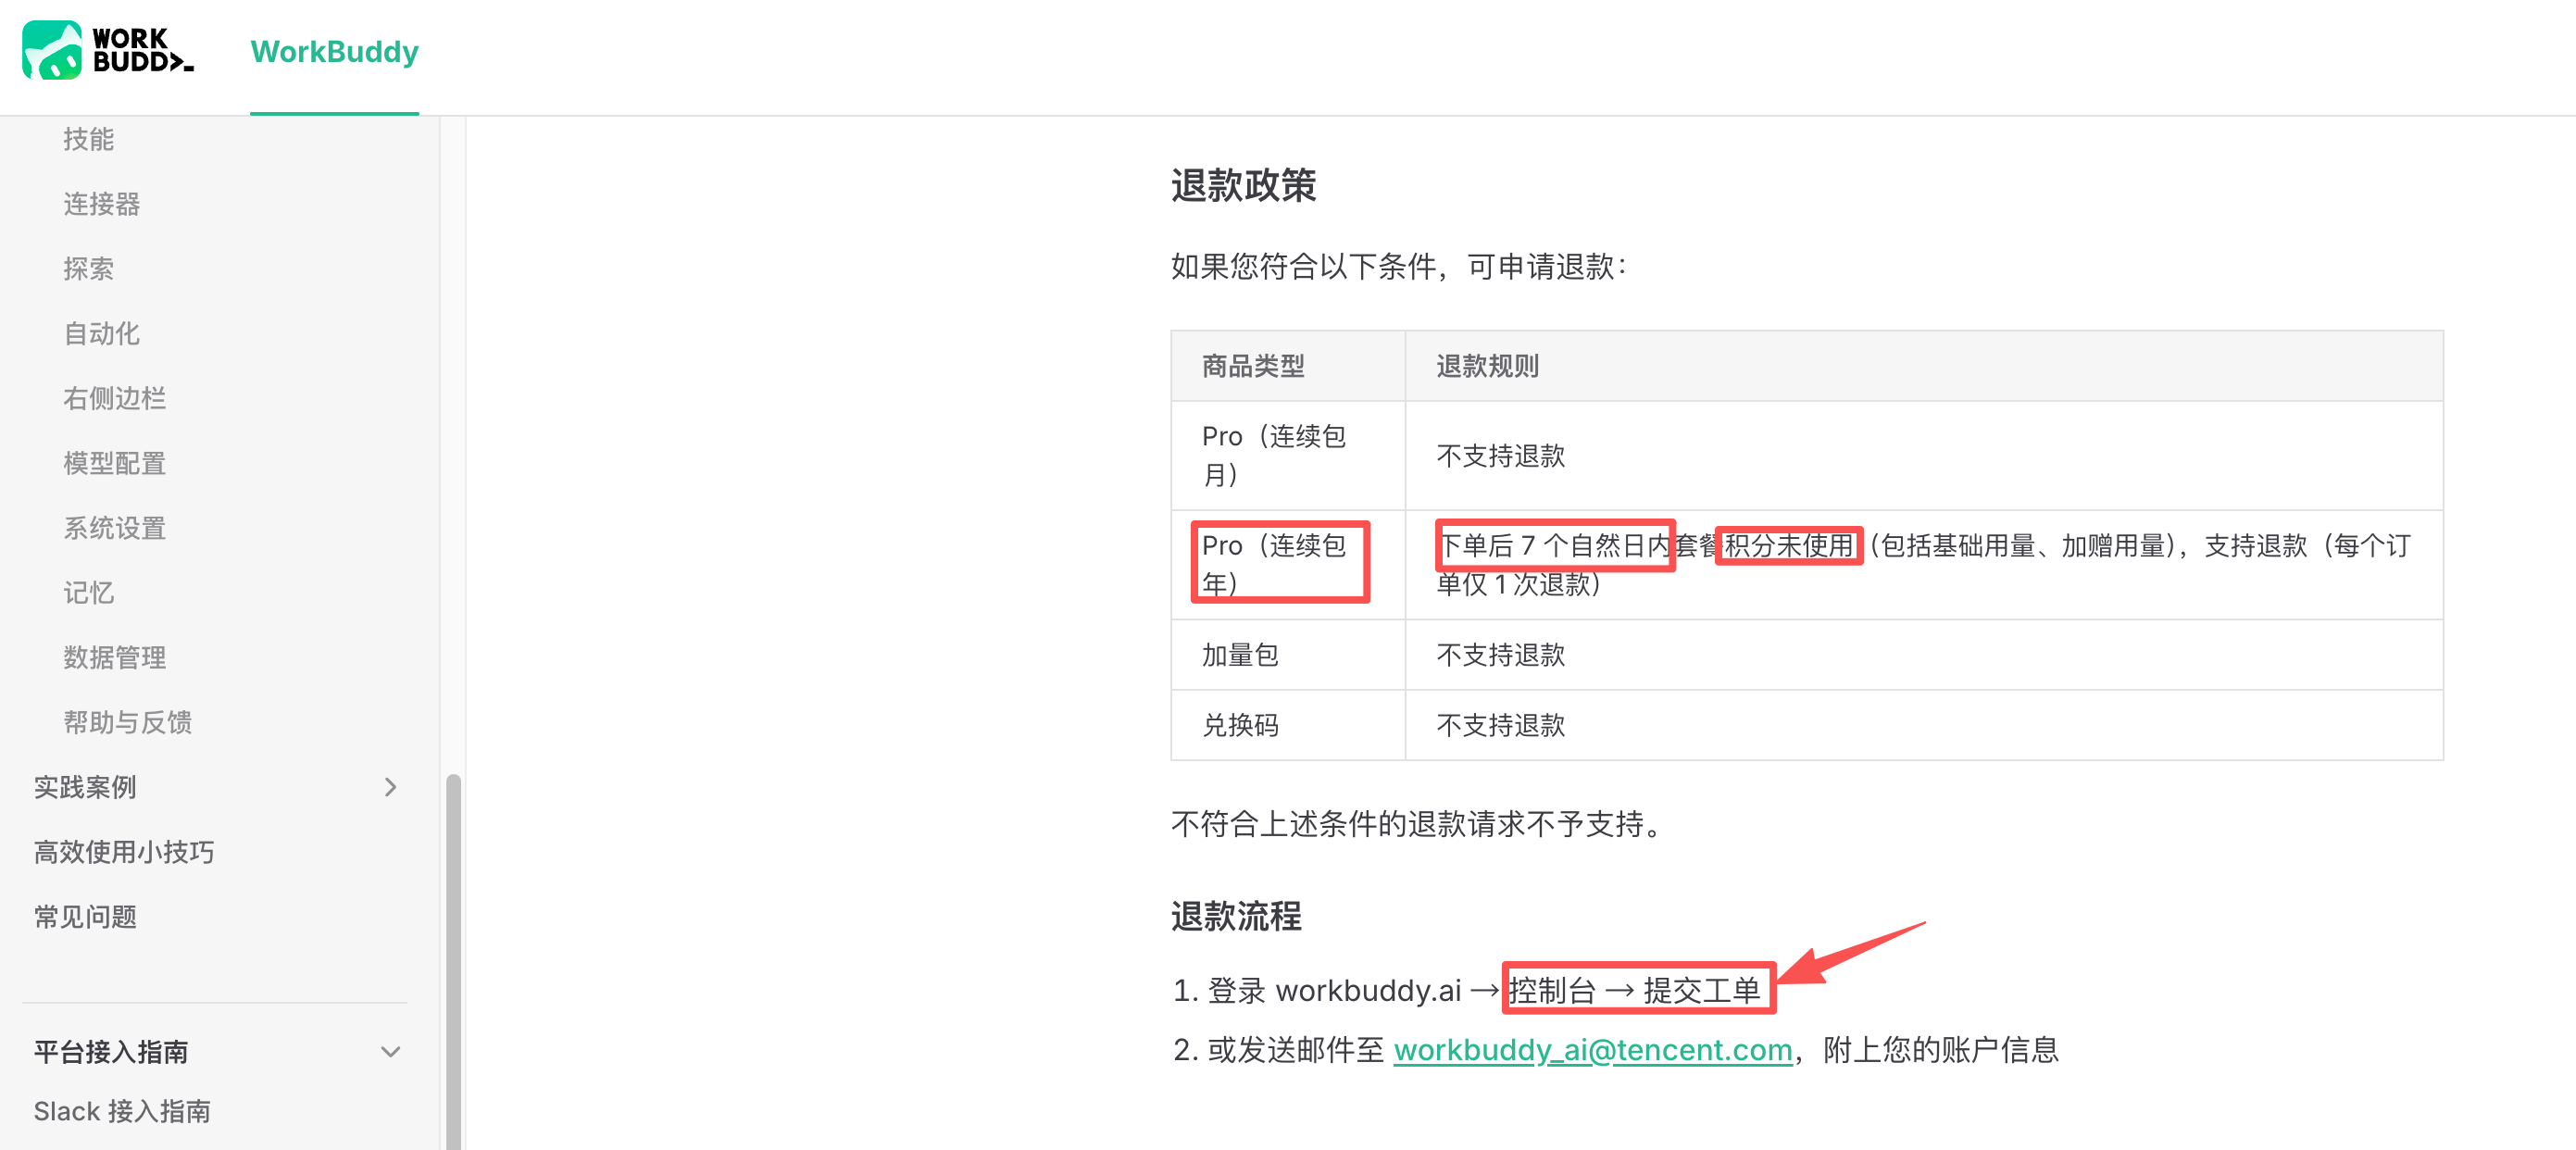
 一个 AI 时代的 Agent,退款模式倒是很“怀旧”和“保守”嘛