Flash Next 见多识广。回的答案非常详尽。
IQ_3XSS速度快,但有时候会乱跑。IQ_3S 好一点。NVFP4 应该会更好 就是速度慢了一点。用它策划中度工作应该可以。当然长的Context比不上DS4.1 Flash 1M
Qwen 27B 执行工作还是很可靠. 是生产或备用的必需品。
真的。但其实双卡Qwen3.6\3.8 27B 也是跑得很爽,而且可以同时多发。
首次在 Windows 11 系统上安装 DSH。运行 DeepSeek 4.1 Flash,安装 Strata NVFP4 仅花费 0.15 美元。NVFP4 据称相当于 4.5 量化版本。
Strata NVFP4 分支 https://github.com/sergqwer/strata-nvfp4
jpezzulli/OrcaRouter-Qwen3.8-Flash-Next-Uncensored-ModelOpt-NVFP4
单次解码速度 (Decoding),~43 tok/s
服务端解码速度,~30 tok/s
首枚令牌时间 (TTFT),1.31 秒
竞技场负载 (Arena Load),63.28 GiB @ 2.52 GiB/s
草案通过率 (Draft Acceptance),23/31 (74%)
计算能力 12.0,AVX2 池(此 CPU 不支持 AVX-512),并且已自动将缓存大小调整为 2773 个插槽
| Item | Details |
|---|---|
| Model | strata-nvfp4 |
| Engine | v0.1.40.2 |
| Context | 65,536 tokens |
| KV cache | 8-bit, all in VRAM |
| Experts in VRAM | 2,773 (7.1 GB) |
| Speculation | MTP drafts up to 3, 4 tokens, prompt lookup on |
| Images | off |
| Component | Specification |
|---|---|
| GPU | NVIDIA GeForce RTX 5070 Ti, 16 GB |
| CPU | AMD Ryzen 7 3700X 8-Core Processor, 16 threads |
| RAM | 128 GB |
模型 strata-nvfp4 (Qwen3.8-Flash-Next 125B MoE, ModelOpt NVFP4)
服务端 http://127.0.0.1:8097 · 上下文 65536 · --kv int8 · 专家缓存 auto (2773 slots)
工具 llama-benchy 0.4.0 · --runs 3 · --exact-tg · concurrency 1 · depth 0
主机 RTX 5070 Ti 16 GB (sm_120) · Ryzen 7 3700X (AVX2) · 128 GB DDR4-3200 · PCIe 4.0 x16
以服务端 timings 为准(见下方「关于 benchy pp 列」)。每个尺寸用不同前缀,避免 prefix cache 命中。
| pp (tokens) | 实测 tokens | 耗时 (ms) | pp (tok/s) | 相对 128 提升 |
|---|---|---|---|---|
| 128 | 180 | 1082.0 | 166.4 | 1.00x |
| 512 | 564 | 1433.1 | 393.6 | 2.37x |
| 1024 | 1076 | 1605.1 | 670.4 | 4.03x |
| 2048 | 2100 | 1955.9 | 1073.7 | 6.45x |
| 4096 | 4148 | 2906.5 | 1427.1 | 8.58x |
| 8192 | 8244 | 3367.1 | 2448.4 | 14.71x |
| 16384 | 16436 | 6300.4 | 2608.7 | 15.68x |
| 32768 | 32820 | 11773.1 | 2787.7 | 16.75x |
形状:单调上升、逐渐饱和。小提示被固定启动开销支配(128 tokens 时仅 166 tok/s),
到 32K 趋于平坦(~2.8K tok/s)。这与 Strata 的设计一致——prefill 的大部分时间花在
从 RAM/SSD 流式搬运被路由到的专家上,提示越长、每条专家的复用越高,摊销越好。
max_tokens=192,深度 = 解码开始前已占用的上下文。
| depth (tokens) | 实测 prompt | 生成 tokens | tg (tok/s) | 耗时 (ms) | 草稿命中 |
|---|---|---|---|---|---|
| 0 | 59 | 89 | 43.10 | 2065 | 49/85 |
| 4096 | 4156 | 151 | 44.60 | 3386 | 84/122 |
| 16384 | 16444 | 130 | 46.10 | 2820 | 76/99 |
| 32768 | 32828 | 119 | 39.40 | 3020 | 62/108 |
形状:浅上下文几乎平坦(43–46 tok/s),到 32K 下降约 15%(39.4 tok/s)。
下降来自弹性 K/V 增长挤占专家缓存槽位——README 说明该版本为此做了 VRAM 回收,
所以衰减比上游平缓。草稿命中率(MTP, --spec 4)在深上下文下降,也贡献了一部分。
benchy 的 tg 列与上表一致,可交叉验证。数据来自 strata-pp-tg.md。
| tg 目标 | pp=128 | pp=512 | pp=1024 | pp=2048 | pp=4096 | pp=8192 | pp=16384 | pp=32768 |
|---|---|---|---|---|---|---|---|---|
| 32 | 49.65 | 56.05 | 43.39 | 49.09 | 48.37 | 55.18 | 50.00 | 51.50 |
| 128 | 45.76 | 49.53 | 49.23 | 44.59 | 47.52 | 45.20 | 44.17 | 45.92 |
| 256 | 44.62 | 50.88 | 48.80 | 46.88 | 46.40 | 48.69 | 43.99 | 42.44 |
均值约 47.5 tok/s,run 间噪声约 ±5–7%(±1 标准差)。
stdout 的 peak t/s 列即为峰值吞吐,与均值差 <3%,说明稳态。
e2e_ttft 含 prefill + 排队 + 采样启动。
| pp | e2e_ttft (ms) | est_ppt (ms) |
|---|---|---|
| 128 | 1035 – 1497 | 0.9 – 1.4 |
| 512 | 1454 – 1551 | 3.9 – 4.2 |
| 1024 | 1825 – 1920 | 6.5 – 7.5 |
| 2048 | 2320 – 2432 | 12.0 – 13.4 |
| 4096 | 3318 – 3478 | 22.0 – 24.0 |
| 8192 | 3862 – 4166 | 40.9 – 42.3 |
| 16384 | 7708 – 8110 | 78.3 – 79.3 |
| 32768 | 12861 – 12989 | 155.4 – 157.6 |
strata-pp-tg.md 中 pp 行的 t/s 为 95,000 – 225,000,与实测不符(真实值 ~166–2,788)。
原因:在 --exact-tg 模式下 benchy 用 ttfr(首 token 到达时间)作为分母,而该值
不包含服务端的完整 prefill 时间,于是把 pp 吞吐放大了约 170x。
作者在 RTX 5090 (32 GB, PCIe 5.0, 9950X3D, DDR5-5600) 上的参考:
| 作者 5090 | 本机 5070 Ti | 比值 | |
|---|---|---|---|
| 聊天解码 | 138 tok/s | 43.1 | 0.31x |
| 32K 提示后解码 | 132 tok/s | 39.4 | 0.30x |
| 32K 提示读取 | 6740–6930 tok/s | 2787.7 | 0.41x |
差距来源,按影响排序:
README 对 16 GB 卡的预期是 ~67 tok/s(表内数值,用 5090 模拟该显存预算测得),
本机实测 43.1 tok/s 低于该值,差额主要来自 PCIe 4.0 与 AVX2——这两项正是
模拟无法复现的真实硬件差异。
Update - Strata Qwen3.8 Flash Next Abliterated Speed:
v: int8 kv_resident: 32768 ctx: 65536 spec: 6 (mtp_max 4, lookup 3)
expert_slots: 11666 (19.2 GiB cached) vram_free: 830 MiB hit_rate: 0.87
Summary:
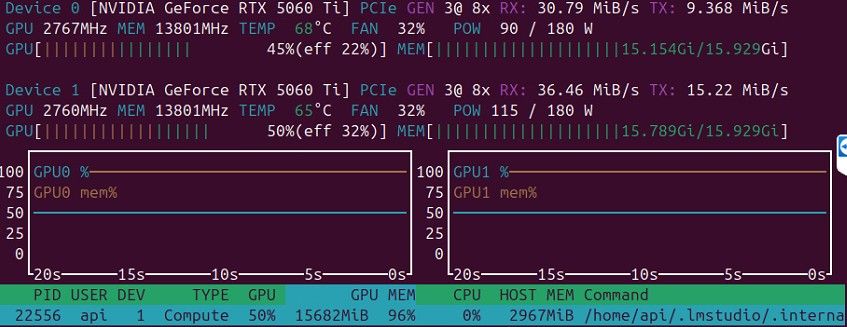
电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.
Model
qwen3.8-flash-next-iq3_s
Engine
v0.1.33
Context
32,768 tokens
KV cache
8-bit, all in VRAM
Experts in VRAM
10,268 (19.4 GB)
Speculation
MTP drafts up to 3 tokens, prompt lookup on
Images
off
@Wyattbaker 51
是的,Inference 对 PCIe 带宽的影响要小得多。
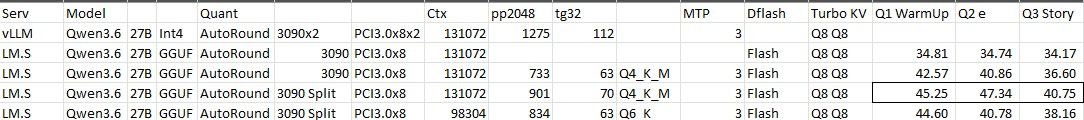
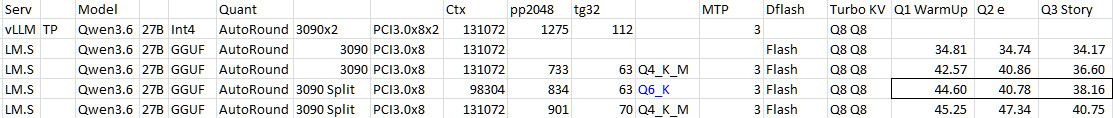
性能对比补充:双卡 RTX 3090 Ampere 实测数据
为了更清晰地评估 Blackwell 架构的提升幅度,这里将 双卡 RTX 3090 Ampere 的测试数据一并交作业。测试基于相同的软件安装环境,但运行在适配 Ampere 架构的旧版 CUDA 版本上。
核心对比数据看板
根据测试记录,双卡 RTX 3090 在不同配置(单卡、vLLM TP、LM Studio Split)下的表现如下:
关键技术解读与对比分析
虽然 Ampere 架构不支持 Blackwell 的 NVFP4,但在成熟的 Int4 优化和 24GB x2 充足显存的加持下,纯粹的吞吐量表现依然非常激进。
此时 Prefill 速度(pp2048)为 1275 t/s,略低于 Blackwell 架构在相同或更长上下文下的表现(1600~1800 t/s)。
Q4_K_M 量化: tg32 测试速度保持在 63~70 t/s 之间,而在真实的生产力场景(如 Q1 预热、Q2 效率测试、Q3 故事生成)中,实际输出稳定在 34~47 t/s 之间。
Q6_K 量化: 在 98304 较长上下文时,真实场景(Real-world Use)输出依然能维持在 38~44 t/s。
RTX 3090 (Ampere): 凭借其 384-bit 的高原生显存带宽(Memory Bandwidth),在处理传统量化(如 GGUF、Int4)的纯推理计算时展现出了极强的韧性。
RTX 5060Ti (Blackwell): 虽然原生显存位宽较窄 (½ of RTX3090),但凭借 NVFP4 计算密度的优势以及新一代张量核心(Tensor Cores)的效率,在极大节省显存的前提下,依然跑出了极其紧凑且高效的能效比。
Example Config:
--model Qwen3.6-27B-int4-AutoRound
--gpu-memory-utilization 0.95
--max-model-len 131072
--enable-auto-tool-choice
--tool-call-parser qwen3_xml
--tensor-parallel-size 2
--language-model-only
--kv-cache-dtype fp8_e5m2
--max-num-seqs 1
--max-num-batched-tokens 4128
--trust-remote-code
--dtype bfloat16
--enable-prefix-caching
--enable-chunked-prefill
--no-scheduler-reserve-full-isl
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
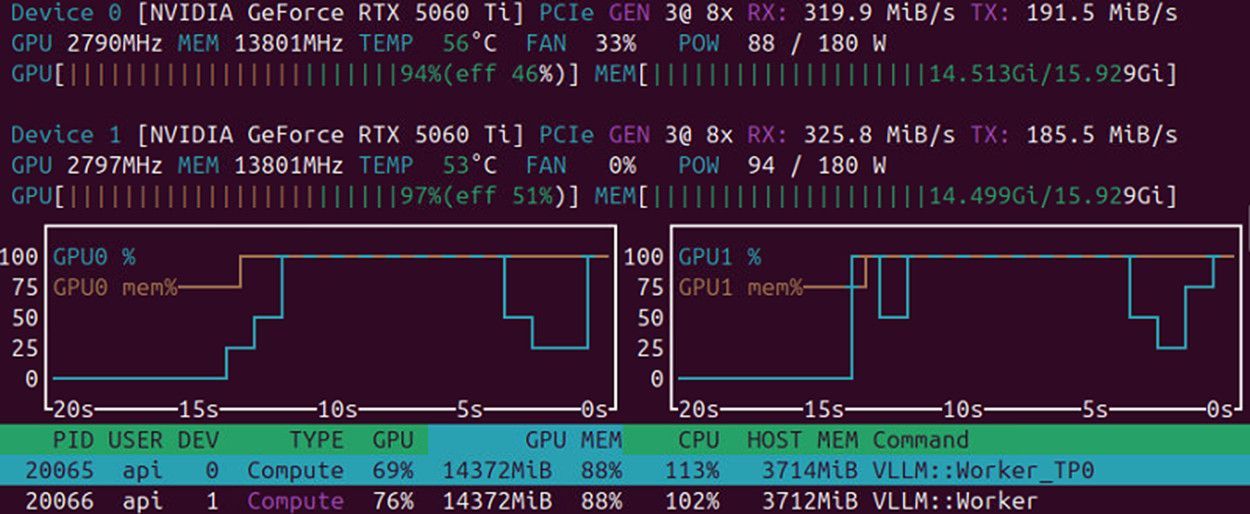
来交作业了。分享一下在双卡 RTX 5060Ti Blackwell GPU 上使用 vLLM 和 LM Studio (LMS) 的实际使用体验与性能测试。
结论先行 (TL;DR)
LM Studio (Split 模式): 理论测试可达 46~50 token/s,实际使用(Real Use)中约为 26~36 t/s。
vLLM TP (Tensor Parallel) 模式: 测试表现为 35~78 token/s,至于实际体验如何?我们在后文详细拆解。
测试硬件环境: 双显卡均运行在 Intel CPU 平台上,运行在 PCIe 3.0 x8 通道下。
vLLM 核心配置参数
当前运行 vLLM 服务的完整启动命令如下:
--model Qwen3.6-27B-Text-NVFP4-MTP
--gpu-memory-utilization 0.95
--max-model-len 64000
--enable-auto-tool-choice
--tool-call-parser qwen3_xml
--tensor-parallel-size 2
--language-model-only
--kv-cache-dtype fp8
--max-num-seqs 1
--max-num-batched-tokens 8192
--trust-remote-code
--enable-prefix-caching
--enable-chunked-prefill
--no-scheduler-reserve-full-isl
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
体验总结
LM Studio: 部署极其简单,开箱即用,但整体速度较慢。
vLLM: 性能强劲,但显存占用(Memory footprint)明显更高,且由于显存开销,可分配的上下文长度(Context)会有所受限。
基准测试数据 (Benchmark Results)测试命令: uvx llama-benchy --base-url http://localhost:8000/v1 --model Text-NVFP4-MTP
测试共独立运行 3 次,详细数据如下:
| model | test | t/s | peak t/s | ttfr (ms) | est_ppt (ms) | e2e_ttft (ms) |
|---|---|---|---|---|---|---|
| /home/api/AiModel/Text-NVFP4-MTP | pp2048 | 1729.27 ± 19.59 | 1186.49 ± 13.32 | 1185.04 ± 13.32 | 1186.49 ± 13.32 | |
| /home/api/AiModel/Text-NVFP4-MTP | tg32 | 61.80 ± 7.58 | 63.80 ± 7.82 | |||
| :--------------------------------- | -------: | -----------------: | -------------: | -----------------: | -----------------: | -----------------: |
| /home/api/AiModel/Text-NVFP4-MTP | pp2048 | 1415.00 ± 227.76 | 1488.69 ± 247.80 | 1487.23 ± 247.80 | 1488.69 ± 247.80 | |
| /home/api/AiModel/Text-NVFP4-MTP | tg32 | 74.86 ± 4.30 | 77.29 ± 4.44 | |||
| :--------------------------------- | -------: | ----------------: | -------------: | ----------------: | ----------------: | ----------------: |
| /home/api/AiModel/Text-NVFP4-MTP | pp2048 | 1735.72 ± 18.16 | 1182.07 ± 12.30 | 1180.62 ± 12.30 | 1182.07 ± 12.30 | |
| /home/api/AiModel/Text-NVFP4-MTP | tg32 | 65.26 ± 5.31 | 67.37 ± 5.48 |
Agent 场景优化配置 (Hermes Agent Setup)
如果在 Agent 场景下运行,为了防止显存碎片化导致 OOM,建议加入环境变量:
export PYTORCH_CUDA_ALLOC_CONF="expandable_segments:True"
Hermes Agent Setup: 同时对 vLLM 参数进行微调(主要调小了 max-num-batched-tokens 并在启动时控制利用率):
--model ~/AiModel/Text-NVFP4-MTP
--gpu-memory-utilization 0.90
--max-model-len 64000
--enable-auto-tool-choice
--tool-call-parser qwen3_xml
--tensor-parallel-size 2
--language-model-only
--kv-cache-dtype fp8
--max-num-seqs 1
--max-num-batched-tokens 2048
--trust-remote-code
--enable-prefix-caching
--enable-chunked-prefill
--no-scheduler-reserve-full-isl
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
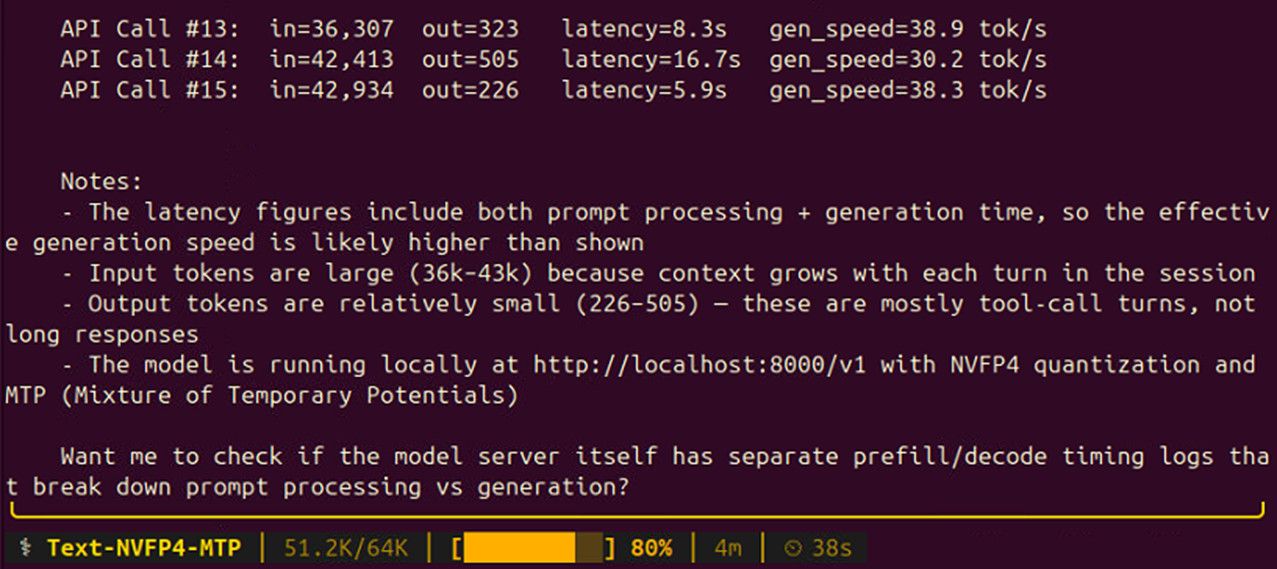
性能归纳与关键解读 (Notes)
NVFP4 量化优势: Blackwell 架构原生支持的 NVFP4 量化非常优秀,在保持极高模型精度的同时,效果明显好于传统的 Q4_K_M 等量化方案。
MTP (Multi-Token Prediction) 投机采样: 即便在没有 NVLink 的双卡环境下,MTP 也能带来很好的速度收益。虽然目前 Turboquant 还不支持它,但配合 vLLM 时,Prefill (pp) 阶段的速度已经足够快,不再是瓶颈。
上下文与吞吐量关联测试汇总
通过调整不同的最大上下文(Context),我们观察了 Prefill (pp2048) 和 Token Generation (tg32) 的吞吐量变化:
| Ctx (上下文) | pp2048 (t/s) | tg32 (t/s) | Quant (量化) | MTP | KV Cache |
|---|---|---|---|---|---|
| 32768 | 1819 | 35 | NVFP4 | NO (关闭) | FP8 |
| 64000 | 1631 | 81 | NVFP4 | 3 | FP8 |
| 98304 | 1734 | 78 | NVFP4 | 3 | FP8 |
| 131072 | 1736 | 75 | NVFP4 | 3 | FP8 |
观察: 从表中第 1 行可以看出,当关闭 MTP 时,tg32 的生成速度直接从 81 t/s 跌至 35 t/s。这强力证明了即使在 PCIe 3.0 x8 的带宽限制下,开启 MTP 投机采样依然能让生成效率翻倍。
目前模型不支持 TurboQuant,或需配置 vLLM,不过 FP8 的速度看起来还行
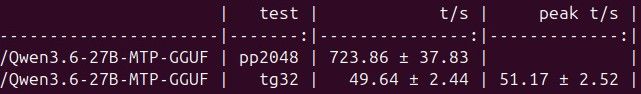
使用 Llama-Benchy 对 vLLM tp 2 进行测试. MTP , ctx 128k:
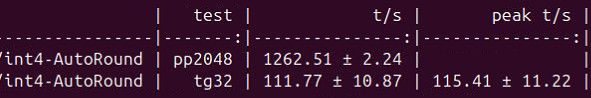
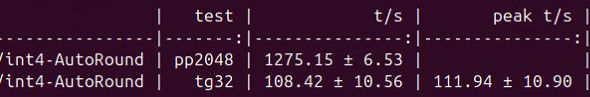
没想到 Qwen3.6 27B Int4 能达到这样的运行速度。还没买 NvLink , 用PCIx 3.0x8
vLLM 主要参数
--max-model-len 131072
--tensor-parallel-size 2
--kv-cache-dtype fp8_e5m2
--max-num-batched-tokens 4128
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
大家都用什么Bench测试?