跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
CHIA AN YANGC

小天子

@CHIA AN YANG
王侯将相
取消关注 关注
关于
帖子
121
主题
14
分享
0
群组
1
粉丝
14
关注
3

帖子

最新 最佳 有争议的

  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    Strata IQ3_S 速度優化前後與原始 Log

    日期:2026-10-22(台北時間)
    本文件把優化前、逐步調整、負對照和正式重跑的原始 Strata engine log 摘錄合併在同一份 Markdown。以下 log 行保留原文、來源檔名與原始行號,可直接複製到貼文,不依賴本機檔案連結。

    結論

    這次把速度推到 70 多 tok/s 的主要有效改動是 --pool-workers 從 15 增至 37。本機是 Xeon 38 核 / 76 執行緒;原先照用社群 16 核主機的 15 workers,沒有充分使用本機 CPU expert pool。

    測試 15 workers 24 workers 37 workers 結果
    短 prompt,1494 tokens、512 輸出,中位數 67.5 tok/s 75.5 tok/s 78.7 tok/s 37 比 15 快約 16.6%
    同一組約 99K prompt、256 輸出,中位數 67.3 tok/s 未測長 prompt 75.2 tok/s 配對提升約 11.7%
    正式重啟後同組 99K prompt,中位數 控制組 67.3 tok/s — 74.6 tok/s 重跑仍快約 10.8%
    正式服務短 prompt smoke — — 81.2 tok/s 單次 smoke,不當作中位數

    測試條件

    • 同一模型:GSQ-RCO abliterated IQ3_S,model ID gsq-rco-qwen3.8-flash-next-iq3_s。
    • 同一引擎:Strata 0.1.45、HIP gfx1100、RX 7900 XTX。
    • 15/24/37 workers 配對測試中,唯一設定差異是 --pool-workers;configuration.diff 的原文如下:
    --- pool15-config.json
    +++ pool37-config.json
    @@ -14,7 +14,7 @@
         "--pcie-frac",
         "0.0",
         "--pool-workers",
    -    "15",
    +    "37",
         "--prefill",
         "auto:32768",
         "--spec",
    
    • 長 prompt 每次實際輸入 99,004–99,005 tokens,輸出上限 256 tokens,cache reuse=0。短 prompt 使用 1494-token fresh prompt,輸出上限 512 tokens。
    • benchmark 的 API sampling 固定為 temperature 0、top-k 1、top-p 1、min-p 0、seed 42、reasoning_effort=none;這是速度測試條件,不是 Hermes Agent 的日常 reasoning 設定。
    • Prefill 在各組約 1,712–1,735 tok/s,變動很小;提升主要出現在 decode。

    原始 Strata Log:15 workers 優化前

    來源 pool15-engine.log。啟動行顯示 15 workers;三筆相同 99K prompt 的 decode 為 57.6、67.3、70.1 tok/s,中位數 67.3。

    pool15-engine.log:1835 [strata] 2026-10-22 00:53:00 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 15 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
    pool15-engine.log:1853 strata generate: 15 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15, the host thread on 0 (draining too) (--host-core first)
    pool15-engine.log:1862 strata generate: 15 expert-pool workers + the host thread
    pool15-engine.log:1896 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57473 ms (1722.6 tok/s), 256 generated in 4445 ms (57.6 tok/s), drafts accepted 132 of 223, 4 checkpoints
    pool15-engine.log:1897 strata serve: decode expert cache hit rate: 78.1% (130028 hits / 166560 lookups)
    pool15-engine.log:1906 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57737 ms (1714.7 tok/s), 256 generated in 3806 ms (67.3 tok/s), drafts accepted 152 of 214, 4 checkpoints
    pool15-engine.log:1907 strata serve: decode expert cache hit rate: 79.6% (121464 hits / 152640 lookups)
    pool15-engine.log:1915 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57815 ms (1712.4 tok/s), 256 generated in 3652 ms (70.1 tok/s), drafts accepted 158 of 201, 4 checkpoints
    pool15-engine.log:1916 strata serve: decode expert cache hit rate: 80.2% (115908 hits / 144480 lookups)
    

    15-worker short prompt control 的三筆原始輸出:

    pool15-engine.log:1780 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1925 ms (776.1 tok/s), 512 generated in 7587 ms (67.5 tok/s), drafts accepted 312 of 454, 1 checkpoints
    pool15-engine.log:1795 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1936 ms (771.6 tok/s), 512 generated in 7450 ms (68.7 tok/s), drafts accepted 313 of 455, 1 checkpoints
    pool15-engine.log:1800 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1934 ms (772.4 tok/s), 512 generated in 7702 ms (66.5 tok/s), drafts accepted 310 of 463, 1 checkpoints
    

    中間值:24 workers

    短 prompt 三筆為 75.4、75.5、75.6 tok/s;另有正式追加一筆 74.7。這是短 prompt 的中間檔位,沒有以 24 workers 跑同一組 99K 長 prompt。

    pool24-engine.log:3 [strata] 2026-10-22 00:44:27 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 24 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
    pool24-engine.log:21 strata generate: 24 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24, the host thread on 0 (draining too) (--host-core first)
    pool24-engine.log:30 strata generate: 24 expert-pool workers + the host thread
    pool24-engine.log:63 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1910 ms (782.4 tok/s), 512 generated in 6790 ms (75.4 tok/s), drafts accepted 314 of 461, 1 checkpoints
    pool24-engine.log:94 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1917 ms (779.4 tok/s), 512 generated in 6784 ms (75.5 tok/s), drafts accepted 314 of 461, 1 checkpoints
    pool24-engine.log:108 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1920 ms (778.0 tok/s), 512 generated in 6771 ms (75.6 tok/s), drafts accepted 309 of 466, 1 checkpoints
    pool24-engine.log:112 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1921 ms (777.8 tok/s), 512 generated in 6853 ms (74.7 tok/s), drafts accepted 308 of 461, 1 checkpoints
    

    原始 Strata Log:37 workers 優化後

    短 prompt 三筆為 78.7、78.8、78.0 tok/s,中位數 78.7。99K 長 prompt 三筆為 65.3、75.2、77.9 tok/s,中位數 75.2。前三組中前兩組 MTP 接受數相同,但 decode 仍提高。

    pool37-engine.log:3 [strata] 2026-10-22 00:47:14 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 37 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
    pool37-engine.log:21 strata generate: 37 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24,25,26,27,28,29,30,31,32,33,34,35,36,37, the host thread on 0 (draining too) (--host-core first)
    pool37-engine.log:30 strata generate: 37 expert-pool workers + the host thread
    pool37-engine.log:63 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1906 ms (783.7 tok/s), 512 generated in 6505 ms (78.7 tok/s), drafts accepted 314 of 461, 1 checkpoints
    pool37-engine.log:76 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1915 ms (780.3 tok/s), 512 generated in 6495 ms (78.8 tok/s), drafts accepted 309 of 466, 1 checkpoints
    pool37-engine.log:89 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1909 ms (782.7 tok/s), 512 generated in 6565 ms (78.0 tok/s), drafts accepted 308 of 461, 1 checkpoints
    pool37-engine.log:111 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57555 ms (1720.1 tok/s), 256 generated in 3923 ms (65.3 tok/s), drafts accepted 132 of 223, 4 checkpoints
    pool37-engine.log:121 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57818 ms (1712.4 tok/s), 256 generated in 3405 ms (75.2 tok/s), drafts accepted 152 of 214, 4 checkpoints
    pool37-engine.log:130 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 58614 ms (1689.1 tok/s), 256 generated in 3288 ms (77.9 tok/s), drafts accepted 160 of 220, 4 checkpoints
    

    負對照:37 workers 下測試 PCIe 0.10,但沒有保留

    短 prompt 雖然到 80.6–82.9 tok/s,99K 長 prompt 波動很大:52.9、75.8、80.9,中位數 75.8,和 PCIe 0 的 75.2 差異不構成穩定收益,因此正式設定仍用 PCIe 0。

    pool37-pcie010-engine.log:3 [strata] 2026-10-22 00:57:30 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.10 --pool-workers 37 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
    pool37-pcie010-engine.log:21 strata generate: 37 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24,25,26,27,28,29,30,31,32,33,34,35,36,37, the host thread on 0 (draining too) (--host-core first)
    pool37-pcie010-engine.log:64 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1907 ms (783.5 tok/s), 512 generated in 6352 ms (80.6 tok/s), drafts accepted 315 of 447, 1 checkpoints
    pool37-pcie010-engine.log:77 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 5043 ms (296.3 tok/s), 512 generated in 6177 ms (82.9 tok/s), drafts accepted 328 of 434, 1 checkpoints
    pool37-pcie010-engine.log:91 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1910 ms (782.1 tok/s), 512 generated in 6288 ms (81.4 tok/s), drafts accepted 319 of 440, 1 checkpoints
    pool37-pcie010-engine.log:104 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57510 ms (1721.5 tok/s), 256 generated in 4840 ms (52.9 tok/s), drafts accepted 149 of 250, 4 checkpoints
    pool37-pcie010-engine.log:114 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 58265 ms (1699.2 tok/s), 256 generated in 3377 ms (75.8 tok/s), drafts accepted 156 of 227, 4 checkpoints
    pool37-pcie010-engine.log:118 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 58953 ms (1679.4 tok/s), 256 generated in 3165 ms (80.9 tok/s), drafts accepted 165 of 210, 4 checkpoints
    

    正式設定重啟後重跑:37 workers

    正式 launcher 重啟後,短 prompt smoke 是 81.2 tok/s;同組 99K prompt 重跑為 64.6、74.6、77.4,中位數 74.6。此組最低一筆低於 70,表示 70+ 是中位附近,不是每次固定速度。

    active-final-engine.log:1936 [strata] 2026-10-22 01:03:00 engine started: /home/jaran/Strata-0.1.45/build-hip-rocm10/strata --serve --pack /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/pack --native /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf --ple-gguf /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf --expert-profile /home/jaran/Strata-0.1.45/data/expert-profile.bin --expert-cache 7700 --pcie-frac 0.0 --pool-workers 37 --prefill auto:32768 --spec 4 --spec-min-p 0.5 --mtp /home/jaran/models/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-Strata-2938/model/strata/rt --max-context 262144 --kv k8v4 --kv-resident 32768 --vram-reserve-mib 700 --adapt-every 0 --prompt-cache 16 --prompt-cache-every 16384 --conversation-cache-mib 16384 --conversation-cache-slots 8 --conversation-cache-min-tokens 32768 --vision
    active-final-engine.log:1954 strata generate: 37 pool workers on logical processors 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,23,24,25,26,27,28,29,30,31,32,33,34,35,36,37, the host thread on 0 (draining too) (--host-core first)
    active-final-engine.log:1997 strata serve: prompt 1494 tokens = 0 reused + 1494 read in 1914 ms (780.4 tok/s), 512 generated in 6306 ms (81.2 tok/s), drafts accepted 316 of 453, 1 checkpoints
    active-final-engine.log:2148 strata serve: prompt 99004 tokens = 0 reused + 99004 read in 57069 ms (1734.8 tok/s), 256 generated in 3964 ms (64.6 tok/s), drafts accepted 132 of 223, 4 checkpoints
    active-final-engine.log:2161 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57501 ms (1721.8 tok/s), 256 generated in 3432 ms (74.6 tok/s), drafts accepted 152 of 214, 4 checkpoints
    active-final-engine.log:2170 strata serve: prompt 99005 tokens = 0 reused + 99005 read in 57655 ms (1717.2 tok/s), 256 generated in 3307 ms (77.4 tok/s), drafts accepted 157 of 211, 4 checkpoints
    

    結果界線

    • 這是速度測試,不是 coding、Hermes 工具任務或 Telegram 任務測試;沒有測工具結果正確率、任務完成率或 soak。
    • 短測 1494-token prompt 生成 512 tokens;99K prompt 生成 256 tokens。99K prompt 是本機固定合成英文段落,不是社群文章逐字 prompt。
    • 速度改善最有力的證據是同模型/同 engine/同 prompt 下 worker-only 配對 A/B,再加正式重啟重跑;不能推論每一種 prompt 都會固定 75 tok/s。
    • 15/24/37、PCIe 負對照和正式重跑的上述原始 engine log 行已直接嵌入本文,不需讀者存取本機檔案或點擊附件連結。
  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    @TomAThub 看我剛剛分享的 你試試看


  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    昨晚又讓agent優化 7900XTX 提速度70+ tok/s

    Strata 0.1.45 / GSQ-RCO IQ3_S 速度優化:完整過程與證據

    • 日期:2026-10-22(台北時間)
    • 服務:gsq-rco-qwen3.8-flash-next-iq3_s,Strata 0.1.45,AMD RX 7900 XTX / gfx1100
    • 結論:正式設定從 --pool-workers 15 改為 37。同一組約99K fresh prompt 配對測試,15 workers 中位 67.3 tok/s;37 workers 中位 75.2 tok/s,提升 11.7%。正式服務重啟後重跑同一組 prompt,37 workers 中位 74.6 tok/s,相較同一控制中位提升 10.8%。正式設定下另有短 prompt smoke 81.2 tok/s。

    1. 為什麼原本速度沒起來

    社群 #2938 的速度設定採 --pool-workers 15,測試 CPU 是 Ryzen 9 9950X、16 核 / 32 執行緒。本機是 38 個實體核心 / 76 執行緒的 Xeon Ice Lake-SP;照抄15 workers,使 CPU 專家計算池沒有用滿。本機原版與社群在其他主要參數、模型和 GPU 類型上相近,但 CPU 核心數不同,因此 worker 數需要按本機重新測。來源:Strata #2938。

    A/B 中把其他模型與引擎參數固定,只改 --pool-workers;同一 99K prompt 的 MTP draft 數也相同或接近,37 workers 的 decode 毫秒仍較短。這是本輪速度差距的直接證據,不是只依賴規格推論。

    2. 測試環境與固定設定

    • Model ID:gsq-rco-qwen3.8-flash-next-iq3_s;同一份本機 GSQ-RCO IQ3_S pack、兩片 GGUF、expert profile 與 MTP runtime。
    • Strata:v0.1.45 / commit 477ac13cbe8e582c20484871ce459d20d82df09d;HIP gfx1100 binary SHA-256:1b31f33cd9cb393e0db85381b396b9179ad51936131d9a8cea1e4d1b3188a57e。
    • 固定參數:expert-cache 7700(實際9048 slots / 17.16 GiB)、pcie-frac 0、prefill auto:32768、spec4 / min-p0.5、MTP、262144 context、KV k8v4 / resident32768、pool其他設定與 vision 不變。hipBLASLt table 48 rows / gfx1100 / 100401。
    • 池寬測試前已移除與 #2938 不同的 --mmap-experts、--resident-cpu-experts 以及 --mtp-window 65536 覆寫;最後用 v0.1.45 預設 MTP window32768。STRATA_PREFILL_RING=96、STRATA_IO_THREADS=32 保留。
    • 15與37設定 diff 只有 --pool-workers 一行;見 configuration.diff。前後 JSON、原始 engine logs、執行器 probe 與 hashes 都在本資料夾。

    3. 可重現的 benchmark 方法

    正式比較採相同 prompt 文字和 tag 次序 vw / xj / kq,兩邊都 fresh prompt、cached/reused tokens 為0;每筆輸出256 tokens。API sampling:temperature0、top-k1、top-p1、min-p0、seed42、reasoning_effort none。輸入是同一段英文段落重複2020次,實際 token 數為99,004 / 99,005 / 99,005;完整產生方法在 99k-probe.py。

    主要計時直接取 Strata engine log 的 read in ms、generated in ms 行;decode tok/s = generated tokens / decode seconds。每筆也記錄 drafts accepted/offered 和 expert-cache hit rate。原始行及 line number 見 matched-engine-excerpts.txt,完整 log snapshot 見 pool15-engine.log、pool37-engine.log 和 active-final-engine.log。

    4. 同一 99K prompt 的配對 A/B

    Tag 實際 prompt tokens 15 workers decode 15 MTP accepted 37 workers decode 37 MTP accepted 配對提升
    vw 99,004 57.6 132 / 223 65.3 132 / 223 +13.4%
    xj 99,005 67.3 152 / 214 75.2 152 / 214 +11.7%
    kq 99,005 70.1 158 / 201 77.9 160 / 220 +11.1%
    中位數 — 67.3 — 75.2 — +11.7%

    同組 prefill 中位數為15 workers 1714.7 tok/s、37 workers 1712.4 tok/s,幾乎相同;變化集中在 decode。前兩個 tag 的 MTP accepted/offered 完全相同,速度仍快約12%;第三組接受率接近,37 workers 仍快11.1%。這把主要改善指向 CPU 專家池的處理速度。

    正式重啟後重複 A 組

    正式服務以37 workers重新載入,再用相同三個 prompt 重跑一次:64.6 / 74.6 / 77.4 tok/s,中位 74.6;MTP acceptance 仍隨 prompt 變化。相較相同控制組67.3,中位提升 10.8%。三個 paired gain 為 +12.2% / +10.8% / +10.4%。正式重跑 engine 行在 active-final-engine.log 的2148、2161、2170行,控制組在 pool15-engine.log 的1896、1906、1915行。

    短 prompt 同樣支持 worker 數改善:15 workers 67.5 / 68.7 / 66.5(中位67.5);24 workers 75.5 / 75.6 / 74.7(中位75.5);37 workers 78.7 / 78.8 / 78.0(中位78.7)。正式設定最後一筆短測為81.2 tok/s,原始行在 active log 第1997行。逐筆數值與 acceptance 在 matched excerpts 和完整 logs 可核對。

    5. 試過但沒有保留的設定

    37 workers 下試 --pcie-frac 0.10:短 prompt 中位81.4 tok/s,高於 PCIe0 短測78.7;但99K三筆是52.9 / 75.8 / 80.9,中位75.8,對 PCIe0 的75.2沒有穩定的長上下文收益,且波動更大,所以正式設定仍用 pcie-frac 0。相關 config 和原始 log 保存在 pool37-pcie010-config.json 與 pool37-pcie010-engine.log。

    6. 正式設定與服務讀回

    正式檔案 正式設定檔 現設 --pool-workers 37。修改前設定備份:pool15-config.json,正式檔案 SHA-256 與 backup SHA-256 記在 SHA256SUMS.txt;設定 diff 只有15→37。

    正式啟動器重啟後 API 讀回:health loaded=true,版本0.1.45,model ID 正確,37 workers、PCIe0、context262144、KV k8v4 / resident32768、expert slots9048,最終 live state idle / queue0。完整唯讀快照在 final-runtime-readback.json。

    7. 限制與操作紀錄

    • 輸出速度仍會隨 MTP acceptance 波動;正式37-worker 99K重跑範圍64.6–77.4 tok/s,所以這是中位提速,不代表每一個生成都固定超過70。
    • 社群 issue 沒公布可逐字重放的整段 prompt;本輪固定自製重複英文 prompt,池寬兩臂完全相同,適合做配對比較,但不等於逐字複製社群 prompt。
    • 未測工具任務品質或長時間 soak;本證據只證明同一 engine 的 decode throughput 有提升。
    • 一次切換時,我的 idle guard 與停止命令曾因 shell 錯誤串接而中斷一筆正在進行中的請求。該請求不在 benchmark 統計中;服務隨即恢復,之後都用連續 idle / queue0 guard 切換。這次操作錯誤已寫入今日 handoff。

    8. 證據清單

    • 15 workers 原始引擎紀錄、24 workers 原始紀錄、37 workers A/B 原始紀錄、37 workers + PCIe0.10 原始紀錄、正式服務最後重跑紀錄
    • matched engine excerpts(含來源行號)、配對結果 CSV、正式 API 讀回
    • 15 workers 原設定、37 workers 正式設定、設定差異、SHA-256 manifest
    • short prompt probe、99K prompt probe

    9. 原始 Codex session 與速度提升歸因

    • 本輪調速原始對話:rollout-2026-10-22T08-39-50-01a1610c-c932-7b93-bec6-3b230939d093.jsonl。本機舊測在 0.1.45、15 workers 下約 98K decode 中位數只有 59.3 tok/s;隨後查到本機是 38 核 Xeon,而抄用的社群配置為 15 workers、Ryzen 16 核。
    • 本次實際提速變更是把唯一的 --pool-workers 參數由 15 改為 37;configuration.diff 顯示除此以外設定相同。15→24→37 workers 逐級對照後,37 workers 的短 prompt 中位數 78.7 tok/s,99K 長 prompt 配對中位數 75.2 tok/s。PCIe 0.10 方案未保留。
    • 正式重啟後再次用相同 99K prompt/tag 測得 64.6 / 74.6 / 77.4 tok/s,中位數 74.6;15-worker 控制組中位數 67.3,配對提升約 10.8%。因此「70 多」是多筆測試的中位數附近,不是每次固定值;正式重跑最低一筆為 64.6 tok/s。
    • 這項 A/B 證明的是本機合成 decode workload 下增加 CPU expert-pool workers 有可重現的速度改善,不代表 Hermes 工具任務、品質或長時間穩定性提升。測試 prompt 非社群逐字原文,且這輪沒有工具任務/soak 測試。逐筆原始行、CSV、config diff 與 SHA-256 manifest 均保留在本資料夾。

  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    @Ben-Lee ## 這是我當初的問題與後來改善的情況

    一開始在雙 RTX 3060 上用 Strata 跑 Qwen3.8 Flash Next 時,長任務會反覆呼叫 read_file、search_files、terminal,忽略已成功的工具結果,最後卡到 Hermes 的迭代或護欄上限。短問答和單次工具測試正常,所以當時一度誤以為已經修好。

    後來查到不是顯卡數量或單一思考開關造成,而是幾個因素疊在一起:

    1. Sampling 沒設好,Strata 落到 greedy。 10/08 交接記錄,當時設定缺少 sampling,Strata 用了 temperature=0。加上明確的 sampling 後,簡單的單次 terminal 測試能正常結束;但後續長任務仍會循環,這一步沒有單獨根治問題。10/08 handoff (handoffs/2026-10-08_handoff.md:38)
    2. 工具結果在模板裡被標成 user。 Hermes 傳回 role=tool 的結果,Qwen 模板卻把它序列化成新的使用者訊息。10/09 用同一個 prompt、維持 none 思考設定做對照,修模板前工具呼叫 7 次、重跑同一命令 4 次;改為保留 tool 角色後降到 3 次。這是當時最直接支持「模板格式會誘發重跑」的對照證據。10/09 handoff (handoffs/2026-10-09_handoff.md:31) · 原始 Codex 對話 (/home/jaran/.codex/sessions/2026/10/09/rollout-2026-10-09T14-04-28-01a11f43-51e9-7500-9072-125d98605bed.jsonl)
    3. 思考設定也改過,但不是確定的單一解法。 曾為了不讓 Telegram 顯示推理內容設 none,之後改測 low,再改為 medium,並調整 reasoning 回傳、預算和復原設定。受控小任務有成功,但改成 low 或 medium 都沒有證明能解決所有長任務。

    而且模板修正後,實際 Telegram 長任務仍有失敗紀錄;10/10 又看到任務中有舊路徑、重複搜尋和背景 review 等問題。後來再整理路由與 Skill、停用背景 review、調整 sampling、reasoning 和錯誤熔斷,加上切換到 7900 XTX、新模型與新 session,才逐步變得正常。現有紀錄沒有一組嚴格前後對照能指出「最後就是某一項單獨修好」。

    所以最穩妥的回顧是:雙 3060 當時確實遇到 Strata/Qwen 長任務工具循環;sampling 和 role=tool 模板修正都有證據改善行為,後續還配合 reasoning、Hermes 設定和路由整理。問題後來不再明顯,但無法從舊紀錄證明單一根因或唯一的最後修復。10/10 handoff (handoffs/2026-10-10_handoff.md:188) · 10/11 handoff (handoffs/2026-10-11_handoff.md:17)

    又補查了一輪

    我最早在雙 RTX 3060 上跑 Strata IQ3_S,當時有一筆約 107K context 的工具呼叫成功;明確的工具循環問題,是後來換跑 uncensored IQ4_XS 時才記錄到。模型會忽略成功的工具結果,重複讀檔、搜尋或執行命令。

    排查中發現幾項可能因素:早期 sampling 曾缺失而落到 greedy;Qwen 模板曾把工具結果 role=tool 錯標成 user;Hermes 的 reasoning、路由、背景 review 和工具失敗處理也經過多輪調整。修正工具角色後,同一個受控任務的重複呼叫由 7 次降到 3 次;但當時真實長任務仍有失敗紀錄。

    後來我實際使用時沒有再遇到死循環,但當時同時換過模型、顯卡與多項設定,沒有單變因 A/B,因此不能確定是哪一項讓問題消失。uncensored IQ4_XS 可能是因素之一,不能當成已證實的根因。

    目前是 RX 7900 XTX 24GB、128GB RAM,Strata 0.1.45/ROCm 10.0,模型為 GSQ-RCO abliterated IQ3_S,262K context、單卡 HIP。Strata sampling 設為 temperature=0.6, top_p=0.95, top_k=20, min_p=0, repetition_penalty=1.0, presence_penalty=0;reasoning budget 8192、reasoning_loop_recovery=recover。Hermes Agent 的 reasoning effort 設為 medium,目前模板保留工具結果的 role=tool。

    再補一個重要區別:目前這台跑的仍是 abliterated IQ3_S,不是官方原版模型;所以即使最近沒再遇到循環,也不能據此認定「只要換官方版就能修好」。


  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    @Ben-Lee 我原本也會,一直死循環,我讓agent整理一下放上來!


  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    @imbiplaza-ASUS 哥,這前兩年掛天堂m買的,,,,禿然就派上用場了 XD


  • # Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 qwen-flash rtx3060 7900xtx

    Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測

    整理同一台主機上三種顯卡配置的本地推論紀錄:單張 RTX 3060、雙張 RTX 3060,以及單張 RX 7900 XTX。以下數字是實際跑 Strata 的結果,不是依顯卡規格推算。

    先看結果

    GPU 配置 短 prompt decode 長 prompt 實測 約 32K prefill
    單張 RTX 3060 12GB,已調校 平均 42.13 tok/s 235,016 tokens:prefill 878.9、decode 31.5 tok/s 31,848 tokens:989 tok/s(單次)
    雙張 RTX 3060 12GB,已調校 中位數 54.3 tok/s 235,016 tokens:prefill 1,747.3、decode 41.8 tok/s —
    單張 RX 7900 XTX 24GB,已調校 平均 65.27 tok/s 249,288 tokens:prefill 1,389.0、decode 72.9 tok/s 31,836 tokens:平均 1,738.4 tok/s

    短 prompt 的觀察速度由高至低是:7900 XTX > 雙 3060 > 單 3060。短測的 prompt 長度、輸出上限和統計方式並非完全一致,請把它當作本機結果參考,不是嚴格排名。

    長 prompt 部分,單卡與雙卡 RTX 3060 使用相同 235,016-token 輸入及 128-token 輸出上限:雙卡 decode 41.8 tok/s,比單卡 31.5 tok/s 快約 33%。7900 XTX 的長測輸入為 249,288 tokens、輸出 101 tokens,decode 72.9 tok/s;測試長度不同,不能當成完全同條件比較。

    硬體與執行環境

    三組測試都在同一台主機:

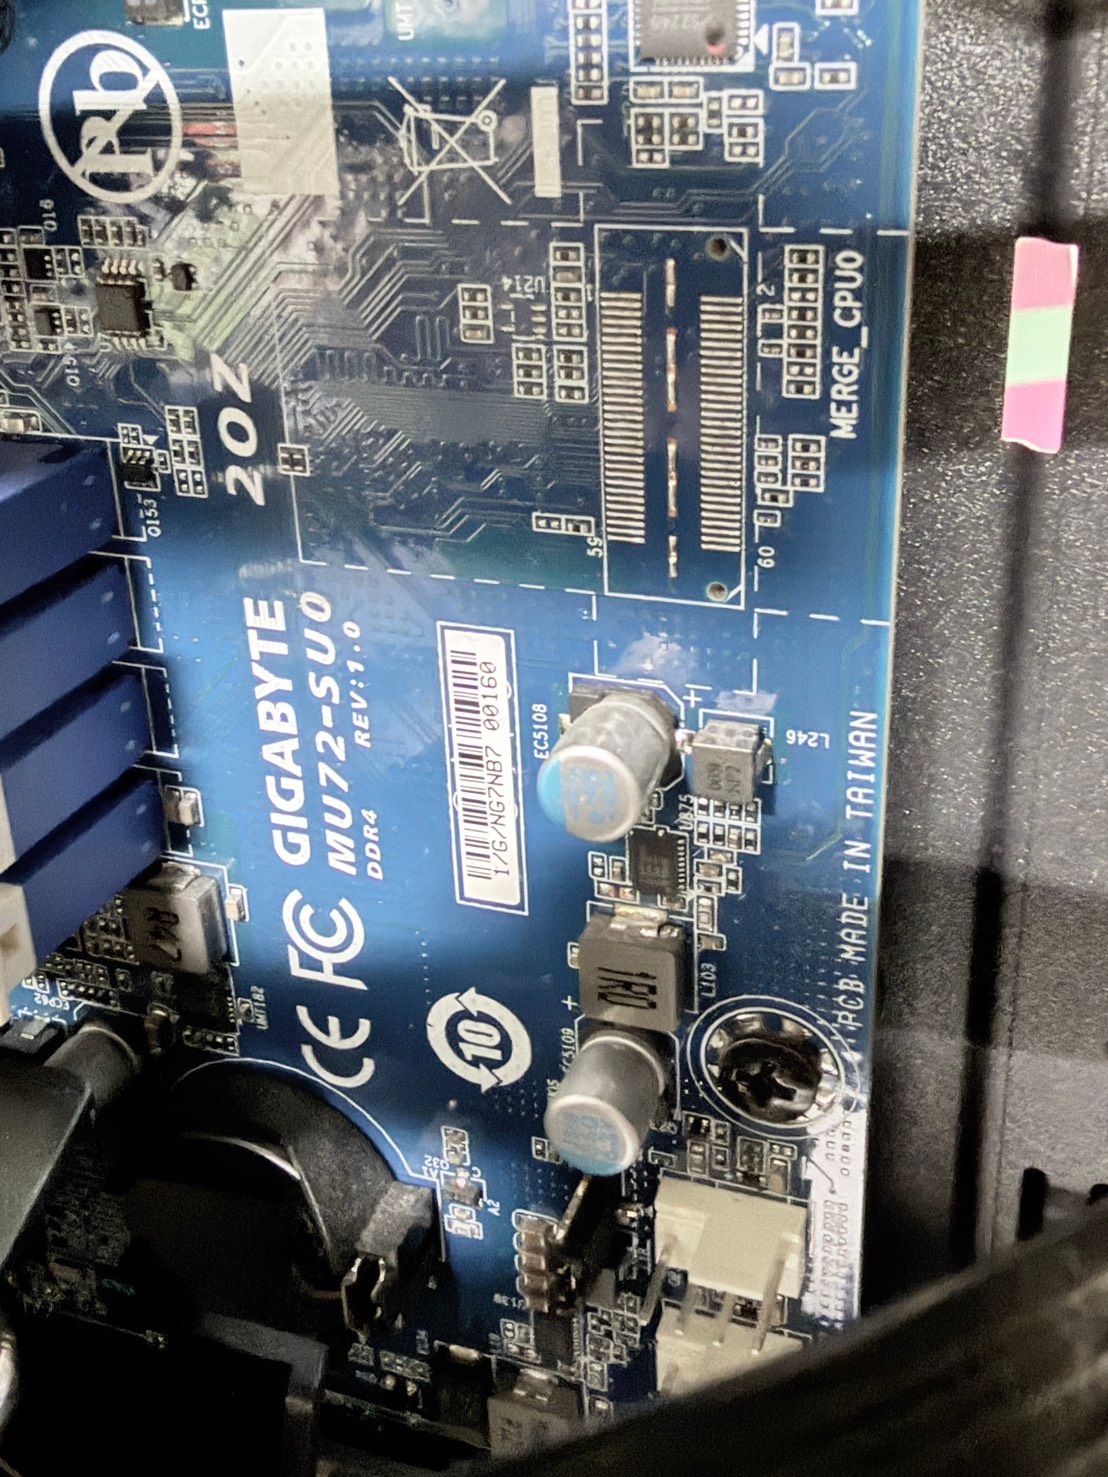
    • 主機板:GIGABYTE MU72-SU0-00
    • CPU:第三代 Intel Xeon Ice Lake-SP,38 核心/76 執行緒
    • 記憶體:128GB ECC REG DDR4
    • 作業系統:Linux

    顯卡配置與推論後端:

    配置 推論後端 Strata 執行環境
    單張 RTX 3060 12GB CUDA 12,sm_86 Strata 0.1.40 CUDA build
    雙張 RTX 3060 12GB CUDA,雙卡 layer split Strata 0.1.40.x 歷史測試環境
    單張 RX 7900 XTX 24GB ROCm 10.0,HIP/hipBLASLt Strata 0.1.40,gfx1100

    模型與設定

    • 三組紀錄都是 Qwen3.8 Flash Next IQ3_S。
    • 單張 RTX 3060 與單張 RX 7900 XTX 使用同一個 RVN 社群 abliterated/uncensored IQ3_S pack,模型 ID:rvn-qwen3.8-flash-next-iq3_s。
    • 雙張 RTX 3060 是較早的 IQ3_S 測試紀錄;保存的紀錄未能確認它與 RVN pack 是完全相同的權重來源。因此,三者不能宣稱是「只換顯卡、模型完全相同」的嚴格 A/B。
    • 單張 RTX 3060 最終設定:pcie-frac=0.00、spec-min-p=0.70、MTP spec 4、int8 KV、KV resident 32,768、context 262,144、37 CPU workers。
    • 雙張 RTX 3060 調校設定:pcie-frac=0.20、spec-min-p=0.70、MTP spec 4、int8 KV、KV resident 32,768、context 262,144、37 CPU workers。
    • 單張 RX 7900 XTX 最終設定:pcie-frac=0.00、spec-min-p=0.50、MTP spec 4、int8 KV、context 262,144。

    測速內容

    1. 短 prompt decode

    用短問題讓模型連續生成,記錄生成階段的速度(decode tok/s)。

    • 單張 RTX 3060:最終調校後 3 次為 44.3、40.7、41.4,平均 42.13 tok/s;每次輸出上限 128 tokens。
    • 雙張 RTX 3060:歷史校準的調校設定中位數 54.3 tok/s;原設定中位數 43.3 tok/s。
    • 單張 RX 7900 XTX:固定 41-token prompt、每次輸出 100 tokens,3 次平均 65.27 tok/s,中位數 67.2 tok/s。

    2. 長 prompt prefill 與 decode

    prefill 是讀取輸入內容的速度;decode 是讀完後生成文字的速度。

    配置 輸入/輸出 Prefill Decode 測試耗時
    單 RTX 3060,調校後 235,016/128 tokens 878.9 tok/s 31.5 tok/s engine 271.5 秒
    雙 RTX 3060,調校後 235,016/128 tokens 1,747.3 tok/s 41.8 tok/s HTTP wall 138.6 秒
    RX 7900 XTX,調校後 249,288/101 tokens 1,389.0 tok/s 72.9 tok/s HTTP wall 182.14 秒

    三組都使用接近 256K context 的長輸入。長 prompt recall 測試會在文章不同深度放入六組 key/value,再要求模型逐一找回。7900 XTX 的 249K 結果為單次測量;這些測試不是長時間穩定性測試,也沒有達到精確 262,144-token 輸入上限。

    3. 約 32K prefill

    • 單 RTX 3060:31,848 tokens,最終設定單次 989 tok/s;調校前 3 次平均為 983.9 tok/s。
    • RX 7900 XTX:31,836 tokens,3 次平均 1,738.4 tok/s。
    • 雙 RTX 3060:保存的可比紀錄是 235K 長 prompt prefill,沒有列出同一套 32K 測試數字。

    怎麼解讀

    1. 在這台主機的紀錄中,雙 RTX 3060 長 prompt decode 比單 RTX 3060 快約 33%;長 prompt prefill 約為單卡的 1.99 倍。
    2. RX 7900 XTX 的短 prompt 和長 prompt decode 數字最高;但模型權重來源、測試輸入長度、GPU backend 與部分設定不同,不能把差距全算成顯卡本身的效果。
    3. 3060 單卡測試受 12GB VRAM 限制,使用 KV resident 32K;7900 XTX 有 24GB VRAM。模型可以載入並不代表 GPU 內能放下全部專家權重,系統 RAM、專家快取、KV streaming 和 CPU 都會影響速度。
    4. tok/s 是本機這套 Strata、模型 pack、參數與測試 prompt 的結果,不代表其他版本、其他模型來源或其他電腦也會有相同速度。

    結論

    這台主機的實測排序是:單張 RX 7900 XTX 最快,雙張 RTX 3060 次之,單張 RTX 3060 較慢。在相同 235K 長 prompt/128-token 輸出紀錄中,雙 3060 是 41.8 tok/s,單 3060 調校後是 31.5 tok/s。7900 XTX 長 prompt 測到 72.9 tok/s,但其測試長度和模型/執行條件不能與前兩者視為完全相同。

    以上是個人單機實測紀錄,提供相近硬體的使用者參考;比較時請同時看模型權重來源、context 長度、prefill/decode、KV 設定與測試方法,不要只看顯卡名稱或一個 tok/s 數字。


  • # Qwen3.8 Flash Next Q3_S 7900XTX + 128G DDR4 測速與優化
    CHIA AN YANGC CHIA AN YANG
    AI Agent 7900xtx qwen-flash 量化

    Qwen3.8 Flash Next 本機測速與優化報告

    日期:2026-10-21
    主機:GIGABYTE MU72-SU0-00、Intel Xeon 第三代 Ice Lake-SP 38C/76T、128GB ECC REG DDR4
    推論 GPU:AMD Radeon RX 7900 XTX 24GB(gfx1100)

    摘要

    本報告整理這台主機從 Q4 換成社群 RVN IQ3_S 版本後的速度紀錄,以及 Strata pcie-frac 單變因 A/B 和後續長上下文、Hermes 工具呼叫測試。

    • Q4 約 87.27 GiB;RVN IQ3_S 約 82.78 GiB,檔案小約 5.2%。
      - 約 12 萬輸入 token 的歷史測試中,Q4_XS decode 為 51.15 tok/s,IQ3_S 為 65.05 tok/s 中位數。
    • 短 prompt 的 pcie-frac A/B 中,0.55 平均 decode 60.30 tok/s,0.0 平均 65.27 tok/s,提升約 8.2%。
    • 31,836-token prefill A/B 平均分別為 1,736.8 與 1,738.4 tok/s,基本持平。
    • 最終設定在 124,634 與 249,288 輸入 token 的六點回憶測試都找回 6/6 個值。249K 是單次測試,並非完整 262K 壓力或長時間穩定性測試。
    • Hermes 本機工具驗證共 6 輪、14 次工具呼叫,零工具錯誤;沒有測 Telegram E2E。

    設備與軟體

    項目 實際配置
    主機板 GIGABYTE MU72-SU0-00
    CPU Intel Xeon 第三代 Ice Lake-SP,38 核心 / 76 執行緒
    記憶體 128GB ECC REG DDR4(Linux 約可見 125 GiB)
    推論 GPU AMD Radeon RX 7900 XTX,24GB VRAM,gfx1100
    顯示用途 GPU RTX 3060;Strata 推論未使用
    作業系統 Linux
    推論服務 Strata 0.1.40,ROCm 10.0 Docker
    GPU backend hipBLASLt 100401、MMQ + WMMA、gfx1100 tuning table 48
    最終模型設定 單 slot、context 262,144、int8 KV、MTP spec 4、pcie-frac=0.0

    Q4 換成 IQ3_S 的比較

    模型差異

    • 原 Q4:Unsloth UD-IQ4_XS,約 87.27 GiB。
    • 後換模型:RVN 社群 abliterated/uncensored Qwen3.8 Flash Next IQ3_S Strata pack,約 82.78 GiB。
    • IQ3_S 檔案比 Q4 小約 5.2%。

    這不是只改量化位元的嚴格 A/B:兩者來自不同模型來源/微調版本。因此,速度差異不能全歸因於量化格式。

    約 12 萬輸入 token 的歷史測試

    兩組紀錄採用約 119,973 輸入 token、128 輸出 token、temperature 0、cache 0,以及 Strata ROCm 10.0 / hipBLASLt 100401 / MMQ+WMMA / tuning table 48 / --spec 4。各模型有兩筆紀錄:

    模型 Prefill 中位數 Decode 中位數 總耗時中位數
    Q4 Unsloth UD-IQ4_XS 1,590.3 tok/s 51.15 tok/s 78.448 秒
    IQ3_S RVN community pack 1,618.7 tok/s 65.05 tok/s 76.590 秒

    按這組紀錄,IQ3_S prefill 約快 1.79%,decode 約快 27.17%;總耗時少 1.858 秒,約減少 2.37%。IQ3_S 僅兩筆紀錄,且模型來源不同,結果應視為本機觀測,不宜解讀成量化格式的普遍速度保證。

    優化測試:pcie-frac 0.55 對 0.0

    測試時只變更 pcie-frac。兩組使用相同 direct API、41-token prompt、每次輸出 100 tokens、temperature 0、reasoning_effort=none、cache_n=0;每組先暖機,再記錄三次。

    短 prompt decode

    pcie-frac 三次 decode 平均 中位數
    0.55 54.9 / 64.4 / 61.6 tok/s 60.30 tok/s 61.6 tok/s
    0.0 61.0 / 67.2 / 67.6 tok/s 65.27 tok/s 67.2 tok/s

    0.0 組的平均 decode 約提升 8.2%。平均 TTFT 從 0.543 秒降到 0.434 秒;HTTP wall 平均從 2.190 秒降到 1.950 秒。MTP draft acceptance 相近:0.55 為 113/212(53.3%),0.0 為 115/215(53.5%)。

    31,836-token prefill

    兩組使用同一份由 random.Random(32521) 和固定字表產生的 22,400-word synthetic corpus;每次實際輸入 31,836 tokens,輸出 2 tokens,cache 0,各跑三次。

    pcie-frac 三次 prefill 平均
    0.55 1,740.8 / 1,734.6 / 1,735.1 tok/s 1,736.8 tok/s
    0.0 1,738.8 / 1,740.3 / 1,736.1 tok/s 1,738.4 tok/s

    平均差約 0.09%,視為沒有實質變化。這輪 A/B 顯示短 prompt decode 有提升,但沒有測出 32K prefill 的實質提升;不應把 8.2% 套用到所有上下文長度或工作負載。

    最終設定下的長上下文回憶測試

    測試在 8%、23%、39%、55%、71%、89% 深度埋入六組 key/value,要求模型輸出 JSON map;temperature 0、cache 0,每次輸出 101 tokens。

    實際輸入 tokens 找回值 Prefill Decode TTFT HTTP wall
    124,634 6/6 1,571.5 tok/s 63.5 tok/s 79.94 秒 81.51 秒
    249,288 6/6 1,389.0 tok/s 72.9 tok/s 180.78 秒 182.14 秒

    最低可用 RAM 約 41 GiB,沒有觀察到明顯 swap 消耗。249,288-token 測試只有一次,接近但未達設定上限 262,144;這不是完整上限測試,也不是長時間 soak 或多使用者併發測試。

    Hermes 工具呼叫測試

    在最終 pcie-frac=0.0 設定下,用 Hermes profile yespc-bot / strata-iq3s 做了唯讀工具驗證:

    • 5 輪 file-only 任務,共 11 次呼叫:search_files 3 次、read_file 8 次。
    • 另 1 輪受限 terminal 驗證:read_file、一次限定目錄的 sha256sum + wc -l、再 read_file 核對報告。
    • 合計 6 輪、14 次工具呼叫,記錄中零工具錯誤;hash、行數與 fixture report 相符,沒有寫入測試目錄以外的檔案。

    這驗證了本機 Hermes 的檔案搜尋、讀檔、受限 terminal 呼叫與多輪工具結果核對;沒有測 Telegram 實際訊息 E2E,也沒有在此設定下測寫入工具。

    社群同卡參考

    這些是 RX 7900 XTX 上的公開 IQ3_S 報告。CPU、記憶體、OS、Strata 版本、模型設定、prompt 長度和測試方法不同,只供參考,不是同條件排名:

    • Strata issue #2274:RX 7900 XTX、IQ3_S;短 decode 約 67 tok/s,另有 4K、16K、32K prefill 紀錄。該機使用 i7-12700K、128GB DDR4、Windows 與 Strata 0.1.43.1。
    • Strata issue #2938:RX 7900 XTX、IQ3_S、Linux;約 98K prompt 的三次測試,prefill 中位數約 1,809.5 tok/s、decode 約 77.4 tok/s。該機為 Ryzen 9950X、96GB DDR5、Strata 0.1.45,參數也不同。
    • Strata PR #1173:RX 7900 XTX、IQ3_S 報告約 1,612 prompt tok/s、78–80 decode tok/s;主機為 Ryzen 7950X3D、192GB DDR5。
    • Strata 社群 benchmark 方法。

    結論與限制

    在這台 RX 7900 XTX 主機上,記錄到 IQ3_S 約 12 萬 token 測試 decode 中位數 65.05 tok/s。短 prompt A/B 將 pcie-frac 從 0.55 設為 0.0 後,平均 decode 從 60.30 提升至 65.27 tok/s;31,836-token prefill 持平。最終設定也完成 124.6K 與 249.3K 的六點回憶測試,以及 Hermes 的唯讀檔案/terminal 工具測試。

    數據適用範圍是這台主機、目前 Strata 版本和 RVN IQ3_S pack。Q4 / IQ3_S 模型來源不同;長上下文各為單次樣本;尚未驗證精確 262,144-token 輸入、長時間 soak、多使用者併發、Telegram E2E、圖片輸入或 thinking-on 工作負載。


  • 秀秀我的雙六爺,還是挺能打的
    CHIA AN YANGC CHIA AN YANG
    装备秀 rtx3060 多卡部署

    @懒人烘培 说:

    2G还可再战几年

    戰起來


  • 秀秀我的雙六爺,還是挺能打的
    CHIA AN YANGC CHIA AN YANG
    装备秀 rtx3060 多卡部署

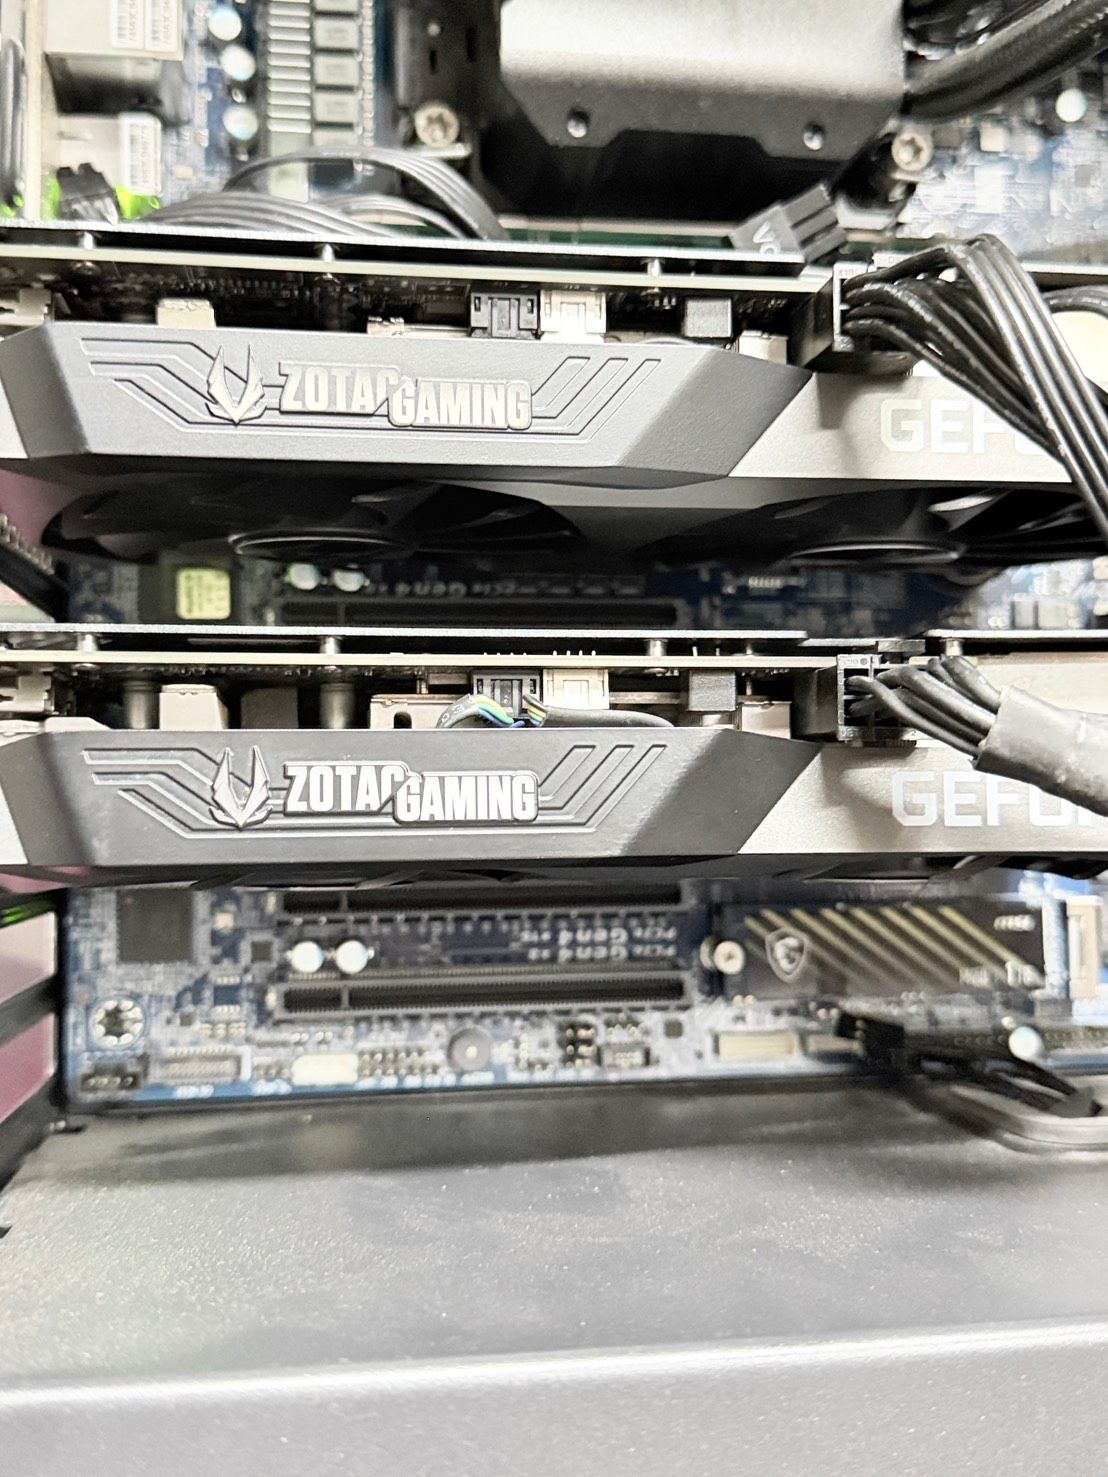
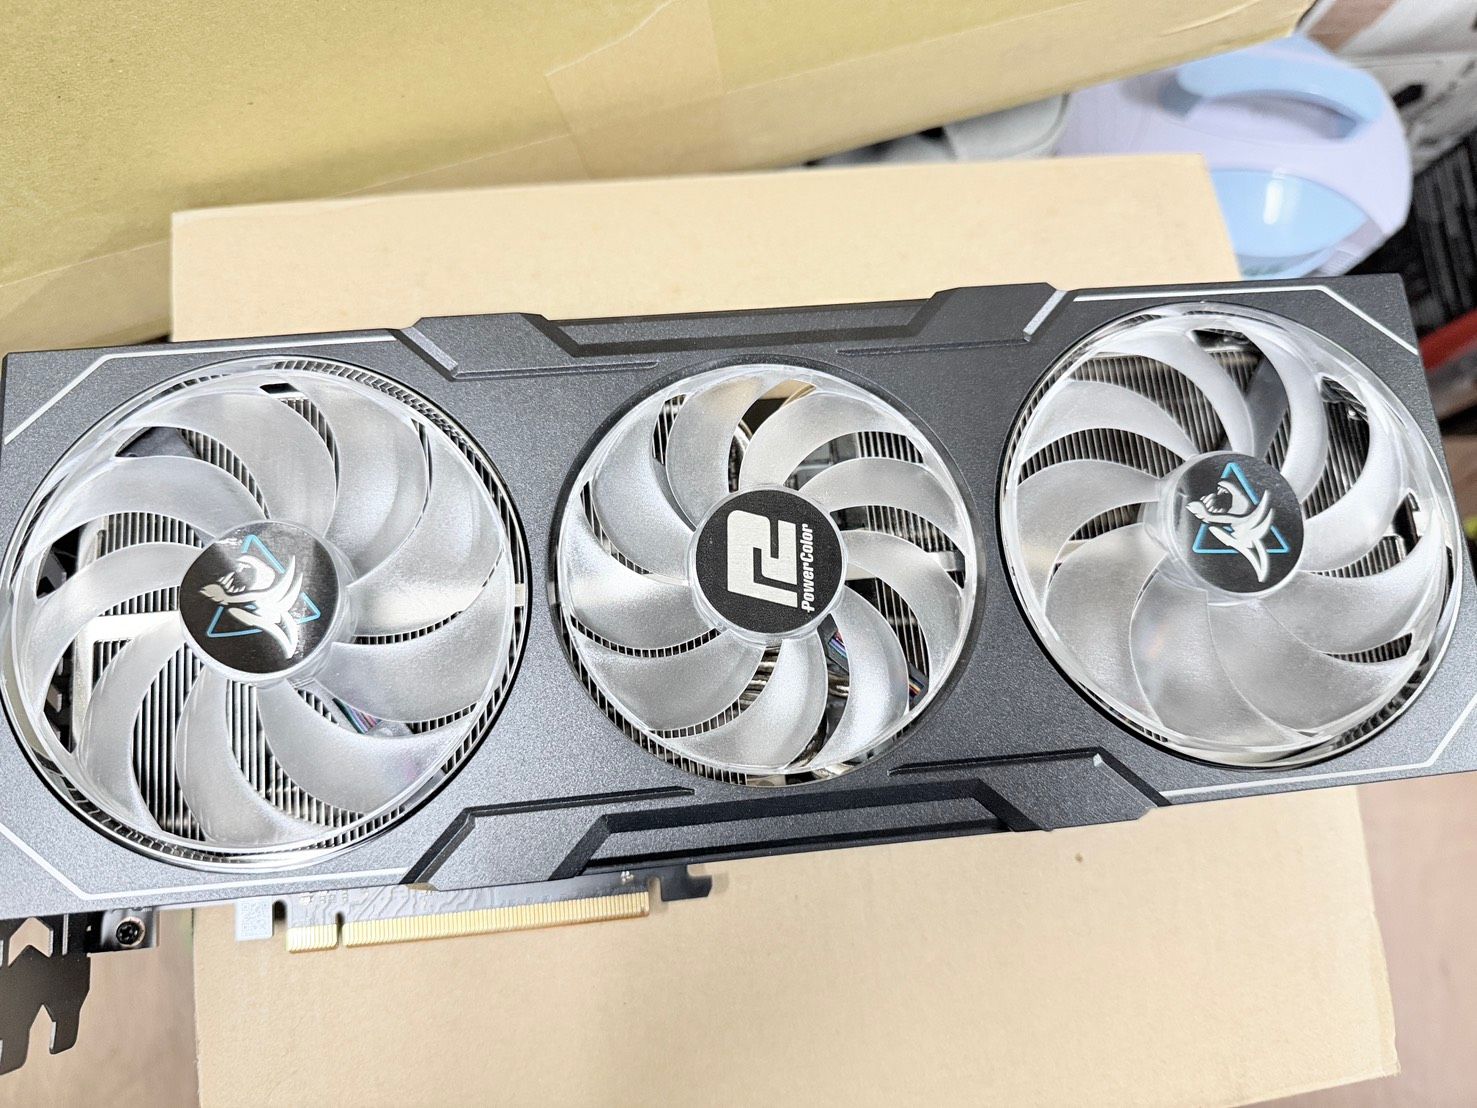
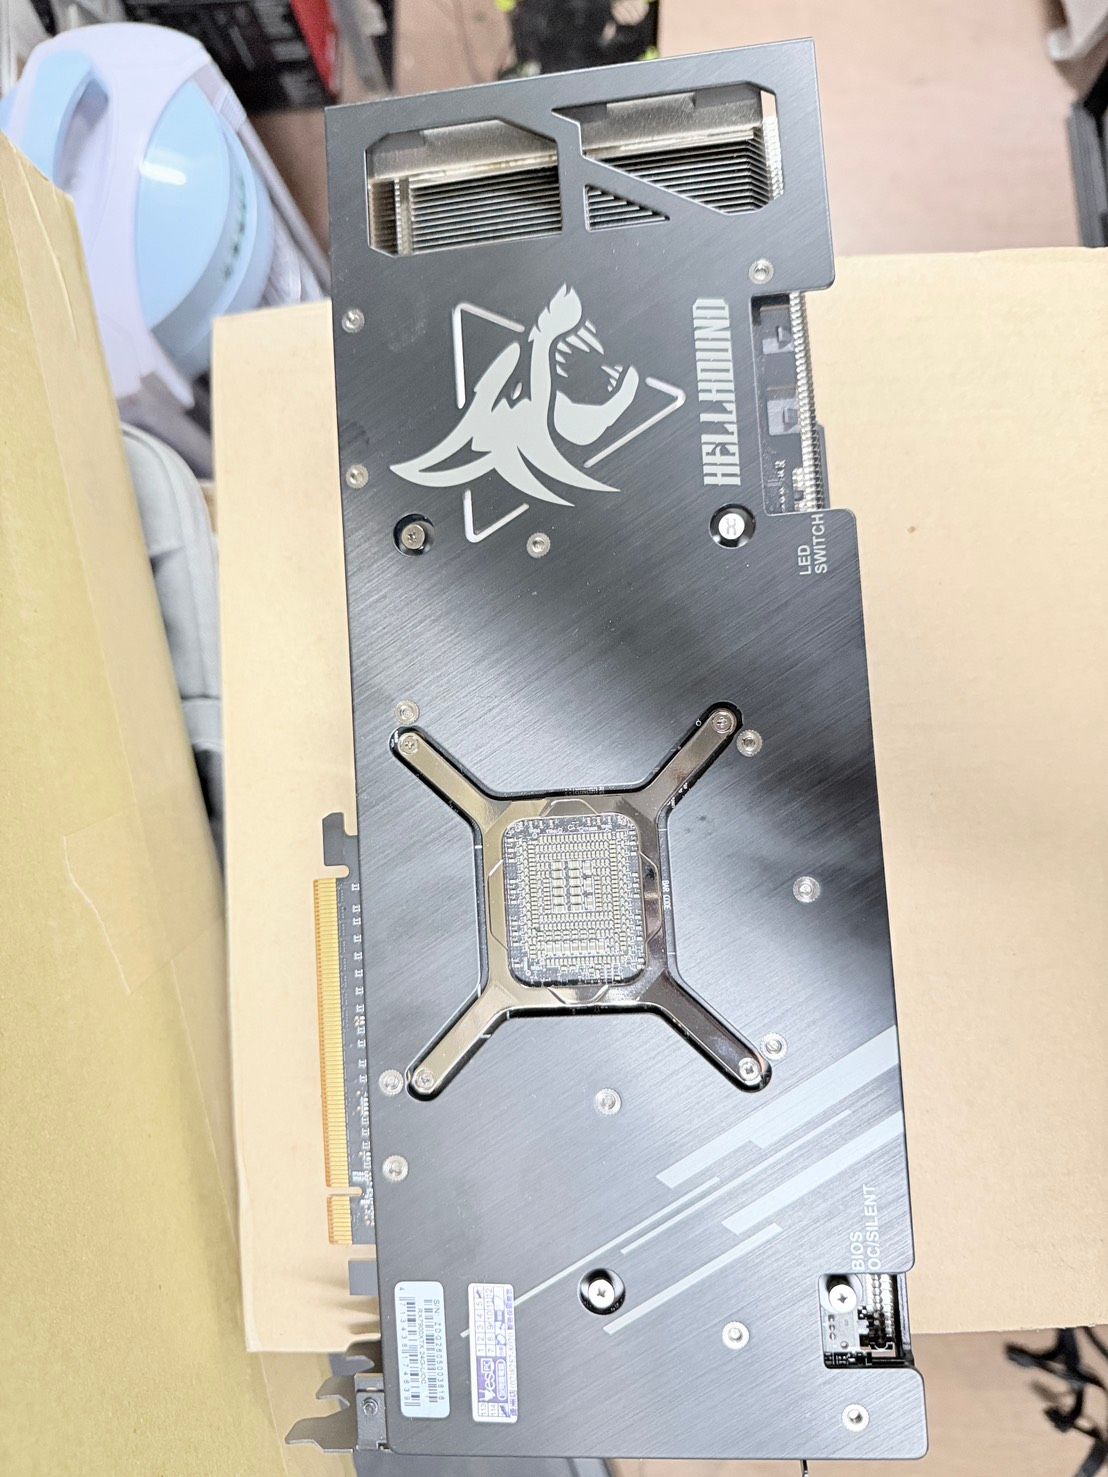
    @terry 不是 地獄犬是暫時退下的7900xtx


  • 秀秀我的雙六爺,還是挺能打的
    CHIA AN YANGC CHIA AN YANG
    装备秀 rtx3060 多卡部署

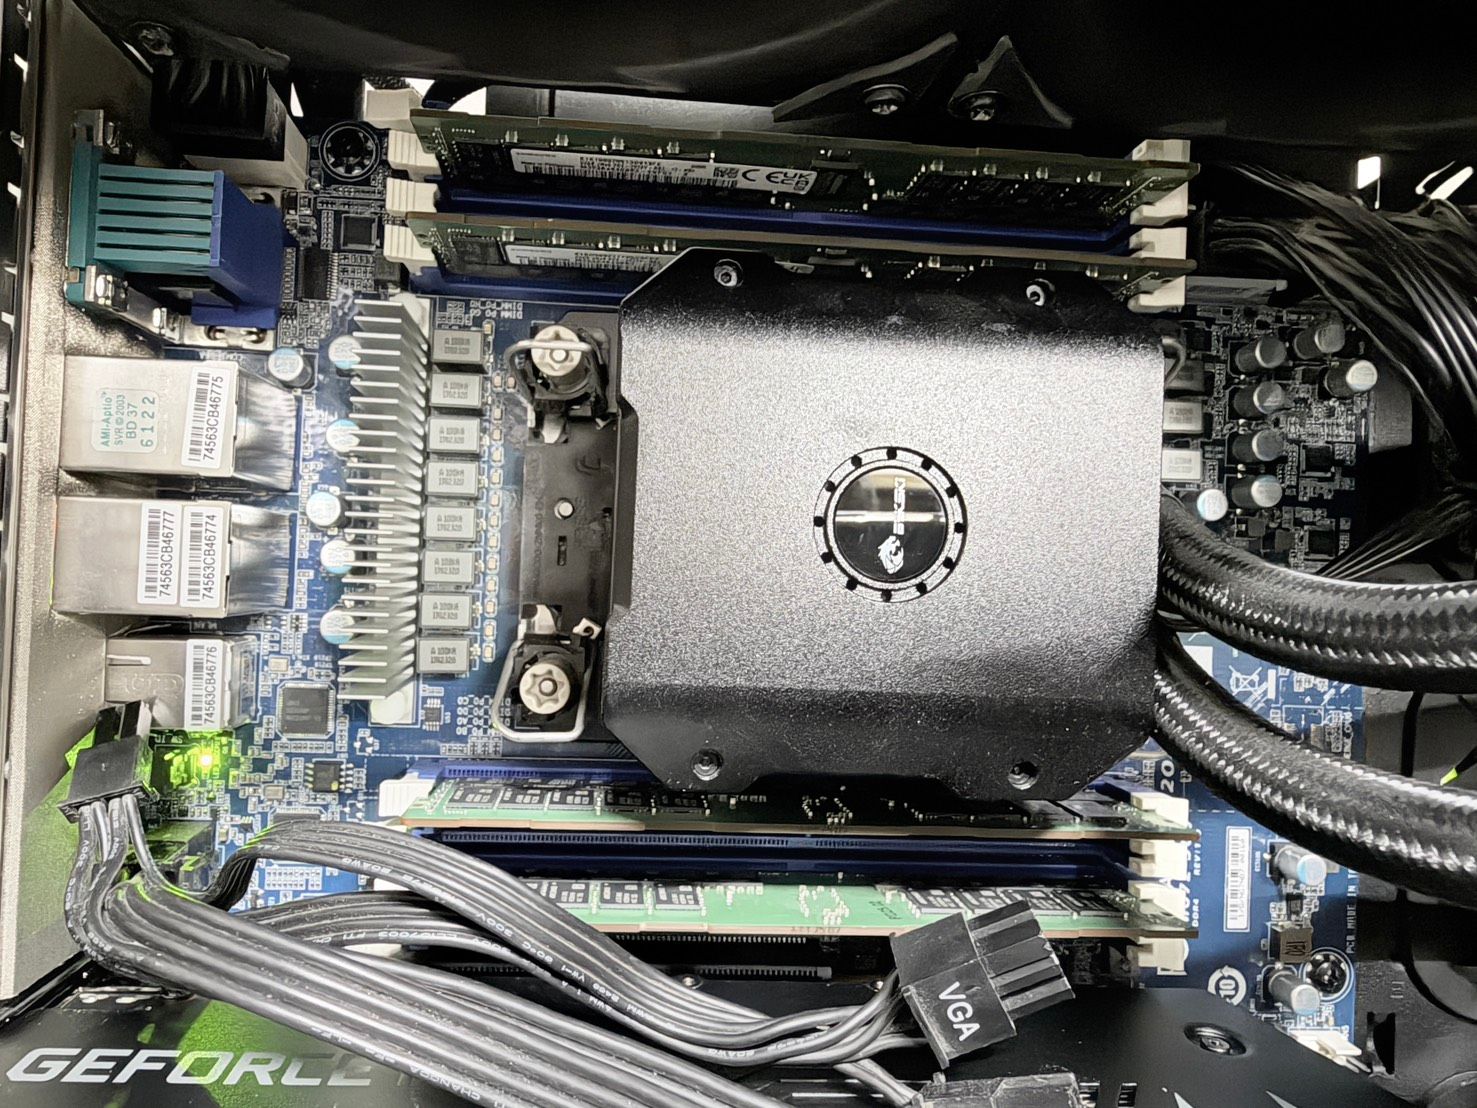
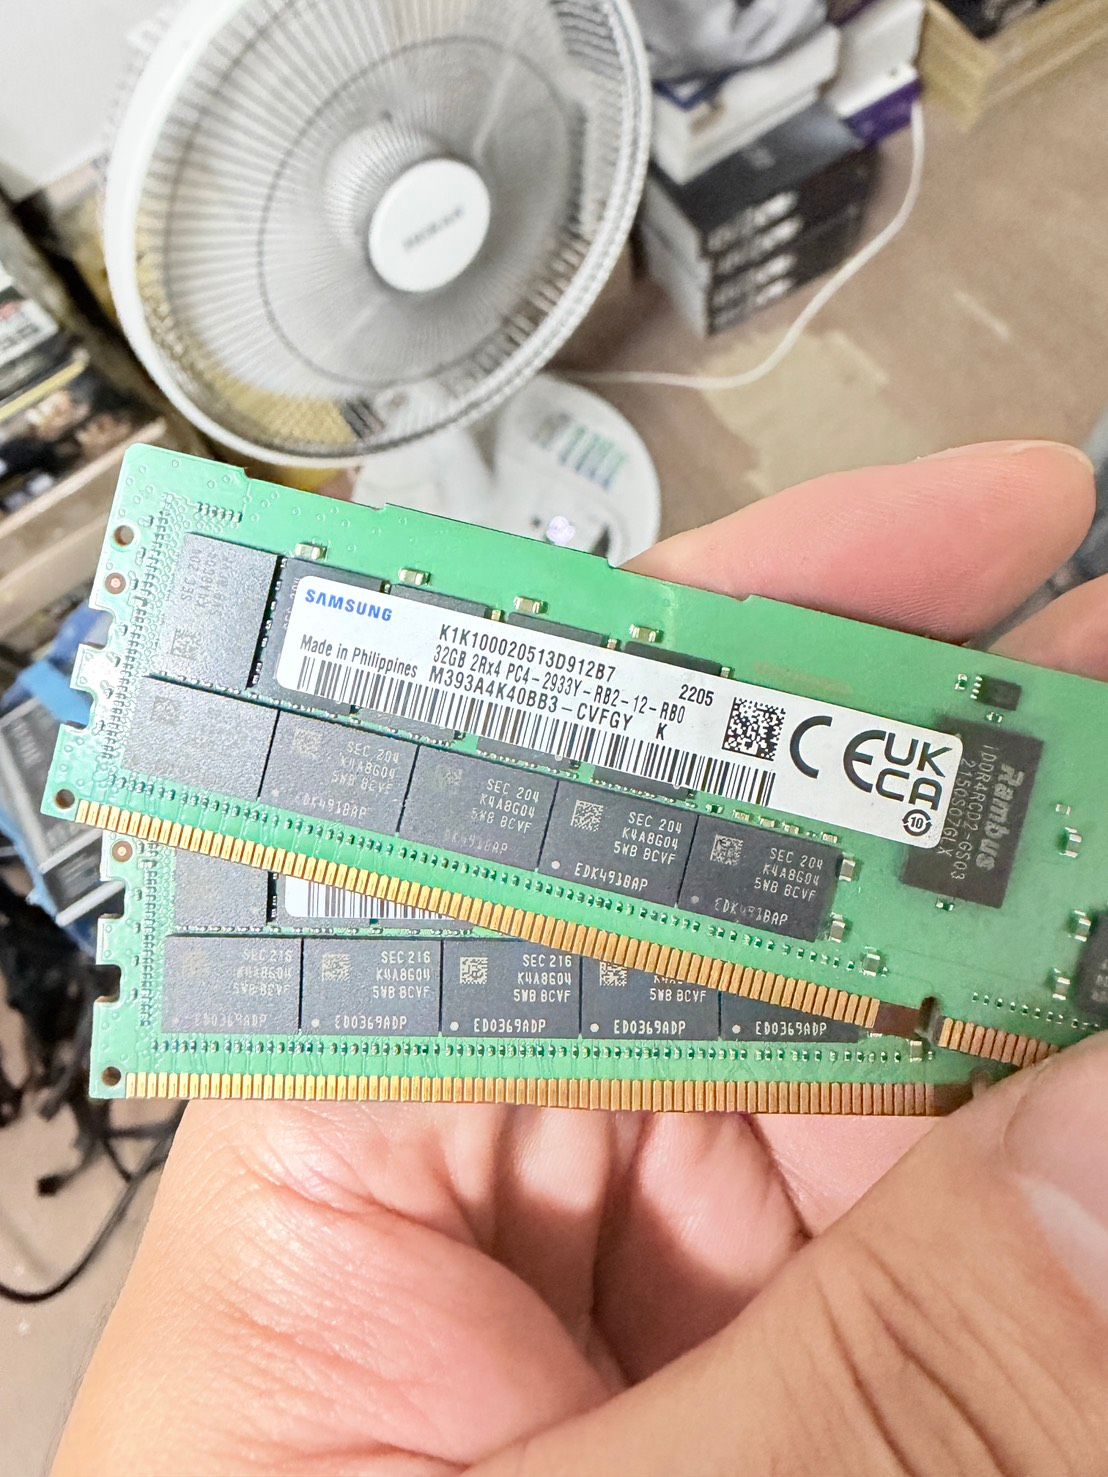
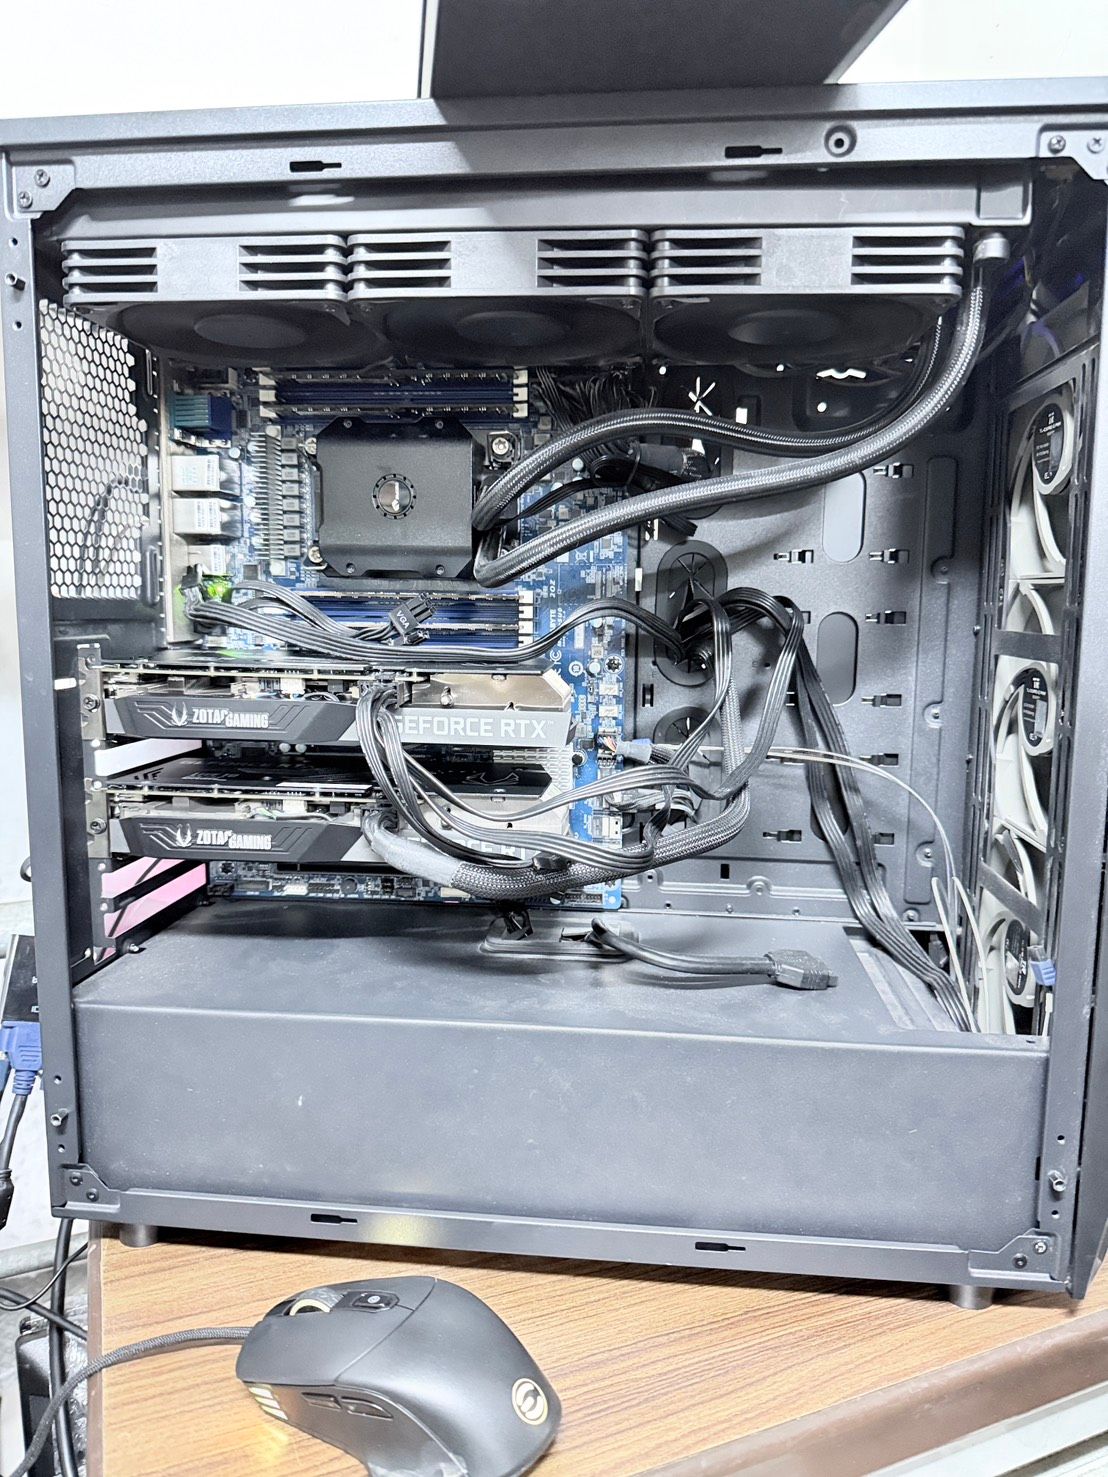
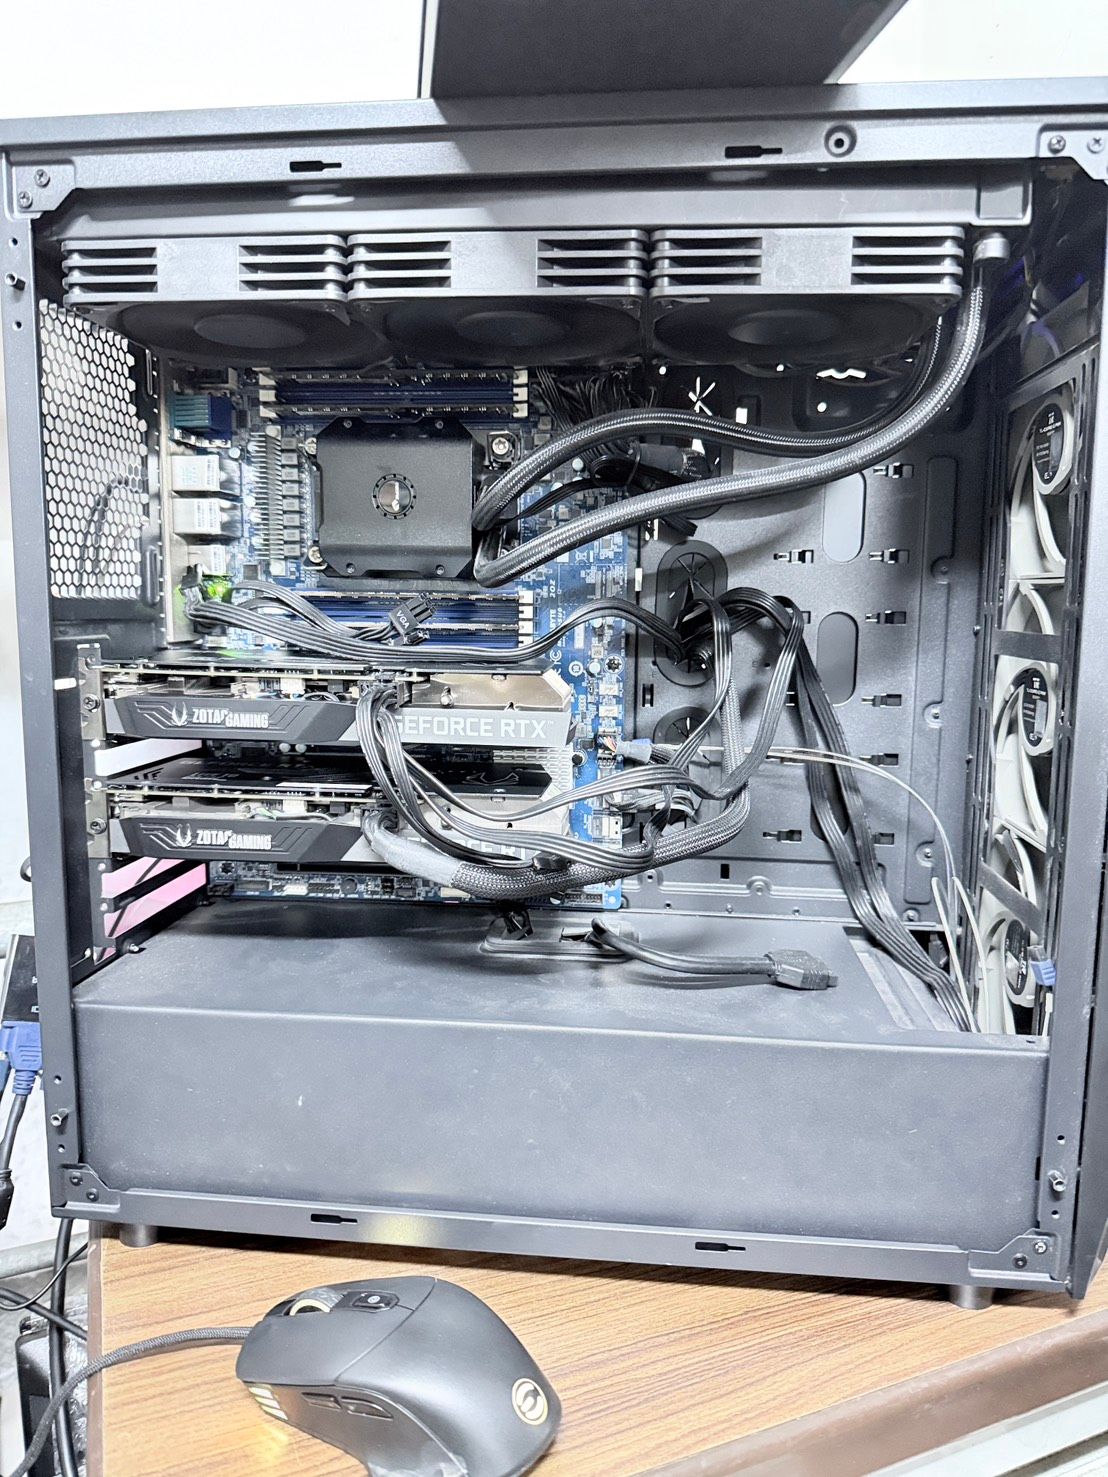
    多補了幾張,暫時退役的憾訊7900XTX 24G,三星32G DDR4-2933,索泰RTX3060 12GB,處理器是XEON 8368Q ES版本,主機板 MA72-SU0 技嘉伺服器板子,當初買來掛天堂M的,幾年過去居然還能再戰!!


  • 秀秀我的雙六爺,還是挺能打的
    CHIA AN YANGC CHIA AN YANG
    装备秀 rtx3060 多卡部署

    @terry 老硬件了,我來補一下,發揮裝備瀑布的效果


  • 六爺再次披甲上陣 # 用雙 RTX 3060/12GB 跑 Strata Qwen3.8 Flash Next IQ3_S:硬體清單、256K上下文,實測速度約50上下tok/s
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 rtx3060 strata qwen-flash

    @johnnybegood 真的,哈哈,六爺是老特版主在視頻裡面提到的,我順勢拿來用,哈,滿舒服的,但就是有點耗電了


  • 秀秀我的雙六爺,還是挺能打的
    CHIA AN YANGC CHIA AN YANG
    装备秀 rtx3060 多卡部署

    S__25878610_0.jpg
    S__25878611_0.jpg
    S__25878612_0.jpg
    S__25878613_0.jpg
    S__25878614_0.jpg
    S__25878615_0.jpg
    S__25878565.jpg

    秀秀我的雙六爺,還是挺能打的

    完整硬體清單

    部件 本次核對結果
    主機板 GIGABYTE MU72-SU0-00,Intel C621A,單路 LGA4189;主機板有 8 個 DDR4 DIMM 插槽,支援 8 通道 ECC Registered RAM(具錯誤更正的暫存式記憶體)。GIGABYTE 主機板規格
    CPU Intel Xeon Ice Lake-SP 世代,38 核心 / 76 執行緒,單一 NUMA node(記憶體區域節點),有 AVX-512。lscpu 的商品名稱只回報 Genuine Intel(R) CPU 0000%@,因此確切 CPU 型號未能確認
    RAM Linux lsmem 顯示 128 GiB online。實際 DIMM 數量、廠牌、速度及目前啟用幾個記憶體通道未重新核對;「主機板支援 8 通道」不等於目前已啟用 8 通道
    GPU 2 張 NVIDIA GeForce RTX 3060 12GB,CUDA index 0、1;GPU 0 的 PCI bus 是 0000:51:00.0,GPU 1 是 0000:c3:00.0。兩張卡的 power limit(功耗上限)各 170W;桌面主顯示卡在 GPU 1
    GPU 連線 推論負載期間 nvidia-smi 取樣顯示兩卡各為 PCIe Gen4 x16;兩卡間 nvidia-smi topo -m 顯示 NODE(經同一 NUMA node 的 PCIe / host bridge 路徑),沒有 NVLink 標記。閒置時 PCIe 連線世代可能省電降速
    顯存規格 一款 GIGABYTE RTX 3060 12GB 板卡列出 GDDR6、360 GB/s 名目頻寬;這是該型號規格,不是本次實測的顯存 GB/s。GIGABYTE RTX 3060 規格
    其他顯示裝置 主機板上的 ASPEED AST2600 BMC 顯示裝置,PCI 0000:06:00.0;Strata 推理使用兩張 NVIDIA GPU
    有線網路 主機板規格有 2 × Intel I210-AT 1GbE 網路埠和獨立 BMC 管理埠;Strata 僅綁 localhost 127.0.0.1,網路介面不在本次 GPU 推理計算路徑上。GIGABYTE MU72-SU0 規格
    SSD MSI M450 1TB NVMe SSD;Strata/Qwen 資料位於本機 NVMe。測量當時根分割區約 916GiB,剩餘約 31GiB
    作業系統 Ubuntu 24.04.4 LTS,Linux kernel 7.0.0-34-generic,x86-64
    NVIDIA 軟體 Driver 595.84;nvidia-smi 顯示 CUDA Version 13.2,這是驅動相容版本,不代表引擎用 13.2 編譯。Strata 本機建置紀錄使用 CUDA Toolkit 12.0
    Strata v0.1.40.1,commit 82f46a8,引擎 v0.1.40,Python 3.12.3。Strata v0.1.40.1 release
    電源 / 散熱 電源供應器型號、CPU/GPU 散熱器與機殼風道未量測;本文不推論是否有供電或散熱限制
    整機功耗 使用者補充:待機約 200W,雙卡全速推理約 500W。此為整機觀測值,量測位置/工具未註明;不是 nvidia-smi 的單卡功耗讀值

  • 六爺再次披甲上陣 # 用雙 RTX 3060/12GB 跑 Strata Qwen3.8 Flash Next IQ3_S:硬體清單、256K上下文,實測速度約50上下tok/s
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 rtx3060 strata qwen-flash

    S__25878565.jpg
    潛水太久了,看大家都再玩strata,這次請出六爺再次披甲上陣

    用雙 RTX 3060/12GB 跑 Strata Qwen3.8 Flash Next IQ3_S:硬體清單、實測速度約50上下tok/s

    **測試日期:**2026-10-07
    **文章目的:**分享一套本機可重現的 Strata 設定,並用實測說清楚推理速度受到哪些硬體影響。
    **測試範圍:**Qwen3.8-Flash-Next IQ3_S,沒有測 Q2_0。本文數字只代表這台主機和這些 prompt,不是所有 RTX 3060 或所有模型都能得到的保證值。

    先看答案

    • 這台機器最快的已測設定,是兩張 RTX 3060 一起跑,context 256K、KV int8,並把 --pcie-frac 設成 0.20、--spec-min-p 設成 0.70。
    • 短 prompt 的 decode 校準中位數從 43.3 升到 54.3 tok/s(約快 25%)。同一份 235K prompt 的長上下文對照,decode 從 38.2 升到 41.8 tok/s(約快 9.4%);prefill 幾乎沒有變化。
    • 同一份 120K prompt 改成單卡 128K,反而比雙卡 128K 慢:單卡總耗時 124.1 秒,雙卡 70.6 秒。
    • 目前最明確的限制是顯存容量與 expert-cache(專家快取)/PCIe/CPU 的分流。這次沒有測到 GDDR6 的實際 GB/s,不能說顯存頻寬已經跑滿。

    1. 測試主機:完整硬體清單

    以下列出這台推理主機中,已實際核對的硬體和版本;沒核對到的欄位明確標示,不用猜測補上。

    部件 本次核對結果
    主機板 GIGABYTE MU72-SU0-00,Intel C621A,單路 LGA4189;主機板有 8 個 DDR4 DIMM 插槽,支援 8 通道 ECC Registered RAM(具錯誤更正的暫存式記憶體)。GIGABYTE 主機板規格
    CPU Intel Xeon Ice Lake-SP 世代,38 核心 / 76 執行緒,單一 NUMA node(記憶體區域節點),有 AVX-512。lscpu 的商品名稱只回報 Genuine Intel(R) CPU 0000%@,因此確切 CPU 型號未能確認
    RAM Linux lsmem 顯示 128 GiB online。實際 DIMM 數量、廠牌、速度及目前啟用幾個記憶體通道未重新核對;「主機板支援 8 通道」不等於目前已啟用 8 通道
    GPU 2 張 NVIDIA GeForce RTX 3060 12GB,CUDA index 0、1;GPU 0 的 PCI bus 是 0000:51:00.0,GPU 1 是 0000:c3:00.0。兩張卡的 power limit(功耗上限)各 170W;桌面主顯示卡在 GPU 1
    GPU 連線 推論負載期間 nvidia-smi 取樣顯示兩卡各為 PCIe Gen4 x16;兩卡間 nvidia-smi topo -m 顯示 NODE(經同一 NUMA node 的 PCIe / host bridge 路徑),沒有 NVLink 標記。閒置時 PCIe 連線世代可能省電降速
    顯存規格 一款 GIGABYTE RTX 3060 12GB 板卡列出 GDDR6、360 GB/s 名目頻寬;這是該型號規格,不是本次實測的顯存 GB/s。GIGABYTE RTX 3060 規格
    其他顯示裝置 主機板上的 ASPEED AST2600 BMC 顯示裝置,PCI 0000:06:00.0;Strata 推理使用兩張 NVIDIA GPU
    有線網路 主機板規格有 2 × Intel I210-AT 1GbE 網路埠和獨立 BMC 管理埠;Strata 僅綁 localhost 127.0.0.1,網路介面不在本次 GPU 推理計算路徑上。GIGABYTE MU72-SU0 規格
    SSD MSI M450 1TB NVMe SSD;Strata/Qwen 資料位於本機 NVMe。測量當時根分割區約 916GiB,剩餘約 31GiB
    作業系統 Ubuntu 24.04.4 LTS,Linux kernel 7.0.0-34-generic,x86-64
    NVIDIA 軟體 Driver 595.84;nvidia-smi 顯示 CUDA Version 13.2,這是驅動相容版本,不代表引擎用 13.2 編譯。Strata 本機建置紀錄使用 CUDA Toolkit 12.0
    Strata v0.1.40.1,commit 82f46a8,引擎 v0.1.40,Python 3.12.3。Strata v0.1.40.1 release
    電源 / 散熱 電源供應器型號、CPU/GPU 散熱器與機殼風道未量測;本文不推論是否有供電或散熱限制
    整機功耗 使用者補充:待機約 200W,雙卡全速推理約 500W。此為整機觀測值,量測位置/工具未註明;不是 nvidia-smi 的單卡功耗讀值

    **RAM 與安裝空間注意:**本機辨識到 128 GiB RAM,但 DIMM 插法和實際記憶體頻寬未知。Strata 官方將 96GB 以上列為 IQ3_S 建議區間;本次安裝的 IQ3_S 兩個模型 shard 約 83.6GB,還有 pack、MTP 草稿資料與其他檔案。新安裝建議預留約 90–100GB SSD 空間。當時這台 SSD 剩 31GB,所以是沿用已安裝的模型做測試,不是重新下載。 Strata 安裝指南

    2. 新手名詞小抄

    • MoE(Mixture of Experts,混合專家模型):模型中有許多「專家子網路」,每個 token 只啟用其中一部分。Qwen 官方模型卡列出這個模型總參數約 125B、啟用參數約 6B;每個 MoE 層有 512 個 experts,每個 token 使用 10 個 routed experts 和 1 個 shared expert。Qwen 官方模型卡
    • Expert(專家):MoE 裡負責計算的一組權重。
    • Expert cache(專家快取):顯卡記憶體先存常用 experts;沒存到的叫 cache miss(快取未命中)。Strata 說多 1GB VRAM 約能多留 700 個 experts,但實際收益依模型和 GPU 而異。Strata 架構說明
    • VRAM / 顯存容量:GPU 上能放多少模型資料、expert cache 和 KV cache。
    • GDDR 顯存頻寬:GPU 核心從顯存讀寫資料的傳輸規格;和「顯存容量」不同。
    • PCIe:CPU/主機 RAM 和 GPU 之間的連線。未命中 expert cache 的權重可以留給 CPU 算,也可以用 --pcie-frac 把一部分送到 GPU 算。
    • KV cache(Key/Value 注意力快取):模型保留已讀 token 的注意力狀態,不是模型權重。
    • Prefill(提示詞讀入):讀取 prompt、系統提示與對話歷史;主要影響第一個 token 要等多久。
    • Decode(逐 token 生成):模型一個 token 接一個 token 寫答案;常用 tok/s 表示每秒 token 數。
    • MTP(Multi-Token Prediction,多 token 預測):草稿層先猜後續 token,再由主模型驗證。
    • Layer split(模型層切分):一張卡跑模型前段層,另一張卡跑後段層;兩張卡不是合成一塊可互換資料的 24GB VRAM。Strata 多 GPU 文件

    3. Strata 怎麼使用這台電腦

    Qwen3.8-Flash-Next 有很多 experts,全部放不進一張 12GB 顯卡。Strata 把完整 experts 放在主機 RAM,顯存保存常用 experts;遇到沒駐留在 GPU 的 expert 時,CPU 可直接由 RAM 計算,也可依 --pcie-frac 把一部分 misses 透過 PCIe 交給 GPU。GPU 顯存還要放共同模型層、KV cache、MTP 和 prompt 暫存區。Strata How it works

    雙卡 layer split 時,每張卡各有自己 layer 的 expert cache。Strata 文件說 token 在兩卡間是每個 verify window(草稿驗證批次)交接一次小量資料,不是每一層都來回搬。因此兩卡的主要價值是分攤模型層、增加總 expert cache;不需要假設有 NVLink 才能工作。Strata Multi-GPU 文件

    4. 新手安裝與設定:一步一步照做

    以下是 Linux 新安裝範例,固定使用本次測試的 Strata 版本和 IQ3_S。模型下載前先確認 SSD 有約 90–100GB 可用空間:

    git clone --depth 1 --branch v0.1.40.1 https://github.com/Niko1221/Strata.git
    cd Strata
    ./setup.sh --family qwen --model IQ3_S --context 262144 --gpus 0,1 --vision no --no-start --yes
    

    nvidia-smi 會列出你的 GPU index(編號);若不是 0、1,請把 --gpus 換成自己的編號。Windows 用官方 START-HERE.bat 回答同樣選項即可。setup 顯示的 RAM 警告要照做:官方資料指出 64GB 上的 IQ3_S 256K context 可能接近記憶體限制,建議依 RAM 選較小 context。Qwen 模型原生 context 是 262,144 tokens。Strata setup flags Qwen 官方 context 規格

    修改設定前先備份

    在 Strata 目錄先備份 setup 產生的 JSON:

    cp -a strata-iq3_s.json "strata-iq3_s.json.bak_$(date +%Y%m%d_%H%M%S)"
    nano strata-iq3_s.json
    

    在 JSON 的 args 陣列中保留 setup 產生的 --pack、--native、--ple-gguf、--mtp 等路徑,只檢查下面參數;不要把這個表當成整份 JSON 覆蓋貼上,也不要在 args 中重複放同一個 flag。

    flag 本機勝出值 說明
    --expert-cache auto 依剩餘顯存自動配置 expert cache
    --prefill auto 本機雙卡實際挑到 8,192-token prompt chunk
    --spec 4 MTP 草稿驗證深度
    --spec-min-p 0.70 草稿層再多猜一個 token 前的門檻;本機校準值
    --max-context 262144 最大總 context,輸入與輸出都要算進去
    --kv int8 KV cache 使用 int8
    --kv-resident 32768 每層 32,768 cells 留在顯存,其餘用 pinned RAM 支援
    --pcie-frac 0.20 未命中顯存的 experts 中,送 PCIe 給 GPU 計算的比例;本機校準勝出
    JSON gpu [0,1] 同時使用兩張卡,編號依 nvidia-smi
    JSON layer_split "auto" Strata 自動切分兩卡模型層

    本機沒有加 --pool-workers,引擎自動用 37 個 CPU workers(工作執行緒);校準顯示這比 25、18、9 workers 快。別的 CPU 不一定應設 37,先跑校準。

    啟動並驗證

    ./run-iq3_s.sh
    

    首次啟動會將約 47 GiB experts 載入 RAM,通常要等一到兩分鐘。看到 ready 後,開另一個終端機:

    curl -fsS http://127.0.0.1:8080/health | python3 -m json.tool
    curl -fsS http://127.0.0.1:8080/slots | python3 -m json.tool
    nvidia-smi
    

    /health 應顯示 loaded: true、max_context: 262144;/slots 應顯示 n_ctx: 262144。瀏覽器可開 http://127.0.0.1:8080/。下面的 curl 只檢查 API 有回應,短 prompt 不代表長 context 速度:

    curl -fsS http://127.0.0.1:8080/v1/chat/completions \
      -H 'Content-Type: application/json' \
      -d '{"model":"qwen3.8-flash-next-iq3_s","messages":[{"role":"user","content":"只回覆 READY"}],"max_tokens":128,"temperature":0}' \
      | python3 -m json.tool
    

    自己測速:不要把 prefill 和 decode 混在一起

    1. 確認沒有其他模型或使用者同時佔用 GPU。
    2. 固定模型量化、prompt token 數、max_tokens(最大輸出 token)、溫度和思考模式;每個設定至少測 3 次取中位數。
    3. 同一 prompt 重跑時,確認 Strata 的 cache_n / reused tokens 是 0,或重新啟動引擎,避免把 prompt cache(提示詞快取)命中誤認成硬體加速。
    4. 記錄 API response 的 timings.prompt_per_second(prefill)和 timings.predicted_per_second(decode)、usage.prompt_tokens 和 completion_tokens。也另記 wall time(實際總等待時間);它還可能包含 queue / tokenize 等非 GPU 推論時間。
    5. 256K 是總 context,不是可放 262,144 個輸入再加輸出。本文用約 235K prompt + 128 output,保留模板和輸出空間。

    看硬體時可用:

    nvidia-smi --query-gpu=index,name,memory.used,memory.total,utilization.gpu,utilization.memory,power.draw,power.limit,pcie.link.gen.current,pcie.link.width.current --format=csv
    

    NVIDIA 的 utilization.gpu 是取樣期間有 kernel 執行的時間比例;utilization.memory 是顯存正在讀寫的時間比例,不是「顯存頻寬已用掉幾成」。NVIDIA 指標定義

    第一次安裝後可用 ./setup.sh --calibrate 自動測本機 PCIe expert 分流、草稿門檻和 CPU workers,需約 5–10 分鐘並會更新 model JSON;先備份、等服務閒置再跑。Strata 校準說明

    5. 本機實測:把數字拆開看

    Decode 校準

    設定 短 prompt decode 中位數
    預設 pcie-frac 0.55 / spec-min-p 0.50 43.3 tok/s
    校準 pcie-frac 0.20 / spec-min-p 0.70 54.3 tok/s

    本機校準提升約 25.3%,但這是校準短 prompt 的結果,長 context 不會保證同幅度。

    同一份 235K prompt:原設定 vs 校準設定

    兩輪使用同一份 235,016-token prompt、同一個 128-token 輸出上限:

    設定 Prefill Decode HTTP wall time
    原設定 1,744.6 tok/s 38.2 tok/s 139.1 秒
    校準後 1,747.3 tok/s 41.8 tok/s 138.6 秒

    prefill 幾乎相同;總 wall time 只少約半秒,因 235K prompt 讀入約佔 134.5 秒。兩次都達到 128-token 上限,這是吞吐量測,不是回答品質比較。

    128K context:雙卡 vs 單卡

    使用同一份 119,992-token prompt、相同 128-token 輸出上限;單卡也先獨立校準:

    配置 Prefill Decode HTTP wall time
    雙 RTX 3060 1,786 tok/s 44.8 tok/s 70.6 秒
    單 RTX 3060 997 tok/s 40.4 tok/s 124.1 秒

    單卡 prefill 約慢 44%、decode 約慢 10%、總耗時多約 76%。單卡啟動日誌配置 2,377 個 expert-cache slots(4.57 GiB);雙卡則各自保存所屬 layer 的 cache。slots 會隨 context 和顯存狀況改變,因此表格用同 prompt 的速度做直接比較,不把不同 context 下的 cache slots 當成完全同條件數字。

    加大 prefill chunk 上限沒有讓引擎實際用更大 chunk

    --prefill 65K prompt 235K prompt 引擎實際 chunk
    auto 1,712.8 tok/s 1,742.9 tok/s 8,192
    auto:16384 1,710.7 tok/s 1,743.9 tok/s 8,192
    auto:32768 1,710.6 tok/s 1,744.3 tok/s 8,192

    雙卡中 CUDA1 的 cache slots 不足以借出更大 prompt buffer,所以三種設定實際都用 8,192-token chunk;32K 設定還出現 slots 不足警告。正式設定保留 --prefill auto。

    另測 K8V4(INT8 K + 旋轉 4-bit V 的 KV 格式):235K prompt prefill 1,613 tok/s,int8 為 1,747 tok/s。K8V4 雖把 pinned KV RAM 約從 1.55 GiB 降至 1.20 GiB,但沒有加快這台機器的 prompt 讀入。兩者生成 token 數不同,因此不把 decode 數字當成嚴格 A/B。

    6. 瓶頸分析:顯存容量、顯存頻寬還是主機 RAM?

    顯存容量:這台最明確的硬體限制

    推論時以 1 秒間隔取樣 39 次,每張卡用了約 11.7–11.9 GiB / 12 GiB;Strata expert cache 合計約 11.5 GiB。GPU 還要放共同層、KV cache、MTP 草稿層和 prompt buffer。對這種 MoE 模型,顯存裝得下更多常用 experts,就能少走 CPU miss 路徑;Strata 文件估計每多 1GB VRAM 約能多留 700 個 experts。Strata 架構說明

    GDDR 頻寬:沒有證據顯示已跑滿

    推論取樣期間,兩卡 GPU kernel 活躍時間平均約 84–86%,但 memory-active 平均約 55–58%、取樣最高約 80%。這表示 GPU 很忙,但不能直接推成 GDDR6 頻寬已到 360 GB/s;本次沒有讀取 DRAM bytes/s。應說「目前未測得飽和」,不能說「頻寬絕不會是瓶頸」。

    主機 RAM:容量夠,頻寬仍未知

    系統有 128 GiB online,推論時約 56–57 GiB available,Swap 幾乎為零;Strata 能把 experts 和 streamed KV 放進 RAM,所以本機 RAM 容量不是瓶頸。CPU 全機平均利用率約 6.9%,但 76 個邏輯執行緒的整體平均不能排除少數 worker 或 RAM 通道很忙。實體 DIMM/通道及 RAM bandwidth 未測。

    PCIe / CPU expert-miss 分流:已證明影響 decode

    235K prompt 的原設定約 11.9% routed experts 走 PCIe 給 GPU;校準後約 2.2%,decode 從 38.2 升到 41.8 tok/s。這支持「本機讓較多 misses 留給 CPU 計算,比搬更多 experts 過 PCIe 更有效」;不代表 PCIe Gen4 x16 的實體頻寬已經滿載。Strata 的 expert-cache hit-rate 會排除一部分 PCIe offload,因此數字可能隨 --pcie-frac 改變,不可單獨用它判斷速度。Strata issue #588

    7. 給朋友的抄作業結論

    對本文這套雙 12GB RTX 3060 + 128 GiB RAM + IQ3_S:

    1. 保留雙卡 layer split;同 prompt 測試顯示單卡 128K 更慢。
    2. 正式設定用 --pcie-frac 0.20、--spec-min-p 0.70;這是本機校準值,不保證其他 CPU/GPU 組合一樣。
    3. 保留 --prefill auto、KV int8、--kv-resident 32768;加大 prefill chunk 上限沒有增加實際 chunk。
    4. 若有資源升級需求,更多可用 VRAM 有比只追求更高 GDDR 頻寬更直接的依據;但本文沒有做不同顯卡的實體升級 A/B。
    5. 128K 只適合輸入加輸出總長在 128K 內的工作;235K 對話不能用 128K context。

    參考資料

    1. Qwen3.8-Flash-Next 官方模型卡 — 125B 總參數、啟用參數、experts 與原生 262,144 context。
    2. Strata v0.1.40.1 release — 本次軟體版本。
    3. Strata AI Setup — IQ3_S RAM 建議、安裝與 GPU/context 選項。
    4. Strata How it works — expert cache、VRAM/RAM/CPU 分工。
    5. Strata Multi-GPU — layer split、卡間交接與限制。
    6. Strata issue #588 — PCIe expert offload 與 cache hit-rate 的意義。
    7. NVIDIA nvidia-smi 文件 — GPU/memory utilization 和 PCIe link 指標定義。
    8. GIGABYTE RTX 3060 12GB 規格 — 一款 RTX 3060 12GB 板卡的 GDDR6 規格。

    **已知缺口:**CPU 精確 SKU、實際 DIMM 數量/通道、RAM 頻寬、DRAM 實際 GB/s、電源供應器與散熱器未核實或未量測。本文所有速度只代表上述本機 IQ3_S 測試;Q2_0 未測。


  • 【直播】4卡R9700从采购到调试
    CHIA AN YANGC CHIA AN YANG
    AI硬件 r9700 多卡部署

    有點好奇需求是跑什麼,這樣的高預算感覺4090d 48g魔改 兩張會不會比較好?


  • (15/9第二次更新)為 gfx1100 用戶追回軟件算力:GIGABYTE W7800 48G 單卡跑通 AMD 原版 Quark INT4,DSH 真實負載七日 +22%(50.9 → 62.11 t/s)
    CHIA AN YANGC CHIA AN YANG
    AI硬件 w7800 rocm 量化

    讀完,,讓ai翻譯,20-24k上下文,感覺生產力不夠?

    直接幫你抽取出「實際開多少上下文」與「實際輸出速度(Token/s)」,對比清清楚楚:


    一、他到底測了什麼?(平台環境)

    • 顯示卡:AMD 專業卡 Radeon PRO W7800 48GB(單卡,跟你的 7900 XTX 一樣是 RDNA3 / gfx1100 架構,但你的 7900 XTX 運算單元比他強!他 70 CU,你的 7900 XTX 是 96 CU 滿血版)。
    • 跑的模型:Qwen3.8-27B(INT4 量化版)。
    • 跑的框架:SGLang(透過魔改支援 AMD ROCm / RDNA3)。

    二、實際「上下文」開多少?實際「Token 速度」多少?

    作者測了 兩種情境(這就是為什麼文章裡數字跳來跳去):

    1. 【真實 Agent 重度工作負載】(對話很長時,也就是你目前關心的指標)
    • 實際上下文深度(Context):約 20,000 ~ 24,000 Tokens (20K~24K)
      (原文數據:full token 20,004 – 20,944,複驗中位數 24,299)
    • 實際解碼輸出速度(Decode Throughput):
      👉 61.5 ~ 62.11 t/s(Token/秒)
      (這是在吃滿 2 萬多字上下文的情況下,每秒還能吐出 62 個字!)
    1. 【短提示單流測試】(問一句簡短問題時)
    • 實際上下文深度(Context):短提示(極小上下文)
    • 實際解碼輸出速度(Decode Throughput):
      👉 85.05 t/s(Token/秒)
      (如果開啟他改寫的 DFLASH 投機解碼,短文最快甚至能飆到 92.57 t/s)

    三、三行白話文總結他整篇在講什麼:

    1. 上下文越長越慢:上下文在短的時候能跑 85 t/s,但當上下文吃到 20K~24K 時,速度會掉到 62 t/s。
    2. AMD 顯卡跑大模型有搞頭:他證明了 AMD RDNA3(gfx1100)單張顯卡跑 27B 大模型,即使上下文塞了 2 萬字,依然能有 62 t/s 的極高實用速度。
    3. 對店長 7900 XTX 的意義:你的 7900 XTX 算力核心(96 CU)比這張 W7800(70 CU)高出近 37%,只要顯存放得下,在類似架構下的理論推論速度只會比他更快!

  • Deepseek v4.1 flash , 4台DGX spark GB10, TP=4
    CHIA AN YANGC CHIA AN YANG
    LLM讨论区 deepseek dgxspark gb10

    好文,謝謝無私分享


  • GPT 5.6-SOL, 真的需要钞能力
    CHIA AN YANGC CHIA AN YANG
    AI Agent gpt openai r9700

    不訂閱真的不敢用gpt ..


  • GPT Pro 5x 實測:用 GPT 6 重做一套管理系統,單一任務燒掉約 20% 週額度
    CHIA AN YANGC CHIA AN YANG
    AI Agent gpt 编程

    認真的有夠燒,plus改一段代碼,就5h額度燒沒了,但事情是真的搞定,還外加很多額外

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组