跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
E

exe127

@exe127
劳动模范
取消关注 关注
关于
帖子
57
主题
7
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 昨天7900xtx到手, 新手馬上試了一下QWEN本地模型...
    E exe127
    LLM讨论区 7900xtx

    昨天7900xtx到手, 新手馬上試了一下Qwen3.6-27B 本地模型...
    過程中完全依靠gemini的幫助安裝 llama cpp + ROCM+QWEN , 可能我安裝的是 ubuntu 26.04 LTS, gemini也折騰了一陣子, 才順利把ROCM驅動裝起來.

    ~/llama.cpp/build/bin/llama-server -m ~/models/Qwen3.6-27B-Q5_K_M.gguf --gpu-layers 99 --port 8080 --host 0.0.0.0

    https://rocm.docs.amd.com/projects/install-on-linux/en/latest/reference/system-requirements.html
    603e8858-b528-4548-98a0-08ada6df3c07-image.jpeg

    把玩了一下, 速度體驗很好. 下一步再折騰一下, 跟隨各位大神用comifyUI 生成5秒視頻, 再把它們拼上試試.


  • [記錄] Google縮減線上免費版能力 , 新手自建本地Qwen 3.8 27b
    E exe127
    LLM讨论区 7900xtx qwen-27b llama.cpp

    感謝此處的各位大師的精華貼, 讓新手的我可以少走歪路.
    剛10月9日, Google縮減線上免費版能力, 只提供flash-lite版AI, 更不再支持讀取文件. 個人本地自建LLM貌似更有必要了.....雖然現在人人都在玩strata, 但我決定不急慢慢學習. 先從llama+Qwen開始. 想在此貼記錄一下自己的步伐. 純新手貼. 多多包涵.

    1)無頭電腦llama.cpp(headless):
    i5 13400
    DDR4 3200 16GBx2
    內顯 UHD730
    7900xtx 24GB

    所用模型, 文件和驅動:
    win11 26H2
    AMD驅動 26.10.41.05 (電源消耗減10%)
    llama-b11540-bin-win-vulkan-x64 (vulkan版)
    Qwen3.8-27B-UD-Q4_K_XL
    mtp-Qwen3.8-27B-Q4_0

    AI啟動指令:

    代码文本
    .\llama-server.exe ^
      -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf ^
      --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf ^
      -dev Vulkan1 ^
      -ngl 999 ^
      --fit off ^
      -c 262144^
      -b 4096 ^
      -ub 512 ^
      --cache-type-k q4_0 ^
      --cache-type-v q4_0 ^
      -np 1 ^
      --spec-type draft-mtp ^
      --spec-draft-n-max 2 ^
      --flash-attn on ^
      --host 0.0.0.0 ^
      --port 8080 ^
      --jinja ^
      -lv 4
    

    結果:
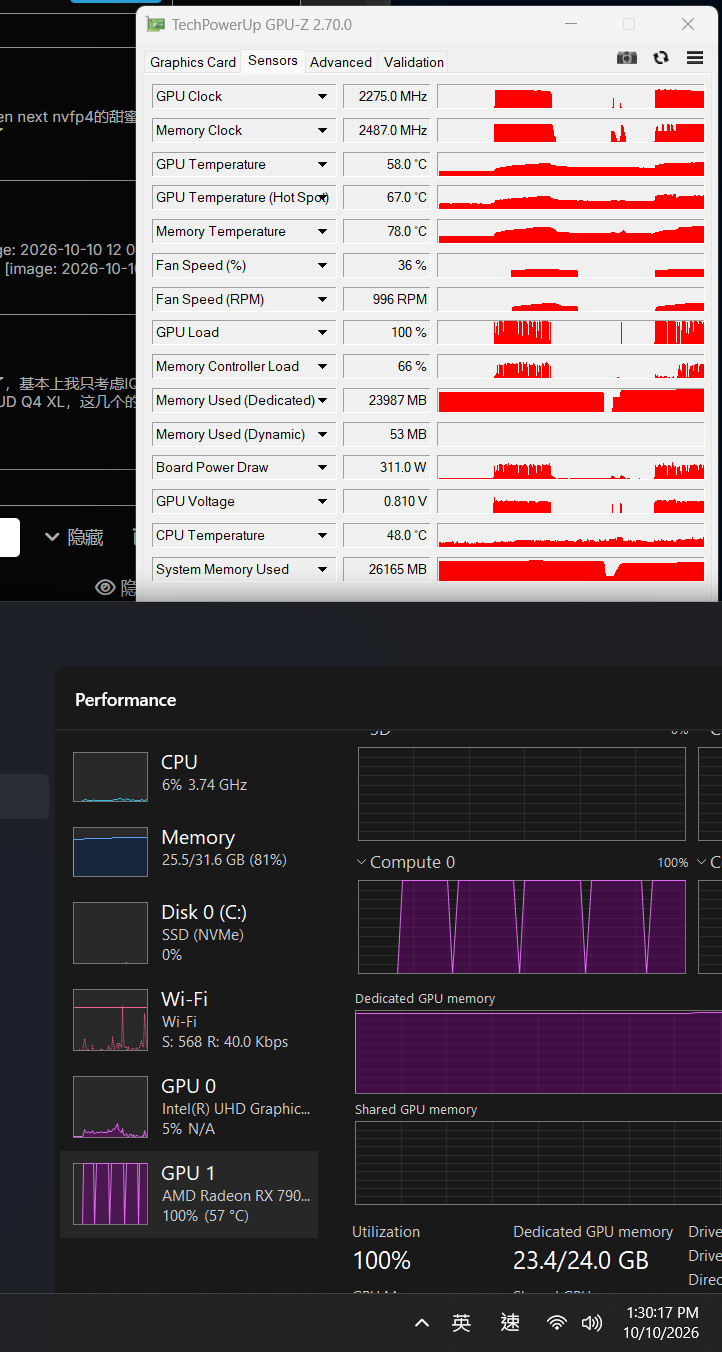
    螢幕擷取畫面 2026-10-10 133049.png
    螢幕擷取畫面 2026-10-10 133023.png

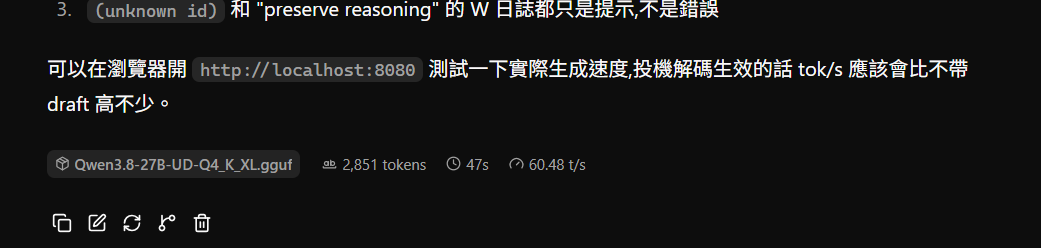
    配置256k上下文的能力, VRAM使用剛好23.4GB, 7900xtx剛好可以處理沒有OOM. 我也很好奇, 為什麼人人都只配64k? 不配置128k呢? 另外, token每秒生成的速度大約60. 不知是不是達標了, 但感覺很可以.

    這裡必須說一下, 有些llama的版本會出現獨顯閒置時, llama強制清空VRAM, 把模型塞回RAM內. 當你發問時, 才把模型由RAM塞回VRAM中. 這個是一個bug, 原因是因為win/AMD十分進取的省電策略, 再加上無頭電腦, 當獨顯閒置時, window強制把VRAM清掉省電. 我看老外都有回報, 解決方法就是確保AMD驅動使用最新, llama的版本就用最新的幾個輪流替換試試. 問題就可以解決.

    下一步必須跑通comfyui+Minimax H3. 謝謝大家


  • AI会夺走越来越多的人的工作,初级文员/程序员等脑力脑洞者率先出局,体力劳动者逐步淘汰,要如何在新的时代养活自己?
    E exe127
    AI危机 ai危机 变现

    😣 過往在新時代之下, 新的工種都會出現. 但AI時代實在強的可怕, 未來的人真的不知道要幹什麼了

  • 【实测】 Qwen3.8-Flash-Next GSQ-RCO IQ3_S,3D鹈鹕骑行动画制作经验分享。
    E exe127
    LLM讨论区 qwen-flash qwen-27b 视频生成

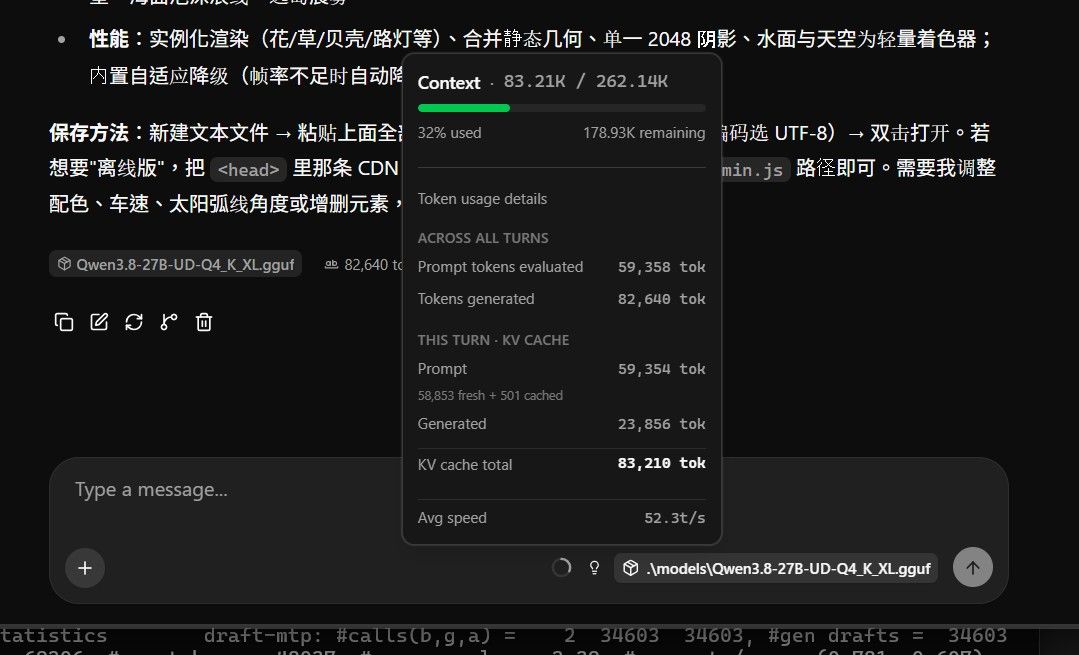
    @gao-Gao 我用你的提示詞, 在llama+qwen 3.8 27B, 限制消耗8萬左右token, 上下文256k.
    最終生成以下代碼. 平均52token每秒, 26分時間. 7900xtx, win11

    bird.html

    image.jpeg


  • 有机会接一些小单,请问我用AMD 7900XTX 24G能够输出短视频么?
    E exe127
    AI音视频画图 7900xtx amd

    有幸看到這個貼, 對於我來說是啟蒙了! 7900xtx , 等待到手


  • 机智罗的V4包发布了,帮助不在墙内的友友共享一下单纯的工作流Json文件
    E exe127
    AI音视频画图 机智罗

    @abaalei 太好了, 有google連結! 這個星期立即試一下

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组