@yi-song 同意! 畢竟付出了就是成本. 最好用個10年就回本了
-
买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业! -
买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业! -
QWEN4准备好了? -
【实测】 Qwen3.8-Flash-Next GSQ-RCO IQ3_S,3D鹈鹕骑行动画制作经验分享。@Henry-Chiu-0
兄弟, 大家交流分享吧. 我也新手上路.
我的:
i5 13400
ddr4 16gb x 2
內顯uhd730
獨顯amd 7900xtx就這
-
【实测】 Qwen3.8-Flash-Next GSQ-RCO IQ3_S,3D鹈鹕骑行动画制作经验分享。 -
Qwen Flash Next for AMD R9700 -
[記錄] Google縮減線上免費版能力 , 新手自建本地Qwen 3.8 27b感謝此處的各位大師的精華貼, 讓新手的我可以少走歪路.
剛10月9日, Google縮減線上免費版能力, 只提供flash-lite版AI, 更不再支持讀取文件. 個人本地自建LLM貌似更有必要了.....雖然現在人人都在玩strata, 但我決定不急慢慢學習. 先從llama+Qwen開始. 想在此貼記錄一下自己的步伐. 純新手貼. 多多包涵.1)無頭電腦llama.cpp(headless):
i5 13400
DDR4 3200 16GBx2
內顯 UHD730
7900xtx 24GB所用模型, 文件和驅動:
win11 26H2
AMD驅動 26.10.41.05 (電源消耗減10%)
llama-b11540-bin-win-vulkan-x64 (vulkan版)
Qwen3.8-27B-UD-Q4_K_XL
mtp-Qwen3.8-27B-Q4_0AI啟動指令:
代码文本
.\llama-server.exe ^
  -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf ^
  --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf ^
  -dev Vulkan1 ^
  -ngl 999 ^
  --fit off ^
  -c 262144^
  -b 4096 ^
  -ub 512 ^
  --cache-type-k q4_0 ^
  --cache-type-v q4_0 ^
  -np 1 ^
  --spec-type draft-mtp ^
  --spec-draft-n-max 2 ^
  --flash-attn on ^
  --host 0.0.0.0 ^
  --port 8080 ^
  --jinja ^
  -lv 4
結果:
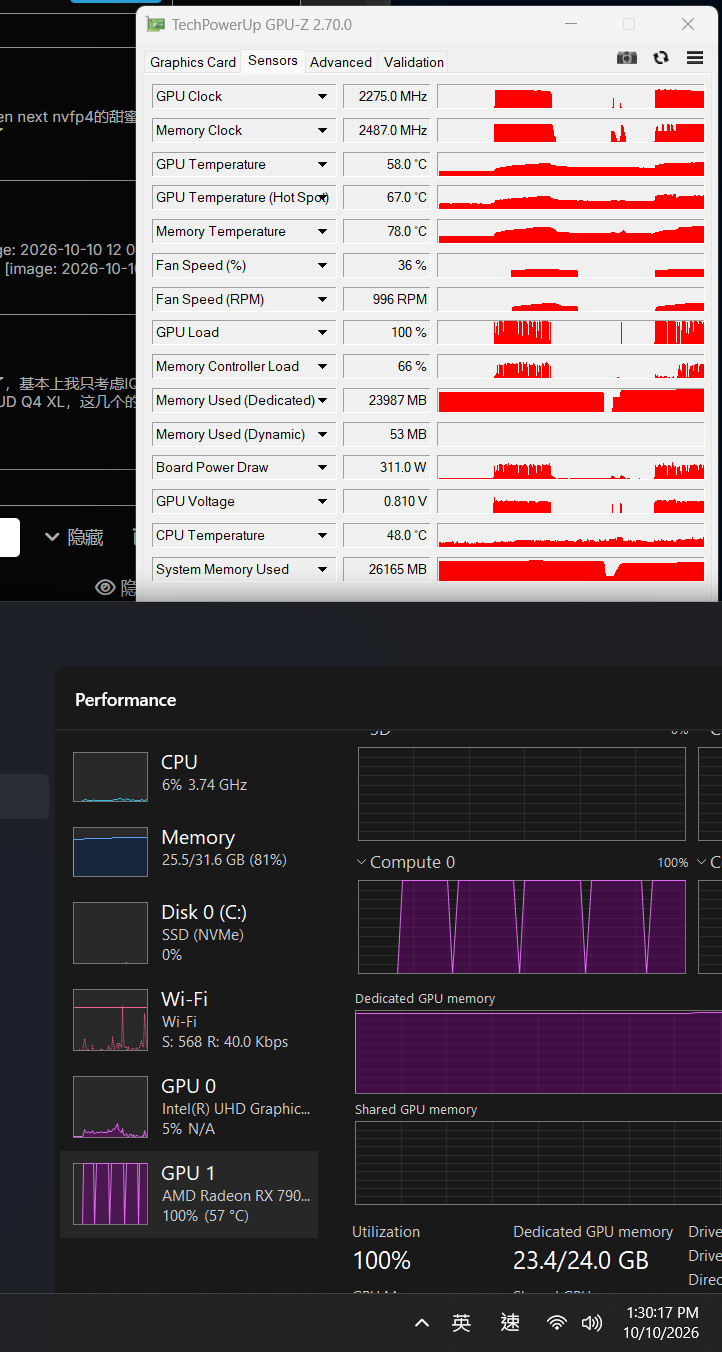
配置256k上下文的能力, VRAM使用剛好23.4GB, 7900xtx剛好可以處理沒有OOM. 我也很好奇, 為什麼人人都只配64k? 不配置128k呢? 另外, token每秒生成的速度大約60. 不知是不是達標了, 但感覺很可以.
這裡必須說一下, 有些llama的版本會出現獨顯閒置時, llama強制清空VRAM, 把模型塞回RAM內. 當你發問時, 才把模型由RAM塞回VRAM中. 這個是一個bug, 原因是因為win/AMD十分進取的省電策略, 再加上無頭電腦, 當獨顯閒置時, window強制把VRAM清掉省電. 我看老外都有回報, 解決方法就是確保AMD驅動使用最新, llama的版本就用最新的幾個輪流替換試試. 問題就可以解決.
下一步必須跑通comfyui+Minimax H3. 謝謝大家
-
MiniMax H3 Director Cut Studio 教程(教程更新在最新楼)@imbiplaza-ASUS 太強了. 馬上試一下我的 7900xtx 能不能跑
-
llama.cpp 0.6.0 出了,继续跑我的 Deepseek V4 和 GLM5.3 Flash !@johnnybegood 謝謝, 我先回去試一下. 我的這個現象就是OOM嗎? 不知為何生成token 也可以有~50左右. 感覺還算很可以
-
llama.cpp 0.6.0 出了,继续跑我的 Deepseek V4 和 GLM5.3 Flash !@johnnybegood
想請教一下,
我下載了: llama-b11475-bin-win-vulkan-x64
模型是: Qwen3.8-27B-UD-Q4_K_XL命令:
@echo off
title Qwen3.8-27B XL 131K MTP
.\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
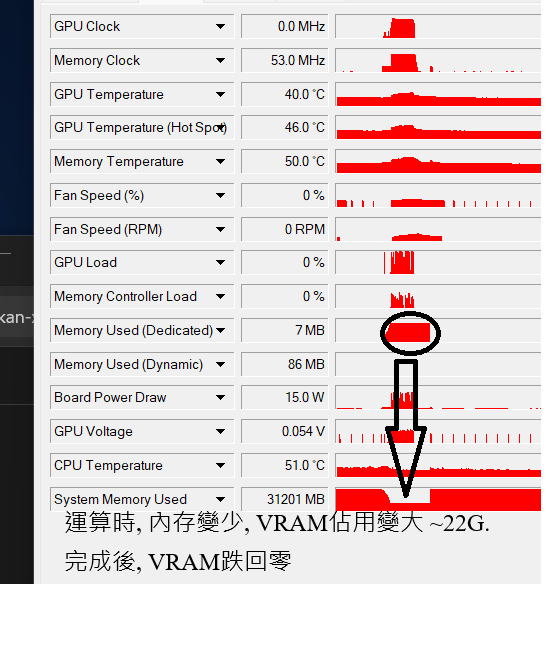
pause我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙
-
买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业! -
# 7900 XTX 跑 Qwen3.8-27B 實測73.4t/s 完整部署與實測指南,claude code opus5協助佈署的,分享給大家@CHIA-AN-YANG 感謝大神! 我完全是小白一名. 在現時人人都在玩strata的時候, 我決定先從基礎學習向你請教. 我在用i5 13400配32G內存, 使用7900xtx, win11.
下載了:
llama-b11475-bin-win-vulkan-x64
模型在hugging face下載的:
mmproj-F16
mtp-Qwen3.8-27B-Q4_0
Qwen3.8-27B-UD-Q4_K_S
Qwen3.8-27B-UD-Q4_K_XL我知道你是用ubuntu的, 把你的 (4. 最終配置(可直接複製))扔給AI, 它參照你的給我生成win11可用的命令:
@echo off
title Qwen3.8-27B XL 131K MTP
.\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
pause跑起來的時侯, 大約生成速度約52 ~ 60 t/s 也滿足了, 但就遇到個問題如下圖:
當我啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙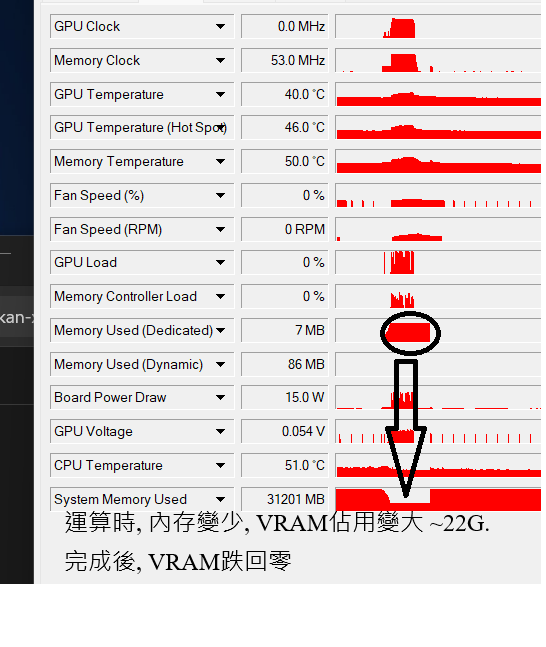
-
【练手作品】MinimaxH3,高燃连续击打测试,15s直出,二采+放大,122m9s -
【练手作品】MinimaxH3,高燃连续击打测试,15s直出,二采+放大,122m9s -
小白請教入門級的全新硬體@williamlouis 現在把玩AI最好的地方就是中國. 不但有魔改, 電費低廉, 壞了修卡也有張哥
-
【交作业】7900 XTX + ROCm + ComfyUI 调优小结@Fery-Chen 以我認知, 7900xtx 只支持FP16, FP8, INT8. INT4就已經不支持了, 如果出INT4的版本, 7900xtx 應該跑不了嗎? 會很慢
-
【交作业】7900 XTX + ROCm + ComfyUI 调优小结@Fery-Chen 後續不知會不會有H3對7900xtx的優化, 可以跑快一點呢
-
(7900xtx) 昨天推出的Minimax H3本地生成影像模型, 會比WAN/LTX更好嗎? -
(7900xtx) 昨天推出的Minimax H3本地生成影像模型, 會比WAN/LTX更好嗎?(7900xtx) 昨天推出的Minimax H3本地生成影像模型, 會比WAN/LTX更好嗎?
我問了deepseek v4 flash, 以下是它的回覆:
MiniMax H3
• VRAM 需求: ~20GB+ (GGUF 可能 ~12GB)
• 質素: 極高
• 音訊: 原生立體聲
• ComfyUI 支援:好像正好可以部署在7900xtx運行. 更可以生成音訊, 不知有沒有大神有留意呢?
-
AI会夺走越来越多的人的工作,初级文员/程序员等脑力脑洞者率先出局,体力劳动者逐步淘汰,要如何在新的时代养活自己? 過往在新時代之下, 新的工種都會出現. 但AI時代實在強的可怕, 未來的人真的不知道要幹什麼了