跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
J Z 0J

J Z 0

@J Z 0
体面乡绅 硕果累累
取消关注 关注
关于
帖子
67
主题
8
分享
0
群组
2
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 作业: 7900 XTX 128g DDR4 跑 Q4_K_XL:Strata RDNA3 调优记录
    J Z 0J J Z 0
    LLM讨论区 7900xtx amd strata

    参考这篇复测帖和部署帖,也在自己的 NAS 上折腾了两天。模型保留原来的 Qwen3.8-Flash-Next UD-Q4_K_XL。
    下面是AI总结的速度, 我实际写专业模型代码的速度从60tps升到80多, prefill的体感速度也是快了很多。

    最终结果:32K prefill 提升约 20.4%;之后单独校准 decode,同为 12 workers 时提升约 3%–6%。 两轮基线不同,下面分开列。

    配置

    项目 本机配置
    CPU / RAM Ryzen 9 5900XT,16 核 32 线程 / 128GB
    GPU RX 7900 XTX 24GB,PCIe 4.0 ×16
    系统 TrueNAS 25.10.7
    驱动 / ROCm AMDGPU 7.1.9.31600000 / ROCm 10.1 系统 SDK,非 TheRock 轮子
    推理框架 nicejunjie/Strata-rdna3,PR #1,commit 309f0c8,engine 0.1.43
    模型 / KV UD-Q4_K_XL / int8,最大上下文 262144

    简要优化过程

    1. 先照配置跑,再处理本机差异

    最初照搬参数,没有复现帖子中的 decode。我的 CPU、量化和测试内容都不同,不能直接拿 IQ3_S 的 100+ tok/s 当目标。

    PLE 最后保留 ram,加载日志确认表已锁在 RAM;direct 在这台机器上出现过很慢的随机读取。这个选择主要解决本机加载体验,没有单独做可归因的速度百分比对照。

    2. 针对 Q4 测 prefill 开关

    逐项及组合测试后,保留:

    STRATA_PF_FUSED_KQ=1
    STRATA_PREFILL_RING=384
    STRATA_FUSE_CONVAB=1
    

    这一轮全部固定 15 workers,比较的是同一 RDNA3 fork 内的参数变化:

    指标 调整前 三项开启后 变化
    8K prefill,tok/s 2432.4 2631.5 +8.2%
    32K prefill,tok/s 3169.4 3815.1 +20.4%
    32K 首字耗时,秒 10.39 8.64 −16.8%
    32K 完整请求耗时,秒 19.82 17.94 −9.5%

    32K 的读取收益在 KQ 融合单项测试中就能重复看到;ring 和 CONVAB 单独开启没有明确收益。三项组合在本轮混合负载中总耗时最低,因此保留,但不把全部提升归功于每个开关,也不将这一轮约 1%–2% 的 decode 波动当成稳定收益。

    hipBLASLt 调优表也做了开关对照:这些负载走 WMMA/自定义路径,日志中 hipBLASLt 调用为 0,关表没有改善,因此保留原有 43 行表,没有为了凑参数额外重做。

    3. 跑内置 calibrate,再用长输入复测

    内置校准约 16 分钟,扫描 PCIe 分工、MTP 阈值、worker 数和专家更新参数。之后把日常 worker 固定为 12 (10-14差别都很小),并补做了 两组都为 12 workers 的对照;上面的三个 prefill 设置在这两组中均保留。

    场景 校准前 decode,tok/s 校准后 decode,tok/s 变化
    8K 合成代码 55.8 57.5 +3.0%
    缓存对话续问 59.4 61.3 +3.2%
    32K 合成检索 54.4 57.4 +5.5%
    128K 合成检索 57.8 61.4 +6.2%

    这一轮 prefill 基本不变,完整请求耗时缩短约 1.2%–2.7%。decode 的百分比不能直接当成整笔任务的提速。12 workers 是最终日常选择,不代表已经证明它是所有负载的最优值。

    最终保留的关键参数

    以下是关键项,模型路径及其余已有配置省略:

    --pool-workers 12
    --pool-tasks 96
    --pcie-frac 0.20
    --spec 4
    --spec-min-p 0.70
    --adapt-every 1
    --adapt-swaps 160
    --adapt-decay 0.97
    --prefill auto
    --ple-io ram
    --max-context 262144
    --kv int8
    --kv-resident 32768
    --vram-reserve-mib 512
    

    另外限制 ROCm 队列:主进程 GPU_MAX_HW_QUEUES=6,视觉辅助进程覆盖为 2。模型驻留后的短时观察为 GPU 0% busy、约 14–18W,没有再出现此前待机约 110W 的现象;这是显卡功耗,不是整机功耗。

    测试口径与体会

    每组先预热,候选每个场景测 3 次取中位数;第一轮基线另复测一次,合并 6 次取中位数。输入为固定的合成代码/检索文本,输出 512 tokens;temperature 0、top-k 1、top-p 1、min-p 0、seed 42,关闭 thinking。新输入确认无提示词缓存复用,续问允许缓存;冷启动时间不计入上述速度。输入输出长度、检索码和固定代码答案检查均通过,但不等于完整的质量评测,也不是实际 DSH 长任务计时。


  • 垃圾佬的快乐!
    J Z 0J J Z 0
    装备秀 7900xtx amd 服务器

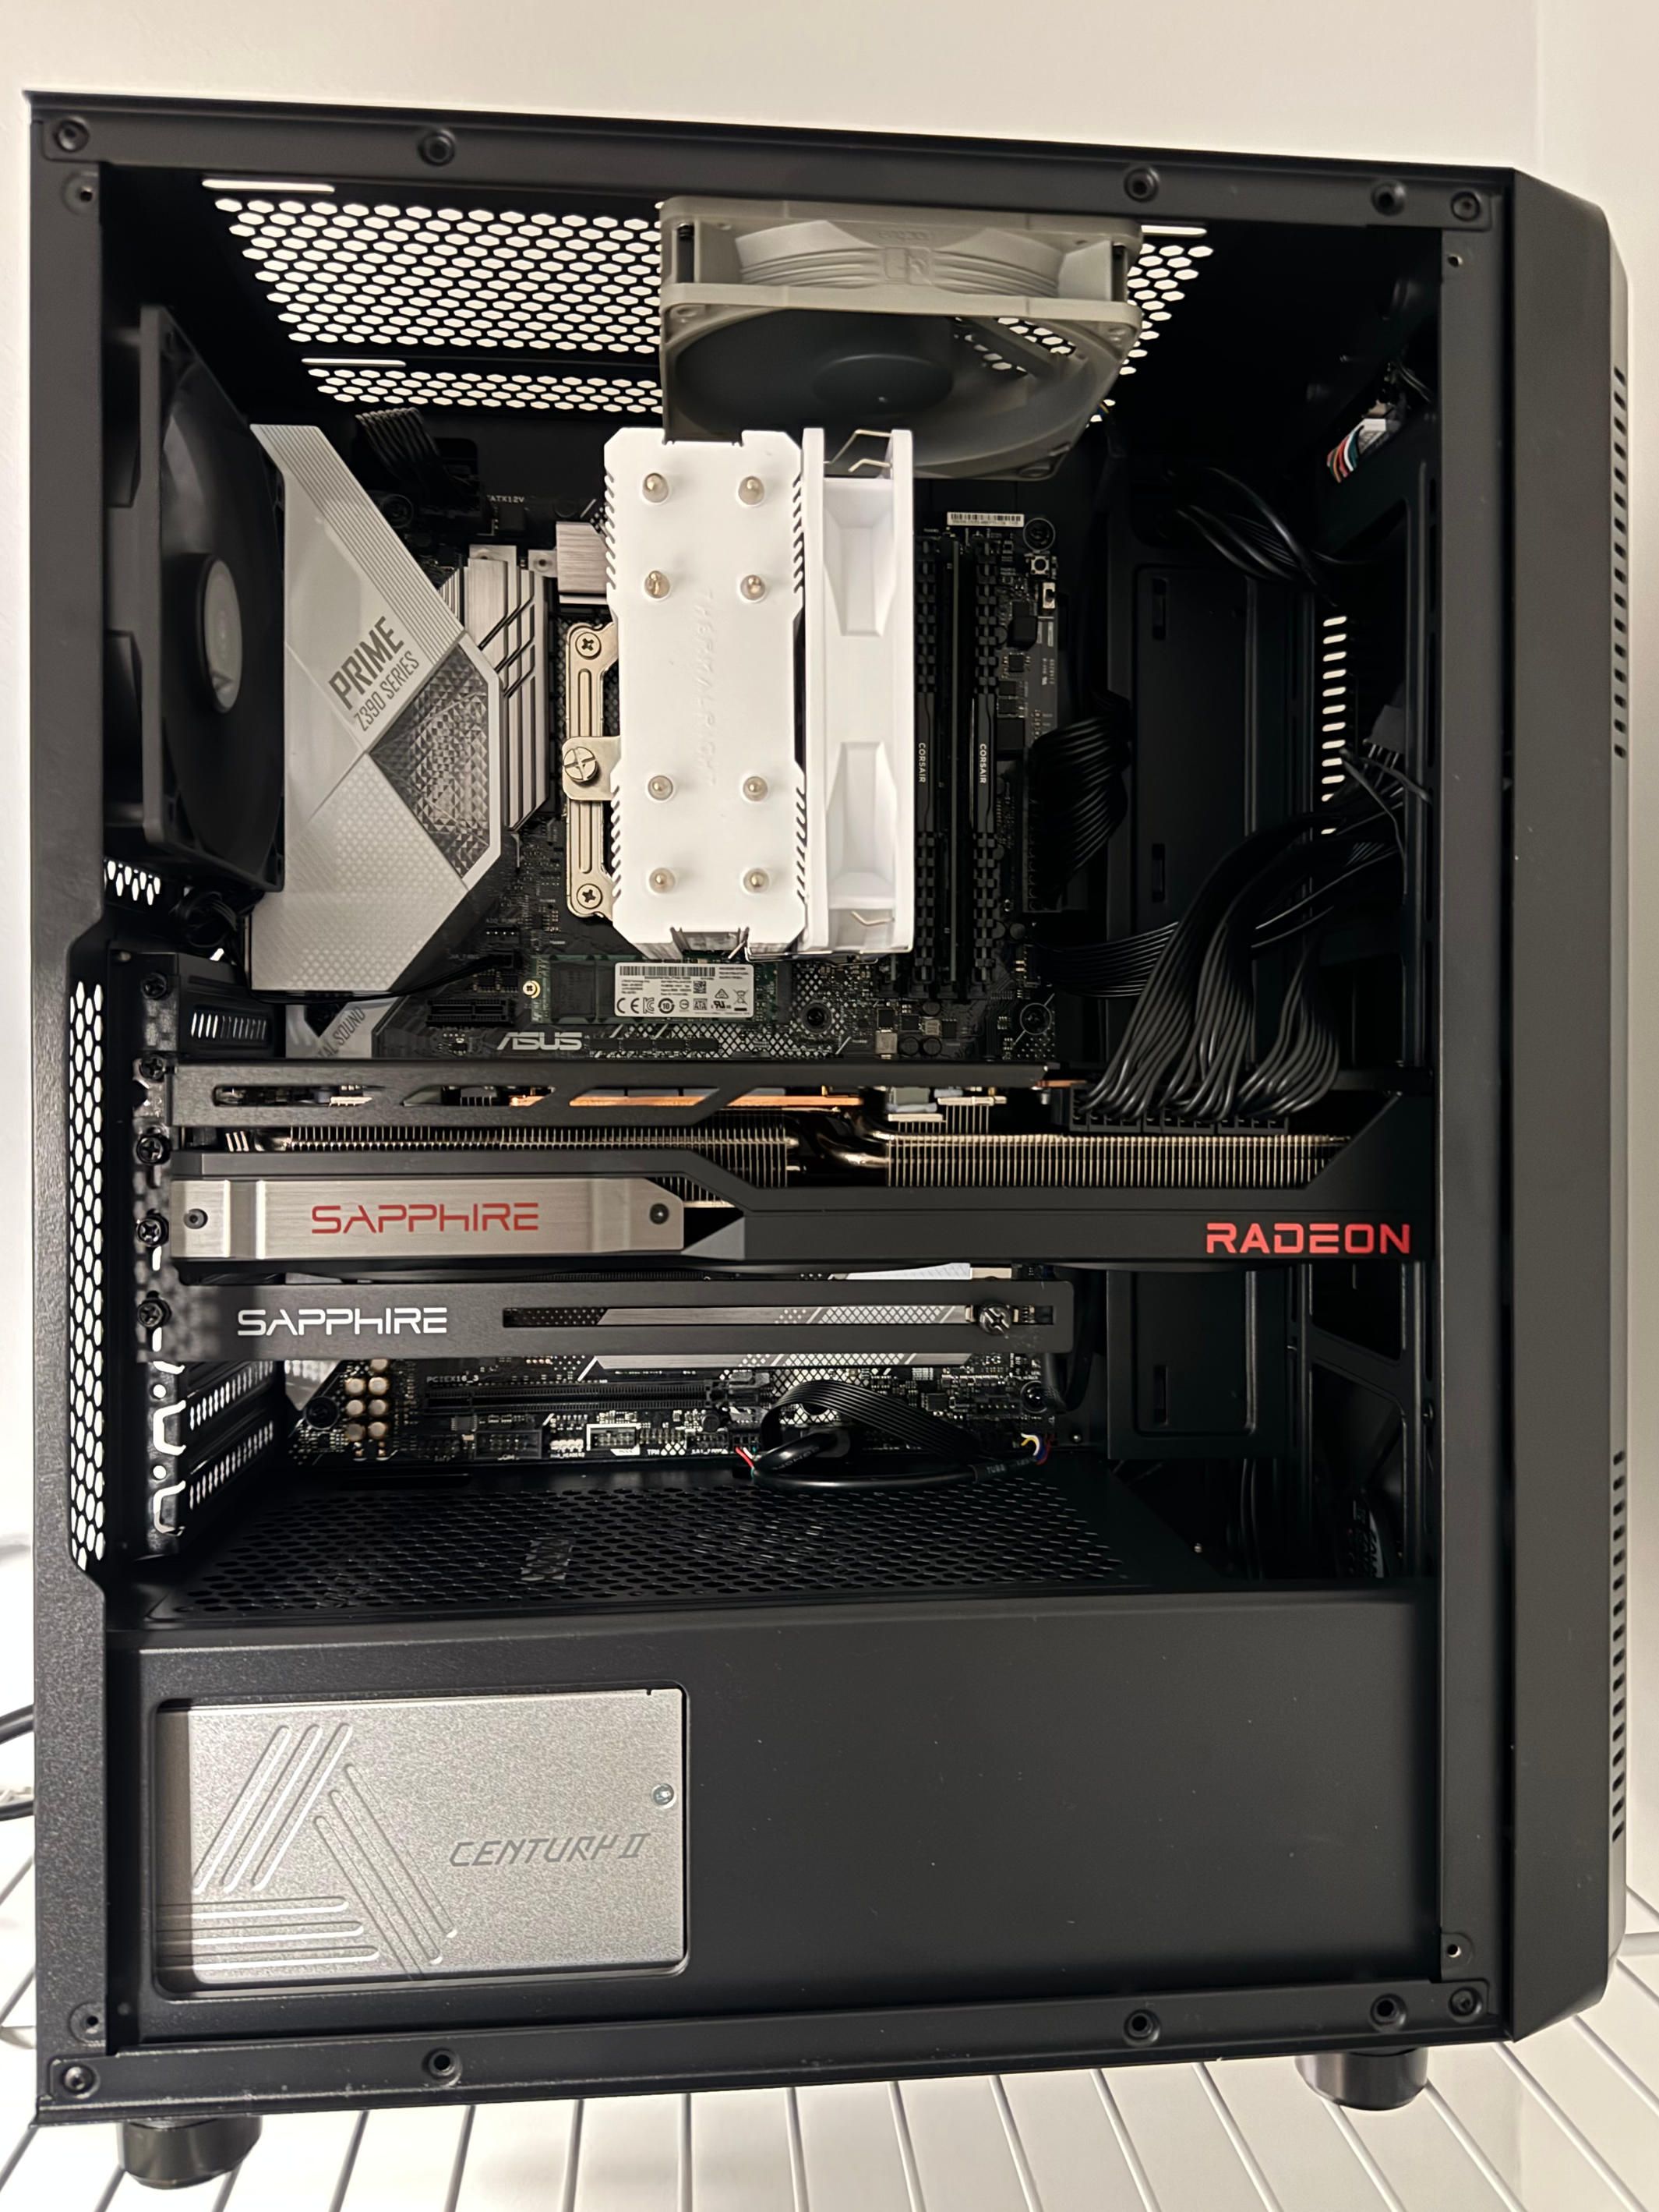
    26-09-25 10-17-16 7396.jpg

    我的原则是能捡垃圾的就不买新的!!!

    最近升级了下nas的机箱/电源, 刚好塞进这个7900xtx。 除了机箱和cpu风扇, 外加一个猫头鹰的机箱风扇, 其他都是二手件。这个机箱是我找到的最便宜的一个, 铁皮轻轻一掰就弯了。平时打开侧板, 半裸跑。

    组件 型号/规格 备注
    CPU Intel Core i5-9600K 6核6线程,旧电脑上拆的
    主板 华硕 PRIME Z390-A 旧电脑上拆的
    内存 32GB DDR4 (4×8GB) 计划升级至 128GB (4×32GB)用于运行 Qwen 3.8 Flash Next , 正在二手网站谈
    显卡 AMD Radeon RX 7900 XTX 800美元买的返修货
    系统盘 160GB SATA SSD 旧笔记本拆机件,仅用于系统
    模型存储 256GB M.2 SSD 旧笔记本拆机件,存放模型文件
    数据盘 10TB 希捷 NAS 红盘 前几年买的, 最近看了下价格, 连这玩意都涨了
    电源 MONTECH CENTURY II 1050W 返修货, 只花了70美元
    操作系统 TrueNAS Scale Docker部署AI应用

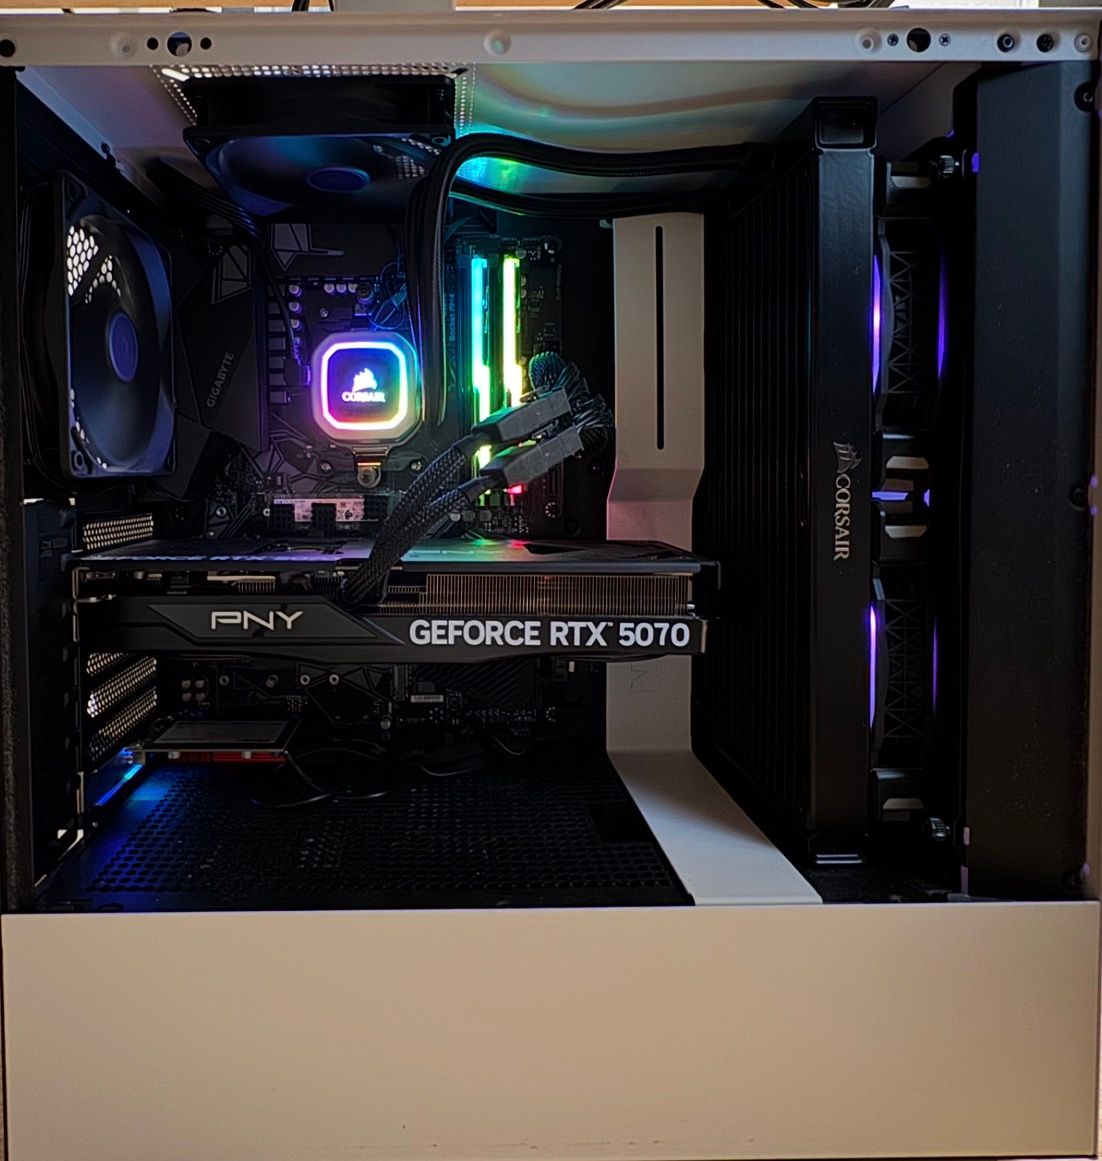
    还有个台式机,跑windows, 兼顾打游戏 (其实完全没时间玩)。 为了不买ddr5, 我选了5900xt, 现在有点后悔了, 应该买好点的cpu+ddr5的, 性价比高很多。
    26-10-05 09-57-49 7515.png

    台式机配置清单

    组件 型号/规格 备注
    CPU AMD Ryzen 9 5900XT 16核32线程
    主板 技嘉 B550 GAMING X V2 ATX
    内存 32GB DDR4 等nas内存升级完, 可以把这个补到48g, 这样也能跑strata了
    显卡 PNY RTX 5070 12GB 显存 , 这个是前两个月抢的打折货, 550美元买的, 现在再也回不到这个价格了
    系统盘 intel 1TB NVMe SSD PCIe 4.0
    数据盘 1TB HDD 日常文件
    电源 海韵 650W
    系统 Windows 11

  • 贫穷的3060玩家弄来了8个DGX
    J Z 0J J Z 0
    装备秀 dgxspark gb10 rtx3060

    @terry 凌乱中透露着对金钱的不屑,何尝不是一种淡然的炫富行为。真正的穷屌丝连个1000块的电脑都要整的人模狗样


  • 新手 最近配置好的主機
    J Z 0J J Z 0
    随便聊聊 本地模型 多卡部署

    @好米玉 新買的 E5 2673 V3 +X99 +128G DDR3 1866 + 舊卡3090 跑 Q4XL 是否要捕到256G? 不用,但 ple io必须 mmap, 不能ram


  • 水一贴: Strata v0.1.43 又又又提速了
    J Z 0J J Z 0
    随便聊聊 strata rtx5070 7900xtx

    从 v0.1.41 升到v0.1.43, 其它设置都没动,
    同样的任务, 我的5070 从90+tps 升到120+tps (iq2_xs, win11, 48G ddr4)
    7900xtx 少些, 从60+tps升到70+tps (iq3_s, truenas scale, 128G ddr4)

    大家快升级吧!!!


  • 7900 XTX单卡:prefill 2086→3205,decode 64.7→96.3
    J Z 0J J Z 0
    AI硬件 7900xtx strata qwen

    @Y-G-0 这个是可以的, 我的agent也真的干了, 成功了。rdna3 的作者这几天也有基于新引擎的更新, 我也都测试了。 不过我的问题是,我用128g内存跑Q4_K_XL. 0.1.43引擎可以把PLE io 设成ram (差不多还剩10g的ram余量), 是最快的。 引擎从某个版本开始, 对内存占用提高了,结果就是只能选direct或mmap,否则就是OOM,把东西挤回硬盘, 都没有原版rdna3设成ram快。 我估计很长一段时间内, 我都没法更新了, 不过这样也比原版strata快不少, 7900xtx单卡, 干长活60tps, 写一段简单代码80+tps


  • 新手交作业:X99+DDR3+7900XTX 攒机和调试小结
    J Z 0J J Z 0
    AI硬件 x99 7900xtx 本地模型

    一样的卡,我升到350w, 减了50的电压,目前很稳定,温度也比默认降了


  • 7900 XTX + 128g 内存 单卡跑 Strata + Qwen3.8 Flash-Next, 踩坑经验分享
    J Z 0J J Z 0
    LLM讨论区 7900xtx strata qwen-flash

    这台NAS电脑比较不典型,属于内存/显卡都够用, 但cpu/ssd (不是nvme)严重拖后腿。 给大家一点数据参考。
    被 DSH 的 deepseek flash 坑了,抄着论坛作业框框干了两个多小时,告诉最好 16 t/s。后来自己下场找原因,找到了。
    引擎默认把 27GB 的 PLE 表直接从 SSD 读,每个生成窗口都在等硬盘。塞进内存后,升到 65 t/s, 代价是内存占用来到了80G左右。

    另一个就是不要盲信strata自带的calibrate, 它给的--pcie-frac 是0.37 。但我实际工作环境跟测试不一样, 速度变慢很多, 明显cpu拖后腿了, 所以我把它固定到0.55 。

    1. 环境

    项目 配置
    系统 TrueNAS SCALE 25.10.7(内核 6.12)
    GPU / CPU RX 7900 XTX 24GB(gfx1100,HIP)/ i5-9600K 6C/6T,只有 AVX2
    RAM 128GB DDR4
    ROCm / Strata 7.14.1(hipBLASLt 100401 调优表命中)/ v0.1.41 HIP
    模型 Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S(IQ3_S,83.6 GB 两片),来自 ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
    Context / 图像 131072 / 开(strata-vision-hip GPU 编码器 + BF16 mmproj)

    2. 关键参数

    参数 值
    --ple-io ram
    --pcie-frac 0.55(写死;不写则引擎自测出 0.37)
    --pool-workers 3
    --kv / --kv-resident int8 / 32768
    --spec / --spec-min-p 4 / 0.5
    --adapt-every / -swaps / -decay 1 / 80 / 0.97
    idle_unload_s 1800

    后四项来自 --calibrate。--pool-workers 别往大调:3 → 55.3 t/s,5 → 46.4,2 → 49.7。

    3. 经验

    1. --ple-io ram 是这台机器的命门。 PLE 表 26.82 GiB(512 亿参数,IQ4_NL),默认直读盘、每 window 卡在 330 MB/s。搬进内存后 22 → 65;代价是常驻 26.82 GiB,第二次重启只要 1.1 秒(页缓存已热)。
    2. --calibrate 值得跑(只调 4 项,实测 +19%),但注意它会把没保留下来的 flag 直接删掉退回产品默认。
    3. 参数好坏要看 /metrics 里的真实流量,别只信合成 benchmark。 我用"反复读同一批文档"的 prompt 测(专家缓存命中率 92 ~ 97%,几乎不 miss),结论是 --pcie-frac 越高越慢;换成不同话题的真实对话(命中率 80 ~ 90%、40K 上下文),0.55 比 0.37 快 50%。miss 越少,PCIe 这条路越不划算 —— 拿一个「不 miss」的场景去否定一个专门处理 miss 的参数,方法本身就错了

  • RTX 5070 12G (48G 内存) 单卡跑 Strata + Qwen3.8 Flash-Next
    J Z 0J J Z 0
    LLM讨论区 rtx5070 strata qwen-flash

    今天给NAS买的128g DDR4内存到了, 就匀了16G闲置内存到台式机。过程很顺利,跟DSH的deepseek flash 许了个愿,喂给它论坛的帖子,一会就好了。Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS。 总共48g内存, 只是勉强够, 速度倒是不错, 只是空余内存很少,估计干不了什么正经事, 纯娱乐吧。估计以后可以让nas跑长任务, 然后分一些小活给台式机同时做。 (这几天折腾了下让两台机器协同工作, 不过还没整明白)

    关于NAS的128g内存+ 7900xtx 被Deepseek flash坑了, 它框框一顿操作了2个多小时, 还是在抄论坛作业的情况下, 告诉我最快16tk/s。 我只好自己下场找原因, 晚点整理好发上来。

    1. 环境

    项目 配置
    操作系统 windows 11
    GPU RTX 5070 12GB(sm_120),单卡
    CPU Ryzen 9 5900XT 16C/32T,仅 AVX2
    RAM 48GB DDR4-2933
    Strata v0.1.41 官方 CUDA 引擎
    量化 IQ2_XS
    Context 32768
    图像输入 关闭(mmproj 文件有,但没启用)

    图像没开:省下约 1GB 显存留给专家缓存

    2. 关键参数

    参数 值
    --expert-cache auto
    --kv int8
    --spec 4
    --pcie-frac 0.35
    --spec-min-p 0.70
    --pool-workers 10
    --adapt-every / -swaps / -decay 1 / 80 / 0.97
    idle_unload_s 900

    后 6 项全是 --calibrate 实测出来的。

    3. 成绩

    场景 Decode
    校准前 76.4 t/s
    校准后 82.2 t/s
    512 token 稳态 81.3 t/s
    数学/结构化短答 89 ~ 96 t/s
    技术长文 74 ~ 82 t/s

  • 升级后单卡7900xtx,strata 可以跑 100token/s 了!!
    J Z 0J J Z 0
    LLM讨论区 7900xtx strata

    @farmer-node 我也升了, 速度没升也没降, 但SSD疯狂读盘, 只要agent干活, 就在读ssd。 好奇怪, 我看你的ssd几乎是不动的


  • Avalon大家试了吗 AMD又要冲一波了
    J Z 0J J Z 0
    LLM讨论区 amd qwen-flash

    @terry 读了下作者描述,预估跟rdna3分支提升差不多


  • RAG LoRA和大模型的关系以及应用场景
    J Z 0J J Z 0
    LLM讨论区 本地模型 rag

    @AGI 说的有道理,我这几个月都在钻研手搓rag。尤其是一开始只有5070, 跑一个27b后,显存就已经很紧张了,随便给点rag,上下文就爆了。 那时我的策略是根目录加一个index, 特定问题只读特定部分。最近用上qfn后,开始放飞自我了,不再刻意给rag瘦身。
    另外我的体验是,开放式问题,比如这个帖子里说的中医,其实对本地模型还是有点难。但如果是在rag里给足模版,按照特定流程,生成一个文件,其实模型不用太聪明也能做到。


  • 【实测】Strata 0.2.7.1 12GB NV显卡打了鸡血 RTX5070 IQ3_S平均超过110tok/s
    J Z 0J J Z 0
    LLM讨论区 rtx5070 strata 本地模型

    @terry 又折腾了一下午, 现在7900xtx 128g ddr4,cpu是5900xt, 150k 上下文, 跑 Q4_K_XL从60tps升到80多,prefill 3800左右(32k读取),而且启动速度也明显变快了。 还是很值得折腾的,得益于版友们分享的参数优化


  • 【实测】Strata 0.2.7.1 12GB NV显卡打了鸡血 RTX5070 IQ3_S平均超过110tok/s
    J Z 0J J Z 0
    LLM讨论区 rtx5070 strata 本地模型

    @terry 今天已经试过了,哥。 对我没用,我一直用q4_k_xl, 调了半天参数也只比最新strata慢了一点点,还有模型跑完gpu还是满载的bug,又改回来了。可能对我用的模型还没有优化,但我又觉得iq3做我的长线任务容易陷入死循环


  • 作业: 7900 XTX 128g DDR4 跑 Q4_K_XL:Strata RDNA3 调优记录
    J Z 0J J Z 0
    LLM讨论区 7900xtx amd strata

    @terry 我想做一个给数据就自动跑数学模型, 出报告的agent, 一个任务时间比较长, 上下文要多次压缩。 之前用IQ3, 速度倒是快, 但偶尔不稳定, 会陷入死循环的自言自语, 也不是每次都发生, Q4好很多


  • # Qwen3.8 Flash Next Q3_S 7900XTX + 128G DDR4 測速與優化
    J Z 0J J Z 0
    AI Agent 7900xtx qwen-flash 量化

    @CHIA-AN-YANG 跟我测的差不多,我的cpu是5900xt,别的硬件跟你差不多,发现 设成0,结果最好。我现在用q4_k_xl,比你的慢一些


  • 7900 XTX + 128GB:Strata RDNA3 三档模型精度测试
    J Z 0J J Z 0
    LLM讨论区 7900xtx strata amd

    128G ram, 最高跑到UD-Q5_K_XL, 最低测了IQ4_XS-v31 + N-gramQ8. 发出来方便大家参考

    硬件 / 软件环境

    项目 环境
    CPU AMD Ryzen 9 5900XT,16核32线程,AVX2
    GPU AMD Radeon RX 7900 XTX,24GB,gfx1100
    内存 128GB;系统可用约125.7GiB
    模型存储 XG7000 1TB NVMe,ZFS
    系统 TrueNAS 25.10.7,Linux 6.12.105-production+truenas
    AMDGPU 7.1.9.31600000
    ROCm 10.1.0,系统路径 /opt/rocm
    hipBLASLt 100401,匹配 gfx1100 调优表(43行)
    推理后端 Strata RDNA3 fork,具体引擎版本见下表
    GPU 队列 引擎 GPU_MAX_HW_QUEUES=6;视觉助手限制为2
    ZFS ARC 自动管理,zfs_arc_max=0

    文件体积与速度总表

    PP = prefill,TG = decode,速度单位均为tokens/s;每格按 PP / TG 排列。GB按10⁹字节,括号GiB按2³⁰字节。

    配置 引擎版本 原GGUF分片合计 GB(GiB) 实际N-gram / PLE GGUF+所用外置表 GB 约8K输入 PP / TG 长输入 PP / TG
    IQ4_XS-v31 0.1.49.1 93.67(87.24) 外置Q8_0,54.40GB;mmap;1MiB块 148.07 802.3 / 65.5 32K:1126.8 / 62.7;128K:1489.9 / 60.0
    UD-Q4_K_XL 0.1.43 111.33(103.69) 内置IQ4_NL,28.80GB;ram 111.33 2082.7 / 57.4 64,358 tokens:3670.2 / 58.3
    UD-Q5_K_XL 0.1.49.1 158.29(147.42) 外置Q8_0,54.40GB;direct;16KiB块 212.69 1600.5 / 46.0 32K:2368.5 / 50.9;128K:3432.4 / 47.4

    体积口径: 原GGUF分片合计包含包内N-gram。IQ4_XS和Q5_K_XL另外使用独立Q8表,所以额外计入54.40GB;Q4_K_XL直接使用包内28.80GB的IQ4_NL表,不再重复加一次。合计不含native pack、MTP、视觉投影及备用文件,不等于RAM占用。

    测速口径: IQ4_XS与Q5_K_XL取对应最终配置的固定新输入记录,temperature=0、top_k=1、top_p=1、seed=42,各输出384 tokens,禁止prompt复用。Q4_K_XL取最终版本的完整无缓存日常日志:约8K一栏为11条记录的中位数,输入7,961~8,072、输出158~506 tokens;64,358一栏为单次150-token输出。Q4日常请求的实际采样未统一。不同输入语料、输出长度、PLE方式和引擎版本的结果只作整套配置参考,不作为严格同条件量化排名。

    三套共用参数

    以下是启动参数片段,公共段与对应方案段合并使用。模型、pack、MTP和profile路径按各自安装目录填写;数值取实际最终配置。

    --pack "$PACK_DIR" \
    --native "$MODEL_GGUF" \
    --expert-profile "$EXPERT_PROFILE" \
    --mtp "$MTP_DIR" \
    --expert-cache auto \
    --max-context 153600 \
    --spec 5 \
    --spec-min-p 0.70 \
    --mtp-window 4096 \
    --mtp-q4 all \
    --pcie-frac 0.20 \
    --kv int8 \
    --kv-resident 32768 \
    --pool-tasks 96 \
    --ple-row-cache 1048576 \
    --prompt-cache 12 \
    --prompt-cache-tail \
    --adapt-every 1 \
    --adapt-decay 0.97 \
    --conversation-cache-min-tokens 2000 \
    --conversation-cache-min-free-mib 2048 \
    --stats \
    --vision
    

    公共MTP数据目录为rt格式。三套默认采样均为temperature=0.5、top_p=0.95、top_k=40;客户端显式参数可以覆盖默认值。

    1. IQ4_XS-v31

    • 引擎:RDNA3 0.1.49.1。
    • 主模型:UD-IQ4_XS-v31,4个GGUF分片。
    • PLE:独立Q8_0表,mmap读取;实际文件为1MiB ZFS数据块。
    • 专家arena约56.24GiB,不含N-gram缓存、KV和系统开销。
    --pool-workers 12 \
    --prefill 32768 \
    --vram-reserve-mib 768 \
    --ple-io mmap \
    --ple-gguf "$Q8_ENGRAM" \
    --adapt-swaps 80 \
    --conversation-cache-mib 4096 \
    --conversation-cache-slots 4 \
    --mtp-draft-vocab "$ZH60K_DRAFT_VOCAB"
    

    对应方案环境变量:

    export STRATA_PREFILL_CPU_SHARE=0.6
    export STRATA_PREFILL_CPU_SHARE_MAX=7936
    export STRATA_ADAPT_OVERLAP=1
    export STRATA_TOPK_SPLIT_MIN=98304
    export STRATA_QSA_ROWS=1
    export STRATA_ENGINE_NICE=0
    

    2. UD-Q4_K_XL

    • 引擎:RDNA3 0.1.43。
    • 主模型:UD-Q4_K_XL,4个GGUF分片。
    • PLE:直接使用包内的IQ4_NL表,ram模式锁入内存。
    • 专家arena约71.73GiB;加上约26.82GiB的PLE表及其他开销,128GB内存接近满载。
    • Prefill为auto,最终上限32768;未额外指定mtp-draft-vocab。
    --pool-workers 12 \
    --prefill auto \
    --vram-reserve-mib 512 \
    --ple-io ram \
    --adapt-swaps 160 \
    --conversation-cache-mib 2048 \
    --conversation-cache-slots 2
    

    对应方案环境变量:

    export STRATA_PREFILL_AUTO_MAX=32768
    export STRATA_PREFILL_CPU_SHARE=auto
    export STRATA_PREFILL_CPU_SHARE_MAX=6144
    export STRATA_PREFILL_MMQ_TILE_ROWS=32
    export STRATA_PF_SWITCH_MIN_T=4096
    export STRATA_WMMA_GEMM=1
    

    3. UD-Q5_K_XL(当前在用)

    • 引擎:RDNA3 0.1.49.1。
    • 主模型:UD-Q5_K_XL,6个GGUF分片。
    • PLE:独立Q8_0表,direct读取;使用16KiB ZFS数据块的文件副本。
    • 专家arena约91.61GiB。N-gram表放在NVMe按需读取,不将整张54.40GB表锁入RAM。
    • 所用Q8表与原表字节相同,SHA256校验通过;主模型专家仍完整放在RAM。
    --pool-workers 10 \
    --prefill 32768 \
    --vram-reserve-mib 832 \
    --ple-io direct \
    --ple-gguf "$Q8_ENGRAM_16K" \
    --adapt-swaps 160 \
    --conversation-cache-mib 4096 \
    --conversation-cache-slots 4 \
    --mtp-draft-vocab "$ZH60K_DRAFT_VOCAB"
    

    对应方案环境变量:

    export STRATA_PREFILL_CPU_SHARE=0.6
    export STRATA_PREFILL_CPU_SHARE_MAX=7936
    export STRATA_ADAPT_OVERLAP=1
    export STRATA_TOPK_SPLIT_MIN=98304
    export STRATA_QSA_ROWS=1
    export STRATA_ENGINE_NICE=0
    

    当前Q5配置另通过了两轮150,000-token输入检索验证。GPU加载模型后的待机实测为0%占用、约23W。

    共用环境变量

    下面是三套配置中取值相同的环境变量;与各方案自己的环境段一起使用。HIPBLASLT_TABLE应指向与本机gfx1100、hipBLASLt 100401相匹配的调优表。

    export HIP_PLATFORM=amd
    export ROCM_PATH=/opt/rocm
    export HIP_PATH=/opt/rocm
    export HSA_OVERRIDE_GFX_VERSION=11.0.0
    export LD_LIBRARY_PATH=/opt/rocm/lib
    export GPU_MAX_HW_QUEUES=6
    export STRATA_HIP_WMMA=1
    export STRATA_SELECT_WMMA=1
    export STRATA_HC_UPMIX=1
    export STRATA_HEAD_MIX_MULTI=1
    export STRATA_GR_RDNA=1
    export STRATA_GR_RDNA_Q8=1
    export STRATA_GR_RDNA_A8=1
    export STRATA_GR_FUSED=1
    export STRATA_GR_INJ_UP=1
    export STRATA_GDN_CHUNKED=1
    export STRATA_GDN_HEAD=1
    export STRATA_GDN_CONVL2=1
    export STRATA_GDN_NOY=1
    export STRATA_GDN_PP=1
    export STRATA_GDN_CHUNK_GDV=0
    export STRATA_PF_FUSED=1
    export STRATA_PF_GEMM=1
    export STRATA_PF_F16=2
    export STRATA_PF_HCDOWN=1
    export STRATA_PF_PAD=1
    export STRATA_PF_GROUP_RES=1
    export STRATA_PREFILL_RING=384
    export STRATA_QFUSE=1
    export STRATA_PA_FAST=1
    export STRATA_PA_KLDS=1
    export STRATA_KV_HOST_DMA=1
    export STRATA_COMBINE_CPU=1
    export STRATA_WAIT_FUSE=1
    export STRATA_ROUTE_PUBLISH=1
    export STRATA_VERIFY_QDEDUP=1
    export STRATA_RDNA_MMVQ_WAVE=3
    export STRATA_RDNA_Q6K=1
    export STRATA_STAGER_RING=64
    export STRATA_PEER_TRANSPORT=host
    export STRATA_HIPBLASLT_TUNING="$HIPBLASLT_TABLE"
    export STRATA_PF_FUSED_KQ=1
    export STRATA_FUSE_CONVAB=1
    export STRATA_SH_STREAM=0
    

    ZFS的16KiB块需要对应文件实际以该块大小写入;改变dataset的recordsize不会自动改变旧文件的数据块。当前整个models dataset仍为1MiB,Q5所用独立Q8表副本为16KiB。

    项目:Strata RDNA3;模型:Unsloth Qwen3.8-Flash-Next GGUF。


  • 垃圾佬的快乐!
    J Z 0J J Z 0
    装备秀 7900xtx amd 服务器

    @terry 这个机箱前面板是封死的。为了散热进气, 它在前面板的底部和你看到的挡板的另一面开了网眼, 然后留下了那么多空间。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组