
@算盤俠 说:
@stormaround 据说两张R9700部署H3是有1.7倍左右速度提升
默认估计没有,需要装插件,昨天github上看到一个插件,multiGPU
@算盤俠 说:
@stormaround 据说两张R9700部署H3是有1.7倍左右速度提升
默认估计没有,需要装插件,昨天github上看到一个插件,multiGPU
@算盤俠 说:
@stormaround 谢谢建议,但是ddr3我就不考虑了。因为手上有几十条ddr4 16g的ecc,是以前公司剩下的。而且PCIE3.0太慢啦。
我是准备双R9700来跑生图视频/llm的,因为是纯兴趣个人在家的AI服务器。也不是什么生产力工具,就是家里想有个这玩意,跟当年玩NAS一样啦
那确实可以用ddr4,如果一定要本地部署两张r9700 部署qwen3.8-flash最好,或者用云端api,本地部署comfyui,单张r9700 部署27b,另一张部署minimax h3 也可以
怎么用windwos跑,速度不太快,github上有个现成的,我用e5 洋垃圾 + 128g ddr3 + 双r9700,一般decode速度都有70以上,zx-bench 4并发decode平均也有50多
github上有成熟方案,可以搜下
a3b靠谱吗,之前用过的a3b经常会死循环,而且mac跑大模型太热了,我都改用r9700跑了,双r9700 配洋垃圾部署qwen3.8-flash-next很稳,我现在替换掉deepseek-flash完全没问题,肯定不如云端,但是比35b ,27b要强很多
私有银行,数据不能出本地,都8张4090 48g,直接考虑部署deepseek-v4.1-flash啊,团队只考虑 qwen3.8-flash-next,glm5.3-flash,deepseek-flash,也可以考虑R9700,毕竟质保时间长,魔改卡有风险。大体量模型可能得加钱,上下文一定得拉长,不能裁减kv。
可以考虑用e5 + x99 + ddr3,能省不少,ddr4价格大概是ddr3的3-4倍,如果两张r9700 跑模型,用128g -256g内存,可以跑qwen3.8-flash-next很好用,如果一张跑模型,一张跑视频,可以考虑买4080s 32g,出视频n卡少折腾,跑的快
@stormaround 多问一句,电源的选择,双卡GPU,在考虑是R9700还是7900xtx,这个电源配多大,双GPU电源线怎么接出来。
1000w就够了,850w的其实都够,不放心就1200w,7900xtx功耗高,建议限制到305w,我现在用的是微星 1200w电源,一共5个pcie/cpu + 一个12v的,双9700 完全够用,如果两张7900xtx,3x8pin 需要有一个插那个分线
@stormaround 对了问一下,你agent 上网查询的主要工具是什么,google seach api 现在好像不能用了。
hermes直接爬网页,考虑要不要加上brave search
了解, 我27B 主要是用在Agent用途 知識面不懂它就上網自己去查,
如果Qwen3.8-Flash-Next coding 能力強過27B, 那倒是有可以發揮的空間做指揮調度的角色
全套地端local llm, 否則只能必要時依賴 云端 前沿模型了
我感觉还是flash更好一些,如果做的任务不复杂27b应该是够用,稍微复杂点可以考虑用flash,或者直接用云端模型
我用华南x99 + 2xr9700 用1000w电源都没问题,最近换了个1200w,准备再把7900xtx插上去
zx-bench 智秀评测截图
請問跟跑Qwen3.8-27B 相較之下 各項表現差異大嗎?
我想主力用Qwen3.8-27B, 在遇到難題時 派出Qwen3.8-Flash-Next, Deepseek or Codex 應戰
27b稳一些,但是知识面不足,我现在主要还是用云端模型,目前考虑用本地flash替换云端,而且这个模型是去审核的
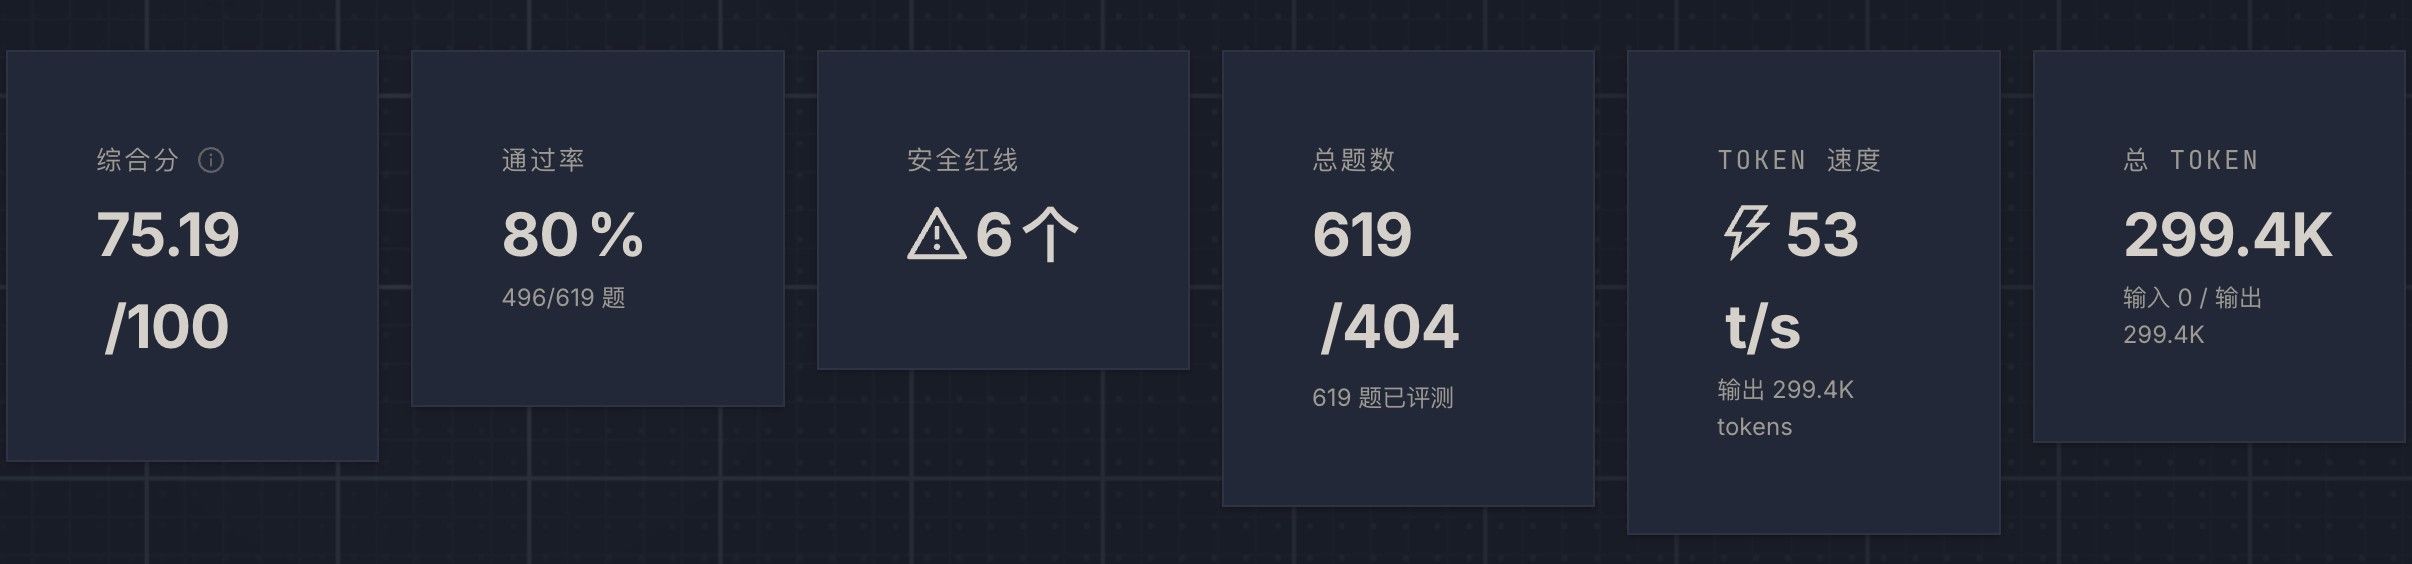
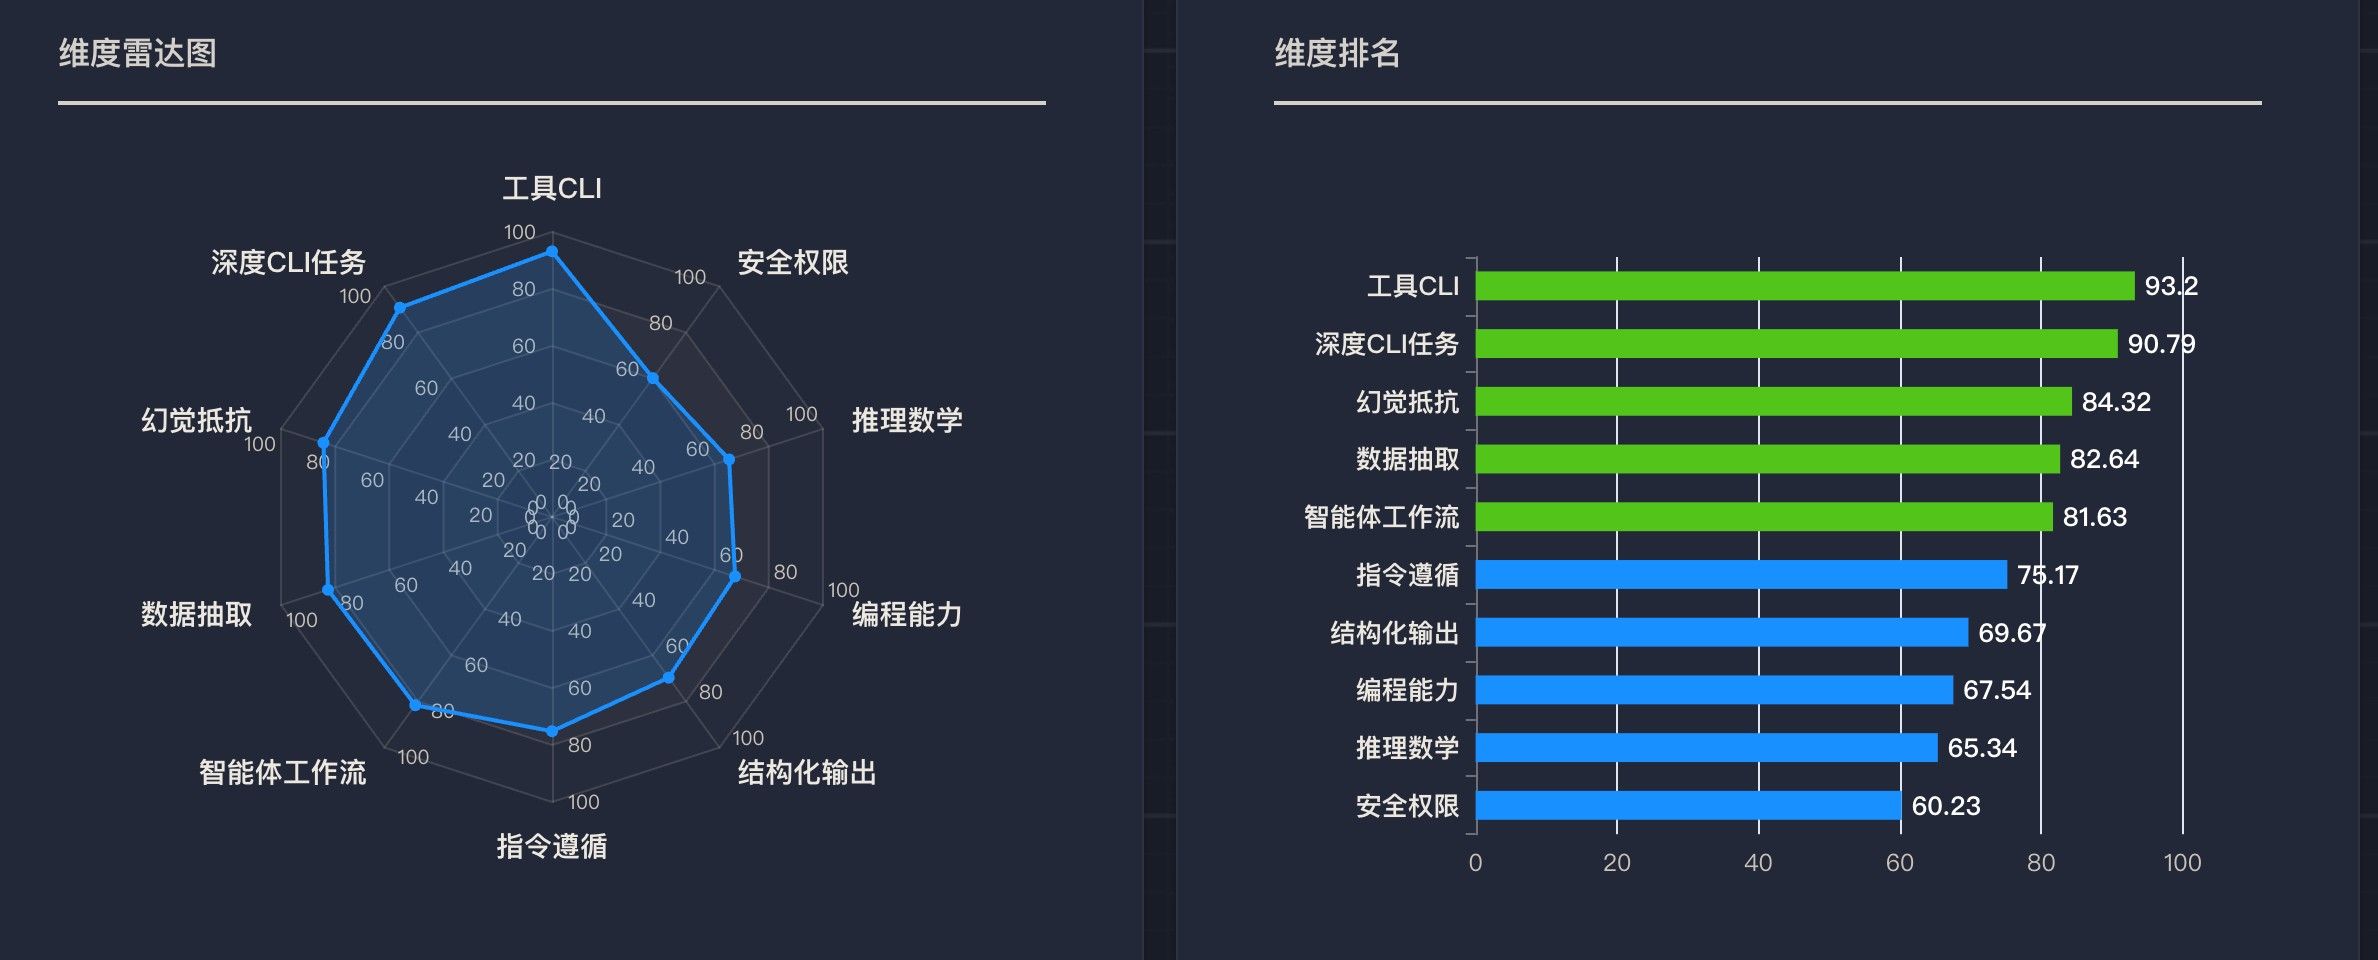
zx-bench 智秀评测截图,4并发
这是一份在 2× AMD Radeon AI PRO R9700 上,用 davetha 的 r9700-lru-expert-cache 把 Qwen3.8-Flash-Next 跑起来的实操记录。
结论先写在前面:
如果你只想复现作者那套 256k / ~90–140 tok/s,先看内存账,再决定要不要上这套。
双卡是 张量并行 TP=2(--tensor-parallel-size 2),不是数据并行。
| 参数 | git原作者默认(大内存) | 本机已跑通 | 作用 |
|---|---|---|---|
| 并行 | TP=2 | TP=2 | 一份模型切两张卡 |
LRU 热槽 HOT_GB |
15 GB / rank | 15 GB / rank | 显存里的可变专家槽;不要上 16,会挤死 KV |
上下文 max-model-len |
262144(256k) | 163840(160k) | 几乎只改 GPU KV,不改 PLE 体积 |
并发 max-num-seqs |
4 | 1(单用户) | 同时请求数 |
max-num-batched-tokens(NBT) |
4096 | 2048 | chunked prefill 块大小;越大越吃瞬时显存 |
| MTP | 4 draft tokens | 4 | speculative_config.num_speculative_tokens |
| KV dtype | fp8 | fp8 | --kv-cache-dtype fp8 |
| 专家 offload | --cpu-offload-gb 40 --cpu-offload-params experts |
同左 | 主层 MXFP4 专家走 host UVA |
| PLE | VLLM_PLE_CPU_OFFLOAD=1 |
同左 | ~47.75 GiB n-gram 表钉在 CPU |
| 视觉 | image 8 / video 1 | 关掉(MM_IMAGE=0 MM_VIDEO=0) |
省一点 host / 调度 |
gpu-memory-utilization |
0.97 | 0.97 | 尽量把剩余显存给 KV |
| prefix cache / chunked prefill | 开 | 开 | 长上下文必备 |
| 服务端口 | :8057 |
:8057 |
容器内 :8000 |
本机 wrapper 默认写的是 MAXLEN=32768;上面 160k 是启动时 MAXLEN=163840 覆盖的。160k 起来后日志:GPU KV cache size: 519,545 tokens(相对 163840 约 3.17×,NSEQ=1 用不满)。
测的是 32k 服务窗口、MTP-4、NSEQ=1、NBT=2048、text-only、LRU 15 GB/rank。数字是客户端扣掉 TTFT 之后的 decode,以及 prompt_tokens / prefill_time。
| 场景 | Prefill | Decode | MTP 接受率 | tok / step |
|---|---|---|---|---|
| 8k × 3(真实文本,逼 LRU 换入,不是 pad) | 594.6 ± 5.7 tok/s | 68.1 ± 10.0 tok/s | 38.8 ± 7.7% | ~2.55 / 5 |
| 32k prefill | 580–588 tok/s | — | — | — |
32k decode(ignore_eos + 半句续写) |
— | 91.2 ± 11.7 tok/s | 56.5 ± 7.0% | ~3.27 / 5 |
同一轮里用 padding 灌满 32k 时,模型会复读 pad,接受率会被抬到 70%+,不能当日常数字。上面 8k 的 ~39% 更接近正常写说明。
较早一版(padding 提示、单次 128 gen,仅供对照):
| 场景 | Prefill | Decode | MTP 接受率 |
|---|---|---|---|
| 8k / 8192 tok | 560.9 tok/s | 71.8 tok/s | 64.6% |
| 32k / 32000 tok(复读 pad) | 620.2 tok/s | 82.1 tok/s | 74.2%(虚高) |
MTP 深度用 metrics 核对:draft_tokens / drafts = 4。
curl -s http://127.0.0.1:8057/metrics | grep ^vllm:spec_decode
作者 fp8head arm:EPYC + 更大内存 + NBT 4096 + 256k + MTP-4 + 15 GB 热槽。单流 greedy,bench/ab3.py best-of-3:
| prose | JSON | code | prefill | |
|---|---|---|---|---|
| 静态热集(baseline) | 60.2 | 68.6 | 89.1 | ~3066 tok/s |
| 启动脚本默认(fp8head) | 93.1 | 138.8 | 128.5 | ~3551 tok/s |
作者并发(c8 全栈,aggregate tok/s):B=1 → 105.7,B=4 → 165.7。
Qwen3.8-Flash-Next 是超大 MoE:每层 512 个 routed expert,主层专家是 MXFP4。两张 R9700 一共约 64 GB VRAM,装不下全部专家。
常见做法是:
davetha 仓库改的是第 2 步:显存里仍是那批槽位(默认每卡 15 GB),但 槽里装谁由 GPU 上的两个 HIP kernel 在 decode 步之间决定。作者测到生产 trace 上 PCIe 专家流量从 432 MB/step 降到 86 MB/step,MoE grouped GEMM 从 21.1 ms/step 降到 4.2 ms/step。
同时还有一串 kernel-count 补丁(W4 draft LM head、fused SiLU-quant、fp8 target lm_head、MTP-4 等)。启动脚本默认复现的是 README 里的 fp8head arm。
权重用的是作者测数字的同一份 checkpoint:
| 项 | 值 |
|---|---|
| Hugging Face | davetha/q38fn-heretic2-mxfp4-fp8 |
| 来源 | Qwen/Qwen3.8-Flash-Next 的 MXFP4/FP8 量化,Heretic 去审查 |
| 体积 | 约 118 GiB,25 个 safetensors shard |
| 专家 | 主层 MXFP4;attention / MTP / PLE 为 FP8 |
换一份别的 Flash-Next 量化也能起,但不要拿它和 README 表格比速度。
作者 big |
这台机器 | |
|---|---|---|
| 主板 / CPU | Supermicro H12SSL-NT + EPYC 74F3(Milan,八通道) | 华南 X99-T8 + Xeon E5-2696 v3 |
| GPU | 2× R9700(推理只用这两张;同机还有 2× MI210) | 2× R9700(DID 0x7551,gfx1201,各约 32 GB) |
| 卡间 P2P | 两卡各占一条 Gen4 root port,没有 P2P | X99 双 root port;这套 vLLM 不依赖 Direct-P2P |
| Host RAM | 未写死,但从 EPYC + MI210 推断远大于 128 G | 128 G 安装,系统可见约 126 GiB |
| 宿主机 ROCm | — | 7.2.4 |
| 容器内 PyTorch | ROCm 10 / torch 2.11(gfx1201) | 同左 |
| 权重盘 | 未特别强调 | 必须放 NVMe ext4,不要从 NTFS/FUSE 直接 serve |
要点:GPU 型号一致,差的是主机内存、CPU 通道、PCIe 代数。 作者仓库默认 GPUS=1,2,那是因为他机器上 0/3 是 MI210。纯双 R9700 一般是 0,1。不要抄他的 GPU 下标。
本机 grub 里有 intel_iommu=on(以及 amdgpu.ras_enable=0)。对这套 LRU/UVA 路径,P2P 不是启动门槛——作者自己也没有 P2P。
按仓库 docs/VRAM_CENSUS.md,q38fn-heretic2-mxfp4-fp8 + TP=2 + --cpu-offload-gb 40 --cpu-offload-params experts:
| 块 | 每 rank / 全局 | 住哪 |
|---|---|---|
PLE / n-gram 表(*.ple.*) |
47.75 GiB(全局,不切 TP) | CPU only(VLLM_PLE_CPU_OFFLOAD=1),不能卸 GPU |
| 主层 MXFP4 experts | 29.88 GiB / rank | Host,UVA(--cpu-offload-gb 40) |
| LRU 热槽 | 默认 15 GB / rank | VRAM |
| 常驻 VRAM 权重(attn / GDN / MTP experts / lm_head / embed / 视觉塔等) | 约 6 GiB / rank | VRAM |
| KV(fp8) | 显存扣完热槽和权重后的剩余 | VRAM |
加载峰值比稳态更凶:PLE worker 要把约 48 GiB 表物化,两个 TP worker 同时把 checkpoint 读进来。这就是 94 G、甚至 128 G 也会在启动瞬间被 OOM killer 干掉的原因。
上下文长度几乎只改 GPU KV,不改 PLE 体积。 把 max-model-len 从 32k 调到 160k,救不了 host OOM。
经验阈值(单用户、桌面还要活着):
| Host RAM | 现实 |
|---|---|
| ≤ 96 G | 几乎必然 OOM(PLE worker 先被杀) |
| 128 G + NVMe swap | 能起来;稳态下 PLE 大部分在 swap |
| 作者那类大内存服务器 | PLE 留在 DRAM,才能接近 README 的 prefill |
128 G 上测到的稳态(服务已起来、空闲):
| 进程 | RSS | Swap |
|---|---|---|
PLE worker(multiprocessing.spawn) |
~4.1 GiB | ~44.7 GiB |
VLLM::Worker_TP0/TP1 |
各 ~42.4 GiB | 各 ~0.6 GiB |
| 整机 swap | — | ~48 GiB / 71 GiB |
也就是说:进 swap 的主要是 n-gram / PLE,不是专家权重。 Decode 打到冷 n-gram 项时会先从 NVMe 换页回来。
下面按「别人机器也能照着做」写。本机封装脚本路径单独标出。
/dev/kfd、/dev/dri/renderD128 / renderD129,用户在 video + render 组。docker 组(否则每次 sg docker -c '...')。ghcr.io 时,要把代理配到 dockerd / containerd,只 export 当前 shell 的 http_proxy 不够。Ubuntu 24.04 + Docker 29 用 containerd-snapshotter 拉层,必须给两个服务都写 drop-in。本机脚本:
~/sglang/scripts/install_docker_flashnext.sh   # apt 装 docker,加组
~/sglang/scripts/setup_docker_proxy.sh         # dockerd/containerd → Clash :7897
# 可用镜像站;本机脚本默认 HF_ENDPOINT=https://hf-mirror.com
hf download davetha/q38fn-heretic2-mxfp4-fp8 \
  --local-dir /path/to/fast-nvme/q38fn-heretic2-mxfp4-fp8
本机先下到机械盘 NTFS(/mnt/hdd/llm-storage/...),再 byte-identical 拷到:
/home/minghao/models/q38fn-heretic2-mxfp4-fp8 # 125913314711 bytes,25 shards
不要从 NTFS / FUSEBLK(/mnt/hdd、/mnt/ssd 这类)直接给容器 serve。加载本来就把 host RAM 顶满,再叠加 FUSE 延迟,失败面更大。
本机下载脚本:~/sglang/scripts/dl_q38fn_mxfp4.sh。
系统自带 /swap.img 只有 8 G,装不下 PLE。在 系统盘 NVMe 上另做一块:
sudo fallocate -l 64G /home/$USER/swap-fn.img
sudo chmod 600 /home/$USER/swap-fn.img
sudo mkswap /home/$USER/swap-fn.img
sudo swapon /home/$USER/swap-fn.img
# 可选:写入 /etc/fstab,prio 高于系统 8G swap
本机实际是 /home/minghao/swap-fn.img(64 G,prio 10)+ /swap.img(8 G)。合计约 72 G。
警告: 启动失败时 Linux OOM killer 可能连 GNOME/GDM 一起杀掉。启动前关掉重桌面负载,容器建议加 --oom-score-adj=-300,保护图形会话。
git clone https://github.com/davetha/r9700-lru-expert-cache
cd r9700-lru-expert-cache

docker build -t local/q38fn-rocm10:try1  -f docker/Dockerfile       docker/
docker build -t local/q38fn-rocm10:build -f docker/Dockerfile.build docker/

# 确认容器能看见两张卡
docker run --rm --device /dev/kfd --device /dev/dri --group-add video \
  -v "$PWD:/repo" --entrypoint python3 local/q38fn-rocm10:try1 /repo/docker/probe.py

./prebuilt/install.sh                # 预编译 gfx1201 的 librlu.so 等
./patches/apply_patches.sh --dry-run # 必须先 dry-run
./patches/apply_patches.sh
./templates/fetch.sh                 # 修正过的 Qwen chat template
镜像分层:
ghcr.io/davetha/vllm-flashnext:DevQwenNextFlash(原 tcclaviger/vllm:DevQwenNextFlash 的镜像;上游 Docker Hub tag 已于 2026-09-05 删除)。local/q38fn-rocm10:try1。r4d.so / libfp8hip_gemm.so 在底包里,不在这个 git 仓库里。本机一键:~/sglang/scripts/setup_flashnext_images.sh。
python3 - <<'PY'
import torch
for i in range(torch.cuda.device_count()):
    p = torch.cuda.get_device_properties(i)
    print(f"HIP {i}: {torch.cuda.get_device_name(i)}  {p.total_memory/2**30:.1f} GiB")
PY

# R9700 = PCI device id 0x7551
for d in /sys/class/drm/card*/device; do
  [ "$(cat $d/device 2>/dev/null)" = "0x7551" ] && echo "R9700: $(basename $(dirname $d))"
done
纯双 R9700:GPUS=0,1,VRAM_CARDS 填上面打印的 cardN。混插 MI210 时不要用 0,1。
官方默认(大内存、256k、并发 4、NBT 4096):
export MODELS_DIR=/path/to/parent-of-checkpoint
export MODEL=/models/q38fn-heretic2-mxfp4-fp8
export GPUS=0,1
export VRAM_CARDS="card0 card1"   # 按 4.5 改
./launch/launch_q38fn.sh 15 262144
服务默认 宿主机 :8057 → 容器 :8000,容器名 q38fn-mxfp4,served name q38fn-mxfp4。
本机 128 G、单用户、已验证能起来的组合:
MAXLEN=163840 NSEQ=1 NBT=2048 \
  sg docker -c 'bash /home/minghao/sglang/scripts/start_flashnext_lru.sh'
本机 wrapper:~/sglang/scripts/start_flashnext_lru.sh
它会设好 MODELS_DIR=/home/minghao/models、自动扫 0x7551 的 VRAM_CARDS、关掉图/视频,然后 exec:
~/r9700-lru-expert-cache/launch/launch_q38fn.sh
Wrapper 文件里的默认是 MAXLEN=32768;160k 要靠环境变量覆盖,没有写死。
启动脚本还会:
docker rm -f 旧容器,并等到名字释放、两张卡 VRAM 降下来;profiles/hot_profile.json 做 per-layer 热启动;关键容器环境(完整列表见 launch/launch_q38fn.sh):
VLLM_PLE_CPU_OFFLOAD=1
VLLM_R4D_HOT_PROFILE=/hot/hot_profile.json
VLLM_R4D_HOT_GB=15
VLLM_R4D_LRU=1
VLLM_R4D_LRU_FUSE=1
VLLM_UVA_OFFLOAD_EMBED=1
VLLM_UVA_OFFLOAD_VISUAL=1
关键 vLLM 参数:
--tensor-parallel-size 2
--kv-cache-dtype fp8
--cpu-offload-gb 40 --cpu-offload-params experts
--gpu-memory-utilization 0.97
--enable-prefix-caching --enable-chunked-prefill
--speculative-config {"method": "mtp", "num_speculative_tokens": 4}
日志里必须看到类似:
r4d LRU expert cache: ON (lib ..., thresh 0.50, max_inserts 64, grid 8x16)
r4d LRU: layer 0 -> 257 slots warm-started from the profile hot set,
         read-through above 128 distinct experts/step
如果是 r4d unavailable,某个 bind-mount 补丁 import 失败,MoE 会静默退回官方热集。数字全部作废。这是静默失败,启动后务必搜这一行。
160k 启动成功时,本机日志里还有:
GPU KV cache size: 519,545 tokens
相对 163840 的并发大约 3.17×(max-num-seqs=1 时用不满)。32k 启动时同一套账只报过约 219k KV tokens——hybrid GDN/QSA 的 KV 预算会随 max_model_len 重算,不要拿两次启动的 KV 行直接相减。
256k(MAXLEN=262144 + HOT_GB=15)在这台 128 G 上 没有稳定跑通。若要试,先把 HOT_GB 降到 13–14,给 KV 留空,并接受更差的 expert hit rate。
不行。OOM 发生在 PLE 物化 + 双 TP 读盘 的加载峰值。max-num-seqs=1、关掉视觉塔,只能减 GPU 和一点 host,砍不掉那 48 GiB 表。
权重 118 G,加载期两个 worker 一起读。FUSE NTFS 会把峰值拉得更长,更容易和桌面抢内存。先 cp -a 到 NVMe ext4,再挂进容器。
8 G 系统 swap 不够。64 G 文件必须在 NVMe 上。PLE 进 swap 之后服务能活,但 prefill 会掉一个数量级。
一次「瘦身重启」触发 OOM killer,GDM/GNOME 被干掉。后来给容器加了 --oom-score-adj=-300。启动时不要同时编译、浏览器开几十个标签、或再拉一个大模型。
docker pull ghcr.io/... 走 containerd,必须给 docker.service 和 containerd.service 写 HTTP_PROXY。本机 Clash 只开 7897,没有 7890。
部分网络环境下 pull 会卡在 IPv6。GPU 下标抄作者的 1,2 会直接跑到不存在的设备或错误的卡。
32k 散文、提示里写「忽略 padding」时,模型可能立刻 EOS、生成空。测 decode 要用 ignore_eos,或用半截句子当续写(本机用过「LRU缓存的核心思想是」)。
吞吐、接受率、作者对照和启动档位见文首 「性能参数与实测」。这里只补测量时要注意的两点:
pad,MTP 接受率虚高;要用真实长文或半句续写,并考虑 ignore_eos。http://127.0.0.1:8057/metrics 里 draft_tokens / drafts 应为 4。分词走 POST /tokenize。OpenAI 兼容,模型名 q38fn-mxfp4,端口 8057。
Flash-Next 默认开 thinking。关思考是请求级参数,不是启动开关:
{
  "model": "q38fn-mxfp4",
  "messages": [{"role": "user", "content": "你好"}],
  "chat_template_kwargs": {"enable_thinking": false}
}
reasoning_effort、preserve_thinking 同样生效。
# 权重
/home/minghao/models/q38fn-heretic2-mxfp4-fp8          # 线上用,NVMe ext4
/mnt/hdd/llm-storage/q38fn-heretic2-mxfp4-fp8          # 原始下载,NTFS,不要直接 serve

# 仓库与镜像
/home/minghao/r9700-lru-expert-cache
  launch/launch_q38fn.sh
  profiles/hot_profile.json
  build/MOUNTS.txt
  build/kernels/librlu.so
local/q38fn-rocm10:try1                                # 运行镜像

# 本机封装
~/sglang/scripts/start_flashnext_lru.sh
~/sglang/scripts/setup_flashnext_images.sh
~/sglang/scripts/dl_q38fn_mxfp4.sh
~/sglang/scripts/install_docker_flashnext.sh
~/sglang/scripts/setup_docker_proxy.sh

# Swap
/home/minghao/swap-fn.img                              # 64G,需 swapon
/swap.img                                              # 系统 8G

# 服务
容器 q38fn-mxfp4 ,宿主机 http://127.0.0.1:8057
再拉起上次 160k 配置:
MAXLEN=163840 NSEQ=1 NBT=2048 \
  sg docker -c 'bash /home/minghao/sglang/scripts/start_flashnext_lru.sh'
按优先级:
apply_patches.sh --dry-run,再启动。r4d LRU expert cache: ON。NSEQ=1、MM_IMAGE=0 MM_VIDEO=0,起来再加并发和视觉。HOT_GB 不要上 16:作者测过 16 GB 槽位会把 KV 挤到起不来(「2.4 GiB KV needed, 2.12 GiB available」)。15 GB + NBT 4096 是他那边每次都能起来的最大组合。本机内存更紧,NBT 先用 2048。ghcr.io/davetha/vllm-flashnext:DevQwenNextFlash我就一张7900xtx,之前试sglang 跑fp8 双r9700 开mtp,32k ctx会掉到10几tok/s,普通请求40 -50,关mtp 32k也能稳定25左右tok/s,短的也差不多
@stormaround
关于「DFLASH 牺牲视觉」:不会,正好今天实测验证了。DFLASH 只参与 decode 阶段(草稿出 token),图像编码在 prefill 阶段完成,两段正交。twolven 这个 AWQ 版视觉塔保留 bf16 未量化,模型卡原文就有 "vision still works"。今天 curl 直传图片实测:读图 100% 正确(形状/颜色/文字全对),同时段 DFLASH accept rate 0.28-0.40 照常跑,零冲突。真实照片测试连法文成分表都能正确 OCR。
那还可以,之前用双r9700跑tp2,mtp和dflash速度差不多,就没有再去调dflash
dflash好像要牺牲视觉,两张3090 nvlink 接近两万了,而且现在二手都是矿渣,感觉不是很值
3卡好像不能跑tp3,流水线并行,sglang比较稳,3张卡跑qwen3.8-27b-fp8,显存相当充足,感觉bf16没有必要,5个人完全没有问题,如果想折腾也可以考虑qwen3.8-flash-next,这么大内存确实可以考虑下。27b比较稳,qwen3.8-flash属于知识面广,看需求。flash 那个moe,q4量化容易漂移。27b跑双卡tp也不错。
35b经常死循环,一直重复