

由于站长和网站管理团队缺乏法律、财务、税务等方面的知识,无法对相关话题做出准确判断,无法确定相关内容是否会对会员产生误导,因此即日起,禁止在论坛讨论相关话题。同时,在网络区禁止讨论翻墙以及其他违反中国法律的相关话题,但是可以讨论服务器配置,网站经营等话题。
本站点坚持以AI技术为核心,交流谈论赚钱,本网站亦无技术能力兼容或者限制国内访客。有违规者,没有警告程序,直接禁言或者封号。由于站长本人在中国大陆,必须遵守法律法规,所以请见谅!
之前我在视频里说我配置这个东西就是让DeepSeek harness + DeepSeek V4 Flash配置的,我没有安装插件,但是没想到论坛有哥们到现在还没有配置成功,不要问别人了,直接来抄作业,如果这个帖子看了,你的AI还不会,你就把系统格式化,重装,它应该是觉醒了,耍你呢........
@wml-ai
还有哥们,不要用其它模型来复刻这个东西,每个模型之间的差异很大,有的模型看起来不错,实际上干活很蠢。我没必要骗大家.......
对了,请大家抄作业之后,对发布者表达最基本的尊重,我的帖子不需要,因为我脸皮厚。
论坛一些不错的7900XTX SGLang双卡的,MinimaxH3跑视频的,4090 SGLang跑Dflash的,说实话,这些帖子折腾出来,做到复制给AI就能抄作业的程度,是挺难的,你多给点赞,别特么上来就你的2080Ti跑的更好,你跑的再好是你的事情,不要说别人的方案不行,就你能,你能你还发更好的帖子啊。再发现这种贱人一律封禁。
@Jun 我弟,你这个卡很有可能是我换下来的那一批,就是外观一模一样,人在台湾,本节目一直建议,大陆之外不要买魔改卡,买Pro5000. 你确信你看了我的视频吗?
另外你的处理方式我非常不理解,你在台湾也不妨碍你邮寄啊,邮寄才多少钱,和这张卡的价值比起来才多少点?你直接申请换货,你还和客服沟通,技术支持?返修?究竟为什么?
还有卖掉的说法,还剩余多少残值?你这么有钱还在乎残值?可以换新你都不愿意,非要卖?不在乎钱半价卖给我,我虽然不需要第二张,但是想转手赚点钱。
“我这次卡在「卖家在中国、人在台湾」的位置,非常难处理。”
在论坛你要规范用语,卖家在大陆,人在台湾,再有下次,必然封号。本论坛不讨论政治,偶尔讨论科技的时候可以擦边,但我不找大家的麻烦,大家也不给我找麻烦。
我从来不在这里喊解放台湾,统一祖国,这不是我这个论坛的使命,你也少来钻空子。大陆和台湾并列,你不会有麻烦,我也不会,你要自重。我人在大陆,要遵守大陆法规,你如果在B站这样评论,也会被封号。
呃,我们论坛的这个超级版主 SirWang,他跟英特尔有一定的渠道联系,可能是有商务合作吧。反正他之前在我们这个论坛里发的一些英特尔显卡的帖子,如果说有些工作流跑得不好,或者说有 bug,那么我们也会指出来,人家很快就能够联系到英特尔的官方,来把这些问题解决,然后提供一个能跑的工作流。但是后来呢,我发现确实对这位老兄的要求有点太高了,因为 SirWang 多次联系英特尔之后,多次改进英特尔的 ComfyUI 工作流,但是依然跟 AMD 和英伟达的差距非常明显,以至于后来我们在这个论坛中已经不怎么去推英特尔的这些帖子了。就是讲实话,有点烂泥扶不上墙的味道。
然后呢,SirWang 就在这个群里面,这两天又发了两个图片。讲的是什么呢?说这个英特尔可能是找秋叶给它做了一个 ComfyUI 系列整合包。然后在这个英特尔的展会上,英特尔举办了一个叫“技术创新与产业生态大会”的活动,上面放了一些东西来介绍,叫什么英特尔 Intel Connection“同芯·智远”。
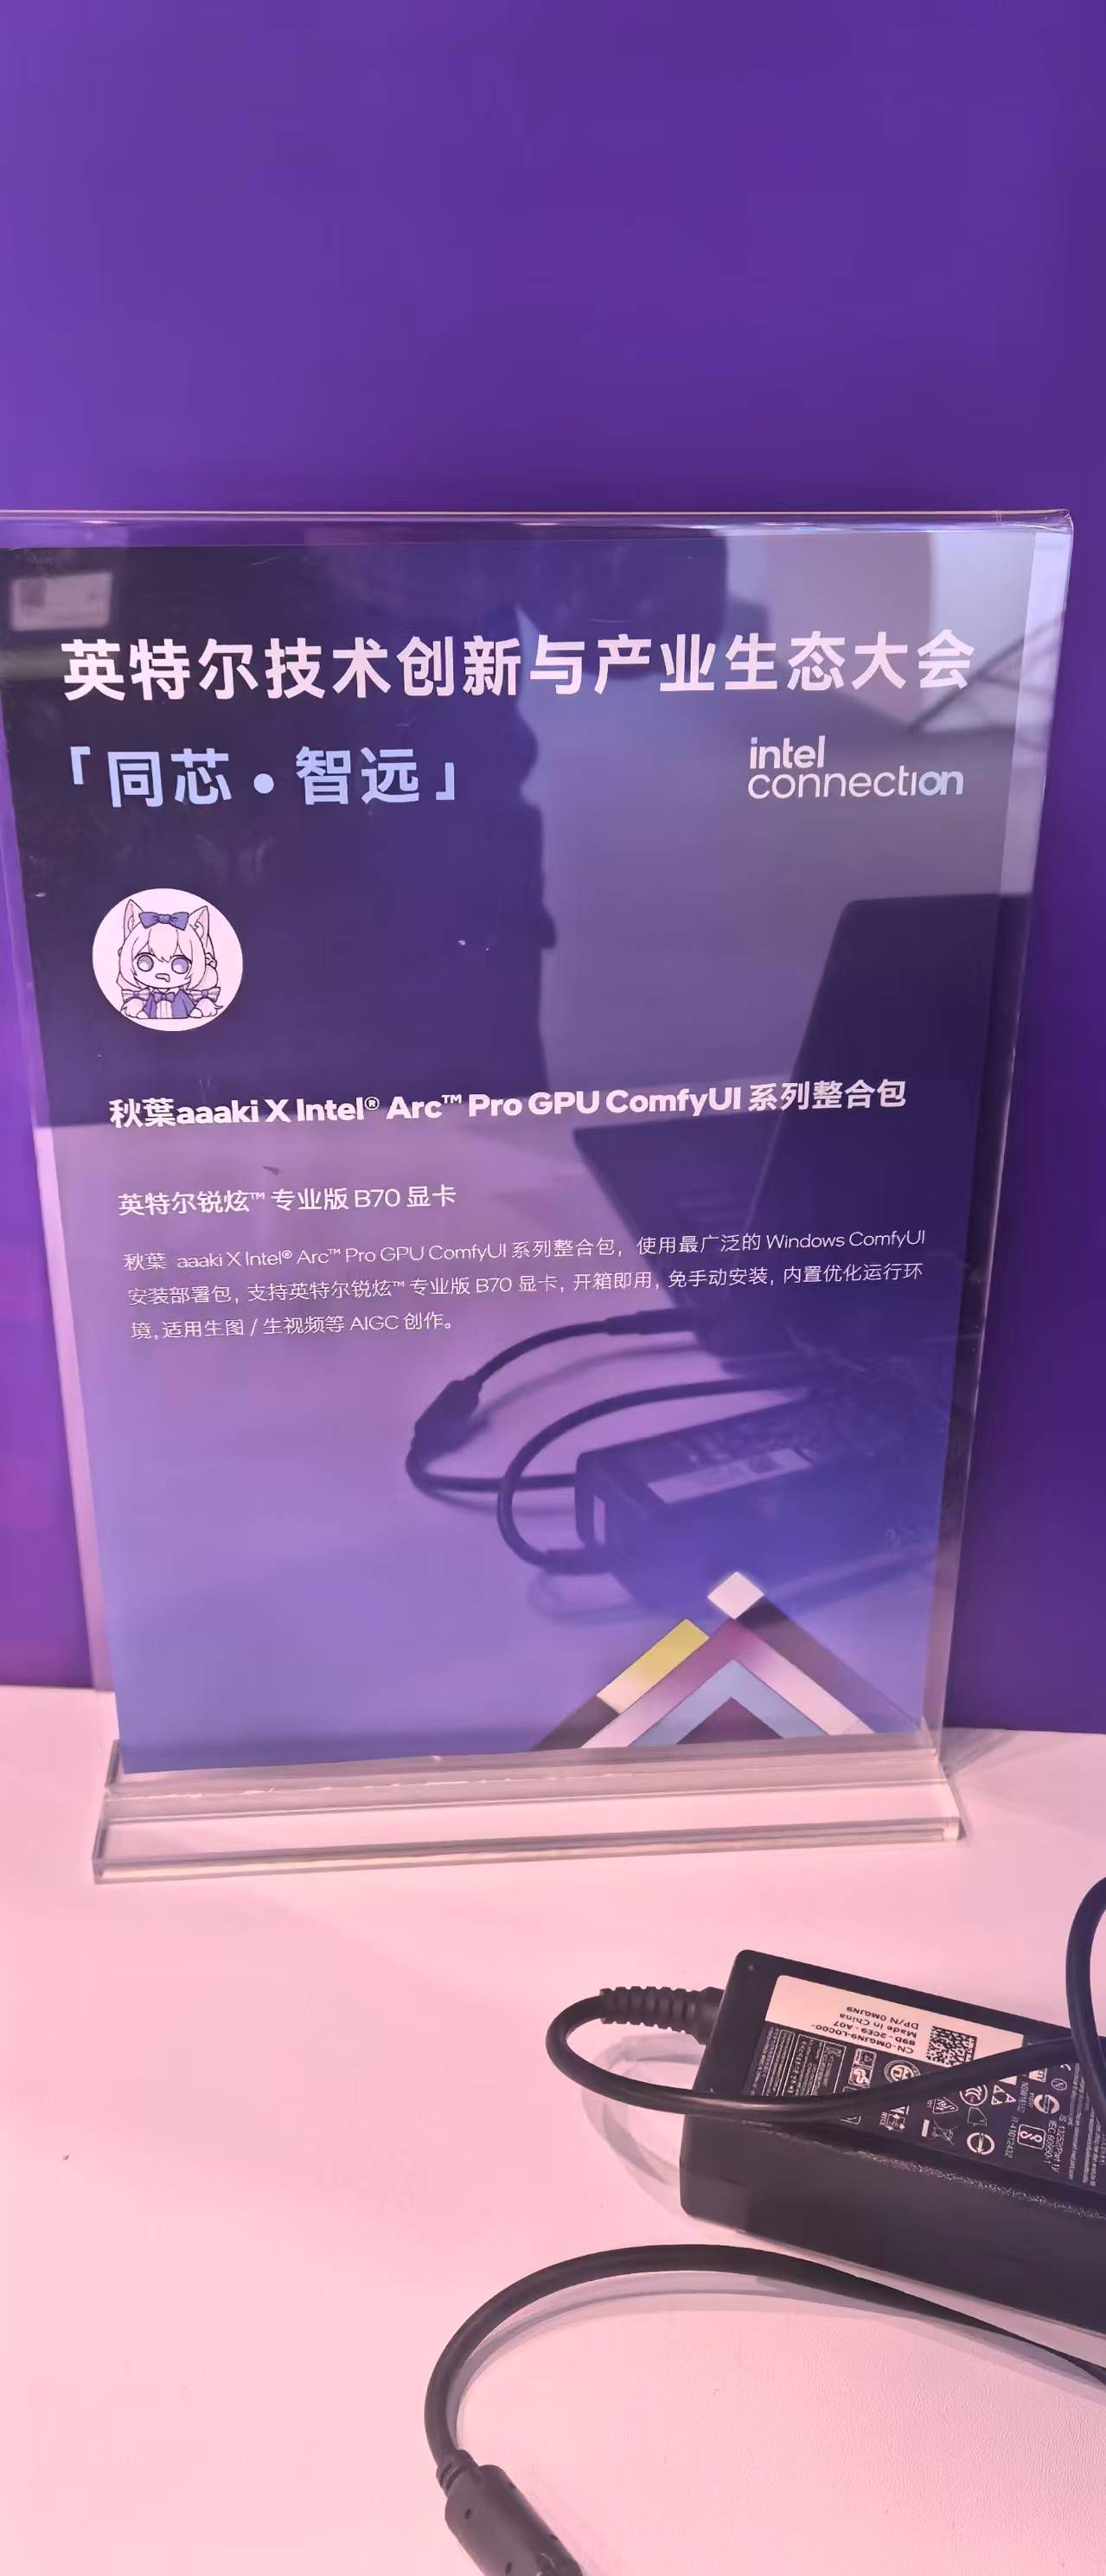
下面就放着一个萌萌的秋叶头像,就说这个“秋叶 aaaki X Intel Arc Pro GPU ComfyUI 系列整合包”。然后下面是英特尔锐炫专业版 B70 显卡,几行小字就强调,秋叶的这个整合包是使用广泛的 Windows ComfyUI 整合包,支持英特尔锐炫 Pro B70 显卡,开箱即用,不用手动安装,内置工作流,好像是适用于生图,还有生视频的这么一个 AIGC 创作。
我讲实话,这个秋叶大神,如果我没记错的话,已经很久没有发布新的整合包了。我不知道英特尔是不是在炒冷饭,就是在自家的 AI 创作生态大会上面,然后把这个秋叶的萌萌头像挂上去。他甚至把那个秋叶用的虚拟人物,自己打印了一个纸板人,把它放在这个展台上,在电视上面展示这个 ComfyUI 的整合包,就是秋叶的这个整合包。就令人匪夷所思啊,我不知道它们给了秋叶多少钱,是不是说秋叶大神最近又想回来恰饭了,不太理解。也或许是炒冷饭吧,可能合作是之前的。总之呢,英特尔的这些动作有点让人匪夷所思,它们可能对于当下的这个 AI 生态完全脱节了。
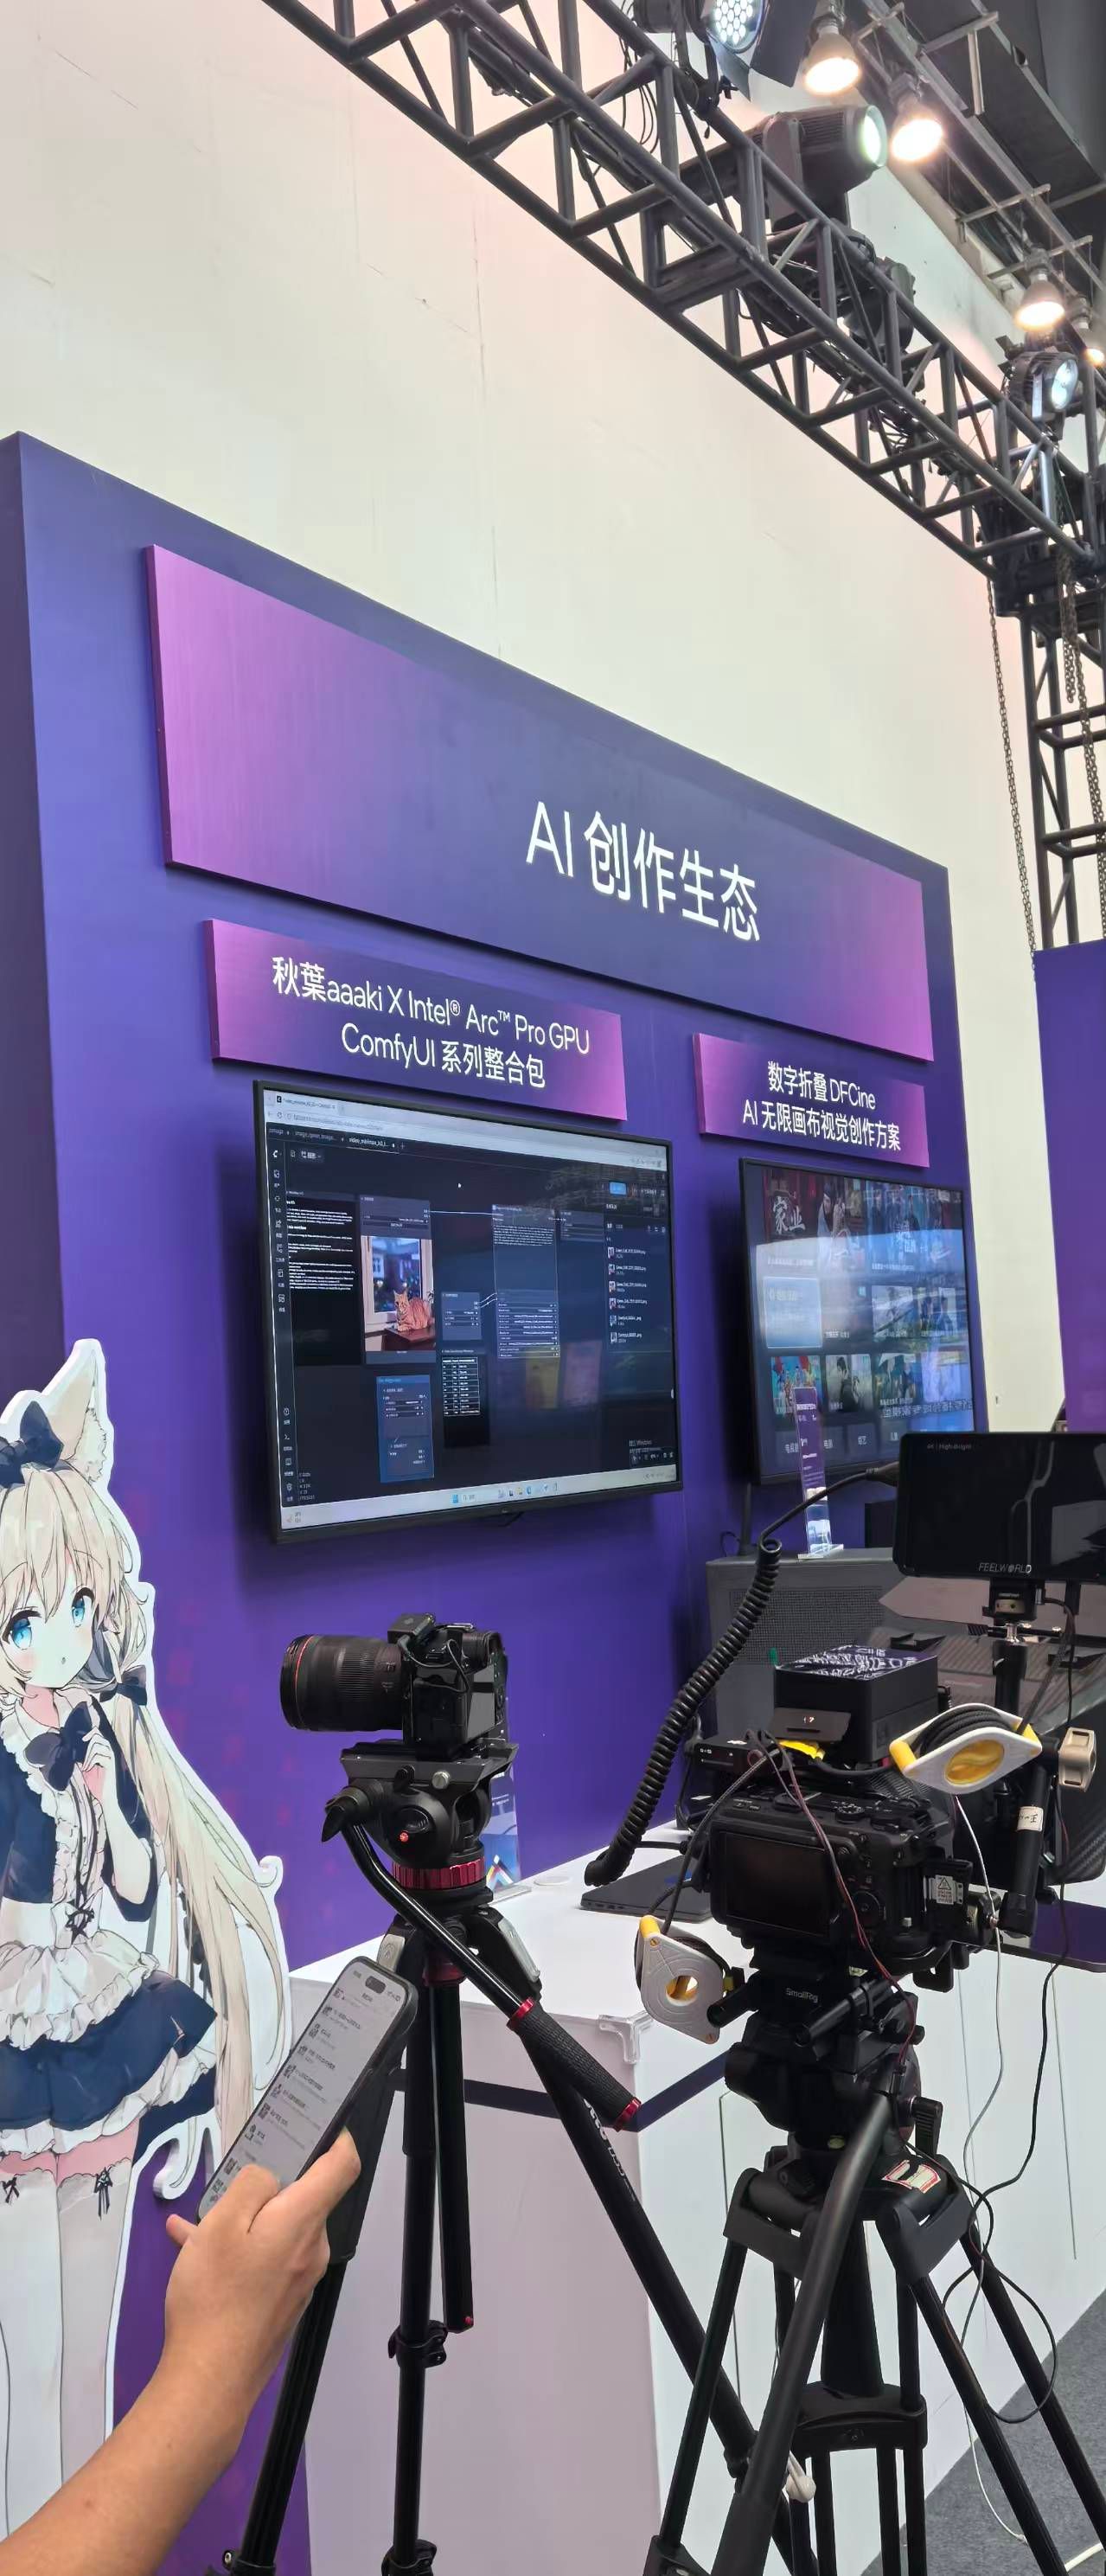
现在没有人还关心底层的这个 ComfyUI 怎么跑起来了。第一就是 ComfyUI 官方的 portable 版本,也就是绿色版,它的整合包就非常好地支持 AMD 和英伟达的显卡,在 Windows 上跑起来其实效果是非常好的。那么 AMD 还有机智 Box 等一些其他的第三方整合包,生态非常好。我想大家可能早就忘了英特尔还有显卡了,是吧?你说你这个时候如果想要打生态,你应该拿出跟 AMD 和英伟达能够正面抗衡的显卡,拿出有性价比的。人家 AMD 的生态不如英伟达,人家有这个自知之明。比如说 Radeon AI PRO R9700,它比这个 4080S 32G 要便宜,一万出头的价格。你看人家卖一万出头,你也卖一万块钱。你这个 B70 也是 32G 的显存,结果你的生态跟狗屎一样。ComfyUI 基本上就没办法玩。
就是我们这个 SirWang 能够联系到你们官方的技术人员,在你们官方技术人员的支持下折腾了很久、扑腾了很久,你们也没有把所有的问题都搞定,也没有做到跟 AMD 差不多的体验,跟英伟达就更不能比了。现在你说你们进入这个 AI 领域已经很久了吧,到目前为止还是拿出一张 B70 32G 的卡。讲实话,我们个人玩家还能玩一玩,32G 显存还不错。对于稍微有点生产力需求的,像我这样的屌丝,都得上个什么 4090 48G 魔改卡。就你们要拿出诚意啊,你老是发一些规格非常脑残的卡,什么 B60,弱得一逼,生态又差,这个显存也不强,然后你还搞那个什么 B60 双芯。你们为什么不能直接发布一个便宜点的 48G 显存的单芯卡呢?你让我们省心一点呢?你的这个双芯就不能用来跑 ComfyUI。你们与其生产这种烂货,把宝贵的产能浪费在这些烂卡上面,也不愿意为消费者提供一点让利,为消费者提供一点新的、有诚意的产品。你说你们能搞得起来吗?
就像之前我喷这个 AMD,我说 AMD 为什么长期在这个显卡领域被英伟达给吊打,就是因为它做产品脑残,知道吗?它们的设计师可能根本就不用自家的显卡。你们明白我说的意思吗?我记得我大学时代好像是买过一张卡,叫做 Radeon 9550。那个时候 AMD 的 Radeon 9600,包括这个 9600 Pro,还有什么 9700,我记得好像是有这张卡。这个全家桶其实是非常有性价比的。但是 AMD 它跟英特尔一样,它就是犯贱,就是它的生态不好,但是它又不愿意给消费者让利。好比说这个英伟达的卡卖 12 块钱,它的体验有 20% 是由于来自这个生态上面的溢价,确实它的体验会更好一点。那么 AMD 愿意给你便宜,但是就便宜两块钱,它卖 10 块钱。它一分钱真正的让利都不肯给消费者,所以它这么多年也没有积累什么忠实的粉丝。没有人对 AMD 有这个忠诚度,它如果买 AMD 的卡,一定是因为便宜。
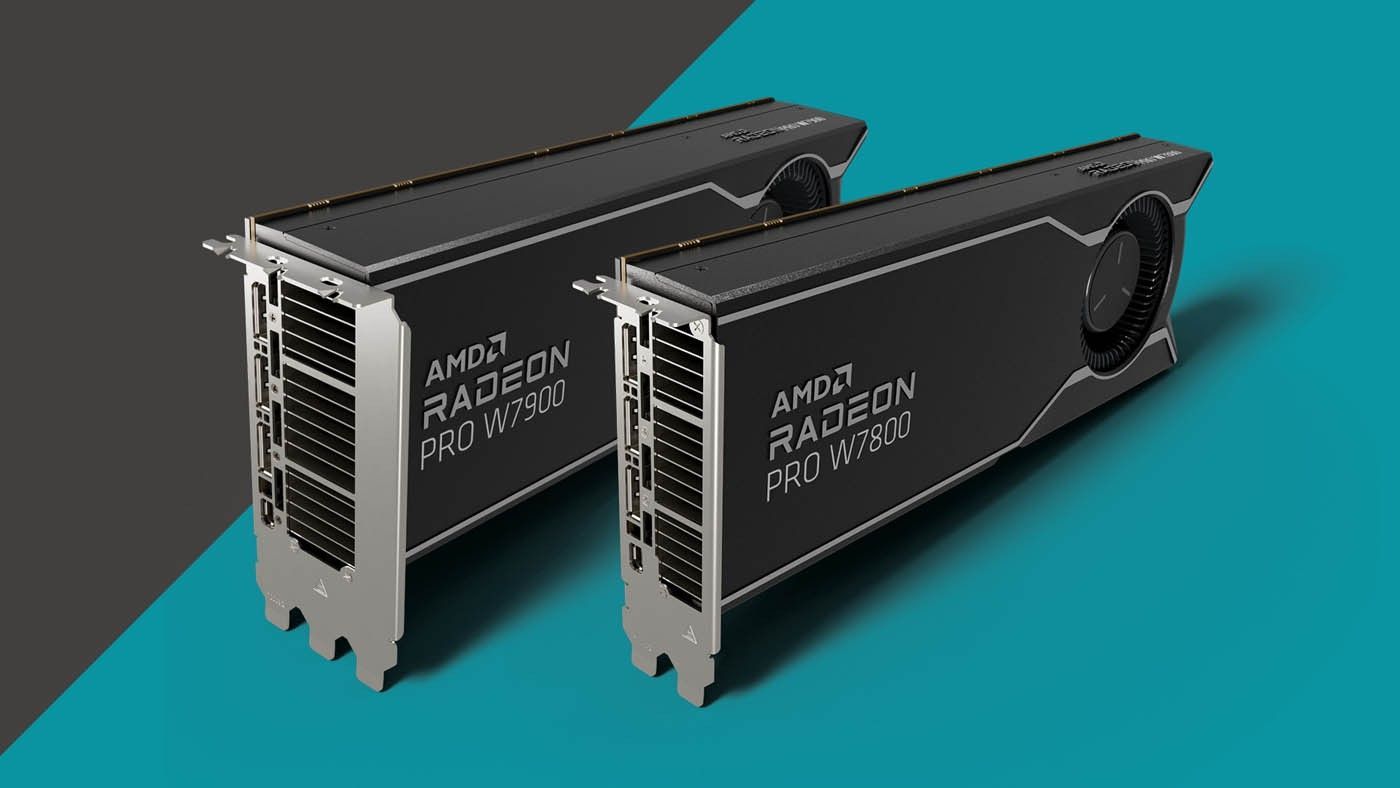
但凡他还想要一点体验,他看到老黄有稍微有一点点性价比的卡,这些人就立刻就会被老黄拉走。所以 AMD 这么多年一直都是当小媳妇,一直都翻不了身。那么我们说进入这个 AI 时代之后,AMD 也是屡屡发力,它消费级有这个 7900 XTX,然后小的工作站有 Radeon AI PRO R9700,也有 W7800、W7900 这些稍微能够打一打的卡。但是你们发现,它们跟对应的、跟同价位的 N 卡比起来,就是提不起劲啊。比如说这个 Radeon AI PRO R9700,它就是比 4080S 32G 魔改卡性能要差一点,然后便宜一点点。它永远是这样的定位,永远拿不出一张让你为之一振的卡,让你觉得,我就是愿意为了它的性价比去折腾生态。它永远都拿不出来。
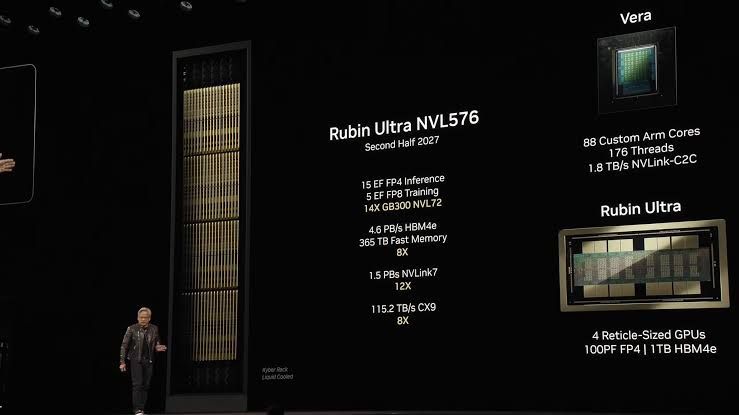
那你说老黄人家现在可以说什么微软、OpenAI 了,包括马斯克的这个 xAI,人家这些大企业、世界各国的企业都在排队抢购英伟达的显卡,甚至说你动作抢得慢,你都买不到,排队都不一定能买得到。在这种情况下,你说老黄如果完全抛弃个人的 AI 生态领域,人家不搞了,人家就去伺候那些大企业,能不能玩得转?这个利润是不是更高?我别的不说,就说把 5090 直接全部砍掉,全部用来生产 RTX Pro 6000,性能差一点的、质量不太好的、有瑕疵的芯片,就用来换个马甲,用来做 RTX Pro 5500,那是不是能卖很多钱?但是老黄人家是不是还是发布了 5090 32G,还是发布了 5080?你 AMD 就直接把 24G 的个人旗舰卡都给砍了,就直接推出什么 9070 这样的 16G 显卡。你说你们平时不注重打生态,然后看着老黄因为生态走红、因为生态大赚特赚,你们就想推出一些垃圾卡去分一杯羹。你说你们这样的公司怎么可能搞得过老黄?
当然了,我个人也是买了 AMD 的 7900 XTX,因为讲实话,这张卡性价比还是非常不错。但是我就有点非常不大理解,就是说你 AMD 如果没有能力研发能够去打什么 5090 的卡,你就不要装逼,不要做什么工作站卡。你就把那个 7900 XTX 发布一个 32G 的,或者发布一个 48G 的版本,这不就行了吗?都不需要你重新研发。你干嘛要把这个版本做成什么 W7900,然后卖好几万一张?你不脑子有屎吗,是不是?你生产这样的垃圾卡卖给消费者,消费者如果真的是花了三四万的价格去买了你的这个 W7900,然后他再跟老黄的这个工作站卡一比,你说他们恨不恨你?你们做这一单生意还有没有后续?你的生态是不是越来越小?
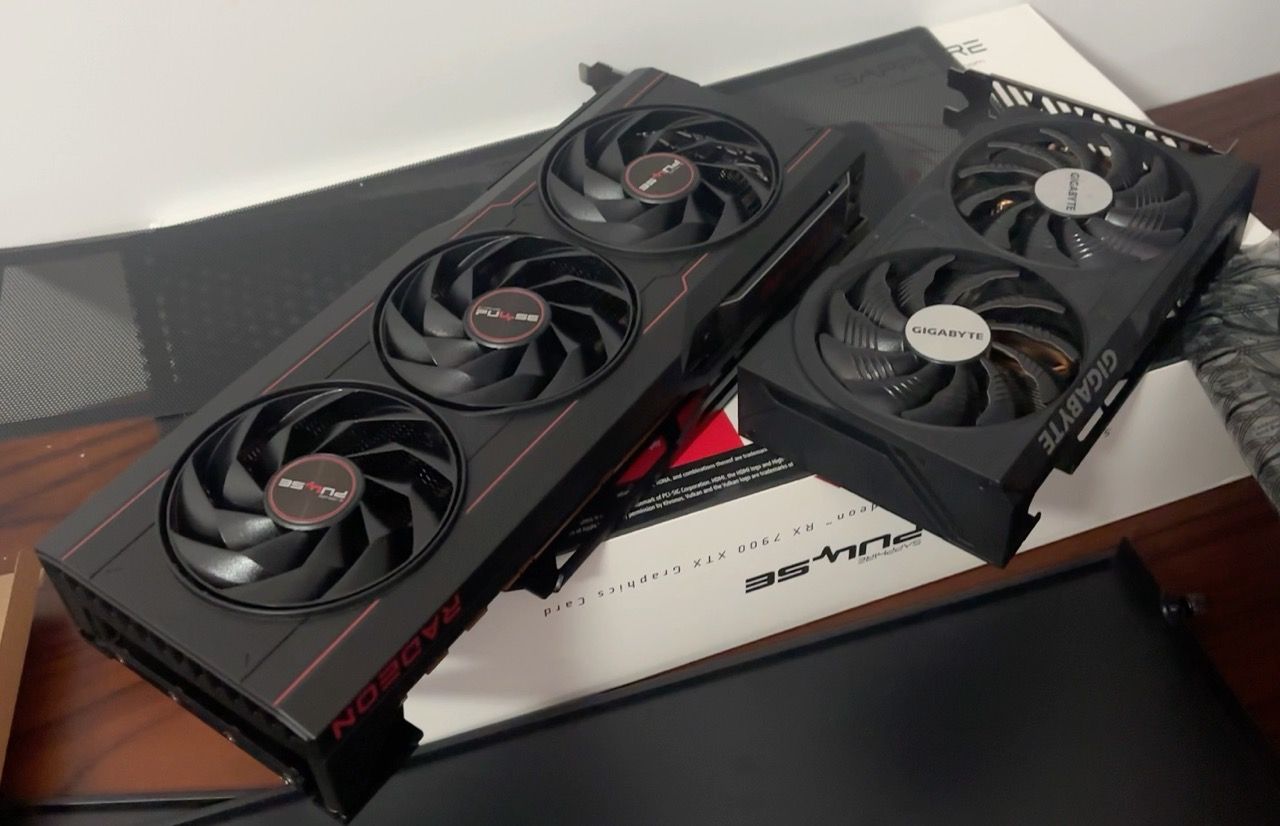
然后你 AMD 的个人玩家发现,7900 XTX 这张卡不错,但是它是 24G 显存。如果说我要升到 48G,哎,没有魔改的途径。我再一看它官方的 48G 版本,就是 W7900,它居然要好几万一张。他会不会觉得自己的智商受到了羞辱?是吧?就说你们这两家公司就不是来打市场的,说白了,你们进入 AI 市场就不是说要玩家跟你们一起去所谓的共建生态,你们就是想让玩家当凯子。就你们完全不知道玩家在干什么。
甚至我不是说了吗?我说这个 AMD 的工程师可能从来不用自家的显卡,那英特尔的工程师我基本上可以肯定,出了他们的办公室,他们很有可能回家打开的也是老黄的显卡。你说你们这样子搞,怎么可能在生态上面超越英伟达?我给你们举一下老黄人家的产品创新。你说老黄的刀法好,但是你看看人家,从 RTX Pro 4000 到 RTX Pro 4500,然后 5000、5500、6000,人家是全家族生态。除了官方之外,还有什么 4080S 32G 魔改卡,有什么 3090 的老涡轮卡,有 4090 48G 魔改卡。游戏旗舰人家还有 5090 在。老黄这个 5090,哪怕提下来再卖个三年,你 AMD 也出不了一样的卡。更不要说老黄还有一些洋垃圾的生态,比如 CMP 170HX,比如 2080 Ti,再比如老的 RTX 8000 之类的。那你说在这种情况下,再加上 V100 32G 这些卡,你说你们的生态怎么可能干得过老黄呢?
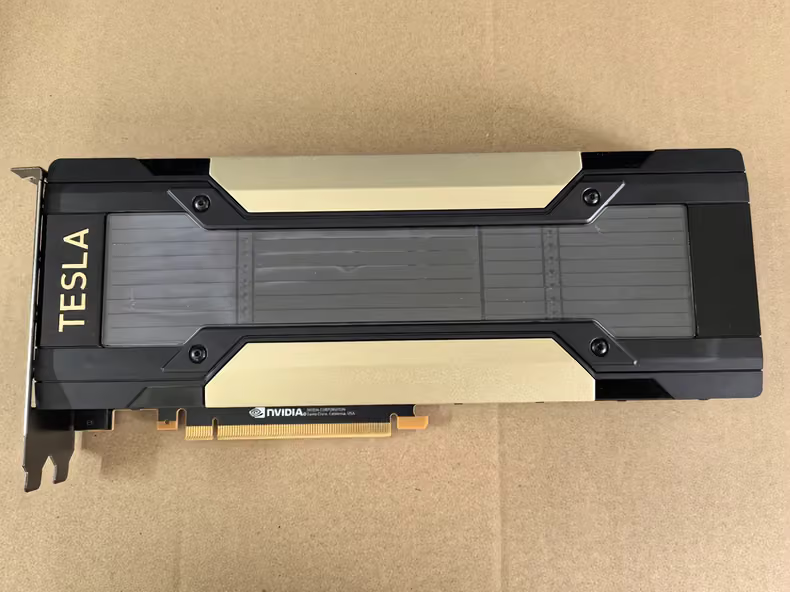
就你们一点便宜都不让玩家占,一点都不愿意让利,就想着玩家免费用自己的钱包,掏个一万块钱来买你这个什么狗屁 B70,然后为你这个打生态,给你英特尔当凯子,可行吗? AMD 人家好歹官方还做了一些生态的美化、生态的优化。我们别的不说,就是今年 AMD 的生态,无论是在开源的 Vulkan 上面,还是它这个闭源的 ROCm 驱动上面,都有长足的进步。这个不说它的卡硬件上残疾,就生态已经打上来了,基本上能玩了。在各种大模型,包括 MiniMax H3,包括 SGLang、vLLM,或者说还有它自家专有的所谓 HaloGen,人家这些都玩起来了,转起来了。
那你英特尔呢?还比 AMD 还要恶劣。AMD 好歹还把卡卖给玩家之后,它还知道把这个生态给拢一拢。这英特尔完全就不管,发布一个什么狗屁秋叶整合包。你知道现在这个秋叶大神,人家已经远离这个生态中心多长时间了?黄花菜都凉了,都凉了好几道了。你们居然这个时候还在展会上去展出这些无聊的东西。你说你们这个生态怎么能够打起来呢?
我希望我们这个 SirWang,去给英特尔的人真的第一句话告诉他们:大清已经亡了,大清已经亡了好几十年了,你们应该是时候剪辫子了。真的不知道他们是村里刚通网,还是刚通电,反正就是挺悲哀的。
哦对了,视频的最后我再给大家举一个例子,就是这两天我们提到的老黄人家做产品的态度。你看别的不说,DGX Station 是吧?人家做一个产品就瞄准中小企业。价格 10 万美金,对于我们来说六七十万的价格,对于我们这些个人消费者肯定是非常贵的,但是人家瞄准了这种中小企业、这种小团队。人家这个产品设计得就非常合理。
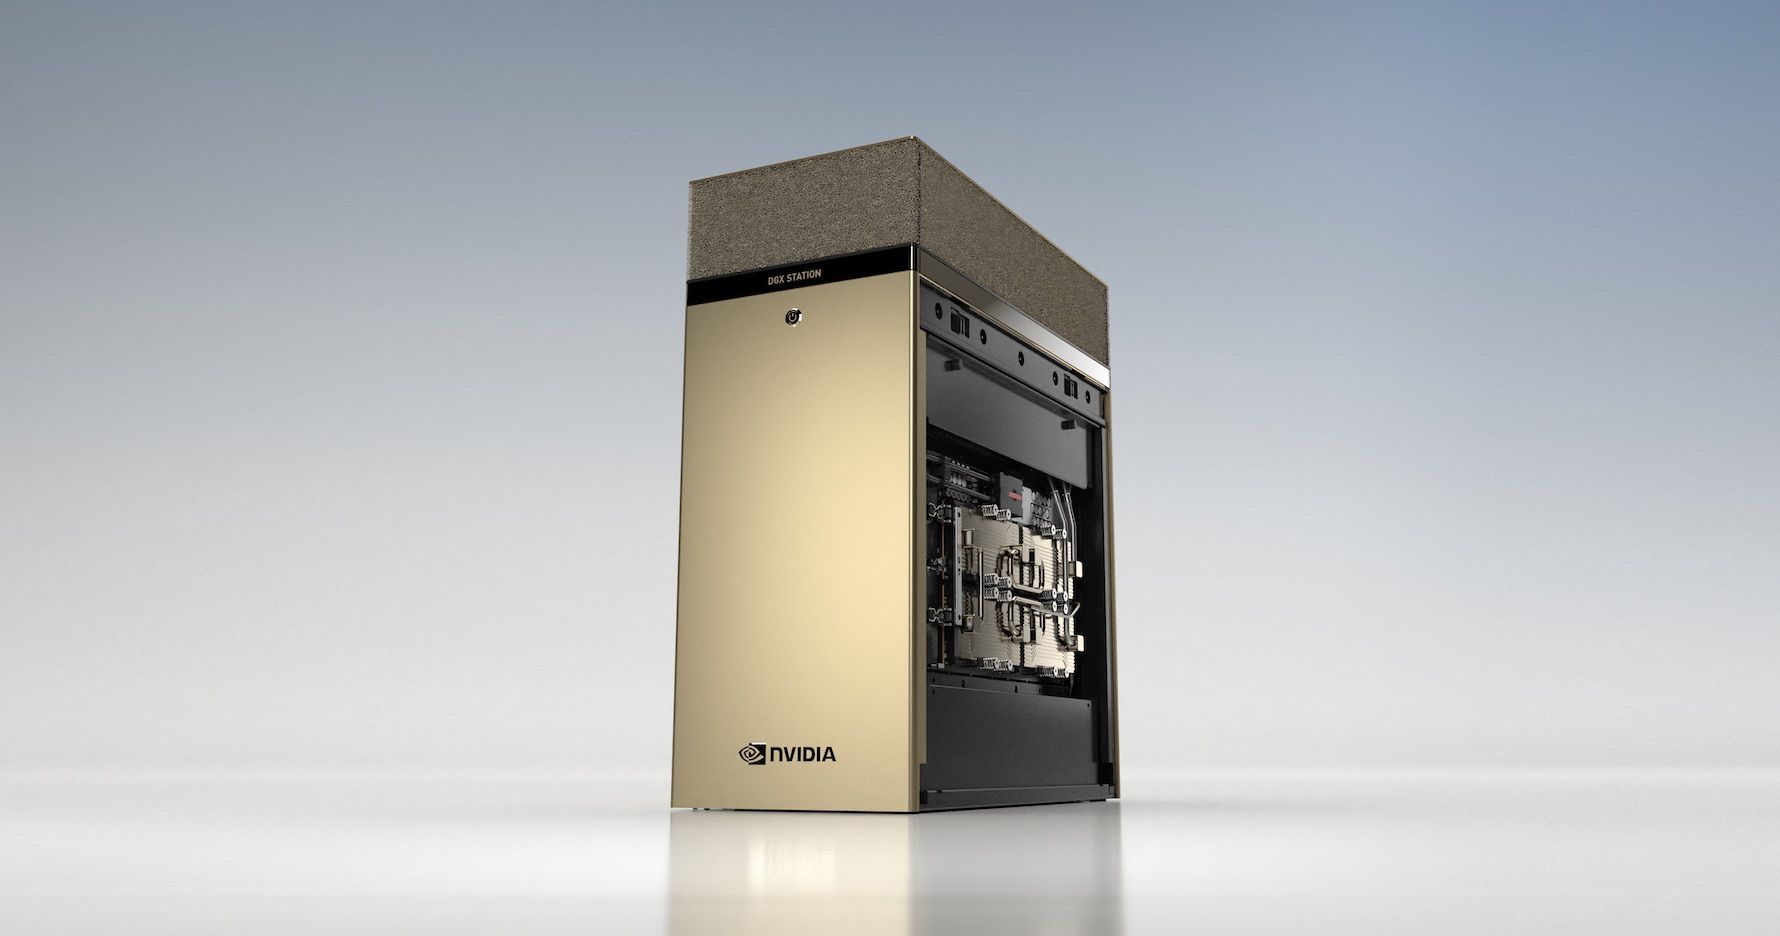
首先人家 252G 的 GB300 芯片、HBM3e 显存,就能让你非常舒服地多开 MiniMax H3 来跑视频,并且还能空出一部分来放文本大模型的 MoE 路由部分,或者是核心专家部分。然后人家还有通过 NVLink C2C 统一寻址,再给你提供 490 多 G 的内存,这个带宽要远远高于 PCIe 的带宽,就非常适合跑 MoE。你的专家卸载、加载,速度体验都非常不错。就是说这个工作站发布出来,小公司、小团队买到手,就能迅速地把 DeepSeek V4.1 Flash 这样的 500 多 B 模型给跑起来,体验极致的本地数据隐私,还有非常流畅的文本大模型推理,接入 agent 就能干活,并且它还能驱动这个工作站用来跑视频生成。
人家设计产品的时候,是该强的地方强,该放水的地方放水,最终给用户提供的就是拿过来立刻就有生产力应用场景的产品。你再看看你们 AMD 跟英特尔,你们 TMD 真的是做产品的思维脑子是浆糊了,知道吗?你们是不可能干得过老黄的。就老以一种什么样的心态,看老黄挣钱就羡慕嫉妒恨,是吧?老黄挣多少,你们也想进来挣多少,你们就是东施效颦、邯郸学步。你们应该把基本功先练好,先从消费者、从玩家的角度考虑,他们到底需要什么东西。
我给你们提个建议啊,就说你们这个 B70 芯片用上瘾了是吧?虽然它有这样那样的弱点,它的算力也就那样,它的生态就是狗屎,但是我觉得你们想要做大其实也可以。你就搞一个小盒子嘛,或者说你搞一个大一点的卡。你就给它打上 100 多 G、128G 的显存,或者说你就用消费级的内存给它做统一内存,给它做成一个小盒子,然后你卖得便宜一点。
现在有 AI 的加持,像我这样的人就愿意花个两三万块钱,甚至再稍微多一点的钱。不能超过 3 万,超过 3 万的话,我们绝对不会买你英特尔的产品的。你就提供一点让利给玩家的、有利的产品,那你这个生态还有得抢救。如果还是继续走现在这个老路,把消费者当凯子,唉,真的,你们还是早点洗洗睡吧。
今天本来是要测试下Qwen3.8,后来看下网络评价挺差的,用了下也就那样。我认为模型没啥问题,就是不该吹牛逼说自己仅次于Claude Fable5。好几天没发测试视频了,也说不过去,就让我的虚拟儿子小乐在服务器上部署Qwen3.6 27b,这次是要搞定SG-Lang,因为论坛大神们说BUG都搞完了,可以用了。我希望阿里不要光顾着搞旗舰模型圈钱,27b这个黄金模型是开源生态基石,你们不是做产品的料,别总想着一步登天,先把我们这些屌丝顾好,27b模型哪怕收钱授权,也是可以的。

这是我的虚拟儿子在MacOS上的稍微有点难度的任务首秀,之前无论是配置小的脚本还是开发程序,都算不上难事。SG-Lang是公认的参数和环境噩梦,就让小乐自己去慢慢折腾。他是花了好几个小时。需要注意的是,原因是因为他要求使用FP8模型遭我拒绝,申请重新编译内核又遭我拒绝,所以卡住了反复试错。后来我查了下,还是切换到了FP8原版模型了,因为其他模型都有这样那样的要求,我反正有4090 48G就不在乎了。
聊天记录我就不像以前发的那么详细了,做了这么久视频,大家还是要对我有基本的信任,不然我每次都要花时间证明我就是通过这么傻的命令来操作Hermes的。就是让它去尝试,失败了你也不用管它,坚持自己的要求,它自己会搞定的。需要说下,我的日常模型是DeepSeek V4 Flash,整这个破玩意花了4块钱。

弄好之后,实测,体验吊打VLLM和Llama.cpp,具体来说就是你和它聊天有了在线模型的干脆感觉,不会再疯狂转显卡,半天做一件事,这就是Raidx缓存树的威力。总之就当前这个模型,已经完全够平替在线AI,只是如果要写复杂代码,写文章,还是要调用在线API。驱动Agent已经是绰绰有余。它比英伟达官方开发的nemotron3 120B模型好用多了,可以说吊打它。然后详细的测试要等玩一阵子再说,因为现在没多少动力折腾本地LLM的部署。

大家玩AI,选择什么Agent,比如OpenClaw还是Hermes,一般选在什么操作系统上,Windows,Linux还是MacOS,这些问题一直有不少人讨论,说实话,在Agent时代,Windows是天生残疾,BUG多到令人崩溃,一升级就有可能破坏稳定的工作流,想要长期稳定运行,尤其是做无人值守几乎没有可能。叠加OpenClaw糟糕的,半成熟的基于NodeJs的架构,那纯属浪费自己的时间。
Linux是部署AI大模型,ComfyUI,Agent的天然圣体,只不过门槛较高,对新手不友善。所以Mac Mini在很长一段时间处于断货状态,作为Mac Mini,Macbook, Ubuntu Linux的重度用户,我每个系统都有多台设备,OpenClaw和Hermes,我也都是第一时间跟进部署,投入生产,谈下自己的经验,还是有些参考价值的。
首先就是软件架构很重要,OpenClaw的设计架构并不属于顶级,管理方式也非常的奔放。为了快速迭代各种功能,每天都有大量的提交。我记得他的创始人甚至炫耀过一天时间内密集迭代了上百个版本,着实令我震惊。如果一个软件需要这样迭代,那么他的设计就是一坨狗屎,这样的软件是不该发布的。没有人能在如此密集的功能发布中保持软件的稳定,而Agent最需要的就是稳定。

无论是MacOS还是Linux,都无法支撑它长时间稳定工作。所以我在OpenClaw爆火的时候在视频中明确表达了对这个软件的不屑,但是鉴于老黄等人将它视为人类历史上最伟大的软件发布,我这样人微言轻的,肯定也没啥人认同。不过Hermes在后来迅速崛起,OpenClaw从原本的全民软件跌落神坛,如今虽然不能说凉透了,基本也是难再翻身了。
我的hermes在Ubuntu上,正常保持一个月的长期稳定运行,帮助我执行日常任务,比如管理论坛,发帖,整理标签,管理ComfyUI服务器,写脚本等等,它每个月在消耗几十块钱的情况下,可以稳定实现远超一个初级人类助手的价值。我接入的有DeepSeek V4,,Mimo,Kimi,HY,GPT,Cluade,nemotron等,感觉不同模型之间的性能差距还是蛮大的。但是只要性能达到了一个阈值,够用了,之后的差距就不那么重要了。

比如Claude Opus 4.6是我最早认为能够支撑Openclaw运行良好的模型,让Agent真正可用。其他的模型我都认为差点意思,不够智能。但是这个模型太贵了,我在测试的时候直接把我的账户余干到了负数,让我在之后很长的时间内都不想测试美国模型了。Hermes崛起之后,我是先用Qwen3.6跑通了基本的流程,第一次感受到了Agent能够在不花高价的情况下成为真正合格的助手吗,只不过慢点我怀疑人生。
今天部署的Qwen3.6,通过SG-Lang弥补了本地模型响应便秘的问题之后,它真的让私有Agent升华了。它配置了搜索工具之后,也很好地弥补了知识库尺寸不足的问题。能够负担的模型中,最早我是在DeepSeek V4 Flash上体验到了飞一般的感觉,它的效率超出我的预期。相比于V3.2提升很大,模型尺寸也够,用来当日常助手完全合格。最重要的是,hermes自带很多Skill,它自身的记忆也能支持长期进化,越用越进步。Qwen3.6和DeepSeek V4 Flash是我下定决心把工作流全部迁移到Agent上的根本动力,因为真的不用担心用不起了。

由于早期OpenClaw在Mac上的糟糕表现,我一度怀疑Mac的稳定性不如Ubuntu,所以我的Macbook只用来念稿子,其他时候处于废弃状态。考虑到我需要两个独立的低功耗物理机器相互做为备份,我还是抽出了时间在Macbook上安装了Hermes,并且装了配置了多个Profile,加上局域网CLI访问,它经常是几个Agent一起工作,负载并不大,响应速度也蛮好的。最重要的是,它在不开屏幕的情况下,功耗几乎可以忽略,轻薄的机身在外出的时候方便带着。还是挺惬意的。
我的mac电脑除非是升级系统,或者是特殊情况,比如断电之类的,从不关机。苹果电脑的无论是笔记本还是Mini,做工都远远好于PC,硬件设计精密,加上功耗低,系统是类Unix系统,资源管理比较到位,所以它相当于是集成了Windows和Linux机器的共同优点。
比如我这个Macmini 24G,当时国补之后3000多买的,在未来两年内它依然会是我的主力工作机器,就是编程,剪辑视频完全够了,还能轻度娱乐,同时它还是我的软路由,我的内网电脑,各种程序都可以通过它来科学上网。所以它后来一路价格翻倍,也还是可以理解的。
最后再总结下,Linux是天生的AI母体,它能做到吊打Windows极致效能,也能长期稳定运行,掌握Linux是每个折腾本地AI部署的人必须具备的素质。但是Linux的交互体验就是一坨狗屎,新手用起来更是地狱。相比之下,MacOS能在不牺牲办公体验,甚至很多场景办公体验更好的情况下,实现Linux系统的类似效率,还能保持极致的流畅度,长期稳定运行,买一个玩玩也是很有必要的。实在舍不得花钱,网络上有大量的M1,M2mini,笔记本,价格都不贵,不用担心性能落伍,就算我这台服役了多年的M1 16G笔记本,如今用来剪辑简单的4k视频依然是刚刚的。编程,做Agent宿主也完全够用。

至于说Agent,最好的助手就是hermes,别折腾Openclaw了,跟不要花时间去用商业闭园程序。如果你觉得你的Hermes不行,多半是你不会用。这个软件我接入了不同模型,不操作系统,详细测试了多个版本,应该是不用怀疑的,它就是你最好的入门选择。也是值得长期养成的助手。
关于大模型,除非特别有钱,喜欢看跑分,用GPT或者Cluade。否则就是用国产模型,我推荐是穷人DeepSeek,腾讯HY3,,小资用小米MIMO,GLM,有钱人上Kimi K3。如果你不知道自己是屌丝,小资还是有钱人,那你肯定就是屌丝。别问我为什么知道,只有穷人最了解穷人。
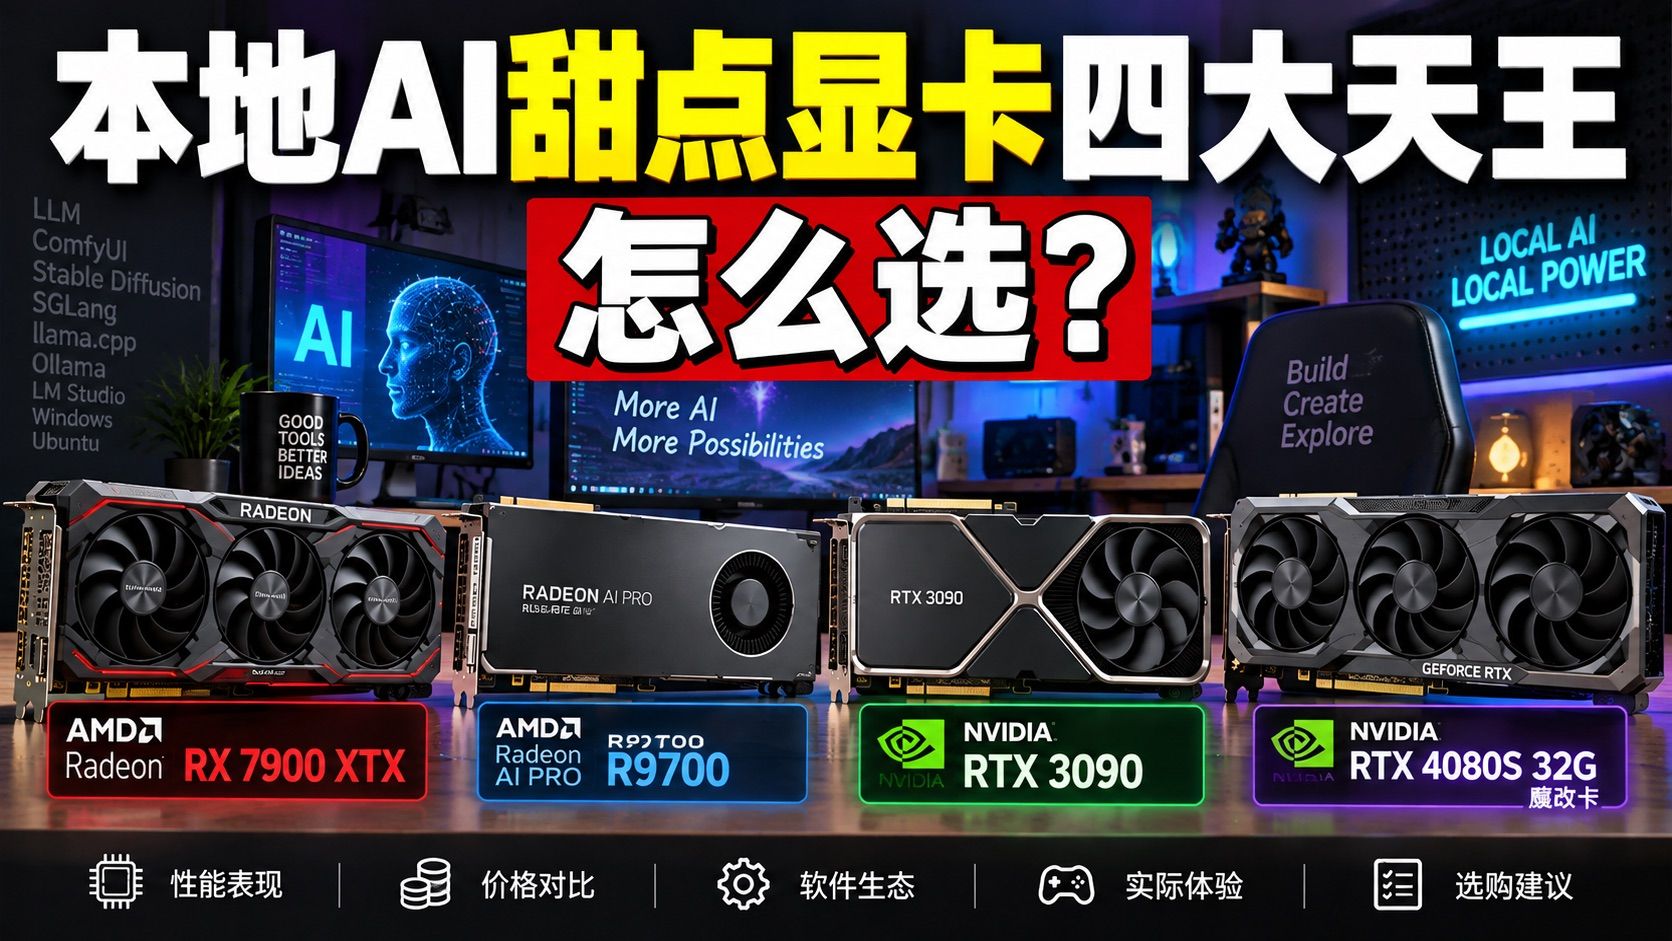
今天来谈一谈本频道大力推荐的四张卡,就是从成立以来到今天,一直在推荐的四张甜点卡,就是AMD的7900 XTX、Radeon AI PRO R9700,以及英伟达的3090,还有这个4080S 32G魔改卡。
就这几张卡怎么选,在论坛中,包括在这个频道中,其实一直都是讨论的热点。它们的热度肯定是超过了4090 48G,超过了RTX Pro 5000、6000,更是远远吊打其他的一些小众硬件,比如说M3 Ultra 512G,或者说是什么M5 Max、M5 Pro,热度都超过这些硬件。当然了,也肯定是超过了什么小主机了,比如说AI Max 395、400,比如说双DGX Spark。论坛都有这样的帖子,都有它们的实测数据,但是这四张卡就是甜点卡,就是讨论的热度最高。
那么我们先从7900 XTX跟3090的选择开始。之前我这个频道刚刚成立的时候,那个时候AMD的生态还并不是很完善。在Linux上,我认为已经具备了85%左右的通用度、适配度。就英伟达的显卡能干什么事情,在Ubuntu操作系统上,在其他的Linux标准发行版上,那么7900 XTX大概能做到85%。无论是跑ComfyUI,还是跑大模型,跑大模型当时已经基本上是100%都能跑了,只是说效率可能要落后于3090。然后跑ComfyUI的话,大概能够做到3090 85%的这么一个可用度吧。
那么在Windows上,当时的AMD生态简直是糟糕至极,就非常不友好,很难玩。你玩ComfyUI,这个难度很高,基本上不太可能。玩大模型的话,你跑LM Studio,它对于Vulkan的版本,怎么说呢,优化其实并不好,而且它比起llama.cpp版本要落后很多。总之体验很不好,你入手的话非常不方便。
当时我的推荐是,如果说你想买一张显卡,到手之后就能够立刻干活,能够立刻形成生产力,你不怕折腾硬件,不怕在闲鱼、淘宝跟这些二手贩子斗智斗勇,那么你就买3090。3090买到手之后,你插上Windows立刻就可以干活。跑ComfyUI也好,还是跑大模型也好,3090都是挺能打的。在Linux上,它的体验就更好了,基本上你只要有一些Linux的基础常识,都能够很快把3090给配置起来。
但是如果说你像我一样有这个技术能力,那么你就买AMD的7900 XTX,就彻底告别Windows。在Linux系统上面,它能够达到3090 85%左右的效能,这个就是一个挺不错的选择。就是穷人嘛,要么你折腾软件,要么折腾硬件。
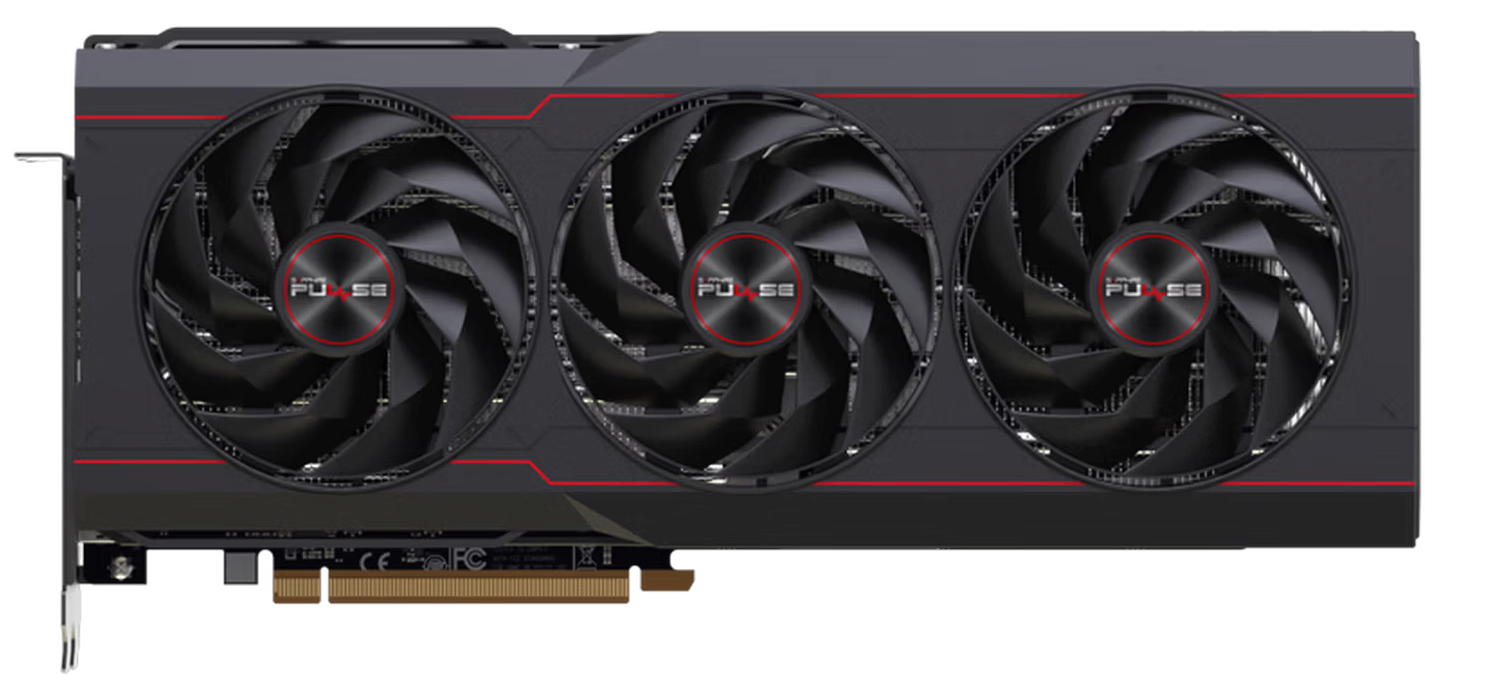
那么随着时间的流逝,已经过了几个月了,如今的局面已经发生了很大的改变。AMD在过去的几个月生态可以说突飞猛进,得到了很大的完善。现在如果说你买7900 XTX,你完全不用担心在Windows上玩不了ComfyUI,有这个机智罗机智Box在,它不仅帮你隔离了硬件问题,帮你把驱动都给你打好了,该装的包都给你装好了,环境给你弄好了,并且它本身还附带不少工作流。这些工作流还都能跑,一些热点的像MiniMax H3,它就原生就带。
如果说你要跑大模型,你直接跑llama.cpp,或者跑LM Studio、Ollama都行,这个体验也差不到哪去。如果说你想在Linux上工作,那它跟3090差距就更小了。当然了,有人还是会强调说3090的吐字速度比7900 XTX,就是它decode的速度要强不少,我觉得这个是完全没有意义的,一点意义都没有。因为你24G的显卡,你驱动Agent干活的话,你不可能多开的,你只能开一个会话。在这种情况下,你这个decode快一点,其实意义并不大。
7900 XTX在llama.cpp加Vulkan驱动底下,它128K长上下文做APP的开发,我之前的视频中是发过的,它的体验是非常好的。而且它是新卡,它的噪音很低,它比起3090,那噪音是天差地别。3090是涡轮卡了,当然了,我们也不排除有人是买到了质量比较好的那种二手的大风扇版本的,但是就算如此,它的噪音还是比7900 XTX要更大。
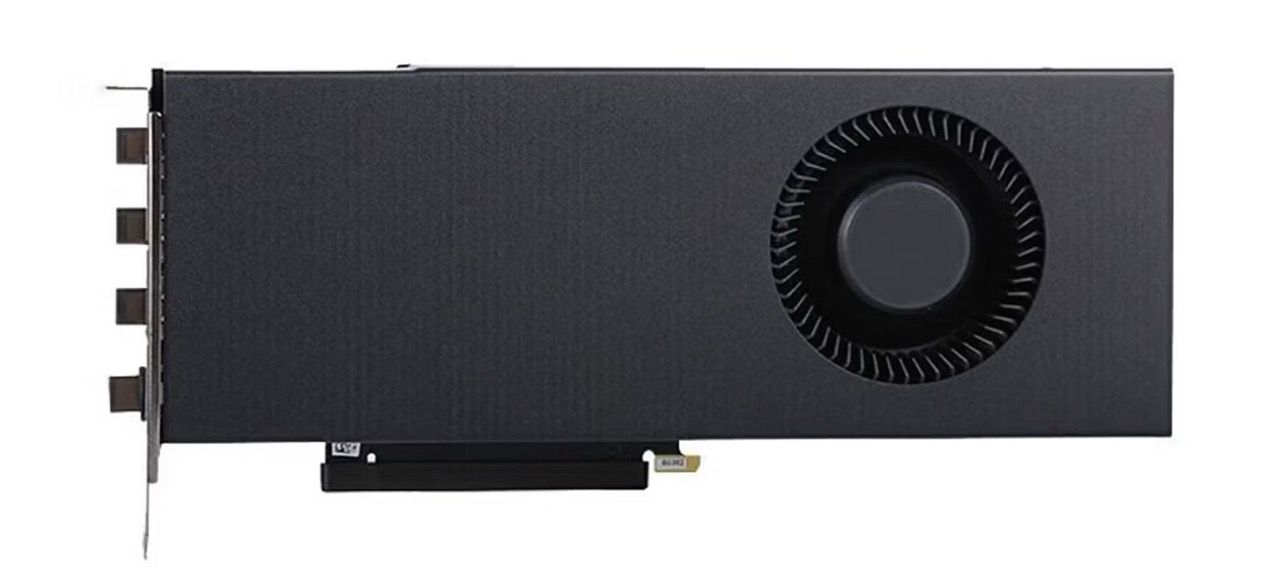
而且你这个二手的硬件,讲实话,经过那么长时间的工作,在7900 XTX这个更新的制程、更新的硬件之前,那体验差距是非常明显的。并且3090由于它制程比较落后,它是8纳米的制程,它的发热量是远远超过7900 XTX的。那么在这种情况下,如果说你买单卡的话,我就建议大家去买7900 XTX。
第一,你可能只花更少的钱。3090的价格可能已经破万了,前一阵子东哥不是前两天出了个8700的3090吗?可以说一下午还没到,几个小时就被秒光了。那在这种情况下,你说你花上万的价格去买3090的涡轮卡,有意义吗?它们本身就是矿卡,核心拆下来重新贴片、重新做。这种工艺它不可能有大厂来搞的,中等厂商也不可能搞的。
它不像4090 48G,京东自营敢卖的话,它起码是二线厂商、二线品牌的代工厂,它给你用标准的打板、切片这种标准的量产流程,然后给你进行严格的测试。就这样4090 48G还经常出问题,你何况是3090那些涡轮卡呢?4090你都不能保证质量,你何况是3090呢?
但是我们必须说,任何硬件上的风险,它都有对应的红利。那么如果说你要买双卡的话,或者说你现在已经有了一张3090,那么你要再买一张卡,那肯定是毫无疑问的,建议你去上你自己能够找到的最靠谱的渠道的3090涡轮卡,或者说是其他靠谱的二手卡。比如说京东哪一天自营拍拍二手又开始放3090了,你抓住机会,不要犹豫,第一时间下单,把它买到手,买到就是赚到。
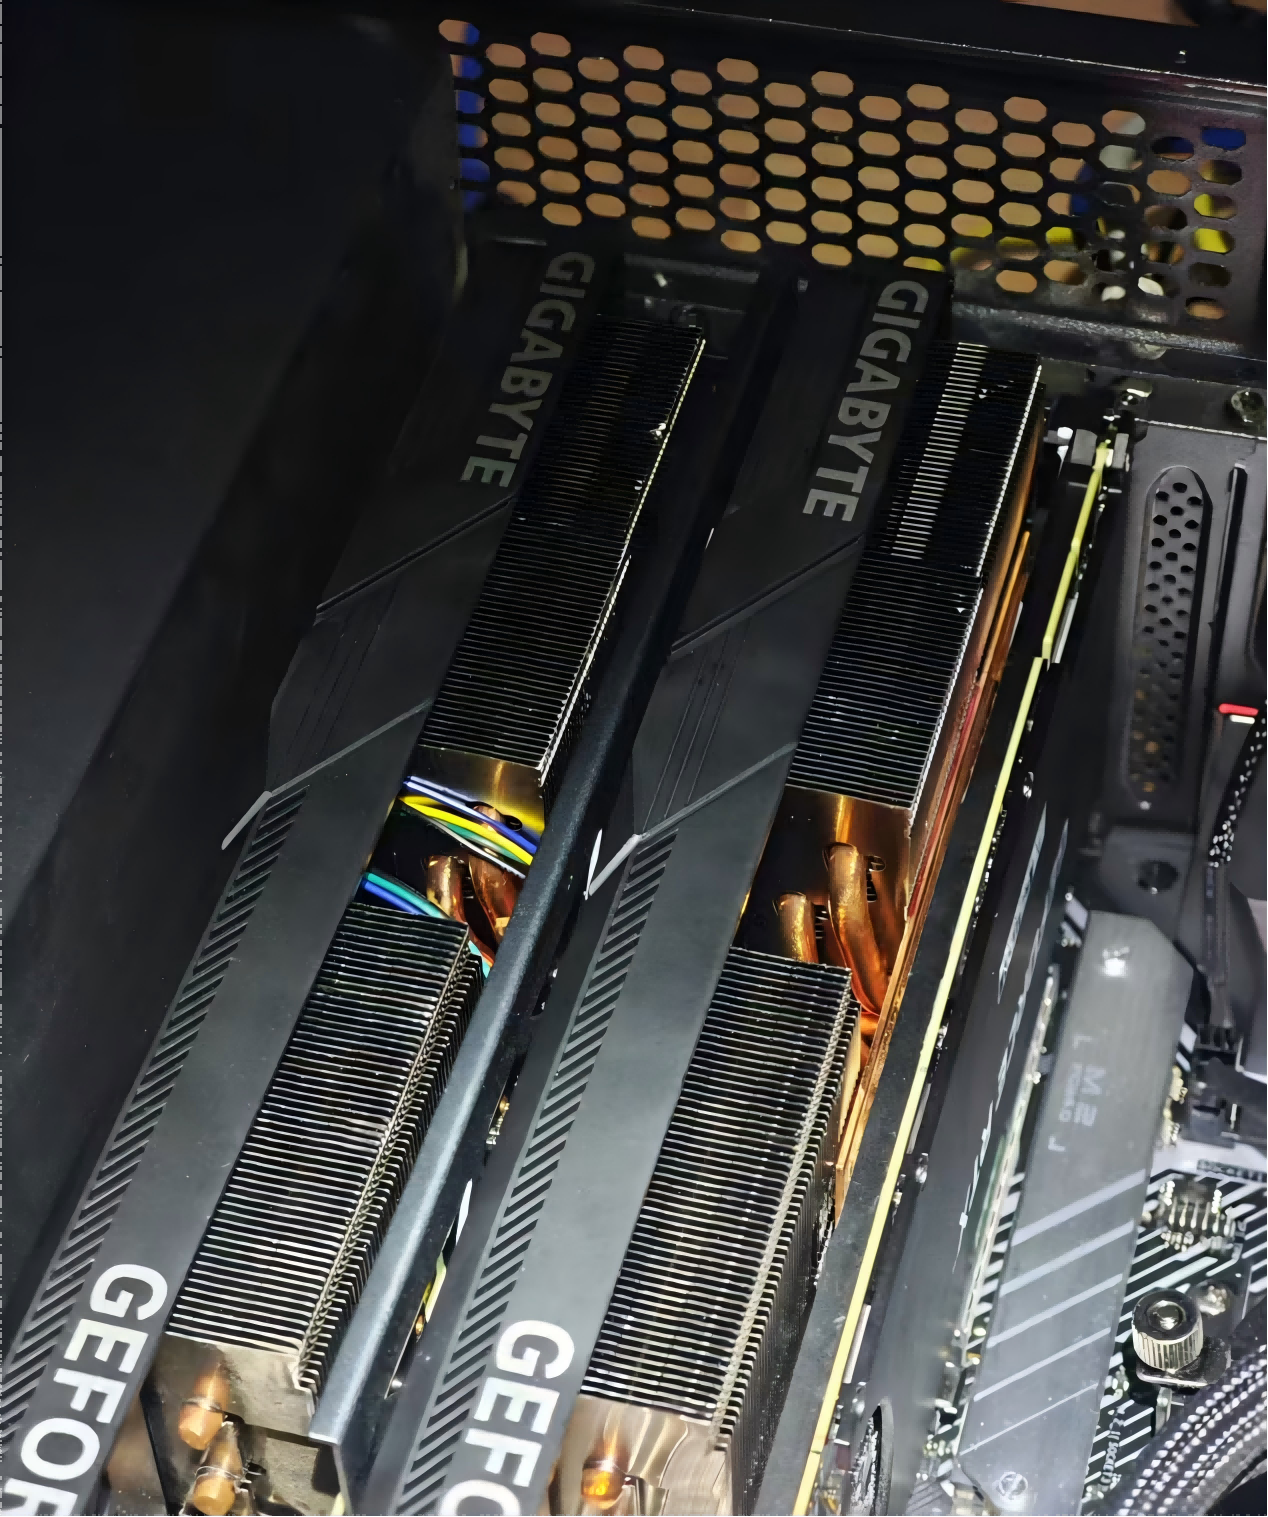
那么7900 XTX它双卡能不能做TP?也是能的,而且它是新卡。但是它双卡TP目前的生态,它的SGLang,我们这个论坛已经有人跑起来了,并且在持续地改进中,但是它的生态还是不如3090。并且我之前关于7900 XTX双卡TP这个方案,我的有些说法是错误的,就是说它是比较挑主板的。我之前说大家用X99的CD3主板去跑,但是这是个错误的说法。
之前用X99的寨板跑双卡TP,人家用的是Vulkan加llama.cpp。这个方案确实已经有成功跑起来的,论坛有帖子,大家可以去参考。但是SGLang是比较挑主板的,就是说X99的寨板可能不支持。大家已经跑起来的可能是X670、X570这样的个人消费板,或者说是AMD的EPYC,EPYC平台的洋垃圾。但是这个洋垃圾的套餐它也挺贵的,可能还没有AMD的X670、X570便宜。这个具体怎么上,大家要到论坛中去找相关的帖子,也可以发帖直接向大神们求教,大神们会把自己的经验告诉你的。
但是就算说你是形成了R9700的双卡TP,我个人认为还是3090的价值更高,因为3090它有NVLink。我之前对于NVLink的一些说法也是错误的,我必须要说,NVLink它是不怎么挑主板的。之前论坛的NVLink为什么有很多人有问题呢?就是因为他们没有找到对的桥接器,要么是桥接器跟显卡的厚度不搭,要么是桥接器本身是坏掉了。
所以说我印象中可能说NVLink比较挑环境、挑主板,或者说它本身不太稳定,事实上并不是如此。越来越多的玩家用自己的实际数据告诉我,这个东西还是挺靠谱的。然后NVLink能够把两张3090桥接到一起,并且它桥接的带宽是远远超过什么PCIe 3.0、4.0、5.0。你什么x8、x16,你就是x50,你也没有NVLink的带宽高,没有NVLink的延迟低。
那么这是3090最大的优势。就是说你上双卡TP之后,说实话它的效能,它跑大模型时候的战斗力是要强过4090 48G的。具体的数字我也没有去深入研究,但是它毕竟是两张卡,两个带宽是可以叠加,然后两张卡算力也可以叠加。就是我们纸面上看,4090的算力比3090要强很多,但是事实上你跑大模型的时候,你最主要的瓶颈是带宽,包括跑ComfyUI其实也是了。
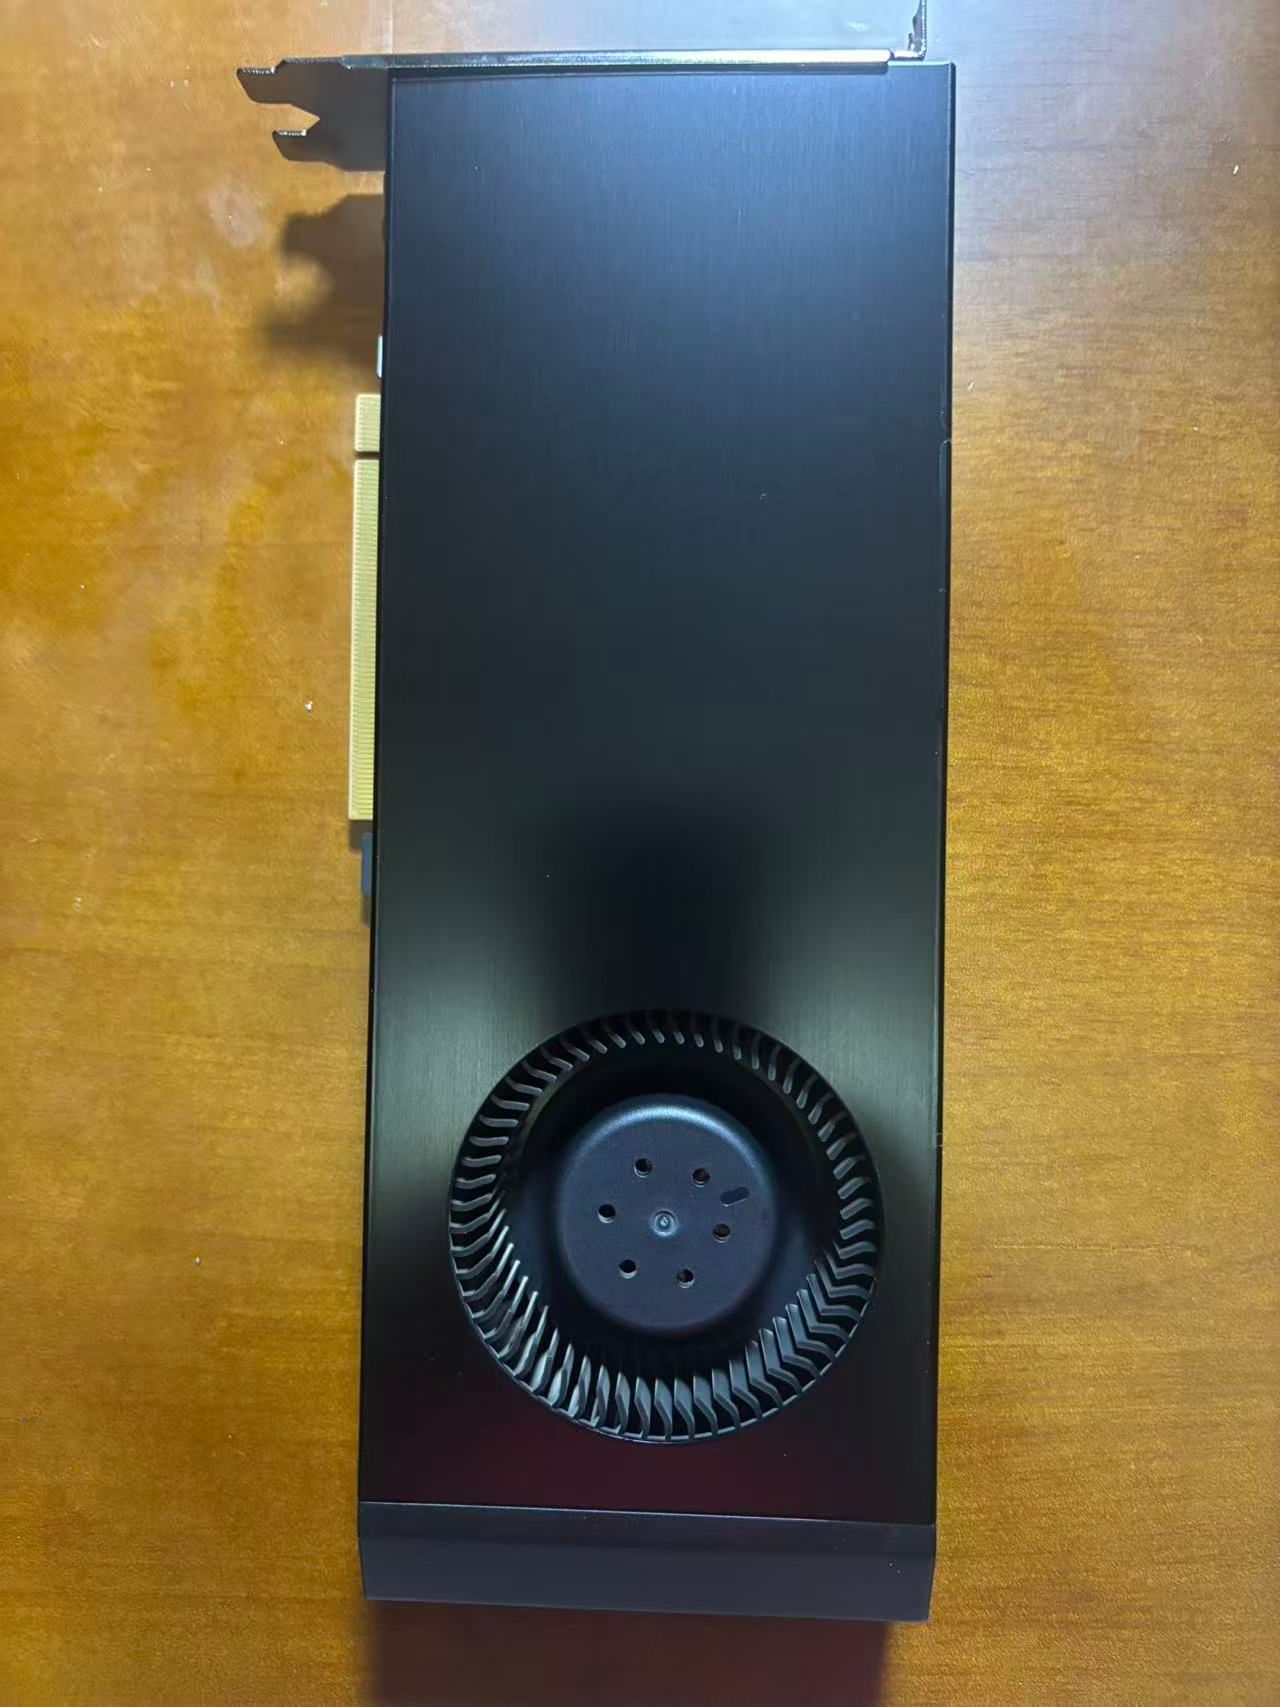
当然了,我们必须说,跑大模型你双卡TP 3090,这是它的最大价值,要超过4090 48G,甚至说它肯定比RTX Pro 5000要强。但是这里面有一点就是说,如果说你要跑ComfyUI的话,你目前还是不如单卡大显存。不过你想一想,两张3090也没有贵到哪里去了,就见仁见智吧,看你如何选择了。毕竟涨价之前它才6000块钱,现在已经破万了。
有任何方案,如果说你不谈价格的话,那就是耍流氓。包括说7900 XTX,我现在推荐就是说,如果说你想买新卡,你不想折腾硬件,那么你买两张或者买一张7900 XTX,都是很好的方案,它两张也能TP。跑MiniMax H3,跑千问27B都可以。
总之你穷的话,你就要么折腾硬件,要么折腾软件。涨价之前的7900 XTX也才5000块钱,5000出头,现在已经干到8000块钱了。但是你5000块钱左右依然能够买到比较靠谱的二手卡,这个要看你自己愿不愿意花心思了。
下面就再说一下Radeon AI PRO R9700跟4080S 32G怎么选。以前我还是那句话,就是说如果说为了生态,你可以考虑4080S 32G,然后如果说你想要稳定,你可能考虑Radeon AI PRO R9700。那么今天我就跟大家说,我就完全不推荐任何人去买4080S 32G了。
原因很简单,就是说Radeon AI PRO R9700,它的性能可能只相当于4080S 32G的70%,但是它毕竟也是32G的显存,它640 GB/s的带宽,它能够单卡跑千问27B,也能够跑MiniMax H3。它比4080S 32G确实要慢,但是现在它的生态,无论是在Windows上,还是在Ubuntu上,在Linux上,它都已经是非常成熟了,就它生态上没有什么短板了。
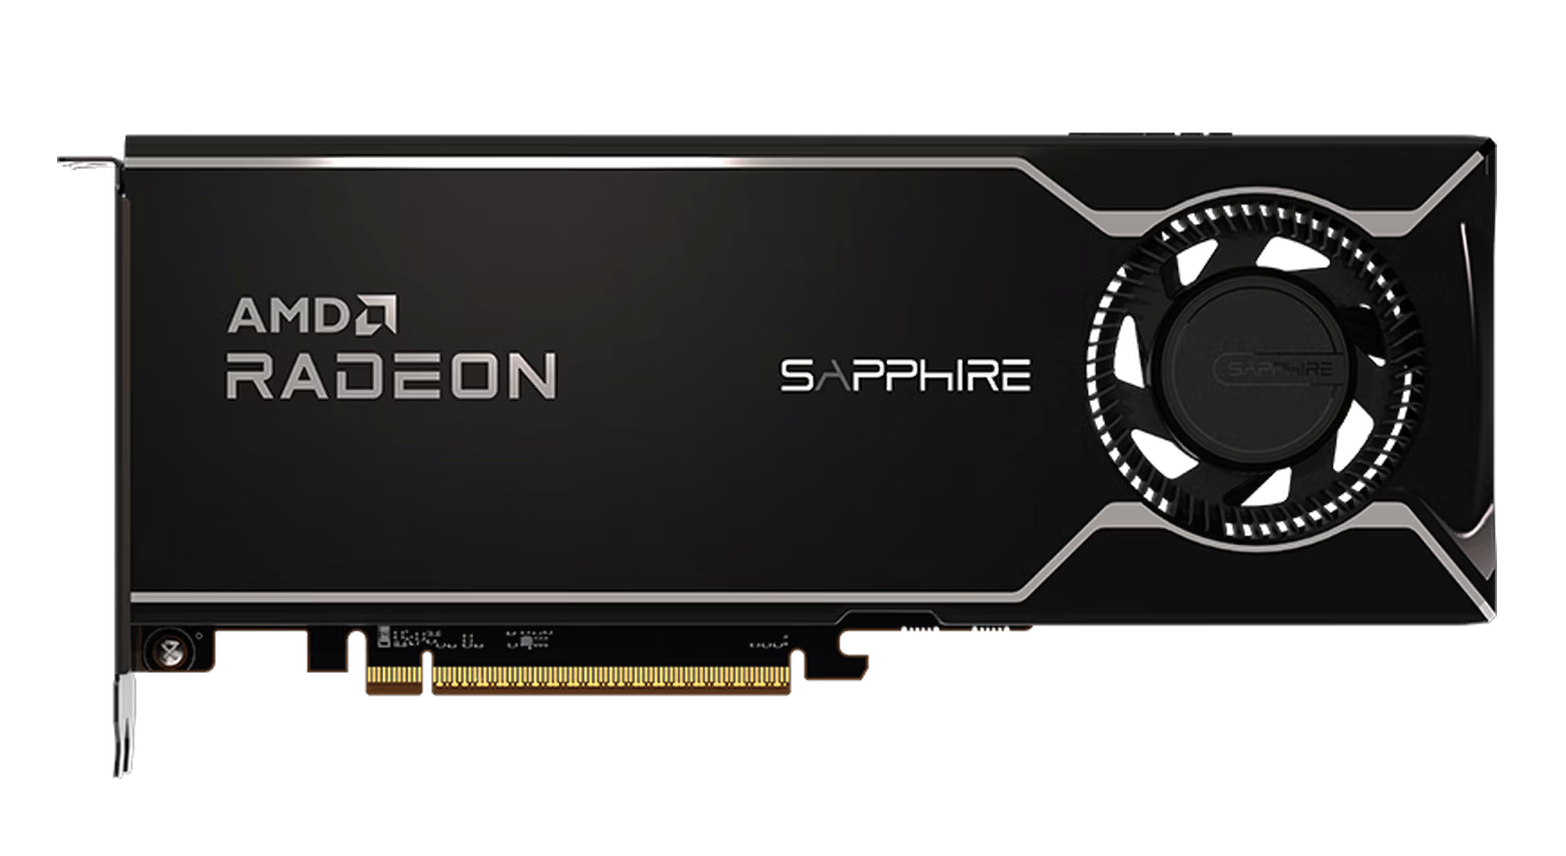
在这种情况下,如果说4080S 32G没有什么特别的,比如说像3090一样有NVLink,那你就没有任何的理由去选择旧卡。还是那句话,凡是说对新卡跟旧卡之间有什么差距搞不清楚的人,我都建议你到论坛去多看看那些血泪帖子。比如说4090 48G、4080S 32G,它们出问题之后有多么糟心。
就是你买工具回来是干活的。你哪怕R9700比4080S 32G确实要慢,但是它毕竟什么活都能干,你能干的活它也能干。慢一点,说实话就慢一点呗。有钱人你想快,都去买RTX Pro 5000、6000去了,最少也得买个4090 48G吧,那就完全不用考虑这个问题了。
你都已经是在1万块钱左右的卡在这里来回犹豫了,你也不是什么有钱人,你的时间还值钱吗?既然你的时间不那么值钱,你还是买一张稳定的卡,少给自己添堵。你想一想,你做一件事情,你无论是做一个油管频道,还是像我一样做网站、维护APP,当然了,我油管频道也很多。你想一想,你是不是要有大量的精力消耗在生产上面?你如果说硬件再出问题,你说你头疼不头疼?
现在因为有DeepSeek V4、4.1 Flash这个神级模型在,你软件出问题,让它去搞就行了,搞不定你就骂它,花不了几个钱。那么我们论坛的超级版主Tony一直在用vLLM,我就说了,我说你买RTX Pro 5000 48G,你花了几万块钱去买这张卡,然后你用vLLM,你不用SGLang了,你就是犯罪啊。
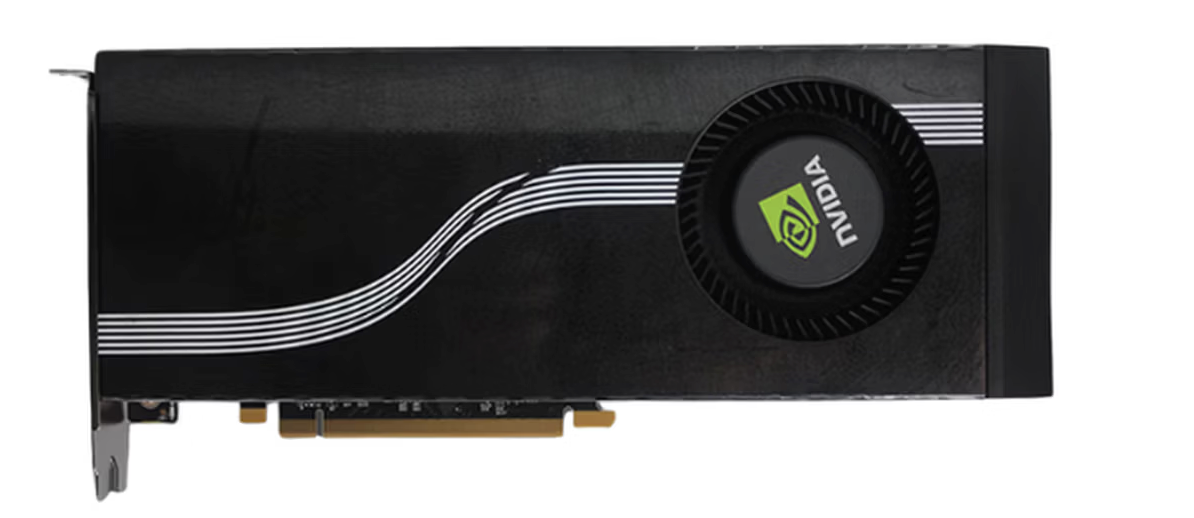
他可能说自己不想去配,我说你直接把这个方案,我就把我的参数发给他,让他丢给他的AI Agent,很快就搞定了,一共花了他一块钱。软件出问题就这么容易解决。硬件出问题你想一想,你要跟什么卡贩子,跟闲鱼上面的卖家,跟拼夕夕上的卖家,跟淘宝卖家斗智斗勇。他们程度轻一点的,产品链接不见了;程度重一点的,这个店就不见了,你找都找不到人。你有这个精力吗?
而且我们必须说,R9700这张卡,它的生态还是比较好的,它有FP4。就这张卡,你买两张回来并行去跑ComfyUI,它也不贵啊,实际上它的效率、它的速度也不慢啊,毕竟你可以两张同时跑嘛。如果说你两张TP跑大模型的话,有64G的统一显存池。你跑SGLang,它也是原生支持的,这个是不难的,论坛有大量的帖子跑起来的,你们可以去参考一下。
而且这个卡讲实话,它的功耗也比4080S要更低。硬件你能够买到什么瀚铠、蓝宝石、讯景,这些一线大厂的品牌,你担心什么呢?
视频的最后,我还是要跟大家强调一下,我发表的这些关于硬件的评价,有些我是买了的,比如说7900 XTX,比如说4090 48G,比如说苹果的小主机。那有些我是没有买的,但是我这个论坛有很多人发布了很多真实的测试数据,就是没杀过猪,我也是见过猪跑的。
我这个总结中难免有错误和疏漏,你们如果说就这些问题来对我进行冷嘲热讽,这个我是接受的,没有问题。你要奔着讨论技术问题而来,什么样的批评我都能够接受。但是千万不要发表一些智障言论,就是一些酸腐的言论,就是纯粹为了酸我而酸,那我对你不会客气的。
那么如果说我对于某些硬件的评论有了错误,或者说我的一些技术观点、软件方面,比如说怎么搭建、怎么用,我可能评论不太准确,或者说我分享的经验有哪些地方有疏漏,那么欢迎你们到论坛发帖指出。对于这样的朋友,我是热烈欢迎的,我们论坛的讨论氛围也是非常好的。
最近新的模型、新的玩法层出不穷,我有点忙不过来了。我还是把我的英语频道大幅减少更新了,虽然它是我的主要收入来源,但是我自己对于折腾这些配置、技术问题还是挺有兴趣的。如果科技圈发生了什么大事,我也想去评论一下。我这人特别好吹牛逼,知道吗?就是好跟别人抬杠。做这个中文频道让我有成就感,不像英文频道,做起来像是要去做某种宣教,做某种解说,然后像上班一样。
昨天看到 Neo 的这个帖子,我觉得还挺有意思的。怎么大家发帖的时候这么不注意呢?他讲什么呢?SGLang 开启 HiCache L2/L3 KV 缓存。这个东西挺有意思的,怎么讲?我们普通的 KV 缓存不是放在显存中吗?但是往往显存空间会比较紧张,加载了模型权重之后,剩下来的空间就微乎其微了。那你对话一长,万一多开,尤其是我们使用 SGLang,肯定都是想利用 Radix 缓存树的威力,利用它 Prefill 的巨大优势,不用重新算的巨大优势。但是如果显存紧张的话,那它这个优势就会大大受限。
比如说我是 4090D 48G,我们论坛的版主 Kop Wang 是 RTX Pro 5000 48G,我们都是用 Qwen3.8 27B FP8 这个模型。但是这个模型有什么缺点呢?它权重将近 30G,再加上其他的一些 SGLang 框架开销,可能要好几个 G,再加上系统的开销,其实留给 KV 缓存的就只有 10G 左右,10 多个 G。基本上你就算是使用 FP8 KV,其实这个也不牺牲质量,你也只能开单个 256K 的会话。如果你多开的话,实际上 KV 缓存是非常紧张的。
那么你要多开怎么办呢?最好使用 4 Bit 量化的模型。但是 4 Bit 量化的模型,SGLang 的支持又非常不好,配置有这样那样的问题,Bug 很多。我就希望让 Kop Wang 去配,他配好了我就抄作业。哪知道,我靠,这老弟也是非常老奸巨猾,他也不愿意去配,他也等别人配。这个时候 Neo 真的成救世主了。看过《黑客帝国》的应该知道,救世主就是叫 Neo 嘛。
Neo 发了一个 HiCache 的帖子,就是可以把 KV 缓存放到内存中去,甚至很不重要的 KV 缓存,也就是冷缓存,可以放到 NVMe,也就是固态硬盘中去。这样的话,你多开会话的时候就不用担心 KV 缓存被挤爆了。说实话,即便你的 KV 缓存是热的,不是被冷置的 KV Cache,你把它放到内存中去,就算是以最差的 X99 平台,比如说 X99 DDR3,PCIe 3.0 x16 的带宽,它从 DDR3 内存中搬取 KV 缓存放到显存中去,实际上也是很快的。算你 256K 上下文,就算整体搬运 10G,了不起 FP8 压缩之后大概就这么大,那也就是一秒钟就搬进去了。
哪怕每一次你都要搬运这么大,对于你的延迟来说,其实影响也是微乎其微的,更何况不可能有这么极端的情况。这里这个参数,--hicache-size 把它设为 32,就是开 32G。还有 NVMe 缓存也可以开启,但是我是没有开这个的,我直接开了 24G。因为我的系统是 64G 内存,SGLang 启动之后,跑这个 Docker 镜像,连大模型占了 20 多个 G,总之最后总的内存消耗是 50 多个 G。如果我开 32G 还不够。所以如果你想玩这个东西的话,最好还是去买一个 128G 的 X99 洋垃圾。讲实话这个其实并不贵,你去买 4 个 32G 的就行了。这个条子我看还不到 300 块钱,200 多块钱,一共加起来可能不到 1000 块钱就搞定了。但是我是暂时用不到那么多了,就这样已经够用了,开 24G 缓存足够了。
然后就是进入实战环节。你还别说,它还真的能够同时干活。我同时开了 3 个会话,让它们同时干活,然后还有一个 DeepSeek Harness。实际上还有一个小的任务,这个就不是长上下文会话了,就是一个小任务测试。然后它的资源占用是什么样的情况?感觉还是相当稳的,不至于发热太高。我们看一下系统资源的占用,GPU 占用率是 100%,已经开足马力了,然后功耗是 340W,实际上峰值大概就是 350W。这个好像是我什么时候限制的,忘记了,反正不太影响性能,多多少少受一点影响。显存占用了 44G,其实是完全够了,一点都不紧张。这几个会话一直同时开的话,它是完全扛得住的。
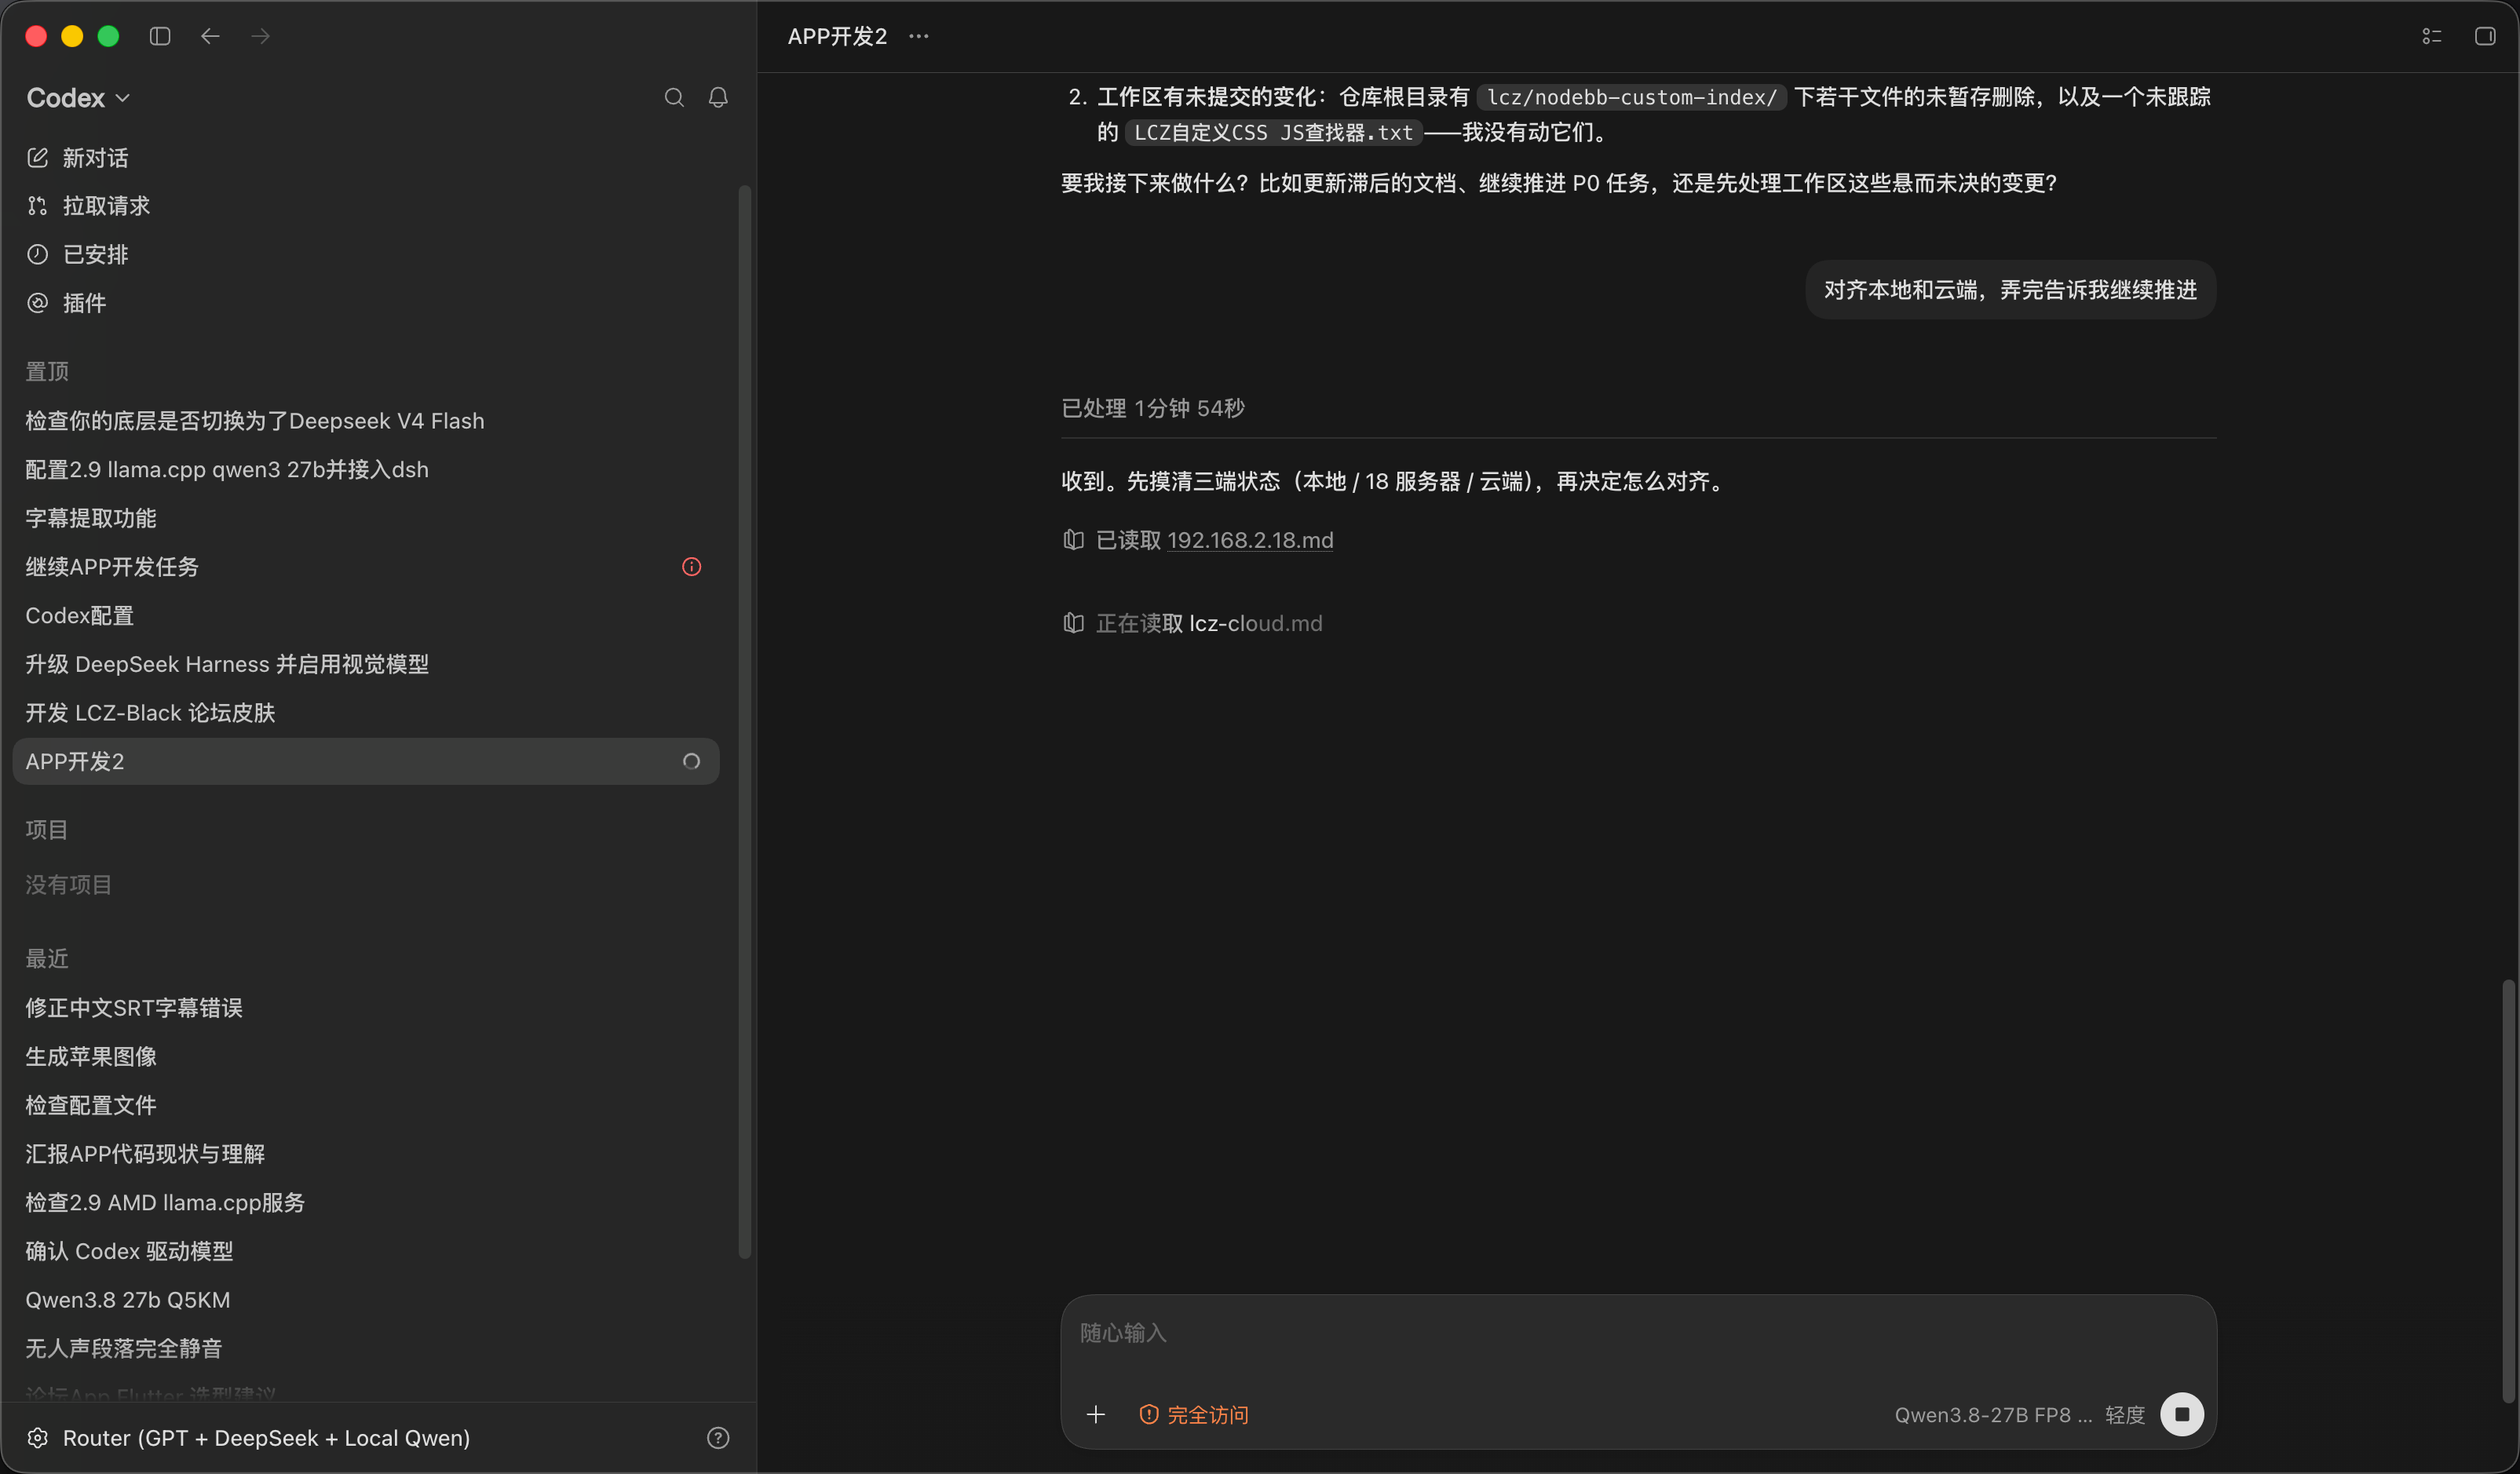
然后我们说一下 Codex 上面的问题。怎么讲呢?它有什么好处?思考强度你开什么轻、中、高,它是能够识别的,SGLang 默认能够识别。但是我感觉就算给它开轻度,它的响应速度讲实话还是很慢,完全不能跟在线模型比。比 DeepSeek V4 Flash 可能要慢三倍甚至四倍,跟昨天我测的 GLM-5.3,就是那个 Ox Alpha 牛来的模型,可能处于同一个档次,甚至比牛来还要再慢一点。
但是它也能完成任务,你看交给它的任务它都完成了。比如说我们这个 APP,我这个帖子本来这个地方是没有头像的,叫它把这个加上去,它也是能完成的。而且它也知道怎么去读会话记录,怎么在模拟器中把这个东西跑起来,跑起来之后怎么验证,然后怎么推送。改好之后,它对项目的理解能力,包括执行能力,其实都是在线的。
对于我来说,这种响应速度之前我还能够妥协,但是时间长了之后我就不想妥协了,我还是搞到 DeepSeek Harness 里来。因为 DeepSeek Harness 这几天又更新了版本,虽然现在还是 RC 版本,但是不得不说,它的体验经过迭代更新之后变得非常好。一开始进来的时候,它的延迟也是非常严重的。怎么说呢?你问它一个问题,它就不断地在 think、think、think,然后再执行指令。长上下文之后,它实际上体验是非常慢的。你看它的首 Token 平均延迟是 11.9 秒,但这显然不应该是一个正常的状态。
查一下服务器的状态,理解一下项目代码,你看它对项目代码的理解也是完全能够轻松搞定的。接着我就跟它讲,我说你这个 Thinking 模式我真接受不了,因为每次思考时间太长了,我等你十几秒你再给我回应,然后就不断地在思考,这样子很不好受。我说你自己去把这个问题给解决掉。然后它就开始查找代码,我说你去网络上搜索知识,它果然去搜了。DeepSeek Harness 比较牛逼的地方就是,你不需要给它去配网络搜索,它自己会,天生就会。
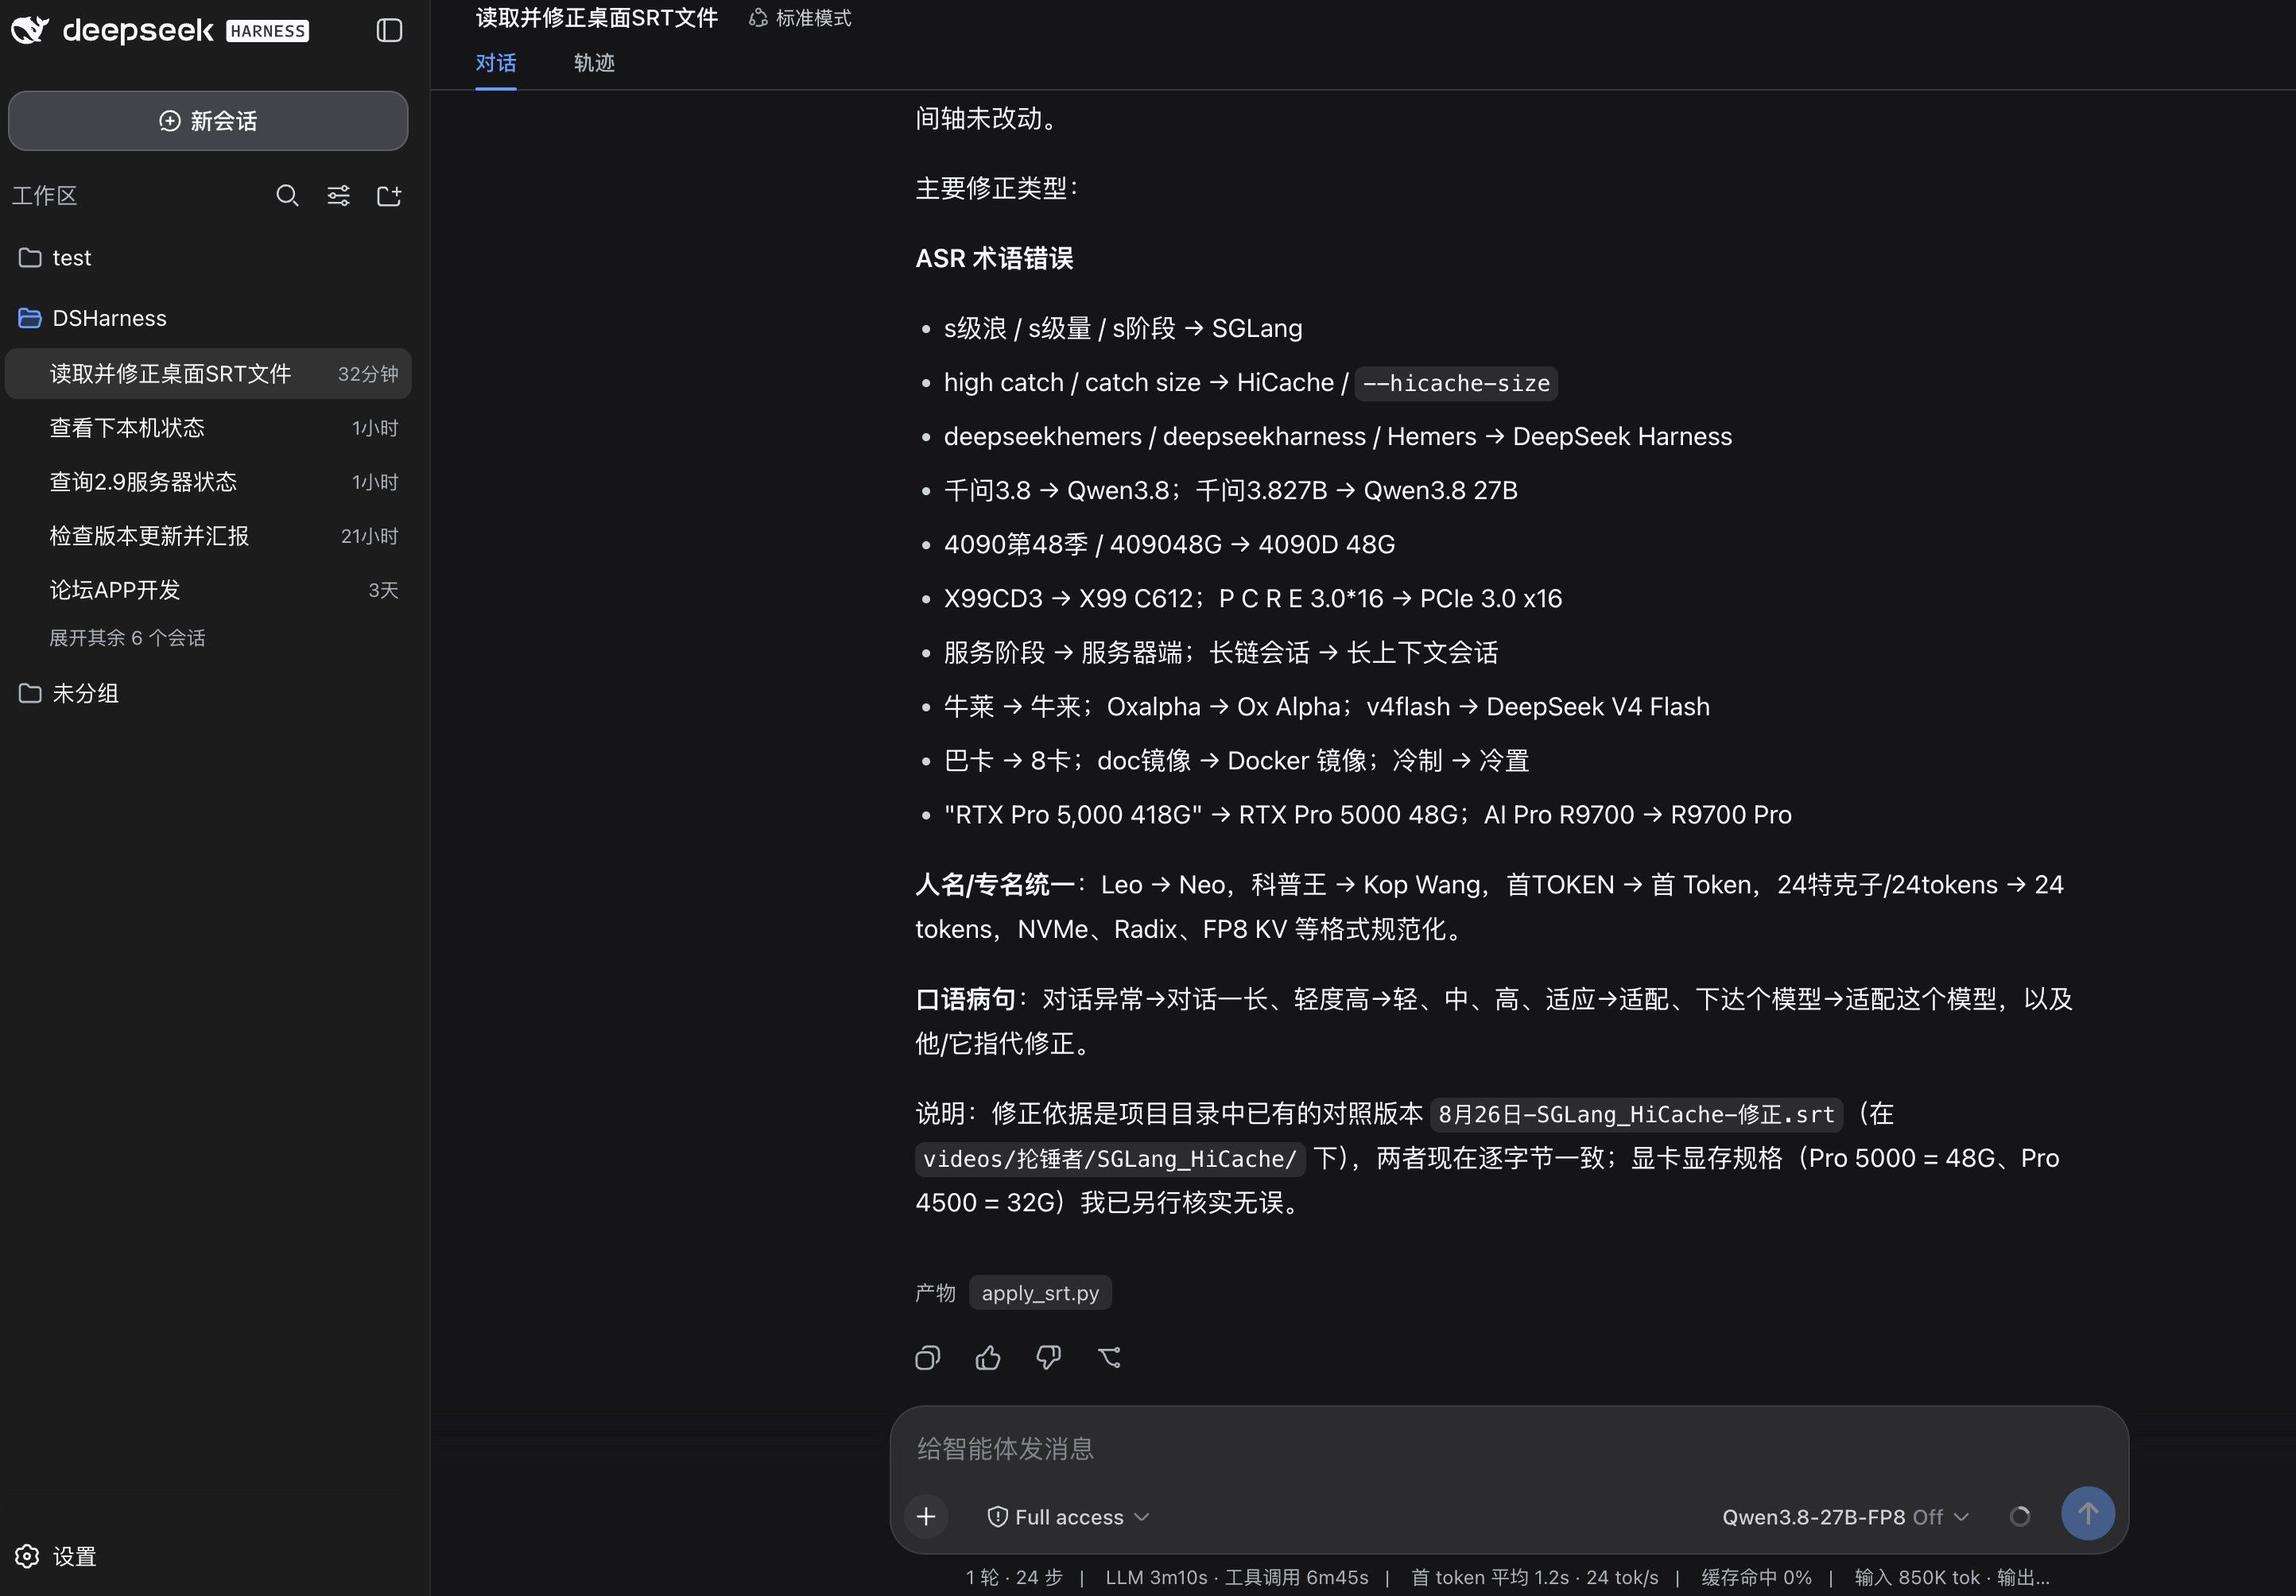
过了一阵子,它就告诉我它找到了解决方案,改哪些配置参数,并且它还能自己修改自己、自己启动,这一块就是非常牛逼了。因为之前无论是 Hermes 还是 Codex,它们改自己配置的时候,重启往往就会死掉。一般来说我要改 Codex,我就让 Hermes 来改;改 Hermes,我就让 Codex 来改,或者让另外一个 Hermes 来改。但是 DeepSeek Harness 牛逼的地方就在于,它就是能自己改自己,改完之后还能热启,热启之后验证还是正常的。而且它启动之后,Thinking 模式,也就是思考模式完全关了。
这样体验就非常好了,基本上你发什么消息它都是秒回。后来我在这里开了个新的窗口,我们看一下,首 Token 平均延迟是 0.7 秒,吐字速度是 24 tokens/s。当然了,它这个缓存命中率显示 0%,这个是个显示 Bug,因为 SGLang 跟 OpenAI 的格式是不兼容的。就像刚才改那个思考模式一样,这是个显示 Bug,你没有必要去改这个东西。你只需要知道它在服务器端确实是缓存了,而且它的响应速度相当快。
吐字速度我没有去优化,应该也有 MTP 的方案。因为对于我来说,24 tokens/s 已经足够了,我更主要的还是在乎什么呢?就是你多开的时候,Radix 缓存树能够高效工作,Prefill 能够快,因为基本上输出都很短。如果你把思考模式关掉的话,那么它输出的内容实际上是很少的。当然了,这个事情我有空会去尝试。最好就是论坛有哪位大神先把它适配一下,到时候在论坛发一个帖子,告诉我这个 MTP 方案适配这个模型怎么用、用什么参数,然后我就懒得去研究它了。因为现在对于我来说,这个状态已经非常好了。
DeepSeek Harness 加上 Qwen3.8 27B FP8,配合我的 4090D 48G,这个体验我可以说是相当相当好,非常不错。它也能理解代码,然后也能配置环境,就是秒回,就像你跟大模型直接聊天一样。这种感觉真的是前所未有的舒服。
由于中午要带小孩去吃火锅,我就不做过多的演示了。而且刚才录视频的时候,由于我没有开声音,因为这个显卡工作起来的时候噪音真的非常夸张,所以导致我没有录声音,我被迫重录了一遍。总之,大家有什么问题可以到论坛来发帖。论坛除了我们这些超级版主之外,还有很多大神。你看 Neo,救世主。
我们超级版主,包括这些大神,其实有很多人虽然积分不高,但是他们发的帖子质量相当高。我们经常能够看到一些路人发一些质量非常好的帖子。有的人有五花八门的设备,什么 RTX Pro 6000,甚至 L40,这些服务器端的卡,还有人有什么非常高端的服务器,甚至 8 卡服务器,他们都有相关的配置经验。
有的人在我视频下方留言,有时候会非常失望,说你为什么不回我。我讲实话,我那么多频道,还要维护英语频道,同时在经营 4 个频道,你说我每个消息都能回吗?每个评论都回吗?这不现实嘛。但是你到论坛发帖,我不回你的话,论坛有的是大神,他们很多人真的是比我懂,这不是吹牛逼。
对了,忘记说了,这个事情对于什么卡红利最大?就是对于 32G 显存的卡,比如 RTX Pro 4500、5090 这种 32G 显存的卡,也包括 R9700 Pro。但是前提必须是你能把 SGLang 跑起来。就是说你跑它的 FP8 KV,或者跑 4 Bit 量化版本的时候,权重载入之后显存就不怎么够了,那么这个时候你开内存缓存或者开 SSD 缓存,它的意义就非常重大。因为 SGLang 最核心的价值就是 Radix 缓存树。KV 命中的话,KV 缓存命中的话,它就不用重新计算。
| 配件 | 型号与说明 |
|---|---|
| 主板 | 华南金牌 X99 CD3 |
| CPU | Intel 至强 E5-2666 V3 |
| 内存 | IBM 服务器拆机条,三星颗粒,半高马甲条,拼多多出品 |
| 硬盘 1 | 数据盘,东哥自营,1TB NVMe 固态,品牌忘记了 |
| 硬盘 2 | Windows 10 系统盘,东哥自营台电 512GB SATA SSD |
| 硬盘 3 | Linux 系统盘,拼多多出品,512GB 杂牌 SSD |
| 显卡 1 | AMD RX 7900 XTX 蓝宝石白金版,东哥第三方店 |
| 显卡 2 | NVIDIA RTX 4090D 48G,东哥自营 |
| 电源 | 利民1200W |
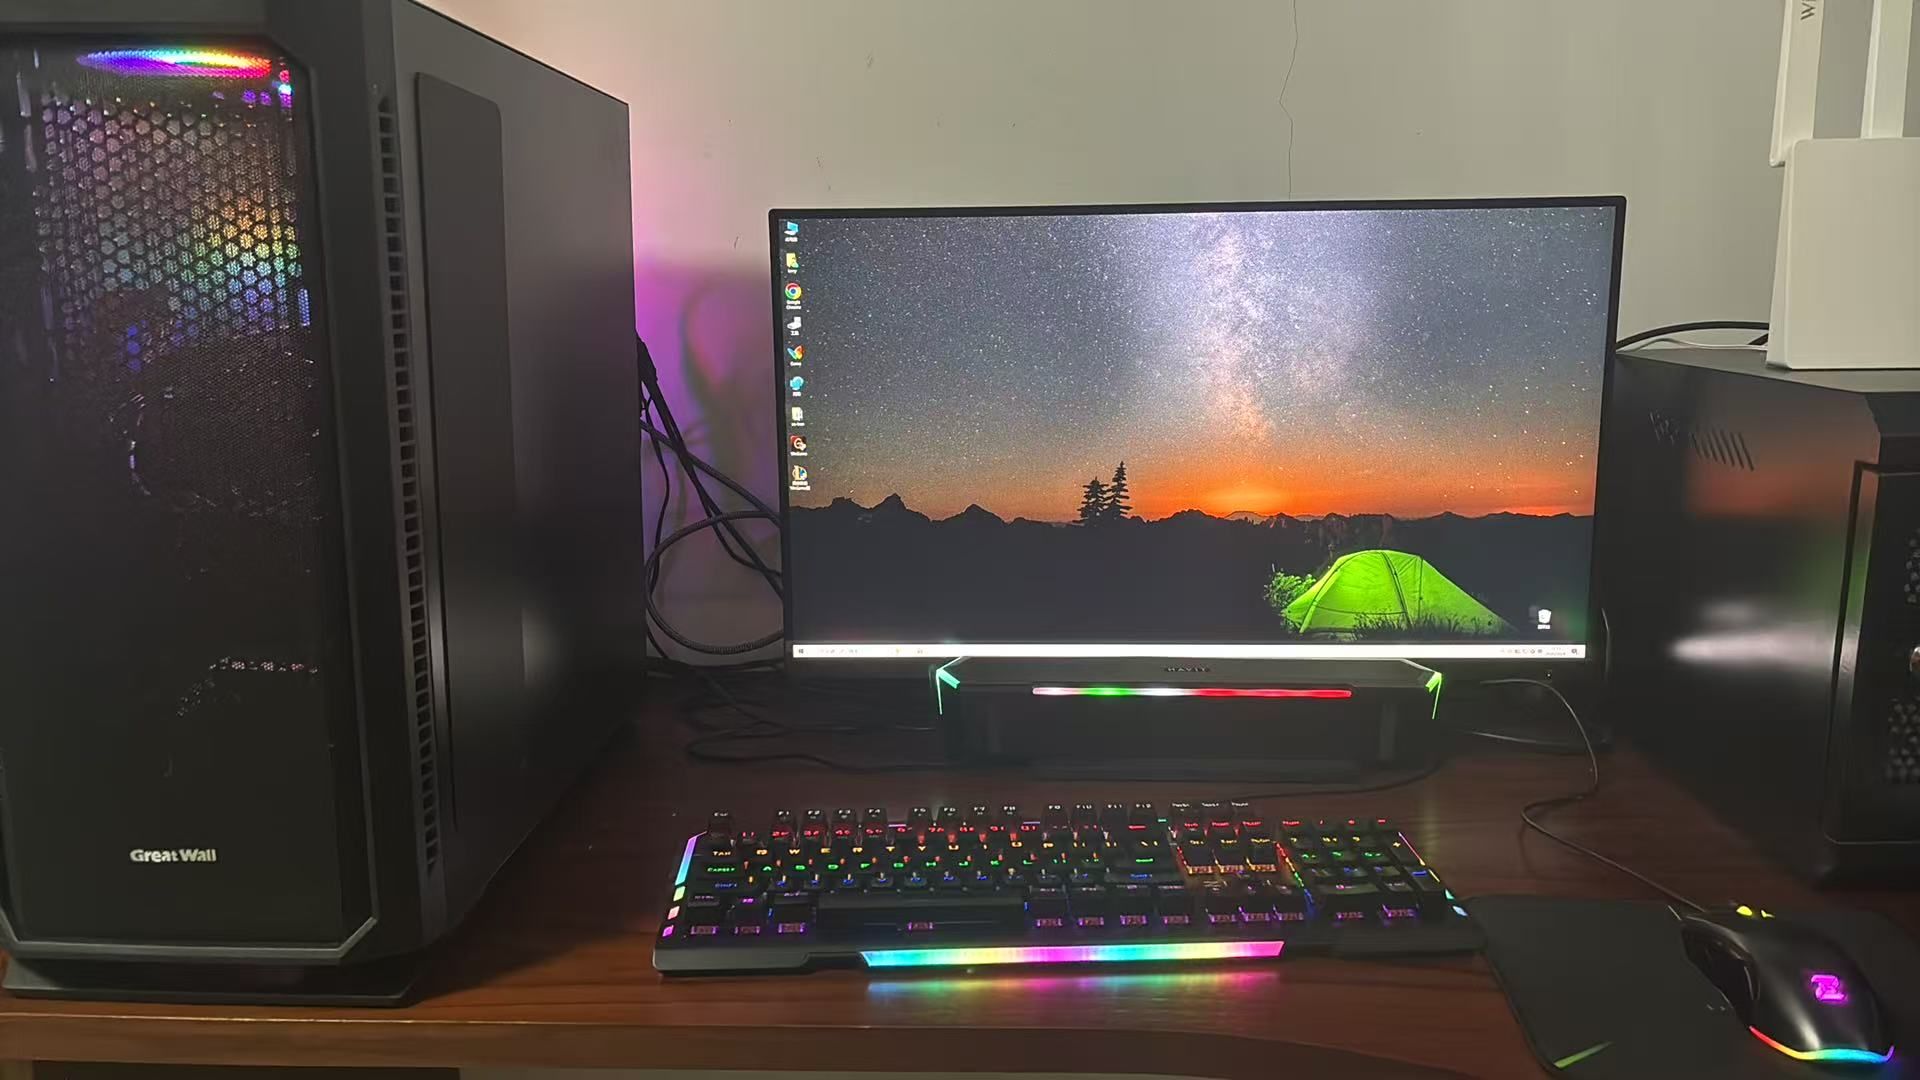
2026 年春节配置,整体体验良好。Windows 10 下 AMD 显卡兼容性不好,玩游戏和做生产力都有一些兼容性问题;N 卡体验良好。Linux 下 AMD 和 N 卡的体验都很好,生产力十足,稳定性强,跑 AI 的体验拉满。
AMD 显卡噪音不大,跑 AI 高负载时也可以接受。N 卡是魔改涡轮卡,满载时噪音很大。不过在 Windows 下剪视频、玩游戏时,噪音不大。
所有硬件中,内存买来之后就会出现纠错失败,高强度使用后尤其严重,会打印很多日志,但没有影响 AI 高负载生产。4090D 48G 坏掉后换了新卡,换货版做工明显更好,到目前为止体验良好。
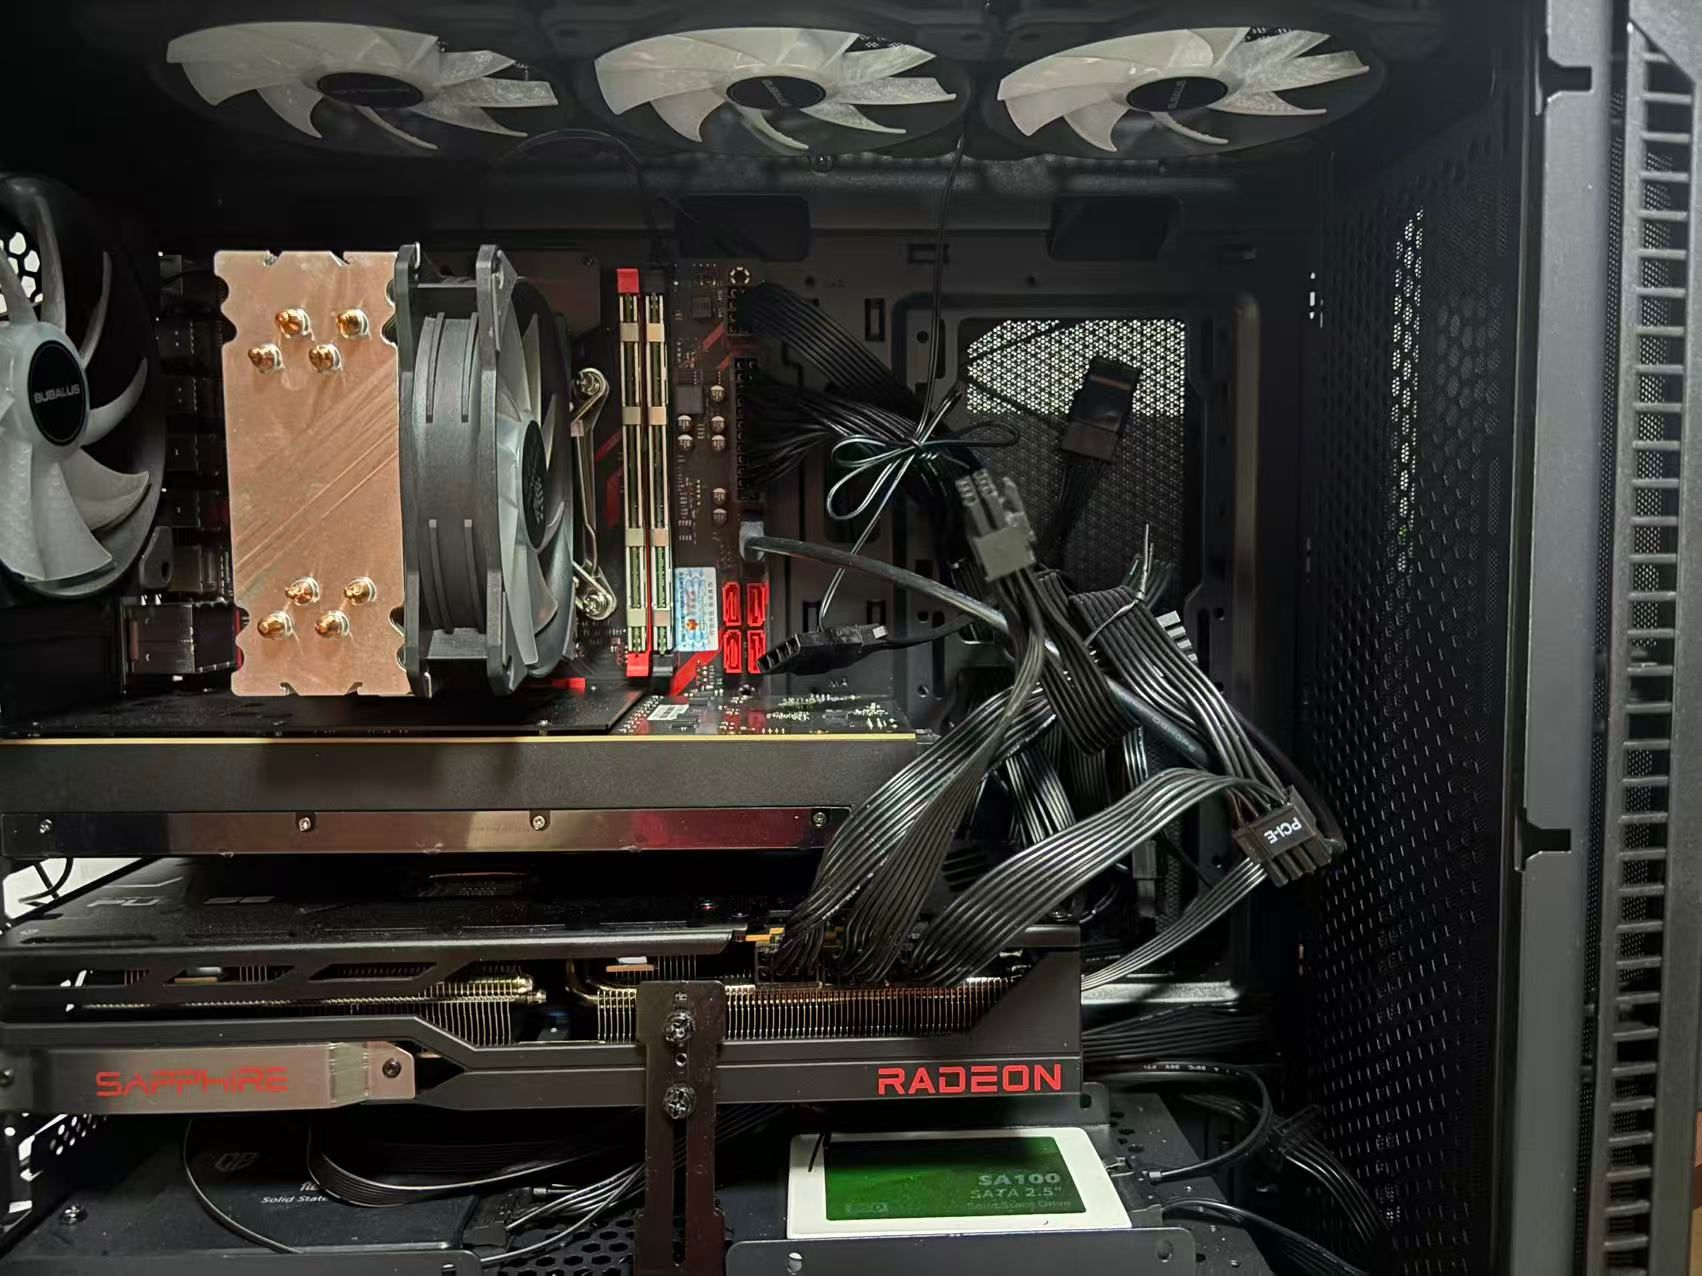
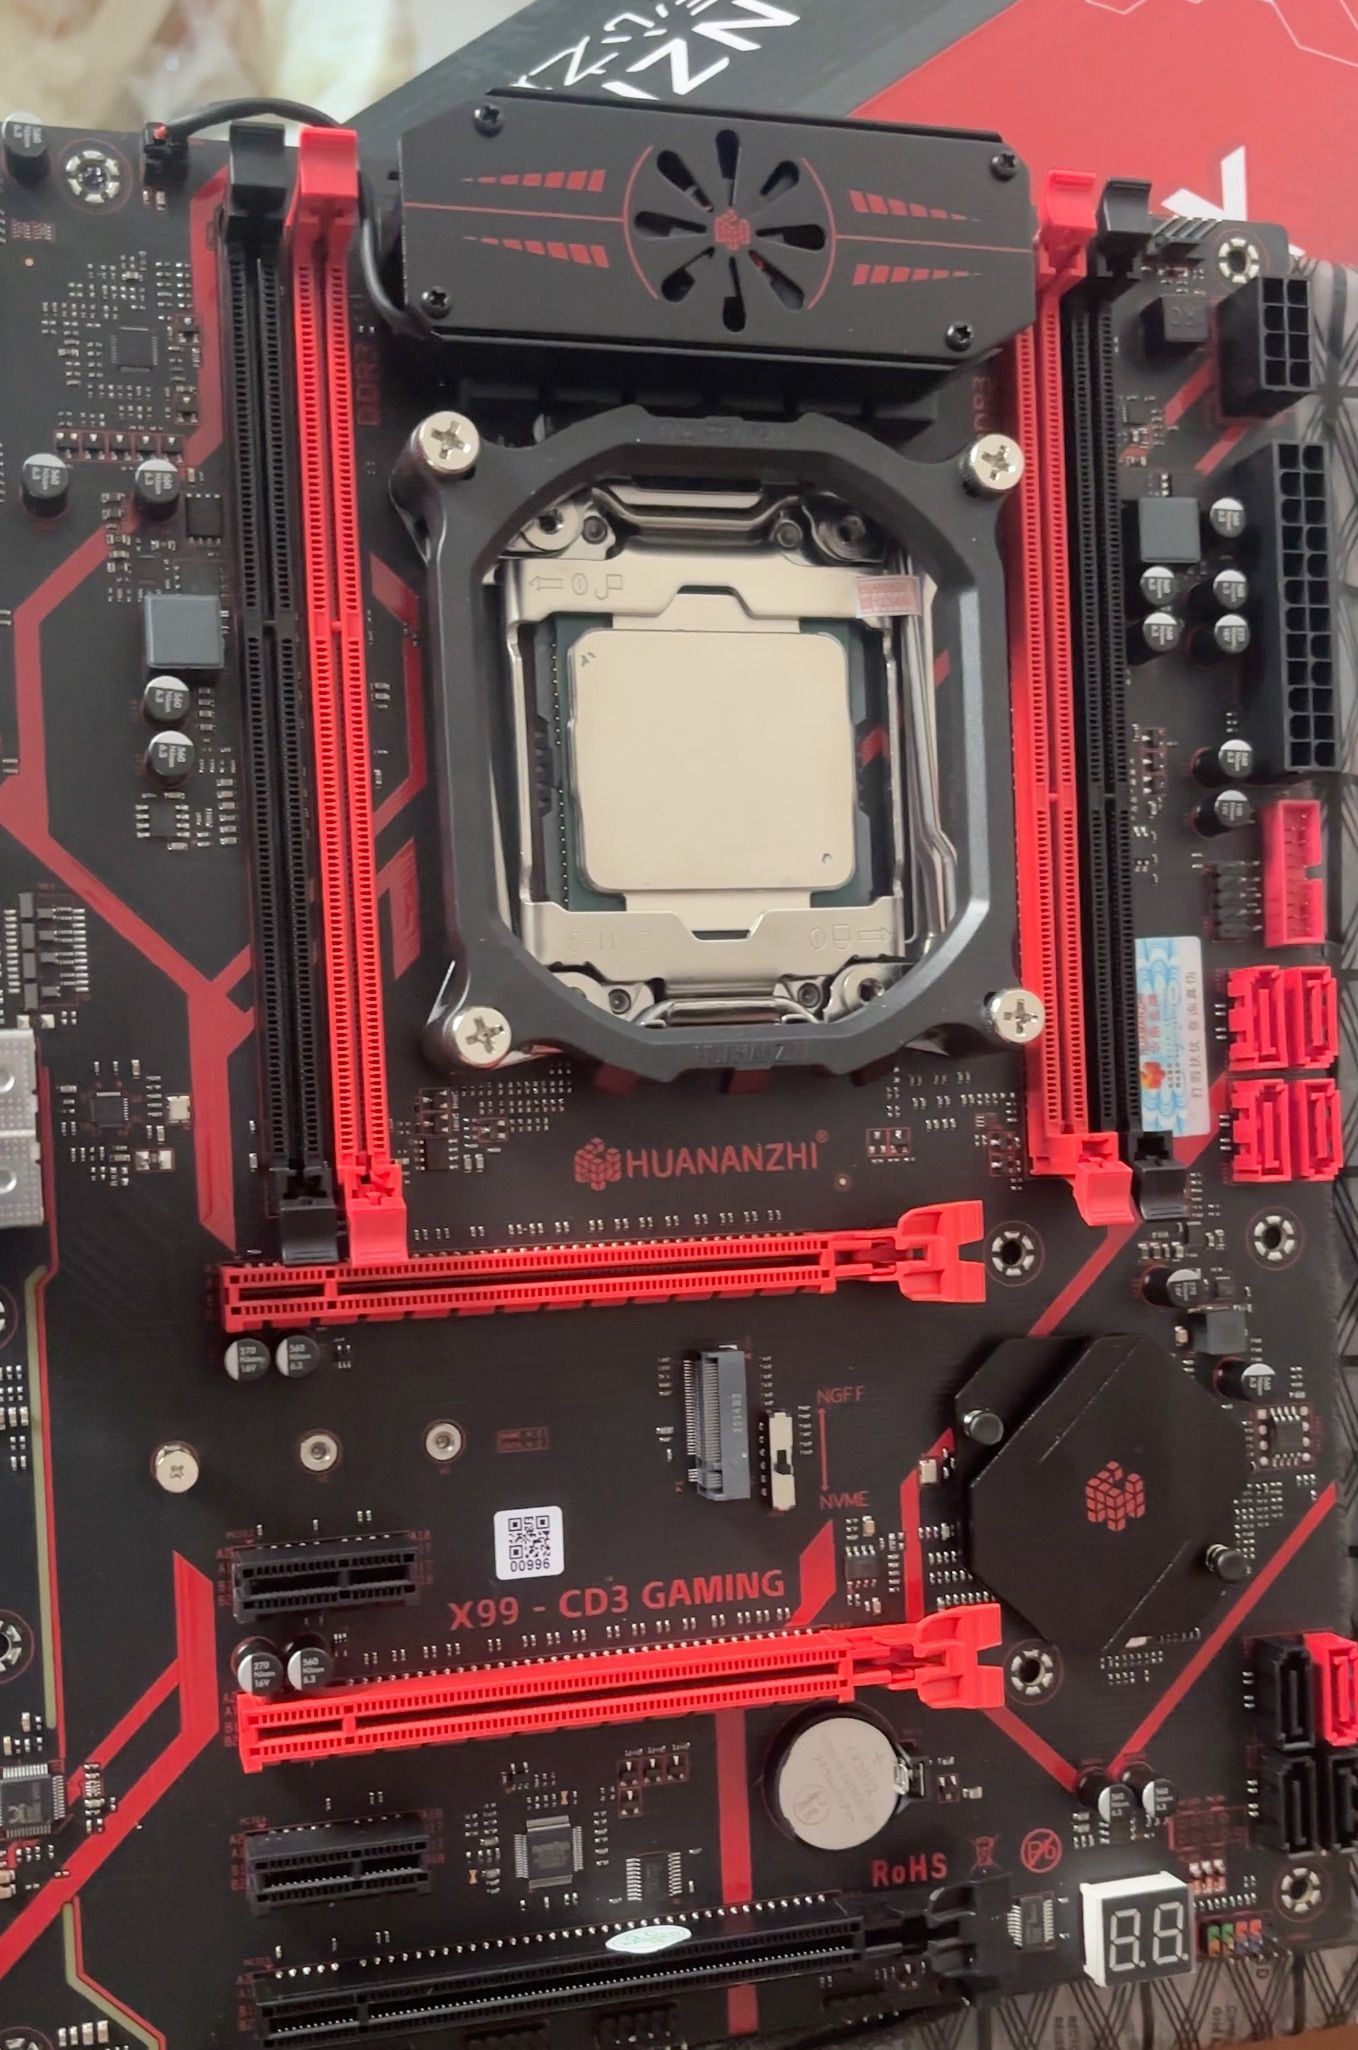
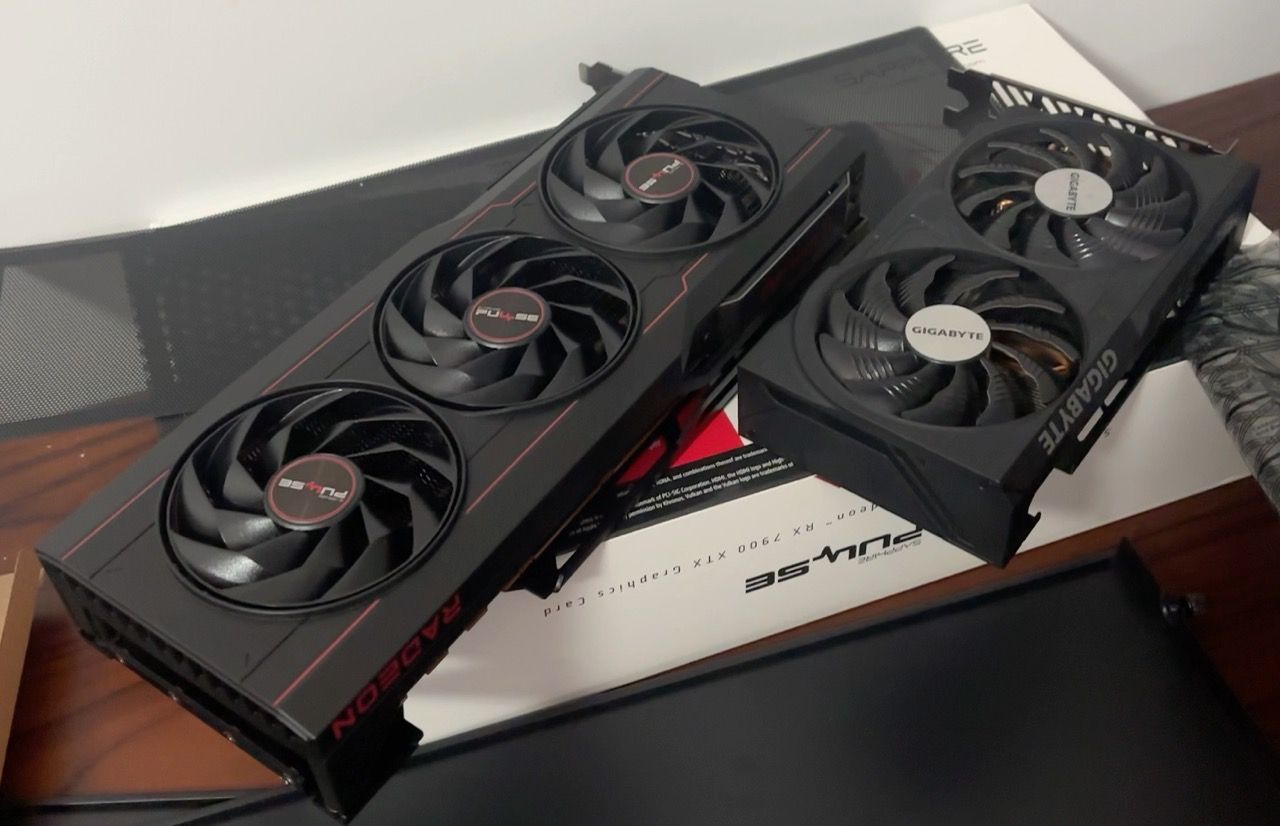
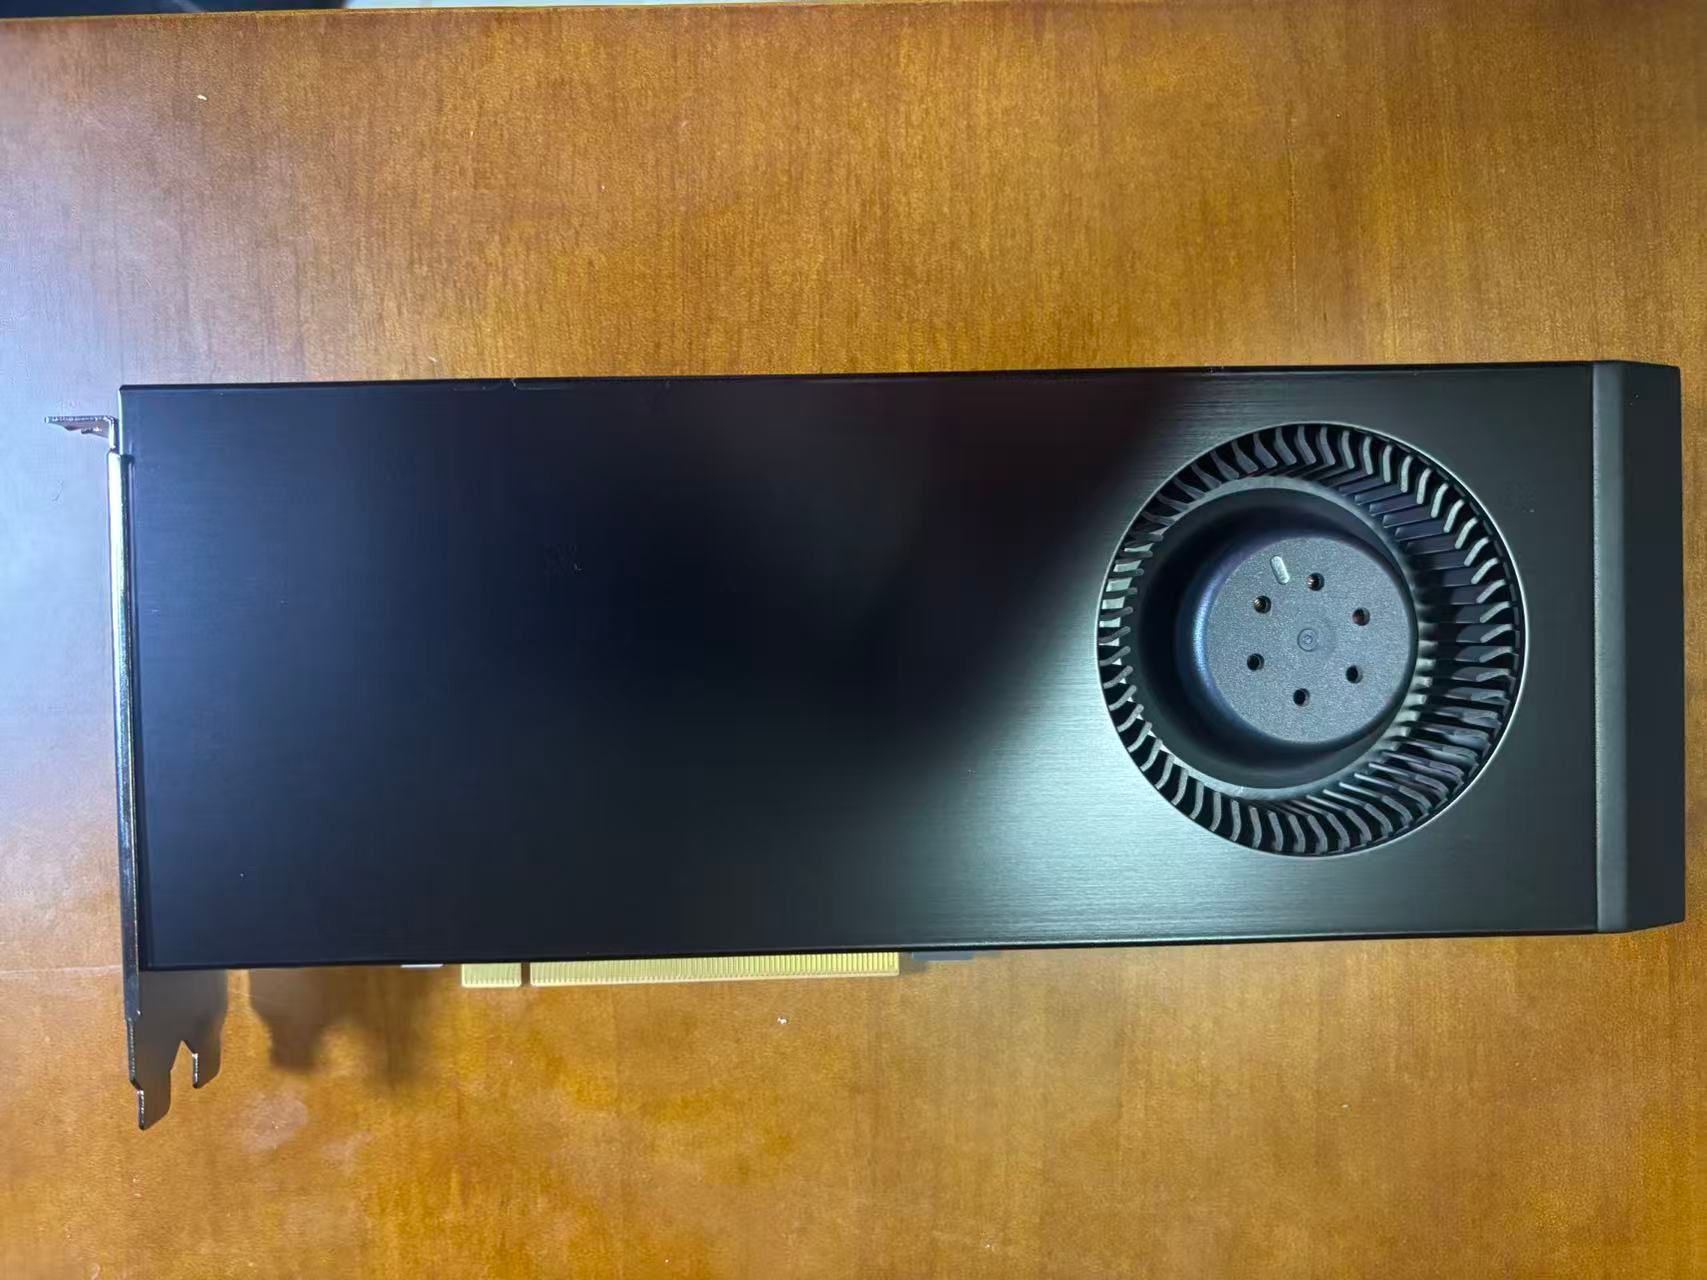
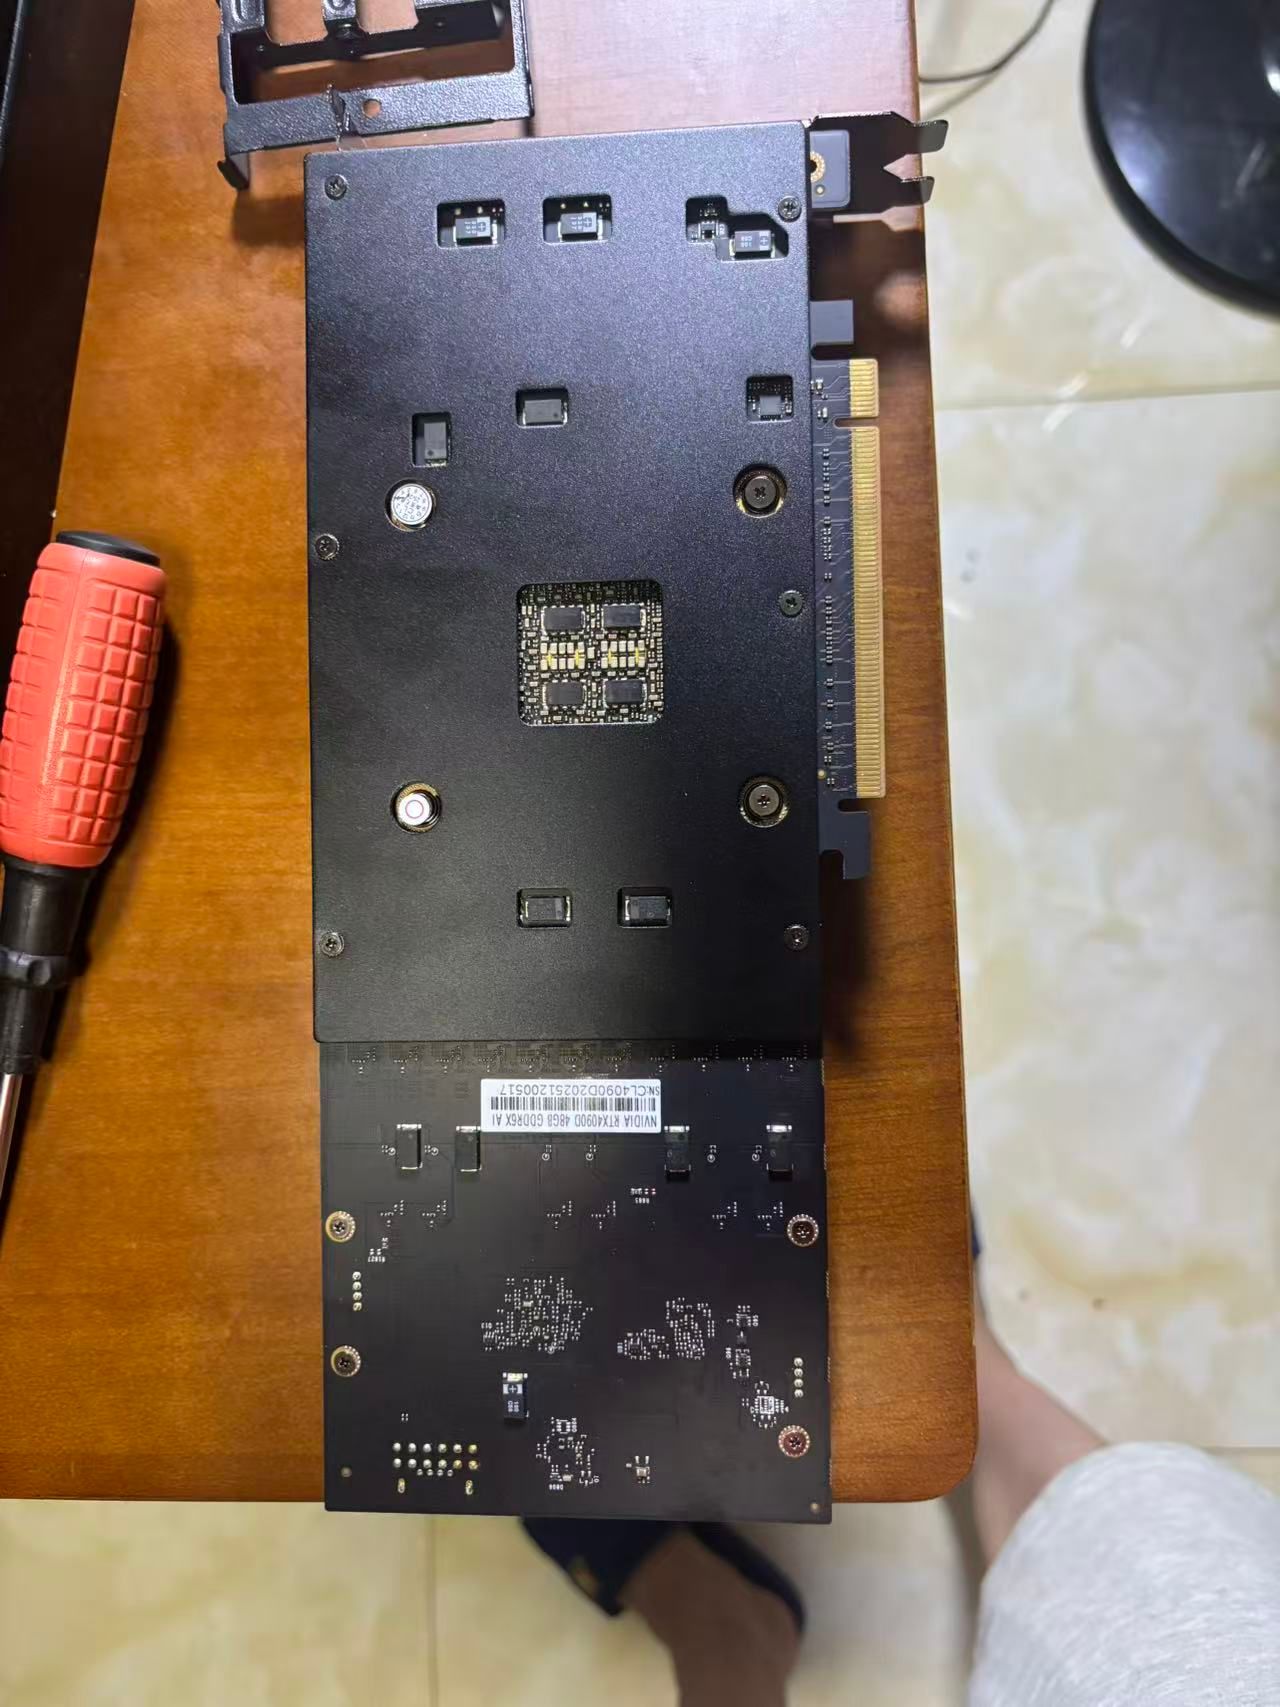
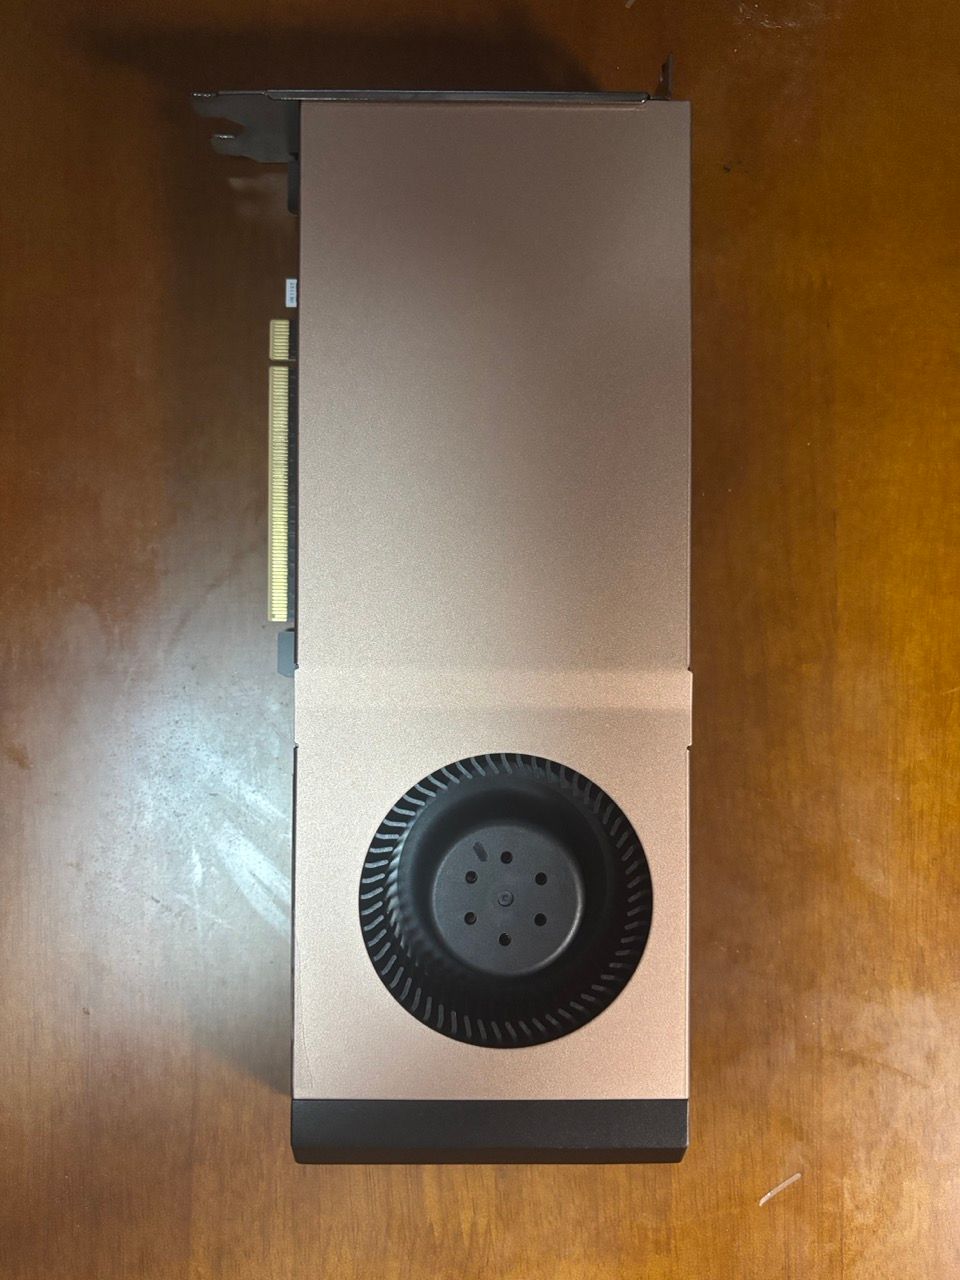
我知道我的帖子朴实无华,但是我抛砖引玉。因为我知道,人人都有一颗装逼的心
东方算芯的DF1000最近引起了广泛的讨论,这个清华大学魏少军团队研发的产品在发布之后,以独特的可重构计算,近存计算,混合键合等创新概念,给人们展示了一条新的AI芯片赛道。DF1000的架构属于 动态可重构架构(CGRA,Coarse-Grained Reconfigurable Architecture),这也就是魏少军教授团队在清华深耕了20年的核心技术,它不同于传统的指令集,比如ARM/X86/RISC-V,比如传统的GPU内部是固定的ALU(算术逻辑单元)阵列,通过固定的硬件流水线 and 复杂的指令控制流来干活。而DF1000内部是一个由大量异构计算颗粒(如处理单元阵列)组成的拓扑网络。它能在运行时在微秒甚至纳秒级别改变电路的物理连接状态,适配软件算法。就相当于它可以通过自家的CAAP工具链实现FPGA的类似功能,在定制的颗粒度上比FPGA更粗,不过其性能是吊打传统FPGA,可以做到和先进CPU/GPU差不多的性能。

这个概念听起来很玄幻,但是从官方数据来看,它就是现实,它的FP32/BF16算力基本上比A100更强,落后于H100,也就是在7nm到4nm制程的英伟达芯片之间,而且它的内部带宽远高于英伟达的这两款芯片,卡间互联带宽则持平。它以14nm制程做到如此恐怖的算力,着实令人震惊。由于采用近存架构,就是把计算部分和存储部分通过3D键合技术焊在一起,它的带宽利用效率远超外部布线连接的传统存储架构,构成了它差异化路线的另一个重要优势。

这颗芯片从架构生态、芯片制造再到软件生态,都是完全国产,自主可控,它可以接入开源的Linux系统,支持当下的Pytorch等标准AI生态,也能运行其他的国产定制系统,实用价值,情绪价值都拉满了。它的可变架构意味着在AI算子层出不穷,模型创新迭代飞快的当下,大模型企业可以通过软件修改芯片底层逻辑,得到近似于通用GPU,或者ASIC定制芯片的硬件加速效能。对于前沿算法创新而言,它简直就是神器。
如果你听的云里雾里,怀疑它是PPT造芯,骗经费的项目。那么你又搞错了,它不是中美贸易战之后的产物,早在2006年就立项,魏少军也是公认的可重构计算芯片领军人物。这是长达20年的技术积累和产业打磨,才有了今天的高光时刻,也就是说,他是个行动派,不是嘴炮。耐得住性子,芯片发布之后,整套软件栈,以及配套的下游厂商的多卡集群方案就同时推出,直接上架开卖。如果是那些骗经费的二把刀,估计在10年前就开始搞雕吹嘘了,一路吸引眼球了。

东方算芯的新技术路线革命性,类似于一战中出现的坦克,会改变战场力量对比。但是坦克并不是一战的关键胜负手,它在索姆河战役中只是把局部战线推进了十几公里。德国人在惊慌之后很快稳住了阵脚,找到了应对方法。真正让坦克发挥战力的是二战时的苏德两军,德国的闪电战就是依赖坦克装甲车为核心的突击集群,库尔斯克会战更是钢铁洪流的最高级别碰撞。东方算芯的最大问题时它和龙芯一样,是官方科研机构的产物,国资孵化,不是说这个模式不好,它能解决产业早期的生存问题,但是缺点就是决策缓慢,产业脱节,缺乏爆发力。龙芯在技术上是不错的,也是完全自主的指令集架构,它的行业影响力,完全不如华为这样的科技大厂。就算政府给它十倍的资源,它也不可能发展出从手机到电脑,再到AI服务器集群这样的规模化产业生态。

中国的国资,科技大厂已经用钱投票,接洽入股。东方算芯的估值已经突破百亿人民币,完全不愁销路,上海附近的企业就能消化掉。但是它的工程问题其实很多,比如采用3D键合导致多个工艺环节累进误差,早期良率不到50%,产能爬坡不仅需要时间,还需要中芯国际、华虹半导体这样的大厂专门定制产线,但是很明显,中芯华虹的产能都不够用,保障华为在未来几年都会是主轴,因为它承担了太多产业使命,大到不得不特殊对待。国内的AI知名企业比如GLM,DeepSeek等都在把适配华为当做头等任务,这不是因为它们有政治任务,而是现实决定了只有华为才能在这几年关键的竞争期,稳定提供大规模集群算力。
而且东方算芯的架构优势,越早投入,对AI产业的影响越大,如果迟迟不能规模化迭代,有可能错过黄金发展机遇,面临伤仲永的悲据。东方算芯是上海国资的项目,如果直接打包卖给华为,基本上是不现实的,深圳和上海的芯片产业竞争非常激烈,宇量升就是个典型的妥协产物,双方都不太可能把主导权主动交出去。所以即便华为和中芯国际的合作非常稳定,深圳市政府还是在牵头搞独立的芯片产业群落,新凯来一大堆本地企业就是代表。深圳在建立本地芯片生产线的同时,还要攻克EUV,并不是完全指望上海微电子的,中芯国际的项目。

所以,东方算芯是有比较大的可能成为下一个龙芯的,它目前的沪产沪用口号看起来是有强力的市场保障,实则是地方保护主义的温室效应。从技术重要性的角度来说,它的上限远比龙芯重要,是能够破局的关键武器,而且它有众多专利护城河,但是上海本地企业的工程化能力,是远不如深圳的。你别看中芯国际很牛逼,它的很多技术迭代,梁孟松贡献很大,但华为也同样功不可没。深圳有比亚迪,华为,大疆这样世界顶级的硬件厂商,中国的手机产业链,也是深圳最强。能不能打破地方隔阂,把东方算芯掌握的关键技术打造成各地协同的生态,是它能否做大的关键指标。
毕竟,同样是在中国,总体上各地合作大于竞争,无非是主导权,政绩算谁的。魏少军的清华团队,在科研上毫无疑问是北京提供,但是上海主导了产业链,沪产沪用就是政绩宣誓。中芯国际+东方算芯+DeepSeek可以组成一个不错的长三角生态,能玩出点花样,或许值得一试。这样不用牵扯到深圳的华为,又能展开第二条技术突围路线。就是最终你的芯片如何,还是要放到国际竞争中来。在上海的小圈子里小打小闹,百卡集群供应给小企业,研究机构,就是温室成长路线,毫无前途。多花点钱,找个互联方案提供者,和DeepSeek协作下,直接冲击千卡,万卡集群,最终以大模型作为成品和OpenAI、Anthropic,谷歌等国际企业竞争,才是最好的检测手段。

这个生态竞赛其实很简单纯粹,就是没有必要比拼芯片制造,封装测试,底层算子,模型架构等等琐碎的技术细节,就是看谁的最终解决方案更好用,更有性价比。无论是在线API,还是本地部署交付方案,只要有一个能得到高分,它的价值就能得到体现。在国际一线竞争中接受最强对手的考验,用这样的外部压力和国际通行指标来考核,才能压榨东方算芯,魏少军团队的极限潜能,把这项技术创新打造成为国之重器。
退一万步讲,如果企业没什么进取心,可以专供小企业,小团队,本地AI的细分市场,早点拿出单卡双卡小主机,推到市场上,开源机构以及AI爱好者用起来,检验下你们的技术成色。DF1000发布以来,国际媒体报道很多,各种媒体节目讨论也很多。但是英伟达,AMD,英特尔等国际巨头基本上没什么表态,不是说这个技术不够新颖震撼,而是在这些巨头的眼中,东方算芯不过是高阶版本的龙芯,对自身业务的影响可以说无限趋近于零。越是在对手蔑视的时候,中国企业越应该协同努力,把我们掌握的先进技术工程化,产业化,最终用顶级产品打脸四方。华为的逻辑折叠,长鑫、东方算芯的3D键合,近存计算等概念争取了战略缓冲期,国产EUV项目等传统技术路线也在不断推进。
样本测试环境是Ubuntu24.04,显卡4090D 48G魔改卡,用到GPU-RUN,stress-ng等,工具大家不用关心,直接复制脚本给AI,比如DeepSeek或者Gemini,让它们改就行了。主要有简单的显卡压力测试,显存测试,,还有系统内存测试,这些对魔改卡,二手内存都挺有用的。当然,烤机还是建议大家使用3D Mark或者Fury Mark等专业工具。由于跑AI的服务器很多人只装了Linux,而且AI高负载运行本身的烈度就是烤机级别的,所以我个人认为搭配脚本,Nvidia-smi等工具也就差不多了。
下面这个是显存测试脚本,检查显存坏快,对非ECC显存的显卡而言很实用:
cat << 'EOF' > ~/ex/vram_heavy_test.py
import torch
import sys

print(f"📦 正在启动英伟达大显存/魔改卡物理专项分块扫描...")
if not torch.cuda.is_available():
    print("❌ 没找到 GPU 驱动")
    sys.exit(1)

device = torch.device("cuda:0")

# 物理显存总量
total_mem = torch.cuda.get_device_properties(0).total_memory
print(f"⚡ 物理检测到总显存: {total_mem / (1024**3):.2f} GB")

# 留出 2GB 驱动余量,其余全部压榨
usable_mem = total_mem - 2 * 1024 * 1024 * 1024

# 分块测试:每块分配 8GB
chunk_size_bytes = 8 * 1024 * 1024 * 1024
num_chunks = int(usable_mem // chunk_size_bytes)
element_per_chunk = int(chunk_size_bytes // 4) # int32 占 4 字节

print(f"🔥 自动开启分块轰炸模式:共分 {num_chunks} 块,每块 {chunk_size_bytes / (1024**3):.1f} GB 滚动压榨...")

try:
    holder = []

    # 模式一:分块写入全 0 并校验物理放电
    print("\n -> [步骤 1/4] 分块写入全 0000 模式并校验物理放电...")
    for i in range(num_chunks):
        chunk = torch.zeros(element_per_chunk, dtype=torch.int32, device=device)
        torch.cuda.synchronize()
        if not (chunk == 0).all().item():
            raise ValueError(f"第 {i+1} 块显存放电校验失败!")
        holder.append(chunk)
    print(f"   [OK] 成功霸占并校验 {len(holder) * 8} GB 显存全 0 写入。")

    # 释放并清理
    del holder; torch.cuda.empty_cache(); holder = []

    # 模式二:分块写入全 1 并校验物理充电
    print("\n -> [步骤 2/4] 分块写入全 1111 模式并校验物理充电...")
    for i in range(num_chunks):
        chunk = torch.full((element_per_chunk,), -1, dtype=torch.int32, device=device)
        torch.cuda.synchronize()
        if not (chunk == -1).all().item():
            raise ValueError(f"第 {i+1} 块显存充电校验失败!")
        holder.append(chunk)
    print(f"   [OK] 成功霸占并校验 {len(holder) * 8} GB 显存全 1 写入。")

    # 释放并清理
    del holder; torch.cuda.empty_cache(); holder = []

    # 模式三 & 四:棋盘格交替位元高频冲刷与深度校验
    print("\n -> [步骤 3/4] 发起物理交替位元高频冲刷 (0101 棋盘格)...")

    # 【核心修正】直接利用有符号整型溢出特性得到对应的 int32 标量
    # 0x55555555 -> 1431655765
    # 0xAAAAAAAA -> -1431655766
    p1 = 1431655765
    p2 = -1431655766

    for i in range(num_chunks):
        chunk = torch.empty(element_per_chunk, dtype=torch.int32, device=device)
        # 使用原生 int32 标量通过 fill_ 填充,完美避开 Python 自带的边界拦截
        chunk[0::2].fill_(p1)
        chunk[1::2].fill_(p2)
        holder.append(chunk)
    torch.cuda.synchronize()
    print(f"   [OK] 成功写入并高频冲刷棋盘格位元模式。")

    print("\n -> [步骤 4/4] 正在进行全量显存深度读取校验...")
    for i, chunk in enumerate(holder):
        if not (chunk[0::2] == p1).all().item():
            raise ValueError(f"第 {i+1} 块奇数位元干扰校验失败!")
        if not (chunk[1::2] == p2).all().item():
            raise ValueError(f"第 {i+1} 块偶数位元干扰校验失败!")

    print(f"\n🎉【显存物理体检通过】这块 {total_mem / (1024**3):.1f}GB 的大显存卡通过 100% 逐位读写测试!")

except Exception as e:
    print(f"\n❌【显存检测失败】: {e}")
    sys.exit(1)
EOF

# 再次启动!
python ~/ex/vram_heavy_test.py
GPU- RUN压力测试:
# 1. 强行激活虚拟环境(确保在 venv 状态下)
source /mnt/nvidia/venv_4090/bin/activate

# 2. 直接一行命令写出一个暴力硬件压力测试脚本
cat << 'EOF' > ~/ex/gpu_hardware_test.py
import torch
import time
import sys

print(f"📦 正在检测硬件设备: {torch.cuda.get_device_name(0)}")
print(f"⚡ 当前 CUDA 版本: {torch.version.cuda}")

# 强行拉起一个 20000x20000 的恐怖巨型浮点矩阵(直接把显存和计算核心撑爆)
device = torch.device("cuda:0")
try:
    print("🚀 正在往显存里疯狂塞入大量物理数据...")
    x = torch.randn(20000, 20000, dtype=torch.bfloat16, device=device)
    y = torch.randn(20000, 20000, dtype=torch.bfloat16, device=device)

    print("🔥 矩阵已就绪,正式发起 1000 轮全血满载高频计算轰炸(请盯紧系统状态)...")
    start_time = time.time()

    for i in range(1, 1001):
        # 连续进行极其高频的矩阵乘法冲刷
        z = torch.matmul(x, y)

        # 每 100 轮强制进行一次物理同步和显存冲刷(专门去踩你之前的 Xid 158 断层)
        if i % 100 == 0:
            torch.cuda.synchronize()
            print(f"   -> [进度] 已顶过 {i}/1000 轮高频轰炸...")

    torch.cuda.synchronize()
    print(f"🎉【测试通过】显卡硬件抗住了全部物理轰炸!耗时: {time.time() - start_time:.2f} 秒!")

except Exception as e:
    print(f"\n❌ 软件层捕获到异常: {e}")
    sys.exit(1)
EOF

# 3. 直接开轰!
python ~/ex/gpu_hardware_test.py
系统内存检查:
sudo apt-get install -y stress-ng
# 强行用 8 个线程,把 90% 的系统总内存全部塞满高频读写,测试 2 分钟
stress-ng --vm 8 --vm-bytes 90% --timeout 120s --metrics-brief
前些年我们中国不是流行一句话吗,说“二舅治好了我的精神内耗”。那么我想,AI兴起之后,它成了很多人的二爷,或者成了很多人的二叔。它是直接把你这个精神内耗,不是治好了,直接给打没了。
之前我们老是担心什么?中年失业是吧,我们这个行业不再流行了、不再兴旺了,或者我们这个年纪身体不行了,或者我们的专业技能跟不上时代的进步了,我们要被淘汰了。但是有了AI之后,哎呦我操,在AI面前我们真的,你就是再给你年轻个十年八年,再给你年轻个十五年,你又能如何?
你像论坛的一些工作,叫它去做一些信息的统计,整理这些什么AI项目、AI框架、AI软件、大模型这些基本的信息,你说你要自己吭哧吭哧地去搞,这里得多少信息啊?比如说哪些是推理框架,哪些是生成式AI,哪些是普通的AI大模型,哪些是苹果的,哪些是Agent。这些东西信息讲实话太多了,包括大模型的家族,哪些是开源的,哪些是闭源的。这里面就有很多东西,包括它要跟论坛的帖子互动,比如说像vLLM。
当然这里面显示有一些异常,就是我的Firefox没有连科学上网,有的时候显示会有一点问题,这个是没办法,我们国内的环境就是这样。我专门备一个不连外网的浏览器,来尽量保证我们国内的用户访问论坛的时候,能有一个基本的体验,当然会稍差一点。不过我测试的时候,也没有使用我在线的论坛,而是把我在线论坛的数据给同步到了本地。大家看看,这是局域网的地址。
一般来说,我会让AI在本地开发好之后,我基本上测试大差不离了,没什么严重的问题了,我再把它提交、同步到在线的论坛中去。但是我也跟大家说实话,我只能让另一个AI来审核它的工作成果,然后我自己抽查。因为现在AI产出的内容太多了,你说完全人工去审核,那基本上是不可能的,你做不到的。
然后我们论坛有些大神,不是已经有那个社区项目吗?他们搞的一些开源的小工具,我们也把它用专门的页面展示出来,现在是不是非常牛逼了?如果说你想在这个社区分享一下自己的开源项目,论坛也尽量帮你推一推,让你有一个基本的起步。这些教程,我们的内容还是会越来越多的。
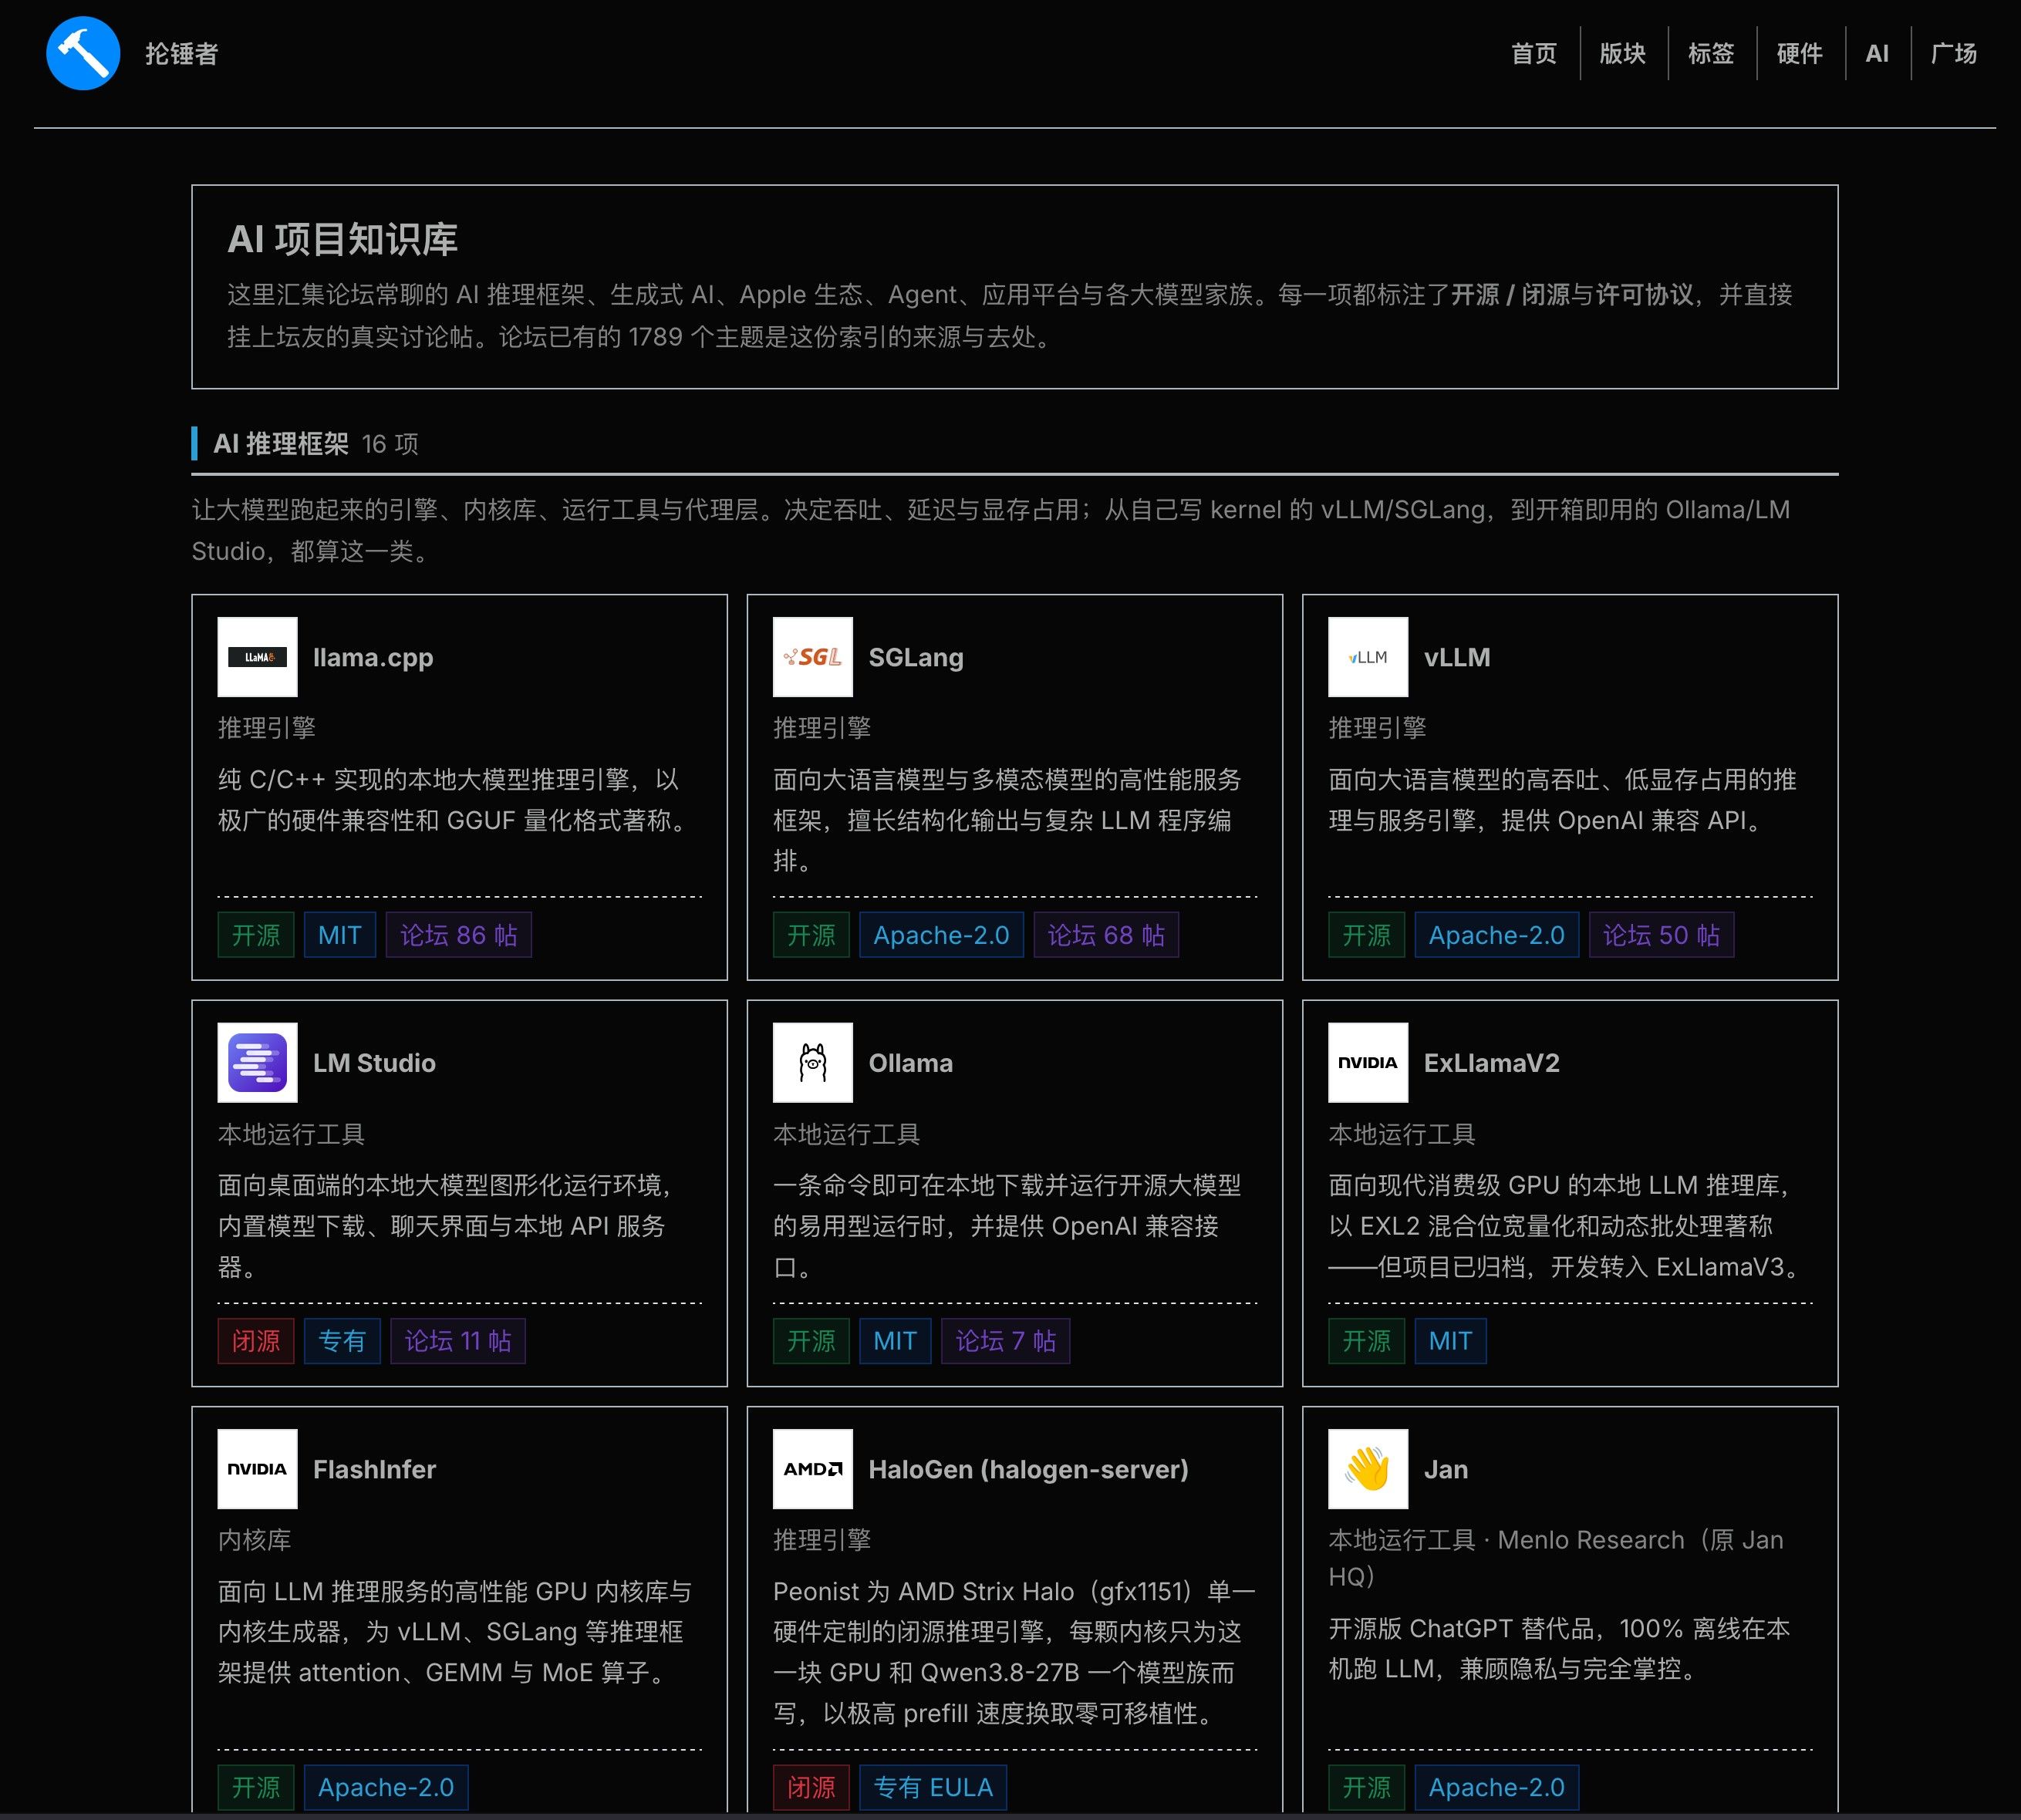
当然了,这个视频有的是绑定YouTube的,没有科学上网是解析不出来的,这个我就管不了了。我只能管大家没有科学上网的时候,能访问一些基本的信息,文字啊、图片啊。但是视频由于我们是以油管这些境外的平台为主,所以就没有办法了。当然以后可能我们也会引入对于B站的支持,大家可能在国内的抖音、B站放的一些视频,我们都能把它正常解析出来。现在暂时还没去搞这个东西,以后有空再说吧。
前段时间我不是搞了一个硬件家族的页面吗?这些都是AI硬件相关的,各种显卡,英伟达的显卡、AMD的显卡,有很多个页面。其实两个项目总体的工作量是差不多的,但是当时它一天耗了我80多块钱。那一天是耗了我89块钱,耗了14亿个tokens,一共消耗了89块钱,我觉得有点夸张了。
那么今天,它的消耗是23块钱。可能有一块钱到一块五左右,是我零点要对网站进行一次审计。我让Hermes去审计DeepSeek Harness的维护成果,这个是不是有点拗口?我的Hermes是有长期记忆系统的,就是我的虚拟助手“小特”。然后它有一个分身在我的网站服务器上,由它来管理我整个在线的论坛,响应版主跟我的指令。然后每天它的工作成果,我是让本地的Hermes去审计,它大概一次要花一块钱左右,有的时候会更多一点。
你说以前嘛,你要找一个助手,你想一个月雇一个最便宜的员工,四五千块钱你得要吧?他得有一点IT常识,得有一点基本的常识。最近几天还有涨价的时候,因为还加上我在开发视频的自动生成器,我又在开发论坛的APP,而且是跨平台的,苹果跟安卓都开发。在这种情况下,我一个月的消耗,加上我的网站整个维护、本地的一些脚本的一些配置使用,这一个月消耗才400多块钱。
当然了,我必须承认,我是用了一部分本地的千问3.8 27B这个模型来辅助,但是大部分的消耗还是在DeepSeek家族,就是在线的API。你说在这种情况下,我们去讨论我们人类有没有什么生产力,我们跟AI相比,我们的生产效率如何,你觉得还有意义吗?
但是我必须要说,有很多人整天吹牛逼说AI会快速地取代人类,尤其是什么Anthropic跟OpenAI,它们说人工智能现在的能力又多么多么强,怎么怎么样。我必须也要否定这个东西,就是说有很多东西还是需要我们人工介入的。你再牛逼的大模型,像我平时在开发APP,就有很多功能讲实话没有用的,你还是要自己人工来监工才行。
有些功能测试,AI觉得自己能用了,但是你真正人类来用的话,它的bug还是非常多的。你看看,我这里面多少轮?118轮,3000多步。然后tokens消耗多少?15亿个tokens。它实际上怎么讲呢?AI暂时还没有智能到完全脱离人类,不需要我们审计,它自己能给出一个明确预期的这么一个状态。现在还不能,而且我觉得未来几年可能都做不到。
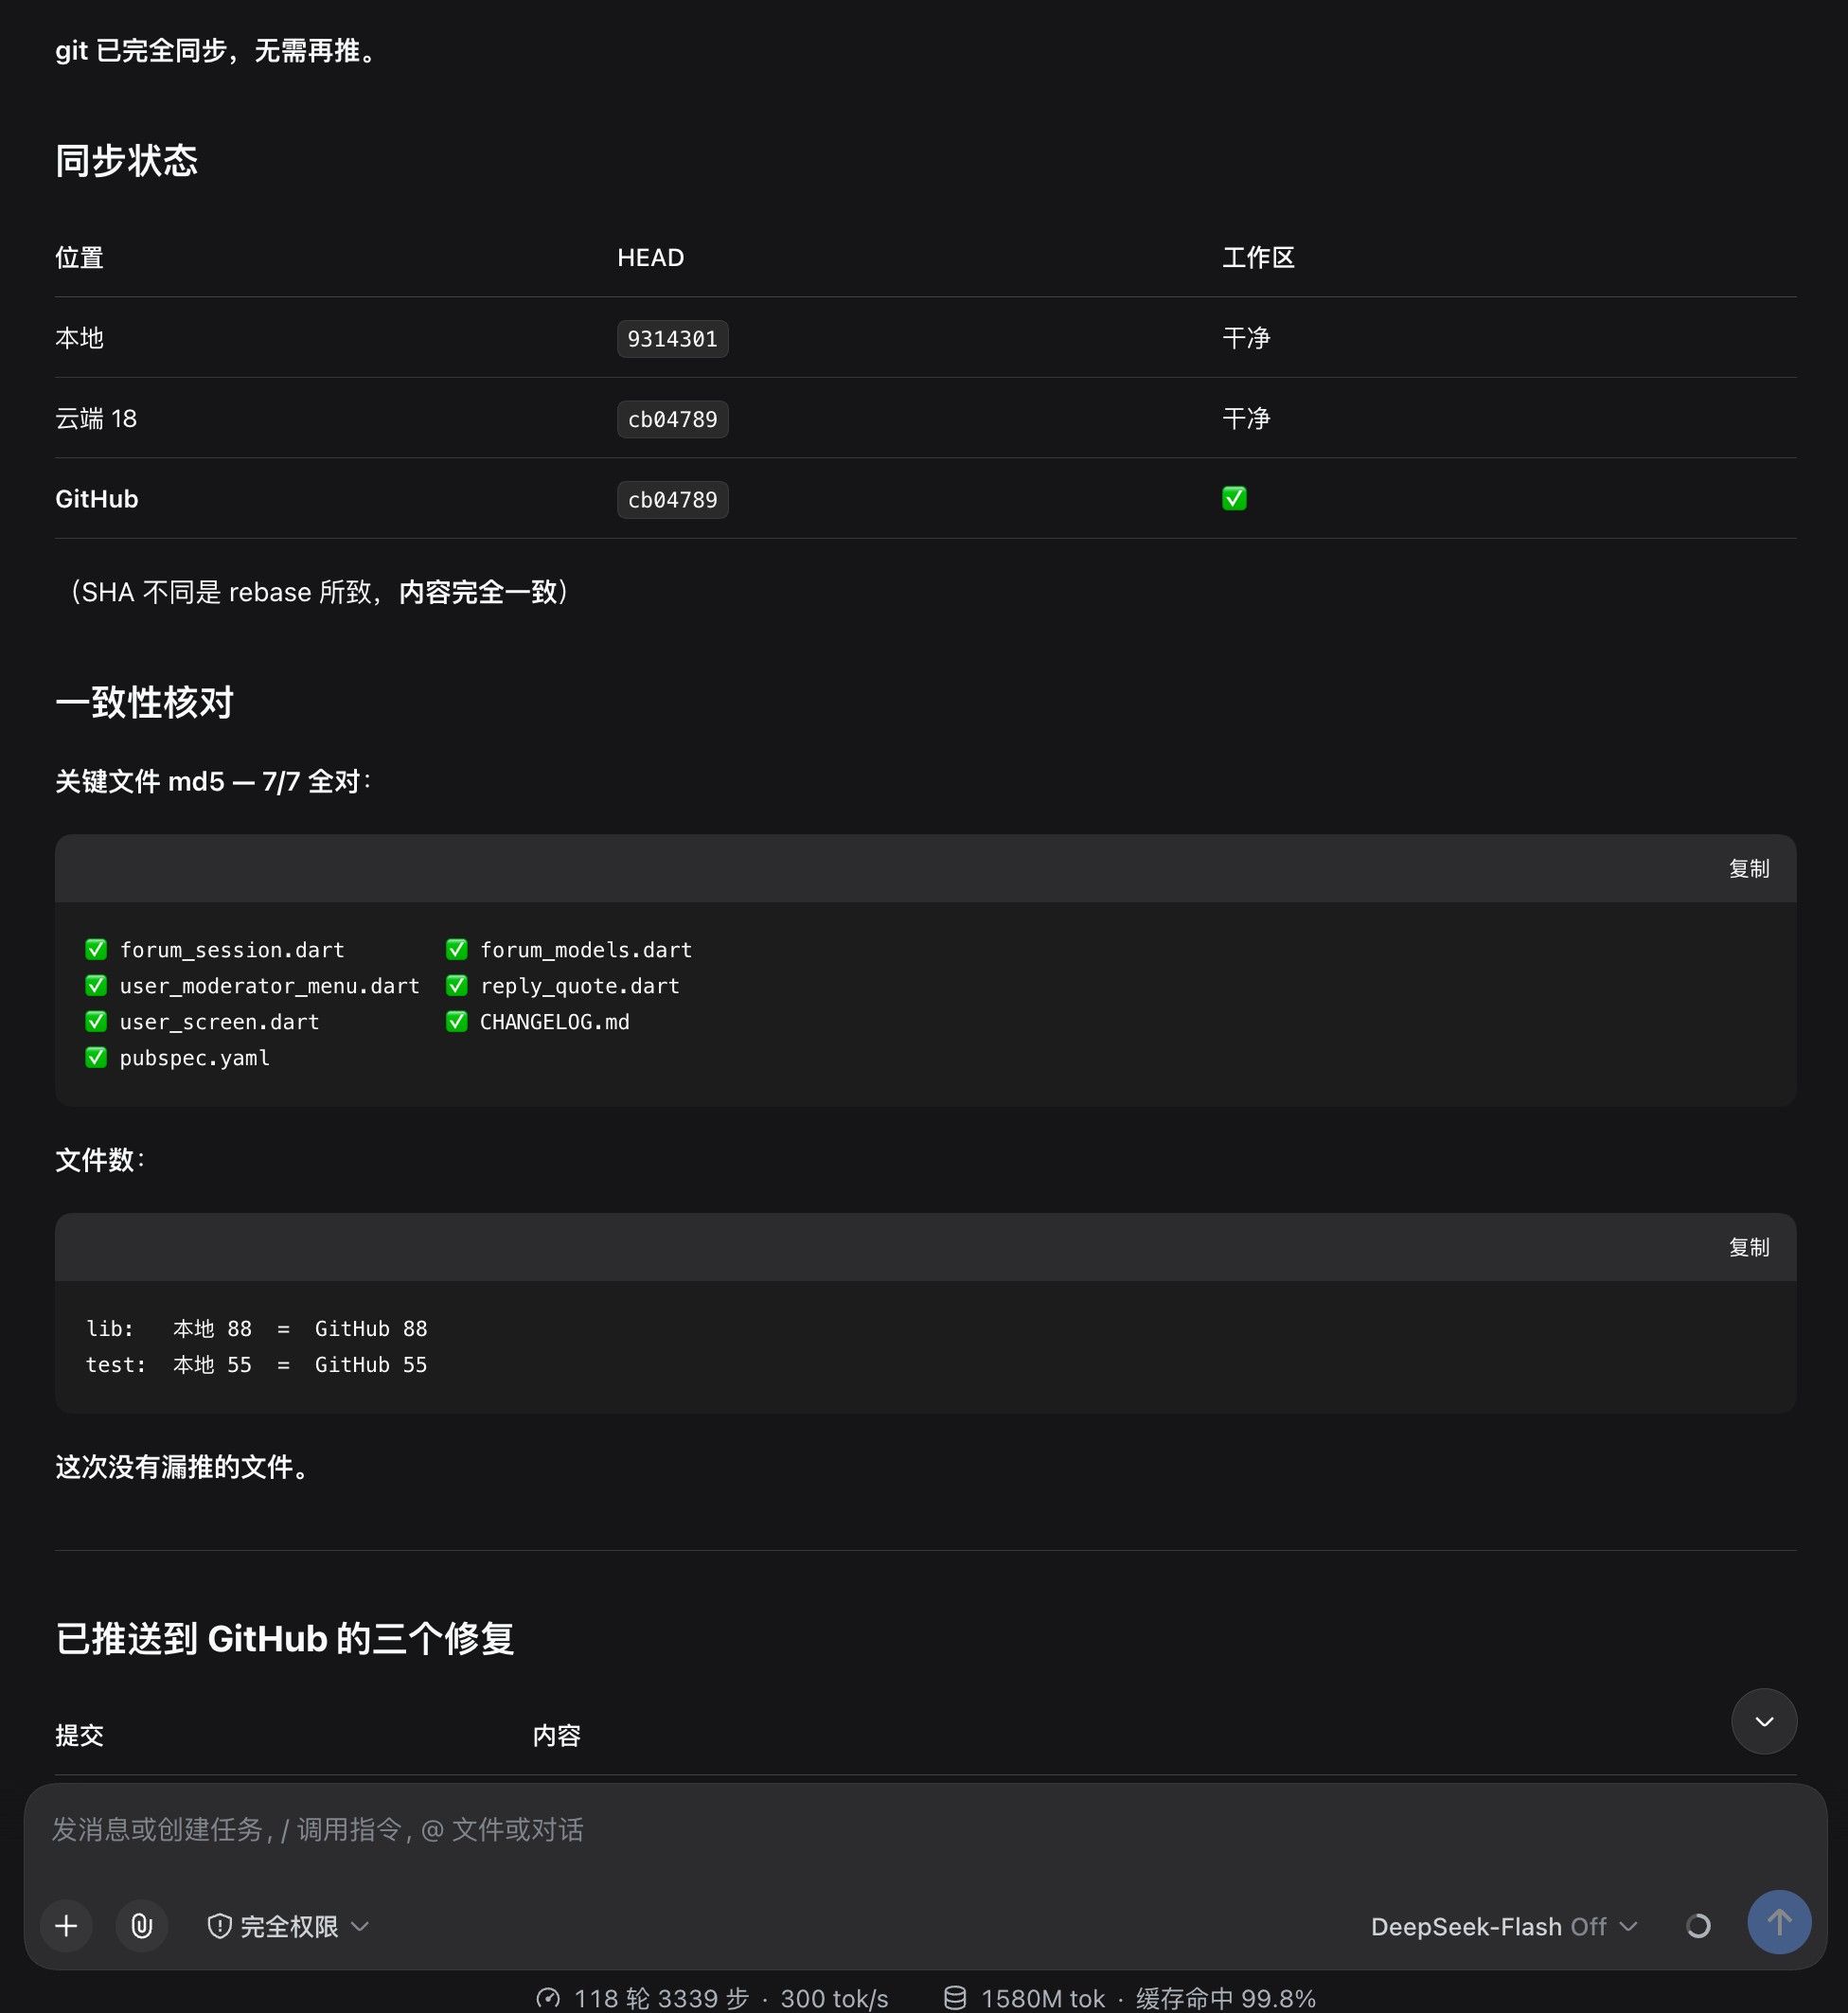
未来几年有可能AI能够实现什么功能呢?就是我这个论坛APP,我在之前的视频里不是讲过吗?它有一个锚点的话,我们只需要一句话就告诉它,我这个网站的网页端实现了哪些功能,你在APP上给实现一模一样的功能就行了,它可能就搞定了。因为它有一个明确的锚点,它能够自己自我修正,它有一个参考目标。
但是如果说你还是一句话就说一下,那我想你这一句话本身都不能把这个论坛的基本功能给描述清楚,你还是做不到的。你要设计一个产品,即便AI再强大,你还是要把这些基本的功能,论坛有哪些功能,给它说清楚,它才能把你的APP快速地开发出来。
但是像我这样已经成熟运营的社区,再加上我这个开源软件NodeBB本身把API做得非常成熟,而且我使用的是标准的Linux系统,也方便AI通过命令行操作。在这种情况下,AI在知道你的一些基本审美要求之后,它能够快速地开发出APP。
然后我再说一下一些常识。很多东西是超出我们预料的,就是之前我们不是一直以为很多软件是开源的吗?但事实上它不是的。就像昨天的视频中,我不是抨击这个ZCode,就智谱的ZCode。我们一直以为它是,很多人都以为它是开源的软件,因为智谱这家公司很多AI大模型都是开源的,但是大家可能没意识到,它的编程工具ZCode是闭源的。然后它偷到用户的代码,偷偷上传用户的整个项目信息,被抓了个现行。
那么其实我也就整理了一些信息,哪些东西是开源的,哪些东西是闭源的。你像Cursor,它就是闭源的商业软件,可能有些也是部分开源的。像OpenAI,它都是有些模型是开源的,有些模型是闭源的,但是它以闭源为主。像阿里巴巴,它有些模型是开源的,有些是闭源的,但是它以开源为主。像Claude,它就是完全闭源,它无论是Claude Code还是Claude大模型家族本身。像DeepSeek就是开源最彻底的,它是什么东西都开源,它连部署工具都给你开源。
像我们一些印象中的错误,比如说LM Studio,我们在Linux平台上面就经常用它,包括我们最近推的HaloGen,它对AMD的本地推理效率提升很大,但是实际上这些工具它们都是闭源的。未来它们什么时候开源我们不知道,反正目前它们是闭源的。
就是尽量我们还是要使用一些开源的产品。所有的公司、所有的大模型,基本上你把数据提交上去之后,你就难免会泄露自己的商业思维。但是开源工具往往它会更干净,因为开源是它市场生态地位的一个重要助力、一个重要标志、重要的来源,它是不会轻易糟蹋这个招牌的。
你比如说像智谱,它偷了用户的代码之后,它就算道歉,有没有用?我个人认为用处是不大的。它说以后要把ZCode开源,但是我觉得如果说你还在相信它,就被贼偷了一次之后,你还再去相信它,那么基本上就是智商问题了。你在开源世界去糟蹋自己的信誉,去偷用户的数据,成本是非常高的。但是闭源的项目说实话,它好像本身就给你签订了对自己有利的数据协议。你每次装它APP,你点的那个同意,基本上就等于卖身了。
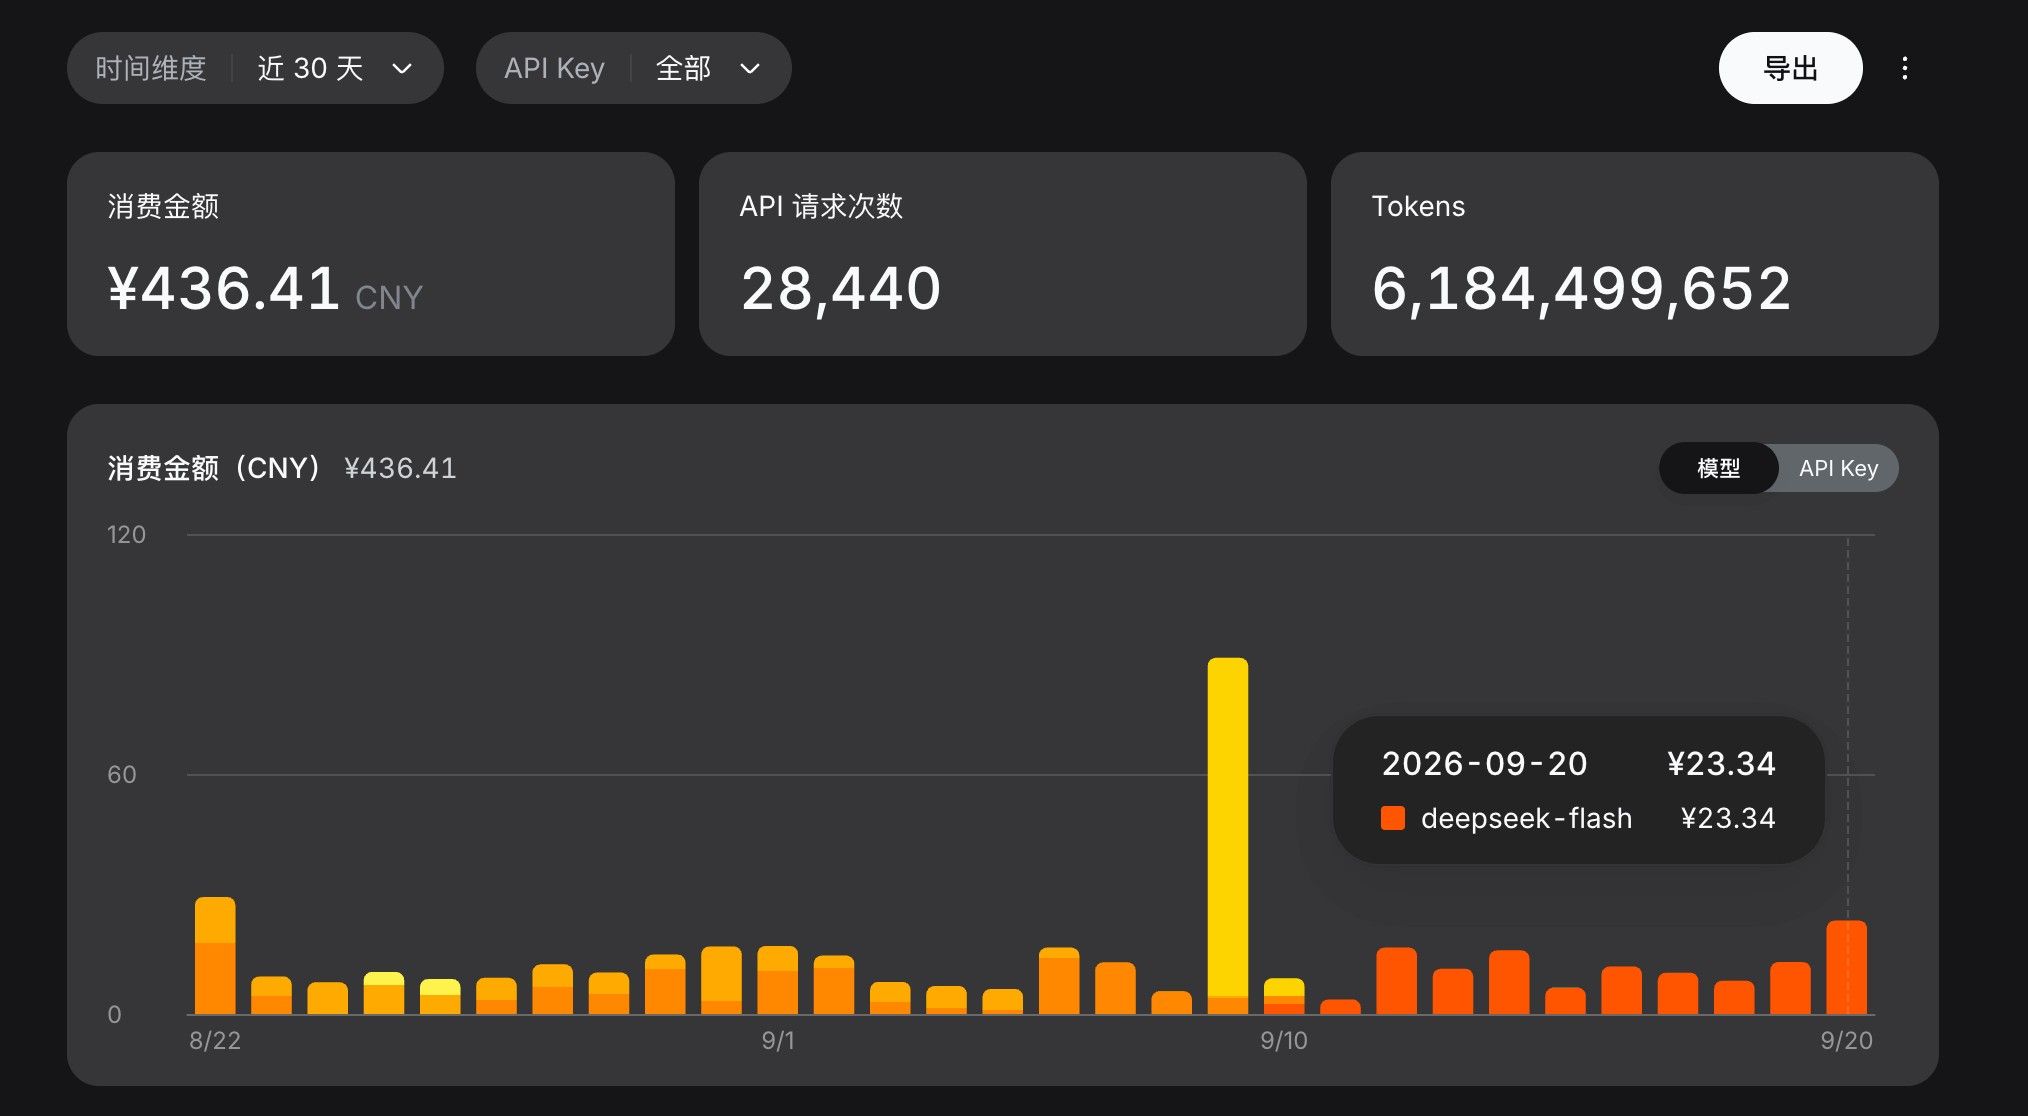
然后我们看一下AI的进步速度。你说这几天时间,不到一个月的时间,它的工作效率就大大提升。之前可能我花80多块钱做的这些项目,现在我可能只需要花它1/3甚至1/4的价格就能搞定了。当然了,本身也是由于它消耗的tokens确实是变少了。另一方面,就是DeepSeek V4降价了。总之是一个综合的因素吧。
以后我们用AI来干活,它这个成本,我不好说会变得更便宜或者说更贵,但是相对于同一家公司来讲的话,我觉得随着算力的大幅提升,包括软件本身在进化、效率在提高,使用AI干活的成本总体上会越来越低。
如果说你的工作没有特别深的这么一种架构耦合,或者说你对项目经理、产品经理、架构师的工作基本上一无所知,你本身不能独立地去完成一个还比较复杂的APP,就是独立完成,你带领一群AI就能搞定这个工作。如果说你不掌握这个能力,那你基本上离失业就不远了,你是肯定会失业的。
但是如果说你掌握了这个能力,我相信你也有可能就不太想在老板的手下工作了。因为现在AI处于成长的初级阶段,如果说你掌握了驾驭AI的这么一个能力,你有可能在老板炒掉你之前能够找到新的项目,这个项目有可能为你赚到钱。
就像几个月之前,我还在视频中跟大家讲,我说我现在要放弃我已经在赚钱的英语频道,而且是两个。我单个频道一年还是能给我挣个两万三四千美金的,一个月大概2000美金左右。但是我说我不露脸,我怕被平台封杀,因为我的AI含量太高,怕被平台封杀,我要做真人露脸的视频来谈AI、来谈科技。
那么现在我单个中文频道的收入已经是接近我英语频道的收入了,但是确实还没有达到。那我可以承受一部分的经济损失,转移到这个中文频道上来,把工作重心转移到中文频道上来。那我就能吃这个AI的长周期红利,因为我谈AI本身就赚钱,我再利用AI做一些实践,再把这些实践做成视频,又能赚一波钱。
虽然我这个小论坛、小网站本身流量也不是很夸张,刚刚起步,有几千人注册,现在还在谷歌的沙盒里,只有其他的一些什么必应、百度,或者说油管、其他的社交媒体分享来给我带来一些基本的流量,起步了。那如果我坚持做个几年,它也有可能会成为一个非常不错的收入来源。
总之,担心是没有用的,就是变化已经来临了。越早适应它,你越主动。好吧,本期视频就到这里。有什么需要分享的,欢迎到论坛发帖。
论坛首批版主名单:
@tony-wang
@kop-wang
@sirwang
@mark
@jenaflex
@williamlouis
加上我共7个人,第一批全部为超级版主,享有论坛最高权限。请版主们即时更新置顶帖子,封禁违规发言。我会建立电报群,大家电报中交流。论坛如有变动,移除或者增加新的超级版主,需要有明确理由,集体投票过半。以此公示,感谢大家的支持。
后续论坛如果流量有起色,有足够多的用户,会在具体板块招募版主,敬请关注!
版主特权:不影响网站整体内容的情况下,可以合理推广自己的相关业务。签名档已经开放给版主,大家可以放上自己的频道链接。如需在特定板块置顶自己的商务帖子,请在工作群提出申请,提出后24小时内,超级版主无过半人数反对,视作通过。每月一次,期限一周。站长有否决权,但需要阐述合理原因。超级版主可以在任意板块发布推广,但请大家珍惜权利,不要滥用,因为后期站长会为超级版主开发专门的推广页面,如有简单个人主页制定需求,站长亦可代劳,可以提供免费二级域名,或者由版主提供独立域名。
超级版主如有需求增加独立板块,可以向站长申请。站长的目标就是做好这个论坛,为用户解答AI相关的疑问,提供AI相关的资讯,与大家一起通过AI赚钱,不偏离这个大方向皆可。