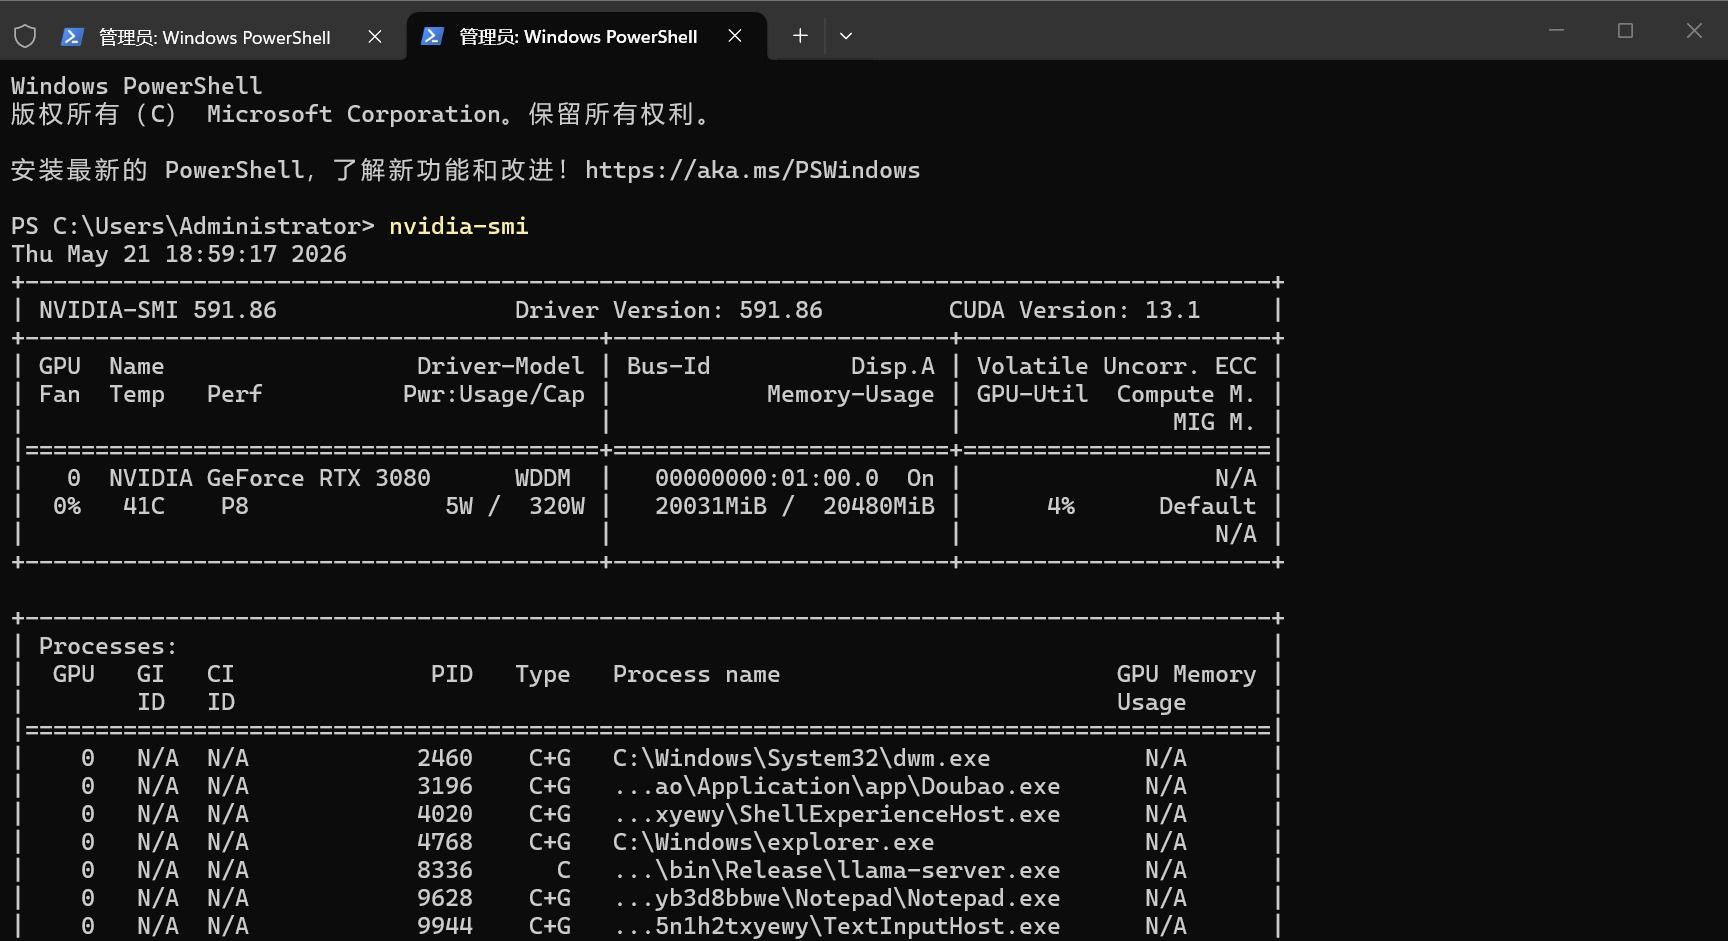
记录一下自己RTX3080 20g的一些配置
WIN11安装:
git clone https://github.com/ggerganov/llama.cpp
cmake -B build -D GGML_CUDA=ON -D CMAKE_CUDA_ARCHITECTURES=86 -D LLAMA_BUILD_SERVER=ON -D LLAMA_BUILD_ALL_EXAMPLES=OFF -D LLAMA_BUILD_TESTS=OFF -D LLAMA_BUILD_EXAMPLES=OFF
cmake --build build --config Release --parallel 2
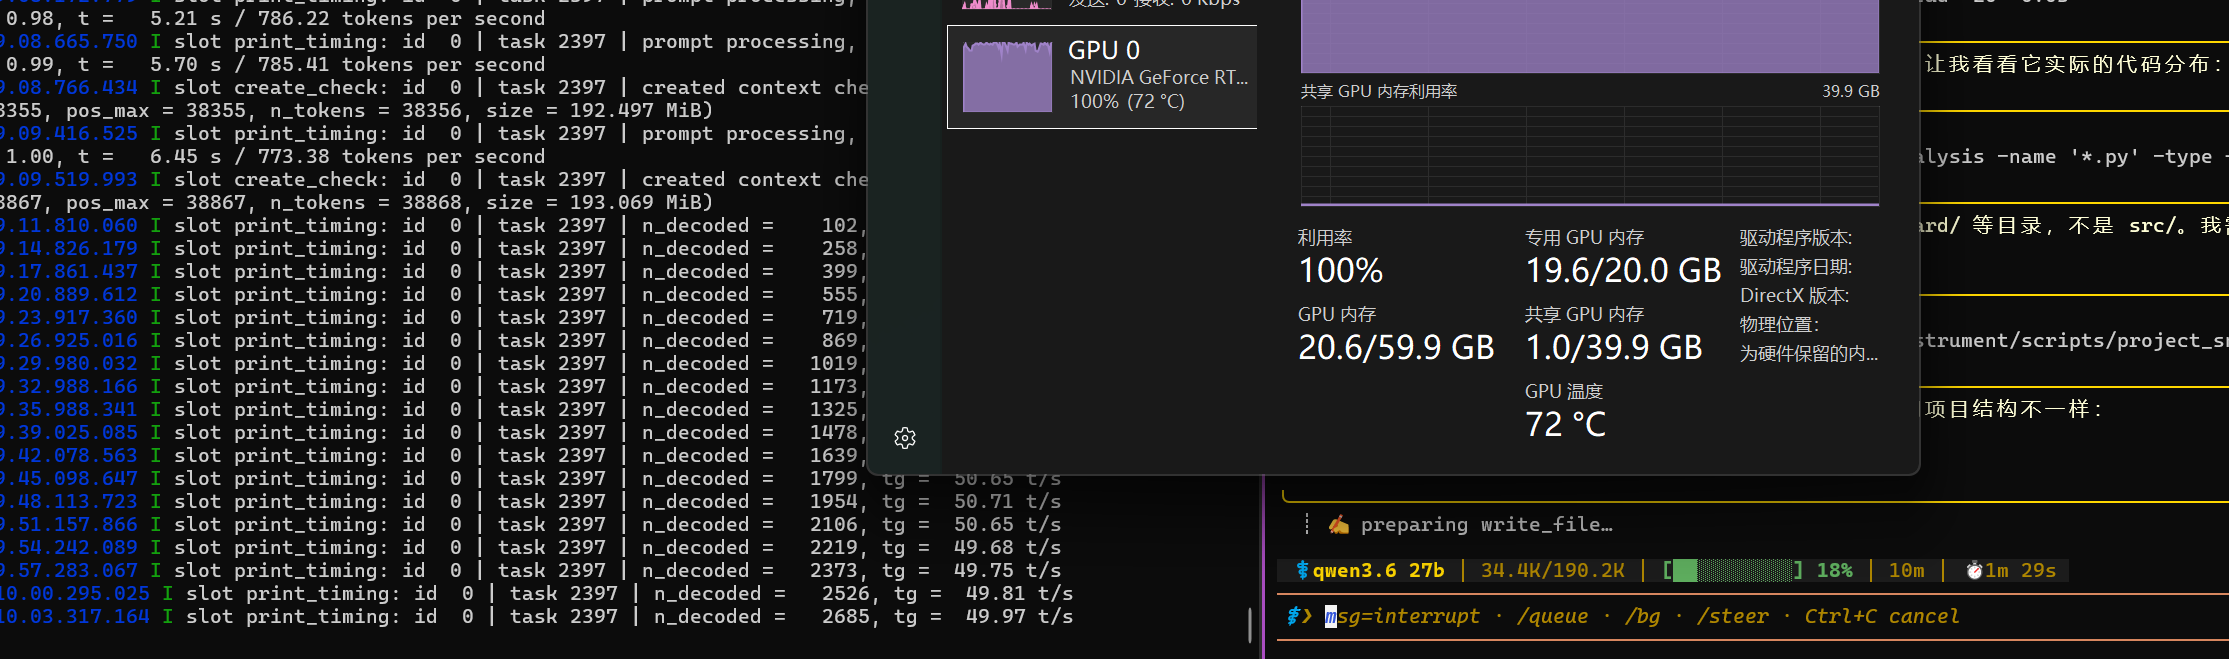
启用集成显卡很有帮助,可以设置更大的上下文长度,
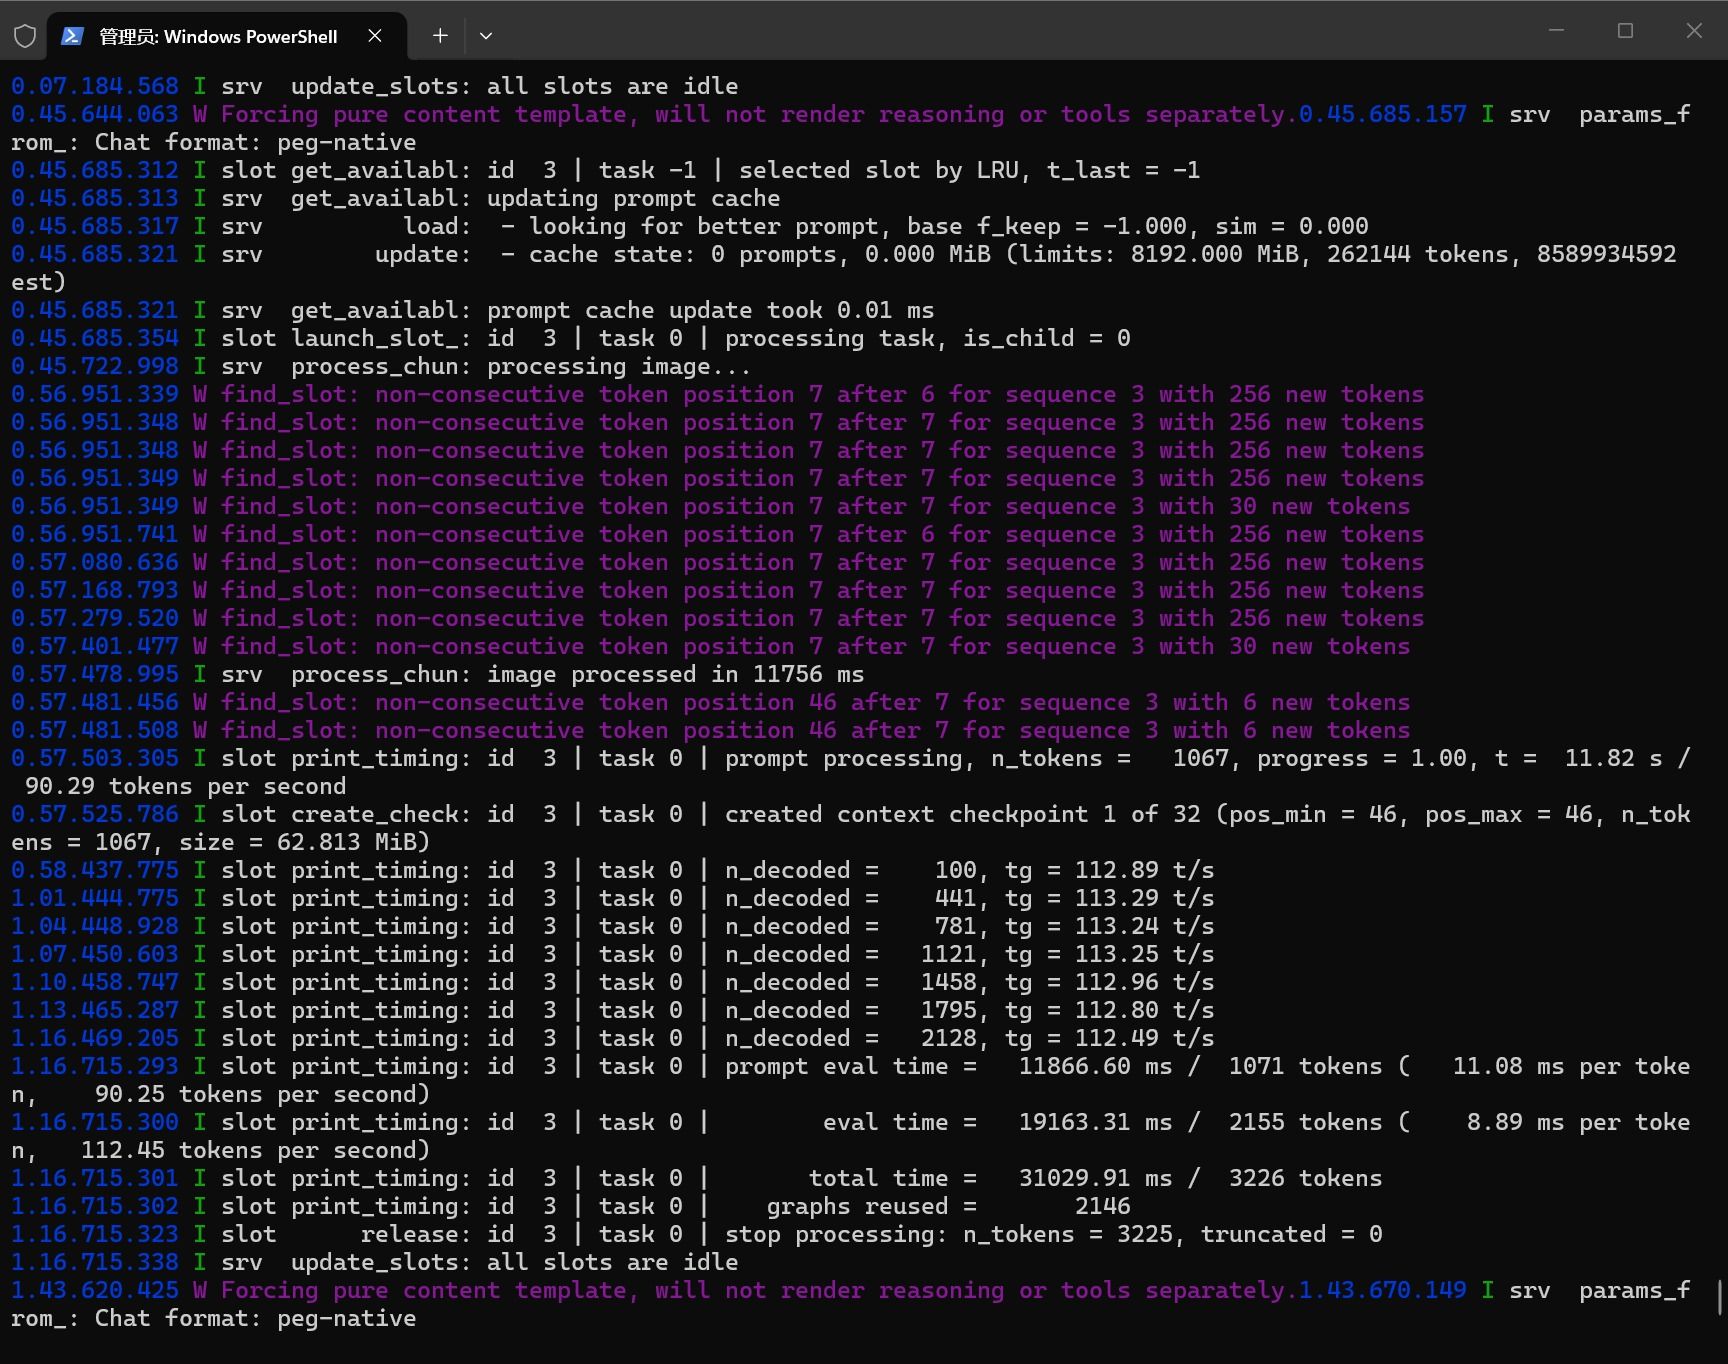
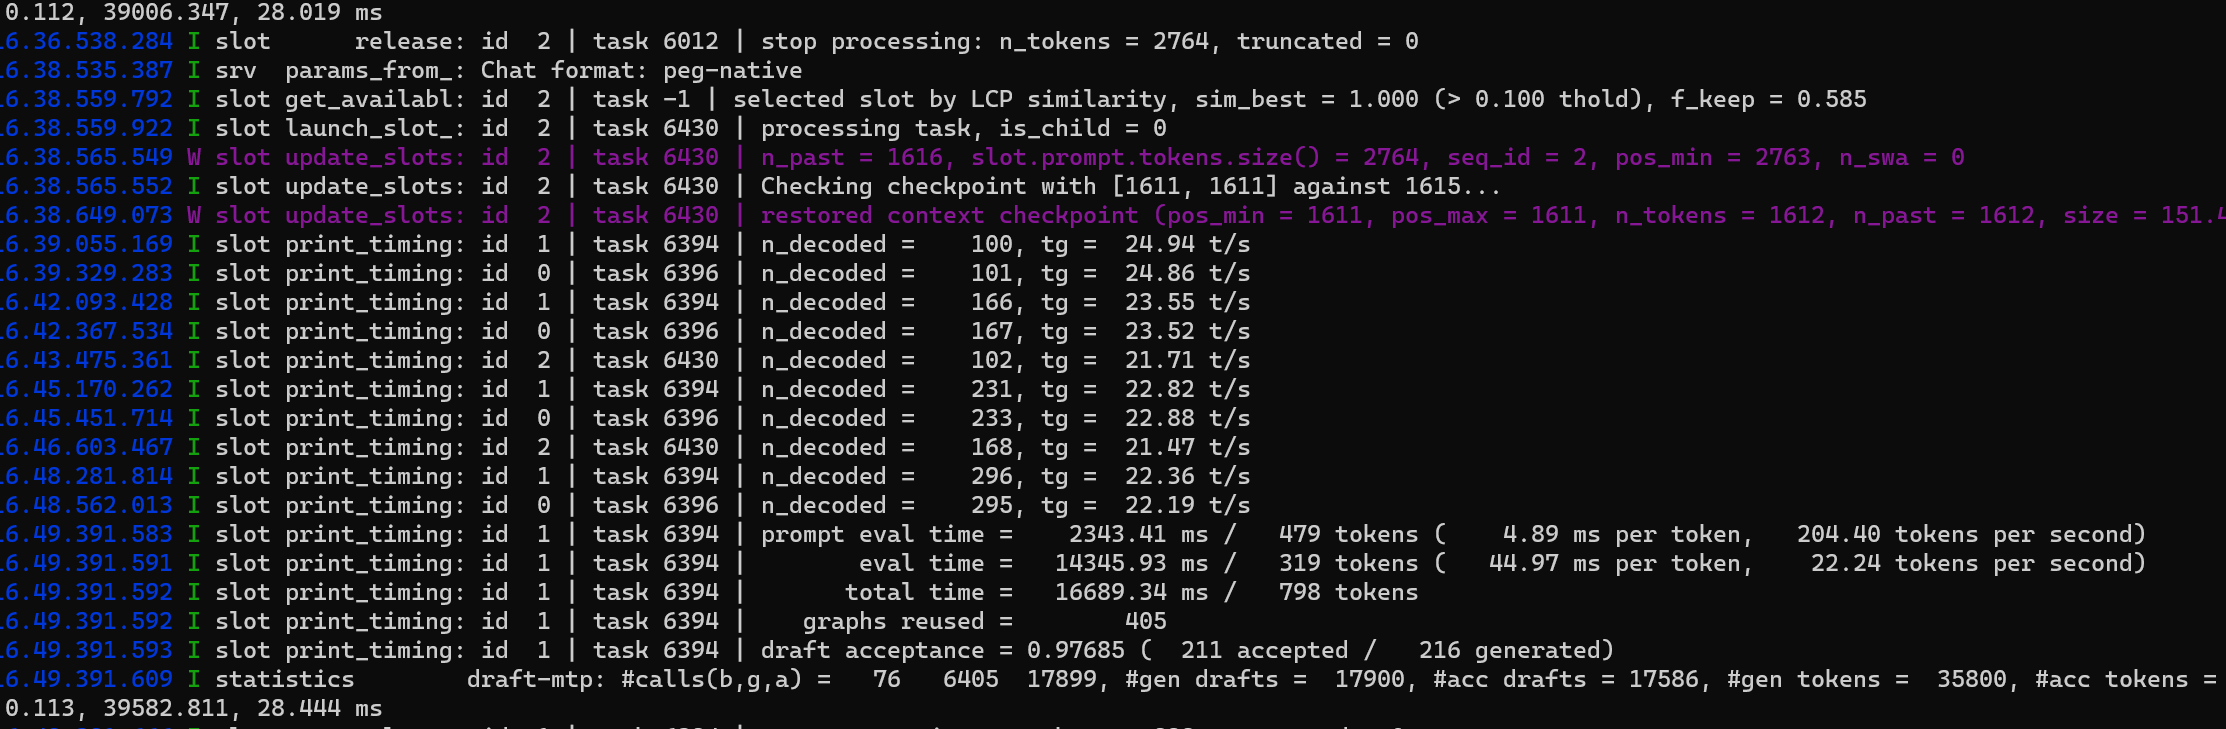
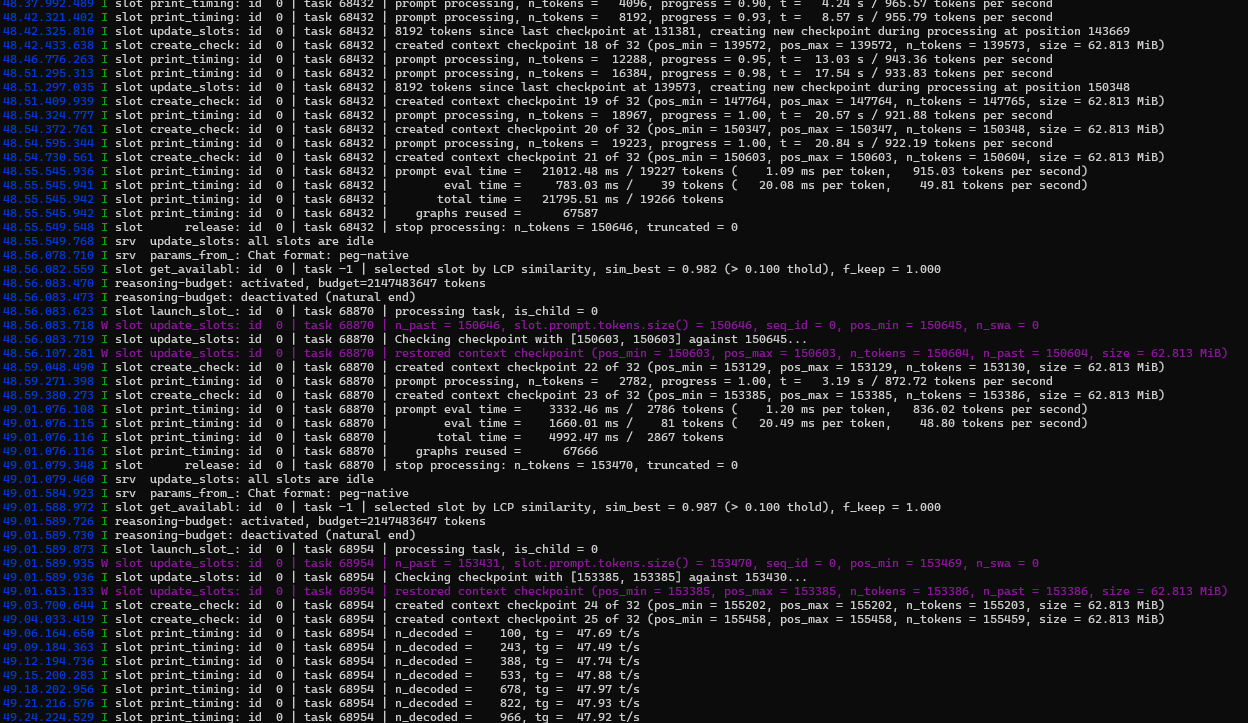
初始40+T/S PREFILL1200 T/S,使用DEEPSEEK HARNESS,到压缩上下文之前还能有35T/S,PREFILL600T/S
实际工作体验中,KV量化使用Q80和Q40精度损失见仁见智吧,我觉得还是可用的,特别是DSH对于模型自身能力有加成,极少出现工具调用失败,死循环等现象,一定程度缓和了3.8雷霆思考的影响,而且THINKINGCAP模型也会一定程度减少思考长度(好像没吹的厉害)
本地爽玩大模型了
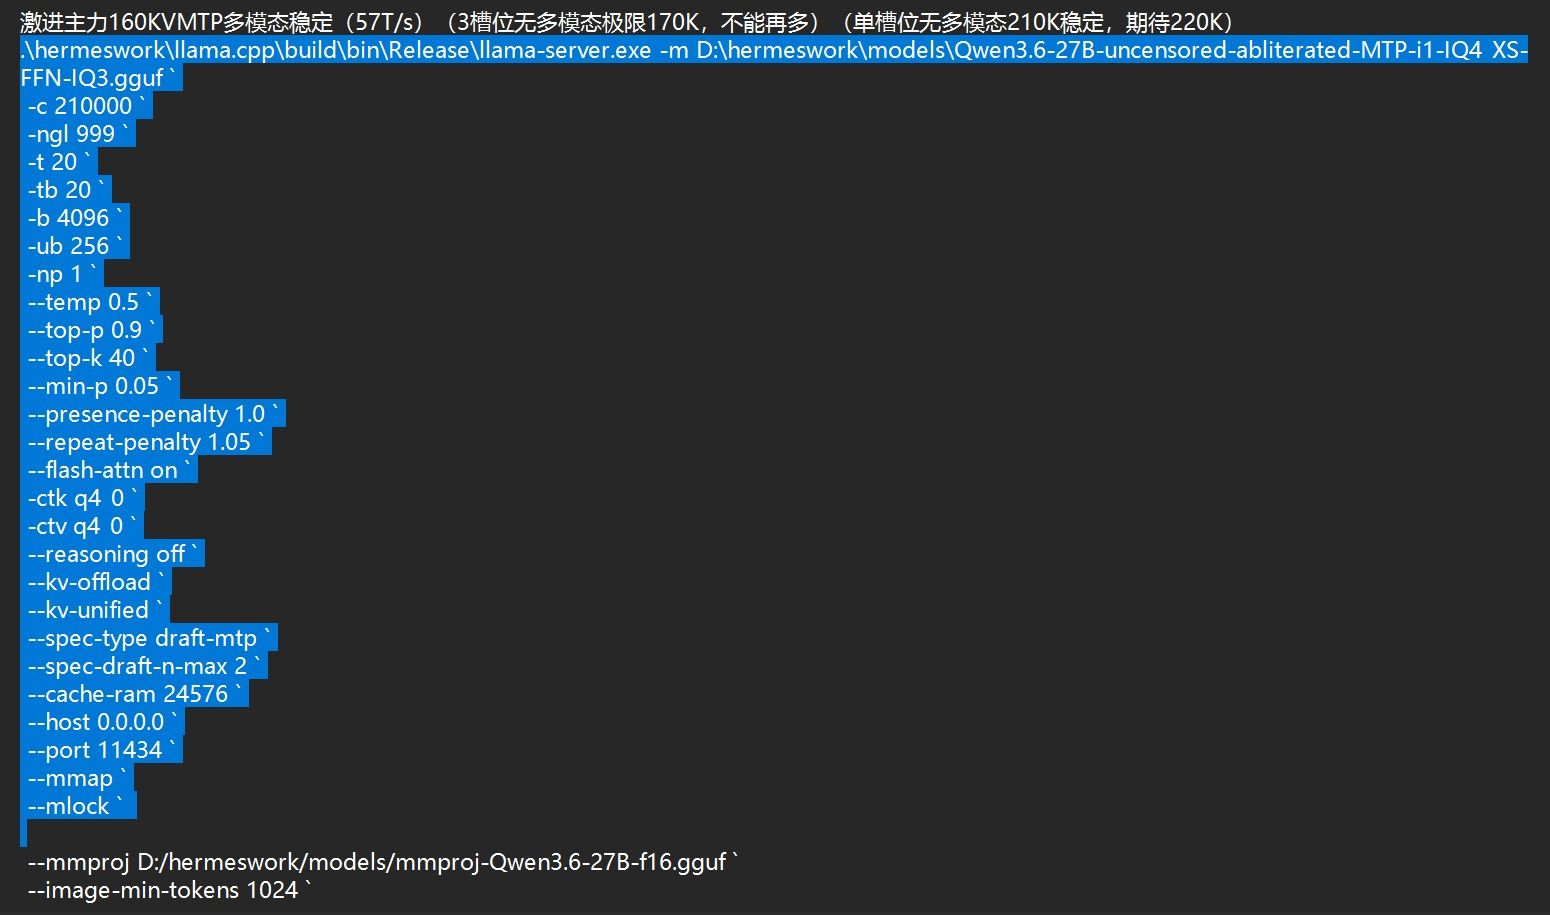
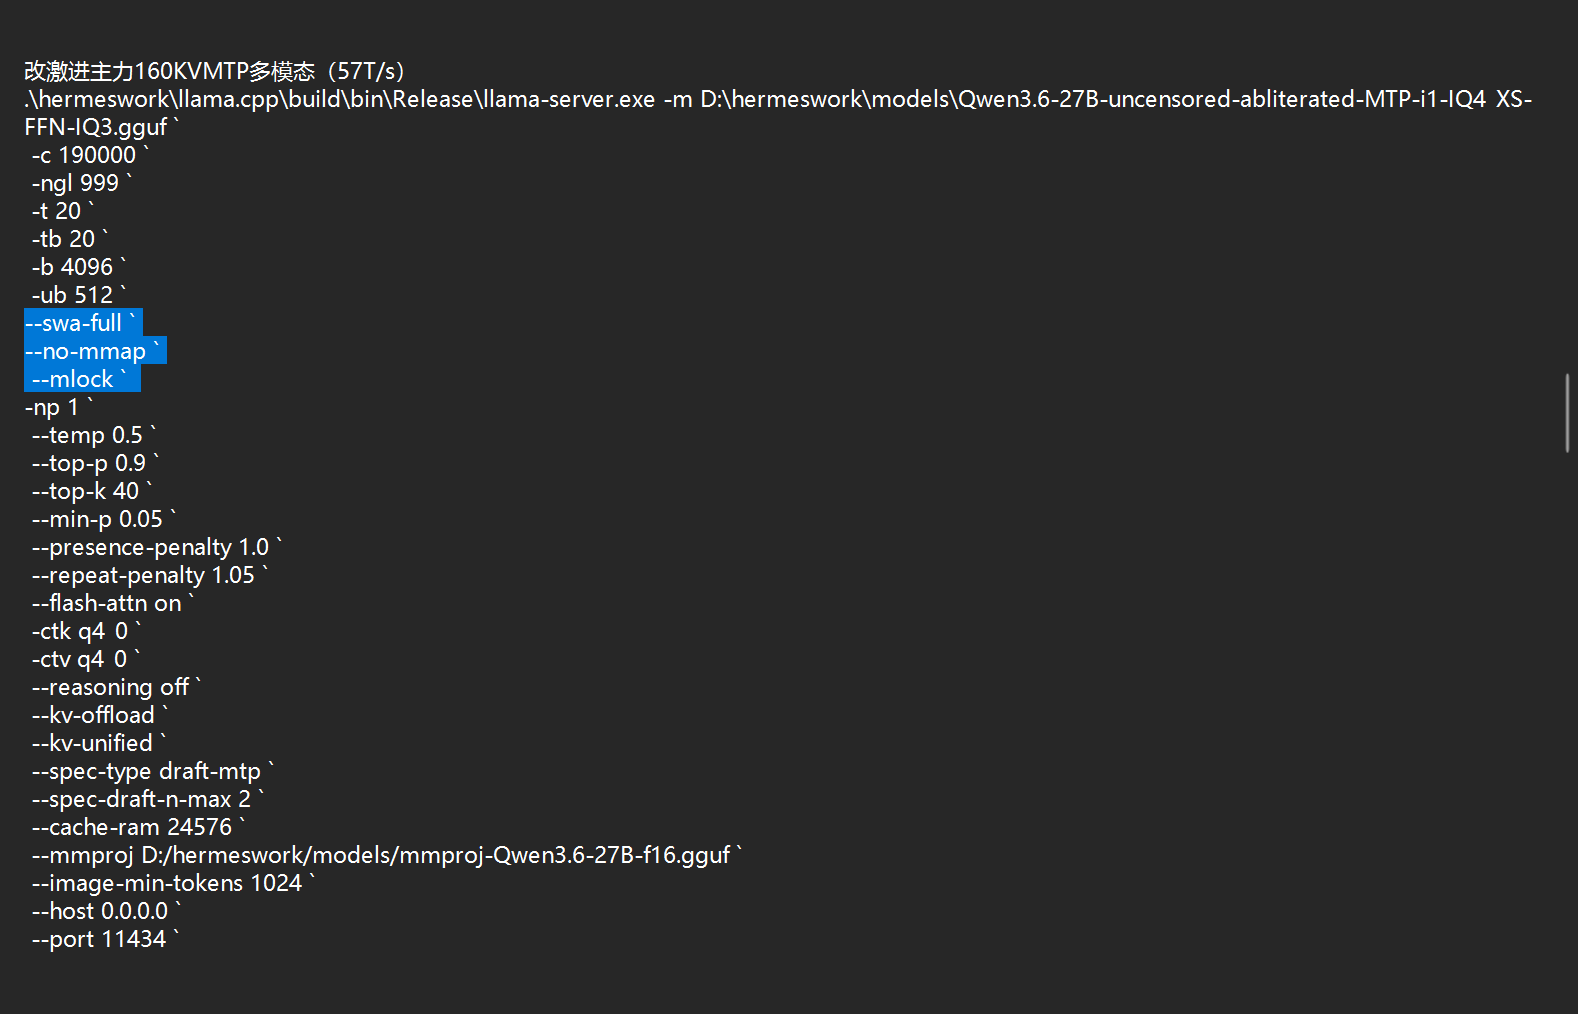
.\hermeswork\llama.cpp\build\bin\Release\llama-server.exe `
 -m D:\hermeswork\models\Qwen3.8-27B-thinkingcap-abliterated.IQ4_XS.gguf `
 -c 160768 `
 -np 1 `
 -ngl 99 `
 -fa on `
 -b 4096 `
 -ub 256 `
 -t 18 `
 -tb 18 `
 --temp 0.5 `
 --top-p 0.9 `
 --top-k 44 `
 --min-p 0.05 `
 --presence-penalty 1.0 `
 --repeat-penalty 1.05 `
 --cache-type-k q4_0 `
 --cache-type-v q4_0 `
 --spec-type draft-mtp,ngram-mod `
 --spec-draft-n-max 2 `
 --spec-ngram-mod-n-match 24 `
 --spec-ngram-mod-n-min 48 `
 --spec-ngram-mod-n-max 64 `
 --load-mode mmap+mlock `
 --host 0.0.0.0 `
 --port 11434 `
 -mm D:\hermeswork\models\mmproj-Qwen3.8-27B-bf16.gguf `
 --no-mmproj-offload `
 --image-min-tokens 1024 `
 --jinja `
 --reasoning-format deepseek `
 -fit off `
 --cache-prompt `
新的LLAMA.CPP支持ngram加速,这个加速还是挺好用的,不会像MTP那样增加显存占用,如果命中,加速效果很恐怖的,时不时给你来个200+TS
真是一张神卡啊