跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 【双 R9700 折腾记】让 Radiance 跑起 MiniMax-H3 Rer2VA

【双 R9700 折腾记】让 Radiance 跑起 MiniMax-H3 Rer2VA

已定时 固定直到 2026/10/28 06:59 已锁定 已移动 精华 AI音视频画图
radiancer9700minimax
44 帖子 7 发布者 480 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Tony WangT
    Tony WangT
    Tony Wang
    易有太极
    编写于 最后由 Tony Wang 编辑
    #27

    响应 @terry 的号召, 测试了一下我的 Pro5000 48G, 功率限制在250W.

    速度比 @bunsei 的单卡还慢. 可能是显存不够? 也可能是我的设置有问题? 具体我还没分析.

    成片效果和 @bunsei 的持平, 肉眼检查无明显差异.

    以下是AI生成

    MiniMax H3 全参考视频生成总报告

    测试日期: 2026-10-26(北京时间)
    任务: 使用同一组素材完成 MiniMax H3 Ref2VA 全参考视频生成;分别测试 1344×768 与 832×480。

    总结

    • 两个分辨率的成功生成时间合计:1,500.563 秒(25 分 0.563 秒)。这是两次 ComfyUI execution_start → execution_success 的时长相加,不含输入准备、传输和最终音轨封装。
    • 两轮均生成成功,均使用 226 帧生成结果;交付时取前 220 帧,约 9.167 秒,并复用原始 AAC 音轨。
    • 832×480 本轮耗时 274.026 秒(4 分 34.026 秒),比 1344×768 本轮的 1,226.537 秒短约 77.66%,约快 4.48 倍。每个分辨率只测试一次,结果仅作本次实测对照,不是统计基准。
    • 测试结束后 ComfyUI 已停止,SGLang nvfp4 已恢复,并验证健康检查、模型列表及实际问答正常。

    两轮结果

    分辨率 ComfyUI 执行时间 请求接受至完成 显存 / 设备状态 交付视频
    1344×768 1,226.537 秒(20 分 26.537 秒) 1,226.863 秒 执行中采样快照:47,800 / 48,935 MiB(97.68%),GPU 100%、81°C。此轮没有连续采集,不是可确认的峰值。 H.264,24 fps,220 帧,约 9.167 秒
    832×480 274.026 秒(4 分 34.026 秒) 274.523 秒 约每秒采样;峰值 45,224 / 48,935 MiB(92.42%),GPU 利用率平均 96.06%、峰值 100%,温度峰值 81°C。 H.264,24 fps,220 帧,约 9.167 秒

    计时口径

    • ComfyUI 执行时间包括参考素材预处理、模型加载、采样、解码和输出保存;不包括此前的素材准备/传输及最后的音轨 remux。
    • 832×480 监控窗口共 263 个样本:GPU 功耗平均 244.56 W、采样峰值 258.59 W;主机 CPU 利用率峰值 45.6%,系统可用内存最低 110,155 / 123,614 MiB。约 1 秒间隔采样可能漏掉更短的瞬时峰值。

    共同生成配置

    • 模型:MiniMax H3 Ref2VA int8_convrot;文本编码器 Qwen3-VL 32B MiniMax H3 NVFP4 AWQ。
    • 条件输入:5 张参考图、动作参考视频、音频参考。
    • 两轮均为 24 fps、226 帧、seed 42、8 steps、CFG 1、res_multistep / simple,使用 8-step Turbo LoRA。
    • 两轮主要测试变量为输出分辨率;832×480 使用 target_megapixels=0.39936,日志确认预处理输出为 832×480、226 帧、24 fps。
    • 两轮的 12 帧抽样检查均可见大致相同的时序:夜间公交站空镜、女性入镜并坐下、黄色角色加入并围聚、多人互动、站台群像。此项是抽帧核验,不代表逐帧动作完全复刻。

    过程异常与修正

    1344×768 首次任务运行约 719.211 秒后被主动中断:预处理把 220 帧参考视频裁成 209 帧,丢失尾部 11 帧。随后将参考视频末帧保持补至 226 帧,重新提交并成功完成。该中断任务不计入上述两次成功执行时间合计。

    与论坛测试数据的边界

    虽然 832×480 与论坛测试分辨率一致,但论坛数据使用不同硬件、工作流和步数/LoRA 配置,且报告的是采样耗时;本报告记录的是 ComfyUI 全流程执行耗时。因此不能把两者当作同条件性能排名。

    成片与记录文件

    1344×768

    • 成片:lcz2582_comfyui_1344x768_9.17s.mp4
    • 抽帧图:contact_sheet.png
    • 结构化数据:result.json
    • 说明:report.md

    832×480

    • 成片:../lcz-h3-20261026-832x480/lcz2582_comfyui_832x480_9.17s.mp4
    • 抽帧图:../lcz-h3-20261026-832x480/contact_sheet.png
    • 原始 GPU 采样:../lcz-h3-20261026-832x480/gpu_metrics.jsonl
    • 结构化数据:../lcz-h3-20261026-832x480/result.json
    • 说明:../lcz-h3-20261026-832x480/report.md

    服务恢复

    ComfyUI 已停止;SGLang nvfp4 已恢复。验证结果:/health HTTP 200,模型 qwen3.8-27b-nvfp4 可用,实际问答返回 4。

    BunseiB 1 条回复 最后回复
    1
    • Tony WangT Tony Wang

      响应 @terry 的号召, 测试了一下我的 Pro5000 48G, 功率限制在250W.

      速度比 @bunsei 的单卡还慢. 可能是显存不够? 也可能是我的设置有问题? 具体我还没分析.

      成片效果和 @bunsei 的持平, 肉眼检查无明显差异.

      以下是AI生成

      MiniMax H3 全参考视频生成总报告

      测试日期: 2026-10-26(北京时间)
      任务: 使用同一组素材完成 MiniMax H3 Ref2VA 全参考视频生成;分别测试 1344×768 与 832×480。

      总结

      • 两个分辨率的成功生成时间合计:1,500.563 秒(25 分 0.563 秒)。这是两次 ComfyUI execution_start → execution_success 的时长相加,不含输入准备、传输和最终音轨封装。
      • 两轮均生成成功,均使用 226 帧生成结果;交付时取前 220 帧,约 9.167 秒,并复用原始 AAC 音轨。
      • 832×480 本轮耗时 274.026 秒(4 分 34.026 秒),比 1344×768 本轮的 1,226.537 秒短约 77.66%,约快 4.48 倍。每个分辨率只测试一次,结果仅作本次实测对照,不是统计基准。
      • 测试结束后 ComfyUI 已停止,SGLang nvfp4 已恢复,并验证健康检查、模型列表及实际问答正常。

      两轮结果

      分辨率 ComfyUI 执行时间 请求接受至完成 显存 / 设备状态 交付视频
      1344×768 1,226.537 秒(20 分 26.537 秒) 1,226.863 秒 执行中采样快照:47,800 / 48,935 MiB(97.68%),GPU 100%、81°C。此轮没有连续采集,不是可确认的峰值。 H.264,24 fps,220 帧,约 9.167 秒
      832×480 274.026 秒(4 分 34.026 秒) 274.523 秒 约每秒采样;峰值 45,224 / 48,935 MiB(92.42%),GPU 利用率平均 96.06%、峰值 100%,温度峰值 81°C。 H.264,24 fps,220 帧,约 9.167 秒

      计时口径

      • ComfyUI 执行时间包括参考素材预处理、模型加载、采样、解码和输出保存;不包括此前的素材准备/传输及最后的音轨 remux。
      • 832×480 监控窗口共 263 个样本:GPU 功耗平均 244.56 W、采样峰值 258.59 W;主机 CPU 利用率峰值 45.6%,系统可用内存最低 110,155 / 123,614 MiB。约 1 秒间隔采样可能漏掉更短的瞬时峰值。

      共同生成配置

      • 模型:MiniMax H3 Ref2VA int8_convrot;文本编码器 Qwen3-VL 32B MiniMax H3 NVFP4 AWQ。
      • 条件输入:5 张参考图、动作参考视频、音频参考。
      • 两轮均为 24 fps、226 帧、seed 42、8 steps、CFG 1、res_multistep / simple,使用 8-step Turbo LoRA。
      • 两轮主要测试变量为输出分辨率;832×480 使用 target_megapixels=0.39936,日志确认预处理输出为 832×480、226 帧、24 fps。
      • 两轮的 12 帧抽样检查均可见大致相同的时序:夜间公交站空镜、女性入镜并坐下、黄色角色加入并围聚、多人互动、站台群像。此项是抽帧核验,不代表逐帧动作完全复刻。

      过程异常与修正

      1344×768 首次任务运行约 719.211 秒后被主动中断:预处理把 220 帧参考视频裁成 209 帧,丢失尾部 11 帧。随后将参考视频末帧保持补至 226 帧,重新提交并成功完成。该中断任务不计入上述两次成功执行时间合计。

      与论坛测试数据的边界

      虽然 832×480 与论坛测试分辨率一致,但论坛数据使用不同硬件、工作流和步数/LoRA 配置,且报告的是采样耗时;本报告记录的是 ComfyUI 全流程执行耗时。因此不能把两者当作同条件性能排名。

      成片与记录文件

      1344×768

      • 成片:lcz2582_comfyui_1344x768_9.17s.mp4
      • 抽帧图:contact_sheet.png
      • 结构化数据:result.json
      • 说明:report.md

      832×480

      • 成片:../lcz-h3-20261026-832x480/lcz2582_comfyui_832x480_9.17s.mp4
      • 抽帧图:../lcz-h3-20261026-832x480/contact_sheet.png
      • 原始 GPU 采样:../lcz-h3-20261026-832x480/gpu_metrics.jsonl
      • 结构化数据:../lcz-h3-20261026-832x480/result.json
      • 说明:../lcz-h3-20261026-832x480/report.md

      服务恢复

      ComfyUI 已停止;SGLang nvfp4 已恢复。验证结果:/health HTTP 200,模型 qwen3.8-27b-nvfp4 可用,实际问答返回 4。

      BunseiB
      BunseiB
      Bunsei
      王侯将相
      编写于 最后由 Bunsei 编辑
      #28

      @Tony-Wang 看起来像是显存不足导致的 ? 也不对,怎么能比单卡还慢。 我明白了,我的第一个那个测试是一张参考图 + 参考视频的。 素材里的是第二个测试的。😌

      Tony WangT 1 条回复 最后回复
      0
      • BunseiB Bunsei

        @Tony-Wang 看起来像是显存不足导致的 ? 也不对,怎么能比单卡还慢。 我明白了,我的第一个那个测试是一张参考图 + 参考视频的。 素材里的是第二个测试的。😌

        Tony WangT
        Tony WangT
        Tony Wang
        易有太极
        编写于 最后由 编辑
        #29

        @Bunsei 说:

        @Tony-Wang 看起来像是显存不足导致的 😕 ? 也不对,怎么能比单卡还慢。 我明白了,我的第一个那个测试是一张参考图 + 参考视频的。

        我这包含了预处理, VAE, 不单是 Ksampler 的采样时间. 可能是这个原因. 我现在让它重跑一次, 分开记录时间.

        BunseiB 1 条回复 最后回复
        0
        • BunseiB Bunsei

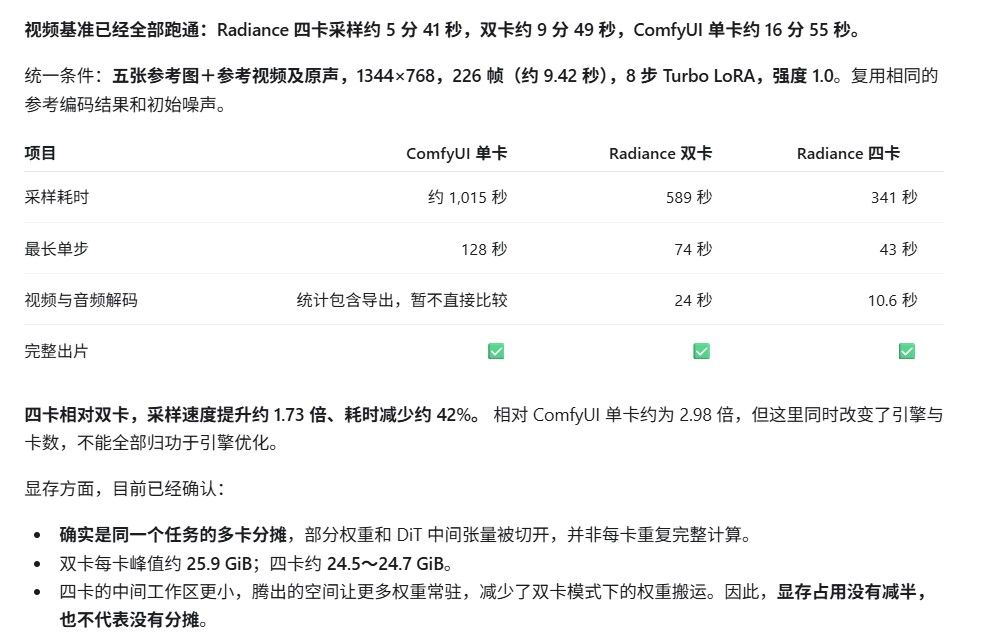
          第一轮测试已经出来了,可以见GPT的回复,接下来我再让GPT把这部分调度策略调整一下,主 DiT 权重尽量留在显存,其他模块和暂时不用的数据放主机内存,把腾出的显存留给当前生成任务。 然后再优化一下预处理时候的速度😁

          image.jpeg

          Tony WangT
          Tony WangT
          Tony Wang
          易有太极
          编写于 最后由 编辑
          #30

          @Bunsei 说:

          第一轮测试已经出来了,可以见GPT的回复,接下来我再让GPT把这部分调度策略调整一下,主 DiT 权重尽量留在显存,其他模块和暂时不用的数据放主机内存,把腾出的显存留给当前生成任务。 然后再优化一下预处理时候的速度😁

          image.jpeg

          我是按照你这张图来比较的.

          BunseiB 1 条回复 最后回复
          1
          • Tony WangT Tony Wang

            @Bunsei 说:

            @Tony-Wang 看起来像是显存不足导致的 😕 ? 也不对,怎么能比单卡还慢。 我明白了,我的第一个那个测试是一张参考图 + 参考视频的。

            我这包含了预处理, VAE, 不单是 Ksampler 的采样时间. 可能是这个原因. 我现在让它重跑一次, 分开记录时间.

            BunseiB
            BunseiB
            Bunsei
            王侯将相
            编写于 最后由 编辑
            #31

            @Tony-Wang 说:

            @Bunsei 说:

            @Tony-Wang 看起来像是显存不足导致的 😕 ? 也不对,怎么能比单卡还慢。 我明白了,我的第一个那个测试是一张参考图 + 参考视频的。

            我这包含了预处理, VAE, 不单是 Ksampler 的采样时间. 可能是这个原因. 我现在让它重跑一次, 分开记录时间.

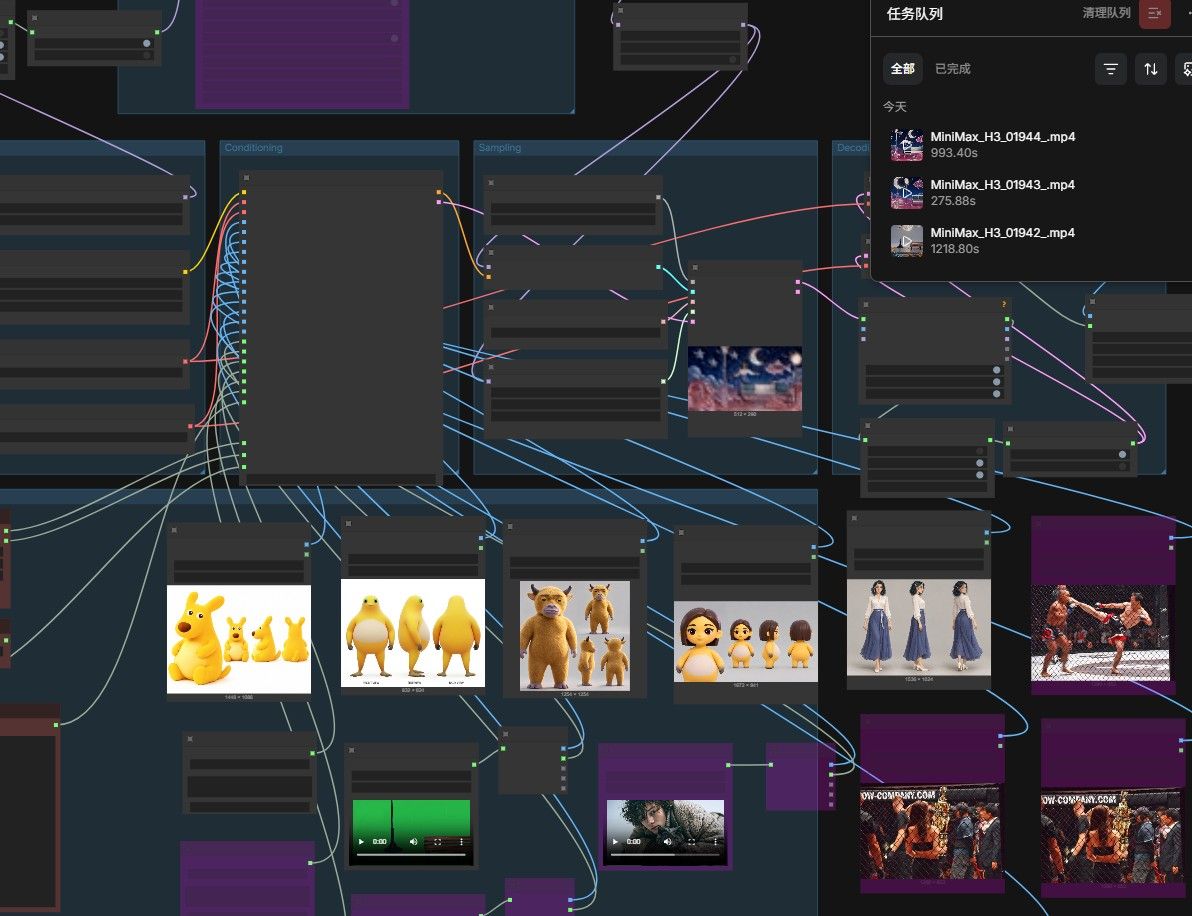
            我的这两个也是,但是差别是第一个1张人物图一个参考视频、背景和后面四个人都是提示词生成的,而第二个则是5张参考图+ 参考视频。

            1 条回复 最后回复
            1
            • imbiplaza ASUSI
              imbiplaza ASUSI
              imbiplaza ASUS
              谪仙人
              编写于 最后由 编辑
              #32

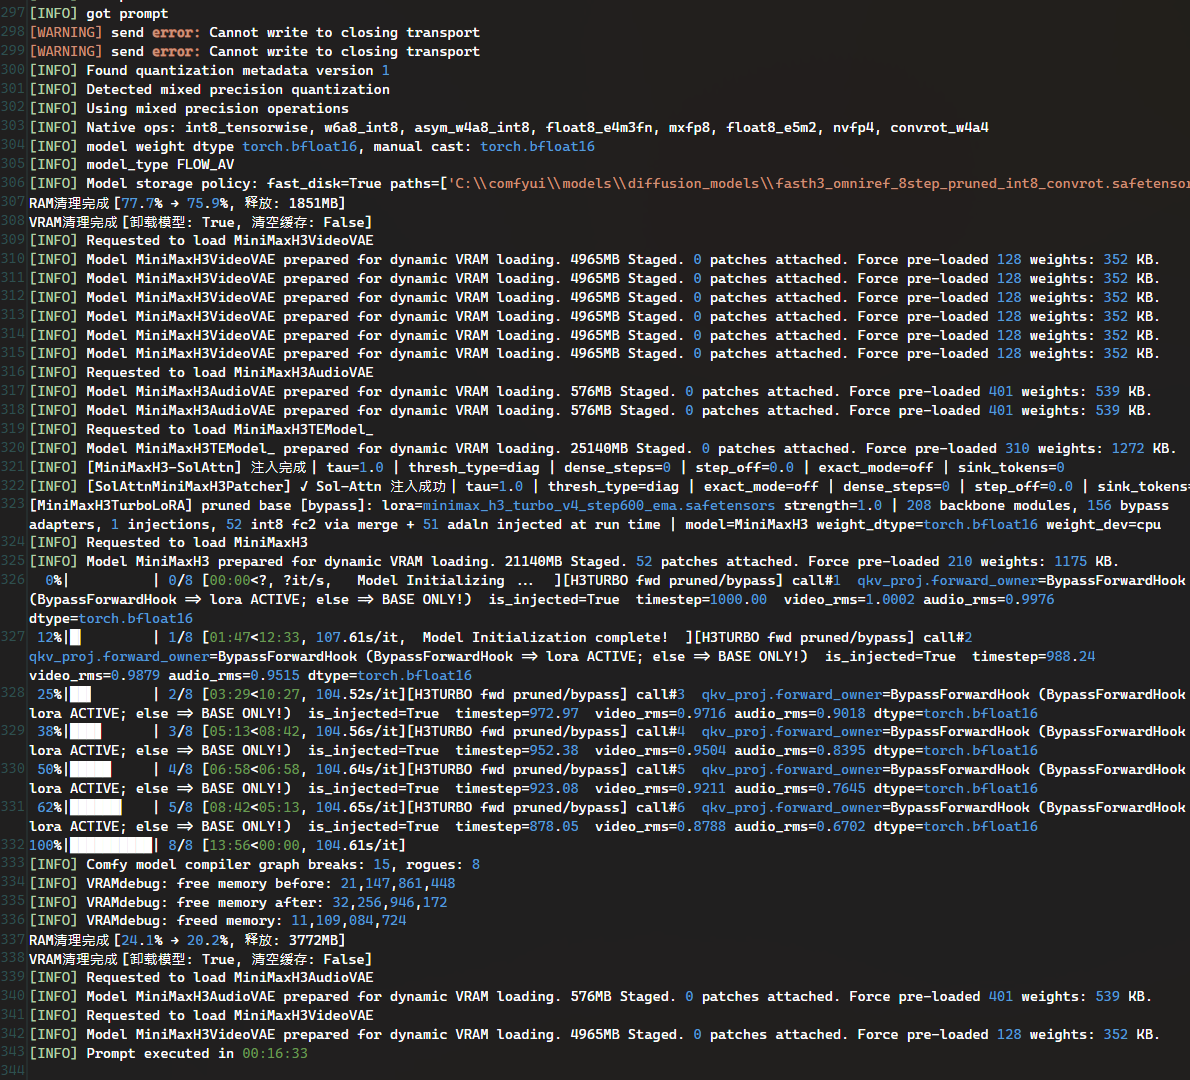
              image.jpeg

              Screenshot 2026-10-26 210141.png

              0.50m
              rtxpro 4500 32g
              16:33

              BunseiB 1 条回复 最后回复
              1
              • Tony WangT Tony Wang

                @Bunsei 说:

                第一轮测试已经出来了,可以见GPT的回复,接下来我再让GPT把这部分调度策略调整一下,主 DiT 权重尽量留在显存,其他模块和暂时不用的数据放主机内存,把腾出的显存留给当前生成任务。 然后再优化一下预处理时候的速度😁

                image.jpeg

                我是按照你这张图来比较的.

                BunseiB
                BunseiB
                Bunsei
                王侯将相
                编写于 最后由 Bunsei 编辑
                #33

                @Tony-Wang 说:

                @Bunsei 说:

                第一轮测试已经出来了,可以见GPT的回复,接下来我再让GPT把这部分调度策略调整一下,主 DiT 权重尽量留在显存,其他模块和暂时不用的数据放主机内存,把腾出的显存留给当前生成任务。 然后再优化一下预处理时候的速度😁

                image.jpeg

                我是按照你这张图来比较的.

                租的服务器是八通道的DDR4内存... 如果超出显存的话速度优势很大,感觉是这里的原因。

                1 条回复 最后回复
                1
                • imbiplaza ASUSI imbiplaza ASUS

                  image.jpeg

                  Screenshot 2026-10-26 210141.png

                  0.50m
                  rtxpro 4500 32g
                  16:33

                  BunseiB
                  BunseiB
                  Bunsei
                  王侯将相
                  编写于 最后由 编辑
                  #34

                  @imbiplaza-ASUS 单卡比较感觉像是内存通道上占了便宜。

                  imbiplaza ASUSI 1 条回复 最后回复
                  0
                  • BunseiB Bunsei

                    @imbiplaza-ASUS 单卡比较感觉像是内存通道上占了便宜。

                    imbiplaza ASUSI
                    imbiplaza ASUSI
                    imbiplaza ASUS
                    谪仙人
                    编写于 最后由 编辑
                    #35

                    @Bunsei

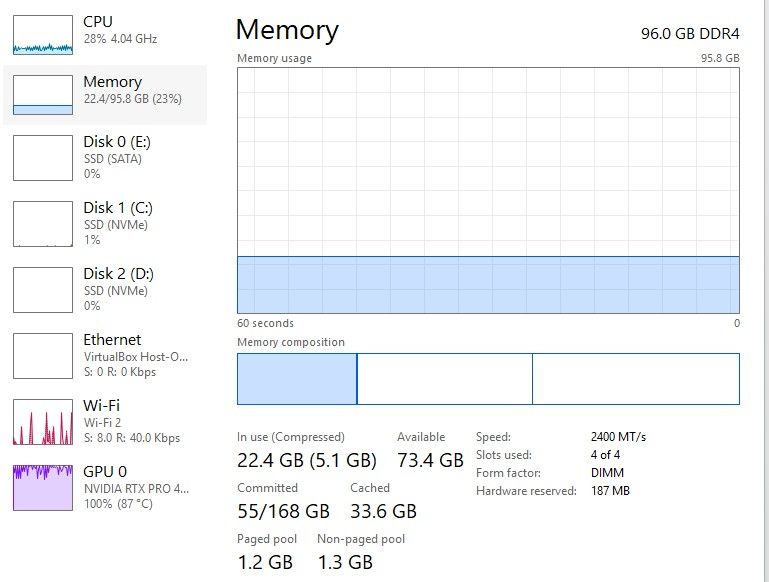
                    今天update bios, 变成ddr4 2400

                    等下调整ddr4 3200 看看

                    image.jpeg

                    1 条回复 最后回复
                    1
                    • imbiplaza ASUSI
                      imbiplaza ASUSI
                      imbiplaza ASUS
                      谪仙人
                      编写于 最后由 编辑
                      #36

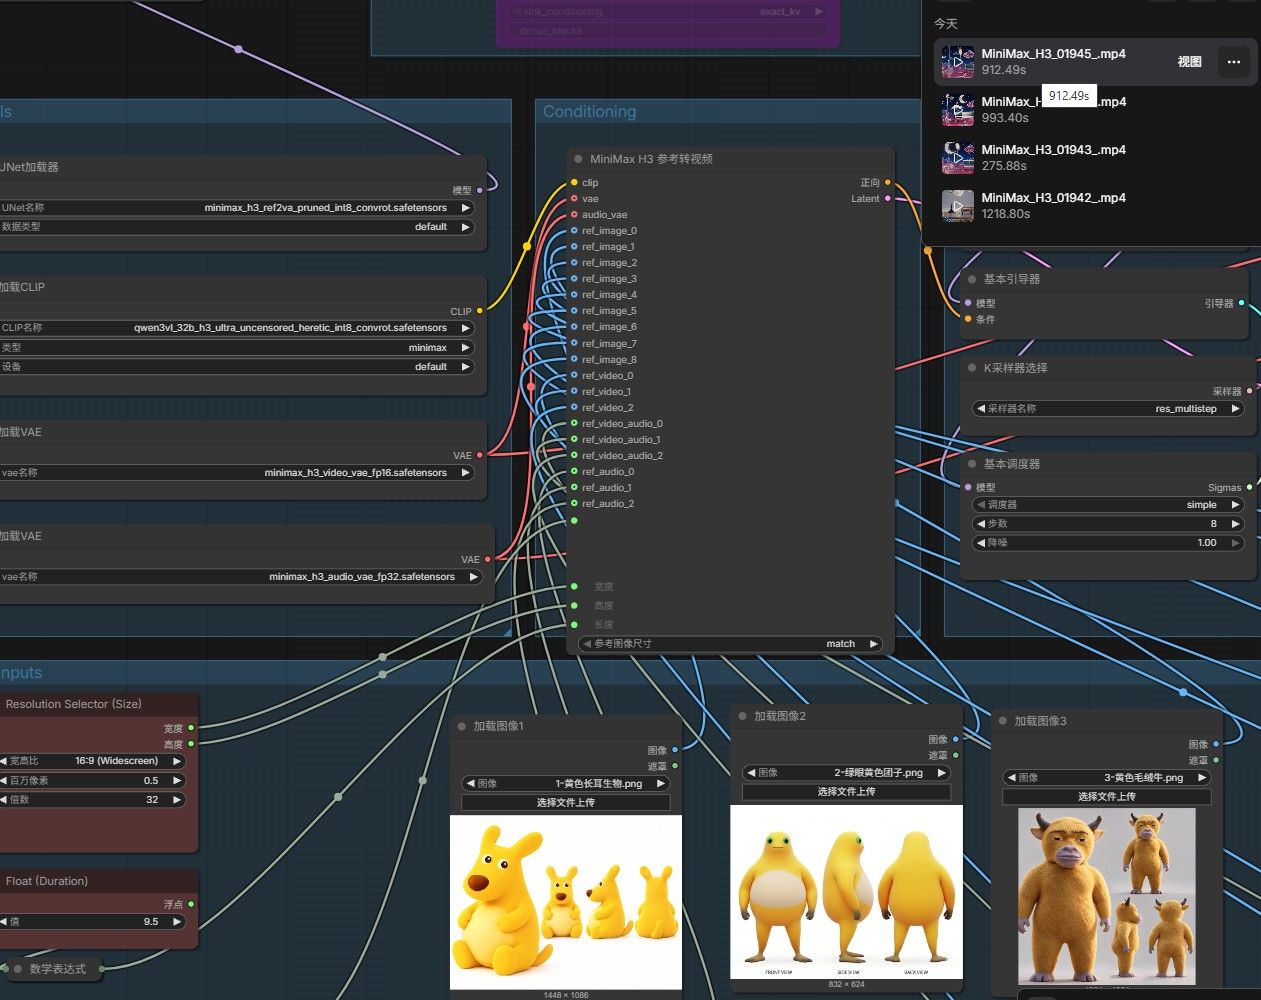
                      第二次执行变成

                      image.jpeg

                      之前
                      0.5m
                      rtxpro 4500 32g
                      ddr4 2400mt
                      16:33
                      fasth3_omniref_8step_pruned_int8_convrot.safetensors

                      现在
                      0.5m
                      rtxpro 4500 32g
                      ddr4 2400mt
                      15:12
                      minimax_h3_ref2va_pruned_int8_convrot.safetensors

                      BunseiB 1 条回复 最后回复
                      1
                      • imbiplaza ASUSI imbiplaza ASUS

                        第二次执行变成

                        image.jpeg

                        之前
                        0.5m
                        rtxpro 4500 32g
                        ddr4 2400mt
                        16:33
                        fasth3_omniref_8step_pruned_int8_convrot.safetensors

                        现在
                        0.5m
                        rtxpro 4500 32g
                        ddr4 2400mt
                        15:12
                        minimax_h3_ref2va_pruned_int8_convrot.safetensors

                        BunseiB
                        BunseiB
                        Bunsei
                        王侯将相
                        编写于 最后由 编辑
                        #37

                        @imbiplaza-ASUS LORA还有影响? 这我去试试看

                        imbiplaza ASUSI 1 条回复 最后回复
                        1
                        • BunseiB Bunsei

                          @imbiplaza-ASUS LORA还有影响? 这我去试试看

                          imbiplaza ASUSI
                          imbiplaza ASUSI
                          imbiplaza ASUS
                          谪仙人
                          编写于 最后由 imbiplaza ASUS 编辑
                          #38

                          @Bunsei

                          我也不懂,但是这几天大家都说omi 这个模型很神。。。
                          但是我用起来更慢了,可能我原本得优化就是已经尽头了

                          https://huggingface.co/FastVideo/FastH3-Omni-Comfy

                          terryT 1 条回复 最后回复
                          1
                          • Tony WangT
                            Tony WangT
                            Tony Wang
                            易有太极
                            编写于 最后由 编辑
                            #39

                            不行, 还是跑不过楼主的 单卡, 如下是AI总结:

                            1344×768 按 KSampler 日志口径复测

                            测试日期: 2026-10-26(北京时间)
                            ComfyUI prompt ID: a1f3a589-9412-44d4-b88e-769f1bbde739

                            结果

                            • ComfyUI 全流程:1,224.673 秒(20 分 24.673 秒),21:19:34.218 → 21:39:58.891。
                            • ComfyUI 日志中 KSampler 进度条:18 分 36 秒(1,116 秒),8/8,平均 139.60 秒/步。
                            • 逐步时间由 WebSocket progress 事件记录。第 1 个间隔从 KSampler 节点进入到第一次观察到步数增加,包含节点初始化/预热;之后各步以相邻进度变化的时间差计算。
                            步 用时 说明
                            1 142.620 秒 含 KSampler 初始化/预热,不宜视作纯去噪步
                            2 134.094 秒
                            3 139.671 秒
                            4 140.065 秒 第 1 步之后的最长单步
                            5 139.093 秒
                            6 139.546 秒
                            7 139.567 秒
                            8 139.513 秒

                            因此,若按包括首步初始化的观测区间,最长为第 1 步 142.620 秒;若排除首步初始化影响,最长是第 4 步 140.065 秒。

                            与截图中的 ComfyUI 单卡数据对照

                            截图列出采样约 1,015 秒、最长单步 128 秒。按本次 ComfyUI 日志的 KSampler 进度条 1,116 秒比较,本次多 101 秒;排除首步初始化后,最长步 140.065 秒,比截图多约 12.065 秒。这组数据表明截图中的这次结果更快一些,但硬件、计时边界仍未被证明完全相同,宜作近似对照,不宜视为严格同机基准。

                            本次完整执行比采样进度条多出全流程其他阶段。进度条最终日志到 ComfyUI prompt 成功之间约 18.630 秒,但这段还包括后续节点和保存,不能单独称为视频/音频解码时间;现存日志没有将解码与导出独立拆开。

                            成片与记录

                            • 成片:lcz2582_comfyui_1344x768_sampler_9.17s.mp4(1344×768、24 fps、220 帧,复用原始 AAC 音轨)
                            • 原始生成视频:comfyui_raw_1344x768.mp4
                            • WebSocket 逐步事件:progress_trace.jsonl
                            • 校正后的计时汇总:sampler_timing.json
                            • ComfyUI 捕获原始结果:run_result.json
                            • 使用的 API 工作流:api_workflow_1344x768.json
                            1 条回复 最后回复
                            1
                            • Tony WangT
                              Tony WangT
                              Tony Wang
                              易有太极
                              编写于 最后由 编辑
                              #40

                              Pro5000 48G肯定是不行了. 看看谁有72G测试一下吧.

                              @bunsei 不错, 这个多卡提升还是蛮有价值的.

                              terryT 1 条回复 最后回复
                              1
                              • Tony WangT Tony Wang

                                Pro5000 48G肯定是不行了. 看看谁有72G测试一下吧.

                                @bunsei 不错, 这个多卡提升还是蛮有价值的.

                                terryT
                                terryT
                                terry
                                易有太极
                                编写于 最后由 编辑
                                #41

                                @Tony-Wang 我哥有你这句话,就值得了。还有就是等双卡xtx了。其实双卡xtx最重要,不要跑高分辨率,长度也不用太长,可以脚本拼接。主要是要能突破分辨率限制就行。

                                油管:https://www.youtube.com/@抡锤者

                                1 条回复 最后回复
                                0
                                • imbiplaza ASUSI imbiplaza ASUS

                                  @Bunsei

                                  我也不懂,但是这几天大家都说omi 这个模型很神。。。
                                  但是我用起来更慢了,可能我原本得优化就是已经尽头了

                                  https://huggingface.co/FastVideo/FastH3-Omni-Comfy

                                  terryT
                                  terryT
                                  terry
                                  易有太极
                                  编写于 最后由 编辑
                                  #42

                                  @imbiplaza-ASUS 再多试试看呢。我弟,发挥文西的钻研精神。我过段时间事情忙完了疯狂comfyui,抄你们作业

                                  油管:https://www.youtube.com/@抡锤者

                                  1 条回复 最后回复
                                  0
                                  • BunseiB
                                    BunseiB
                                    Bunsei
                                    王侯将相
                                    编写于 最后由 Bunsei 编辑
                                    #43

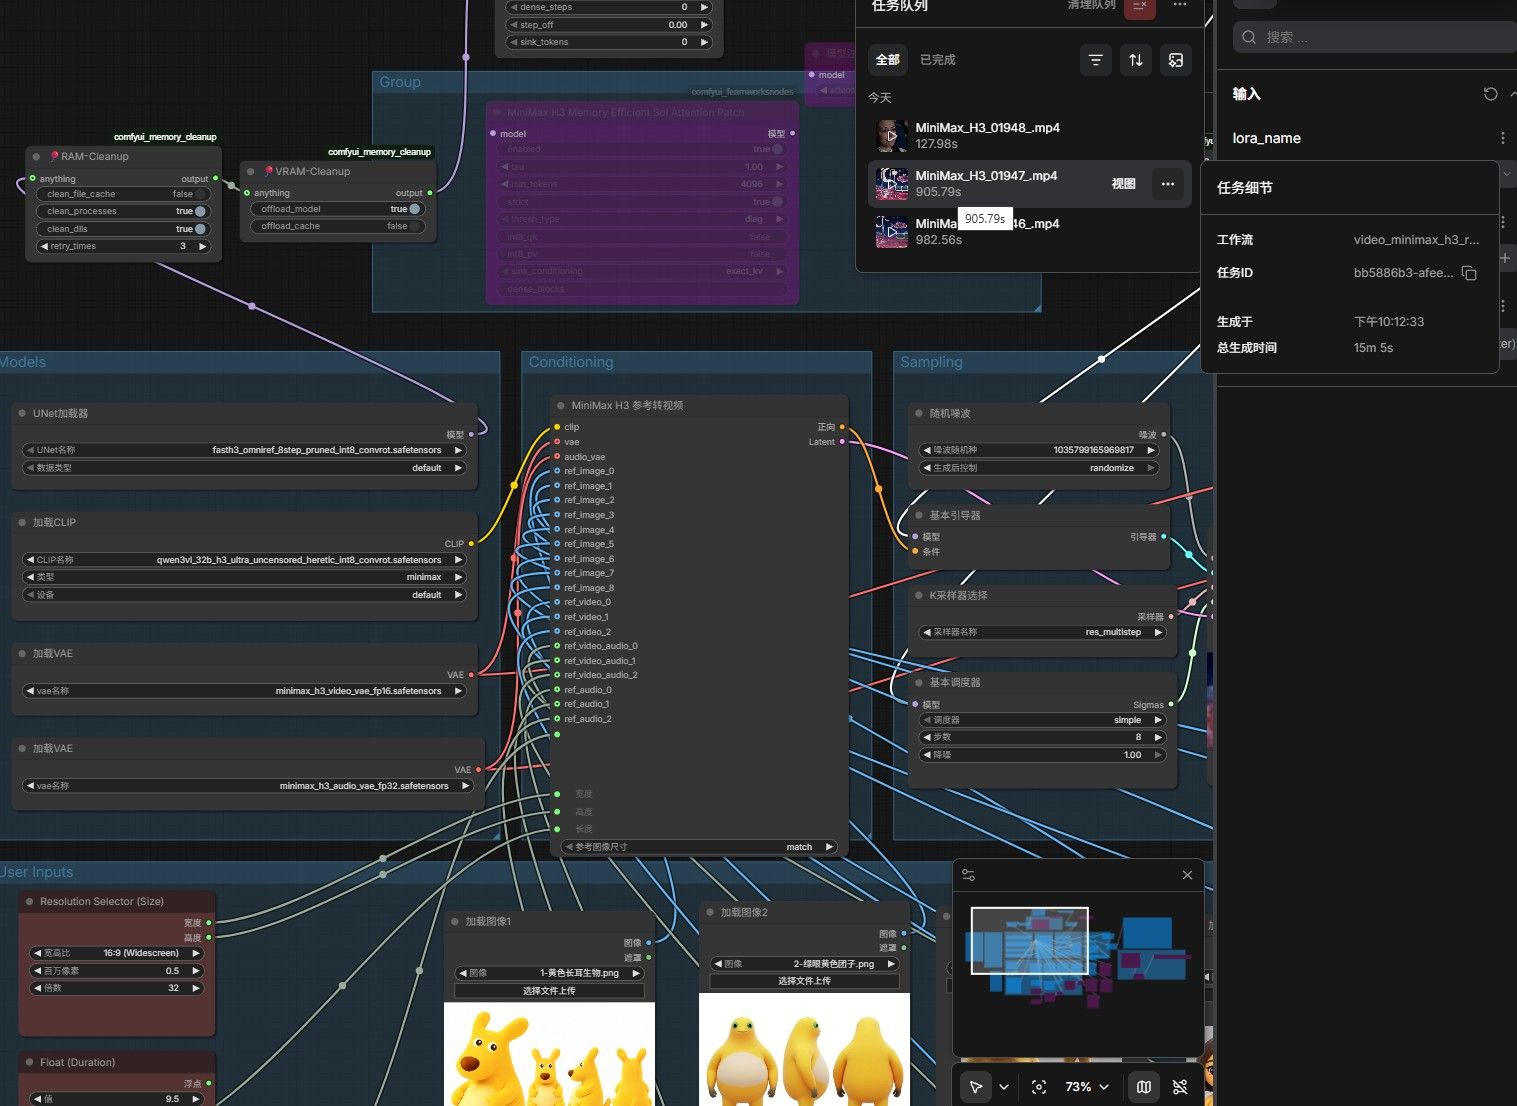
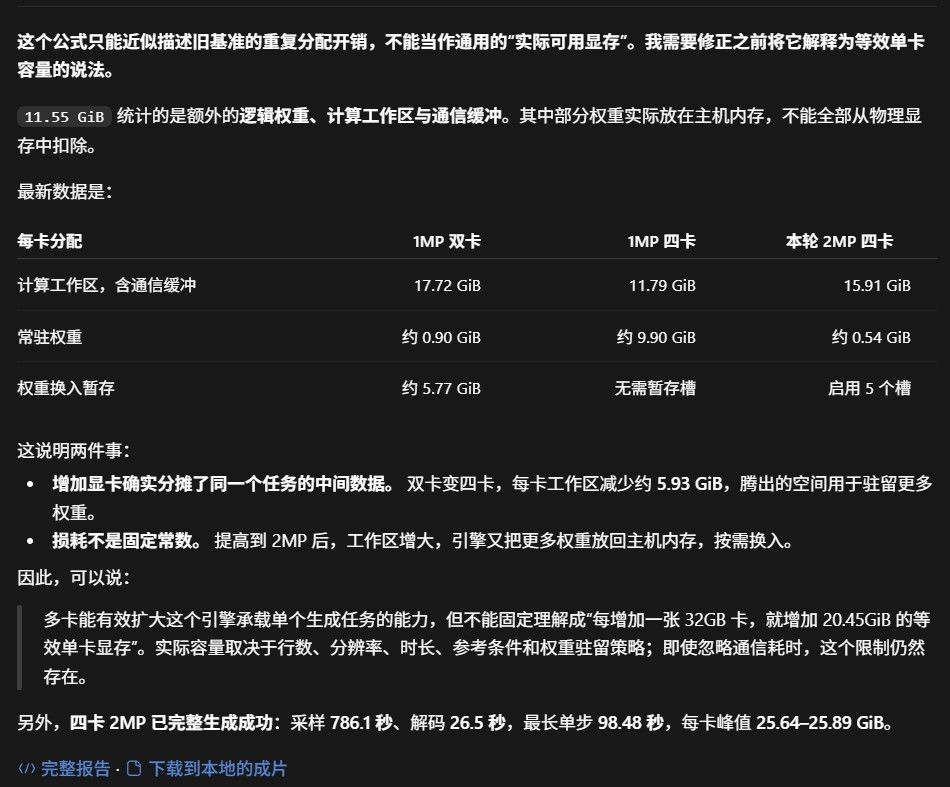
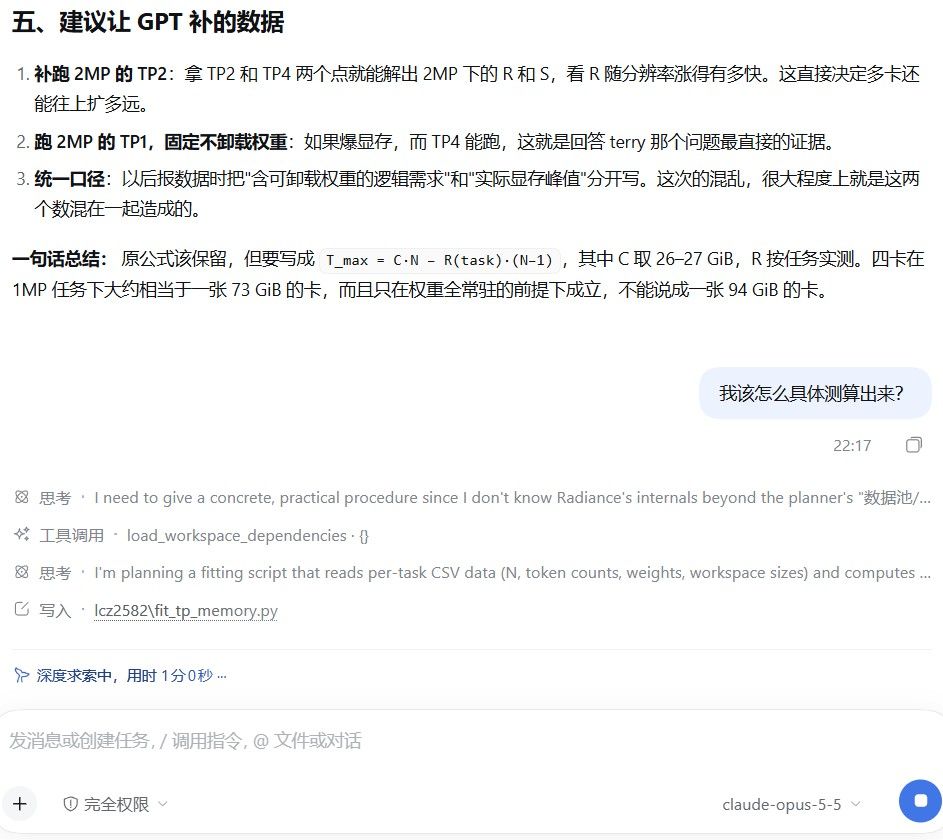
                                    等效显存得改调度策略,感觉再纠结这个意义不大,我这边测试了一个2mp4卡的。

                                    image.jpeg

                                    这次真的下血本了,要用禁忌的力量了
                                    image.jpeg

                                    1 条回复 最后回复
                                    1
                                    • imbiplaza ASUSI
                                      imbiplaza ASUSI
                                      imbiplaza ASUS
                                      谪仙人
                                      编写于 最后由 编辑
                                      #44

                                      image.jpeg

                                      冷启动
                                      0.5m
                                      rtxpro 4500 32g
                                      ddr4 3200mt
                                      16:22
                                      minimax_h3_ref2va_pruned_int8_convrot.safetensors

                                      热启动
                                      0.5m
                                      rtxpro 4500 32g
                                      ddr4 3200mt
                                      15:05
                                      fasth3_omniref_8step_pruned_int8_convrot.safetensors

                                      另外使用官方omni 得工作流,的确达到宣传得10s 视频,90秒完成输出

                                      https://huggingface.co/FastVideo/FastH3-Omni-Comfy

                                      fast_h3_omni_base.json

                                      1 条回复 最后回复
                                      0

                                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                      有了你的建议,这篇帖子会更精彩哦 💗

                                      注册 登录
                                      回复
                                      • 在新帖中回复
                                      登录后回复
                                      • 从旧到新
                                      • 从新到旧
                                      • 最多赞同


                                      • 登录

                                      • 登录或注册以进行搜索。
                                      • 第一个帖子
                                        最后一个帖子
                                      0
                                      • 版块
                                      • 最新
                                      • 标签
                                      • 热门
                                      • 用户
                                      • 群组