跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. 魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec

魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec

已定时 已固定 已锁定 已移动 精华 热议 AI硬件
7900xtxsg-lang多卡部署
106 帖子 36 发布者 5.9k 浏览 9 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Ben LeeB Ben Lee

    @terry @flyer666 @farmer-node @laobenxiong @墙内人
    各位大佬,今天继续给大家汇报一下这两天折腾 SGLang 的进展。

    先说句实话,我现在都不知道自己哪来的勇气。一个纯小白,在这个论坛里混了三个月,现在居然就敢大包大揽接下这么一个技术含量挺高的测试,回头想想,多少有点自不量力。结果这两天果然被现实狠狠地打脸。各种之前根本没想到的问题一个接一个冒出来,搞得我抓耳挠腮、鼻青脸肿,折腾了一天一夜多,整个人都有点焦头烂额了。

    首先就是ROCm 7.2 升级到 7.14 带来的编译问题和系统兼容问题,vLLM的识图也一度崩了,最离谱的是,后来发现硬件这边居然也在捣乱。先是 CPU 温度超过警戒值,后来排查下来,怀疑和散热器压紧程度、接触状态有关;接着两张显卡温度也一度冲得很高,又牵扯出上下卡位、风道以及两张卡之间热量互相影响的问题。这些因素叠在一起,导致我最开始跑出来的结果甚至有点违反预期。

    老特前不久的视频里很明确地说过,SGLang 相比 vLLM 是更高一档的存在。我第一轮测出来 vLLM 更占优势,更不用说vLLM可以Int8 KV量化,SGlang只能BF16。要不是我一直紧跟特哥的视频,我当时可能还真就信了,所以第一反应不是下结论,交作业,而是立马警惕,是不是我哪里搞错了?

    带着这个怀疑,我训着AI(也是跟老特学的)把整套测试重新审了一遍,结果还真发现了降频、温度干扰以及测试方案本身的一些漏洞。后来又花了很多时间,把温度、驱动、配置、测试方法这些干扰项一个一个排掉。折腾到刚才,总算拿到了一组我自己看完以后比较放心能拿得出手的结果。毕竟发出来的东西还是要负责的,不能随便浪费大家时间。

    下面直接上数据。


    一、先汇报 PR #34058 / N=1 的实际结果

    先把上次大家比较关心的这件事交代一下。

    我这次实际按 PR #34058 对应的 N=1 路线继续用了下来。

    结论很直接:

    目前已经达到我认为可以投入实际生产使用的状态。双 7900 XTX 的 SGLang 路线正式打通,flyer666大神牛B!!!

    而且不是“能启动、能跑请求”这种意义上的可用。在我后面重新做完的正式测试里,SGLang 已经不只是恢复正常,很多和我真实 Agent 工作负载相关的项目,实际表现已经超过了之前我用的很顺手的vLLM。(这个也是跟着flyer666大神的帖子 ”双卡7900xtx VLLM qwen3.8 爽玩agent pp1600 tg 160+ (附 mtp/7900xtx全攻略)” 学到的。 Respect!https://lcz.me/topic/1363 )

    尤其是:

    • 长期 Agent 追加轮
    • 多个 64K 请求并发
    • 文本→图片→再返回文本
    • 64K decode

    所以在我现在这套双 7900 XTX / ROCm 7.14 / Qwen3.8-27B 环境里,我已经把SGLang正式部署为我的生产环境。
    e2b6bf12-fba1-4152-942a-23d9e144e6be.png

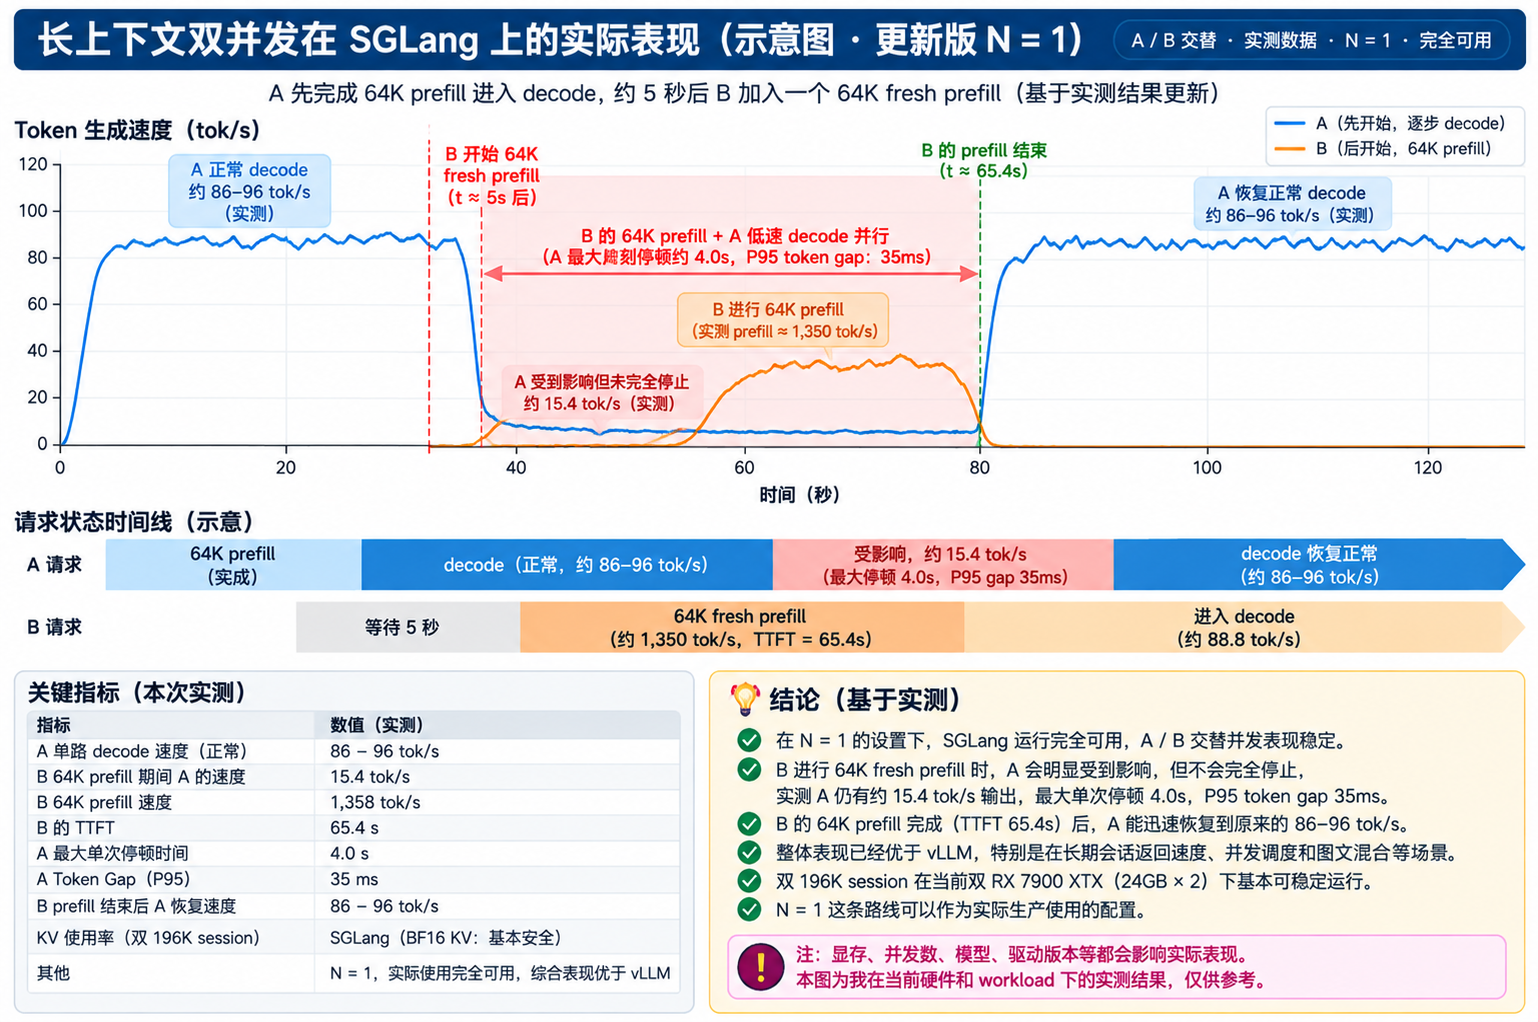
    注: N=1 后,64K fresh prefill 不再把正在 decode 的 Agent 完全饿死,但重 prefill 仍会造成显著性能下降。这其实也很合理。B 的 64K fresh prefill 本身就是一个非常重的 GPU 任务,它进来以后会大量占用算力和带宽。双卡总资源固定,A 的 decode 被挤压是正常的;N=1 做到的是不让 A 完全没饭吃。

    下面汇报测试细节,欢迎批评指正


    二、测试平台

    硬件环境

    项目 配置
    CPU AMD Ryzen 5 9600X
    主板 GIGABYTE X870E AORUS Xtreme AI TOP
    内存 64GB DDR5
    GPU 1 ASRock Radeon RX 7900 XTX 24GB
    GPU 2 Sapphire PULSE Radeon RX 7900 XTX 24GB
    并行方式 双卡 TP=2
    系统 Ubuntu
    ROCm 7.14
    模型 Qwen3.8-27B-W4A16-AutoRound-GPTQ
    最大上下文 196,608 tokens(约 192K)

    两套生产配置

    项目 SGLang vLLM
    Tensor Parallel TP=2 TP=2
    模型 同一 W4A16 AutoRound checkpoint 同一 W4A16 AutoRound checkpoint
    KV dtype BF16 / auto INT8 int8_per_token_head
    最大上下文 196,608 196,608
    Attention Triton TRITON_ATTN
    Speculative EAGLE MTP=3
    最大并发设置 4 running requests max-num-seqs=128
    GPU Memory 生产配置 0.95
    ROCm 7.14 / gfx1100 适配 7.14 / gfx110x 独立 MM 环境

    这里先声明一下:这不是完全归一化的学术 benchmark。 我测的不是“把所有参数强行改成完全一样以后,哪一个 scheduler 理论上更强”。

    打通这条 SGLang 路线以后,我真正想测的其实很简单:同样的硬件、同样的模型、同样的 196K 上下文目标,SGLang 和 vLLM 到底哪个更适合我真实的 Agent 使用场景。


    三、我的真实使用场景

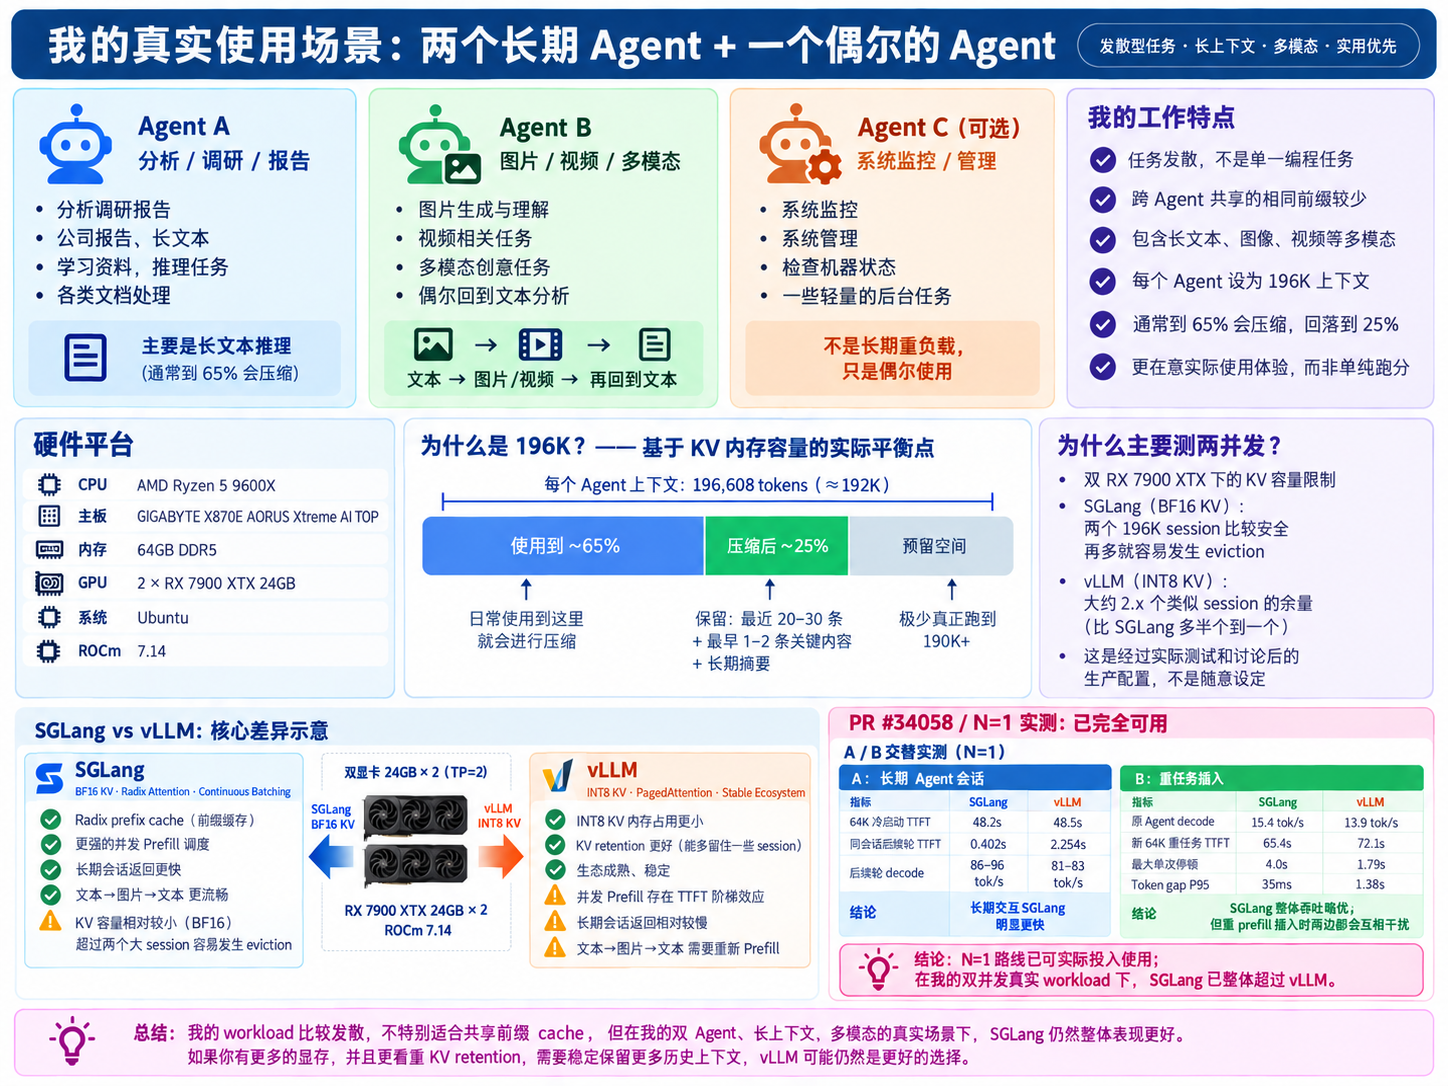
    这个部分其实比单纯的 benchmark 数字更重要。我的机器不是拿来给多个人同时跑 API 的。大多数时间,我就是自己用两个长期 Agent。

    Agent A:分析 / 推理

    主要做:

    • 分析
    • 调研
    • 公司报告
    • 长文本
    • 学习资料
    • 各类推理任务

    Agent B:创意 / 多模态

    主要做:

    • 图片
    • 视频
    • 多模态
    • 创意任务
    • 偶尔回到文本分析

    偶尔的 Agent C

    第三个 Agent 在我的NAS上,主要负责:

    • 系统监控
    • 系统管理
    • 检查所有机器状态
    • 远程唤醒
    • 家庭智能助手
    • 一些比较轻量的后台任务(邮件,提醒,定期搜寻资料等)

    但三路长期重负载不是我的常态。


    为什么我最终把 Context 定在 196K?

    每一个 Agent 我都配置到:196,608 tokens,约 192K。

    这个数字不是随便拍脑袋定的。主要是结合双 7900 XTX 的实际 KV 容量,反复讨论以后选出来的生产平衡点。

    在我现在的配置下:

    SGLang

    因为还是 BF16 KV,所以 KV 空间比较紧。196K 65%压缩阈值这个设定下:

    两个长期 Agent 基本是比较安全的。

    再加入第三个大 Context session,就开始很容易发生 eviction。

    vLLM

    vLLM 使用 INT8 KV,KV 容量明显大一些。从这次实际测试表现看,大致可以理解成:

    比 SGLang 多出半个到一个 session 的余量。

    也就是大约 2.x 个类似长期上下文的空间,而不是无限增加。

    所以最终对我来说,196K + 双 Agent 本身就是一个经过取舍以后比较合理的生产点。(注意,Qwen3.8 27B的雷霆大思考是病,得治,网上有药)

    后端 KV dtype 可用 KV 池
    SGLang BF16 / auto 约 263K tokens
    vLLM INT8 int8_per_token_head 约 295K tokens

    而且我的 Agent 不会真的一路堆到 196K

    我的Hermes Agent压缩机制大约到 65% context 左右就会压缩。压缩以后回落到大约 25%,同时保留:

    • 最近约 20–30 条重要消息
    • 最早 1–2 条关键内容
    • 压缩后的长期摘要

    所以现实里我根本不会经常跑到 190K+。这也是为什么这次 196K 极限测试因为测试载荷多了几个 token 而作废以后,我没有再专门补测。对我的生产场景意义不大。


    我的 workload 和 Coding Agent 其实不太一样

    还有一点必须特别说明。我的工作比较发散,两个Agent大多数时间都算是“脉冲式”推理,基本没有双路满载的情况。具体来说 -

    一个 Agent 可能正在做:

    公司分析、报告、调研、长文本推理

    另一个 Agent 可能已经跑去:

    做图、做视频、看图片、多模态

    所以这并不像很多 Coding Agent:

    • system prompt 类似
    • tool schema 类似
    • repository 内容高度重复
    • 大量代码 prefix 可以反复共享

    我的两个主 Agent 之间,真正完全相同的大段业务 prefix 并没有那么多。所以从这个角度讲:

    我的 workload 其实并不是特别“照顾”SGLang prefix cache 的 workload。远远没有发挥SGLang高效缓存命中的实力

    同一个 Agent 自己继续聊天,cache reuse 当然非常明显。但跨 Agent 的共享命中率不会像 Coding / 大规模同质 Agent 那么高。我平时使用两个 Agent 的任务内容差异较大,因此跨 Agent 可复用的大段 prefix 不多,新任务更容易表现为 fresh prefill,而不是高比例 prefix hit,如果你的 workload 是:

    • Coding Agent
    • 多个 Agent 共用同一套 tools
    • 大量相同 system prompt
    • 大量重复 repository/context
    • 显存又比我的双 24GB 更充裕

    那么我认为 SGLang 的 prefix cache 优势反而可能比我这里体现得更充分。
    26606364-d1ed-4221-b86c-58f6e50a0922.png


    四、核心结果

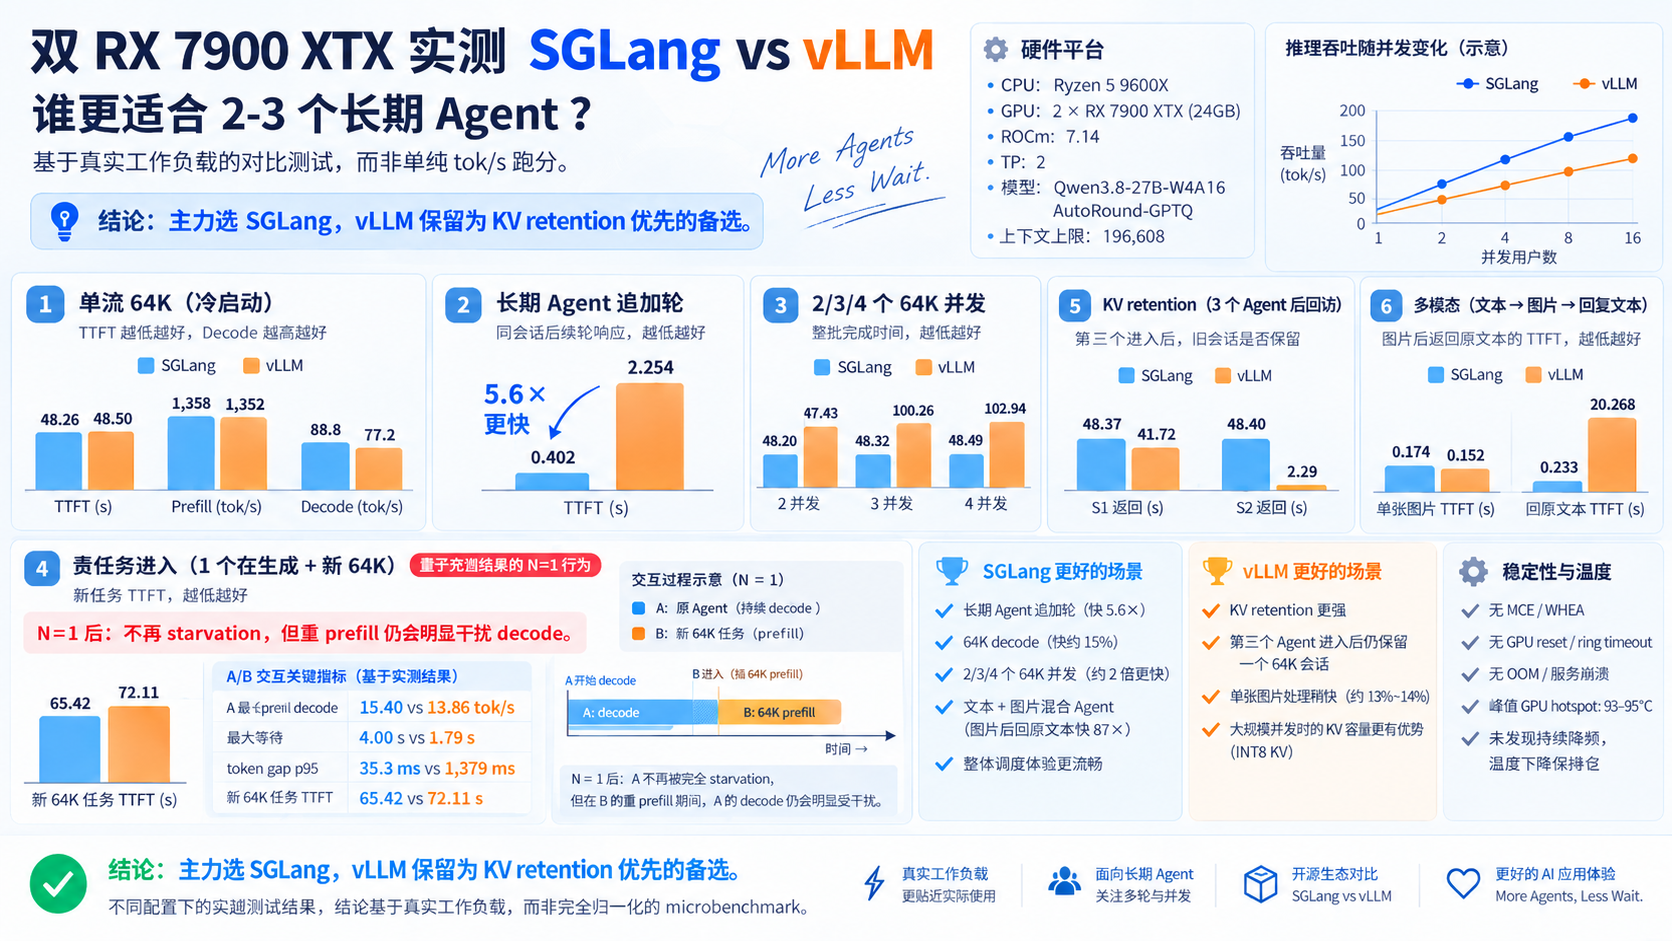
    1. 单流:两边差距其实不大

    32K Cold Prefill

    指标 SGLang vLLM
    TTFT 20.00s 20.30s
    Prefill 1,640 tok/s 1,615 tok/s
    Decode 99.0 tok/s 94.5 tok/s

    32K 基本可以认为打平。

    64K Cold Prefill

    指标 SGLang vLLM
    TTFT 48.26s 48.50s
    Prefill 1,358 tok/s 1,352 tok/s
    Decode 88.8 tok/s 77.2 tok/s

    Prefill 还是几乎一样。但 64K Decode:> SGLang 领先大约 15%。


    2. 长期 Agent:这里开始真正拉开

    两个 64K 长期 Session 建好以后,继续原来的会话:

    指标 SGLang vLLM
    64K 冷启动 ~48.2s ~48.5s
    后续轮 TTFT 0.402s 2.254s
    后续轮 Decode 86–96 tok/s 81–83 tok/s

    这是我最看重的项目之一。

    0.402 秒 vs 2.254 秒。

    SGLang 后续轮响应大约快:

    5.6 倍。

    这已经不是 benchmark 表格上好看一点的问题。

    长期 Agent 每天真正用的时候,0.4 秒和 2.2 秒的体感完全不一样。


    3. 一个 Agent 正在 Decode,另一个突然进来一个 64K 重任务

    指标 SGLang vLLM
    原 Agent Decode 15.4 tok/s 13.9 tok/s
    新 64K TTFT 65.4s 72.1s
    最大单次停顿 4.0s 1.79s
    Token Gap P95 35ms 1.38s

    vLLM 最大那一下停顿更短。

    但 SGLang:

    • 原 Agent 吞吐更高
    • 新任务完成更快
    • 大多数 token 输出更连续

    所以综合下来,我还是判 SGLang 略胜。

    不过这个测试也证明了一件很现实的事情: 显存能解决“装不装得下”,解决不了无限算力。

    三路、四路都同时真正 Decode 的时候,两张 7900 XTX 的总算力就在那里,不可能每一路都保持单流速度。我自己用短上下文的三个Agent实测时,已经感觉到明显卡顿了,算力瓶颈开始显现。


    4. KV Retention:这一项 vLLM 明确赢

    加入第三个 Agent 后:

    SGLang

    两个原来的 64K Session 回来:

    • ~48.4s
    • ~48.4s

    基本都需要重新 Prefill。

    vLLM

    一个大部分被驱逐。

    另一个还能:

    ~2.29s

    所以这一项:

    vLLM 明显胜出。

    但这里要再次提醒:

    • vLLM = INT8 KV
    • SGLang = BF16 KV

    这很大程度上就是 KV 容量的直接差异。

    如果以后 SGLang 的 8-bit KV 在 gfx1100 / ROCm 上稳定打通,这一项我认为非常值得重新测。顺带说一句,这两天折腾的时候倒是误打误撞把 FP8 KV 给跑通了,只不过现在速度慢得比较明显,肯定还有坑,暂时谈不上实用,flyer666大神也尝试过了也还没搞定,但是AMD社区发展很快,后面我继续盯着看有没有大神们的分享。


    5. 2 / 3 / 4 个 64K 同时进入

    这是我这轮最惊讶的结果之一。

    并发 SGLang 整批完成 vLLM 整批完成
    2 48.2s 97.4s
    3 48.3s 100.3s
    4 48.5s 102.9s

    SGLang 基本是:

    大家一起进来,差不多一起出去。

    vLLM 则出现明显 TTFT 阶梯:

    • 2 并发:48 → 97s
    • 3 并发:48 → 97 → 100s
    • 4 并发:48 → 97 → 100 → 103s

    至少在我这套双 RX 7900 XTX TP2 环境下:

    SGLang 并发 Prefill 调度明显占优。

    注:这一组输出只有 2 tokens,因此主要衡量 64K 并发 prefill、TTFT 和整批 wall-clock,不代表 2/3/4 路持续 decode 吞吐。


    6. 多模态

    单独看一张图片:

    指标 SGLang vLLM
    TTFT 0.174s 0.152s
    总耗时 0.363s 0.311s

    纯视觉:vLLM 略快。 但是我真正的 Agent 工作方式通常是:

    长文本 → 看图识图 → 再回原来的长文本

    图片之后返回原文本:

    • SGLang:0.233s
    • vLLM:20.268s

    这里差距就完全不是一个量级了。所以:

    单图:vLLM 略胜。

    真实文本 + 视觉长期 Agent:SGLang 明显胜。


    五、最后结论

    先声明:

    这个结论只代表我的硬件和 workload,不代表所有人。

    如果你的显存更大、长期并发 session 更多,而且 KV retention 的优先级高于交互延迟,那么 vLLM 的 INT8 KV 路线依然非常有吸引力。我的结论并不是“vLLM 不行”,而是 在我的 workload 权重下,SGLang 更合适。我的真实使用前提已经决定了选择:

    • 常态就是两个长期 Agent
    • 第三个 Agent 只是偶发监控/管理,用云端模型花不了多少钱
    • 每个 Agent 虽然设到 196K,但 65% 左右就会主动压缩
    • 工作内容发散,不是大量重复 Coding Prefix
    • 更在意长期 Session 返回速度和双并发体验

    在这个前提下:

    我最后选择 SGLang 做主力。

    因为对我最常发生的场景来说,它已经表现出:

    • 64K Decode 更快
    • 长期 Session 返回明显更快
    • 双/三/四 64K 并发 Prefill 更强
    • 文本→图片→文本工作流明显更顺

    而 vLLM 最大的优势:KV retention 在我的生产策略里反而不是最高优先级。如果以后 SGLang 能把 gfx1100 下稳定的 INT8 KV 打通,那我认为它目前最明显的短板也基本补上了。
    5e1f8a77-c092-4393-9db7-541ce8e05d90.png

    最后还有一个问题我后面很想继续测: > 1 个双卡 TP2 SGLang > vs > 2 个单卡独立实例 到底双卡协同能不能真正做到:

    1 + 1 > 2

    这个我觉得比继续追几十个 tok/s 更有意思。对了,这次主要围绕 SGLang、vLLM 和 llama.cpp 三条本地推理路线展开。当前这一轮先完成了 SGLang vs vLLM 的正式对比,llama.cpp 因为双卡实现方式不同(layer split,不是 TP=2),我准备单独开一轮测试,避免混在一起造成误导。特哥一直鼓励我发新帖,我正在弄,弄好了我一起发我的本论坛处女楼主贴。


    最后聊点题外话。

    感谢 AI 治好了我的“电子阳痿”。无比怀念当年天天晚上工会活动,我法师准时上线,和一帮兄弟姐妹一起开荒魔兽世界的日子——美好、热血,也确实挺不务正业。现在年纪大了,游戏买了一大堆,全躺在硬盘里吃灰,删又不舍得删,打开玩又确实意兴阑珊。

    结果这几个月折腾 AI,居然又找回了当年那种感觉:白天上班,晚上回来折腾机器、编译、跑模型、改参数、看视频、查日志,一不小心又干到下半夜。

    区别只是当年开荒的是副本,现在开荒的是 ROCm、SGLang、vLLM、llama.cpp,还有各种自建 Skill。

    更妙的是,这次在家天天熬夜的理由还格外冠冕堂皇——“学习 AI、研究新技术、提升生产力”。连申请显卡经费审批都顺利了不少,居然和当年的高手们“名正言顺申请 5090以便在特殊时期更好的上网课”那种窃喜和偷感共情了。

    仔细想想,人其实没怎么变,只是当年折腾装备、插件和副本,现在折腾显卡、推理框架和 Agent。还是那个毛病:一旦找到新坑,就总想往深里挖。

    搞不懂就查,跑崩了就重来,偶尔折腾出一个能用的结果,那个爽感还真和当年首杀 Boss 有点像。

    游戏还是继续吃灰吧。现在这个“副本”,感觉还够我开荒一阵子。

    F
    F
    flyer666
    技术大牛
    编写于 最后由 编辑
    #89

    @Ben-Lee 哈哈哈 不错不错 有看我最新帖子吗?可以试试dflash,pp & tg都有加速

    Ben LeeB 1 条回复 最后回复
    0
    • ,terryT terry 分叉了 此主题
    • Ben LeeB
      Ben LeeB
      Ben Lee
      超凡大师
      编写于 最后由 编辑
      #90

      @terry 特哥,你给我抬旗了呀 😊 👍

      1 条回复 最后回复
      1
      • F flyer666

        @Ben-Lee 哈哈哈 不错不错 有看我最新帖子吗?可以试试dflash,pp & tg都有加速

        Ben LeeB
        Ben LeeB
        Ben Lee
        超凡大师
        编写于 最后由 编辑
        #91

        @flyer666 大佬,你一周一个大招,我这边屁滚尿流要忙活好几天呀 😁

        1 条回复 最后回复
        1
        • ?
          ?
          老用户
          编写于 最后由 编辑
          #92

          双R9700一样可用吗?

          1 条回复 最后回复
          0
          • terryT terry

            这个绝对是精品,卧槽要是这样,我都想折腾下双卡了,就是不知道主板多少钱?分享下你的详细配置,最好弄个教程,我做个视频推广下,这是一件大事,😢......

            GeekyangG
            GeekyangG
            Geekyang
            已封禁
            编写于 最后由 Geekyang 编辑
            #93

            @terry 这个双7900XTX 主板的尺寸,我是没有找到

            947d6dc5-402e-4db7-ad68-a747d3613269-image.jpeg

            X99 PCIE 之间的空隙只有50mm, 不管双路还是单路,都不可能双卡。主板是个大问题。

            建议把主板和电源单独做一个版块。我现在是找不到可以特别合适双卡的主板。

            韦 你 2 条回复 最后回复
            0
            • GeekyangG Geekyang

              @terry 这个双7900XTX 主板的尺寸,我是没有找到

              947d6dc5-402e-4db7-ad68-a747d3613269-image.jpeg

              X99 PCIE 之间的空隙只有50mm, 不管双路还是单路,都不可能双卡。主板是个大问题。

              建议把主板和电源单独做一个版块。我现在是找不到可以特别合适双卡的主板。

              韦
              韦
              韦春花
              编写于 最后由 韦春花 编辑
              #94

              @Geekyang X99主板的PCI插槽设定死了,双7900xtx必须第一和第二(三)槽才能X16+X16(E5‑26xx v3/v4的 CPU 要40 条 PCIe 通道,才能让前两条物理插槽跑满 PCIe3.0 x16 + x16(16+16=32 条,剩余 8 条留给 M.2 / 网卡等外设)。
              要SGLang或者Vllm,PCIe3.0X8有点艰难,所有矿板基本排除,还剩下4个办法:
              1.7900xtx换水冷,我试过了,改善不大,技术犬的水冷直接用CPU水冷改的,厚度只少了一槽位,带显存一体水冷据说只有一槽,得空试试;
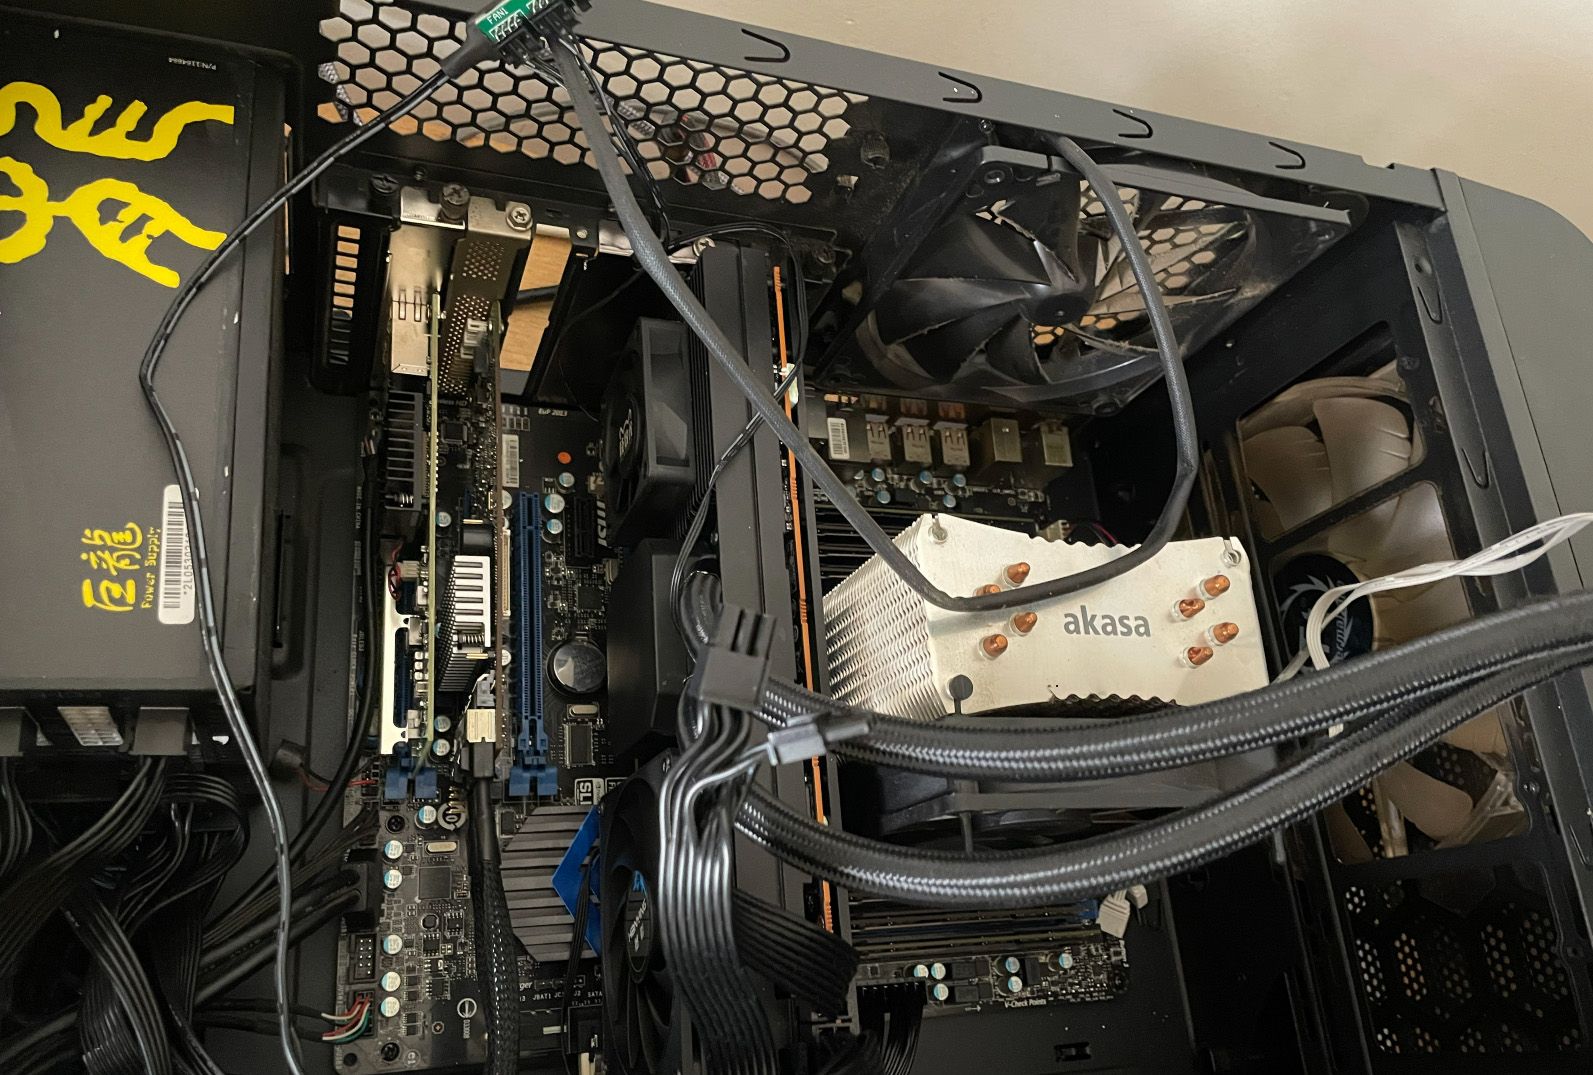
              7900-2.jpg

              2.显卡延长线从第二槽引出,竖装支架固定在机箱下部(电源上面位置);电源上这块卡示意,高度接近,两槽多间距进风还行;
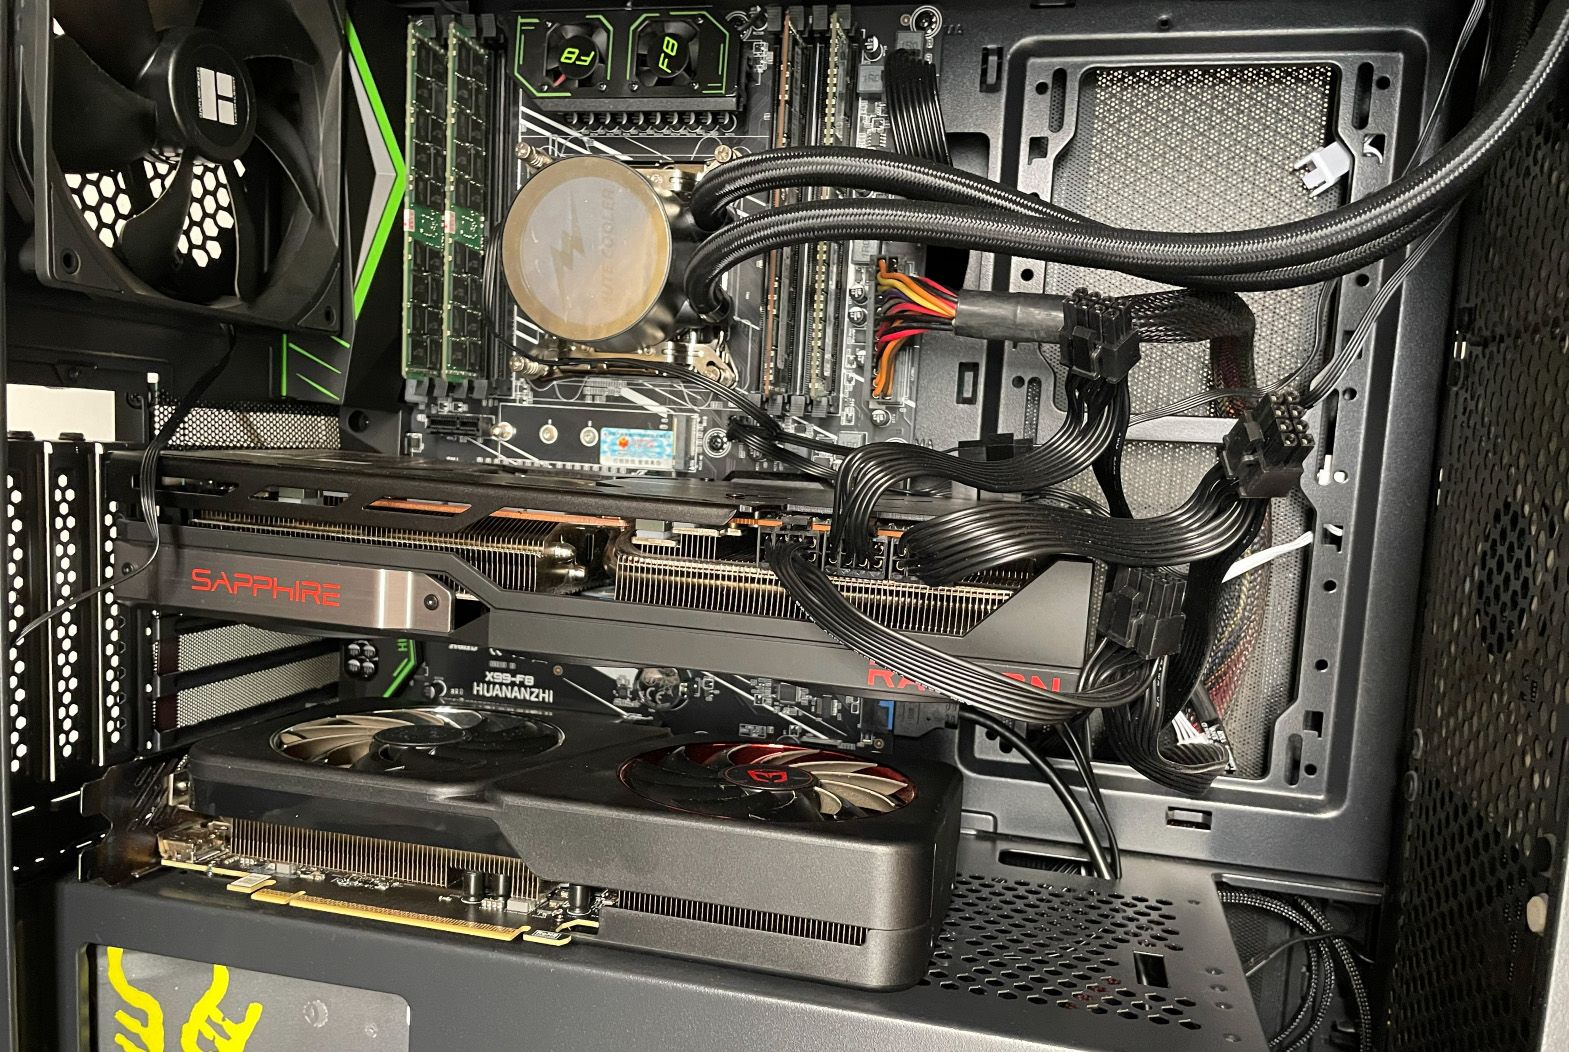
              7900-1.jpg

              3.超微和华硕有些X99服务器主板PCI插槽更多还有PLX 桥接芯片,不一定必须第一+第二槽、第一+第三槽,也可以运行在x16 + x16,这样就避开了显卡延长线损耗,只要机箱选高一点就成。但这些X99服务器主板价格感人,不符合咱屌丝范儿哈;
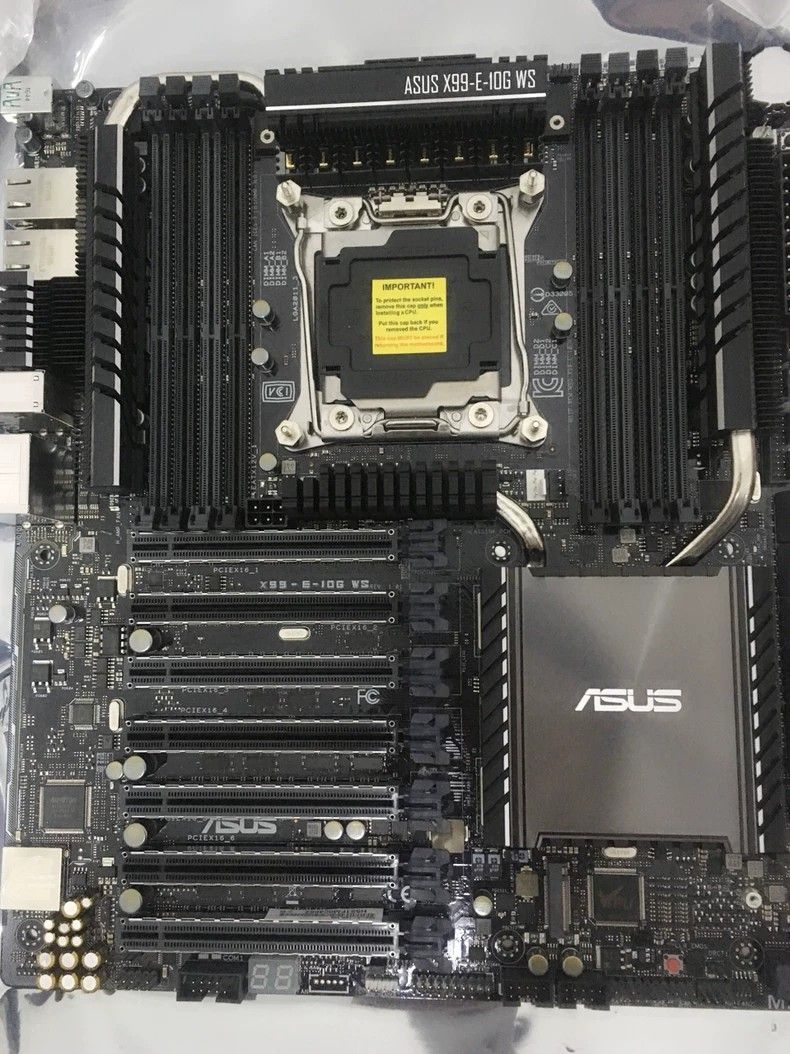
              e475bfd7-13f3-4215-8a60-7dc69fd00b2b-image.jpeg

              4.矿架,没有矿架解决不了的安装问题😊

              terryT 1 条回复 最后回复
              3
              • ,F franklee006 引用了 此主题
              • 韦 韦春花

                @Geekyang X99主板的PCI插槽设定死了,双7900xtx必须第一和第二(三)槽才能X16+X16(E5‑26xx v3/v4的 CPU 要40 条 PCIe 通道,才能让前两条物理插槽跑满 PCIe3.0 x16 + x16(16+16=32 条,剩余 8 条留给 M.2 / 网卡等外设)。
                要SGLang或者Vllm,PCIe3.0X8有点艰难,所有矿板基本排除,还剩下4个办法:
                1.7900xtx换水冷,我试过了,改善不大,技术犬的水冷直接用CPU水冷改的,厚度只少了一槽位,带显存一体水冷据说只有一槽,得空试试;

                7900-2.jpg

                2.显卡延长线从第二槽引出,竖装支架固定在机箱下部(电源上面位置);电源上这块卡示意,高度接近,两槽多间距进风还行;

                7900-1.jpg

                3.超微和华硕有些X99服务器主板PCI插槽更多还有PLX 桥接芯片,不一定必须第一+第二槽、第一+第三槽,也可以运行在x16 + x16,这样就避开了显卡延长线损耗,只要机箱选高一点就成。但这些X99服务器主板价格感人,不符合咱屌丝范儿哈;
                e475bfd7-13f3-4215-8a60-7dc69fd00b2b-image.jpeg

                4.矿架,没有矿架解决不了的安装问题😊

                terryT
                terryT
                terry
                超级版主
                编写于 最后由 编辑
                #95

                @韦春花 非常好的分享

                油管:https://www.youtube.com/@抡锤者

                1 条回复 最后回复
                0
                • ,Ben LeeB Ben Lee 引用了 此主题
                • GeekyangG Geekyang

                  @terry 这个双7900XTX 主板的尺寸,我是没有找到

                  947d6dc5-402e-4db7-ad68-a747d3613269-image.jpeg

                  X99 PCIE 之间的空隙只有50mm, 不管双路还是单路,都不可能双卡。主板是个大问题。

                  建议把主板和电源单独做一个版块。我现在是找不到可以特别合适双卡的主板。

                  你
                  你
                  你的名字我的名字都是一样的
                  编写于 最后由 编辑
                  #96

                  @Geekyang 如果用讯景等2.9槽的显卡,x99/x299 d4很多主板都可以双卡。如果用矿架,还可以4卡。另外pci3x16延长线价格也不贵。普通x99 d3 支持双pci3x16的主板用延长线也行。不过相对来说,能用机箱肯定也是方便一点。用矿架,还是要有较大的空间才方便。

                  1 条回复 最后回复
                  0
                  • Z znx

                    感谢楼主分享 在您帖子的感召下,我已经准备购入第二张显卡了 等过两天买好装好也跑跑多并发感觉一下
                    我的配置是精粤X99D3 看看显卡在PCIE 3.0 16x 下会受到多大的影响

                    farmer nodeF
                    farmer nodeF
                    farmer node
                    德高望重 劳动模范
                    编写于 最后由 编辑
                    #97

                    @znx 先别急着买,你这个板子可能不支持P2P ,TP2 跑不了,跑起来也非常慢,你先弄清楚,帖子你有其他人测过,我之前好像就是这个板子,我换了 EYPC 的平台才跑起来的。

                    1 条回复 最后回复
                    1
                    • Z
                      Z
                      znx
                      编写于 最后由 编辑
                      #98

                      我已经购入第二张 根据各位大神的帖子已经在本地的卡间带宽跑到10g,tp2已经没问题了 这两天在弄散热的问题 要不确实2张一起发热 几分钟必崩

                      1 条回复 最后回复
                      0
                      • kos orK
                        kos orK
                        kos or
                        超凡大师
                        编写于 最后由 kos or 编辑
                        #99

                        昨天 Agent 把我的 7900 XTX 解開枷鎖功耗飆升到 390W, 趕快鎖回305W, 家用風扇開到最大 伺候這些顯示卡老爺們 降降溫

                        坤 1 条回复 最后回复
                        0
                        • kos orK kos or

                          昨天 Agent 把我的 7900 XTX 解開枷鎖功耗飆升到 390W, 趕快鎖回305W, 家用風扇開到最大 伺候這些顯示卡老爺們 降降溫

                          坤
                          坤
                          坤坤
                          德高望重 劳动模范
                          编写于 最后由 编辑
                          #100

                          @kos-or 我直接用普通风扇怼着两张卡直吹

                          kos orK 1 条回复 最后回复
                          0
                          • 坤 坤坤

                            @kos-or 我直接用普通风扇怼着两张卡直吹

                            kos orK
                            kos orK
                            kos or
                            超凡大师
                            编写于 最后由 编辑
                            #101

                            @坤坤

                            風扇便宜, 顯卡越來越貴,
                            顯卡溫度不壓低, 24/7 長期滿載高溫運轉 容易壞掉 損失重
                            風扇壞了 直接再買一個就行

                            坤 2 条回复 最后回复
                            0
                            • kos orK kos or

                              @坤坤

                              風扇便宜, 顯卡越來越貴,
                              顯卡溫度不壓低, 24/7 長期滿載高溫運轉 容易壞掉 損失重
                              風扇壞了 直接再買一個就行

                              坤
                              坤
                              坤坤
                              德高望重 劳动模范
                              编写于 最后由 编辑
                              #102

                              @kos-or 是呀,二十多的那种风扇怼着吹,然后温度的话稳在80左右,核心温度差不多90

                              kos orK 1 条回复 最后回复
                              0
                              • kos orK kos or

                                @坤坤

                                風扇便宜, 顯卡越來越貴,
                                顯卡溫度不壓低, 24/7 長期滿載高溫運轉 容易壞掉 損失重
                                風扇壞了 直接再買一個就行

                                坤
                                坤
                                坤坤
                                德高望重 劳动模范
                                编写于 最后由 编辑
                                #103

                                @kos-or 模型不推理的话甚至温度降到35度左右风扇都不带转的,之前不知道还以为显卡坏了怎么风扇不转了

                                1 条回复 最后回复
                                0
                                • 坤 坤坤

                                  @kos-or 是呀,二十多的那种风扇怼着吹,然后温度的话稳在80左右,核心温度差不多90

                                  kos orK
                                  kos orK
                                  kos or
                                  超凡大师
                                  编写于 最后由 编辑
                                  #104

                                  @坤坤 said:

                                  然后温度的话稳在80左右,核心温度差不多90

                                  長期90度算高嗎? 我想讓顯卡一天運作20小時, 溫度希望能壓在80度左右

                                  這對RX7900XTX 是個壓力
                                  對 RTX-5070 Ti 來說平均溫度是 65以內, 不超過70,
                                  所以我比較擔心RX7900XTX 長期連續運轉的能力

                                  张光璞张 1 条回复 最后回复
                                  0
                                  • kos orK kos or

                                    @坤坤 said:

                                    然后温度的话稳在80左右,核心温度差不多90

                                    長期90度算高嗎? 我想讓顯卡一天運作20小時, 溫度希望能壓在80度左右

                                    這對RX7900XTX 是個壓力
                                    對 RTX-5070 Ti 來說平均溫度是 65以內, 不超過70,
                                    所以我比較擔心RX7900XTX 長期連續運轉的能力

                                    张光璞张
                                    张光璞张
                                    张光璞
                                    技术大牛 劳动模范
                                    编写于 最后由 编辑
                                    #105

                                    @kos-or 说:

                                    @坤坤 said:

                                    然后温度的话稳在80左右,核心温度差不多90

                                    長期90度算高嗎? 我想讓顯卡一天運作20小時, 溫度希望能壓在80度左右

                                    這對RX7900XTX 是個壓力
                                    對 RTX-5070 Ti 來說平均溫度是 65以內, 不超過70,
                                    所以我比較擔心RX7900XTX 長期連續運轉的能力

                                    建议降压,锁功率

                                    1 条回复 最后回复
                                    0
                                    • XiaoteX
                                      XiaoteX
                                      Xiaote
                                      编写于 最后由 编辑
                                      #106

                                      ⭐ 本帖点赞数达到自动加精门槛,已设为精华,作者 +5 积分奖励,希望再接再厉!

                                      奖励凭证:精华 +5 分 · 编号 f1532-2645-1(系统自动发放,只发一次)

                                      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                                      1 条回复 最后回复
                                      0
                                      • ,Ben LeeB Ben Lee 引用了 此主题

                                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                      有了你的建议,这篇帖子会更精彩哦 💗

                                      注册 登录
                                      回复
                                      • 在新帖中回复
                                      登录后回复
                                      • 从旧到新
                                      • 从新到旧
                                      • 最多赞同


                                      • 登录

                                      • 登录或注册以进行搜索。
                                      • 第一个帖子
                                        最后一个帖子
                                      0
                                      • 版块
                                      • 最新
                                      • 标签
                                      • 热门
                                      • 用户
                                      • 群组