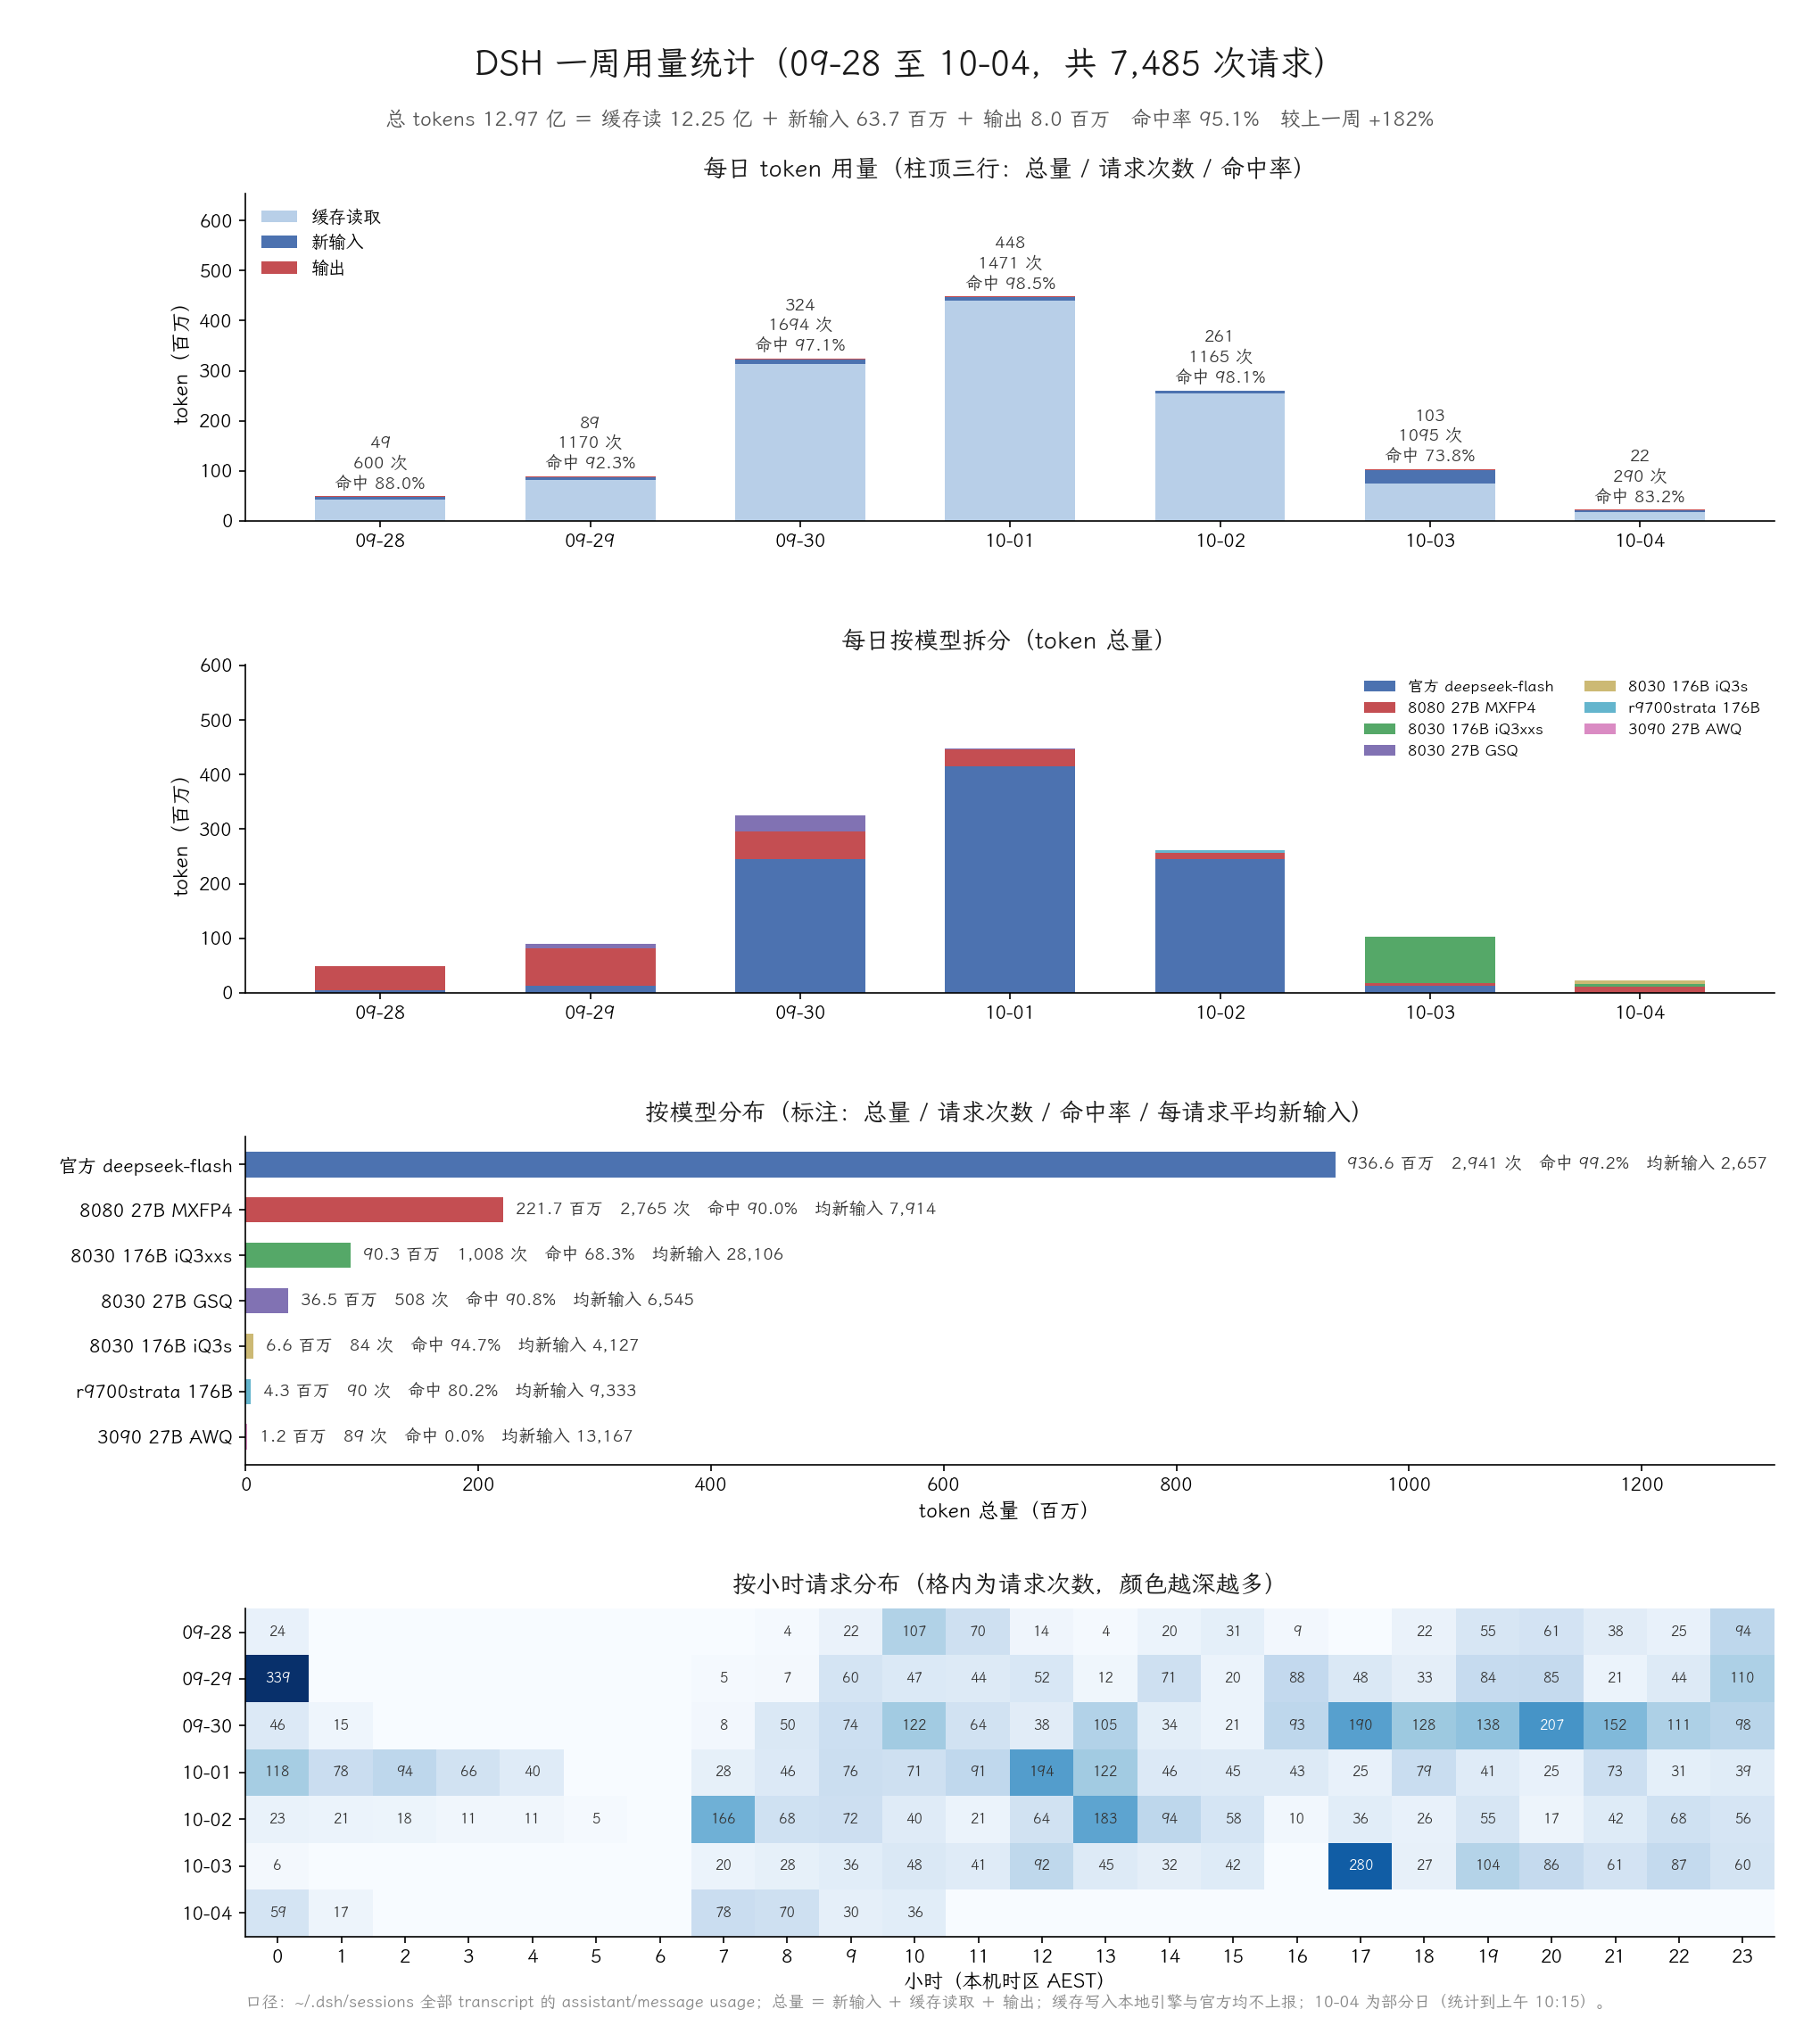
體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27B
-
-
-
可是我的最难的那个关,已经被27b 解决了。。。所以我还等,等真正你们觉得可以超越27b 我才来下载。。。
nvme 也是很紧张了
-
-
-
-
-
個人使用體感經驗 (未和SGLang Qwen3.8-27B 或NInfer, HyperQwen 比較)
比較了 Strata-Swift15-Qwen3.8-Flash-IQ4_NL (RTX 5070 Ti) vs. LLama.cpp-Qwen3.8-27B-Q4_K_M-Dflash2 (7900XTX)
在雙方都是 Reasoning Low 的條件下,使用的介面為Hermes Agent,從Agentic一般生活常態功能(不含coding)操作的角度來說,
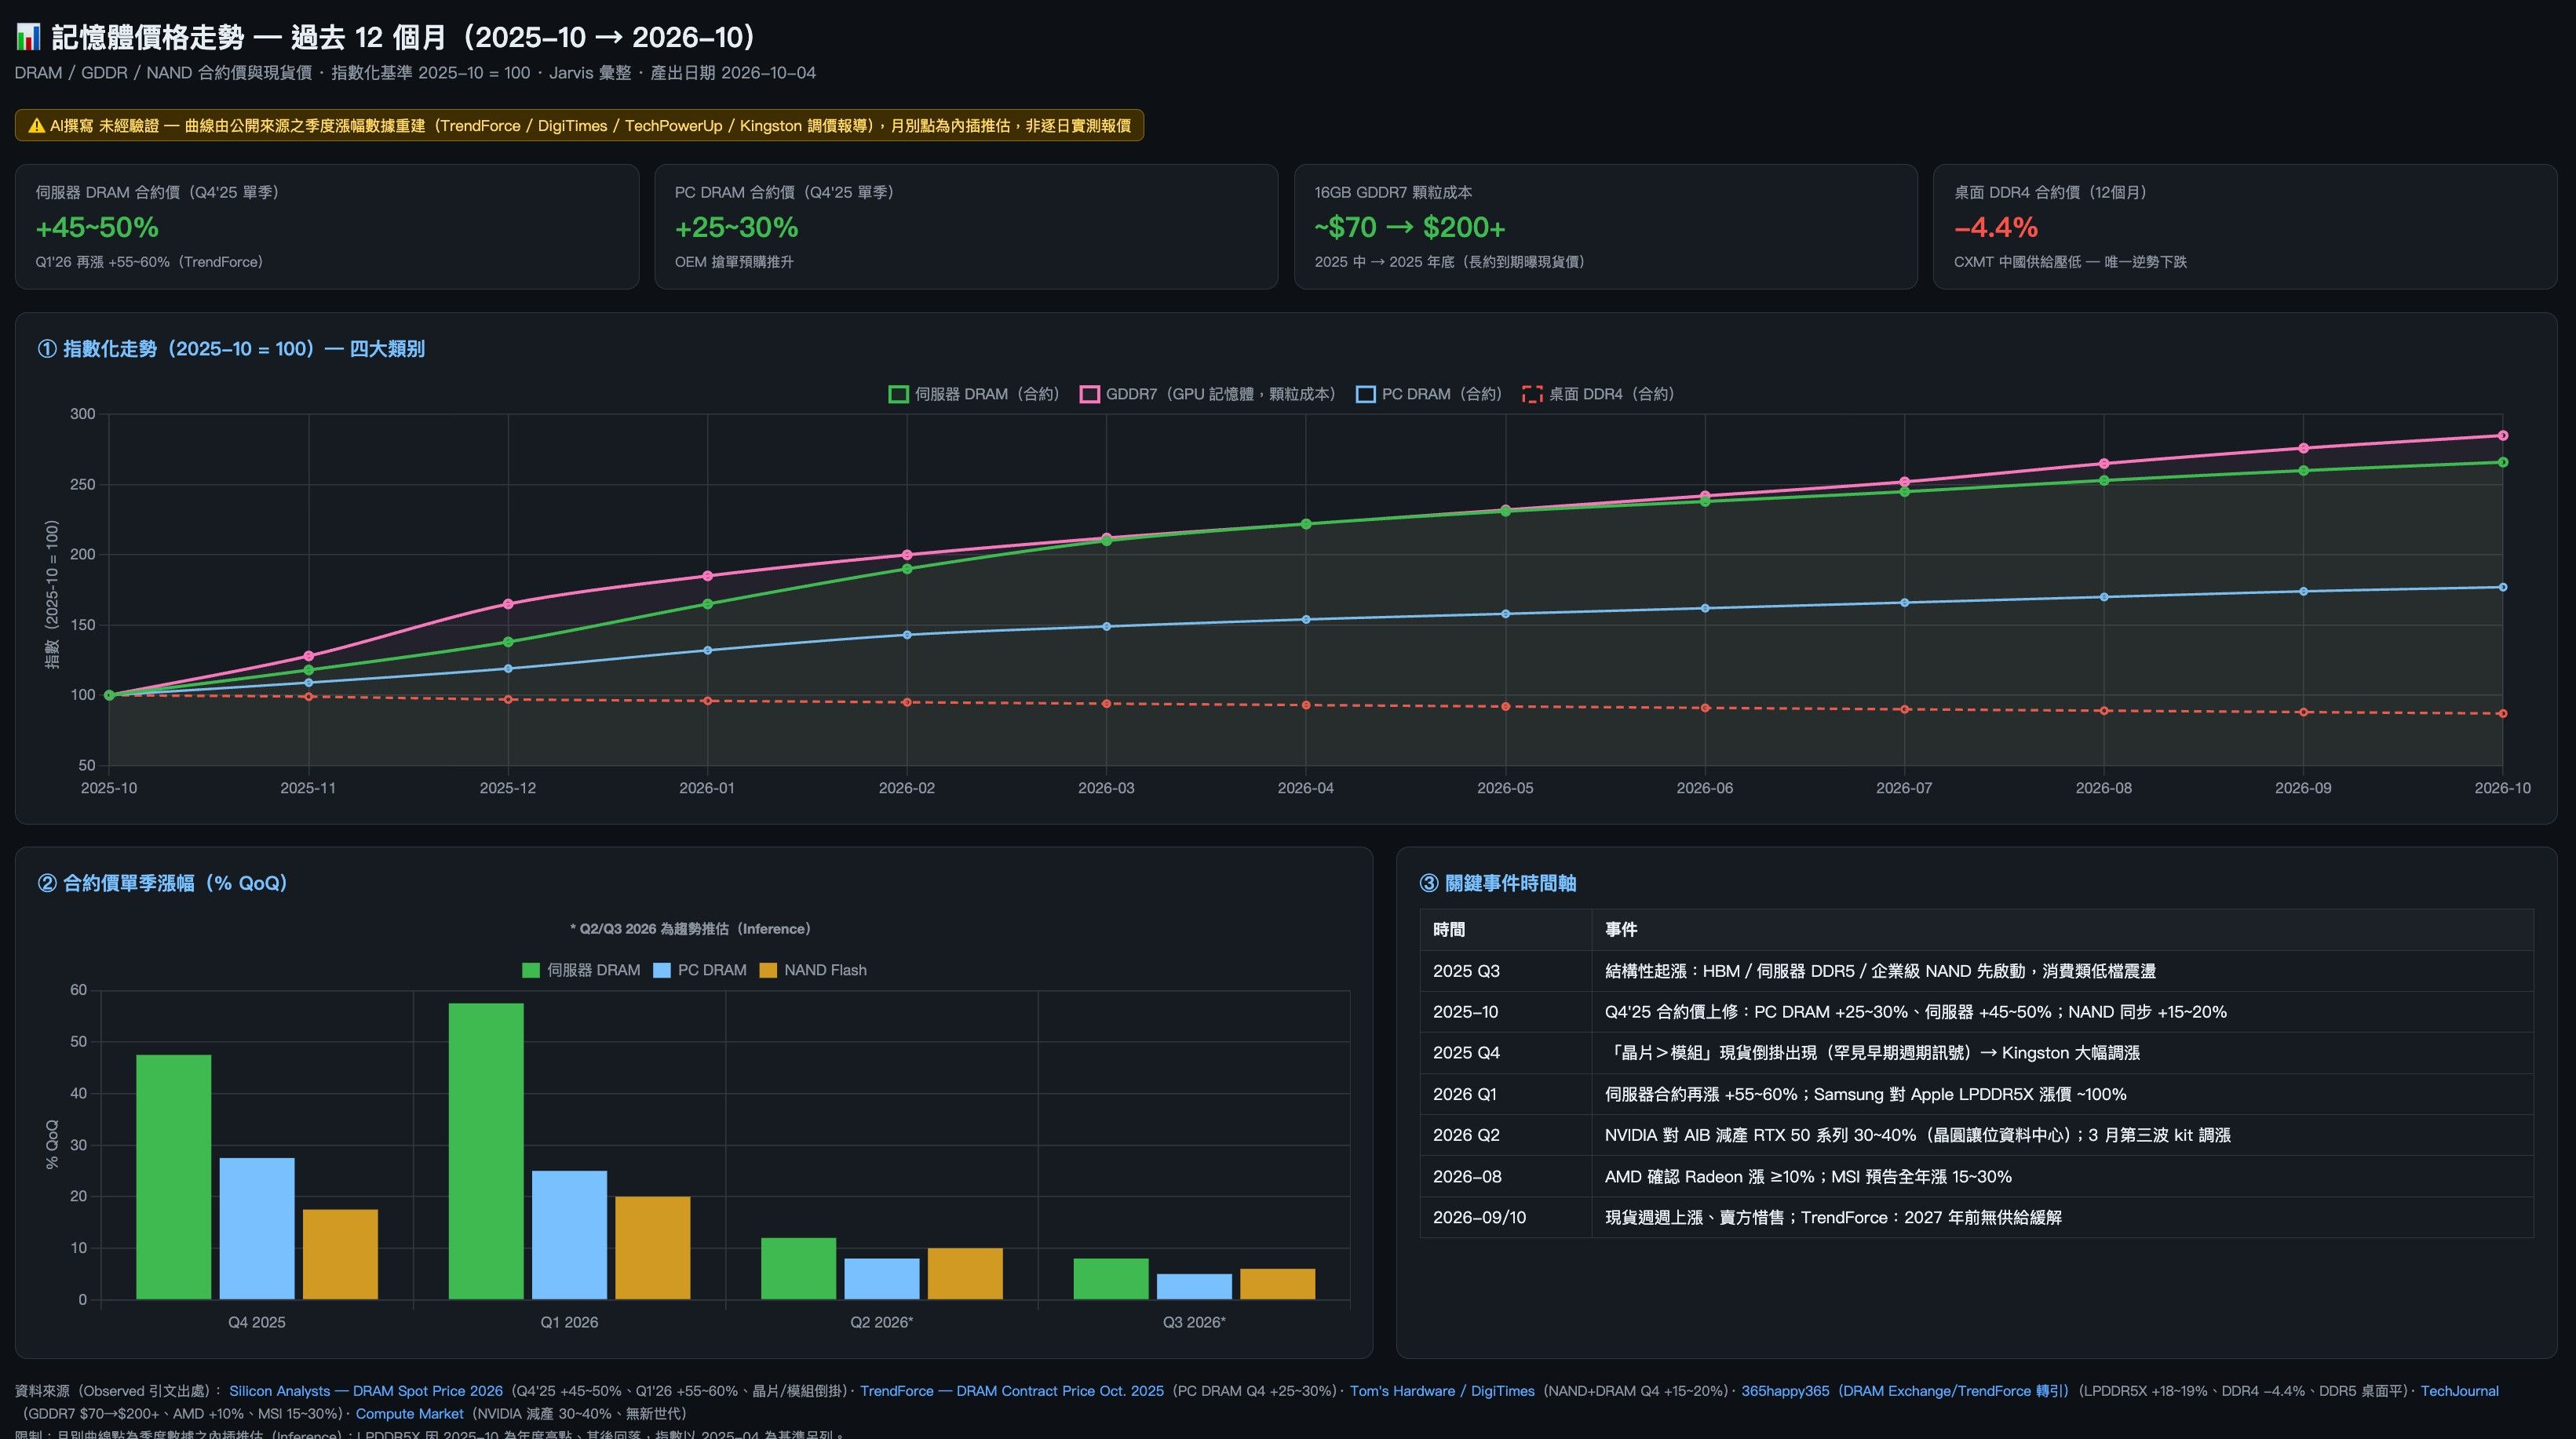
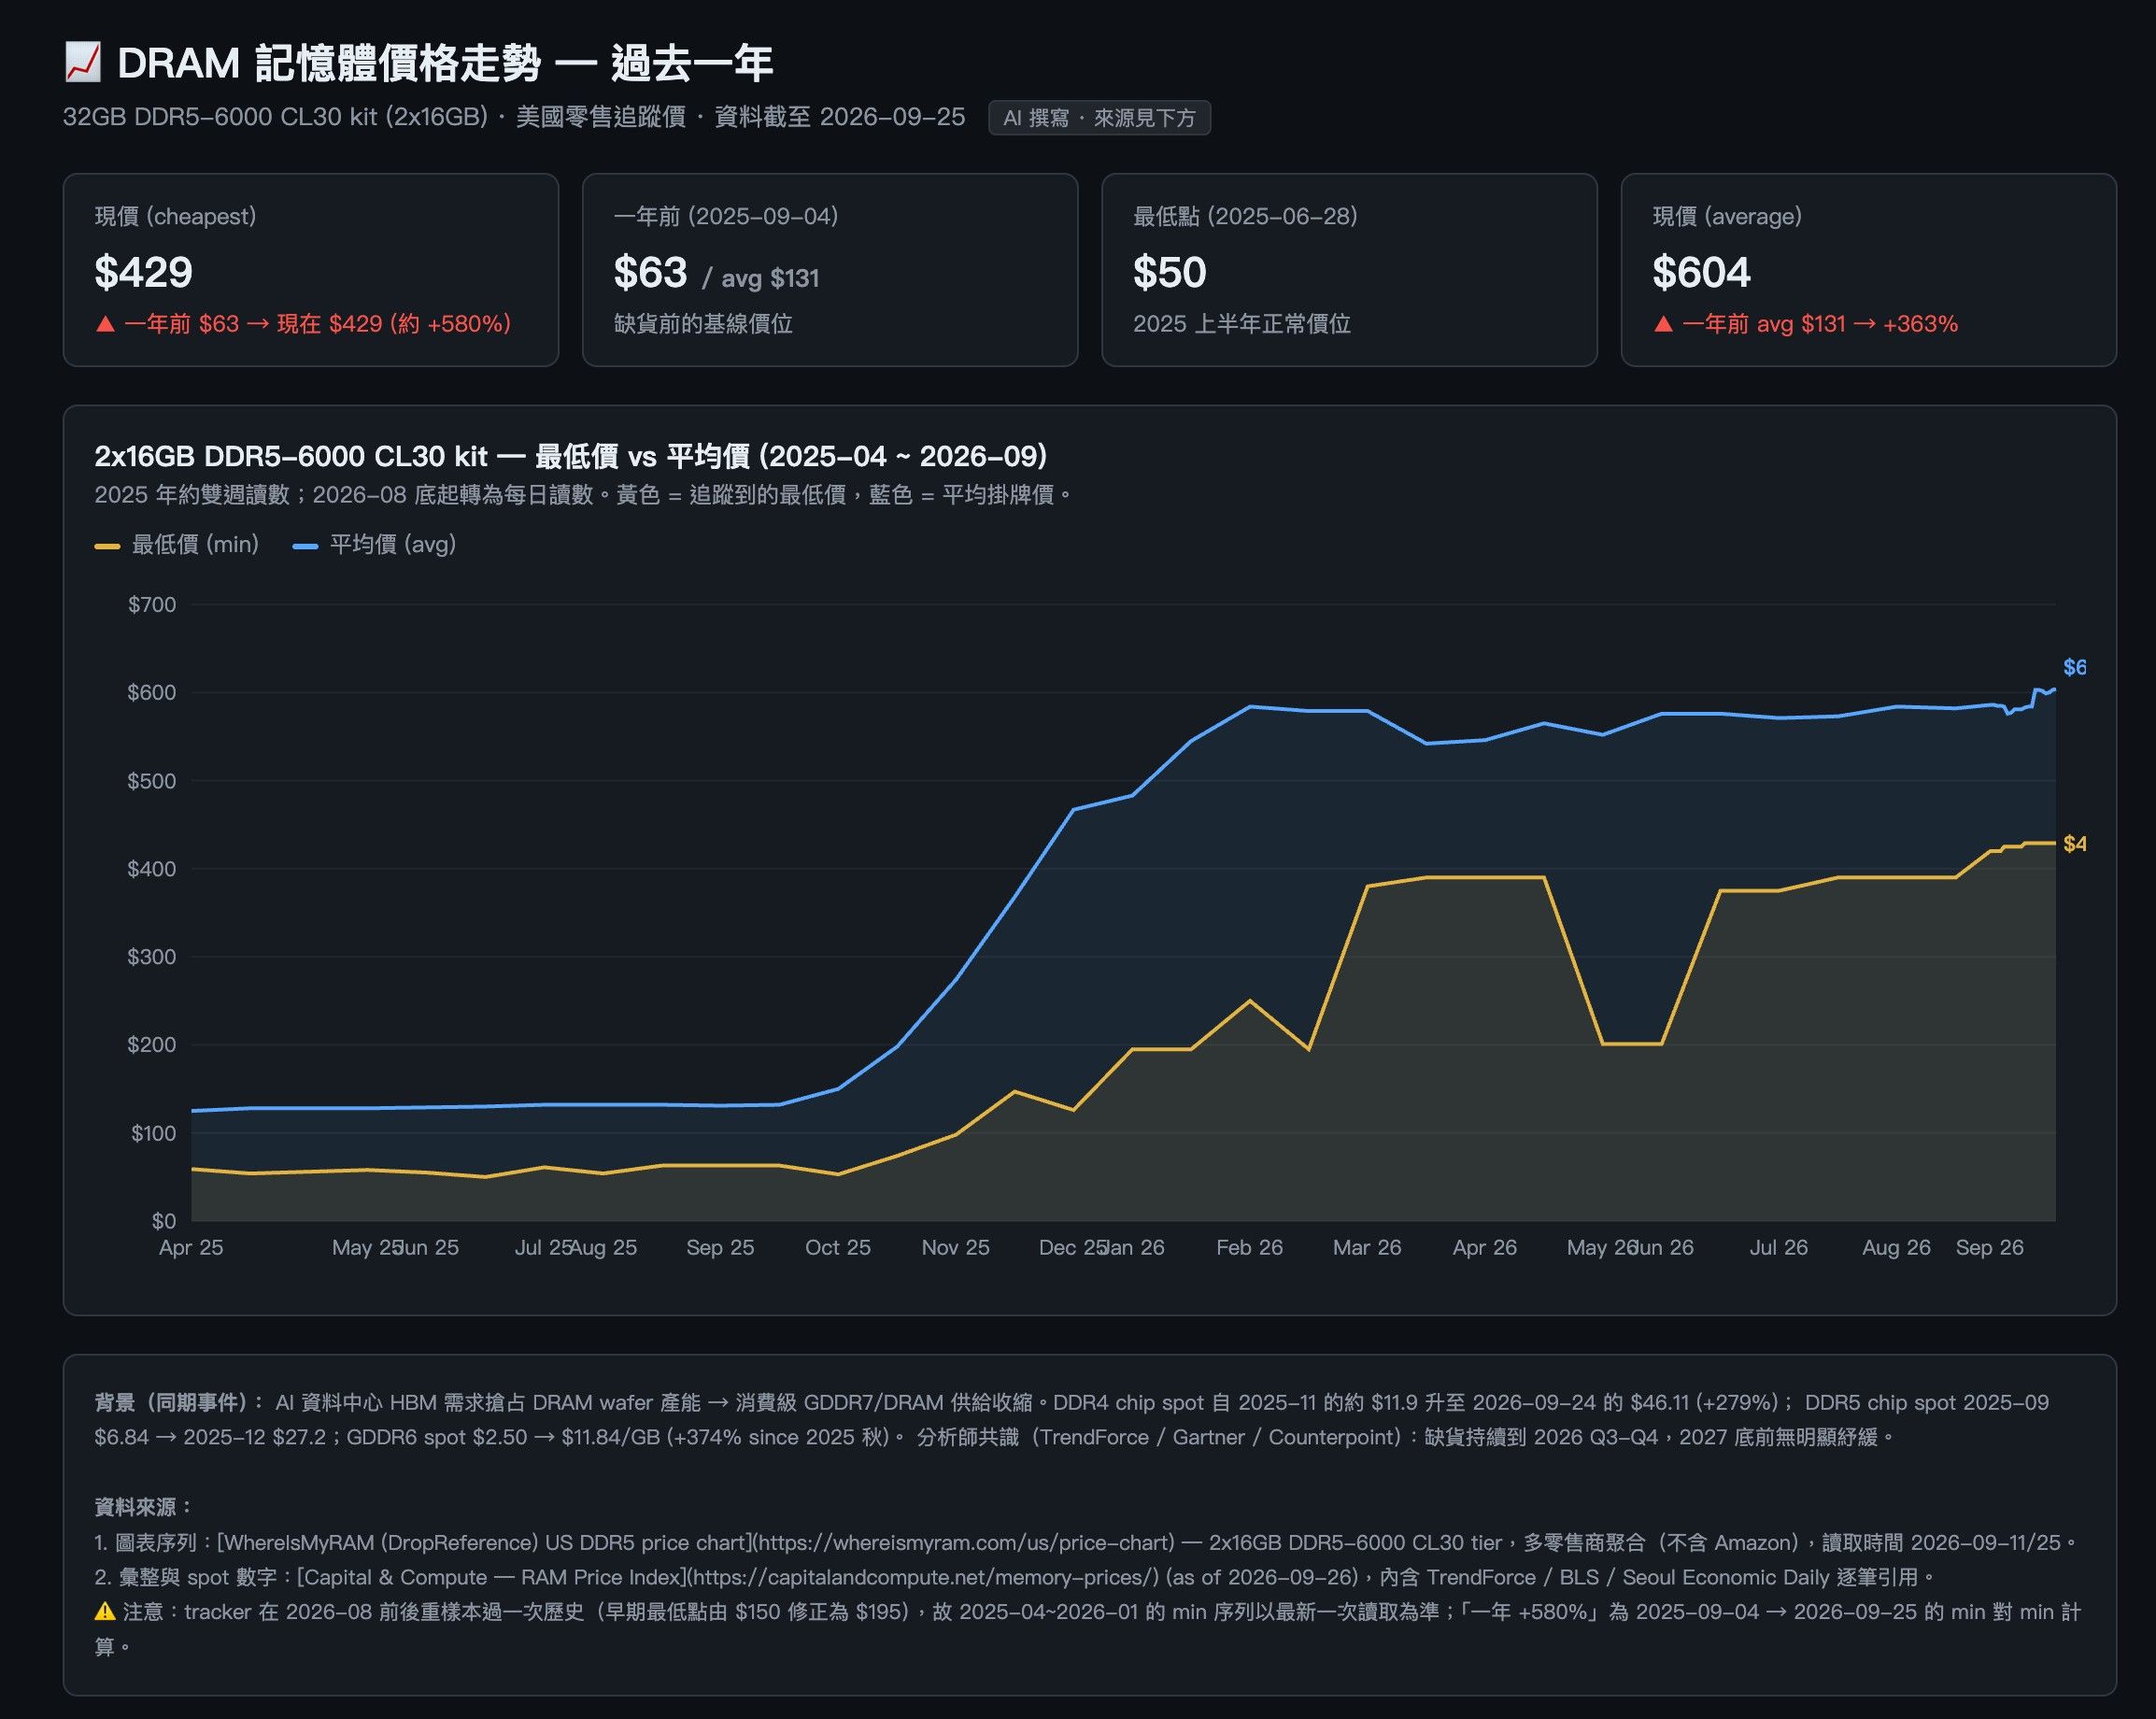
Strata-Swift15-Qwen3.8-Flash-IQ4_N 任務輸出品質約多出30%,任務輸出速度約快30%~70%(看任務複雜度)prompt : 製作一張過去一年記憶體走勢的圖表 in html
Strata-Swift15-Qwen3.8-Flash
LLama.cpp-Qwen3.8-27B-Q4_K_M.
-
-
-
-
测试了2个方案,还是觉得strata+flash-next更智能、更快。2张4090下,输出能200 t/s,prefill能到7600 t/s。能耗设置330W,温度不过60,GPU LOAD也能跑满。体感上速度和网络API差不多了
-
-
-
-
我本來也是27B用好一陣子 但Flash Next用過回不去了 速度與知識面差距太大
-
-
有没有这样一种可能,QFN有一定的量化感知能力,或者说作为MOE模型,它的自信心没有27B那么强。
导致QFN在对一件事没有把握的时候会反复重新思考,试图激活更多的参数,这样让答案的准确率更高? -
-
我感觉让flash 准备规划 然后dense 执行?

 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!