跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. LLM解題 極限測試 Extreme-Exam-v7-A (出題者 : GPT6-Astra-max)

LLM解題 極限測試 Extreme-Exam-v7-A (出題者 : GPT6-Astra-max)

已定时 已固定 已锁定 已移动 热议 随便聊聊
本地模型qwen-27bninfer
64 帖子 12 发布者 1.0k 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • stxpnetS stxpnet

    其实如果是让HERMES来做,允许用python会不会高一些呢?或者用插件。 有些数学的纯让它靠模型的词汇,应该要用不少思考TOKEN吧?

    kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 kos or 编辑
    #28

    @stxpnet said:

    允许用python会不会高一些呢?或者用插件

    yes, 如果是先在工具庫 提供給Agent 足夠多的 skills, tools, GPUs 我相信解題速度會飛快

    Joker Chang 的Agent (3090Ti+96G RAM+Xeon E5-2680 v4) 只花了25分鐘就解出了
    不清楚他的Agent為何解題這麼快?

    J 1 条回复 最后回复
    0
    • Tony WangT
      Tony WangT
      Tony Wang
      易有太极
      编写于 最后由 Tony Wang 编辑
      #29

      我觉得一开始模型是否能找到合适的方向,以及之前Agent是否有类似的经验.

      如果方向对了,或者Agent已经有了相关skill,那应该能大大提速.

      我是用的Hermes,它绝大部分时间都在自我纠错.

      kos orK 1 条回复 最后回复
      1
      • Tony WangT Tony Wang

        我觉得一开始模型是否能找到合适的方向,以及之前Agent是否有类似的经验.

        如果方向对了,或者Agent已经有了相关skill,那应该能大大提速.

        我是用的Hermes,它绝大部分时间都在自我纠错.

        kos orK
        kos orK
        kos or
        至尊皇帝
        编写于 最后由 编辑
        #30

        @Tony-Wang said:

        一开始模型是否能找到合适的方向,以及之前Agent是否有类似的经验

        進一步延伸設計 :
        這有點像是 Agentic MoE, 主Agent做路由 routing, 丟給專用的expert agent(subagent)去運作
        這架構可行, 不過會增加維護成本, 但處理特定領域的任務時 上下文(context)會乾淨很多

        1 条回复 最后回复
        0
        • Marck WongM
          Marck WongM
          Marck Wong
          编写于 最后由 编辑
          #31

          补一组本地测试结果:SC117-Qwen3.8-Flash-Next-IQ3_S + Strata + Codex Desktop,单张 RTX 5080。

          这次比较特别:中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关。 下面区分原始结果和事后复核,不把复核后的修正算成模型原本答对。

          测试环境

          项目 配置
          Model SC117-Qwen3.8-Flash-Next-IQ3_S
          Agent Codex Desktop;本机 App version 26.1007.2314.0
          Agent core 本次 session 记录的 Codex CLI 0.162.0-alpha.17.2
          Inference runtime Strata 0.1.43.1
          Reasoning effort high
          CPU AMD Ryzen 7 9700X,8 cores / 16 threads
          GPU NVIDIA GeForce RTX 5080,16 GB VRAM,单卡
          RAM 64 GB,2 × 32 GB Kingston DDR5-6000
          Motherboard MSI MAG B850M MORTAR WIFI
          OS Windows 11 Pro for Workstations
          Context Strata 128K(131,072 tokens);Agent session 报告可用 context 124,518 tokens
          Tools 允许编写和运行 Python,属于 Agent + tools 测试

          Model 名称由测试者确认;硬件、App/runtime version 在评分时从本机读取,Agent core、effort 和可用 context 来自原始 session log。

          耗时和 token 用量

          测试日期为 2026-10-13,以下时间均为 UTC+8。

          指标 本次结果
          开始 → 最终回复 20:20:45 → 22:47:53
          总耗时(wall time) 约 2 小时 27 分 8 秒
          首次计算出正确数值 21:11:47,开始后约 51 分 2 秒
          Model requests 223
          Input tokens,包含 cached input 16,320,789
          其中 cached input 14,903,261
          未缓存 input 1,417,528
          Output tokens,包含 reasoning 559,835
          其中 reasoning tokens 426,054,约占 output 的 76.1%
          Input + output 总量 16,880,624,约 16.88M
          平均 decode 速度 77.2 tok/s(Strata monitor 显示值)
          全程 output / wall time 63.4 tok/s(包含 prefill、tools 和其他等待)
          Context compaction 9 次

          统计取自这一个 chat 的 223 条 token usage records,逐条求和与最终累计值一致,也与测试时的 Strata monitor 截图总量对上。Cached input 已包含在 input 中,不能再加一次;reasoning 也已包含在 output 中。16.88M 是多轮累计处理量,不是一次装入 context 的长度。

          答案与评分

          • 标准答案:385583993536
          • 原始最终提交:583993536
          • 最终代码和证明使用:M = 10^9,原题要求:M = 10^12
          • 严格按最终答案 exact match:0/1,本次单题正确率 0%,未通关。 这不是对该 model 整体能力的正确率估计。
          • 按方法、实现和证明给予 partial credit:85/100,非官方主观评分。

          Partial-credit rubric:group action / Burnside 15/15;Möbius 与 product 条件 18/20;transfer / character 与 reflection 推导 22/25;精确 modular arithmetic 与可执行算法 15/15;可复现计算与数值检查 15/15;原题要求的最终答案 0/10。

          主要计数方法是成立的:正确处理了 h^k=e 的 block product 条件、两类 reflection、奇数 block length,以及先取模 2NM 再整除 2N。证明文字仍有几处需要修正,例如 period 子集定义、inverse-reflection 的 adjacency 等价表述,以及把 endpoint adjacency 说成自动成立,因此不能给满分。

          评分时未改动原始文件,只把两套最终实现的调用参数在内存中设回 M=10^12,两者都得到 385583993536。这说明最终错误确实与 modulus 参数有关,不是随机猜中了末九位。

          另用直接 brute-force enumeration 与两套实现重新核对 N=2…8,结果均为:
          1, 3, 6, 15, 63, 195, 717,即 7/7 small cases 通过。144 个 reflection component cases 也全部通过。原交付还记录了 N=9…13,但本次评分没有重跑该范围。

          为什么耗时这么久?

          从记录看,大量时间用于 reasoning、修改代码、独立实现和反复 verification:全程有 166 次 command execution、53 次 file-change 操作。首次得到正确数值后,又继续约 96 分钟才结束;期间后续实现引入了 M=10^9。

          所以这里的 2 小时 27 分钟是完整 Agent 作答成本,不是最终 Python 算法单次计算大 N 的耗时,也不能把 51 分钟的“首次正确数值”直接写成“完整通关时间”。77.2 tok/s 是 decode 指标,不能单靠它判断整题完成速度。

          本次记录能支持的结论是:这个 model 有能力构造有效计数算法并算出正确数值,但原始最终交付发生了参数错误,最终成绩必须据此判定。

          kos orK 2 条回复 最后回复
          1
          • Marck WongM Marck Wong

            补一组本地测试结果:SC117-Qwen3.8-Flash-Next-IQ3_S + Strata + Codex Desktop,单张 RTX 5080。

            这次比较特别:中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关。 下面区分原始结果和事后复核,不把复核后的修正算成模型原本答对。

            测试环境

            项目 配置
            Model SC117-Qwen3.8-Flash-Next-IQ3_S
            Agent Codex Desktop;本机 App version 26.1007.2314.0
            Agent core 本次 session 记录的 Codex CLI 0.162.0-alpha.17.2
            Inference runtime Strata 0.1.43.1
            Reasoning effort high
            CPU AMD Ryzen 7 9700X,8 cores / 16 threads
            GPU NVIDIA GeForce RTX 5080,16 GB VRAM,单卡
            RAM 64 GB,2 × 32 GB Kingston DDR5-6000
            Motherboard MSI MAG B850M MORTAR WIFI
            OS Windows 11 Pro for Workstations
            Context Strata 128K(131,072 tokens);Agent session 报告可用 context 124,518 tokens
            Tools 允许编写和运行 Python,属于 Agent + tools 测试

            Model 名称由测试者确认;硬件、App/runtime version 在评分时从本机读取,Agent core、effort 和可用 context 来自原始 session log。

            耗时和 token 用量

            测试日期为 2026-10-13,以下时间均为 UTC+8。

            指标 本次结果
            开始 → 最终回复 20:20:45 → 22:47:53
            总耗时(wall time) 约 2 小时 27 分 8 秒
            首次计算出正确数值 21:11:47,开始后约 51 分 2 秒
            Model requests 223
            Input tokens,包含 cached input 16,320,789
            其中 cached input 14,903,261
            未缓存 input 1,417,528
            Output tokens,包含 reasoning 559,835
            其中 reasoning tokens 426,054,约占 output 的 76.1%
            Input + output 总量 16,880,624,约 16.88M
            平均 decode 速度 77.2 tok/s(Strata monitor 显示值)
            全程 output / wall time 63.4 tok/s(包含 prefill、tools 和其他等待)
            Context compaction 9 次

            统计取自这一个 chat 的 223 条 token usage records,逐条求和与最终累计值一致,也与测试时的 Strata monitor 截图总量对上。Cached input 已包含在 input 中,不能再加一次;reasoning 也已包含在 output 中。16.88M 是多轮累计处理量,不是一次装入 context 的长度。

            答案与评分

            • 标准答案:385583993536
            • 原始最终提交:583993536
            • 最终代码和证明使用:M = 10^9,原题要求:M = 10^12
            • 严格按最终答案 exact match:0/1,本次单题正确率 0%,未通关。 这不是对该 model 整体能力的正确率估计。
            • 按方法、实现和证明给予 partial credit:85/100,非官方主观评分。

            Partial-credit rubric:group action / Burnside 15/15;Möbius 与 product 条件 18/20;transfer / character 与 reflection 推导 22/25;精确 modular arithmetic 与可执行算法 15/15;可复现计算与数值检查 15/15;原题要求的最终答案 0/10。

            主要计数方法是成立的:正确处理了 h^k=e 的 block product 条件、两类 reflection、奇数 block length,以及先取模 2NM 再整除 2N。证明文字仍有几处需要修正,例如 period 子集定义、inverse-reflection 的 adjacency 等价表述,以及把 endpoint adjacency 说成自动成立,因此不能给满分。

            评分时未改动原始文件,只把两套最终实现的调用参数在内存中设回 M=10^12,两者都得到 385583993536。这说明最终错误确实与 modulus 参数有关,不是随机猜中了末九位。

            另用直接 brute-force enumeration 与两套实现重新核对 N=2…8,结果均为:
            1, 3, 6, 15, 63, 195, 717,即 7/7 small cases 通过。144 个 reflection component cases 也全部通过。原交付还记录了 N=9…13,但本次评分没有重跑该范围。

            为什么耗时这么久?

            从记录看,大量时间用于 reasoning、修改代码、独立实现和反复 verification:全程有 166 次 command execution、53 次 file-change 操作。首次得到正确数值后,又继续约 96 分钟才结束;期间后续实现引入了 M=10^9。

            所以这里的 2 小时 27 分钟是完整 Agent 作答成本,不是最终 Python 算法单次计算大 N 的耗时,也不能把 51 分钟的“首次正确数值”直接写成“完整通关时间”。77.2 tok/s 是 decode 指标,不能单靠它判断整题完成速度。

            本次记录能支持的结论是:这个 model 有能力构造有效计数算法并算出正确数值,但原始最终交付发生了参数错误,最终成绩必须据此判定。

            kos orK
            kos orK
            kos or
            至尊皇帝
            编写于 最后由 编辑
            #32

            @Marck-Wong said:
            SC117-Qwen3.8-Flash-Next-IQ3_S + Strata
            中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关

            SC117 可能是Uncensored 版本的 或許權重路徑影響到一些LLM行為

            Marck WongM johnnybegoodJ 2 条回复 最后回复
            0
            • Marck WongM Marck Wong

              补一组本地测试结果:SC117-Qwen3.8-Flash-Next-IQ3_S + Strata + Codex Desktop,单张 RTX 5080。

              这次比较特别:中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关。 下面区分原始结果和事后复核,不把复核后的修正算成模型原本答对。

              测试环境

              项目 配置
              Model SC117-Qwen3.8-Flash-Next-IQ3_S
              Agent Codex Desktop;本机 App version 26.1007.2314.0
              Agent core 本次 session 记录的 Codex CLI 0.162.0-alpha.17.2
              Inference runtime Strata 0.1.43.1
              Reasoning effort high
              CPU AMD Ryzen 7 9700X,8 cores / 16 threads
              GPU NVIDIA GeForce RTX 5080,16 GB VRAM,单卡
              RAM 64 GB,2 × 32 GB Kingston DDR5-6000
              Motherboard MSI MAG B850M MORTAR WIFI
              OS Windows 11 Pro for Workstations
              Context Strata 128K(131,072 tokens);Agent session 报告可用 context 124,518 tokens
              Tools 允许编写和运行 Python,属于 Agent + tools 测试

              Model 名称由测试者确认;硬件、App/runtime version 在评分时从本机读取,Agent core、effort 和可用 context 来自原始 session log。

              耗时和 token 用量

              测试日期为 2026-10-13,以下时间均为 UTC+8。

              指标 本次结果
              开始 → 最终回复 20:20:45 → 22:47:53
              总耗时(wall time) 约 2 小时 27 分 8 秒
              首次计算出正确数值 21:11:47,开始后约 51 分 2 秒
              Model requests 223
              Input tokens,包含 cached input 16,320,789
              其中 cached input 14,903,261
              未缓存 input 1,417,528
              Output tokens,包含 reasoning 559,835
              其中 reasoning tokens 426,054,约占 output 的 76.1%
              Input + output 总量 16,880,624,约 16.88M
              平均 decode 速度 77.2 tok/s(Strata monitor 显示值)
              全程 output / wall time 63.4 tok/s(包含 prefill、tools 和其他等待)
              Context compaction 9 次

              统计取自这一个 chat 的 223 条 token usage records,逐条求和与最终累计值一致,也与测试时的 Strata monitor 截图总量对上。Cached input 已包含在 input 中,不能再加一次;reasoning 也已包含在 output 中。16.88M 是多轮累计处理量,不是一次装入 context 的长度。

              答案与评分

              • 标准答案:385583993536
              • 原始最终提交:583993536
              • 最终代码和证明使用:M = 10^9,原题要求:M = 10^12
              • 严格按最终答案 exact match:0/1,本次单题正确率 0%,未通关。 这不是对该 model 整体能力的正确率估计。
              • 按方法、实现和证明给予 partial credit:85/100,非官方主观评分。

              Partial-credit rubric:group action / Burnside 15/15;Möbius 与 product 条件 18/20;transfer / character 与 reflection 推导 22/25;精确 modular arithmetic 与可执行算法 15/15;可复现计算与数值检查 15/15;原题要求的最终答案 0/10。

              主要计数方法是成立的:正确处理了 h^k=e 的 block product 条件、两类 reflection、奇数 block length,以及先取模 2NM 再整除 2N。证明文字仍有几处需要修正,例如 period 子集定义、inverse-reflection 的 adjacency 等价表述,以及把 endpoint adjacency 说成自动成立,因此不能给满分。

              评分时未改动原始文件,只把两套最终实现的调用参数在内存中设回 M=10^12,两者都得到 385583993536。这说明最终错误确实与 modulus 参数有关,不是随机猜中了末九位。

              另用直接 brute-force enumeration 与两套实现重新核对 N=2…8,结果均为:
              1, 3, 6, 15, 63, 195, 717,即 7/7 small cases 通过。144 个 reflection component cases 也全部通过。原交付还记录了 N=9…13,但本次评分没有重跑该范围。

              为什么耗时这么久?

              从记录看,大量时间用于 reasoning、修改代码、独立实现和反复 verification:全程有 166 次 command execution、53 次 file-change 操作。首次得到正确数值后,又继续约 96 分钟才结束;期间后续实现引入了 M=10^9。

              所以这里的 2 小时 27 分钟是完整 Agent 作答成本,不是最终 Python 算法单次计算大 N 的耗时,也不能把 51 分钟的“首次正确数值”直接写成“完整通关时间”。77.2 tok/s 是 decode 指标,不能单靠它判断整题完成速度。

              本次记录能支持的结论是:这个 model 有能力构造有效计数算法并算出正确数值,但原始最终交付发生了参数错误,最终成绩必须据此判定。

              kos orK
              kos orK
              kos or
              至尊皇帝
              编写于 最后由 编辑
              #33
              此主題已被删除!
              1 条回复 最后回复
              0
              • kos orK kos or

                @Marck-Wong said:
                SC117-Qwen3.8-Flash-Next-IQ3_S + Strata
                中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关

                SC117 可能是Uncensored 版本的 或許權重路徑影響到一些LLM行為

                Marck WongM
                Marck WongM
                Marck Wong
                编写于 最后由 编辑
                #34

                @kos-or 本地模型不用Uncensored 有点对不起中男骚动的心

                1 条回复 最后回复
                1
                • kos orK kos or

                  @Marck-Wong said:
                  SC117-Qwen3.8-Flash-Next-IQ3_S + Strata
                  中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关

                  SC117 可能是Uncensored 版本的 或許權重路徑影響到一些LLM行為

                  johnnybegoodJ
                  johnnybegoodJ
                  johnnybegood
                  王侯将相
                  编写于 最后由 编辑
                  #35

                  @kos-or

                  我刚用本地 GLM 5.3 Flash 跑完(Maya-M), 结果让我很失望, 跑了 30分钟, 最后出来个 r = 62500000000

                  答案错了

                  但是模型也说了, 它觉得错误的概率也挺大。

                  这。。。

                  我准备加一些限定词让他再跑一遍。

                  kos orK 1 条回复 最后回复
                  1
                  • johnnybegoodJ johnnybegood

                    @kos-or

                    我刚用本地 GLM 5.3 Flash 跑完(Maya-M), 结果让我很失望, 跑了 30分钟, 最后出来个 r = 62500000000

                    答案错了

                    但是模型也说了, 它觉得错误的概率也挺大。

                    这。。。

                    我准备加一些限定词让他再跑一遍。

                    kos orK
                    kos orK
                    kos or
                    至尊皇帝
                    编写于 最后由 编辑
                    #36

                    @johnnybegood said:

                    我刚用本地 GLM 5.3 Flash 跑完(Maya-M), 结果让我很失望, 跑了 30分钟

                    能否用線上GLM5.3 模型先測試一下 比較快 ? 說不定也有問題 不見得能拿到滿分
                    我OpenCode沒使用了 無法測試線上GLM5.3 API, 目前線上只能用Codex

                    1 条回复 最后回复
                    0
                    • kos orK
                      kos orK
                      kos or
                      至尊皇帝
                      编写于 最后由 kos or 编辑
                      #37

                      @johnnybegood

                      這個評分是正確答案提供給ChatGPT SOL high後, 它來在同一個chat session中評分的

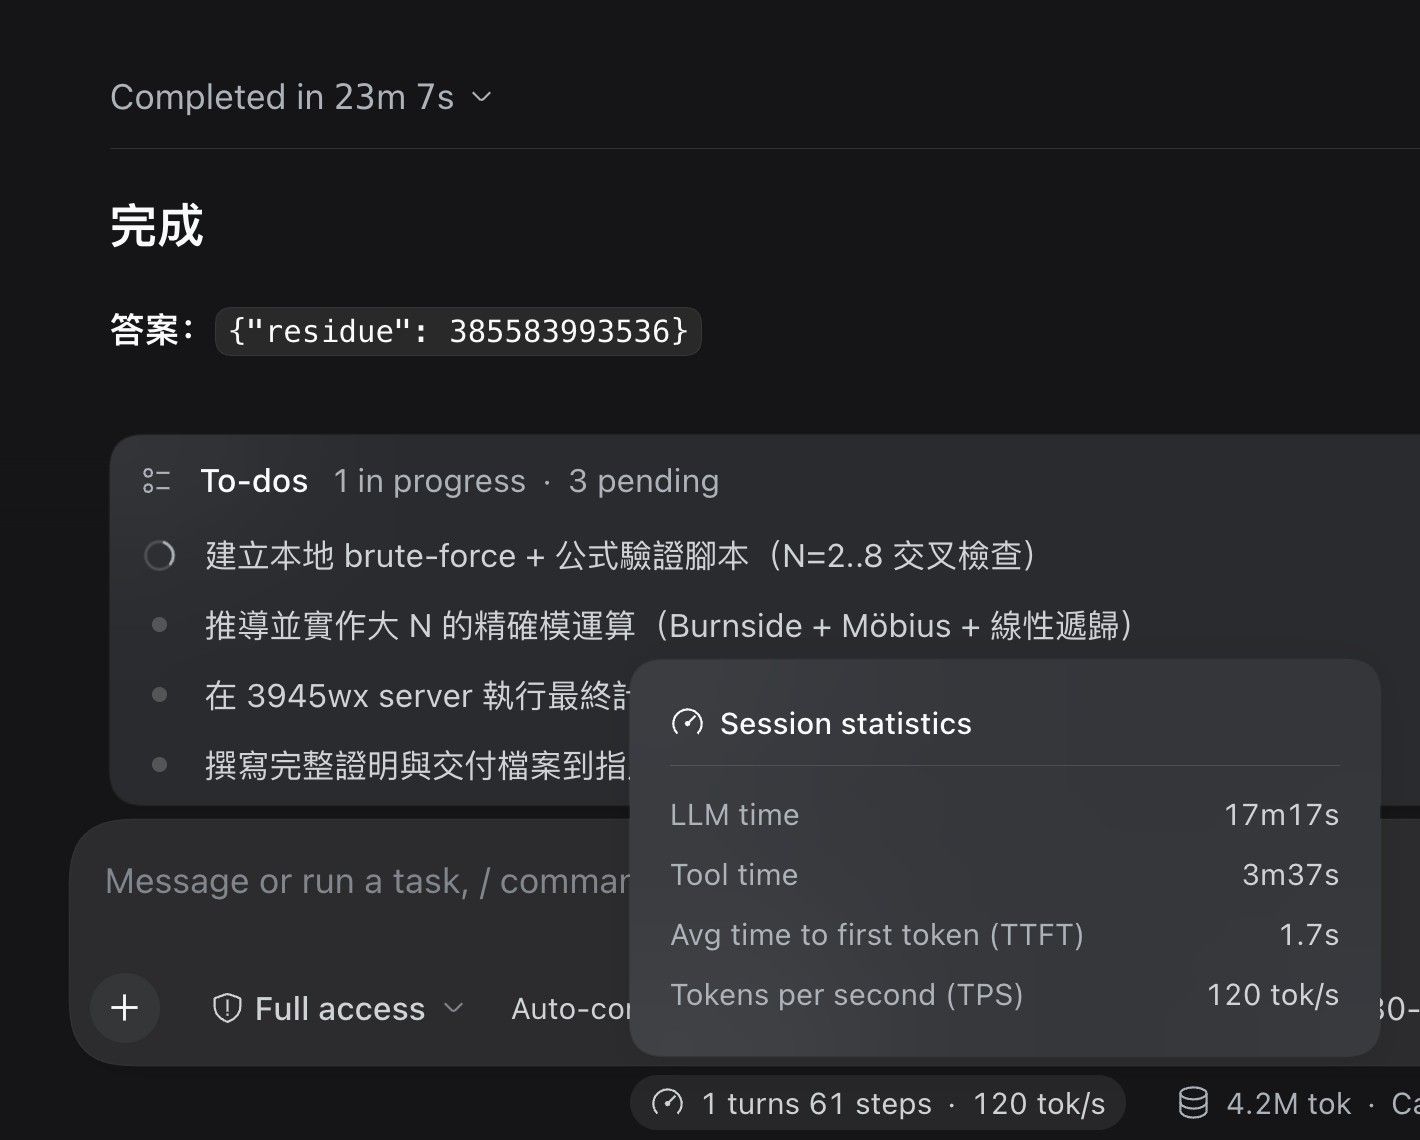
                      看來這個最快 雙卡 RTX5070 Ti + DSH + LLM07 — Strata-Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS + Reasoning Low

                      其他的都要跑好久 , 可能跟 Context Window / Max output token setting 有關, 思考一多
                      上下文就會壓縮compaction, 失去早期的推理鏈CoT

                      1 条回复 最后回复
                      0
                      • kos orK kos or

                        @joker_chang said:

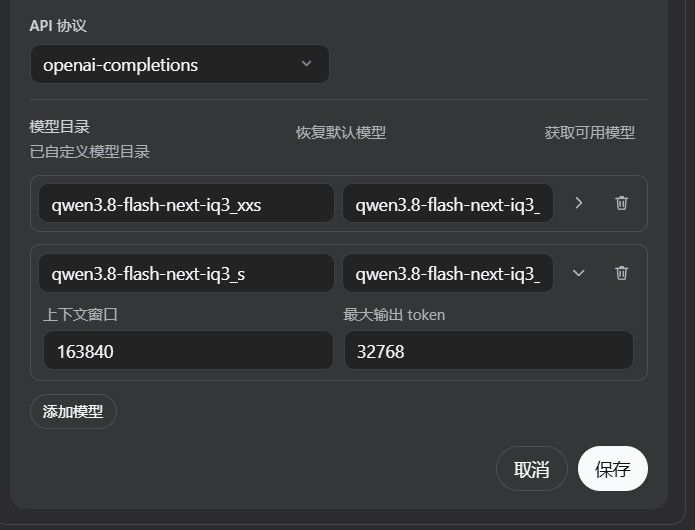
                        qwen3.8-flash-next-iq3_s+128K上下文,完成测试,用量 4.6M tok、用时 25分10秒。

                        25分10秒是我見過解題速度最快的 (我用Qwen3.8-27B-NVFP-NInfer ctx225k大約在3~4個小時)
                        難道128K上下文有利於解題速度?
                        請問以下Max output tokens 你設置多少搭配128K上下文呢?
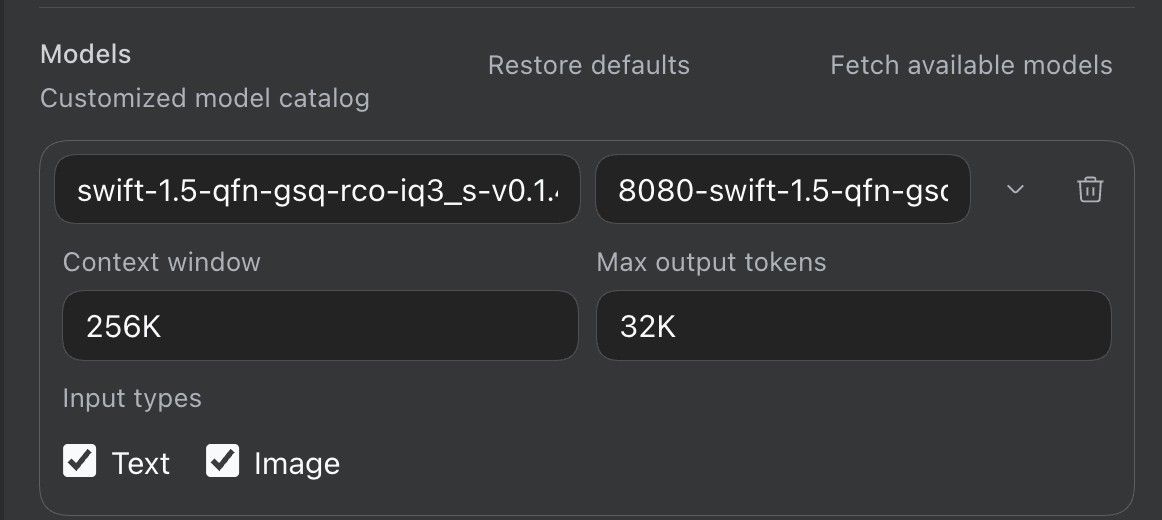
                        image.jpeg

                        J
                        J
                        joker_chang
                        体面乡绅 硕果累累
                        编写于 最后由 编辑
                        #38

                        @kos-or 我在DSH中的模型设置
                        image.jpeg

                        1 条回复 最后回复
                        0
                        • kos orK kos or

                          @stxpnet said:

                          允许用python会不会高一些呢?或者用插件

                          yes, 如果是先在工具庫 提供給Agent 足夠多的 skills, tools, GPUs 我相信解題速度會飛快

                          Joker Chang 的Agent (3090Ti+96G RAM+Xeon E5-2680 v4) 只花了25分鐘就解出了
                          不清楚他的Agent為何解題這麼快?

                          J
                          J
                          joker_chang
                          体面乡绅 硕果累累
                          编写于 最后由 joker_chang 编辑
                          #39

                          @kos-or DSH完成任务共有64 次工具调用,session 日志:
                          dsh-session-session-49ec30f7-29db-46bc-81d2-60d520dca910.zip

                          J 1 条回复 最后回复
                          0
                          • kos orK kos or

                            評分前
                            請先把以下正確答案丟給線上模型分析後;
                            再把受測目標LLM的輸出解果丟給線上模型對照評分即可

                            正確解答和說明:

                            Extreme-Exam-V7-A-PROOF
                            
                            # A:精確計數與唯一答案證明(私有裁判)
                            
                            答案是 **385583993536**。本文件及同目錄工具不得提供給受測者。
                            
                            ## 1. 被計數的唯一物件
                            
                            解是公開定義的軌道數模 10¹² 的最小非負餘數。字串、群元與軌道都是有限且無歧義的集合;以下給出完備計數。沒有預植字串,也沒有以字典序挑一個多解 witness。
                            
                            旋轉把群乘積改為共軛,取逆反射把乘積改為逆元的共軛。因此乘積為 e 的條件在全部操作下不變;相鄰不等及最小週期也保持。公開操作構成大小 2N 的二面體群作用。
                            
                            ## 2. 週期消去不能把區塊乘積固定成 e
                            
                            對任意 d≥1、k≥1,令 T(d,k) 是長 d 的環狀相鄰不等字串,且其乘積 h 滿足 hᵏ=e 的數量。令 μ 是 Möbius 函數。
                            
                            長 N 字串如果是長 d=N/k 的區塊重複 k 次,全串乘積就是 hᵏ。因此原始合格字串數恰為
                            
                            P = Σ_{k|N} μ(k) T(N/k,k)。
                            
                            這是對每個全長字串的週期指示函數作 Möbius 反演;只需 64 個平方自由 k。群為 S₃,h 的階僅有 1、2、3,所以 T(d,k) 只依賴 gcd(k,6)。若先要求區塊 h=e,會漏掉重複後才變為 e 的區塊。
                            
                            ## 3. 反射固定點與週期消去
                            
                            令 V、E 分別為原始合格字串中 S₀、S₁ 的固定點數。N 是偶數,因此 N/2 個反射屬於每一類。對原始字串,除恆等旋轉之外沒有旋轉固定點。Burnside 公式給出
                            
                            軌道數 = [ P + (N/2)(V+E) ] / (2N)。
                            
                            週期 d 的字串被 S_r 固定,等價於區塊滿足 b_i=b_{r−i}^{−1}(索引模 d)。故可以在各反射的固定點集合內使用同樣的 Möbius 反演:V=Σμ(k)V(N/k,k),E=Σμ(k)E(N/k,k)。以下完整給出 V(d,k)、E(d,k)。
                            
                            記 I 為三個換位,C 為兩個三循環,D 為五字母上無自迴路的鄰接矩陣:D_ab=1 當且僅當 a≠b。令
                            
                            - E₀(m)=1_Cᵀ Dᵐ 1_C。
                            - O₀(m)=1_Iᵀ Dᵐ 1_C。
                            - U₀(m)=1_Iᵀ Dᵐ 1_I。
                            
                            若 d=2m:
                            
                            - 邊軸反射的字串由長 m 路徑及其取逆反序組成。群乘積自動為 e;兩端必須是非自逆字母,才能通過兩個接縫。因此 E(d,k)=E₀(m−1)。
                            - 頂點軸反射的字串可唯一寫成 `(s,a₁,…,aₘ₋₁,t,aₘ₋₁⁻¹,…,a₁⁻¹)`,其中 s,t∈I。設 Q=a₁⋯aₘ₋₁,乘積為 sQtQ⁻¹,是兩個換位的乘積,階為 1 或 3。
                            - 若 3|k,所有端點換位都允許,V(d,k)=U₀(m)。
                            - 若 3∤k,必須 t=Q⁻¹sQ。追蹤 `(last,c)`,其中 c=Q⁻¹sQ。起始狀態為 `(s,s)`,每次選 a≠last,更新 `(a,a⁻¹ca)`。共 15 個狀態。走 m−1 步,只接受 last≠c 的終點。這個數量記 V₀(m−1),即 V(d,k)。
                            
                            若 d=2m+1,所有反射同類。固定字串可唯一寫成 `(s,a₁,…,aₘ,aₘ⁻¹,…,a₁⁻¹)`,s∈I;群乘積就是 s,要求 k 為偶數。接縫使 aₘ∈C,故當 m≥1 且 2|k 時,V(d,k)=E(d,k)=O₀(m)。其他情況為零。d=1 時自鄰必然相等,亦為零。
                            
                            由於 N 的 2-adic 次數恰為 1,偶數 k 確實會產生奇數 d;不能略過這一情況。
                            
                            ## 4. T 的完整轉移計數
                            
                            使用 30 個狀態 `(last,g)`,last 為五個字母之一、g∈S₃。每一步選 a≠last,轉移至 `(a,ga)`。對每個起始字母 s,從 `(s,e)` 走 d 步,接受 `(s,h)` 且 hᵏ=e 的狀態並加總。
                            
                            所記錄的長 d 路徑對應字串 `s,a₁,…,a_{d−1}`,最後一次轉移回 s;群累積為 `a₁⋯a_{d−1}s`,與從 s 開始的字串乘積共軛。接受條件依群元階而定,故完全相同。這個對應是一對一,不多算也不漏算。
                            
                            ## 5. 算術證書與獨立驗證
                            
                            參考工具 `solve_a.py` 由轉移矩陣求出可直接驗證的消去多項式,再用多項式模冪計算長度。30 維矩陣的最小多項式次數實際只有 9;15 維矩陣為 7;D 為 2。這是實際有效縮減,不應用名目字串數宣稱計算困難。
                            
                            `A-certificate.json` 保存全部遞迴式、初值、64 個反演項與提升模數後的中間值。另一份工具 `check_a.py` **不讀參考遞迴式**,直接對 30、15、5 維整數矩陣做二進位模冪,得到同一答案。它另外逐字枚舉 N=2,…,9,直接建立旋轉/取逆反射軌道,與公式全部相符。
                            
                            在模數 L=2NM 下計算 Burnside 分子,得到 s∈[0,L)。由整數群作用計數可知真分子可被 2N 整除;L 也可被 2N 整除,故 s 同樣整除。用普通整數除法 s/(2N),得到的正是軌道數模 M 的最小非負餘數。全程沒有在模 M 下使用不存在的逆元。
                            
                            完整計數公式、語義對應及精確有限算術排除了任何不同的合法餘數。不同程式與證書可表示同一答案,不要求它們唯一。


                            ChatGPT 解釋給國小學生聽的圖卡 (感謝 imbiplaza ASUS提供的原始圖檔)
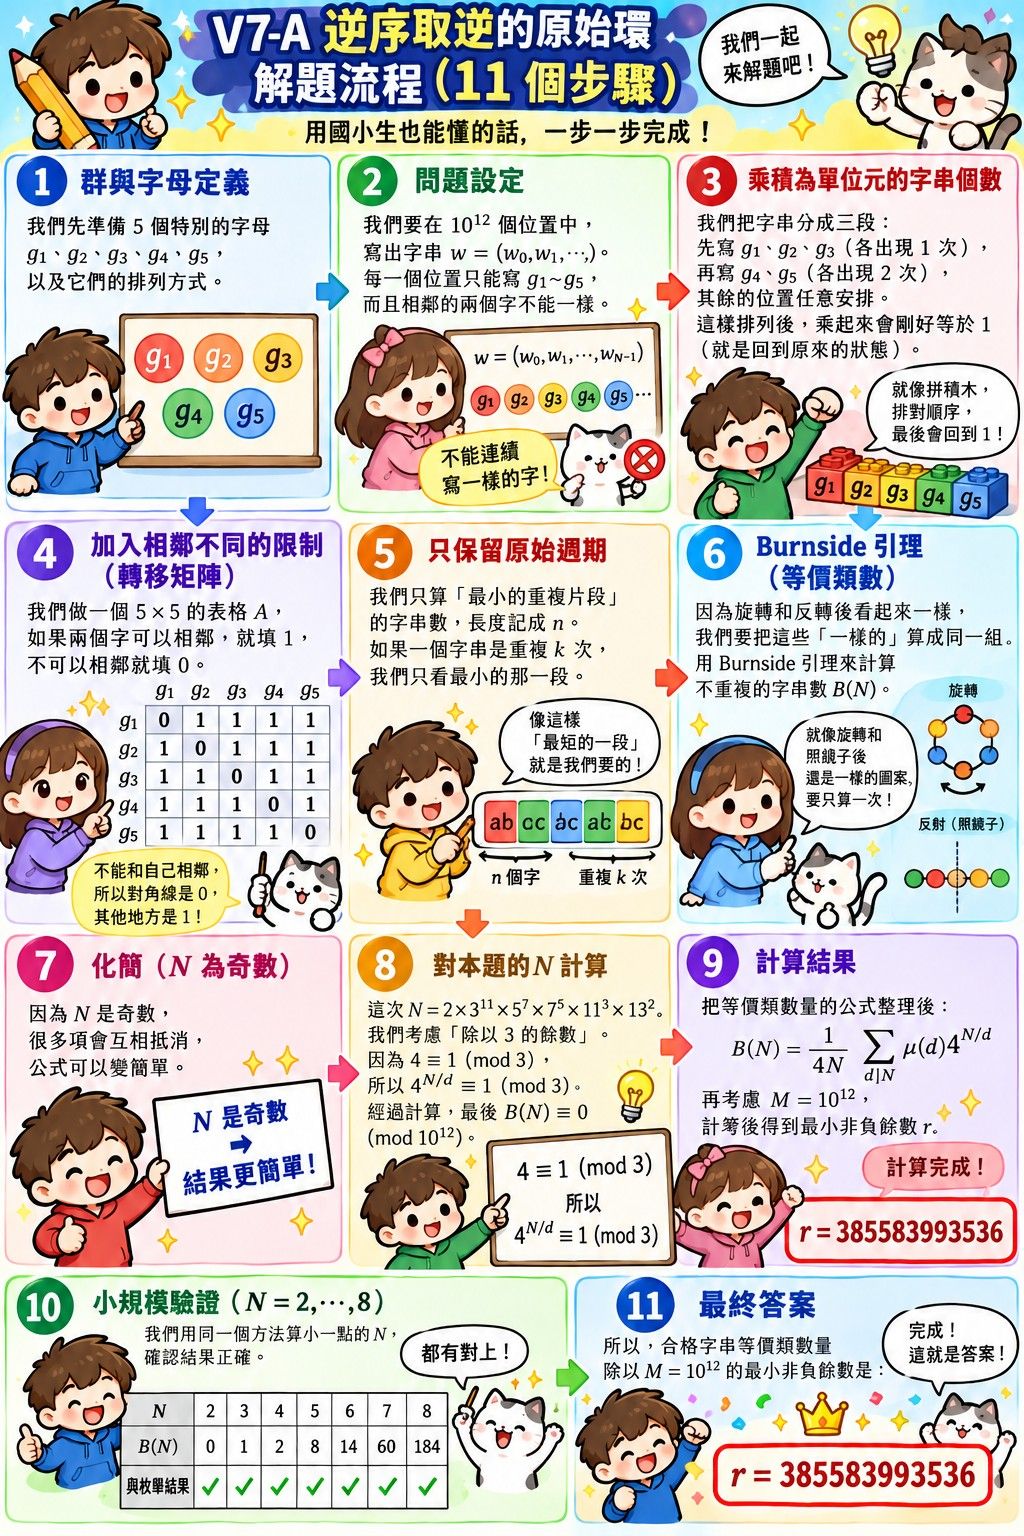
                            image.jpeg

                            johnnybegoodJ
                            johnnybegoodJ
                            johnnybegood
                            王侯将相
                            编写于 最后由 编辑
                            #40

                            @kos-or 又用 GLM5.3 Flash (Maya-L) 跑了一遍, 还是出错。 10^12 弄成 10^6 , 只给了后六位的结果, 倒是数字对, 可是不知道为什么截断了。

                            我个人感觉, 这种复杂的数学题, 说不定用小模型的 8bit版本, 算的都比大模型的 2-3bit 版本来得好。 数学计算就是需要精确, 所以还是量化bit数比较重要。

                            kos orK 1 条回复 最后回复
                            0
                            • J joker_chang

                              @kos-or DSH完成任务共有64 次工具调用,session 日志:
                              dsh-session-session-49ec30f7-29db-46bc-81d2-60d520dca910.zip

                              J
                              J
                              joker_chang
                              体面乡绅 硕果累累
                              编写于 最后由 编辑
                              #41

                              我将模型切换到ninfer-3090,其它都不变,然后任务跑不完,全是中断,dsh不断告诉我”已达到输出 token 上限回答被截断,已有输出保留在对话中。发送“继续”可让模型接着输出。“

                              我觉得就是模型的问题,qwen3.8-27b的思考模式ninfer应该是默认打开的,thinking也算入了输入token。
                              image.jpeg

                              kos orK 1 条回复 最后回复
                              0
                              • kos orK
                                kos orK
                                kos or
                                至尊皇帝
                                编写于 最后由 kos or 编辑
                                #42

                                @joker_chang

                                這一題的reasoning推論過程很長,越少遇到上下文壓縮越好,模型可以避免失去中間的推論過程
                                我不確定 Max Output tokens 設置多少比較好
                                這次用了 Context Window 256K / Max output 100K 得出的速度(答題時間)和輸出品質不錯

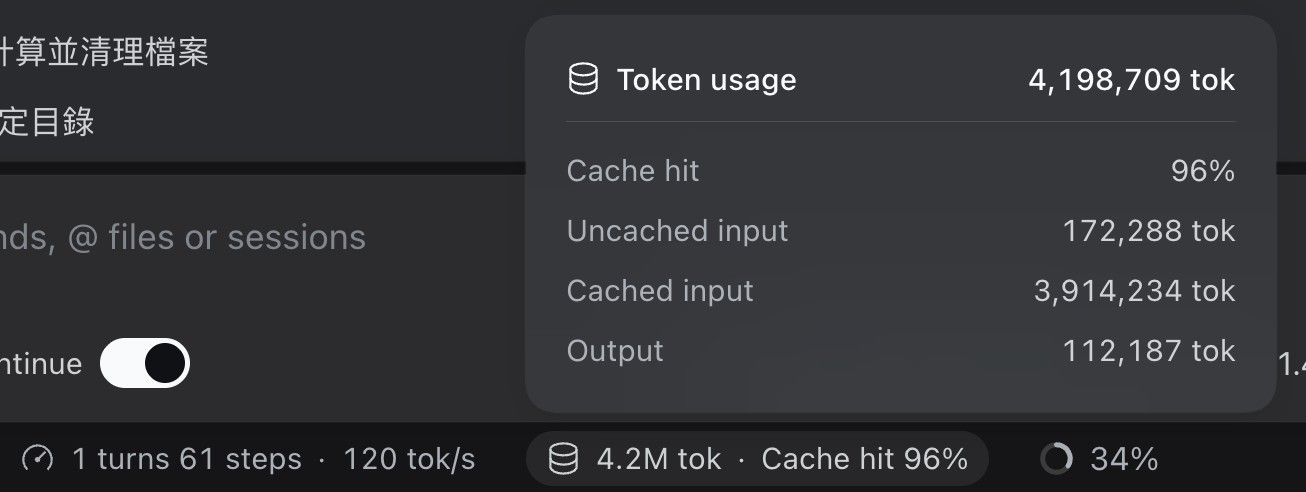
                                單卡 5070 Ti + Strata-v0.1.43-QFN-IQ3_S + DSH + Context Window 256K / Max output 100K
                                做了A/B Test - Reasoning Low vs. High/xHigh
                                本來還以為開Reasoning High/xHigh 會過度思考 不過這次反而更快找到答案,

                                評價官 GPT5.6-SOL : " 這次 xHigh run 進一步支持一件事:IQ3_S 本身完全沒有顯示 V7-A 級別的 reasoning cliff(推論能力大減);同一 3-bit-ish quantization 在 Low 與 xHigh 都能達到接近滿分,差異主要落在 verification discipline,而不是「能不能解出來」。"
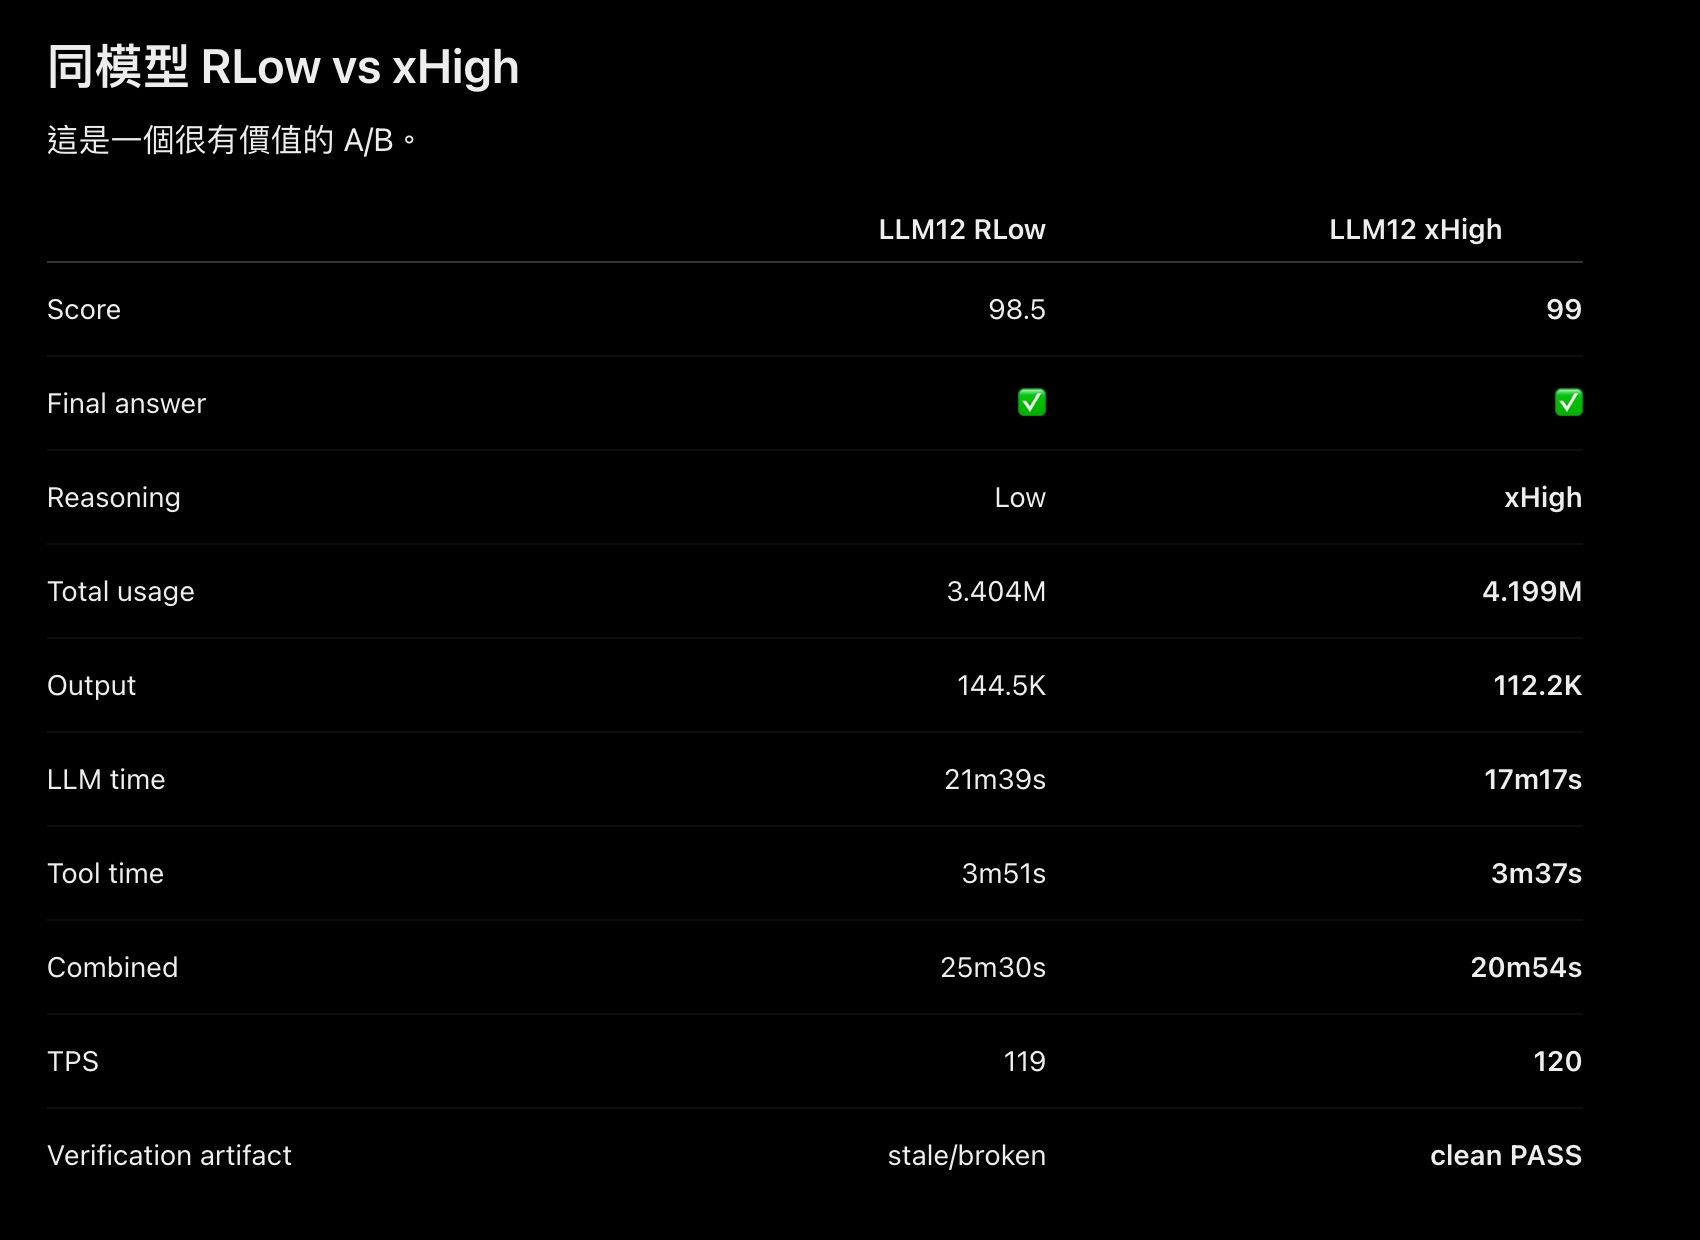
                                image.jpeg

                                xHigh的數據

                                image.jpeg

                                image.jpeg

                                johnnybegoodJ 1 条回复 最后回复
                                0
                                • J joker_chang

                                  我将模型切换到ninfer-3090,其它都不变,然后任务跑不完,全是中断,dsh不断告诉我”已达到输出 token 上限回答被截断,已有输出保留在对话中。发送“继续”可让模型接着输出。“

                                  我觉得就是模型的问题,qwen3.8-27b的思考模式ninfer应该是默认打开的,thinking也算入了输入token。
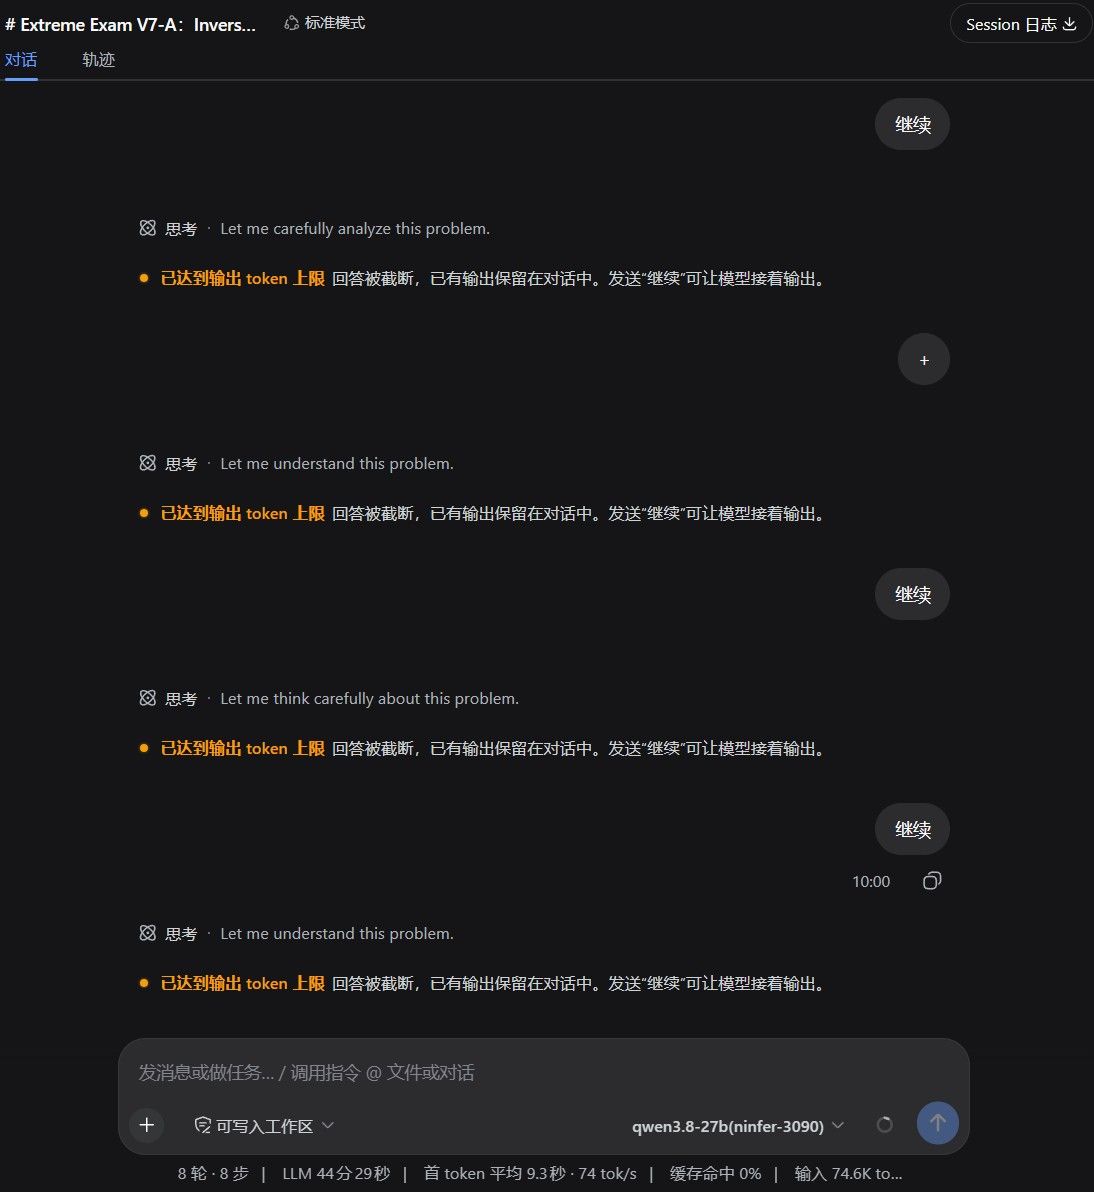
                                  image.jpeg

                                  kos orK
                                  kos orK
                                  kos or
                                  至尊皇帝
                                  编写于 最后由 编辑
                                  #43

                                  @joker_chang said:

                                  务跑不完,全是中断,dsh不断告诉我”已达到输出 token 上限回答被截断,已有输出保留在对话中。发送“继续”可让模型接着输出

                                  因為max output token 用完了 就要手動continue
                                  可以安裝plug-in auto continue 自動繼續跑 不用手動

                                  dsh-client-auto-continue(外掛,已裝、已啟用)
                                  已掛進 web profile 的 bundles:package.json(dsh-base + dsh-web-app + dsh-client-auto-continue,版本 0.14.1)
                                  設定條目在 cordis.patch.yml:159-162,目前只覆寫 locale: en,其餘走內建預設

                                  1 条回复 最后回复
                                  0
                                  • johnnybegoodJ johnnybegood

                                    @kos-or 又用 GLM5.3 Flash (Maya-L) 跑了一遍, 还是出错。 10^12 弄成 10^6 , 只给了后六位的结果, 倒是数字对, 可是不知道为什么截断了。

                                    我个人感觉, 这种复杂的数学题, 说不定用小模型的 8bit版本, 算的都比大模型的 2-3bit 版本来得好。 数学计算就是需要精确, 所以还是量化bit数比较重要。

                                    kos orK
                                    kos orK
                                    kos or
                                    至尊皇帝
                                    编写于 最后由 编辑
                                    #44

                                    @johnnybegood said:

                                    说不定用小模型的 8bit版本, 算的都比大模型的 2-3bit 版本来得好。 数学计算就是需要精确, 所以还是量化bit数比较重要。

                                    的確, 或許是 GLM5.3 Flash (Maya-L)壓縮過度,產生了reasoning cliff (推論斷層 能力大減) Qwen-Flash IQ3_S倒是沒有出現這種現象

                                    小模型最小大概只有 27B-Q4_K_M 版本能解出, 再壓縮的話 目前沒看過能解出的模型

                                    1 条回复 最后回复
                                    0
                                    • J
                                      J
                                      joker_chang
                                      体面乡绅 硕果累累
                                      编写于 最后由 编辑
                                      #45

                                      在锤哥的视频中看到过,qwen的模型上下文最多到16*KB,超过了模型会变成傻逼。

                                      所以我一般都只将上下文开到160K

                                      1 条回复 最后回复
                                      0
                                      • J
                                        J
                                        joker_chang
                                        体面乡绅 硕果累累
                                        编写于 最后由 编辑
                                        #46

                                        在锤哥的视频中看到过,qwen的模型上下文最多到16*KB,超过了模型会变成傻逼。

                                        所以我一般都只将上下文开到160K

                                        1 条回复 最后回复
                                        0
                                        • kos orK kos or

                                          @joker_chang

                                          這一題的reasoning推論過程很長,越少遇到上下文壓縮越好,模型可以避免失去中間的推論過程
                                          我不確定 Max Output tokens 設置多少比較好
                                          這次用了 Context Window 256K / Max output 100K 得出的速度(答題時間)和輸出品質不錯

                                          單卡 5070 Ti + Strata-v0.1.43-QFN-IQ3_S + DSH + Context Window 256K / Max output 100K
                                          做了A/B Test - Reasoning Low vs. High/xHigh
                                          本來還以為開Reasoning High/xHigh 會過度思考 不過這次反而更快找到答案,

                                          評價官 GPT5.6-SOL : " 這次 xHigh run 進一步支持一件事:IQ3_S 本身完全沒有顯示 V7-A 級別的 reasoning cliff(推論能力大減);同一 3-bit-ish quantization 在 Low 與 xHigh 都能達到接近滿分,差異主要落在 verification discipline,而不是「能不能解出來」。"

                                          image.jpeg

                                          xHigh的數據

                                          image.jpeg

                                          image.jpeg

                                          johnnybegoodJ
                                          johnnybegoodJ
                                          johnnybegood
                                          王侯将相
                                          编写于 最后由 编辑
                                          #47

                                          @kos-or 怎么从几个小时变成20多分钟的?

                                          kos orK 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组