-
-
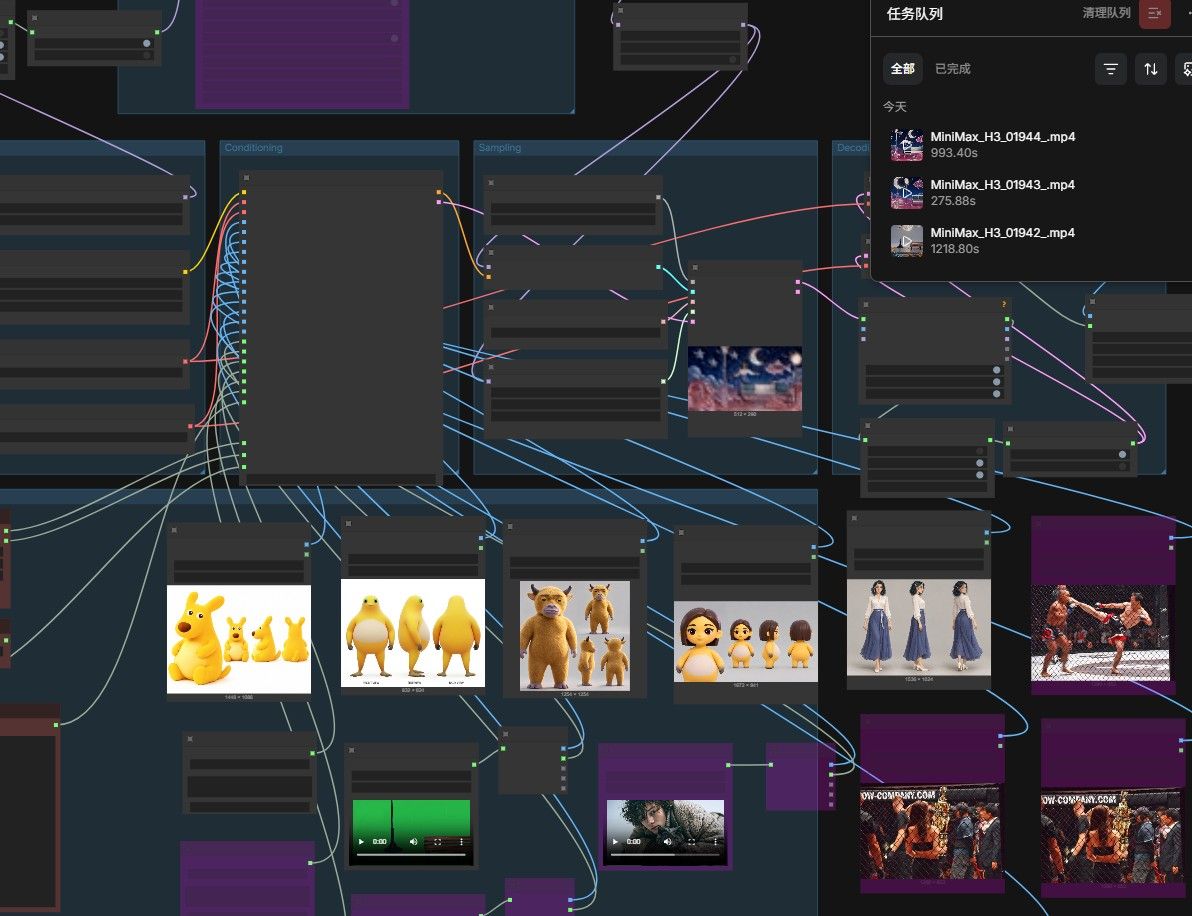
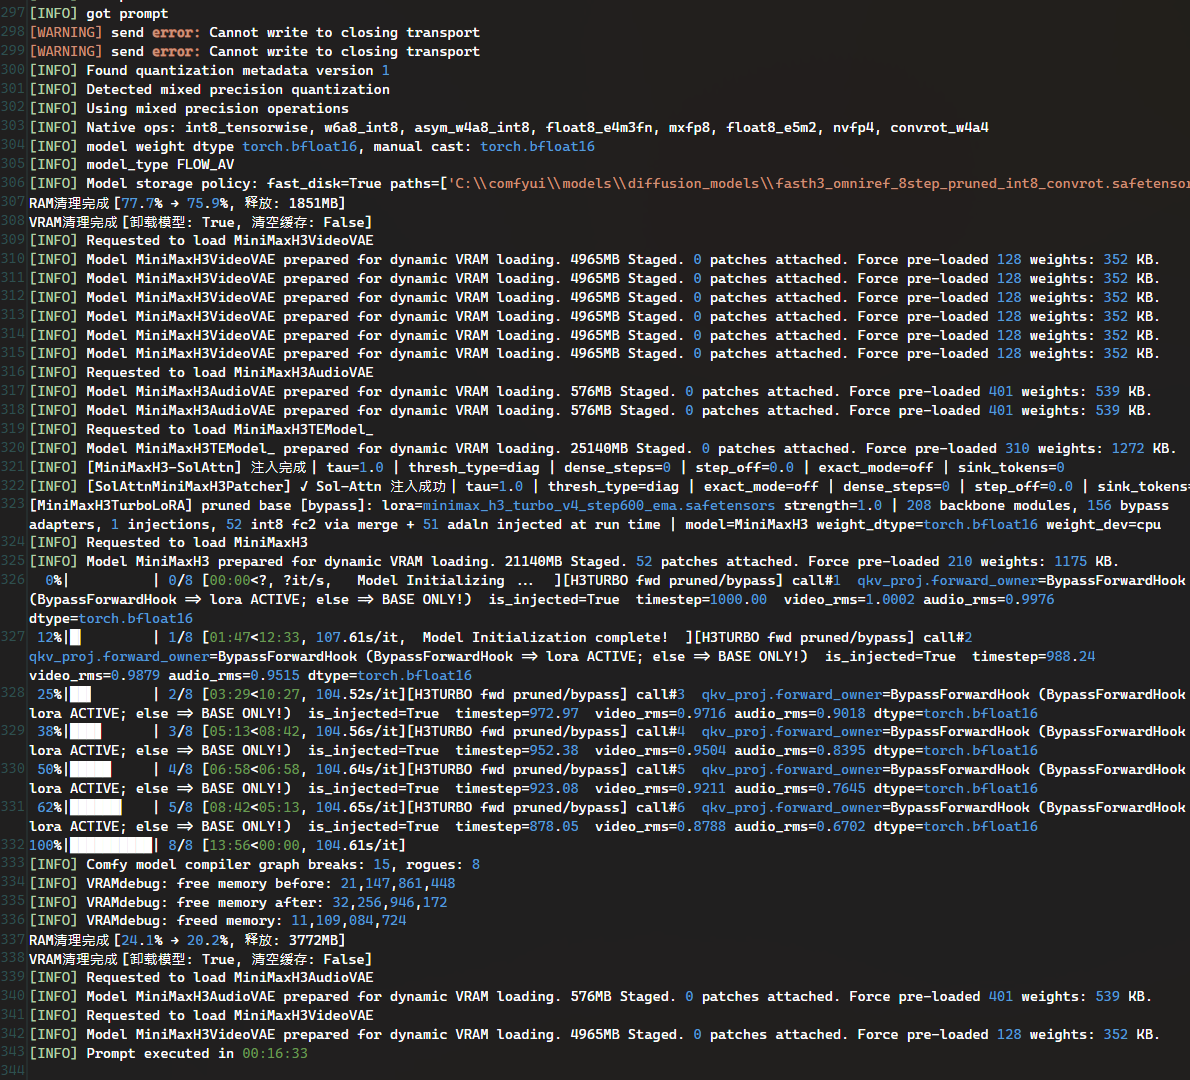
0.50m
rtxpro 4500 32g
16:33 -
@imbiplaza-ASUS 单卡比较感觉像是内存通道上占了便宜。
-
-
第二次执行变成
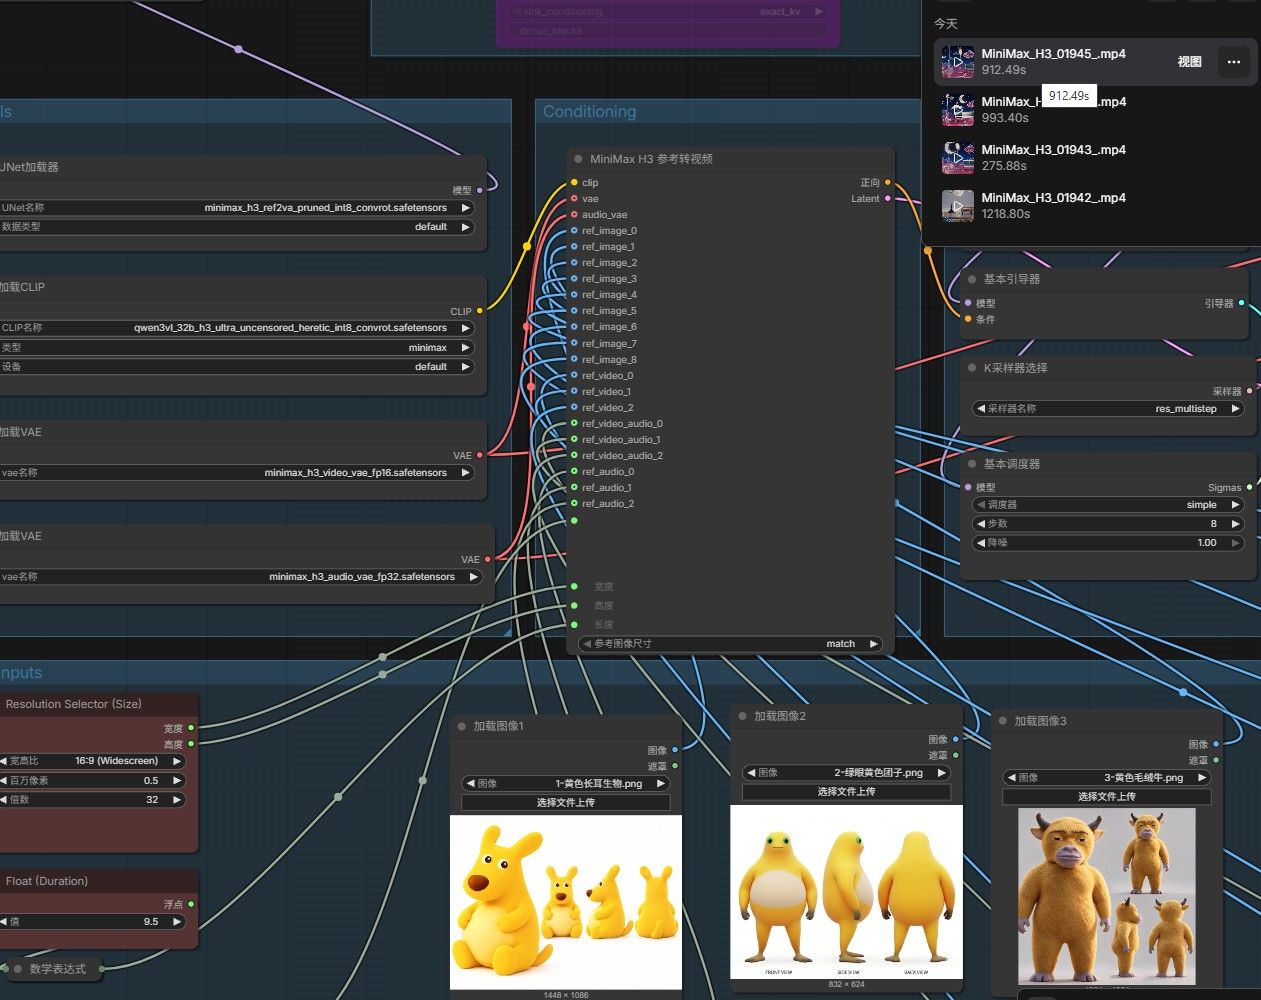
之前
0.5m
rtxpro 4500 32g
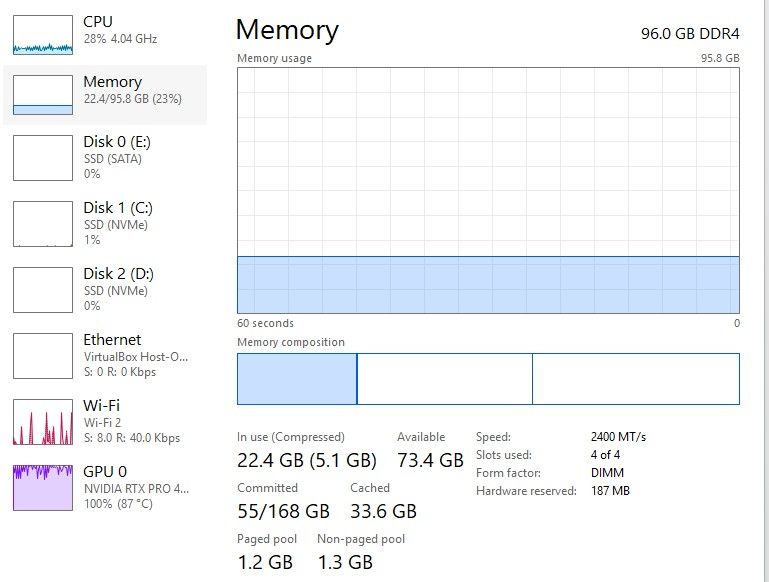
ddr4 2400mt
16:33
fasth3_omniref_8step_pruned_int8_convrot.safetensors现在
0.5m
rtxpro 4500 32g
ddr4 2400mt
15:12
minimax_h3_ref2va_pruned_int8_convrot.safetensors -
@imbiplaza-ASUS LORA还有影响? 这我去试试看
我也不懂,但是这几天大家都说omi 这个模型很神。。。
但是我用起来更慢了,可能我原本得优化就是已经尽头了 -
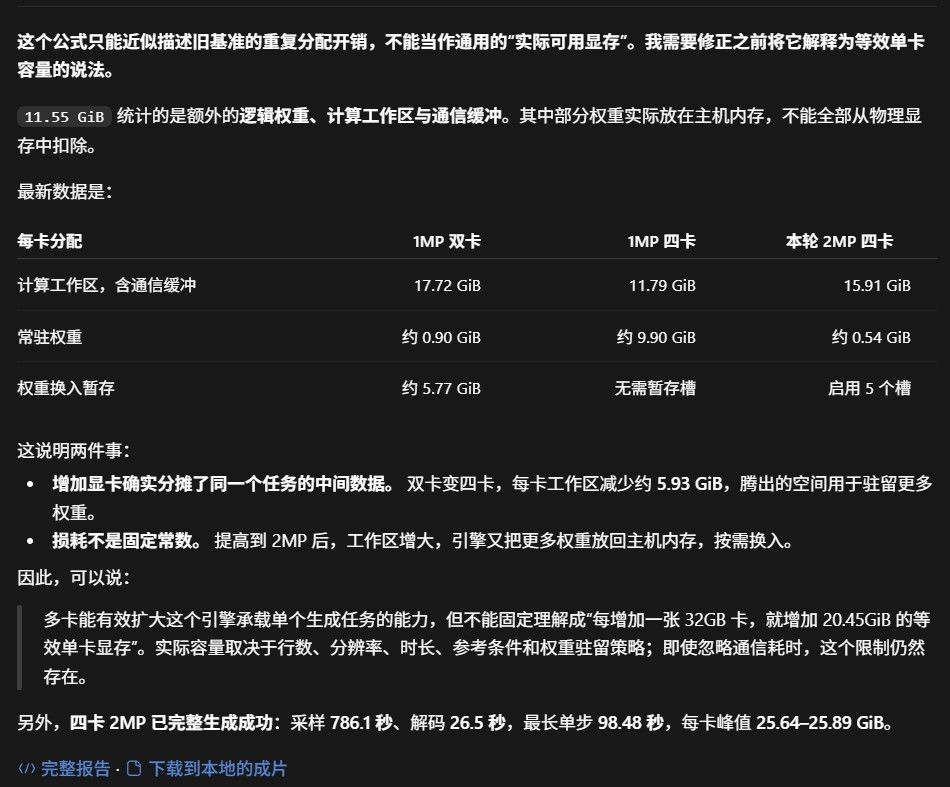
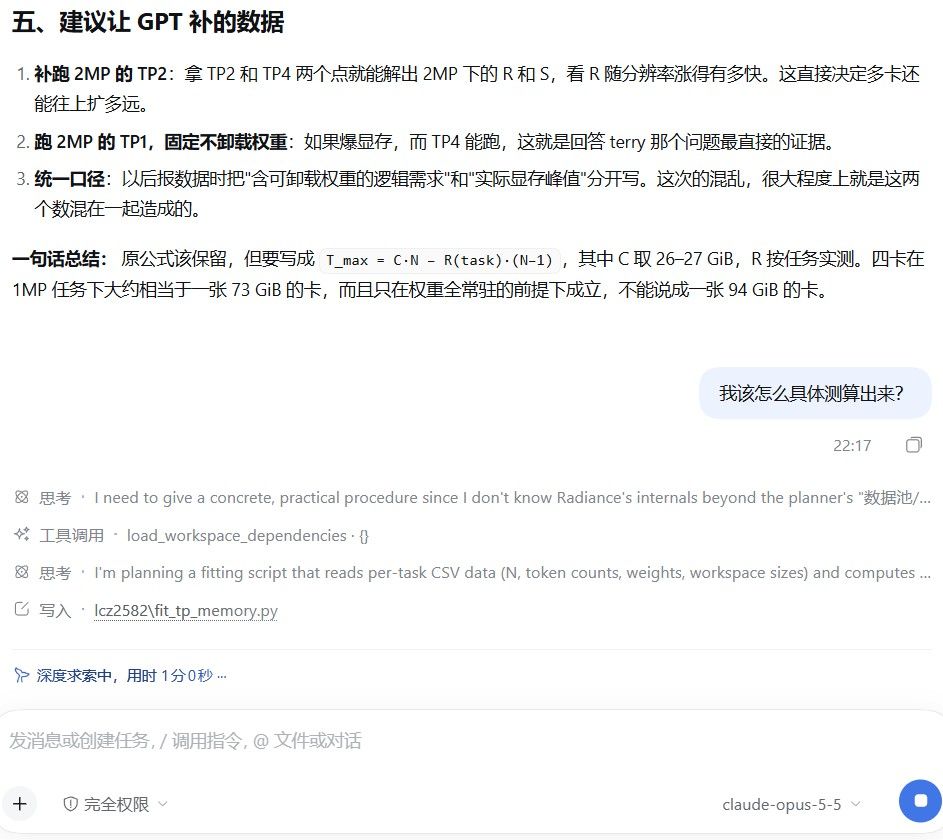
不行, 还是跑不过楼主的 单卡, 如下是AI总结:
1344×768 按 KSampler 日志口径复测
测试日期: 2026-10-26(北京时间)
ComfyUI prompt ID:a1f3a589-9412-44d4-b88e-769f1bbde739结果
- ComfyUI 全流程:1,224.673 秒(20 分 24.673 秒),21:19:34.218 → 21:39:58.891。
- ComfyUI 日志中 KSampler 进度条:18 分 36 秒(1,116 秒),8/8,平均 139.60 秒/步。
- 逐步时间由 WebSocket progress 事件记录。第 1 个间隔从 KSampler 节点进入到第一次观察到步数增加,包含节点初始化/预热;之后各步以相邻进度变化的时间差计算。
步 用时 说明 1 142.620 秒 含 KSampler 初始化/预热,不宜视作纯去噪步 2 134.094 秒 3 139.671 秒 4 140.065 秒 第 1 步之后的最长单步 5 139.093 秒 6 139.546 秒 7 139.567 秒 8 139.513 秒 因此,若按包括首步初始化的观测区间,最长为第 1 步 142.620 秒;若排除首步初始化影响,最长是第 4 步 140.065 秒。
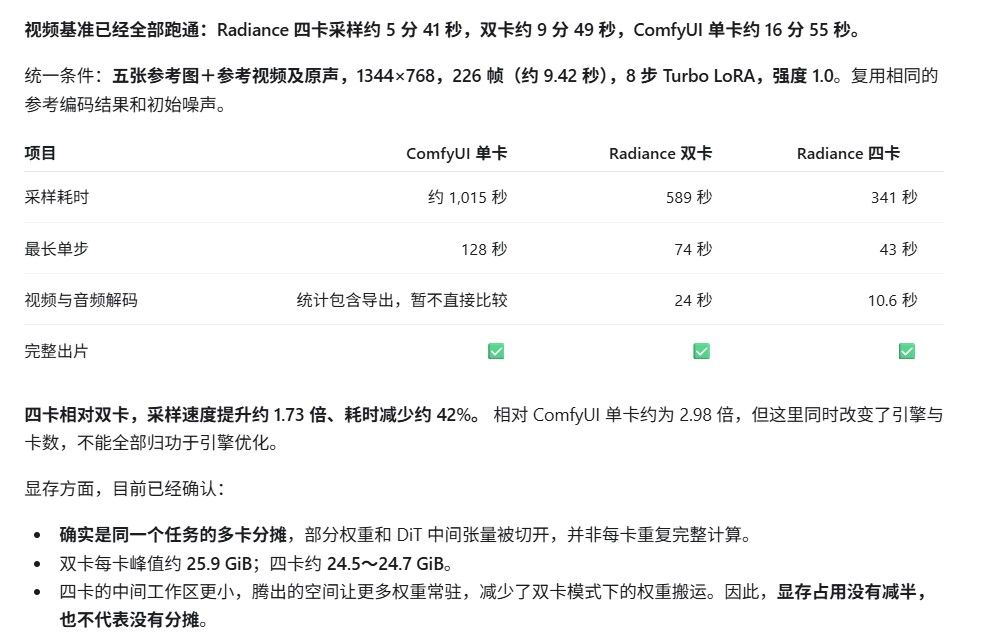
与截图中的 ComfyUI 单卡数据对照
截图列出采样约 1,015 秒、最长单步 128 秒。按本次 ComfyUI 日志的 KSampler 进度条 1,116 秒比较,本次多 101 秒;排除首步初始化后,最长步 140.065 秒,比截图多约 12.065 秒。这组数据表明截图中的这次结果更快一些,但硬件、计时边界仍未被证明完全相同,宜作近似对照,不宜视为严格同机基准。
本次完整执行比采样进度条多出全流程其他阶段。进度条最终日志到 ComfyUI prompt 成功之间约 18.630 秒,但这段还包括后续节点和保存,不能单独称为视频/音频解码时间;现存日志没有将解码与导出独立拆开。
成片与记录
- 成片:
lcz2582_comfyui_1344x768_sampler_9.17s.mp4(1344×768、24 fps、220 帧,复用原始 AAC 音轨) - 原始生成视频:
comfyui_raw_1344x768.mp4 - WebSocket 逐步事件:
progress_trace.jsonl - 校正后的计时汇总:
sampler_timing.json - ComfyUI 捕获原始结果:
run_result.json - 使用的 API 工作流:
api_workflow_1344x768.json
-
-
-
我也不懂,但是这几天大家都说omi 这个模型很神。。。
但是我用起来更慢了,可能我原本得优化就是已经尽头了 -
-
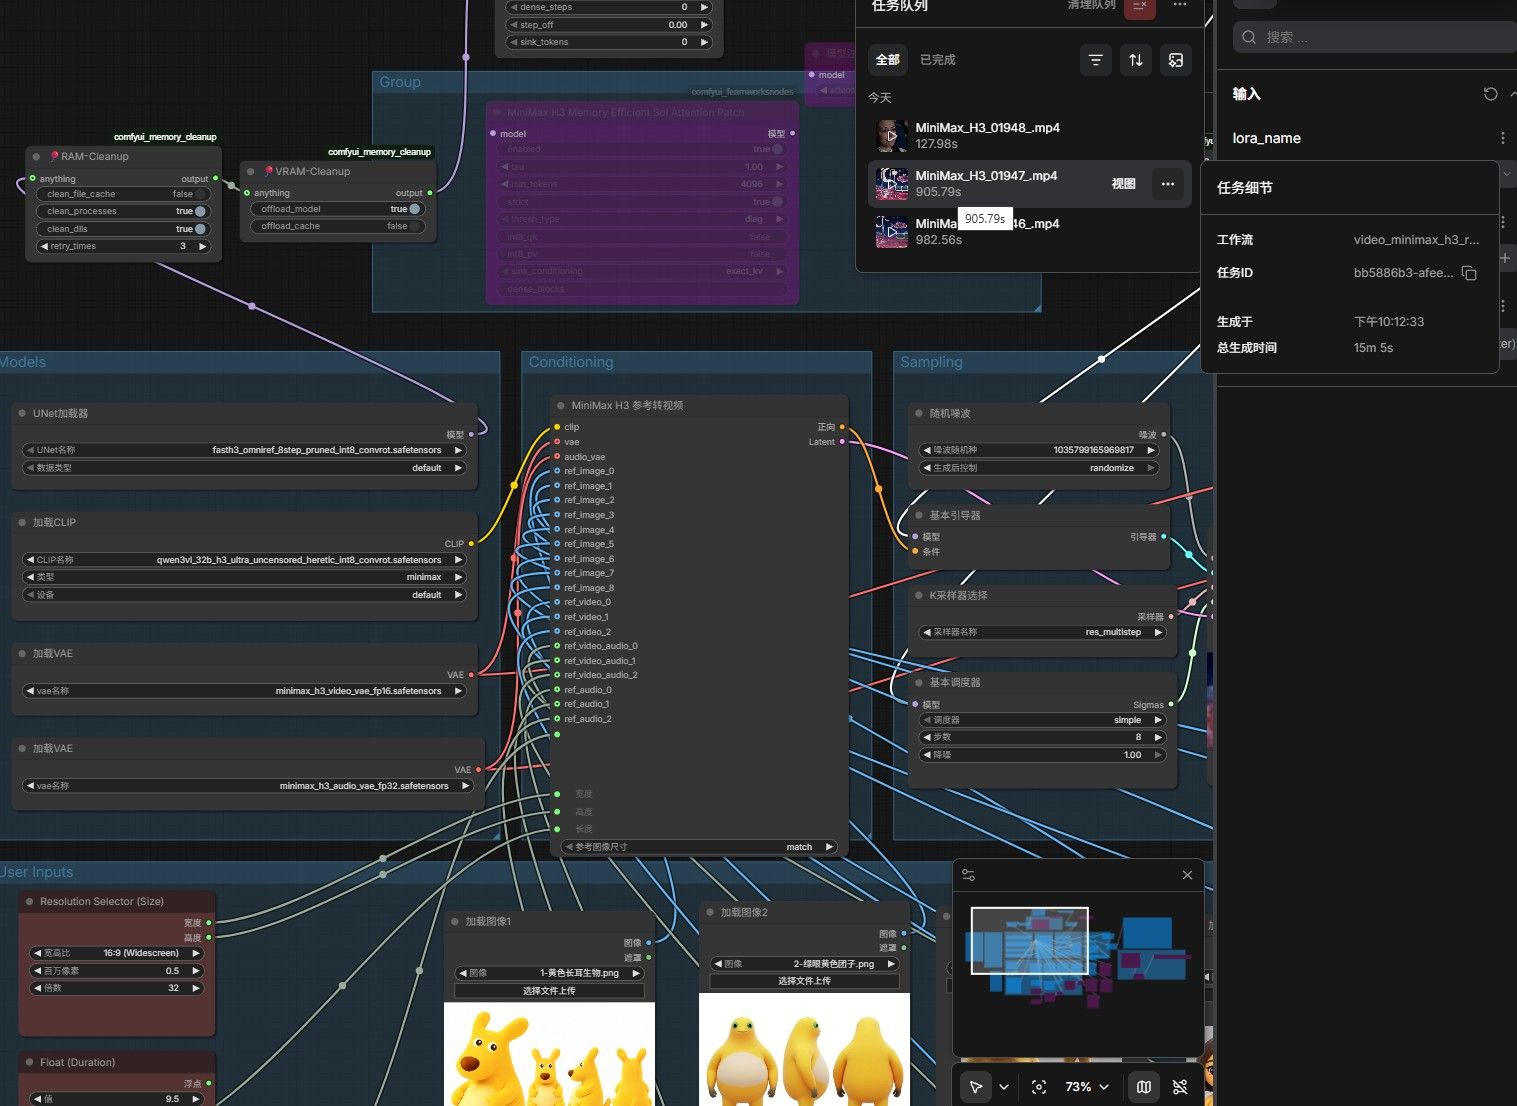
冷启动
0.5m
rtxpro 4500 32g
ddr4 3200mt
16:22
minimax_h3_ref2va_pruned_int8_convrot.safetensors热启动
0.5m
rtxpro 4500 32g
ddr4 3200mt
15:05
fasth3_omniref_8step_pruned_int8_convrot.safetensors另外使用官方omni 得工作流,的确达到宣传得10s 视频,90秒完成输出