跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
A

applejuice

@applejuice
王侯将相
取消关注 关注
关于
帖子
669
主题
16
分享
0
群组
1
粉丝
7
关注
0

帖子

最新 最佳 有争议的

  • 双 3090(NVLink)跑 Qwen3.6-27B,128K 上下文实测
    A applejuice
    AI硬件 nvidia rtx3090 多卡部署

    声明:这篇东西是叫AI 总结的

    交作业。双 3090 跑 Qwen3.6-27B,测了上下文深度对速度的影响

    GPU:RTX 3090 ×2,已上 NVLink(nvidia-smi topo -m 显示 NV4,4 条 link 各 14GB/s,约 56GB/s)
    模型:Qwen3.6-27B-UD-Q4_K_XL(unsloth 动态量化) --- 下载错了 将就用
    引擎:llama.cpp 自编译(CUDA),layer-split(默认模式)
    KV cache:q8_0,上下文 153600
    开了 MTP(--spec-type draft-mtp --spec-draft-n-max 3)、flash-attn

    测试方法: 每次冷 prefill,关掉 prompt cache,数字比较实在。脚本跑 /completion 读 timings。
    prompt_n | prefill t/s | gen t/s | 总显存 | 功耗
    782 | 708.8 | 59.2 | 34.7G | 440W
    6155 | 1285.9 | 58.5 | 34.8G | 436W
    24587 | 1249.5 | 54.6 | 34.8G | 441W
    98315 | 835.4 | 47.4 | 34.8G | 441W
    135017 | 694.2 | 43.2 | 34.8G | 444W

    解码 59 → 43 t/s,从 800 一路到 135K 上下文只掉 27%,曲线相当平,不像单卡过了 64K 就断崖
    显存全程稳定 34.7G(KV cache 启动时按满 context 预分配),48G 总显存还剩富裕,上下文还能再往上拉
    prefill 在中段(6K~24K)能冲到 1250+ t/s,深上下文回落到 700 左右
    双卡 layer-split,两张卡轮流跑,速度约等于单卡——双卡的收益主要是"显存容量",能塞下深上下文
    功耗双卡合计稳定 ~440W

    一开始先用vllm 跑两张卡 结果只有7t/s, 所以先用上llama 然后在看能不能用上NVLINK
    现在还叫claude 解决vllm 然后测试


  • 交作业 — 淘宝 华南金牌旗舰店 硬件 - RTX 3090 NVLink + 双路 Xeon E5-2686 v4
    A applejuice
    AI硬件 nvidia rtx3090

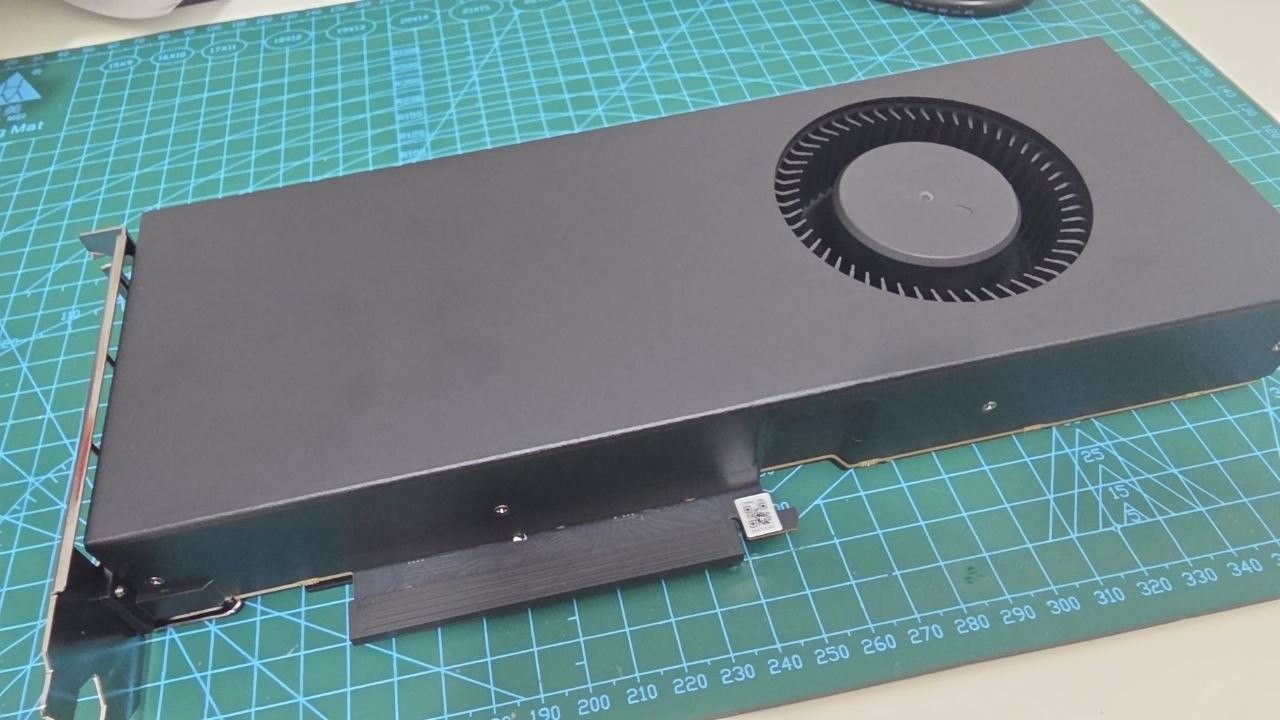
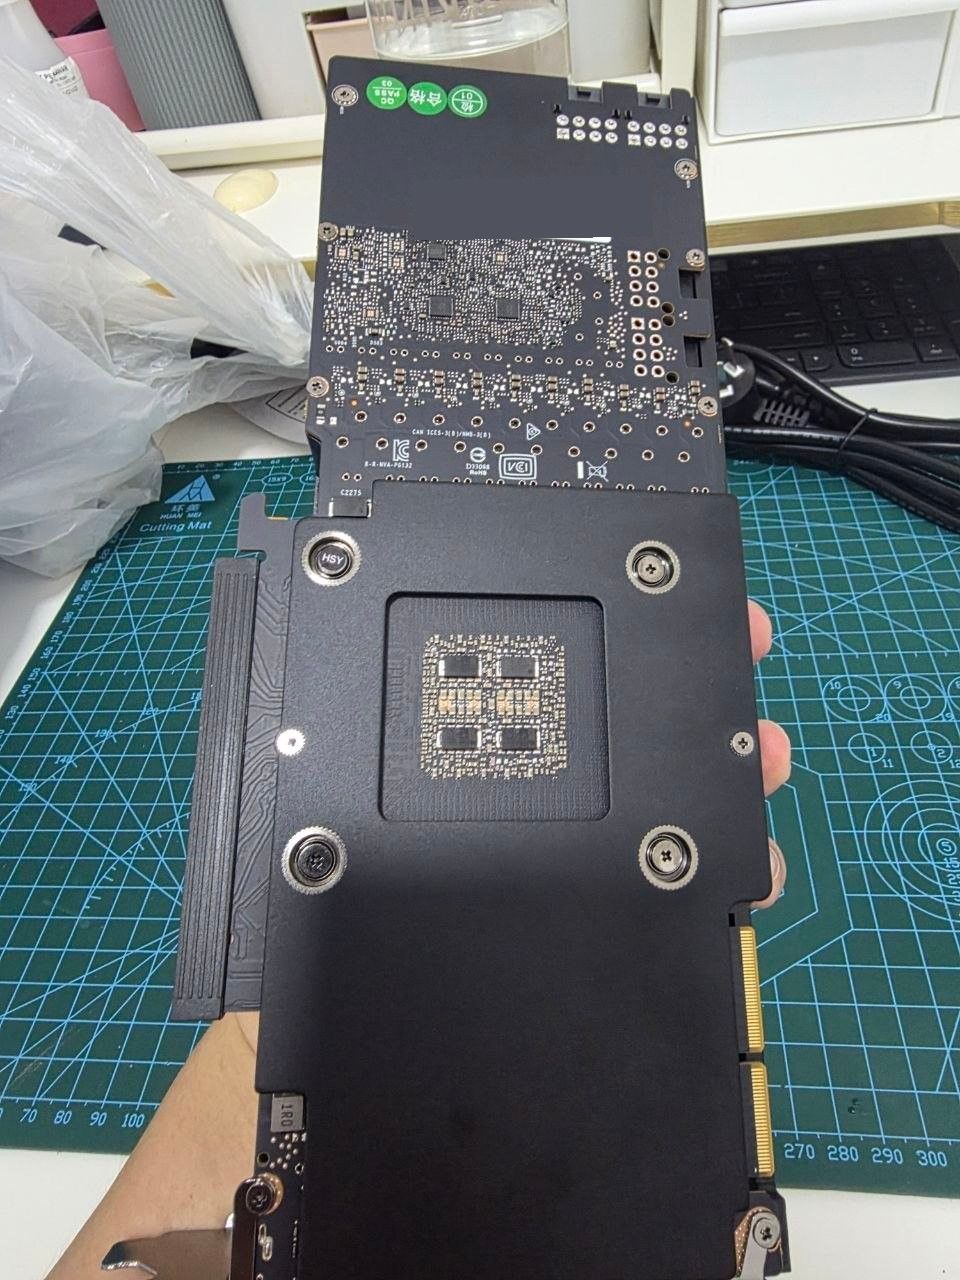
    拿到手显卡成色不错
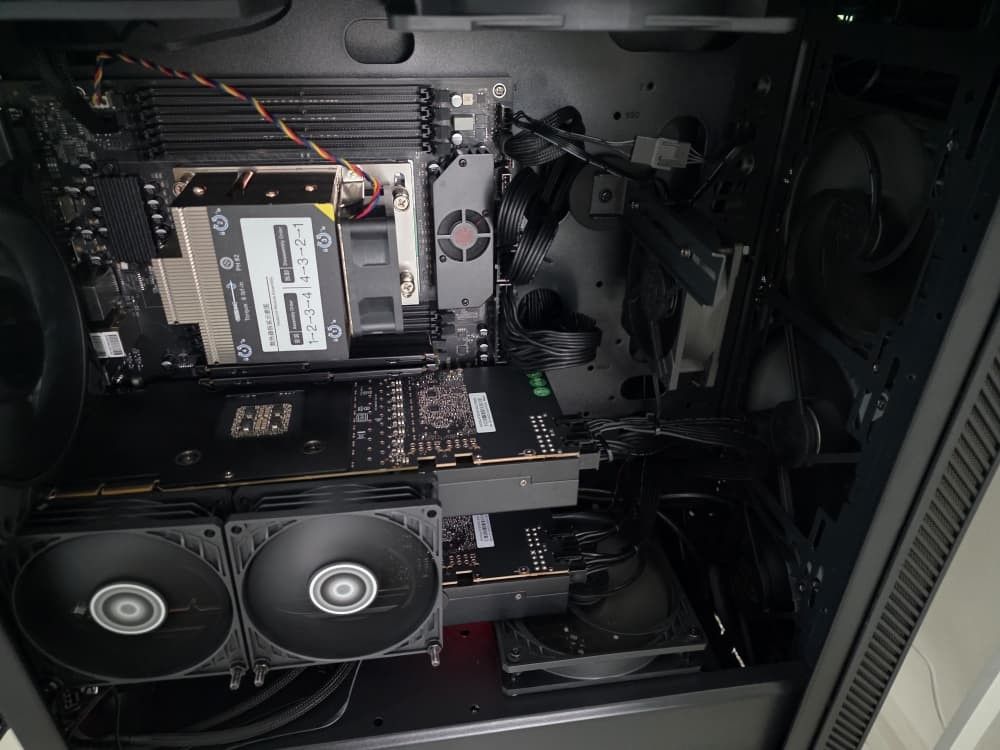
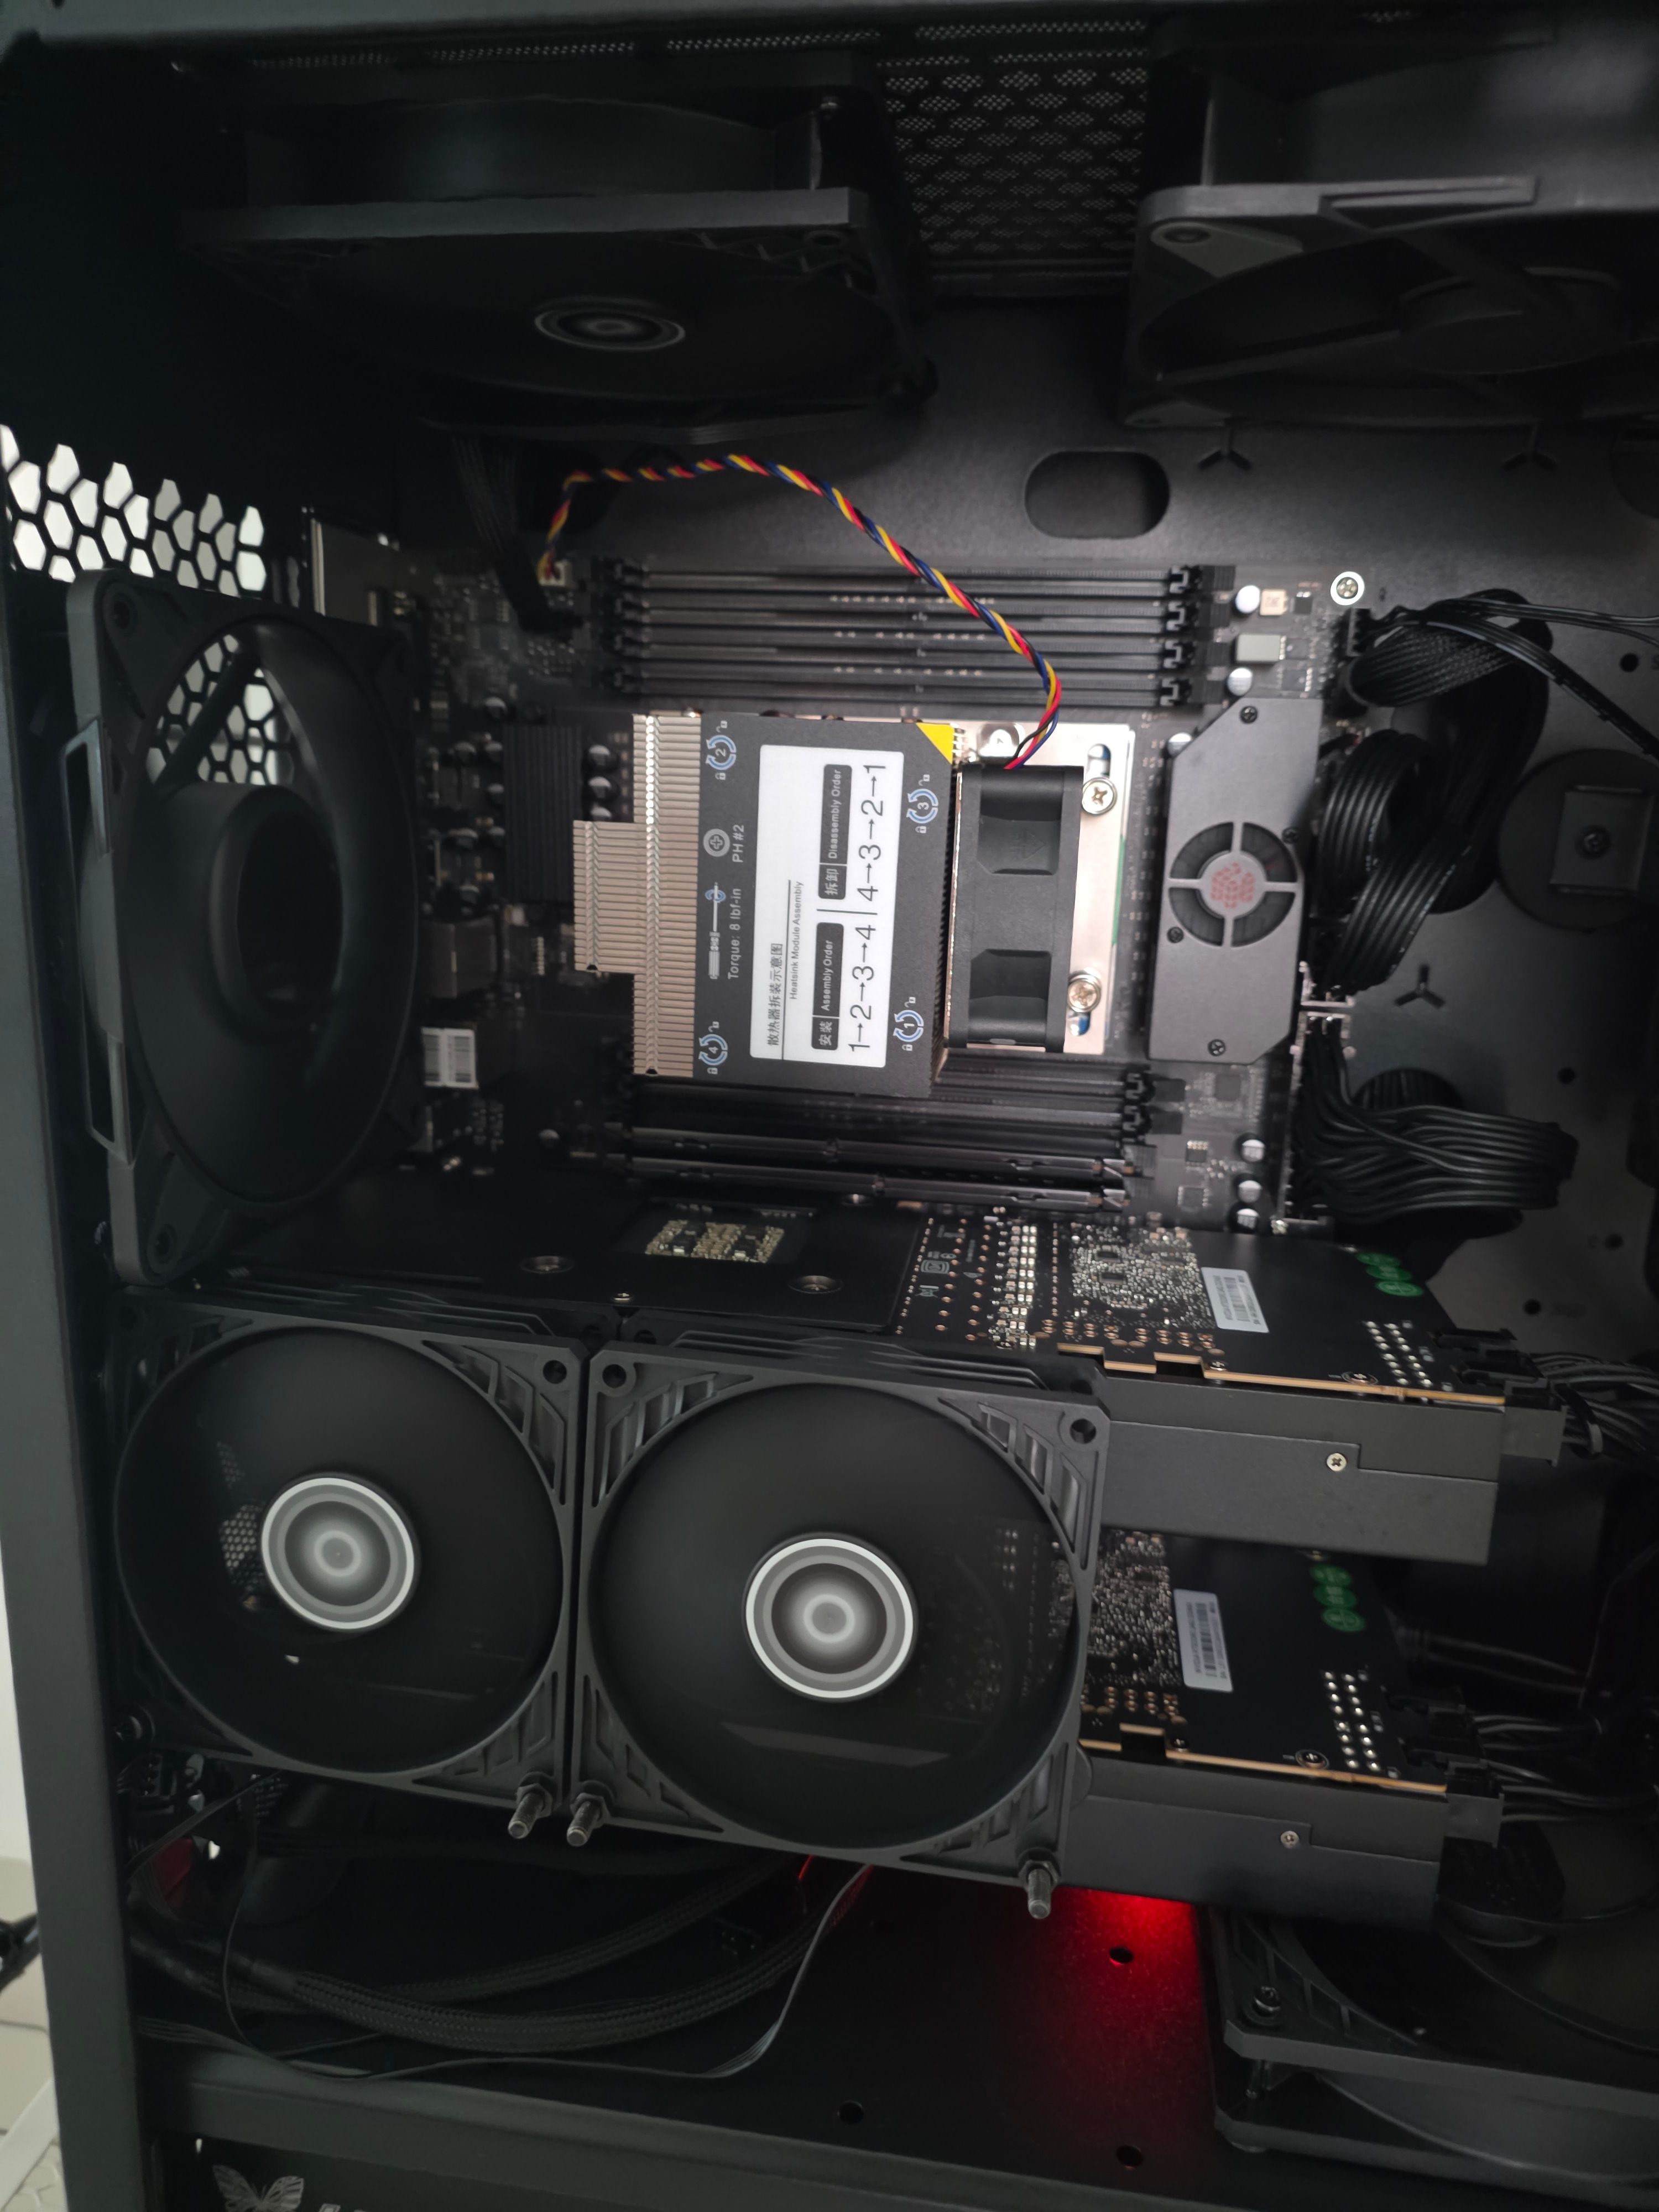
    两张3090涡轮的声音还可以接受 比我3d打印机安静很多
    只是我接受不了那个热气
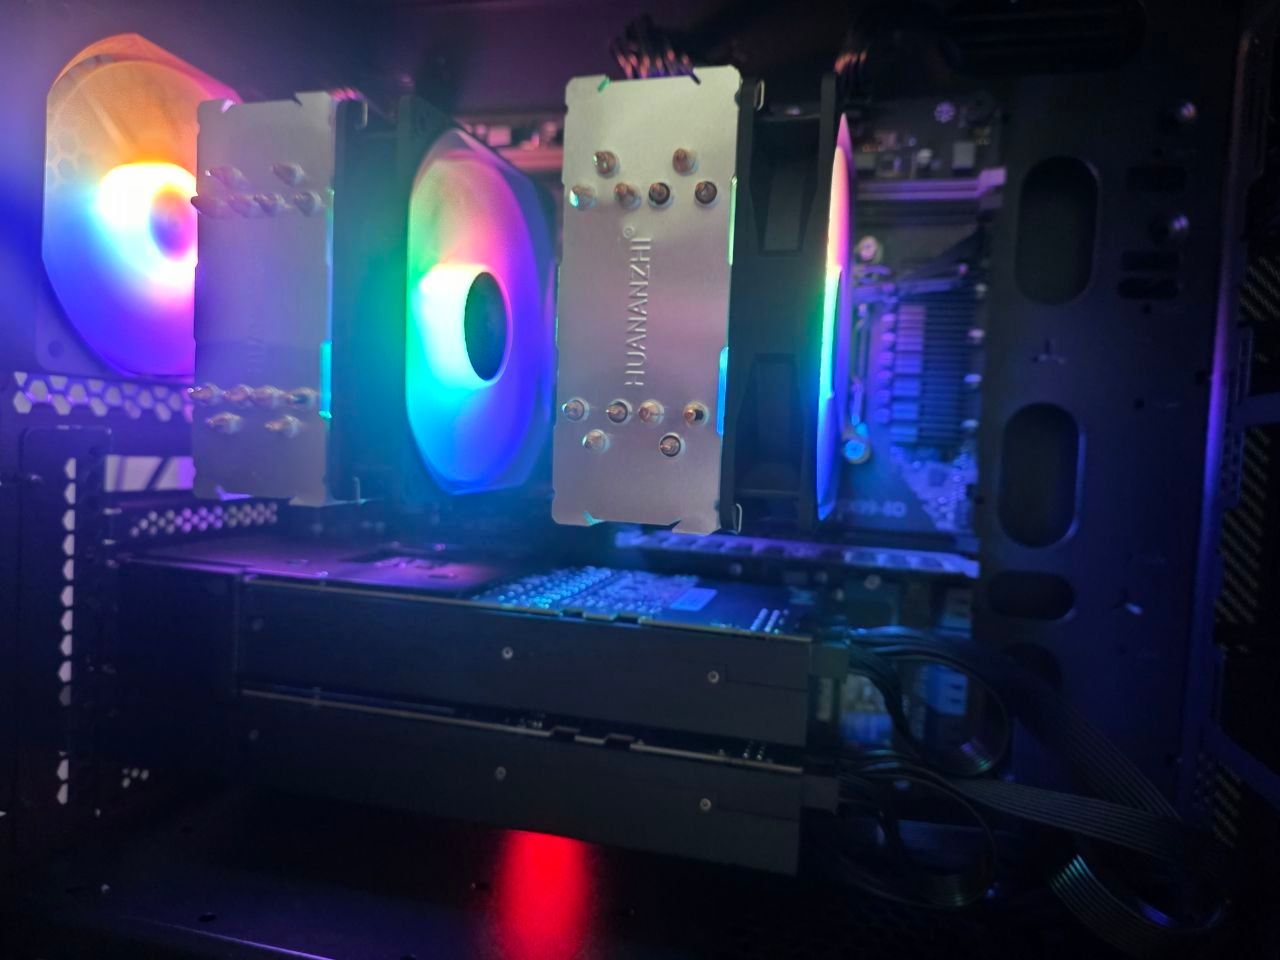
    选双路因为那个NVLINK (暂时没发现多大用处)单路的nvlink 2/3slot 距离都不适用

    整了1个小时多放弃了 才装上Ubuntu
    一开始还是 手动问ai 一句我做一步
    后面懒了 直接交给claude code

    还有一点就是,刚好跟同一家买,卖家测好发货
    不然我就踩了NVLINK间距的坑, 卖家测了不能用 就跟我说 结果还帮我找2slot nvlink连接器 换了PCIE 间距适合的 主板(当然花更多钱了)
    意外收获的是,因为升级主板买到带有IPMI接口的 所以可以远程开关机 省点电费

    硬件清单

    组件 型号
    主板 华南 X10-X99-8D(双路 LGA2011-3,8× DDR4 RDIMM,合计 80 条 PCIe 通道)
    CPU × 2 Xeon E5-2686 v4(18c/36t,145W TDP,Broadwell-EP)
    内存 三星 32GB DDR4-2133 ECC RDIMM × 2(合计 64GB,每 CPU 1 条)
    显卡 × 2 RTX 3090 24GB 涡轮版
    NVLink 2-slot 3090 NVLink 桥接
    电源 长城 G13 1250W 金牌全模(ATX 3.1)
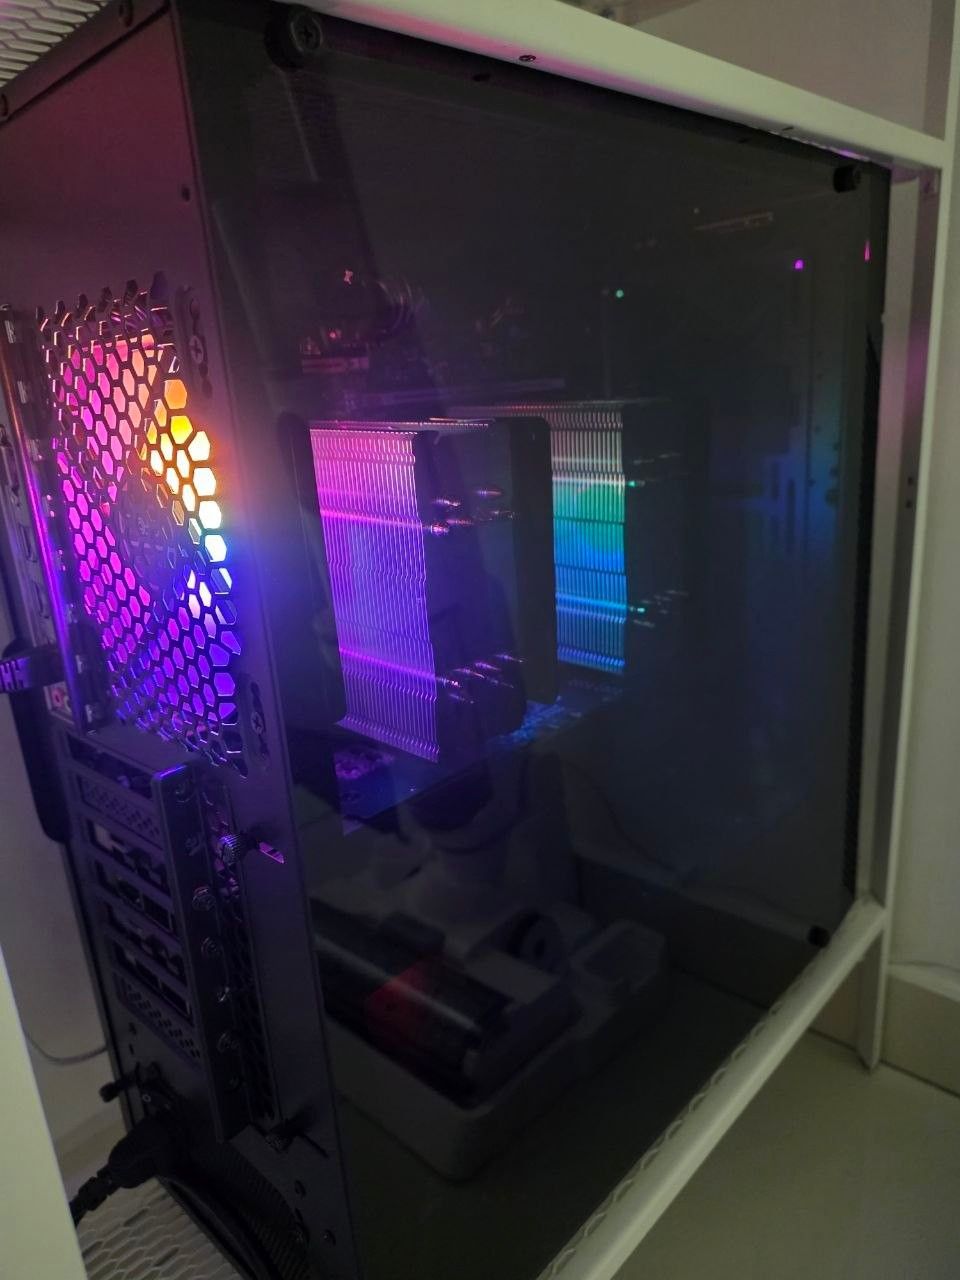
    机箱 华南 Z40

    |

    db114e2b-cb47-4df2-92ca-21ea1b6b4f2a-image.jpeg
    966a11af-b9d4-4a5e-93f3-ae497c337bbf-image.jpeg
    90422da3-ac33-486d-8a3e-77a397db9a99-telegram-cloud-photo-size-5-6113878735065911173-y.jpg
    98b770db-2faa-4e74-a493-82f1444eab43-image.jpeg

    烤gpu 测试

    ./gpu_burn 300
    Using compare file: compare.ptx
    Burning for 300 seconds.
    GPU 0: NVIDIA GeForce RTX 3090 (UUID: GPU-74cf88c2-0b03-6936-e1ab-8e990e6e854f)
    GPU 1: NVIDIA GeForce RTX 3090 (UUID: GPU-717e4ea4-942e-072e-5e0c-52d905fa5773)
    cuInit returned 0 (no error)
    cuInit returned 0 (no error)
    Initialized device 0 with 24126 MB of memory (23848 MB available, using 21463 MB of it), using FLOATS
    Results are 268435456 bytes each, thus performing 81 iterations
    Initialized device 1 with 24126 MB of memory (23848 MB available, using 21463 MB of it), using FLOATS
    Results are 268435456 bytes each, thus performing 81 iterations
    11.0% proc'd: 486 (16447 Gflop/s) - 405 (16252 Gflop/s) errors: 0 - 0 temps: 68 C - 63 C
    Summary at: Tue May 26 09:48:50 AM UTC 2026

    22.0% proc'd: 891 (15863 Gflop/s) - 891 (15699 Gflop/s) errors: 0 - 0 temps: 71 C - 67 C
    Summary at: Tue May 26 09:49:23 AM UTC 2026

    33.3% proc'd: 1458 (15569 Gflop/s) - 1377 (15598 Gflop/s) errors: 0 - 0 temps: 73 C - 68 C
    Summary at: Tue May 26 09:49:57 AM UTC 2026

    43.7% proc'd: 1863 (15447 Gflop/s) - 1863 (15446 Gflop/s) errors: 0 - 0 temps: 73 C - 69 C
    Summary at: Tue May 26 09:50:28 AM UTC 2026

    54.7% proc'd: 2349 (15331 Gflop/s) - 2268 (15387 Gflop/s) errors: 0 - 0 temps: 74 C - 69 C
    Summary at: Tue May 26 09:51:01 AM UTC 2026

    65.3% proc'd: 2754 (15300 Gflop/s) - 2754 (15318 Gflop/s) errors: 0 - 0 temps: 75 C - 69 C
    Summary at: Tue May 26 09:51:33 AM UTC 2026

    75.3% proc'd: 3159 (15246 Gflop/s) - 3159 (15322 Gflop/s) errors: 0 - 0 temps: 75 C - 69 C
    Summary at: Tue May 26 09:52:03 AM UTC 2026

    85.7% proc'd: 3645 (15201 Gflop/s) - 3564 (15280 Gflop/s) errors: 0 - 0 temps: 75 C - 69 C
    Summary at: Tue May 26 09:52:34 AM UTC 2026

    97.0% proc'd: 4050 (15205 Gflop/s) - 4050 (15248 Gflop/s) errors: 0 - 0 temps: 75 C - 69 C
    Summary at: Tue May 26 09:53:08 AM UTC 2026

    100.0% proc'd: 4212 (15204 Gflop/s) - 4212 (15231 Gflop/s) errors: 0 - 0 temps: 75 C - 69 C
    Killing processes with SIGTERM (soft kill)


  • 双RX7900XTX塞进同一机箱,满载温度成功压到 90℃以内
    A applejuice
    AI硬件 7900xtx 多卡部署

    我不是 7900xtx 但是借帖分享

    我刚装了
    14cm 进风风扇 在 前置中间
    14cm 进风风扇 在 上面靠中间部分
    12cm 进风风扇 在 底座
    换了一个比较有力的后排风风扇
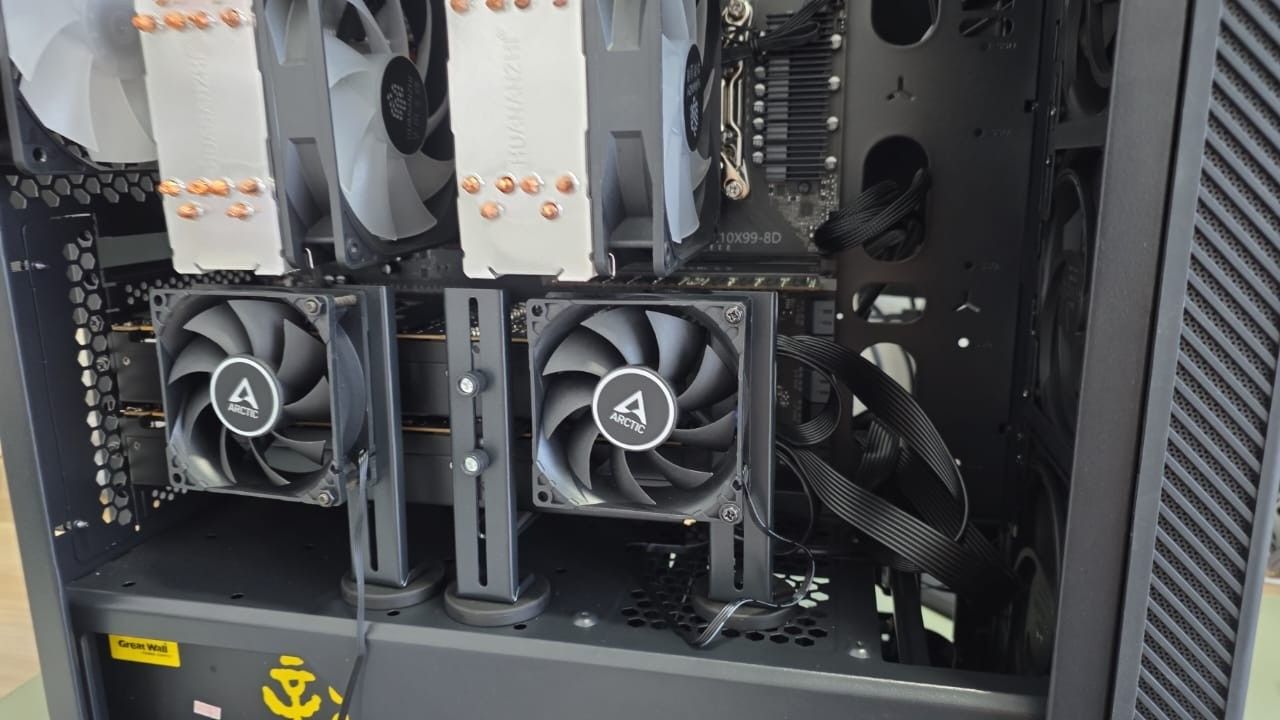
    再加两个9cm 显卡风扇
    跑起来机箱都不感觉到有热气堆积在机箱内

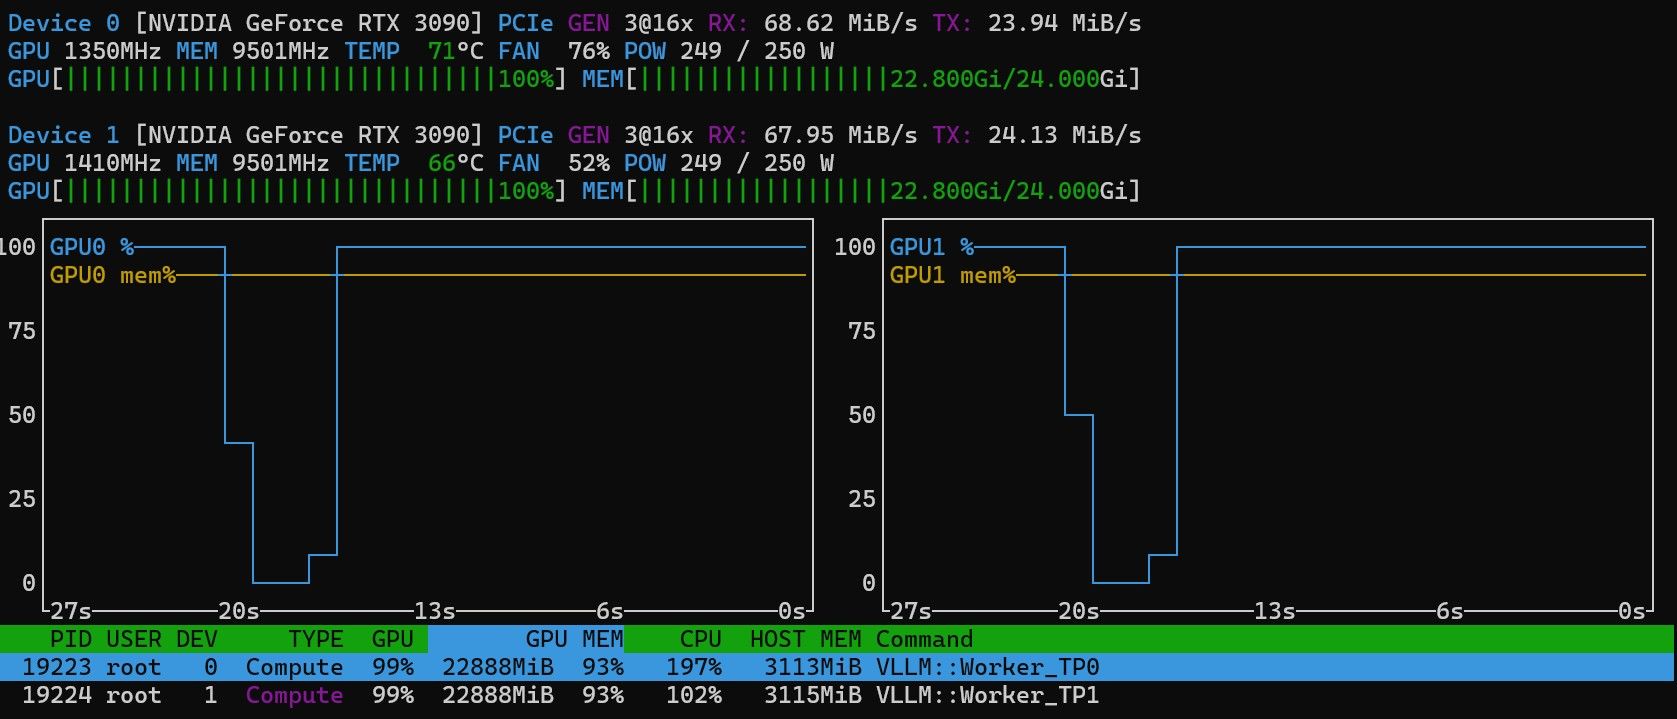
    2张 265w 3090
    显卡温度压在68c 热点86c (一个gpu 热点只在80, 86c那张卡导热贴应该不给力了)
    重点是gpu 风扇也只上到65%
    不再搞了 最后85w只换来不到5% 效率 不想折腾了
    就这样用
    下一次要搞硬件 应该就是双卡r9700 了 ,6000 t/s prefill速度有点猛

    Decode (t/s)

    Workload 245 W 265 W 350 W
    Chinese prose 68.4 70.2 72.7
    Chinese dialog 73.7 76.0 78.4
    English technical 118.2 122.1 126.0
    Code generation 266.9 276.1 284.9

    Prefill (t/s)

    Prompt tokens 245 W 265 W 350 W
    19,206 1673 1778 1966
    43,036 1525 1620 1781
    88,907 1296 1384 1499
    181,307 1001 1071 1141

    Peak GPU core temp

    265 W 350 W
    68 °C GPU0 76 °C / GPU1 87 °C

    要点:在 decode(解码)和 prefill(预填充)两个阶段,265 W 都比 245 W 高约 3%,比 350 W 低约 3%。

    dcd1a925-dc55-4058-858e-d1322096b93a-image.jpeg20260920_152943.jpg

    走了弯路
    一开始应该直接上h12d-8d
    一开始应该全风扇用arctic pro max


  • Linux下显卡测试工具和脚本分享
    A applejuice
    AI硬件 linux

    @joker_chang 我也是因为高强度用的时候gpu 假死卡机 需要从启 所以才测测


  • DGX单机也有春天——Qwen3.8-27B at 34-38 tok/s on DGX Spark (GB10) — one-command SGLang + NVFP4 + DSpark
    A applejuice
    LLM讨论区 dgxspark qwen-27b gb10

    prefill 呢?
    少过1000的prefill 个人觉得很难用

    hermes cold start 要等20-30秒会要命


  • 3090x2 nvlink 翻车
    A applejuice
    AI硬件 rtx3090

    记错了 是26%,差不多30%了

    Heretic (qwen3.6-27b-heretic) — NVLink vs No-NVLink (TP=2, 245 W cap)

    Metric With NVLink Without NVLink (NCCL_P2P_DISABLE=1) Change
    Decode, single-stream (tok/s) 68 65.6 −3.5 %
    Prefill, cold (tok/s) ~1,950 ~1,438 −26 %

  • 交作业, 7900XTX + Hermes Agent + Qwen3.6-27B 调优过程分享
    A applejuice
    AI硬件 7900xtx hermes

    笑死我了
    我翻回去看了一下,第一眼看过去 真的像酸
    但是说是台湾人又觉得没问题了 😆


  • 想问 成功用上 nvlink 3090 的你们. 是用在什么平台上?
    A applejuice
    AI硬件 rtx3090 多卡部署

    @terry
    暂时根据ai看来 是gpu 出问题
    已经第2个nvlink 一样问题
    第一个nvlink 卖家用别的卡测试也是有问题

    感觉 4张 gpu 2条nvlink 都刚好出问题
    所以怀疑是平台问题


  • 双 3090(NVLink)跑 Qwen3.6-27B,128K 上下文实测
    A applejuice
    AI硬件 nvidia rtx3090 多卡部署

    可以了
    用上nvlink
    但是不能用MTP 因为模型不支持 上述GITHUB 文章 用的只是文字模型 我想要多模态模型
    我就不测试 文字模型 了 应该100t/s 没问题
    比较奇怪的是 我没想到prefill 快了

    GPU 限制 250w
    e02b4388-500a-4f29-a5eb-a5ac4aefe60b-image.jpeg

    模型

    Repo llmfan46/Qwen3.6-27B-uncensored-heretic-v2-GPTQ-Int4
    Multimodal ✅ vision (image input)
    MTP heads Present but disabled (0% accept on GPTQ)
    Native context 262,144 tokens
    Engine vLLM v0.21.0

    参数

    --model /models/heretic-gptq-int4
    --served-model-name qwen3.6-27b-heretic
    --quantization gptq_marlin
    --dtype float16
    --tensor-parallel-size 2              # both 3090s, real NVLink usage
    --max-model-len 262144                # 262K context
    --gpu-memory-utilization 0.92
    --max-num-seqs 2                      # 2 concurrent streams
    --max-num-batched-tokens 8192
    --kv-cache-dtype fp8_e5m2             # 1 byte/token KV
    --trust-remote-code
    --reasoning-parser qwen3              # routes <think> → reasoning_content
    --enable-auto-tool-choice
    --tool-call-parser qwen3_coder        # native Qwen3 tool format
    --enable-prefix-caching               # repeated prompts share KV
    --enable-chunked-prefill              # long prefill doesn't block decode
    --disable-custom-all-reduce           # MANDATORY for cross-NUMA setup
    

    测试

    Metric Value
    Decode (single-stream, steady) 67 t/s (同时2个对话同时 62t/s
    Prefill (4K prompt, warmed)** 1,289 t/s (同时2个对话 1,000 t/s)
    VRAM total ~43 GB / 48 GB

  • 双RX7900XTX塞进同一机箱,满载温度成功压到 90℃以内
    A applejuice
    AI硬件 7900xtx 多卡部署

    @terry

    前面有个暴力风扇 全力吹声音不小
    3871b6b0-3e7b-465a-aa56-3f087ff63792-image.jpeg

    我纯属小白整套买回来 然后慢慢再加
    但是基本上除了显卡 跟机箱 全部都换了...
    都那么老了第一次 自己搞
    小学买过整机
    大学,同学帮我整

    这个风道暂时我还满意
    全力跑 都没感觉有热气堆在机箱

    机箱风道图.svg


  • 3090坛友进来,过年了【解锁F16算力 加快TTFT】(10-26更新WIN系统)
    A applejuice
    AI硬件 rtx3090 nvidia

    来了

    Tensor matmul (torch 2.14 + CUDA 13, 8192³, 250 W cap):

    FP16 BF16 TF32
    GPU0 locked 53.8 TFLOPS 56.5 32.2
    GPU0 unlocked 67.8 (+26 %) 72.6 (+28 %) 41.5 (+29 %)
    GPU1 unlocked 72.8 76.5 44.7

    没有像github 的50% 那么多,有可能是限功率250w 的原因

    Strata (sergqwer fork 0.1.44.1-nvfp4.2, UD-Q4_K_XL, production config).

    Locked, 250 W Unlocked, 250 W Change Unlocked, 350 W vs unlocked 250 W vs locked 250 W
    Prefill 19K tokens 2,277 tok/s 2,618 +15 % 3,079 +18 % +35 %
    Prefill 43K 2,786 3,227 +16 % 3,705 +15 % +33 %
    Prefill 89K 3,126 3,539 +13 % 4,316 +22 % +38 %
    Prefill 122K 3,189 3,613 +13 % 4,454 +23 % +40 %

    decode 没变,预料中 因为decode 是被宽带限制了
    coding 150t/s


  • Strata - 3090 / R9700, 2133 ddr4 / 2633 ddr4
    A applejuice
    LLM讨论区 rtx3090 r9700 strata

    刚换了 32gbx2 2133mhz 去 32gbx8 2633mhz
    神奇的是 速度完全没有改变
    所以 还没买内存的朋友 可能不需要追求3200 mhz 毕竟价钱 差不少

    原本是64gb 不够玩strata 又找不到便宜内存
    刚好本地有人出2633 但是只有买10条才肯给折扣
    所以忍痛买了

    顺便放下 单3090, 双3090, 单r9700 strata的对比
    epyc7452

    Decode ( greedy, 1024 tokens, median of 3; range in brackets)

    Workload 2x 3090 1x 3090 R9700 1x 3090 vs 2x R9700 vs 2x
    Chinese prose 104.8 t/s (96.4-108.3) 83.4 (76.2-83.5) 64.2 (59.8-65.6) -20 % -39 %
    Chinese chat 112.3 (110.0-112.7) 83.6 (82.3-84.2) 70.6 (66.5-72.6) -26 % -37 %
    English technical 109.2 (103.7-109.9) 83.1 (74.9-84.2) 70.6 (65.6-72.8) -24 % -35 %
    Code 159.7 (141.5-161.1) 117.5 (93.3-118.1) 108.4 (94.3-109.2) -26 % -32 %

    Prefill (cold prompts with a unique salt)

    Prompt 2x 3090 1x 3090 R9700
    19K 2,489 t/s (7.7 s) 1,912 (10.0 s) 1,039 (18.5 s)
    43K 3,137 (13.7 s) 2,005 (21.5 s) 1,323 (32.5 s)
    89K 3,523 (25.2 s) 2,030 (43.8 s) 1,156 (76.9 s)
    123K 3,564 (34.4 s) 1,994 (61.4 s) 1,123 (109.0 s)

    IQ3_S vs IQ3_XXS on 2x RTX 3090

    Decode

    Workload IQ3_XXS, 64 GB RAM (2026-10-07) IQ3_XXS, 256 GB RAM IQ3_S, 256 GB RAM IQ3_S vs IQ3_XXS (same RAM)
    Chinese prose 109.9 t/s 105.2 (102.1-106.8) 104.8 (96.4-108.3) -0.4 %
    Chinese chat 112.2 115.8 (114.4-116.4) 112.3 (110.0-112.7) -3.0 %
    English technical 111.6 114.8 (114.5-115.6) 109.2 (103.7-109.9) -4.9 %
    Code 163.5 166.5 (153.9-167.2) 159.7 (141.5-161.1) -4.1 %

    Prefill

    Prompt IQ3_XXS, 64 GB RAM IQ3_XXS, 256 GB RAM IQ3_S, 256 GB RAM IQ3_S vs IQ3_XXS (same RAM)
    19K 2,571 t/s 2,563 (7.5 s) 2,489 (7.7 s) -2.9 %
    43K 3,183 3,236 (13.3 s) 3,137 (13.7 s) -3.1 %
    89K 3,585 3,649 (24.4 s) 3,523 (25.2 s) -3.5 %
    123K 3,647 3,686 (33.2 s) 3,564 (34.4 s) -3.3 %

    单张 3090 胜过 R9700:解码快 8-30%(代码场景差距最小),预填充约快 1.5-1.8 倍。
    同一张 R9700 上的对比: vLLM 跑稠密模型 Qwen3.8-27B(MXFP4,DFlash2),解码为 42 / 52 / 81 / 181 t/s,19K 时预填充约 2,500 t/s。Strata 的 125B 在中文上更快(64-71 对 42-52),在代码和提示词处理上更慢。
    IQ3_S 相比 IQ3_XXS 的代价很小:解码仅慢 0-5%,预填充约慢 3%,在 256K 以内召回表现相同,且其作者评定它与完整的 BF16 模型持平。它现在是默认选项(~/start_strata.sh)。
    内存升级没有改变 2x 3090 的速度(IQ3_XXS 与 64 GB 时的数据相差在 ±3% 以内)。

    所以我暂时的决定就是双3090 跑strata, 单张r9700 跑vllm


  • 大热的3090风冷改造方案 大幅降温稳定AI大脑
    A applejuice
    AI硬件 rtx3090

    @joker_chang

    z40? 我也用一样机箱 但是侧板装起来
    前面3个风扇抽风
    后面上面一个风扇排风
    里面两个风扇对准GPU

    但是我限制功率245w

    烤机5分钟
    gpu - 70c(fan 70%) /74c (fan 92%)
    vram - 82c/84c
    cpu - 47c

    我感觉我加了那么多风扇 cpu 收益最多😆

    7d7b0279-f31e-4928-94c2-0eed12a07e73-image.jpeg


  • 双3090 本地AI,大家现在还用消费级平台,还是已经转 TRX40 了?
    A applejuice
    AI硬件 rtx3090

    @Haiyun-LIU 不懂你香港有什么分别.
    但是我在马来西亚寄回根本是恶梦,寄回两张3090显卡大概是10% 显卡的价钱, 还没包过关税. 虽然说在国内买 可以免进关税 但是没人敢确定.
    甚至 运输公司说可能在海关就被丢掉.


  • ai 帖子的频率是不是太高了
    A applejuice
    随便聊聊

    其实 只要技术点的 都是ai 回复
    我个人觉得也不算 辅助回复
    基本ai就是回复

    当然可以说都有人批准
    这个写代码一样 人工审核的程度到哪里 就是@kos-or 说的那点

    我不知道别人 可是很多都帖 我读不下去 就觉得就是ai终结
    读不懂我会慢慢继续问ai
    如果是ai终结我倒不如拿标题慢慢跟ai 探讨

    ai回复 很明显 基本上就是小特 那种风格😆
    个人看法 所以放在随便聊聊


  • 【双 R9700 折腾记】从 Strata 到 Radiance
    A applejuice
    随便聊聊 r9700 strata 多卡部署 radiance

    我不懂怎样算好怎样算不好
    我第一眼看上去东南西北是倒反
    但是他说 上南下北,左东右西

    QFN + 27B 花了28分钟
    QFN (3090x2) - 603 秒
    27b (R9700 vllm-sly-radiance) - 1078 秒

    一页讲中国传统八卦文化的暗墨水网页,含:

    可交互八卦图 — SVG 太极居中缓转,八卦环列,上南下北左东右西罗盘圈;先天(伏羲)/ 后天(文王) 双排布一键切换,0.7s 旋转过渡;点击/回车选卦,朱砂 highlight,详情卡显示卦名、☰ 符号、拼音、自然/人伦/五行/方位、《说卦》象德
    太极生八卦 二进制生成树、八卦取象歌(乾三连坤六断…配手绘爻图)、八卦类象对照表、先后天二图对比、八卦与生活(易学/中医/八卦掌/风水)、落款印章
    验证方式:构建和两轮修复都经子代理执行,我在磁盘+浏览器里逐项复核:八组角度与卦画 bit 位精确匹配(含 先天=天地定位/后天=离南坎北 两个标准排布);先天→后天→先天 切换往返实测角度、方位标签正确回位;node --check 语法通过;无 emoji、viewport/lang="zh-CN"/prefers-reduced-motion 齐全;除 Google Fonts(可离线降级到本地宋体)外零外部依赖。截图复核两轮,无重叠、无破版。

    bagua.html


  • 4090 48G 水冷,新人报道,多多指点!
    A applejuice
    装备秀 rtx4090 sg-lang

    我买了2 张3090 1张r9700
    突然间 发现倒不如一开始买48gb 4090


  • 我普通人的算力需求 病态
    A applejuice
    随便聊聊 rtx3090 本地模型

    只是说说个人感受

    我个人玩家
    也没搞视频
    现在用着3090x2 ,也用claude
    本地大模型 只是驱动自己的hermes 跟 RAG
    感觉已经超过我自己的需求
    Hermes 也少用 多数都用claude 解决问题
    也用显卡转了几个3d 电影
    但是只看了一套,而且是快进的看 完全没有真正享受3d 电影

    但是心里一直想要 更多的显卡
    一直想买r9700

    我是不是生病了


  • 双卡 3090 qwen 3.8-27b dflash2 131k上下文 ,100+ t/s 有大神已经搞出来了?
    A applejuice
    随便聊聊 rtx3090 qwen-27b dflash

    @stxpnet

    我在国外,邮寄需要一个星期多
    前两天搞到卖家手上,不知道他们几时才能给回复

    现在用着

    Item Value
    Model Qwen3.8-27B UD-Q4_K_M (16.46 GB, sha256-verified, nextn head present)
    Engine llama.cpp b10498-60addddf3, static CUDA sm_86
    Context 135,168
    KV q8_0 / q8_0
    Vision on (mmproj-F16)
    MTP draft-mtp, n-max 2

  • 4× RTX PRO 6000 Blackwell Max Q
    A applejuice
    装备秀 rtxpro6000 多卡部署

    这根本就是工作室了

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组