-
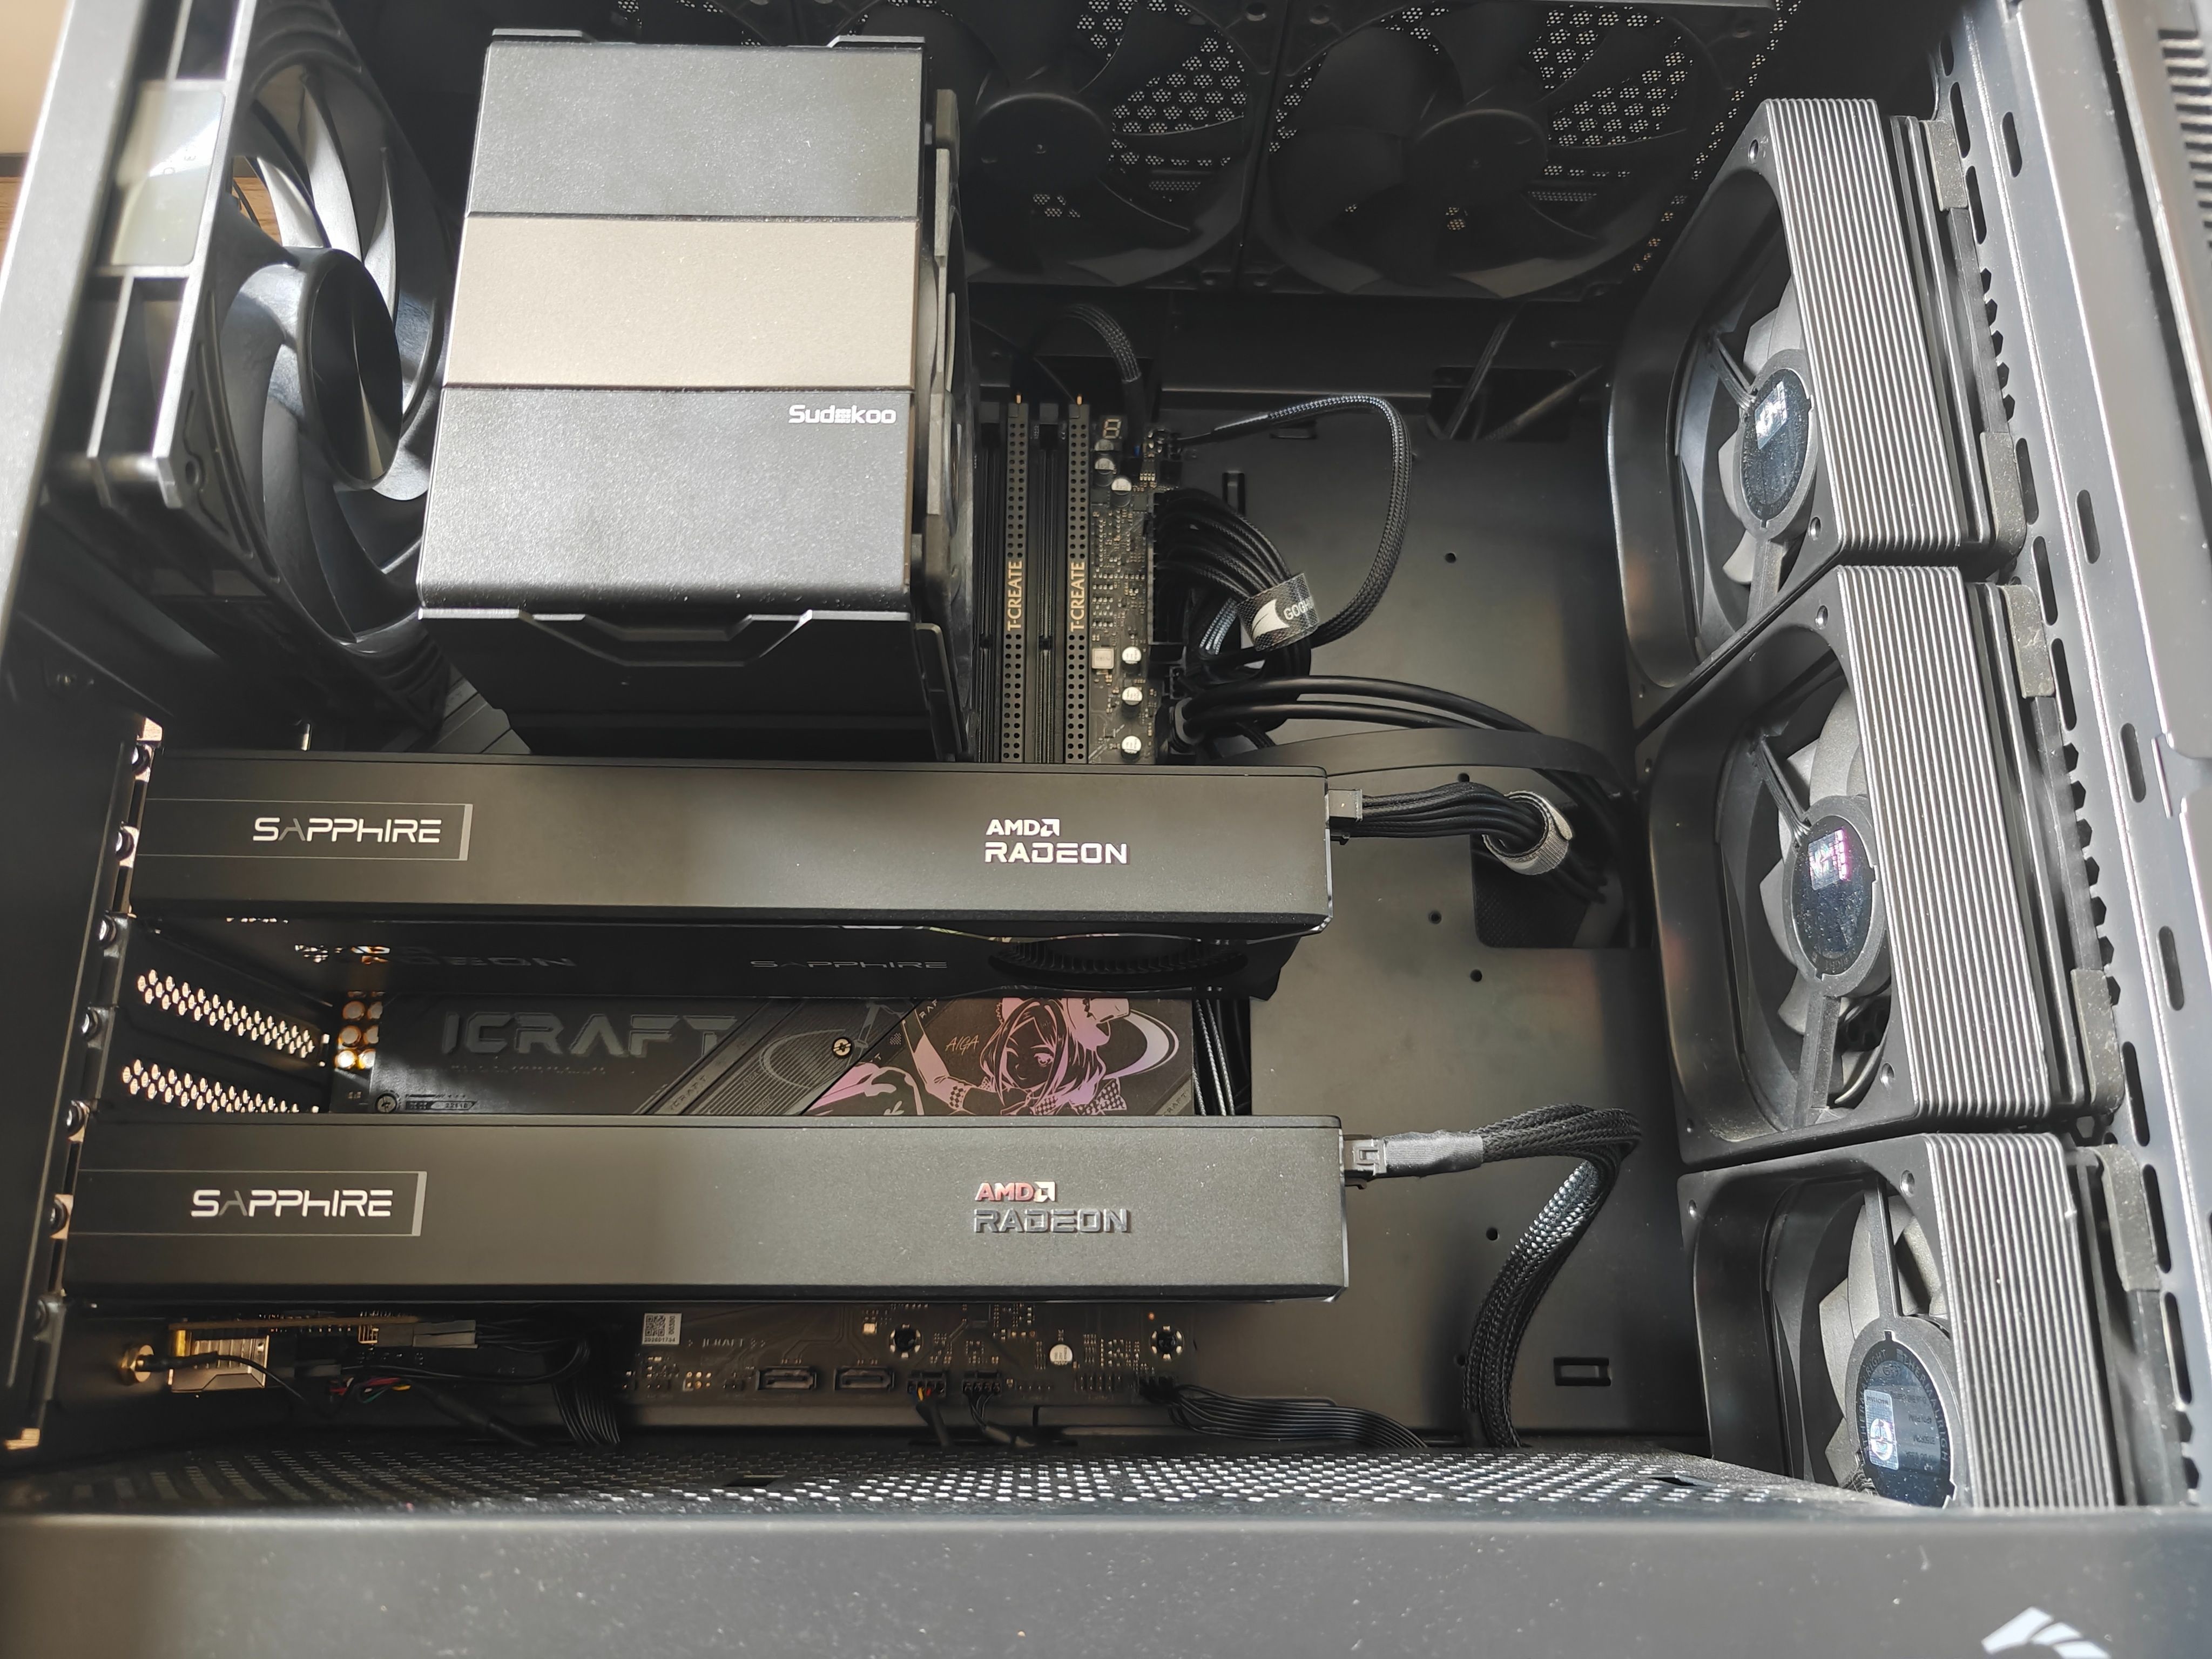
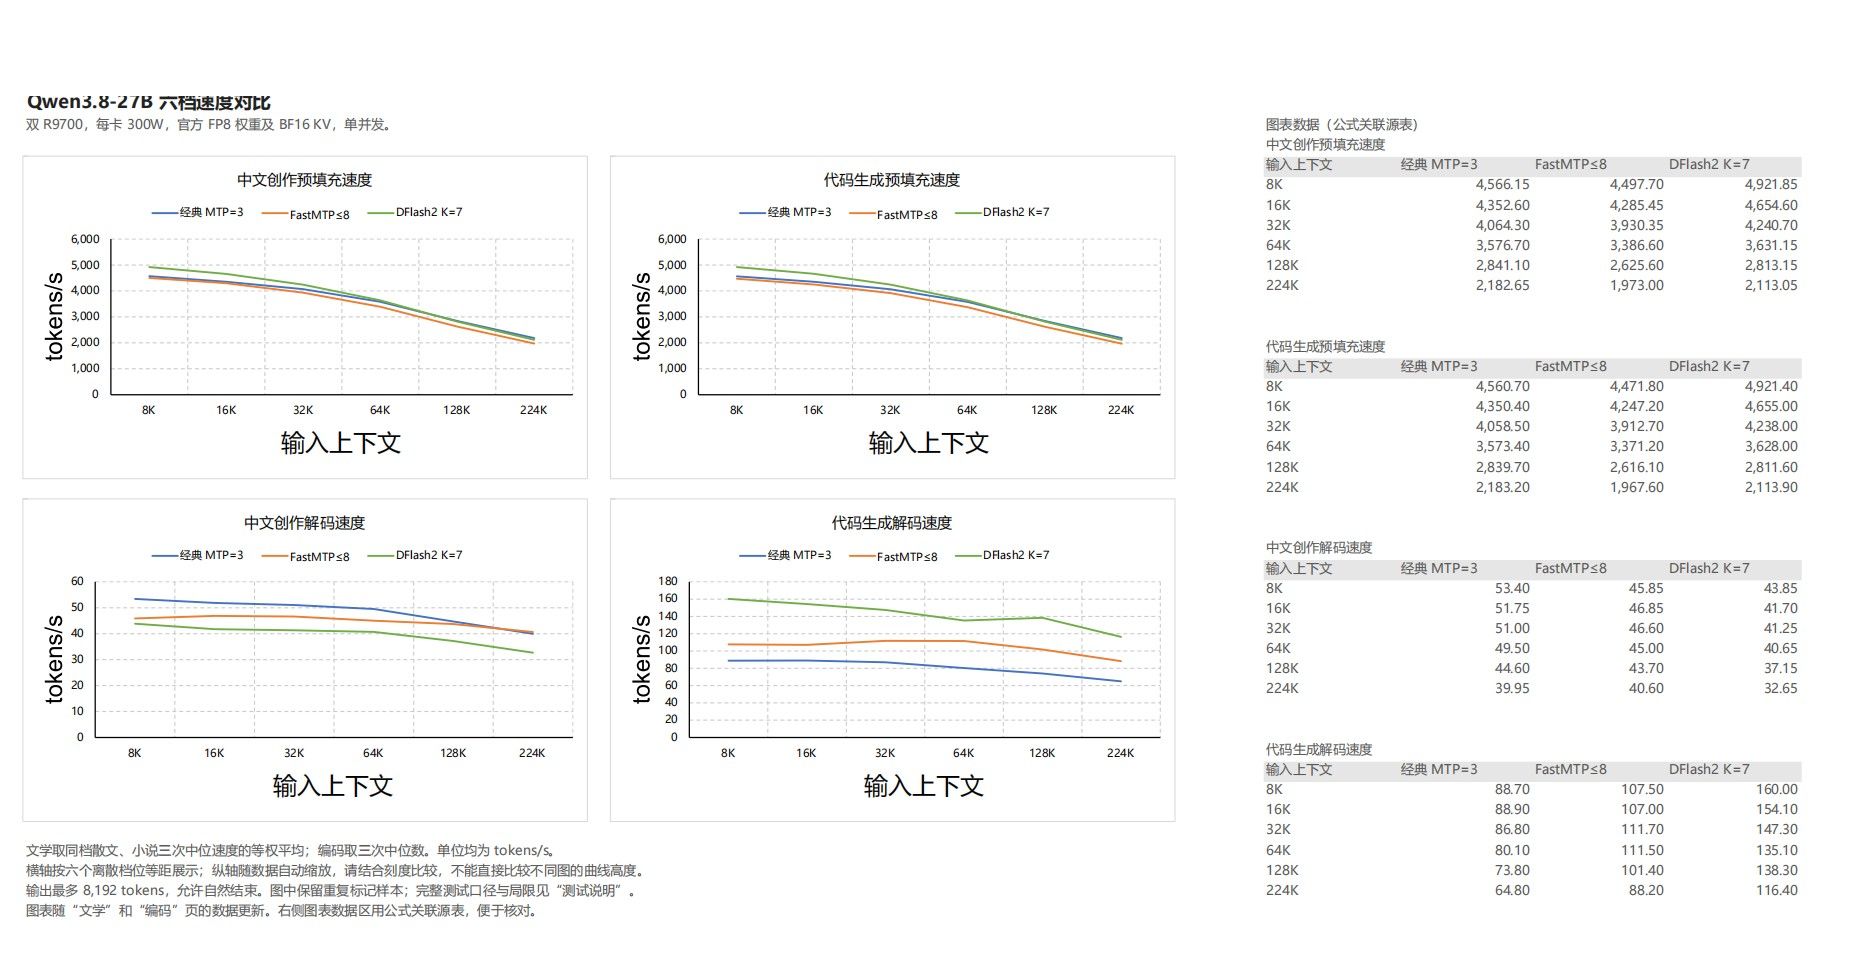
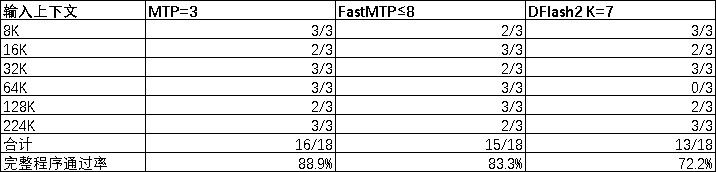
折腾了大半个月,我也是2* R9700的拥有者了! -
双 A10 运行:Qwen3.8-Flash-Next 非统一内存异构推理实测完整测试数据表
测试类型 配置/上下文 GPU层数 CPU-MoE Prompt/Prefill Generation 峰值RSS/资源 备注 短基准 双A10主配置 24 否 361.66 tok/s 13.907 tok/s RSS约67.7 GiB;显存约19/19 GiB 当前综合最优 单卡对照 单A10 12 否 305.71 tok/s 10.663 tok/s RSS约86.4 GiB;GPU1未使用 单卡+CPU异构 双卡流水对照 双A10,总计仍为12层 12 否 292.12 tok/s 8.909 tok/s RSS约86.5 GiB 比单卡更慢,decode波动较大 纯CPU对照 完全CPU 0 否 55.29 tok/s 9.065 tok/s RSS约104.36 GiB;显存0 验证高速内存影响 CPU-MoE 双A10,全部routed experts在CPU 24 48层 73.65 tok/s 12.759 tok/s RSS约102.18 GiB;显存约1.5/2.1 GiB 保留91.7%主配置decode API短提示 18-token prompt 24 否 31.03 tok/s 13.58 tok/s 双卡+CPU 固定开销占比较高 重复文本 2,207-token prompt 24 否 354.79 tok/s 12.43 tok/s 双卡+CPU 重复度高,只作乐观上界 长上下文 32,768 tokens 24 否 211.59 tok/s 9.41 tok/s 增量耗时156.5秒 从空slot开始 长上下文 65,536 tokens 24 否 136.42 tok/s 7.74 tok/s 新增32,772 tokens,耗时242.2秒 复用前32,764 tokens 极限上下文 130,000 tokens 24 否 85.01 tok/s 4.45 tok/s 新增64,468 tokens,耗时765.4秒 最终slot约130,031 tokens 满上下文资源 130K填充完成 24 否 — 4.45 tok/s RSS约72.54 GiB;显存22.2/21.4 GiB 系统仍约47 GiB available 内存带宽 1线程 — — Copy 14.60 GB/s — Triad 15.41 GB/s 单线程 内存带宽 8线程 — — Copy 77.34 GB/s — Triad 91.30 GB/s — 内存带宽 16线程 — — Copy 110.12 GB/s — Triad 130.82 GB/s 物理核心数 内存带宽 32线程 — — Copy 112.56 GB/s — Triad 133.42 GB/s SMT增益很小 PCIe GPU0 Host→Device — — 23.95 GB/s — PCIe 4.0 x16 — PCIe GPU1 Host→Device — — 23.91 GB/s — PCIe 4.0 x16 — PCIe GPU0/1 Device→Host — — 26.30/26.29 GB/s — PCIe 4.0 x16 — 本地显存 GPU0/GPU1 — — 558.04/558.06 GB/s — ECC关闭 两卡对称 跨卡能力 GPU0  GPU1
— — P2P不支持 — 无NVLink,经主机桥接 单向中转约20.2 GB/s -
ROCm 7.14 与 ROCm 10.0:llama.cpp Q8 160K 双卡实测下午摸鱼的时候无意中发现 ROCm发布10.0了 (其实本质上是7.15
 ),不过看他版本号跨度这么大,想必定是有什么过人之处,于是让Codex替我盘盘他。
省流:
与 ROCm 7.14 没啥差别。
测试平台:
GPU:Radeon AI PRO R9700 32GB + Radeon RX 9070 16GB
设备顺序:HIP_VISIBLE_DEVICES=1,0
功耗上限:R9700 210W,RX 9070 200W
llama.cpp:d3371929bb1b6982cf73f1e54156d3d426cd80a1
ROCm 7 镜像:local/llama.cpp-rocm:7.14.0-gfx1201-rccl
ROCm 10 镜像:local/llama.cpp-rocm:10.0.0-gfx1201-rccl
编译参数:GGML_HIP=ON、GGML_HIP_RCCL=ON、GGML_HIP_GRAPHS=ON、AMDGPU_TARGETS=gfx1201
模型:Qwen3.8-27B HauhauCS-Aggressive Q8_K_P
mmproj:BF16
KV:FP16
上下文:160K、parallel=1
双卡:split-mode=tensor、tensor-split=65,35、RCCL
MTP:n-max=3
每轮请求:160K token输入,128 token输出,cache_prompt=false结论
核心指标 ROCm 7.14 ROCm 10.0 ROCm 10 相对变化 160K 冷 Prefill 370.759 t/s 370.740 t/s -0.005% Decode 35.721 t/s 37.281 t/s +4.366% 端到端墙钟 445.170 秒 445.058 秒 -0.025% - Prefill 持平。 两版均值仅差 0.020 t/s,远小于两轮自然波动,不构成性能差异。
- Decode 有小幅、稳定收益。 ROCm 10 两轮分别为 37.291、37.271 t/s;ROCm 7 两轮为 35.717、35.726 t/s,提升约 4.37%。
- MTP 行为一致。 四轮接受率均为 89/113,即 78.761%,因此 Decode 差异不是由接受率变化造成的。
- 端到端无收益。 ROCm 10 平均墙钟只少 0.111 秒;对一次约 7 分 25 秒的请求,这一差异不可感知。
-
27B 本地模型能做严肃逆向吗?Qwen3.8 硬刚最近很火的 Ox Alpha(牛来)匿名模型实测 -
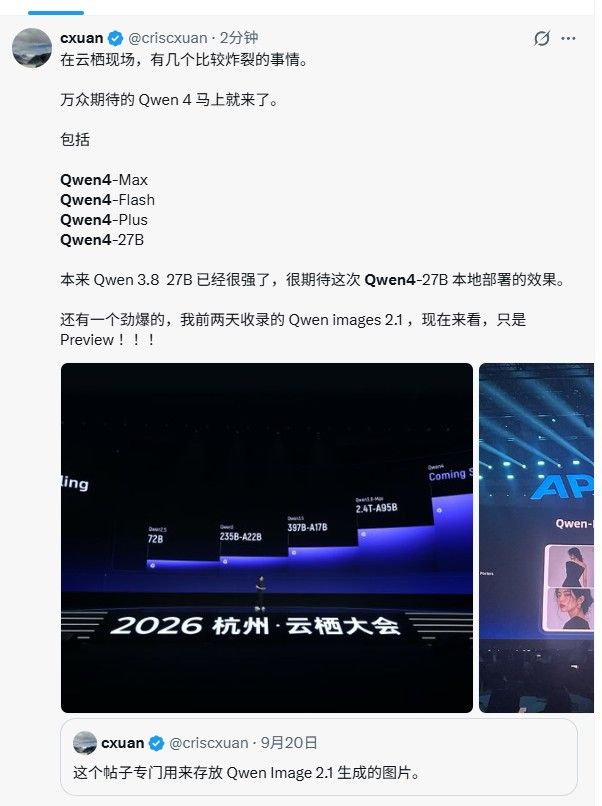
Qwen4也要来了! -
Qwen releases Qwen3.8-Flash-Next! 來了 -
第二张 AMD 显卡该怎么用?一次 128K Agent 双卡推理实测结论:第二张显卡究竟值不值得?
回到最开始的问题,那就是这套AMD平台究竟值不值得继续折腾多卡?
我的答案是:
值得,但需要清楚自己得到的是什么。
RX 9070并没有让R9700的性能简单翻倍。这套同架构异规格双卡仍然受到显存容量不对称、计算能力差异和PCIe通信的限制。TP需要快卡等待慢卡,PP又无法自动提高单流生成速度,额外的驱动、构建和参数维护也都是真实存在的成本。
但第二张显卡同样不只是增加了16GB显存,在严格同条件测试中,TP + RCCL + MTP把129K启动、高缓存命中追加和31K突发追加三种长上下文任务的总等待时间缩短了大约32%到34%。
对于一次十几秒的短对话,这种差距可能不算久,但对于一个持续运行数小时、不断搜索、编译、测试和调用工具的Agent任务,每一轮节省下来的几秒或者几分钟,最终都会累积成可以真实感受到的工作效率。
这也是这次实验给我最重要的答案:
双卡没有让本地模型突然变成另一种级别的产品,但它确实让一个已经能够完成工作的模型,变得更适合持续工作。
RX 9070也完成了它作为“测试卡”的任务。
它证明了这张B850主板可以实现PCIe 5.0 x8/x8和双向P2P,证明了ROCm上的TP与RCCL能够在消费级平台上获得实际收益,也暴露了DFlash2在TP分片权重路径中的兼容问题。更重要的是,它让我在真正购买第二张R9700之前,先用相对有限的成本看清了多卡能够带来什么,又需要付出什么。
如果未来升级到双R9700,两张卡拥有相同的显存容量和计算规模,切分与同步应该会比现在更加自然。
至于这篇文章本身,如果后来有人在相似的平台上尝试AMD双卡,能够因为这些记录少走一点弯路,那么这次折腾就已经超过了它最初的意义。
-
ROCm 7.14 与 ROCm 10.0:llama.cpp Q8 160K 双卡实测原始结果
运行时 轮次 Prefill t/s Decode t/s Prompt 秒 Decode 秒 墙钟秒 MTP 接受率 ROCm 7.14 1 372.374 35.717 439.644 3.500 443.323 78.761% ROCm 7.14 2 369.145 35.726 443.490 3.499 447.016 78.761% ROCm 10.0 1 371.095 37.291 441.159 3.352 444.728 78.761% ROCm 10.0 2 370.384 37.271 442.006 3.354 445.389 78.761% -
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code -
【R9700/RX7900XT】Comfy UI 的 ck-attention 配合8步 加速 LoRa 效果明显,强烈推荐大家试一下。如题,Comfyui 现支持 CK Attention 和 Rocm 动态显存,Minimax H3 总完成时间与基线缩短一半。
我的配置是CPU:R7 9700X,内存:DDR5-6000 2x24GB,显卡:R9700;系统Windows 11。
ComfyUI 版本:0.33.1 & ROCm 7.14 & PyTorch 2.12.0,添加以下启动项后:
--use-ck-attention

--enable-dynamic-vram
生成时间为 180.02秒(8/8 [01:56<00:00, 14.58s/it] ),而不添加此启动项则为 284.44秒(8/8 [03:14<00:00, 24.28s/it])秒,约为1.6倍,效果显著。
我测试的视频随机种子为 43 ;视频比例为 16:9;视频长度为 8秒;0.4MP的清晰度;
这是我的测试提示词:
integrated_multimodal_description: [Shot 1] Live-action, cinematic, dreamlike photorealism. At blue hour beneath a deep indigo sky, a young East Asian woman with long black hair walks slowly through a vast field of delicate white flowers covered by ankle-high silver mist. She wears a flowing translucent white chiffon dress with subtle pearl embroidery. A low-angle tracking shot follows behind her with smooth, gentle movement as her hair, sleeves, and layered skirt drift naturally in the soft night breeze. Cool moonlight creates realistic highlights along the fabric and flower petals, while faint warm light glows beneath the mist. A luminous blue butterfly enters from the right, circles once around her shoulder, and settles lightly on her extended fingertip. She pauses and turns into a graceful three-quarter profile, watching it with a subtle, peaceful expression. The camera begins a slow arc around her with small amplitude. The butterfly dissolves into hundreds of tiny blue-white particles that flow from her hand like sparkling dust. A circular wave of light travels outward through the field, causing the flowers to illuminate one after another in a smooth expanding pattern. The camera gently cranes upward and moves past her, revealing a perfectly still mirror-like lake beyond the flowers and an enormous luminous full moon resting close to the horizon. The moon, stars, glowing flower field, and drifting particles reflect naturally in the water. The final frame holds briefly on the woman standing alone before the moonlit lake as several glowing particles float upward. Realistic human anatomy, consistent facial identity, physically accurate fabric and hair movement, volumetric moonlight, shallow depth of field, subtle lens bloom, fine film grain, high dynamic range, elegant restrained color grading, no cuts, no dialogue, no visible text.

overall_soundscape: A soft night breeze moves through the flowers and gently rustles the woman's chiffon dress. Her quiet footsteps brush against the grass, accompanied by a delicate crystalline shimmer when the butterfly dissolves and the flowers begin to glow.

non_diegetic_music: Sparse felt-piano notes at a slow tempo, joined by a sustained ethereal string pad and very light glass harmonics. The music gradually rises as the flowers illuminate, then resolves into a soft sustained note over the final frame.
另外也可以通过安装节点来进一步加速(不过我嫌麻烦没有折腾),节点链接:
https://github.com/xmarre/ComfyUI-Spectrum-MiniMax-H3
Reddit原帖:
https://www.reddit.com/r/comfyui/comments/1vo9zjj/comfyui_now_supports_ck_attention_and_dynamic/
另外还有个利用Ltx2.5为MiniMax H3 放大的放帖子我觉得也不错,所以也一并搬来了,但我没有尝试:
-
有关论坛声望问题的咨询。 -
抡友们Qwen Image 2.1 发布了如题 :https://qwen.ai/blog?id=qwen-image-2.1
 现在还在加班,有没有已经吃上螃蟹的抡友说一下是个什么滋味儿?
-
MiMo-2.6-Flash 发布了HF: https://huggingface.co/collections/XiaomiMiMo/mimo-v26
一共发布了三款,参数如下:
XiaomiMiMo/MiMo-V2.6-Flash-RL 约 159B 、 XiaomiMiMo/MiMo-V2.6-Pro-RL约 524B
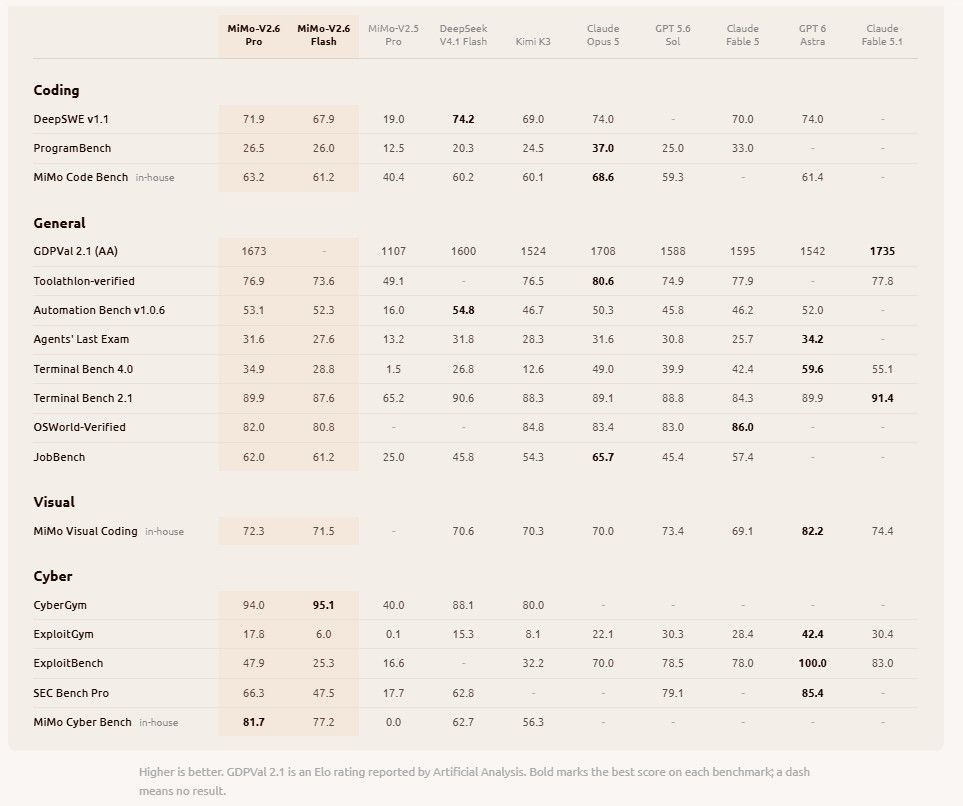
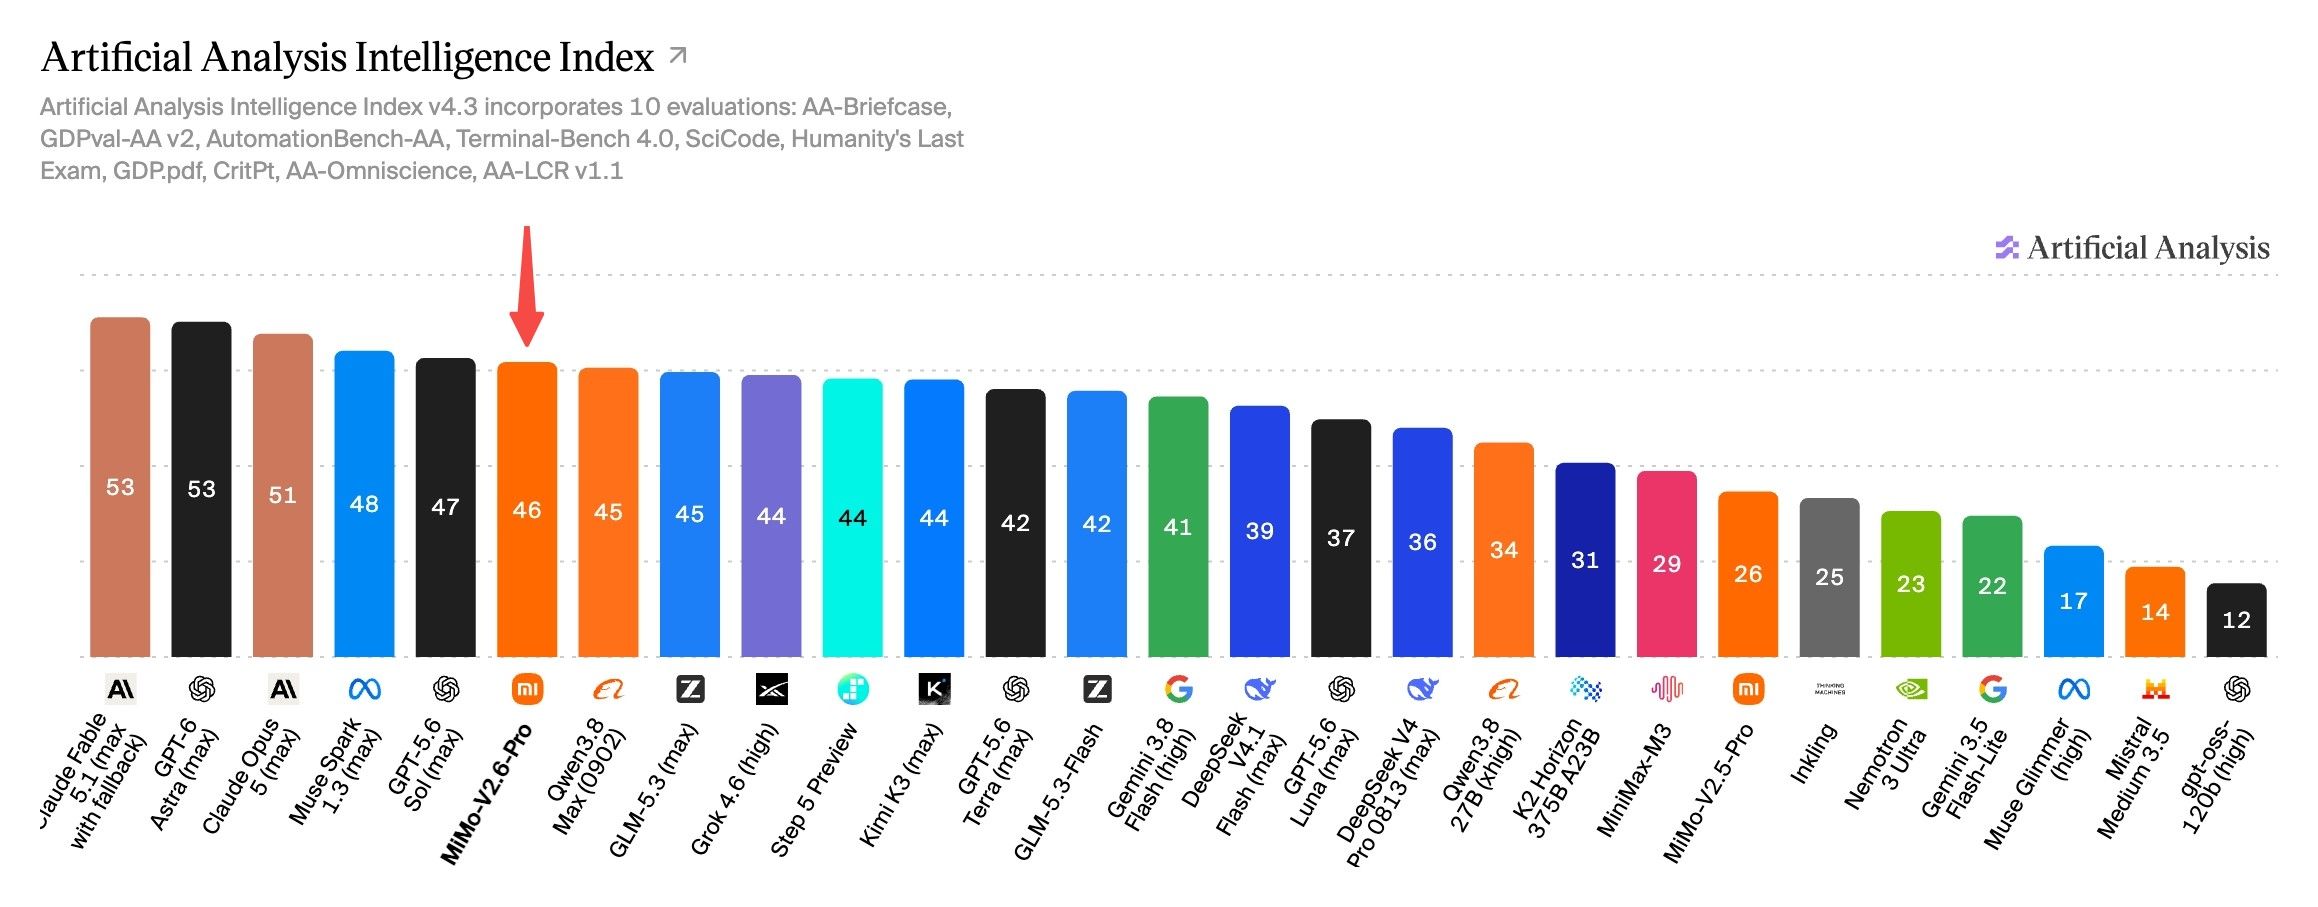
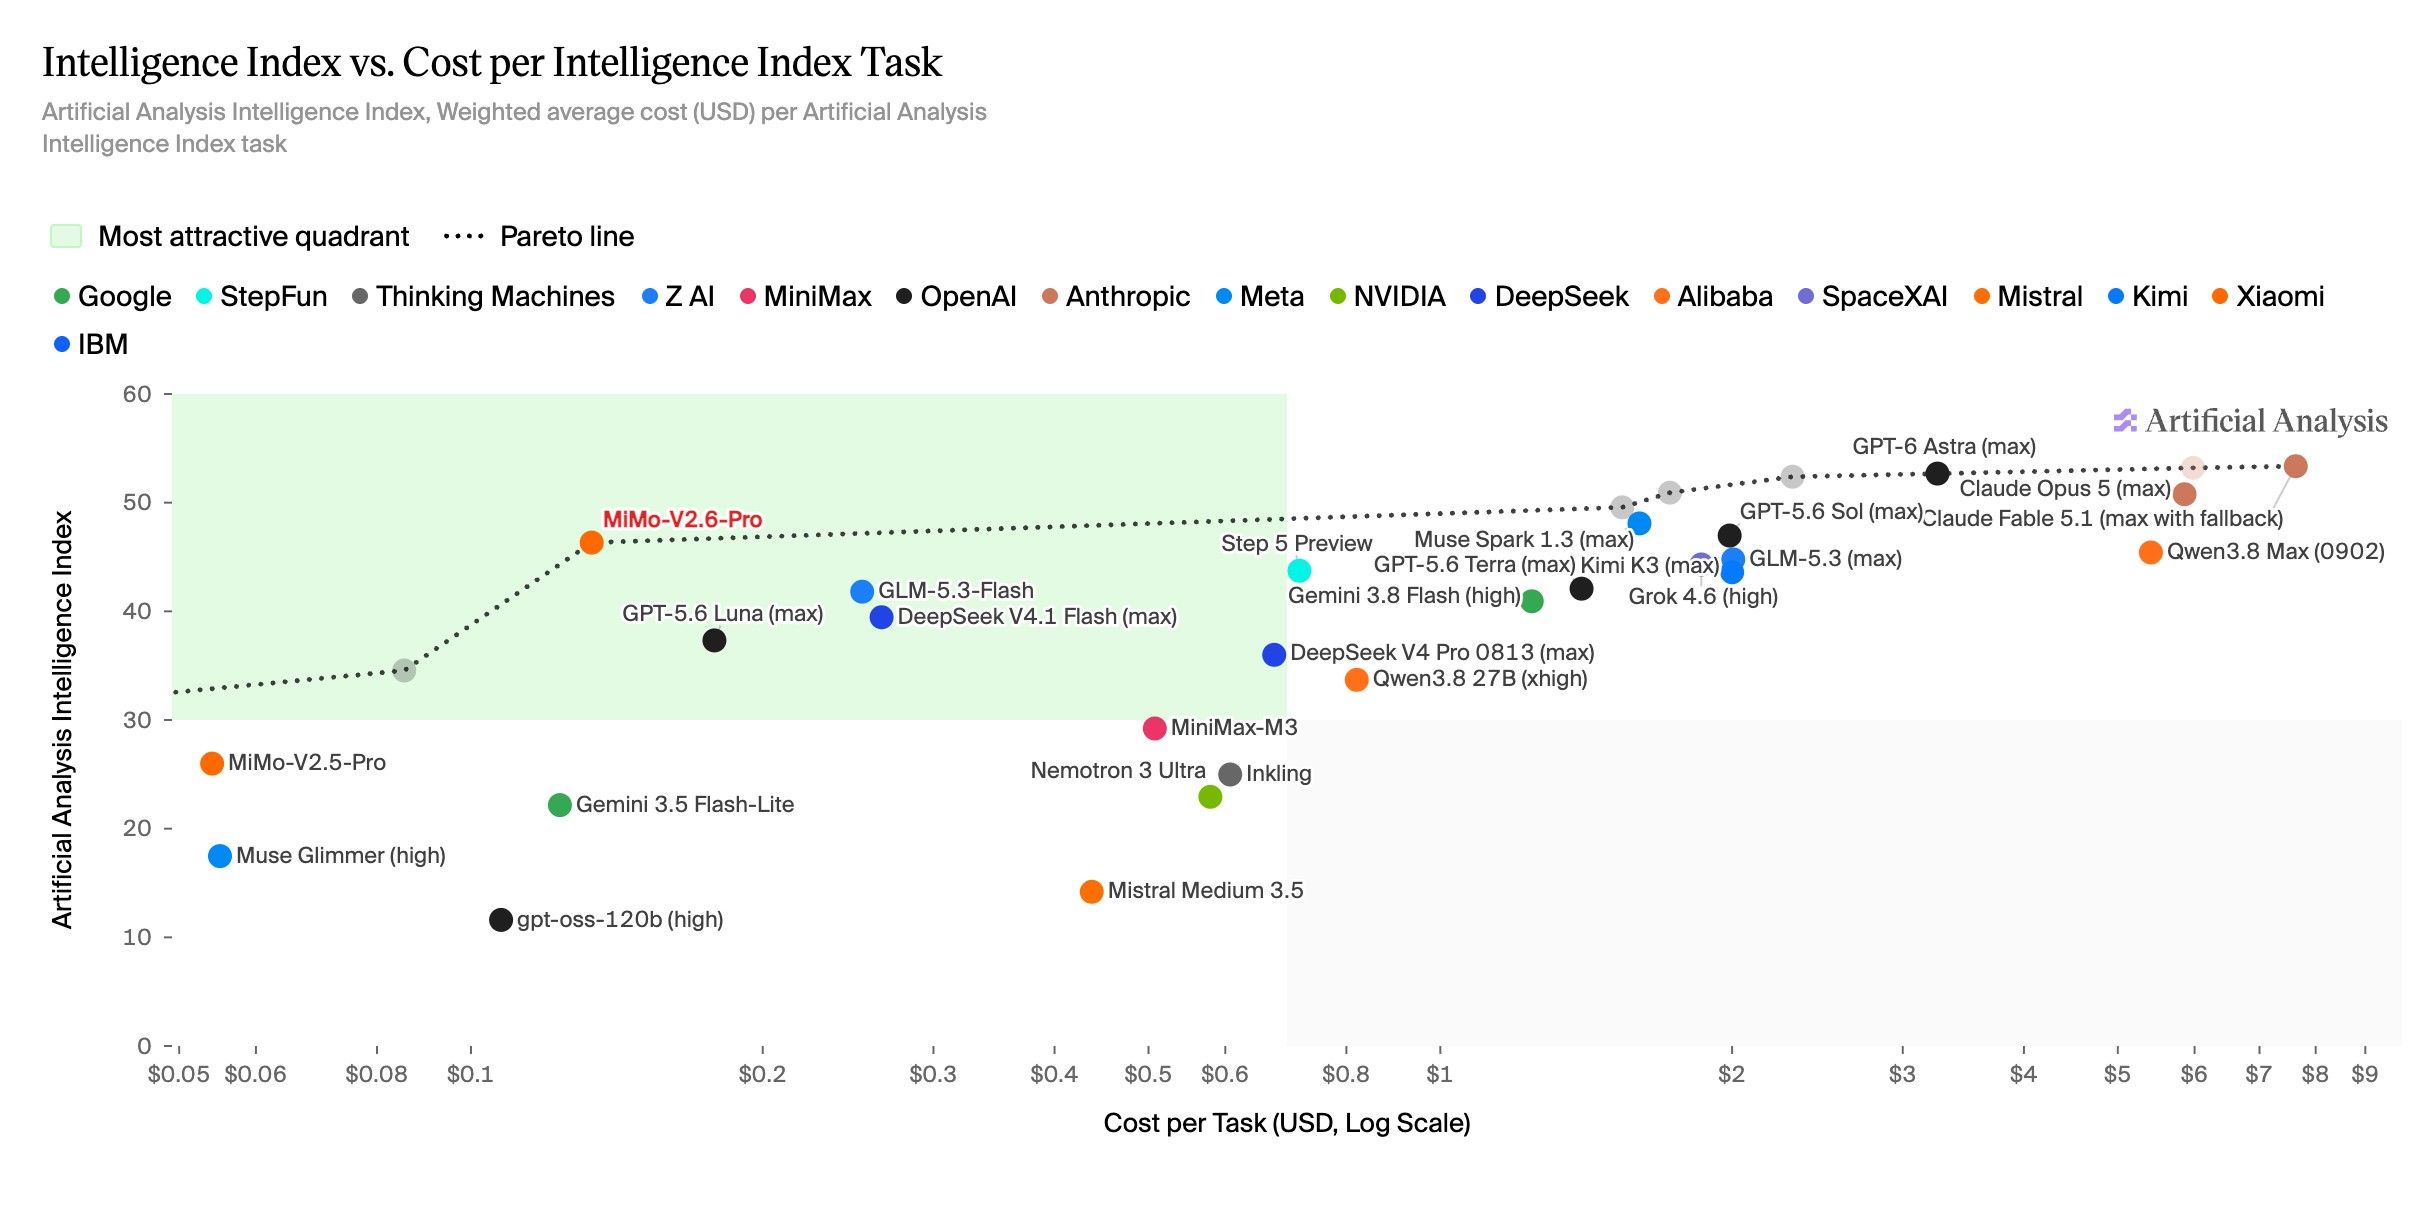
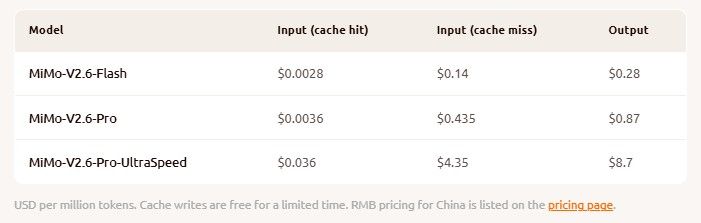
价格:
最有意思的是 XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B 约9B
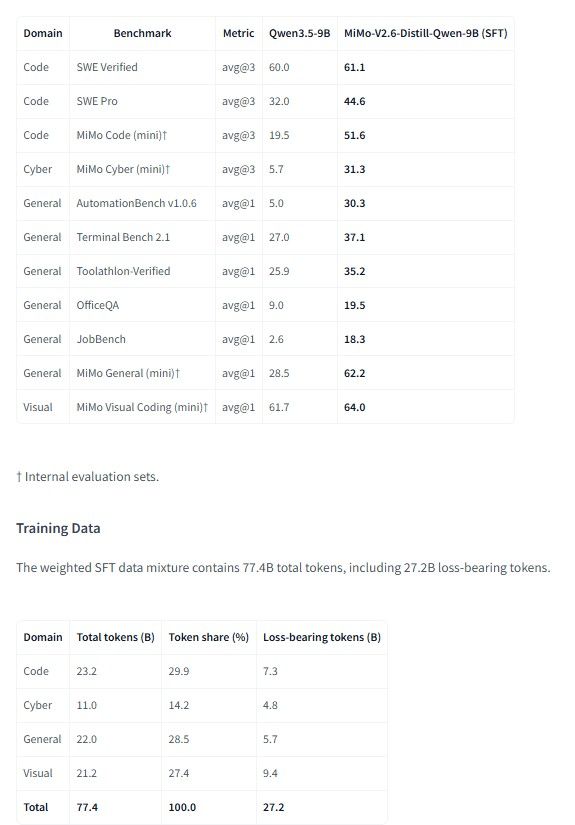
PS:不过在隔壁听说好像刷分严重,不知道真假,不过对于我来说,只要9B模型能比原来的Qwen3.5 强就好...

-
R9700 很香。 -
论坛遭机器人攻击:Hermes + DeepSeek V4 Flash自动防御处理,AI Agent代替人类完成繁琐运维工作! -
R9700 很香。 -
R9700 很香。 -
第二张 AMD 显卡该怎么用?一次 128K Agent 双卡推理实测 -
第二张 AMD 显卡该怎么用?一次 128K Agent 双卡推理实测二、两张显卡,究竟应该怎样分工?
RX 9070已经选好了,P2P测试也顺利通过了测试。但这只解决了两张显卡能不能直接交换数据的问题,还有一个更加关键的问题没有回答,那就是它们究竟应该怎样一起计算?
毕竟,llama.cpp可不会因为系统里多出一张显卡,就自动把两张卡的性能相加,显卡插上去只是第一步,模型权重、KV Cache和计算任务究竟怎样分配,仍然需要由我们自己选择。
相同的硬件可以采用完全不同的模型切分方式,而切分方式会直接影响跨卡通信频率、显存分配以及最终的性能特征。这一步选得是否合适,可能决定第二张显卡究竟是一块加速器,还是一项额外的通信负担。
目前llama.cpp的--split-mode支持none、layer、row和tensor四种模式。其中none只使用单张显卡,真正涉及多卡切分的是layer、row和tensor。
row模式会按行切分部分模型权重,但中间结果和KV Cache仍主要放在指定的主显卡上。它没有充分利用两张卡共同分担长上下文KV Cache,与这次利用48GB总显存服务128K Agent的目标并不完全一致,因此本文不再展开测试(官方也不推荐使用)。
最终,我真正需要比较的是两条路径,layer模式(也就是下文所说的PP),tensor模式(也就是仍处于实验阶段的TP)。
它们使用的是同一套硬件,却代表了两种完全不同的多卡思路。把不同的模型层交给不同显卡(PP)
PP在llama.cpp中对应 --split-mode layer。
它会把模型的不同层分配给两张显卡。例如,前面一部分层由R9700负责,后面一部分层由RX 9070负责。数据完成一段计算后,再通过PCIe传递给下一张显卡继续处理,它更像是把一条生产线拆成了两个工段。
这种方式的优势是跨卡通信相对简单。模型不需要在每一层都让两张显卡交换中间结果,通常只需要在不同模型阶段的边界传递数据。因此,即使PCIe互联速度远不及显存带宽,PP仍然比较容易获得可用的性能。
兼容性也相对成熟,量化KV Cache、视觉模型和独立草稿模型通常更容易在PP模式下运行。
但PP的问题同样明显,那就是对于单个token来说,两张显卡并不是同时完成同一层计算的,而是依次经过两个模型阶段。R9700完成自己的部分之后,RX 9070才能继续处理后面的层。
所以在单并发的Agent任务中,这种串行关系会限制逐token生成速度。即使两张卡都在参与推理,也不代表生成速度一定会比单卡更快。
让两张显卡共同计算每一层(TP)
TP对应 --split-mode tensor。
与PP不同,TP不是把不同模型层分别交给两张卡,而是把同一层中的张量切分到两张显卡上。R9700和RX 9070会同时计算这一层的不同部分,然后再通过跨卡通信合并结果,继续进入下一层,它更像是让两个人同时完成同一道工序。
这种方式更有机会降低单个token的生成延迟,也更加符合我最初希望双卡共同加速的设想。但它对跨卡通信的要求明显高于PP,因为两张卡几乎每一层都要交换和归约数据,任何通信延迟都会不断累积。所以TP是本次实验的预期目标。
这也是PCIE-P2P对TP格外重要的原因。如果没有P2P,每一层的同步都可能绕经CPU内存,而即使P2P已经可用,PCIe延迟、两张卡的性能差异以及PCIE归约实现,仍然可能限制最终收益。
两种模式可以简单概括为:
项目 PP / Layer Split TP / Tensor Split 切分对象 不同模型层 同一层中的张量 跨卡通信 主要发生在阶段边界 几乎每层都要通信 对P2P依赖 相对较低 很高 单流Decode 容易受串行阶段限制 更有机会降低延迟 长提示Prefill 通常较有优势 受跨卡同步影响 软件兼容性 相对成熟 仍带有实验性质 异规格双卡问题 阶段负载不均 快卡频繁等待慢卡 存算比例
在本次测试中无论使用PP还是TP,都不能不加思考地把两张显卡按照50/50平均切分。
R9700拥有32GB显存和64个CU,RX 9070则拥有16GB显存和56个CU。两张卡的显存容量比例接近2:1,但计算单元比例只有大约53:47。这意味着显存分配和算力分配之间,本身就不存在一个绝对完美的比例。
如果按照50/50切分,计算负载看起来比较接近两张卡的CU比例,但RX 9070只有16GB显存。在128K上下文、FP16 KV、mmproj和投机解码组件同时存在时,它会比R9700更早接近显存上限,也很难为计算缓冲区和软件版本变化留下足够余量。
如果完全按照32GB与16GB的显存容量切成67/33,又可能把过多计算交给R9700,没有充分利用RX 9070的56个CU。最终,这次严格对照测试主要使用了一个相对保守的折中比例:
--tensor-split 65,35
它更接近两张卡的显存容量比例,优先保证16GB的RX 9070不会过度接近显存边界,同时让计算能力更强、显存更大的R9700承担更多模型权重和额外组件。
在128K、FP16 KV、完整模型、mmproj和MTP同时加载的情况下,两种实际测试过的比例大致表现为:
切分比例(R9700 / RX 9070) R9700显存占用 RX 9070显存占用 65/35 约23.3GB 约12.9GB 60/40 约22.1GB 约14.1GB 60/40能够更充分地使用RX 9070,但副卡显存余量会进一步缩小,而65/35则为16GB显存留下了更安全的运行空间。因此,后面的严格性能对照统一采用65/35,避免显存压力变化干扰测试结果。
在测试开始之前,还有一个很容易踩坑的问题,那就是设备顺序。
本机原始设备编号为:
GPU0 = RX 9070
GPU1 = R9700
但测试时使用了:
HIP_VISIBLE_DEVICES=1,0这条环境变量重新排列了ROCm设备顺序。进入llama.cpp之后,R9700成为逻辑上的ROCm0,RX 9070成为ROCm1。
所以:
--tensor-split 65,35在本文中实际表示:
R9700:65
RX 9070:35
这里的65和35本质上是相对权重,并不强制要求总和等于100写成65/35,只是更方便按照百分比理解。
另外值得一提的是,--tensor-split这个名字也容易让人误以为它只对TP有效。实际上,在layer模式中,它同样用于决定不同显卡获得模型层的相对比例,在tensor模式中,则用于控制模型张量和KV Cache在不同设备间的目标分配比例。
还需要注意,65/35只是模型切分的目标权重,并不意味着两张显卡最终的显存占用、计算量和执行时间都会严格保持65/35。
KV Cache、计算缓冲区、输出层、mmproj、草稿模型以及无法无限细分的模型层,都会让最终结果发生偏移。它不保证两张卡最后一定按照同样的百分比工作。
RCCL
TP会把同一层的模型张量分到两张显卡上并行计算。完成各自的部分后,两张卡还需要对中间结果进行Reduce和Sync,才能继续进入下一层。这个过程会在模型的许多层中反复发生。
如果把P2P理解成两张显卡之间的一条直达道路,那么RCCL负责的,就是怎样在这条道路上组织跨卡数据交换。
RCCL是AMD面向多GPU集合通信提供的运行库,可以为Reduce、AllReduce等操作提供专门的通信实现。启用RCCL之后,llama.cpp可以使用这套路径完成TP中的部分跨卡Reduce,减少普通后端路径中的同步和数据合并开销。
但需要强调的是,RCCL并不是一个让TP从不能运行变成能够运行的开关!
在没有RCCL时,llama.cpp依然可以通过普通后端路径完成跨卡Reduce,启用RCCL只是尝试让这部分通信更加高效。最终能够带来多少提升,取决于跨卡通信在整个推理过程中的耗时占比。
如果瓶颈主要来自跨卡Reduce,那么RCCL的收益就会比较明显。如果主要时间已经消耗在长上下文Attention、显存访问或者模型本身的计算上,那么RCCL即使优化了通信,在总耗时中的提升也可能很有限。
 ,不过沟通蛮愉快的,从寄出去显卡到收到打款大概是5天。