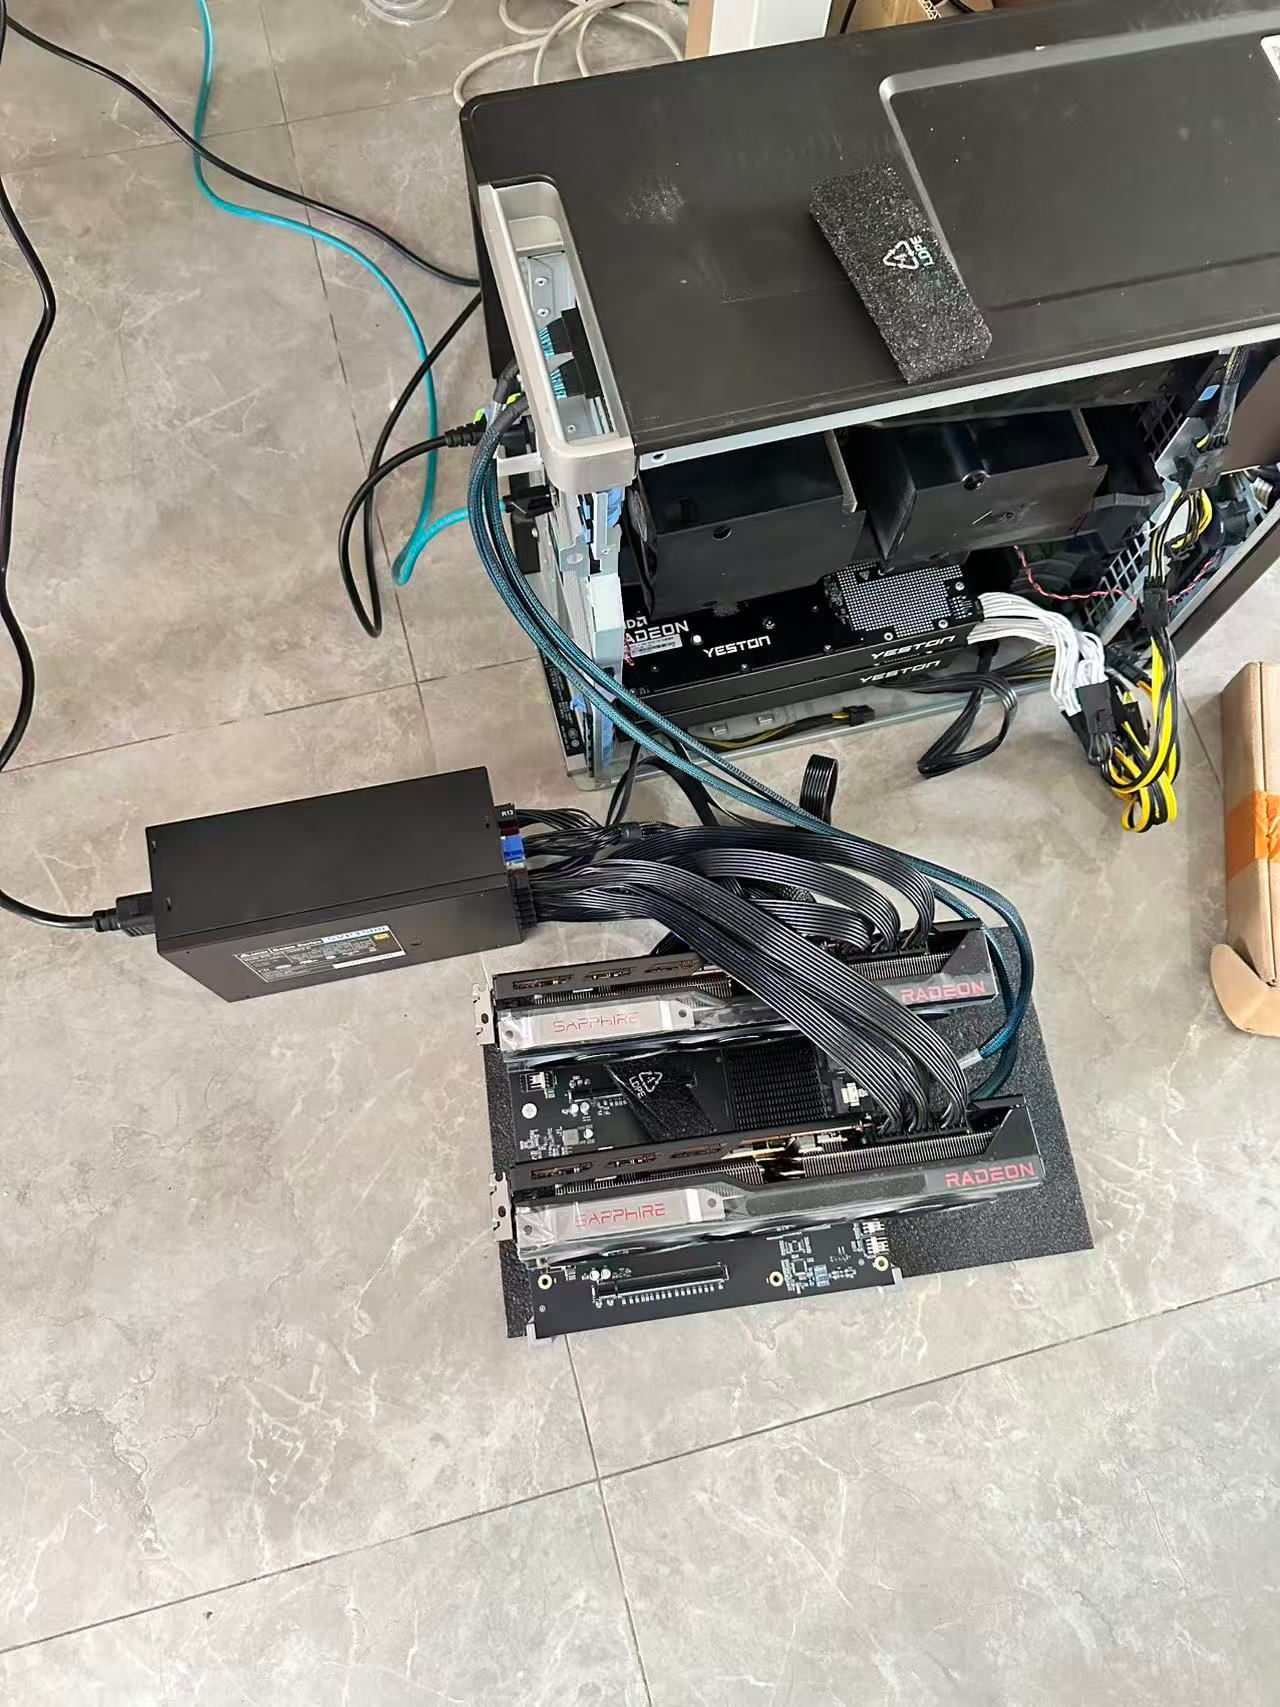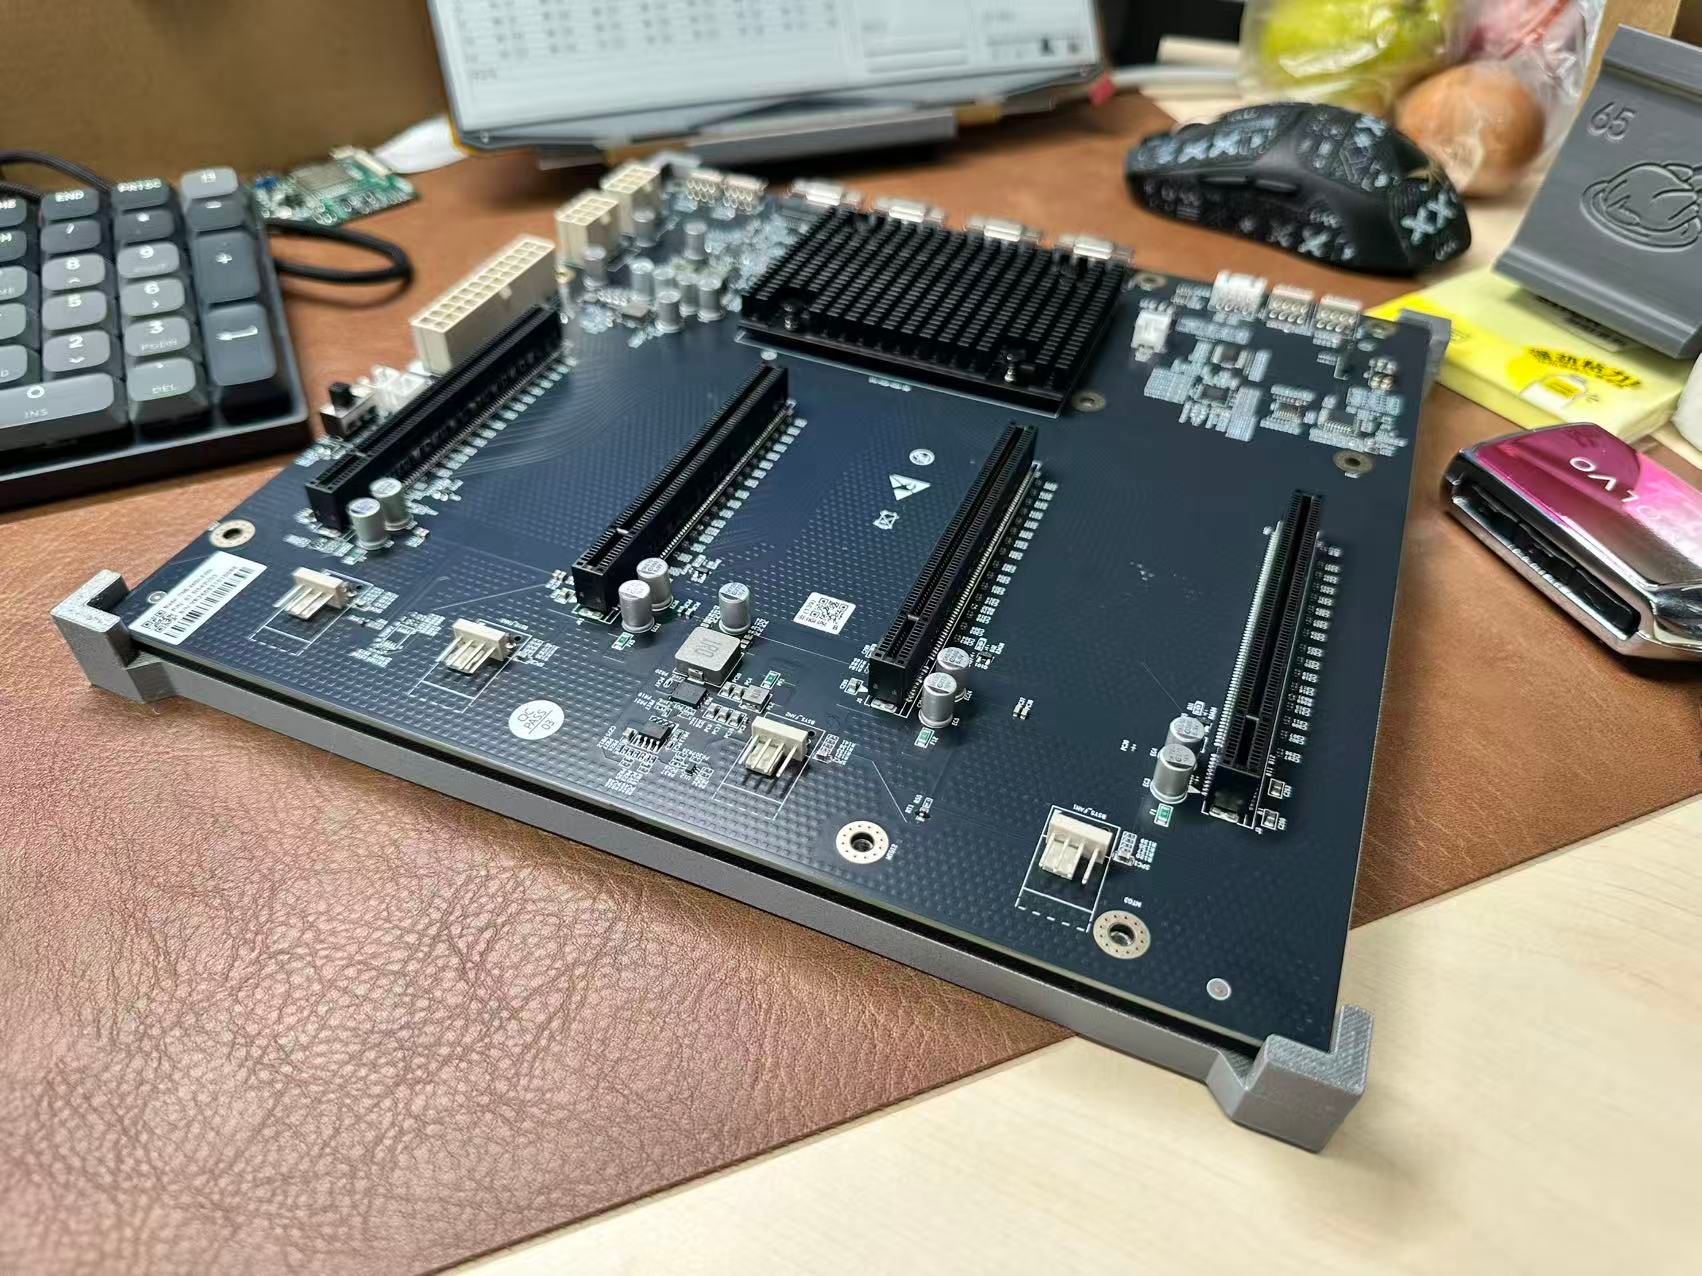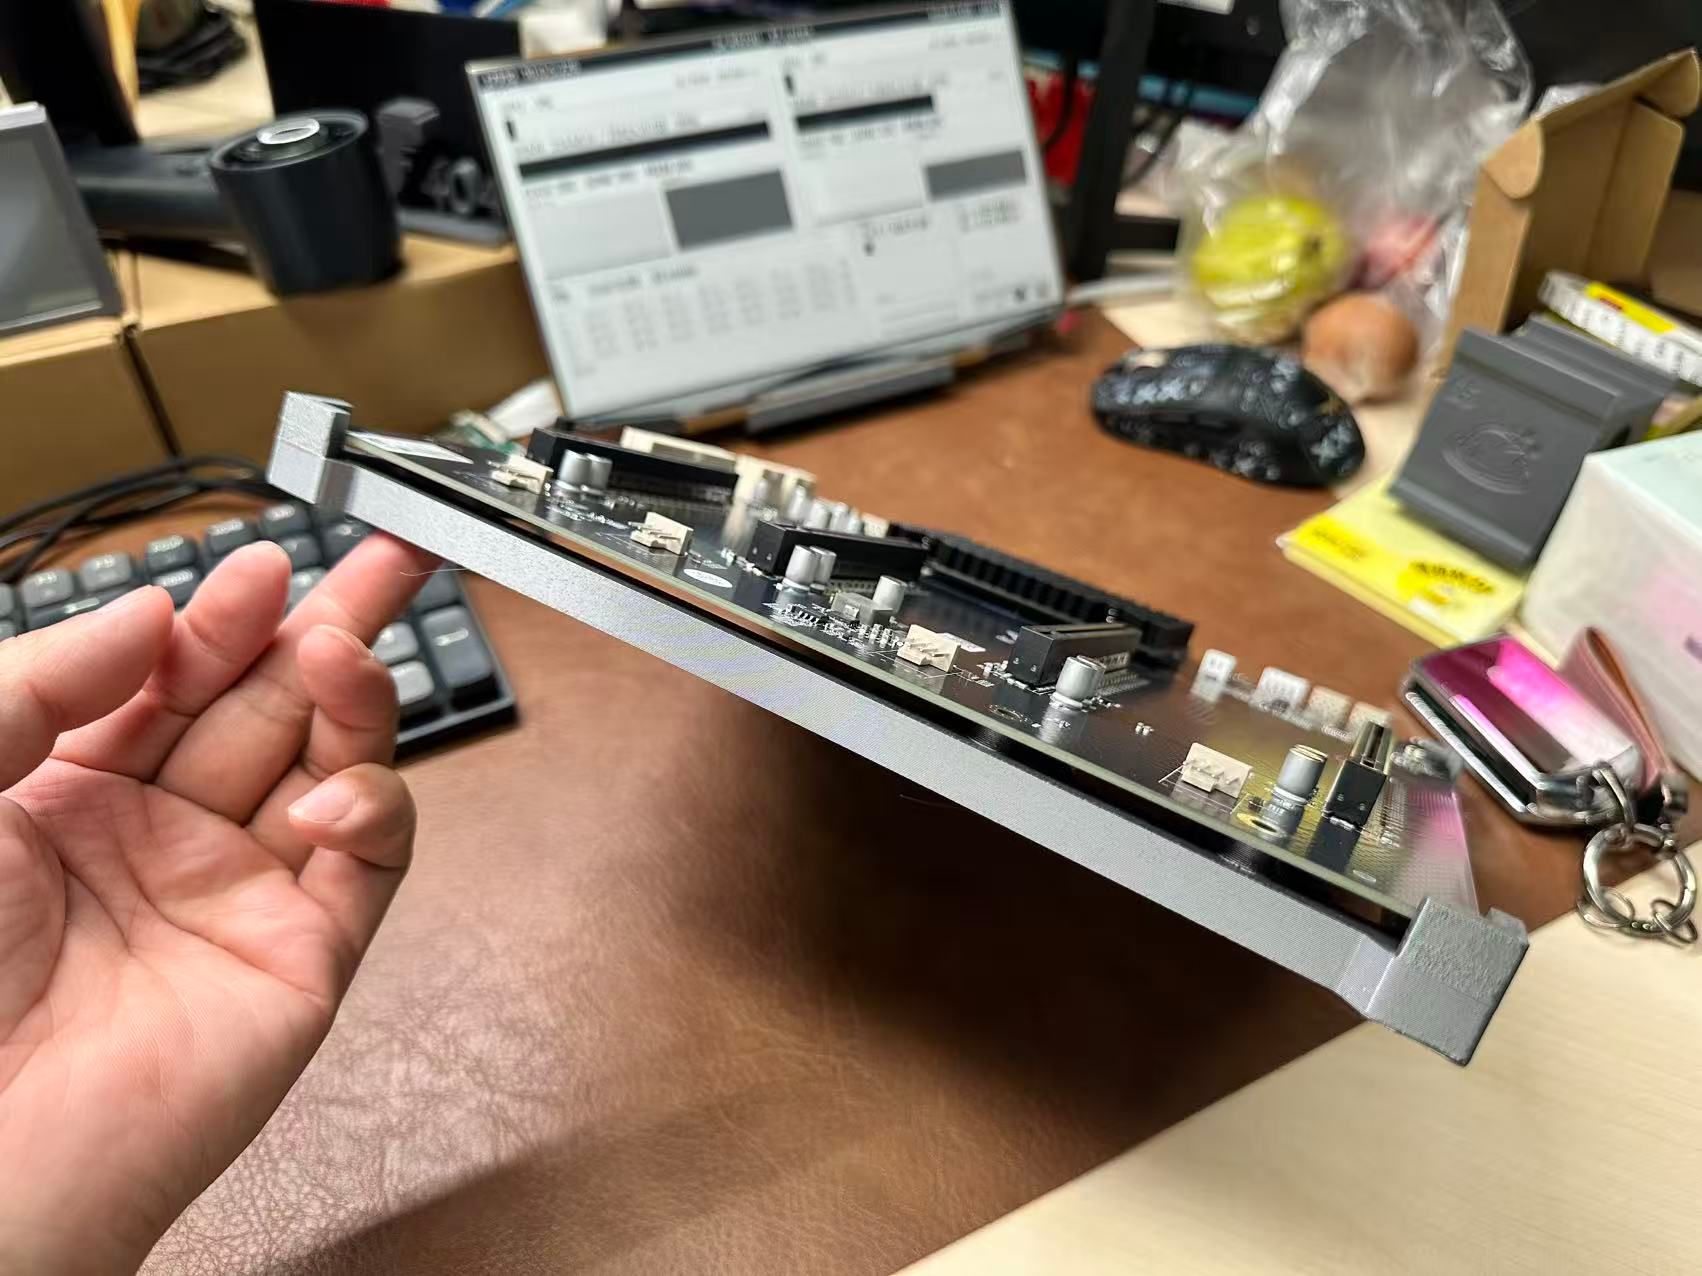
这下内存是不得不加了。
-
Strata × RDNA2:6000 系老卡跑 125B,近期 prefill 大補血 -
水一贴: Strata v0.1.43 又又又提速了 -
Anthropic 新规: 不许辱骂模型 -
秀一下我的装备,某保密机关ai本地主机1、可以参考一下这个: https://duanyll.com/2026/7/13/4090-48G-P2P/ 处理好后可以尝试一下TP。
2、 https://hudeqi.github.io/ai-learning-blog/10-vllm-scheduler.html 参见这个文章让gpt给你写一个靠谱点的调度器脚本,来平衡并发的吞吐量(主要是平衡预填充速度,最好增加额外的优先级进行加权调度策略)。
3、你这个配置适合使用Qwen3.8-Flash-Next or DSV4.1,性能更好吞吐量更大。
4、让AI协助你,进行KV缓存的量化测试,单独尝试BF16K-INT8V之类的设置,尝试在不影响实际推理效果的前提下提高并发or上下文的长度。
5、测试投机解码或者DFlash2技术对解码速度的影响。
6、实际使用的时候不要让vllm推理服务直接暴露给客户端,最好再搭建网关or反代。不过2、3、4都是建立在1的基础上的XD...
 , 这一套流程下来十几二十路长程代理任务是没问题的。
-
长鑫长存崛起扩大市场份额,国产货让利装机党,爱国双向奔赴?纯属想多了,还是要做好和奸商长期斗争的准备!苹果 转移 存储采购都被回绝了。
屌丝市场对比苹果的订单,没有任何可比性。我是我觉得是苹果想拿他去跟美光压价,然后长鑫没理。
-
OpenAI降价战Anthropic,中国AI初创企业遭受池鱼之殃!GPT6 Luna太有性价比,除了梁子大家压力都很大! -
OpenAI降价战Anthropic,中国AI初创企业遭受池鱼之殃!GPT6 Luna太有性价比,除了梁子大家压力都很大! -
X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s) -
X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s) -
決策模型:Jev vs Laya 魔術方塊大對決 -
4卡r9700应该选择 WRX90E-SAGE 还是 MU72-SU0 主板? -
今天查了一下京东,竟然没有4090 48G的自营了。那以后如果买的话怎么办呢?第三方不敢买呀 -
4卡r9700应该选择 WRX90E-SAGE 还是 MU72-SU0 主板? -
R9700 也是好起来了吹的有点过了, 这个卡, 个人玩玩还行, 其他的。。。
还不是么的钱钱嘛,要不然直接5090、Pro5000、6000了,还用得着折腾ROCm这些嘛

-
R9700 也是好起来了 -
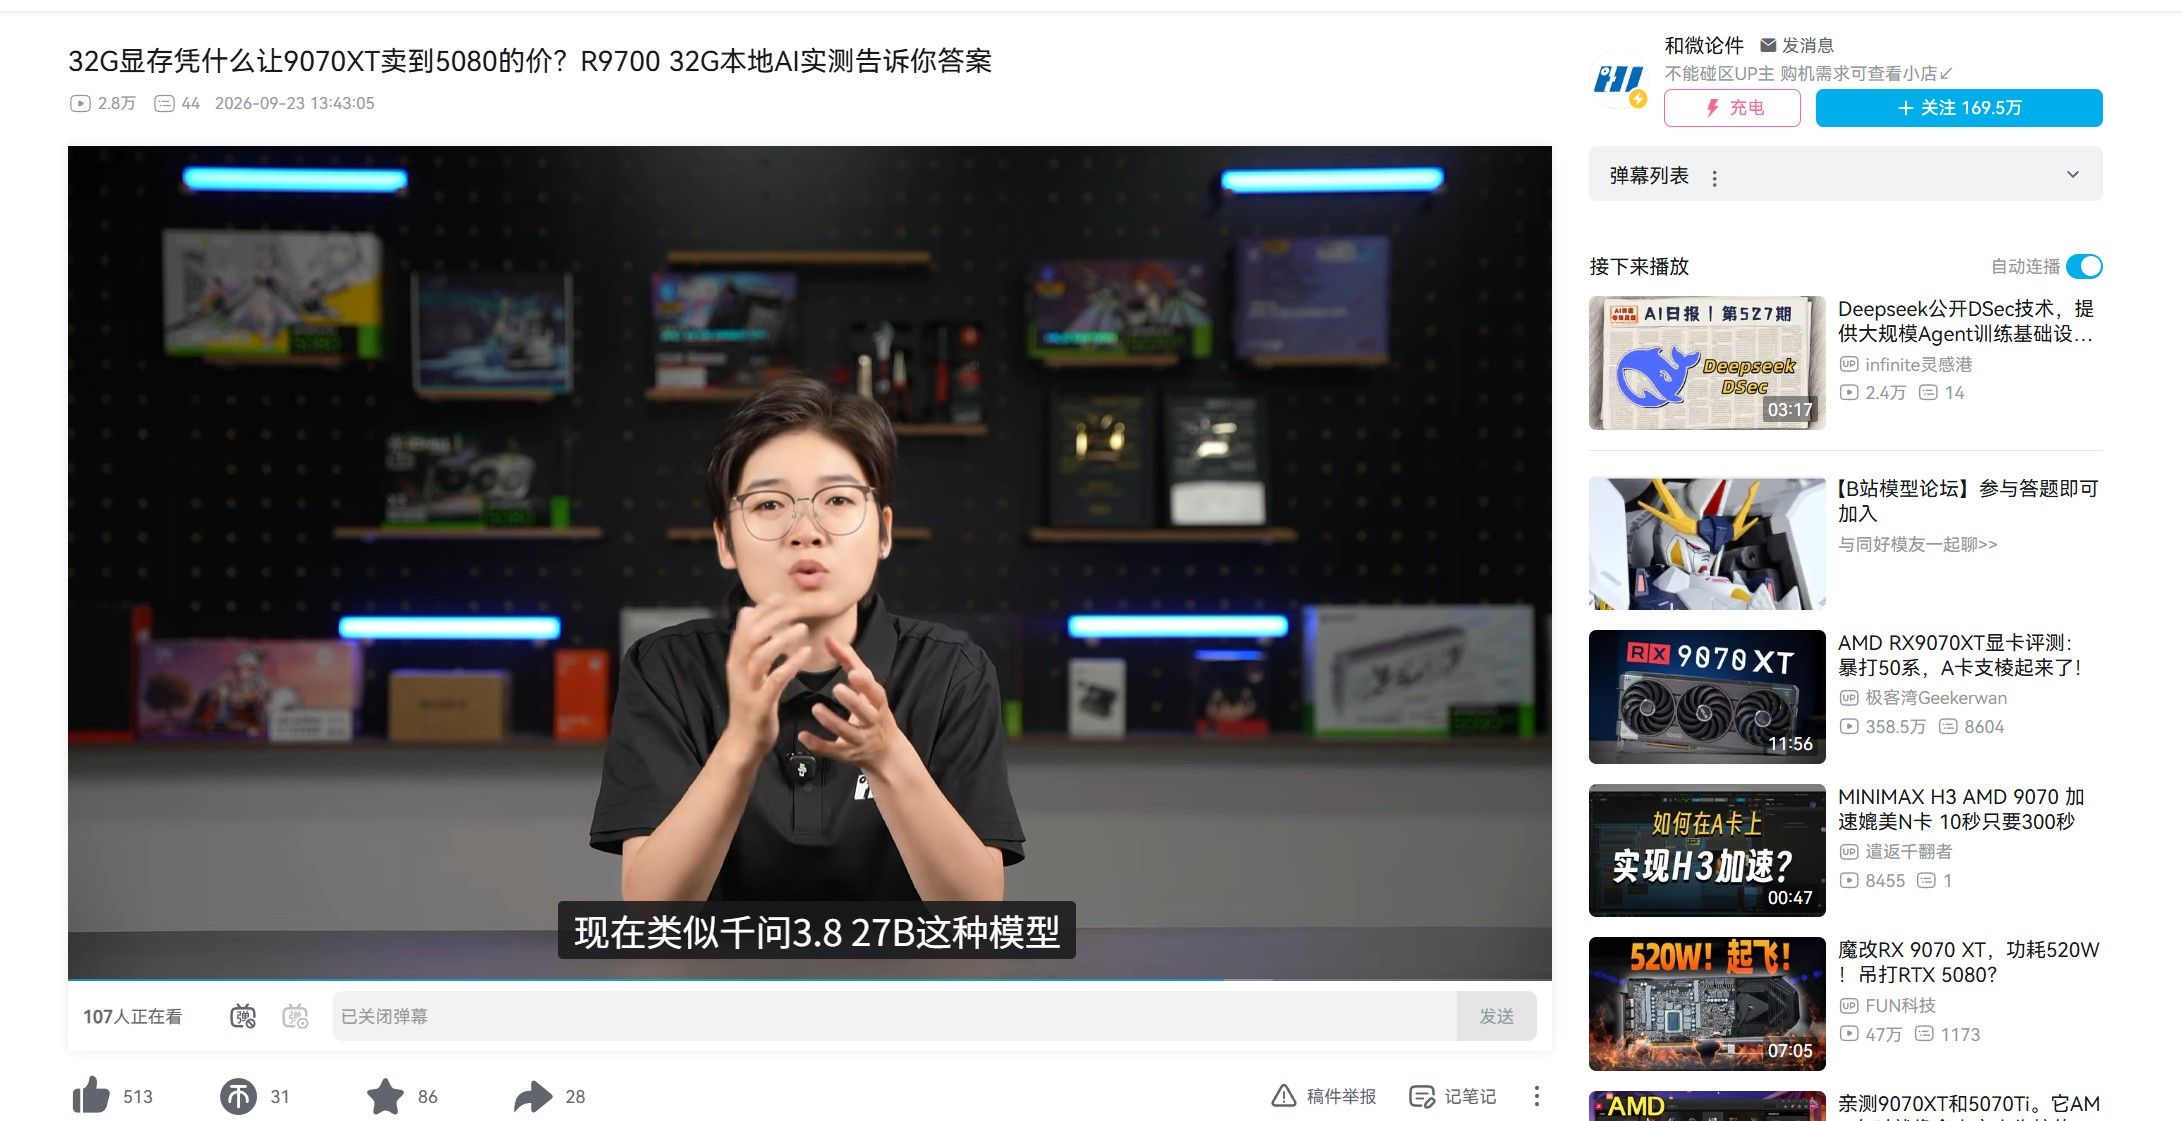
R9700 也是好起来了如题,竟然也有大up做这个卡的视频。虽然不知道是不是广告,但R9700我看可能马上要迎来一轮不小的涨价。这张卡现在的热度跟两个月前我刚入坑本地llm的时候简直是一个天一个地。(沾了Qwen3.8-27B、Minimax-H3的光)
-
GDDR7 市場對VRAM顯存大小的影響 -
我普通人的算力需求 病态 -
[實測] 開源社群釋出非官方破解版驅動,實現 RTX 5090 P2P 共享記憶體共享(類似nvlnk方法)