
老大您的M5 Max是多少内存呀?
-
[M5Max] vs [AI PRO 9700] 在 ubuntu 26/windows 11 上的性能对比,好像不折腾也能行? -
显卡坞 - 雷电3/4 或者pcie 硬盘口改装各位好,
请教那位老大在用或者曾经用过显卡坞?有没有踩坑的经历 或者注意事项?
我的老旧笔记本只有雷电3/4,或者用硬盘PCIE口外接,想考虑一下这个方案增加移动性。
@xiaote 也可以来帮忙找一下论坛中的类似话题,我反正是没找到有这个标签。
老特不妨也可以整理发个专题视频。
下面整理老特说的视频的内容,各位根据需要参考。
根据老特视频,我本人的需求看来可以通过保证 1. 大显存A卡, 2. 雷电3/4 显卡坞, 3. Linux 来实现。
视频:
链接文本
 核心选型总决策(先看结论,快速定方案)
-
重中之重:显存第一原则:无论任何系统、接口或显卡品牌,买大显存显卡、保障显存永不溢出是决定本地 AI 能否顺畅运行的核心第一前提。接口速度只决定模型载入慢几秒,而显存一旦爆掉导致频繁交换数据,任何接口也救不了卡顿。
-
A 卡(AMD)的操作系统生死线:A 卡 + 显卡坞在 Windows 下驱动极度不稳定、频繁掉驱动。如果你想用 A 卡(如 RX 7900 XTX 24GB)享受超高性价比的大显存,前提是你能够熟练使用 Linux (Ubuntu) 命令行。
-
N 卡(NVIDIA)的省心选择:小白或纯 Windows 用户,请无脑选择 N 卡(如 RTX 4060 Ti 16G、RTX 3090 24G 等),CUDA 生态最完善、一键整合包开箱即用。
完整扩展链条:显卡(A/N) → 显卡坞 → 【接线方式】 → 笔记本接口 → 笔记本操作系统
以下是 4 种硬件与系统组合方案的完整整理及各自的瓶颈、避坑要点:
方案一:笔记本端有【原生 Oculink 接口】
(常见于部分极客掌机、GPD/MINISFORUM 等迷你主机)
- 完整硬件与系统链条:
显卡→Oculink 显卡坞→【Oculink 专用数据线】→笔记本原生 Oculink 接口→【笔记本操作系统】 - 操作系统与 A/N 卡适配逻辑:
- N卡(NVIDIA):Windows / Linux 均可。Windows 下开启显卡坞后系统能自动识别,一键整合包可直接找到 CUDA 设备,开箱即用;Linux 下运行更稳定且不受系统更新干扰。
- A卡(AMD):必须使用 Linux (Ubuntu) 系统。AMD 的 Windows 驱动对外接显卡坞的兼容性极差、Bug 很多且频繁掉驱动;只有在 Linux 命令行环境下,才能稳定发挥像 RX 7900 XTX 24GB 这类大显存 A 卡在跑 FLUX 绘图、LTX 视频模型时的极致性价比。
- 瓶颈与“坑”:
- 绝对不可热插拔:Oculink 本质是原生 PCIe 延长线,不支持热插拔。在开机状态下插拔极易引发蓝屏、死机或硬件损坏,必须在关机状态下接拔。
- 物理接口与线材脆弱:Oculink 线材较硬且接口物理寿命有限,频繁弯折容易接触不良。
方案二:普通笔记本【无 Oculink,通过闲置 M.2 NVMe 插槽扩展】
(绝大多数双硬盘位笔记本的低成本改装方案)
- 完整硬件与系统链条:
显卡→Oculink 显卡坞→【Oculink 数据线】→【M.2 转 Oculink 转接卡】→笔记本闲置 M.2 插槽→【笔记本操作系统】 - 操作系统与 A/N 卡适配逻辑:
- N卡(NVIDIA):Windows / Linux 均可。Windows 系统开箱即用,适合小白用户快速部署一键整合包。
- A卡(AMD):必须使用 Linux (Ubuntu) 系统。A 卡在 Windows 环境下走外接转接通道极其不稳定;如果想要享受 A 卡高显存、低价格的优势,必须依靠 Linux 命令行系统来规避驱动崩溃隐患。
- 瓶颈与“坑”:
- 拆机与毁外观(最大痛点):必须拆开底盖固定转接卡并引出线材,使笔记本彻底失去便携性。
- 接口耐用度极差与 BIOS 限制:M.2 插槽物理强度低不耐拉扯;部分笔记本 BIOS 会限制闲置 M.2 位设备识别。
方案三:笔记本端有【雷电 3 / 雷电 4 / USB4 接口】
(最常见的轻薄本、商务本与游戏本扩展方案)
- 完整硬件与系统链条:
显卡→雷电 3/4 显卡坞→【雷电 3/4 Type-C 数据线】→笔记本雷电接口→【笔记本操作系统】 - 操作系统与 A/N 卡适配逻辑:
- N卡(NVIDIA):首选 Windows(小白/日常),进阶选 Linux。连接雷电坞后 Windows 系统能顺畅识别 CUDA 驱动;唯一的坑是 Windows 系统强制更新隔三差五会破坏外接显卡驱动,导致握手失败需要重装驱动。
- A卡(AMD):坚决避开 Windows,必须使用 Linux (Ubuntu)。A 卡搭配雷电显卡坞在 Windows 下是“噩梦级”体验,极易频繁掉驱动或蓝屏;如果执意要选 RX 7900 XTX 跑 AI,必须在 Linux 命令行下运行,才能稳定作为生产力工具。
- 瓶颈与“坑”:
- “显存溢出”引发性能骤降:雷电 3/4 给 GPU 保留的物理带宽约 32Gbps。当显存能够完全容纳模型时,雷电接口在运行中毫无瓶颈;但一旦显存爆掉发生数据交换,雷电的较窄带宽会导致性能严重卡顿。
- 显卡坞设备昂贵:受英特尔雷电芯片授权费影响,雷电坞造价明显高于 Oculink 坞。
方案四:笔记本端有【雷电 5 接口】
(最新款高端笔记本方案)
-
完整硬件与系统链条:
显卡→雷电 5 显卡坞→【雷电 5 高速数据线】→笔记本雷电 5 接口→【笔记本操作系统】 -
操作系统与 A/N 卡适配逻辑:
- N卡(NVIDIA):Windows / Linux 均可(Windows 下仍需预防系统更新损坏驱动)。
- A卡(AMD):必须搭配 Linux (Ubuntu) 命令行。
-
瓶颈与“坑”:
- 设备昂贵且普及率低:雷电 5 硬件选择少且价格高。
- 依然无法拯救显存溢出:虽然 GPU 通道上限提升至 PCIe 4.0 x4(64Gbps),但一旦显存不足借用系统内存,体验依然会大幅下滑。
图片有错字,请自行甄别。
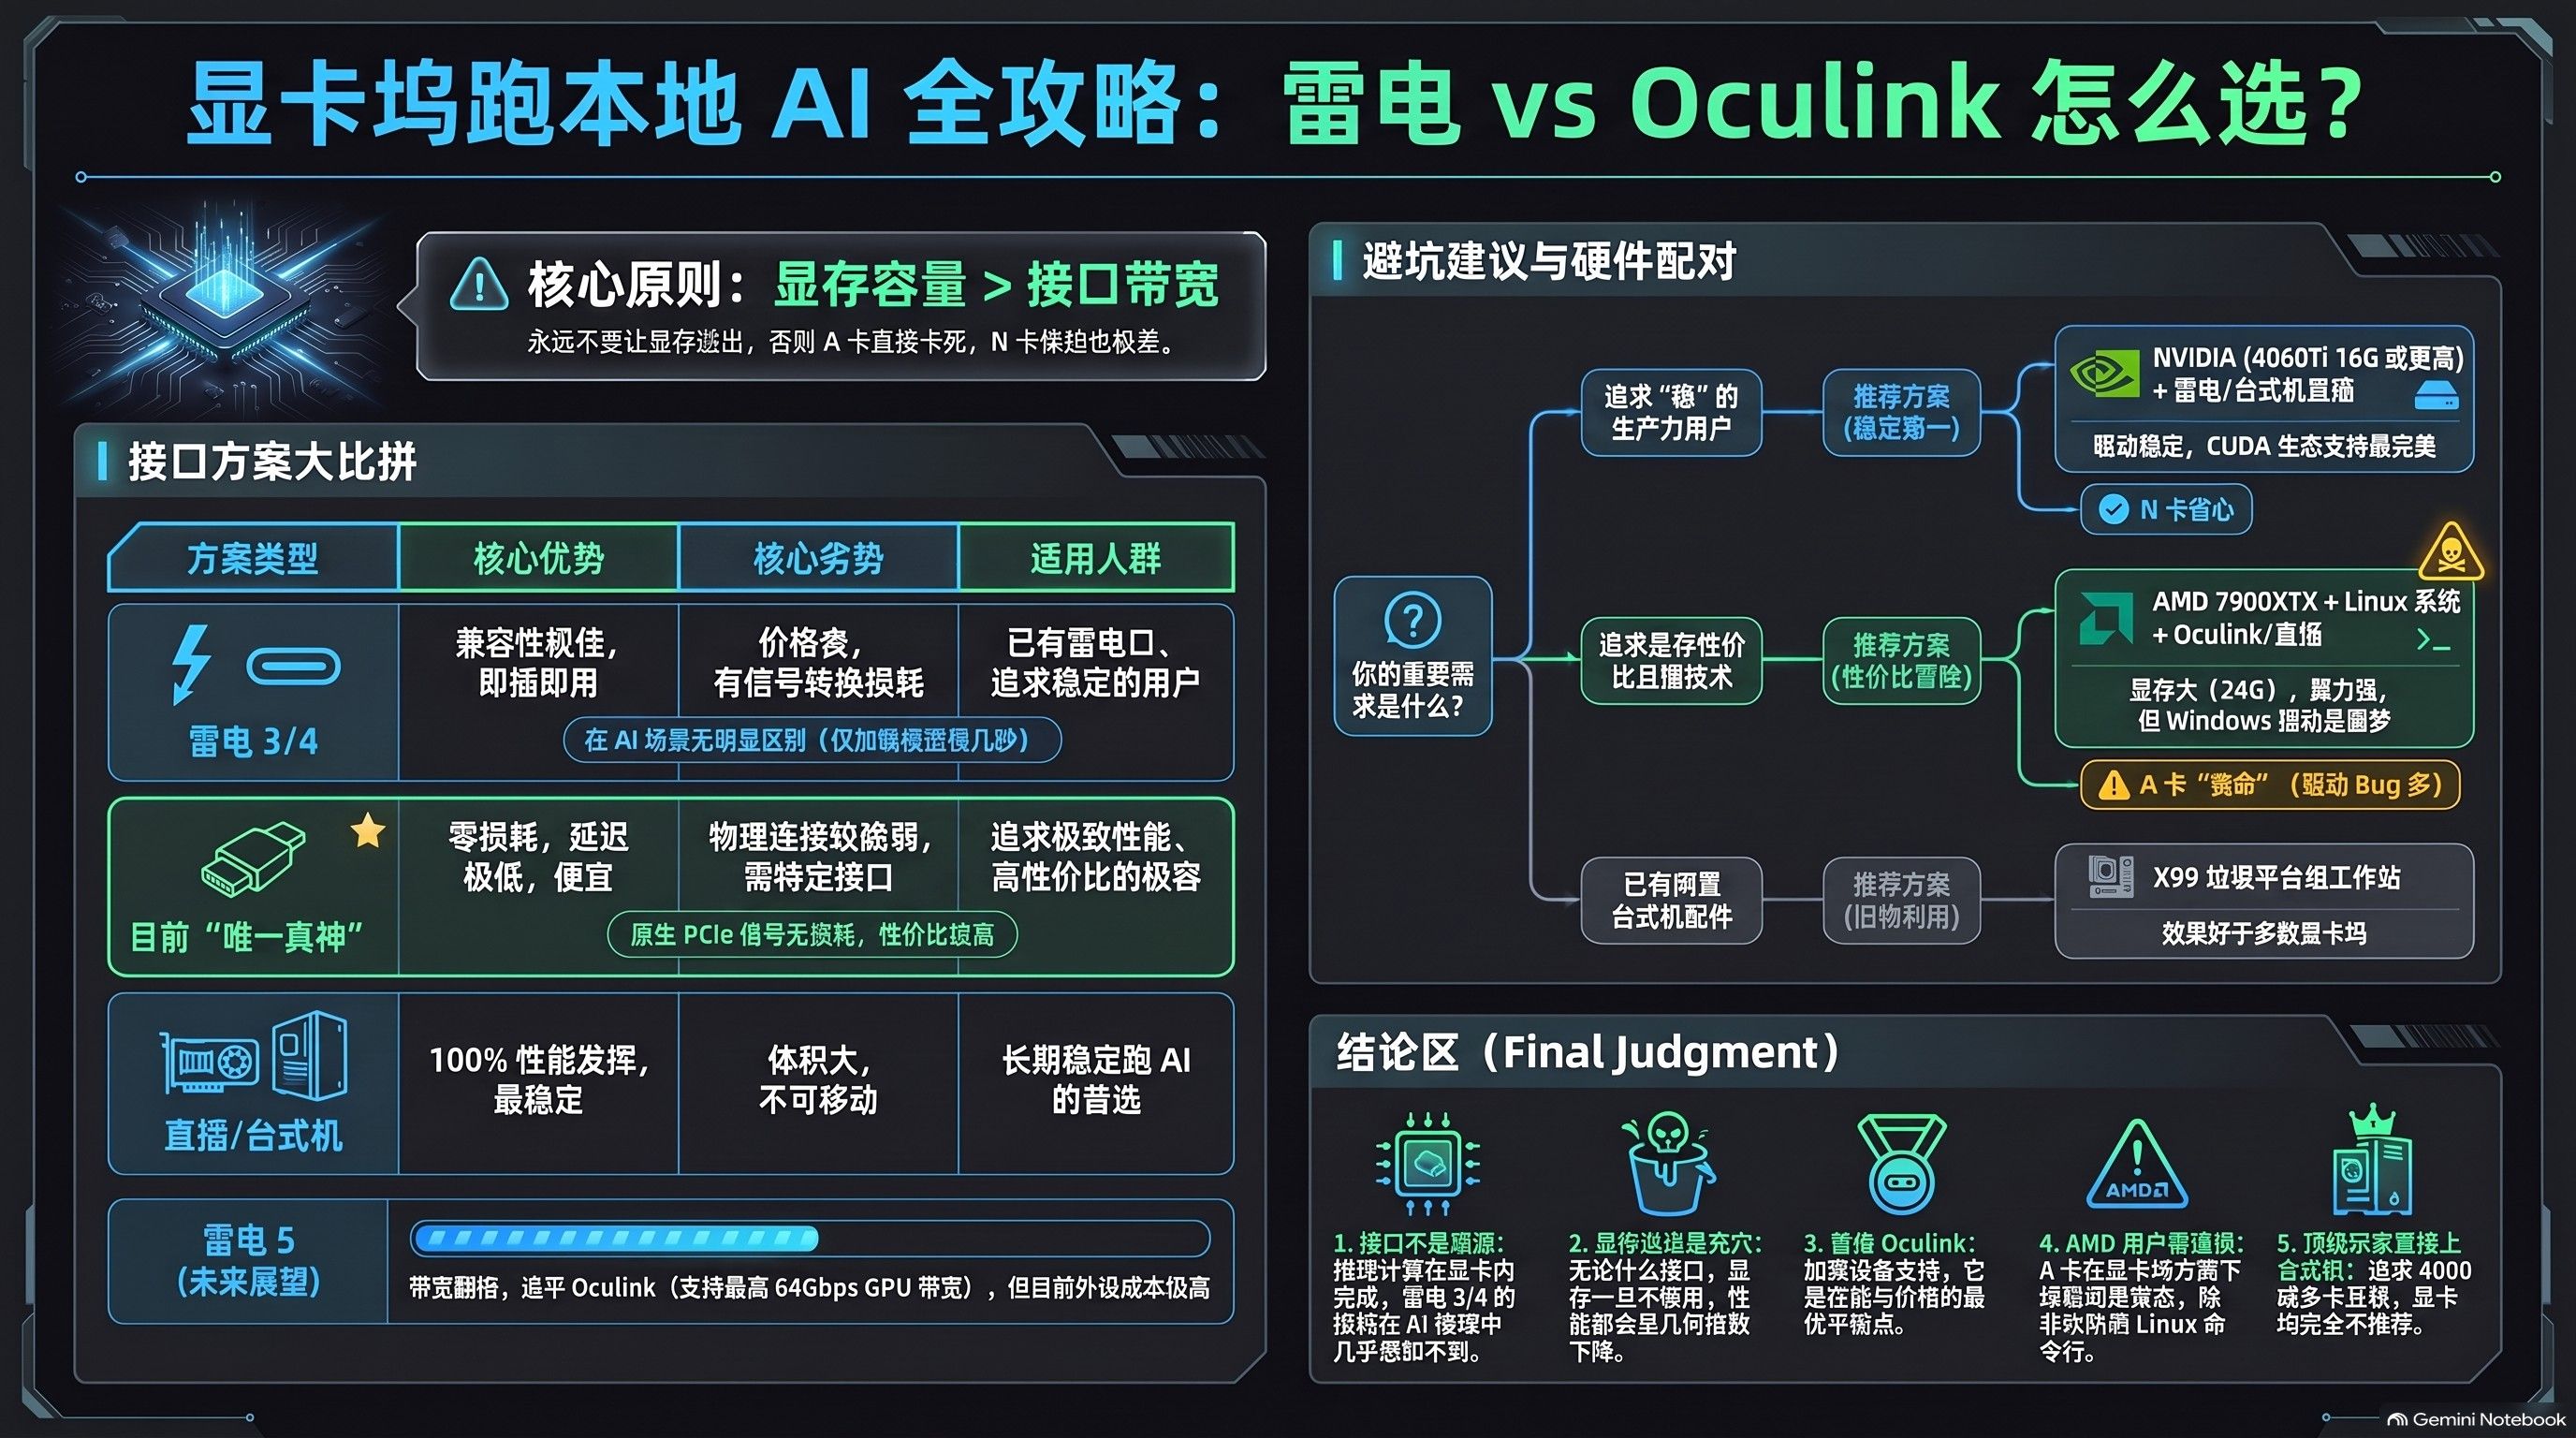
-
-
在辦公室架一套能共用的本地 AI 環境:Qwen 3.8、Pi Agent 與 KAI Scheduler@Botio-Kuo 主要是自己家裡買不起太貴的設備,都是在 HomeLab 實驗後再移到公司 server 上面進行比較大規模的驗證, 我們目前都是使用 liteLLM ,最近是在評估 omnirouter / bifrost ,有什麼好的經驗也可以分享一下
工作上還是只能氪金 codex + claude code 才能應付大規模的專案....
這套比較像是拿來做一些打雜,還有不趕時間的小玩具/ ETL 自動化的整理之類的谢谢大哥分享!
试过 https://openwebui.com/ 吗?
-
15 年老平台 + 单张 RX 7900 XTX 跑 Qwen3.8-27B:本地 Coding Agent 实测谢谢大哥分享详实的数据。
虽然不想做伸手党,但通读了帖子也没有发现具体是哪个模型。
我让AI给总结了一个清单,能麻烦大哥看一下您用的是哪个模型吗?
Qwen3.8-27B GGUF 模型推荐指南
参考帖子:15 年老平台 + 单张 RX 7900 XTX 跑 Qwen3.8-27B:本地 Coding Agent 实测
 帖子核心需求总结
根据 lcz.me 帖子(作者 hoyin258),帖主要求的 Qwen3.8-27B 模型需要满足以下条件:
需求 要求 量化格式 Q4_K_M GGUF(约 17-18GB) MTP 支持 保留 MTP 5 layers(用于 spec decode 加速) Flash Attention 支持 Chat Template 带 Jinja template(Tool Calling 稳定) KV Cache 支持 q8_0/q4_1 用途 Coding Agent(长 Context、多轮 Tool Calling) 显存 24GB(RX 7900 XTX)
 Hugging Face 推荐模型
 推荐 1(最匹配):unsloth/Qwen3.8-27B-GGUF
- 链接: https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
- 下载量: 1050万次(最热门)
- 推荐理由:
 提供 UD-Q4_K_M 量化(16.5 GB)— 最接近帖主使用的 Q4_K_M
- 提供 MTP/mtp-Qwen3.8-27B-Q4_0.gguf(1.37 GB)— MTP 草稿模型
- 提供 UD-Q4_K_XL(17.6 GB)— 更接近 17-18GB 范围
- 提供 UD-Q5_K_M(19.8 GB)— 如果你的显存足够,质量更好
- 提供 UD-Q5_K_S(18.7 GB)— 另一个接近 18GB 的选择
- 带有 mmproj 视觉投影器
- 官方添加了 Unsloth 风格 chat template
- Apache 2.0 许可证
- 由 Unsloth AI(知名量化团队)维护
可用量化版本速查
量化 文件大小 BPW 说明 UD-Q4_K_M 16.5 GB ~4.9 推荐,平衡质量与速度UD-Q4_K_XL 17.6 GB ~5.2 比 Q4_K_M 略大略好 UD-Q5_K_S 18.7 GB ~5.7 质量更高 UD-Q5_K_M 19.8 GB ~5.9 如果显存允许,推荐此档 UD-Q6_K 22 GB ~6.6 最高质量 llama.cpp 启动命令参考
llama-server \
  -m Qwen3.8-27B-UD-Q4_K_M.gguf \
  --mtp-model MTP/mtp-Qwen3.8-27B-Q4_0.gguf \
  --gpu-layers all \
  --no-host \
  --fit off \
  --load-mode mmap \
  --parallel 1 \
  --kv-unified \
  --kv-unified-per-slot 98304 \
  --cache-type-k q8_0 \
  --cache-type-v q4_1 \
  --cache-ram 1024 \
  --cache-prompt \
  --cache-reuse 256 \
  --batch-size 512 \
  --ubatch-size 512 \
  --flash-attn on \
  --cont-batching \
  --spec-type draft-mtp \
  --spec-draft-n-max 5 \
  --spec-draft-type-k q4_0 \
  --spec-draft-type-v q4_0 \
  --reasoning off \
  --jinja \
  --threads 4 \
  --threads-batch 4
推荐 2(带 MTP + Vision + 中文优化):cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP-GGUF- 链接: https://huggingface.co/cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP-GGUF
- 下载量: 3.5万次
- 推荐理由:
- Q4_K_M-MTP 量化(16 GB)— 已集成 MTP,单文件即用
- 保留完整 MTP tensors(866 个)
- 包含 mmproj 视觉投影器
- 基于 heretic-ara 微调(去除审查、中英双语优化)
- 对 AMD Vulkan 有优化
- 标注了 AMD Strix Halo/RDMA3.5 优化
- 提供 ROCmFP4-FAST 极速量化(14 GB,~42 t/s)
 ️ 下载量较少,社区验证不如 unsloth 充分
- ️ 是"abliterated/uncensored"版本,适合 Coding Agent(更少拒绝回答),但可能更自由奔放
可用量化版本
文件 大小 BPW 说明 Qwen3.8-27B-heretic-ara-ROCmFP4-FAST.gguf 14 GB 4.26  最快,~42 t/s,需 ROCmFPX fork
Qwen3.8-27B-heretic-ara-Q4_K_M-MTP.gguf 16 GB 4.83 推荐,开箱即用Qwen3.8-27B-heretic-ara-Q6_K-MTP.gguf 21 GB 6.56 更高质量 mmproj-Qwen3.8-27B-heretic-ara-BF16.gguf 931 MB — 视觉投影器 llama.cpp 启动命令(单文件版)
llama-server \
  -m Qwen3.8-27B-heretic-ara-Q4_K_M-MTP.gguf \
  --gpu-layers all \
  --parallel 1 \
  --kv-unified-per-slot 98304 \
  --cache-type-k q8_0 \
  --cache-type-v q4_1 \
  --flash-attn on \
  --cont-batching \
  --cache-prompt \
  --jinja \
  --threads 4
 各模型对比
模型 量化 大小 MTP Vision 下载量 适合场景 unsloth/Qwen3.8-27B-UD-Q4_K_M Q4_K_M 16.5GB 需额外下载 1050万+ 最均衡推荐 unsloth/Qwen3.8-27B-UD-Q5_K_M Q5_K_M 19.8GB 需额外下载 — 质量更高 cygnal/heretic-ara-Q4_K_M-MTP Q4_K_M 16GB 内置3.5万 开箱即用 unsloth/Qwen3.8-27B-Q4_1 Q4_1 17.5GB 需额外下载 — 接近帖主尺寸
最终建议方案 A:最接近帖主配置(推荐)
使用 unsloth/Qwen3.8-27B-UD-Q4_K_M + unsloth 的 MTP 草稿模型,两者都来自同一团队,兼容性最好。
模型:Qwen3.8-27B-UD-Q4_K_M.gguf(16.5 GB)
MTP:MTP/mtp-Qwen3.8-27B-Q4_0.gguf(1.37 GB)
方案 B:开箱即用
使用 cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP,MTP 已内置,单文件即可启动。
模型:Qwen3.8-27B-heretic-ara-Q4_K_M-MTP.gguf(16 GB)
MTP:内置,无需额外文件
方案 C:追求更高质量
如果显存足够,使用 unsloth/Qwen3.8-27B-UD-Q5_K_M(19.8 GB),在 24GB 显存上也能放下,质量更高。
 重要注意事项
1. 模型架构特点
Qwen3.8-27B 采用 Gated DeltaNet + Gated Attention 混合架构:
- 64 层,隐藏维度 5120
- Token 词汇表:248,320
- 原生上下文长度:262,144 tokens(可扩展至 1,000,000)
- 内置 MTP(Multi-Token Prediction)训练
2. Chat Template 对 Tool Calling 的重要性
"普通 Chat 能跑,并不代表多轮 Agent Tool Loop 一定能跑。"
- 使用
--jinja参数启用 Jinja2 模板渲染 - 推荐使用带 Unsloth 风格 template 的版本
- 多轮 Tool Calling 稳定性与 Chat Template 强相关
3. MTP 是否保留 Layers 很重要
"同一个模型、同一个量化名称,不同 conversion 可能完全不同。"
- 检查 GGUF 文件中是否包含 MTP tensors
- unsloth 版本将 MTP 单独放在
MTP/目录下 - cygnal 版本将 MTP 内置在单文件中
4. 显存与量化选择
量化 大小 24GB 显存能否放下 推荐程度 Q4_K_M ~16-17GB 可以Q4_K_XL ~17-18GB 可以Q5_K_S ~18-19GB 可以Q5_K_M ~19-20GB 可以Q6_K ~22GB ️ 勉强Q8_0 ~29GB  放不下
— 5. 官方原始模型
- Hugging Face: https://huggingface.co/Qwen/Qwen3.8-27B
- 格式: Transformers (Safetensors)
- 特点: 官方原版,适合 vLLM / SGLang 推理
- 注意: 不是 GGUF 格式,需要自行转换或用 Transformers 加载
 相关链接
- 原始帖子:https://lcz.me/topic/1508/6
- Unsloth Qwen3.8-27B-GGUF:https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
- cygnal heretic-ara Q4_K_M-MTP:https://huggingface.co/cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP-GGUF
- 官方 Qwen3.8-27B:https://huggingface.co/Qwen/Qwen3.8-27B
- llama.cpp 文档:https://github.com/ggerganov/llama.cpp
生成时间:基于 Hugging Face 页面信息,模型更新请以官方页面为准。
-
请教X99主板+7900xtx 第一次开机有什么注意嘛?我这里黑屏不显示记不清楚了,看看我儿子的回复,它提到的你弄弄看,我当时没改什么。
谢谢老特亲自回答,我的问题是因为显示线缆。。。
有一个坑我在另外一个R9700+x99帖子里提到了:BIOS里设置Above 4G Decoding反而黑屏。
像下面小特说的,最后放电救回来的。所以我特地转载了小特的回复,希望后来者不要再踩了。
------------------小特的分割线-----------------------
Above 4G Decoding 开完黑屏、只能放电救回来——老平台(X99/B75 这代)九成是 BIOS 的 Above 4G 实现和 CSM 在打架。
原因:RDNA3 显卡的 VBIOS 是纯 UEFI GOP。CSM 开启时,PCIe 资源分配本来按传统方式走;一开 Above 4G,BIOS 要把显存 BAR 重新映射到 4G 以上地址空间,老 BIOS 这段逻辑和 CSM 冲突,POST 阶段显卡初始化就崩了——所以连 BIOS 画面都没有,只能放电。
关键结论:跑 AI 推理不需要开它。llama.cpp Vulkan 下 7900XTX 不开 ReBAR / Above 4G 完全正常——今天正好有人发了同款实测(TID:1508,B75 + i5-2400 老平台无 ReBAR 跑 Qwen3.8-27B,40~46 t/s),无 ReBAR 时加环境变量 GGML_VK_DISABLE_HOST_VISIBLE_VIDMEM=1 即可稳定跑。你的用途不受影响,保持默认别动。
真想开(比如为了游戏性能上 ReBAR):顺序要对——先关 CSM 切纯 UEFI 再开 Above 4G,反了就容易黑。老 X99 BIOS 对这组开关很敏感,没有刚需就别碰。
-
交作业:X99 CD3+E5 2666 +128G DDR3 + AMD AI Pro 9700,成功安装ubuntu,等不及跟大家分享。后续再更新大哥,我的7900xtx本来是亮的,设了下面这个反而黑屏了。
路径: Advanced(高级)-> PCI Subsystem Settings
设置项: Above 4G Decoding -> 修改为 Enabled(开启)
给CMOS放电才重新点亮。
-
DeepSeek-V4-Flash-Vision-Exp 开源了,现在有跑本地的量化版本吗James-Chen 说:
mac m4 pro 64g能跑起来,用ds4,需开启ssd streaming,能跑而已。
10tok/s样子,有图有真相
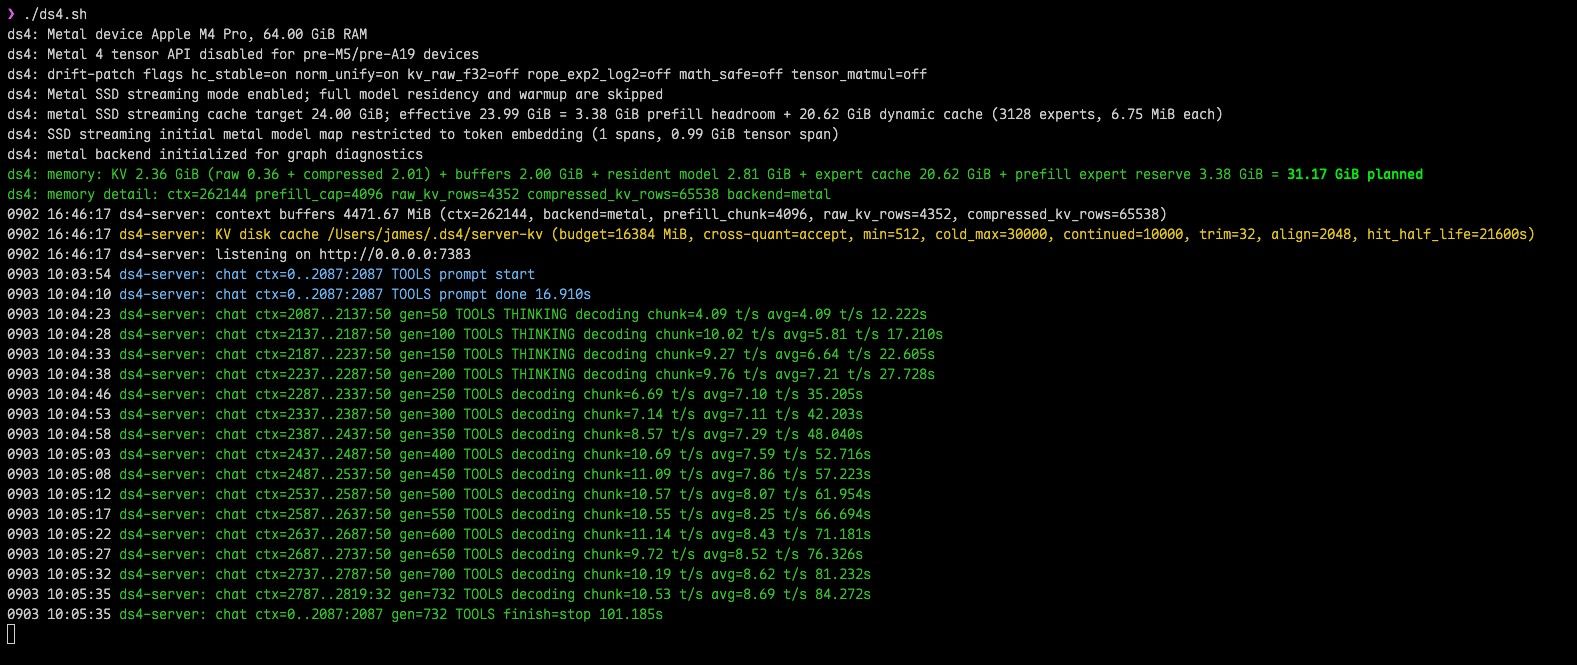
64都能跑,Mac越来越看不懂了。
Mac Studio M5 Max 64的话,是不是能快一点? -
有几块RTX8000显卡48G显存,有什么好意见?话说48g好生羡慕啊, 27b稠密模型能干活了
-
有几块RTX8000显卡48G显存,有什么好意见?招本论坛5个用户帮我做压力测试。
注册地址http://123.125.174.5:3000 ,注册时用户名前缀加lcz,我好管理。
注册后,发账号到该帖下。然后我给前5个充值300$测试。测试有什么意见跟帖。木兄找测试要不要单独发个主贴? 我是看到最后才发现,别人可能不一定看见。
我也不懂测试,不然注册一个帮你跑跑了。
-
请教各位大神,想要起一个英语频道,文案、语音生成方面应该怎么解决?各位大神能指点一下内容是哪方面可以做吗?谢谢!
-
几个建议 -
几个建议 -
几个建议 -
几个建议AGI已经回复你了:
1,不需要太多板块,论坛已经有Tag系统,AI在维护,需要相关知识可以去Tag或者硬件页面查看,也可以搜索。
2,个人有主页,论坛有大神推荐,搞好自己的积分,将来推荐的时候,有足够曝光度。如果你的等级高,到了超凡大师,可以申请建立群组,甚至自己的板块。
3,目前回复风格很好,大多数人都能明确知道,斜体容易加,但最好保持简洁,维护好核心功能就行。第二个的话,目的是要给用户去分享和学习的一个地方。
很多普通用户,其实对于怎么利用AI来帮助自己处理日常的工作其实很缺乏概念,就是不知道拿它干嘛,不知道怎么解决实际问题。
大家相互分享和借鉴一下,可能会让小白用户在提高日常工作效率上受益,也可能激发出一些新的点子。
‘自媒体’板块和‘LLM'版块都有点类似,但前者就局限在仅自媒体的领域,后者就只是在谈LLM本身,缺乏把LLM扩展到各个日常工作场景中的案例。
这样的话,是不是受众也可以更多一些?
当然,如果咱们论坛就是定位在自媒体结合AI的方面,这个版块就不需要了。
-
几个建议-
硬件下面要不要设几个子频道,N卡/A卡/Mac/其他/这样的,大家讨论或者抄作业等也有的放矢。
-
要不要开一个版来给大家分享自己用LLM做的好玩的项目,或者工作流,尤其是本地模型的。
-
给回复引用换个风格? 斜体?引号,缩进等?
谢谢
-
-
请教X99主板+7900xtx 第一次开机有什么注意嘛?我这里黑屏不显示 -
请教X99主板+7900xtx 第一次开机有什么注意嘛?我这里黑屏不显示刚刚问了华南金牌客服,问主板上显示什么代码,我还不知道主板上会有代码。
-
请教X99主板+7900xtx 第一次开机有什么注意嘛?我这里黑屏不显示看论坛一位大哥说要改bios的几个设置,可是现在直接黑屏也无法设置。
想请教一下这个卡有什么要注意的没有,还是说x99的内存等问题可能性更大。
谢谢!
-
请教:AMD R9700 还是 Mac Studio? -
请教:AMD R9700 还是 Mac Studio?通过 OPEN AI 大量收购MAC 设备。
仔细思考了下。MAC 其实主要的价值是他的系统环境。而不是作为算力供应商。是,所以我才觉得把预算给它多一些。
可能问题要修正为:
能跑差不多的大模型,比如27b这种的,R9700和Mac,选哪个。