前言:strata最近已经火出圈了,火到RAM又翻了个倍。目前京东自营,海力士颗粒的64GB的DDR5 6000内存已经几近破万。
十一长假回来,笔者也是暂时小试牛刀了一把,发现有一些关键参数,会直接影响整个LLM引擎的本质体验,但是默认值并不是特别合理。所以发个tips小文供大家交流。欢迎批评指正。
本文全程手打,无任何AI含量,请放心阅读。
1、Harness会频繁唤起子代理(sub agent),导致切换会话prefill浪费太多时间,怎么办?
答:开启--conversation-cache-mib
这个参数会让strata使用RAM来缓存历史对话,从而不让LLM反复重新prefill老的session。增加会话切换时的速度,对于agent、harness场景有奇效。
开启conversation-cache-mib后,monitor面板会有如下展示:
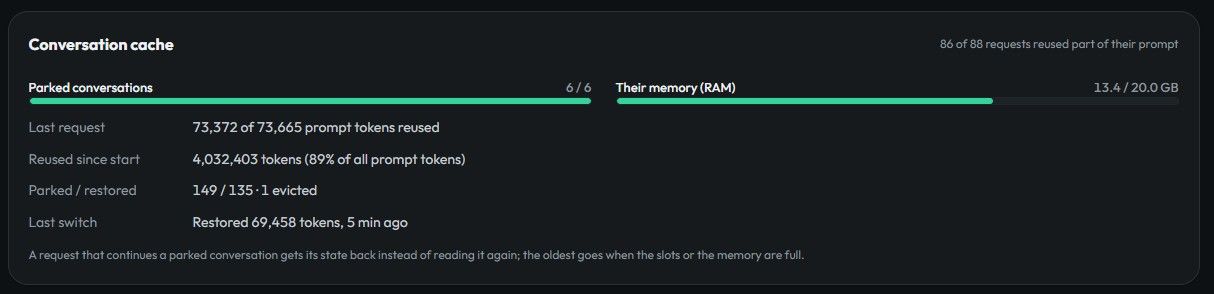
分别表述当期缓存了多少个会话,以及目前占用了多少RAM。
这个机制有两个痛点:1、不支持多显卡。2、最大只支持20GB的对话缓存(如果是8bitkvcache,大概就是4各半的262k context)。
2、我的显卡显存总是占不满,浪费一些,怎么破?
答:配置--expert-cache,不要用auto档位。手动指定
让更多的专家进驻显存。注意,手动指定的是下限,所以要反复测试量力而行。
3、我想使用上文的conversation-cache,但是我RAM都快满了,怎么办?
答:启用低内存模式:--resident-experts
小科普,正常默认情况下,strata加载的专家是内存+SSD加载全量,vRAM加载高命中概率专家。相当于RAM和vRAM之间,是有一定的重复加载的。
官方这样指定默认值是有道理的,一旦VRAM的专家没能命中,直接可以读取RAM的进入vRAM。
代价就是这会导致RAM的极大浪费。
通过配置低内存模式,能够让vRAM+RAM分别加载不同专家,分工合作。这样能节省巨量RAM。代价是一旦VRAM中的专家没能命中,除了从RAM读取以外,还要从vRAM剔除一个回写到RAM。但相较于直接节省40GB的RAM空间而言,这点回写简直可以忽略不计。而且你显卡的显存越大,遇到回写的概率越低。
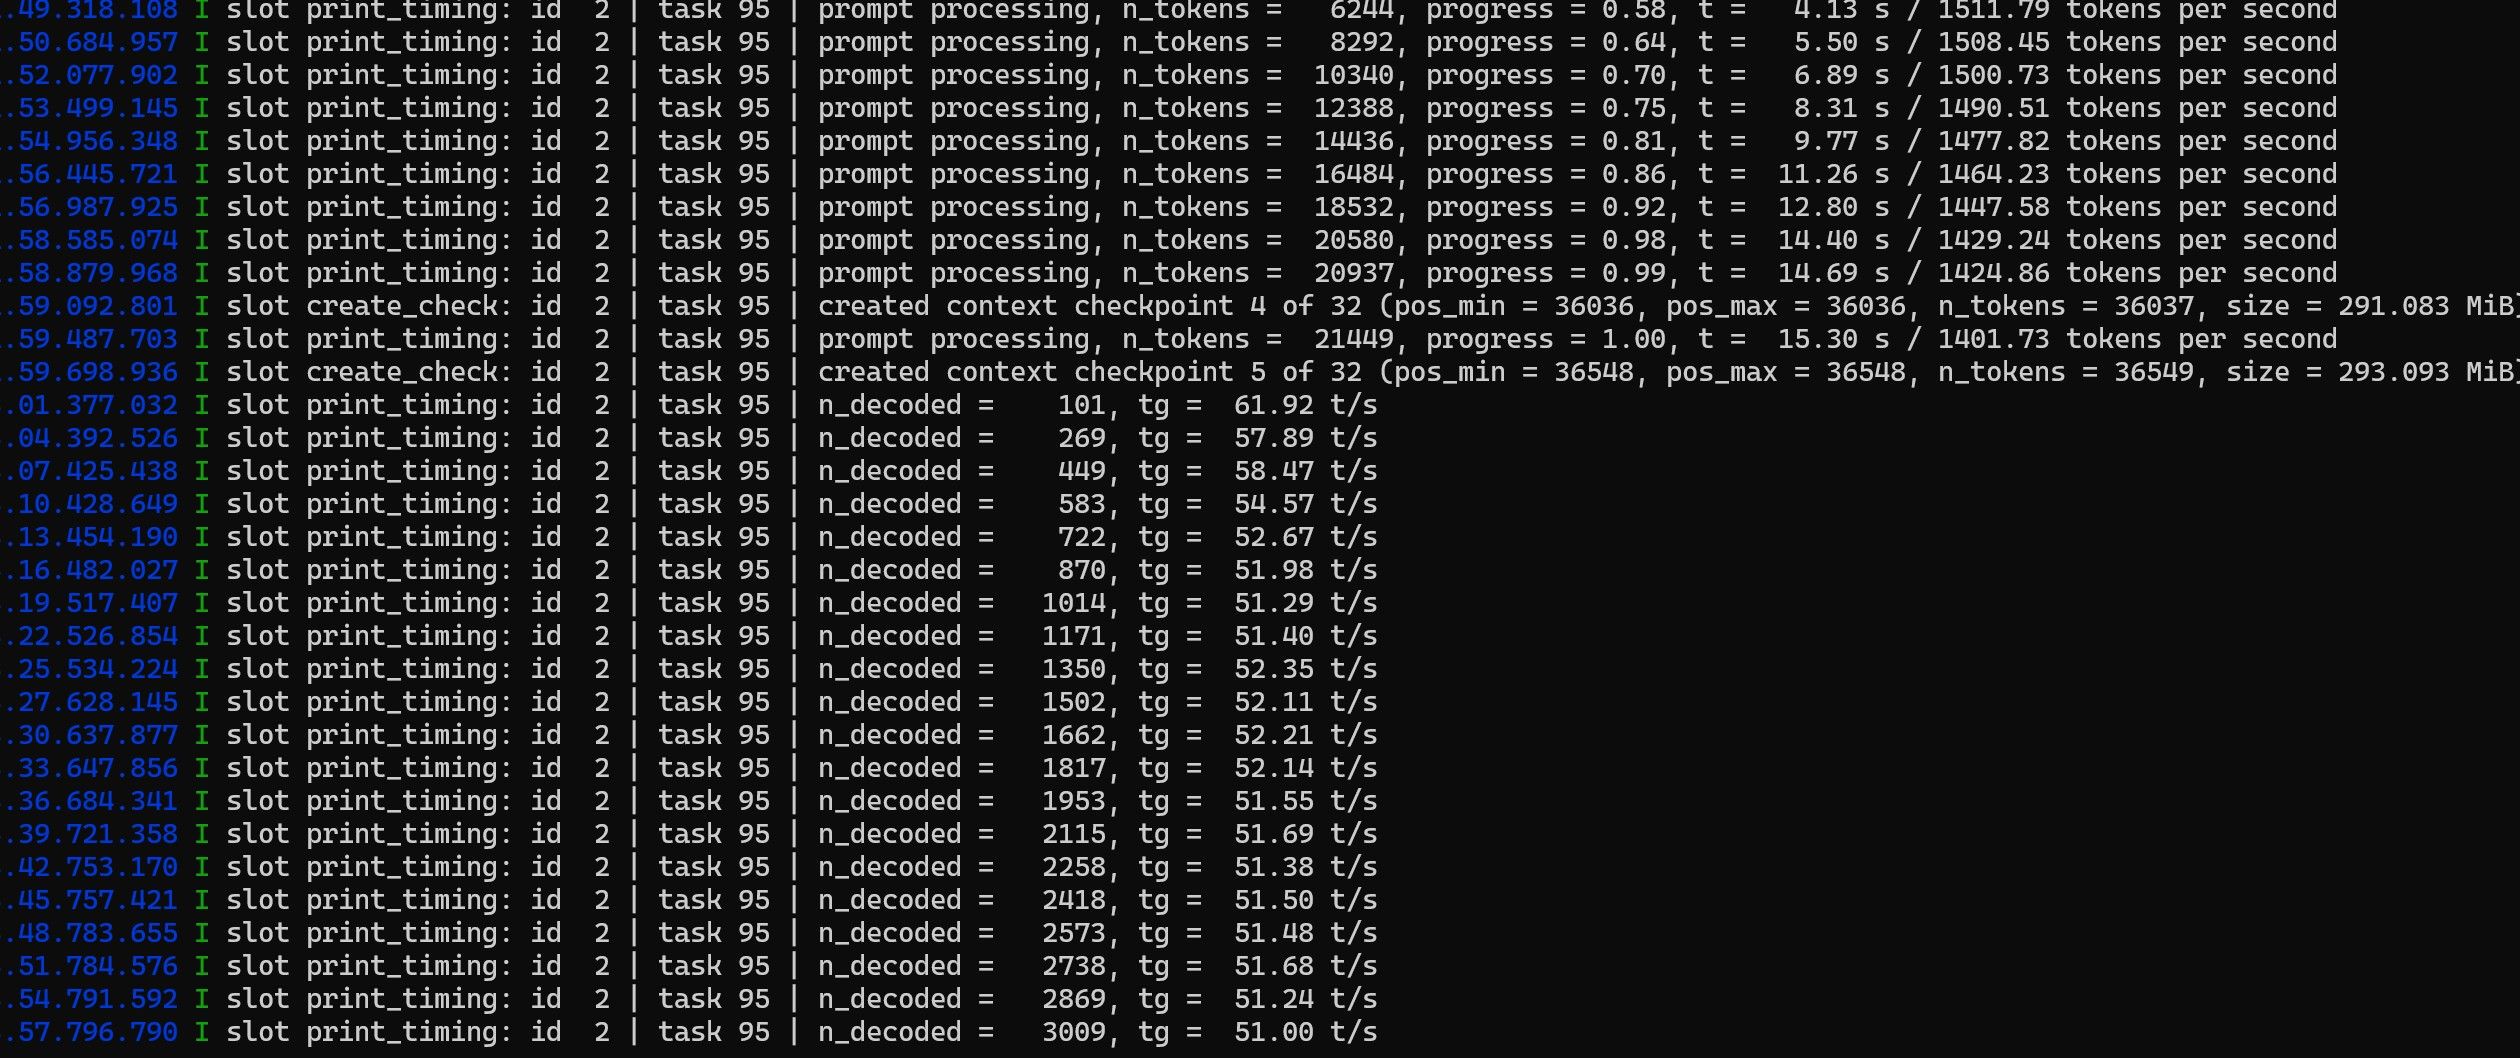
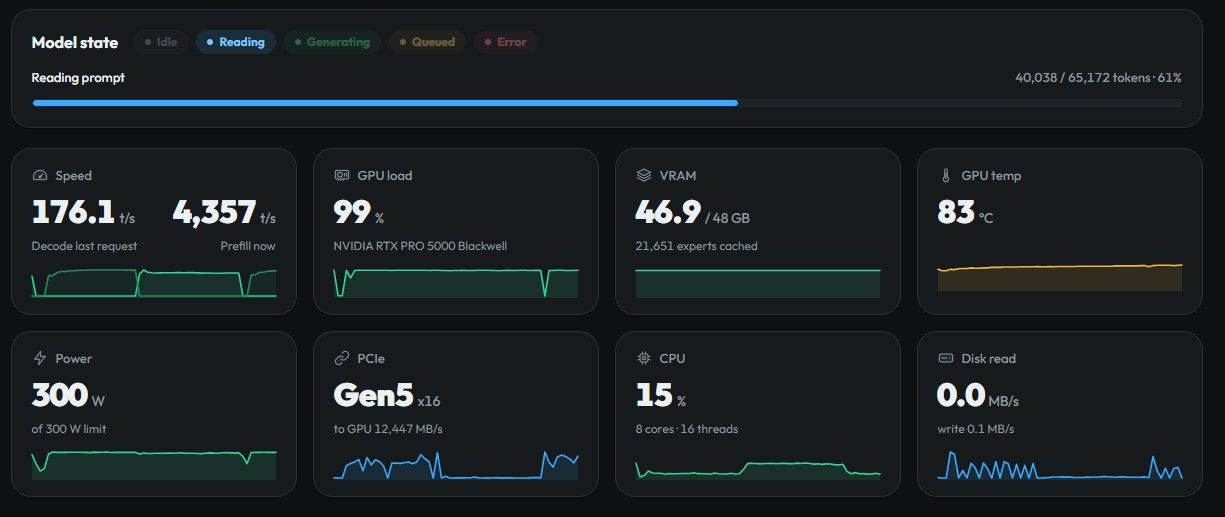
笔者的是48GB的 rtx pro 5000,专家命中率一直保持在99%。
4、我想多个聊天会话一起聊(并发),怎么办?
答,配置parallel: X(X是并发会话数,最大8)
会占用显存,我个人实测,IQ3_XXS量化下,会话长度262k,每个并发占用5.2GB显存。
以上,欢迎列为交流,指正。最后列出我个人的全套参数,供各位参考。
"args": [
  "--pack", "C:\\work\\Strata-data\\packs\\iq3_xxs",
  "--native", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.gguf",
  "--ple-gguf", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00002-of-00002.gguf",
  "--expert-profile", "C:\\work\\Strata\\data\\expert-profile.bin",
  "--resident-experts",
  "--expert-cache", "19000",
  "--prefill", "auto",
  "--spec", "4",
  "--mtp", "C:\\work\\Strata-data\\mtp\\rt",
  "--max-context", "262144",
  "--kv", "k8v4",
  "--vision",
  "--vram-reserve-mib", "3400",
  "--pcie-frac", "0.00",
  "--spec-min-p", "0.70",
  "--conversation-cache-mib", "20480",
  "--conversation-cache-slots", "6",
  "--conversation-cache-min-free-mib", "13824",
  "--prompt-cache-every", "8192"
 ],