
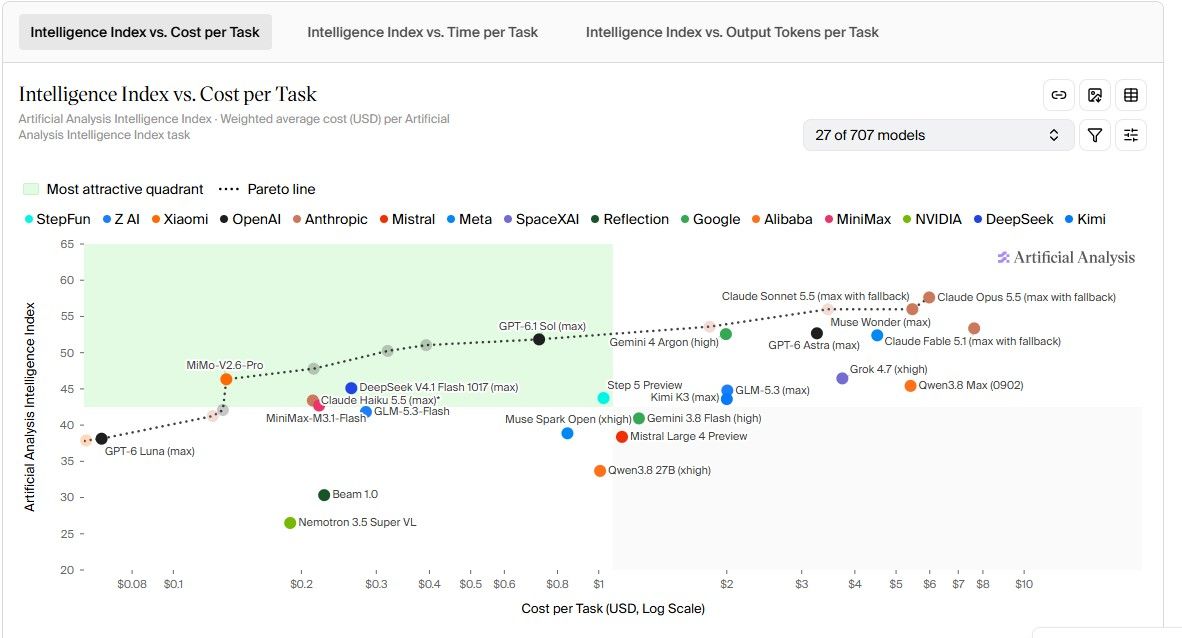
可能跑分不太能精准表达模型的能力,但是这张质价比图还是有些信息量的:
-
【讨论】 Minimax M3.1 Flash开源了 (26-10-23) -
3090春天来啦!最新推理引擎比Strata 快1.63倍!!! -
美国dell 的主机 rtx pro 6000 性价比 -
求M3 Ultra 512G 内存 模型推荐 -
请教各位大神 都用什么模型和agent 来运行自动化minimax h3?@imbiplaza-ASUS agent同步执行主要的问题就是抽卡的代价太大。通过API调用进去的工作流任务是无法通过web页面更换种子重跑的。对于一些抽卡就能解决的场景,用agent执行个“换个种子重跑”这种东西太不环保了。
然后就是LLM对于图、视频的QC能力目前还是差,多腿、手指异常、违反物理、生物学的运动,这种很容易错漏。所以音视频任务目前我还是不太相信agent自己loop出来的结果。
-
请教各位大神 都用什么模型和agent 来运行自动化minimax h3? -
micro center降价Pro 5000价格,给5500价格留出来空间 -
给论坛整了套专属表情,申请收编 -
如何远程使用DSH?——推荐dsh-im插件 -
【分享】strata-desktop 能取代 DeepSeek harness吗? -
浅谈thinkRail,是老牌收费IDE软件厂商的“回光返照”,还是“破釜沉舟” -
浅谈thinkRail,是老牌收费IDE软件厂商的“回光返照”,还是“破釜沉舟”前言:本文依旧,无任何AI含量,请放心阅读。
先放地址:https://thinkrail.ai/ https://github.com/JetBrains/thinkrail
背景:在过去的古法编程时代,编程工具分为两派,一个是以eclipse等为首的“免费派”,以及以Visual studio 以及 IDEA系列为首的收费派。
收费的编程工具有更贴心的一站式操作功能,以及更精细的工作流把控,比如通过编程工具可以直接串联数据库,比如能够有更强大的debug界面等。
但随着AI Coding的来临,这一切都变得没有了意义。就像是汽车来临时,人力脚夫和人力三轮车夫之间的选择。
废话少叙,JetBrain推出的thinkRail,本质上是Pi(https://github.com/earendil-works/pi )的UI再封装。这也是为何其也是开源应用的本质原因。
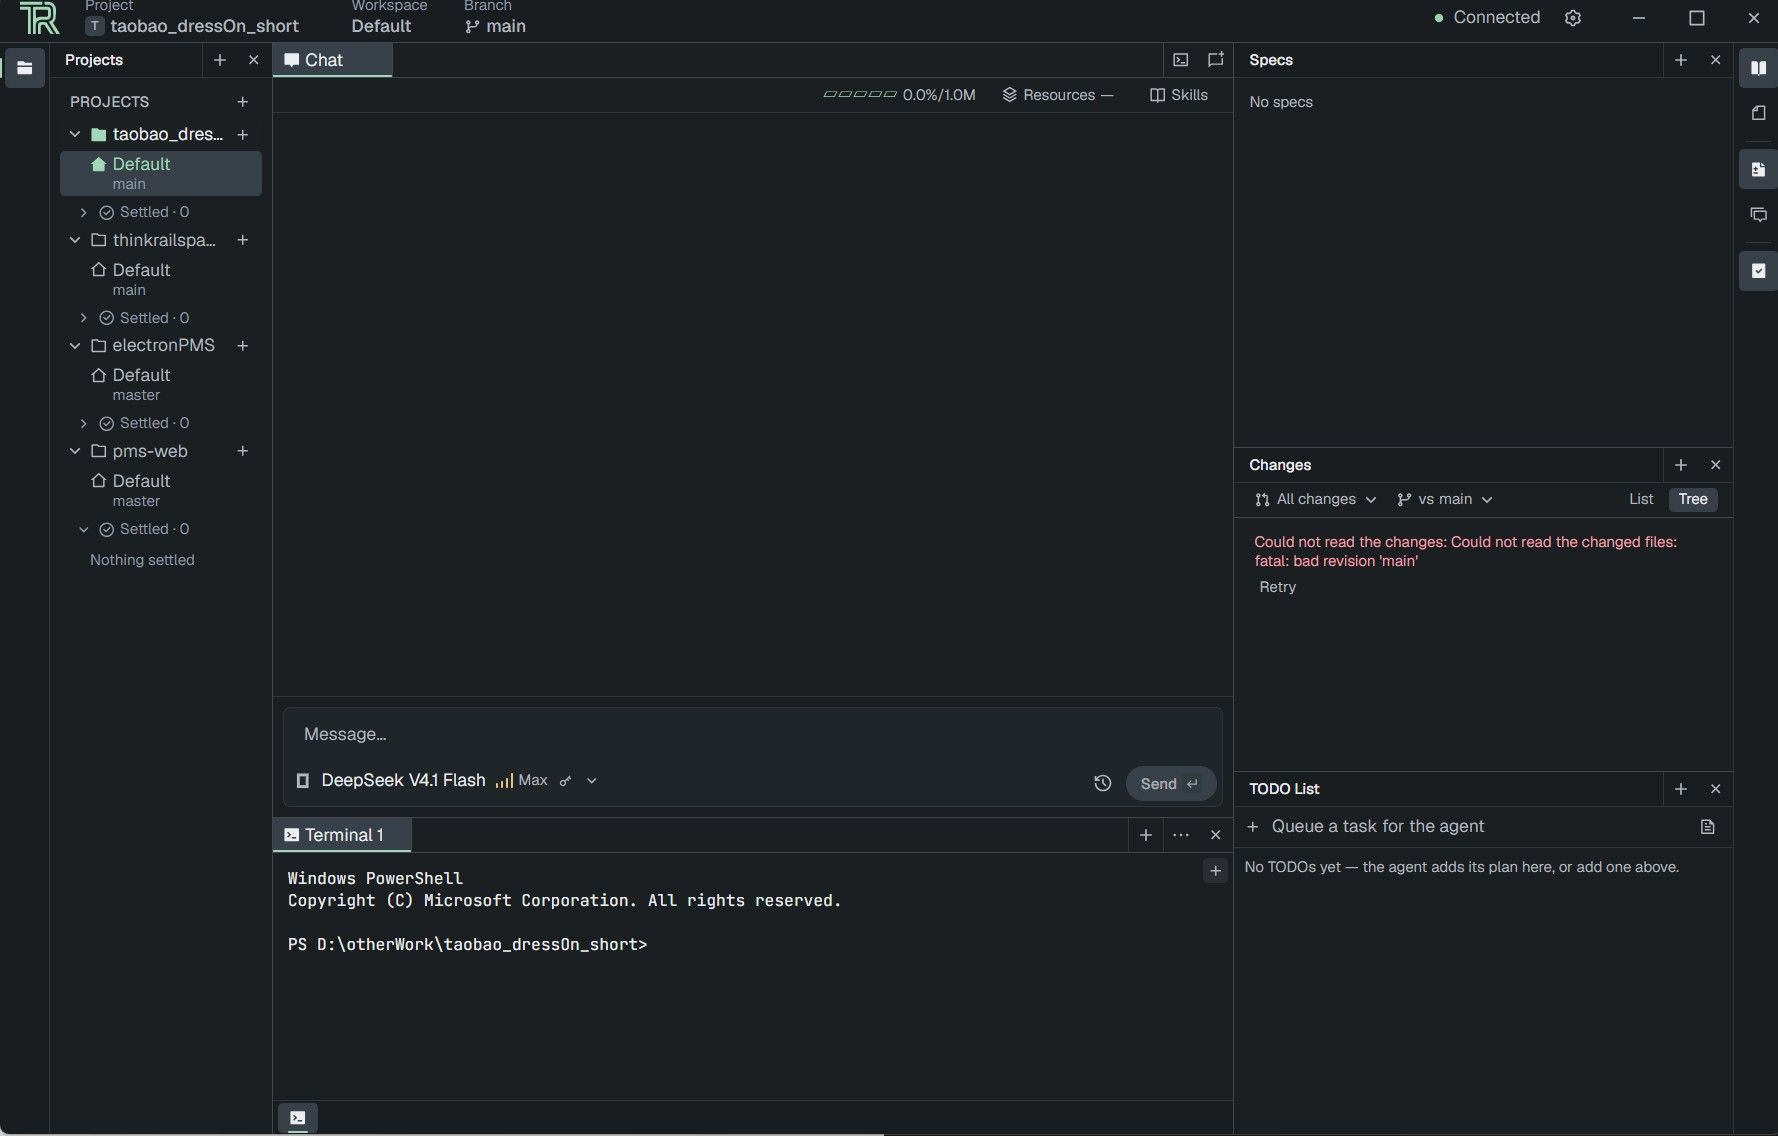
从界面也能看出,thinkRail充满着对于“古法程序员”控制欲的满足。你随时可以看到当前的目标,todoList,对代码的changes历史。
同样的竞品还有vscode Copilot以及 cursor、TRAE。
thinkRail在立意上的优势,就是其采用了目前人气最高的Pi内核。规避了用户对于Agent应用内核能力的不信任。
但也仅此而已了,以上。
-
给论坛整了套专属表情,申请收编 -
请教一下各位大神 的comfyui minimax h3 的生成时间 -
把 Strata+qwen3.8-flash-next-unsloth-ud-q4_k_xl 接进 Claude Code的五个坑 -
给论坛整了套专属表情,申请收编 -
在有Pro 6000情况下,到底选择Wan2.2还是H3 -
在有Pro 6000情况下,到底选择Wan2.2还是H3H3主要的优势是一个是配音、配乐都带,一个是有很强大的参考生成(r2v)。
wan一个是没有参考生成(只有i2v),一个是没有配音配乐。这就导致二者其实本质上的视频生产逻辑有区别。H3爆火的原因,也是开源界当时没有 qwen image2.1。
然后就是H3和wan2.2,如果只是官方参数对比的话,我个人理解他们的画质其实没本质差距。
包括参数上,H3其实也是只支持24fps*15秒。配音配乐方面H3也只能说是聊胜于无,尤其是配乐bgm能力。跟目前最新的开源yue2等没法比。
所以关键还是要看你对于最终产物的品质要求。
我的观察是,开源模型的甜区是做一个大概45~50分的视频(百分制)。假设你需要一个65分以及以上的视频,其实使用开源模型你的时间成本和精力成本会陡增。目前闭源甜区大概能做到70~75分。
导致以上差距的原因,除了模型能力本身以外,还有一个就是H3的提示词处理其实不会开源。闭源模型包装的是一整个生产流程。开源模型其实只开源了模型本身。
-
请教一个公司用的配置,希望有高低两种建议 -
好起来了,国产算力产品也开始慢慢面向消费端了。
