跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
suboyangS

suboyang

@suboyang
硕果累累 体面乡绅
取消关注 关注
关于
帖子
78
主题
2
分享
0
群组
2
粉丝
0
关注
3

帖子

最新 最佳 有争议的

  • 双R9700 P2P+双卡TP 方案总结
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

    双R9700 如果要实现双卡TP, 需要主板支持必须技术如下:

    2个PCIE3.016 直通CPU(X99 系列主板) 或者
    拆分成2个PCIE4.0
    8(个别消费级主板)
    Above 4G Decoding = ON
    Resizable BAR = ON
    CSM = OFF

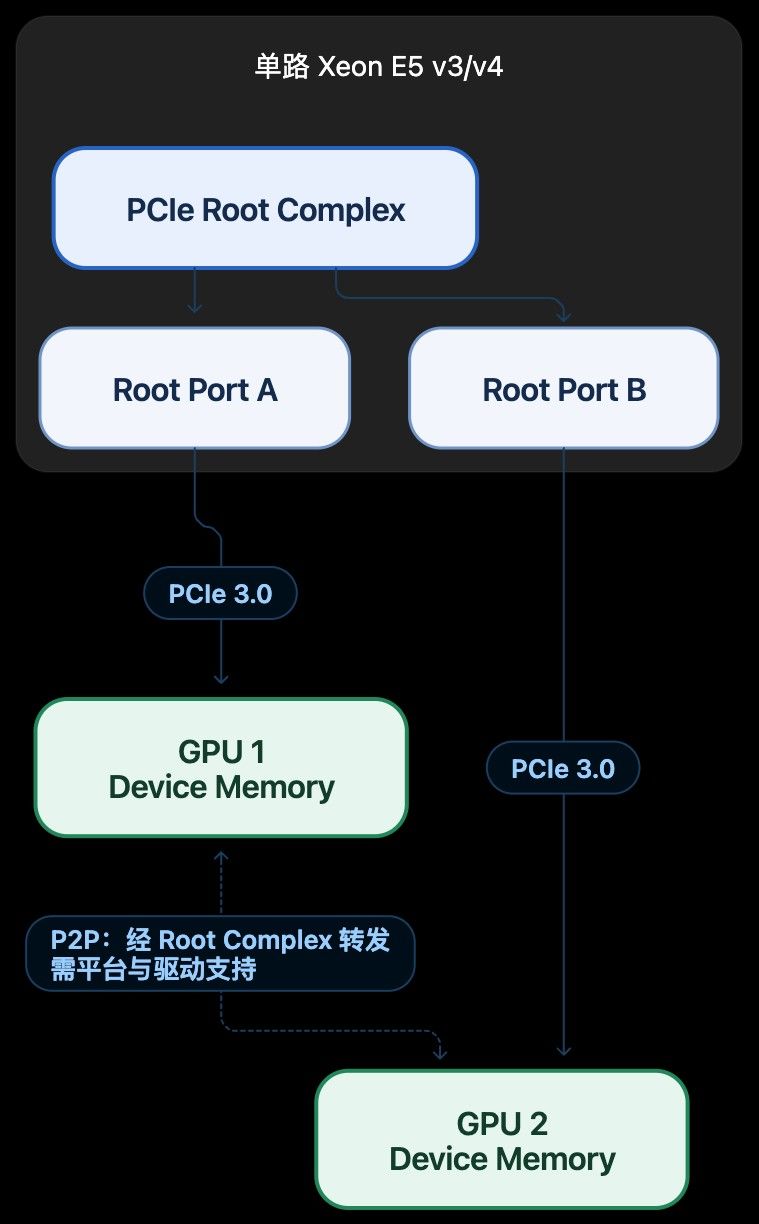
    2个PCIE3.0*16 直通CPU 可以实现root complex P2P
    mermaid-diagram.png
    mermaid-diagram.jpeg

    消费级主板确认两个 x8 槽都接 CPU 可以支持拆分,主板的第二个长插槽实际接芯片组不可以。

    但是不管是消费级CPU 还是E5v3/v4, 都必须支持Resizable BAR = ON, 否则 GPU不可能认识到另一个GPU的地址。

    现在可以确认的主板有
    resize BAR功能的是这些型号:X99-4MF 4MT 4MTPLUS 4MFPLUS
    8D3 8D4 AD3 AD4 BD3 BD4
    F8D T8D F8DPLUS M-F M-T
    P4T P4F PD3 PD4

    R9700方案
    https://www.primeline-solutions.com/media/categories/server/nach-gpu/amd-radeon-ai-pro-r9700/amd-radeon-ai-pro-r9700-rocm-pytorch-environment-setup-guide.pdf

    框架推理方案
    https://github.com/Eliovp-BV/paiton-vllm-plugin
    https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
    https://github.com/magiccodingman/vllm-radiance
    https://lcz.me/topic/1925

    模型选择
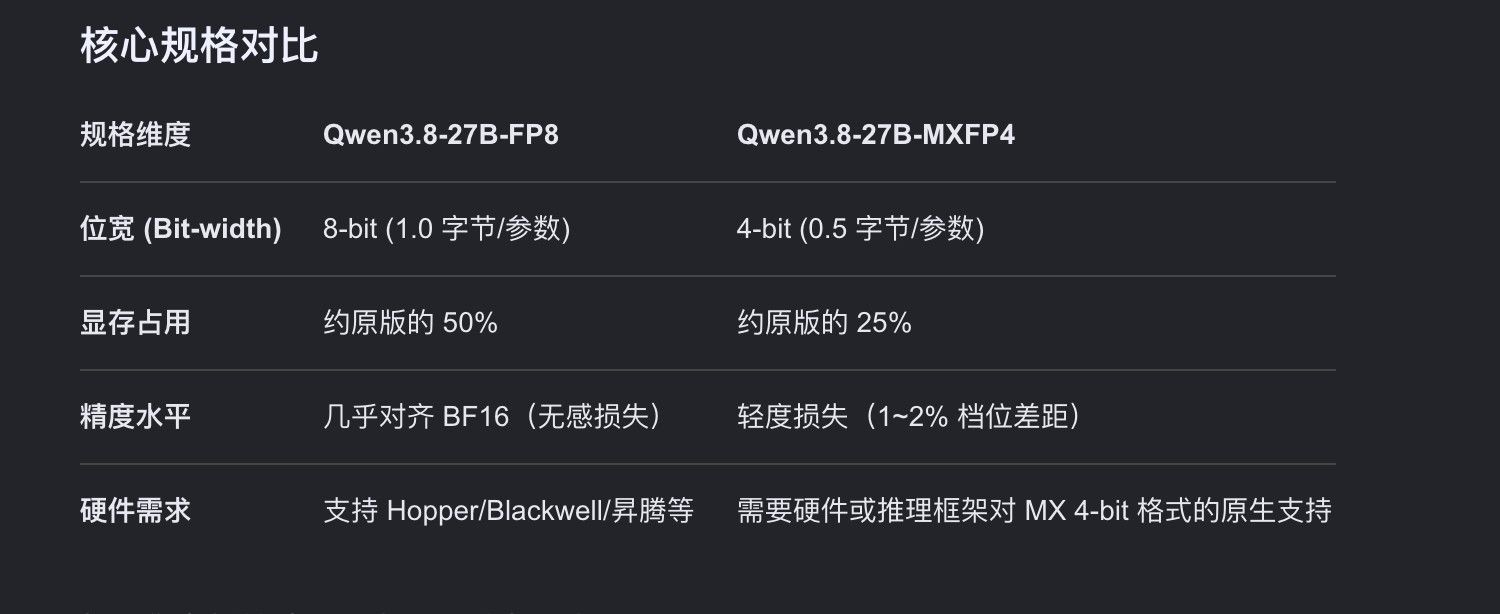
    image.jpeg


  • 双 R9700 TP. SGlang 部署qwen3.8-27b-fp8踩坑记录
    suboyangS suboyang
    AI硬件 r9700 sg-lang qwen-27b

    @Ben-Lee 这个模型是FP8
    7900xtx 跑的是低精度模型。

    楼主应该用
    tcclaviger/Qwen3.8-27B-DFlash2-FP8

    这个模型,不应该用MTP3,层数太深也影响效率。

    如果一定要用MTP,可以改成1

    https://github.com/magiccodingman/vllm-radiance

    https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese


  • 双R9700 P2P+双卡TP 方案总结
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

    @fcme

    按说这个sglang方案是没有问题的
    https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese

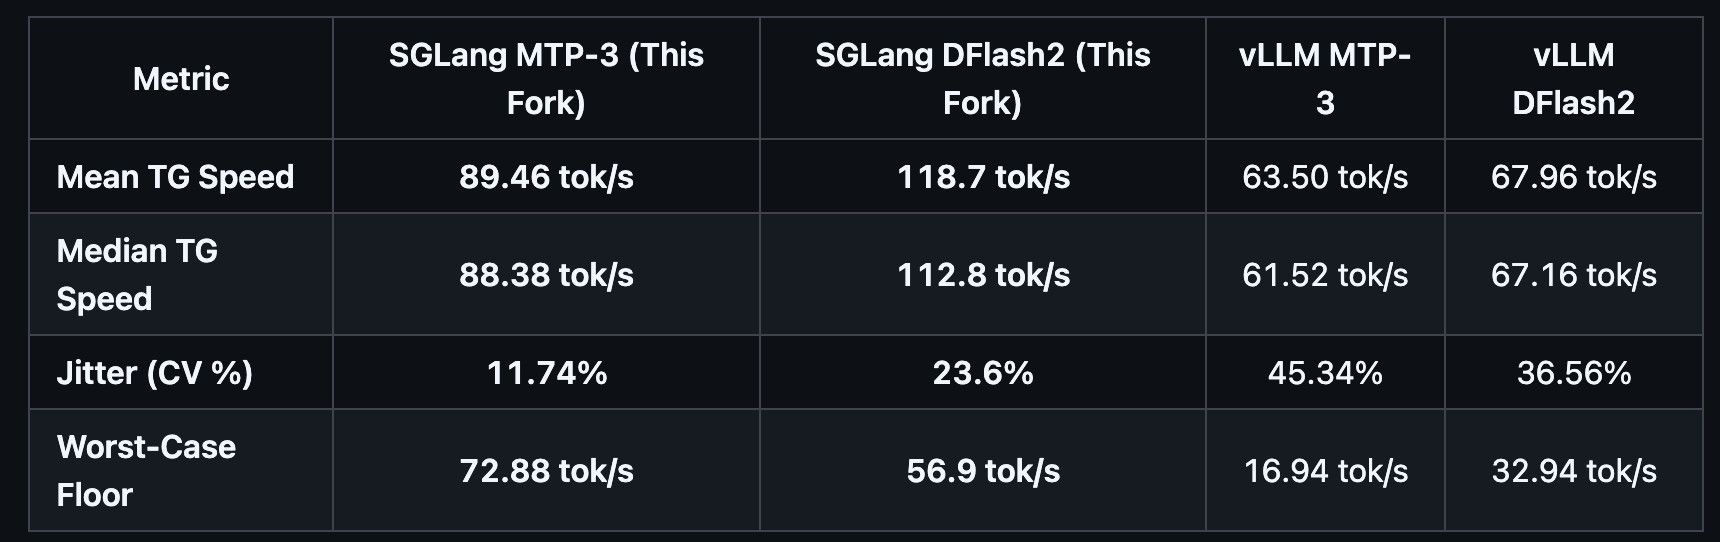
    双卡7900xtx 跑出了这样的水平,R9700 应该更高才对。
    image.jpeg


  • 双R9700 P2P+双卡TP 方案总结
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

    @applejuice 所以要比单卡3090 和单卡r9700速度 以及双卡tp. 就算没有150t/s 120也要的吧。双卡tp 只有58t/s ,那r9700双卡tp 可以不用折腾了。


  • 双R9700 P2P+双卡TP 方案总结
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

    @applejuice

    但是带宽影响比较大的是视频生成,和语音生成。大模型TP未必这么敏感,这个还得有人测。主要成本实在太高,要不然我自己早上手了。


  • X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s)
    suboyangS suboyang
    AI硬件 x99 ai-pro-r9700 多卡部署

    @张光璞 说:

    99主板好像没有ReBAR

    X99主板用ReBAR,需要打BIOS补丁的。所以才去买华南金牌X99主板,他们把补丁已经打好了。ReBAR 只能在UEFI开启,传统BIOS不支持。


  • X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

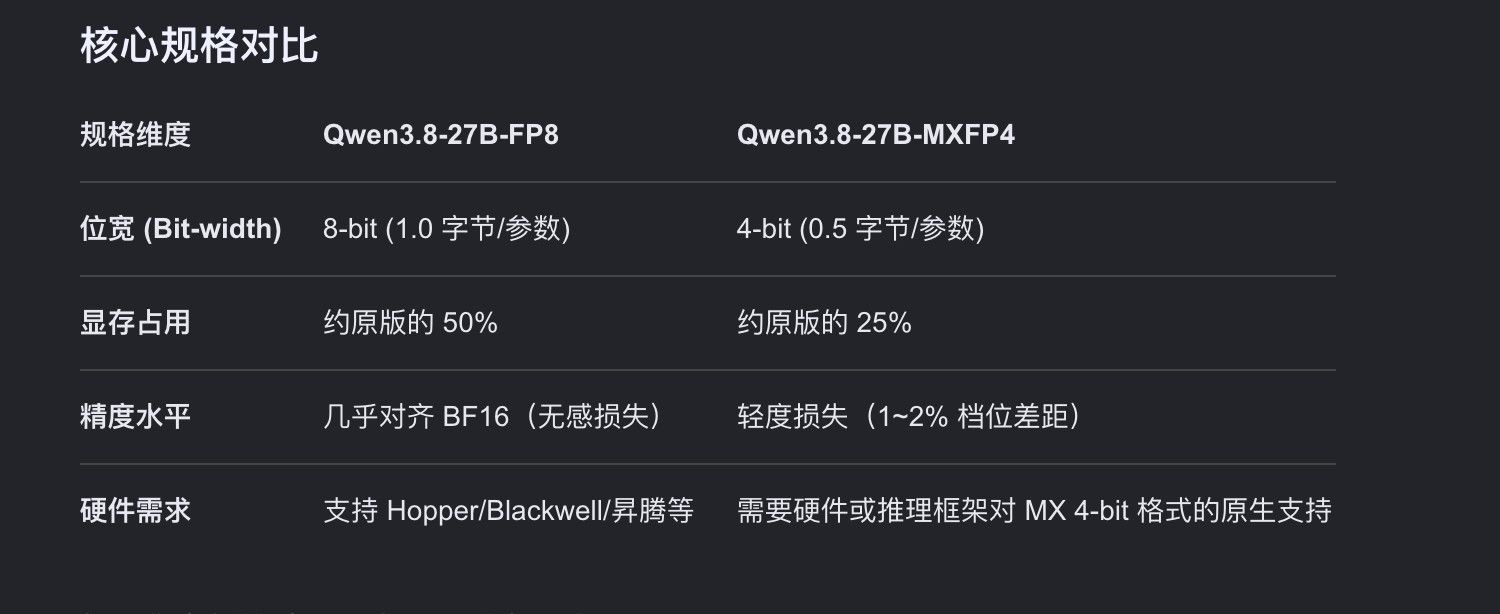
    @fcme 不是,搞本地模型不就是为了干大活,24小时推理着。不过精度差的不多。
    Qwen3.8 27B MXFP4 + DFlash2 比 Qwen3.8 27B FP8 精度,

    image.jpeg

    云端模型真心跑不起,每个月100亿token


  • 双R9700 P2P+双卡TP 方案总结
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

    现在最大的问题是,Qwen3.8-27B-MXFP4 这类模型,我还没有看到双卡 R9700 可以稳定100t/s 以上的,尤其是250K上下文的测试,如果在250K 还能保持80~100t/s,本地模型部署才有意义,要不然干活太慢了,这个时间等不起。


  • Qwen3.8-Flash-Next EXL3 双卡实测 60+T/S:MTP on/off 解码速度与多轮测速
    suboyangS suboyang
    LLM讨论区 rtx3090 rtx3080 多卡部署 qwen-flash

    @johnnybegood

    我用这个Qwen3.8-Flash-Next 干活已经干了两周了 速度是50token/s吧,而且我是调优关闭思考模式的。但是最后我还是放弃了,人是被模型拖着走的感觉, 最后我换回了deepseek。


  • 双R9700 P2P+双卡TP 方案总结
    suboyangS suboyang
    AI硬件 r9700 x99 多卡部署

    @fcme 就怕双卡TP 拉稀啊。

    https://github.com/mattbucci/2x-R9700-RDNA4-GFX1201-sglang-inference

    这个sglang 双卡才20t/s多,就算加上dflash2,也就40t/s。 如果是这样,双卡TP就没有折腾的必要。

    我认为双卡TP 本地模型,需要保持在150t/s,才有折腾的必要,否则就没有生成力啊。玩玩image 还行。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组