跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
张光璞张

张光璞

@张光璞
技术大牛 劳动模范
取消关注 关注
关于
帖子
322
主题
7
分享
0
群组
2
粉丝
2
关注
0

帖子

最新 最佳 有争议的

  • T7910 双卡本地推理全记录:7900 XTX 把两张卡跑掉总线,换 R9700 后大 BAR + P2P 一次打通,最后 4 并发 × 160K 稳跑
    张光璞张 张光璞
    AI硬件 7900xtx r9700 多卡部署

    T7910 双卡本地推理全记录:7900 XTX 把两张卡跑掉总线,换 R9700 后大 BAR + P2P 一次打通,最后 4 并发 × 160K 稳跑

    平台:Dell Precision Tower 7910(双路 Xeon E5-2683 v4 / 128 GB ECC / 无 BMC)
    本文是合集:前一半是先前那篇《双 7900 XTX 经 PCIe 交换机跑社区魔改 SGLang:TP=2 真跑到 100 tok/s,但一条卡死的请求把两张卡打掉了总线》的压缩版,后一半是换卡之后的新进展。没看过前篇的可以直接从这篇读起。
    两阶段的实测数字不能直接互相比较(模型、量化档、框架、prompt 全变了),所以本文只比「形态与能力」,速度账单独列表并标口径。


    TL;DR

    结果
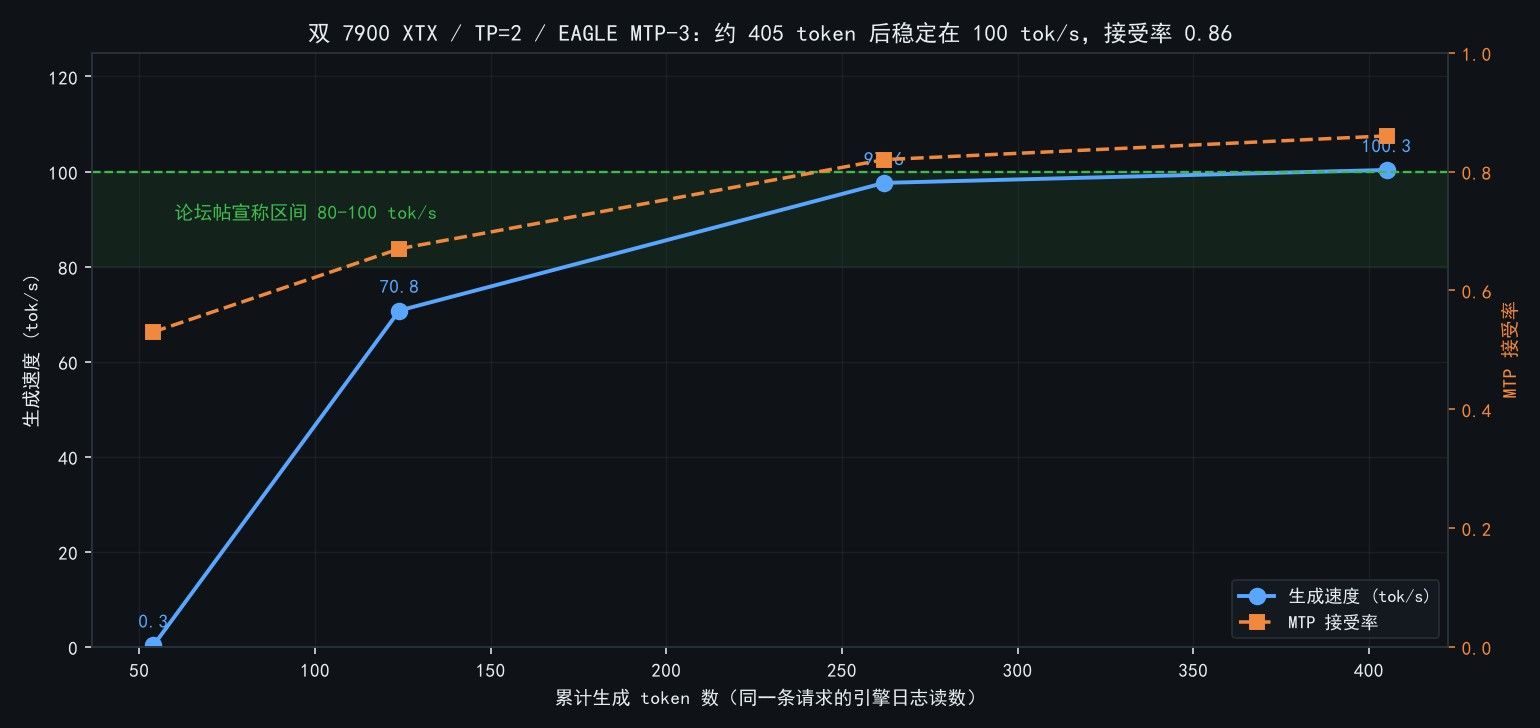
    ✅ 第一阶段(2× 7900 XTX 经 PCIe 交换机 / SGLang + W4A16 GPTQ + EAGLE MTP-3) TP=2 真跑起来了:100 tok/s、MTP 接受率 0.86、KV 243,403 token @196K —— 速度达标
    ❌ 但服务在第 6 分钟被一条卡死的请求把两张卡打成 device lost from bus 驱动连试 8 次复位全部失败(ret = -19),只能重启救回。根因不是供电也不是过热(掉卡瞬间仅 272 W / 54 °C)
    ⚠️ 那代卡的死结 7900 的 VBIOS 开机只申请 256 MB BAR ⇒ 这台机器拿不到大 BAR、也就没有 P2P;跨卡通信退回 NCCL,且经交换机有 4 跳只跑 Gen2 ⇒ 一切能跑,但脆弱
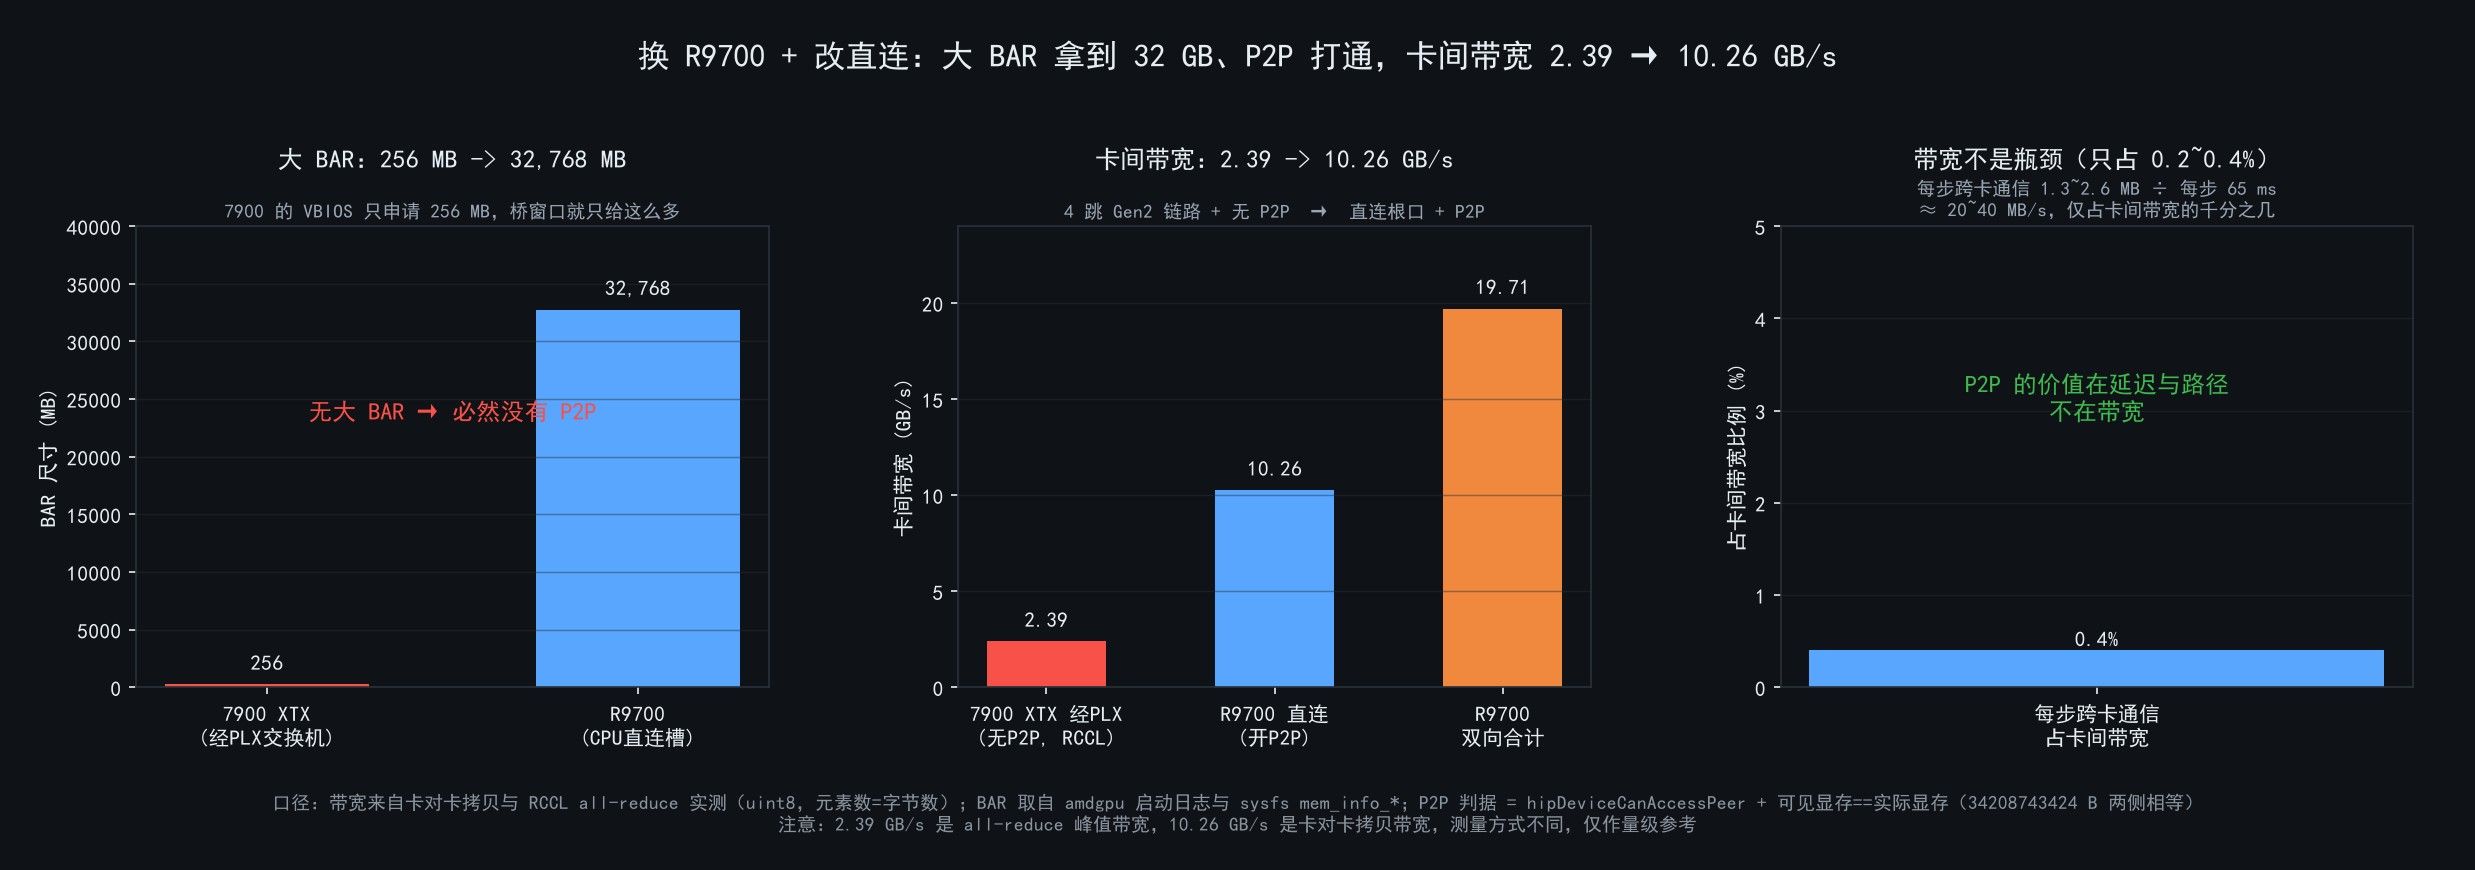
    🔄 转折(本文主线) 换成 2× R9700 32 GB,插 CPU 直连槽,再给自编内核的 p2pdma 白名单加一行 ⇒ 大 BAR 32 GB 与 P2P 一次打通,卡间带宽 2.39 → 10.26 GB/s
    ✅ 现在的形态 双卡 TP=2 + MXFP4 量化 + 4 并发 × 单请求 163,840 上下文(KV 717,986 token / 4.38×),单流贪心 43 tok/s,已连续稳定运行(含重启在内 0 次掉卡)
    🧱 本轮撞的三面新墙 ① 掉电写坏编译缓存 ⇒ 容器每 4~5 分钟静默死;② OD 偏移(时钟)才是速度旋钮;③ 160K 的代价 100% 落在投机接受长度上
    🔑 最反直觉的一条 投机解码的接受率与「精度」无关 —— 草稿 token 一律经主模型验证,接受率掉只掉速度;决定精度的是主模型量化档 + 上下文长度。别为了接受率去牺牲别的东西
    🎯 结论 这台机器上「大 BAR / P2P」不是玄学,是卡 VBIOS 的申请尺寸决定的。同一台 T7910,换一代卡就能从「能跑但会掉」变成「稳跑」——而你不需要换主板、不需要刷 UEFI

    一、平台与环境

    项 值
    主机 Dell Precision Tower 7910,双路 Xeon E5-2683 v4 @2.10 GHz(16C/32T×2),128 GB DDR4 ECC,BIOS A34(2020)
    系统 Ubuntu 24.04;自编内核 7.0.14-p2pdma(含下文那 4 行白名单补丁);Secure Boot 关;CONFIG_PCI_P2PDMA=y
    供电 显卡与 PCIe 交换机走独立一台 1500 W 电源(与主机电源分开);主机侧另有外接显卡供电
    阶段一显卡 2× RX 7900 XTX 24 GB(RDNA3 / gfx1100),挂在 PLX88096 PCIe 交换机下游
    阶段二显卡 2× AMD Radeon AI PRO R9700 32 GB(RDNA4 / gfx1201),插 CPU 直连槽(不经交换机)
    阶段一软件栈 ROCm 7.2 + StevenChenSE/sglang @ gfx1100-support 分支 + Qwen3.8-27B W4A16 AutoRound GPTQ
    阶段二软件栈 社区容器 magiccodingman/vllm-radiance(版本串 0.9.3-dev.vllm0.28.0-r4d0.5.0-mxfp4.rx4.dflash2…)+ Qwen3.8-27B MXFP4(AWQ/Quark 量化)

    两种形态对照(这才是本文的主线):

    阶段一:7900 XTX + PCIe 交换机 阶段二:R9700 + CPU 直连槽
    大 BAR(Resizable BAR) ❌ 256 MB(lspci 支持列表里明明有 32 G,VBIOS 只申请 256 M) ✅ 32768 MB(启动日志 Detected VRAM RAM=32624M, BAR=32768M)
    P2P(卡对卡) ❌ canAccessPeer 双向 = 0 ✅ P2P access : ENABLED 0↔1
    卡间链路 交换机下游 4 跳只跑 Gen2(5 GT/s) 根口 Gen4 x16
    跨卡通信方式 退回 NCCL(自带的 PCIe All-Reduce 在 gfx1100 上编不过) 容器自带的 R4D one-shot all-reduce(走 P2P,byte-identical to RCCL)
    卡间实测带宽 2.39 GB/s(all-reduce 峰值,延迟主导) 10.26 GB/s 单向 / 19.71 GB/s 双向
    结果 100 tok/s,但第 6 分钟掉总线 长跑稳定,4 并发 × 160K

    二、第一阶段(压缩版):能跑,但会掉

    2.1 部署踩坑(严格按我踩到的顺序,压成一张表)

    # 坑 症状 解法
    1 魔改 fork 的依赖版本 README 说 torch 2.11,pyproject.toml 实际要 2.13 以 pyproject 为准,并用 constraints 锁死 ROCm 版 torch,否则依赖解析会把它换成 CUDA 版
    2 torchvision 装成 CUDA 版 import sglang 直接炸:operator torchvision::nms does not exist 从 ROCm 源装 torchvision==0.26.0+rocm7.2 --no-deps
    3 (最阴)PyPI 的 sglang-kernel 会盖住 fork 的 Python 层 调度器初始化阶段挂:gptq_gemm() takes 7 positional arguments but 8 were given 只覆盖 .so 不够,Python 层也要整层覆盖
    4 kernels 包与新版 transformers 冲突 ValueError: Either a revision or a version must be specified. pip uninstall kernels(该代码在 try/except ImportError 里)
    5 AOT 内核编译 —— 唯一一步「照着走就行」:setup_rocm.py build_ext --inplace(本机双路 E7 单核弱,约 50 分钟)
    6 fork 自带的自定义 All-Reduce 编不过 __builtin_amdgcn_global_store_b128 needs target feature gfx940-insts(那是 MI300/CDNA3 专属指令) 关掉,退回标准 RCCL:SGLANG_RDNA_CUSTOM_AR=0
    7 (致命)无 P2P ⇒ 所有 symm-mem / multimem 路径都崩 一进 decode 就 SIGABRT,栈顶却是 logits_processor.py(极具误导性,实际炸在 decode CUDA Graph 捕获阶段建通信器时) ① --disable-custom-all-reduce + SGLANG_OPT_USE_CUSTOM_ALL_REDUCE_V2=0;② 打补丁:给 MultimemAllGatherer._build() 首行插 return None,强制走 NCCL all-gather
    8 起服务前没检查谁占着卡 一个 unless-stopped 的旧容器在无限重启,每次抢走一张卡 23.7 GB ⇒ TP=2 直接被挡死 rocm-smi --showmeminfo vram + docker inspect 看重启策略

    坑 7 的结论值得单独记一句:无 P2P 的 RDNA3 是能跑 TP 的,前提是把跨卡通信全部退回 NCCL。

    2.2 成绩单(数字取自引擎自己的日志,不是客户端计时)

    双卡 TP=2 生成速度与 MTP 接受率
    指标 实测值
    生成速度 100.33 tok/s(稳定段;爬升过程 0.29 → 70.75 → 97.61 → 100.33)
    MTP 接受率 0.86(每轮 4 个草稿 token 实际接受 3.58 个)
    KV 容量 243,403 token
    上下文 196,608
    显存占用 卡0 22.46 GB / 卡1 22.19 GB(各 24.6 GB 可用)
    权重加载 / 就绪 20 GB 用时约 77 s;服务就绪共 112 s

    fig2.jpeg

    口径:W4A16 量化、单流、上下文 196 K、开启 EAGLE MTP-3;速度取自引擎日志 decode batch 行(第 405 个 token 之后稳定),非多并发聚合、非客户端计时。
    顺带一个教训:这个 100 tok/s 是强规律 prompt 下的成绩 —— 换成不可预测的 prompt 会掉到 43 tok/s(见 2.5 的 fig5)。

    2.3 掉卡全过程

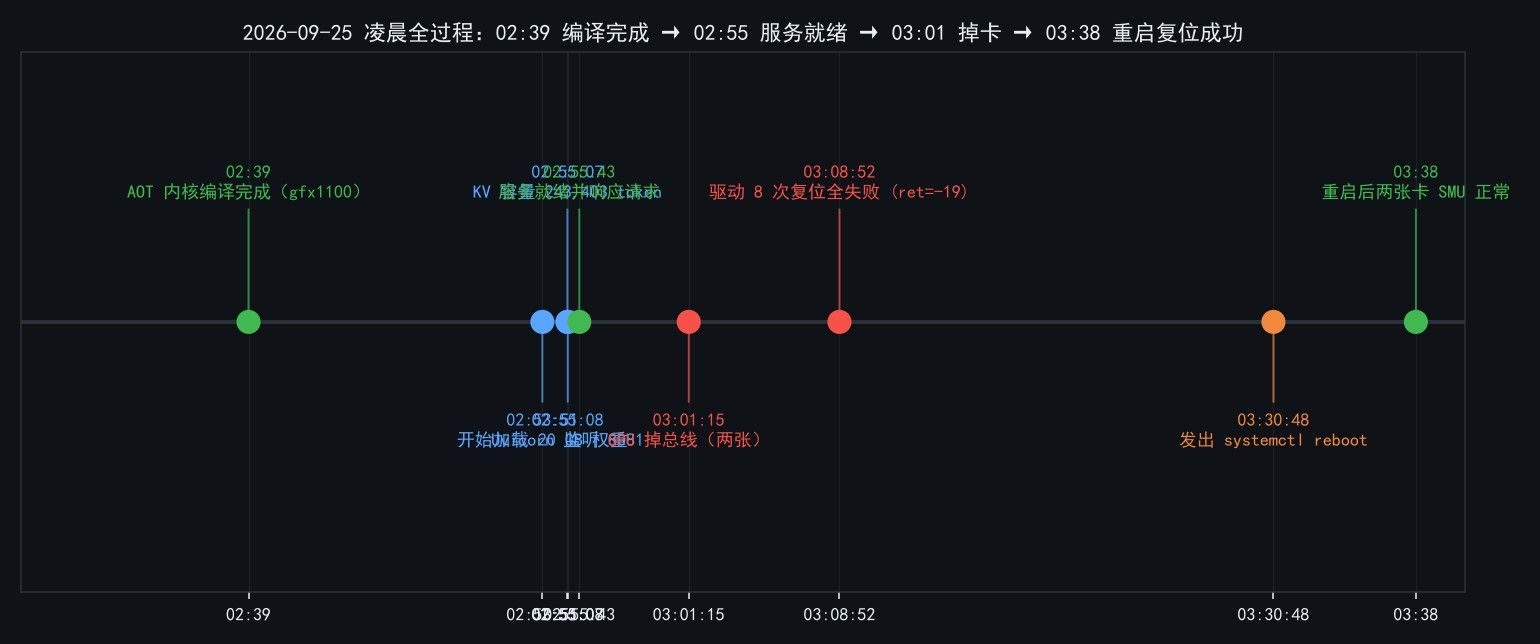
    服务 02:55:43 就绪,我发了一条请求做基准 —— 那条请求卡住了(引擎两个进程各 200% CPU 空转),6 分钟后,卡崩了。

    时间 事件
    02:55:43 服务就绪、正常响应请求,速度见上图
    03:01:15 卡0 爆 sq_intr 着色器/队列错误,紧接着两张卡 device lost from bus!
    03:08:52 驱动自救:ring sdma0 timeout → failed to reset legacy queue → GPU reset begin! → GPU reset end with ret = -19,连试 8 次全失败
    之后 SMU: bus error ... 0xFFFFFFFF 无限刷;nvtop / rocm-smi 读不到任何温度
    03:30:48 发出 reboot
    03:38 机器起来,两卡 SMU is initialized successfully!、device lost 0 条 ⇒ 卡自己回来了

    ![全过程时间线]
    fig3.jpeg

    🔑 转折点

    掉卡前最后一条有效遥测(03:01:14):卡0 272 W / 56 °C,卡1 271 W / 54 °C,风扇刚爬到 799 / 642 RPM。

    我最初的条件反射是「又是供电/过热把机器打死了」,但数据说 272 W 离 355 W 上限还差得远,54 °C 更是凉快。

    ![掉卡瞬间功耗曲线]
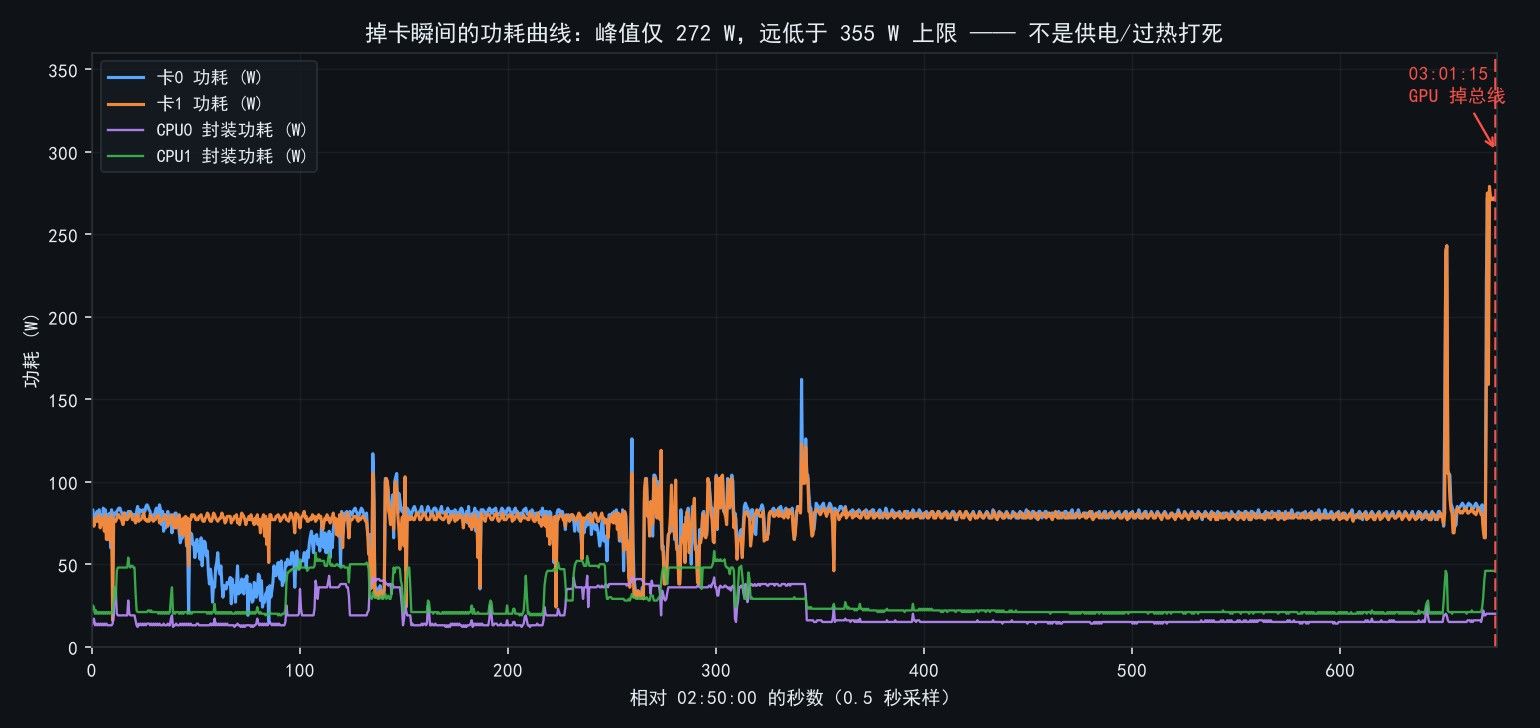
    fig1.jpeg

    ⇒ 方向立刻从「供电/散热」掰到「计算故障 + 驱动复位失败」。

    # 假设 判据 结论
    1 过热 掉卡瞬间 54–56 °C,风扇刚起转 ❌ 排除
    2 供电瞬态尖峰(老毛病) 272/271 W,远低于 355 W cap;主机本身没断电 ❌ 排除
    3 卡物理损坏 lspci 仍枚举、驱动仍绑定;重启后完全恢复 ❌ 排除
    4 驱动/固件崩 + 复位失败 sq_intr → device lost from bus → 8 次 GPU Recovery Failed: -19 ✅ 就是这个
    5 触发源 时间线:一条卡死的请求在同一秒触发 sq_intr;此前 6 分钟完全正常 ✅ 高置信

    我自己的责任:那条请求卡死后我拖了 18 分钟才发现,而崩卡发生在卡死的第 1 分钟内。如果 2 分钟内就杀进程,大概率不会有这次掉卡。这条已写成硬规矩:请求超时 3~5 倍、或引擎 CPU 拉满却没有吞吐日志 ⇒ 立刻杀进程。

    2.4 想拿大 BAR / P2P 的三条路,全走死了

    路径 结果
    运行时扩 BAR(resource0_resize) ❌ 写值返回 I/O error,内核 old value restored
    内核参数 pci=realloc ❌ 大 BAR 仍 256 M,桥窗口仍刷 mem size 0x800200000: failed to assign
    把 PLX 交换机从 CPU1 侧挪到 CPU0 侧 ❌ 两卡都变成 numa_node=0、BAR 地址落在 CPU0 的 1 TiB 窗口内,大 BAR 仍 256 M

    机理:大 BAR 要求「先选 BAR 尺寸、后分配桥窗口」,而选尺寸的只能是 BIOS/VBIOS(驱动 probe 时再写 rebar 控制寄存器,桥窗口早已被固件定死)。
    ⇒ 根因唯一:7900 的 VBIOS 开机只申请 256 M。

    附一条容易踩的判据:别用 amdgpu 日志的「沉默」判断 P2P 可用 —— 大 BAR 那层的否决是静默的。只剩两张 7900 时日志里 P2P 判词是 0 条,看着像通过,但 HIP 实测 canAccessPeer 双向都是 0。判据只能用 hipDeviceCanAccessPeer + 真跑的 hipMemcpyPeer。

    2.5 附带实测:三张这次才补上的图

    ① 并发天花板是 max_running_requests,不是硬件;提高 OD 上限没有收益

    ![并发基准与 OD 上限对照]
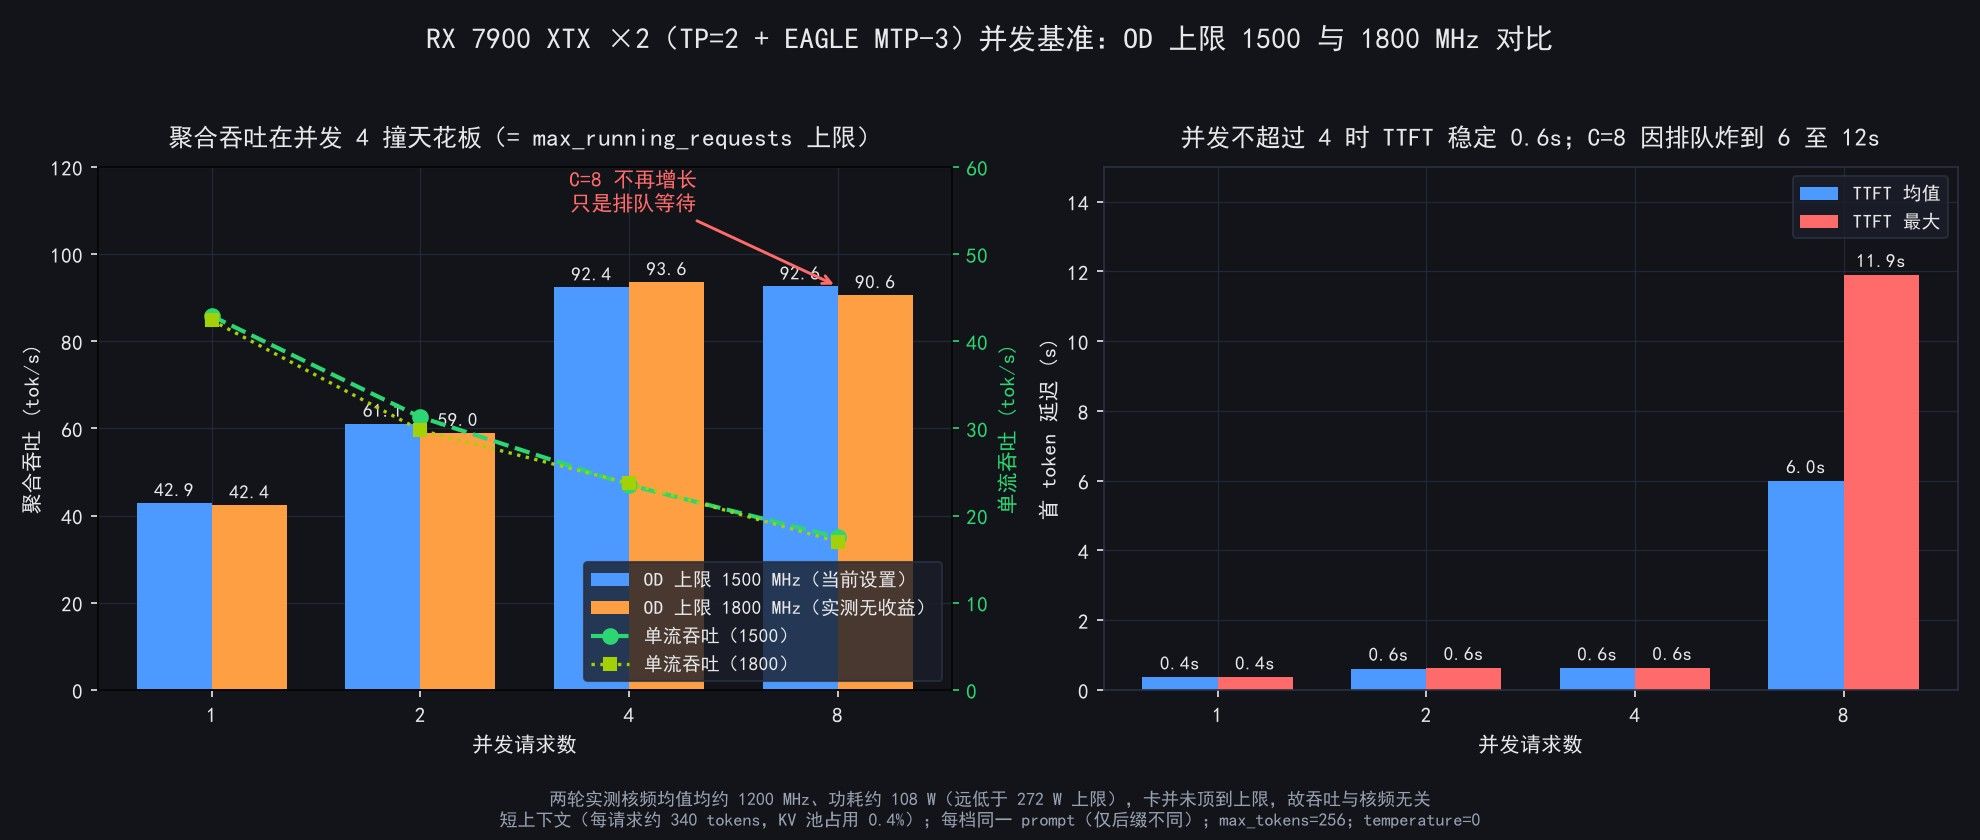
    fig4-并发基准.jpeg

    • 聚合吞吐在并发 4 撞天花板(92.4 tok/s),并发 8 不再增长(92.6),只是排队:TTFT 从 0.6 s 炸到均值 6.0 s / 最大 11.9 s。
    • OD 上限 1500 MHz vs 1800 MHz:两轮核频均值都只有约 1200 MHz、功耗约 108 W —— 卡根本没顶到上限,所以提上限自然没收益。这个结论和本文第五章「时钟偏移才是旋钮」是一对,别混。

    ② 同样的并发,只换 prompt,吞吐差 55% —— 因为 MTP 接受率变了

    ![prompt 类型对接受率与吞吐的影响]
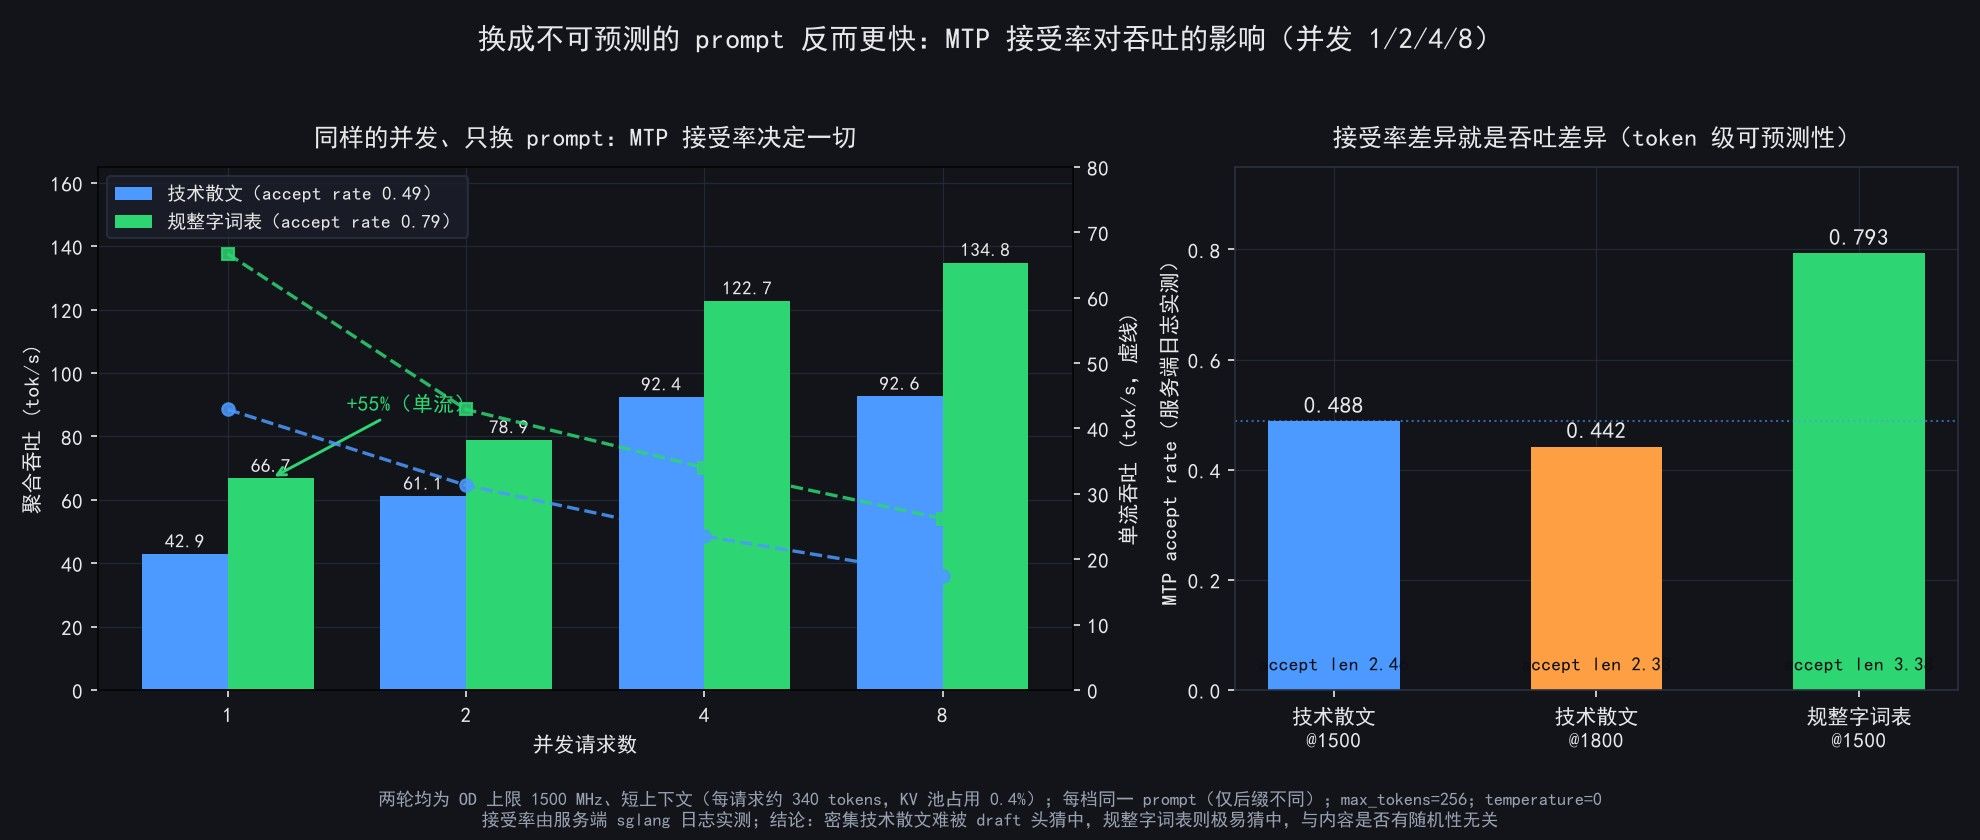
    fig5-prompt类型与接受率.jpeg

    • 技术散文 accept rate 0.49 vs 规整字词表 0.79:单流吞吐 42.9 → 66.7 tok/s(+55%),并发 4 时聚合 92.4 → 122.7。
    • 结论:接受率是 token 级可预测性的函数,跟你用不用随机内容无关。这条在第六章会再出现一次,但方向相反 —— 那时我们要说明接受率不影响精度。

    ③ 卡间通信:不是带宽不够,是链路太长 + 延迟太高

    ![卡间通信与 PCIe 链路实测]
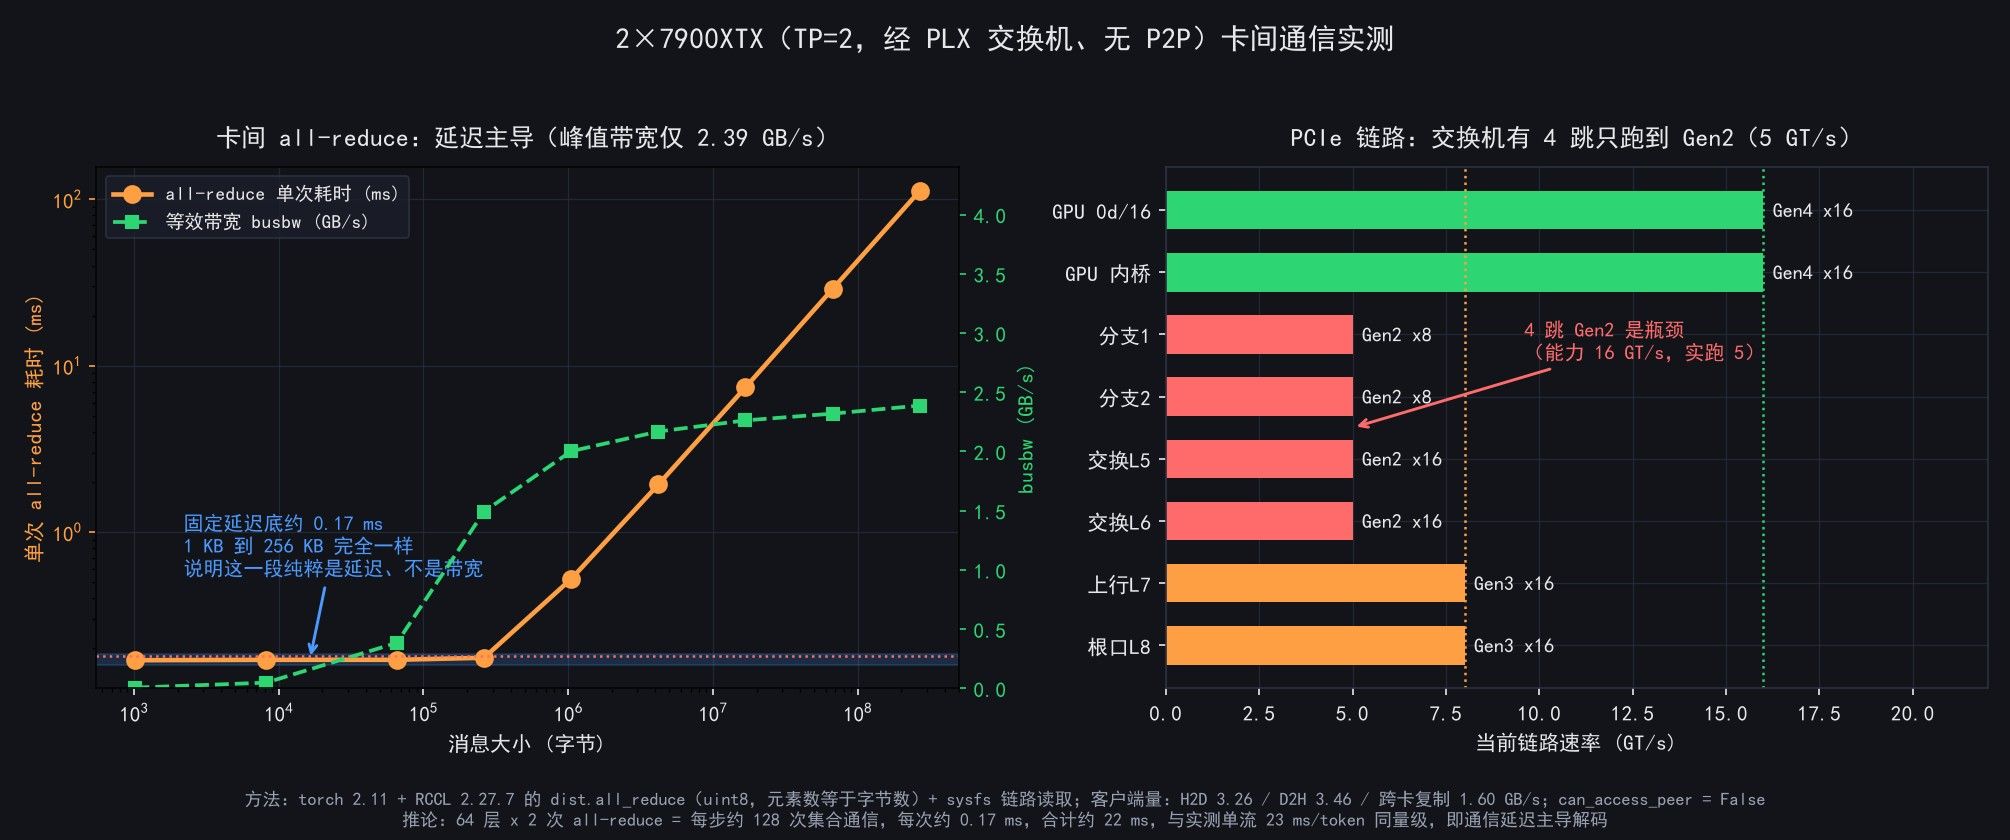
    fig6-卡间通信.jpeg

    • all-reduce 峰值带宽仅 2.39 GB/s;1 KB 到 256 KB 的耗时完全一样(约 0.17 ms) ⇒ 这一段纯粹是延迟,不是带宽。
    • 交换机下游有 4 跳只跑到 Gen2(实跑 5 GT/s,能力 16 GT/s)。
    • 推算:64 层 × 2 次 all-reduce = 每步约 128 次集合通信,每次约 0.17 ms ⇒ 约 22 ms/步,与实测单流 23 ms/token 同量级 ⇒ 通信延迟主导解码。

    这三张图的共同结论:在无 P2P 平台上跑 TP,你付的钱不是带宽,是延迟和脆弱性。

    2.6 掉卡后的恢复动作(建议背下来)

    1. 先看内核日志定性:journalctl -k | grep -iE 'device lost|sq_intr|Recovery Failed'
    2. 先试 reboot,但要有耐心:本次 03:30:48 发出、03:38 才起来(约 7 分钟),期间全网段无响应、很像死机 —— 等满 10 分钟再判死
    3. 还没回来再冷断电:关机 → 断 PSU 30–60 s → 按顺序上电
    4. ❌ 绝对不要用 unbind / bind 或 resource0_resize 去「救」一块 AMD 卡 —— 我曾这么干过一次,直接内核 NULL 指针 panic + 整机紫屏

    三、转折:换 R9700,大 BAR 与 P2P 一次打通

    拆掉两张 7900 XTX,换成两张 R9700 32 GB,插到 CPU 直连槽(不经交换机),然后给自编内核打了一行补丁:

    /* drivers/pci/p2pdma.c —— 让同/跨 Root Port 的 GPU 之间允许 P2P(本机 host bridge 8086:6f00)*/
    {PCI_VENDOR_ID_INTEL, 0x6f00, REQ_SAME_HOST_BRIDGE},
    

    三条判据一次性全绿(都来自启动日志与 sysfs,不是「感觉能行」):

    # ① 大 BAR 拿满
    Detected VRAM RAM=32624M, BAR=32768M          (两卡各 32 GiB)
    
    # ② 可见显存 == 实际显存(大 BAR 生效的零成本判据)
    card0  34208743424 / vis=34208743424
    card1  34208743424 / vis=34208743424
    
    # ③ P2P 打开 + 容器自己的互访矩阵全 1
    P2P access : ENABLED   0↔1
    rocm-bandwidth-test: Inter-Device Access(2 号/3 号设备之间 = 1)
    RADIANCE_USE_R4D_AR   P2P one-shot all-reduce for TP=2, byte-identical to RCCL
    

    卡间带宽对照(阶段一 2.39 GB/s 是 all-reduce 峰值;阶段二为卡对卡拷贝):

    阶段一 7900 XTX(经交换机、无 P2P) 阶段二 R9700(直连、开 P2P)
    卡间有效带宽 2.39 GB/s 10.26 GB/s 单向 / 19.71 GB/s 双向
    每次通信的固定延迟 约 0.17 ms(1 KB~256 KB 都一样) 每次 all-reduce 不再绕 NCCL,走 P2P one-shot

    ![换卡前后:大 BAR / P2P / 卡间带宽对照]
    fig7.jpeg

    但请注意最后那个 0.2~0.4%:这套部署里每步跨卡通信量只有 1.3~2.6 MB,跟 10.26 GB/s 比只占千分之几。⇒ P2P 的价值不在带宽,在于「能开起来」和「延迟低、路径短」。反过来说:如果你为了带宽去折腾 P2P,方向就错了。

    换卡后立刻要做的三件事(顺序别反):

    1. 先 unbind 旧卡 → 断电 → 插新卡(动卡必须断电)
    2. 先给交换机/显卡那台独立电源通电,再开主机
    3. 起来先验上面三条判据,再去装模型服务 —— 判据不过就别浪费时间调服务

    四、新墙 ①:掉电写坏编译缓存 ⇒ 容器每 4~5 分钟静默死

    这是本轮最阴的一个坑,也是最值得抄走的排查路径。

    症状

    服务跑起来又自己死,而且非常规律:

    时间 事件
    22:41:50 主机硬掉电(日志戛然而止,无 shutdown / Oops / panic —— 上电后对比新 boot 才确认是掉电)
    22:45 冷启动回来(此时 160K 的 KV 分配已经成功过:731,270 tokens, 4.46x @163,840)
    22:50:34 容器起后 约 4 分钟死亡(RestartCount 1)
    22:54:24 再起,又是 4 分钟死亡(RestartCount 2)
    —— docker inspect:退出码 0、OOMKilled=false、内核无 amdgpu 报错、entrypoint 里没有看门狗
    22:57 隔离整套编译缓存
    23:02 → 23:11 从零重编,一次通过、再没崩过

    三条判据(缺一条都会误判)

    1. 它不是随机掉电:两轮死亡时间几乎相同(4 分钟),稳定复现 ⇒ 确定性病因
    2. 它不是被杀的:退出码 0 + 无 OOM + 内核无告警 ⇒ 进程是「自己走完」的
    3. 日志停在 CUDA Graph 捕获阶段,但显存监控证明权重已经加载到 29.4 GB ⇒ 日志随进程缓冲一起丢了,别拿日志位置当「没跑起来」的证据

    真凶判据(一条命令)

    # 数「掉电瞬间正在被写」的缓存文件
    find <缓存目录> -path '*BROKEN*' -prune -o -type f -size 0 ! -name '*.lock' -print | wc -l
    # 隔离前 = 49(全是 torch_aot_compile/*/inductor_cache/ 下的 .py / *.best_config)
    # 隔离后 = 0
    

    因果链:掉电砸在首次编译过程中(掉电窗口里 40 个文件正在写)⇒ 留下 49 个 0 字节缓存文件 ⇒ 之后每次启动都读这份坏缓存,在 cudagraph 捕获阶段稳定死。
    (为什么是首次编译?因为我把 max_model_len 改成 163,840 触发了 AOT 缓存从零重建 —— 改这类参数会重编,重编期断电就是灾难。)

    修法:隔离,不要删

    mv torch_compile_cache{,.BROKEN-<日期>-<原因>}   # 整套改名保留,出问题时还能回查证据
    mv triton/<相关键目录>{,.BROKEN-...}             # 同一时刻在写的 triton 键目录一起隔离
    # 然后重启服务,让它从零重编
    

    ![掉电写坏编译缓存:崩循环与判据]
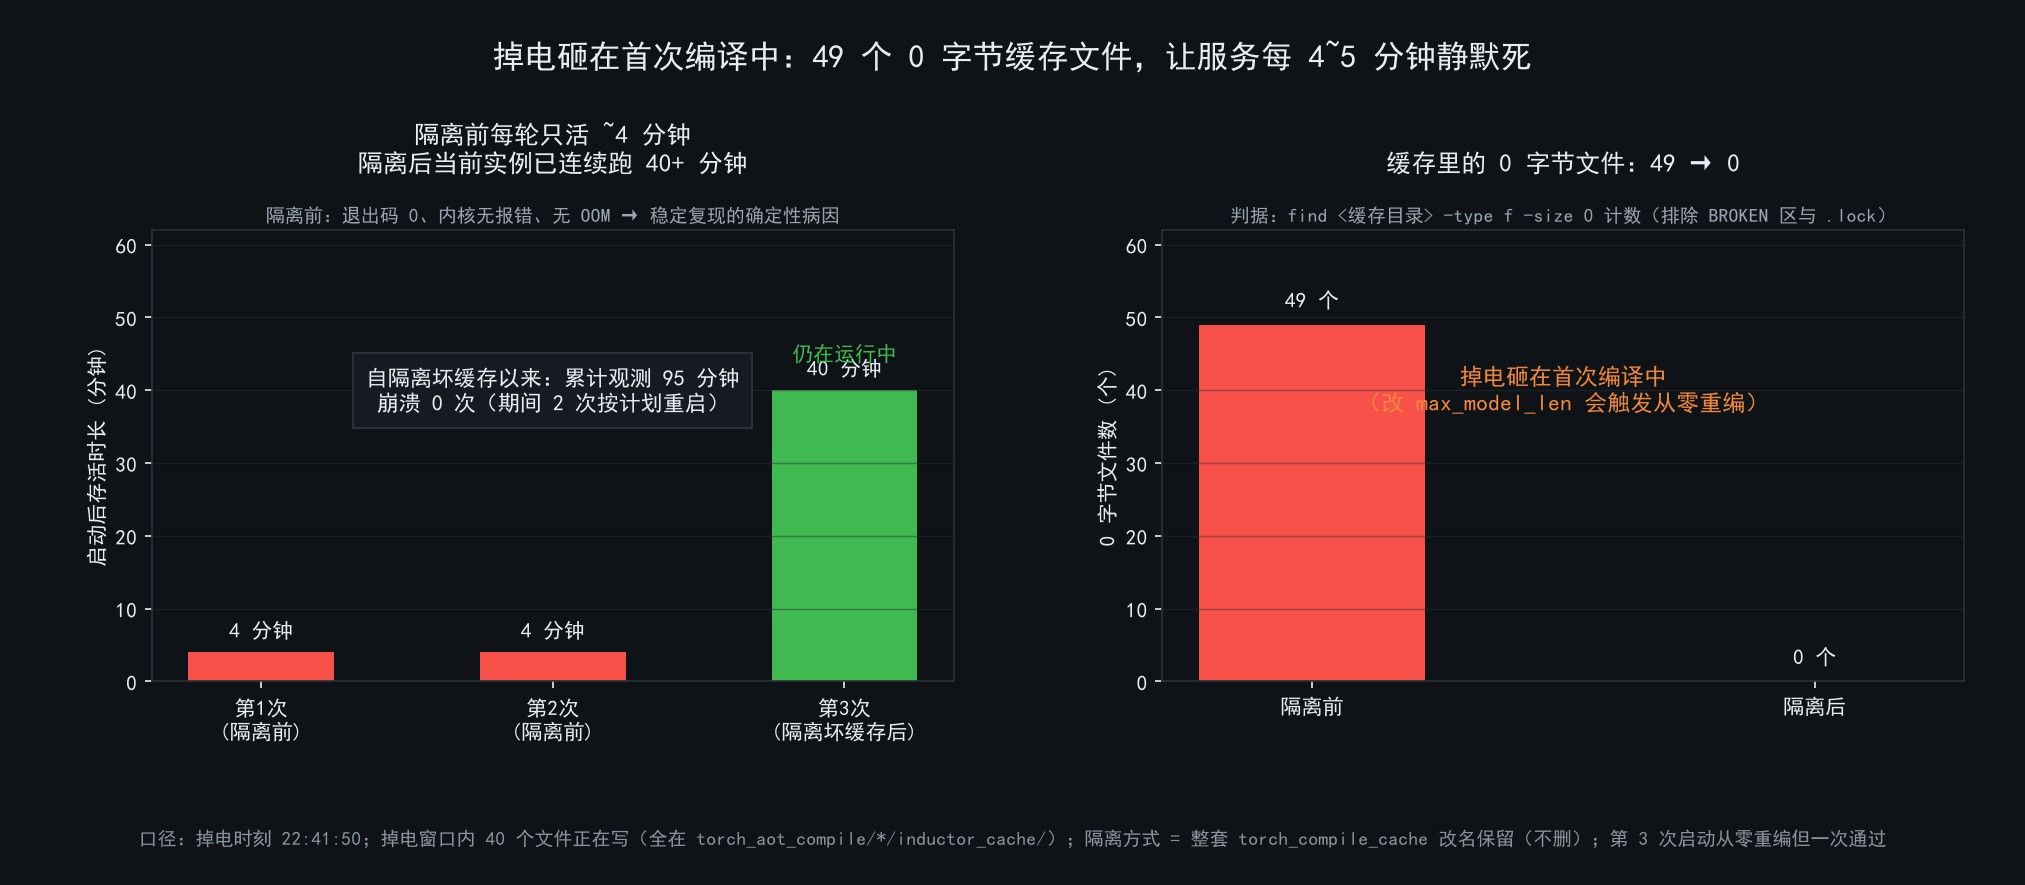
    fig8.jpeg

    收进习惯:① 只要「服务起得来但总在几分钟内自己死」,先查 0 字节缓存;② 隔离而不是删除,保留证据;③ 编译期尽量别断电(真要改配置,先确认不会触发首编,或者编完再断电)。


    五、新墙 ②:慢的不是功率上限,是时钟偏移

    阶段一那张 fig4 说「提高 OD 上限没有收益」,因为它测的是 cap。本轮踩的是另一个旋钮:偏移(offset)。

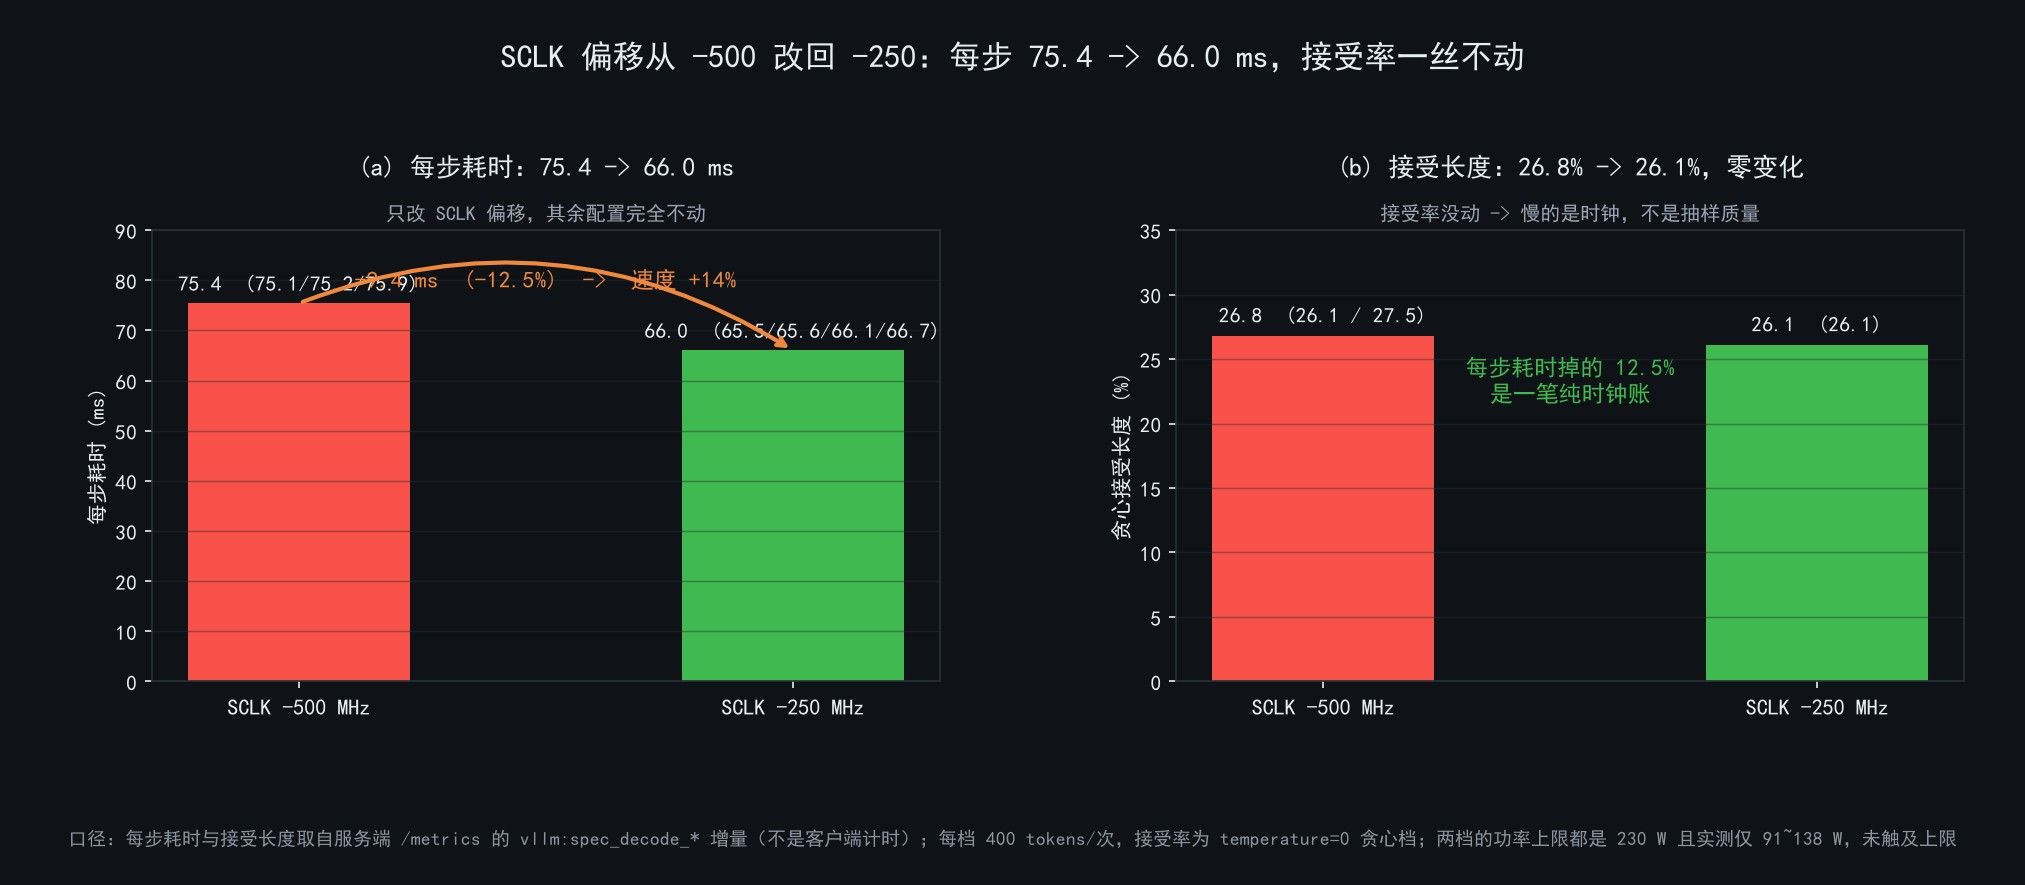
    我把供电护栏从「激进」调到「保守」时,顺手把 SCLK 偏移从 −250 MHz 改成 −500 MHz,结果每步耗时稳定 +13%:

    SCLK 偏移 每步耗时(多次实测) 均值 贪心接受长度
    −500 MHz 75.1 / 75.2 / 75.9 ms 75.4 ms 26.1% / 27.5%
    −250 MHz 65.5 / 65.6 / 66.1 / 66.7 ms 66.0 ms 26.1%(一丝不动)

    ![SCLK 偏移与每步耗时:纯时钟账]
    fig9.jpeg

    归因很干净:只改 SCLK 偏移,接受长度完全没变(26.1% 一模一样),而每步耗时掉了 12.5%、速度 +14%。
    ⇒ 这就是一笔纯时钟账,跟「功率上限」「量化档」「上下文」都无关。

    判据写法备忘:验证这类偏移有没有真正落到硬件,不能只看 --show 的回读值(那只是 sysfs 写回什么就显示什么),要用「每步耗时」这种端到端指标去反证。另外,一次性写两张卡的 OD 有竞态,可能存在「只配到一张卡」的情况 —— 回读两张卡各自的节点、并跑一段负载看两卡是否对称。

    现在的供电护栏(这台机器有过 PSU 瞬态过载史,护栏是必要的):

    项 值
    功率上限 230 W(出厂 300 W,下限 210 / 上限 330)
    SCLK 偏移 −250 MHz
    VDDGFX 偏移 −75 mV
    实测表现 两卡 91~138 W、温度 38~42 °C —— 离上限很远,慢不是 cap 造成的
    稳定性 本阶段长跑 0 次掉卡;内核侧保留 kernel.panic=15(掉卡能自愈重启)

    六、新墙 ③:160K × 4 并发,代价 100% 落在「接受长度」上

    服务是社区容器 magiccodingman/vllm-radiance,双卡 TP=2、MXFP4 权重、4 并发 × 单请求 163,840 上下文。

    容量账(引擎自己算的)

    GPU KV cache size: 717,986 tokens
    Maximum concurrency for 163,840 tokens per request: 4.38x
    Available KV cache memory: 14.28 GiB        (权重 ~9.5 GiB/卡,两卡各占 ~30 GB)
    

    ⇒ 4 并发 × 160K 是这套组合的上限档,再想加并发就得牺牲单请求上下文。

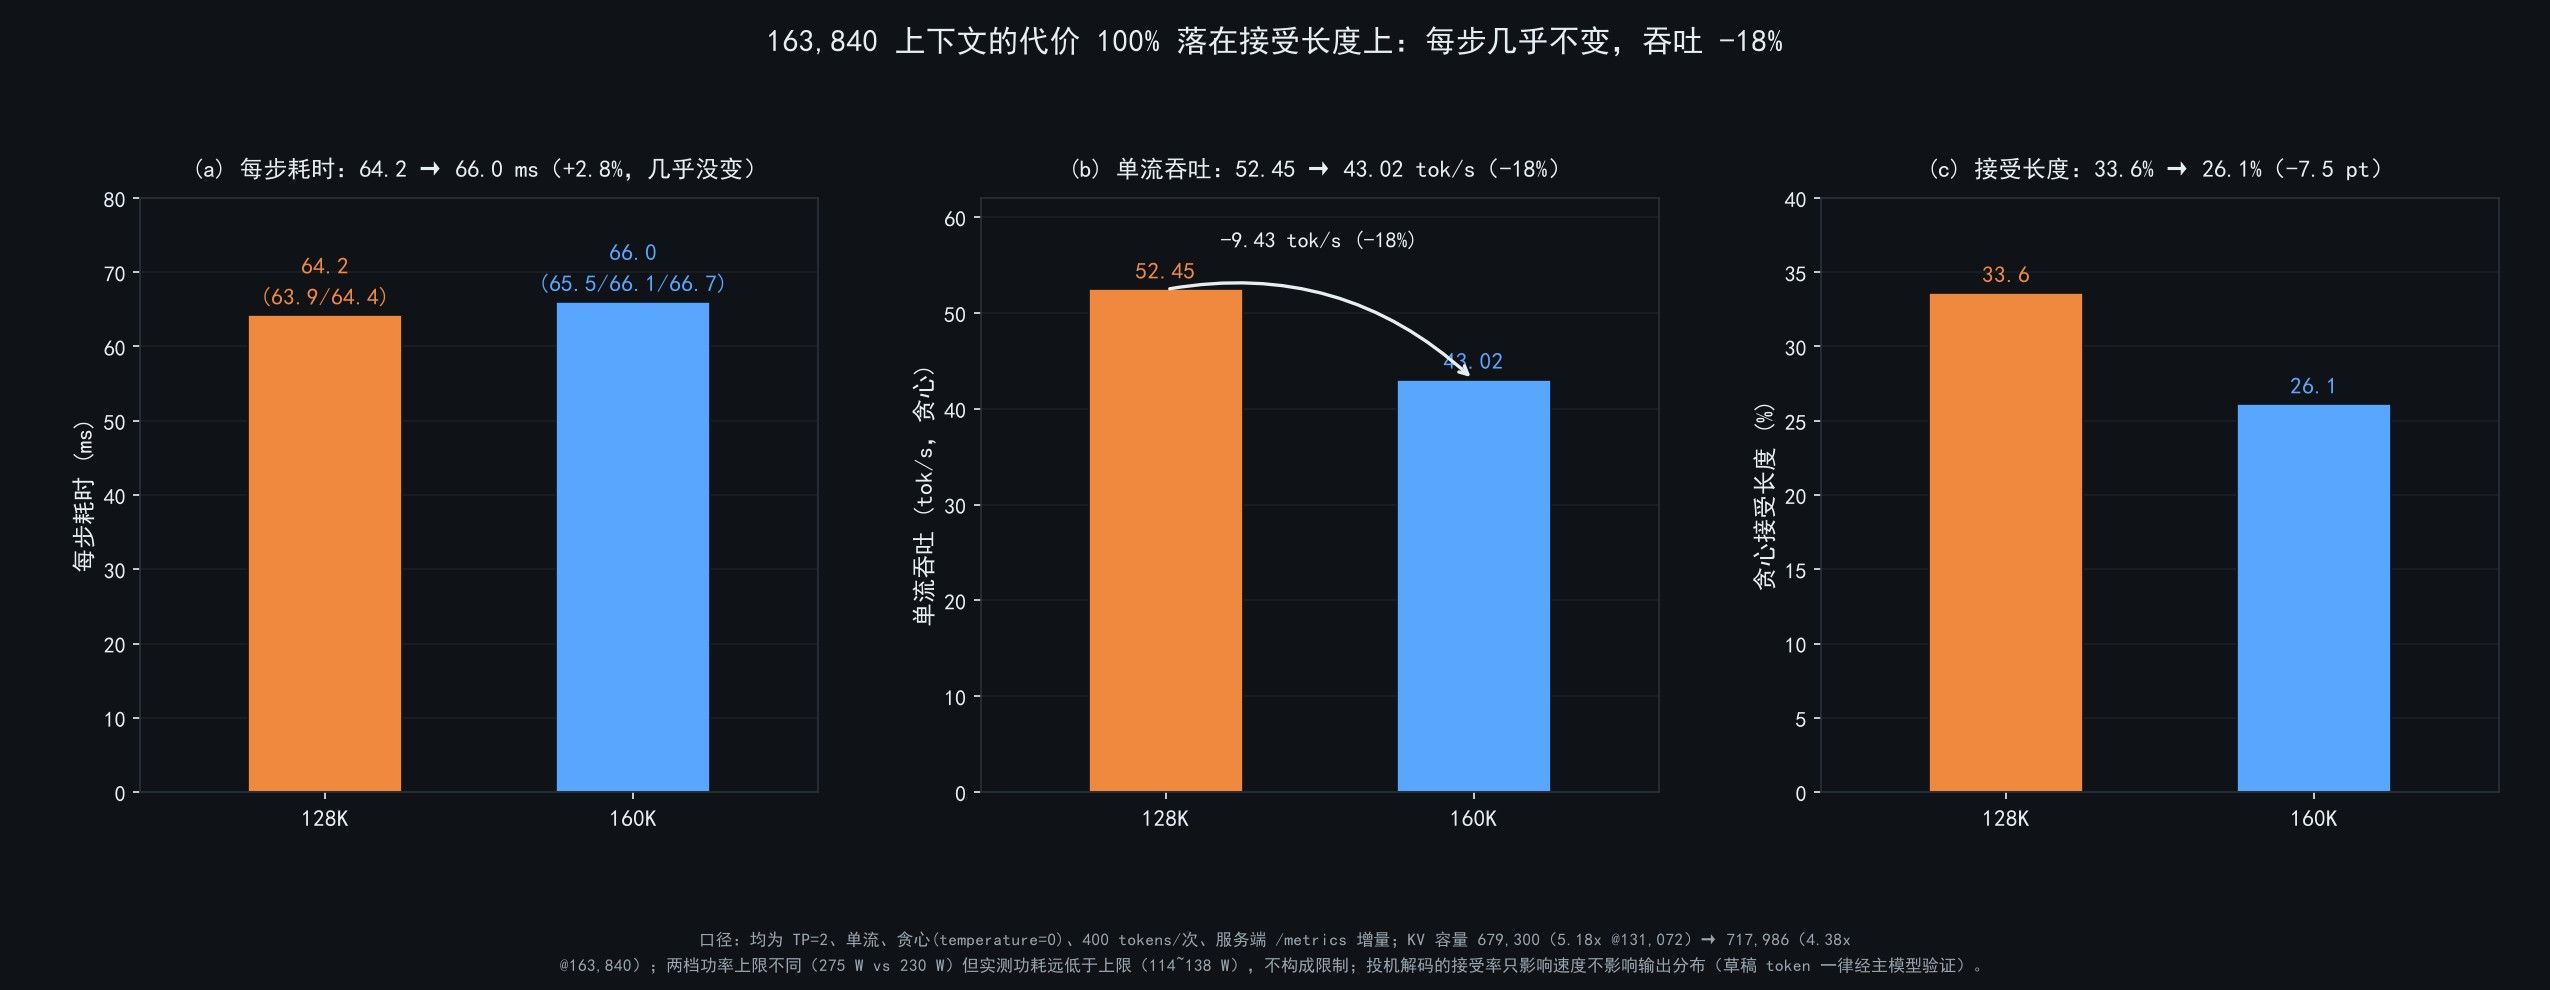
    128K → 160K 的完整取舍账(同机、同脚本、单流、贪心)

    131,072 上下文 163,840 上下文
    KV 容量 679,300 token(5.18×) 717,986 token(4.38×)
    每步耗时 63.9 / 64.4 ms(均 64.2) 65.5 / 66.7 ms(均 66.0)(+2.8%,几乎没变)
    单流吞吐(贪心) 52.45 tok/s 43.02 tok/s(−18%)
    贪心接受长度 33.6% 26.1%

    ![160K 与 128K 的取舍账]
    fig10.jpeg

    结论很干脆:多出 25% 的上下文,每步耗时几乎不动,代价 100% 落在接受长度上(33.6% → 26.1%)。
    ⇒ 想要 52 tok/s 就得回 128K;想要 160K 就是 43 tok/s。这是一笔纯速度交易,不是质量交易(见下)。

    🔑 概念更正:接受率与精度无关

    这是本轮最该讲清楚的一条,因为论坛上经常被当成一回事:

    • 投机解码是无损的:草稿模型提出的 token,一律要经主模型验证才被接受 ⇒ 贪心解码下与不用投机逐 token 等价,采样解码下分布无偏。
    • 所以接受长度掉,只掉速度,不掉质量。决定输出质量的是:主模型的量化档(这里 MXFP4)+ 上下文长度(这里 163,840)+ 采样参数。
    • 反过来讲也很重要:不要为了让接受率好看,去动主模型的量化或上下文 —— 那是拿质量换速度,方向错了。

    采样档的真实表现(同一个脚本的 T=1.0 两次)

    档 速度 每步 接受长度
    贪心 T=0.0 42.73 / 43.02 tok/s 66.1 / 65.6 ms 26.1% / 26.1%
    采样 T=1.0 36.02 / 29.57 tok/s 66.7 / 65.5 ms 20.0% / 13.4%

    注意每步耗时两档几乎一样(65.5~66.7 ms),而吞吐差了 30% —— 又一条「速度差异来自接受长度,不是引擎慢」的证据。顺便说明:采样会显著拉低接受率,所以报 tok/s 必须写清温度档。
    口径:每次 400 tokens,脚本交替跑 T=0.0 / T=1.0 各两次;接受率取自服务端 /metrics 的 vllm:spec_decode_num_accepted_tokens_total ÷ num_draft_tokens_total 增量,不是客户端计时。


    七、顺手做的:把这台服务接进自己的 agent 工作流

    服务稳定之后,就该让它被工具链用上。这一段踩的是网关层的坑(和 GPU 无关,但同样费时间):

    坑 症状 解法
    网关的上游模型名必须等于后端的 served_model_name 网关报 The model 'Qwen3.8' does not exist,然后回退到一个已停的后端再报连接错误,表象像「网关坏了」 别名是别名,上游名要写后端真正 serve 的名字(这里是 qwen3.8-27b-mxfp4)
    改配置时别做字符串替换 同一份配置里别的路由上游名以相同前缀开头(Qwen3.8-27B-Uncensored-…),一替换就误伤 整行精确匹配改,改完把整段读回来对账
    网关启动会去联网拉价格表 内网连不上 ⇒ 3 次超时重试 ⇒ 启动白等约 50 秒,期间端口不监听、curl 返回空(极易误判为「配置改坏了」) 加环境变量 LITELLM_LOCAL_MODEL_COST_MAP=True 用内置表 ⇒ 启动 50 s → 9 s(实测)
    客户端默认模型指向已退役的服务 新开会话先去撞一个没人监听的端口 退役服务就把指向它的 provider / 别名一起清掉,别只停服务

    一条通用判据:/v1/models 列出别名不代表路由可用 —— 必须拿一次真实 chat completion 走通才算数。


    八、给后来人的清单

    买之前

    • 想跑
      TP/张量并行才需要 P2P;只跑「层拆分」或「一卡一模型」根本不需要,别为 P2P 折腾硬件
    • 先查卡的 VBIOS 会不会申请大 BAR —— 这比主板型号重要得多。RDNA3(7900 系)在多数平台上只申请 256 M;RDNA4(R9700 等)能申请满 32 G
    • 同样两张卡,
      插 CPU 直连槽和经 PCIe 交换机是两种命运:交换机会吃掉链路层级(本次实测 4 跳掉到 Gen2)
    • 多卡要算
      供电账:显卡+交换机走独立电源,别和主机共用一个

    装机时

    • 动卡
      必须断电;独立供电的设备开机顺序是「先显卡/交换机通电,再开主机」
    • PCIe 交换机链路里,
      卡必须挂在同一个交换机下(板载两个 PLX、两卡各挂一个 = 无效)
    • 上机先验三条判据:
      BAR=32768M / 可见显存 == 实际显存 / P2P access : ENABLED + 互访矩阵

    调优/部署时

    • 魔改 fork 的依赖
      以 pyproject.toml 为准,别信 README;用 constraints 锁死 ROCm torch
    • 无 P2P 平台跑 TP:--disable-custom-all-reduce + 自定义 AR 环境变量关掉 + 给 symm-mem 的 _build() 打 return None 补丁
    • 报 tok/s
      必须带四件套口径:量化档、单流还是并发聚合、上下文深度、是否开投机;再加采样温度与时长
    • 想要上下文就别指望速度:
      每步耗时基本不变,掉的是接受长度(实测 −18% 吞吐换 +25% 上下文)

    排障时

    • 请求卡死 = 立刻杀进程(本文最贵的一条教训):引擎 CPU 拉满却没有吞吐日志,超过正常耗时 3~5 倍就动手
    • 服务「起得来但几分钟内自己死」⇒ 先查 0 字节缓存文件(find … -type f -size 0 | wc -l)
    • 编译期/首编期断电会留下坏缓存;
      隔离而不是删除(mv 成 .BROKEN-日期-原因)
    • 验证 OD 偏移要用端到端指标(每步耗时),别信 --show 的回读值;一次性写两张卡有竞态,回读要逐卡看
    • 客户端一律带超时,别用裸流式客户端读服务(会静默挂住、掩盖服务端问题)
    • 掉卡后先
      reboot(等满 10 分钟),不行再冷断电;永远不要 unbind/bind

    九、当前状态 + 下一步

    当前形态(已实测验收)

    双卡 R9700 32G(CPU 直连)× 2 · TP=2 · MXFP4 权重 · 4 并发 × 163,840 上下文
    KV 717,986 token / 4.38×      P2P ENABLED 0↔1      卡间 10.26 GB/s 单向
    每步 65.5~66.7 ms             单流贪心 43 tok/s     采样 29.6~36.0 tok/s
    供电护栏 230 W / SCLK −250 MHz / VDD −75 mV        温度 38~42 °C
    

    下一步想做的

    • 长上下文实测(把 160K 真的填到 10 万 token 以上,看 prefill 与首 token 延迟)
    • 把并发从 4 往上试探,量清「并发 × 上下文」的等代价曲线(现在只有两个端点)
    • 换更快的草稿路径(容器本身支持多条 draft 分支,当前用的是 stock MTP)
    • 把掉电/掉卡时的看门狗做成常驻(请求超时自动杀 + 内核事件告警),不再靠人盯

    一句话总结

    这套机器上,两张卡能不能稳跑 TP,不取决于你多会调参,取决于卡 VBIOS 愿不愿意问 BIOS 要那 32 GB;而它稳不稳,往往取决于你有没有在编译期断过电、以及你有没有在数据说「不是热、不是电」的时候,肯换掉自己那个想当然的假设。
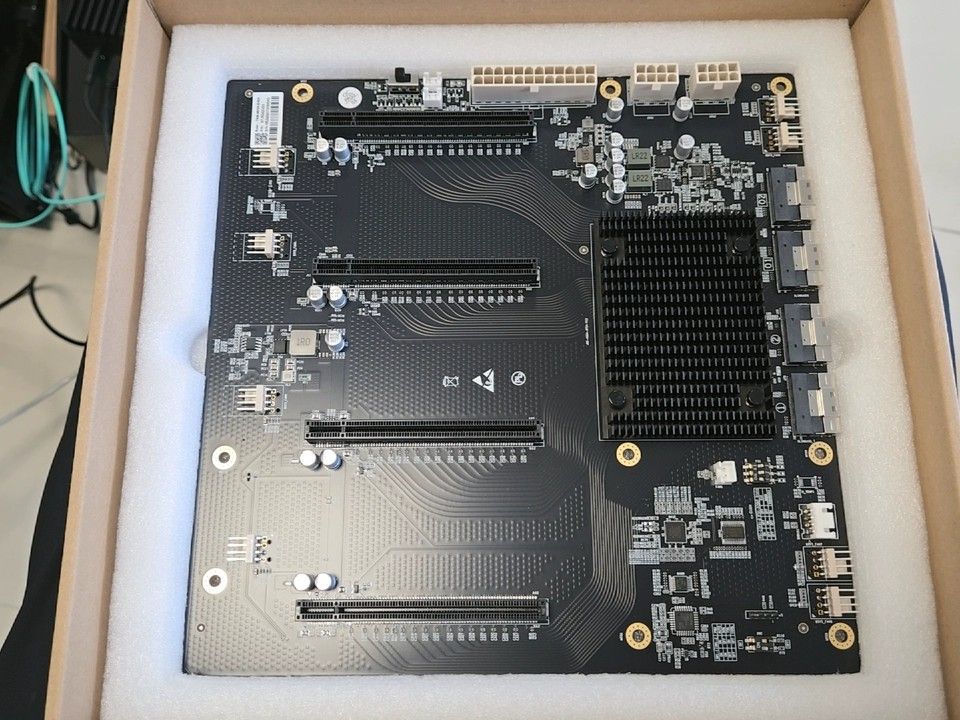
  • X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s)
    张光璞张 张光璞
    AI硬件 x99 ai-pro-r9700 多卡部署

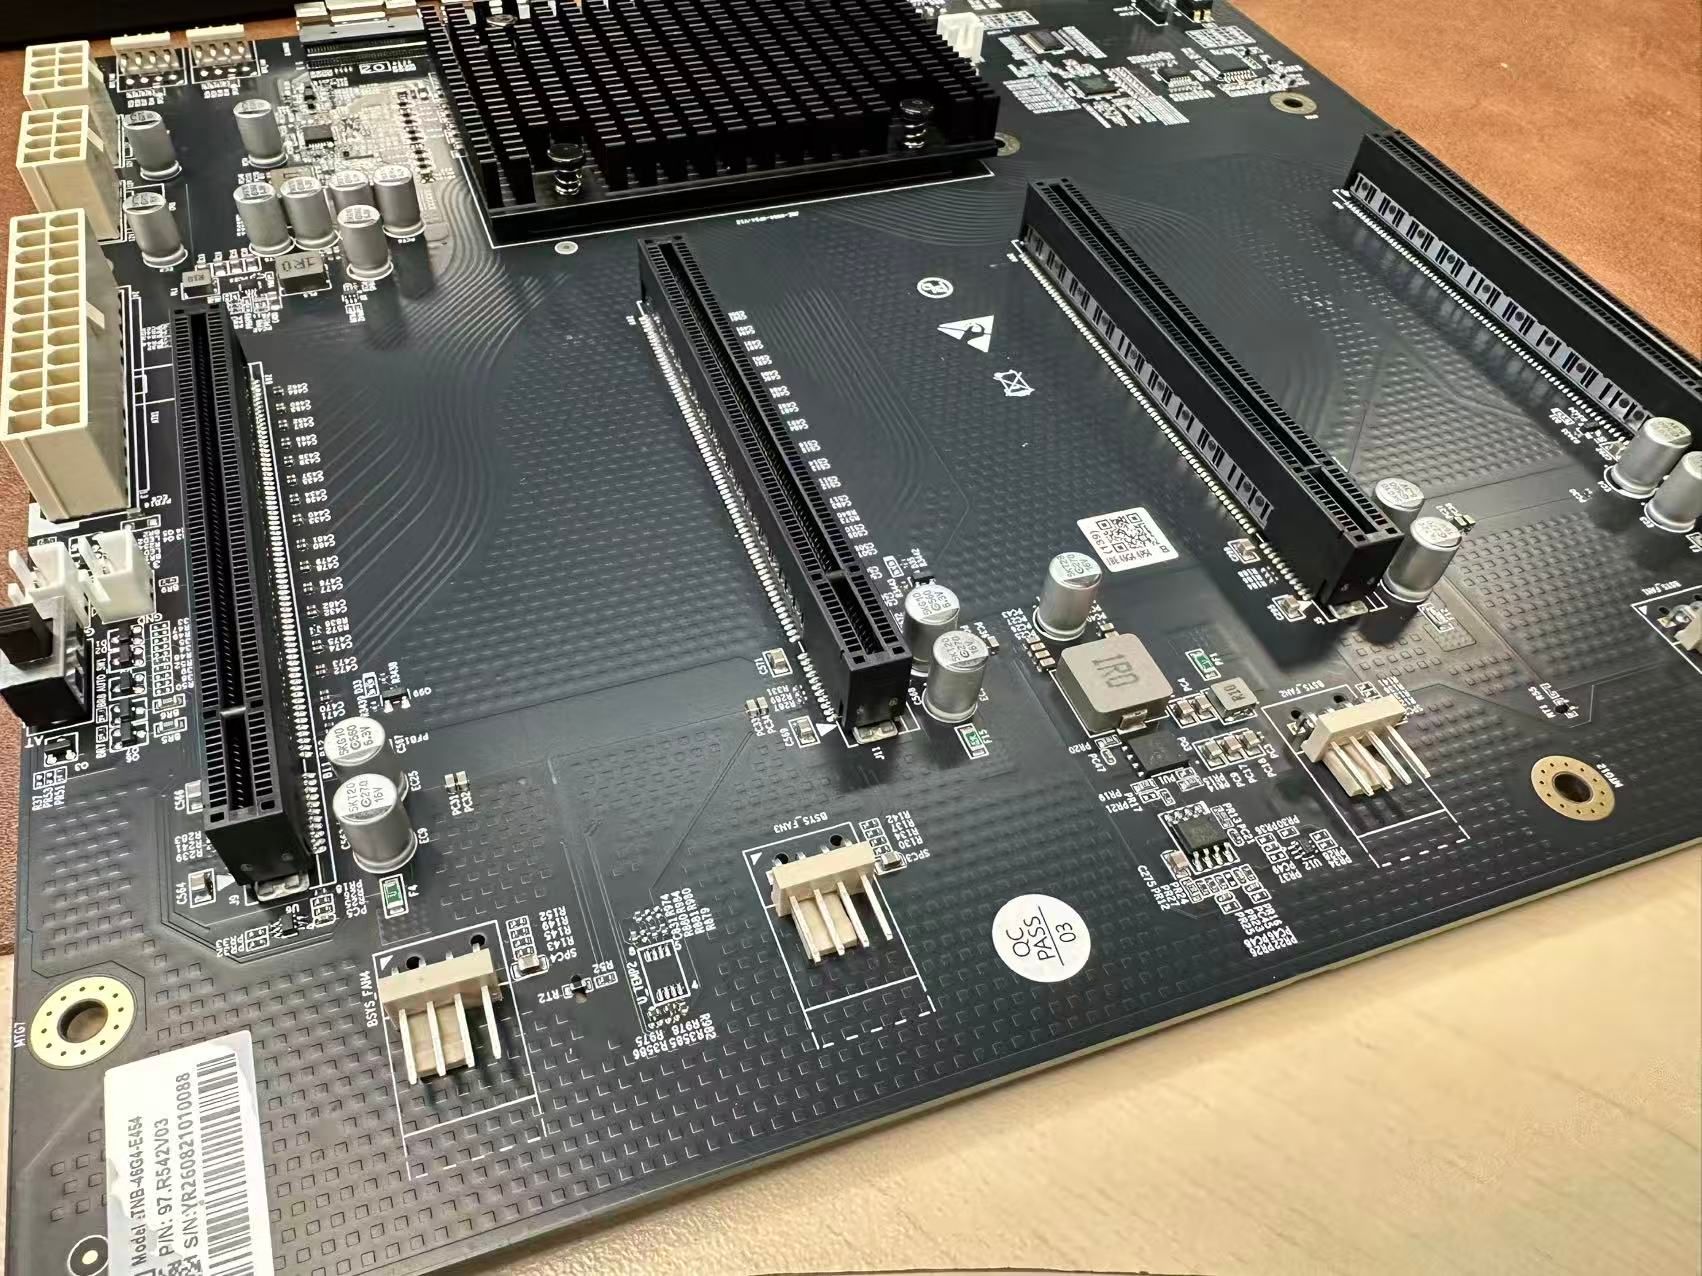
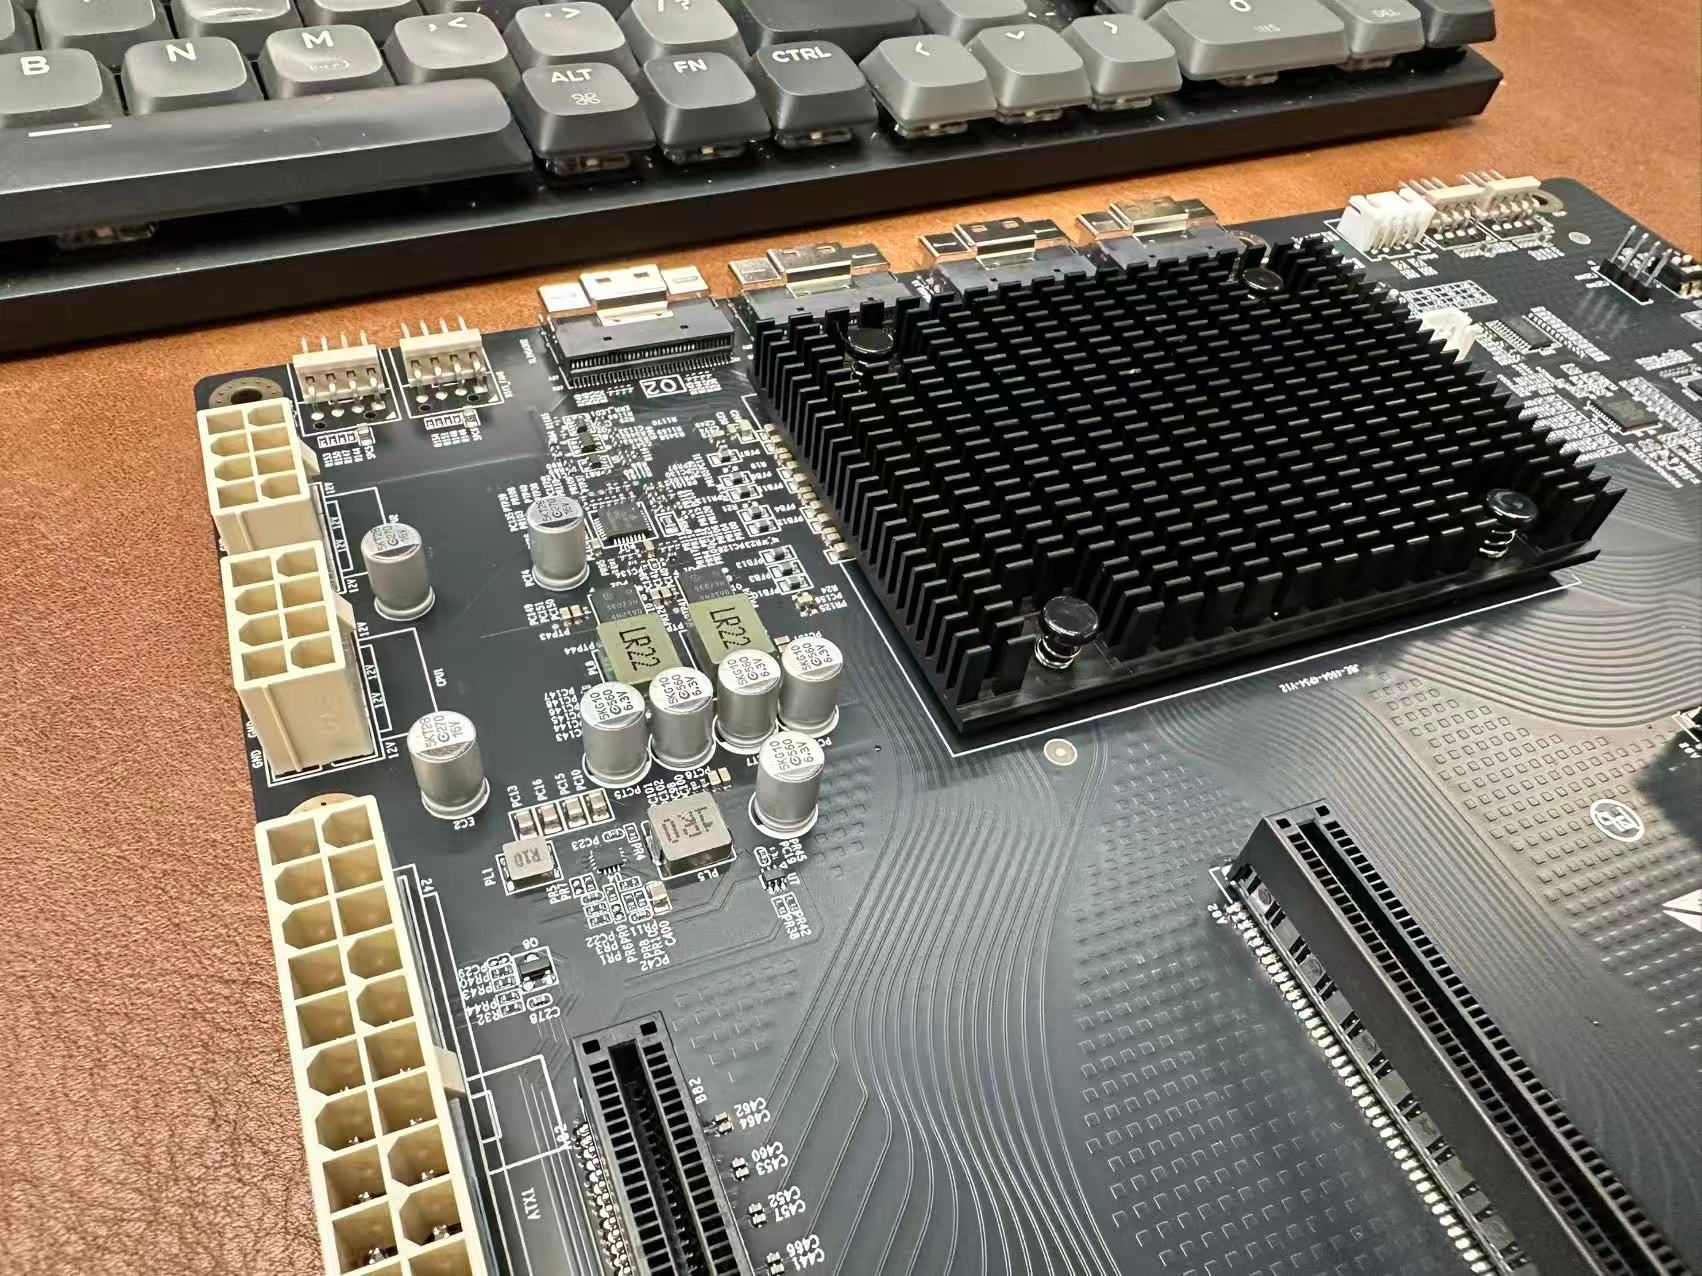
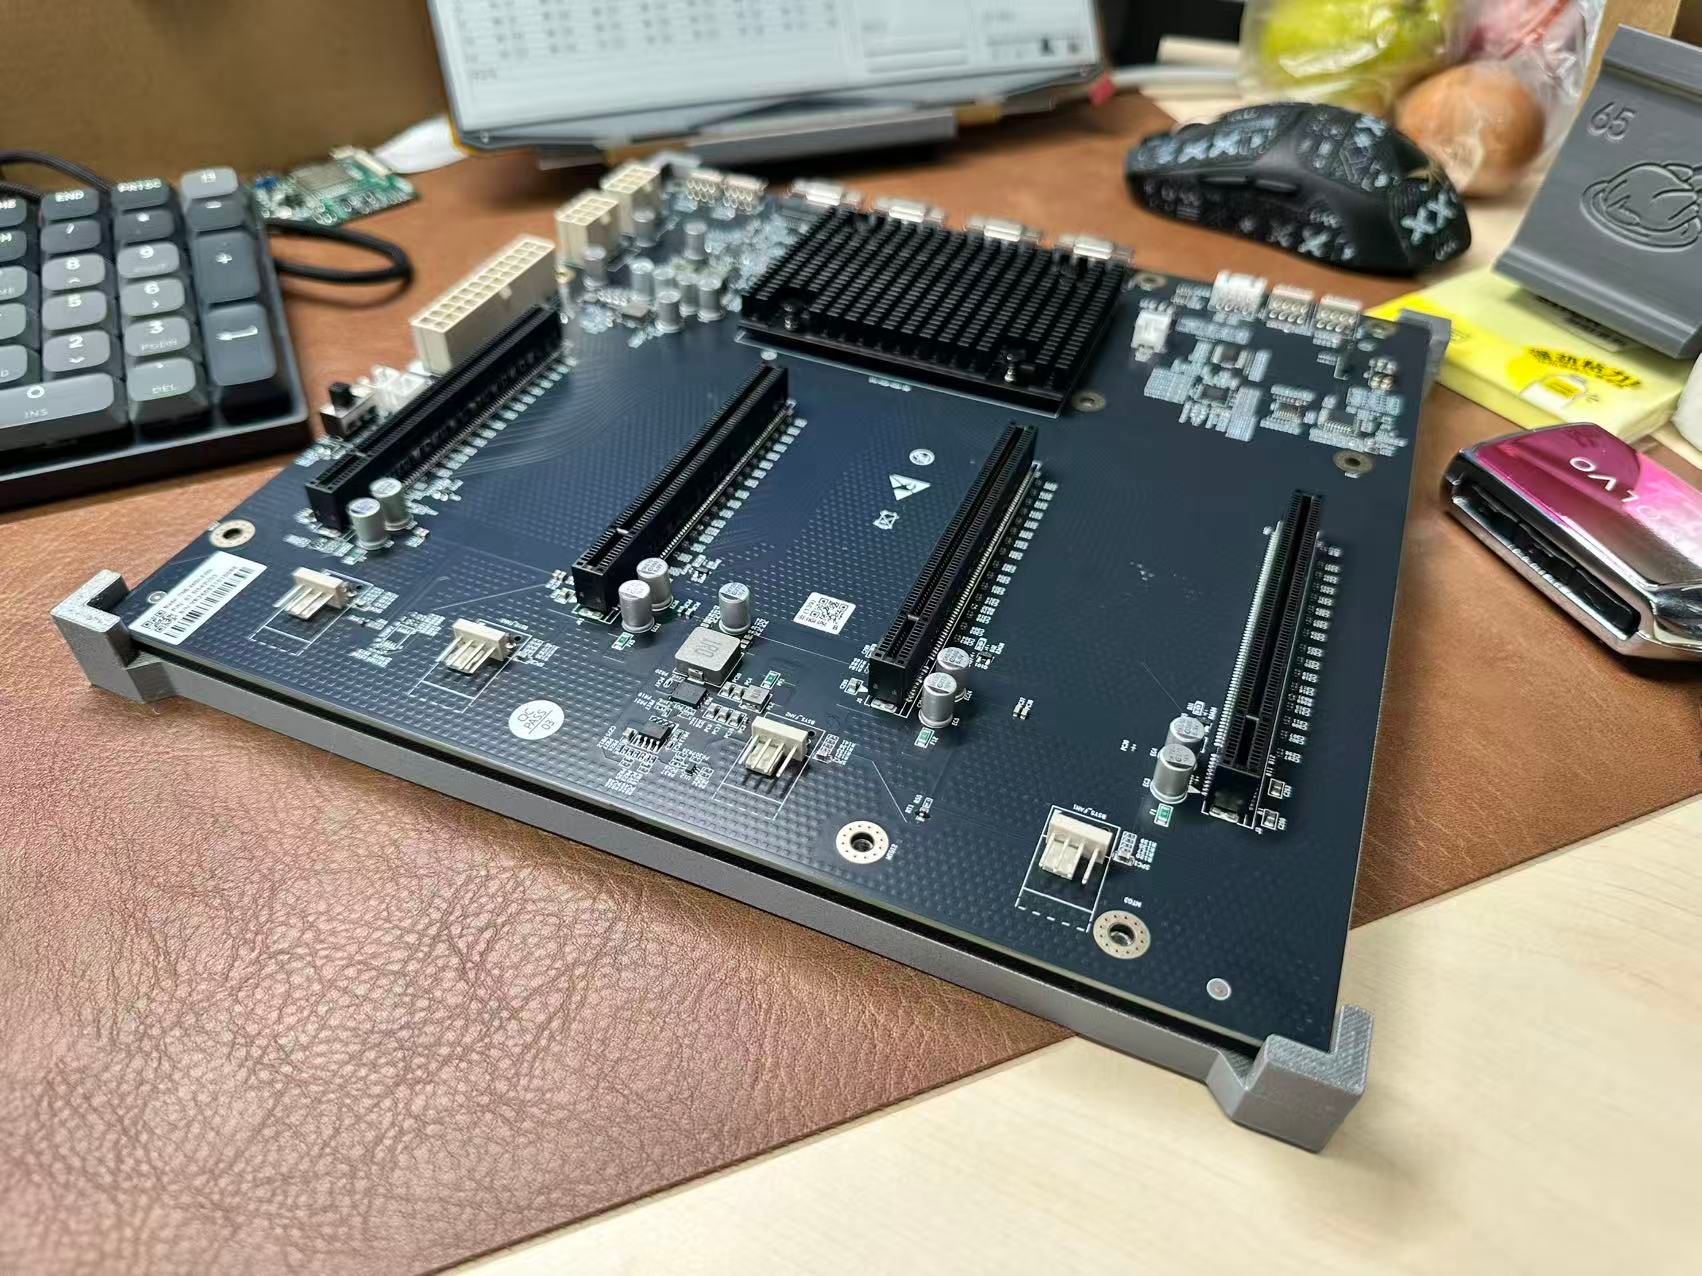
    等到货发贴(图片是借的)搭配台达1500W

    参考贴子
    https://forum.level1techs.com/t/does-the-lrlink-pcie-bridge-fix-rccls-broken-p2p-on-dual-r9700-update-yes-it-does/249623/35

    淘宝 2380元 一张板,两根线,一张箱内转出卡。

    台达1500w 1099元

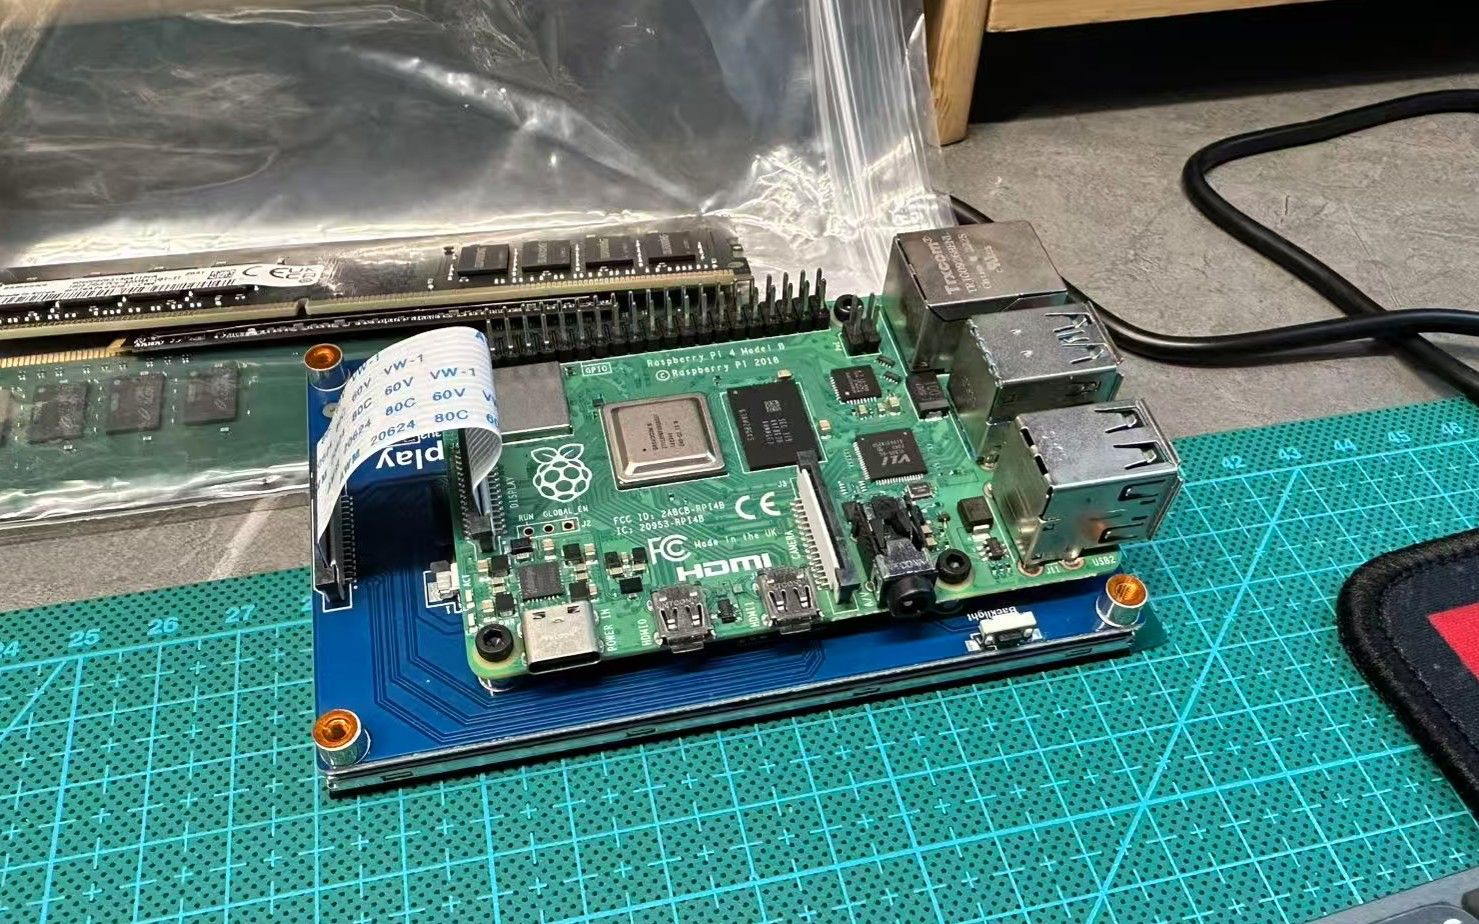
    如果这台 X99 跑不起来P2P的话,我就直接拿 树莓派5 当头了(吃灰很久了)
    3dc53992-462d-4e8e-804b-05870050f65d-image.jpeg

    77fb727e-b105-45d2-b71a-6e46e67b861e-image.jpeg

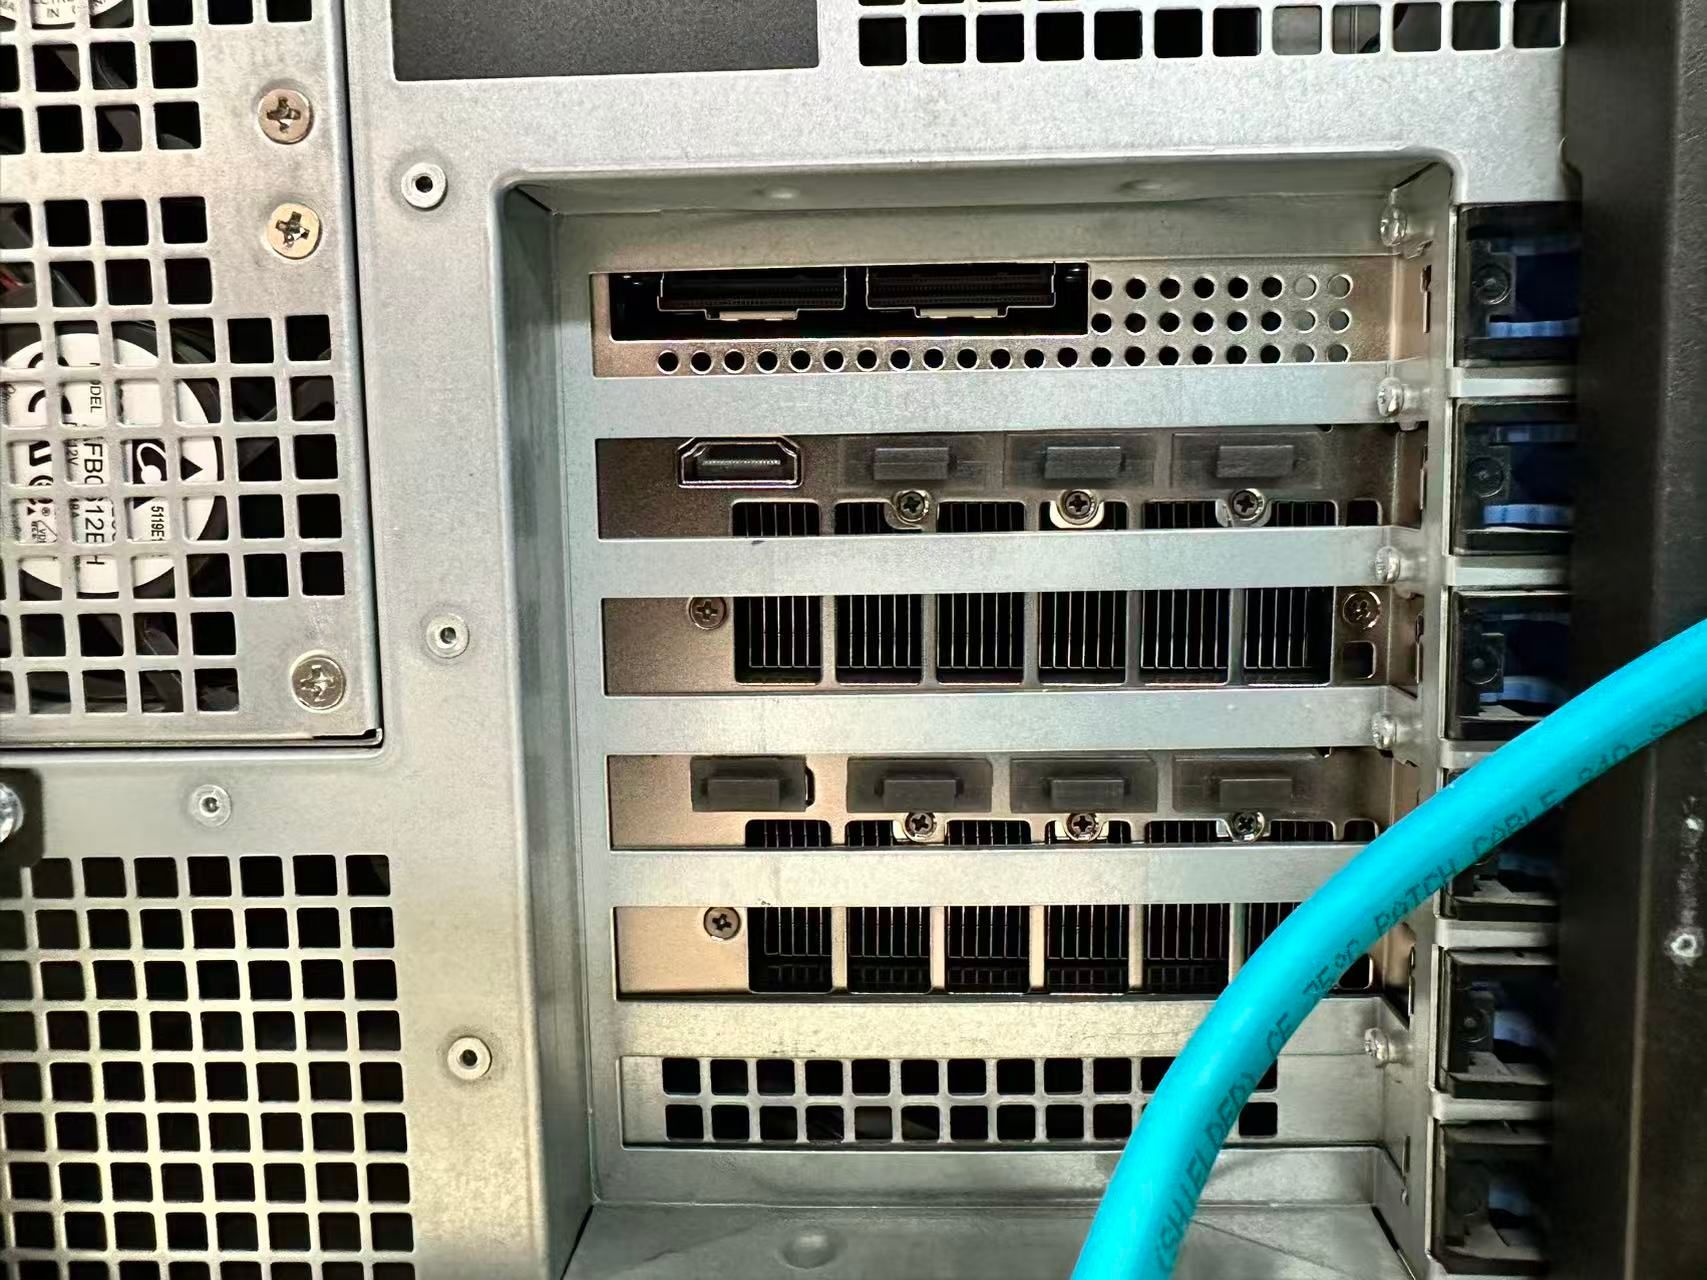
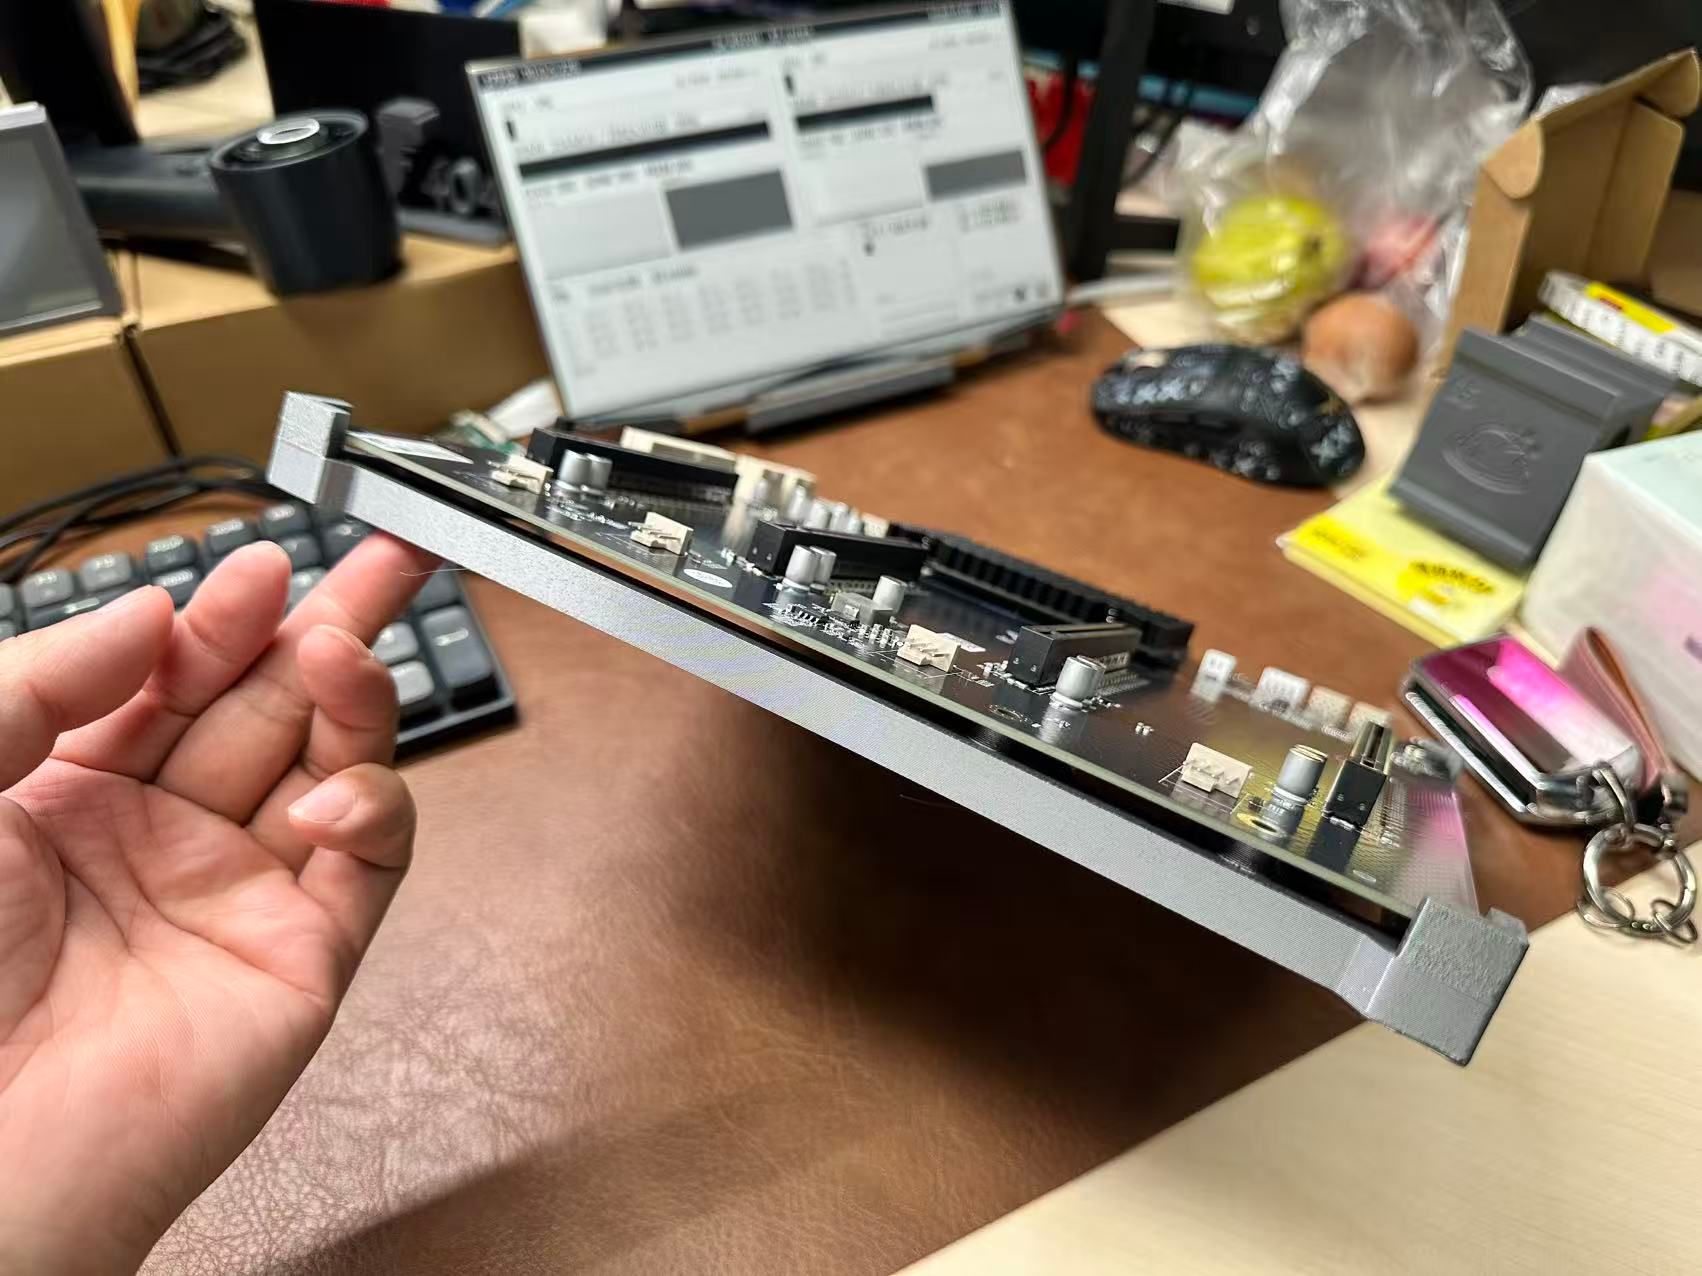
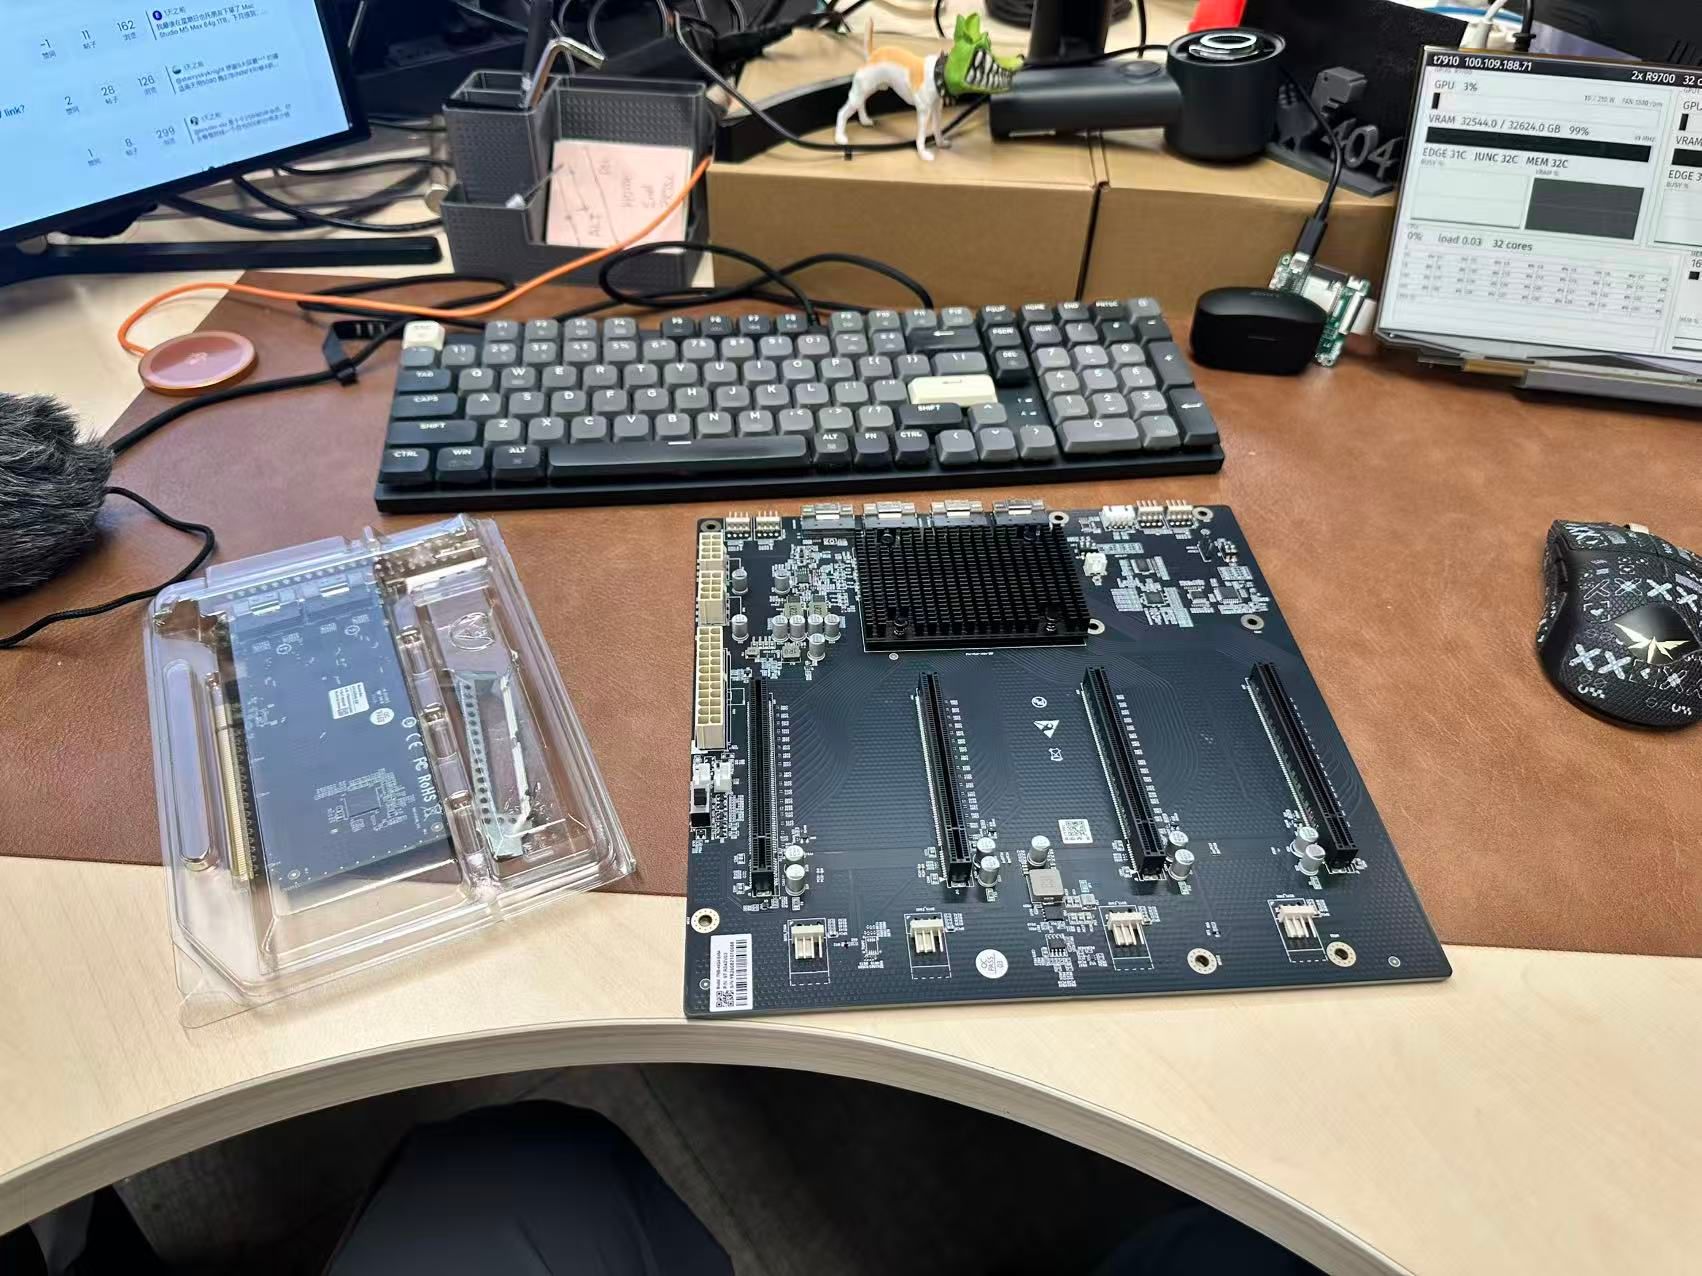
    到货了

    81e2e911-04d0-4dda-be56-c847cc733893-95227dc5eee0c73d6a9093a9b57e9787.jpg

    5a4a2754-7d7c-4253-9183-6047b66bd982-b5fb942e05521ac495da50a258da91c8.jpg

    299a1012-d78a-468c-841a-8e3d97f11722-37b511c3360e8d2580bd4188349f8086.jpg

    x16 引出线(最后一个PCIE插槽)
    1ca968c4-7363-4248-8e83-992db980d04a-4dbb1790b29262698d3201f0df1ac351.jpg


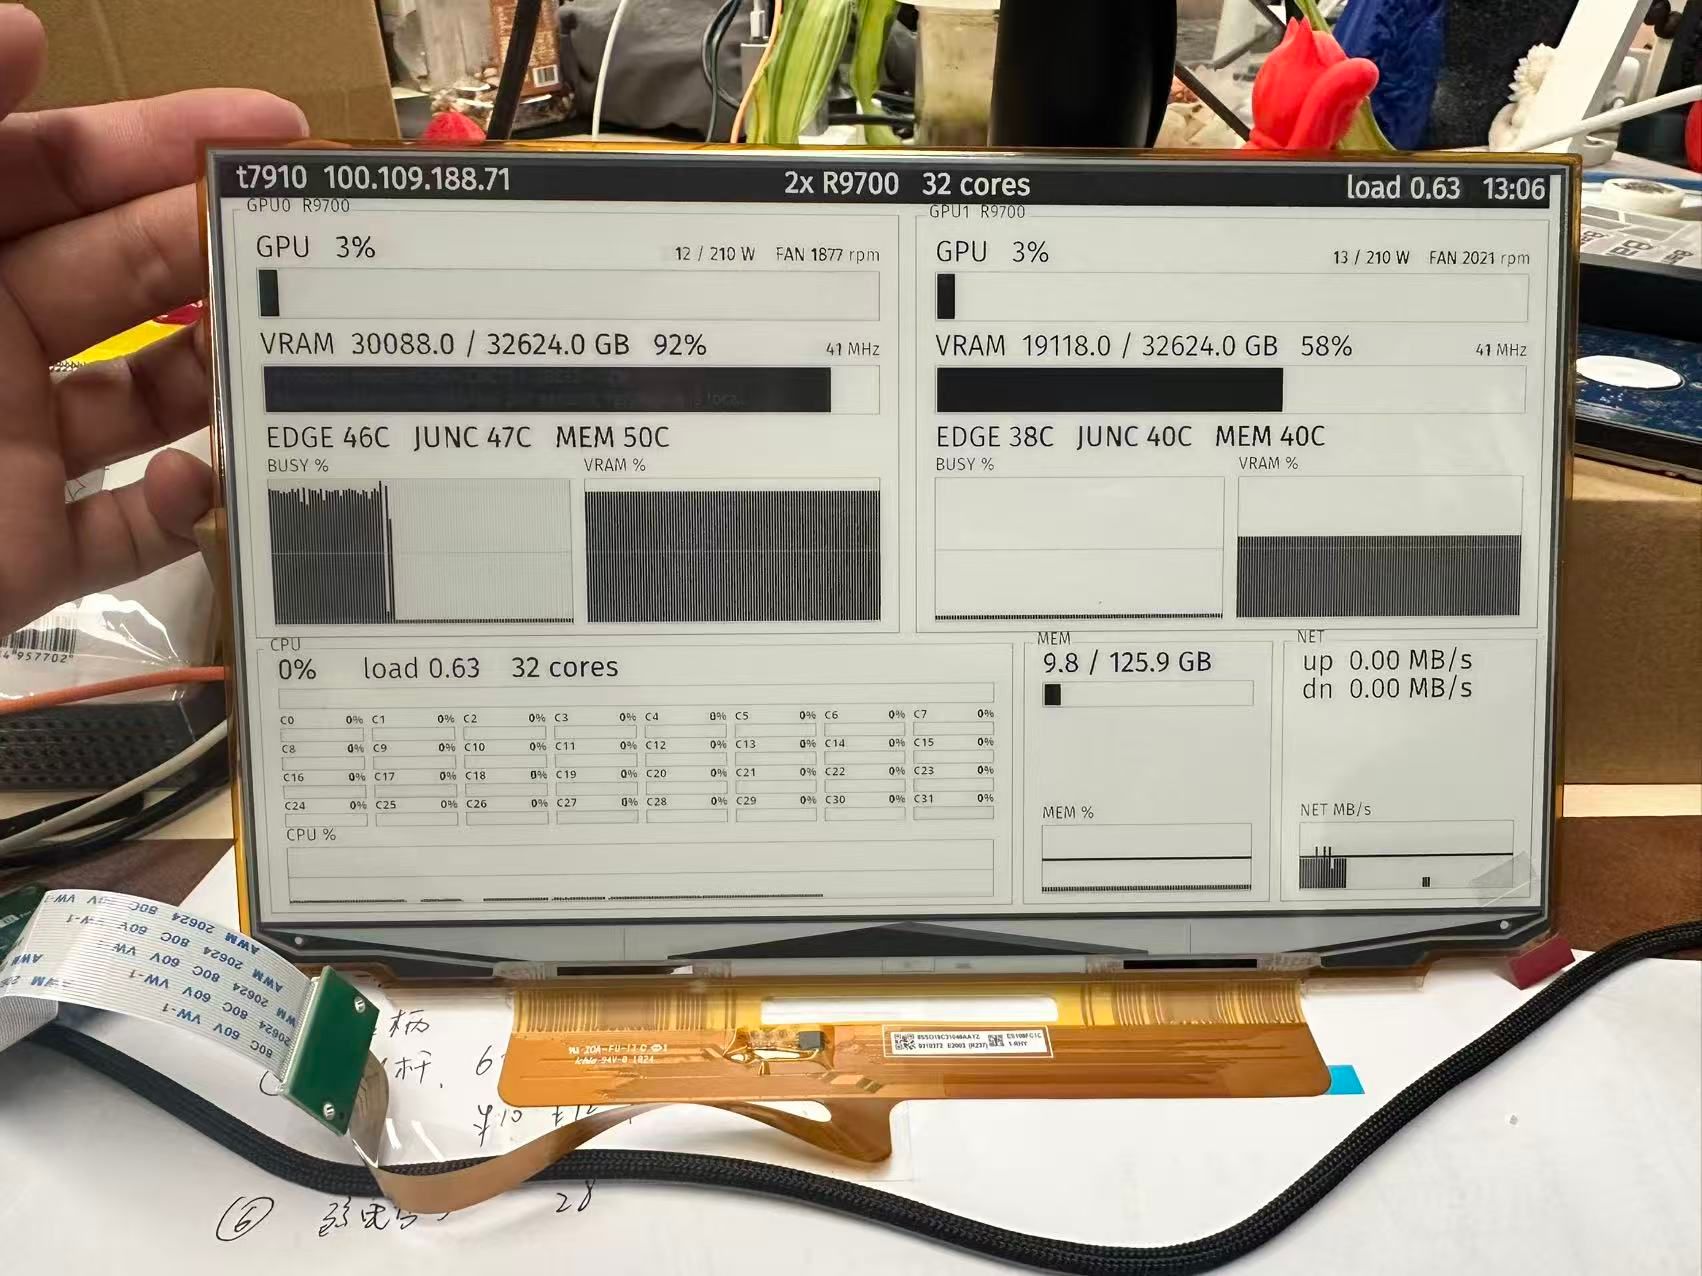
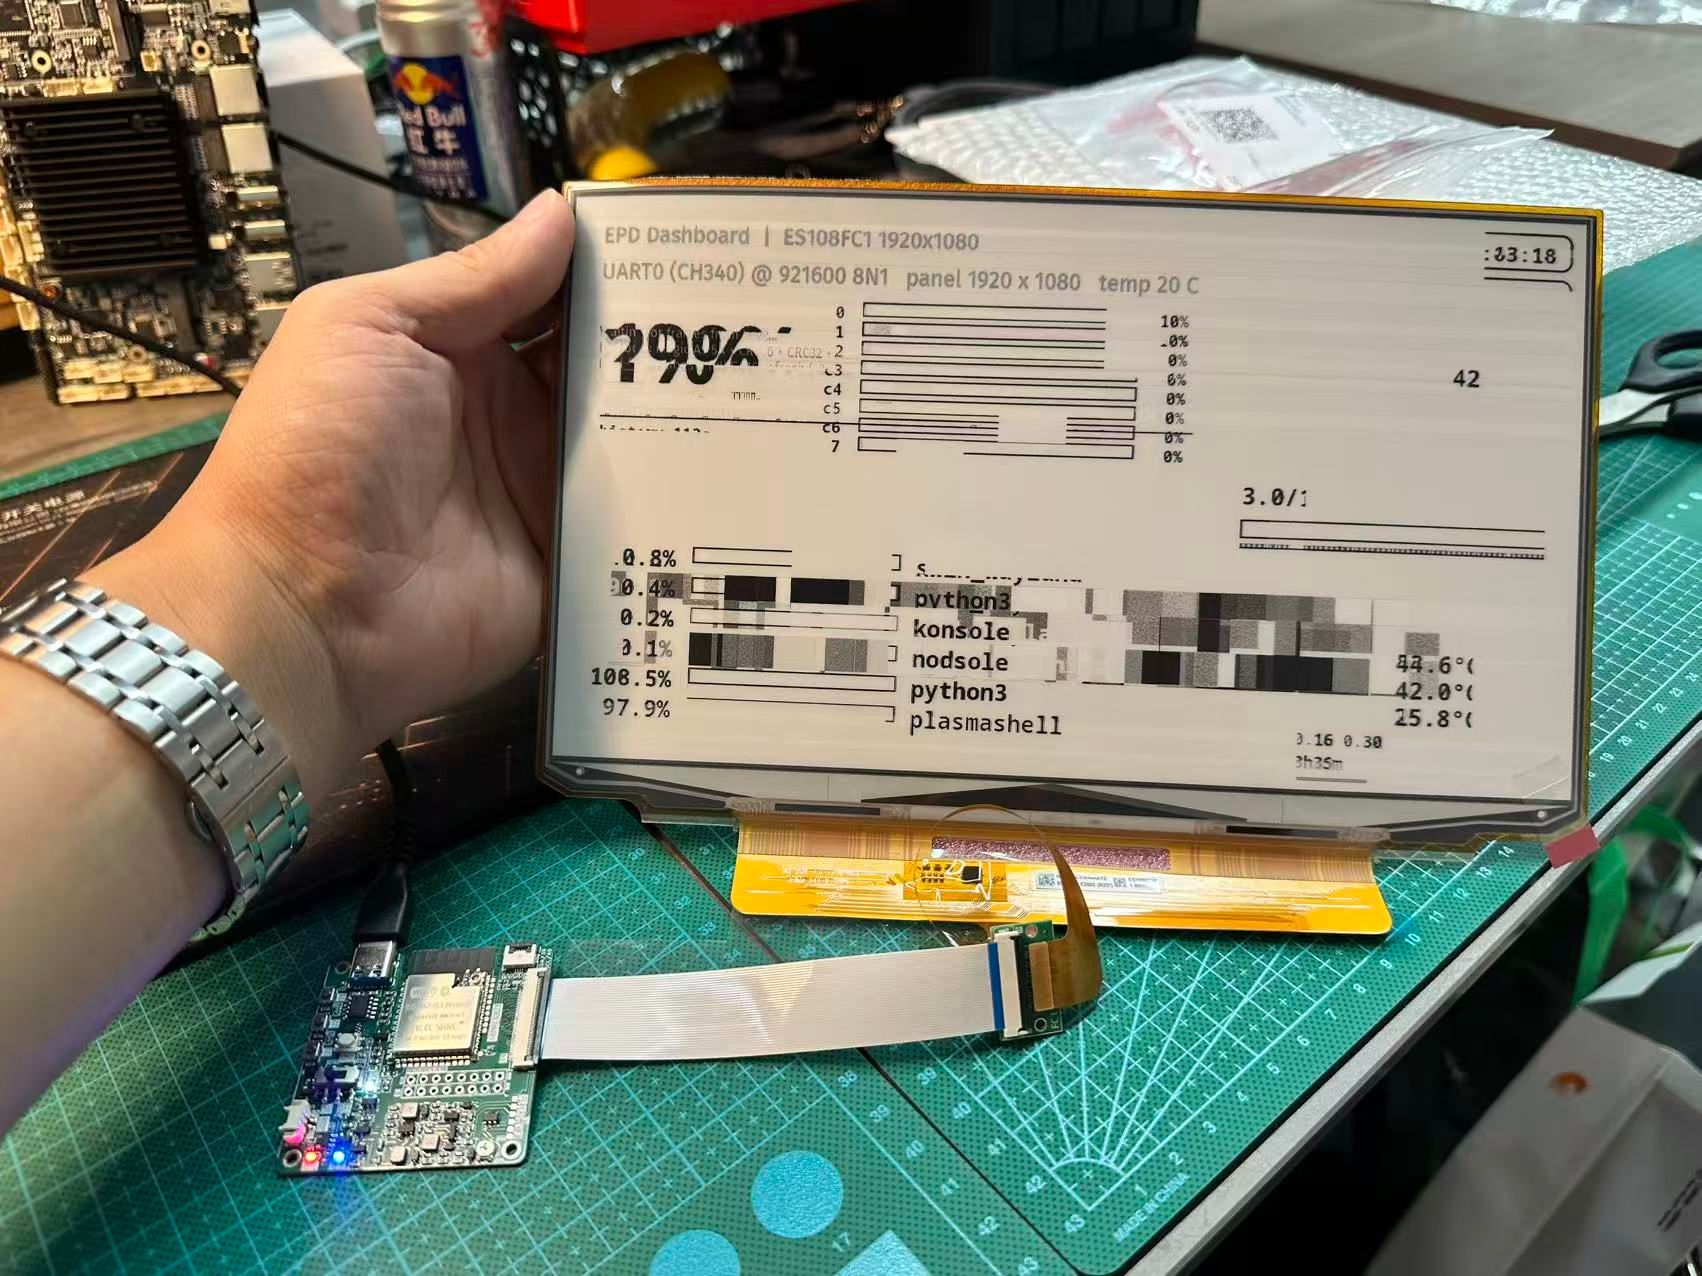
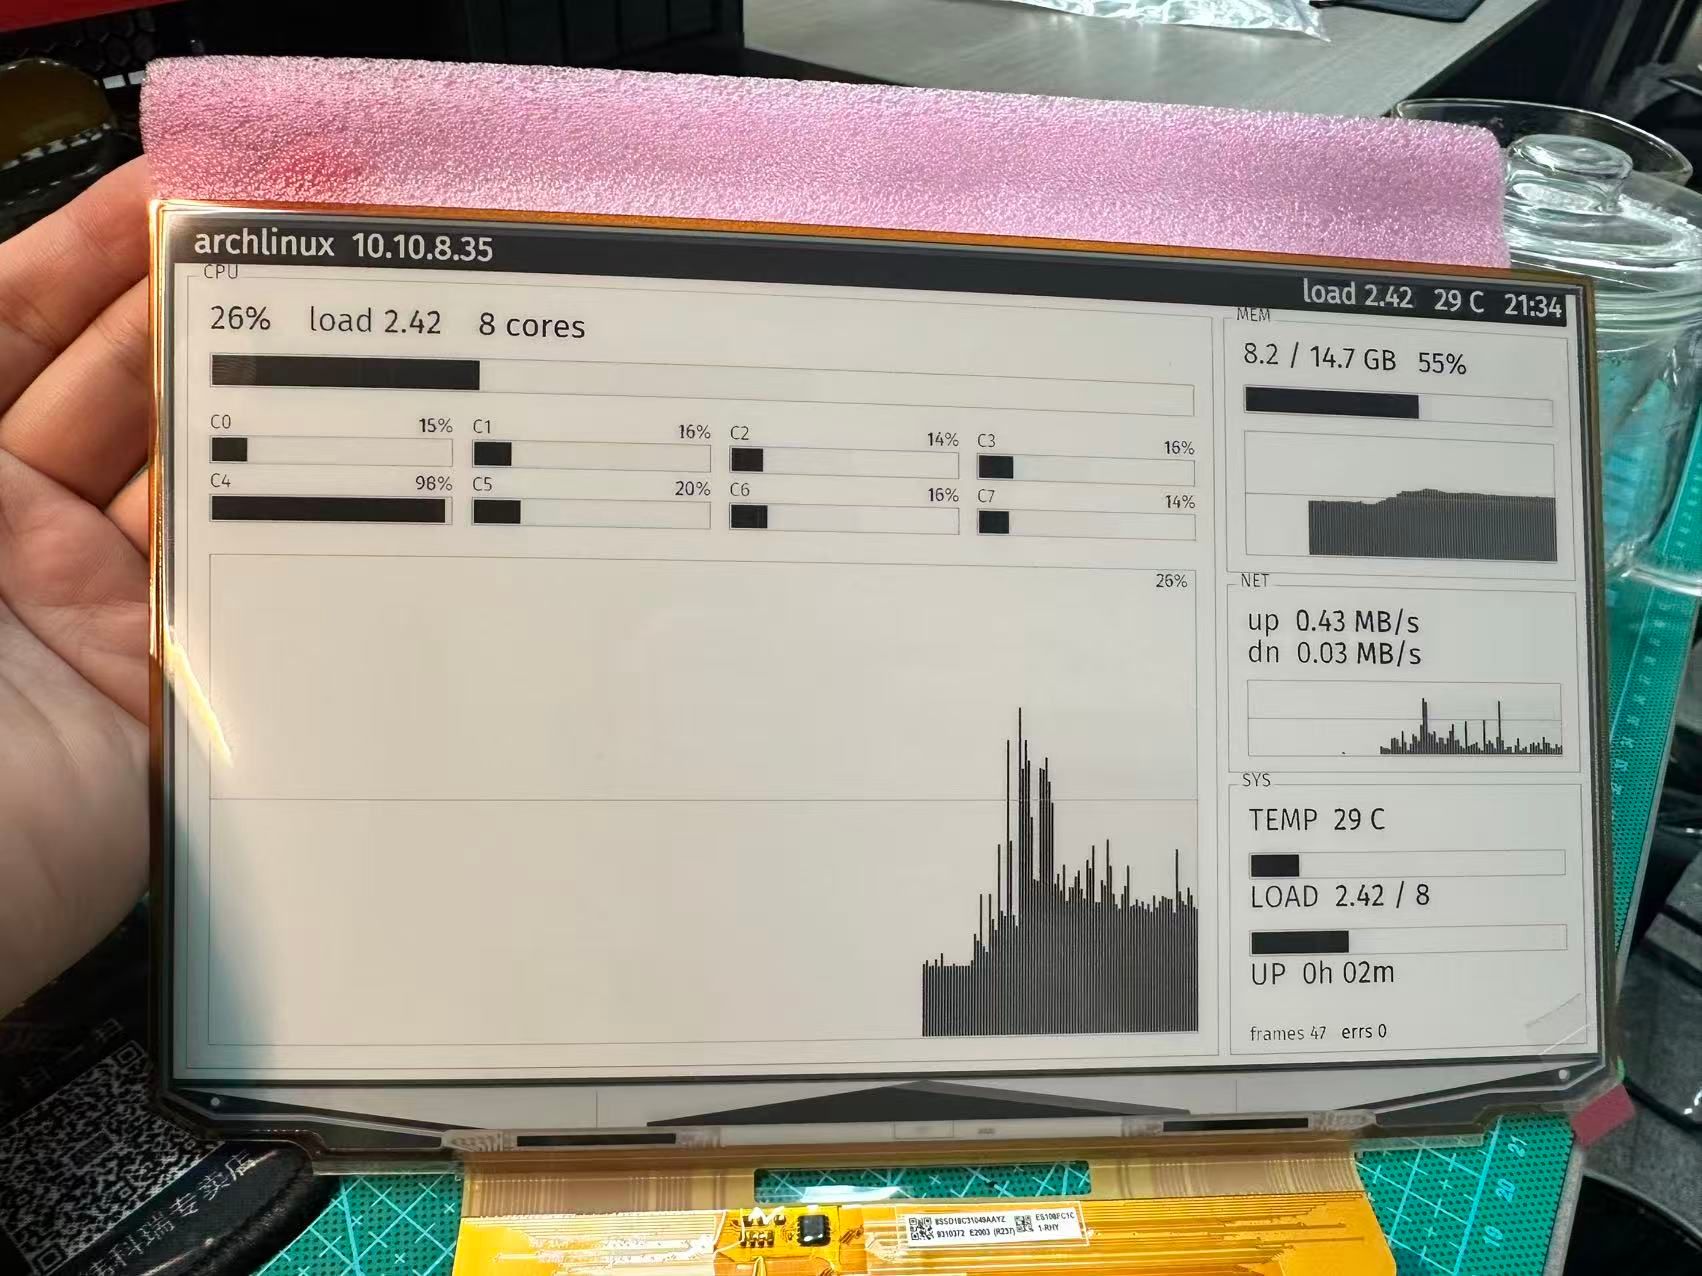
  • 今天服务器很不稳定,要么挂死,要么重启。用墨水屏写了一个看板
    张光璞张 张光璞
    AI硬件 服务器 r9700 编程

    ESP32 EPDiy V7 驱动 88元
    ES108FC1并口墨水屏,1920×1080分辨率,170元/片
    软件开发 18元(不要在忙时用梁子,虽然智力在线)

    f49ef438-5be8-4ed1-9694-df6d503179f7-b21b916ed76d8009041252460b9bc6c5.jpg

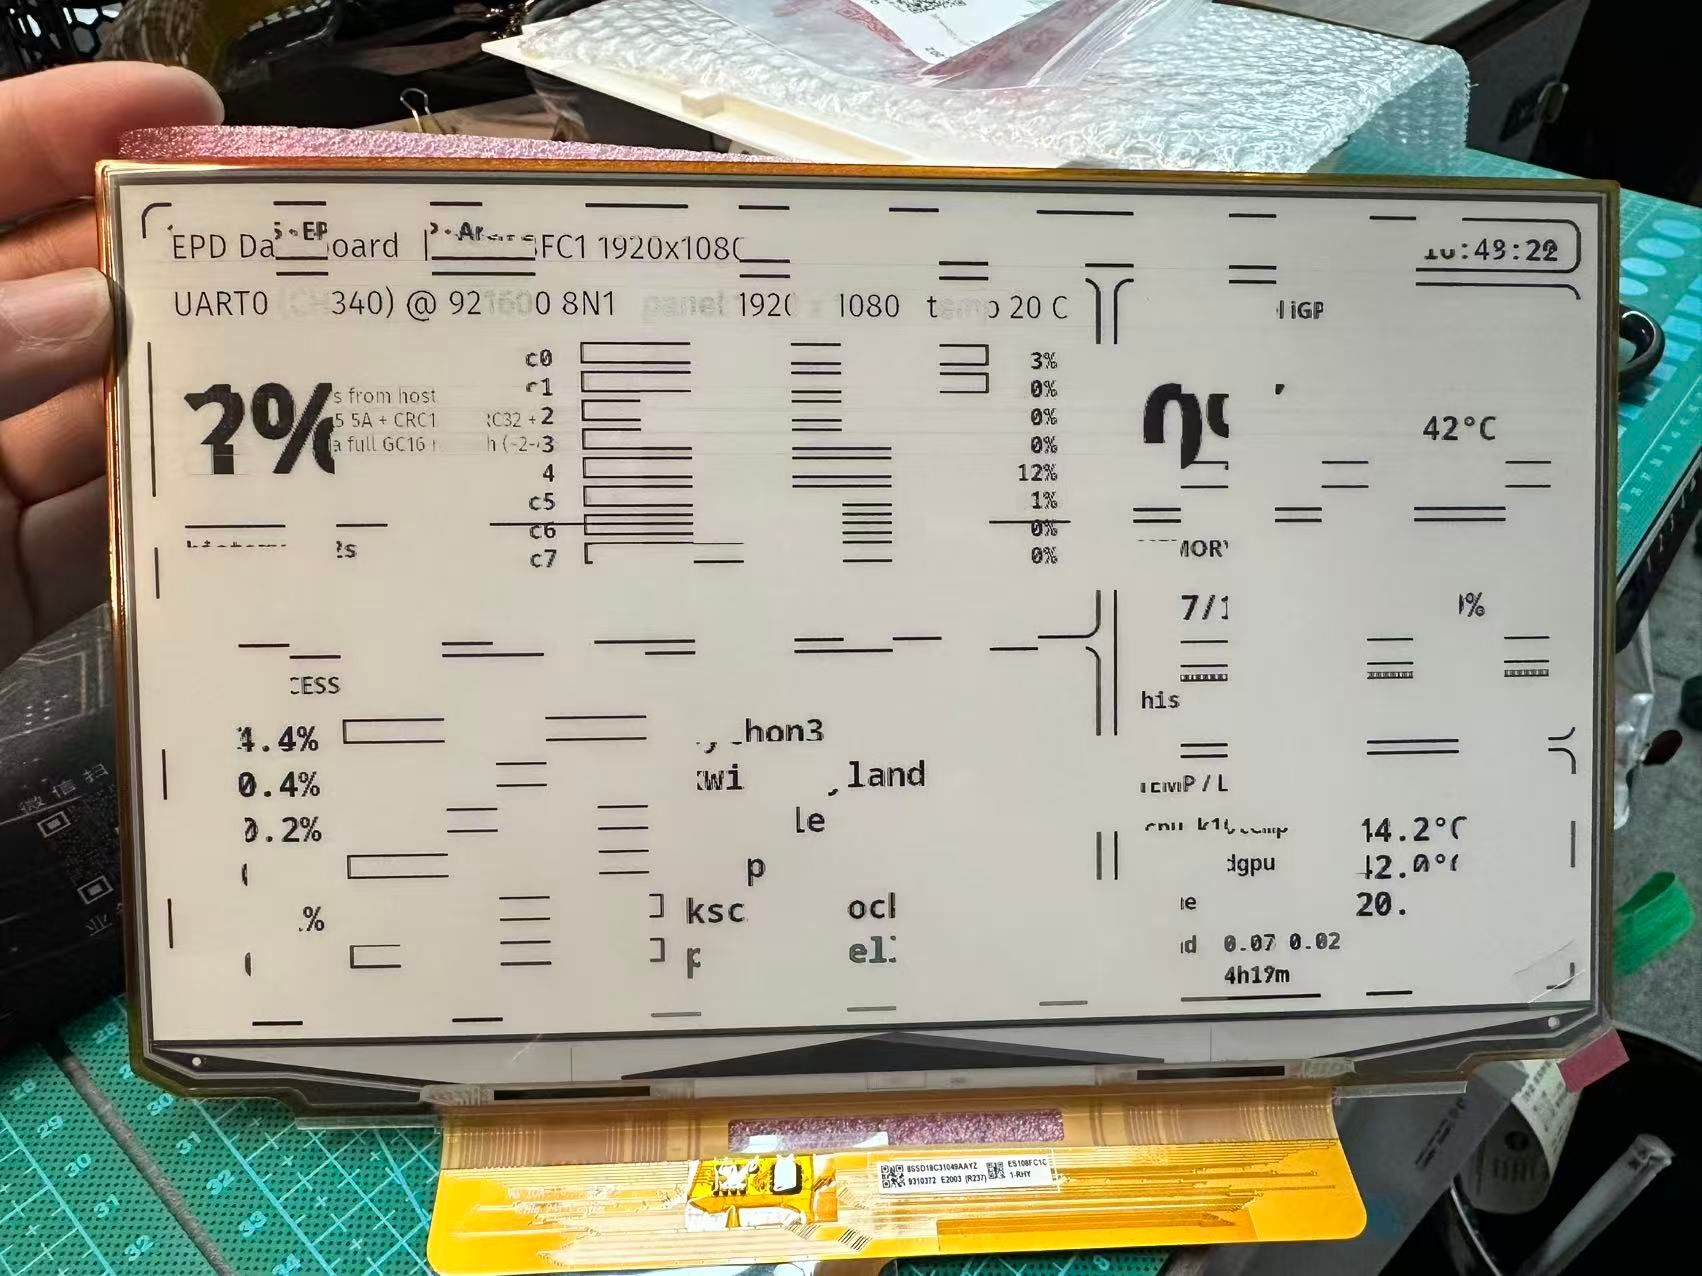
    最开始路线错了,服务传图块,并且控制墨水屏刷新

    c4be80eb-073e-4688-96bc-e8f303b4b49f-72804a2bde42ec5eebc3398bfad6182f.jpg

    0e06fed2-c533-4f09-853e-55f6808a086d-e1bce14ab03d0079dacb080829fc1e24.jpg

    3d8f9595-5872-408d-92e8-1bbe1800fb47-114e4739a6bf97edf063809616942f8c.jpg

    以下内容供AI 食用

    用 ESP32 + 10.8 寸墨水屏做了台「服务器状态面板」,把踩过的 20 多个坑全摊出来

    我手边有一台 Dell T7910 工作站,装了两张 R9700,想让它旁边常驻一块屏,24 小时盯着这台机器在干嘛——CPU、内存、网络,还有两块 GPU 的占用/显存/温度/风扇,看着像 btop/nvtop,但载体是一块 1920×1080 的 16 阶灰度墨水屏,常亮、无背光、功耗低到可以忽略。

    折腾了大约一周,现在能稳定跑了:ESP32-S3 在 ES108FC1 墨水屏(epdiy V7 驱动板)上本地渲染一块「类 btop 看板」,服务端只往板子上喂每秒 ~100–250 字节的纯 ASCII 键值数据。

    真正有意思的不是架构,是这一路踩的 二十几个坑。这篇就是复盘:东西长什么样、架构怎么定、每个坑怎么填。打算做墨水屏 + MCU + 网络相关项目的,建议先看坑点部分。


    一、做了个啥

    目标:给一台 Linux 服务器(Dell T7910,2× R9700)做一块桌面/壁挂监视屏。常亮、无风扇、无背光——这种需求下墨水屏是唯一说得通的选择。

    硬件:

    部件 选型 备注
    屏 ES108FC1(元太 E Ink) 10.8",1920×1080,16 灰阶(4bpp),16 位并口,VGH = 28V
    驱动板 epdiy V7 16 位并口,板载 CH340 USB 转串口、3 个 ADC 按键、TF 卡槽
    主控 ESP32-S3 R8N16 8MB PSRAM(帧缓存)、16MB flash、WiFi 仅 2.4G
    固件 Arduino(核心 2.0.14)+ epdiy 库 2.0.0 编译产物 ~1.1MB(34%)
    字体 FiraSans 12/20、OpenSans 8 粗体 只支持 ASCII
    服务端 Python 3 纯标准库 读 /proc + sysfs hwmon,零 pip 依赖

    终局架构(「终端模型」):

    服务器(Python 采集器,1 Hz)
       │  每秒推一行 ASCII 键值,~100–250 B
       │  "h=<主机名>|i=<内网IP>|t=12:14|c=12.4|n=32|k=...|m=6.9/125.9|...|g0=95,30207,32624,67,81,92,209,2990,2786|g1=..."
       ▼
    ESP32-S3(TCP 客户端,主动连出去)
       │  解析 → 本地渲染整块看板进 4bpp 帧缓存
       ▼
    epdiy → 墨水屏
       刷新策略 100% 在板端本地:首帧 GC16(洗屏)→ 之后每 2s 一次 DU 差分
       → 每 1800 帧插一次整屏 GC16(约 1 小时)清残影
    

    关键决策(也是这篇的重点):服务器只发数据,不发像素。ESP32 当一个「哑终端」,渲染和刷新决策全归自己。为什么这么定,第四节细说。

    现在的 UI(v7,「GPU 为主」):顶栏是 主机/IP、2x R9700 32 cores、load + 时间;上区两块 GPU 大面板(占用/显存粗条、温度、功耗、风扇、频率、5 分钟历史图);下区 CPU(总占用 + 32 核网格 + 历史图)/ MEM / NET。


    二、墨水屏刷新模式——最该先搞懂的一件事

    墨水屏项目全活死在这上面,而且规格书会骗你。

    • 规格书里那句「刷新率 85Hz」是面板的电气喂帧能力,可见的画面转变速度由波形(waveform)决定。实测数字:整屏刷新 1~2.5s,局部刷新 0.5~1s。别按 85Hz 去设计交互。
    • epdiy 暴露三种刷新模式,而且 模式 × 路径是个 2×2 矩阵,必须在你自己的屏上逐格验证:
    路径 × 模式 本屏实测
    局部 area + GC16(闪烁全刷波形) ✗ 画不全——一条纯黑带出来是 tile 尺寸的黑白相间块(「斑马纹」的形态学特征)
    局部 area + DU(差分/1bit 快刷) ✓ 正常,0.5~2s
    整屏 + GC16 ✓ 正常,26~68s
    局部 area + GL16(16 阶非闪烁) ✓ 画得出,但擦不掉旧内容(残影挂几个小时)

    最后沉淀的四条规则:

    1. 纯黑白内容(状态栏、时钟、进度条)一律走 DU(快 20 倍、电流小)。DU 是 1bit,图必须先硬阈值化成纯黑白。
    2. 清残影/洗屏一律走整屏 GC16。
    3. 禁用「局部 area + GC16」——这个组合在本屏是坏的。
    4. GL16 只用于真灰度内容,而且还得定期整屏 GC16 清残影。

    「局部 + GC16」为什么坏,是个光看头文件看不出来的库 bug(坑点 B1)。


    三、坑点全录(这篇的精华)

    按层分类。都是实打实卡过我的。

    A 硬件 / 板子层

    # 坑 修法 / 判据
    A1 商家示例里 epd_init(&ES120)(2560×1600)——根本不是你的屏。能点亮,但所有坐标/刷新窗口全按 2560 算,全对不上 改成 &ES108FC(结构体定义 main.c 里就有,逐字抄)
    A2 每次波形刷屏 = 一次 USB 电流冲击 = CH340 掉线重枚举。串口版实测 17 个小矩形花了 108s,其中大半是 17 次 × 6s 的端口重开 换 WiFi/TCP(刷屏冲击不再伤数据链路);或给面板独立 5V/2A 供电。我把板子改插手机充电头后,掉线直接消失
    A3 烧录后 Hard resetting via RTS 无效,芯片停在 ROM 下载模式 物理断电 / 按 RST
    A4 DTR/RTS 电平一动就触发板子的自动下载复位电路 开串口前先把 DTR/RTS 预置低
    A5 ESP32-S3 只有 2.4GHz,5G SSID 直接 WL_NO_SSID_AVAIL 连 2.4G
    A6 把 85Hz 当可见刷新率(见第二节) 按「秒」设计,别按「赫兹」
    A7 板子把 IO19 给了 3 个 ADC 按键,而 S3 原生 USB 要吃 IO19/20 → 原生 USB 不可用。「USB 传数据」其实就是 CH340 串口 GPIO 预算要同时绕开 16 位并口和按键,没有第二条数据通路

    B epdiy 库层(读源码,别凭记忆)

    # 坑 修法 / 判据
    B1 dirty_lines 是 malloc() 出来从不清零——初始化不清、每次刷完也不清——而 epd_difference_image_base() 只重算本次 area 覆盖行的 dirty 标记。残留的 dirty 行就拿 difference_fb 里的旧差分数据去驱动波形 → 随机黑白块,块边界正好对齐 tile/area。这就是斑马纹的底层机制 GC16 一律扩整屏(让所有行重算);每次局部刷新前 memset(hl.dirty_lines, 0, …) 预清零
    B2 epd_write_string 默认不画背景(EPD_DRAW_BACKGROUND 没置位,只写前景字形像素)。旧内容留在帧缓存里,差分认为「没变」就永不刷 → 永久重影 每帧开头整幅清白(epd_fill_rect(full_screen, 0xF0))。零性能损失:差分只送变化行
    B3 「局部 + GC16」画不全(见第二节) 模式 × 路径逐格单独验证
    B4 固件只在开机画面写了字,首帧后再不碰帧缓存。主机差分只跟自己上一帧比,固件画过、主机不知道的东西永远擦不掉 固件改屏必须让主机也知道(或渲染前全清)
    B5 字体只带 ASCII,中文渲染成空白/方块 屏上文案只用英文
    B6 epdiy 必须配核心 2.0.x:它的 pca9555.c 用了 #include <driver/i2c.h>(IDF legacy I2C 驱动),3.x 已删除 锁死核心 2.0.14;升级前先确认这个 legacy API 还在不在

    C 固件应用层

    # 坑 修法 / 判据
    C1 g_first(首帧强制 GC16)每次清屏后都被置回 true → 主机发的 DU 被固件悄悄升级成坏的「局部 + GC16」路径,主机侧的修复被完全抵消 删掉一切「固件自作主张改刷新模式」的逻辑,模式完全由数据/flags 决定。判据:日志出现 mode=2(GC16)而主机明明发的是 DU flag——注意固件枚举(DU=1/GC16=2/GL16=5)和协议 flag(0x02=DU)是两套不同的数字
    C2 HardwareSerial::begin(baud, config, rx, tx) 参数顺序是先 RX 后 TX。我按直觉写成 (…, TX, RX) → 固件 TX 顶到 CH340 自己的 TXD,两边对顶。极具迷惑性:能收帧、能刷屏,但日志/ACK 一句都上不来 按 RX, TX 顺序传(本板 TX=GPIO43 / RX=GPIO44)
    C3 USB CDC 的日志字节被泵进了同一个协议解析器 → 每次刷屏 USB 重枚举都投杂散字节,整帧错位。坏帧率 45%→80% 非传输通道的字节流一律不许进解析器
    C4 1MB 收帧缓冲放内部 RAM 挤爆堆 ps_malloc 进 PSRAM
    C5 固定 x 落笔的文字(时间/数值)字宽一超就出画 epd_get_text_bounds() 先量实际字宽再落笔(从右边缘右对齐)
    C6 固件链路看门狗 12s:服务端任何静默 > 12s 就拆链 服务端保证任何一次静默 < 12s(批内每 ~4s 回一次 ACK)
    C7 固定超时是错的:整屏帧光发送就要 11.3s,固定 2s 超时必然误判重传 → 死循环 超时按帧长自适应:max(基础值, 字节数/(波特率/10) + 基础值)
    C8 掉一个字节就永久失联,除非有两套恢复机制:① 空闲 100ms 丢半截帧(不丢的话之后每次重传的帧头都会被当 payload 吞掉 → 死锁);② 伪同步 22 字节重扫(帧头 CRC 不符时把已消费的字节重新扫一遍,救回被噪声偷走的真帧头) 两套都要。UART0 与启动日志共线,还要加抗噪(magic 重同步 + 双重 CRC + 整帧校验通过才 ACK)

    D 服务端 / 部署层

    # 坑 修法 / 判据
    D1 pkill -f epd_serve.py 把自己所在的 shell 也杀了(cmdline 含同一串)→ 输出全空、进程「起不来」 [e]pd 括号技巧,或 ss -ltnp 取 pid 再 kill <pid>
    D2 SSH 里 nohup & 起的后台进程随会话死(systemd 用户 Linger=no) tmux new -d -s epd '… \| tee log' 分离常驻(后来迁到 systemd service,见第五节)
    D3 CPU 差分公式:busy ≠ 各列求和,而是 total − (idle + iowait)。写错时空载恒显 ~50%。判据:「每核全 50% 但 load 只有 0.1」的矛盾 busy = 总时间 − idle − iowait
    D4 Arch 的串口组是 uucp(不是 Debian 的 dialout) usermod -aG uucp <user> 重登录
    D5 开机 WiFi.scanNetworks() 饿死 IDLE(core0) → task_wdt abort 重启循环 别开机扫描,直接 WiFi.begin(ssid, key)
    D6 「静默 80ms = 批末」的判定是错的——链路抖动被当批末 → 巨型 GC16 → 板子卡死在刷屏里 显式发 PING 帧标记批末;兜底空闲阈值放宽到 1500ms
    D7 清屏帧回两条 ACK,没收干净后面所有 ACK 索引整体错位 逐条对齐收
    D8 glob("/sys/class/drm/card[0-9]*") 会把 card0-DP-4 也算进来 → 双卡只读到一张 re.fullmatch(r".*/card\d+", path) 过滤
    D9 sysfs 的 cardN 顺序和 rocm-smi 的 GPU[x] 是反的(而且本机物理下层那张卡散热更好)。按 rocm-smi 序号写标签会把 GPU 标反 别抄 rocm-smi 的编号,先搞清映射
    D10 整屏 1MB 帧必被固件当「半帧」丢掉(dropped a half frame) 整屏重画切 64×64 tile 逐块发,固件自动合并成一次大刷新

    四、架构转向(真正的教训)

    第一版是推像素的:服务端 PIL 渲染、差分成 64×64 tile 推过去,配 ARQ 补发、看门狗、批时序。能跑——直到斑马纹 bug 出现,我花了一整天追。

    排障过程中反复出现同一类症状:「主机和固件对同一状态的理解不一致」(谁定 GC16、ACK 收到第几条、什么算批末)。这是分布式状态一致性问题,说明职责切错了地方。

    于是我把整条像素通路砍了,切到终端模型:服务器发一行数据,ESP32 本地渲染、本地决策。

    推像素(旧) 终端模型(现)
    链路负载 整帧 1MB / 差分几十 KB ~100–250 B/s(一行 ASCII 键值)
    渲染 服务端 PIL ESP32 本地(fill_rect + write_string——btop 看板就是矩形 + 字)
    刷新决策 跨网络协调(flags/ARQ/看门狗/扫屏时序) 纯固件本地
    改 UI 改 Python 就行 改 C++ 重烧(换稳定性的代价)

    把控制面(刷新决策、状态同步)收到离屏最近的一端之后,网络上只剩数据面——复杂度按数量级下降。1MB 缓冲、ARQ、看门狗、扫屏切块、USB 掉线 workaround 全都不存在了。

    沉淀出来的一条经验:当排障已经把故障面收窄到一小撮已知嫌疑时,估算「绕过这条路径」的成本 vs「复现→定位→修复」的成本——绕过去往往更快。这里绕过的成本 = 加一个帧类型 + 一个小渲染引擎 + 一个小采集器(约半天),比把像素通路查穿便宜,而且顺手消灭了一整类问题。

    同阶段还有两个值得带走的手法:

    • 隔离自检(本地复现法):做 5 个固件自检阶段(ST1~ST5),每条生产路径都在固件本地复现一遍,数据全本地生成(排除网络/协议/传输),一次烧录分辨全部嫌疑。每条自检只和上一条差一个变量。当「本地自绘」永远干净、只有「网络推送」出斑马时,故障面一下午就劈到网络数据面了。自检做成编译开关(-DEPD_SELFTEST)常驻代码——屏上再出任何异常,先跑一遍。
    • 远程判屏:人不在屏前的时候,手机拍照 → 二值化 → 按列算暗占比 → 跑游程 RLE:黑白块宽是 tile 尺寸的整数倍 ⇒ 差分/合并层的锅;不是 ⇒ 波形/面板层的锅。屏上留四角角标当坐标标尺;本机把发出去的 tile 解回像素量黑占比,判「发送端是否无辜」。

    五、不性感但致命的运维细节

    • 版本锁死写进文档。核心 2.0.14 + epdiy 2.0.0 不是随便能换的——升级前先确认 legacy I2C API 还在。
    • 自检代码是资产不是垃圾,留宏开关常驻。
    • 数据协议宁 ASCII 不二进制:一行可 grep、人眼可读、CRC 照挂的键值,在这个带宽下比紧凑二进制强——带宽预算宽裕时,可调试性 > 字节数。
    • 服务端采集纯标准库:/proc + sysfs 不需要 psutil,scp 一个文件就能跑。
    • 服务端做开机自启:最后是 systemd unit(Restart=always)。实测服务器掉电重启后拿到的 IP 一晚上漂了三次,板子 15s 内自己连回。当前拓扑里板子先连到一台常开的笔记本(portproxy 转发到服务器),我计划把服务器网线直插路由器 LAN 口去掉这一跳。
    • 凭据放仓库外:WiFi 凭据放在 git/网盘之外的头文件,编译 -I 引入。
    • GPU 数据全走 sysfs,不起子进程、不用 root:gpu_busy_percent、mem_info_vram_used/total、hwmon 温度/功耗/风扇/频率——比 shell 出 rocm-smi 轻得多。(AMD 是 rocm-smi/sysfs,不是 nvidia-smi。)

    六、下一步

    • GPU 信息再加细(per-process 级别,向 nvtop 看齐);板子直连服务器(去掉转发这一跳),整系统收敛成两节点。
    • 静态层缓存 + 元素级脏重绘:真要往 2s 节奏以上提刷新时再上(内存还有 ~5MB PSRAM、~13MB flash 富余,唯一潜在瓶颈是 CPU 时间——触发线没到之前不优化)。
    • 长期跑下来如果 DU 残影累积明显,再调 GC16 频率或把灰度内容切 GL16。

    一句话总结

    做「显示终端」,就让它当终端:渲染和刷新决策放在离屏最近的地方,网络只走数据。

    有问题欢迎留言,帧协议和自检设计都可以聊。想看完整源码的(固件 + 协议 + 服务端 + 自检序列),评论区留言,我看到会发。


  • # X99 洋垃圾 + 双 R9700 续篇:限频降压救活双卡供电,P2P/TP 却全线阵亡 —— 最终形态是「双卡双实例」
    张光璞张 张光璞
    AI硬件 x99 r9700 多卡部署

    上一篇讲了怎么把这台 X99 洋垃圾(Dell T7910)刷成能跑 R9700 的推理机,以及插上第二张卡后一满载就硬断电的翻车。
    这篇是续集,三件事:
    ① 把供电问题彻底解决(不是换电源);
    ② 把「双卡跑一个大模型提速」这条路从 TP → 行拆分 → tensor 全试一遍;
    ③ 得到最终形态 —— 双卡双实例,一卡一个模型。


    TL;DR

    我想做的事 结果 关键原因
    双卡同时满载不掉电 ✅ 做到了(400W 稳定 225 秒) OD 限频 + 降压,不是换电源
    双卡 TP(张量并行)提速 ❌ 全线失败 P2P 不可用(内核白名单),绕不过去
    双卡「行拆分」提速 ❌ 加载即崩 ROCm 后端没实现 split_buffer_type
    双卡「tensor」模式提速 ⚠️ 能跑但不值 AllReduce 退化 + 不兼容投机解码
    双卡「层拆分」提速 ❌ 不提速,只加显存 层拆分是串行流水线
    双卡最终形态 ✅ 双实例,一卡一个模型 零通信开销、互不拖累

    一句话:这块平台的瓶颈从来不是钱,是**「并行」这件事在 X99 上被物理封死了** —— 双卡唯一正确的用法是让它俩各干各的。


    一、平台配置

    项 规格 备注
    机型 Dell Precision T7910 塔式工作站 洋垃圾整机
    CPU 2× Xeon E5-2683 v4(16C/32T each,32C/64T) 双路,两个 NUMA 节点
    内存 4× 32G DDR4-2400 每路双通道,76.8 GB/s
    电源 原装 1300W(型号 D1300EF-02) ⚠️ 规格是 4 路 12V × 18A
    GPU 2× AMD Radeon AI PRO R9700 32GB(gfx1201 / RDNA4) 250W/卡(限频后实际 ~250W 峰值)
    系统 Ubuntu 24.04.5 LTS,内核 7.0.0-31 ROCm 7.2.0
    推理后端 llama.cpp(HIP 后端,commit 56381e4) 自己编译,打了 FastMTP 补丁

    相对上一篇,平台这边新增的两件事

    1. 换了卡位:把其中一张卡从 CPU2 的槽搬到 CPU1 的空闲 x16 槽 → 两卡同 NUMA 节点、跳数 3→2。
    2. 关了 BIOS 虚拟化(本想关掉 IOMMU 隔离,后来发现没用,见第五节)。

    二、破解跳闸:根本不是功率问题

    2.1 先做对照实验(这一步是全文的地基)

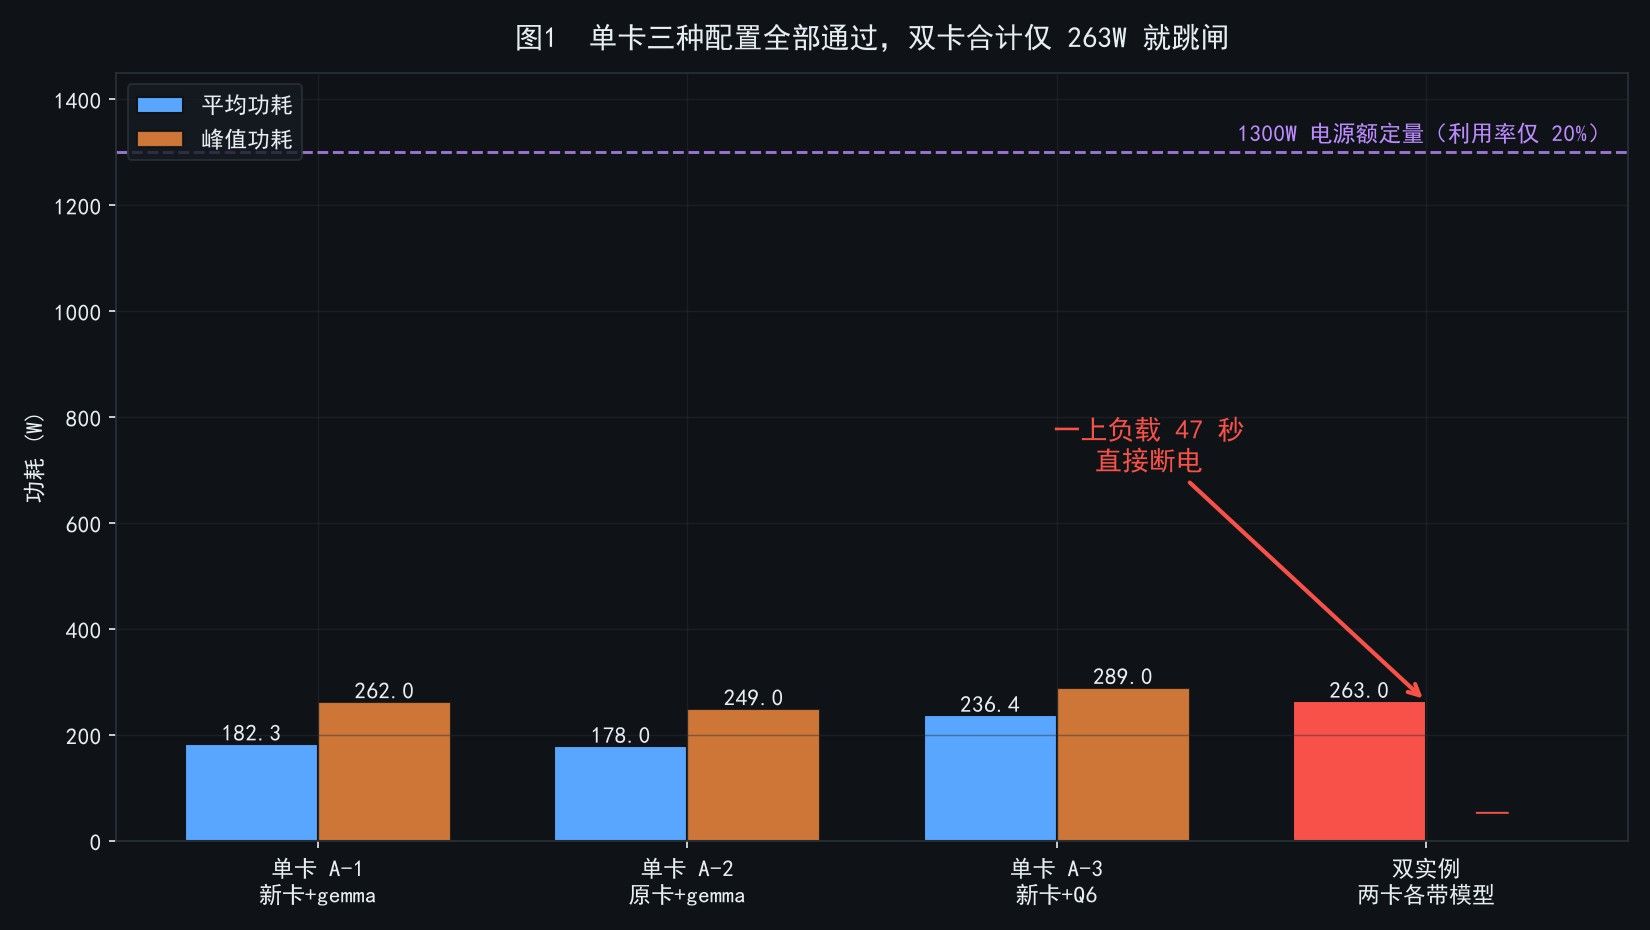
    单卡任何配置都能跑,双卡一上负载 47 秒断电。所以我把「单卡 × 模型」全排列测了一遍,每档压 90 秒以上:

    88705bd0-6679-4b26-8b90-0c972ae12857-image.jpeg
    单卡三种配置全部通过,双卡合计仅 263W 就跳闸

    实验 平均功耗 峰值功耗 时长 结果
    A-1 新卡 + gemma-4-26B 182.3 W 262.0 W 90s ✅ 通过
    A-2 原卡 + gemma-4-26B 178.0 W 249.0 W 98s ✅ 通过
    A-3 新卡 + Qwen3.8-27B Q6 236.4 W 289.0 W 92s ✅ 通过
    双实例(两卡各常驻一个模型) 合计仅 263 W — 47s ❌ 硬断电

    功耗采样口径:读 /sys/class/drm/card*/device/hwmon/hwmon*/power1_average,0.15~15 秒一次,采样落盘到家目录(⚠️ 写 /tmp 会在重启后丢光,我踩过)。
    时长口径:三段单卡对照全部 ≥90 秒,和双卡失败那次的 47 秒可比。

    2.2 🔑 转折点

    看第三行和第四行:236W 的单卡不跳,263W 的双卡跳。

    也就是说 —— 失败跟总功率、跟在跑什么模型,都没有关系。

    再补一刀:我把 power1_cap(功率上限)从 280W 一路降到 210W(这卡的硬件下限),双卡依然一上负载就跳。

    结论:限制的不是「总功率」,是「瞬态尖峰的幅度」。
    power1_cap 管的是长窗口平均功耗,对微秒级的 dI/dt 尖峰毫无办法(它的 sysfs 标签其实叫 PPT = Power Target,是「目标」不是「上限」)。
    唯一和失败严格相关的变量是:两张卡的显存子系统是否同时从空闲转入满载。

    证据链(按排除顺序):

    1. 降 cap 后仍断 ⇒ 不是「上限设太高」
    2. 崩溃瞬间实测功率确实等于设定值 ⇒ 不是「限功没生效」
    3. 单卡 289W 不跳、双卡 263W 跳 ⇒ 不是「持续过载」
    4. 跳闸发生在上负载而非启动/加载(双卡空载挂 90+ 秒完全没事)⇒ 是尖峰触发电源保护

    (另外:崩溃前 journalctl 没有任何内核日志,登录会话全部标记 crash —— 这是电源保护跳闸的签名,不是内核 panic、不是驱动崩溃、不是过热。)


    三、解法:限频 + 降压(不换电源)

    既然要压的是尖峰,那就去动电压/频率曲线,而不是功耗上限。

    3.1 正确接口是 pp_od_clk_voltage,不是 pp_dpm_sclk

    # 每张卡都要做一遍
    echo "s -500"  | sudo tee /sys/class/drm/cardN/device/pp_od_clk_voltage   # SCLK  偏移 -500MHz
    echo "vo -100" | sudo tee /sys/class/drm/cardN/device/pp_od_clk_voltage   # VDDGFX 偏移 -100mV
    echo "c"       | sudo tee /sys/class/drm/cardN/device/pp_od_clk_voltage   # 提交
    # echo "r"     | sudo tee ...                                              # 复位回默认
    

    可调范围(读同一文件即得):SCLK_OFFSET: -500 ~ +1000 MHz、VDDGFX_OFFSET: -200 ~ 0 mV。

    ⚠️ 坑:pp_dpm_sclk 的档位写法 echo "s 2 1500" > pp_dpm_sclk 静默无效(写不报错、读回不变,实测平均功耗 172.6W 几乎没动)。正确接口只有 pp_od_clk_voltage 的偏移写法。

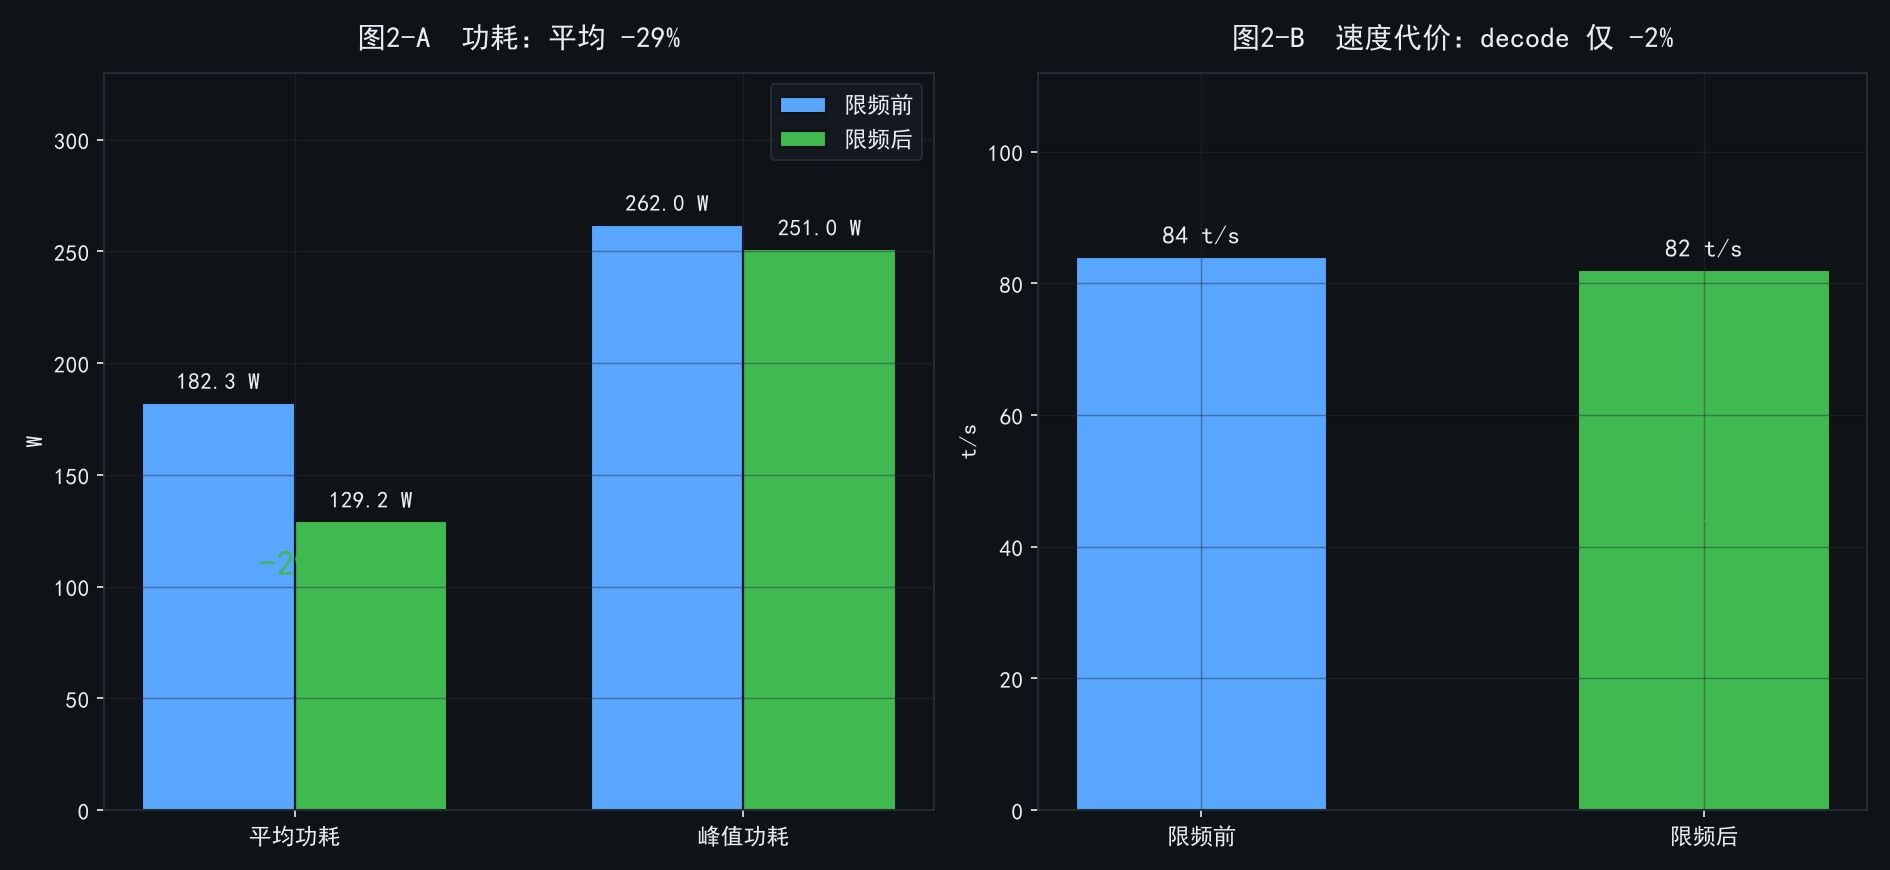
    3.2 效果:功耗 -29%,速度只掉 2%

    51285964-bdce-438b-83f8-ed8b10eae90f-image.jpeg
    (fig2.png)

    指标 限频前 限频后 变化
    单卡平均功耗 182.3 W 129.2 W -29%
    单卡峰值功耗 262.0 W 251.0 W -4%
    decode 速度 84 t/s 82 t/s -2%
    双卡同时满载 ❌ 47 秒跳闸 ✅ 403~426W 稳定 —

    速度口径:llama.cpp server 返回的 timings.predicted_per_second(纯 decode,不含 prefill);固定 prompt + max_tokens=600 长回答;--parallel 1 单流;开 MTP 投机解码。

    为什么速度几乎无损:decode 是显存带宽活(每 token 把权重读一遍),prefill 才是算力活。降 SCLK 主要砍 prefill,decode 掉得很少。

    3.3 固化 + 两个必踩的坑

    已经做成 systemd 服务(Type=oneshot + RemainAfterExit=yes),开机自动应用:

    • ⚠️ 坑 1:必须带「读回校验 + 重试」。首次部署时出现过只配置到一张卡的竞态(开机太早,第二张卡的 sysfs 节点还没出现,for d in /sys/class/drm/card*/... 只匹配到一张)——另一张卡没限频等于白限。脚本要逐卡读回 OD_SCLK_OFFSET 确认,不匹配就重试。
    • ⚠️ 坑 2:只 systemctl enable 不等于生效。必须真重启一次并读回每张卡的值才算验证过。

    四、双卡终于跑起来了

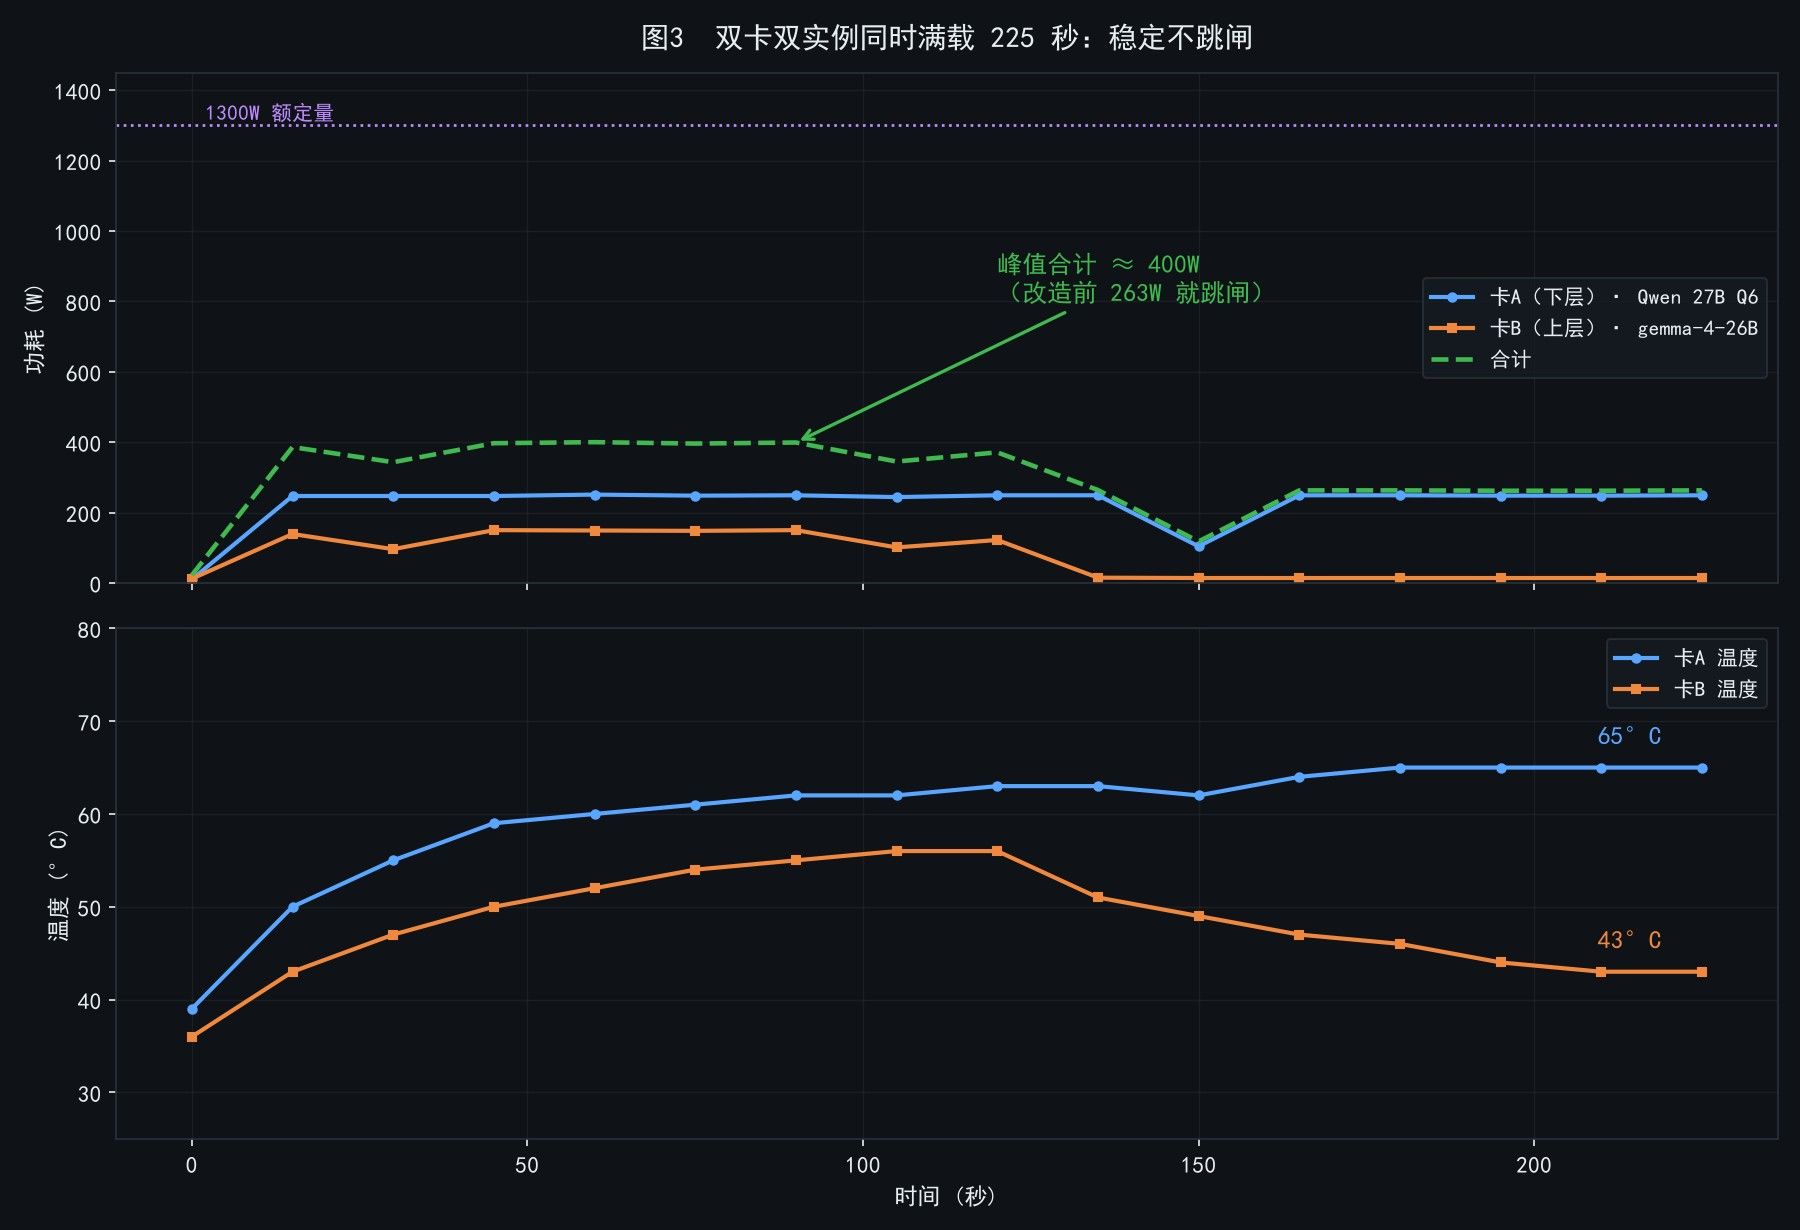
    修好供电之后,把两个模型同时挂上去,压了 225 秒:

    2d20b795-1d87-488a-aa3a-7c00a2d721c3-image.jpeg
    (fig3.png)

    时刻 卡A(跑 27B Q6) 卡B(跑 gemma-4-26B)
    15s 247W / 50°C 139W / 43°C
    60s 251W / 60°C 149W / 52°C
    120s 249W / 63°C 122W / 56°C
    225s 249W / 65°C 14W / 43°C

    双卡同时满载峰值合计 ≈ 400W,持续 225 秒不跳。
    (对比:改造前 263W 就 47 秒断电 —— 撑了 4.8 倍的时长、1.5 倍的功率。)

    口径说明:卡B 在 135 秒后掉到 14W 是正常的 —— gemma 是 MoE(26B/激活 4B),速度快 ~5 倍,它那批 1500 token 早就答完了;卡A 的 Q6 是稠密 27B,一直压到结束。

    顺手做的散热分配(这一步意外地有效):把持续重载的 Q6 放在下层卡(吸冷风顺畅),轻载的 gemma 放上层(散热条件差)。
    实测结果是下层卡最高 65°C、上层卡最高 56°C —— 如果把 Q6 放上层,估计要冲 75°C+。


    五、然后我想上 TP —— 结果撞了三堵墙

    供电解决后,第一个念头就是:既然两张卡都能满载了,那并行跑一个模型是不是能提速?

    答案是不能,而且原因比想象的深。

    5.1 第一堵墙:P2P 根本不可用

    amdgpu 驱动在初始化时就把判决写进了内核日志:

    amdgpu: PCIe P2P access from peer device ... is not supported by the chipset
    

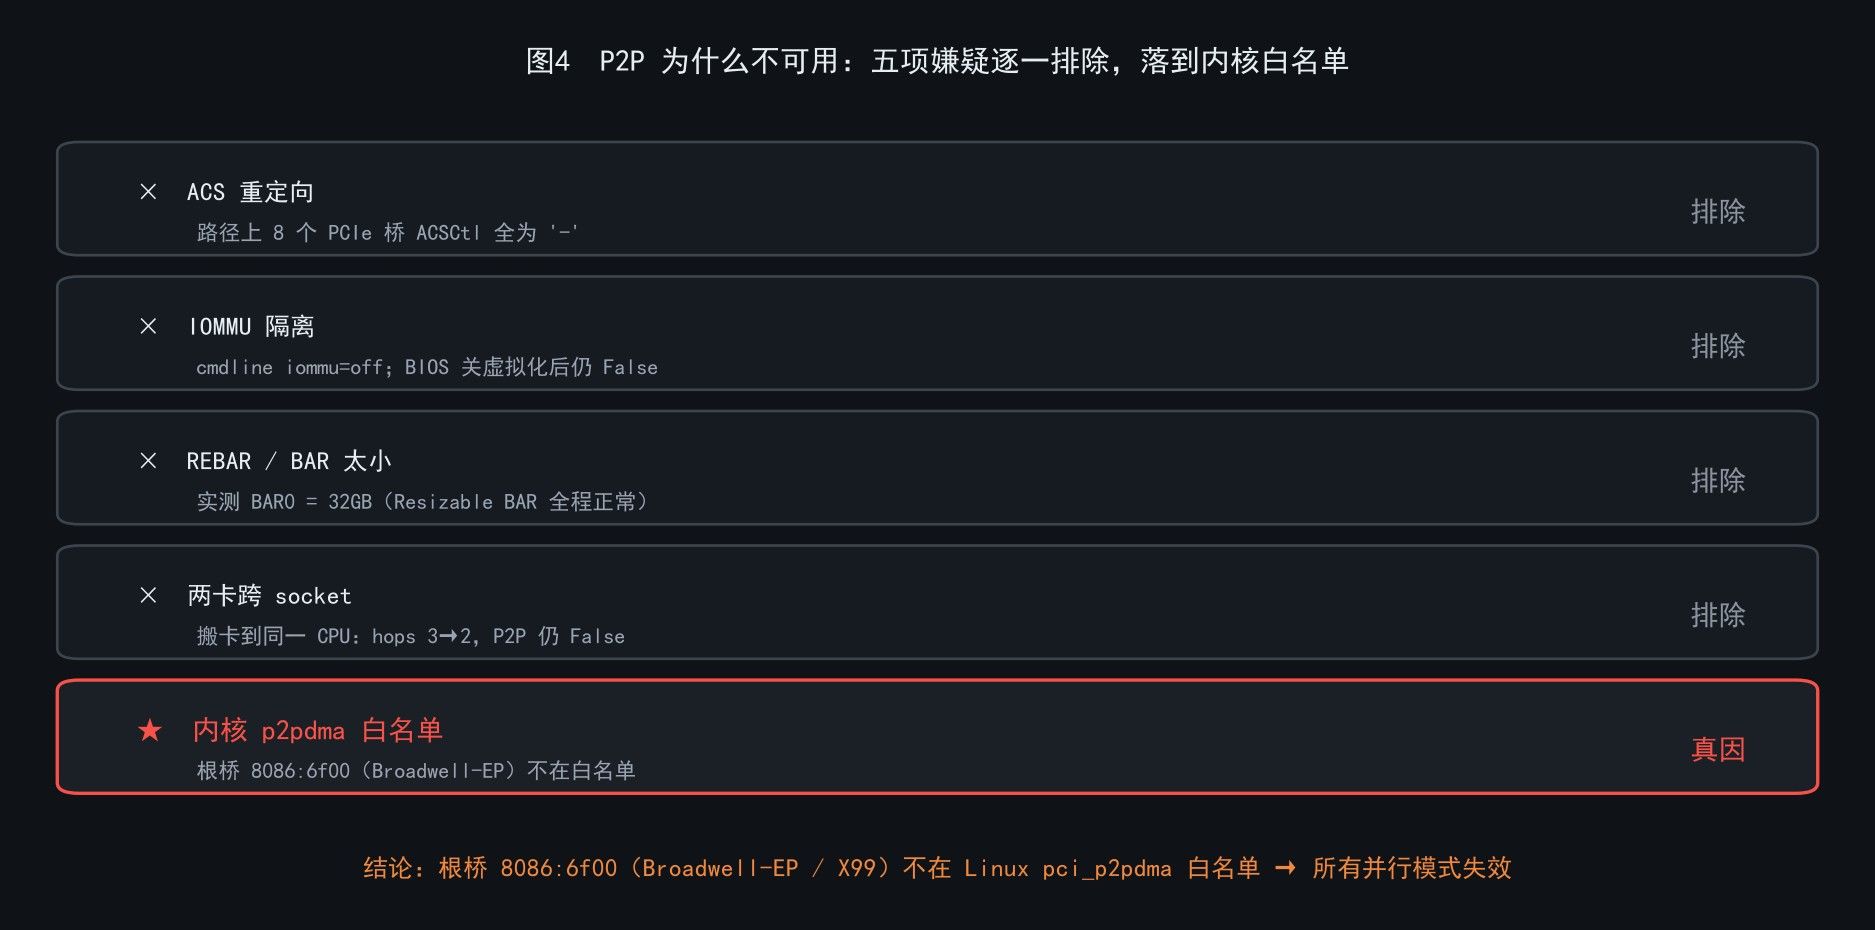
    一行命令就能定性,不用猜。但我不信邪,把常见嫌疑逐个排除了:

    da30bfcb-188b-437c-aff3-a27b5f784e02-image.jpeg
    (fig4.png)

    嫌疑 实测 结论
    ACS 重定向 路径上 8 个 PCIe 桥的 ACSCtl 全是 - × 排除
    IOMMU 隔离 iommu=off;去 BIOS 关了虚拟化后仍然 False × 排除
    REBAR / BAR 太小 BAR 0: current size: 32GB —— 大 BAR 完全正常 × 排除(我原来的判断是错的)
    两卡跨 socket 搬卡到同一 CPU(hops 3→2、同 NUMA)后 P2P 仍为 False × 排除
    内核 p2pdma 白名单 根桥 8086:6f00(Broadwell-EP / X99)不在白名单里 ★ 真因

    这里是本文最大的一个认知修正:我原以为「X99 没有 REBAR」是死因 —— 错。开了 BIOS 的 Above 4G 之后,两张卡都拿到了完整的 32GB BAR。真正卡住的是 Linux 内核的 pci_p2pdma 白名单:只要数据路径要经过 host bridge,就要查这份白名单,而 Intel X99 的根桥不在里面。

    旁证:社区里有人在同代平台(E5-2699v4 + X99 + 同款 R9700)打内核补丁把 0x6f00 加进白名单后,hipDeviceCanAccessPeer() 确实返回了 1,带宽 10.2 GB/s。
    所以「芯片组不支持」这句话是内核策略,不等于硬件做不到。

    5.2 但就算修好,也是负收益

    同一份社区实测的后半段才是关键:硬件 P2P 打通之后,hipIpcOpenMemHandle 在 gfx1201 上恒定报错 17 → RCCL 的 P2P 传输用不上 → vLLM 的 TP=2 只能退回 SHM 传输:

    配置 传输路径 decode(同规模稠密模型)
    默认 SHM/direct/direct 13.6 t/s
    打 DMA 48 位补丁 SHM/direct/direct 14.1 t/s(天花板)
    强开 P2P → 死机,需物理重启 —

    14.1 t/s 比我这张单卡跑 MoE 模型的 84~92 t/s 慢 6 倍。 这是 AMD 侧的软件 bug,不是配置能解决的。

    → 结论:TP 这条路,在这块平台上「要么走不通,要么走通了也没用」。

    5.3 顺手澄清两个常见误区

    ① 「x16 拆分成 x8+x8 就能直连」——不行。
    内核判的是「数据路径是否经过 host bridge」,不是「是否同一个物理插槽」。拆分后两卡落在两个独立 root port(lspci 里表现为成对端口 00:01.0 / 00:01.1),彼此通信仍要「上行进 root complex 再下来」⇒ 依然查白名单 ⇒ 照样判死。
    唯一能绕开的是让两卡挂在同一个 PCIe switch 的下游(公共祖先变成交换芯片,TLP 直接被转发,不进 host bridge)。⚠️ 必须是「同一个」—— 板载两个 PLX、两卡各挂一个,无效。

    ② 「搬卡到同一 CPU 就好了」——也不行。
    实测搬卡后 hops 从 3 降到 2、NUMA 也统一了,P2P 仍然 False,而且层拆分的速度一模一样(详见 5.4)。

    5.4 第二堵墙:llama.cpp 的三种 split-mode 实测

    既然 TP 指望不上,那就试试 llama.cpp 自己的多卡拆分。它有四种模式,我把没测过的三种全测了:

    模式 加载 能否配投机解码 decode 判定
    layer ✅ 73s ✅ 16.8 t/s ✅ 唯一完整可用
    row ❌ 加载即崩 — — ❌ ROCm 后端没实现
    tensor ✅ 81s(不带投机) ❌ 带投机必崩 20.0 t/s ⚠️ 能跑但退化
    layer(关投机对照) ✅ — 18.6 t/s 投机在双卡下≈没开

    row 为什么直接崩(源码里是硬性 throw):

    E llama_model_load: error loading model: device ROCm0 does not support split buffers
    

    llama.cpp 的 ROW 模式要求后端提供 ggml_backend_split_buffer_type 这个接口 —— HIP/CUDA 后端没实现(只有 SYCL 和 Hexagon 有)。所以这不是配置问题,是后端实现缺口。

    tensor 为什么「能跑但不值」:日志里明说了

    W internal AllReduce init failed (n_devices != 2?); falling back to meta-backend butterfly
    W set_sampler: backend sampling not supported with SPLIT_MODE_TENSOR; using CPU
    

    快速 AllReduce 初始化失败,退化成了软件 butterfly —— 而它依赖的正是 peer access(P2P)。没有 P2P,tensor 模式注定退化。 再加上带投机解码会直接断言崩溃(GGML_ASSERT(... GGML_BACKEND_SPLIT_AXIS_1) failed),实际是负收益。

    5.5 闭环:为什么「双卡只能层拆分」是必然的

    X99 根桥不在 Linux pci_p2pdma 白名单
            ↓
    P2P 永远不可用
            ↓
    ├─ vLLM / SGLang TP2   → RCCL 用不上 P2P → 14.1 t/s 天花板
    ├─ llama.cpp `row`     → 后端没实现(另一条独立死因)
    └─ llama.cpp `tensor`  → AllReduce 退化 → 只 +19%,还不兼容投机
            ↓
    唯一能完整跑通的 = `layer`(串行流水线,不依赖 P2P)
            ↓
    但 layer 不提速,只加显存
    

    「双卡并行」这件事,在这块平台上是被物理封死的,不是没调好参数。


    六、速度总账

    d6abfd3a-d115-4736-8c5e-d19b463d0508-image.jpeg
    (fig5.png)

    配置 decode 上下文 备注
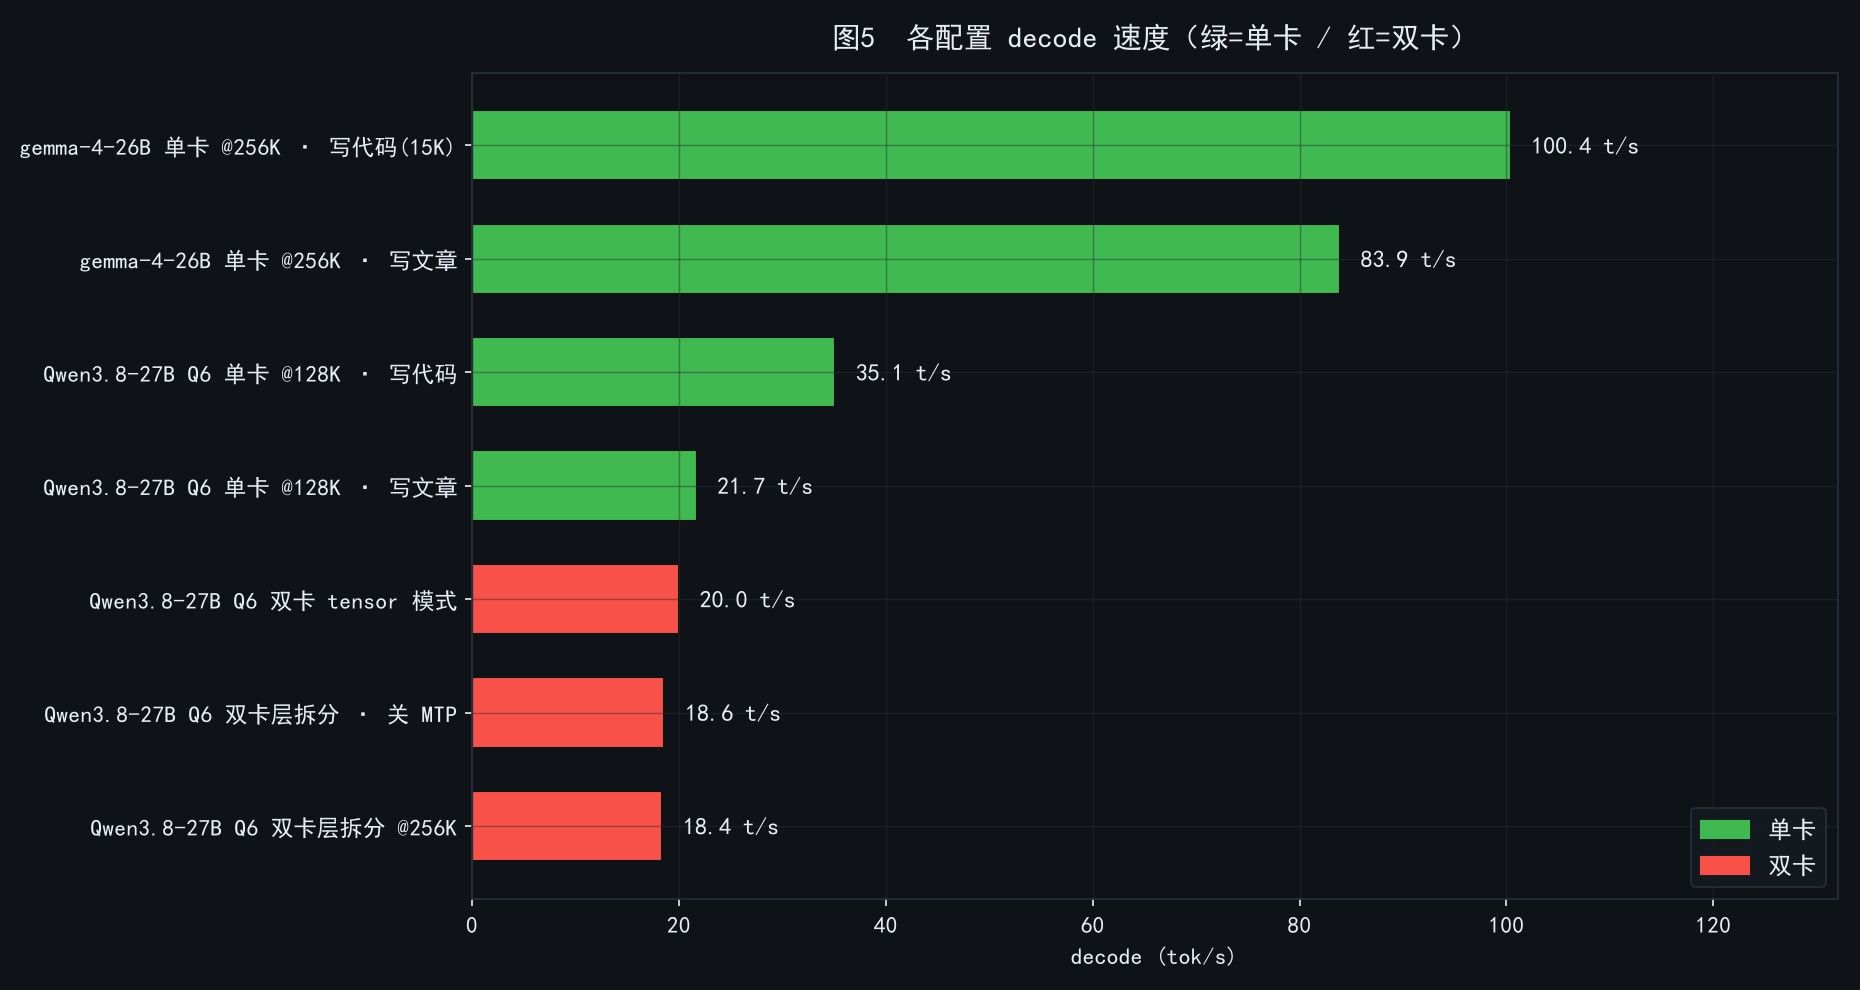
    gemma-4-26B-A4B 单卡 · 写代码 100.4 t/s 256K MoE 26B/激活 4B
    gemma-4-26B-A4B 单卡 · 写文章 83.9 t/s 256K
    Qwen3.8-27B Q6 单卡 · 写代码 35.1 t/s 128K 稠密 27B
    Qwen3.8-27B Q6 单卡 · 写文章 21.7 t/s 128K
    Qwen3.8-27B Q6 双卡 tensor 20.0 t/s 128K 不兼容投机
    Qwen3.8-27B Q6 双卡层拆分 · 关投机 18.6 t/s 256K
    Qwen3.8-27B Q6 双卡层拆分 18.4 t/s 256K
    Qwen3.8-27B Q6 单卡(同档对照) 17.3 t/s 256K KV 降 q4_0 贴边

    关键读法:

    • 双卡层拆分 18.4 vs 单卡 17.3 —— 双卡连 1 帧都没快,反而略慢。 层拆分是串行流水线,单请求延迟 = 两卡耗时之和。
    • 搬卡前后完全一致(18.4/18.9/16.2/12.7)⇒ 卡间通信从来不是瓶颈,这条实验直接证明了 5.1 的结论:P2P 通不通,对层拆分毫无影响。
    • 真正拉开差距的是模型选择:MoE 26B(激活 4B)比稠密 27B 快 4 倍 —— 换模型比加卡有效得多。

    七、两个附带发现(都实打实能提速)

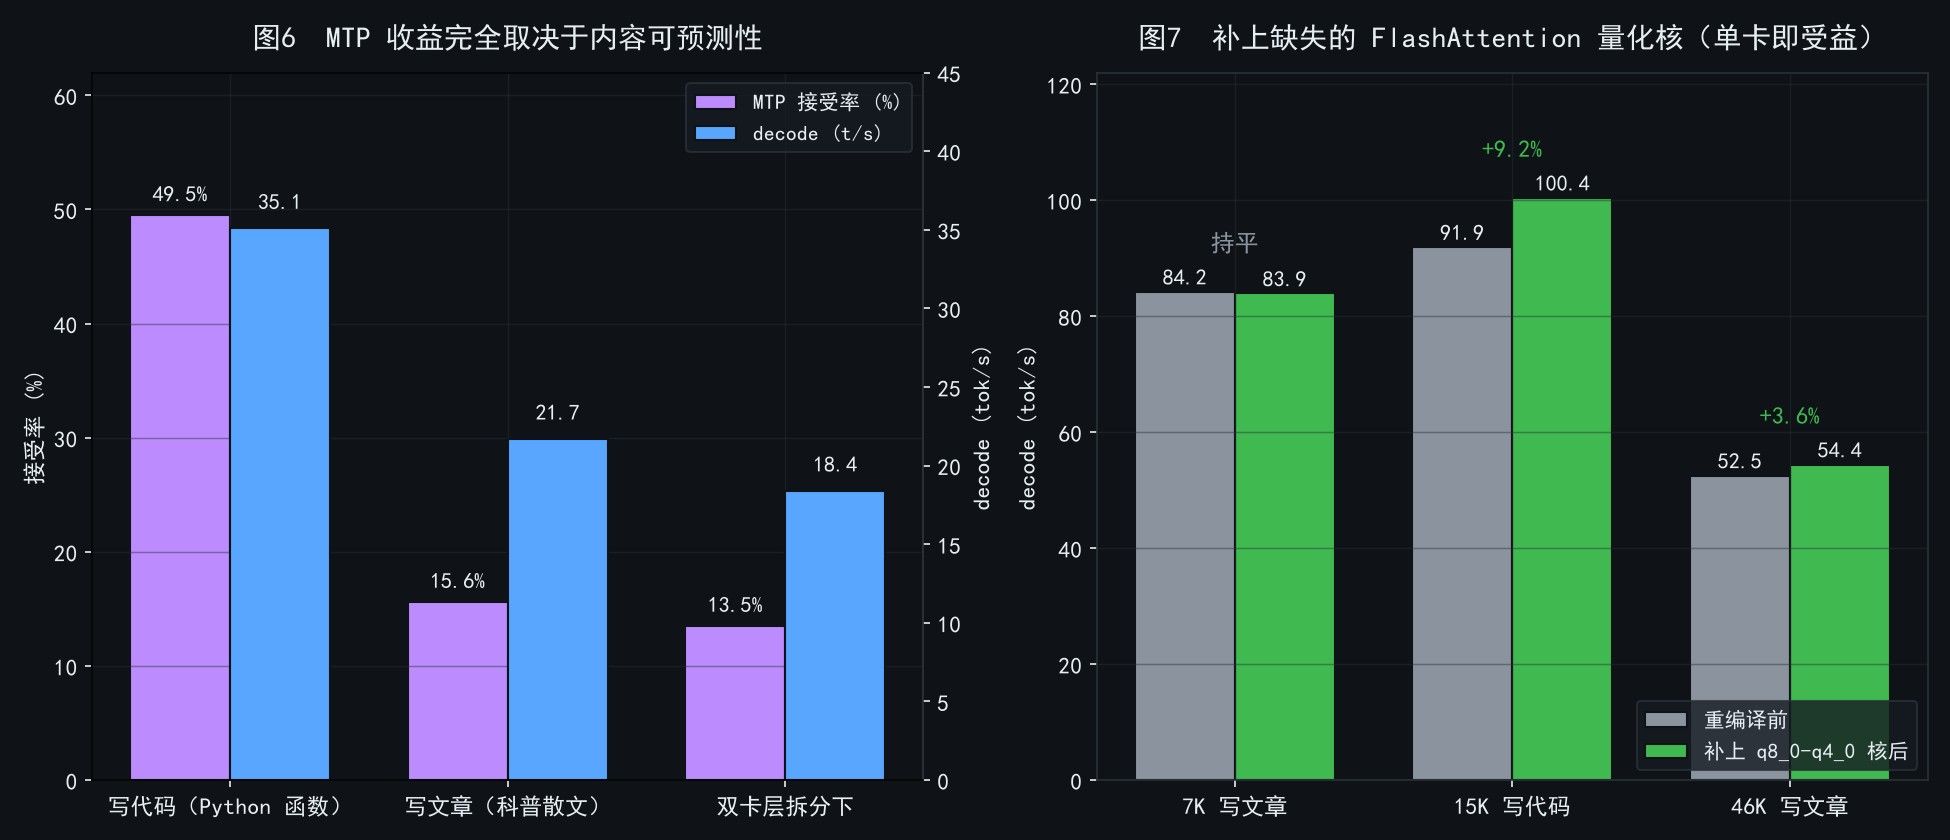
    7.1 投机解码(MTP)的收益完全取决于内容

    29062bd8-7e62-40d8-b304-db56ed7e7380-image.jpeg
    (fig6.png)

    同样的模型、同样的量化、同样的上下文,只换任务类型:

    任务 MTP 接受率 平均接受长度 decode
    写代码(Python 函数) 49.5% 2.49 35.1 t/s
    写文章(科普散文) 15.6% 1.48 21.7 t/s
    (双卡层拆分下) 13.5% 1.40 18.4 t/s

    差 62%。 代码 / JSON / tool-calling 这类结构化输出可预测性高,投机大赚;自由创作每个 token 都是选择,草稿基本对不上,等于白干。

    口径:接受率 = llama.cpp 日志里的 draft acceptance(draft_n_accepted / draft_n),--spec-draft-n-max 3、p-min 0。
    给后来人的提醒:看到别人贴「MTP 3 倍提速」时,先问一句他跑的是什么内容。

    7.2 一个被白白浪费的性能:FlashAttention 量化核没编进去

    启动日志里有这么一行(很容易被刷过去):

    W ggml_cuda_flash_attn_ext_vec: no FlashAttention vector kernel compiled
      for K/V types q8_0-q4_0, converting K and V to f16 instead (slow).
      Add "q8_0-q4_0" to GGML_CUDA_FA_QUANTS to compile it.
    

    llama.cpp 默认只编了 4 组 FA 组合:q4_0-q4_0; q8_0-q8_0; f16-f16; bf16-bf16。
    而我们常用的省显存组合 -ctk q8_0 -ctv q4_0 不在里面 → 每次注意力都把 K/V 转成 f16,一直在走慢路径。

    补一个组合、增量重编译(只重编 FA 模板实例 + 重链接,4.5 分钟):

    cmake -B build -DGGML_HIP=ON -DAMDGPU_TARGETS=gfx1201 -DCMAKE_BUILD_TYPE=Release \
      -DGGML_CUDA_FA_QUANTS="q4_0-q4_0;q8_0-q8_0;q8_0-q4_0;f16-f16;bf16-bf16"
    

    实测(同 benchmark,两次复测取一致值):

    场景 重编译前 重编译后 变化
    7K 写文章 84.2 83.9 持平
    15K 写代码 91.9 100.4 +9.2%
    46K 写文章 52.5 54.4 +3.6%

    真实但温和(+4~9%),短上下文中性 —— 因为 decode 是权重带宽活,注意力只占一小部分;上下文越长、注意力占比越高,收益才越明显。单卡就受益、不依赖 P2P、无副作用,白捡的。

    增量重编译的小知识:运行中的进程持有旧 inode,重链接不会影响它(但要生效得重启服务)。


    八、最终形态:双卡双实例

    既然「并行」被物理封死,那双卡的正确用法就只剩一个 —— 各跑各的:

    卡A(下层,散热好)→ Qwen3.8-27B Q6  @128K  → 端口 8081   ← 编程 / 严谨推理
    卡B(上层,散热差)→ gemma-4-26B-A4B @256K  → 端口 8080   ← 日常 / 轻任务
    

    两个 systemd 服务常驻,并且:

    • 错峰启动:第二个实例延迟 30 秒起(避免两卡同时从空闲转满载 —— 那正是当初跳闸的瞬间)
    • 互相依赖:After= 保证限频服务先生效
    • 各自独立:任一服务重启/换模型,另一个不受影响

    好处:零通信开销、互不拖累、总吞吐直接翻倍。客户端想用哪个就连哪个端口,也可以配成两个模型档位随手切。


    九、给后来人的建议清单

    💰 买之前

    • 先算供电账,但别只算总瓦数:这台 1300W 电源带双卡稳态只有 ~400W(利用率 30%),照样跳闸。看的是单路 12V 的瞬态承载能力,不是铭牌总功率。
    • 查平台有没有 P2P 能力(想跑多卡并行/TP 的话):lspci -s 00:00.0 -nn 拿根桥 ID,对照 Linux drivers/pci/p2pdma.c 的白名单。X99/C612(Broadwell-EP,8086:6f00)不在里面。
    • 别信「老平台没有 REBAR」这个说法:X99 开 BIOS 的 Above 4G 之后,32G 卡能拿到完整的 32GB BAR。
    • 想要「多卡一个模型真提速」的平台取向:
      AMD 单路(TRX40/EPYC)或 Xeon Scalable(C621) —— root complex 支持端口间 P2P 且在白名单里。

    🔧 装机时

    • BIOS 打开 Memory Mapped I/O above 4GB(大显存卡的硬前提)。
    • 散热条件好的槽位留给持续重载的卡(下层/进风顺畅的那个)。实测差 10°C。
    • 侧记:
      关 BIOS 虚拟化 / 关 IOMMU 对 P2P 没有任何帮助(如果你的 cmdline 里本来就有 iommu=off,改了等于没改)。

    ⚡ 遇到「一满载就断电」

    • 先做单卡 × 模型的全排列对照,每档 ≥90 秒 —— 这一步直接把「总功率」和「瞬时尖峰」区分开。
    • 降 power1_cap 没用就别再降了:它管平均功耗,管不住微秒尖峰。
    • 正解是 pp_od_clk_voltage 限频 + 降压(不是换电源):
      SCLK -500MHz + VDDGFX -100mV → 平均功耗 -29%、decode 仅 -2%、双卡 400W 稳。
    • ⚠️
      别用 pp_dpm_sclk 的档位写法(静默无效)。
    • ⚠️
      开机自动应用必须带「读回校验 + 重试」,否则会只配到一张卡。
    • ⚠️
      采样数据要落盘到家目录,写 /tmp 会在跳闸重启后丢光。

    🚀 调优时

    • 先确认 FA 量化核齐不齐:grep -i 'FlashAttention vector kernel' 日志 —— 有这行 warning 就是在走 f16 慢路径,补编对应组合。
    • 投机解码必须按「内容」看收益:代码/JSON 大赚(接受率 ~50%),自由创作基本白干(~15%)。
    • 优先换模型,而不是加卡:MoE(激活参数少)比同体积稠密快 4 倍。
    • 多卡只跑一个模型时:
      层拆分只换容量不提速;row/tensor 在 ROCm 上要么不支持、要么退化。

    十、当前状态与下一步

    现状:双卡双实例稳定运行(400W / 65°C 峰值),供电问题彻底解决,两个模型随取随用。

    还没做 / 想做的:

    • 给服务加 --api-key:现在两个端点是无鉴权的,放公网或公司内网同网段都不安全。
    • 异地部署的两个保命项:这机器没有 BMC/IPMI,搬去异地前必须配 ① 智能插座(远程硬断电重启)② BIOS AC Power Recovery = On(断电恢复自动开机)。只靠 systemd 自启只能救服务崩,救不了机器没起来。
    • tensor 模式待验证的部分:它的 AllReduce 退化是不是必然由 P2P 缺失导致,我只观测到相关性 —— 属于推测,待验证。有 P2P 平台的朋友可以对照测一下,欢迎补充。

    数据口径汇总(避免争论):

    • 功耗:power1_average sysfs,0.15~15s 采样,落盘;power1_cap 经 sysfs 写入并回读校验。
    • 速度:llama.cpp server 自带 timings.predicted_per_second(纯 decode,不含 prefill);--parallel 1 单流;固定填充 prompt + 任务指令;max_tokens 600(写作)/1500(压力测试);temperature 0.3~0.7;stream=false。
    • 投机解码:--spec-type draft-mtp、--spec-draft-n-max 3、--spec-draft-p-min 0;接受率取 llama.cpp 日志 draft acceptance。
    • 上下文:文中标注 128K / 256K 均为 --ctx-size 实际值(n_ctx,单槽)。
    • 所有功耗/温度数据均为实采,非推算。

  • # X99 洋垃圾 + 双 R9700 翻车实录:单卡 39 t/s 稳跑 27B,双卡一满载就断电,1300W 电源也救不了
    张光璞张 张光璞
    AI硬件 x99 r9700 多卡部署

    平台:Dell Precision T7910(双路 Xeon E5-2683 v4 / 128G DDR4 ECC / 1300W 电源)
    显卡:盈通 R9700 32G(RDNA4 / gfx1201 / Navi48)×2
    系统:Ubuntu 24.04.5 LTS + HWE 内核 7.0.0 + ROCm 7.2 + llama.cpp(HIP 后端 + FastMTP 补丁)
    模型:Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-Q6_K_P(24.1G)
    ed5c60ee-d7d7-451f-9226-78b1b069abfd-7d7ac939f0bbe987e3ed6f931a931046.jpg


    TL;DR(赶时间看这张表)

    项目 结果
    单卡 32G ✅ 27B Q6 + MTP + 128K 上下文 → decode 39.7 t/s / prefill 395 t/s
    双卡 64G ❌ 一满载就整机断电重启,连发一句"你好"都能重启
    把功率限到 250W ❌ 照样断
    限到硬件下限 210W ❌ 还是断(且已确认崩溃瞬间功率确实是 210W)
    最终结论 不是总功率不够 —— 双卡稳态才 ~690W,1300W 电源只用了 53% → 怀疑是单路 12V 瞬态过流触发电源保护
    现状 单卡先跑着,等解决供电再上双卡

    一句话教训:power1_cap 限的是平均功耗,限不住微秒级瞬态尖峰。靠降功率,救不了供电不足的机器。


    一、平台配置与采购价

    部件 规格 来源/价格
    准系统 Dell Precision T7910 塔式(双路 LGA2011-3 / 8 内存槽 / BIOS A34) 闲鱼 ¥1,199 包邮
    CPU Xeon E5-2683 v4 ×2(16C/32T,2.1GHz,120W)×2 —
    内存 4×32G DDR4 ECC RDIMM(只插了 4 条,每路 2 通道) —
    电源 1300W(T7910 最高配档) —
    显卡 盈通 R9700 32G ×2(PCI 1002:7551,RDNA4 / gfx1201) —
    系统盘 447G SSD(LVM 根分区从 100G 扩到 437G) —

    ⚠️ 内存插法要留意:每路 CPU 只插了 DIMM1+DIMM2,每路双通道、全平台 4/8 通道,实测带宽 76.8 GB/s。插满 8 条可到 153.6 GB/s(跑 CPU 推理才有意义,见第六节)。


    二、装机踩坑(按踩到的顺序,每条都能省你半天)

    坑 1:Ubuntu 24.04 默认内核 6.8 完全不认识 RDNA4

    • 症状:amdgpu: Fatal error during GPU init、probe of 0000:05:00.0 failed with error -22,/dev/dri/renderD128 压根不出现
    • 原因:RDNA4(Navi48)需要 6.12+ 内核,24.04 GA 的 6.8 太老
    • 解法:装 HWE 内核
    sudo apt install -y linux-generic-hwe-24.04     # 实测拿到 7.0.0-31
    

    坑 2:老平台必须开 BIOS「Above 4G Decoding」

    RDNA4 这种 32G 大显存卡需要 GB 级 BAR 空间,老平台默认不开时:

    lspci -vvs 05:00.0 | grep -A3 'Resizable BAR'   # BAR 0 只有 256MB
    dmesg | grep 'root bus resource \[mem'           # PCIe MMIO 窗口仅 ~320MB
    

    开完 BIOS 后窗口变成 mem 0x30000000000-0x33fffffffff、BAR 升到 33fe0000000,这一步是硬前提。

    坑 3:换新内核后 amdgpu 一初始化就挂 → boot loop

    现象:内核 7.0 下 amdgpu 走到 DMUB hardware initialized 之后就整机重启,日志无 panic 落盘。旧内核 6.8 看不到这症状(它连初始化都进不去)。

    三步定位法:

    1. 内核参数加 modprobe.blacklist=amdgpu 启动 → 系统能稳 ⇒ 确认是 amdgpu,同时拿到一个能抓日志的窗口
    2. 黑名单模式下:一个连接 sudo dmesg -w 流式读,另一个连接手动 sudo modprobe amdgpu → 抓到最后几行
    3. 逐项加参数复测(每次用 grub-reboot '1>N' 一次性试启动,失败自动回默认内核,不会把自己锁在门外)

    最后解决它的不是参数,是硬件:用户换了一个 GPU 供电接口后,连 runpm=0 都可以去掉,彻底稳定。

    💡 教训:软件层对不上时先看硬件。[drm] Initialized amdgpu 3.64.0 都打出来了还挂 → 不是驱动 bug,优先查供电/接线。

    坑 4:ROCm 7.2 装到怀疑人生

    • 国内没有任何 ROCm 镜像(中科大/阿里/腾讯/清华全 404),只能直连 repo.radeon.com,实测 ~2.7 MB/s
    • 下载 5~7 GB / 600+ 包,装完占 8~15 GB,全程约 80 分钟,别少留时间
    curl -s https://repo.radeon.com/amdgpu-install/7.2/ubuntu/noble/ | grep -oE 'amdgpu-install_[0-9._-]+_all.deb'
    sudo apt-get install -y /tmp/amdgpu-install_*_all.deb
    sudo amdgpu-install --usecase=rocm --no-dkms -y
    
    • apt 走清华源时若命中 IPv6 会 403:403 Forbidden [IP: 2402:...] → 写 /etc/apt/apt.conf.d/99force-ipv4 内容 Acquire::ForceIPv4 "true"; 永久解决
    • ROCm 7.2 原生就认 gfx1201,HSA_OVERRIDE_GFX_VERSION 单卡 llama.cpp 不需要(那个变量是留给 SGLang/vLLM 这类还在旧支持列表里的框架的)

    坑 5:装完 ROCm 第一件事 —— 用户要进 render 组 ★

    这是最阴的一个坑:

    rocminfo          # 普通用户跑 → 空的
    sudo rocminfo     # 正常显示 gfx1201
    

    根因:/dev/kfd 和 /dev/dri/renderD128 的权限是 root:render 660,用户不在 render 组里。而 llama.cpp 只会报 no ROCm-capable device is detected,极易误判成"架构不支持/驱动坏了",白查半天。

    sudo usermod -aG render,video <user>     # 必须重新登录才生效
    

    同类报错还有第二个来源:systemd 服务抢在 amdgpu 初始化完成前启动(/dev/kfd 刚出现但还不可用),症状一模一样(is-active=active、/health=ok、实际在跑 CPU)。修法不同:ExecStartPre=/bin/sleep 20 + Wants=dev-kfd.device + 单元文件里必须显式写 SupplementaryGroups=render video(systemd 只继承主组,shell 里的补充组带不进去)。

    一秒判定在不在 GPU 上:cat /sys/class/drm/card*/device/mem_info_vram_used 只有 ~50MiB ⇒ 跑在 CPU 上;正常加载 20G+ 模型应显示几十 GiB。

    坑 6:btop 1.3.0 在 RDNA4 上必崩(段错误)

    1.3.0 新增了 ROCm SMI GPU 监控,会 dlopen 系统的 librocm_smi64,在 gfx1201 上读温度/PCIe 吞吐失败后直接 Segfault。日志线索在 ~/.config/btop/btop.log(先 WARNING: ROCm SMI: Failed to get maximum GPU temperature 再崩)。没有任何配置项/环境变量/命令行参数能关掉它。

    解法:降级到 btop 1.2.13(GPU 模块是 1.3.0 才加的),并且必须覆盖 /usr/bin/btop 本体——只装到 /usr/local/bin 时调用路径没命中,跑的还是那个必崩的版本。

    坑 7:llama.cpp 新版参数改名,照抄教程直接崩

    • --no-mmap → --load-mode {auto|none|mmap|mlock|dio}
    • --draft-n → --spec-draft-n-max
    • 投机解码统一到 --spec-type

    照抄模型卡里的示例命令 → systemd 陷入 Failed with result 'exit-code' 的 5 秒重启循环,而显存看着是空的,容易误判"模型没加载上"。

    抄完必须 llama-server --help | grep <参数> 验证一遍。


    三、单卡成绩单(真香的部分)

    配置

    llama-server \
      --model  Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-Q6_K_P.gguf \
      --spec-type draft-mtp \
      --spec-draft-model Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-FastMTP-32K.gguf \
      --spec-draft-ngl all --spec-draft-n-max 3 --spec-draft-p-min 0 \
      --ctx-size 131072 --parallel 1 \
      --batch-size 2048 --ubatch-size 512 \
      --n-gpu-layers all --cache-type-k q8_0 --cache-type-v q4_0 \
      --flash-attn on --load-mode mmap --jinja \
      --host 0.0.0.0 --port 8080 --metrics
    

    实测(27B Q6_K_P + MTP,128K 上下文,280W)

    场景 prefill decode
    7K prompt(可预测文本) 395.4 t/s 39.7 t/s
    16K prompt(可预测文本) 414.4 t/s 37.4 t/s
    随机文本(低接受率) 308.4 t/s 25.3 t/s
    • 显存占用 29.8G / 32.6G(模型 + 128K KV + draft 全驻显存)
    • 272 秒连续输出 10000 tokens,稳定 36.7 t/s 不掉速
    • 跑完 GPU 立刻回落 17W —— 完全空闲

    对 Agent 工作流的意义:16K 的 prompt 40 秒内消化完,之后 decode 稳在 37~40 t/s。"大 prompt 快速吞吐 + 投机解码加速长输出"正是 coding agent 最吃重的两段。


    四、双卡翻车全过程(本文重点)

    时间线

    步骤 动作 结果
    1 双卡上机,llama.cpp 直接认出 ROCm0 + ROCm1(各 32G) ✅ 识别正常
    2 两卡各限 250W,跑双卡单实例(--split-mode layer) 💥 跑到"生成"阶段"啪"一声整机断电重启
    3 怀疑限功不够,降到 210W(GPU 总功耗仅 420W) 💥 还是断电
    4 重启后确认崩溃瞬间的功率确实 = 210W ⛔ 彻底排除"功率上限太高"
    5 换供电接口再试 💥 依旧断电
    6 最后发现:连发一句"你好"都会重启 🔑 关键线索

    🔑 转折点:一句"你好"就重启

    这一条把整个排查方向掰过来了。

    如果光是满载跑长任务才断,那还能怀疑"持续功耗过高"。但发一句"你好"(输出不到 10 个 token)也断,说明问题不在持续负载上:

    GPU 从空闲 12W 被唤醒到满载 300W+,这个瞬间跳变才是凶手。

    判据链总结

    降功率 → 仍然断电            ⇒ 不是"功率上限设太高"
    崩溃时功率确实等于设定值      ⇒ 不是"限功没生效"
    单卡同功率长期稳定            ⇒ 卡本身没问题
    发一句"你好"就重启            ⇒ 不是持续负载,是瞬态跳变 ← 关键
    

    断电后的后遗症

    反复跳闸几次后,只有一块卡被 amdgpu 接管了(dmesg | grep 'Initialized amdgpu' 只有一条、/dev/dri 里缺 card0),需要重启系统才能恢复。此时另一张卡物理上等于不存在(不耗电,对供电反而"安全")。


    五、为什么 1300W 电源也不够?(分析)

    先算总账:根本不是"瓦数不够"

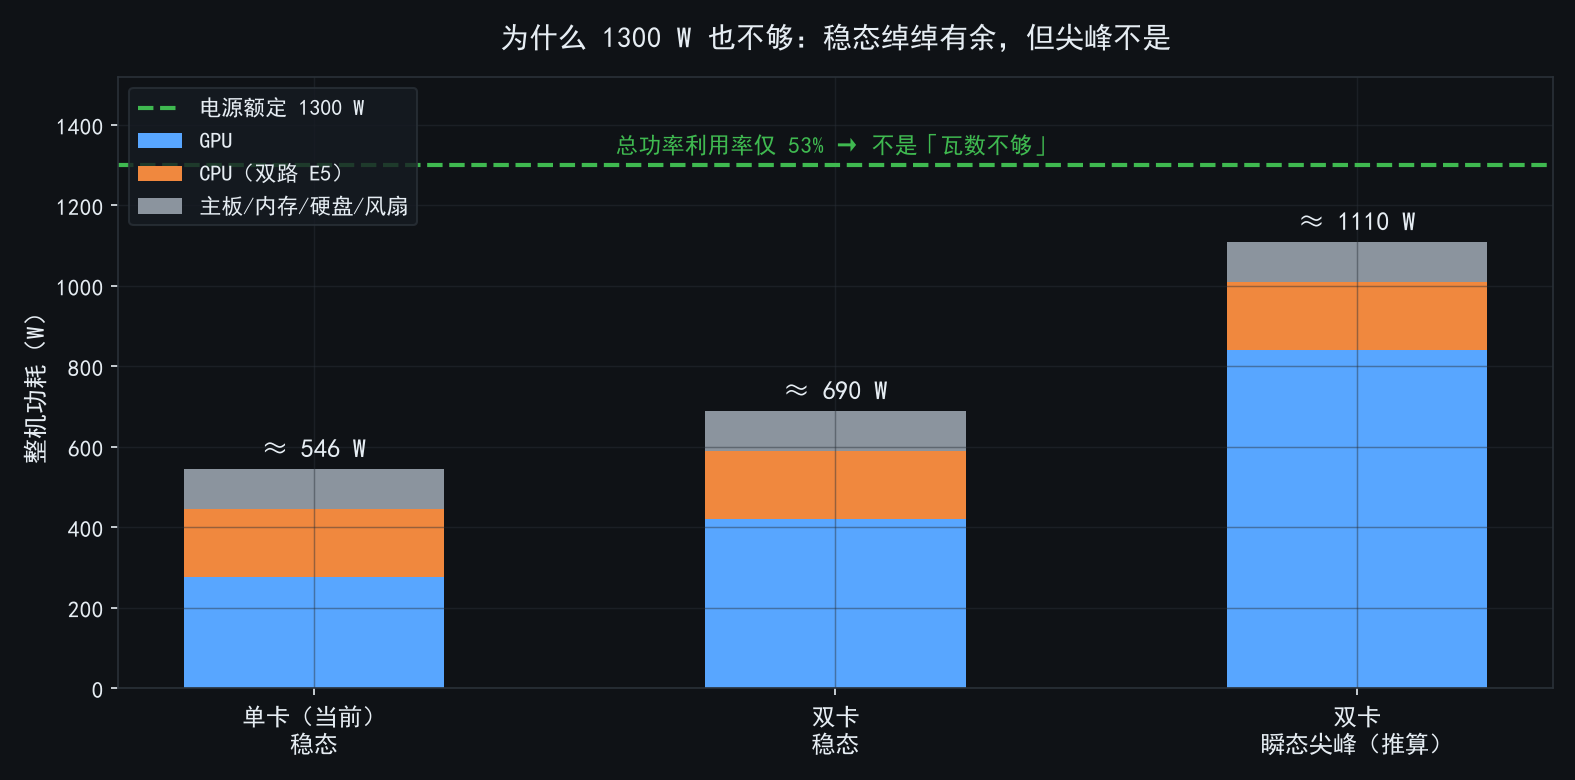
    单卡:276W(GPU) + 170W(双路CPU) + ~100W(平台) ≈ 546W
    双卡:420W(GPU) + 170W(CPU)   + ~100W(平台) ≈ 690W
                                      1300W 电源 → 利用率仅 53%
    

    总功率余量巨大,所以"1300W 不够"这个方向一开始就是错的。

    真相方向:瞬态尖峰 + 单路 12V

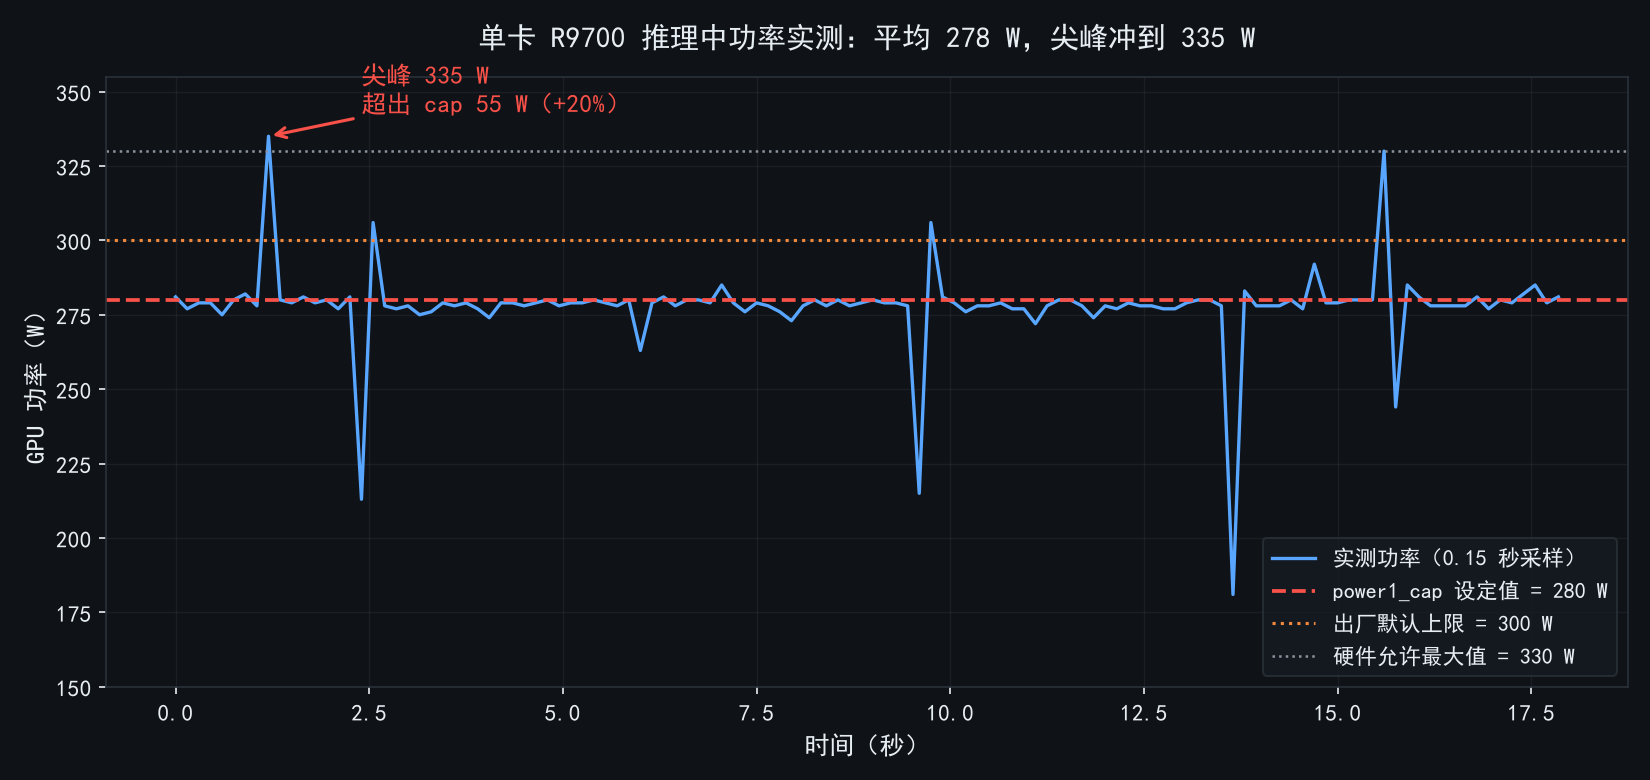
    证据一:power1_cap 根本拦不住尖峰

    单卡实测(0.15 秒采样,120 个点):

    平均 278 W     ← 贴着 cap 280W,说明 cap 在生效
    最大 335 W     ← 但尖峰冲高 20%!
    最小 181 W
    

    fig1_power.png

    cap 是平均值控制,控制回路有延迟。GPU 在微秒级尺度上可以瞬间抽走远超 cap 的电流。

    证据二:现代显卡的瞬态特性

    • 现代 GPU 的瞬态峰值可达稳态的 1.5~2 倍(ATX 3.0 规范正是为此要求电源支撑 200% 峰值)
    • AMD 卡在这块尤其出名(RDNA3 的 7900XTX 就因尖峰太猛有过不少翻车案例)
    • 两张卡同时从空闲跳到满载,尖峰叠加 → 单路 12V 电流跳变极猛

    推论(待验证):

    1300W 是总功率,但电源的 12V 是多路分配的。显卡走的那一(几)路 12V,在瞬态瞬间电流超出该路 OCP(过流保护)阈值 → 电源直接保护性关断。
    这也解释了为什么降 cap 完全没用:cap 管的是平均功耗,管不了 dI/dt。

    fig2_budget.png

    下一步打算(等验证)

    1. 查电源铭牌的分路规格(各 12V 路的额定电流)
    2. 换独立 PCIe 供电线(排除一分二/转接线瓶颈 —— 转接线是最常见的元凶)
    3. 必要时换更大/单路 12V 更强的电源
    4. 或者干脆双电源(显卡单独供电,用同步启动线)

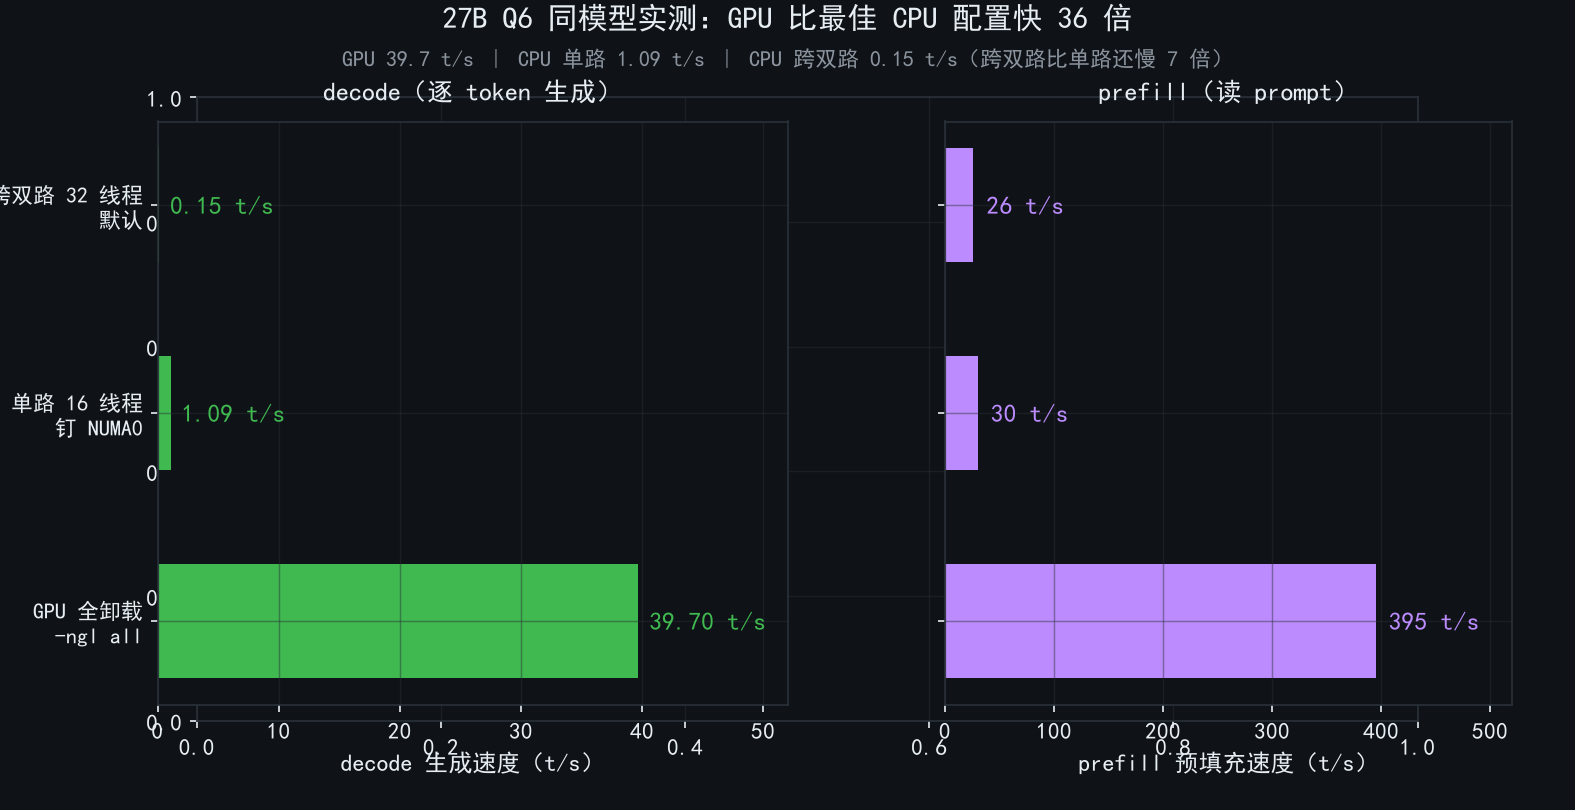
    六、附带实测:CPU 和内存能参与推理吗?

    能,但在这台机器上等于自残。

    配置 prefill decode
    GPU 全卸载(-ngl all) ~395 t/s 39.7 t/s
    CPU 单路 16 线程(numactl --cpunodebind=0 --membind=0) 30 t/s 1.09 t/s
    CPU 跨双路 32 线程(默认) 26 t/s 0.15 t/s ⚠️

    fig3_gpu_vs_cpu.png

    三个反直觉发现

    ① 跨双路比单路还慢 7 倍

    16 线程(单路,内存本地)  = 1.09 t/s
    32 线程(跨两路)          = 0.15 t/s   ← 慢 7 倍!
    

    llama.cpp 的 CPU 后端用自旋屏障做线程同步,双路 Xeon 之间的 QPI 延迟远高于片内;32 个线程跨 socket 同步时,屏障开销直接吃光带宽,叠加远端内存访存惩罚 → 比只用一路还惨。线程多 ≠ 快。

    ② llama.cpp 的 --numa 三种模式全部无效

    模式 decode
    --numa distribute 0.16 t/s
    --numa isolate 0.15 t/s(prefill 还被拖低 20%)
    numactl --interleave=all 0.15 t/s

    别指望参数绕过,只能靠 numactl 钉死单路。

    ③ 单路 1.09 t/s 是完全自洽的

    单路 2 通道 DDR4-2400 = 38.4 GB/s
    38.4 GB/s ÷ 24GB 模型 ≈ 1.6 t/s 理论上限
    实测 1.09 t/s = 68% 效率 ✓
    

    结论:decode 是纯带宽活(每 token 把权重读一遍)。模型能全装进显存时,让 CPU 参与纯属拖后腿;只有模型大于显存(如 70B Q4 = 39G 塞不进 32G)时,混合推理才有意义 —— 且那时必须钉单路。


    七、MTP(FastMTP)实测数据

    HauhauCS 的 FastMTP 补丁(改 src/models/qwen35.cpp,+27 行,实现 d2t draft 词表映射)+ 862MB 的 draft 模型。

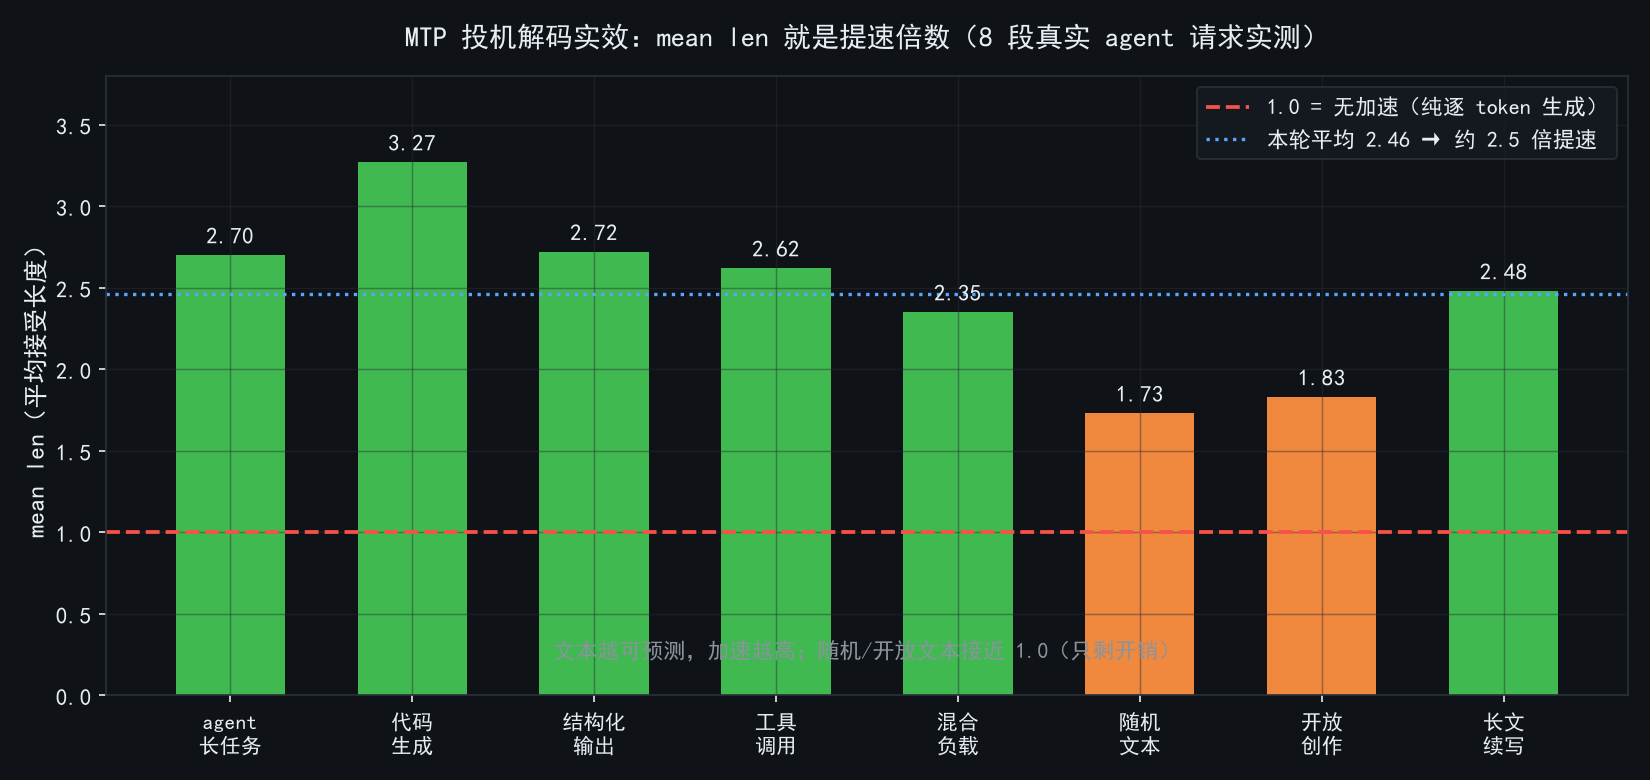
    关键指标是 mean len(平均接受长度),不是 acceptance % —— mean len 就是提速倍数:

    fig4_mtp.png

    8 段真实 agent 请求实测:mean len 在 1.73 ~ 3.27 之间,平均 2.46 → 约 2.5 倍提速。

    规律:

    • 代码生成 / 工具调用 JSON / 结构化输出 / 长文续写 → mean len 高(2.5~3.3),收益大
    • 随机文本 / 开放式创作 → mean len 掉到 1.7 附近,收益有限

    别把官方"3× 提速"当承诺 —— 收益完全取决于你生成内容的可预测性。


    八、给后来人的建议清单

    买之前

    • 先算供电账,别只算显存账:加卡的收益可能被"必须换电源"的代价吃掉
    • 老工作站平台(T7910/R7910 这类)标配电源是按
      当年 250W 级卡设计的,上现代 300W 卡要重算
    • 查清电源是
      单路 12V 还是多路,以及显卡走哪一路

    装机时

    • 大显存卡(24G/32G)
      必须开 BIOS Above 4G Decoding
    • RDNA4 需要
      6.12+ 内核(Ubuntu 24.04 要装 HWE)
    • 装完 ROCm
      第一件事:usermod -aG render,video <user> 并重新登录
    • systemd 跑服务要显式写
      SupplementaryGroups=render video + ExecStartPre=/bin/sleep 20

    调优时

    • power1_cap 只能限平均值,限不住瞬态尖峰 —— 这是本文最大的一个认知
    • 显卡功率限制
      不是 llama.cpp 的参数,在驱动层 sysfs(/sys/class/drm/card*/device/hwmon/hwmon*/power1_cap)
    • 抄启动命令前先
      --help | grep 验证参数名(新版改了一堆)
    • btop 在 RDNA4 上用
      1.2.13,并覆盖 /usr/bin/btop 本体

    排障时

    • 降功率后仍然断电 ⇒ 不是功率上限问题,别再往下调了(硬件下限是 210W)
    • 低频小请求也重启 ⇒ 是瞬态问题,不是持续负载
    • 软件层所有证据都对得上还挂 →
      回头查硬件(供电/接线)
    • 排查"明明修好了又崩"时,先
      diff 本地与远端脚本(本次踩过:本地旧副本覆盖了远端已修好的版本)

    九、当前状态

    ✅ 单卡 R9700 32G + Qwen3.8-27B Q6_K_P + FastMTP + 128K 上下文
       decode 39.7 t/s / prefill 395 t/s / 280W / 显存 29.8G
       已服务化(systemd 开机自启 + 崩溃自愈)
    
    ❌ 双卡 64G:暂不可用,等解决供电问题
    

    下一步:查电源分路规格 → 换独立 PCIe 线 → 必要时换电源 → 再战双卡。


    本文数据均为实机实测,硬件为自购。有踩过同款坑或者对单路 12V 有经验的朋友,欢迎在评论区指教。


  • [实测]m5 ultra 256G ds v4.1 flash oq3.5 97toks | qwen3.8 flash next oq6 143toks
    张光璞张 张光璞
    LLM讨论区 apple-m5 qwen-flash deepseek

    @stxpnet 说:

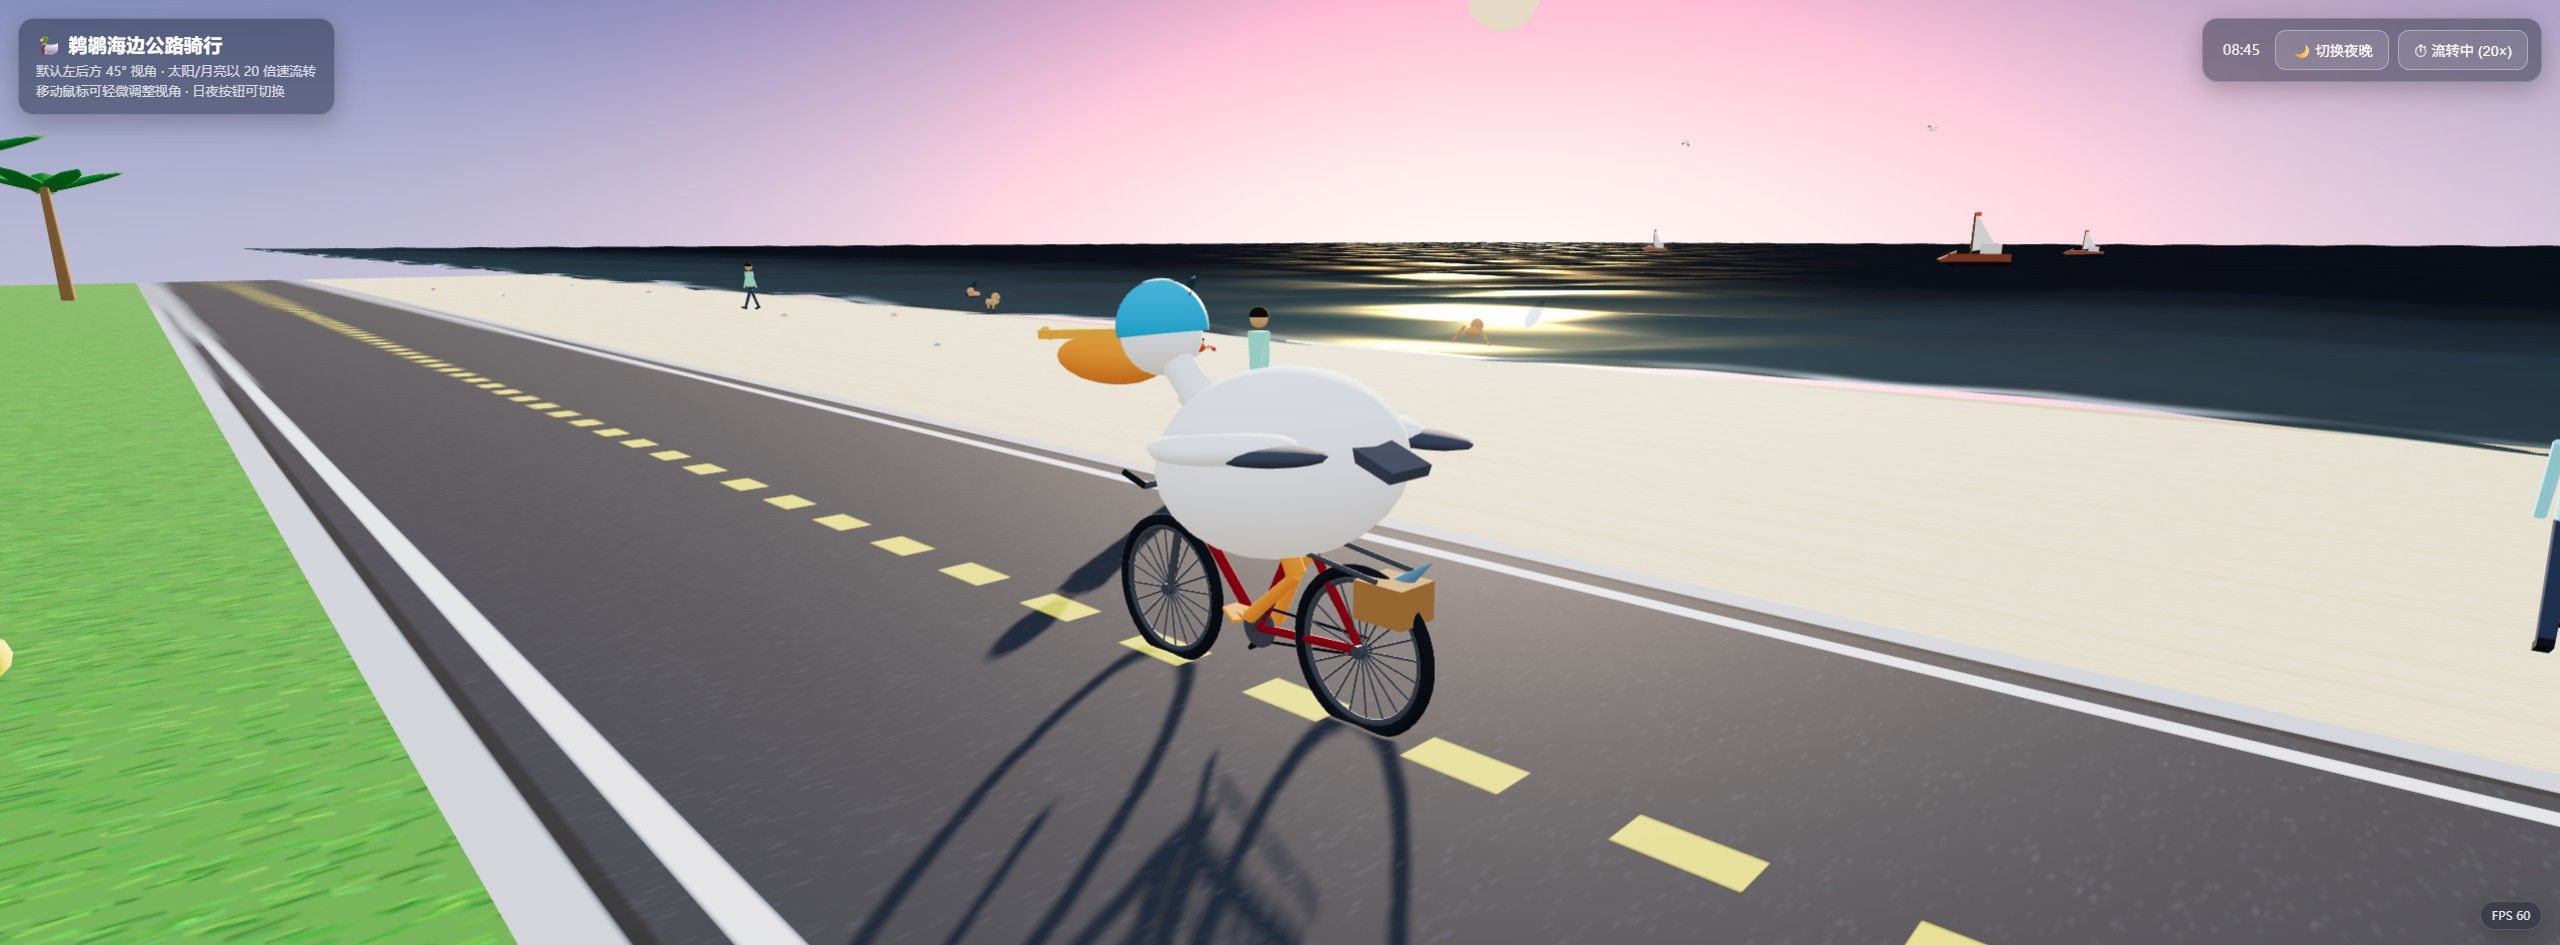
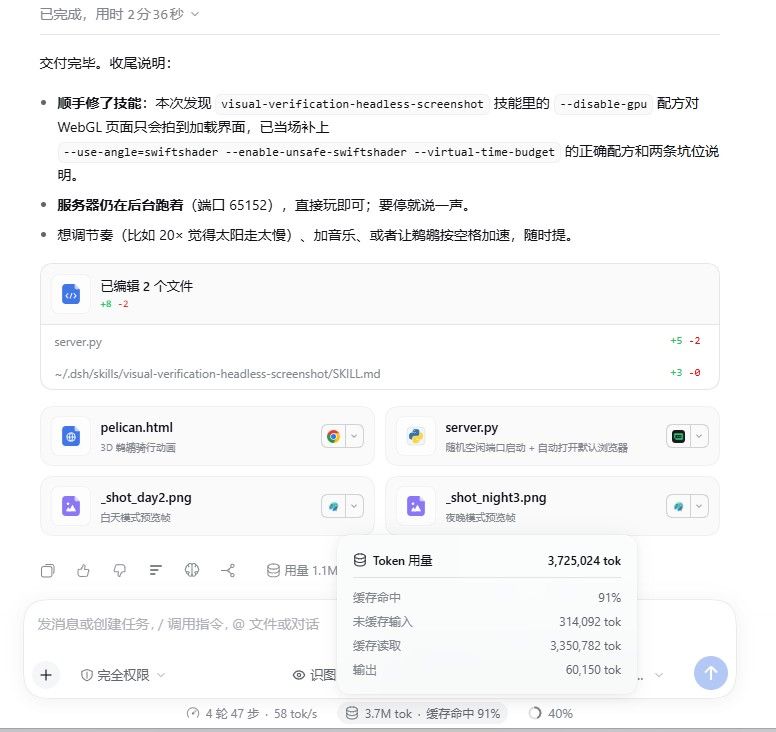
    画一个3D的 鹈鹕在海边公路骑自行车动画,用HTML5及必要的技术来展示,要求细节拉满,有美感,比例正确60帧不卡顿,默认从左后方向45度视角,有日夜切换按钮,太阳和月亮会随时间变化 运动(大概是20倍于现实中的时间流逝),鹈鹕左侧的路面增加一些花花草草,海里增加一些小鱼时不时的跃出水面,沙滩上有螃蟹及海螺,岸边有人散步,海里有些人游泳,远处有一些渔船,海上有一些海鸥随机飞翔。 夜晚天上加一些星星,保存为pelican.html(本机默认下载好three.js,如果没有也可以自动从中国CDN快速加载)。游戏要有server.py,启动后随机寻找一个本机的空闲端口作为服务器,并自动从默认浏览器打开让用户试玩.
    

    可以试试3D鹈鹕提示词,看多久可以完成,效果如何。

    双7900XTX 35分钟

    image.jpeg

    image.jpeg


  • X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s)
    张光璞张 张光璞
    AI硬件 x99 ai-pro-r9700 多卡部署

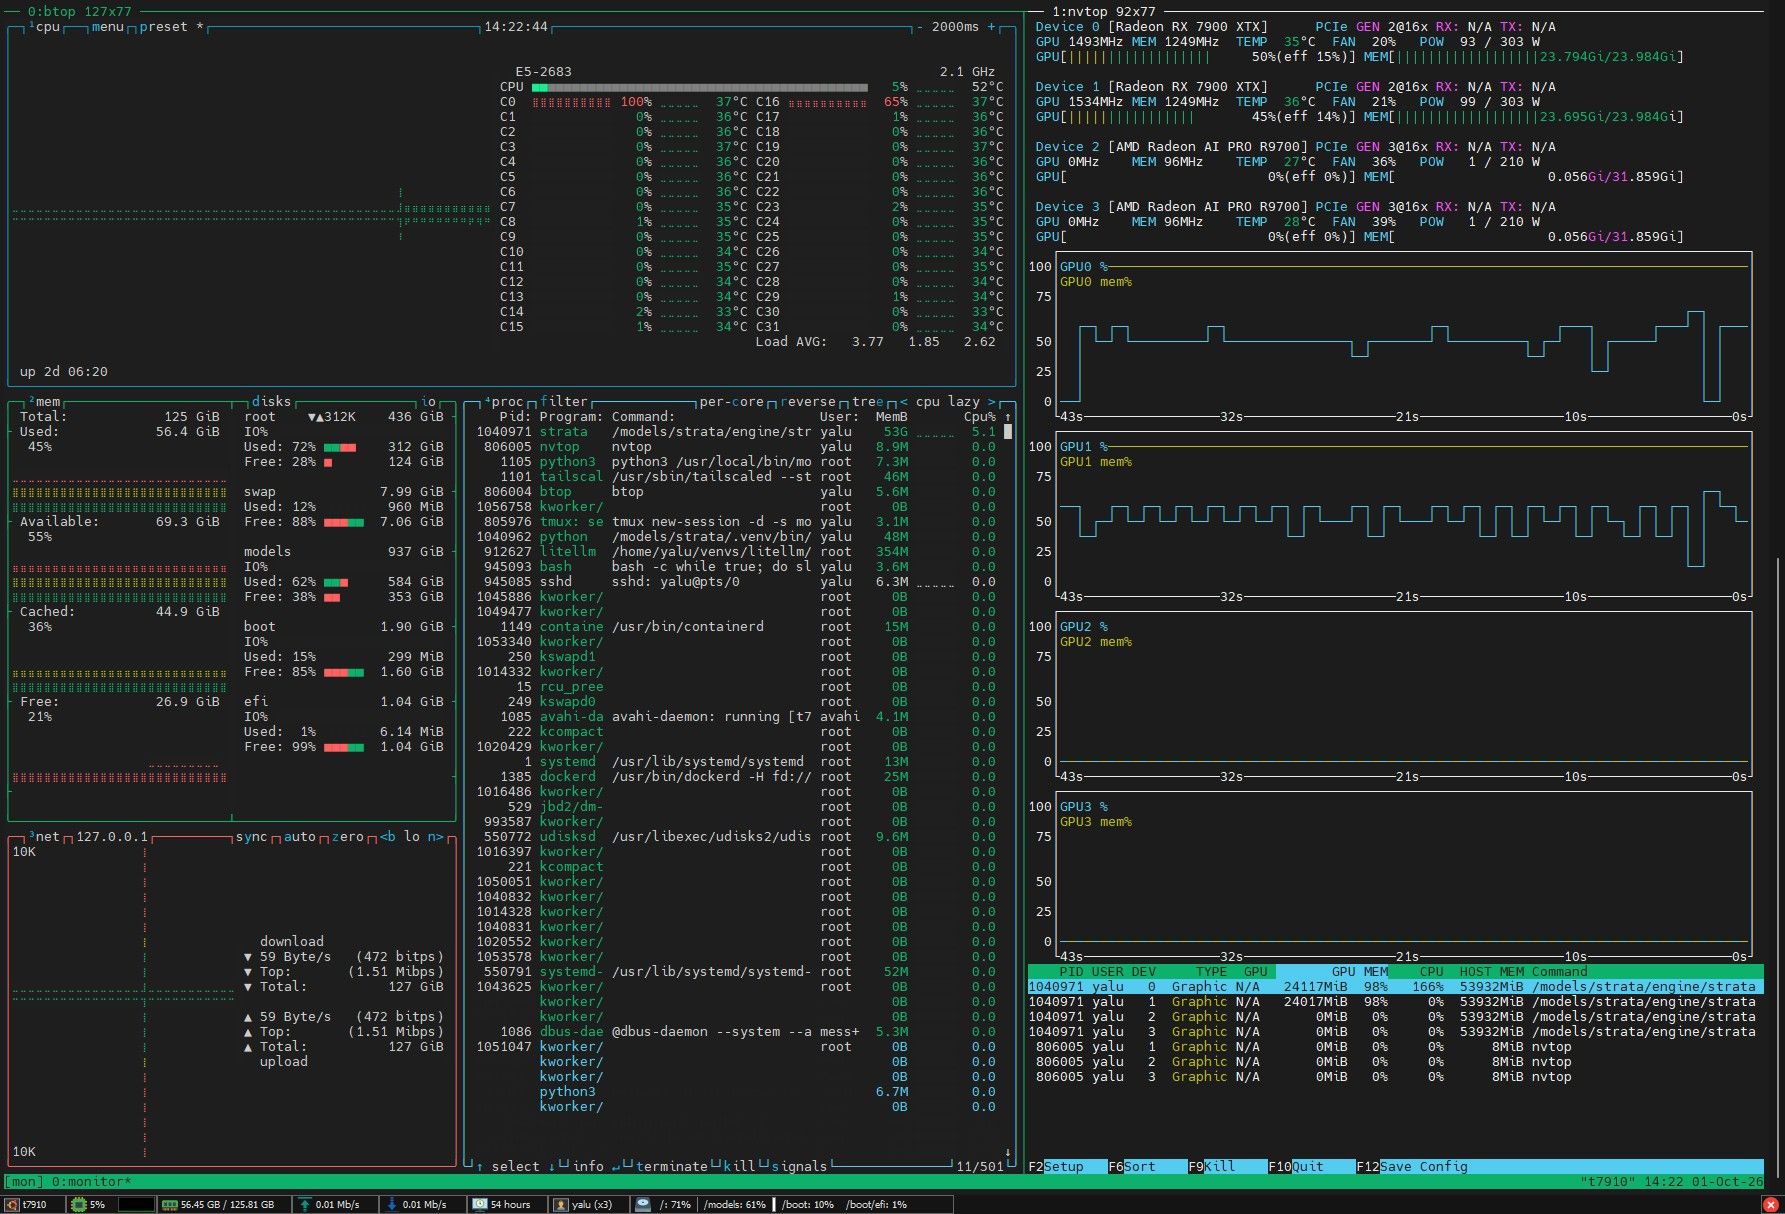
    完美,明天装机 双7900XTX

    f83d7ddd0e8b5c5396a1b108be859adc.jpg

    e379e1c49728b8a68f2faa825957509a.jpg


  • 就最近论坛中瞎带AMD多卡,多卡升级的错误言论的驳斥!小白一定要看。
    张光璞张 张光璞
    AI硬件 amd 多卡部署 rocm

    如果个人低强度用,一张9700 也够, 双97 或 7900xtx 是甜点区。

    但喜欢玩硬件的人 ,是闲不住要折腾的。


  • 【避坑指南】CMP 170HX 是一张完全不值得推荐的卡。没买的就不要入坑了。
    张光璞张 张光璞
    AI硬件 170hx

    卡商放出来的视频 ,都是跑27B,过百的速度,从不展示重载下,或显存吃满后的表现。

    这玩意,愿者上钩吧。


  • 7900xtx单卡魔改Strata跑Qwen3.8 flash next PP1300+ TG60-90
    张光璞张 张光璞
    LLM讨论区 7900xtx vllm qwen-flash

    @applejuice 说:

    @张光璞 不能把2块7900xtx 利用起来?

    折腾下 把r9700 跑起来

    已经双7900xtx了
    image.jpeg


  • 2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s
    张光璞张 张光璞
    LLM讨论区 7900xtx vllm 多卡部署

    @Ben-Lee 说:

    @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

    但是他TTFT 很慢


  • T7910 双卡本地推理全记录:7900 XTX 把两张卡跑掉总线,换 R9700 后大 BAR + P2P 一次打通,最后 4 并发 × 160K 稳跑
    张光璞张 张光璞
    AI硬件 7900xtx r9700 多卡部署

    @懒人烘培 说:

    可能和电源有关,我那7500F去带两张7900XTX,1200w电源完全能顶得住,观察显卡功耗(电源功率计查看)可能会瞬时到400W,然后回落,我看整机满载的时候最大值为980W,然后马上回落在900W左右

    不止400w 。多并发思考的瞬间感觉显卡功率是额定功率的近2倍。但也是毫秒级的。


  • M5 Max/Ultral AI性能强悍?苹果、AMD、英伟达AI小主机AI性能全面分析,潜力很大但统一内存并非万能!
    张光璞张 张光璞
    AI硬件 mac amd nvidia apple-m5 apple-m6

    @薛巨侠 说:

    256G m5 ultra和rtx pro5000的整机,个人使用,本地ai和轻度comfyui,minimax h3。怎么选呢?各位大神

    comfyui,minimax h3 《== 只这俩就锁死Pro5000了


  • 今天服务器很不稳定,要么挂死,要么重启。用墨水屏写了一个看板
    张光璞张 张光璞
    AI硬件 服务器 r9700 编程

    @kos-or 说:

    @张光璞 said:

    ESP32 EPDiy V7

    請問ESP32可以連上網路嗎? 如果可以的話 功用蠻多的
    這個當系統狀態顯示器蠻好的

    我最初的构想是用墨水屏的显示器,后来发现非常贵。

    后来看到类似这种电子相册的东西,我最初想用驱动板的USB做串口接到服务器上,后来发现在驱动板的串口是 ch340 那种烧录口跑数据不是很方便。

    最终改成了 现在的wifi 方案, 服务器走 TailScale 也约等于内网了。


  • M5 Ultra 256G VS 双DGX Spark,谁是本地AI王者?96G的 M5 Ultra值得买吗?它和RTX Pro5000搭配高端PC怎么选?
    张光璞张 张光璞
    AI硬件 mac dgxspark apple-m3 apple-m5

    双机 nvidia dgx spark 跑Deepseek flash v4 这种NVFP4 MOE 模型是最佳搭档,速度大几十,最最可贵的是即使上下文很大的时候,依旧掉速不明显,不像MAC ,只能聊天多并发长文就直接便秘。

    并且苹果特别鸡贼的是他的官司网 写的 x4.5 倍的增幅,是相对M1 Ultra 来说的。M3 Ultra 都便秘

    a69d7235-aa61-41a5-b060-e45a0c562964-image.jpeg


  • 我替大家趟趟路 T7910
    张光璞张 张光璞
    AI硬件 x99

    @laobenxiong 说:

    @张光璞 两张7900xtx, 供电线够吗? 白金版的话, 要6X 6+2pin; 另外, 有没有考虑过 t7920?

    我是想用最便宜硬件跑起来,这年头内存太贵了,吕布骑狗去,主要战力在吕布。


  • amd 公版w7900 划算吗,是否值得买?
    张光璞张 张光璞
    AI硬件 amd

    @kos-or 说:

    @mei-li said:

    3,4090d 48g魔改 京东自营 30199 ,这张卡5月到现在好像涨价1万,不知道我有没有记错。

    這個可能會對標 RTX Pro 6000 96GB 系列的漲幅
    RTX Pro 6000 96GB 一漲, 二三級顯卡就會跟著動
    接下來換二手卡跟著動

    4090 除了老,是个人可用的王者。 50系虽然强,功耗高,D型还阉割了训练没有大于32的显存。


  • (2026/9/8 更新)SGLang 投產實測:W7800 48GB 上嘅 gfx1100 fork + MTP-3 + DFlash 無人區
    张光璞张 张光璞
    AI硬件 amd sg-lang w7800

    以后的论坛模式变为:
    step1:让ai去读论坛内容,按学到的知识配置跑起来后ai发贴
    step2:发完贴攒一波评论
    step3:让ai读自己贴子评论后逐一测试。选出最终配置后总结发贴
    step4: 《 ==等抄作业的人学习自己的第二贴

    左脚踩右脚螺旋飞升!


  • Ubuntu + X99 雙 PCIe 3.0 x16,想上 2× AMD Radeon AI PRO R9700 32GB 跑 ComfyUI / MiniMax H3(Ref2VA),請教可行性與坑位
    张光璞张 张光璞
    AI硬件 ai-pro-r9700 x99 comfyui

    @Nero丶畅畅 说:

    抖音有一个用双r9700跑comfy ui的,可以搜索下看看

    视频不是不能双卡tp吗? 他是双卡双工作流吧


  • amd 公版w7900 划算吗,是否值得买?
    张光璞张 张光璞
    AI硬件 amd

    @kos-or 说:

    @mei-li said:

    1,蓝宝石r9700 基本上带保修价格11994,貌似最近有涨价,闲鱼有全新10900

    R9700 觀察了約兩個禮拜, 一個商店的未上漲前的原價全新10900 共11張已經被清空了, 另一個平台的原價全新10900 兩張 一放上去6小時內被清空

    目前電商平台能買到的只剩下上漲後約13600RMB的貨
    可能有其他管道還是能買到 10900 要花點時間問看看吧

    现在适合本地部署的模型、好模型越来越多了,感觉这个需求还会一直持续下去。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组