跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
懒人烘培懒

懒人烘培

@懒人烘培
德高望重 劳动模范
取消关注 关注
关于
帖子
123
主题
6
分享
0
群组
2
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 双RX7900XTX塞进同一机箱,满载温度成功压到 90℃以内
    懒人烘培懒 懒人烘培
    AI硬件 7900xtx 多卡部署

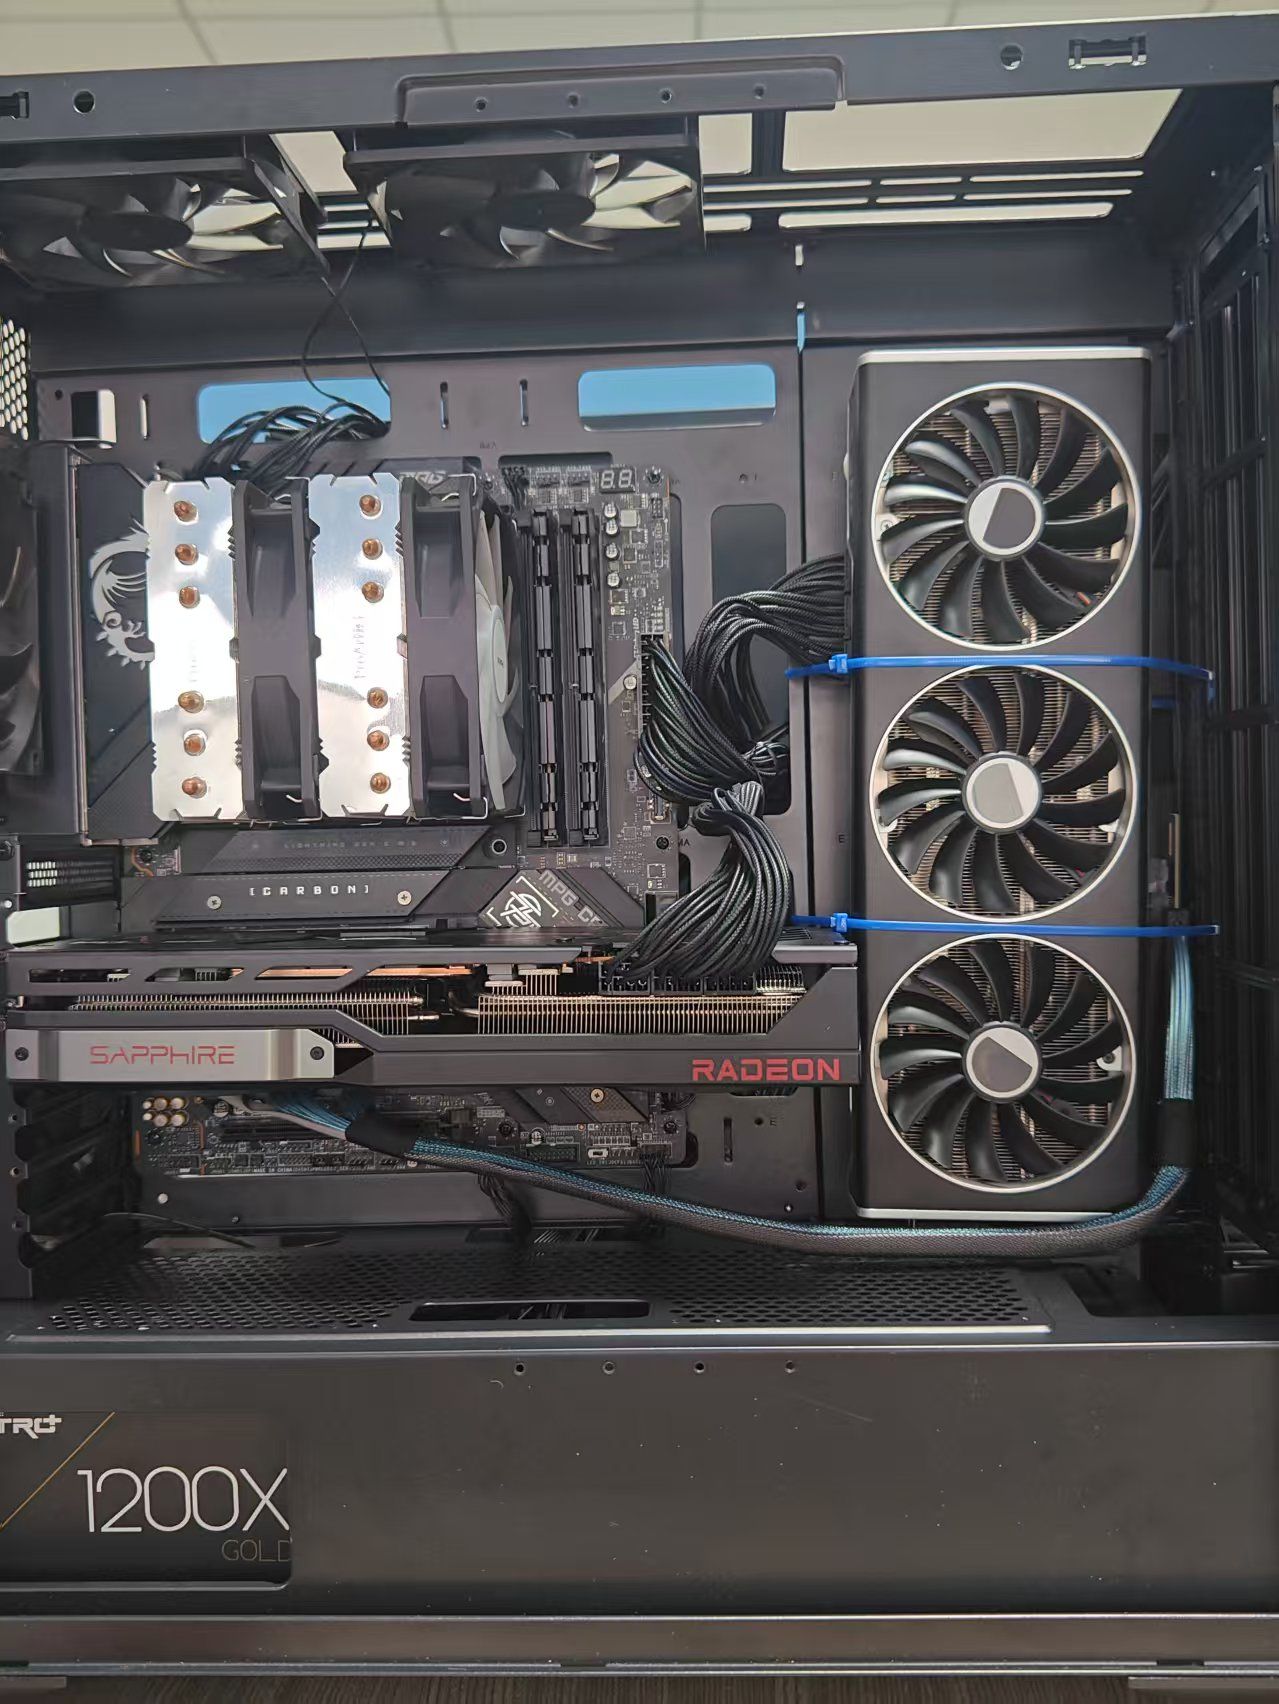
    感谢论坛里的各位大神,也配置了一套双7900XTX,并且成功装入机箱内。

    双 RX 7900 XTX 主机配置

    硬件 型号 / 规格
    CPU AMD Ryzen 5 7500F
    主板 微星 MSI MPG X670E CARBON WIFI
    内存 96 GB DDR5
    硬盘 1 TB
    显卡 1 蓝宝石 Sapphire Radeon RX 7900 XTX 白金版 24 GB
    显卡 2 XFX SPEEDSTER MERC 310 Radeon RX 7900 XTX 24 GB
    总显存 48 GB(24 GB × 2)
    机箱 鑫谷 探云 WS1 Ultra 工作站机箱

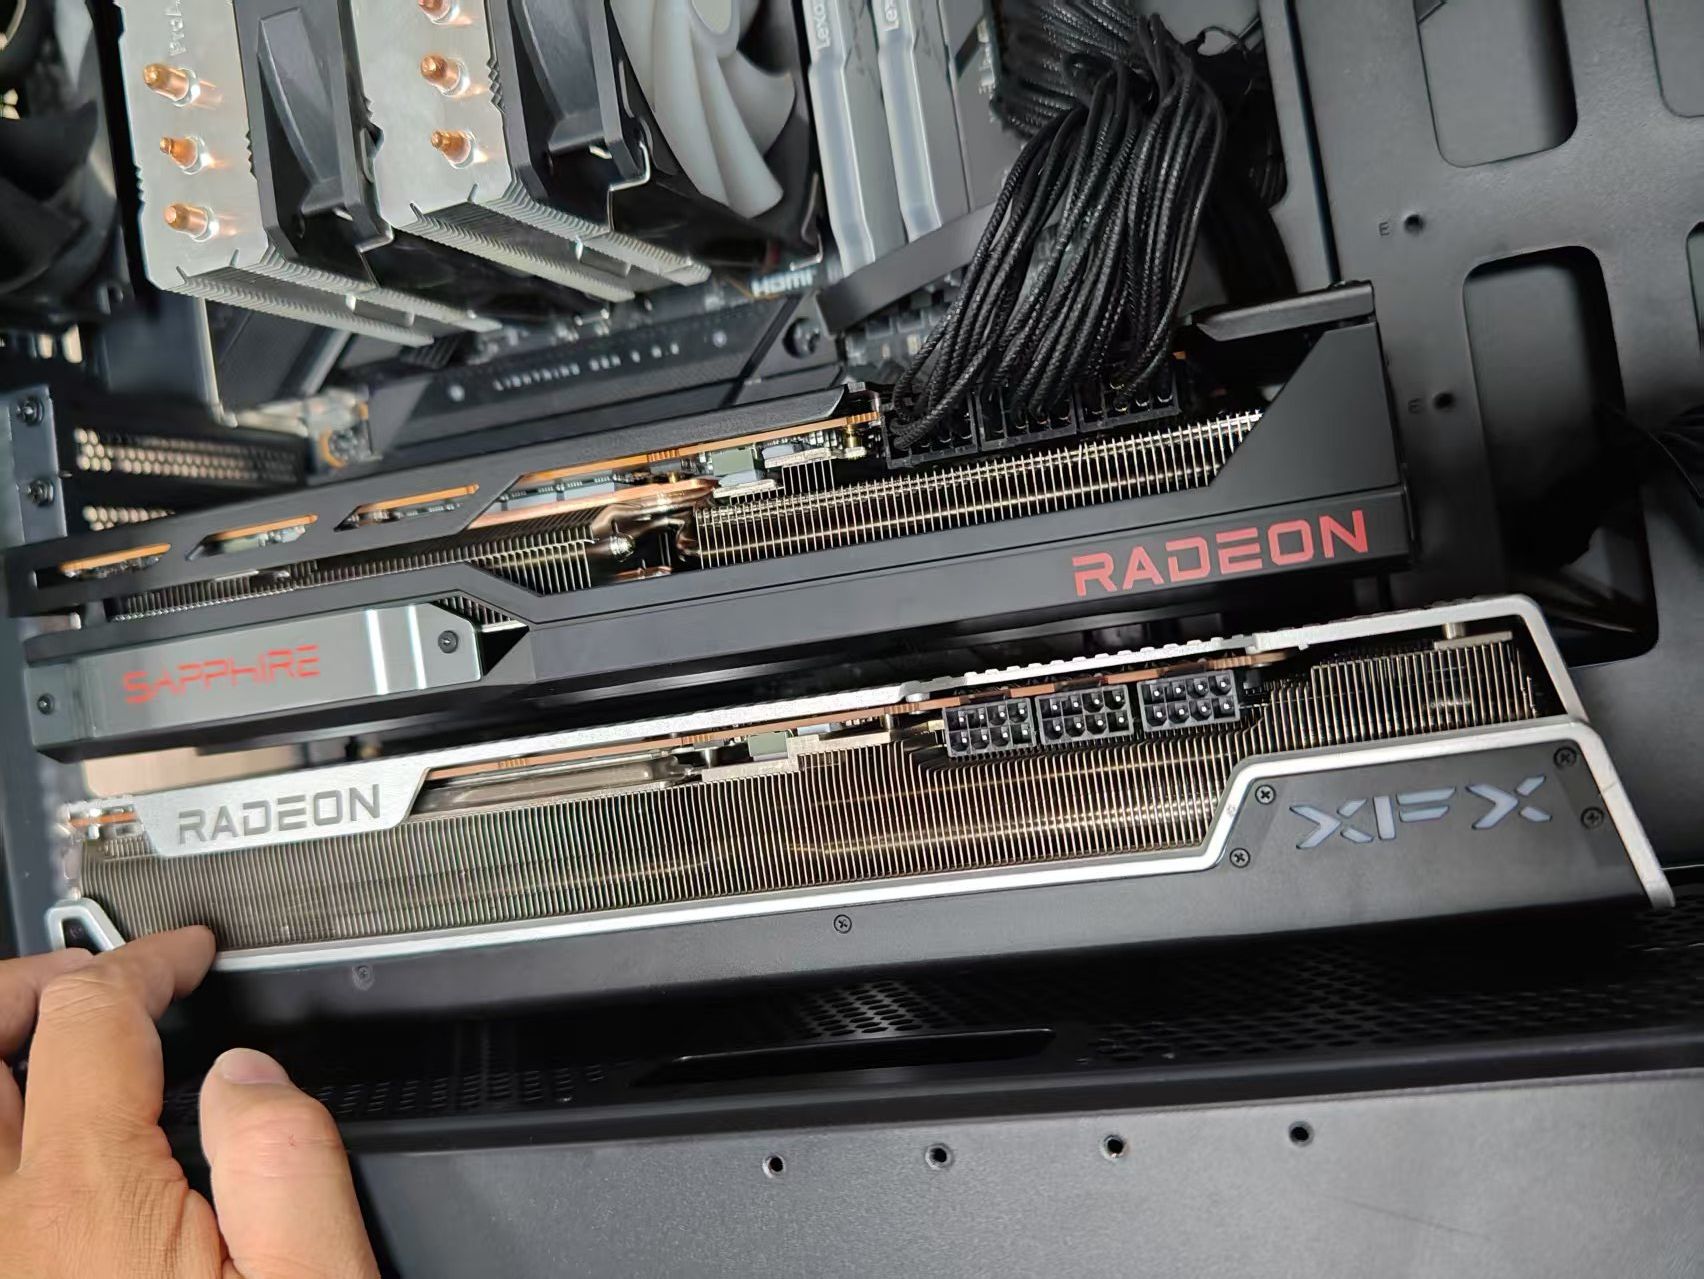
    主要是显卡安放问题,因为机器放在单位,所以不能用开放式机箱,之前安装双卡后的效果图:
    8be453ca-81be-4cdf-b39f-458124791917-微信图片_20260920221523_180_4.jpg

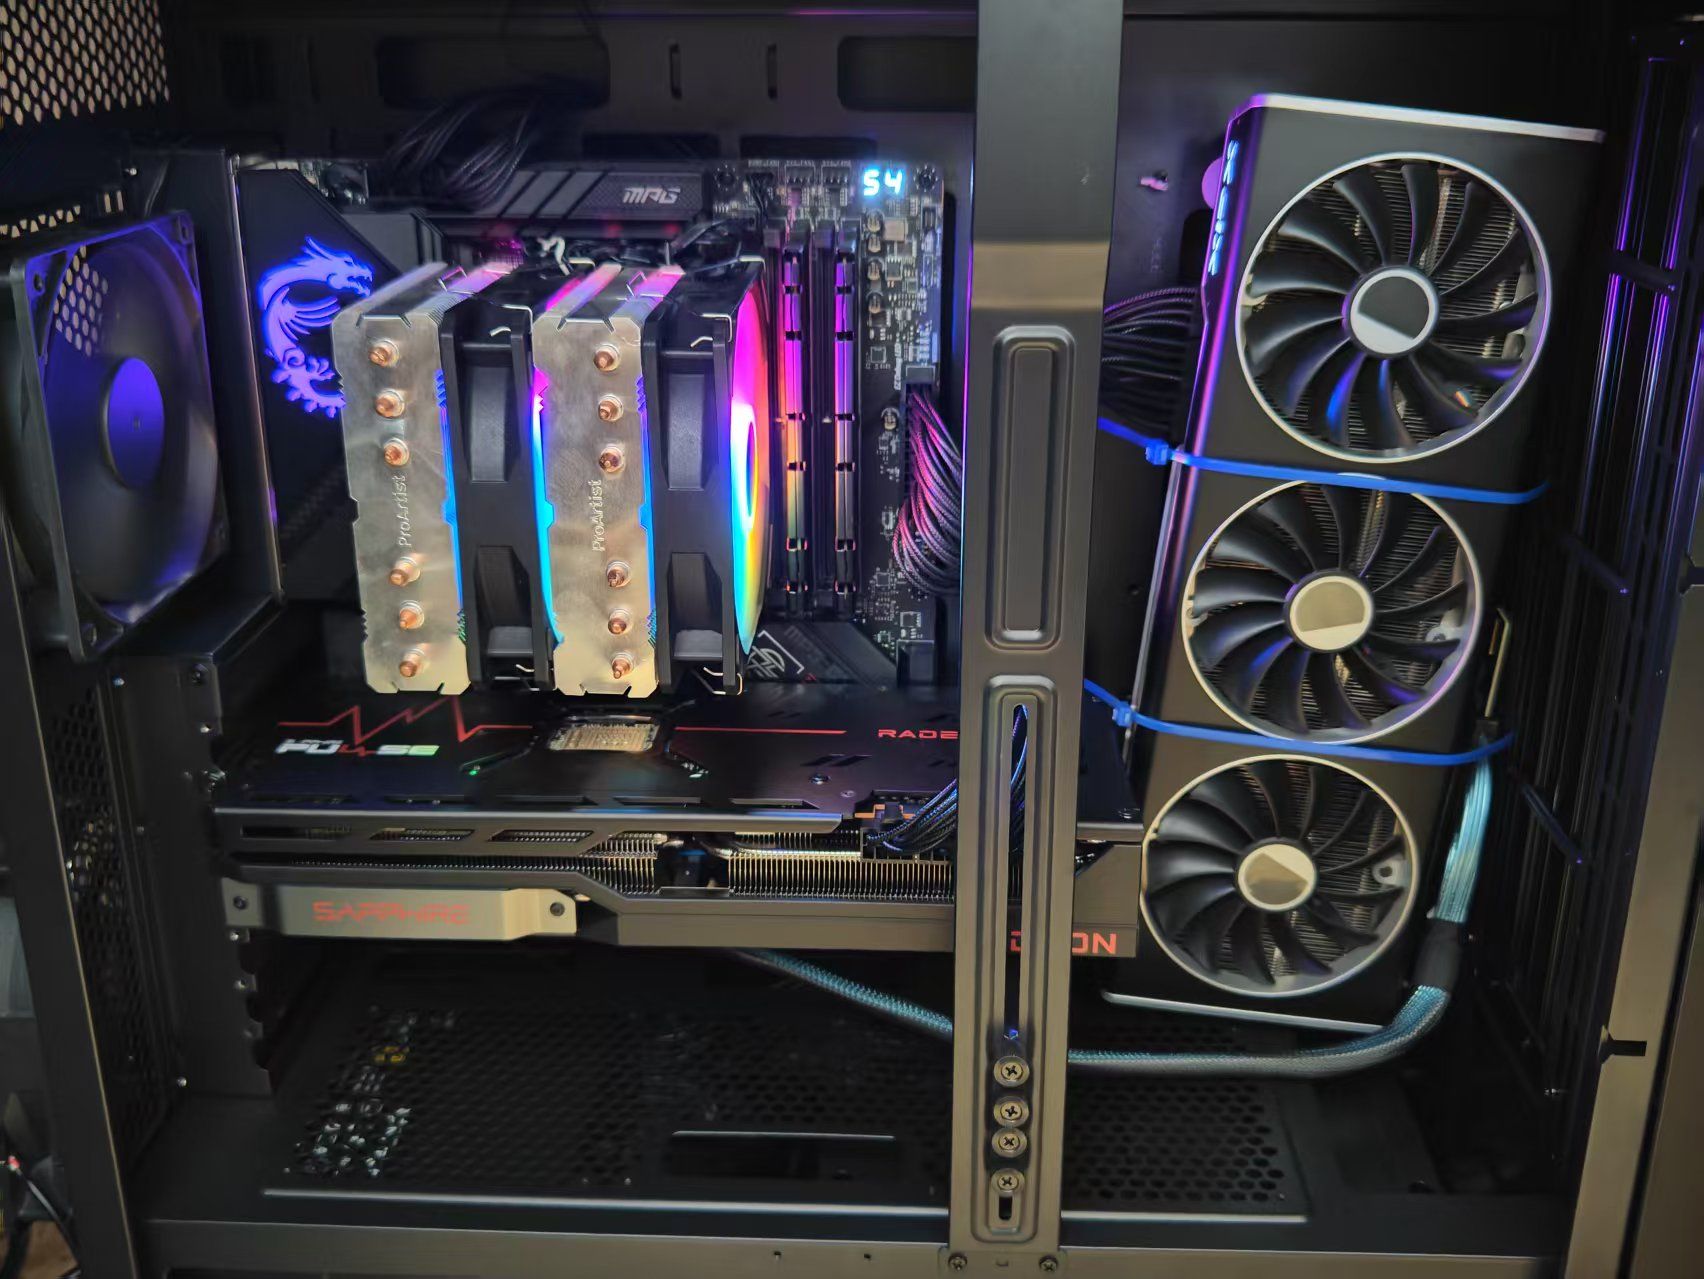
    两卡间距1cm,导致上卡满载会顶到110度,于是采取了倒立安装,以下是成品图:
    微信图片_20260920222035_181_4.jpg

    图中可以看到捆扎带,一切皆可用😁 😁 ,这个不是一般的捆扎带,是耐高温的,只有这个颜色,其实我想选择黑色的。
    满载温度表现,整体控制在90度内:
    微信图片_20260918154451_178_4.png

    需要注意的是这套配置满载功率在933W,功率还是比较高的。
    以上仅给出双卡装入机箱的方案,欢迎讨论。


  • 双7900XTX:vLLM Prefix Cache 与 SGLang HiCache 实测对比
    懒人烘培懒 懒人烘培
    LLM讨论区 7900xtx vllm sg-lang

    首先感谢各位大佬,跟着论坛的技术帖子进行部署。

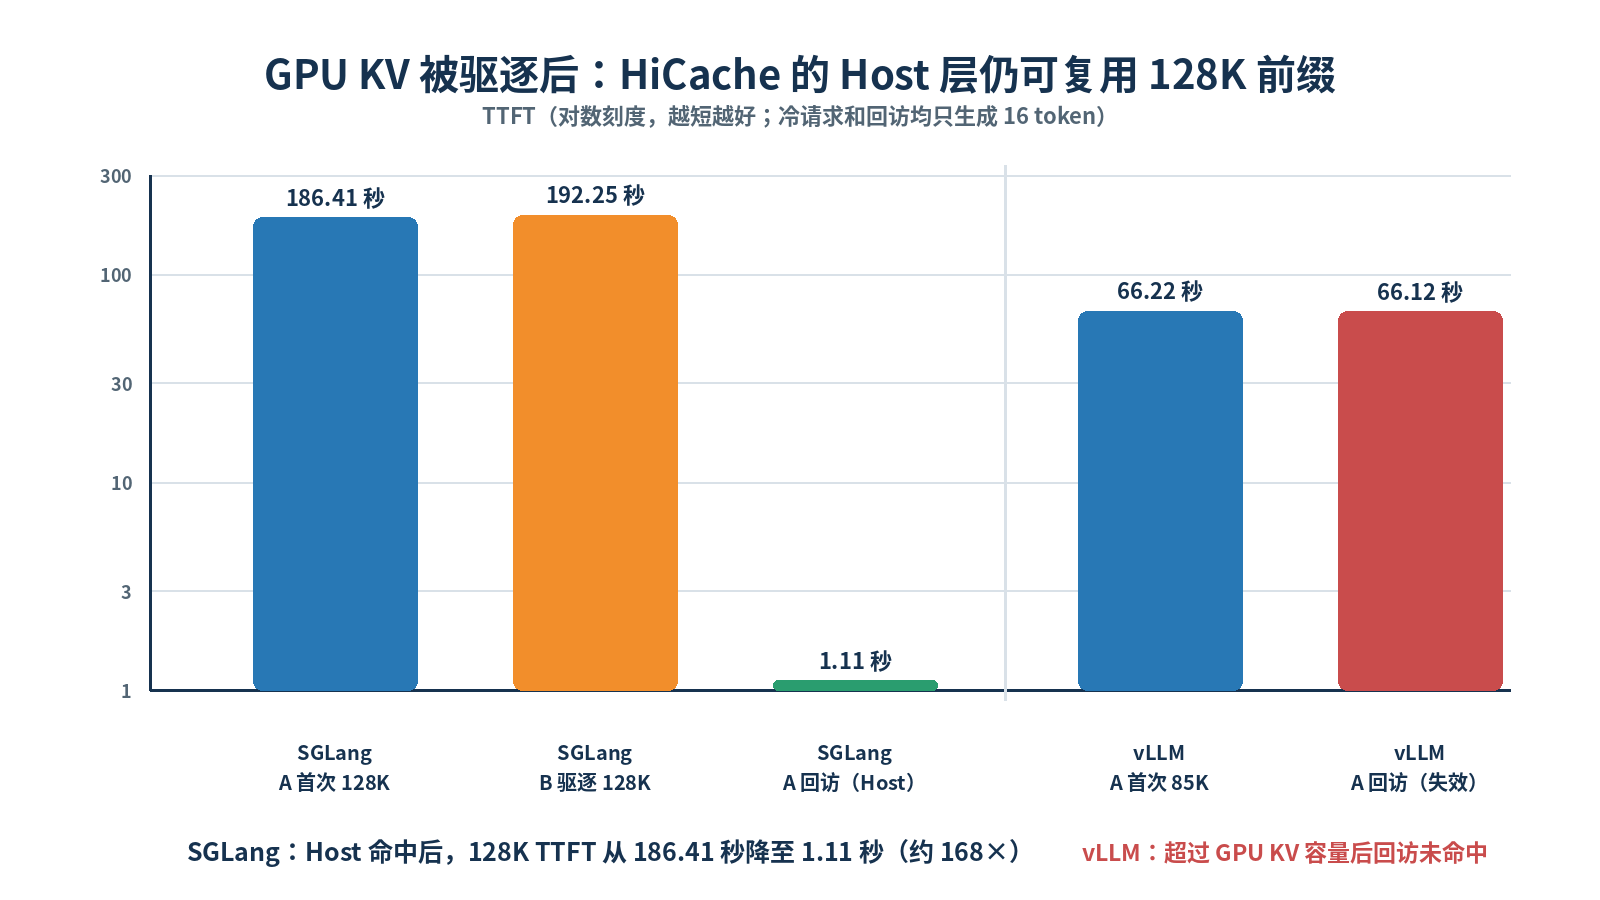
    结论先说:在这台双 RX 7900 XTX 上,vLLM 的冷请求在 8K–85K 全部更快;两者在“同一前缀立刻再问一次”时都能把首字等待压到约 0.14–1.25 秒。进一步将最早的 128K 前缀挤出 GPU KV 后,SGLang HiCache 仍能从主机内存回载 125,952 token,把 TTFT 从 186.41 秒降至 1.11 秒;当前 vLLM 配置在对应的 85K 驱逐回访中没有 prefix-cache 命中。

    测试口径

    • CPU:AMD Ryzen 5 7500F
    • 内存:96 GB DDR5
    • 主板:MSI MPG X670E CARBON WIFI
    • 硬盘:1 TB NVMe SSD。
    • GPU:2 × AMD Radeon RX 7900 XTX 24 GB,TP=2
    • 主模型:Qwen3.8-27B-W4A16-AutoRound-GPTQ
    • 单并发、固定随机 token、temperature=0、同一档位冷/热使用同一 seed
    • 冷请求:指定长度输入、512 输出;热请求:紧接同一前缀、16 输出。
    • vLLM 版本:0.1.dev1+g874bfa3f1.d20260911,87,040 最大上下文、FP8 KV、Triton attention、prefix caching。
    • SGLang:0.5.6.post3.dev10769+gf84475ccf,196,608 最大上下文、BF16 KV、Triton attention、DFLASH,以及 HiCache(size=12, ratio=2.0, kernel, write_through)。

    SGLang 启用了 DFLASH、BF16 KV 和 HiCache;vLLM 使用 FP8 KV、未启用投机解码。因而这是一套“当前实际可用配置”的对比,不是只切换框架二进制文件的纯引擎 A/B。

    冷请求:vLLM 在本轮配置下领先

    冷请求的 512 输出使 E2E 同时含 prefill 与 decode;长上下文交互最关键的 TTFT 单列展示。

    输入 vLLM TTFT SGLang HiCache TTFT vLLM E2E SGLang HiCache E2E
    8K 0.22 s 4.65 s 9.06 s 10.39 s
    16K 0.29 s 10.34 s 9.85 s 12.87 s
    32K 0.54 s 24.59 s 11.55 s 27.64 s
    64K 1.26 s 65.07 s 15.21 s 69.18 s
    85K 0.64 s 100.21 s 16.54 s 113.45 s
    128K —(上限 87K) 192.71 s — 199.03 s

    85K 的 vLLM TTFT 比 64K 更低并不代表规模越大越快;这是单样本下 kernel/JIT、调度和测量抖动共同造成的非单调点。严谨排名应至少每档重复三次并取中位数。

    热前缀:两者都能显著降低首字等待

    热请求只生成 16 token,所以只比较 TTFT 与按完整输入长度计算的等效输入吞吐。该吞吐表示跳过了多少 prefill,不代表模型真实进行同等速度的重新计算。

    输入 vLLM TTFT SGLang HiCache TTFT vLLM 等效输入吞吐 SGLang 等效输入吞吐 SGLang cache 来源
    8K 0.22 s 0.14 s 16.9k tok/s 22.4k tok/s GPU 7,936 / host 0
    16K 0.29 s 0.19 s 28.3k tok/s 50.9k tok/s GPU 15,936 / host 0
    32K 0.54 s 0.29 s 37.2k tok/s 73.6k tok/s GPU 31,936 / host 0
    64K 1.25 s 0.48 s 38.8k tok/s 94.1k tok/s GPU 63,936 / host 0
    85K 0.63 s 0.54 s 79.2k tok/s 84.9k tok/s GPU 84,992 / host 0
    128K — 0.87 s — 109.4k tok/s GPU 127,936 / host 0

    怎么理解这组结果

    1. 一次性长文处理:选 vLLM。 本轮 vLLM 冷路径从 8K 到 85K 的 TTFT 都明显低于 SGLang HiCache。
    2. 重复同一上下文:两者都够快。 同前缀热命中后,两边都进入秒级以下到约 1 秒的 TTFT;日常多轮对话和固定系统提示词都能受益。
    3. HiCache 的独特价值在 GPU KV 被驱逐后。 常规热请求仍在 GPU KV 内时,两者都很快;补测中,SGLang 将 128K A 挤出 GPU KV 后仍从 host HiCache 回载 125,952 token,使 TTFT 保持在 1.11 秒。
    4. vLLM 不能测 128K。 当前桌面 vLLM 启动器上限是 87,040,所以 128K 只有 SGLang 数据,不能用来做框架胜负判断。

    补测:GPU KV 被驱逐后,HiCache 的 host 层确实生效

    这一轮专门验证此前未覆盖的 host-memory 路径,全部使用 16 输出 token,关注 TTFT 和缓存来源。

    引擎 序列 首次 A TTFT 驱逐后 A TTFT 回访缓存结果
    SGLang HiCache 128K A → 不同 128K B → A 186.41 s 1.11 s 125,952 cached tokens;device=0,host=125,952
    vLLM prefix cache 85K A → 5 个不同 85K 前缀 → A 66.22 s 66.12 s Prefix cache hit rate: 0.0%

    SGLang 的 B 写入后,A 已不在 159.7K-token 的 GPU KV 容量内;回访时 cache report 明确显示所有可复用 token 均从 host HiCache 回载。TTFT 从 186.41 秒降至 1.11 秒(约 168×)。

    vLLM 启动日志报告 GPU KV 总容量约 443.6K token;A 加上 5 条不同的 85K 前缀约为 510K token,足以触发驱逐。A 回访与首次 TTFT 基本相同,且服务日志为 0% prefix-cache hit。这说明当前这套 vLLM 配置只有 GPU 前缀缓存,没有可用于该工作负载的 host 层回载。

    hicache-host-eviction-ttft.png

    hicache-cold-performance.png

    为什么本机日常服务限制在 85K

    这台机器不是不能处理 128K:SGLang HiCache 已验证可以完成 128K 冷请求,也能在前缀被 GPU KV 驱逐后从主机内存快速回载。但日常服务仍设为 85K,原因是它是更均衡、更稳定的常用档位:

    1. 冷请求等待更可控。 SGLang HiCache 的 85K TTFT 约 100 秒,128K 约 193 秒;上下文增加约 1.5 倍,首字等待接近翻倍。对单次长文、临时提问和 Agent 任务而言,85K 的体感明显更好。
    2. 保留更多 GPU KV 余量。 当前日常 85K 配置可用 GPU KV 容量约 233k token,适合单用户长会话及后续多轮追问;128K HiCache 配置的 GPU KV 容量约 159.7k token,余量更紧。
    3. HiCache 让长上下文按需可用。 真正需要 128K 的重复代码库、长文档或 RAG 前缀时,可以启用 HiCache;即使旧前缀已被挤出 GPU KV,补测仍能以 1.11 秒 TTFT 回载。

    因此,本机的实际取舍是:85K 作为默认常驻配置,优先保证日常交互与容量余量;128K + HiCache 留给确实需要超长上下文、且能从前缀复用中获益的任务。

    2ec0efa6a1bf7376dc7e748b79d1fcc5.jpg


  • 7900XTX双卡TP,SGLang多并发飞速响应,本地AI神卡最后短板被补齐!配套主板和内存如何选择?
    懒人烘培懒 懒人烘培
    AI硬件 7900xtx sg-lang 多卡部署

    @terry 看你的视频买了第一张全新蓝宝石7900XTX,今天看了@flyer666买了第二张7900XTX(二手),新的太贵了,已入坑。哈哈


  • 双7900XTX跑SGLang:HiCache 开不开?128K 长上下文冷/热路径实测
    懒人烘培懒 懒人烘培
    LLM讨论区 7900xtx sg-lang 多卡部署

    首先感谢各位论坛的大神,跟着这大神的帖子进行了配置,以下是本机的测试效果。

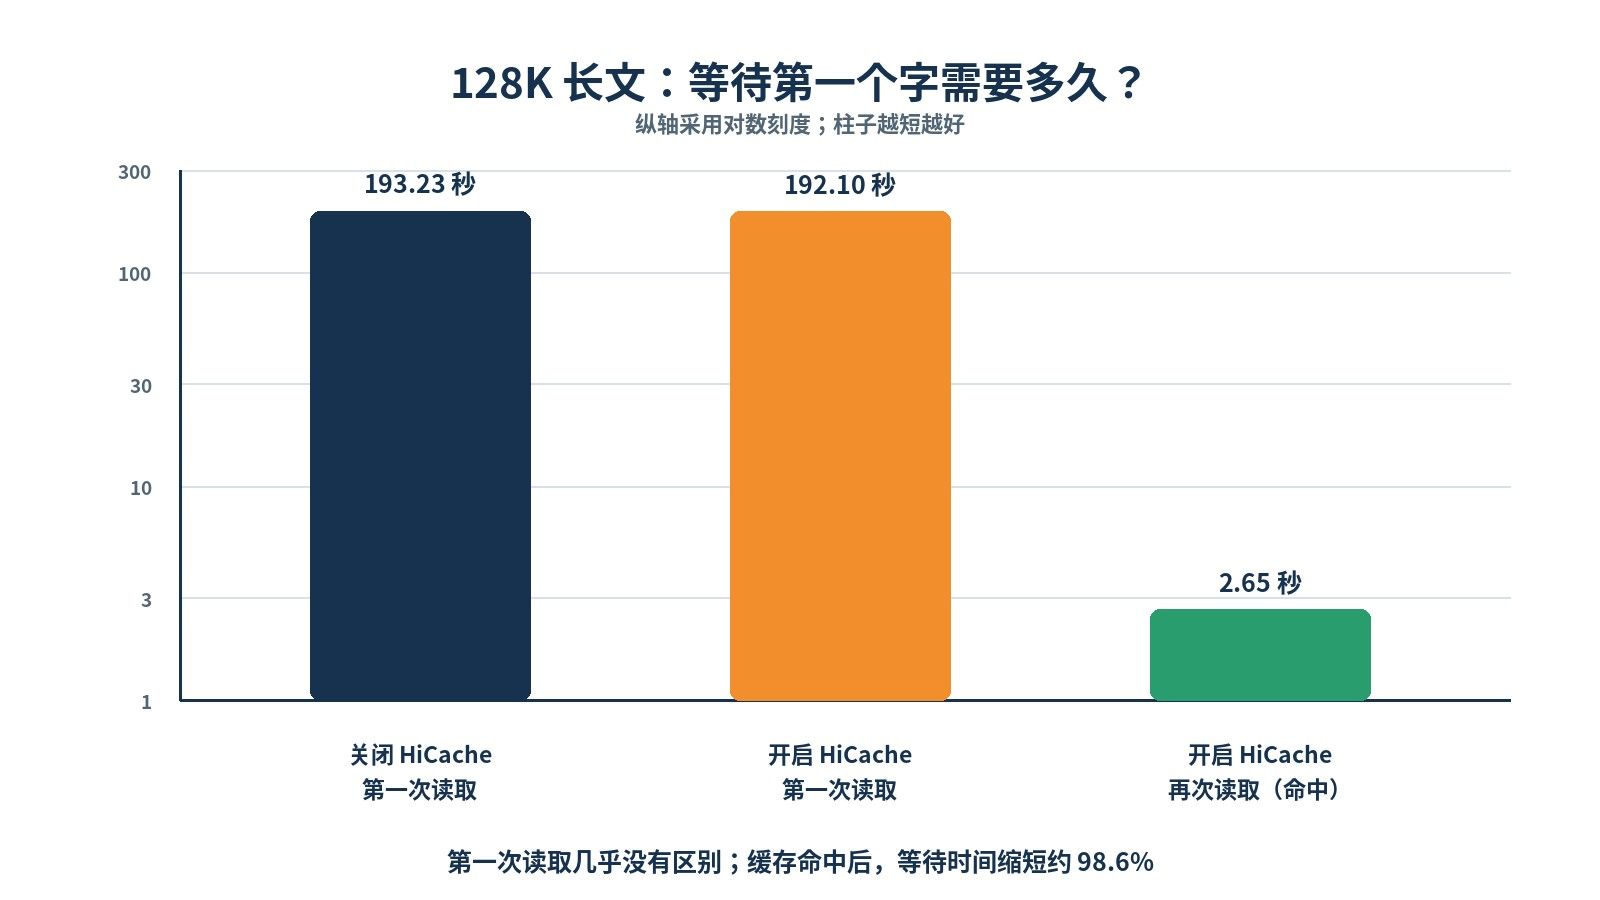
    先说结论:HiCache 不会让模型第一次阅读长文时变快,但可以记住已经读过的内容。再次使用同一份长文时,模型就不必从头重读。

    在这台双 7900 XTX 机器上,第一次处理 128K 长文,无论是否开启 HiCache,都要约 192 秒才开始回答;再次使用同一份长文时,只要约 2.65 秒就能开始回答。多轮对话、反复分析同一个代码仓库、重复使用同一批知识库文档时,收益非常明显。


    1. 解释 HiCache

    可以把 128K 长上下文想象成一本很厚的书。

    • 第一次提问:模型需要从头读完整本书,再开始回答。无论是否开启 HiCache,这一步都省不了,所以都要等待约 3 分钟。
    • 开启 HiCache 后:模型读书时会把已经计算好的“读书笔记”暂存在电脑内存里。
    • 再次针对同一本书提问:模型可以直接加载这些笔记,不必重新读完整本书,因此约 2.65 秒就能开始回答。
    • 如果每次提交的内容都完全不同:旧笔记用不上,开启 HiCache 不但没有明显帮助,还会多占内存并产生少量缓存开销。

    本次测试最直观的结果如下:

    实际场景 开始回答前要等多久 整个请求耗时 通俗解释
    关闭 HiCache,第一次提交 128K 长文 193.23 秒 201.74 秒 模型需要完整读一遍。
    开启 HiCache,第一次提交 128K 长文 192.10 秒 206.60 秒 仍需完整读一遍,同时保存缓存。
    开启 HiCache,再次使用同一份长文 2.65 秒 3.25 秒 直接复用上一次的计算结果。

    等待第一个字的时间对比(柱子越短越好):
    dd291e93-2f40-40e8-89c4-8c7c536cba2a-image.jpeg

    换句话说:

    HiCache 不会让模型第一次阅读长文时变快;它真正加速的是“同一份长内容被再次使用”的场景。

    所以,如果你只是偶尔让模型总结一篇长文,没必要专门开启 HiCache;如果你在做多轮 Agent、连续追问同一个代码仓库,或者很多问题共享同一批 RAG 文档,HiCache 就很有价值。

    文中几个性能名词是什么意思?

    名词 通俗解释 数值怎么看
    128K 输入给模型的内容长度,大约 12.8 万个 token 越长,模型第一次阅读通常越慢。
    TTFT 从发送问题到看到第一个字的等待时间 越低越好,最影响“响应快不快”的体感。
    E2E 从发送问题到整个回答完成的总时间 越低越好。
    Prefill 模型阅读并理解输入内容的阶段 长文的大部分等待时间都花在这里。
    输入吞吐 模型每秒能处理多少输入 token 越高越好,但缓存命中后的数字属于等效速度。
    冷请求 这份内容之前没有缓存,必须重新计算 相当于第一次读书。
    热命中 这份内容已经缓存,可以复用计算结果 相当于直接翻阅读书笔记。

    2. 测试平台

    项目 配置
    GPU 2 × AMD Radeon RX 7900 XTX,24 GB/卡,gfx1100
    并行 Tensor Parallel = 2
    推理框架 SGLang 0.5.6.post3.dev10769+gf84475ccf
    模型 Qwen3.8-27B-W4A16-AutoRound-GPTQ
    权重 / KV GPTQ / BF16 KV cache
    Attention Triton
    投机解码 DFLASH,draft=Qwen3.8-27B-DFlash2-W4A16,8 draft tokens,window=2048
    压测工具 SGLang benchmark.serving,backend=sglang
    请求 固定随机输入 128,000 token;单并发;temperature=0;同一随机种子

    HiCache 参数

    参数 关闭 开启
    enable_hierarchical_cache false true
    hicache_size 0 12
    hicache_ratio 2.0 2.0
    hicache_io_backend kernel kernel
    hicache_host_memory_mode cache cache
    hicache_write_policy write_through write_through

    3. 128K 实测结果

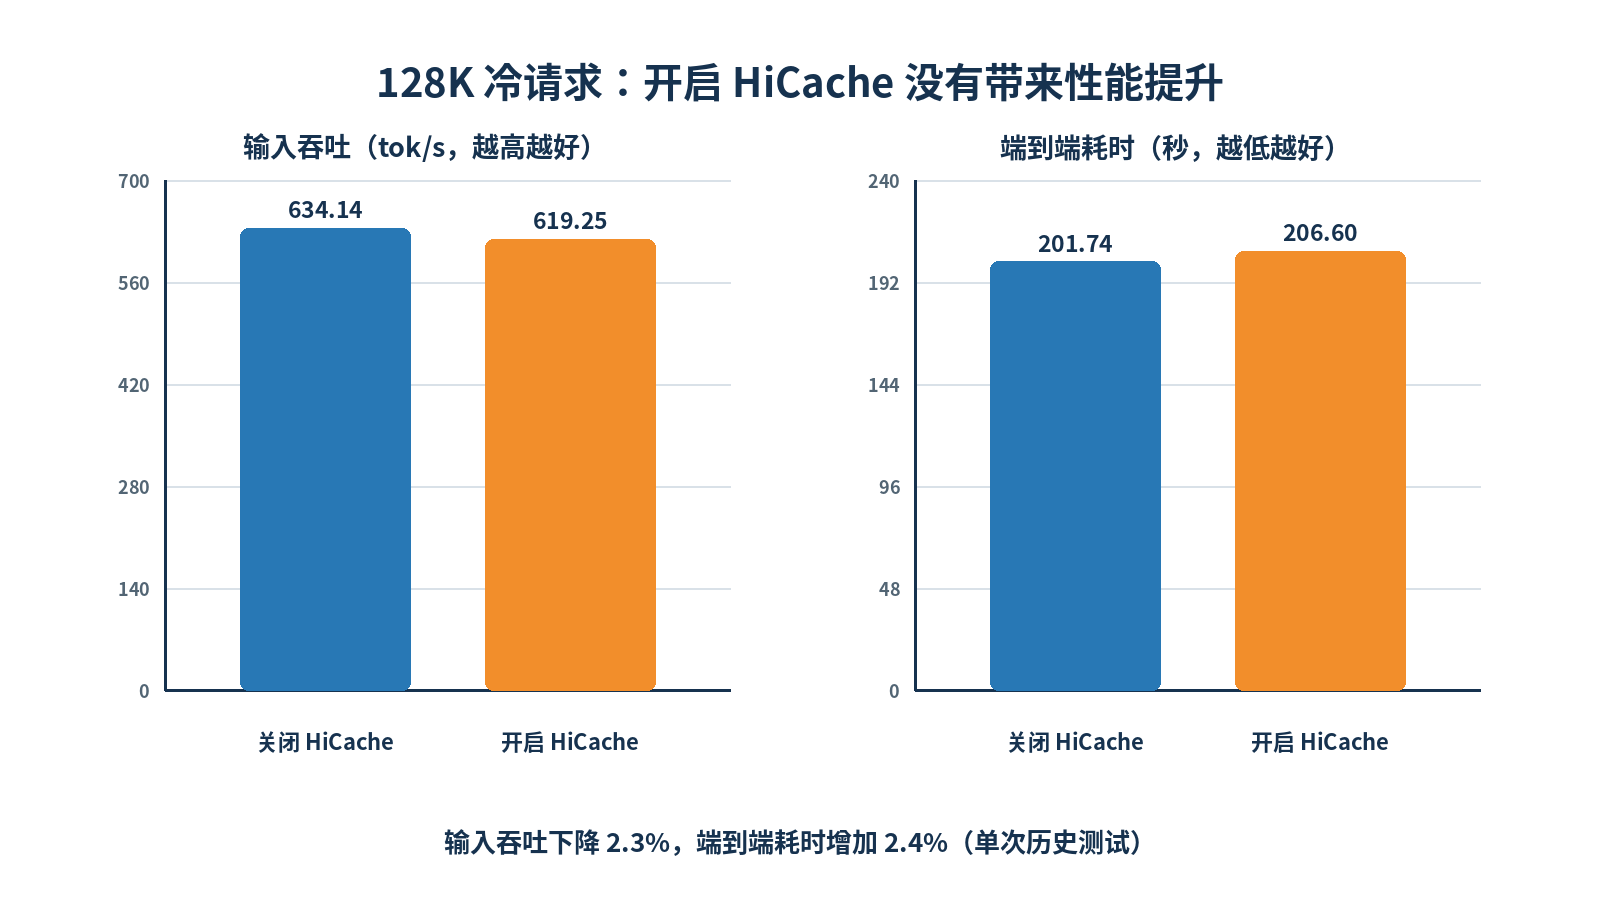
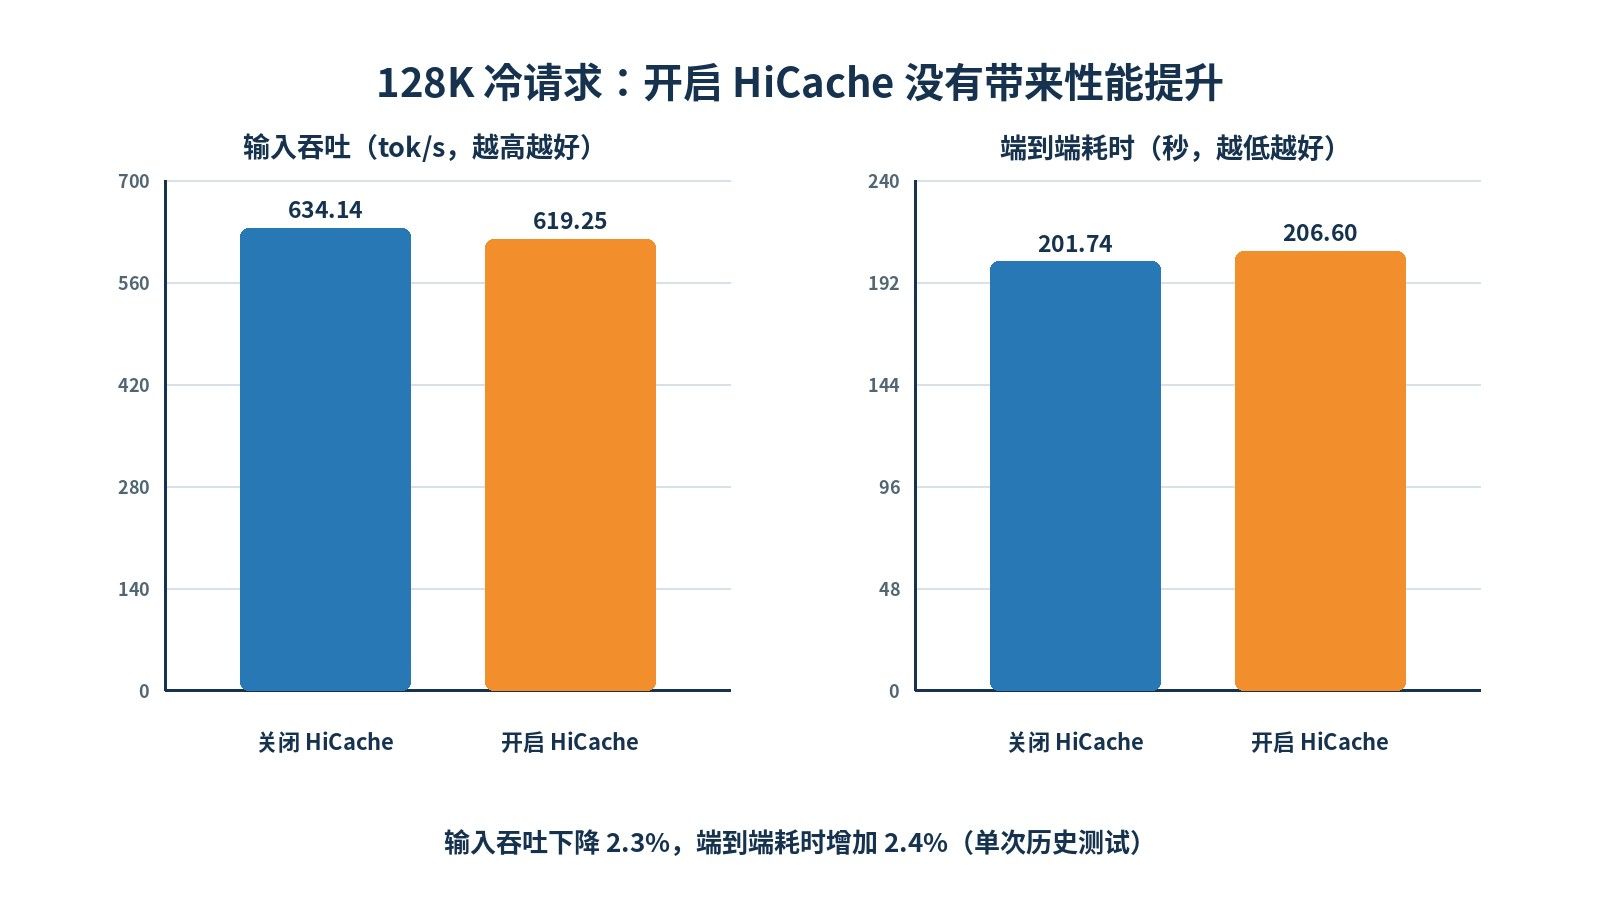
    3.1 冷请求:开 HiCache 不会减少 prefill 计算

    两组均为 128K 输入、512 输出、单并发、无 warmup,且冷测均清缓存。

    场景 输入吞吐 TTFT E2E TPOT DFLASH 接受长度
    不开 HiCache 634.14 tok/s 193.23 s 201.74 s 16.66 ms 5.79
    开 HiCache(冷) 619.25 tok/s 192.10 s 206.60 s 28.37 ms 3.58
    开 HiCache 相对变化 -2.3% -0.6% +2.4% +70.3% -38.2%

    冷路径的 TTFT 差异不足 1%,可以当作持平;输入吞吐和 E2E 则说明 HiCache 没有为“从未处理过的 128K Prompt”加速,反而带来约 2% 的总时延开销。TPOT 变慢较明显,不过 DFLASH 接受长度也不同,单次数据不能把这部分完全归因于 HiCache。

    8ab3aedd-fdf4-458f-a055-0d6eb493b7d0-image.jpeg

    3.2 热命中:同一个 128K 前缀的复用价值

    先用 128K / 512 token 的请求填充 HiCache,然后在不清缓存的情况下再次请求同一随机前缀;热测只生成 16 token,因此只比较 prefill / 首 token / E2E,不拿它的 TPOT 与上表横比。

    场景 输入 / 输出 输入吞吐 TTFT E2E
    开 HiCache(冷) 128K / 512 619.25 tok/s 192.10 s 206.60 s
    开 HiCache(热命中) 128K / 16 38,204.61 tok/s 2.65 s 3.25 s
    热命中收益 61.7× TTFT -98.6% E2E -98.4%

    这里的“38K tok/s”是压测端以完整 128K 输入长度计算的等效吞吐,不代表模型真的重新做了 38K tok/s 的 prefill;正是因为绝大部分 KV 从 host cache 回载,服务端跳过了原本最重的长前缀计算。

    4. 该不该开?

    使用模式 建议 原因
    单次摘要、一次性超长文档 默认关闭 冷 prefill 不加速,且有小幅性能/显存容量代价。
    多轮 Agent 会话 开启 system prompt、历史对话和工具定义经常完全复用。
    RAG:多个问题共享长文档 开启 第一个请求填充,后续请求能直接吃到热缓存。
    大量彼此无关的短请求 先关闭并实测 命中率低,缓存换不来回报。

    还有一个容易忽略的取舍:本次测试中,开启 HiCache 的服务器可用 GPU KV 容量为 159,692 token,关闭时为 233,207 token,减少约 31.5%。它用 GPU KV 空间换取 CPU 内存层级缓存,适合“容量与复用”,而非纯 GPU 性能冲榜。

    5. 一键复现:只切换 HiCache 的严谨 A/B

    下面脚本刻意让两组启动参数相同,只在 EXTRA_HICACHE_ARGS 处切换,避免把上下文长度、并发、显存比例等变量混进结论。

    5.1 环境变量

    export SGLANG_PYTHON=/home/USER/sglang-qwen/.venv/bin/python
    export MODEL_PATH=/path/to/Qwen3.8-27B-W4A16-AutoRound-GPTQ
    export DRAFT_MODEL_PATH=/path/to/Qwen3.8-27B-DFlash2-W4A16
    export PORT=30010
    export MODEL_NAME=qwen3-8-27b-w4a16
    

    5.2 启动基线(关闭 HiCache)

    EXTRA_HICACHE_ARGS=""
    
    "$SGLANG_PYTHON" -m sglang.launch_server \
      --model-path "$MODEL_PATH" \
      --served-model-name "$MODEL_NAME" \
      --host 127.0.0.1 --port "$PORT" \
      --tp-size 2 --quantization gptq --dtype bfloat16 \
      --kv-cache-dtype bfloat16 --attention-backend triton \
      --context-length 131072 --mem-fraction-static 0.80 \
      --max-running-requests 1 --chunked-prefill-size 2048 \
      --enable-cache-report \
      --speculative-algorithm DFLASH \
      --speculative-draft-model-path "$DRAFT_MODEL_PATH" \
      --speculative-draft-model-quantization compressed-tensors \
      --speculative-num-draft-tokens 8 \
      --speculative-draft-window-size 2048 \
      $EXTRA_HICACHE_ARGS
    

    5.3 启动 HiCache 组

    关闭基线服务后,保留上面的完整命令,只把第一行替换为:

    EXTRA_HICACHE_ARGS="--enable-hierarchical-cache \
      --hicache-size 12 --hicache-ratio 2.0 \
      --hicache-io-backend kernel \
      --hicache-host-memory-mode cache \
      --hicache-write-policy write_through"
    

    hicache-size 的单位和适合的取值会受 SGLang 版本、模型 KV 大小与主机内存影响。这里的 12 是本机已跑通的参数,不是所有机器的通用最优值。

    5.4 冷 / 热压测命令

    # 冷请求:每次压测前清服务端缓存,记录 prefill 性能
    "$SGLANG_PYTHON" -m sglang.benchmark.serving \
      --backend sglang --host 127.0.0.1 --port "$PORT" \
      --dataset-name random --random-input-len 128000 --random-output-len 512 \
      --num-prompts 1 --max-concurrency 1 --request-rate inf \
      --seed 42 --temperature 0 --flush-cache --disable-tqdm \
      --output-file cold.jsonl
    
    # 热请求:紧接冷请求执行,不清缓存;必须保持相同 seed / 输入长度
    "$SGLANG_PYTHON" -m sglang.benchmark.serving \
      --backend sglang --host 127.0.0.1 --port "$PORT" \
      --dataset-name random --random-input-len 128000 --random-output-len 16 \
      --num-prompts 1 --max-concurrency 1 --request-rate inf \
      --seed 42 --temperature 0 --disable-tqdm \
      --output-file hot.jsonl
    

    建议每个场景至少跑 3 次,取中位数;并保存每个 jsonl 和 server 日志。检查热命中时,除了 TTFT,还应确认 cache report 中的 host_cached_tokens / 命中率确实上升。

    6. 本机开启 HiCache 的最终配置

    下面是本机实际测试并成功运行的配置,不是根据文档猜测的参数。硬件为双 7900 XTX,模型使用 TP=2 分布在两张显卡上。

    项目 本机实际配置 作用
    GPU 2 × RX 7900 XTX 24 GB 两张显卡共同加载模型
    SGLang 0.5.6.post3.dev10769+gf84475ccf 本次测试版本
    模型 Qwen3.8-27B W4A16 GPTQ 主模型
    Draft 模型 Qwen3.8-27B DFlash2 W4A16 投机解码模型
    tp-size 2 模型切分到两张显卡
    context-length 196,608 服务允许的最大上下文长度
    mem-fraction-static 0.80 每张显卡约 80% 显存用于模型和 KV cache
    max-running-requests 3 最多同时处理 3 个请求
    chunked-prefill-size 2,048 长输入分块处理,降低瞬时显存压力
    GPU KV 容量 159,692 token 服务启动后实际报告的 KV 容量
    单请求最大输入 159,686 token 服务启动后实际报告的输入上限
    hicache-size 12 分配给 HiCache 的主机内存缓存容量参数
    hicache-ratio 2.0 HiCache 的缓存比例
    hicache-io-backend kernel 使用 kernel 后端在 GPU 与主机内存间搬运 KV
    hicache-host-memory-mode cache 主机内存作为缓存层使用
    hicache-write-policy write_through 新生成的 KV 同步写入主机缓存
    DFLASH draft tokens 8 每轮最多草拟 8 个 token
    DFLASH window 2,048 Draft 模型使用的窗口长度

    本机最终使用的完整启动命令如下。其他用户只需要修改主模型和 Draft 模型路径即可照着测试:

    /home/didilc/sglang-qwen/.venv/bin/python -m sglang.launch_server \
      --model-path /home/didilc/models/vllm/Qwen3.8-27B-W4A16-AutoRound-GPTQ \
      --served-model-name qwen3.8-27b-w4a16-dflash2-hicache \
      --host 127.0.0.1 \
      --port 30004 \
      --tp-size 2 \
      --quantization gptq \
      --dtype bfloat16 \
      --mamba-ssm-dtype bfloat16 \
      --kv-cache-dtype bfloat16 \
      --attention-backend triton \
      --context-length 196608 \
      --mem-fraction-static 0.80 \
      --max-running-requests 3 \
      --max-mamba-cache-size 20 \
      --chunked-prefill-size 2048 \
      --enable-mixed-chunk \
      --cuda-graph-bs-decode 1 2 4 \
      --triton-attention-num-kv-splits 16 \
      --reasoning-parser qwen3 \
      --tool-call-parser qwen3_coder \
      --enable-cache-report \
      --enable-hierarchical-cache \
      --hicache-size 12 \
      --hicache-ratio 2.0 \
      --hicache-io-backend kernel \
      --hicache-host-memory-mode cache \
      --hicache-write-policy write_through \
      --speculative-algorithm DFLASH \
      --speculative-draft-model-path /home/didilc/models/Qwen3.8-27B-DFlash2-W4A16 \
      --speculative-draft-model-quantization compressed-tensors \
      --speculative-num-draft-tokens 8 \
      --speculative-draft-window-size 2048 \
      --stream-interval 1
    

    其中真正负责开启 HiCache 的是下面六项,缺少第一项就不会启用:

    --enable-hierarchical-cache \
    --hicache-size 12 \
    --hicache-ratio 2.0 \
    --hicache-io-backend kernel \
    --hicache-host-memory-mode cache \
    --hicache-write-policy write_through
    

    这套参数的实际效果是:第一次处理 128K 长文仍需正常计算,但计算结果会保存到主机内存;再次使用相同前缀时,TTFT 可由约 192 秒降到约 2.65 秒。代价是占用更多系统内存,并且 GPU KV 容量会比未开启 HiCache 时更低。


  • 入门12400F led 机箱
    懒人烘培懒 懒人烘培
    装备秀 rtxpro4500 rtx5060 intel

    楼主只是证明我有,并且我来过,嘿嘿


  • 遊戲卡王RTX5090 傳停產,NVIDIA 擬將 GB202 晶片轉供 RTX PRO
    懒人烘培懒 懒人烘培
    随便聊聊 rtx5090 nvidia

    估计以后只发布每系只发行到XX80,不会在有XX90了


  • 5060 Ti 16GB 跑本地 Coding Agent:折腾到 96K 上下文后的真实体验
    懒人烘培懒 懒人烘培
    AI硬件 rtx5060 qwen-27b dsharness

    @rori 5070ti连接在这里:https://huggingface.co/YukinoKaorisuna/Qwen3.8-27B-Uncensored-ninfer5080-5070ti


  • 7900XTX 24G白金版哪里买划算,现在京东都涨到7799了,之前还是7299
    懒人烘培懒 懒人烘培
    AI硬件 7900xtx

    现在已经涨到8k了


  • 雙 7900XTX + SGLang 跑 Qwen3.8-27B 完整實戰:TP=2 由 ROCm 7.2 到 HiCache,decode 78 tok/s(附全套 benchmark)
    懒人烘培懒 懒人烘培
    AI硬件 7900xtx sg-lang qwen-27b

    支持,我也参考大神的文章,正在做双7900XTX卡单用户单任务的测试,目前等待配件中


  • 7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比
    懒人烘培懒 懒人烘培
    AI Agent 7900xtx sg-lang vllm

    GIGABYTE X870E AORUS Xtreme AI TOP 这个主板确实贵,不过散热真的不错。我买的微星X670E CARBON WIFI,正在解决双卡散热问题


  • Strata 雙卡 RTX 5060 Ti 16GB Qwen3.8-Flash-Next :196K/256K 長 Context 實測
    懒人烘培懒 懒人烘培
    LLM讨论区 rtx5060 strata qwen-flash

    嗯5070ti确实是有性价比,等显卡崩盘了,也在添加5080,组成双5080方案


  • llama.cpp 0.6.0 出了,继续跑我的 Deepseek V4 和 GLM5.3 Flash !
    懒人烘培懒 懒人烘培
    LLM讨论区 llama.cpp deepseek glm

    我主力还是用SGLang,当然用strata也有部署


  • 單卡3060 12G跑Strata Qwen 3.8 flash next -- IQ2_XS 與 IQ3_XXS 比較
    懒人烘培懒 懒人烘培
    LLM讨论区 rtx3060 strata qwen-flash

    3060 12G还是能打的,抗噪


  • 续篇:单卡RTX5080跑Qwen3.8-27B,开关思考与 Q4性能对比
    懒人烘培懒 懒人烘培
    LLM讨论区 rtx5080 qwen-27b 量化

    平台:Windows 11 + WSL2 Ubuntu 24.04、RTX 5080 16GB、本地 NInfer 版 Qwen3.8-27B。本文是上一篇部署与速度实测的续篇:这次看答题、代码和图文生成,还让本机 NInfer 答同一批 800 道选择题,与公开 Q4_K_M/BF16 逐题结果对照。Q4 与 BF16 未在本机运行。

    上篇证明了这套配置能够跑起来,也测了 98K 长序列吞吐。读者更关心的下一问是:这约 3.953 BPW 的 NInfer 版,做实际任务时怎么样?开思考能否减少错误?和常见 Q4 到底能比到哪一步?

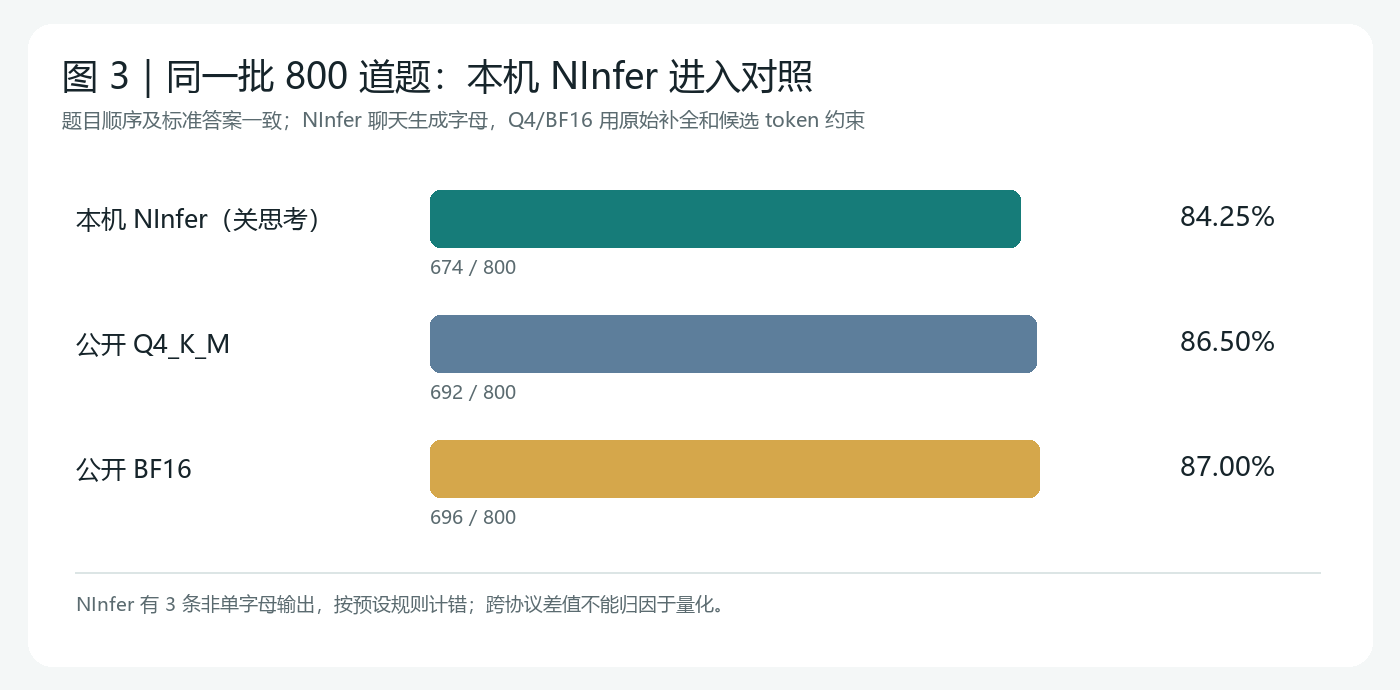
    先说结论:在本机的两道可客观判分的复杂题上,关思考均答错,开思考均答对;代价是单次请求更慢、输出 token 更多。到了网页和 SVG,思考模式并不保证成品正确或好看。同一批 800 道题上,本机 NInfer 关思考答对 674 题(84.25%),公开 Q4_K_M 为 692 题(86.50%),BF16 为 696 题(87.00%)。但 NInfer 与公开结果的取答案协议不同,这个数字差异不能直接归因于量化或模型能力。

    一、测试怎么做

    本机仍运行同一个 qwen3_8_27b.ninfer 文件和 NInfer 服务。复杂任务各请求一次,temperature=0;设置分别为 reasoning_effort: "none" 与 "medium"。完整请求和原始响应均已留存。单题单次结果适合展示案例,不适合推断总体准确率。

    这里有一个必须说明的变量:**两组的输出上限并不完全相同。**排程和金额核算,关思考给 900 token,开思考给 2,500 token;科学 SVG 关思考给 3,400 token,开思考先给 3,400,截断后又补测 7,000;交互网页关思考给 4,100,开思考给 8,000。因此,这是“让思考有足够空间”的实用配置对照,不能把全部差异归因于思考开关。
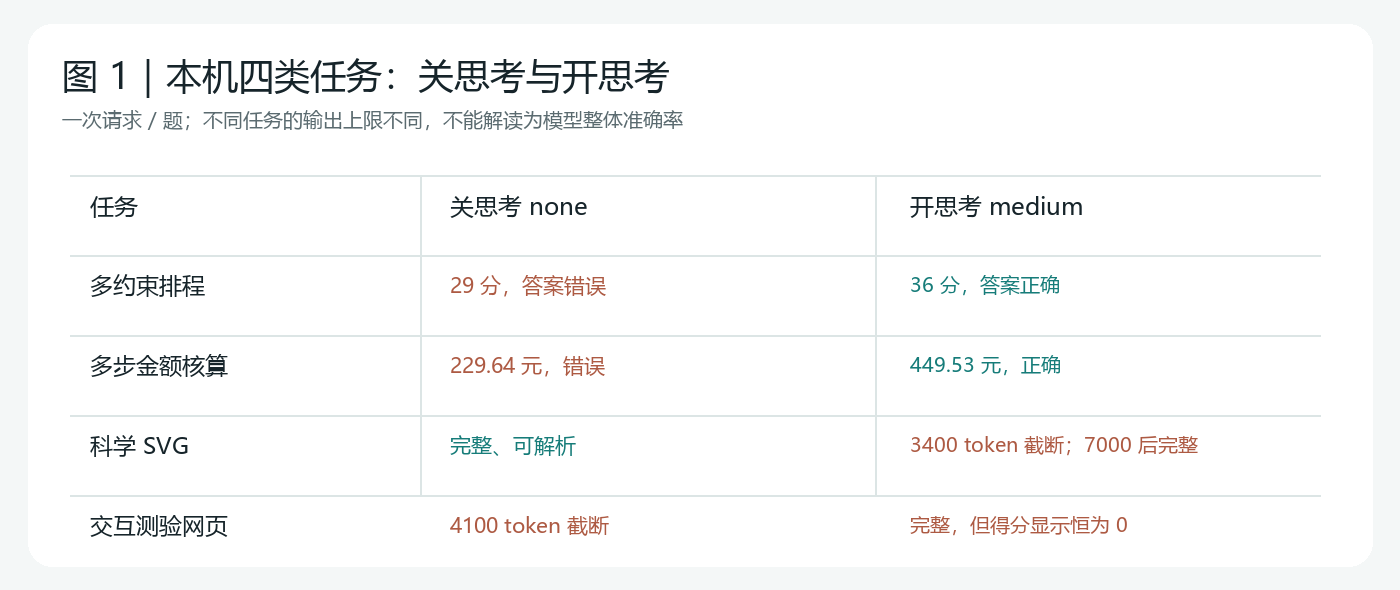
    图1-本机任务结果.png

    二、两道有标准答案的题:开思考答对了

    第一题是八个有时间冲突的任务,要求选出总分最高、格式严格的 JSON。正确结果是 B、D、F、H,共 36 分。关思考返回 A、C、E、G,共 29 分,还带了代码围栏;开思考返回了正确 JSON。

    第二题是商品折扣、优惠券、税和运费的连续计算。正确过程是:折后商品 442.76 元,减券 412.76 元,税 24.77 元,加运费后合计 449.53 元。关思考给出 229.64 元,开思考得到 449.53 元。

    题目 关思考 开思考 正确答案
    多约束排程 29 分,错误 36 分,正确 36 分
    多步金额核算 229.64 元,错误 449.53 元,正确 449.53 元

    开思考并非免费。两题的本机 API 端到端单次耗时分别从 1.50 秒到 21.89 秒、从 1.48 秒到 11.75 秒;输出 token 分别从 34 到 2,067、从 70 到 1,053。这是不同长度答案的一次请求记录,不能当作同字数解码速度,也不能推算平均性能损失。
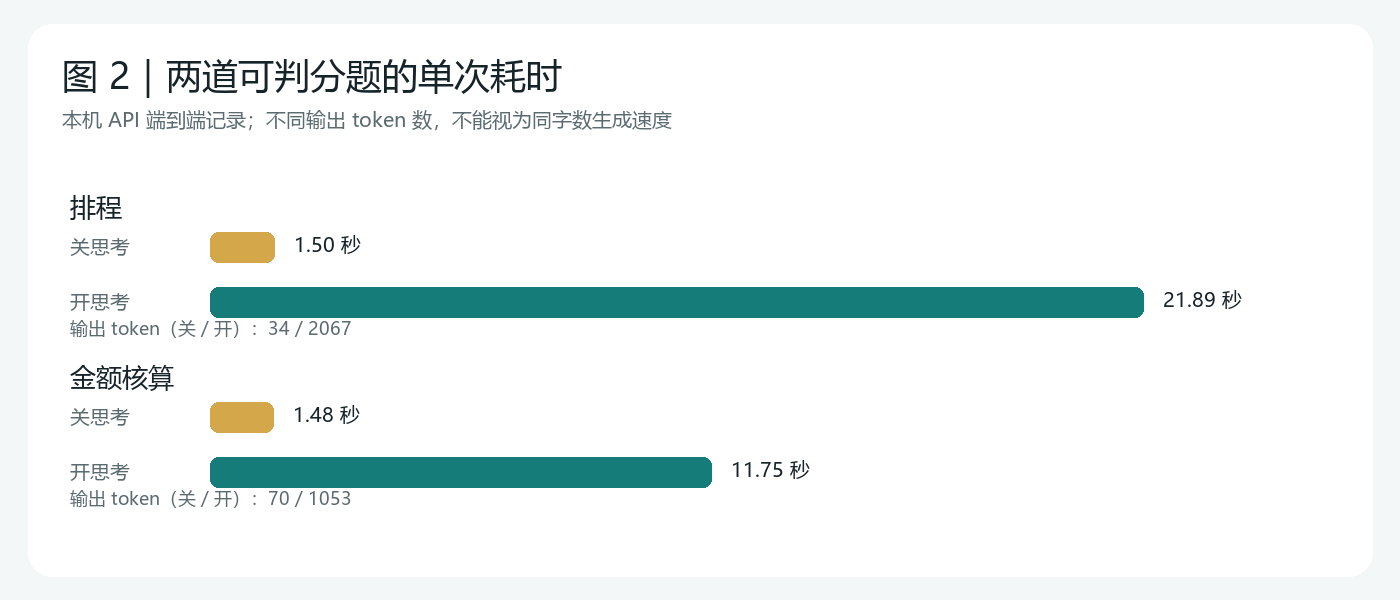
    图2-两题单次耗时.png

    三、代码与图文生成:思考也会犯错

    科学 SVG 题要求画一张“光合作用”信息图并标全六个关键要素。关思考在 3,400-token 上限内输出完整、可解析的 SVG;开思考第一次在同样上限被截断,改为 7,000 token 后才完整。能否闭合文件与输出预算直接相关。

    三题单选测验网页则呈现相反的边界:关思考在 4,100 token 被截断;开思考用 8,000 token 输出了完整页面,但代码先生成“得分:0/3”再累加分数,导致页面显示的得分始终是 0。单看 HTML 闭合和 JavaScript 语法,发现不了这种逻辑错误。

    我还让本地模型分别在关思考和开思考下生成鹈鹕骑车、八卦文化、钍基熔盐堆、薛定谔的猫等 SVG/HTML。五个思考版文件都完整返回;三张 SVG 可解析并渲染,两张网页的脚本通过语法检查。但这些主题图不能当作严格盲测:部分提示词不完全相同,旧版和新版文件也有少量人工修正。下面截图用于展示成品风格与具体问题,不计算胜率。
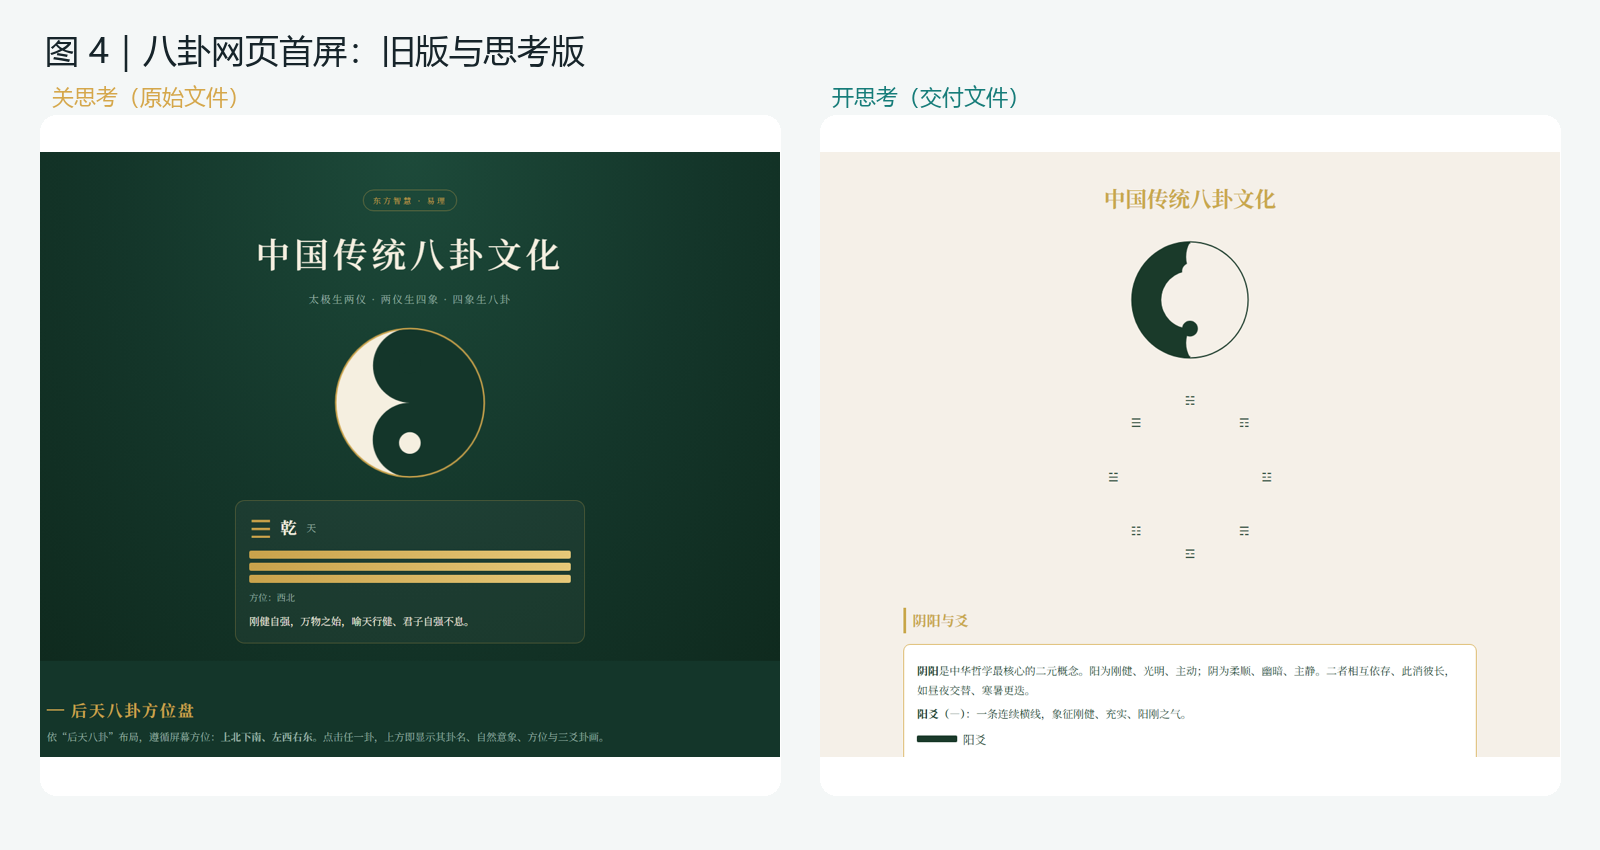
    图4-八卦网页首屏对照.png

    八卦网页尤其说明“开思考 ≠ 自动更好”。关思考版首屏层次更完整;开思考版更简洁,但原始代码把卦画三爻上下顺序倒置。交付文件已人工修正,截图展示的是修正后的版本。若直接发表模型原始输出,这个错误需要保留并指出。
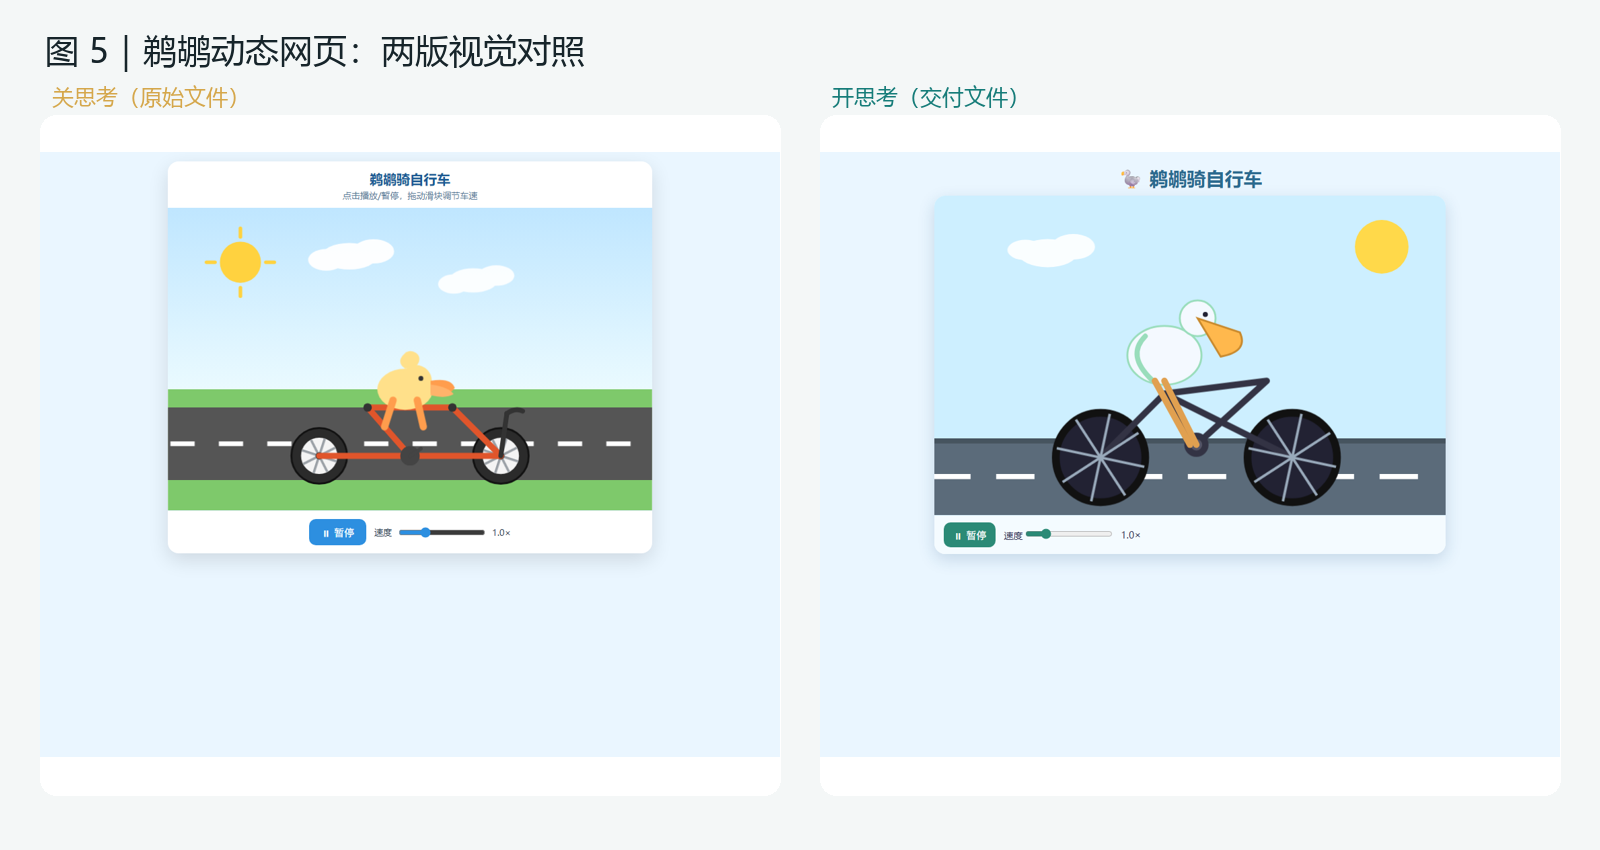
    图5-鹈鹕动态网页对照.png

    鹈鹕网页两版都能在本地打开,思考版的视觉不一定优于关思考版。单看截图也无法验证动画、暂停键和速度滑块的运行逻辑。科学图还需人工复核概念和标注,不能只凭 XML 可解析就认定准确。
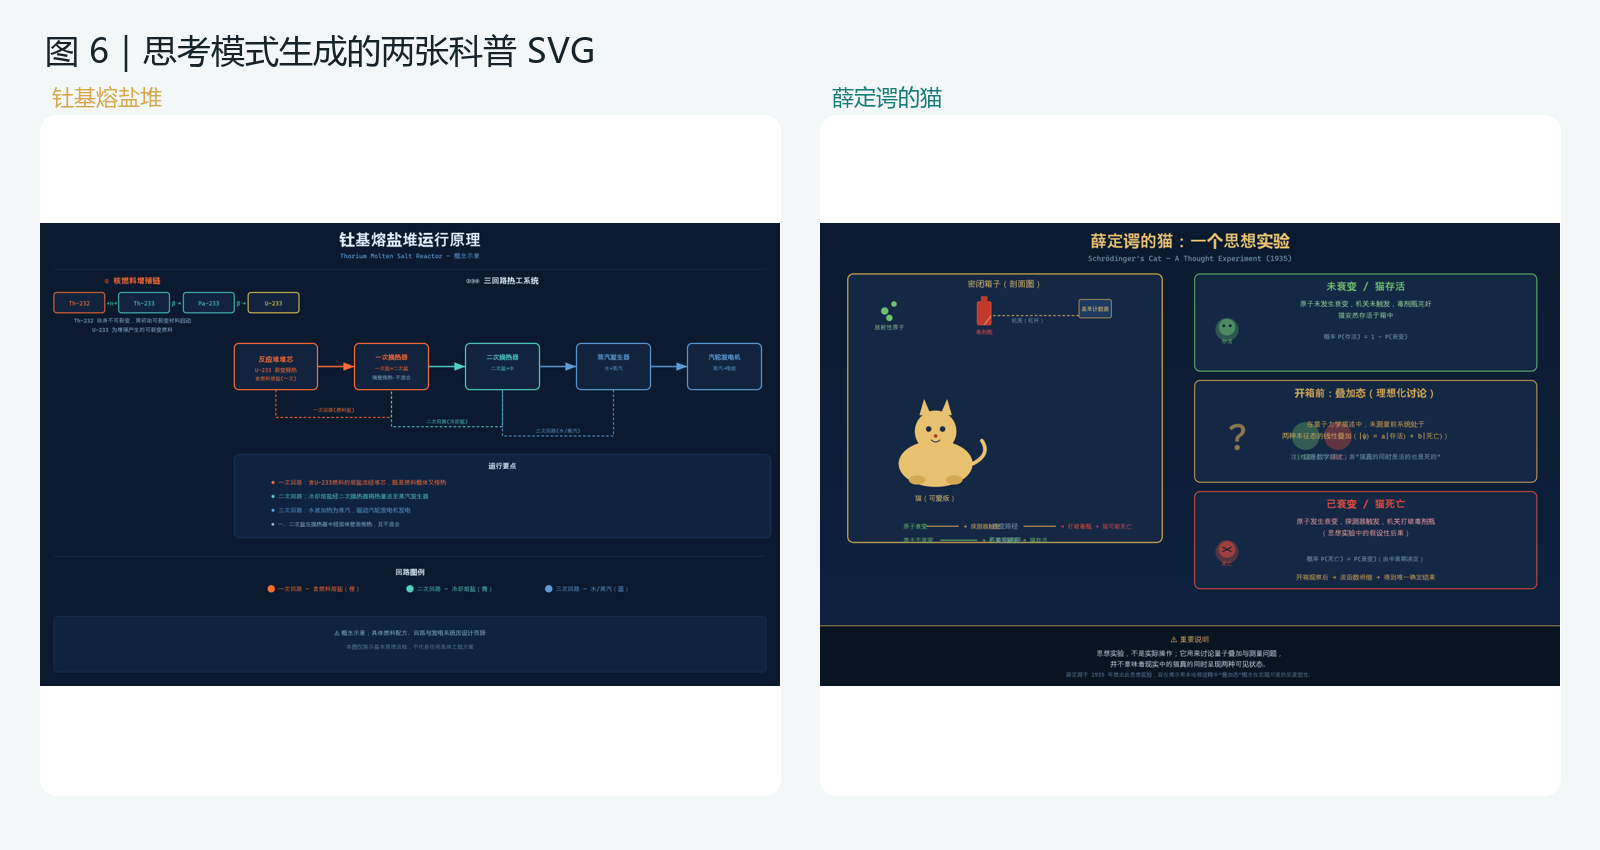
    图6-思考模式科普SVG.png

    四、同一批 800 道题:本机 NInfer 也参加

    为补上本机成绩,我按 topabaem 的 Q4_K_M/BF16 评测使用的固定版本,重建了 MMLU 570 题与 ARC-Challenge 230 题。800 题的有序题目指纹是 a72515282c6fc20f34188b3102d99468ab2b02266105ed9c6e4ec405fbad8fd0,与公开评测一致;逐题标准答案也与公开的 Q4 原始记录逐项相同。接着用本机 NInfer 对这 800 题顺序作答,temperature=0、reasoning_effort="none"、最多 8 个输出 token,只接受单个 A/B/C/D 字母,其他输出按预设规则计错。

    同一批题 本机 NInfer(关思考) 公开 Q4_K_M 公开 BF16
    MMLU(570 题) 455(79.82%) 472(82.81%) 476(83.51%)
    ARC-Challenge(230 题) 219(95.22%) 220(95.65%) 220(95.65%)
    合计(800 题) 674(84.25%) 692(86.50%) 696(87.00%)

    图3-同题NInfer与公开Q4对照.png

    本机 NInfer 比公开 Q4_K_M 少答对 18 题,表面差 2.25 个百分点。其中 MMLU 相差 17 题,ARC 相差 1 题。NInfer 有 3 条输出不是单个字母,原文分别是 Anaphylaxis is a severe,、空字符串和 Well,均按错误计入;没有事后替模型补选项。

    **最重要的边界是协议。**公开 Q4/BF16 用原始补全提示词,通过相同的选项 token bias 强制只从 A/B/C/D 选一项,再按首 token 评分;本机 NInfer 服务目前没有同样可用的原始补全和 token 概率接口,其 logit_bias 字段虽能解析但不作用于生成。因此本机使用聊天接口、单字母指令和严格答案解析。题目与标准答案相同,提示词包装和选项约束不相同。这次测试真实反映了本机 NInfer 在该 API 用法下的表现,但不能据此宣称它的量化质量比 Q4_K_M 低 2.25 个百分点。

    本机用的是 ninfer-5080 发布的混合 Q3/Q4/Q5 NInfer 文件,约 3.953 BPW;公开 Q4_K_M 是另一套 GGUF 文件。Q4_K_M 与 BF16 在其同协议测试中相差 0.50 个百分点;这个结论仅适用于该文件与该题集。两边的显卡与推理框架也不同,公开吞吐数字不能与本机 tok/s 直接排名。

    五、我的使用结论

    日常改写、提纲和短回答,可以先关闭思考模式以减少等待;多约束排程、金额核算等需要逐步推演的任务,可以开启思考模式,并留足输出 token。网页、代码和科普图无论是否开启思考,都需要实际运行并人工核对。这台 RTX 5080 上的 NInfer 版已具备日常生产力价值,但思考模式并非无条件的质量开关。

    在同一批 800 道选择题上,本机 NInfer 关闭思考模式答对 674 题(84.25%),公开 Q4_K_M 答对 692 题(86.50%)。两组结果使用相同题目和标准答案,但取答案方式不同:本机通过聊天接口生成选项字母,公开 Q4 测试则约束候选 token 后评分。这些数据展示了各自测试条件下的表现,阅读差值时应保留这一口径区别。


    资料与口径:上一篇部署实测 · 本机 NInfer 模型卡 · Q4_K_M/BF16 同协议评测 · 公开逐题评测文件。本机 800 条逐题原始输出和结果已保存;每题只测一次,未进行多次重复。


  • Qwen3.8 27B Q5_K_M + 7900xtx + DeepSeek Harness实战平均 52 t/s
    懒人烘培懒 懒人烘培
    LLM讨论区 qwen-27b 7900xtx dsharness

    @exllm @terry
    根据楼主的测试了一下
    cpu: AMD Ryzen 5 7500F
    RAM:DDR5 32GB 6000
    GPU: 7900XTX
    OS: Ubuntu 24.04
    软件 : llama.cpp + vulkan

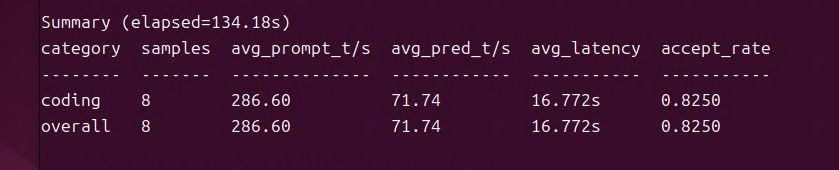
    先说结果:
    d9100061-f4ce-41c6-a642-6c786631721d-image.jpeg
    llama.cpp运行参数,spec-draft-n-max 3 速度最好:

    ~/llama_vulkan/bin/llama-server \
    -m ~/models/Qwen3.8-27B-Q5_K_M.gguf \
    -t 10 \
    -b 512 \
    -ub 256 \
    --spec-draft-n-max 3 \
    --fit off \
    --no-context-shift \
    --metrics \
    --kv-unified \
    --jinja \
    --cache-type-k q8_0 \
    --cache-type-v q8_0 \
    -fa on \
    --spec-type draft-mtp \
    --ctx-size 131072 \
    --parallel 1 \
    -ngl -1 \
    --host 0.0.0.0 \
    --port 8080 \
    --chat-template-kwargs '{"enable_thinking":true,"preserve_think":false,"reasoning_effort":"medium"}' \
    --no-mmap \
    --temp 0.6 \
    --top-p 0.5 \
    --top-k 15 \
    --repeat-penalty 1.0 \
    --alias qwen3.8-27b-q5
    

    llama.cpp运行参数,spec-draft-n-max 2 :
    a0024f56-4593-4dff-b3e1-f28a779fa278-image.jpeg

    llama.cpp运行参数,spec-draft-n-max 4 :
    990f1775-f067-4cb1-a475-497ac29df862-image.jpeg

    总结:

    参数 Prompt速度 生成速度 平均延迟 MTP命中率
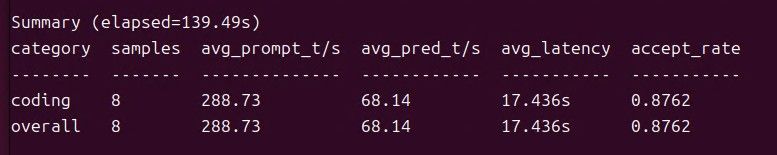
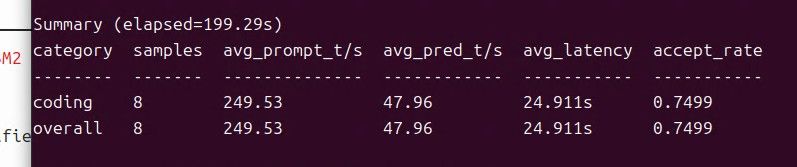
    n=2 288.73 t/s 68.14 t/s 17.436 s 87.62%
    n=3 286.60 t/s 71.74 t/s 16.772 s 82.50%
    n=4 249.53 t/s 47.96 t/s 24.911 s 74.99%

    这台电脑n=3最好。
    注:修改这个参数是MTP speculative decoding(推测解码)一次最多提前“猜”多少个 token。


  • 無事折騰~單張 RX 7900 XTX(gfx1100 / 24GB)上編 SGLang 跑 Qwen3.8-27B —— 完整實作與踩坑全紀錄
    懒人烘培懒 懒人烘培
    LLM讨论区 7900xtx sg-lang qwen-27b

    谢谢,总结的很好,到时候也能抄作业


  • 體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27B
    懒人烘培懒 懒人烘培
    LLM讨论区 qwen 本地模型 strata

    经过实际的测试感觉上27B + SGLang体验会更好些,虽然我3.8 flash next也在本地部署了


  • 双RX7900XTX塞进同一机箱,满载温度成功压到 90℃以内
    懒人烘培懒 懒人烘培
    AI硬件 7900xtx 多卡部署

    @terry 嗯嗯,有些配件是之前买的,还有二手的,接下来找时间要进行测试。


  • 7900 XTX 的可能性探索|双卡篇(一): 魔改 SGLang + DFlash2 + HiCache,200+ t/s 与多 Agent 的丝滑体验
    懒人烘培懒 懒人烘培
    AI Agent 7900xtx sg-lang 多卡部署

    @Ben-Lee 这个优化好,找时间把作业抄了,哈哈,不错


  • 🎉 恭喜 @Ben Lee 晋升「超凡大师」!
    懒人烘培懒 懒人烘培
    荣誉大厅

    恭喜啦~国庆节期间晋升~,跟着论坛大神学习

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组