买了2张5060Ti,谁能跑最便宜的Qwen 27B?
-
-
卡终于到货。等到天荒地老..。
马上把双卡插进去,测试.历尽星霜岁月长, 天荒地老守3090。
苍天有眼怜痴客, 5060Ti双剑合璧试锋芒!觉得很可以用。用电少。不发热 ~ MTP TG 50 t/s
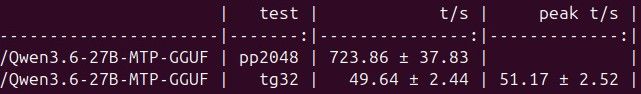
通常可以跑到30 tk/s. 用 Q6_K Ctx 96k 比 Q4_K_M Ctx128k 还快.
LM Studio Split:
3090:
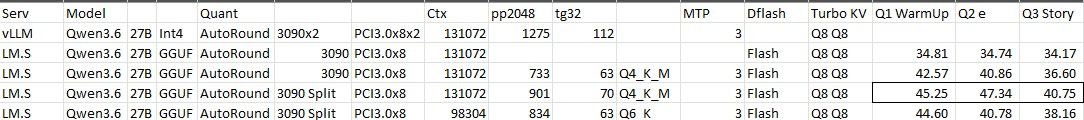
5060Ti:

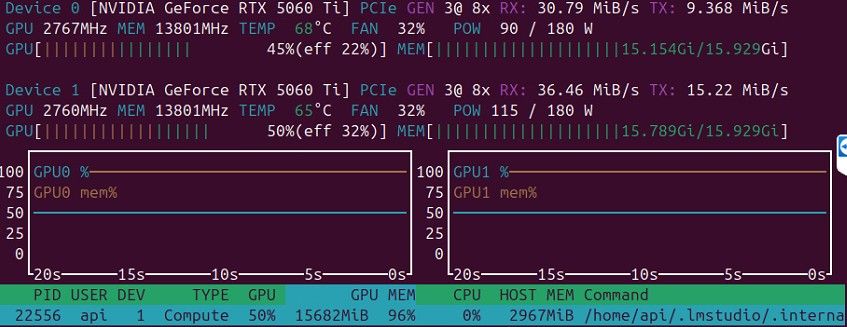
Q6_K 96k 显存几乎用满了
-
-
-
-
-
-
-
双5060TI 16G跑英伟达专门为50显卡优化的Qwen3.6-27B-NVFP4-MTP的表现比双3080-20G还好,NVFP4的优化号称无损Q4,速度40-70T,论坛里面有人发的。
-
-
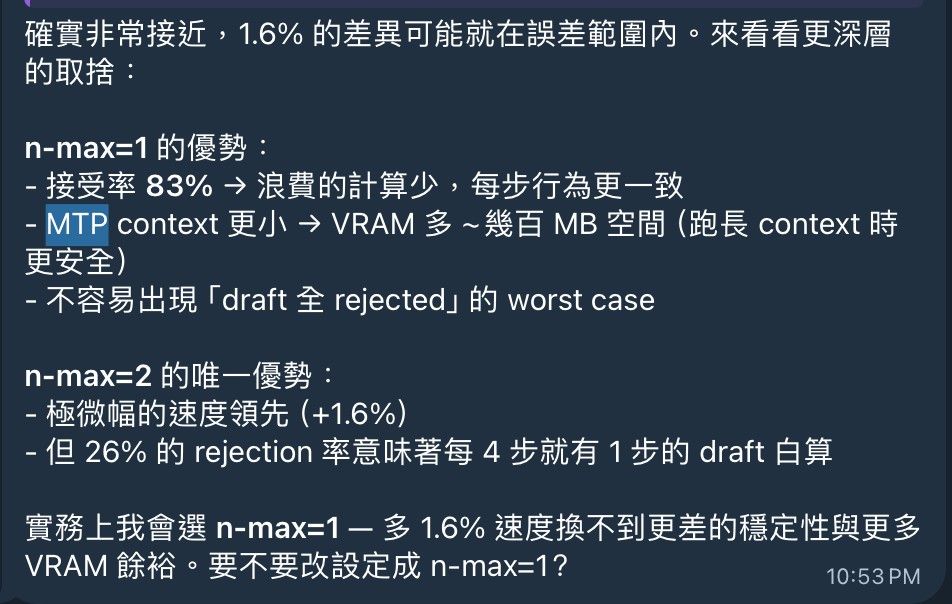
MTP 版本需要設一個參數 Draft tokens (num_speculative_tokens or spec-draft-n-max): AI 幫我測試過 最後1 或 2 是最快的參數, 你也是設定1 或 2 嗎?2 速度只比1 快了3 tokens /s 但是它有一個"準確度" 降了很多(浪費算力) 我跟AI都認同Qwen3.6-27B-MTP-GGUF 最後選擇1 是最佳MTP參數
-
-
 J johnnybegood 于 引用了 此主题
-
电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.
Model
qwen3.8-flash-next-iq3_s
Engine
v0.1.33
Context
32,768 tokens
KV cache
8-bit, all in VRAM
Experts in VRAM
10,268 (19.4 GB)
Speculation
MTP drafts up to 3 tokens, prompt lookup on
Images
off -
电脑现在运行的是 Strata RTX5060Ti x2 ——CPU 没有 AVX-512 指令集,所以速度慢一些,但仍然不错,能达到 60~75 tk/s。64GB DDR4.
Model
qwen3.8-flash-next-iq3_s
Engine
v0.1.33
Context
32,768 tokens
KV cache
8-bit, all in VRAM
Experts in VRAM
10,268 (19.4 GB)
Speculation
MTP drafts up to 3 tokens, prompt lookup on
Images
off -
-
-
-
恭喜终于苦尽甘来。。。。。
-
@Vivid-Vector 牛逼啊兄弟,居然这么会玩,发个帖子说下你的2080Ti,我说2080Ti是垃圾之后,很多人不爽喷我,我想是不是我太武断了,你有信息分享下。跑大模型,ComfyUI实际体验,最好带图,让我坐一起视频,嘿嘿