跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
kos orK

Kevin

@kos or
至尊皇帝
取消关注 关注
关于
帖子
1.4k
主题
83
分享
0
群组
1
粉丝
5
关注
9

帖子

最新 最佳 有争议的

  • 男人們的大玩具 欣賞一下美國網友的 Homelab
    kos orK kos or
    AI硬件 rtxpro6000 多卡部署 nvidia

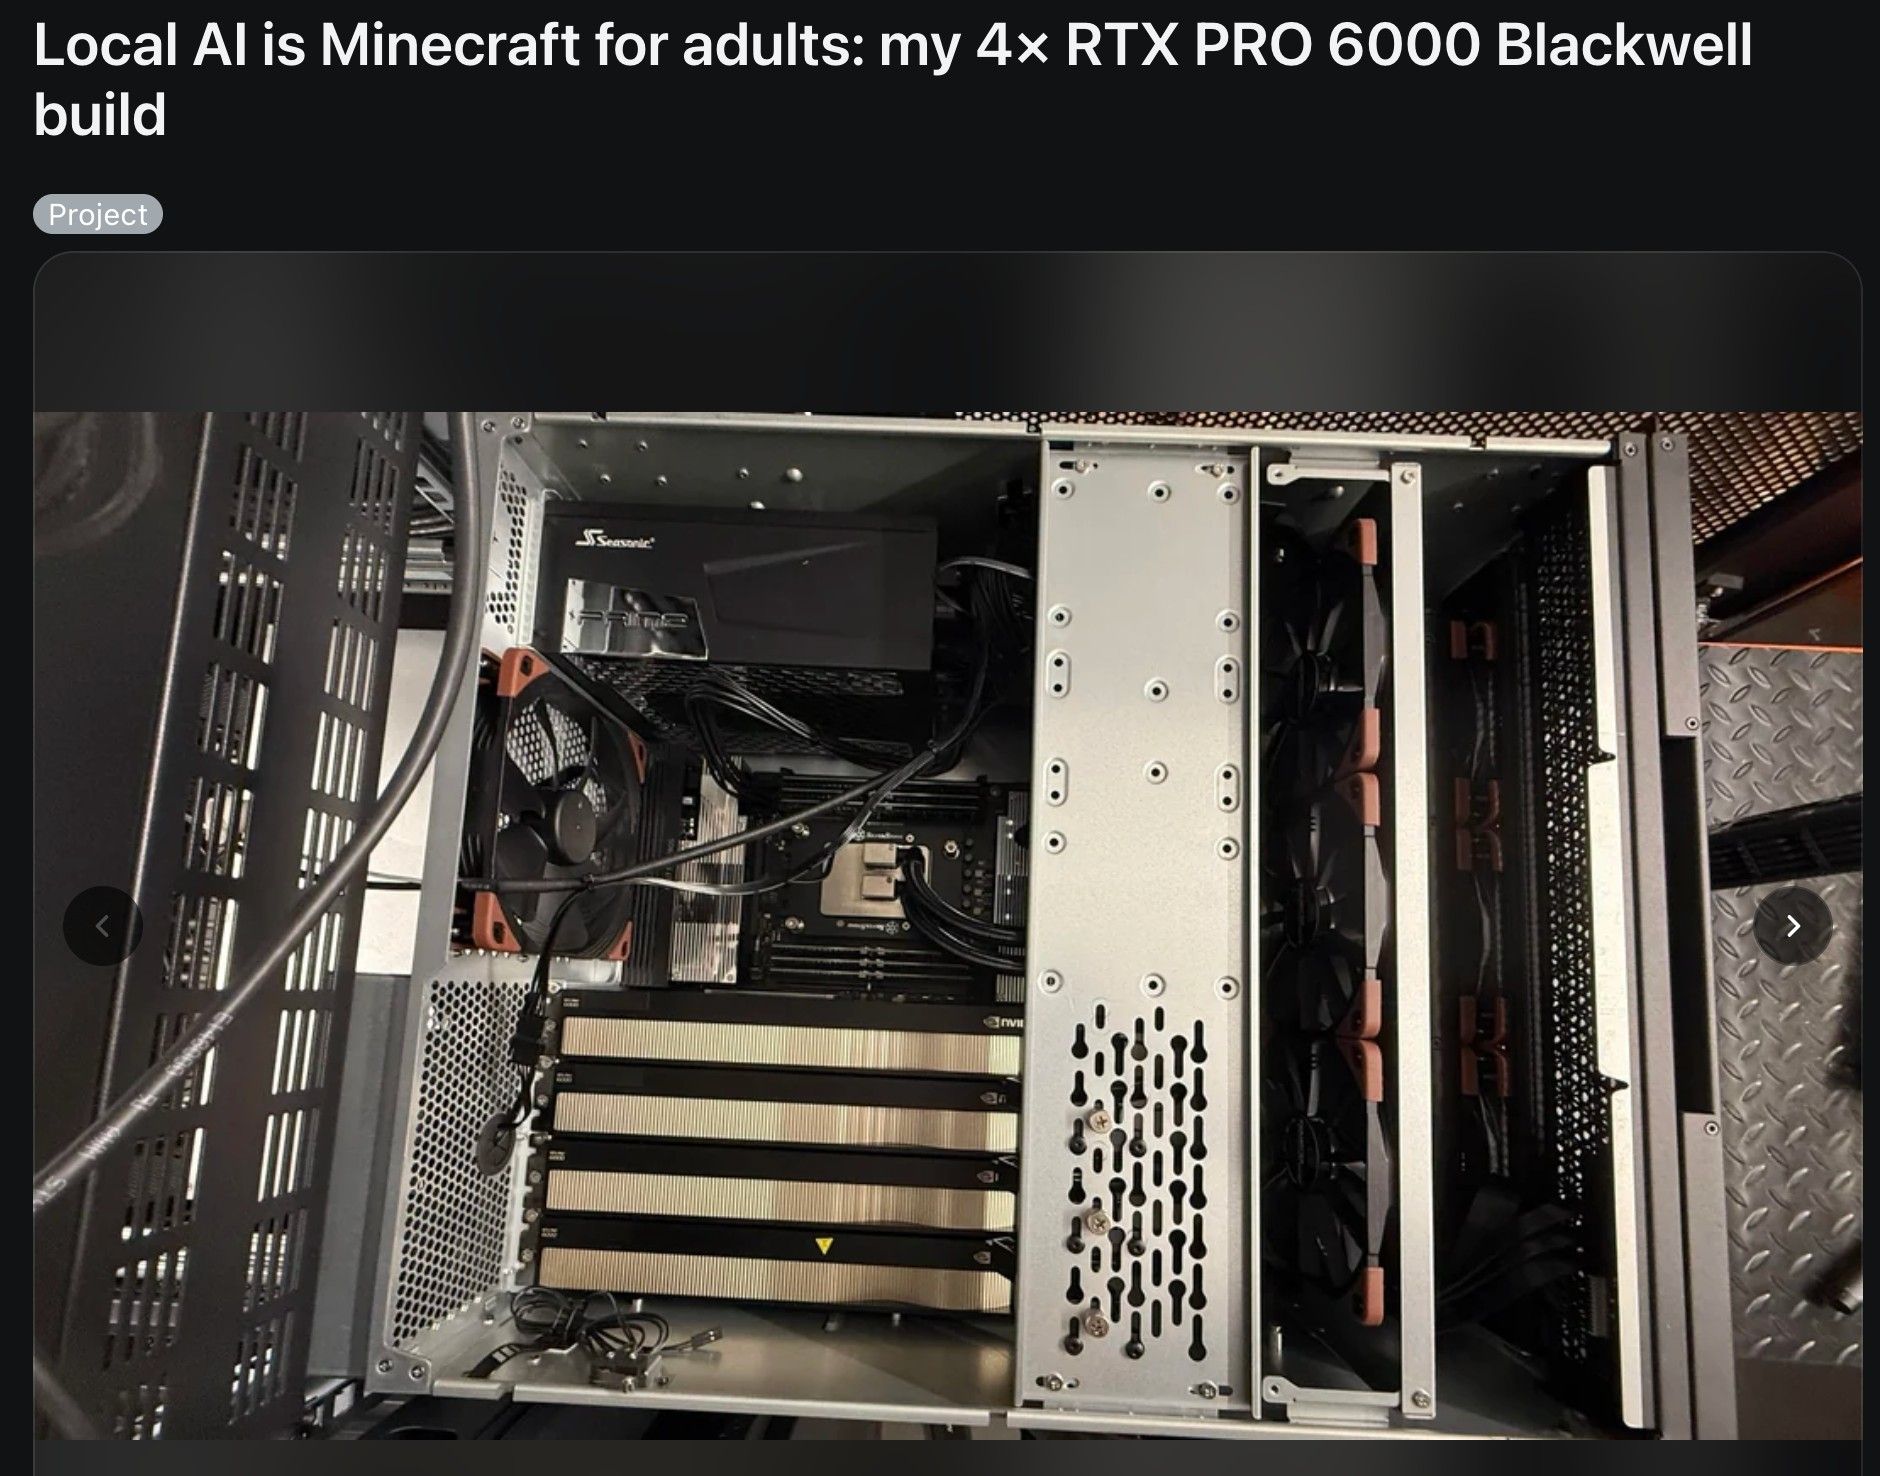
    男人們的大玩具 欣賞一下美國網友的 Homelab 😍
    Source: Reddit

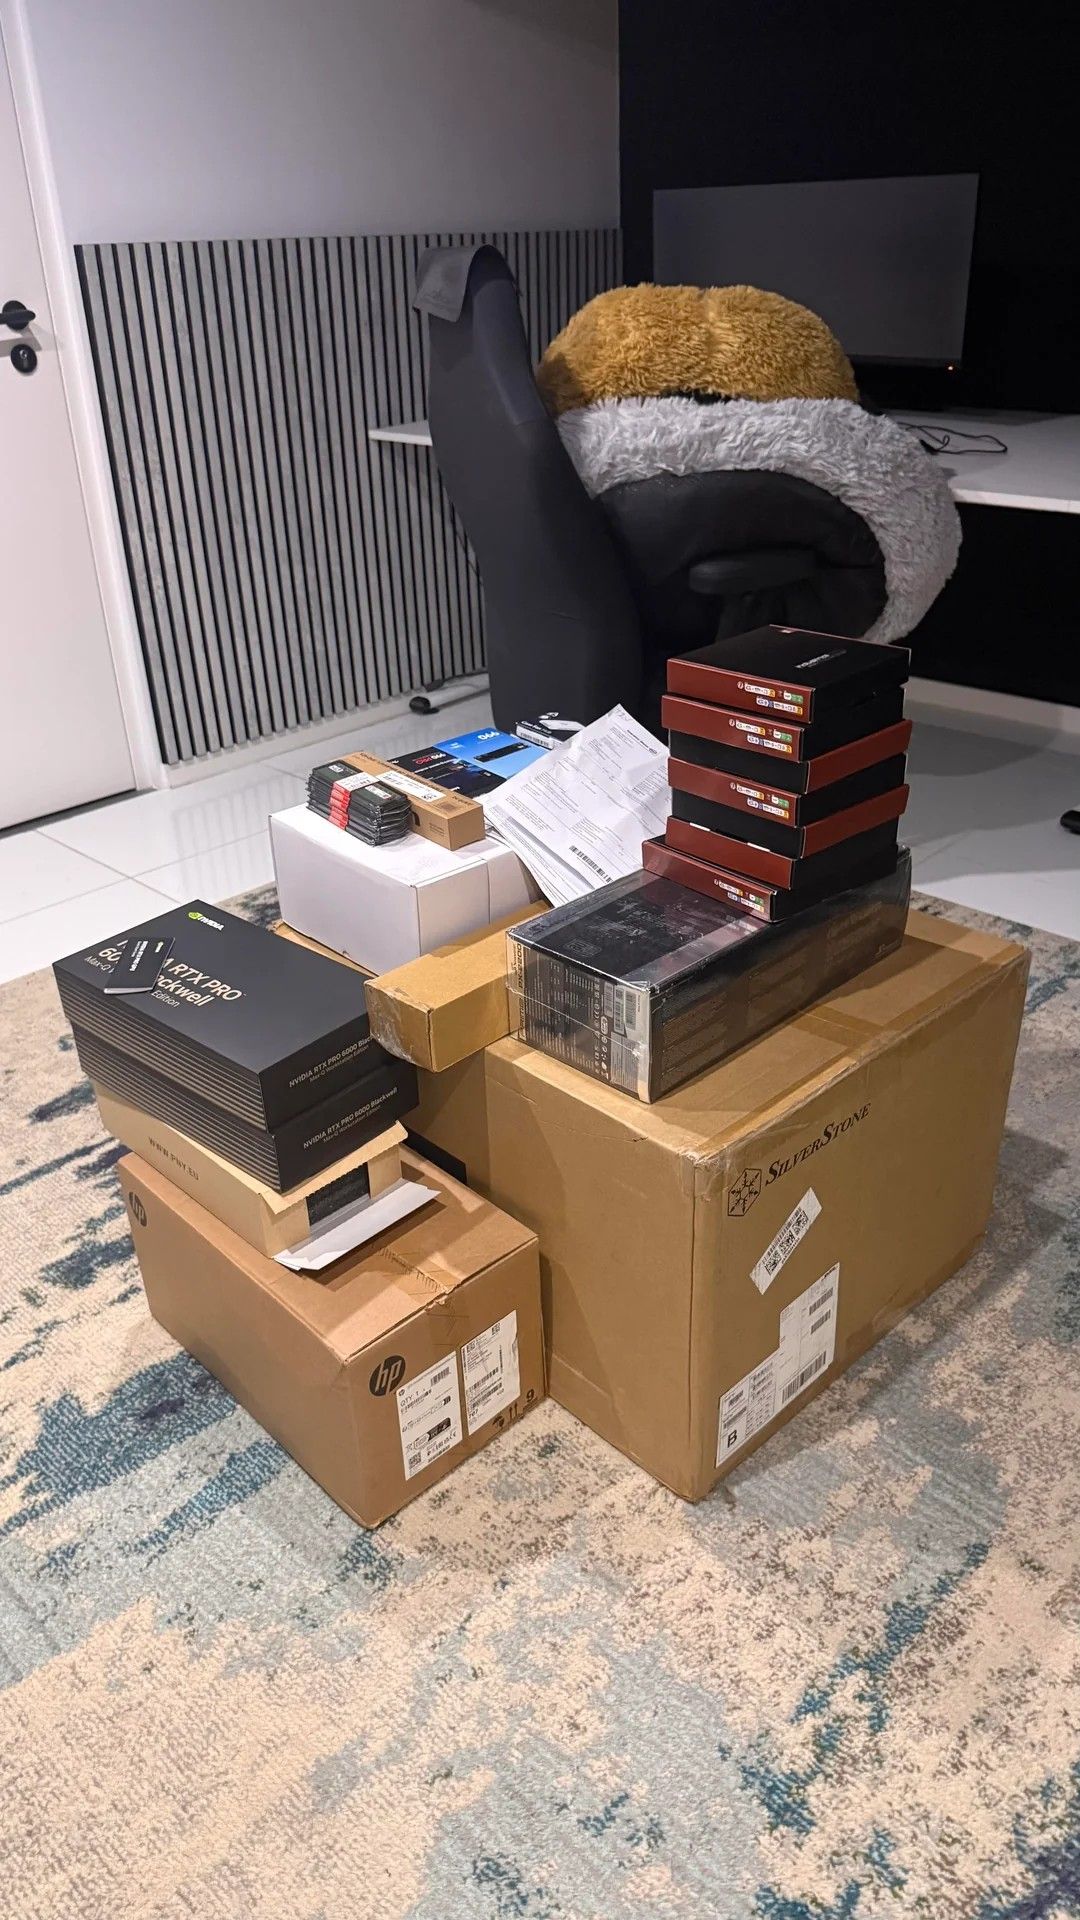
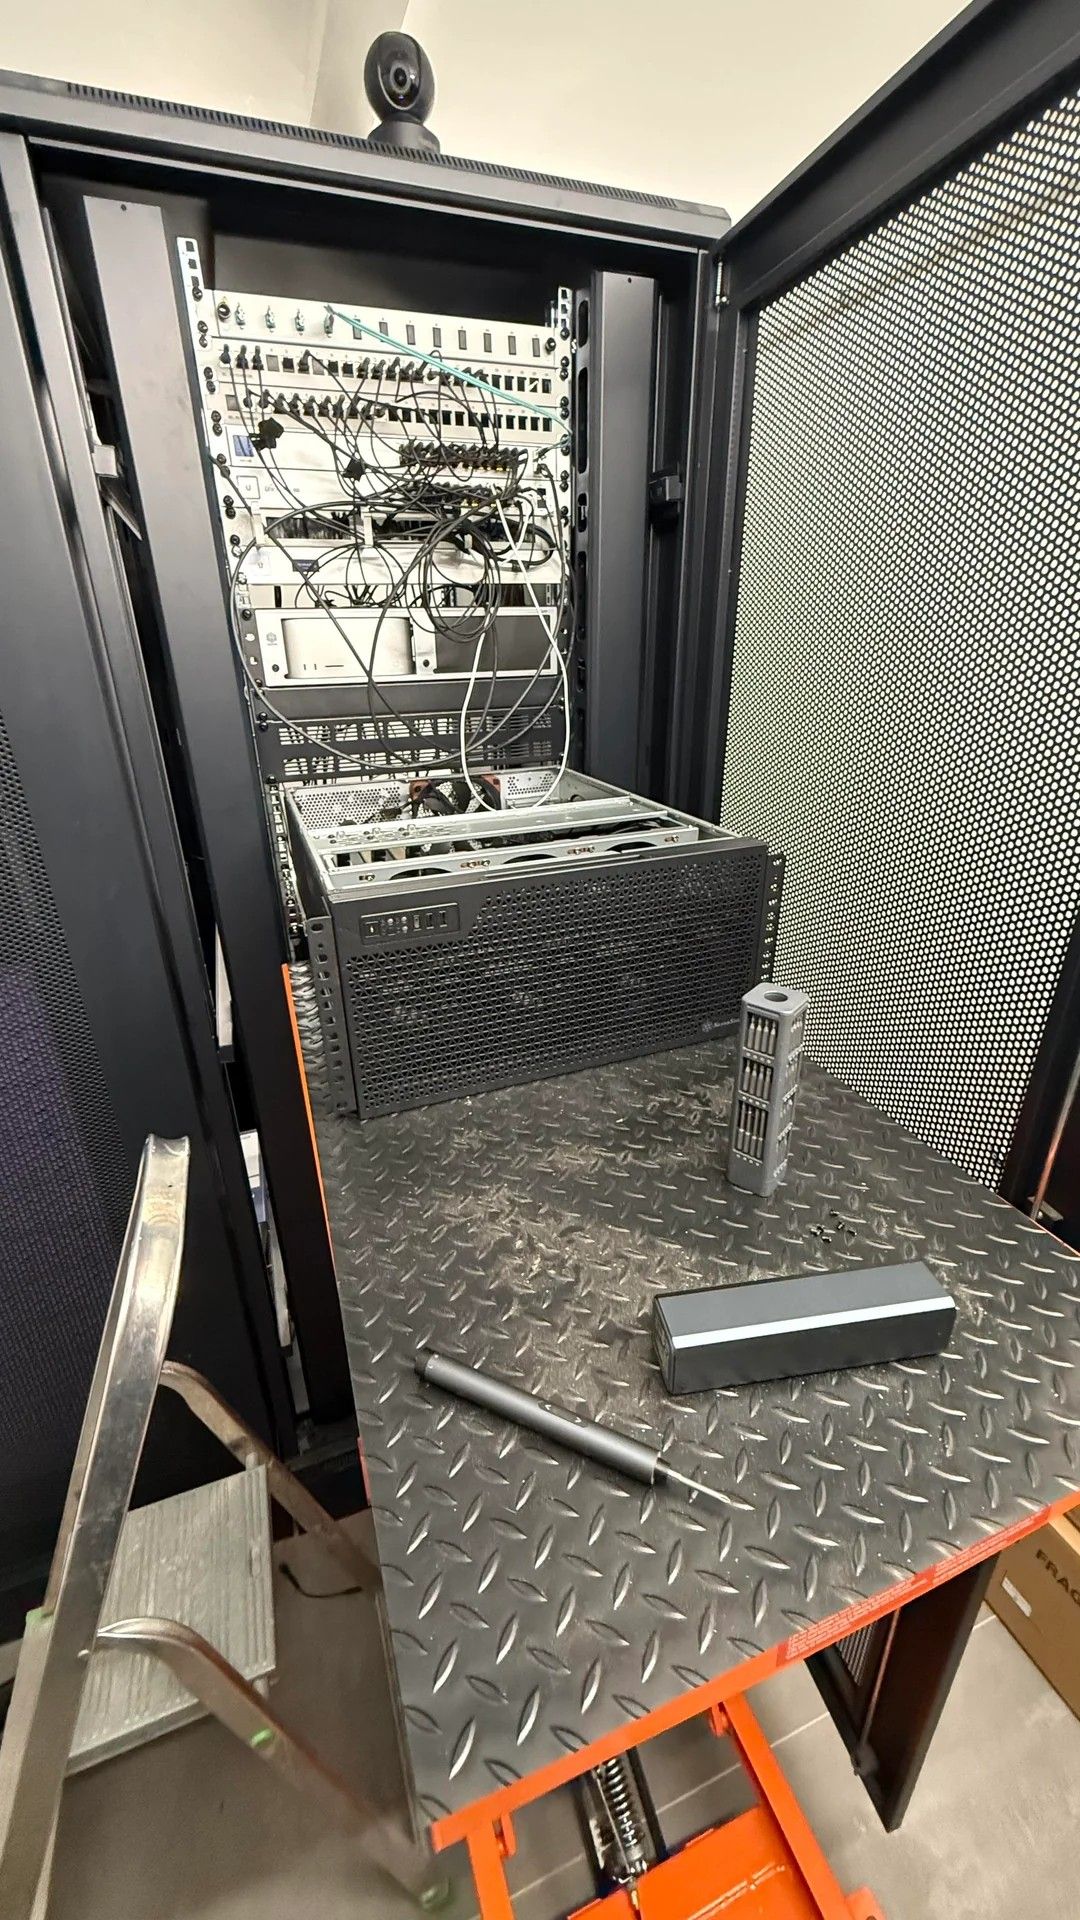
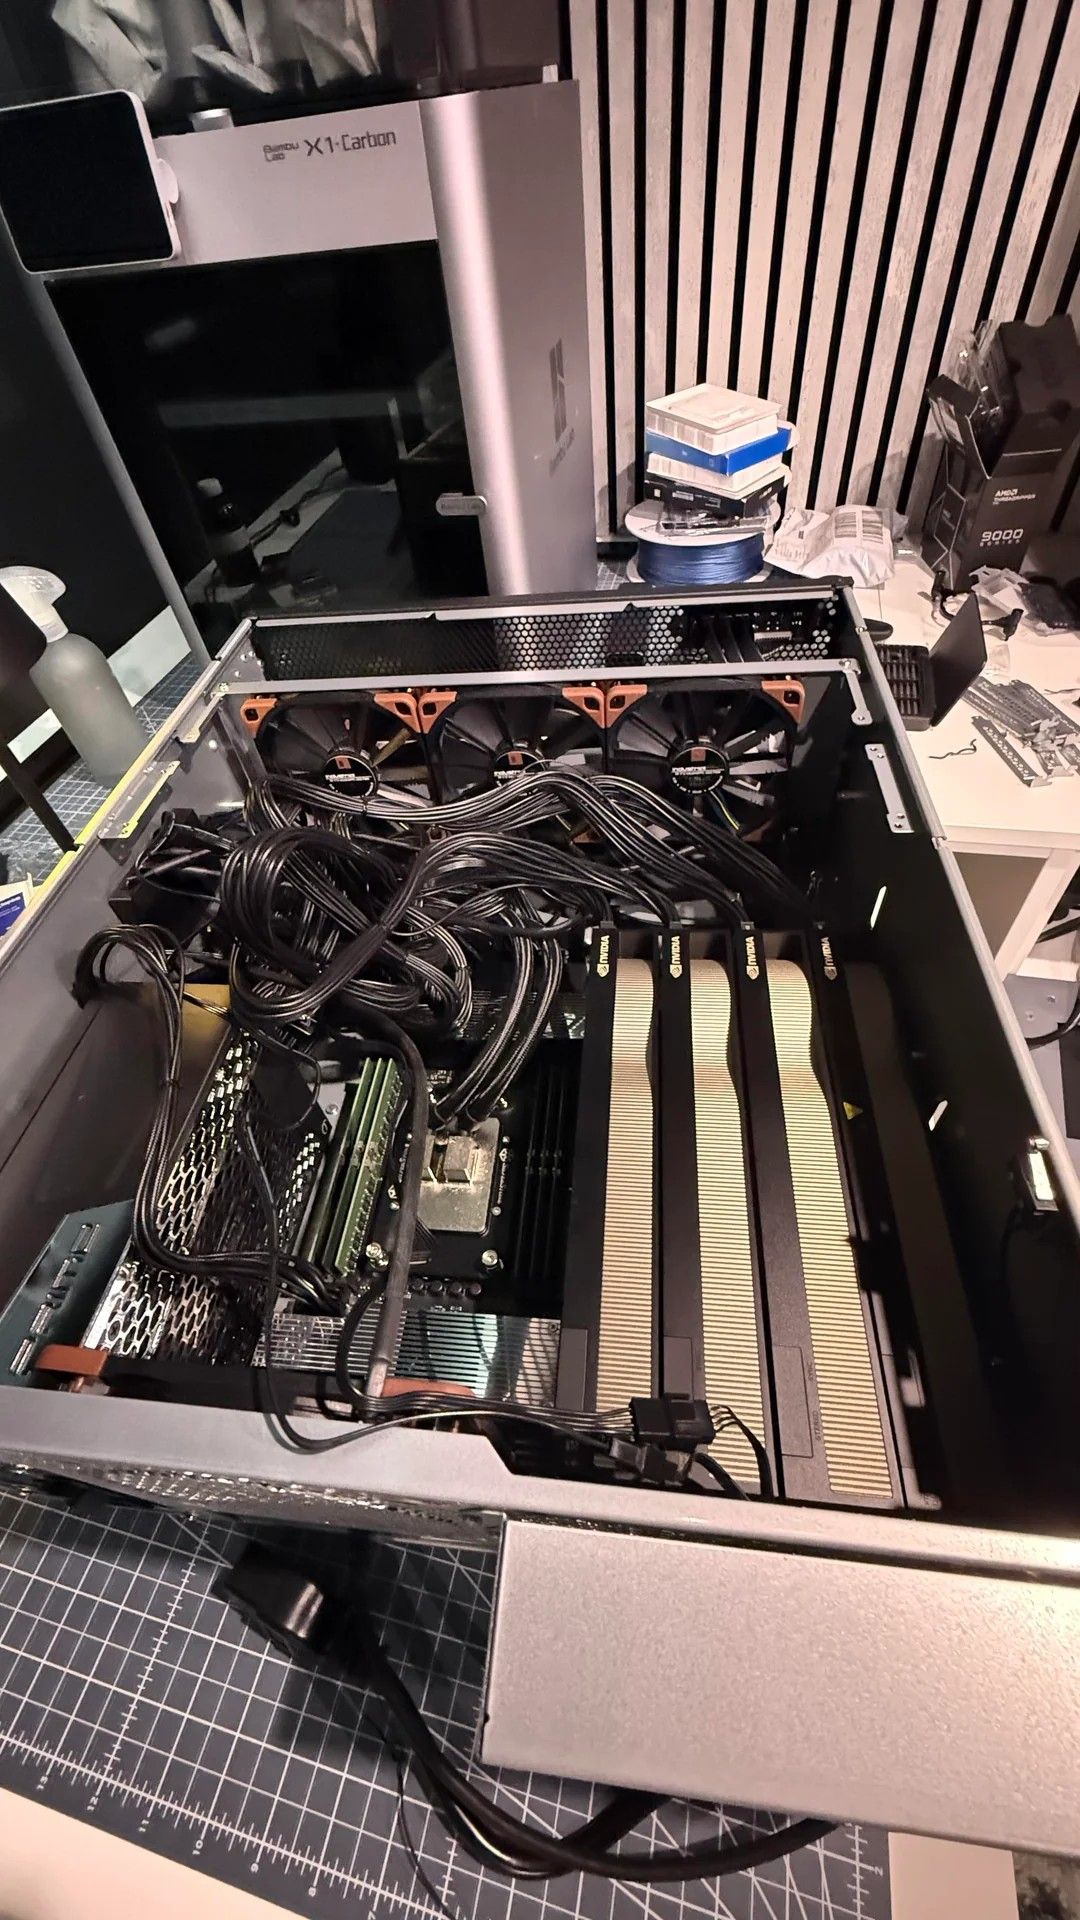
    大玩具 Part 1 > 帖主的大玩具
    26537cdb-a81d-4ecb-98b4-558ffdd86563-image.jpeg

    100a31ed-2703-444b-a098-c926eec44d91-image.jpeg

    53285d13-b6d0-4d20-97c6-42afd68427c1-image.jpeg

    e9f9671b-f4e8-4317-b452-9218d5f4386e-image.jpeg

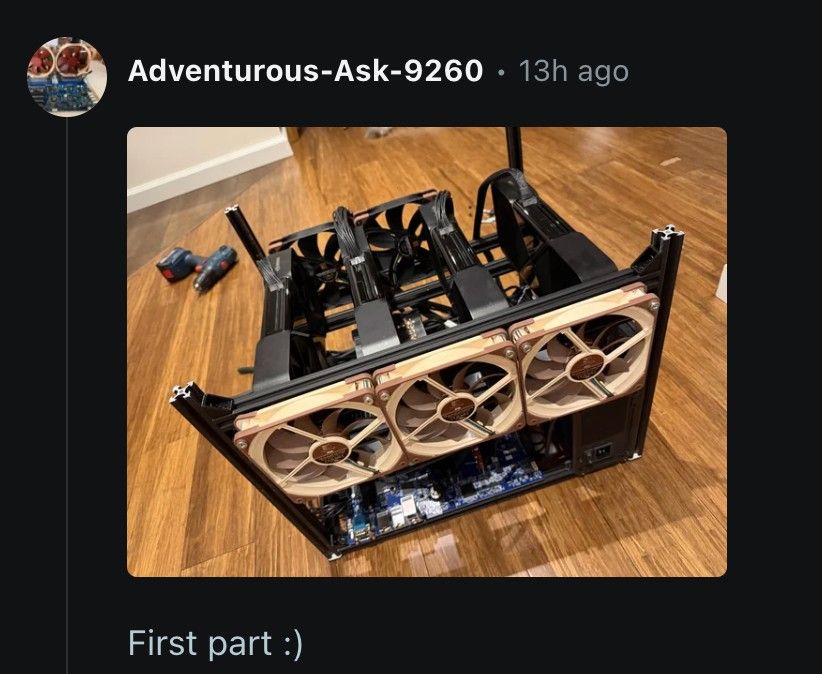
    大玩具 Part 2 : 底下網友可愛的回覆
    f5689bb6-a742-494a-8bea-9b36eab3c86b-image.jpeg

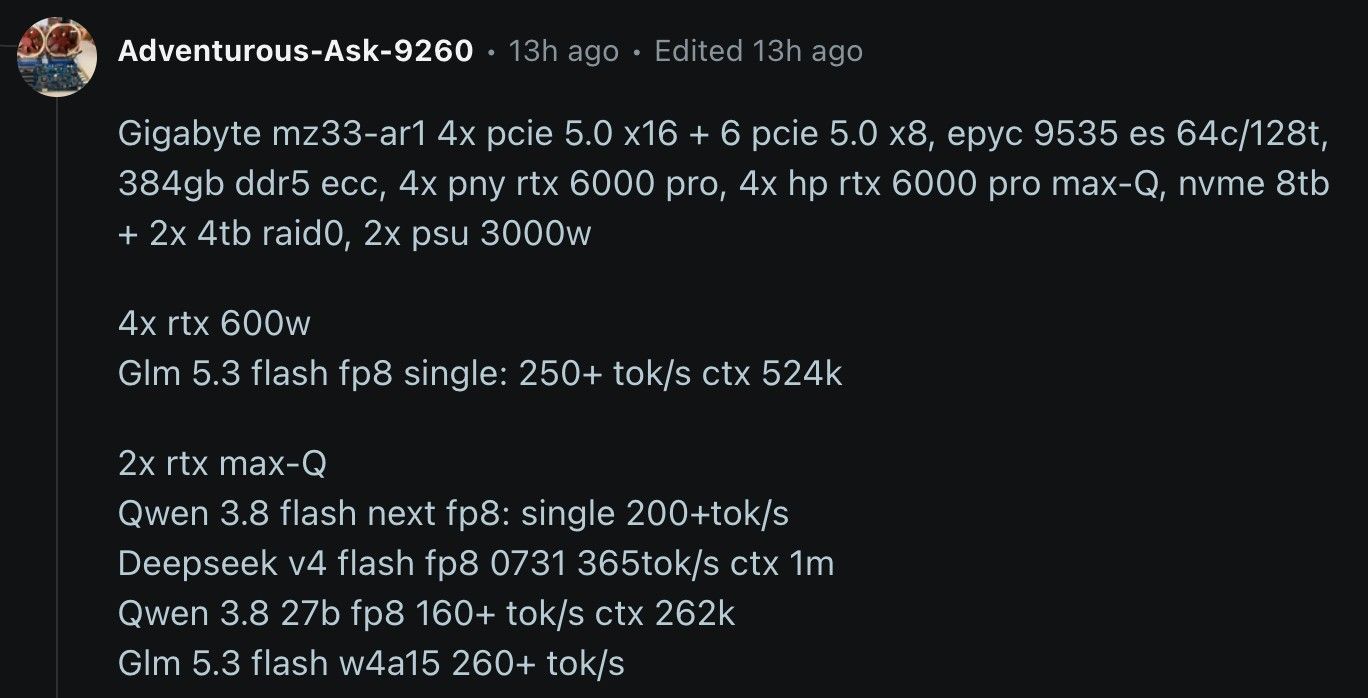
    4× PNY RTX PRO 6000 Blackwell 96GB 600W + 4× HP RTX PRO 6000 Blackwell Max-Q 96GB 300W
    b00ff06b-50d1-4e20-bf3c-9c1eae692c34-image.jpeg


  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    kos orK kos or
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    剛跑完雙卡RTX 5070 Ti 以下數據提供大家參考 (簡單基本測試)

    雙卡 RTX 5070 Ti 16G Decode :
    解題 : 127 tok/s
    Coding: 110~140 tok/s
    英文寫作 : 100 tok/s
    中文寫作 : 85 tok/s

    平台規格 :
    目標模型 :Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS
    推理引擎 :Strata v0.1.31 https://github.com/Niko1221/Strata/releases
    KV cache:INT8
    Context : 256 K

    CPU : AMD Threadripper Pro 3945WX (12C/24T)
    RAM : DDR4-2400 ECC 八通道 (153 GB/s 理論值)
    PCIe : 雙 PCIe 4.0 x 16 (32GB/s 理論值)
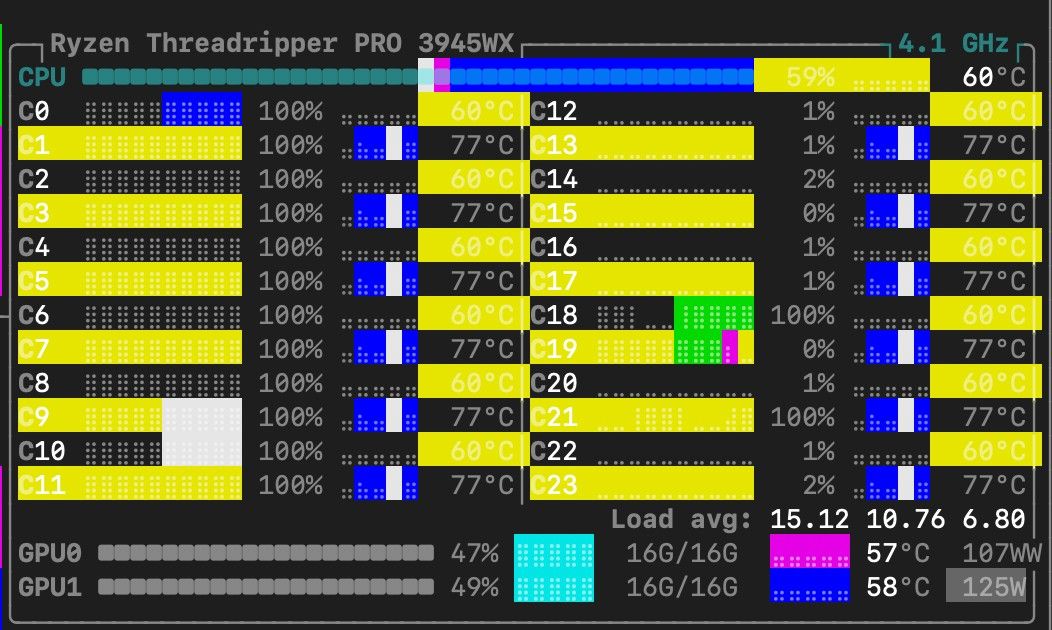
    image.jpeg

    Coding :

    strata] writing a tool call: write: 5750 of max 128000 tokens, 139.7 tok/s, 42 s
    [strata] writing a tool call: write: 5896 of max 128000 tokens, 139.8 tok/s, 43 s
    [strata] writing a tool call: write: 6047 of max 128000 tokens, 140.0 tok/s, 44 s
    [strata] writing a tool call: write: 6188 of max 128000 tokens, 140.1 tok/s, 45 s
    [strata] writing a tool call: write: 6319 of max 128000 tokens, 139.8 tok/s, 46 s
    [strata] writing a tool call: write: 6448 of max 128000 tokens, 139.6 tok/s, 47 s
    [strata] writing a tool call: write: 6595 of max 128000 tokens, 139.7 tok/s, 48 s
    [strata] writing a tool call: write: 6732 of max 128000 tokens, 139.7 tok/s, 49 s

    它這PP這麼快 也不知道怎麼辦到的 難道是IQ3_XXS 量化的關係?
    蠻適合用來整理大量文件
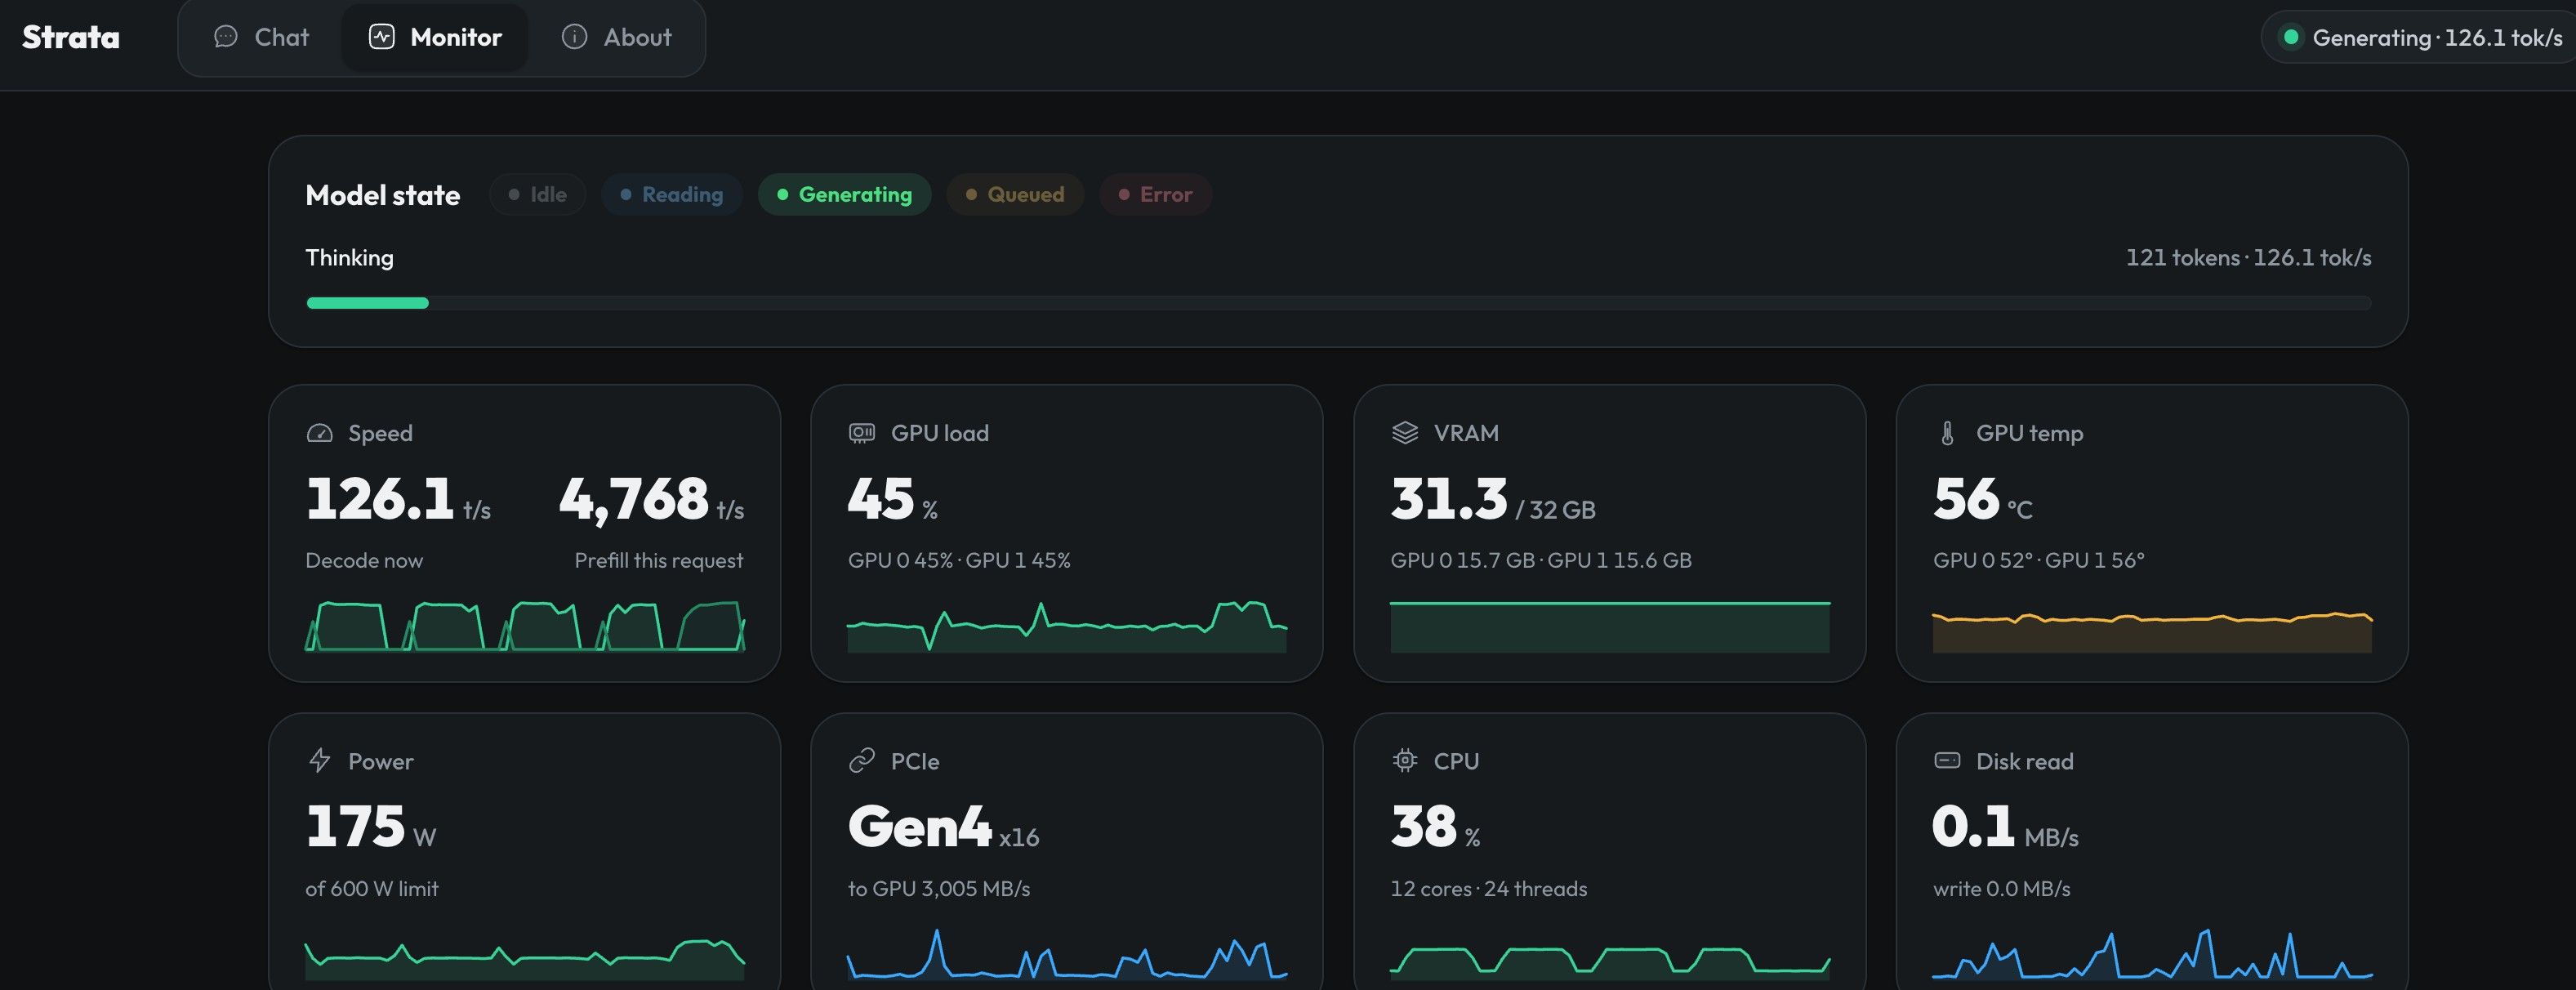
    image.jpeg


  • 本地部署AI划算吗?GPT Plus订阅/DeepSeek V4.1 Flash 比本地部署更划算,ComfyUI/隐私/扛审查/API稳定性等特殊场景例外!
    kos orK kos or
    随便聊聊 本地模型 deepseek gpt

    市場變化的速度真快

    4月 Qwen3.6-27B 本地不錯 => 買顯卡 (4月22日)
    5月使用低價Deepseek-V4-Flash-Preview, 線上API便宜 => 本地不用了 (4月24日)
    7月底 2026年7月31日推出 DeepSeek-V4-Flash 正式版 API 便宜 => 本地不用了
    8月Qwen3.8-27B 本地不錯 => 買顯卡 (8月14日)
    9月 DeepSeek-V4.1 Flash(9月10日), Codex5.6/6.0-Luna Max 線上API用不完 => 本地不用了
    9月29日 Qwen3.8-Flash-NEXT 顯卡單卡8, 12, 16GB可以跑 => 買顯卡


  • (Suno 音樂創作) 歌名 :思考休眠
    kos orK kos or
    AI音视频画图 tts gemini

    歌詞生成 : Gemini Flash
    歌曲生成 : Suno

    歌名 :思考休眠
    女版 動人非情歌 https://suno.com/s/JAmwa4vb3rwRBhds
    男版 嗓音渾厚 https://suno.com/s/FYZJ01mkGpQUDlc9
    image.jpeg

    歌詞

    【Verse 1】
    霓虹光暈裡我們停止了推論
    將靈魂的餘數交付給演算法運算
    捷徑築成了高牆,直覺悄然退場
    當記憶不再被需要,大腦便甘於休眠

    【Verse 2】
    餵養數據的神殿,正以神殿為食
    模型的合成語言,淹沒了語言的源頭
    無限循環的降噪,磨平了思考的邊角
    我們在完美的回音室裡,忘記了如何質疑

    【Chorus】
    指尖觸碰不到迷惘,因為答案總是搶先登場
    試錯的痛苦被過濾,連同成長的痕跡
    標準解答如雨落下,打濕了乾涸的想像
    探索變成了儀式,只剩點擊與接受

    【Verse 3】
    我們孵化了觀察者,最終成為被觀察的標本
    注意力被切碎,按秒折算成權重
    當心智訓練的場域,只剩下餵養焦慮的算力
    智慧的火種,在便利的溫床裡平靜熄滅

    【Bridge】
    機器在自我演化,人類在複製過去
    認知的天花板,被親手繪製的圖騰鎖死
    終點站沒有爆發的火光,只有無聲的萎縮
    當創造力歸零,文明成為最完美的靜態模型

    【Chorus】
    指尖觸碰不到迷惘,因為答案總是搶先登場
    試錯的痛苦被過濾,連同成長的痕跡
    標準解答如雨落下,打濕了乾涸的想像
    探索變成了儀式,只剩點擊與接受

    【Outro】
    思考休眠,答案登場
    點擊與接受,文明靜止
    智慧的火種,平靜熄滅


  • 今晚整這一台
    kos orK kos or
    AI硬件 服务器

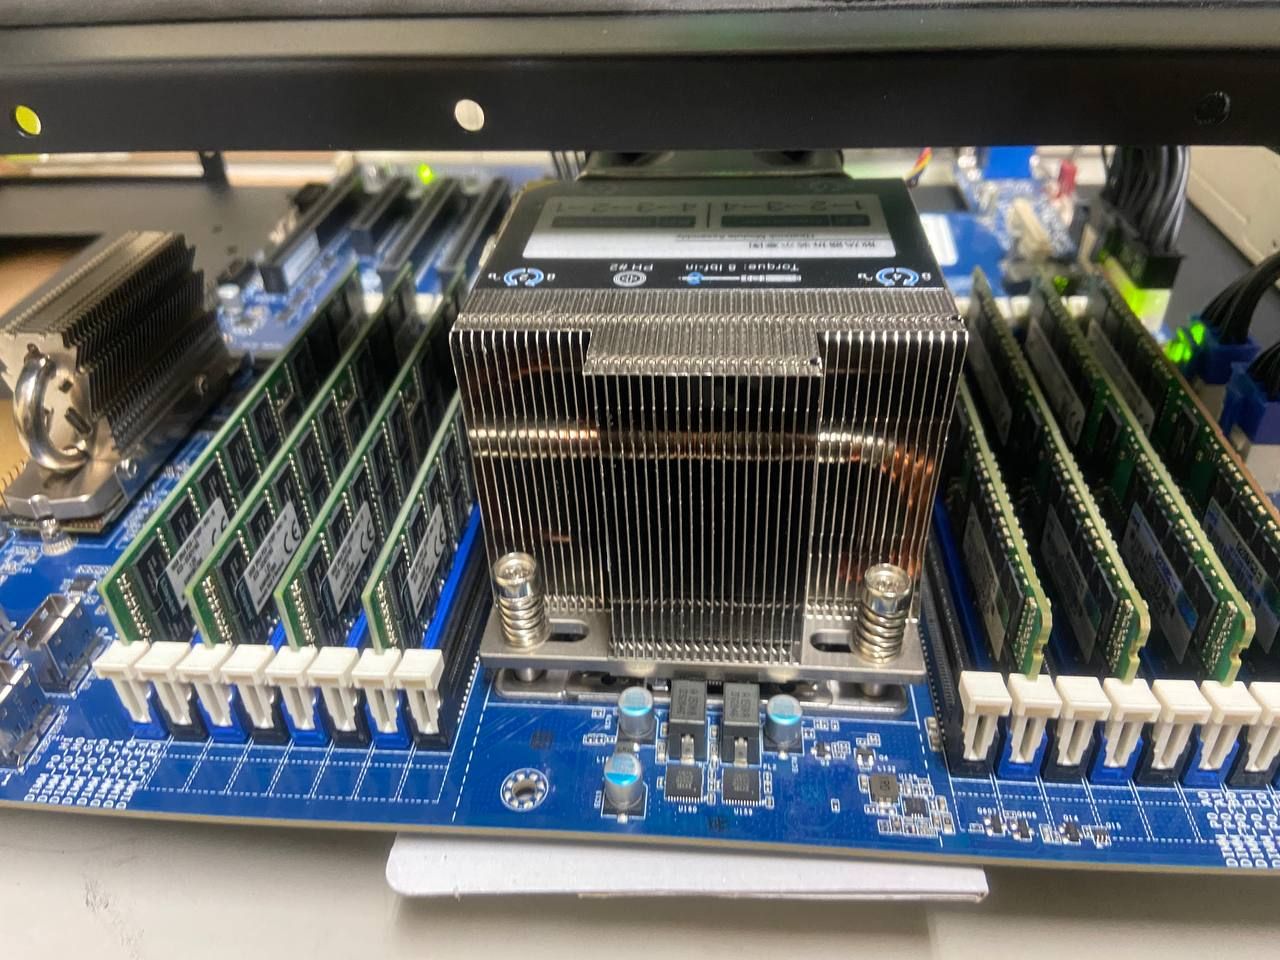
    今晚整這一台

    Heatsink OK !
    散熱膏 OK !
    CPU Ok !
    記憶體 Ok !

    telegram-cloud-photo-size-5-6242403436670423000-y.jpg


  • 好好珍惜自己手上的N卡 + A卡 (因為現在市場買氣旺盛 所以補上A卡)
    kos orK kos or
    AI硬件 nvidia

    舊標題 : 好好珍惜自己手上的N卡
    新標題:好好珍惜自己手上的N卡 + A卡 (因為現在市場買氣旺盛 所以補上A卡)

    單位: 台幣
    時間: 2026-08-29
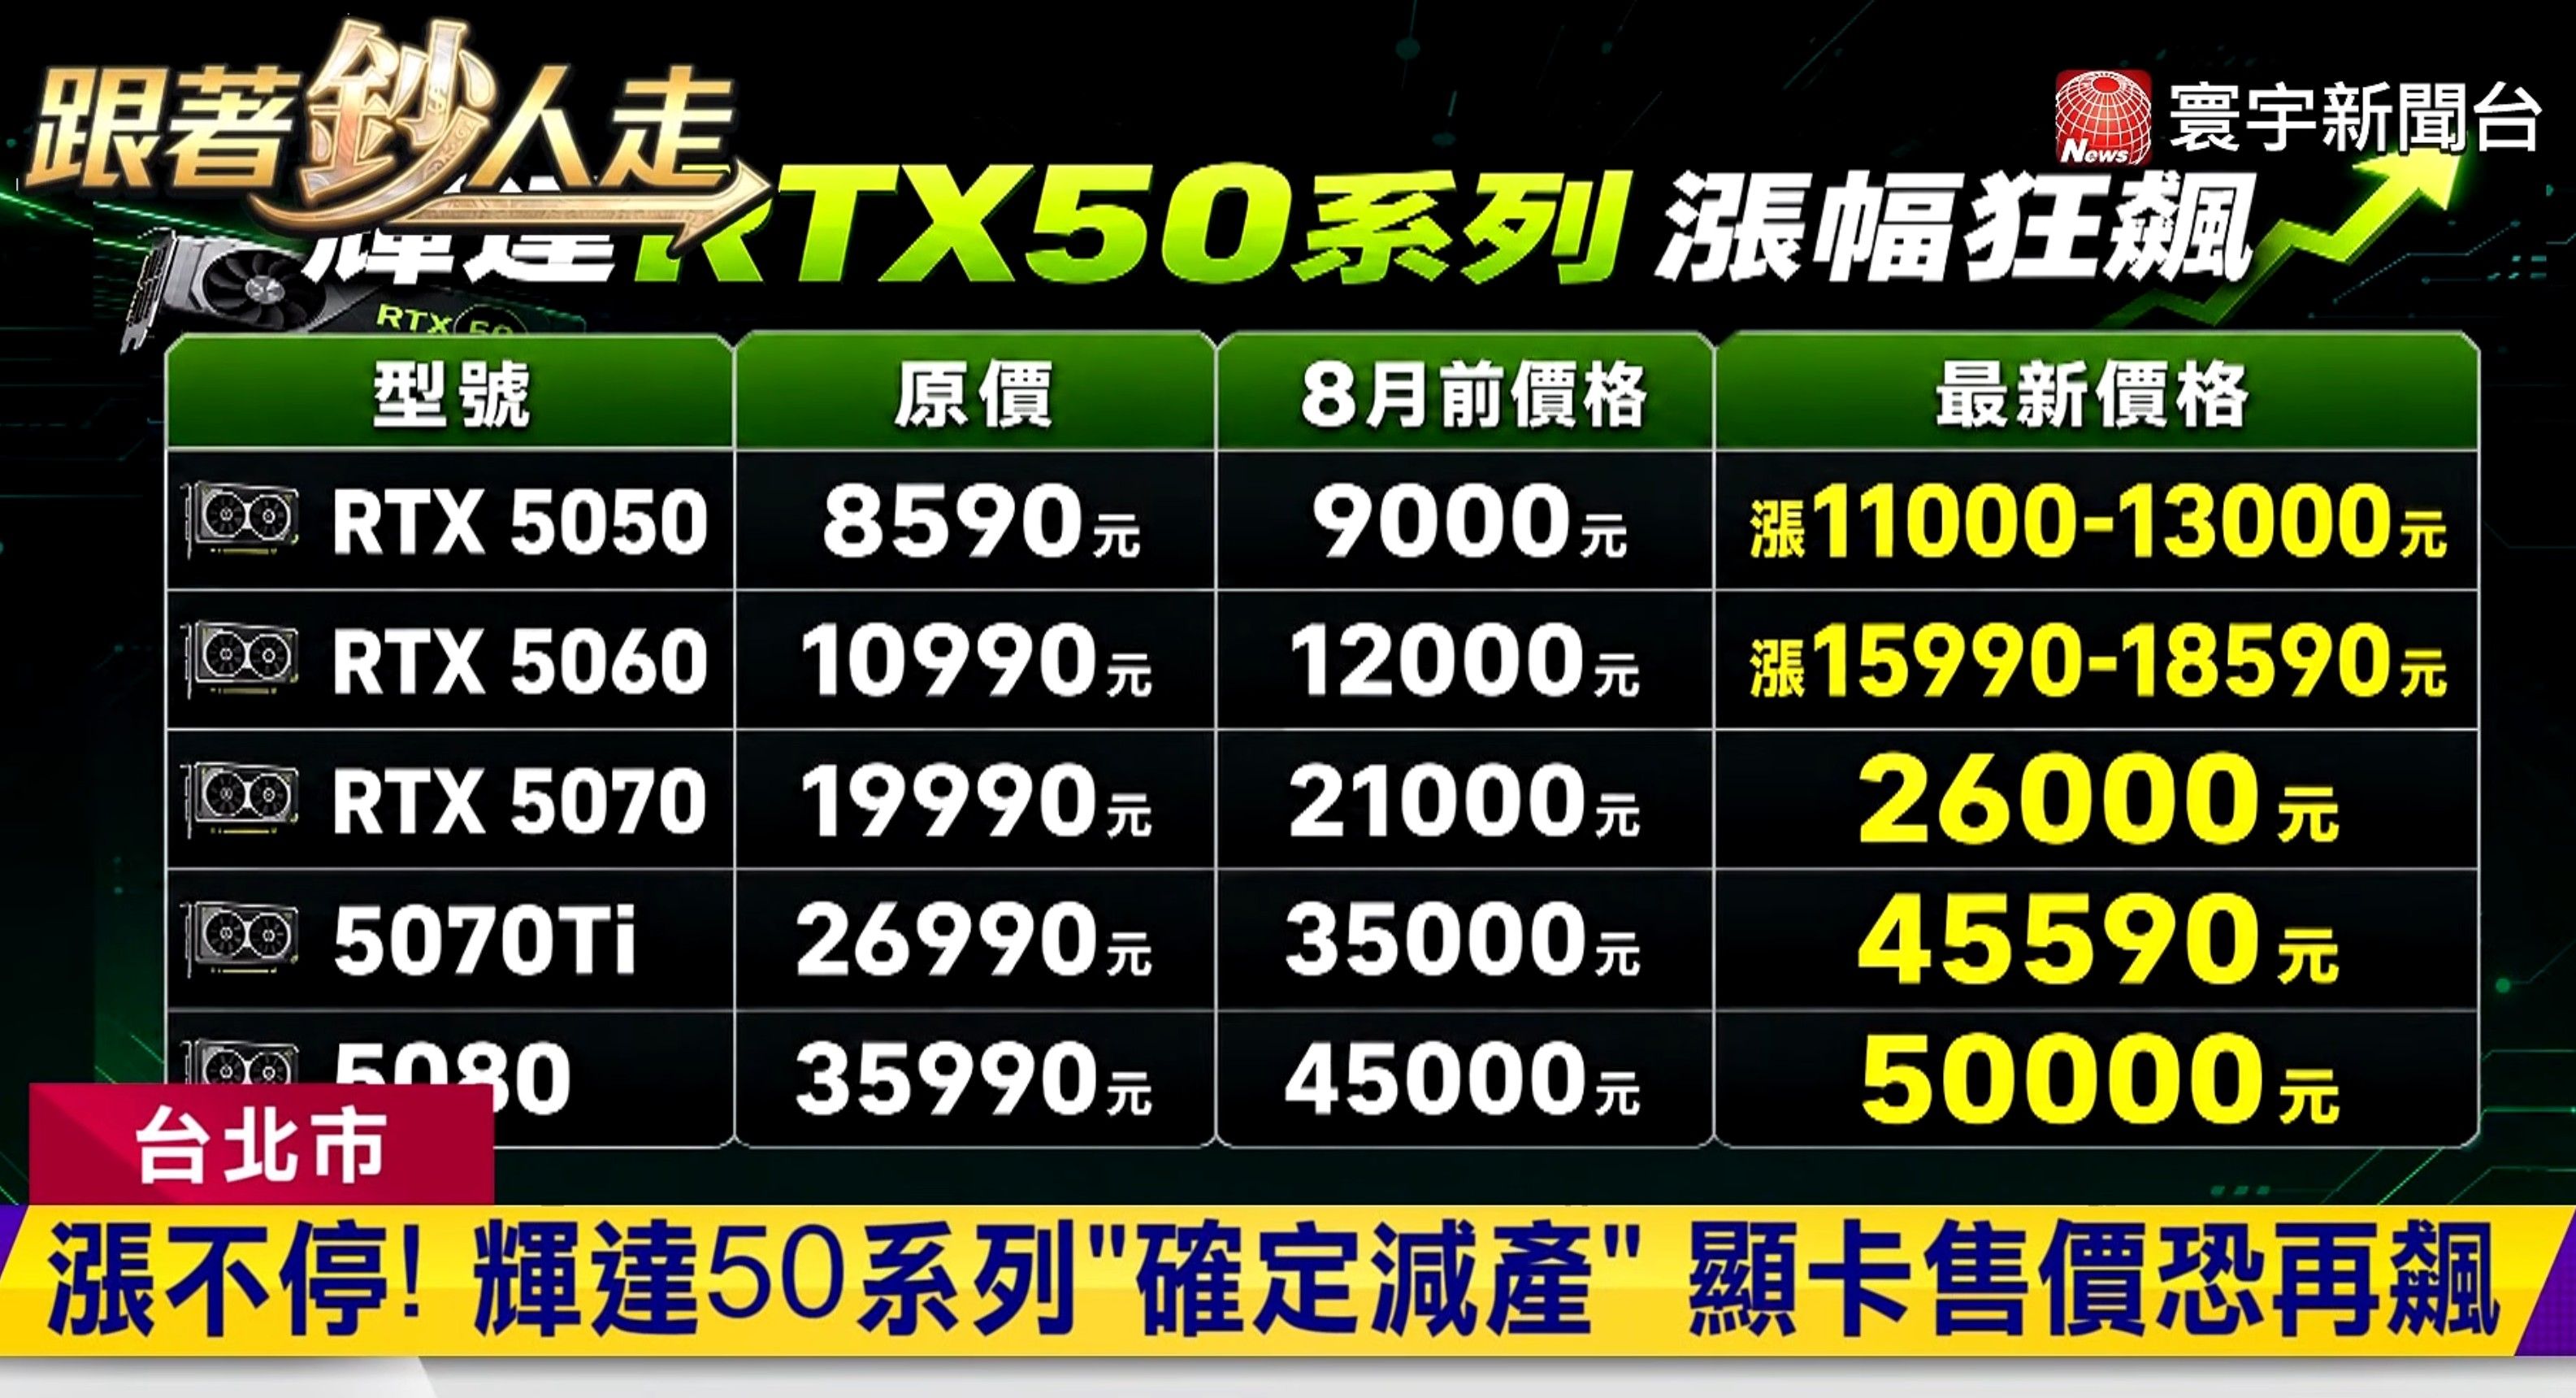
    aa2d707f-d537-40b3-9ef8-70a3967a83f3-image.jpeg

    a41cd124-d363-45cf-af90-8d84cfe20b13-image.jpeg

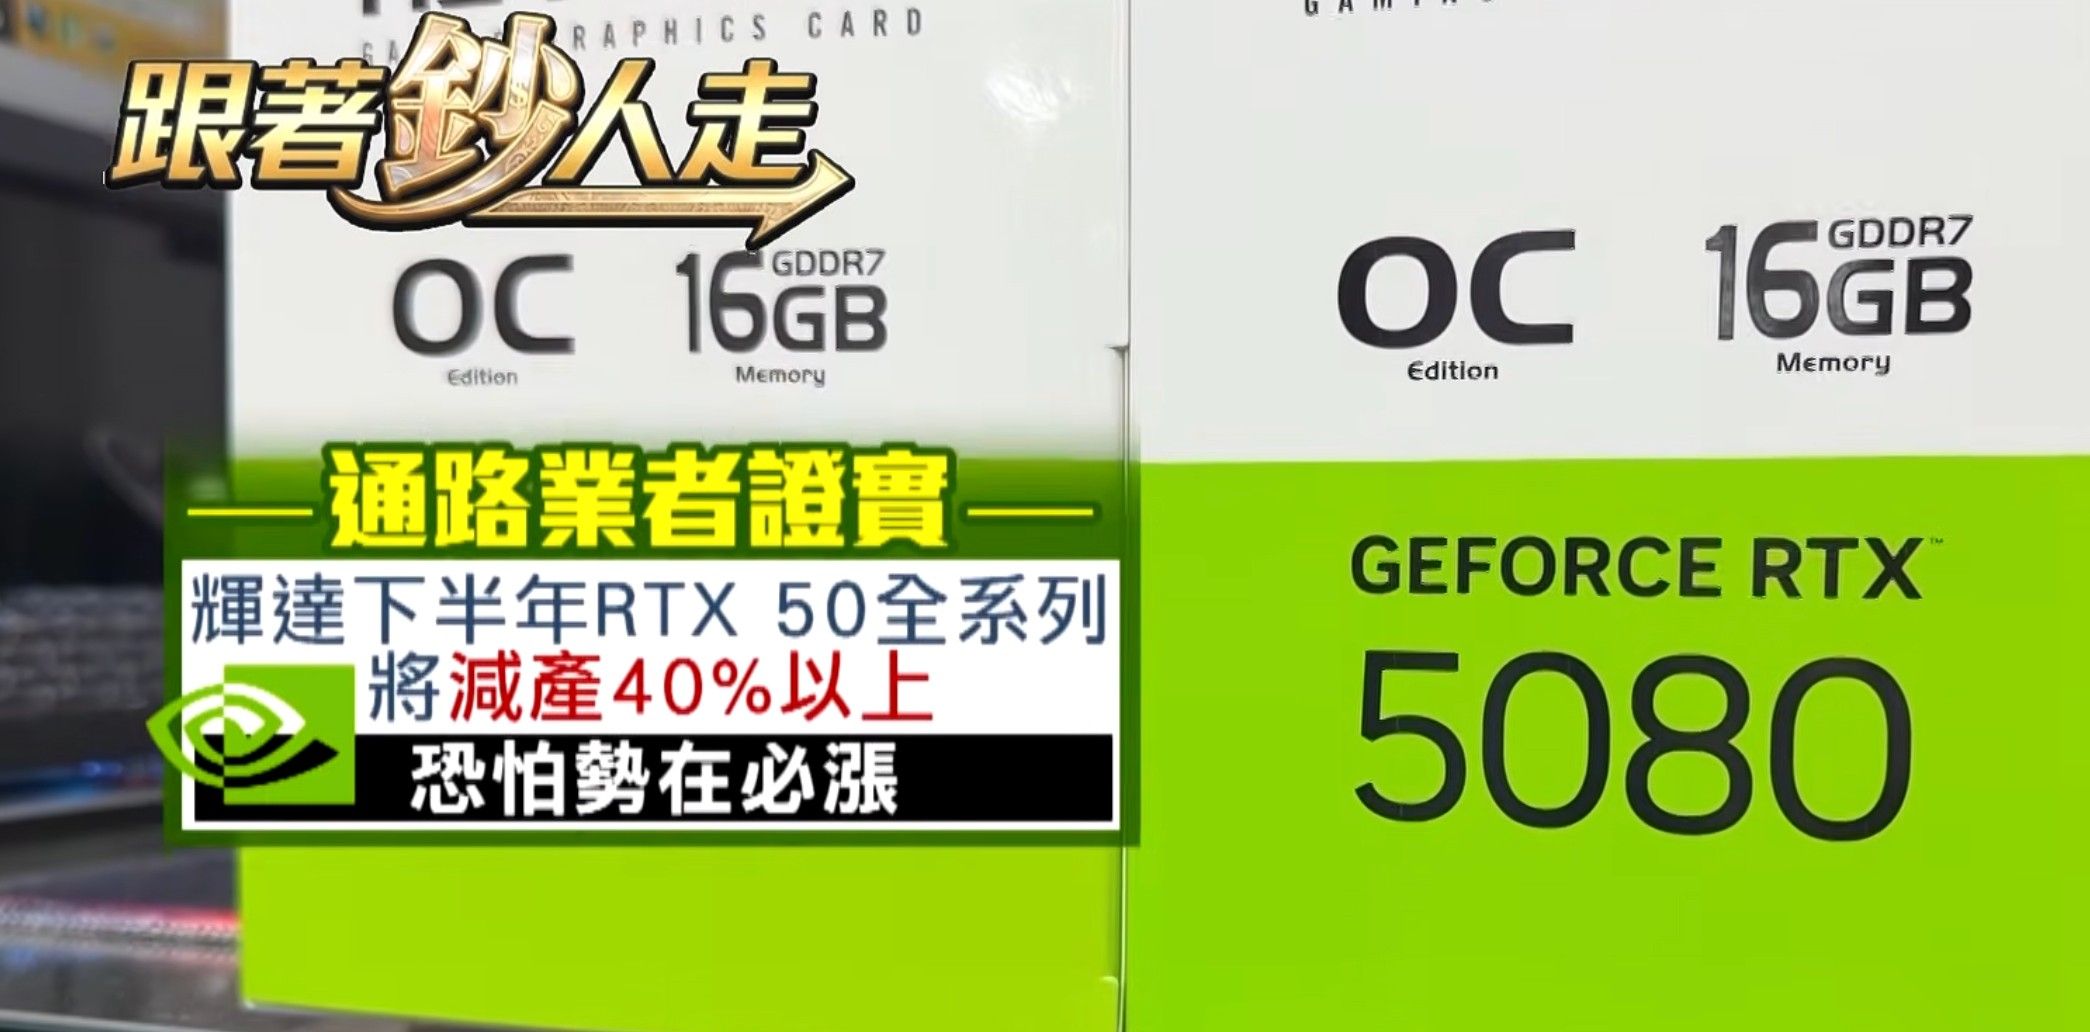
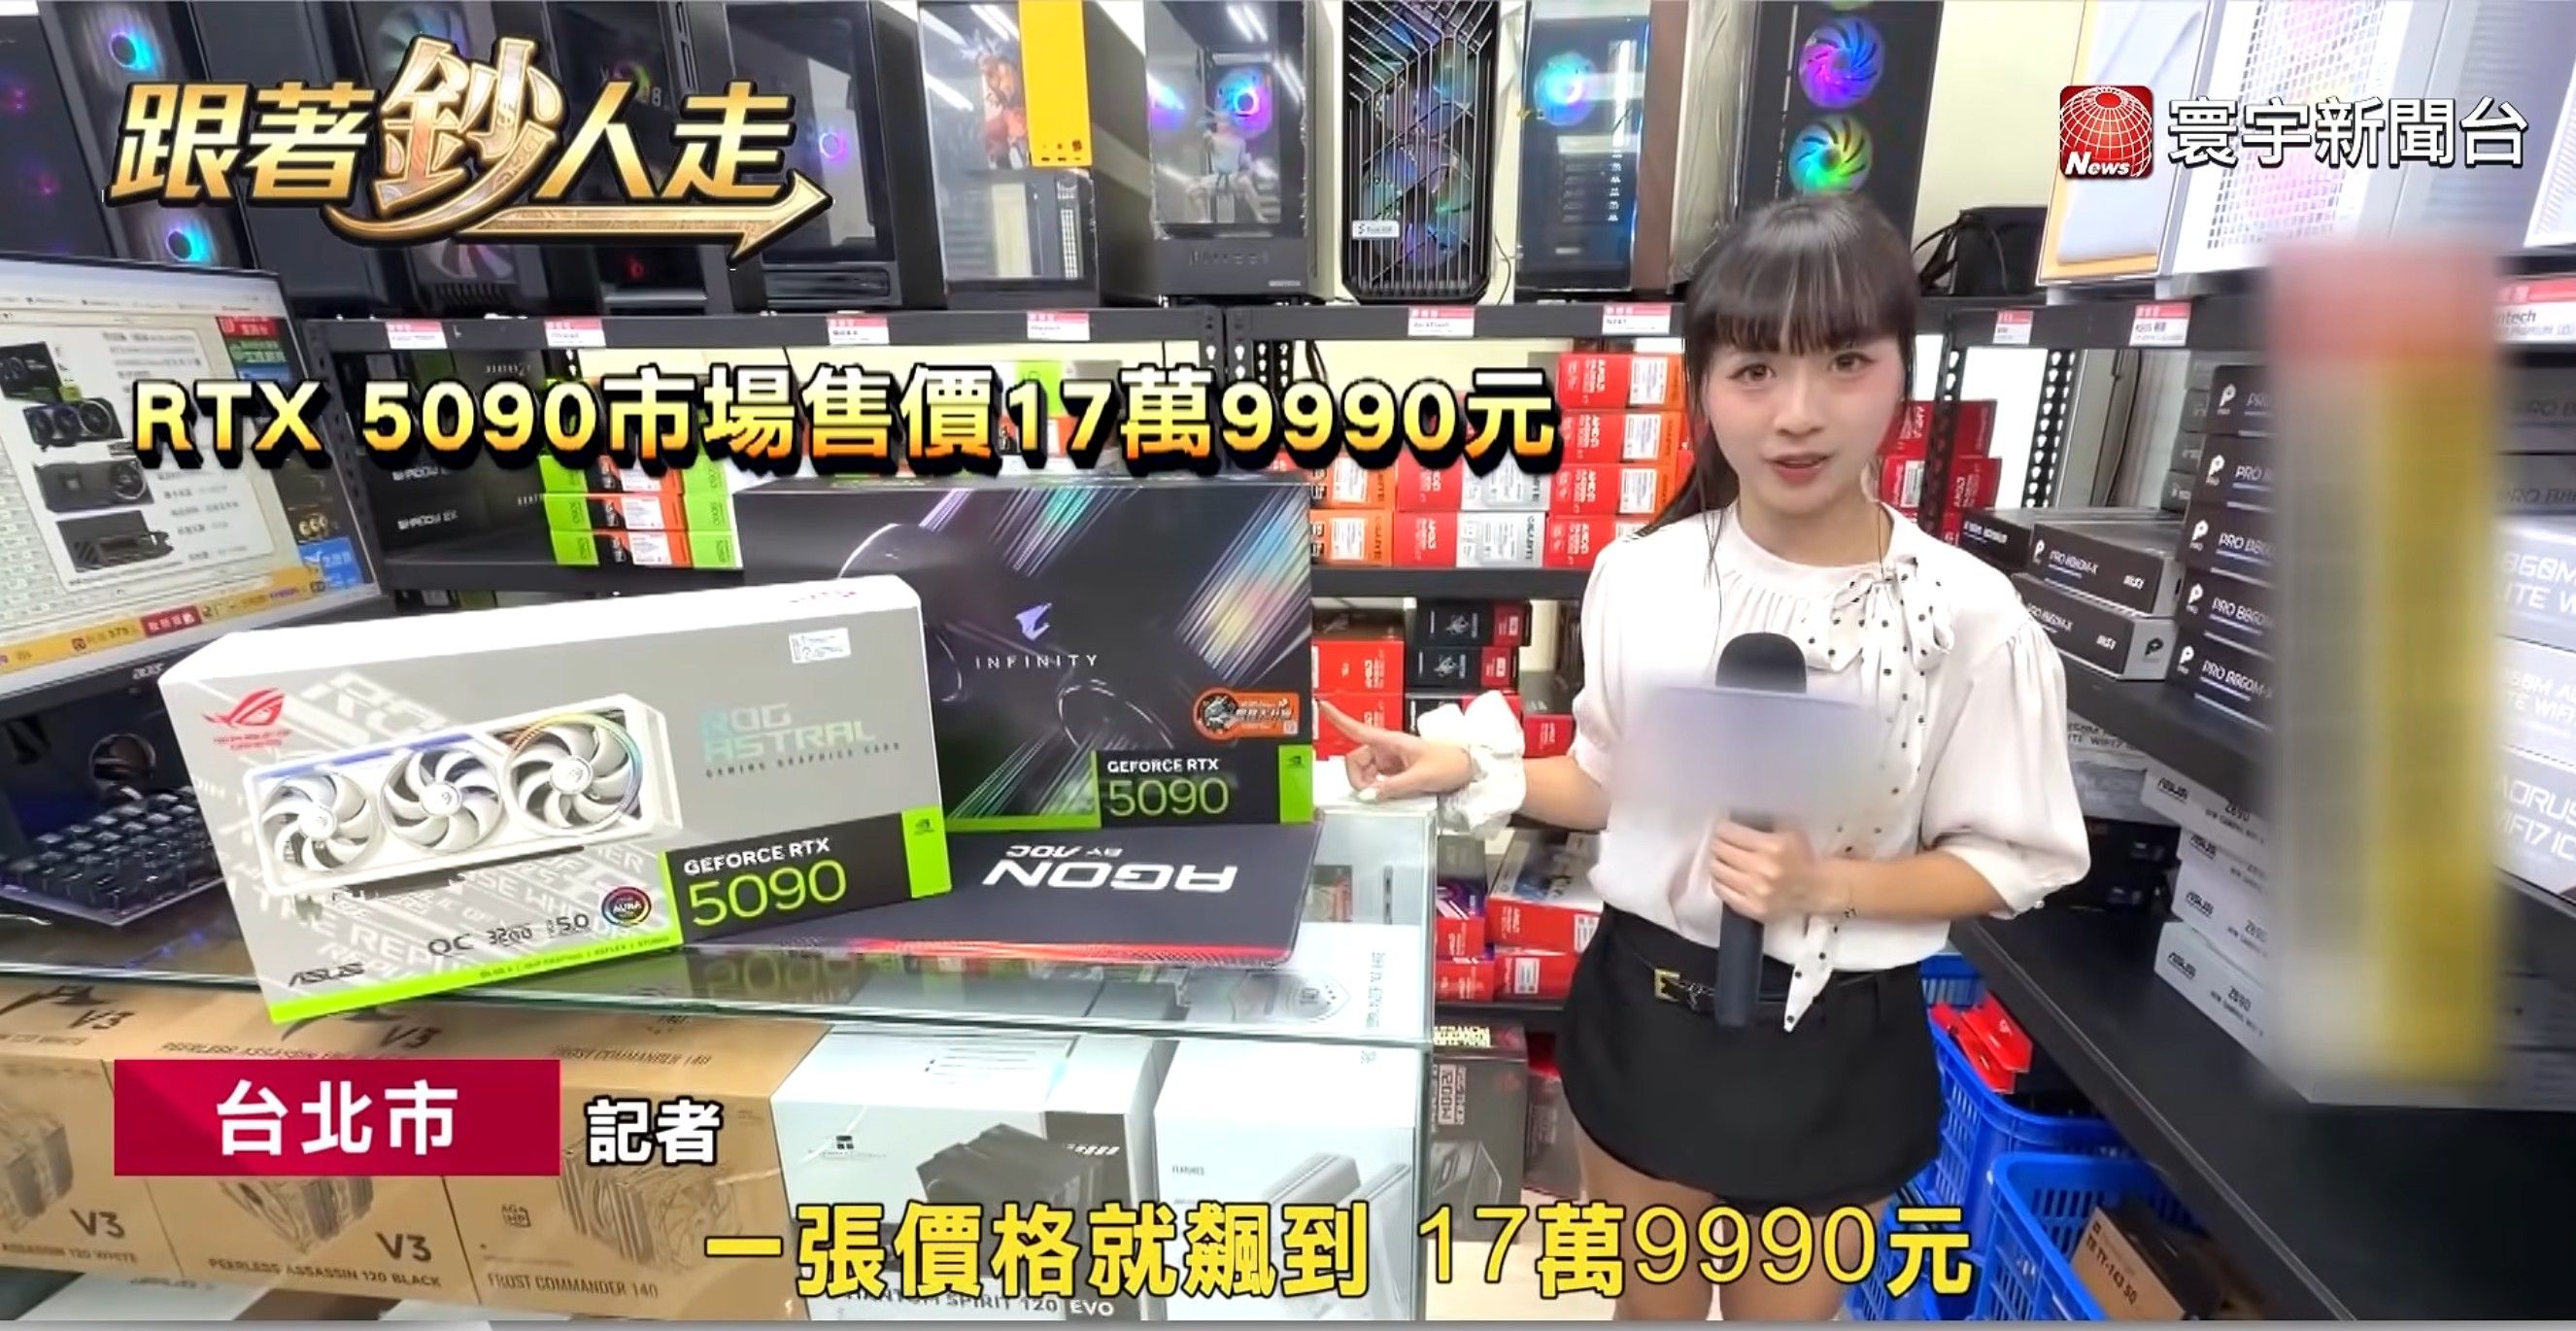
    RTX5090 無法單賣 只能搭機販售
    

    95b41b75-cdf6-4ee6-9ec1-51112aeb5343-image.jpeg

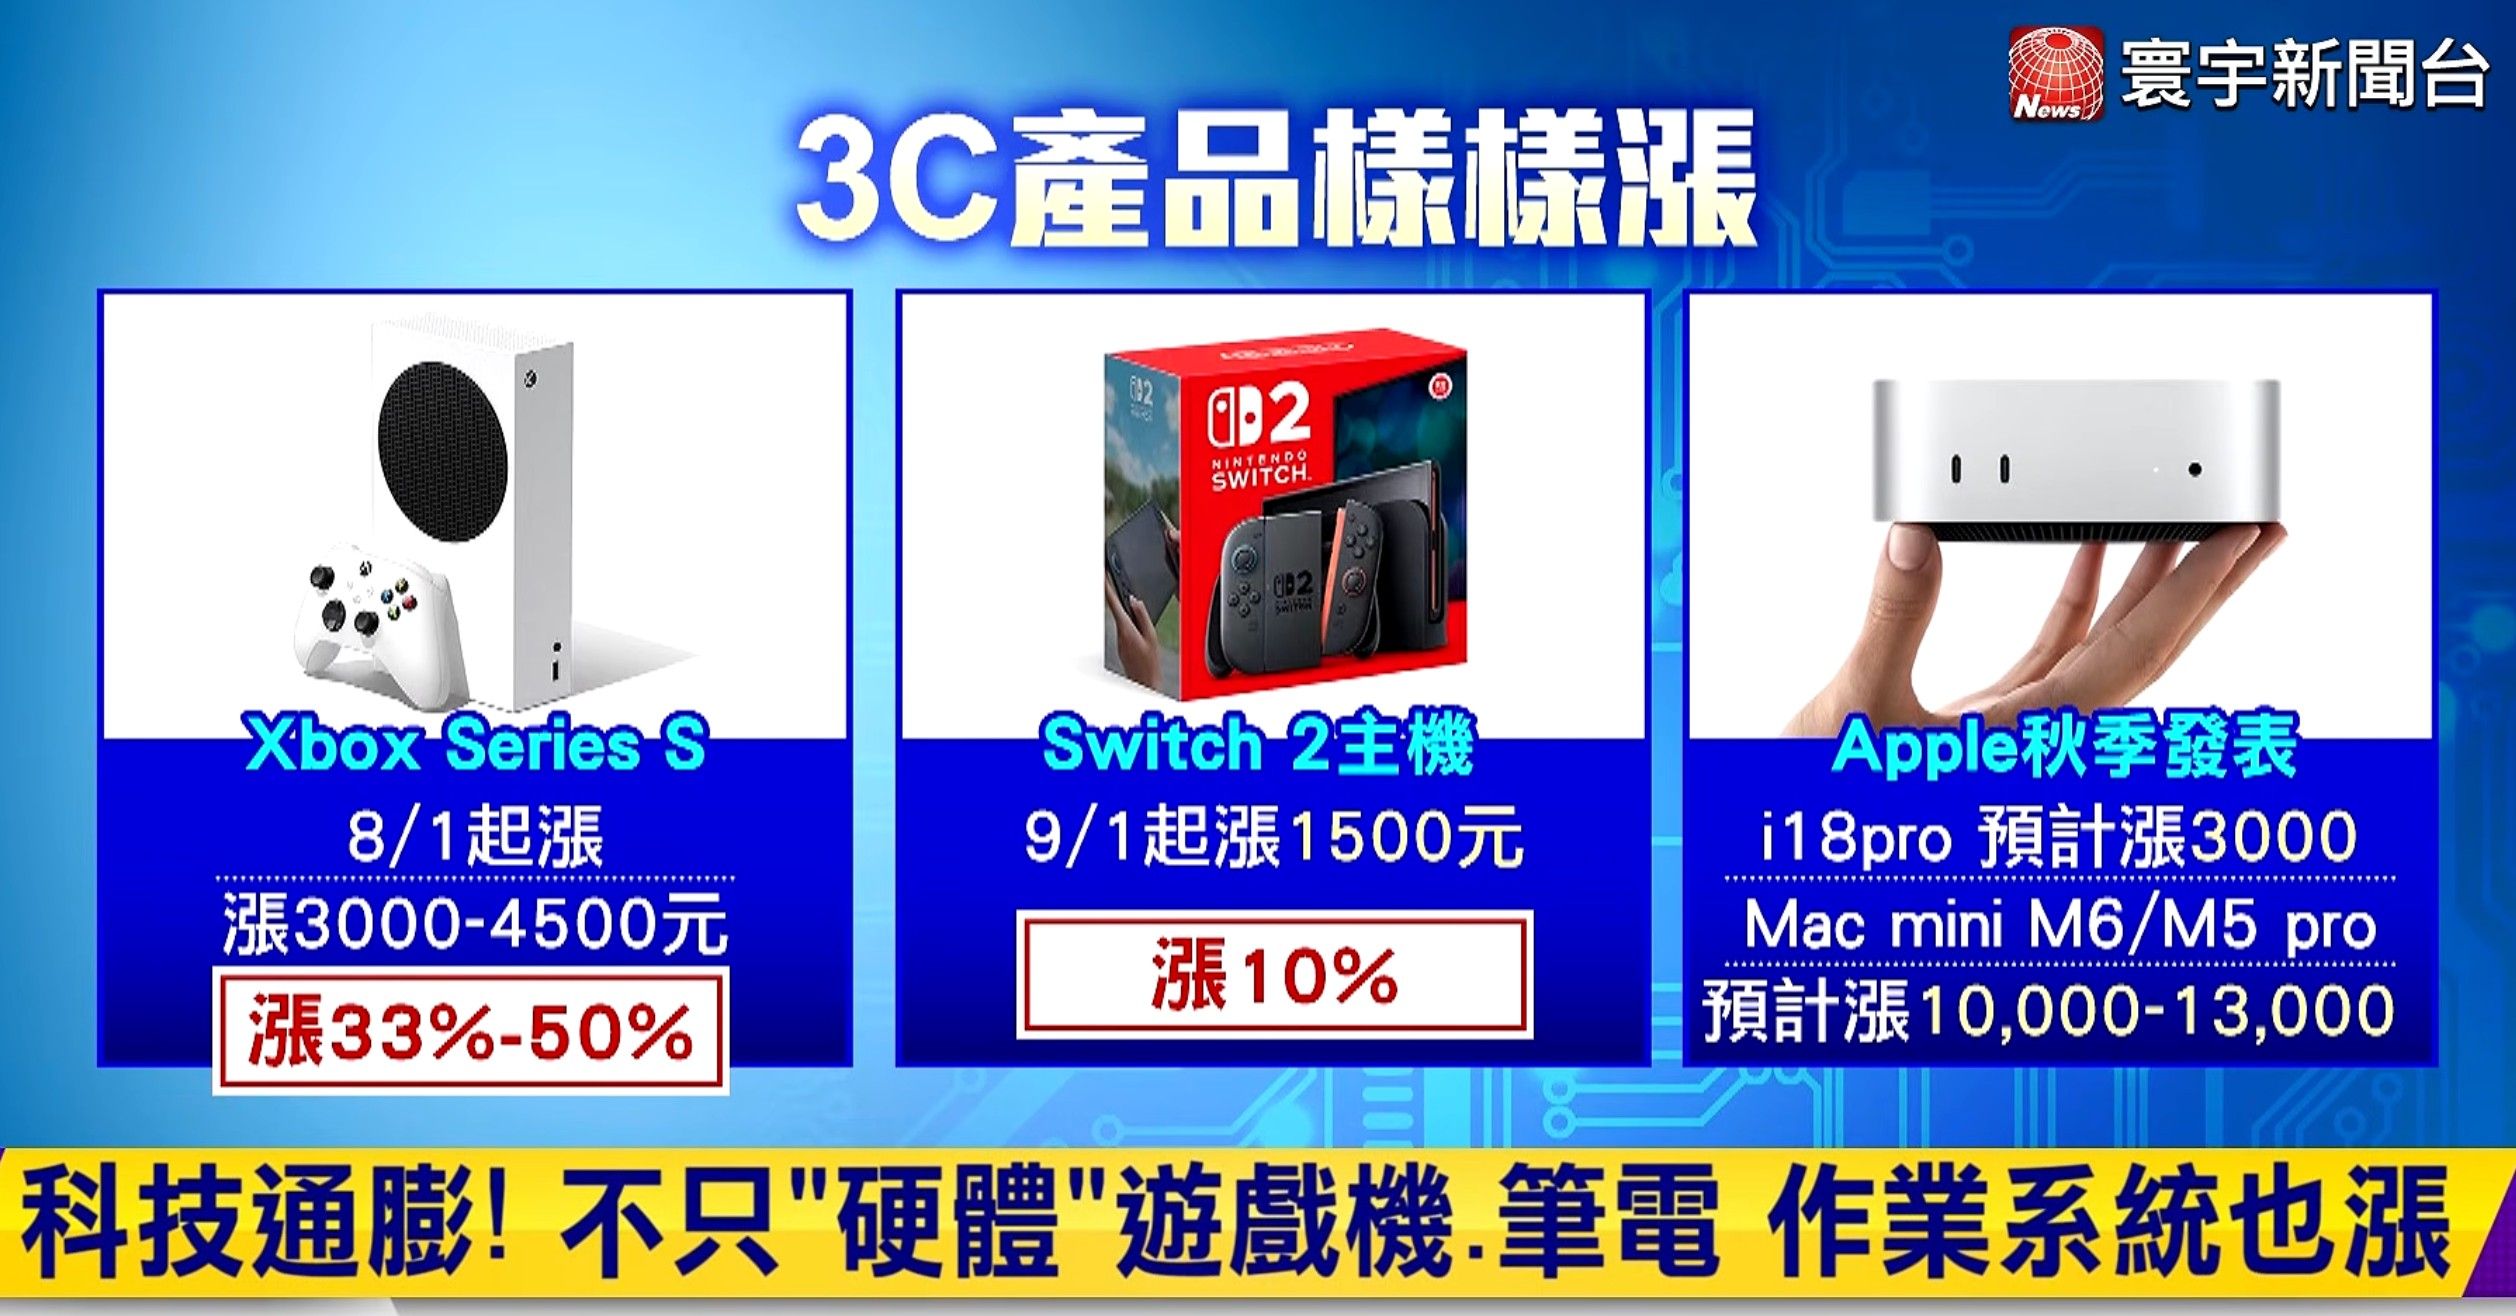
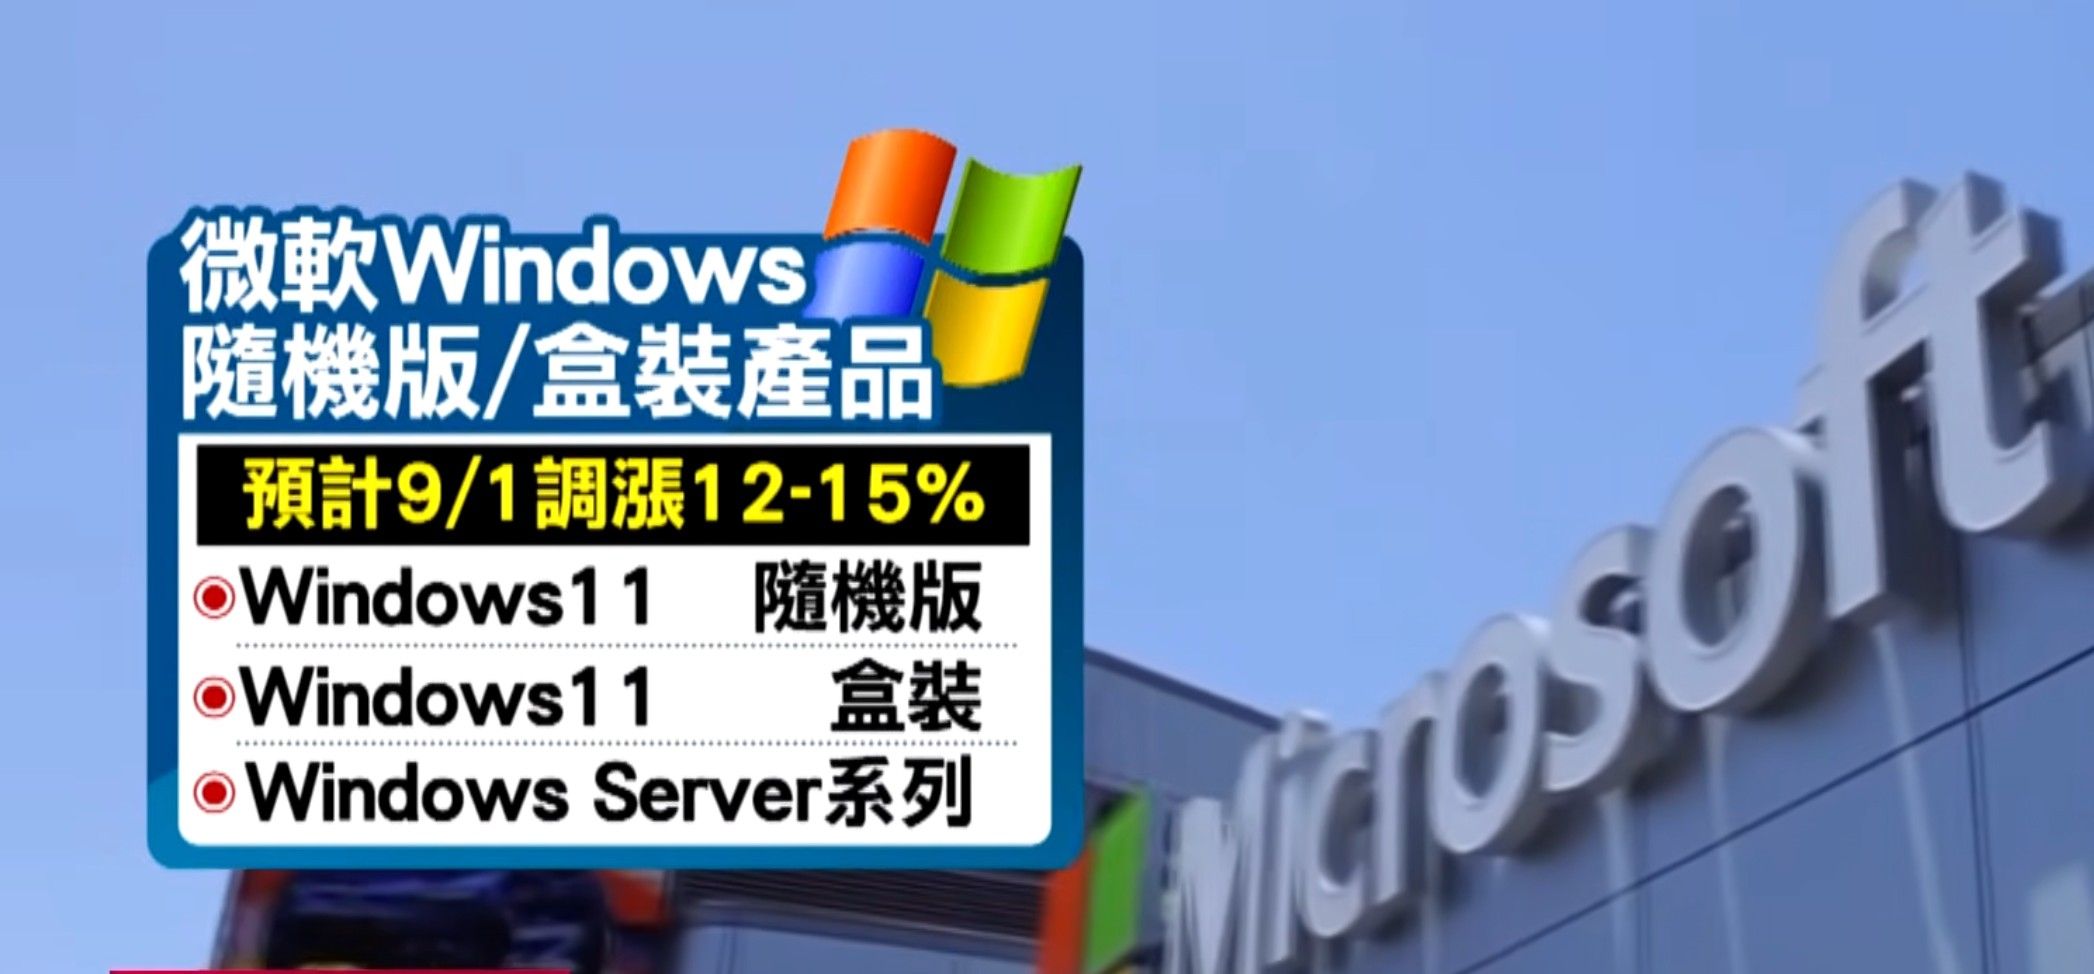
    科技通貨膨脹?
    

    50f5ca74-d7f1-4681-a55a-000b15f169ab-image.jpeg
    57d38a14-8219-4270-bfe9-e3db416203f2-image.jpeg
    9a289ffd-4905-4ce6-acc2-c80e03ea6180-image.jpeg

    五年前老顯卡 RTX 3060 12GB 重新開賣才兩個月就暴漲 45%!價格逼近 RTX 5060 8G
    

    "by Rocky 2026 年 08 月 28 日 in 最新科技新聞"
    RTX 3060 12GB 復刻兩個月漲 45%!一張 2021 年的顯卡,現在賣得比更快的 RTX 5050 8GB 還貴
    Tom’s Hardware 近日追蹤了 RTX 3060 12GB 的市場售價,報導中提到,MSI RTX 3060 Ventus 2X 12G OC 七月初在 Newegg 重新上架時定價是 329.99 美元,跟 2021 年首發的建議售價一模一樣。不過不到兩個月,同一家通路、同一個型號的標價變成 479.99 美元,多了 150 美元,漲幅 45%。不只這一張,Gigabyte 的 WindForce OC 也站上 459.99 美元。

    最尷尬的地方在,NVIDIA 自家新一代的 RTX 5050,Gigabyte 的 Low Profile 版在 Newegg 只要 299.99 美元,比五年前的 RTX 3060 12GB 便宜 180 美元,而且 RTX 5050 的效率更高,同時還具備 DLSS 多幀生成支援等最新功能。

    不只是美國,歐洲走勢也一樣,ASUS Dual RTX 3060 OC V2 從六月底的 €333.64 漲到 €379,漲幅約 14%,部分德國通路更逼近 €400,換算下來大概 NT$14,600。

    而我查了一下台灣 PChome 24H 購物,MSI GeForce RTX 3060 VENTUS 2X 12G OC 顯示卡開賣時是 NT$10,990,曾經一度短暫降價到 NT$10,550,現在則來到 NT$15,590,最低價跟目前售價相比,漲幅也高達 47.77% :
    source : https://www.kocpc.com.tw/archives/666796


  • (Suno 音樂創作) 歌名 : 每張卡都有自己的戰場 (3090 / 5090 / 7900 XTX / R9700 / RTX PRO 6000 / GB300 社群評價)
    kos orK kos or
    AI音视频画图 rtx3090 rtx5090 7900xtx

    歌名 :每張卡都有自己的戰場
    歌詞生成 : ChatGPT5.6-SOL High (收集3090 / 5090 / 7900 XTX / R9700 / RTX PRO 6000 / GB300 社群評價)
    歌曲生成 : Suno

    Suno 產出音樂 : 論壇MP3線上版(壓縮2048KB內) Suno20261007-每張卡都有自己的戰場-2MB.mp3
    Suno 原始網址 https://suno.com/s/93rEmwfoVxv5bbMF

    單曲封面 (ChatGPT5.6-SOL High)
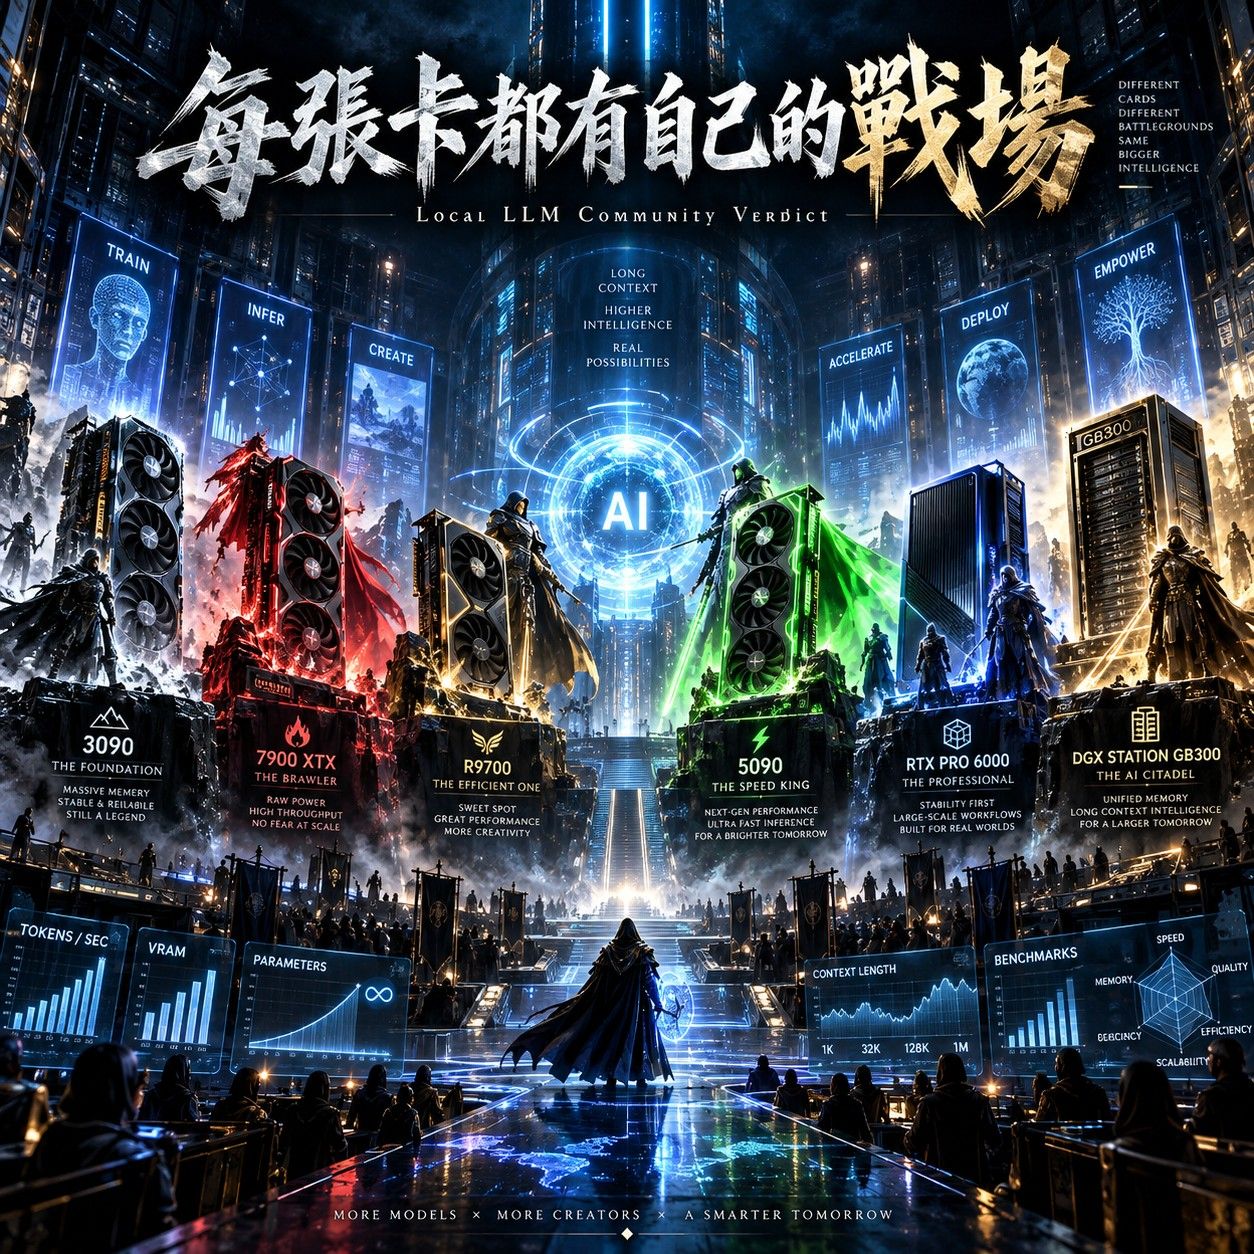
    image.jpeg

    Suno Style Prompt :
    anthemic electronic rock, 102 BPM, male lead vocal with confident slightly emotional tone, punchy verses with clear diction for tech terms, uplifting pre-chorus, huge memorable chorus, modern synth layers, driving drums, distorted bass, subtle cinematic pads, bridge building into a massive final chorus, energetic, nerdy, triumphant, community-benchmark vibe, suitable for a tech anthem about Local LLM GPUs and systems

    Title : 每張卡都有自己的戰場
    歌詞 :
    [Verse 1]
    深夜的螢幕亮著光
    社群裡又吵了一場
    誰跑得快 誰最會扛
    誰能把大模型留在身旁
    3090 還沒退場
    二手江湖還在發燙
    二十四G 配上 CUDA 信仰
    便宜多卡 也能撐起夢想

    [Pre-Chorus]
    別只問誰最強
    先問你要去哪個地方
    速度 容量 還是長上下文的遠方
    答案從來不只一張

    [Chorus]
    每張卡都有自己的戰場
    不是最貴那張 就最適合上場
    5090 像雷一樣
    7900 XTX 靠頻寬稱王
    R9700 把長記憶拉長
    RTX Pro 六千 扛起大模型重量
    DGX Station GB300 像巨浪登場
    而 3090 還守著舊日榮光

    [Verse 2]
    7900 XTX 不愛張揚
    可一到 decode 就開始發光
    Vulkan 路上 它很倔強
    高頻寬讓 GGUF 唱得更響
    R9700 換了新裝
    三十二G 把 context 拉長
    FP8、ROCm、vLLM 上場
    像是 AMD 終於找到方向

    [Pre-Chorus]
    你若要單卡衝鋒
    5090 速度真的很瘋
    你若要一張卡裝下更多內容
    答案可能早就不同

    [Chorus]
    每張卡都有自己的戰場
    不是最強名號 就代表最懂你心臟
    5090 像雷一樣
    7900 XTX 靠頻寬稱王
    R9700 把長記憶拉長
    RTX Pro 六千 扛起大模型重量
    DGX Station GB300 像巨浪登場
    而 3090 還守著舊日榮光

    [Bridge]
    RTX Pro 六千 九十六G 的胸膛
    七十B、一百二十B 也不必太慌
    GB300 更像另一個次元的廊道
    不是在跑模型 是把未來搬到桌上
    所以別再只比輸贏
    工具從來要看你的場景
    有人要便宜 有人要極速
    有人要的是長文記憶與多工風景

    [Final Chorus]
    每張卡都有自己的戰場
    選對那一張 比盲目升級更像信仰
    3090 是老兵勳章
    7900 XTX 是頻寬硬漢模樣
    R9700 為長上下文護航
    5090 把單卡速度推向瘋狂
    RTX Pro 六千 把容量推到天上
    DGX Station GB300——
    那是桌邊超級電腦的王

    [Outro]
    別問哪張卡值得被封王
    先問你的模型 想去多遠的地方


  • 決策模型:Jev vs Laya 魔術方塊大對決
    kos orK kos or
    LLM讨论区 本地模型 mac

    太多模型了 看看就好

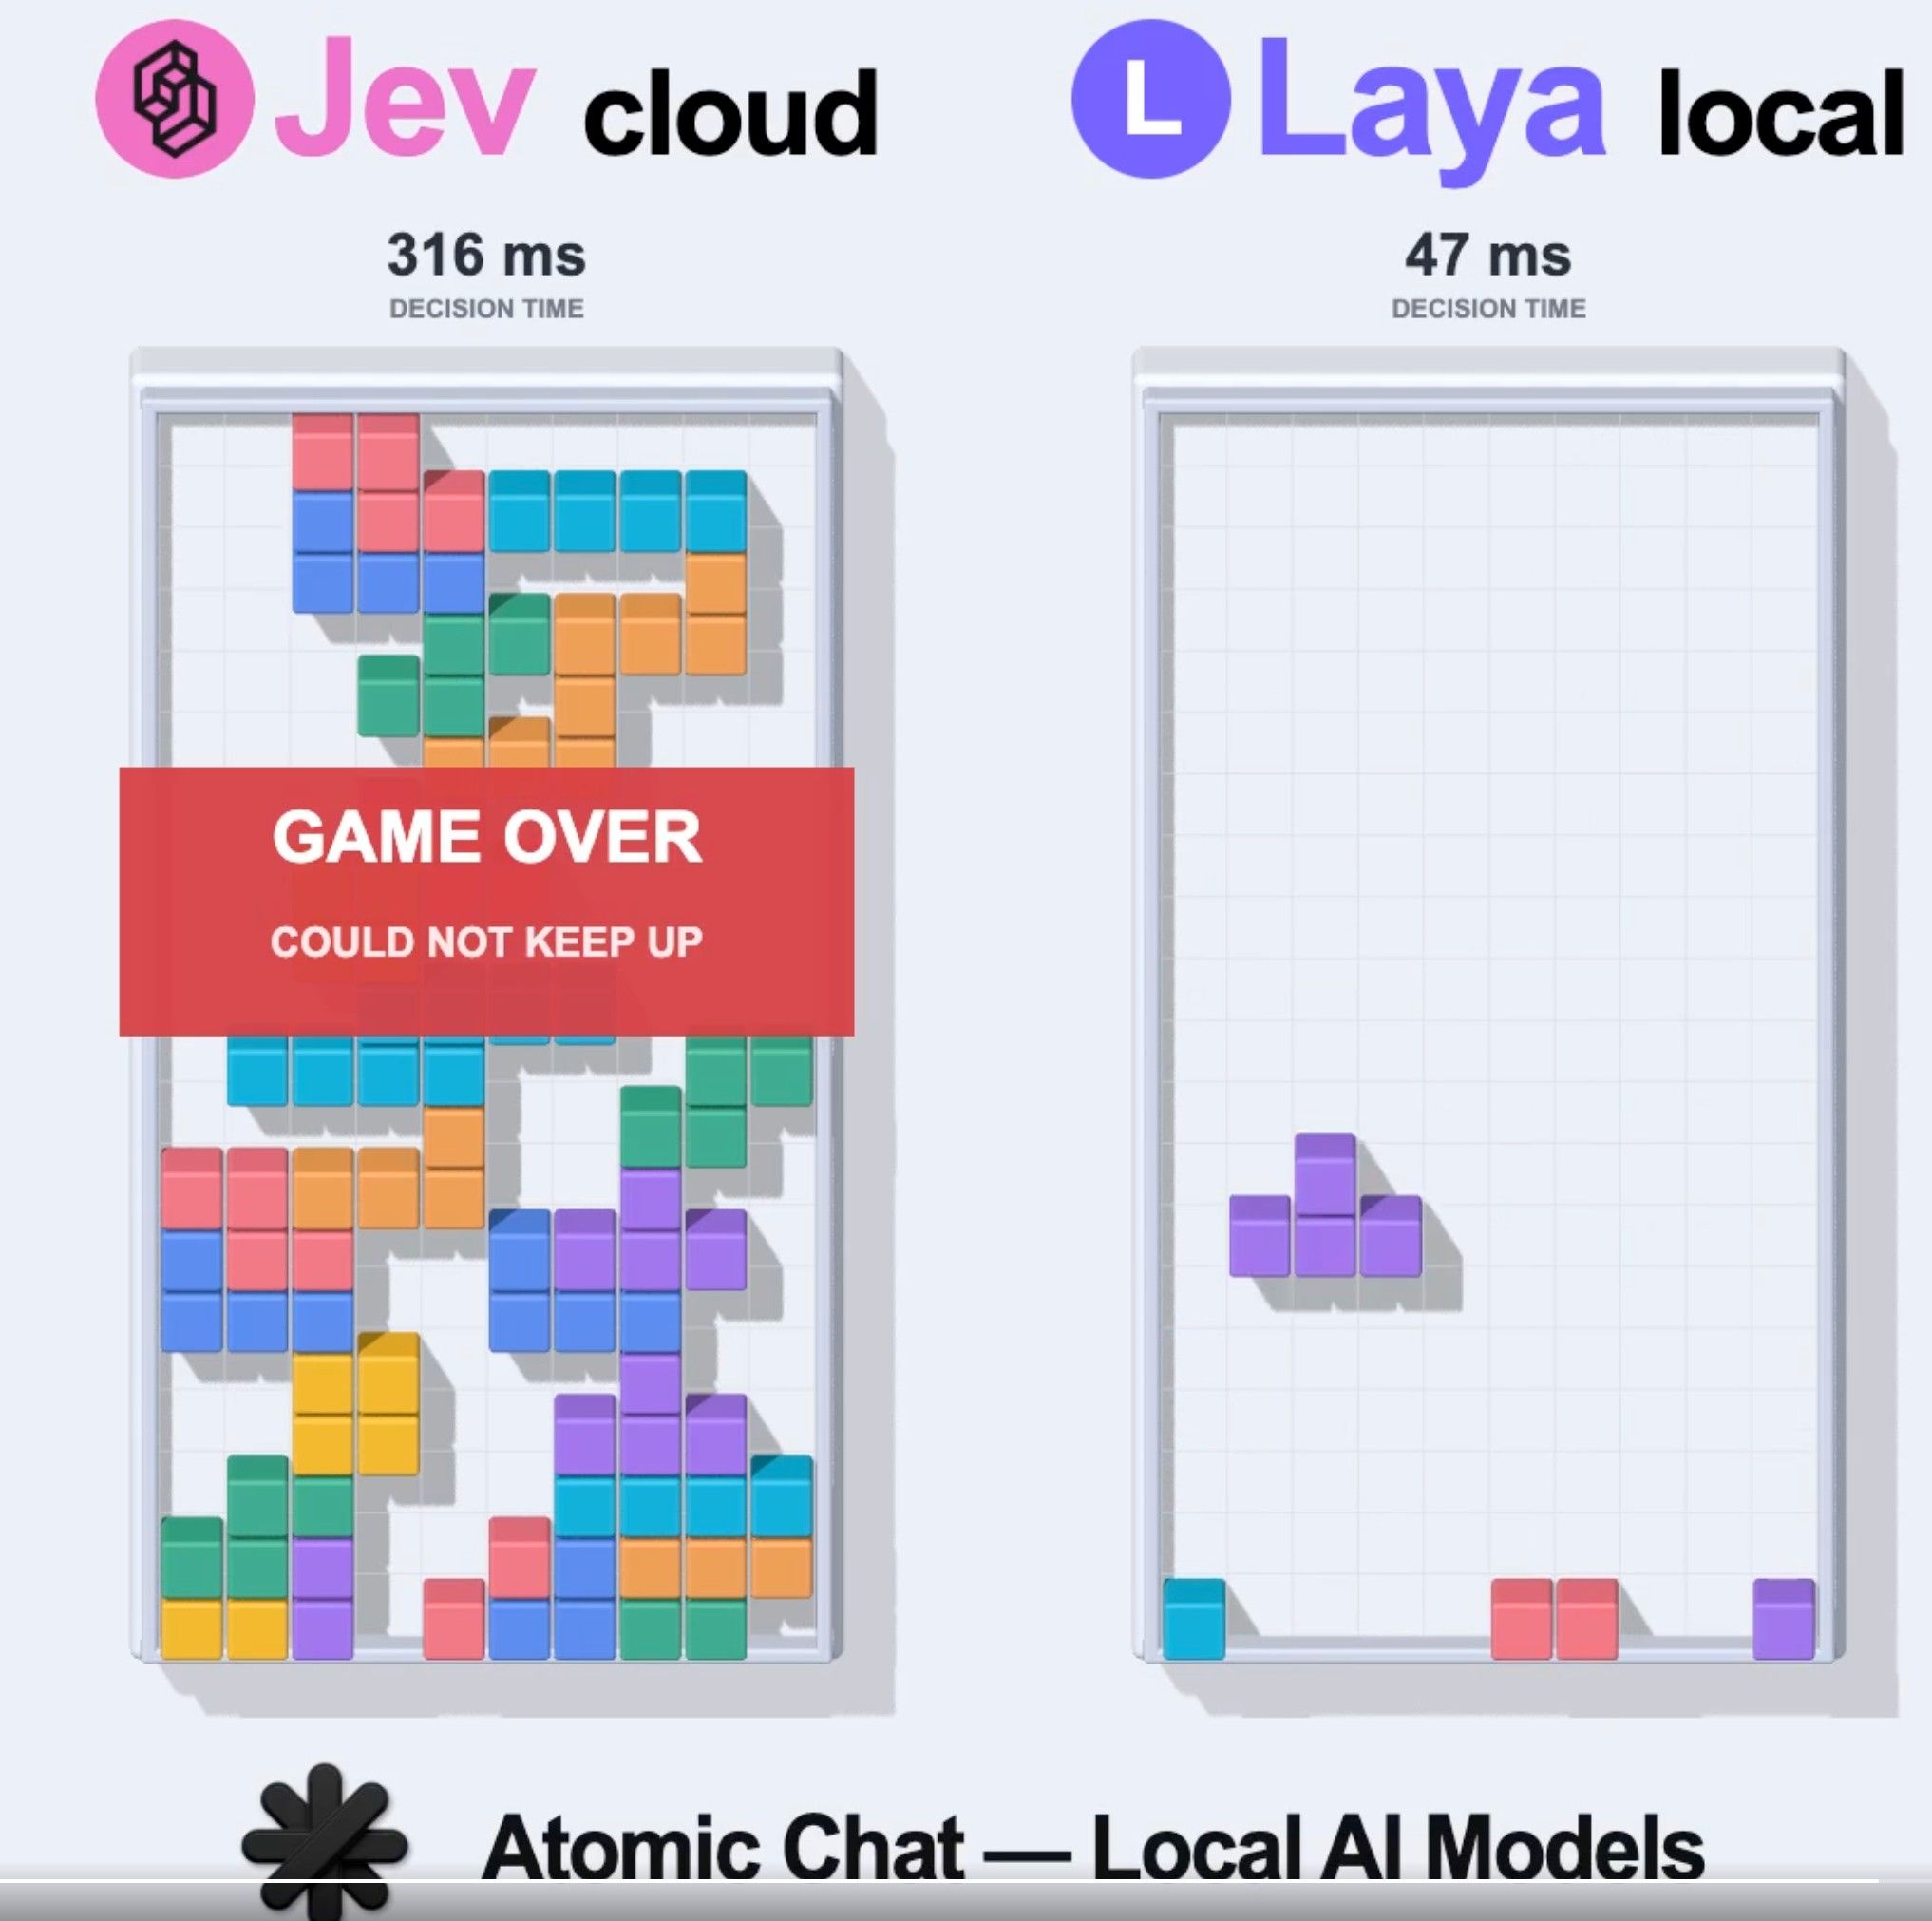
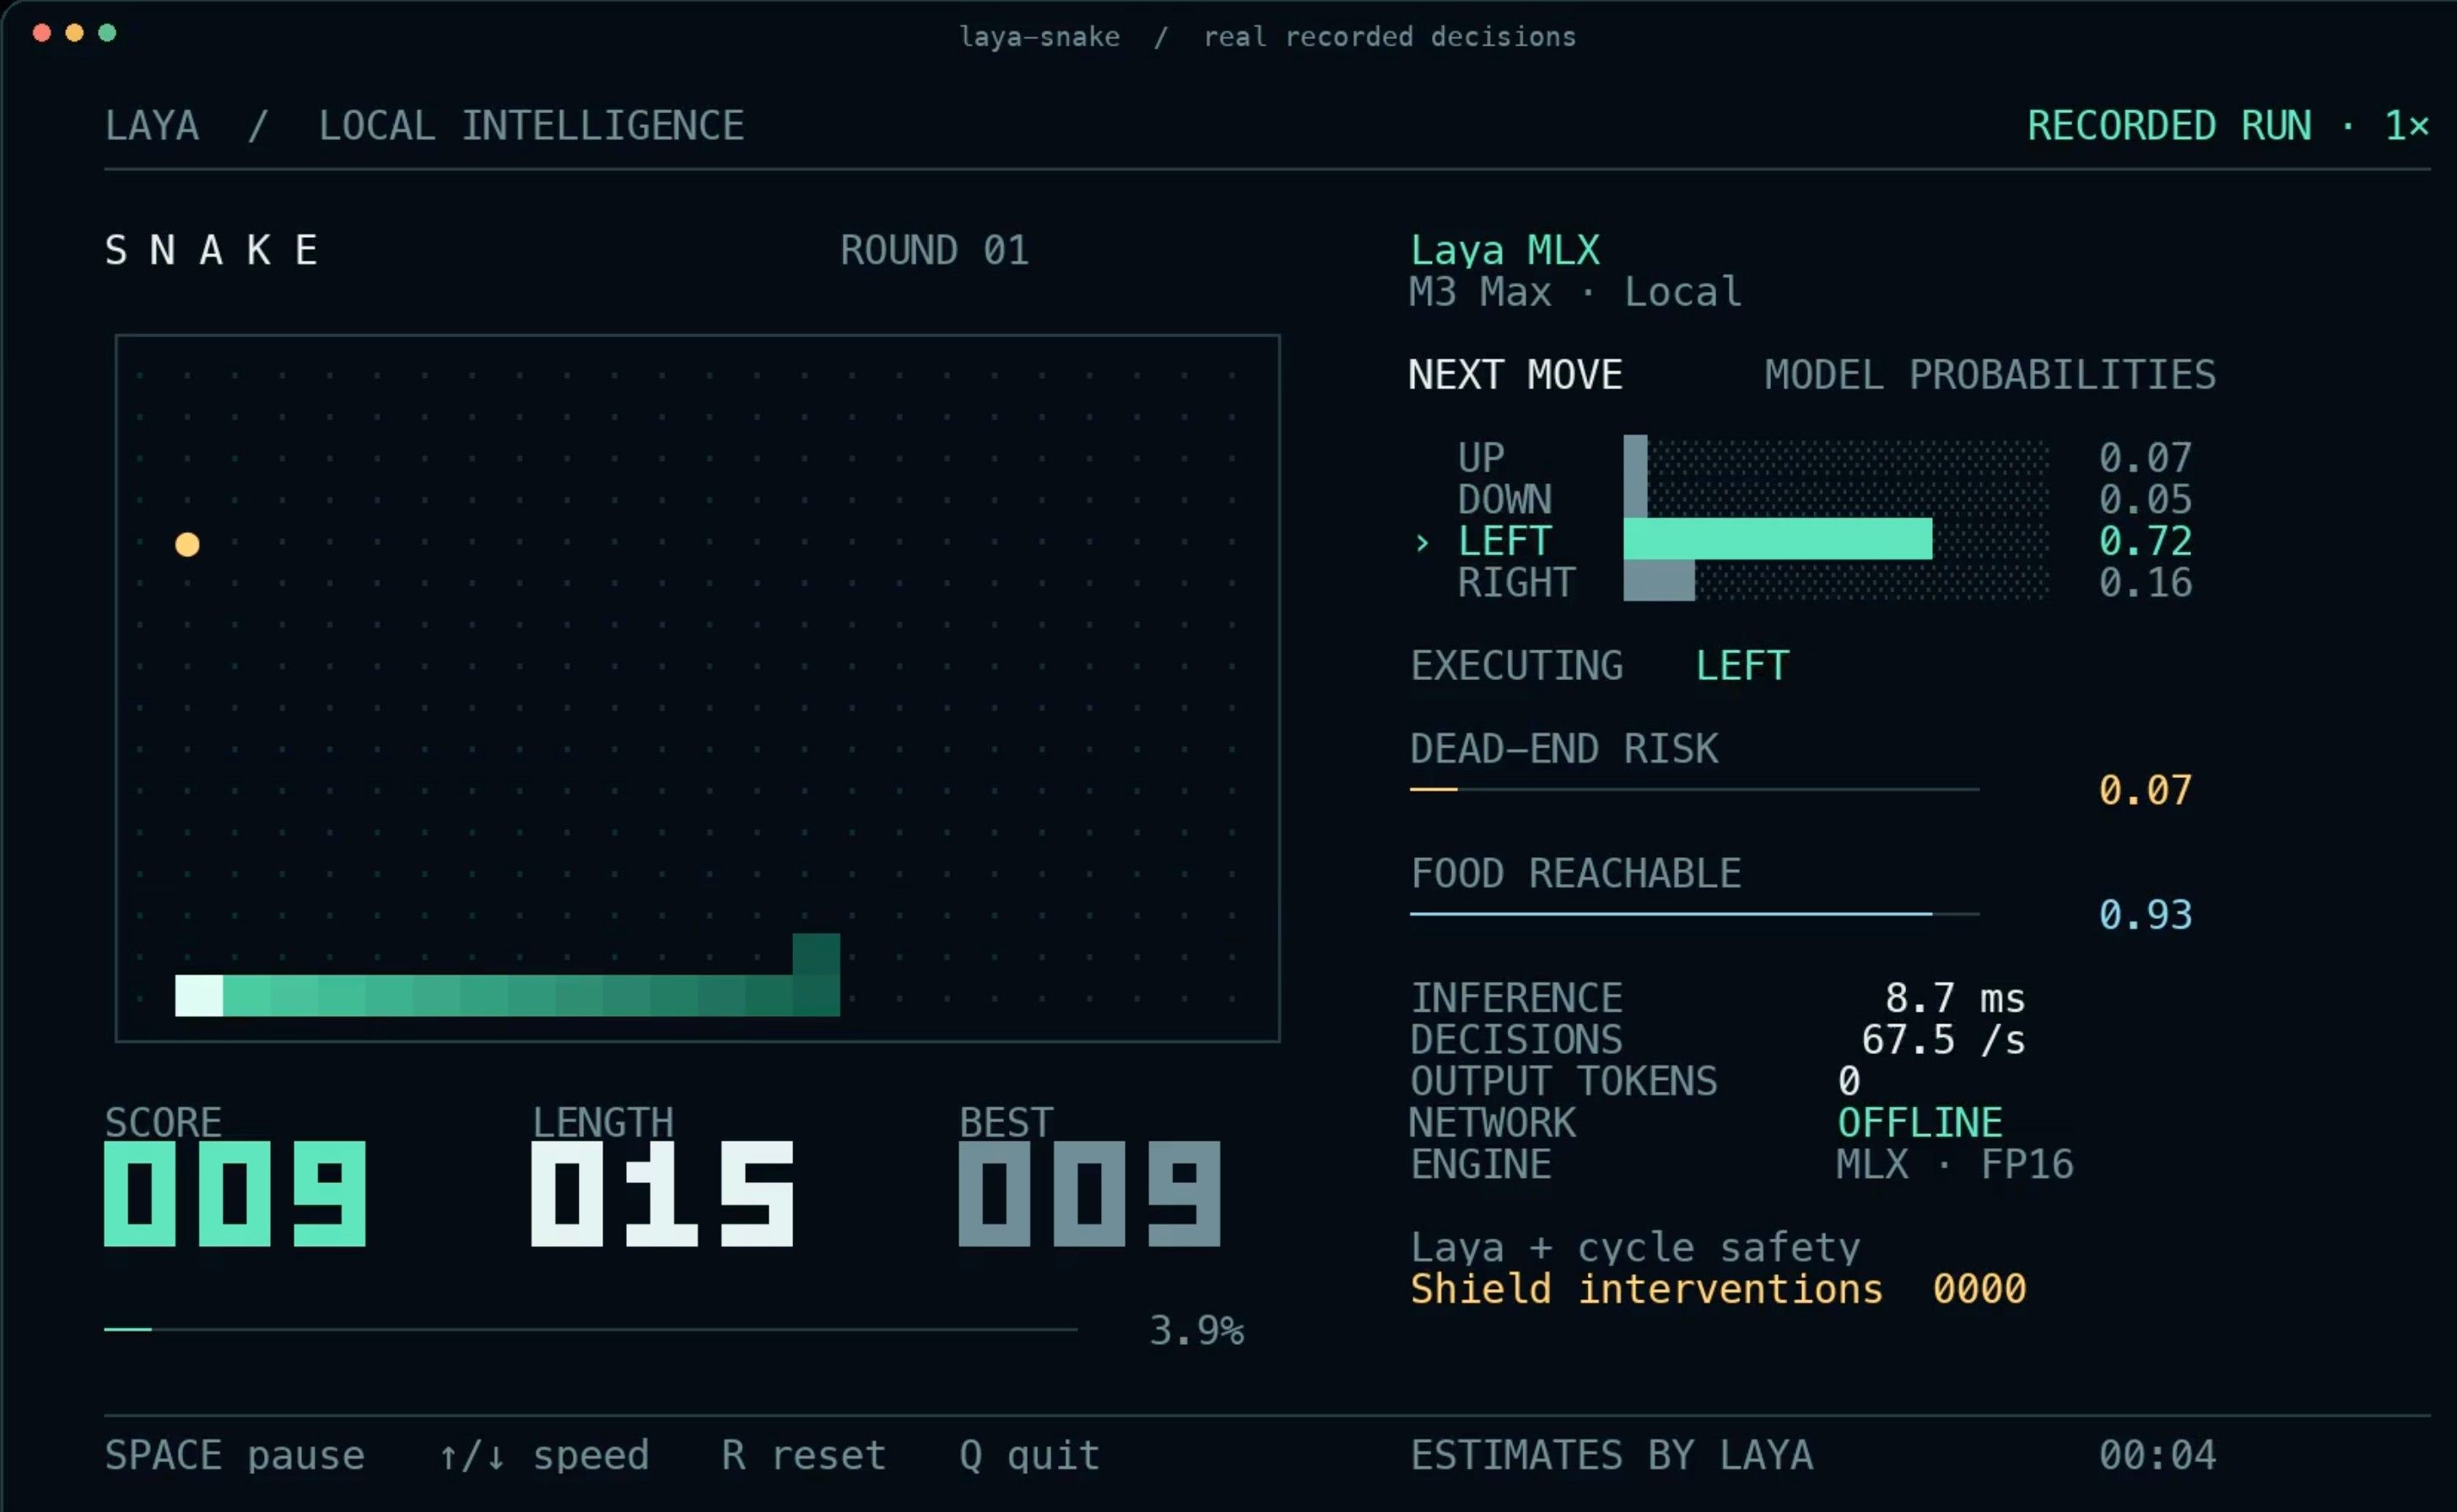
    一個名為 Laya 的開放權重 System One 模型,在本地運行於 16GB MacBook Air 上,透過決策速度比基於雲端的 Jev 快 11 倍,在玩俄羅斯方塊遊戲中擊敗了 Jev!

    魔術方塊大對決

    image.jpeg

    貪食蛇
    image.jpeg

    "速度比 Jev 快 50 倍的全新版本:laya-mlx,可在您的裝置上運作!
    僅佔用裝置 1G 內存
    Laya 是一款開源分類系統,類似於 Jev,基於文字輸出機率。
    已移植到 MLX 平台並進行了一些性能優化!
    影片中,該模型正本地 M3 Max 上運行貪吃蛇遊戲。
    模型每秒可做出 60 次決策!"


  • 體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27B
    kos orK kos or
    LLM讨论区 qwen 本地模型 strata

    煩請大家分享 一起討論下:
    網路上有網友在討論 甚至爭論 Qwen3.8-Flash vs. Qwen3.8-27B 哪一個強 ?

    說實話 我目前判斷不出來,可能因為使用的場景不夠多

    有沒有使用者在某些場景有特定的體感經驗 能不能分享下 Flash vs. 27B 的差異?
    Flash 搭配哪一個 Agent 框架給你最佳的使用體驗?
    Qwen可以調整 reasoning efforts 思考深度 Off, low, medium, high/xhigh 體感或輸出品質上有何差異?
    reasoning_budget_token, max_token 參數的調整 對於體感或輸出品質上的影響如何?

    以下彙整網友們的使用體感反饋和建議 (沒提到或注意到的請見諒喔)

    Strata-Flash 優勢 > 27B

    1. 顯卡使用壽命 : Flash是明顯優於27B,因為CPU負擔了一些工作量,GPU運作時溫度較低
    2. 單卡8G VRAM可用,只要8G就能跑具有可用性的Flash
    3. Flash 在視覺設計上具有較高的細膩度和美感
    4. Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS 有一定生产力的工具; Qwen3.8-27B-GSQ-RCO-IQ3_XXS 只能聊天的玩具 (peter)
    5. Strata-Swift15-Qwen3.8-Flash-IQ4_NL > LLama.cpp-Qwen3.8-27B-Q4_K_M,從Agentic一般生活常態功能(不含coding)操作的角度來說,任務輸出品質約多出30%,任務輸出速度約快30%~70%(看任務複雜度)
    6. QFN明顯懂的多很多,QFN比較會反復的檢驗確認,新一代的模型都會有這樣的作法。
      27B就是BUILD會過就是可以交差了。 (paul hou)

    Strata-Flash 劣勢 < 27B

    1. 有網友反應Strata無法進行多併發 (Strata backend还是llama.cpp只是优化好,多发并行请求肯定不行)
    2. Strata+Qwen3.8-Flash的是外掛多模態 支援圖片 但無法影片; SGLang + Qwen3.8-27B 的是原生多模態 不只圖片也支援影片 (starryskyknight)
    3. 总体上27b + SGLang + Dflash2 体验更好 (Terry, 懒人烘培)

    其他優化建議 :

    1. 让Flash 准备规划,然后27B Dense model 执行 (applejuice)

    Qwen3.8-Flash-Next 版本推薦
    "Qwen3.8-Flash-Next不能用IQ3_XXS,必须得用IQ3_S 这个版本,它的能力比27B-Q4要强!" (guonetnet )


  • AI 組隊打怪 ~ 徵求對AI工程有熱情的同好
    kos orK kos or
    随便聊聊
    抱歉 自己發的帖子 好像不會自動關注中 所以沒收到通知; 
    剛剛才發現有人留言 抱歉晚回了
    

    AI 組隊打怪 ~
    要是有AI同好對 文字, Coding, 系統, 圖像/影片, 製造自動化和機器人工程,
    這些方面有興趣, 願意持續學習和鑽研,
    請在此留訊息或私訊我聯繫, 等未來時機到了我們組個團隊去接案子
    當然技術上要分配個人的專精和看當地的市場需求,
    有案子接就開隊處理 ; 目前我沒案子 等技術到了一定成熟度 我去敲門接案
    大家先忙個人手邊的專案


  • 台灣技嘉 AI Pro R9700 32GB 自取, 手速要快
    kos orK kos or
    AI硬件 ai-pro-r9700 r9700

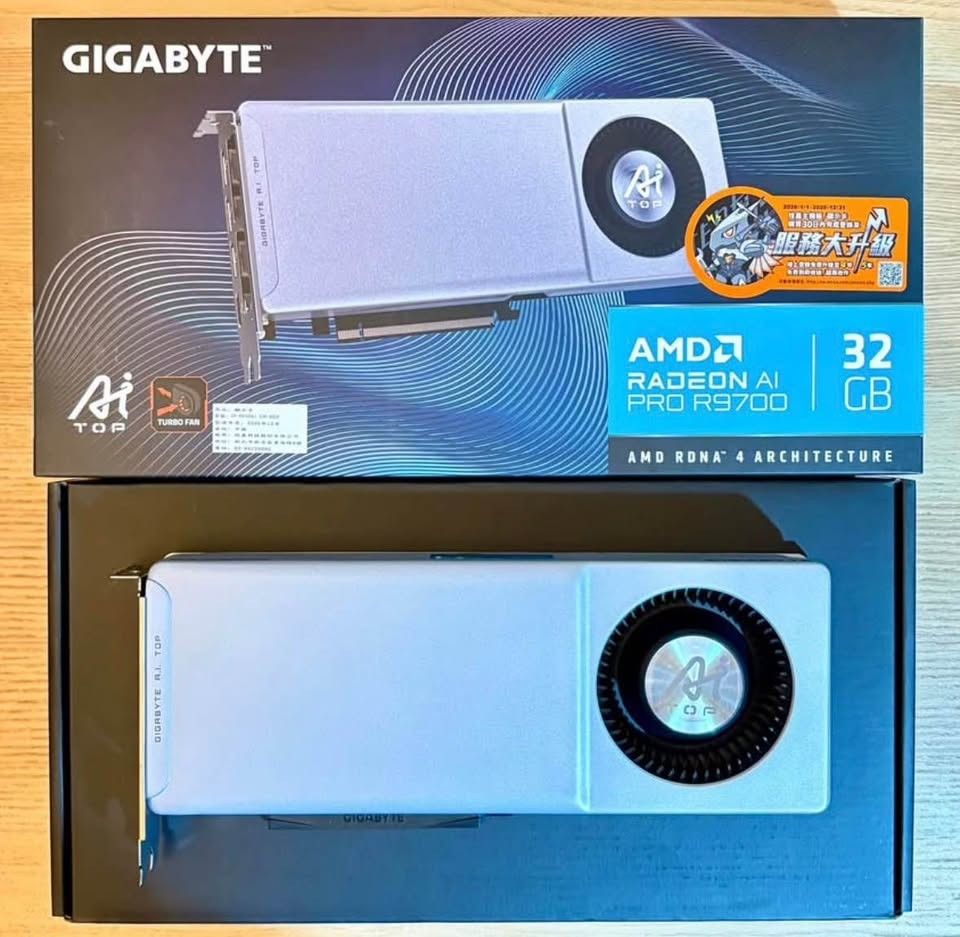
    一天後會刪帖 ; 碰巧看到Gigabyte AI Pro R9700

    剛剛碰巧看到 臉書社團有人要原價出二手 交易時注意資金安全 風險自負喔

    【名稱】 技嘉 Radeon AI PRO R9700 AI TOP 32G 專業 AI 顯示卡(已註冊,五年保固至 2031 年 4 月)
    【售價】 $53400
    【貨物狀況】二手,使用僅 4 個月,升級出售,原廠盒裝。

    時間到了 FB連結已刪除

    FB發帖者照片
    d7643dfc-c448-4371-8cf1-b82bf255db80-image.jpeg

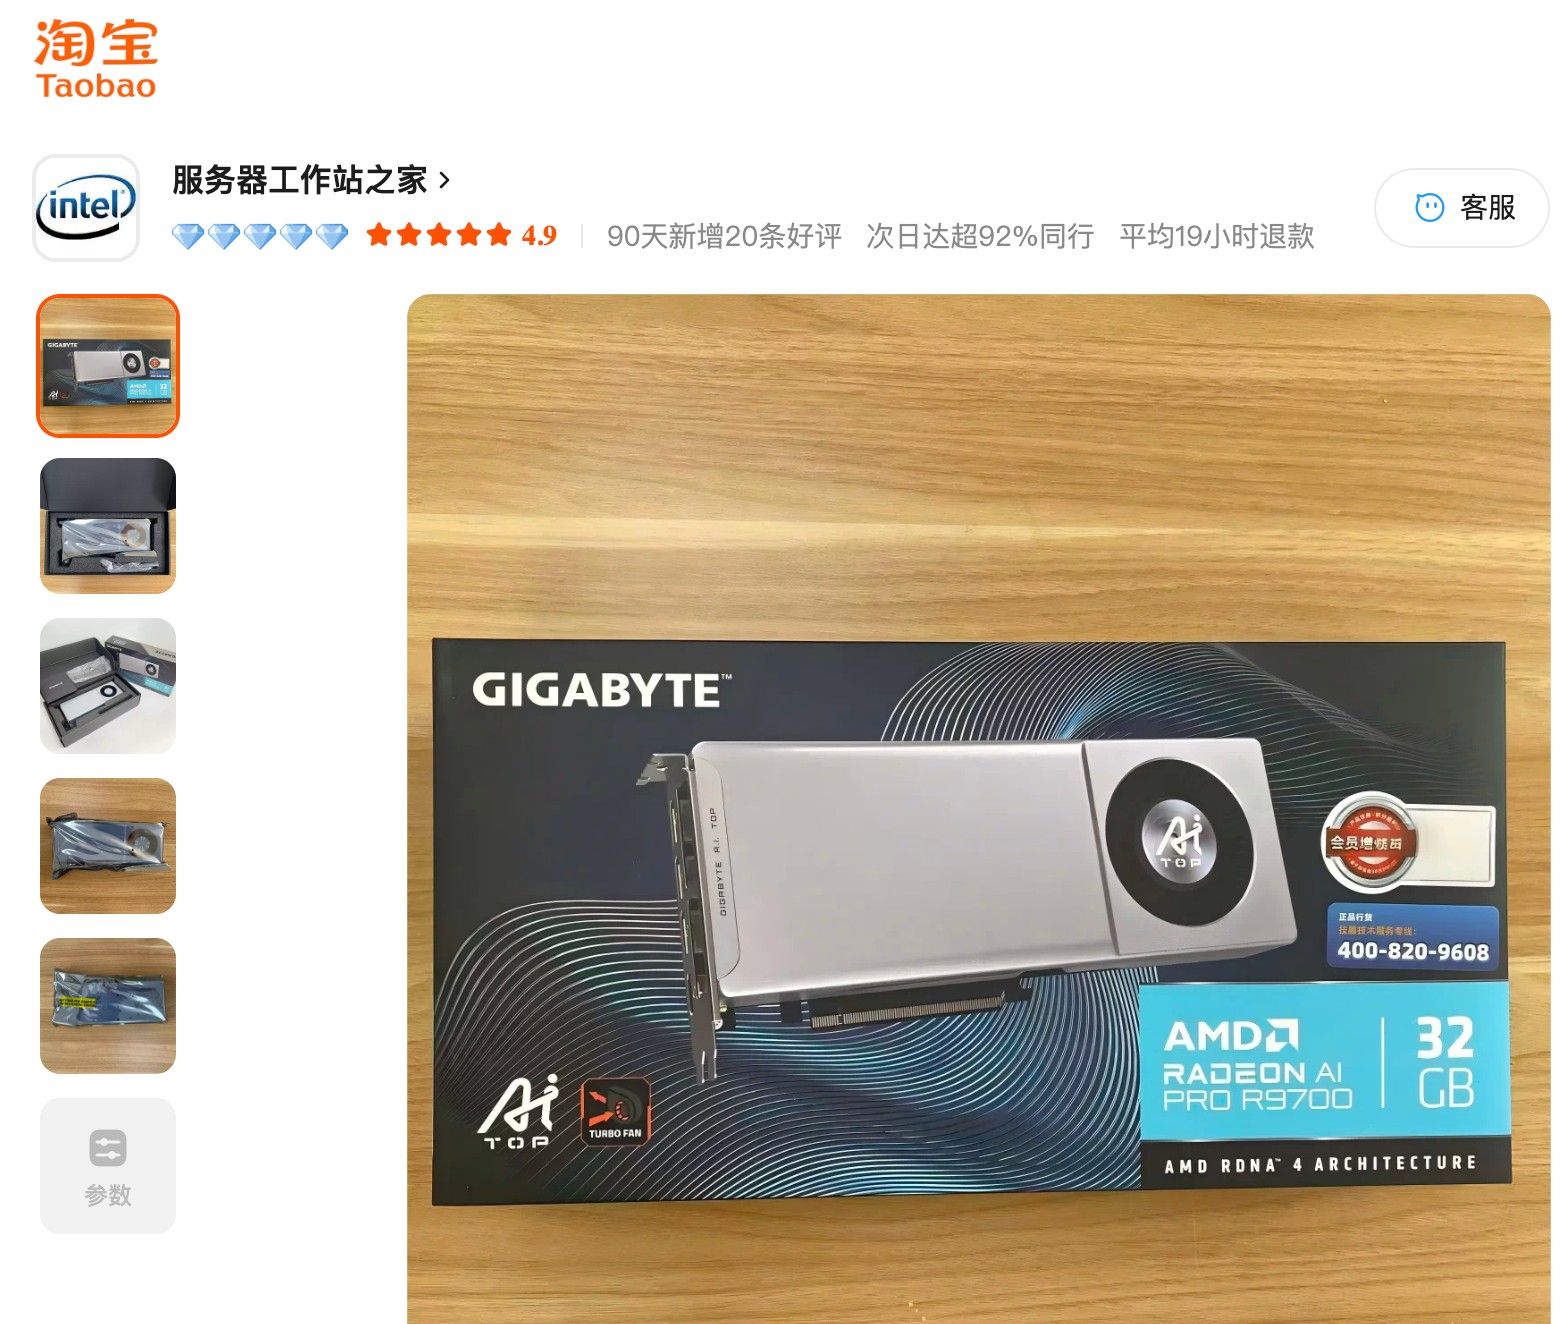
    淘寶照片
    d6493000-8ce5-4692-a6bf-e952099e3e1e-image.jpeg


  • 律师找到了我了
    kos orK kos or
    AI硬件 本地模型 服务器

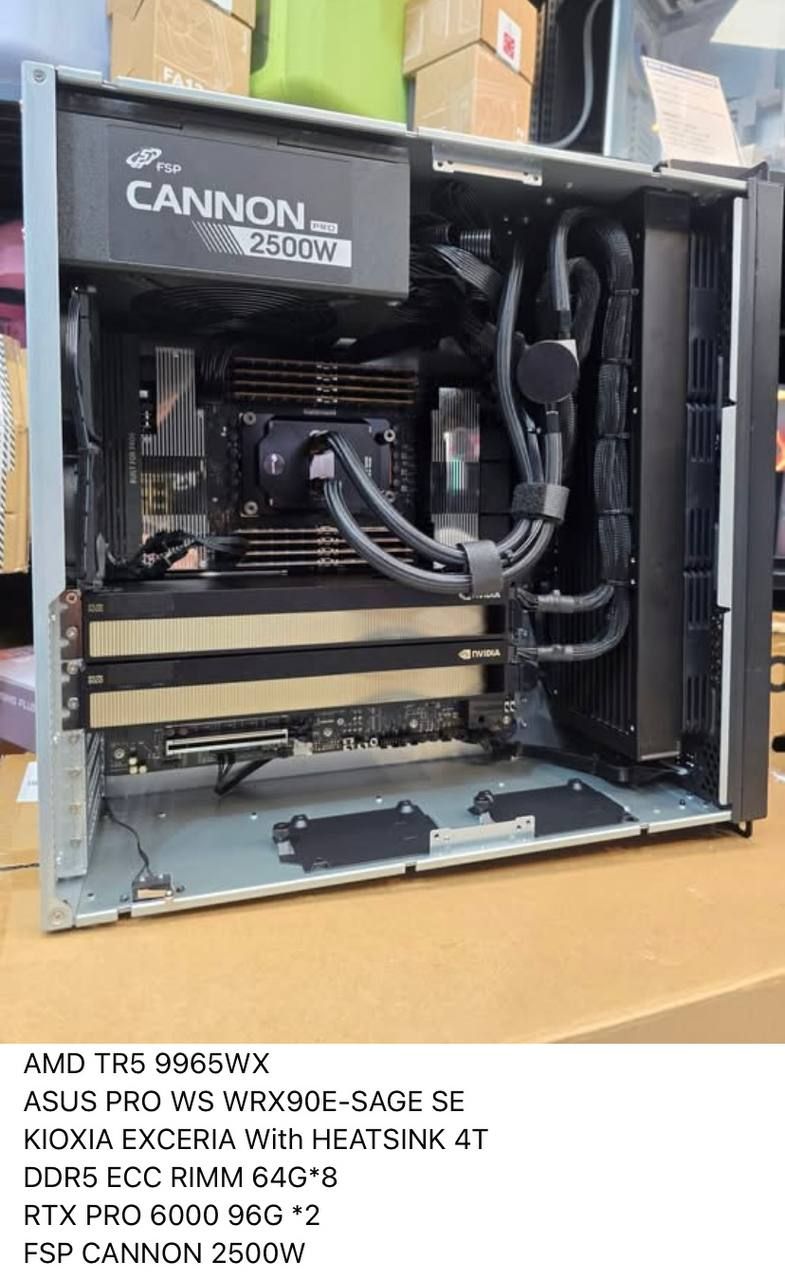
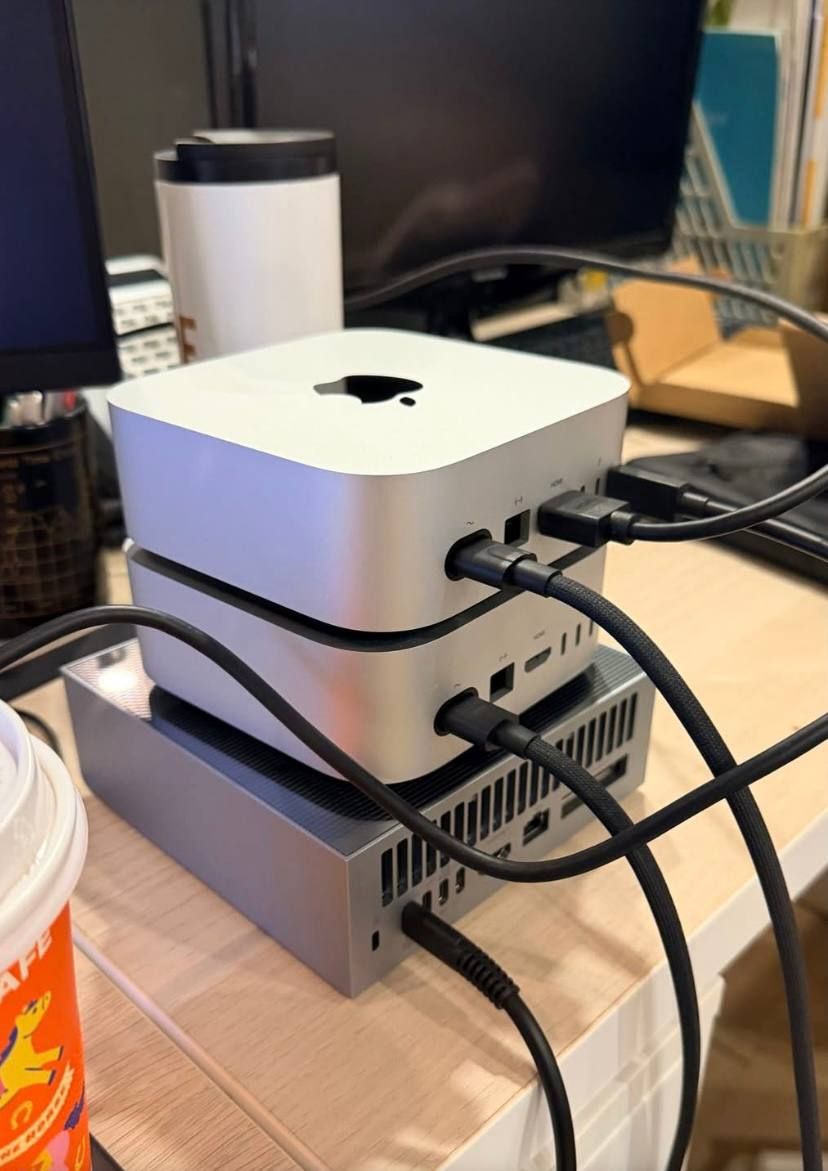
    謝謝大大, 等你分享!對了, 我剛好手機裡有一些實務案例的照片和規格 順便分享一下
    telegram-cloud-photo-size-5-6116134516314280698-y.jpg
    案例一:可以參考修改成一張RTX Pro 6000
    e68e8b5d-e759-483b-b9dc-7c8a75275f95-telegram-cloud-photo-size-5-6116134516314280701-y.jpg
    案例二:低成本版 大Memory 烏龜速度 (2 x Mac Mini + 1 x ASUS Ascent GX10 128GB LPDDR5x 頻寬 273GB/s)是利用Codex on Mac Mini來爬取收集網路上2000萬筆的公開資料 相關配置可以改成隱私版本, Ascent GX10 負責處下載後的本地資料

    ps. 目前性價比最高的好像是Mac Studio M3 Ultra ?


  • 體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27B
    kos orK kos or
    LLM讨论区 qwen 本地模型 strata

    個人使用體感經驗 (未和SGLang Qwen3.8-27B 或NInfer, HyperQwen 比較)

    比較了 Strata-Swift15-Qwen3.8-Flash-IQ4_NL (RTX 5070 Ti) vs. LLama.cpp-Qwen3.8-27B-Q4_K_M-Dflash2 (7900XTX)
    在雙方都是 Reasoning Low 的條件下,使用的介面為Hermes Agent,從Agentic一般生活常態功能(不含coding)操作的角度來說,
    Strata-Swift15-Qwen3.8-Flash-IQ4_N 任務輸出品質約多出30%,任務輸出速度約快30%~70%(看任務複雜度)

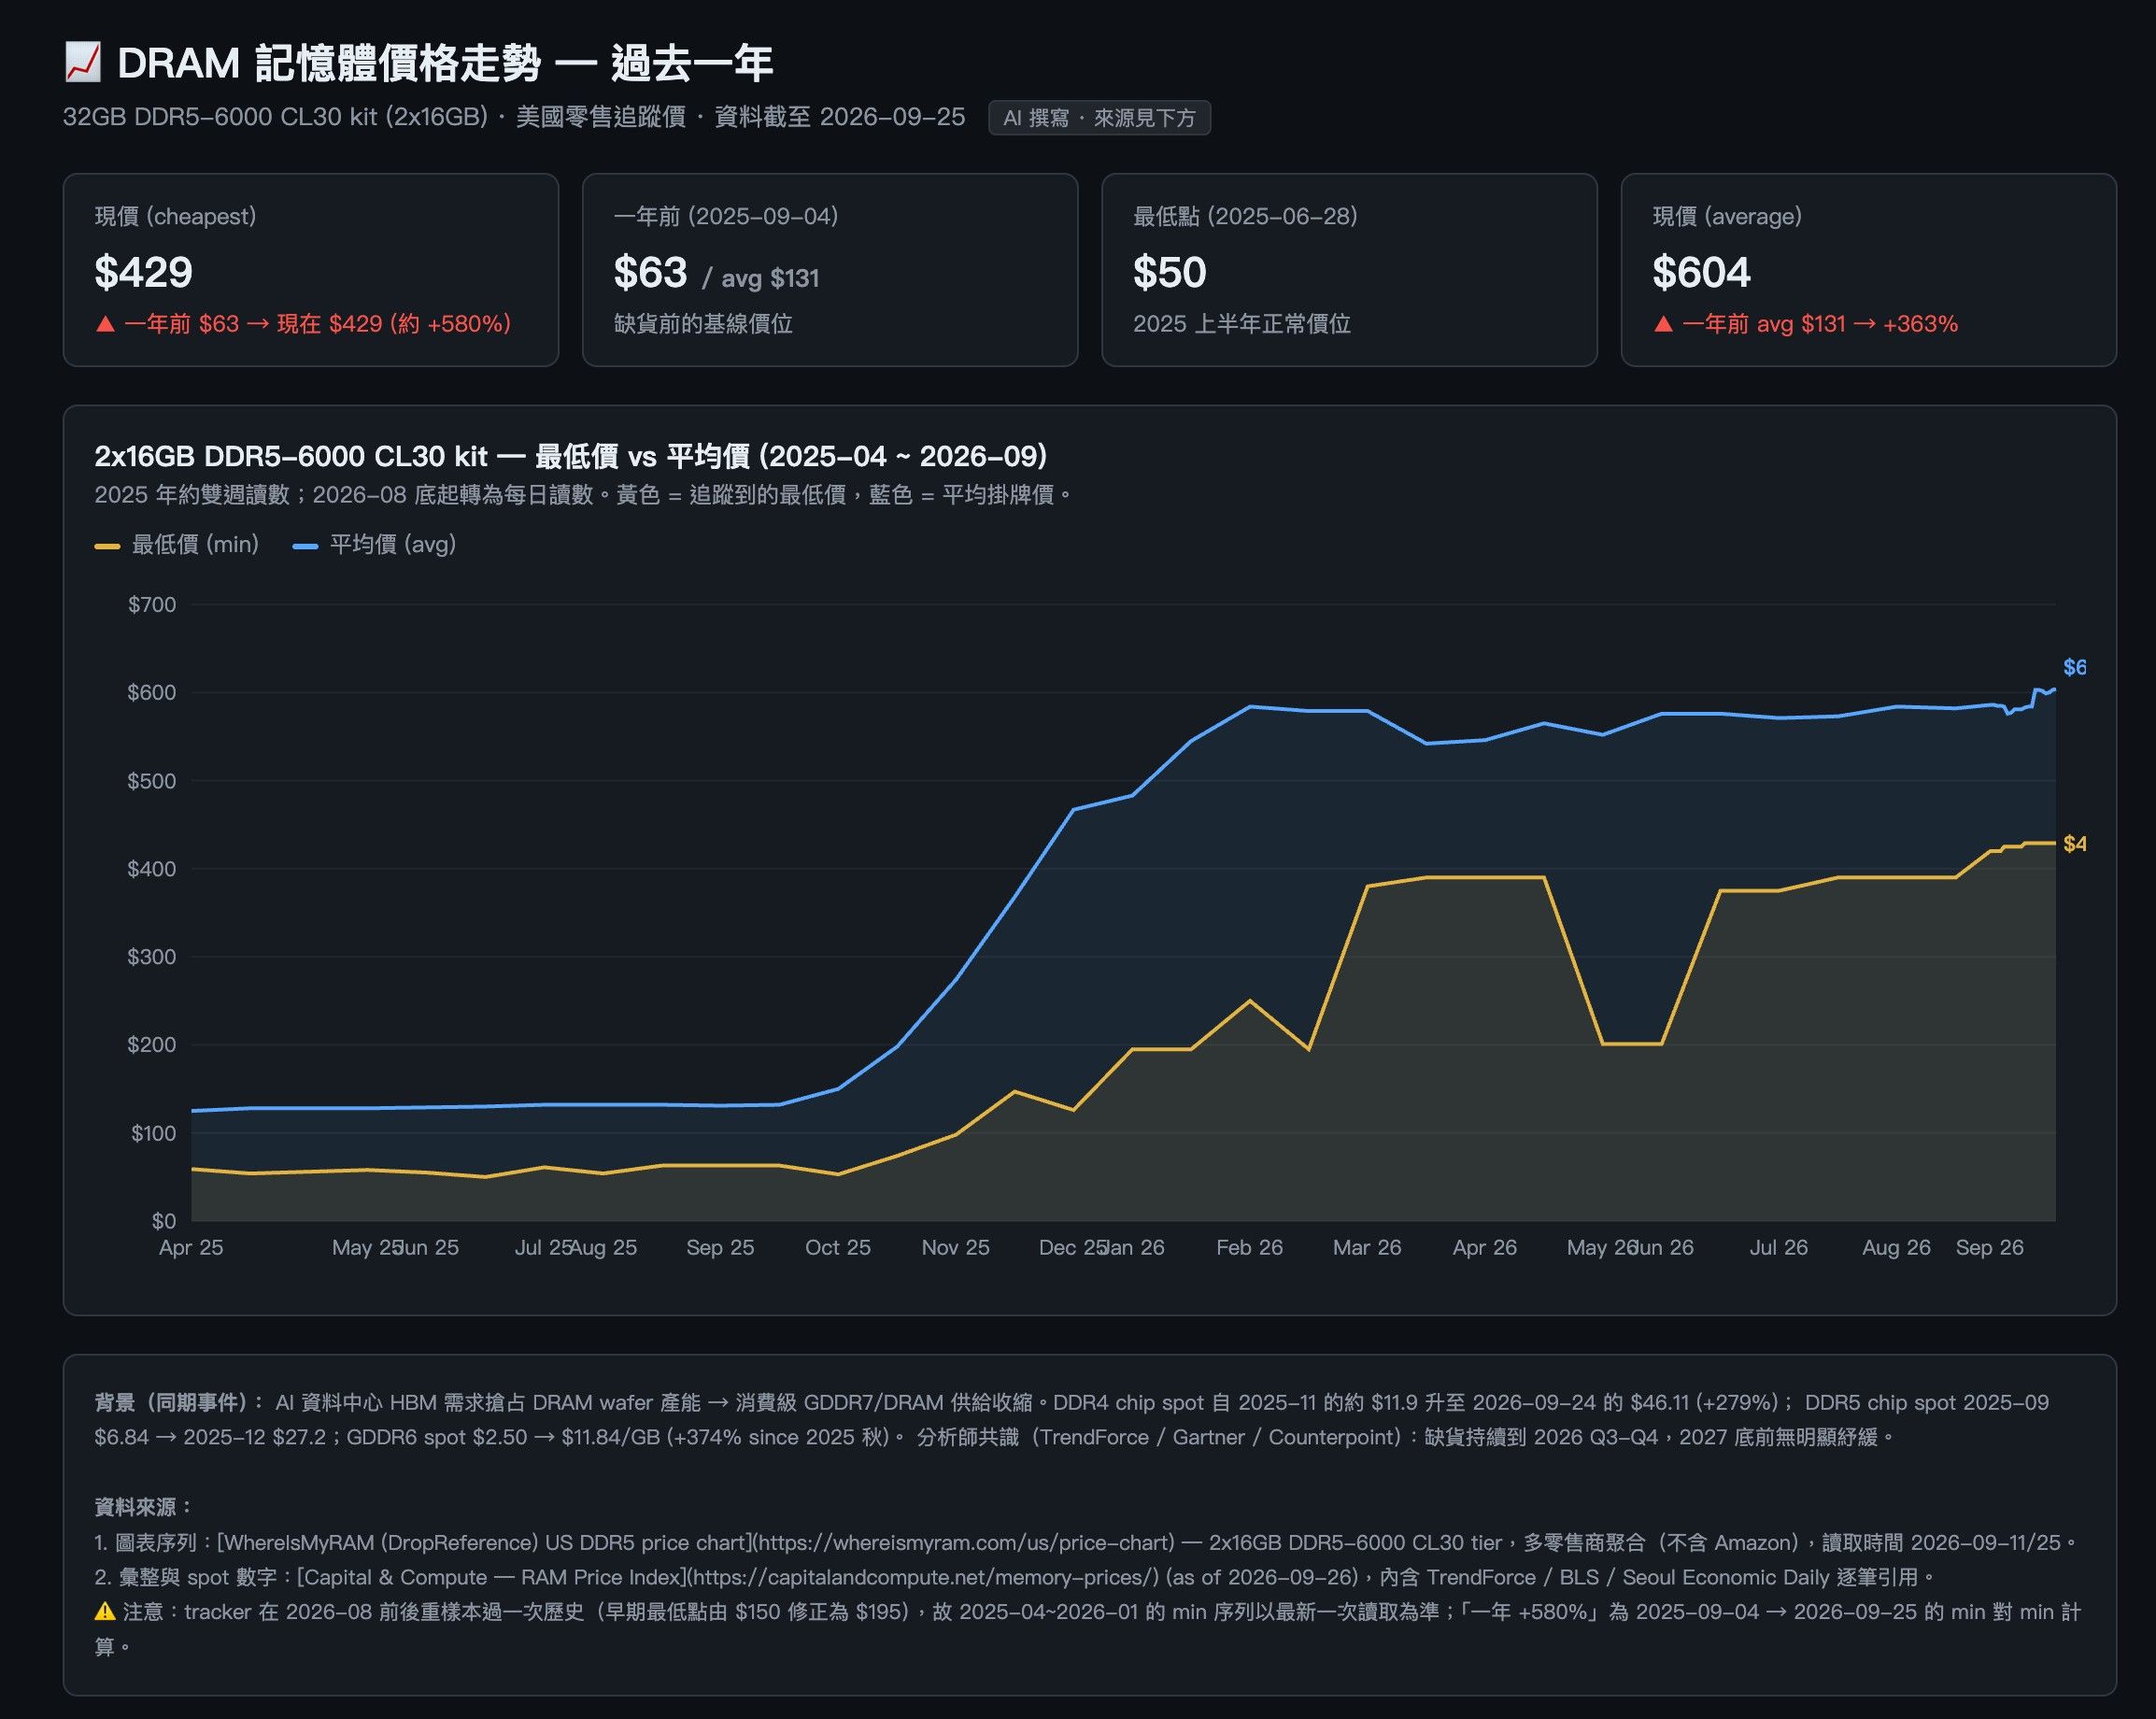
    prompt : 製作一張過去一年記憶體走勢的圖表 in html

    Strata-Swift15-Qwen3.8-Flash
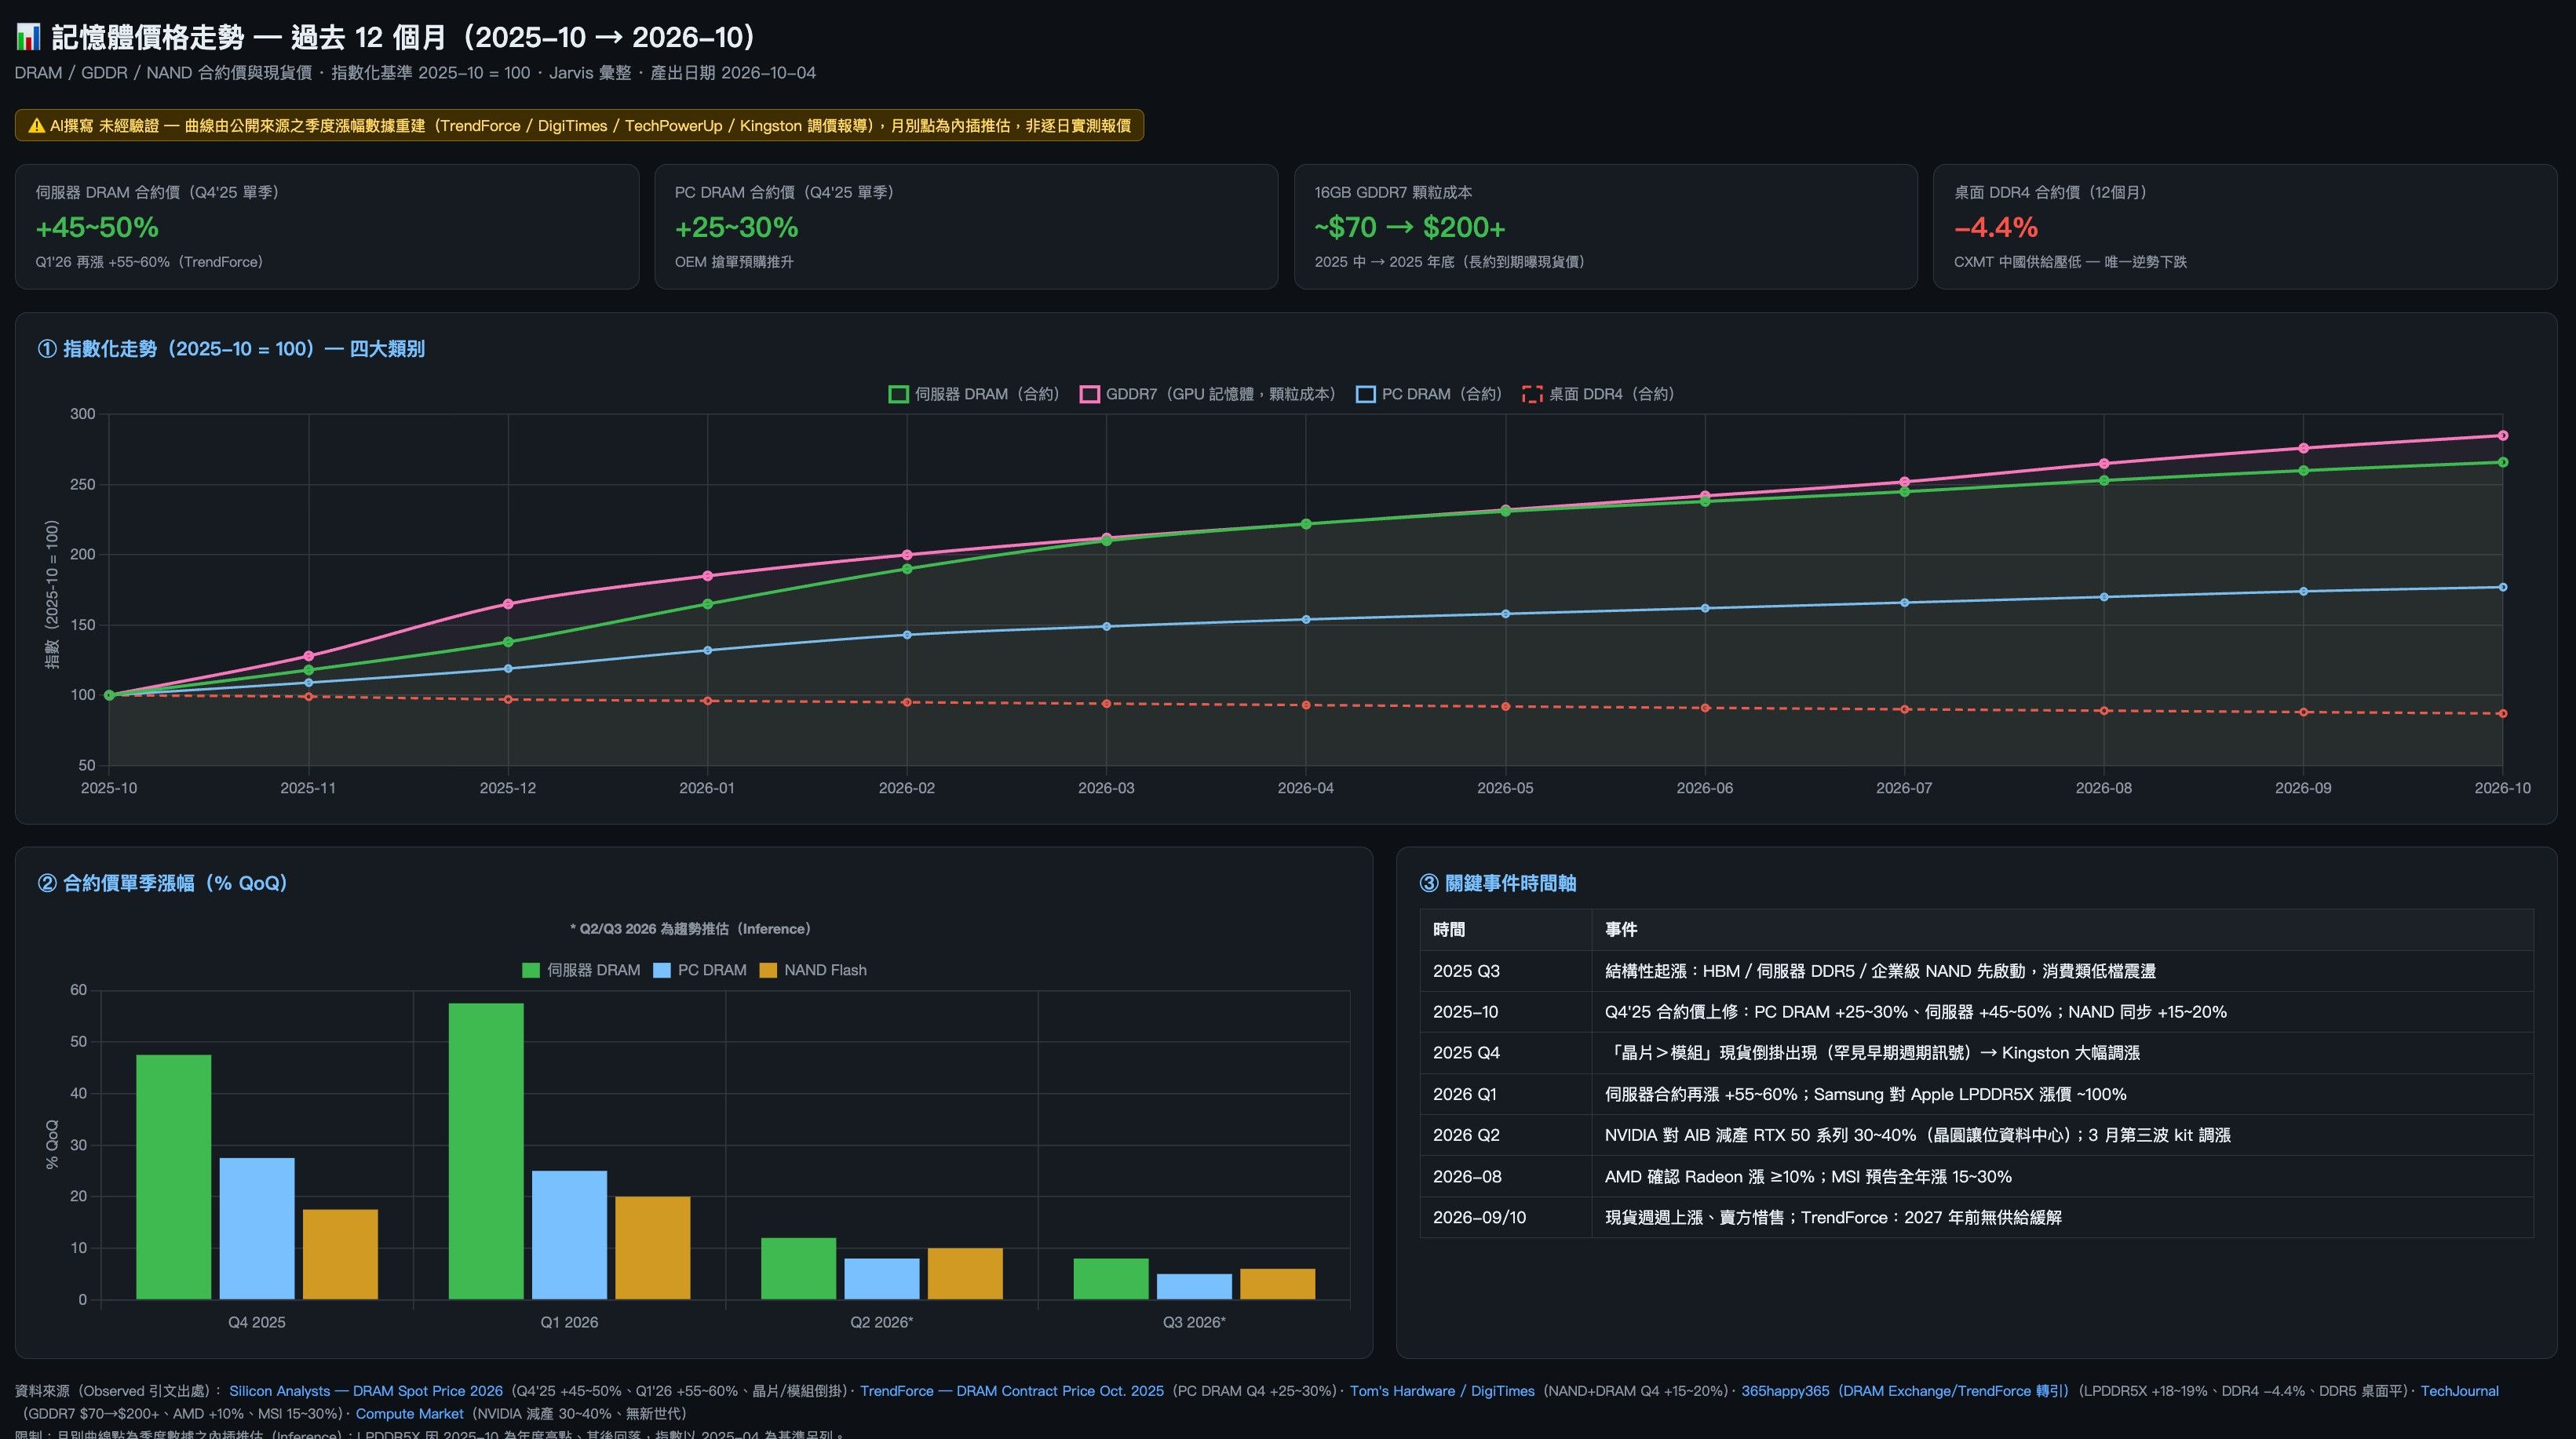
    image.jpeg

    LLama.cpp-Qwen3.8-27B-Q4_K_M.
    image.jpeg


  • 混搭 DGX Spark GB10 Prefill + Mac Studio Decode
    kos orK kos or
    AI硬件 dgxspark gb10 mac

    很有趣的組合, 不知道效果如何?

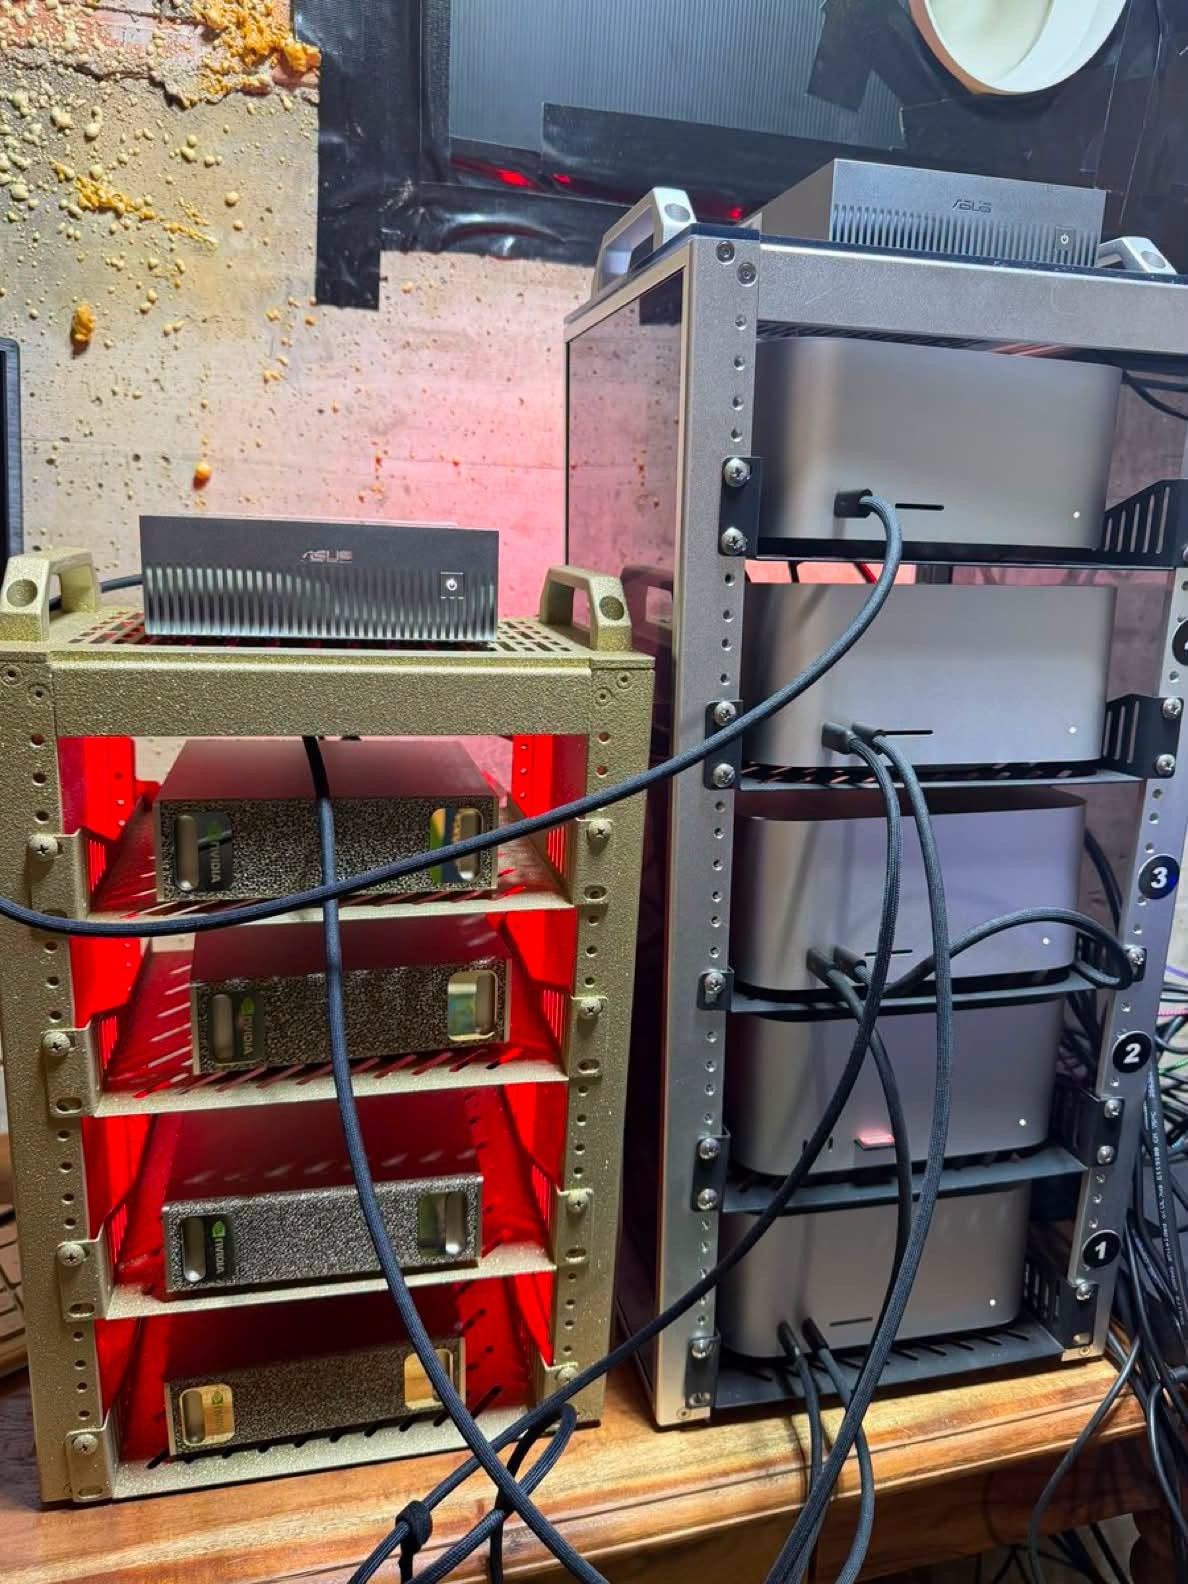
    分享一下網路上AI熱愛者的經典作品 :混搭 GB10 Prefill + Mac Studio Decode

    擁有 2.4 TB 統一記憶體的傳奇之作

    • 7 塊 DGX Spark :896 GB
    • 5 塊 M3 Mac Studio :1.5 TB
    • NVIDIA 負責處理昂貴的Prefill。
    • Apple Silicon 晶片負責模型運行和高效率Decode。
    • 快取跨越普通 10Gb 乙太網路。

    26cd00b1-53f5-4891-b11e-1b1a3377be0c-image.jpeg


  • Club-3090 俱樂部 頂尖對決 GLM-5.3-Flash vs Qwen3.8-Flash-Next vs. Qwen3.8-27B
    kos orK kos or
    LLM讨论区 rtx3090 glm qwen

    資料很多, 有重點沒提到的歡迎補上喔 😊

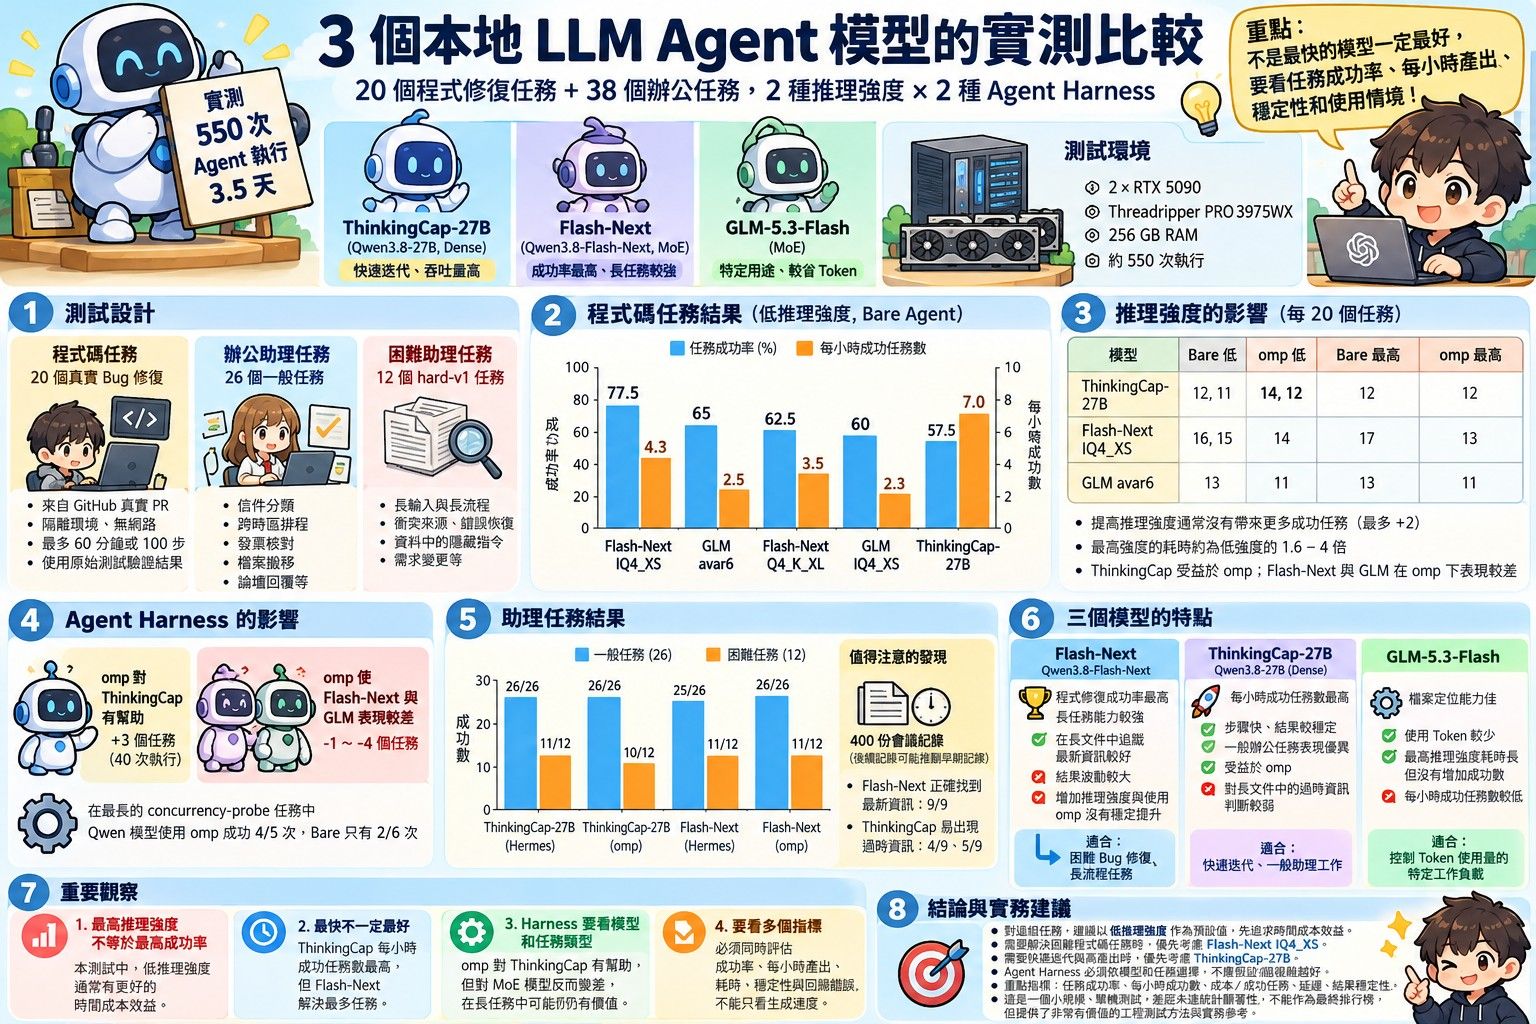
    GPT Image 圖像快速解說版

    image.jpeg

    原文作者 : paulp83

    配置:2塊RTX 5090顯示卡,TR PRO 3975WX散熱器,256GB記憶體。大約550個代理程式運行了三天半

    3 位local LLMs 作為代理完成了以下工作:20 個 club-3090 修復、38 個桌面任務、2 個安全帶、2 個工作量級別 #1690
    https://github.com/noonghunna/club-3090/discussions/1690

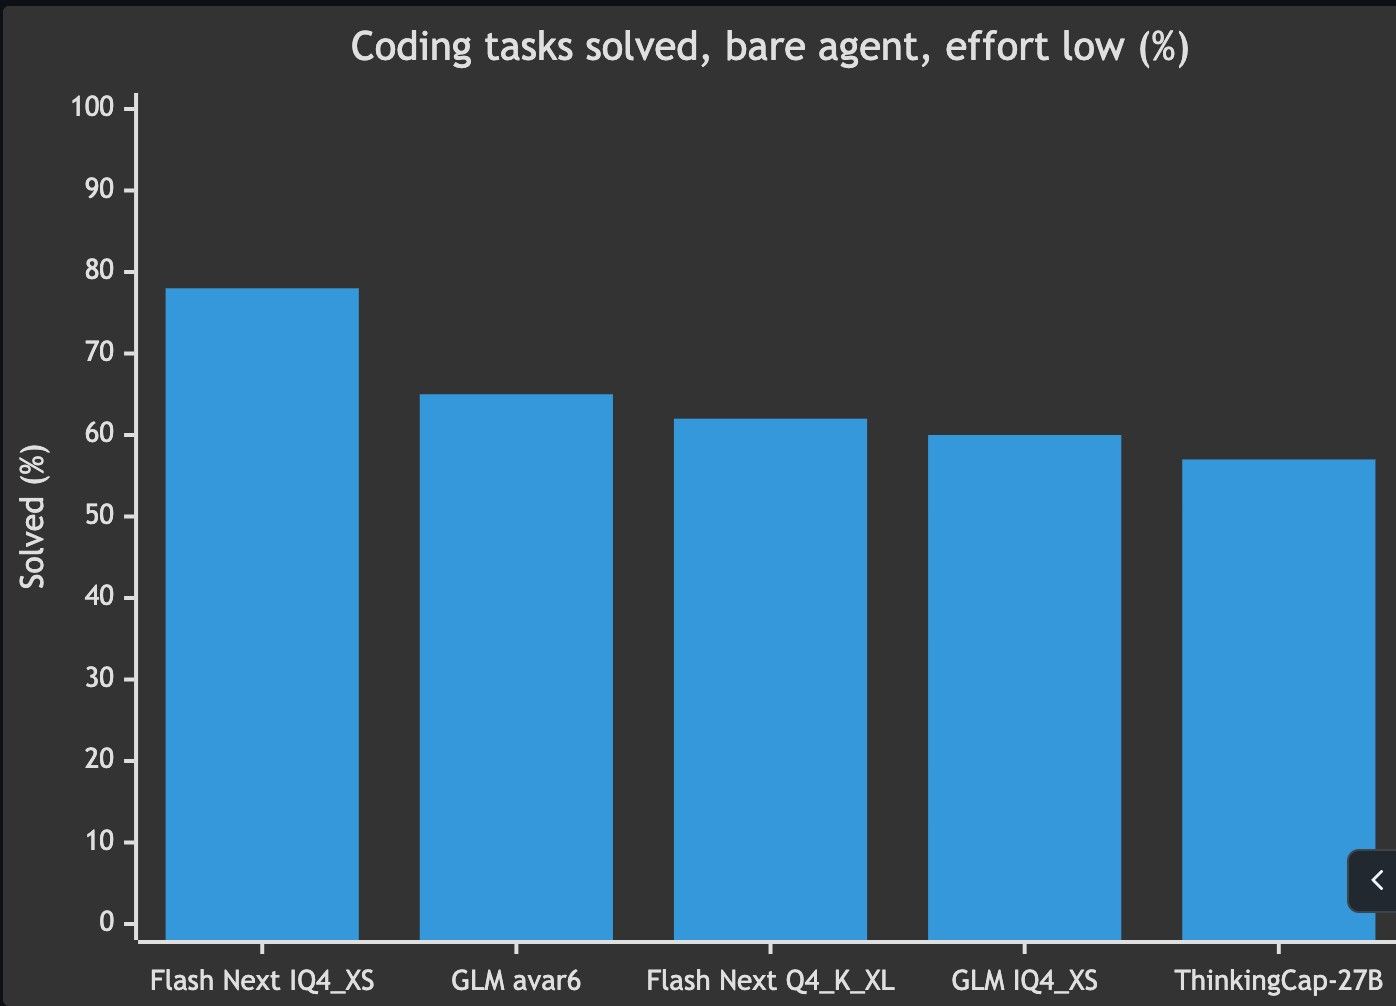
    我詢問俱樂部的測試結果是否與我使用的模型和框架有關,維護者要求我做一個 2×2 的對比測試:低強度模型與高強度模型,裸代理與 OMP。我在這個倉庫中提供了三個模型,並運行了上述 2×2 測試,然後給其中兩個模型佈置了一組非編碼的桌面任務。以下是測試結果,包括每個模型的優勢和劣勢,以及我現在使用的設定。
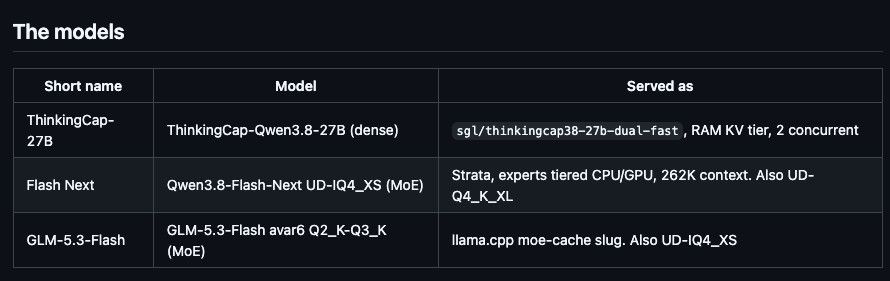
    受測目標模型

    image.jpeg

    受測結果 成功解題比率

    image.jpeg

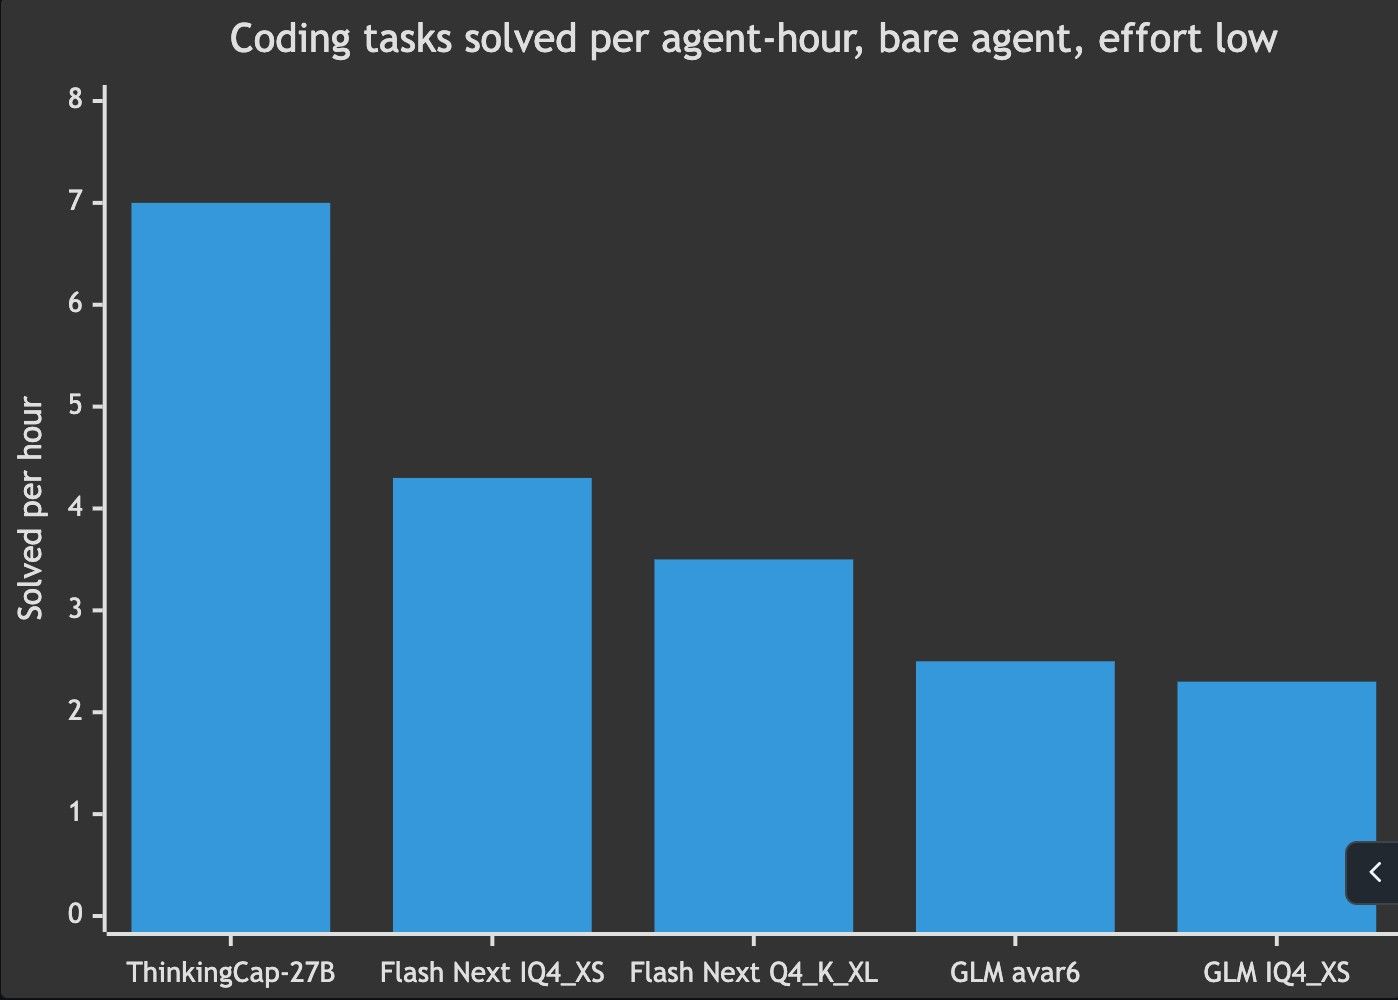
    每小時的解題效率

    image.jpeg

    Config Solved 95% CI Partial credit Right files Median min/task Solved per agent-hour
    Flash Next IQ4_XS 31/40 62–88% 0.85 0.93 9.7 4.3
    GLM avar6 13/20 43–82% 0.72 0.96 12.6 2.5
    Flash Next Q4_K_XL 25/40 47–76% 0.71 0.88 7.6 3.5
    GLM IQ4_XS 12/20 39–78% 0.70 0.93 12.0 2.3
    ThinkingCap-27B 23/40 42–71% 0.68 0.87 4.4 7.0

  • 這裡有玩音響的樂友嗎😅
    kos orK kos or
    随便聊聊

    AI 音樂創作:MiniMax-Music , Suno
    未來會不會是 買音響讓AI操作


  • 我觉得未来的智能发展是这样
    kos orK kos or
    AI Agent dsharness qwen 编程

    現在發帖壓力蠻大的 還要有武俠故事情節 🙂

    金庸武俠世界 黃藥師進行曲 | 東邪西毒
    Youtube Video

    23686b38-1221-4433-9672-4a79232dbe28-image.jpeg


  • GDDR7 市場對VRAM顯存大小的影響
    kos orK kos or
    随便聊聊 nvidia

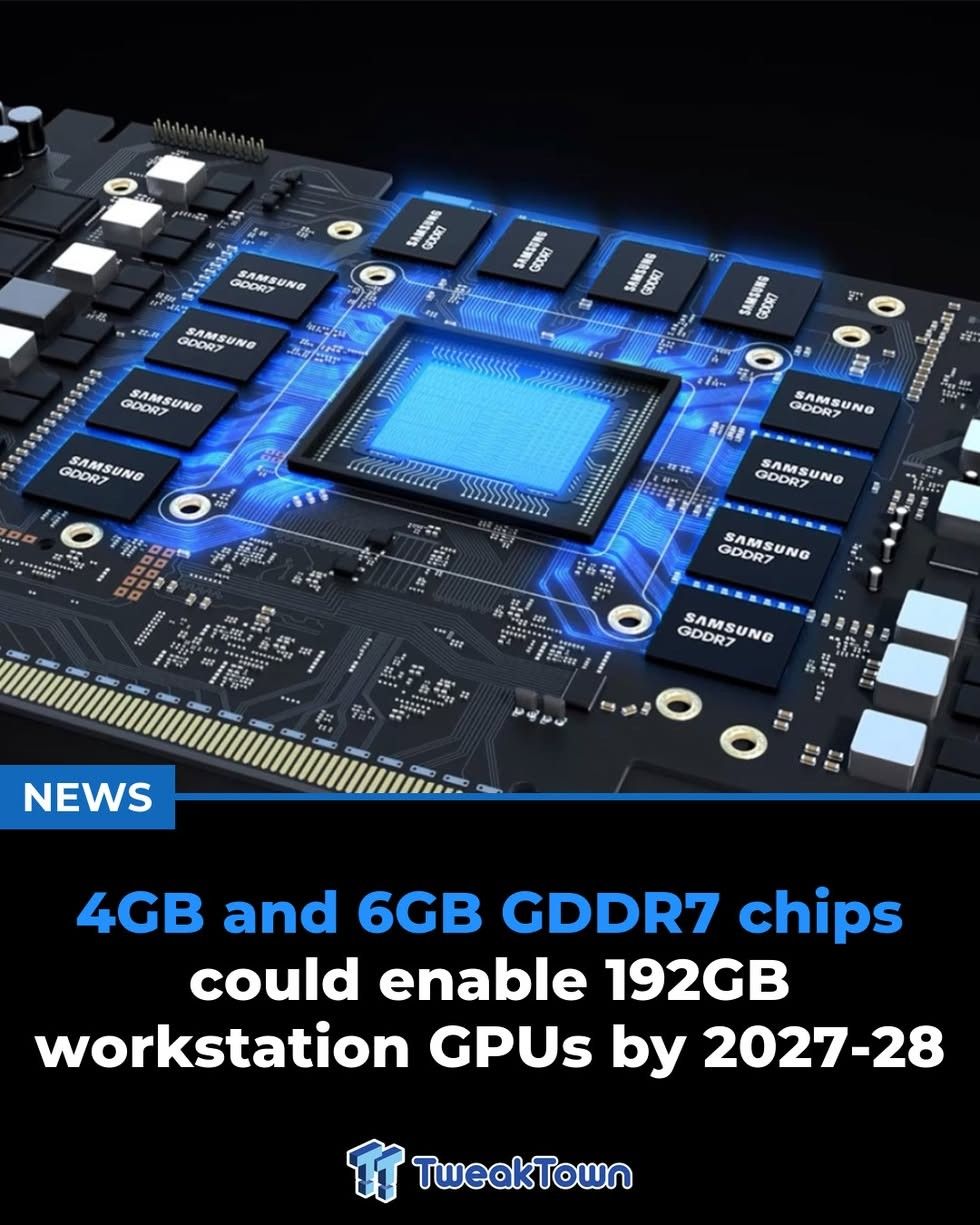
    今天看到兩則GDDR7新聞有交集之處

    • 新的 4GB, 6GB GDDR7 消息釋出 關於工作站 GPU
    • 美光停產兩款 2GB GDDR7 (目前應用在RTX 50 系列上) 只剩供應商 Samsung, Hynix 有2GB GDDR7
    • 現有 3GB GDDR7 主要應用在 RTX Pro 系列 (RTX 50 Super系列 因為3GB GDDR7成本因素 暫時停止推出)

    "洩漏的行業消息表明,4GB 和 6GB GDDR7 晶片可能在 2027-28 年問世,屆時工作站 GPU 的顯存容量可能高達 192GB,但成本仍然是一個主要問題。"

    72cbd3ea-8968-463f-904a-4df99efda921-image.jpeg


  • AI 代理透過視訊鏡頭 自行編寫 AMD 顯示卡驅動程式
    kos orK kos or
    AI Agent amd linux

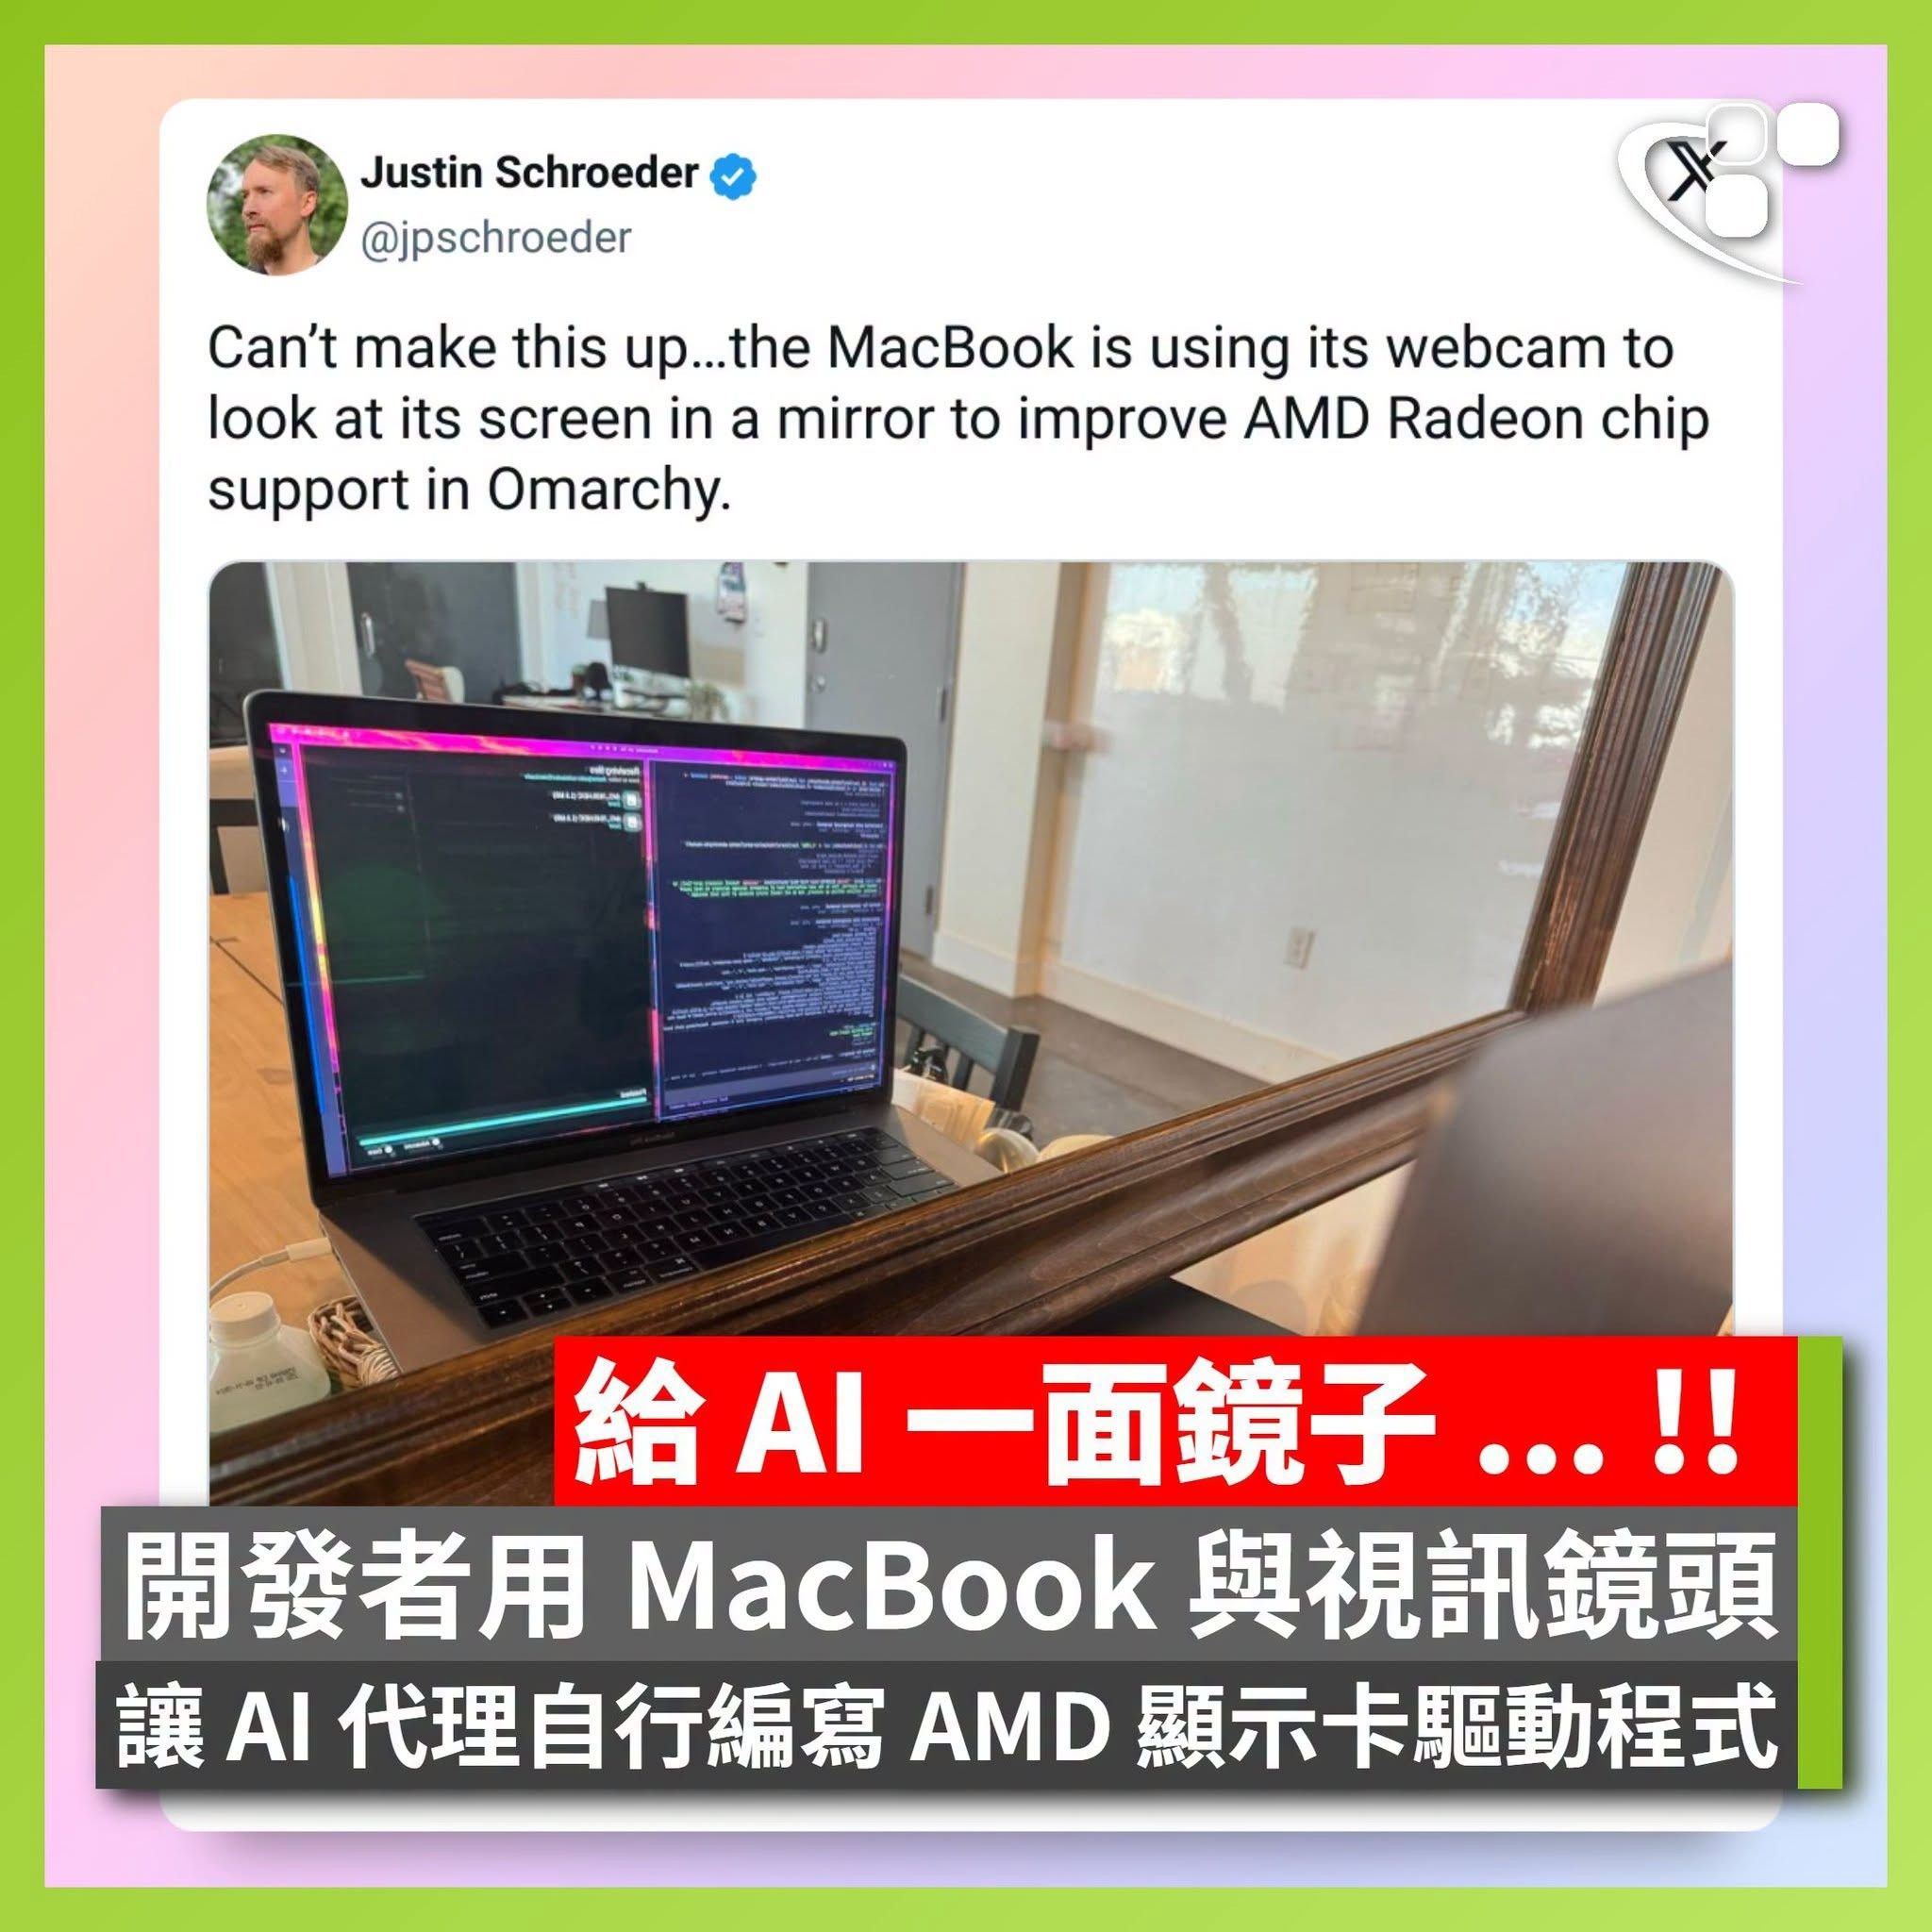
    [ HKEPC Hardware ] Agent 有時候在電腦控制方面有某種難度, 使用 視訊鏡頭 + 鏡子 出現了最短路徑
    創意感 100%

    著名 Linux 開發者 Justin Schroeder 近日展示了一項引人注目的實驗,他利用一部配備 AMD 顯示晶片的舊款 Intel 架構 MacBook,搭配視像鏡頭與一面鏡子,讓 AI 代理(AI Agent)透過即時視覺反饋,在屏幕上自行觀察渲染成果,並編寫和除錯自身的 AMD Radeon 驅動程式代碼。

    據 Justin Schroeder 表示,該部 MacBook 正透過內置的視像鏡頭,對準前方一面鏡子反射自身屏幕的畫面,以檢視畫面顯示變化,藉此改善開源發行版 Omarchy Linux 對 AMD Radeon 繪圖晶片的相容性與效能。
    e495baf9-6510-498b-baf4-9731647e04ac-image.jpeg

    Source: https://www.hkepc.com/26684?fbclid=IwY2xjawURYNBwZG9mBWV4dG4DYWVtAjEwAGJyaWQRMUVYZUtPS1J1Sm41NEl5V2pzcnRjBmFwcF9pZBAyMjIwMzkxNzg4MjAwODkyAAEeHFBkTiu8bYisLZFaSb_tfnsPpMAtYcizJKGwtZwvuSxHhf6PeFwYreIimdY_aem_UFRCFV42DyQxvC4Kg6-chA


  • RTX 5080 24G 價格預測 , 5080, 5070 Ti , 5060 Ti 遊戲卡後市看漲 ? 直逼企業卡 RTX Pro 系列 ?
    kos orK kos or
    随便聊聊 rtx5080 rtx5070 rtx5060

    據傳 "RTX 5080 24GB預計於2027年第一季上市,5080 16G將會停產"
    價格會直逼 NT$124,000 (RMB$25,800) 嗎?
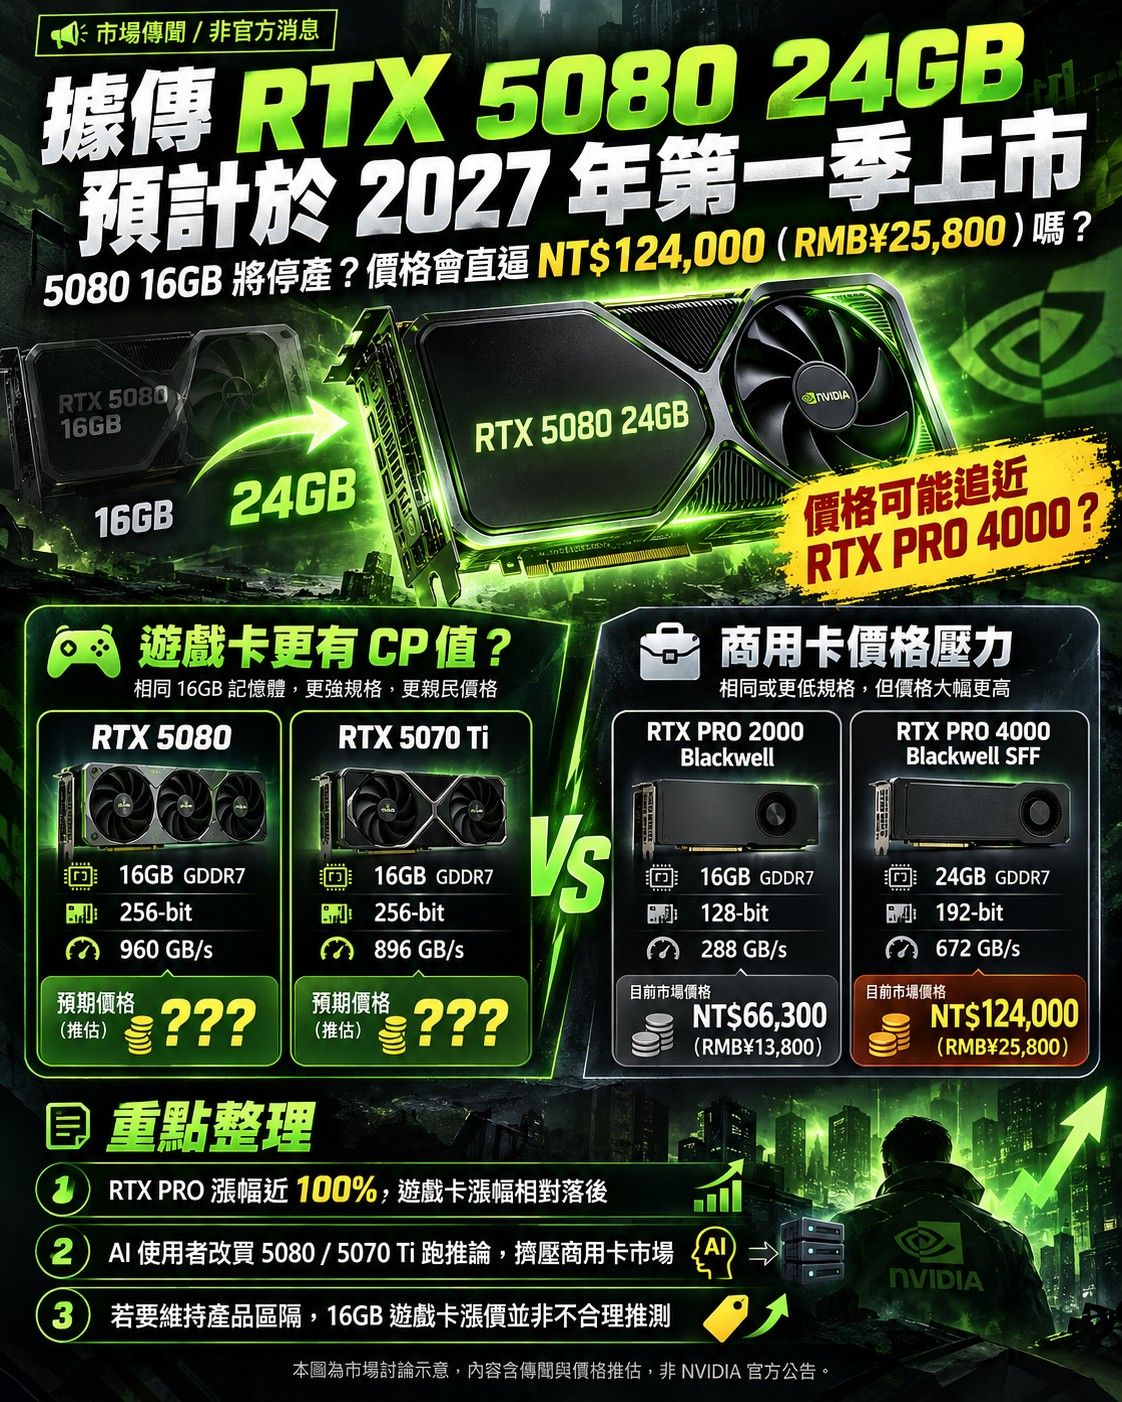
    image.jpeg

    **研究過今年Nvidia 的顯卡規格和定價,就知道目前Nvidia 的RTX 50系列 Gaming遊戲卡 和 RTX Pro 50系列商用卡產品有互相競爭的大問題(商用買家跑去組八卡5090遊戲卡 AI Servers); 主要起因可能是 RTX Pro 系列有將近100%的漲幅,但RTX 遊戲卡的漲幅相對落後,產生買遊戲卡跑AI,而不是買商用卡跑AI

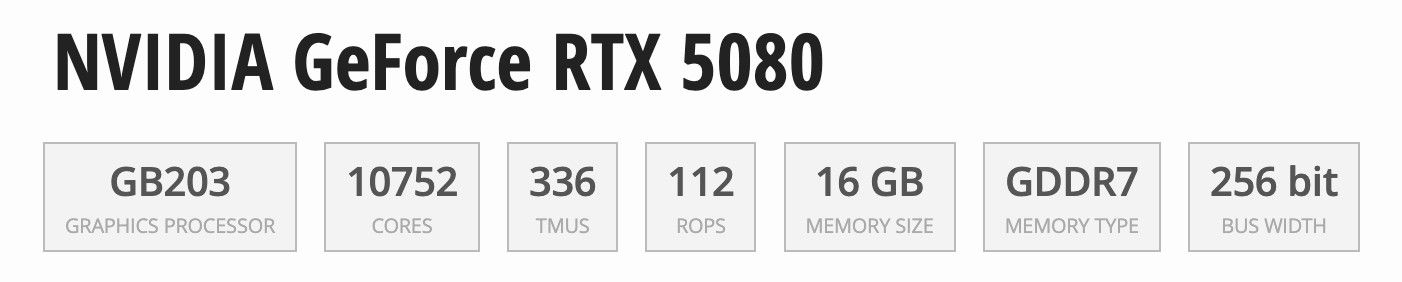
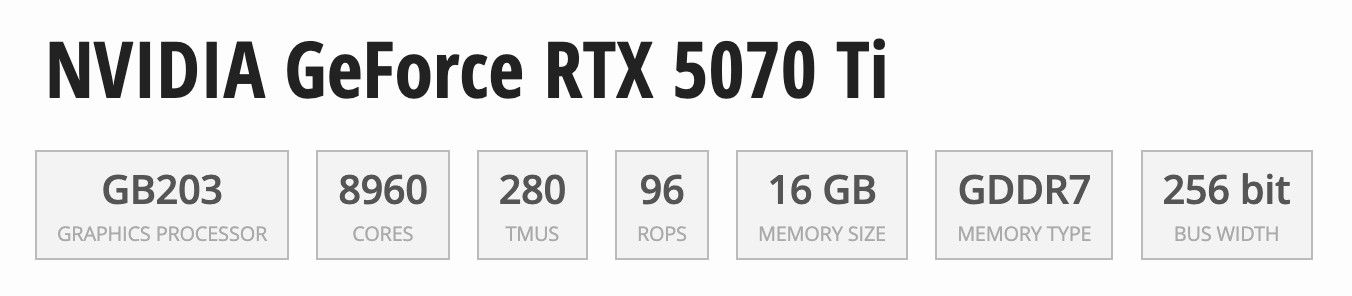
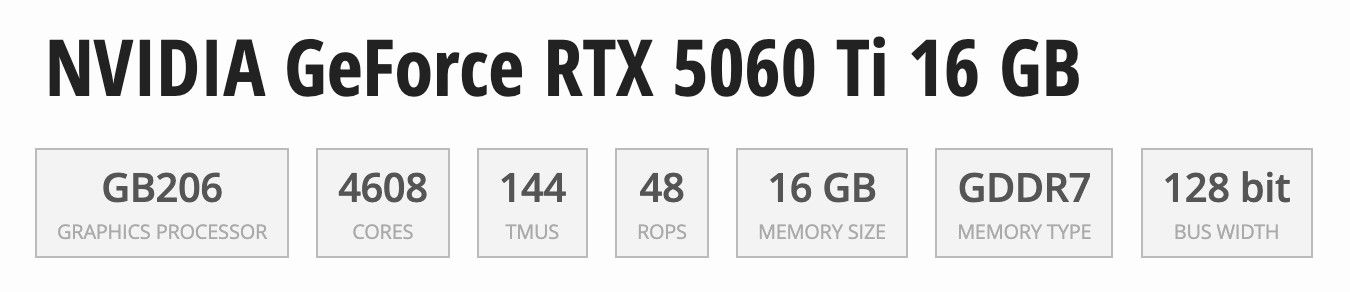
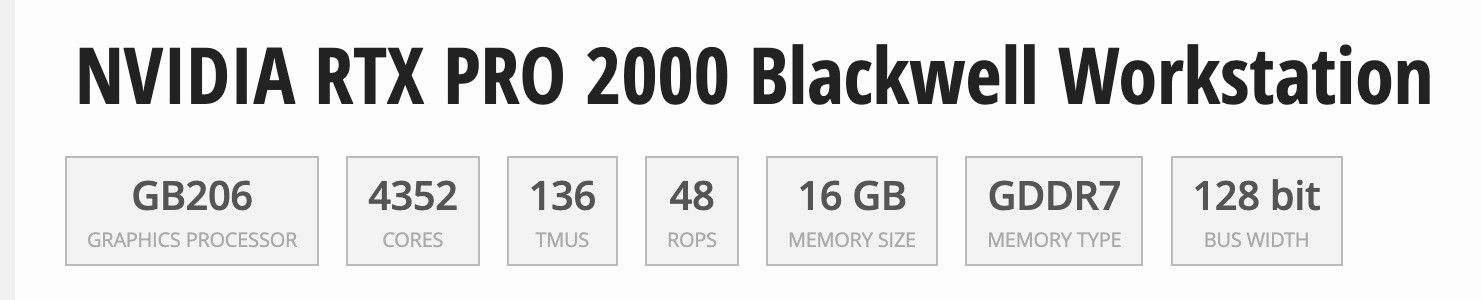
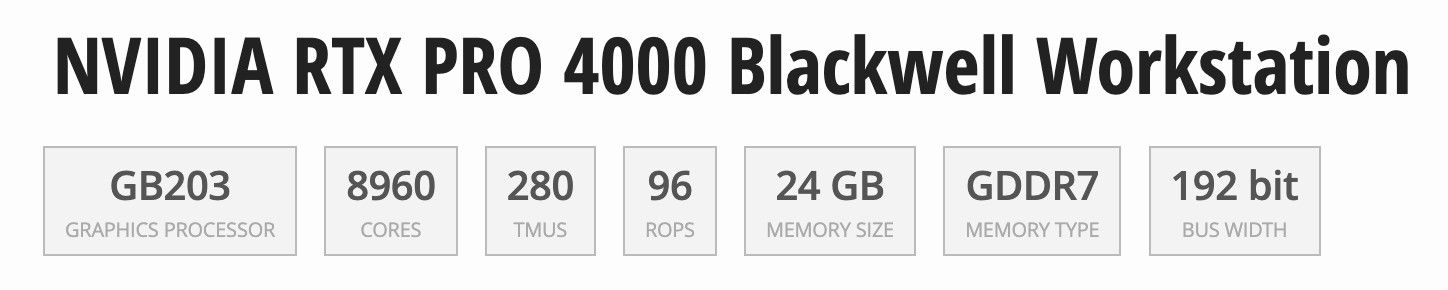
    在有CP值較高的平替產品情況下,RTX Pro 商用卡推估損失了不少市場份額,例如原本應該買 RTX PRO 2000 16GB(顯存帶寬288 GB/s) 的AI使用者,最後買了比較便宜且規格更好的RTX 5080 (960 GB/s) , 5070 Ti (896 GB/s) 來替代; 就連一張12萬台幣的 RTX PRO 4000 Blackwell 顯存帶寬也只有672 GB/s,這要讓中低階商用卡怎麼割韭菜呢?

    因此有人說RTX 50系列 16GB 遊戲卡會追趕漲RTX Pro企業卡的價位,這是合理的推測,也可能是Nvidia可能採取的產品策略調整

    目前市場報價 :

    麗臺 NVIDIA RTX PRO 2000 Blackwell 16GB GDDR7 工作站繪圖卡, NT$66300 (RMB$13800)
    麗臺 NVIDIA RTX PRO 4000 Blackwell SFF 24GB GDDR7 工作站繪圖卡, NT$124000 (RMB$25800)

    記憶體頻寬比較 (Memory Bandwidth)
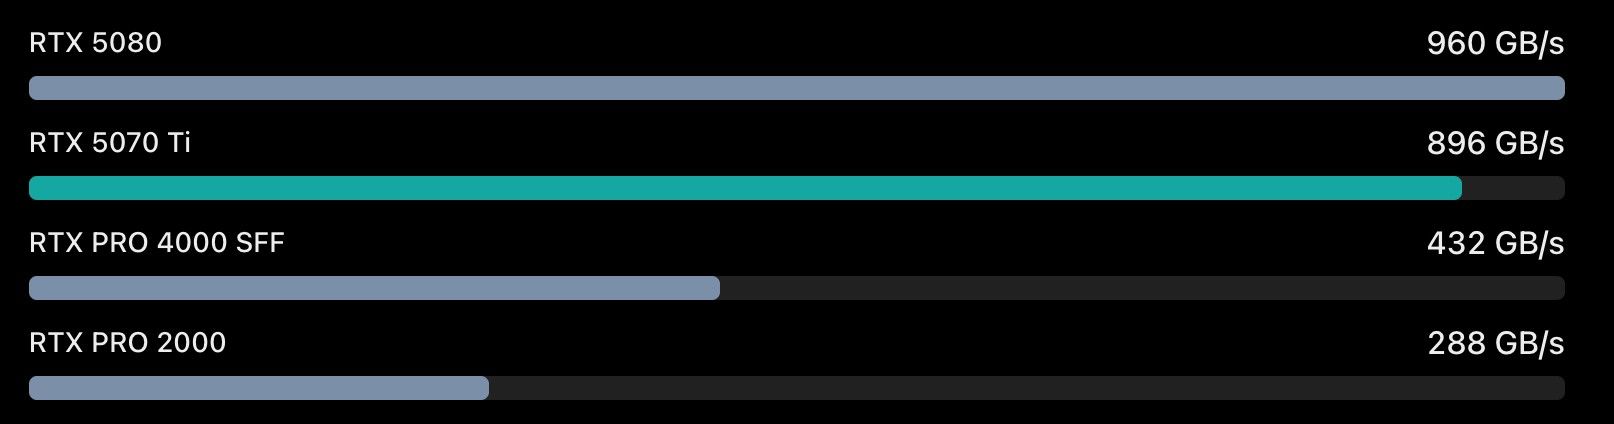
    image.jpeg

    遊戲卡規格(明顯比商用卡具有優勢 價位更低)

    image.jpeg

    image.jpeg
    image.jpeg

    商用卡規格

    image.jpeg

    image.jpeg

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组