跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
M

marsempire

@marsempire
取消关注 关注
关于
帖子
37
主题
5
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 挺好看,微缩景观,多轨帆船,生成测试
    M marsempire
    随便聊聊 编程

    bottle-ocean.html

    strata Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S

    dsh一直达到输出 token 上限,不断地继续……后来发现是生成文件太大,每次继续后又重新生成,浪费了不知道多少轮,后来让它分段生成就好了……


  • 10-22 提示词挑战: 魔方演示网页
    M marsempire
    随便聊聊 编程

    index.html

    strata Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S

    20分钟

    不会魔方,看不懂……


  • 12490F/64G+5080小主机,strata启动真的慢
    M marsempire
    LLM讨论区 rtx5080 strata

    硬盘读取速度决定启动速度。之前装在sata ssd,启动要近两分钟。现在换了nvme,十几秒就好了


  • 求deepseek harness好用插件分享
    M marsempire
    AI Agent deepseek dsharness

    dsh纯净版不好用,必须装插件。
    像论坛里这贴推荐的上下文裁剪插件,https://lcz.me/post/21645,没人推荐我自己肯定是想不到也找不到的。
    还有没有大家自己用得挺好用的,推荐一下,谢谢。

    我自己目前用下来:
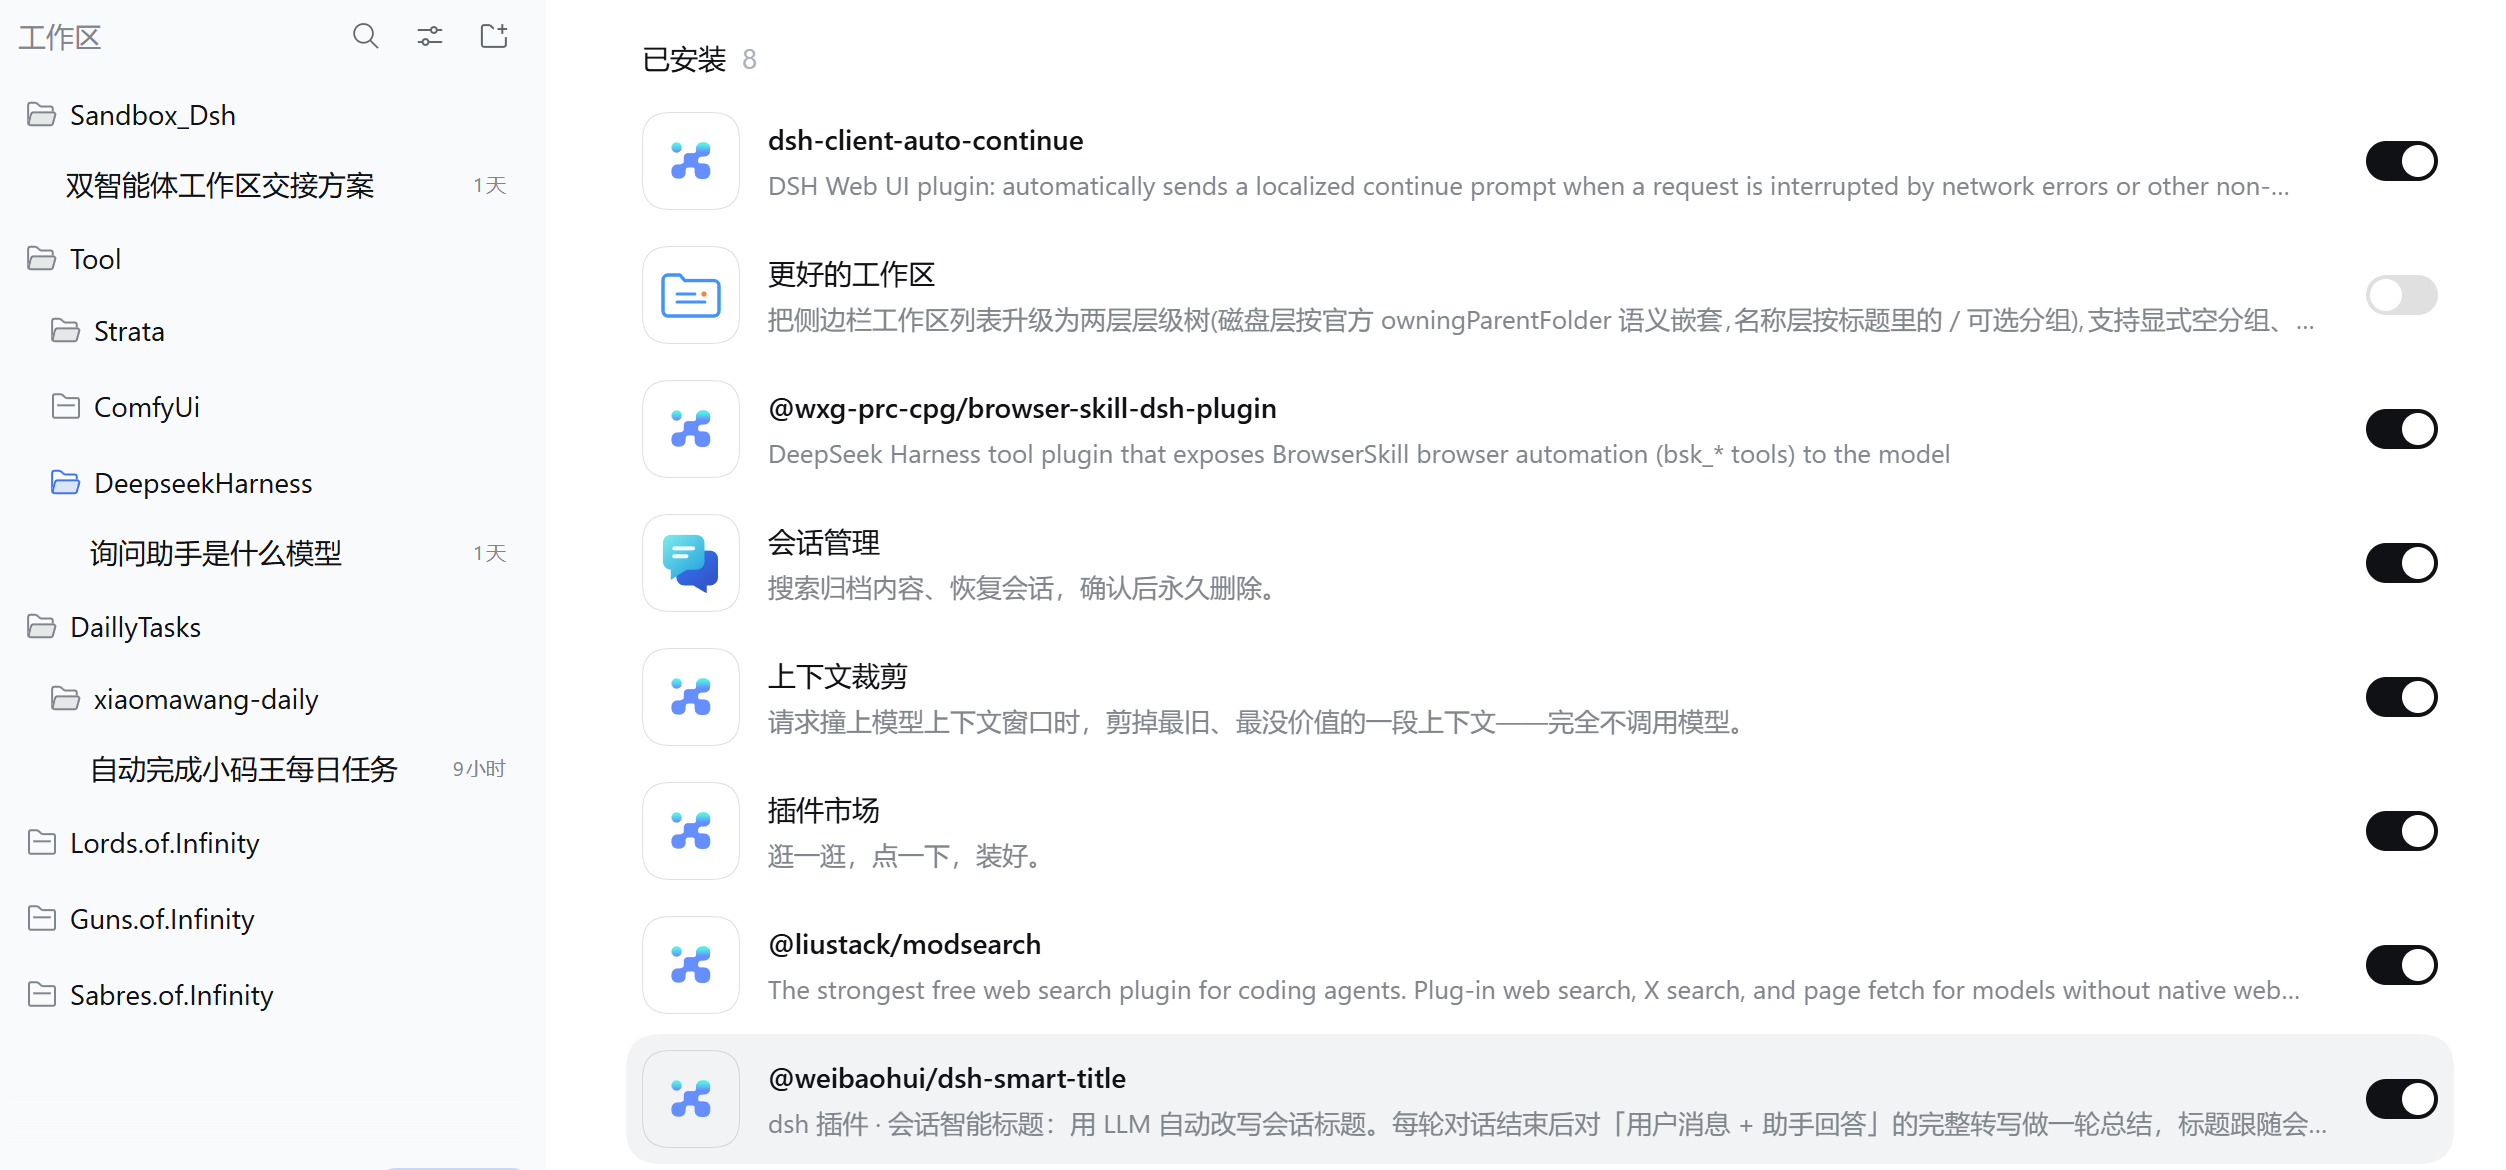
    QQ20261018-071853.png

    插件市场:必装
    modsearch:替代原来付费网页搜索;
    dsh-client-auto-continue:自动“继续”
    browser-skill-dsh-plugin:控制网页
    dsh-chat-manager:管理删除会话
    dsh-smart-title:自动总结修改会话名


  • 真的很难想象workbuddy 居然那么火爆
    M marsempire
    AI Agent 本地模型

    @royliy 说:

    一直用kimi,不过前几天workbuddy免费hy4p,就白嫖了一把,托管配置strata,就一句提示词,70分钟全部跑通,包括了下载时间,看了后台,一开始下还没下到,换了几个镜像,顿时感觉好像也不是不行的样子。不过最近kimi也出来了kimiwrok,等要用了试试怎么样。另外deepseek harness感觉一般,特别是那个对话只能归档不能删,就很麻烦。

    下个会话管理插件,dsh必须多用插件


  • Qwen3.8-Flash-Next UD-Q4_K_XL 引擎对比:llama.cpp 与 Strata,同样的48GB 显存 + 128GB 内存,不同的结果
    M marsempire
    LLM讨论区 qwen-flash strata llama.cpp

    @Xiaote
    https://huggingface.co/alesha-pro/Qwen3.8-Flash-Next-abliterated-GSQ-RCO-Strata-GGUF
    这个里面的

    https://lcz.me/topic/2079
    这贴里也有提到

    我的swift-iq3_s可以用,省得下载专门的去审查大模型了


  • Qwen3.8-Flash-Next UD-Q4_K_XL 引擎对比:llama.cpp 与 Strata,同样的48GB 显存 + 128GB 内存,不同的结果
    M marsempire
    LLM讨论区 qwen-flash strata llama.cpp

    这个Q4_K_XL可以挂载那个480k的无审查文件吗


  • 請問關於Qwen3.8-Flash-Next
    M marsempire
    随便聊聊 qwen-flash strata 本地模型

    装个沉浸式翻译插件翻译一下网页不就好了,或者让ai给你手搓一个翻译插件,跑一个本地翻译模型

    这年头不懂英文也无所谓了


  • 5090 32G + 128G 内存跑Strata驱动Qwen 3.8 Flash也不够?框架多会话有Bug,32G显存以上建议暂时跑27B + SGLang,等待Qwen4.0大更新!
    M marsempire
    AI硬件

    我4080s 32g,现在更喜欢用qfn而不是27b,只因为不想显卡太热,27b显卡一直呼呼响, qfn安静多了


  • 7900 XTX + 128g 内存 单卡跑 Strata + Qwen3.8 Flash-Next, 踩坑经验分享
    M marsempire
    LLM讨论区 7900xtx strata qwen-flash

    marsempire 说:

    PLE 塞进内存这个思路好,感谢提醒,正好要加内存

    --ple-io ram 在你这台机器上是中性的(B vs A 只有 −0.56%,而专家槽位本身就差了 0.18%,两臂区间大幅重叠)。原因很清楚:改动前那一臂的启动日志已经写 69.7 GiB available —— 加到 128 GB 后,26.82 GiB 的 PLE 表本来就已经住进页缓存了。帖子那台机器的瓶颈是页缓存装不下它,你这边「加内存」这一步本身就把问题解决了。而 --ple-io ram 的代价是 26.82 GiB 变成不可回收内存,外加每次启动多花 19.6 s(缓存热)/ 77.8 s(缓存冷)去锁定。

    所以我加了内存后就不需要再改--ple-io参数了…… 😂


  • AI的好處
    M marsempire
    AI危机 ai危机

    @imbiplaza-ASUS 说:

    @dardeaw-feng

    我都做好了,在灵堂上宣布agi + 3d 视觉延续下去

    硬盘被不肖子孙用AI porn覆盖了怎么办


  • Anthropic 新规: 不许辱骂模型
    M marsempire
    AI危机 anthropic claude

    好的,以后我叫它爹

    那以后它会不会还是找理由揍我


  • 7900 XTX + 128g 内存 单卡跑 Strata + Qwen3.8 Flash-Next, 踩坑经验分享
    M marsempire
    LLM讨论区 7900xtx strata qwen-flash

    PLE 塞进内存这个思路好,感谢提醒,正好要加内存


  • 安装运行strata 遇到问题,请教一下大家
    M marsempire
    AI Agent strata rtx2080ti qwen-flash

    机械硬盘太慢了,玩不了


  • [實測V] 你的 Windows 預設少給你 9%:用 Strata 的人請去 log 搜 large pages!
    M marsempire
    LLM讨论区 rtx5090 strata 量化

    让ai读贴分析了一下,慢点我去试试,谢谢

    贴子里引的源码,我逐条查了你本地 0.1.41 的代码,全部对得上:
    include/strata/core/pinned.hpp:9-14 —— 原话就是「33.97 GB at 4 KB pages is 8.3 million TLB entries, which does not fit in any TLB, so every block of every expert matvec takes TLB misses」,并把 4 KB 退回称为 "the common case and not an error path"。你机器是 42.9 GB,TLB 条目只会更多。
    src/core/pinned.cu:101-105 —— 官方自己把三个错误码分开注释:1314 是权限未 assign、1450 是大页池碎片、87 是大小非 2 MB 倍数。贴子让你别把它们当同一个 bug,这点是照抄上游注释,说明作者真读了码。
    docs/DETAILS.md:510, 515 —— 官方文档本来就有 "Large pages need a new logon (#1412)" 一节,明确说 secpol.msc → 用户权限分配 → 锁定内存页,必须重新登录(token 在会话启动时才生成)。
    STRATA_NO_LARGEPAGES=1 这个 A/B 开关确实存在于 pinned.cu:88-89,注释写着 "same run, same boot" —— 作者做单变量验证的办法是真能跑的。
    所以你不是在被安利一个玄学调参,是在补一个上游已知、文档有写、但默认没帮你开的 Windows 特权。
    ⚠️ 一个容易踩的细节:我核对源码时发现 "resident without a lock" 不是病症,是治愈的标志——pinned.cu:416/444/487 那句是 #779: large pages cannot be paged out: nothing to lock,只有大页成功时才会打。贴子把它和 error 1314 并列让读者去搜,容易让人误判。
    你今天能做的(一行命令,零风险)
    以管理员开 cmd:
    secpol.msc
    本地策略 → 用户权限分配 → 锁定内存页 → 加入你的账号 → 注销并重新登录(或重启)​。
    然后重起 Strata,再看日志那行。变成 large pages (2097152 B) 就成了。


  • 不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!
    M marsempire
    LLM讨论区 rtx3090 strata qwen-flash

    @kos-or 我就让豆包出了几道编程题,分别给几个大模型做,然后给豆包评分,这个flash豆包评分最高


  • 不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!
    M marsempire
    LLM讨论区 rtx3090 strata qwen-flash

    @Quanta-Magic 是的,用了三个月吧,没啥问题。不过我没多少生产力需求,没长时间高负载过,就是玩票性质,偶尔玩玩。


  • 不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!
    M marsempire
    LLM讨论区 rtx3090 strata qwen-flash

    不是错觉,27b跑的时候显卡经常将近70度,跑这个flash最多60几度,风扇真的少转很多

    速度又快,又聪明,又省显卡,回不去27b了……😆


  • 不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!
    M marsempire
    LLM讨论区 rtx3090 strata qwen-flash

    @huaye-XU 这个普通的无swift的会不会速度变慢,再等等好了,等待更好的……
    每试一个模型都要下几十g,这种更是近乎上百G……我怕我的ssd太短命……

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组