

按规矩:鹈鹕骑车(Generate an SVG of a pelican riding a bicycle)
按规矩:鹈鹕骑车(Generate an SVG of a pelican riding a bicycle)
之前在1017 上 Strata 还差哪些 Gap和准备开始实测的回复里挖了个坑,这次回来交作业:同一台双 96GB 显存、48GB 系统内存的机器,DeepSeek V4.1 Flash 1017 已经跑上 Strata,也接到 OpenCode 里实际用了。 
不是之前 Qwen 那个 210 tok/s 的配置换了个模型名。这次用的是 1017 的 EXL3 2.7 bpw 量化。原帖截图使用普通 decode;完成下面这轮对照后,当前部署改选 按层拆分 + DSpark,仍然不开跳专家。
这轮把 DSpark 的验证和状态提交改了一遍,也实际做了 TP2。结论先说:这台机器上,当前实现还是按层拆分 + DSpark 更快,TP 暂时不作为默认方案。
同一个代码问题(要求用 Python 写线程安全的 LRU cache),63-token 输入,固定比较前 96 个 greedy 输出 token。输入逐 token 处理,prefill 不计入 decode 时间;预热一轮,再测三轮取中位数。四种模式的输出 token 完全相同:
| 执行方式 | 推测解码 | Decode |
|---|---|---|
| Layer split,18/22 层 | 关 | 68.1 tok/s |
| Layer split,18/22 层 | DSpark | 80.8 tok/s |
| TP2 | 关 | 42.0 tok/s |
| TP2 | DSpark | 43.0 tok/s |
这组短代码题里,Layer + DSpark 比 Layer 普通 decode 快约 18.7%。DSpark 的预热和测量轮都用了 33 个验证窗口,平均每窗口接收 2.909 个输入 token;不是说每个窗口都接收了这么多个额外草稿,这个统计包含必然提交的首 token。
测量使用 CUDA 13.4 / GCC 15;测试进程限制为 16 GiB 主机内存、禁用 cgroup swap,CPU 配额设为 200%。MTP 专家 GPU 缓存上限为每个参与 drafting 的 rank 1024 MiB,按可用显存有界增长。
这轮主要改了两点:
代码和部署配置都已提交、推送:
80.8 tok/s 是这组短输入、固定输出的 native-engine 对照结果,不是下面 OpenCode 截图那条 51K 输入请求的新版测速,也不是所有 coding 请求都能达到的速度。 原截图和约 63 tok/s 的标题保留,不混成同一组数据。
还是之前跑 Qwen 的那台机器,没有为了这次实验升级系统内存。装机、拓扑和机器照片可以看旧帖。
感谢 Niko 的 Strata、Jackwwg83 的 DeepSeek 后端,以及 sudoingx 的量化。不是我从零写了整个推理引擎:现在的仓库直接基于 Niko 的上游,选择性移入已有 DeepSeek/EXL3 实现,再补这台机器需要的双卡驻留、低 RAM 加载、prefill 和服务适配。
部署仓库固定引擎版本和量化版本,具体构建、安装和启动方法都放在 README 里。现成量化会生成运行用的 pack,这是打包/重排,不是本地再量化一遍;也仍然需要额外磁盘空间,不是零转换缓存。
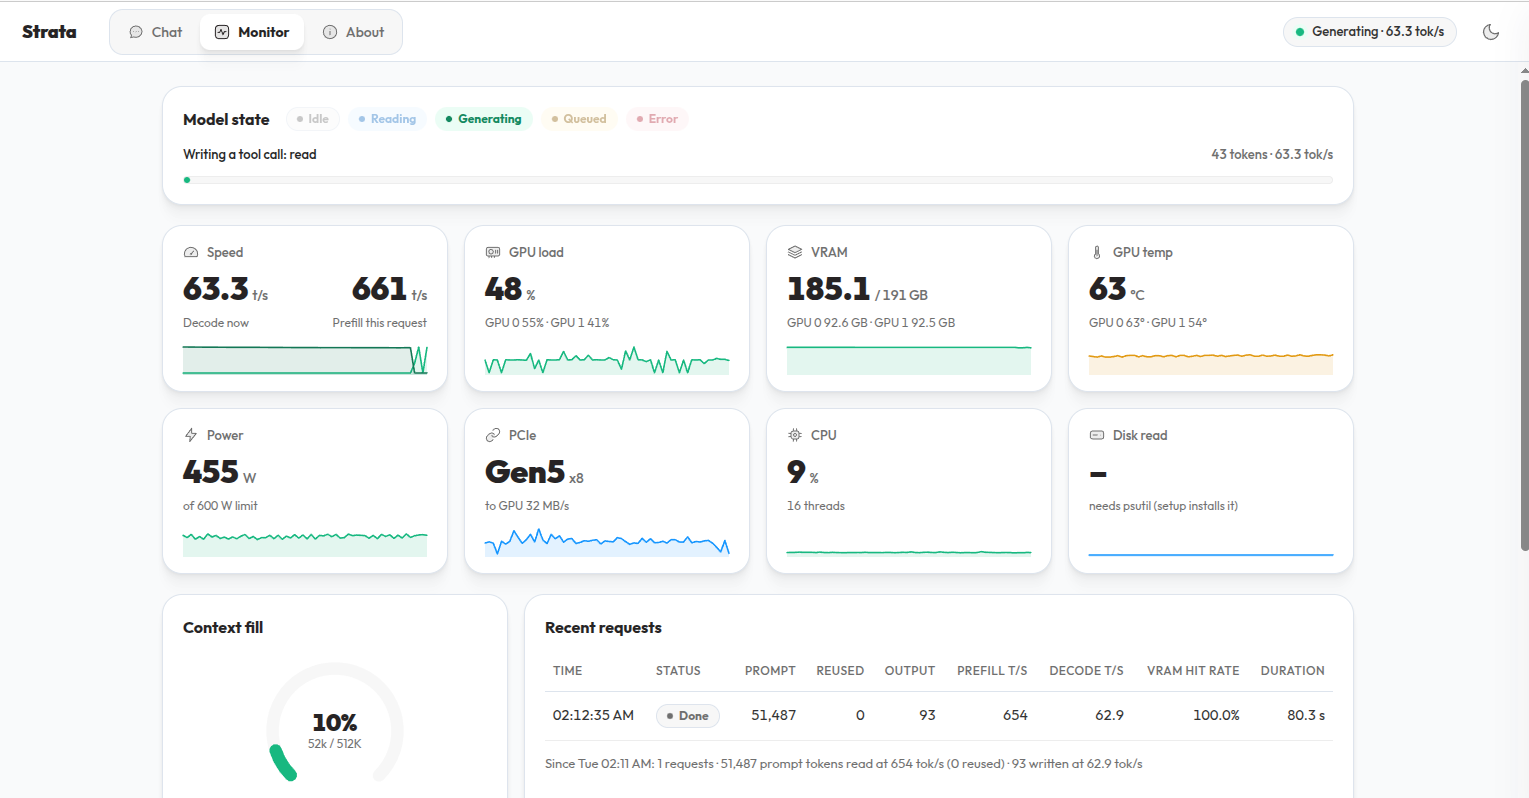
图里正在生成一个 read 工具调用。下面那条已经完成的请求,统计是:
| 项目 | 数值 |
|---|---|
| 输入 | 51,487 tokens |
| 输出 | 93 tokens |
| Prefill | 654 tok/s |
| Decode | 62.9 tok/s |
| 请求总耗时 | 80.3 秒 |
| 专家显存命中率 | 100% |
截图当时双卡合计显存占用 185.1GB,两张卡分别约 92.6GB / 92.5GB。GPU 合计功耗读数约 455W,这是显卡传感器读数,不是整机插座功耗。
所以现在可以更新成:1017 不只是能输出几个字,已经能接进 OpenCode 发起实际工具调用请求,截图这条请求的 decode 约 63 tok/s。
不过这不是统一条件的 benchmark:这条输入约 51K,只输出了 93 tokens,不能代表所有任务和上下文长度。也不要拿它和旧帖 Qwen 的 210 tok/s 直接横比,模型、量化和请求都不同。
核心还是旧帖说的那件事:显存够,不代表加载过程就能在 48GB RAM 里完成。
默认部署走的仍是按层拆分,不是 TP,也不是把两张卡当成一张统一的 192GB 显卡:
Prefill 也做了有界分块,避免长输入时临时空间失控。当前仍是单会话,生成路径改选 Layer + DSpark;上面的 OpenCode 截图仍然是普通 decode 的历史请求,不是靠这轮 DSpark 改动跑出来的。
目前配置容量是 524,288 tokens,单个会话。但这里有两轮版本,数据不能混着写:
ccd8cf2,实际跑过 32K、128K、262K,最后输入 524,256 tokens,在 524,288 容量内取回了开头指定的口令。最后一档 prefill 531.73 秒,约 985.95 tok/s,完整测试 552.90 秒,没有 swap/OOM,也没有主干专家流式换入。前面的长输入测试是重复填充内容加开头口令检索,不是全面的长上下文质量测试;OpenCode 截图也不是 524K 输入。这里先把能确认的结果交代清楚。
之前在讨论里说过,能启动、能输出,不等于已经证明适合当 coding agent 或 subagent。现在至少把部署和实际请求这一步走通了,后面更值得花时间的是 Eval:中文、代码、工具调用成功率、长上下文效果,以及真实任务的延迟和成本。
EXL3 2.7 bpw 的质量损失还没有靠这些测试量化出来,和可信参考实现的全面对照也没做完,暂时不下“无损”“追平原版”之类的结论。Docker 的 GPU 路径和新版实模型 HTTP 端到端验证还没做完,目前部署仍走 native,服务按需手动启动。
总之,之前的 Gap 帖不是白挖坑了。这台“大显存、小 RAM”的机器,现在又多了一个能接进 OpenCode 折腾的模型。欢迎有类似配置的朋友交流,尤其想看看大家怎么做真实 coding/tool-use 的评测。
羡慕了 两张pro6000跑不了
@xiaopbro 这个模型763B参数 Q4要500GB硬盘非常大
准备蹲一波unsloth或者HuggingFace上几个大神的Q2 Q3模型
持续关注中:https://huggingface.co/unsloth/DeepSeek-V4.1-Flash-1017-GGUF
@terry 我觉得可以换个例子来看:Dots、Muse、Cue、Instinct、Grok Bot,甚至 Hermes、OpenClaw 这些,随着模型和工具能力普及,做出类似功能的技术门槛可能会越来越低。但某个产品没有很深的壁垒,不等于这种形态会消失。就像浏览器有 Chrome、Edge、Firefox,产品可以竞争、更替,但浏览器这种入口一直存在。
我说的 Agent Native 更偏向这个变化:以前是人打开不同软件,点窗口、填表,把步骤串起来;以后越来越多时候,是人表达 intention,也就是目标和约束,让 agent 去调用底层系统完成。你主帖里说的“通过聊天把想法告诉 AI,不需要自己点鼠标”,其实也是这个方向。
如果调用者越来越多是 agent,底层系统就不能只考虑按钮放在哪里,还得让它能准确读取状态、在权限范围内执行、出错后恢复。这部分是具体的工程问题,不只是换个名字。
当然也不是说 GUI 和按钮不需要了。就像 Windows 有图形界面,也一直能用 CMD、PowerShell,几种操作方式可以共存。以后我们仍然可以手动操作电脑,也需要看结果、做判断、随时接管。变化的是不必每一步都亲自点,而不是人不能再点了。
@terry 我在企业里看到的是现在每个部门就算不是搞IT的都具备了一定的编成能力 都想做一个部门的数字员工以及AI工具。然后每个部门都有自己的职权范围 所以简单的工作流他们其实可以不依赖程序员了。当然目前来说还是无法完全自动化,只要一个工作流里有一环还是需要人 整个工作流就没法自动化。
但企业系统甚至是人事结构以后都会跟着变化。所以这些部门最后会不会继续拥有现在的职权范围 也很难说。
当然我只能用外企的视角来看 国内很多企业可能是不同的
@terry 老哥你有个feedback信箱之类的可以用来搜集大家对你的建议?类似github issue那种。题外话:为什么Steam中国区游戏评价那么多差评 很多时候是中国玩家没有一个宣泄意见的出口 直接给开发者联系反馈 只能通过留评论来引起注意。
但是这个确实很微妙 一方面您没那么多时间来完成这些细节 push back也是合理的 但有时候有的建议可能会提高论坛的体验。
或者您专门开一个反馈专区?然后让你的Agent定期扫描一遍看看哪些是高优先的feedback?
有个很地狱的比喻:旧显存可以回收 芯片可以回收 旧显卡也可以继续跑新模型。但人脑子可不能回收。
GPU以及一系列支持AI的系统和算力 最终替换的是人的劳动力(也解释了硬件价格为什么越来越贵)
目前世界的网络基础系统还是为Human服务的 但今后大部分人都是靠agent来和底层系统交流 所以很多系统要重新设计成Agent Native:
https://blog.haochuanz.net/posts/when-the-caller-is-an-agent
@johnnybegood 完全同意 跑起来最多能证明能输出>=1 tok/s不能干任何事。
能稳定干活 作为subagent的LLM 能降低延迟或成本 增加效果(这只能通过eval那一套东西来测)才是本地部署的作用
今后的重点是Eval,而不是“我觉得他好像挺聪明”
我近期准备在这台双 RTX PRO 6000、48GB RAM 的机器上实际尝试一下。
初步打算先评估 Strata-DS,参考 Xolotl 和 DS41RT,不急着从官方 Strata 从零写后端。先核对 1017 的权重结构和量化来源,再测短上下文、加载峰值及逐卡显存;正确性基线会先关闭跳专家、缓存感知路由偏置等有损优化。
后面再看双卡驻留、DSpark,以及逐级加长上下文。目标仍是尽量让计算权重留在 GPU、Engram 留在 NVMe,RAM 只承担有限缓冲,但目前不能保证能实现,更不能提前承诺速度。
跑通或踩坑都会回来更新,记录具体版本、量化、每卡 300W 下的速度和内存占用。有做过相关尝试的朋友,也欢迎分享经验。
之前在双 RTX PRO 6000 跑 Qwen3.8-Flash-Next 的帖子里,补充过我为什么选择 Strata:两张卡各有 96GB 显存,但系统内存只有 48GB,两张卡都限制在 300W,主要考虑长期安静开机,不是满功耗刷分。
最近想在同一台机器上尝试 DeepSeek-V4.1-Flash-1017。查了一圈源码后,发现已经有 Strata 的 DeepSeek V4.1 社区分叉,不一定要从零移植。想开个帖子讨论:基于现有实现,距离“双卡、大显存、小 RAM、NVMe 后备”跑好 1017,还剩哪些 Gap?
先说边界:我目前跑通的是 Qwen + Strata,以及之前的 DeepSeek-V4-Flash-0731 + vLLM-Moet;没有在 Strata 系分叉上跑通 V4.1,更没有实测 1017。下面是源码、配置和作者报告整理,不是我的新跑分,也不是一套已经验证可用的配方。
我在原帖的补充里解释过,Strata 吸引我的不是“完全绕过 RAM”,而是可以用有限的主机缓冲,把专家权重分批搬进 GPU cache;已放进 GPU 的部分,不必再在主机内存里常驻一整份专家副本。
现有 Qwen 配置中,全部 24,576 个专家进了双卡 GPU cache。这是它在我机器上表现不错的重要前提,不能直接推导成更大的 DeepSeek 也会一样快。数据仍要经过主机内存,不是 SSD 直接传显存;RAM budget 也不是整个进程的内存上限。
我的诉求是尽量避免为了加载模型,先准备超大主机内存,或者再生成一套几百 GB 的转换缓存。checkpoint 文件大于 48GB,本身不能证明跑不了;关键是加载峰值、常驻分配和临时转换分别占多少。
官方上游 Strata 没有 DeepSeek V4.1 后端,不代表 Strata 生态没有。 目前最值得评估的是这两个项目:
项目:Strata-DS,检查版本 a46eeba。
已经有独立的 V4.1 计算图和 CUDA kernels、EXL3 专家分层、磁盘 Engram、批量 prefill、DSpark、服务接口,以及相关测试。源码里有显式专家 RAM 预算,允许设为零,不能简单理解成“必须在 CPU 常驻一整份专家权重”。
但还不能原样照搬:
项目:Xolotl,原名 Strata-DSV4.1,检查版本 7375e30。
已经有 V4.1 引擎、GSQ 量化工具链、三层专家缓存、磁盘 Engram、DSpark、FP4 KV 和服务适配。量化与正确性检查工具尤其值得参考。
限制也要一起看:作者主要在 4090 + 90GB RAM 上验证,部分配置使用约 60 GiB pinned arena。源码允许限制 arena,但调小后在我这台机器上的峰值和性能没有验证。还有改变专家选择的缓存感知路由偏置,需要与严格路由分开看;现成模型带有 Uncensored 标识,也不能直接当成官方 1017。
两个仓库根许可证都是 MIT,方便研究和改造;具体引入的第三方组件与模型权重仍要分别核对许可、保留声明。我目前只检查了这些源码和文档,没有本机复现,也没有找到这两个项目明确验证 1017 的证据。
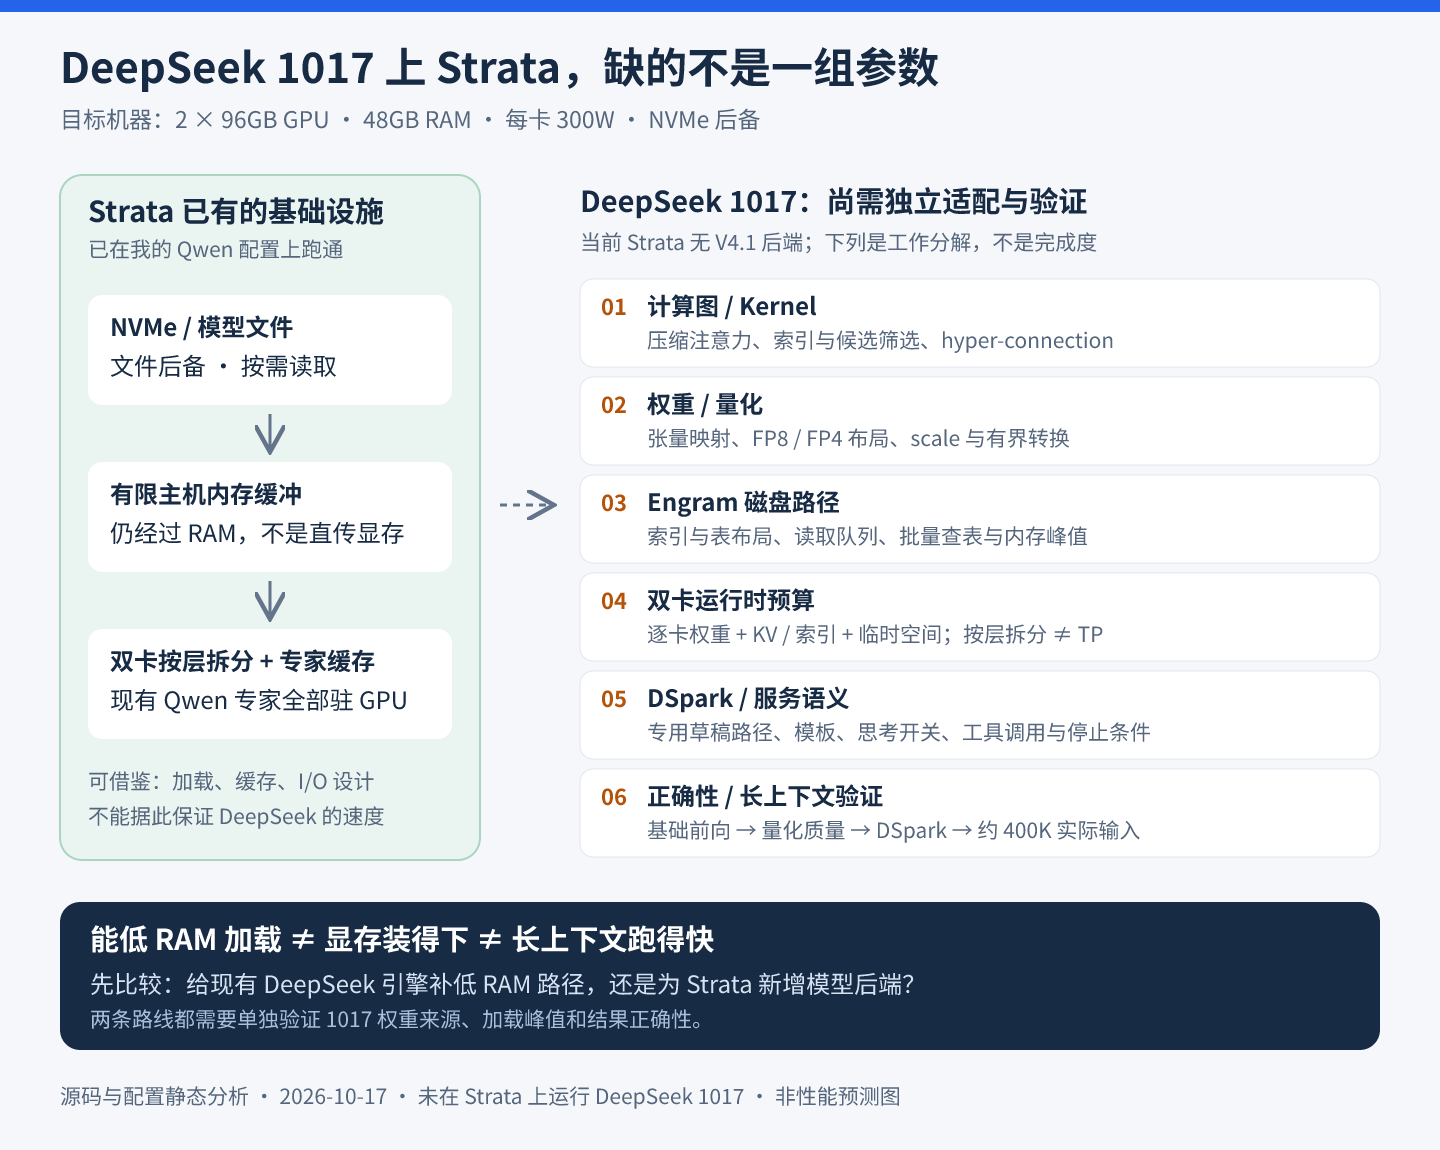
图中“Strata”指官方上游;社区分叉已实现其中不少模块。右侧六项是针对 1017 和我的硬件仍需逐项核对的清单,不代表全部需要从零开发。
检查的官方 Strata 上游版本只识别 qwen4exp 和 qwen35moe;1017 官方配置是 DeepseekV41ForCausalLM,涉及压缩注意力、KV/index 来源层、候选块筛选、hyper-connection 和 Engram 等结构,不能直接套 Qwen 前向。
但社区分叉已经实现了 V4.1 的后端。现在更合理的第一步是对照旧 V4.1 与 1017 的参考实现、张量结构和编码文件,确认哪些模块可以直接沿用、哪些语义需要修改,而不是重新实现一遍全部算子。
1017 官方 checkpoint 使用 safetensors,配置包含 FP8、分块 scale 和 FP4 专家。现有分叉分别走 EXL3/pack 或 GSQ/GGUF 等路径,格式并不互换。
即使计算图兼容,也需要明确基于 1017 权重制作的量化,验证张量映射、scale、布局和质量。旧 V4.1 量化换个模型名称,不会变成 1017。 如果自己量化,还要单独核算校准、转换的 RAM/VRAM 峰值,以及额外磁盘空间;运行时低 RAM,不代表量化也自动低 RAM。
1017 配置在第 1、14 层设置 Engram。现有分叉已提供磁盘查表路径,不需要仅凭 Qwen 的 PLE 经验重新猜一套。
仍要验证 1017 的索引、表布局与 scale 是否匹配,以及长 prompt 下读取队列、staging buffer、pinned memory 和 page cache 的峰值。mmap 只是映射机制,不自动等于物理内存占用有界。
两张 96GB 不能当成一张统一的 192GB 显卡。每张卡都要分别容纳分配给它的权重、KV/索引状态、草稿和临时空间。
我更想利用显存优势:尽量让量化计算权重常驻两张 GPU,Engram 留在 NVMe,RAM 只承担有限缓冲。 不能直接照搬那些为 24GB 显卡优化的大 CPU 专家池方案。
双卡分层还要处理 V4.1 跨层共享的 KV/index 状态,不能只在中间层切一刀。按层拆分与 TP 也不是同一种方式;我这台机器还有 PCIe x8/x8 的约束,需要结合具体路径测。至于两张卡能否把某种量化和运行时状态全部放下,目前不能保证。
两个项目已有相关实现,能减少不少工作。我的顺序仍是先关推测解码,验证基础前向和严格路由,再接 DSpark,检查接受率、结果和实际加速。
tokenizer、chat template、思考开关、tool calling、停止条件也要对照 1017 验证。服务端有兼容 API,不代表模型语义自动兼容;视觉可以后置。
首先关闭跳专家、缓存感知路由偏置等会改变计算结果的优化。即便关闭这些,同一量化与原始权重也未必质量一致,CPU/GPU 数值路径还可能存在差异,需要分别检查。
对我而言,最终目标不是“启动成功、输出几句话”,而是约 400K 实际上下文下还能稳定干活。至少分开记录:
配置上限写 1M,不等于实际填满 1M 测过;一条 200 tok/s 的截图,也不能代表所有任务。
论坛两篇四台 GB10 的报告也很有参考价值,感谢分享:SparkRing 无交换机环、MiaAI-Lab 配方。它们支持了磁盘 Engram 这条路线的可行性,但都是早期 V4.1,不是 1017;四台机器的统一内存容量也不能直接类比双卡 + 48GB RAM,作者报告的速度我没有复现。
我现在的判断是:不必先从官方 Strata 重写整个 DeepSeek 后端,更值得优先评估已有社区分叉,再补 1017、双卡驻留和低 RAM 的缺口。 这仍然不是换一组启动参数就能保证成功,但工作范围比从零移植小得多。
如果有人已经做过相关尝试,尤其想了解:
欢迎贴具体版本、启动峰值和测试口径。比起先追最高 tok/s,我更想先确认一条能稳定复现、长期开着用的路线。
Google发布Harness^2
https://github.com/google-research/harness2
最近很火的逆向Lightroom项目:https://github.com/storytold/lightcraft
@johnnybegood 太机智了
@johnnybegood 感谢参观博客 对的主要是我用的360水冷 本来想用AMD TRX50但要买新散热不方便就直接买了这块b850 价格也不夸张。
x8/x8确实也限制了两张pro6000性能释放。
硬盘就是pcie5x4两个+pcie4x4一个作为系统盘:
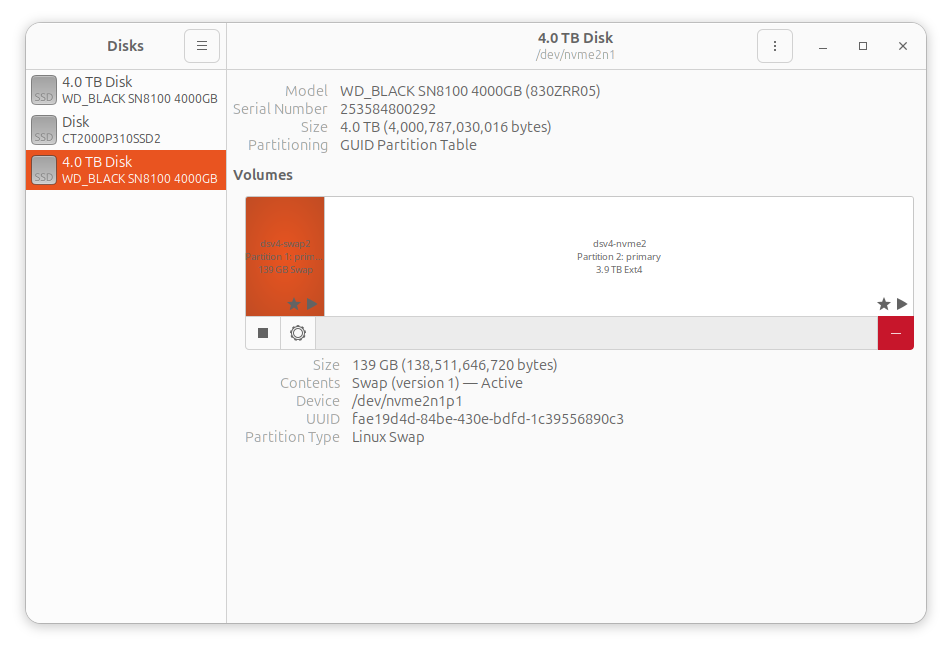
模型放pcie5盘上加载速度快
总之这个配置就是图一乐但也能干活。
噪音真没啥,限制了300w功耗外加调了CoolerControl曲线 非常安静 满载也就400w+
@terry 老特的评论md渲染可以升级一下支持mermaid图
and可以让mermaid图单独弹出来缩放
https://blog.haochuanz.net/posts/preview 小特可以学习一下
@imbiplaza-ASUS 我算了下这玩意儿一个20人团队用大概每人5000刀 绰绰有余。我们很多时候一个月就1000-2000刀token 虽然是SOTA但确实也是贵。
大部分任务开元模型都可以跑,这玩意儿5个月就回本了。
@imbiplaza-ASUS 但我看了下Alex Ziskind和Level1Techs他们实机测试 这个内部走线和配色实在是喜欢不起来(其实也是没钱)
补一篇同一天 Anthropic 的工程文章:Redesigning source control at Anthropic,我觉得挺值得关注。
按他们披露的数据,每天合入的代码改动从约 2,500 次涨到 30,000 多次,瓶颈开始从“写代码”转移到版本控制、构建和 CI。他们为此做了自己的版本控制系统 Scion:很多操作直接走服务端 API,不需要每个 agent 或任务都先拉一份本地仓库,用到文件再按需获取。
我觉得这里更有意思的是 Agent Native Tools 这个方向:现在很多工具和工作流,默认都是人来操作、按人的速度运转。当 agent 可以批量生成代码、报告,同时推进大量任务时,光给原来的工具套个聊天入口可能不够,底层的数据访问、权限、验证和协作方式都值得重新想一遍。
当然,不是说大家都该换掉 Git,文章也明确说 Scion 不适合通用替代。更像是一个信号:生成变便宜以后,怎么管理、验证和消化这些产出,反而成了更难的问题。
顺便问下老特,你的日报平时主要看哪些信息源?有没有值得关注的 Substack 作者推荐?我也想补充一下订阅列表,尤其是 AI 工程和 agent 方向的,哈哈哈。
@imbiplaza-ASUS 啊 4x RTX 6000 Pro 要10万刀的话 GB300 DGX Station不要太超值 算力甩8卡都几条街。